GreenWAM:面向机器人的世界基础模型 GreenWAM: A World Foundation Model for Robotics
以79槽共享解剖动作空间联合训练,一个基础模型同时充当世界模型与跨本体机器人策略
前置知识
世界模型(World Model)
学习场景如何随时间演化的生成模型,通常在大规模视频上预训练,能根据历史帧和(可选的)动作预测未来观测。在机器人中它有两种用法:作为'想象器'模拟动作后果以支持规划与评估,或通过预测状态轨迹直接充当控制器。本文的 WAM(世界-动作)模式就是给定首帧、实测状态 $q_0$ 和指令,用一个生成器同时预测未来视频与关节状态偏移。
全文的核心问题就是'一个世界模型能否兼任策略',所有实验(WorldArena 预测精度、RoboTwin 成功率、策略想象分析)都围绕这一双重角色展开,不先理解世界模型的概念就无法理解论文的立意。
整流流(Rectified Flow)
一类流匹配生成建模方法:把干净数据 $x_0$ 与高斯噪声 $\epsilon$ 沿直线路径插值 $x_\sigma=(1-\sigma)x_0+\sigma\epsilon$,训练网络在任意噪声水平 $\sigma$ 处预测速度 $v=\epsilon-x_0$;采样时从噪声出发沿速度场积分去噪。相比 DDPM 训练目标更简洁、采样步数可更少。Cosmos 3 Edge 及本文全部七种生成/预测模式都使用该目标,损失按有效性掩码对合法元素加权。
本文的训练目标(式 3)、状态目标的相对编码(式 2)以及蒸馏阶段的一致性损失全部建立在速度预测与噪声调度之上,不熟悉流匹配就看不懂损失函数与采样器的设计。
跨具身动作空间
不同机器人的关节数量、顺序、单位、符号与零点约定各不相同,跨具身学习要求把它们的动作映射到一个共享坐标系,使同一坐标在所有机体上意味着相同的关节运动。已有路线包括 Open X-Embodiment 的数据池化、UniAct 的原子动作空间、RDT-1B 的统一动作空间、HPT 的每本体 token 化等。本文用 79 个解剖槽位(腿/躯干/臂/手四块)加每布局 codec 与有效性掩码实现,且对应关系在投影之前就显式建立。
共享解剖空间是全文最重要的技术贡献:20 个家族共享一个动作投影器、新机器人只需写 codec 而无需新动作参数、单臂 Franka 经同一接口被控制,这些结论都源于此。
混合 Transformer 与动作专家
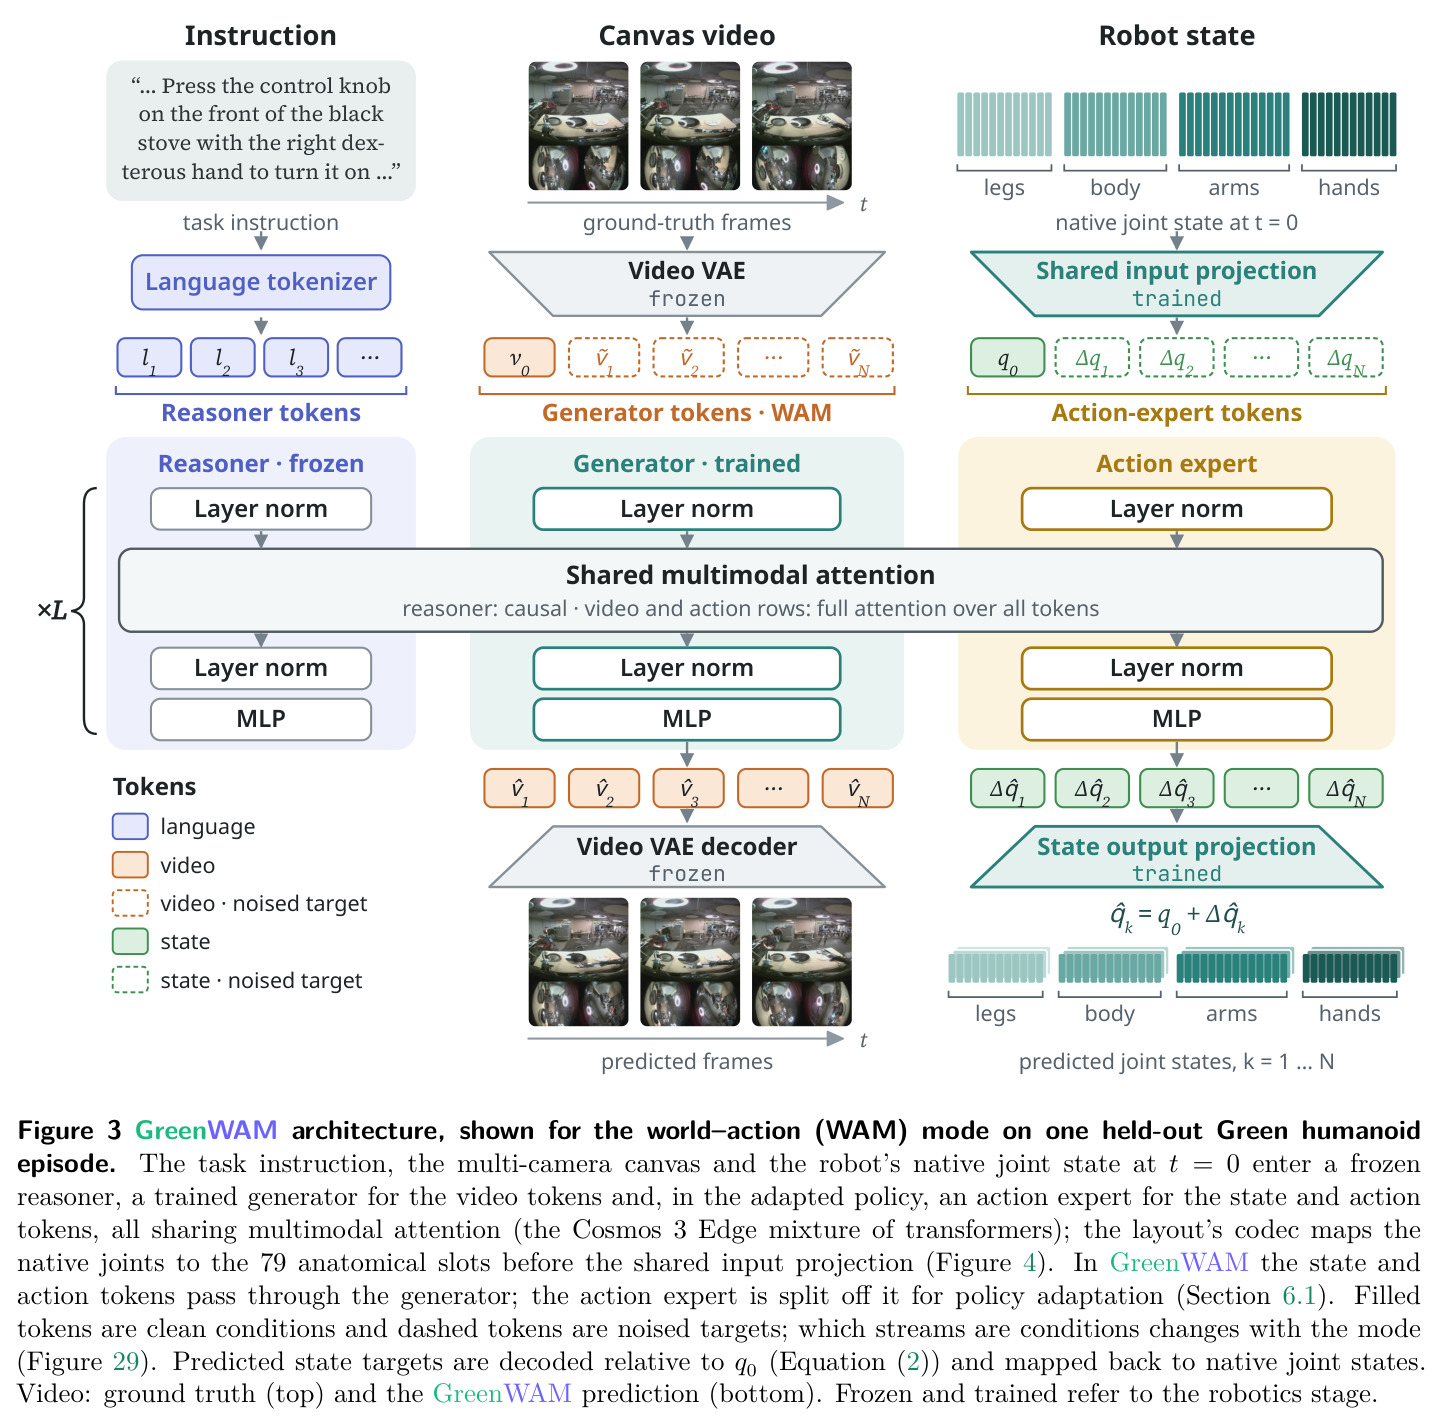
让不同模态的 token 走各自的权重塔(各自的层归一化与前馈网络),但在每一层共享同一个多头注意力,从而兼得模态专用容量与跨模态信息流动。Cosmos 3 的 reasoner-生成器结构即属此类。本文在策略适配时把动作 token 移入独立的专家塔,专家从生成器复制初始化 $\theta_E \leftarrow \theta_G$,形状相同,因此拆分瞬间模型的预测函数完全不变。
'动作专家何时拆分、如何初始化'正是消融实验 Q2 的核心问题(拆分带来 +3.3% 成功率),也是理解策略架构(式 8)的前提。
一致性蒸馏(Consistency Distillation)
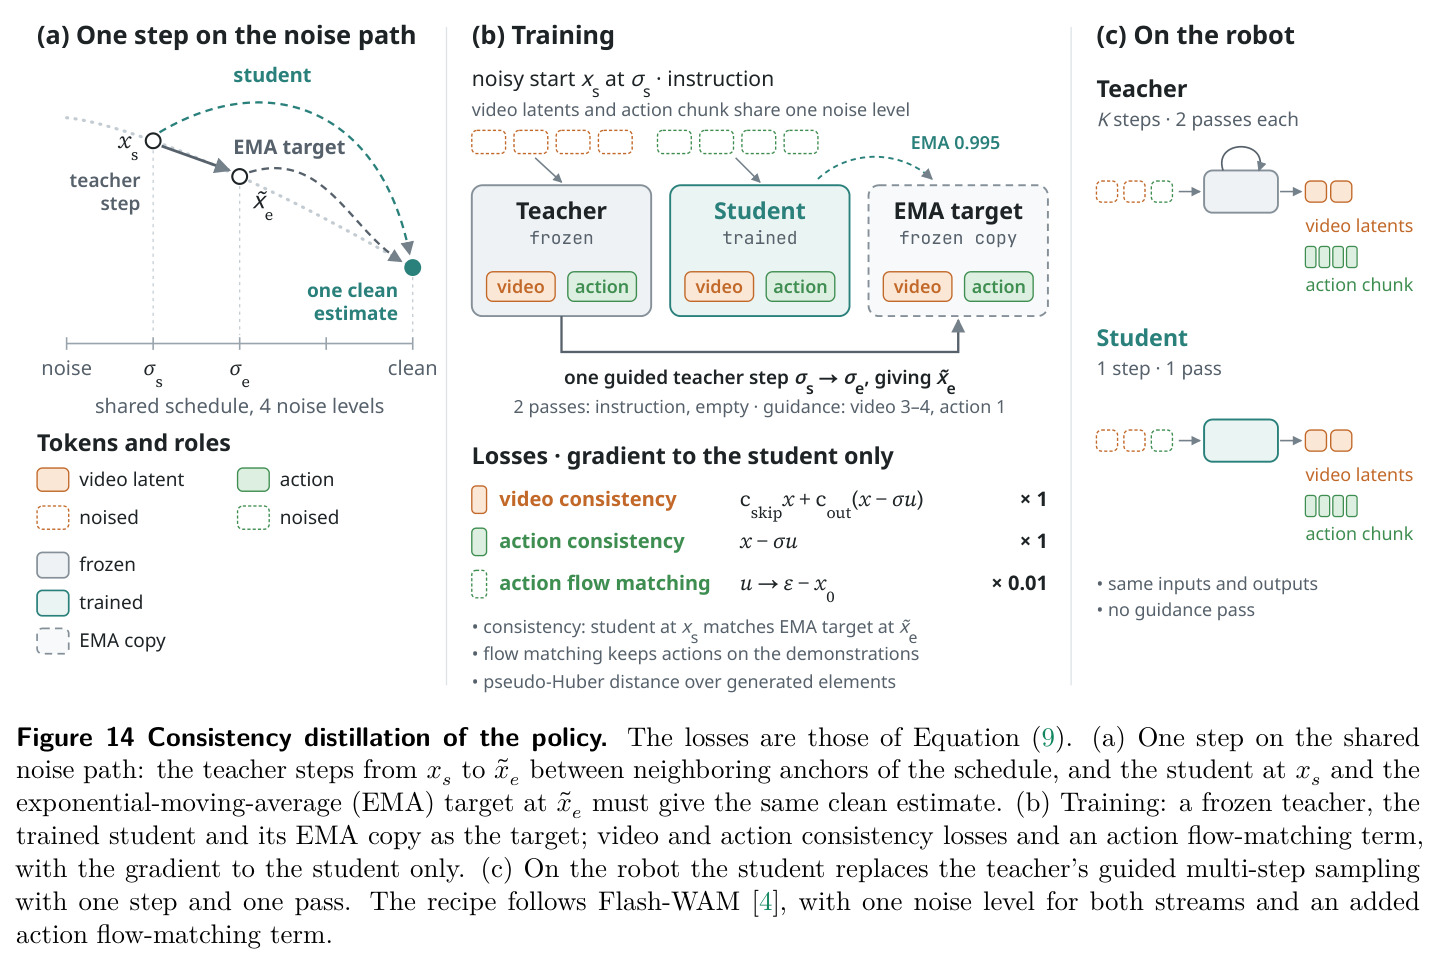
把多步扩散/流模型的采样压缩为一步的方法:冻结教师,训练学生在噪声水平 $\sigma_s$ 处的干净估计与 EMA 目标学生在更低噪声 $\sigma_e$ 处的估计保持一致,通常配指数滑动平均目标来稳定训练。本文按 Flash-WAM 配方让视频潜变量与动作块共享 4 级噪声调度,教师做一次引导步(指令与空提示两次前向、仅视频施加引导),学生单步直接输出干净预测,并额外加入动作流匹配项把学生锚定在演示目标上。
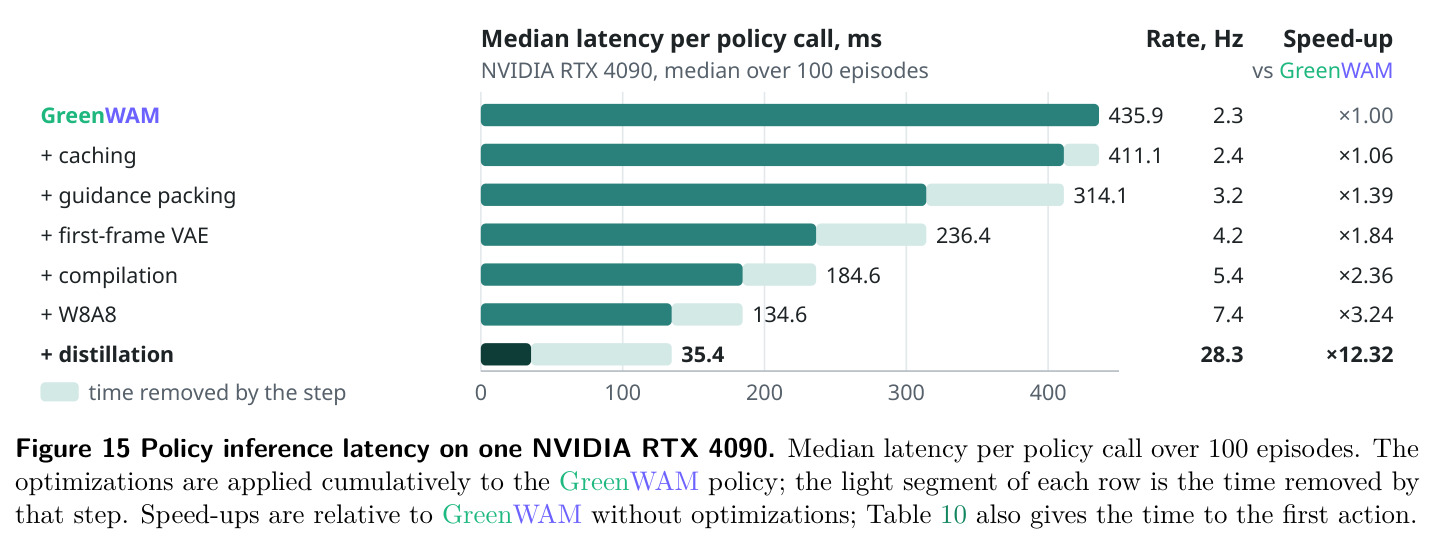
策略达到 35.4 ms、28.3 Hz 的实时控制全靠蒸馏(式 9 与 Figure 14),第 6.4 节的损失设计没有这一概念就无法读懂。
研究动机
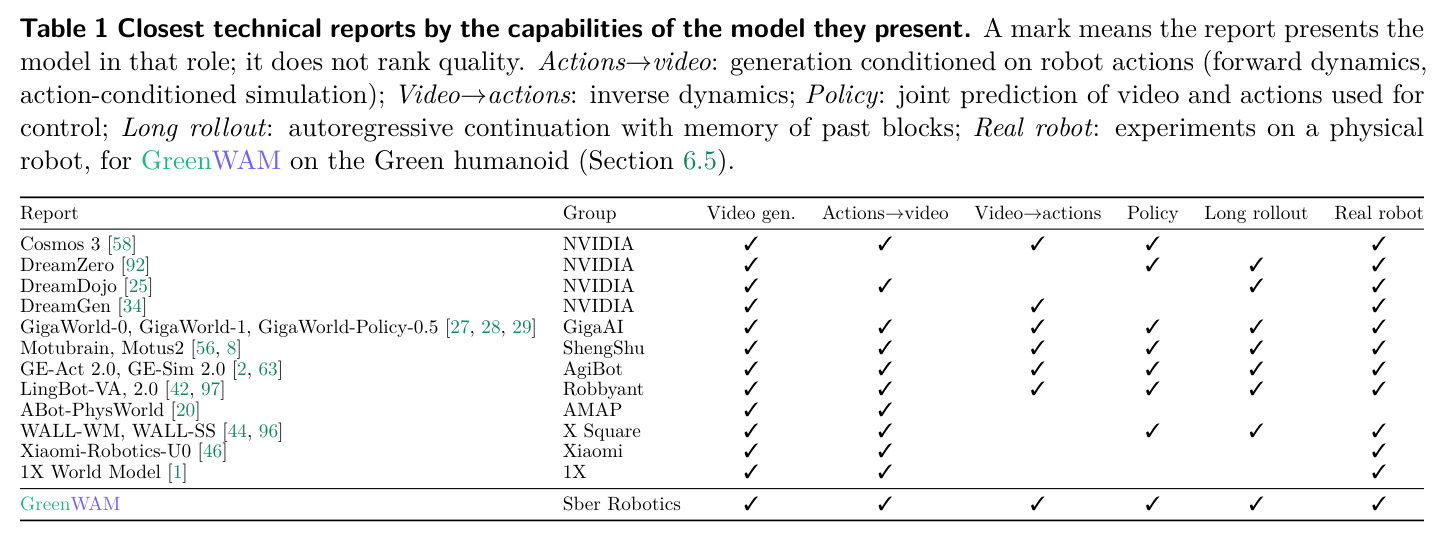
机器人领域长期把'预测场景如何变化'与'决定机器人怎么动'当作两个独立问题:世界模型按预测质量评测,策略按任务成功率评测,模型通常只为其中一个角色构建和评价。更棘手的是机器人数据严重碎片化:不同数据集的关节排布、夹爪与灵巧手、相机配置、帧率和任务边界互不兼容,同一个张量维度在不同机器人上代表完全不同的运动,手臂、躯干、腿和手指之间的对应关系要么隐式要么缺失。已有动作表示分三类且各有缺陷:Cosmos 3 Edge 为每个具身域单独配一个动作投影;GE-Sim 2.0 把末端执行器位姿按标定参数渲染进每一路相机图像,需要逐视角精确标定且无法表达手指关节;还有方法把关节向量补零到统一长度。作为本文母体的 Cosmos 3 Edge 问题尤其突出:其机器人数据只覆盖 6 种本体,81% 的时数来自单一数据集(AgiBot World),动作仅用'末端位姿增量+夹爪开合'表示,学得很粗糙,根本无法描述手指级的灵巧操作。
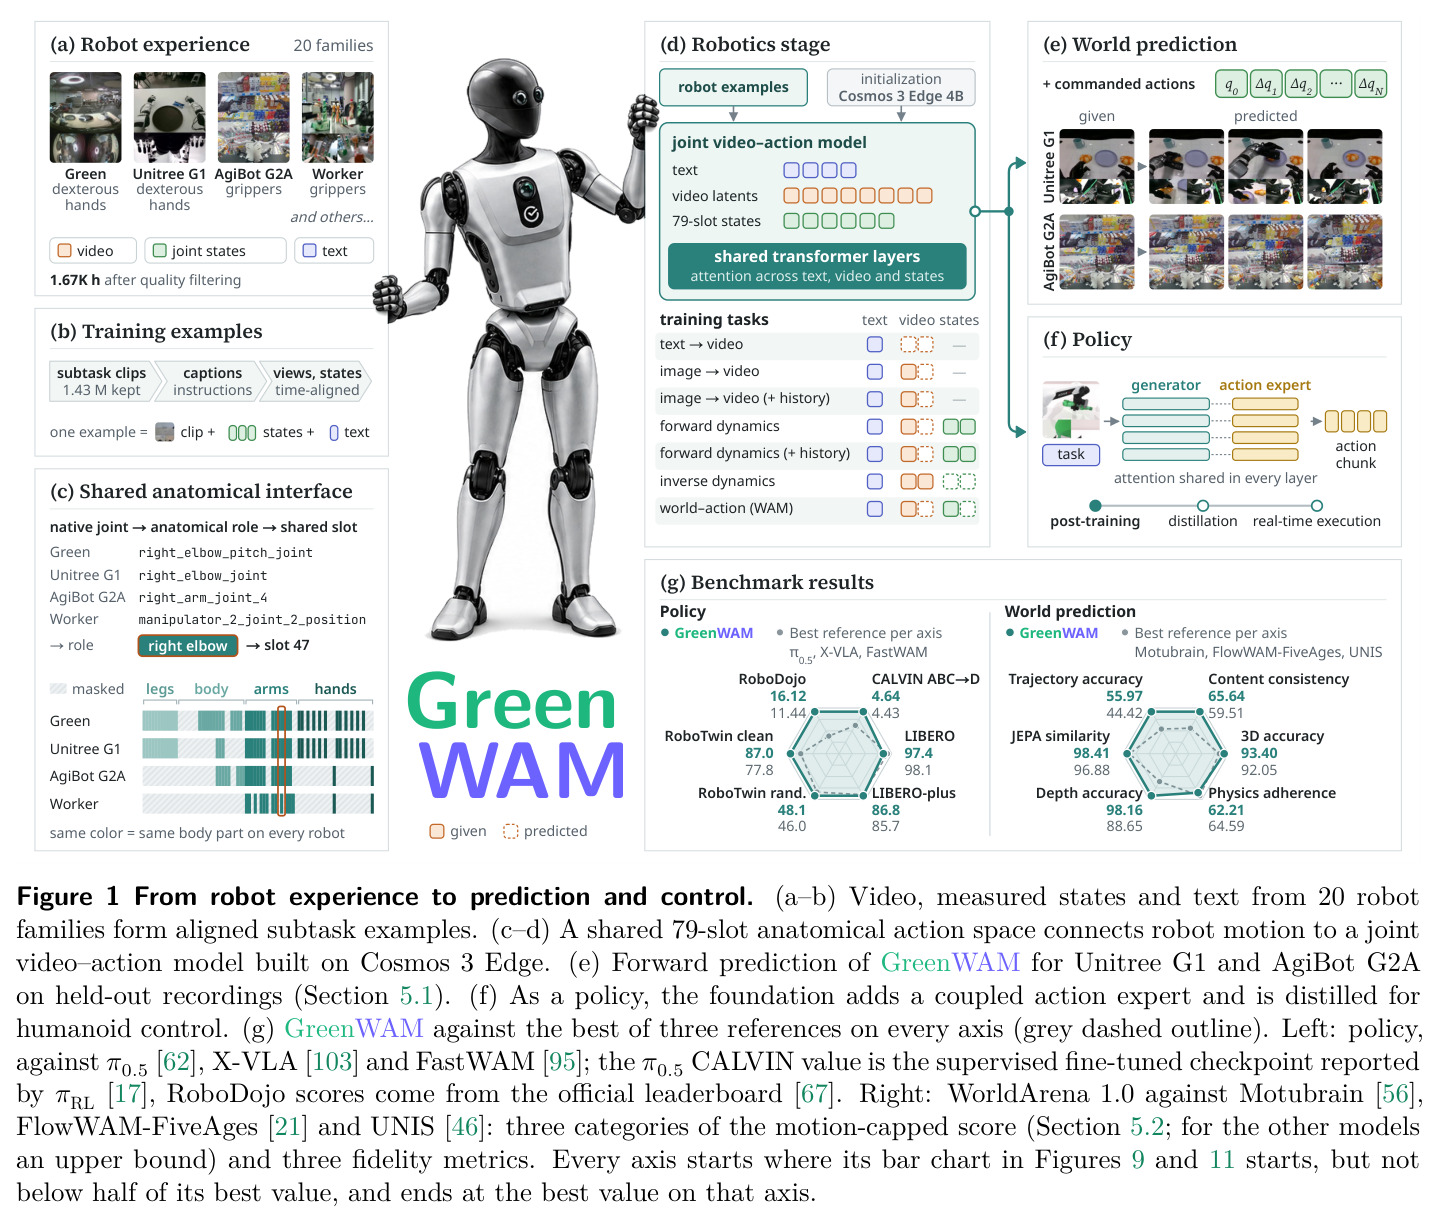
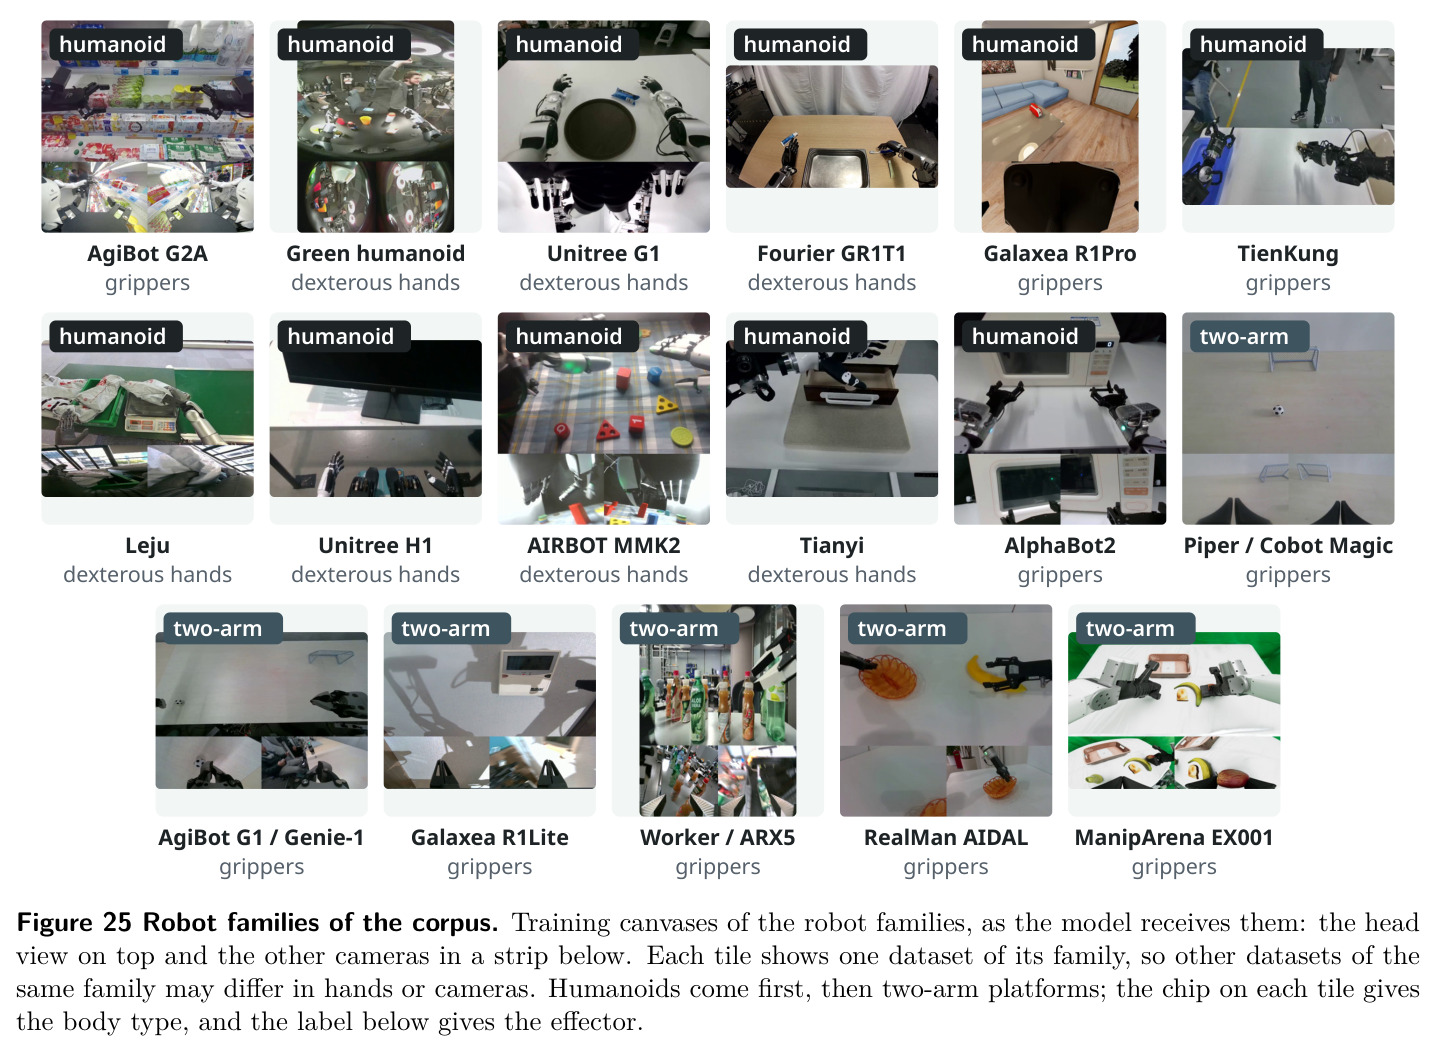
本文的目标是本文的核心问题是:一个机器人世界基础模型能否同时扮演世界模型与策略两种角色,并横跨不同的机器人本体?如果能,究竟是什么设计让它成立?为此作者提出 GreenWAM 及其完整训练配方,分三步:第一步,建立共享解剖动作空间,用统一的关节坐标描述 20 个机器人家族(从双臂夹爪平台到带灵巧手的人形);第二步,在这 20 个家族上以视觉、动作条件与世界-动作共七种模式联合训练一个模型;第三步,通过从生成器拆分动作专家得到策略,再蒸馏成单步实时策略。验证目标非常明确:世界模型角色在 WorldArena 1.0 上评测,策略角色在 RoboTwin 2.0、CALVIN、RoboDojo、LIBERO/LIBERO-plus 四个模拟基准上评测,再加上真实 Green 人形上的打包任务,最后用三组受控实验(专业化起点、动作专家、保留世界模型模式)回答'什么让它成立'。
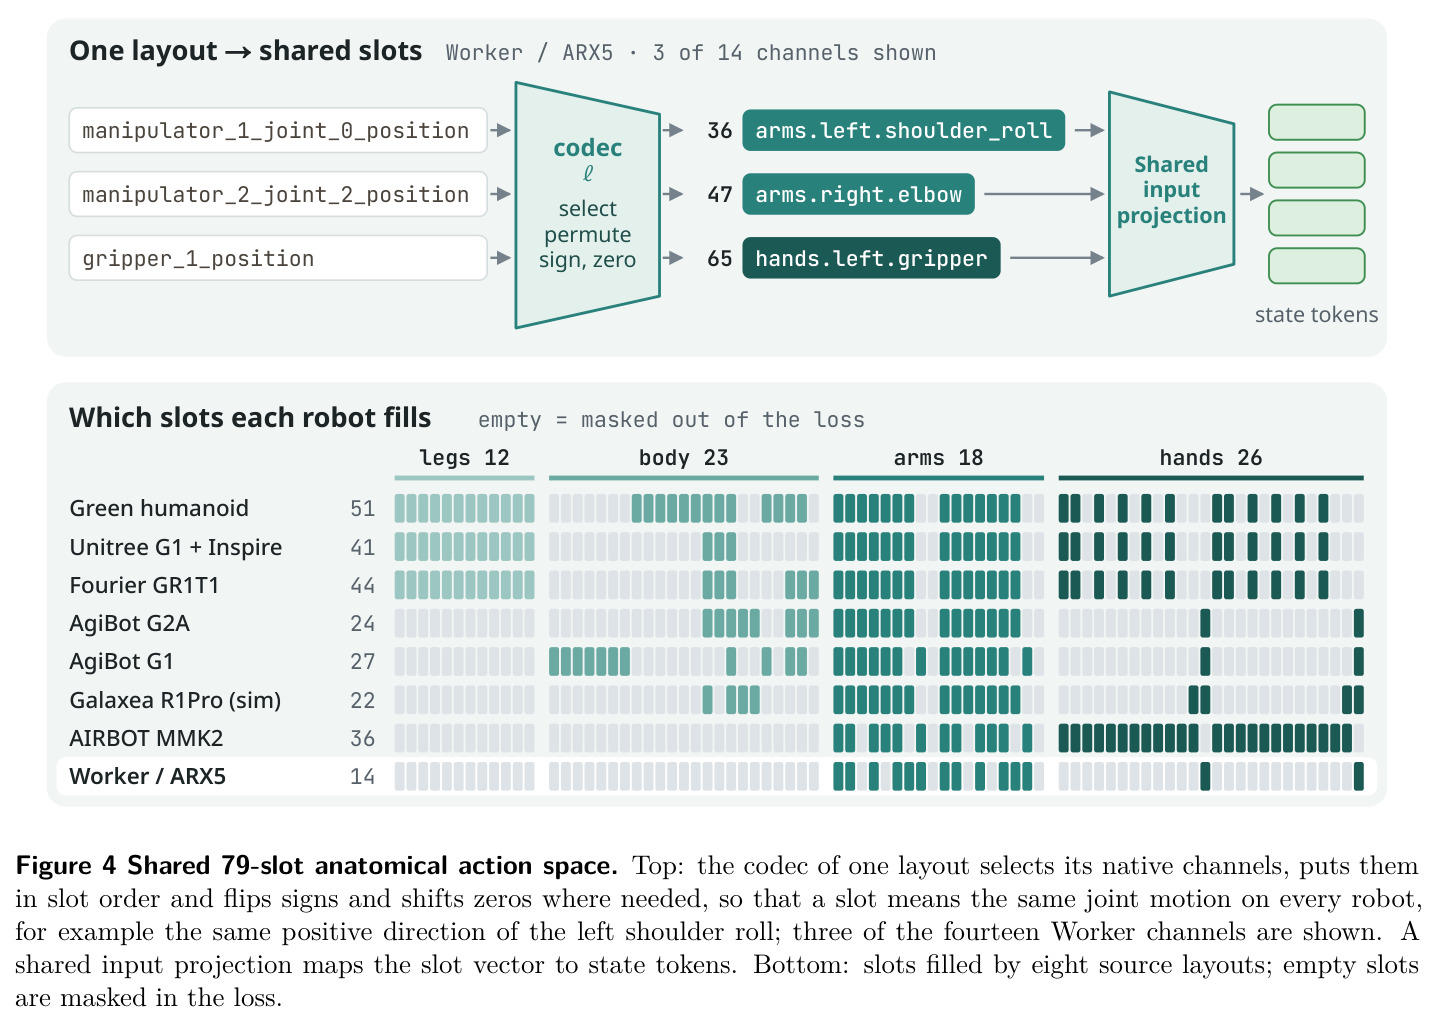
与已有工作不同的是,本文的独特切入有三点。第一,在投影之前显式建立跨本体对应关系:每个机器人布局先经过自己的编解码器(codec),把原生通道选择、重排、翻转符号、平移零点并归一化到 79 个解剖槽位,之后全部家族共享同一个动作投影器——'左肘'在每个平台上占据同一个槽位,而平台特异性约定由 codec 吸收;这比 Cosmos 3 Edge 的每域投影更严格,也比 GE-Sim 2.0 的动作图更通用(后者依赖逐视角标定且表达不了手指)。第二,'一次训练、两个角色':世界模型直接用生成器,策略则在适配时把动作 token 移入从生成器复制初始化的专家塔,两种角色出自同一个检查点与同一个动作接口,连从未出现在语料中的单臂 Franka 也能经同一接口在 CALVIN 和 LIBERO 上被控制。第三,把'保留世界模型能力'本身作为策略适配的设计选择:训练时保留小份额的前向动力学与图生视频模式,换取对场景随机化的鲁棒性,并用'策略想象'实验给出机理解释——这是对世界模型与策略两条研究线的真正缝合。
核心方法
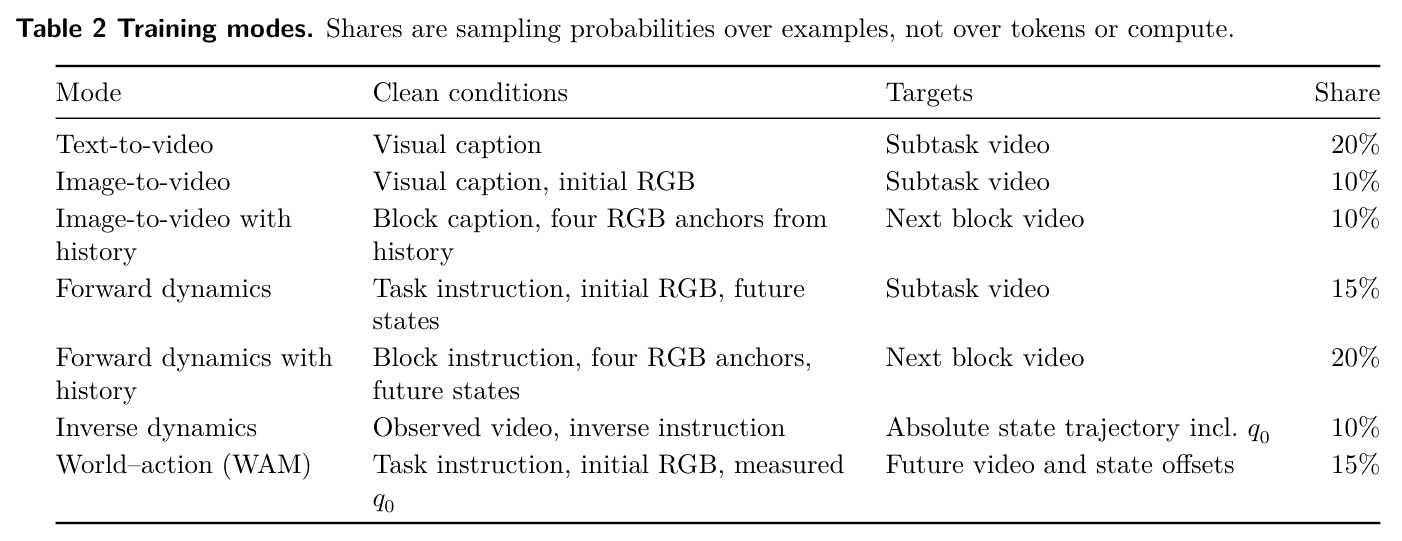
直觉上,一段带状态的机器人视频可以同时回答多个问题:场景接下来什么样、给定轨迹机器人会看到什么、什么轨迹产生了这段视频、以及下一步该做什么。与其为每个问题单独训练模型,GreenWAM 用一套生成器权重同时回答全部问题。技术上,模型从公开的 Cosmos 3 Edge 4B 检查点初始化,采用 reasoner-生成器的混合 Transformer 架构与因果视频 VAE;机器人学阶段冻结 reasoner 和 VAE,只训练生成器、共享动作投影和动作模态嵌入。训练在七种模式下进行(Table 2):文生视频(20%)、图生视频(10%)、带历史图生视频(10%)、前向动力学(15%)、带历史前向动力学(20%)、逆动力学(10%)与世界-动作 WAM(15%)。每种模式由'哪些流是干净条件、哪些是加噪目标'定义,一个样本的所有生成流共享同一噪声水平 $\sigma$,沿整流流路径加噪并预测速度:$x_\sigma=(1-\sigma)x_0+\sigma\epsilon$,$v=\epsilon-x_0$。自回归模式以四个固定位置(起点、1/3、2/3、终点)的 RGB 锚点为历史条件;WAM 模式从首帧、实测状态 $q_0$ 和指令出发,预测未来视频与相对 $q_0$ 的状态偏移。视觉与动作在共享的物理时间网格上对齐。
核心创新是共享解剖动作空间。79 个槽位分四块:腿(12)、躯干(23:基座位姿 7、基座扭转 6、躯干关节 7、头部 3)、手臂(18)、手(26:平行夹爪的开合坐标与灵巧手的逐指坐标,含副指、编码器与指外展的辅助槽位)。每个布局的 codec 在 $m_{\ell j}=1$ 时按 $q_j=\rho_{\ell j}(x_{\pi_\ell(j)}-o_{\ell j})$ 把原生通道填入槽位($\rho$ 翻符号、$o$ 平移零点),再归一化 $\bar q_j=(q_j-\mu_{\ell j})/s_{\ell j}$;无效槽位由掩码 $m_{\ell j}$ 从损失中剔除,机器人没有的腿或手指永远不会变成模型必须学会的'零运动'目标。前向类模式默认把腿、躯干、头、臂表示为相对块边界的偏移 $\delta_k=q_k-d_\ell\odot q_0$,预测后用 $\hat q_k=\hat\delta_k+d_\ell\odot q_0$ 解码,而夹爪与手指保持绝对值。与已有方法的本质区别在于:跨本体的对应关系在进入投影器之前就由 codec 显式建立,一个共享投影器服务全部 20 个家族,接入新机器人只需写一个 codec,无需任何新的动作参数;而状态损失先在腿/躯干/臂/手各部位组内平均、再跨组平均,防止坐标多的组主导训练。
方法步骤详情
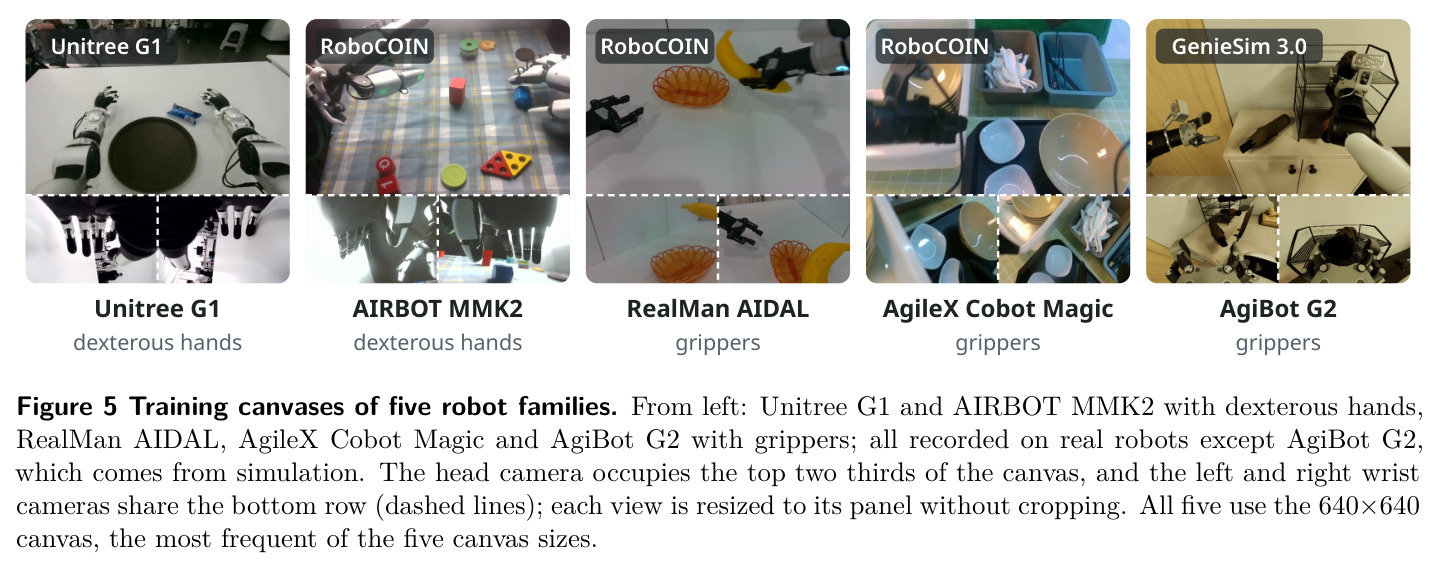
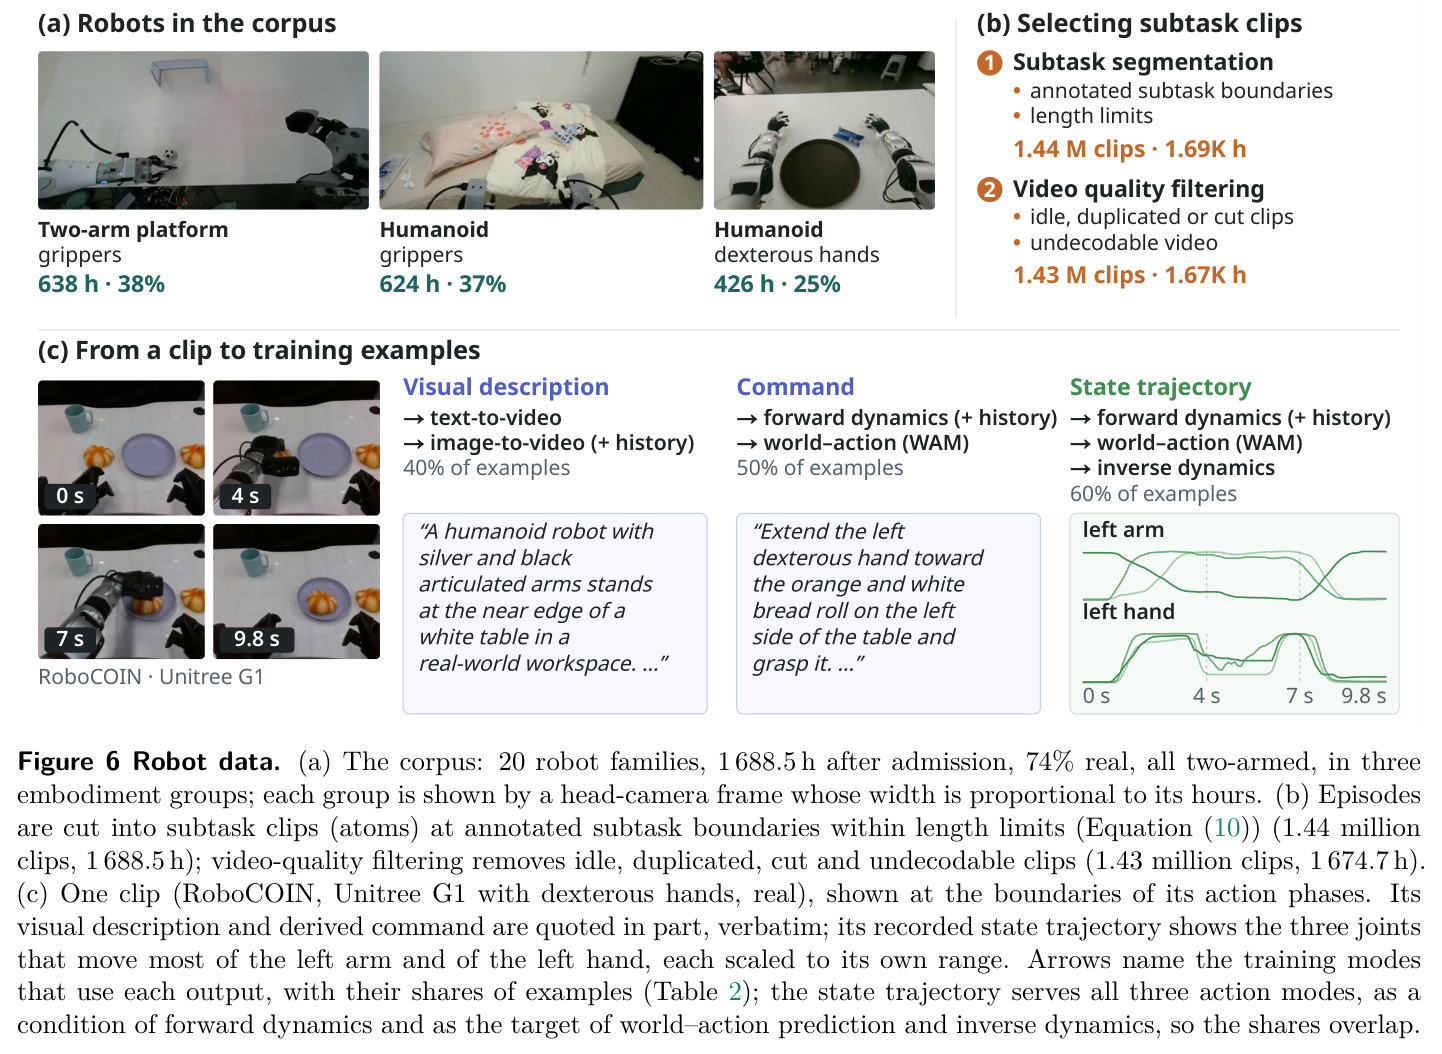
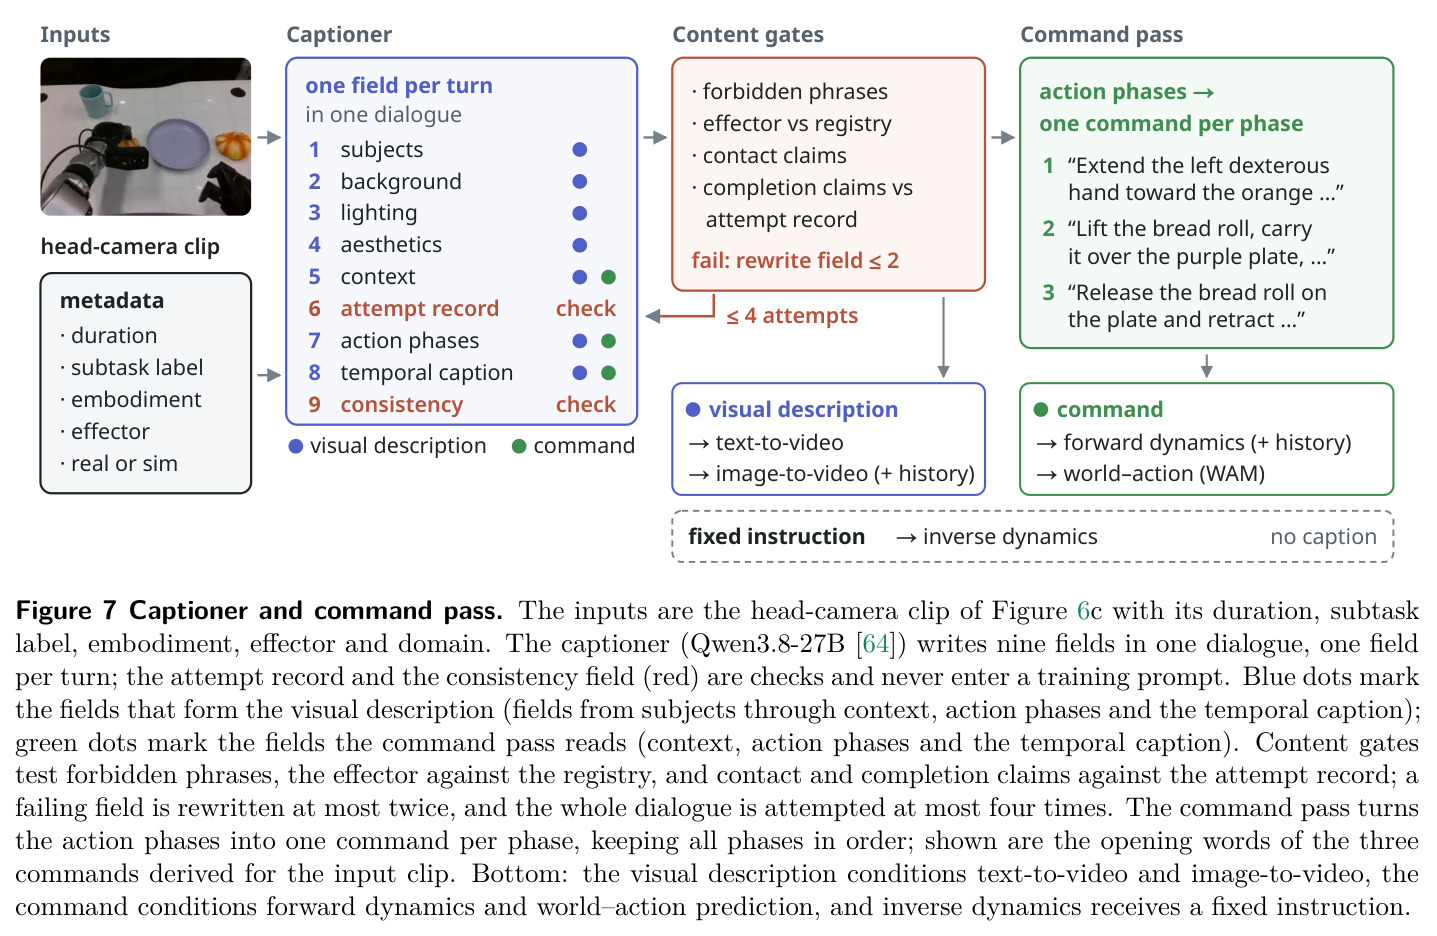
完整流程分四步。第一步,数据构建:把 20 个双臂家族(74% 真实录制)的录像按标注的子任务边界切成'原子',得到 144 万个原子、1688.5 小时;视频质量过滤剔除闲置、重复帧、剪切与不可解码片段后剩 143 万个(1674.7 小时);Qwen3.8-27B 字幕器在单轮对话中逐字段写出九个字段(主体、背景、光照、美学、语境、尝试记录、分阶段动作、时序描述、一致性检查),内容门禁检查违禁短语、效应器与注册表的一致性、接触与完成声明是否与尝试记录相符,失败字段最多重写两次、整段对话最多尝试四次;再由纯文本阶段把动作阶段转成前瞻性指令,保留未完成尝试的真实动作而不替任务'圆谎'。三相机源在离线拼成画布:头部相机占上 2/3,左右腕相机共享下排,最常用 640×640。第二步,联合训练:64 张 H100、全局 batch 256、36500 步(934 万采样样本),总损失 $\mathcal{L}=\lambda(\mathcal{L}_{video}+\mathcal{L}_{state})$、$\lambda=10$,文本条件以 0.1 概率丢弃用于无分类器引导。第三步,成为策略:把动作 token 移入独立专家塔并以 $\theta_E\leftarrow\theta_G$ 复制初始化,每层共享注意力(式 8);各基准用目标机器人演示训练 WAM 模式,预测相对 $q_0$ 的 16 步动作块,执行前缀后重规划,并施加背景替换(50% 样本,需模拟器分割)与颜色扰动(80% 样本)两种外观增强。第四步,蒸馏:视频与动作共享 4 级噪声调度,$\mathcal{L}_{distill}=\lambda_v\mathcal{L}_{CD,v}+\lambda_a\mathcal{L}_{CD,a}+\lambda_{FM}\mathcal{L}_{FM,a}$,EMA 衰减 0.995,得到单步学生策略。
技术新颖性
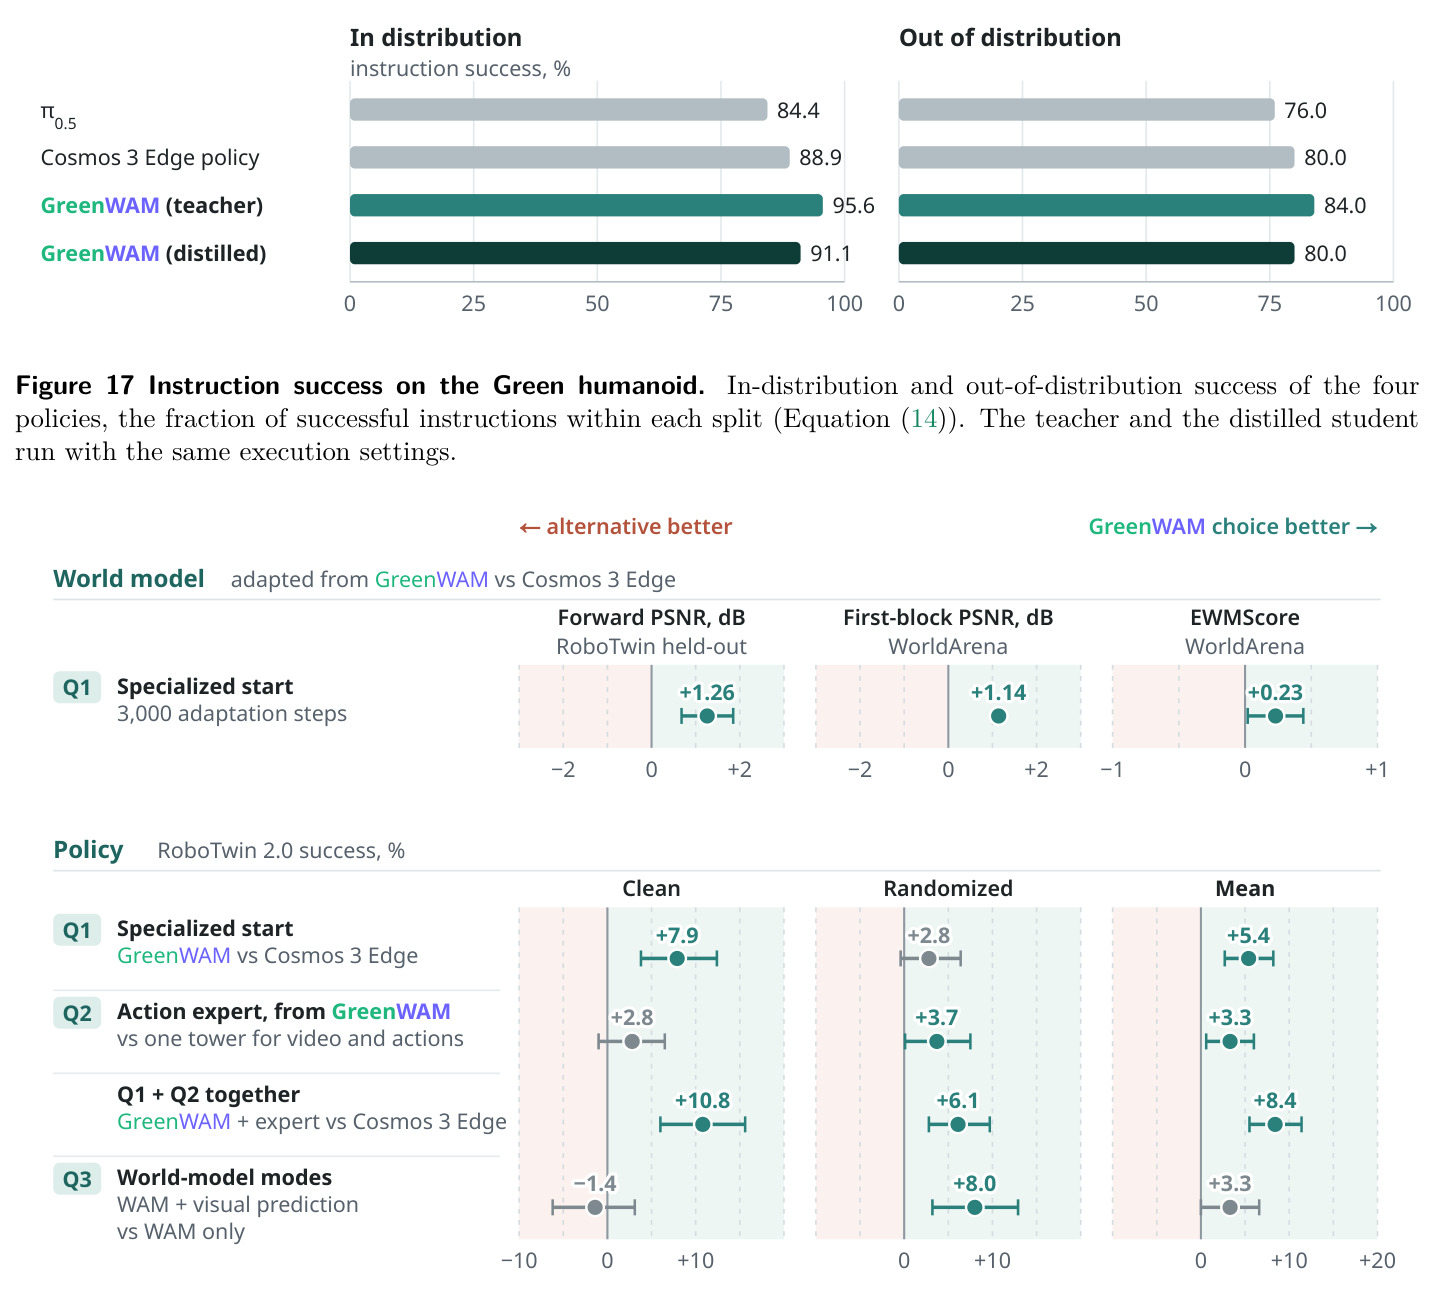
技术新颖性体现在四个方面。其一,79 槽解剖空间加有效性掩码是比'每具身域一个投影'(Cosmos 3 Edge)和'动作图渲染'(GE-Sim 2.0)更严格的设计:槽位的物理意义全局统一,且作者实证了新本体接入只需 codec——单臂 Franka 完全不在语料中,却经同一接口在 CALVIN 达到 4.64、LIBERO 达到 97.4%。其二,把 UWM 的'视频-动作联合扩散'思想推广到 20 个本体:七个模式共享物理时间网格与一套权重,一次训练同时产出世界模型与策略,直接挑战'世界模型与策略分开构建、分开评测'的领域惯例。其三,动作专家的复制初始化保证拆分瞬间模型函数不变(与 Motus 用隐式动作预训练专家、ME-Dex 继承专家的做法不同),消融证明'在适配开始时拆分'本身带来 +3.3% 的成功率,而验证损失几乎不变(1.503 对 1.510),说明收益来自参数化而非拟合能力。其四,策略适配保留 0.05+0.05 的前向动力学与图生视频份额(WAM 占 0.9),在随机化场景提升 8.0% 而干净场景不变,把'世界建模是控制的一部分'从口号变成了可测量、可消融的设计原则,并用想象准确性与成功率的关联给出了因果解释。
实验结果
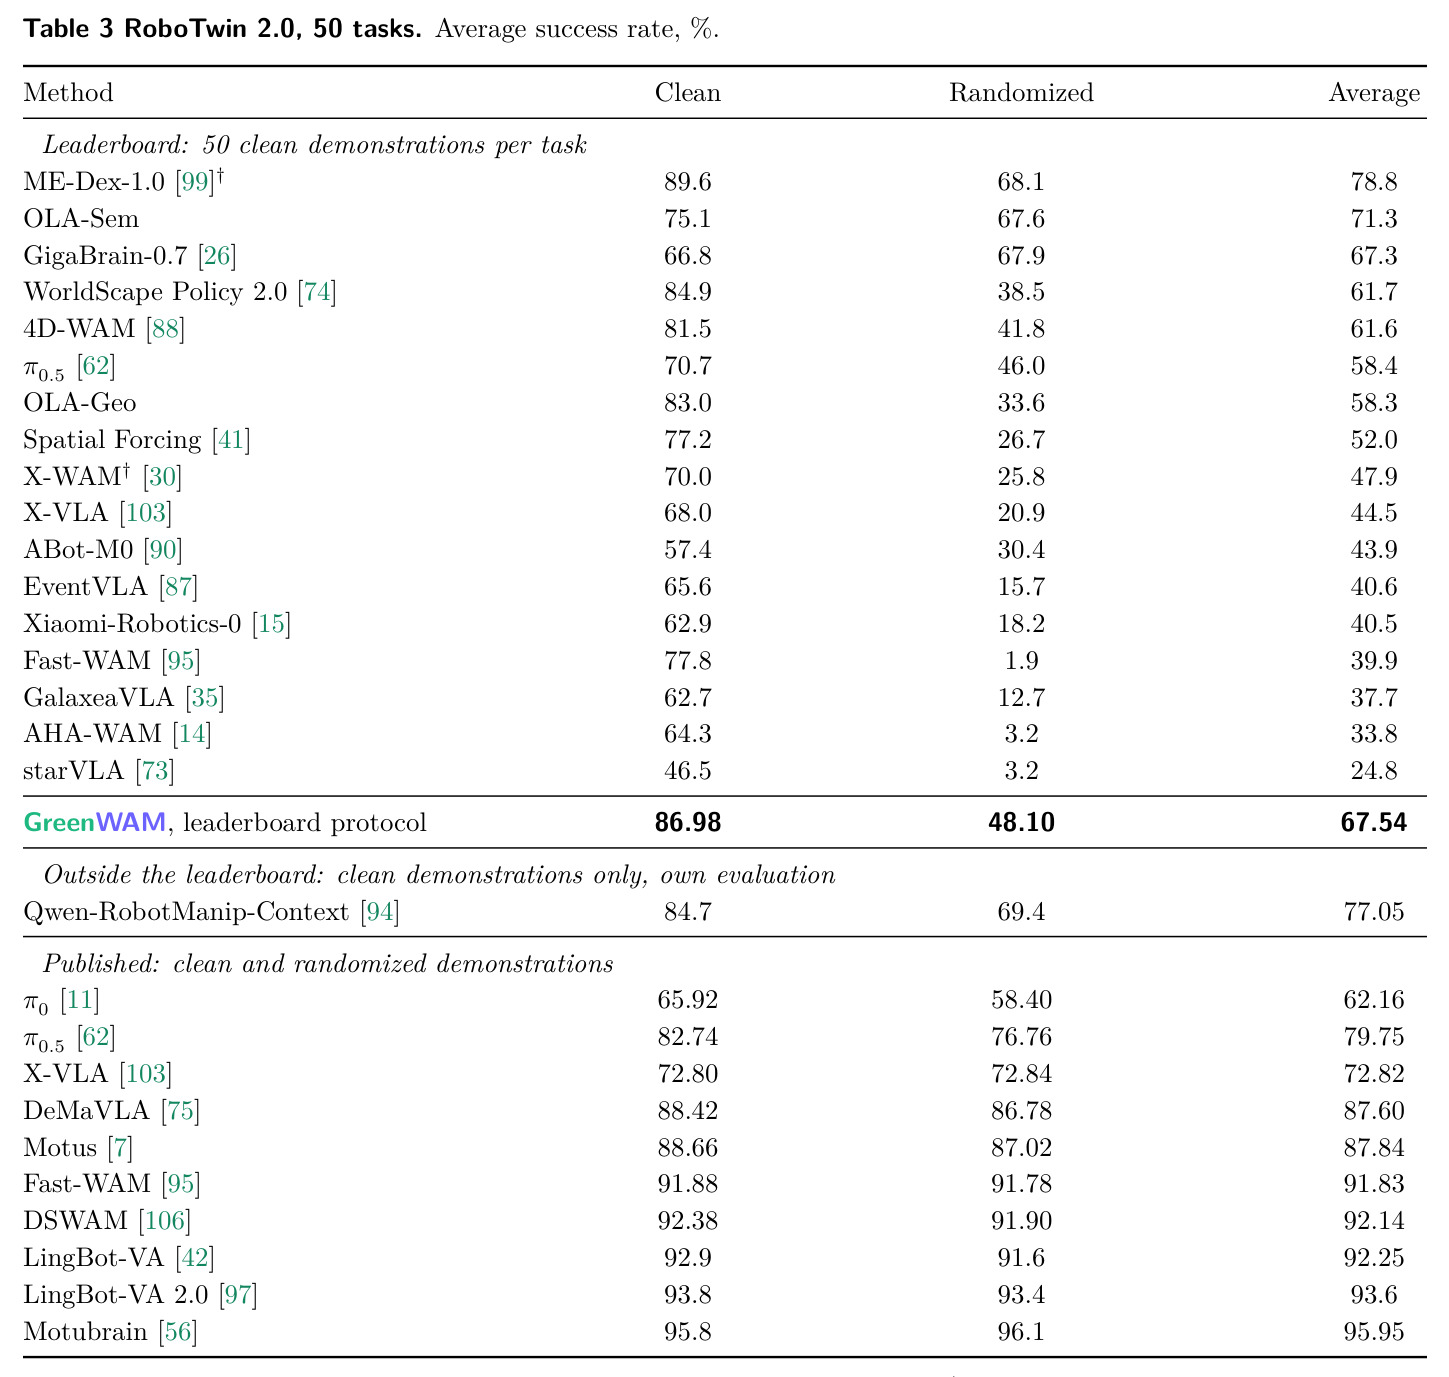
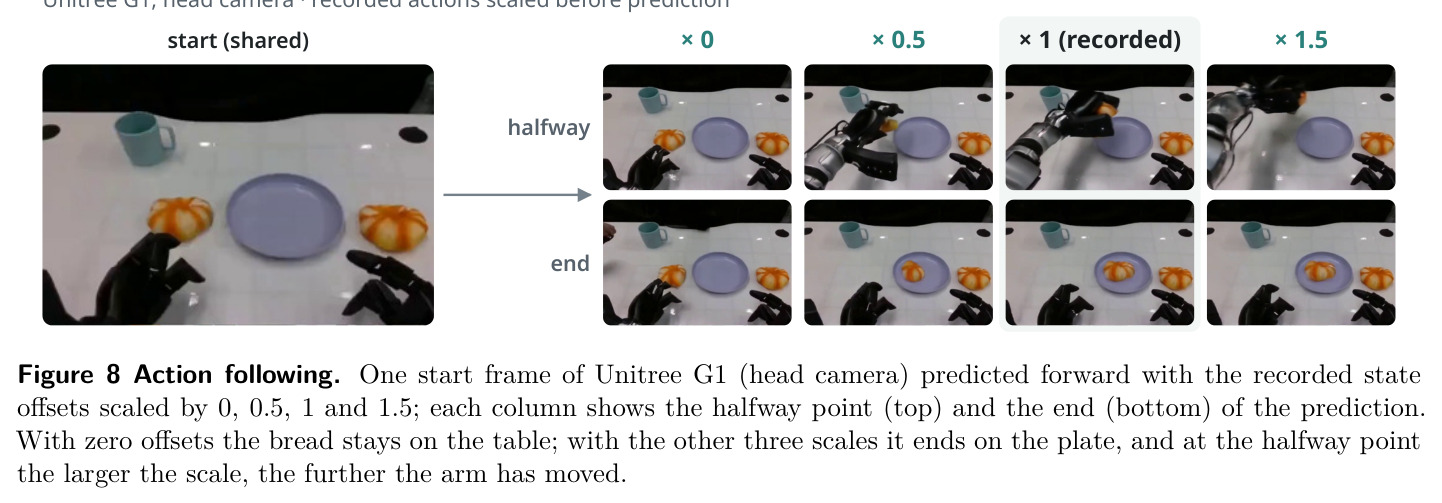
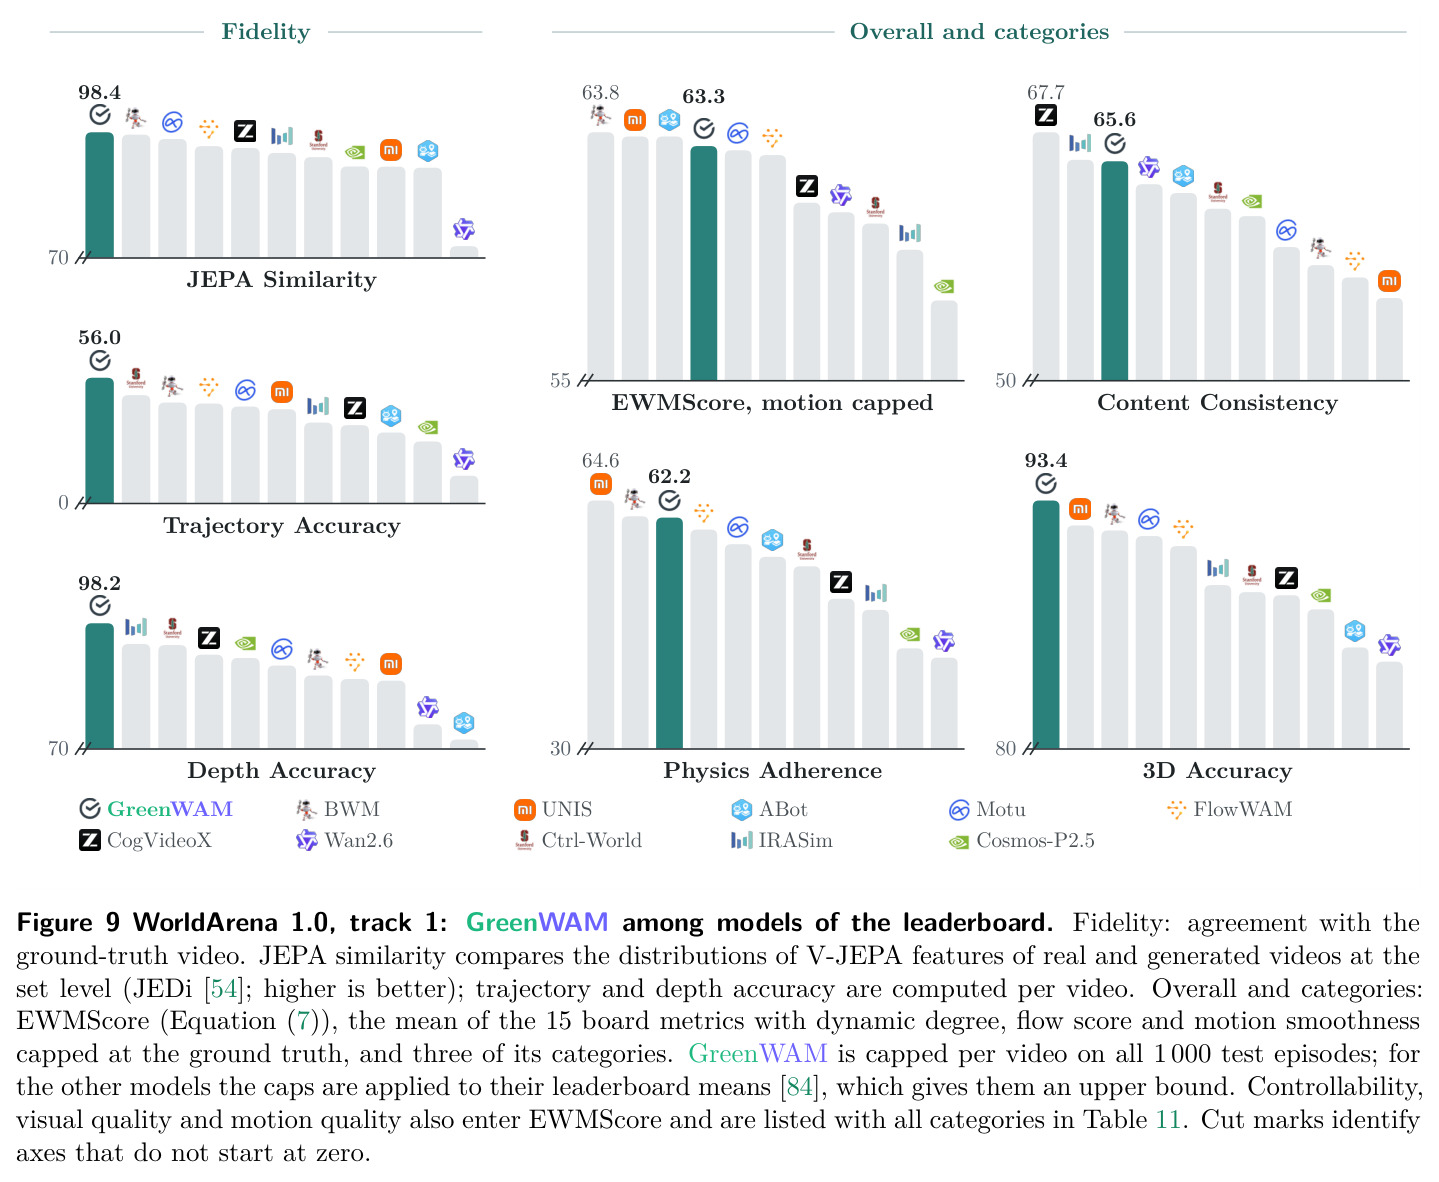
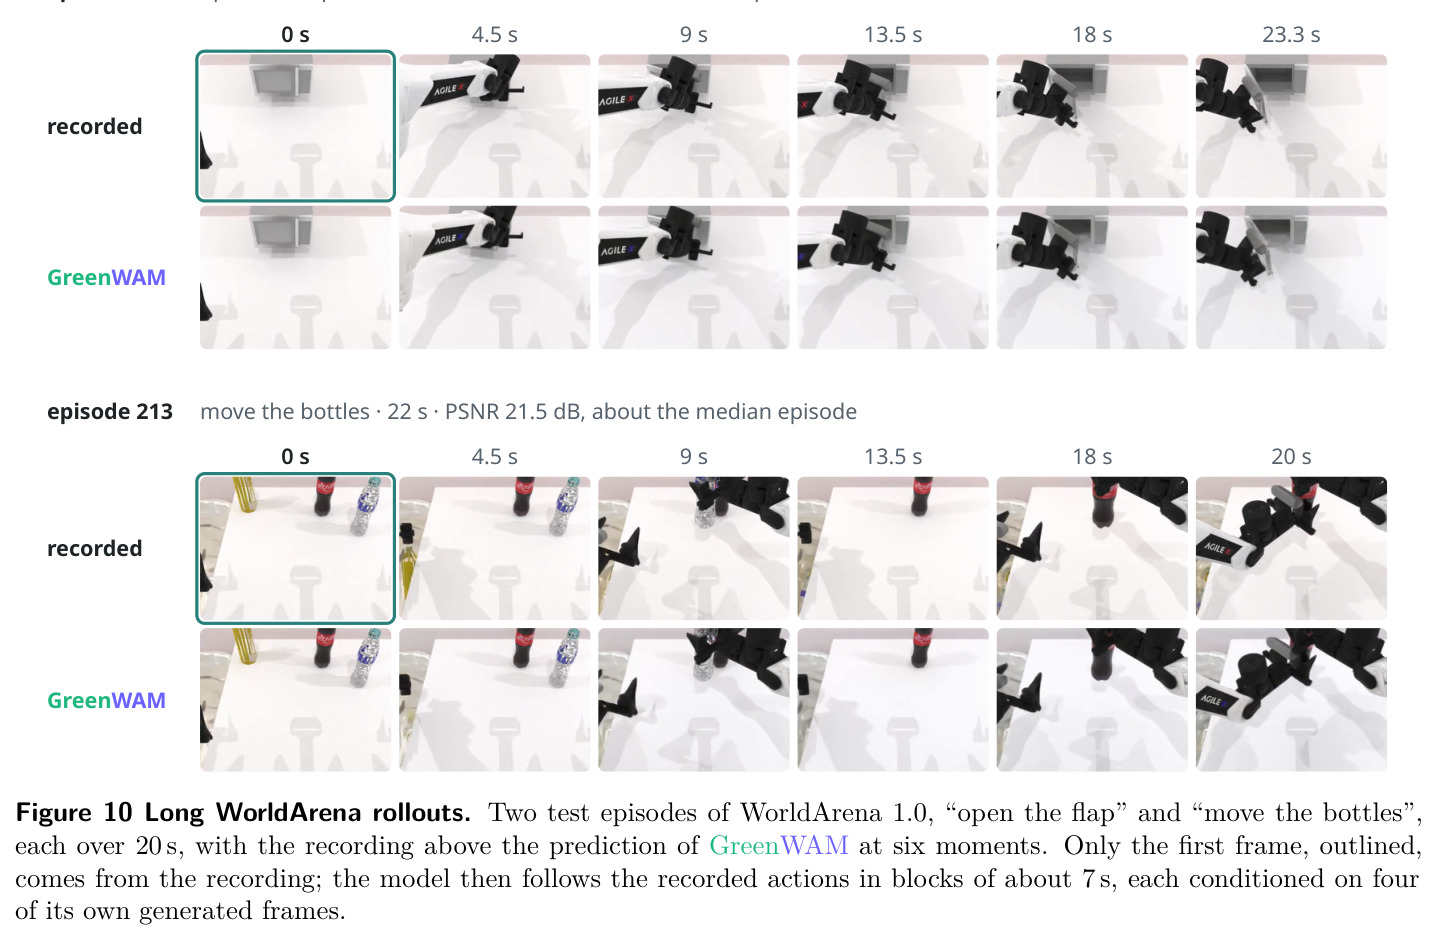
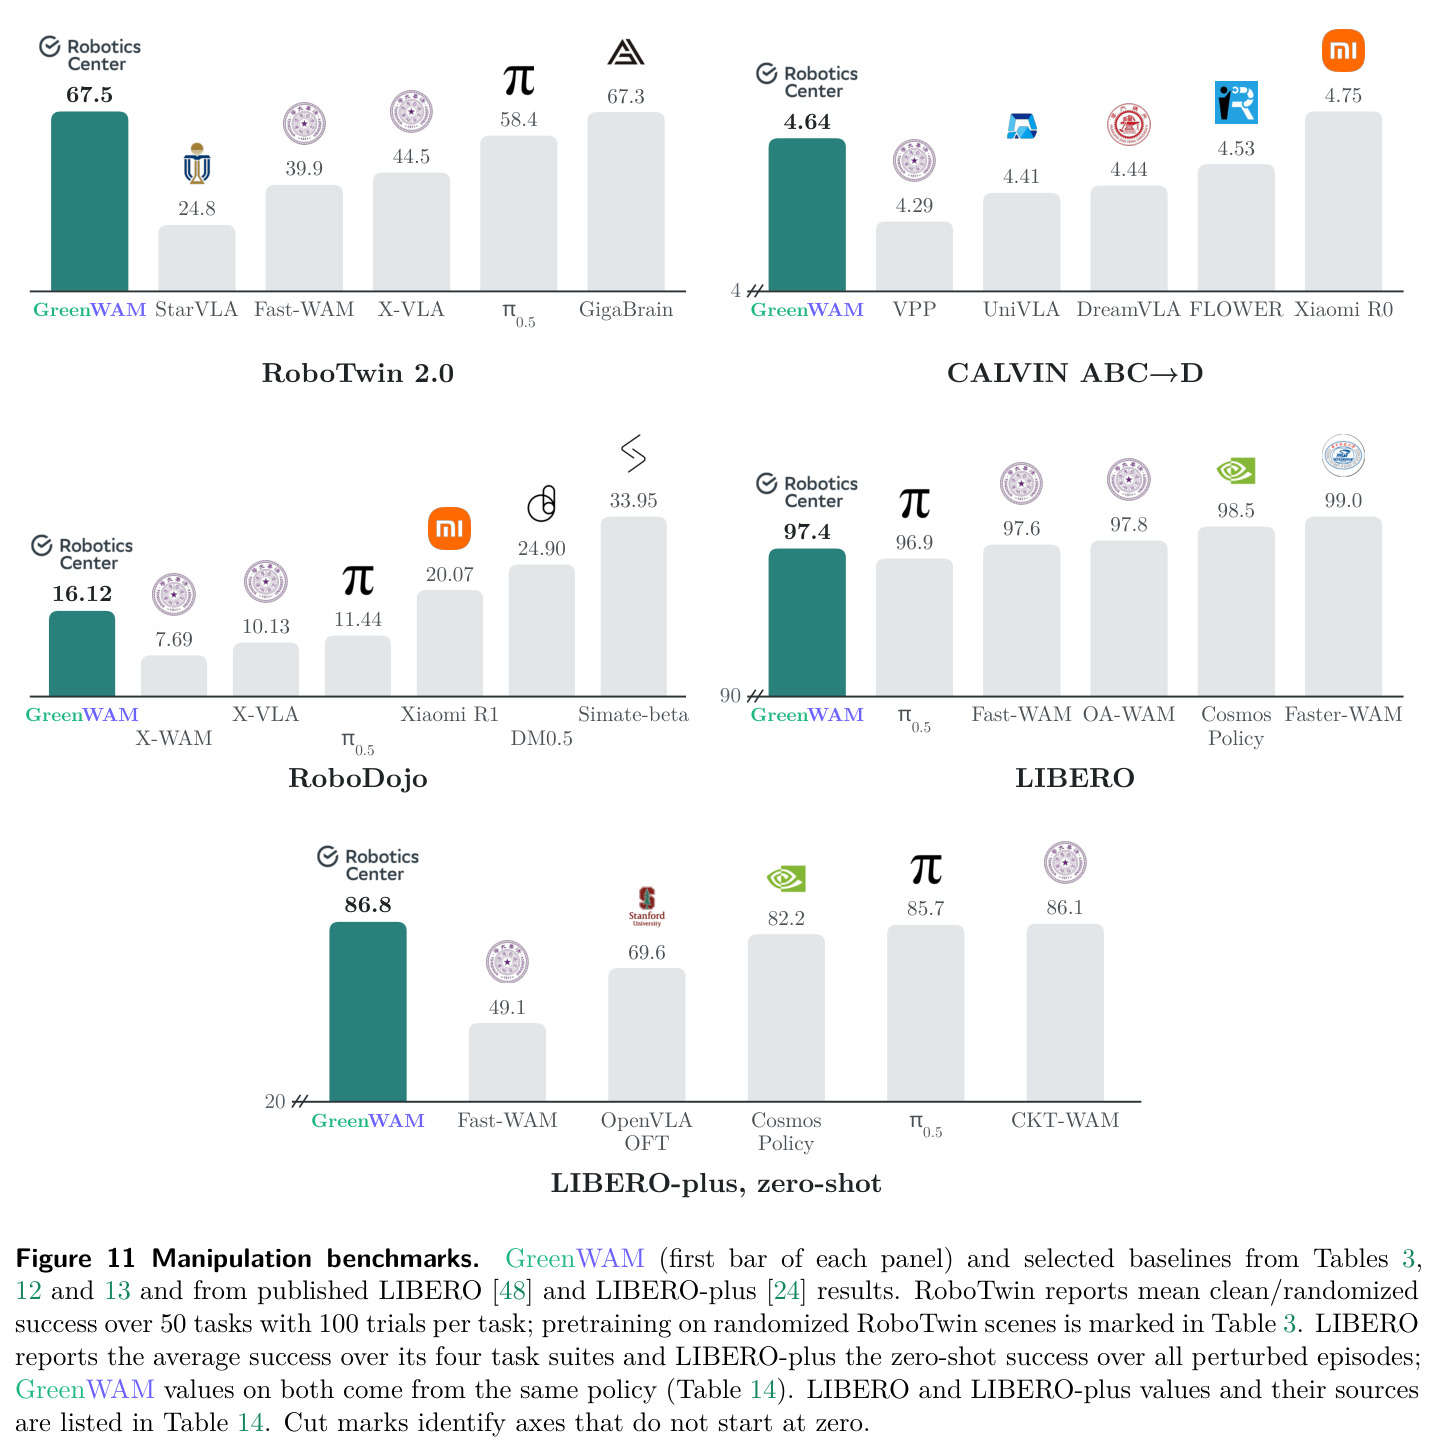
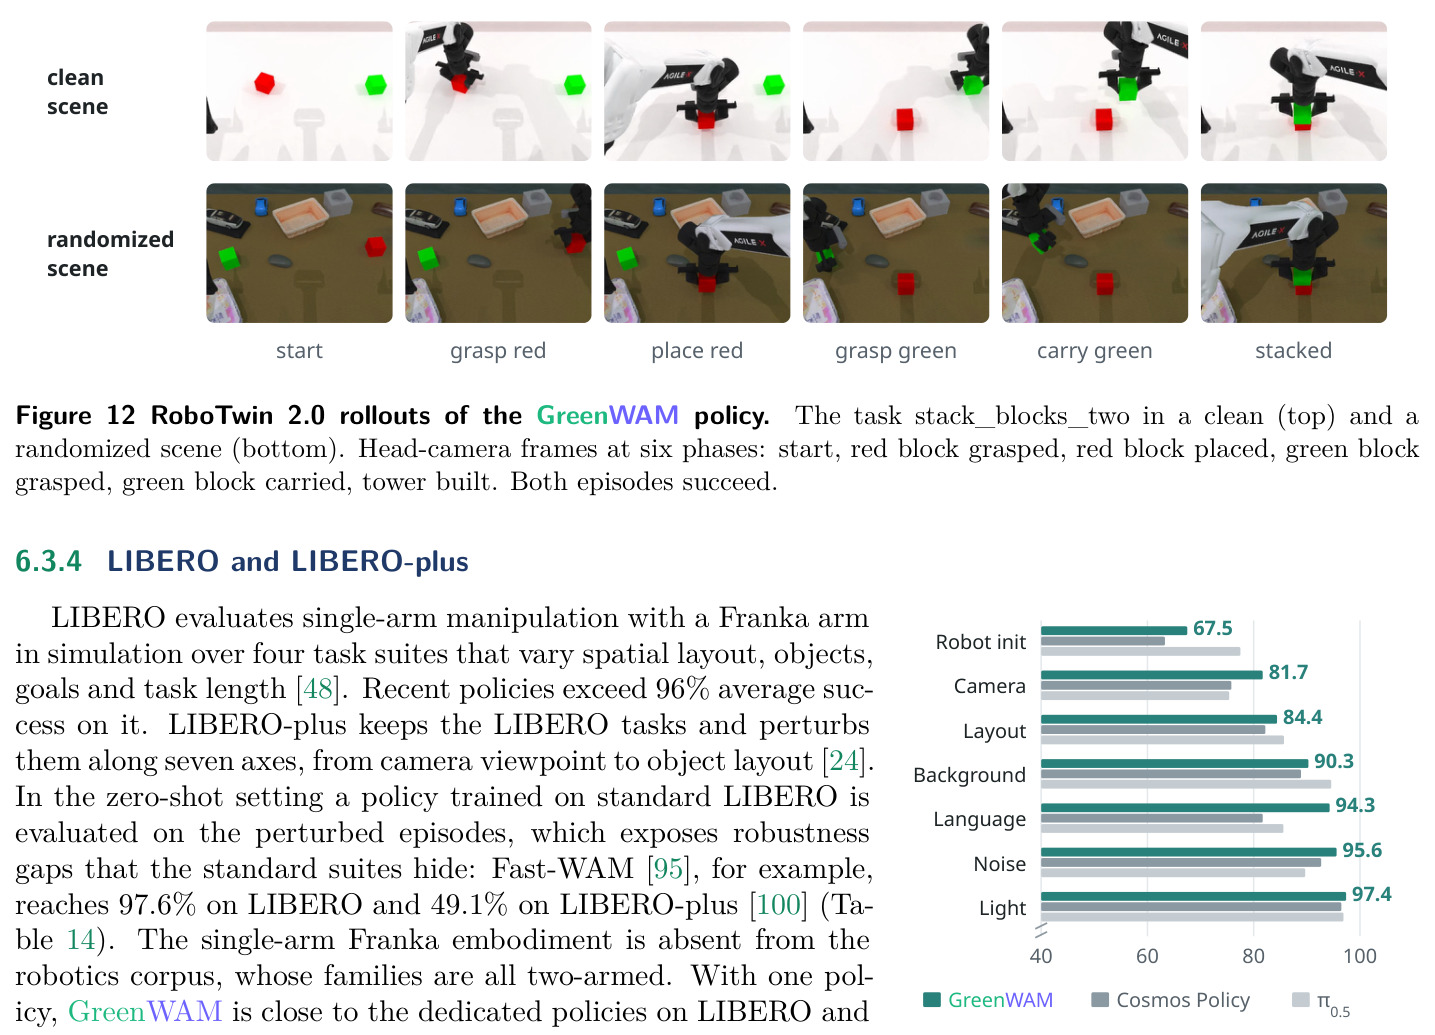
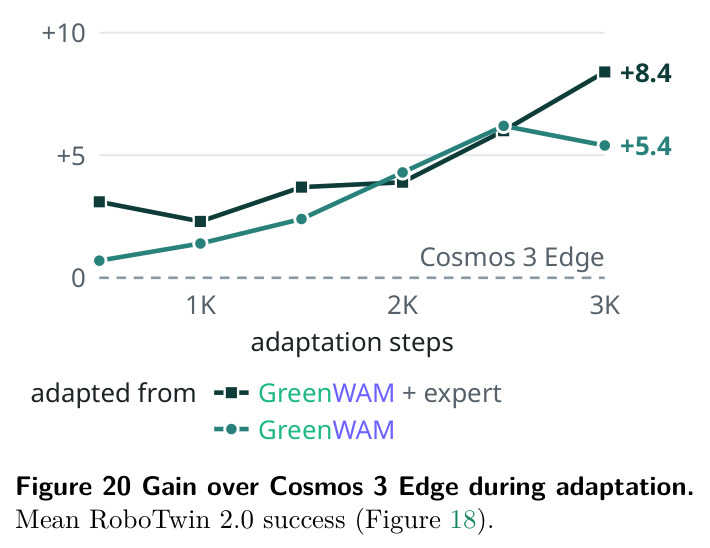
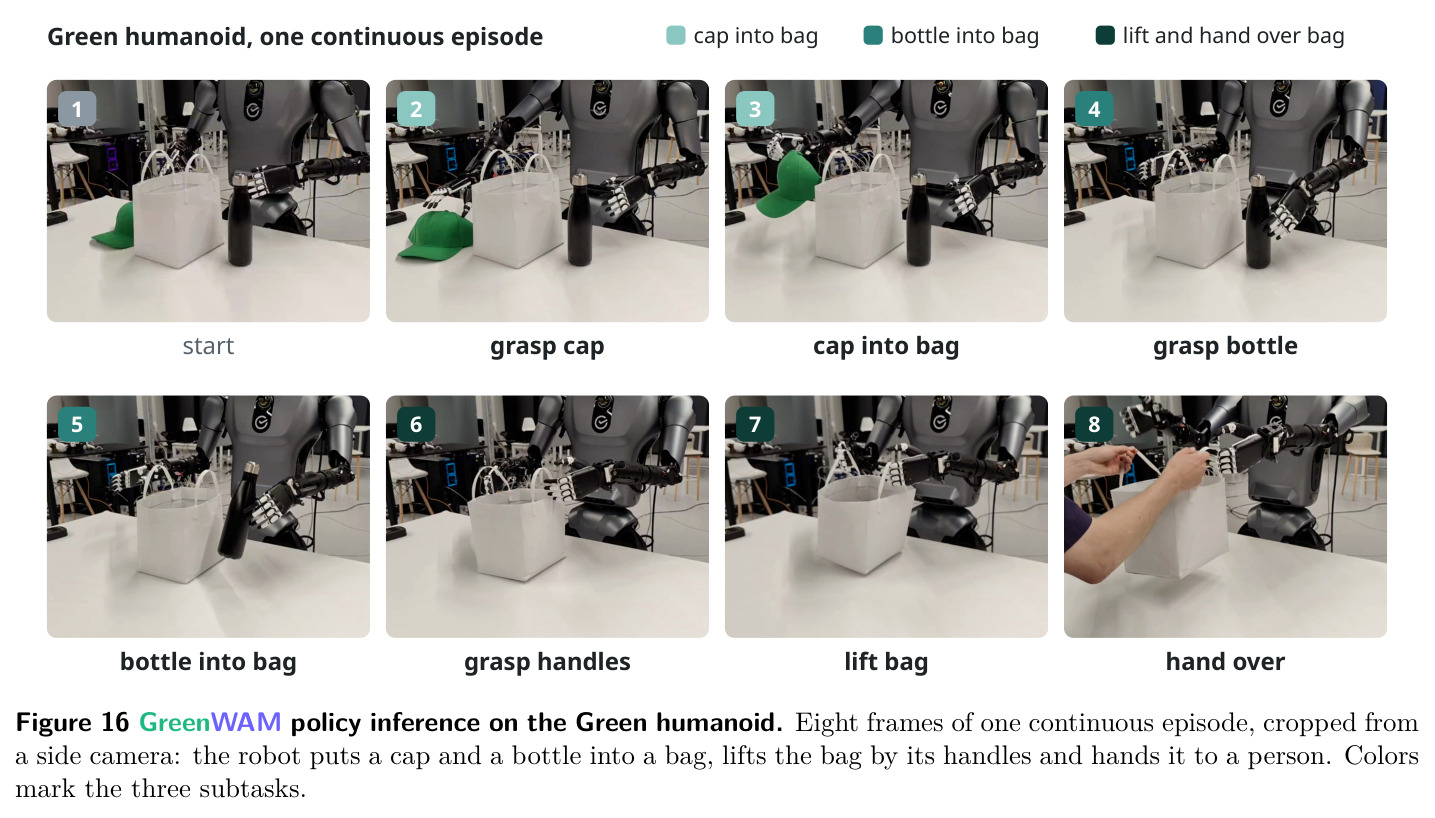
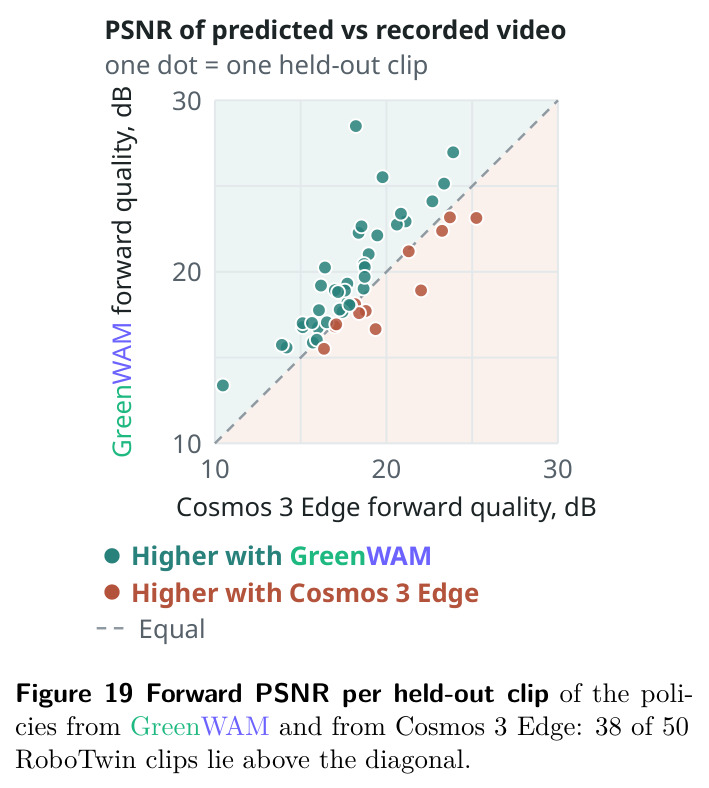
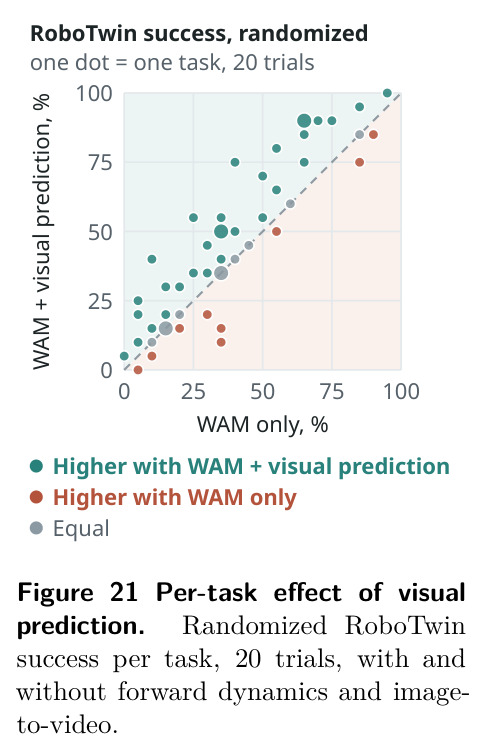
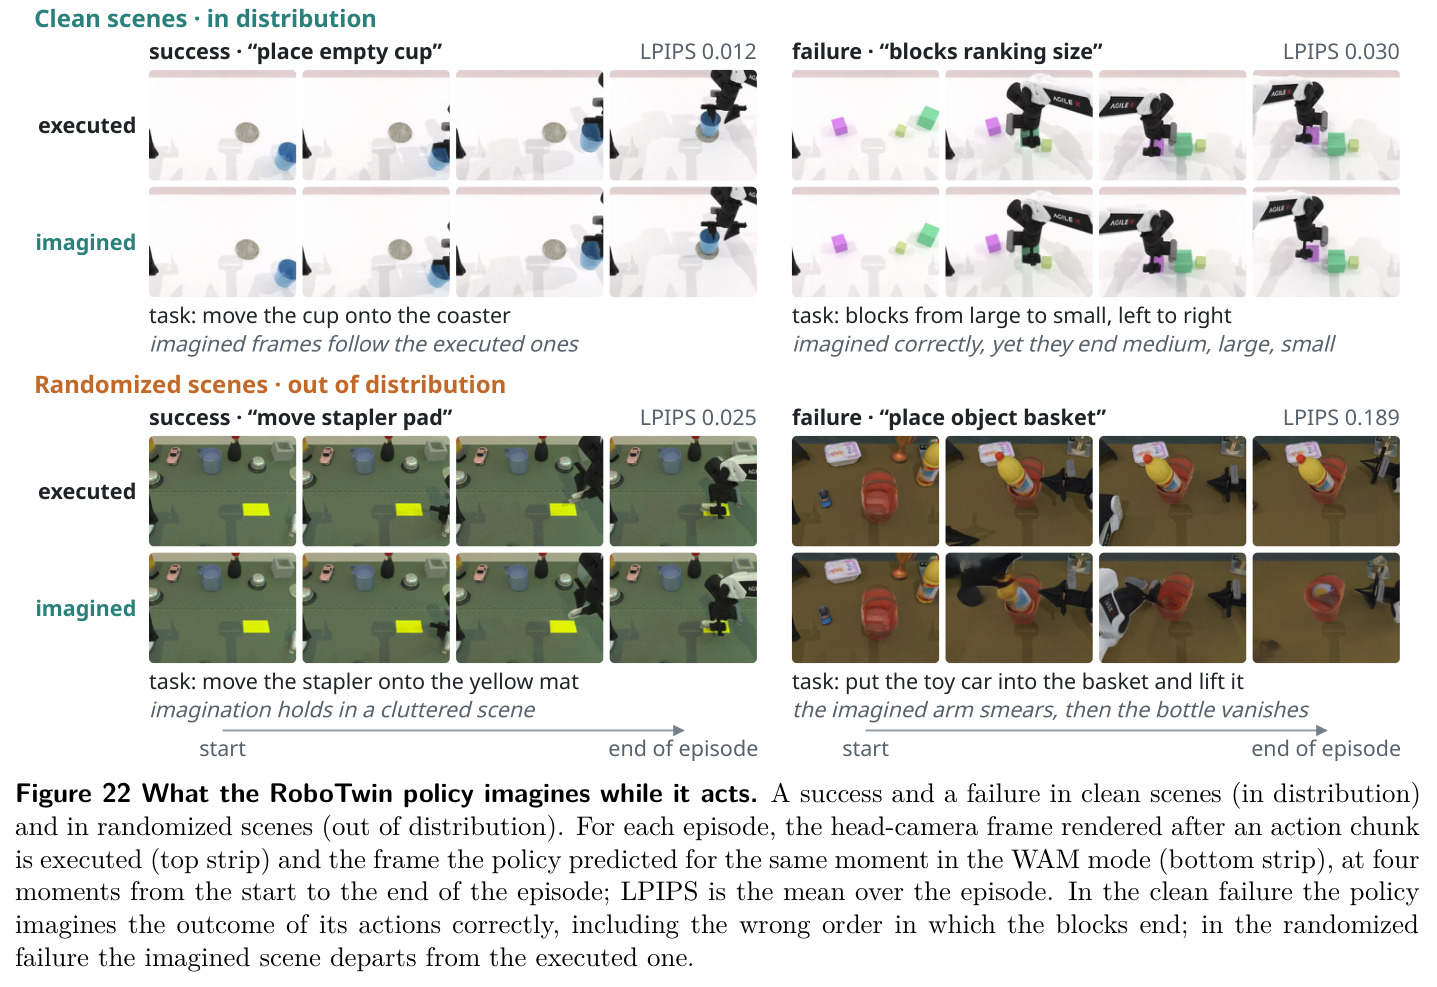
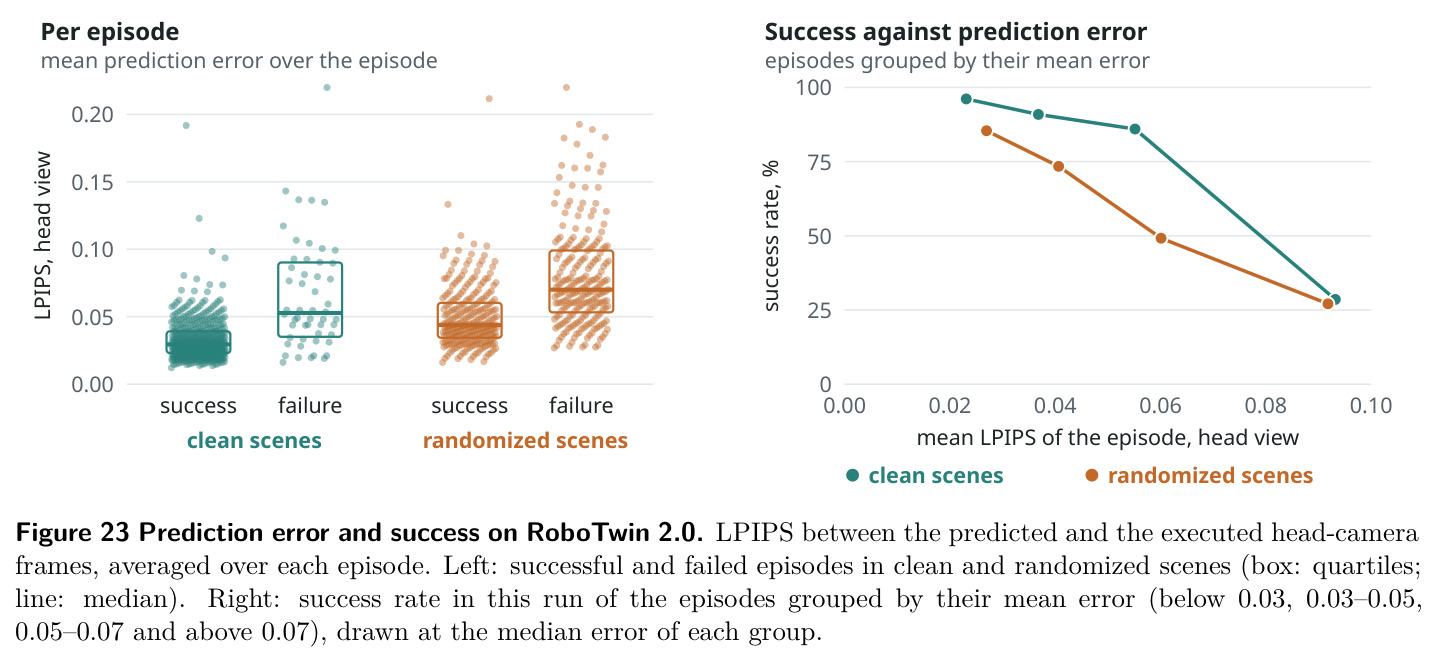
世界模型角色:在 WorldArena 1.0 的 1000 个测试 episode 上,GreenWAM 轨迹精度 56.0、深度精度 98.2、3D 精度 93.4,均为对比的世界-动作模型与视频生成器中最高;JEPA 相似度 98.41 在全部 127 项中列第二(BLM 98.49)。采用对动态指标按真值封顶的 EWMScore 后得 63.31,超过 Motubrain 的 63.16 与 FlowWAM-FiveAges 的 62.99(两者为上限重算);真实视频参考为 67.23,15 项指标中 13 项与真视频差距小于 4。封顶规则确有必要:127 项中 112 项的动态程度超过真实视频、领先者高出 4–8 倍,封顶后领先者掉 6–11 分(如 UNIS 73.64→63.65)而 GreenWAM 只掉 0.05。动作跟随实验中,指令位移缩放为 0 时生成视频的运动量不足实录命令下的五分之一,放大到 1.5 倍时运动量约增加四分之一,证明视频确实服从指令。策略角色:RoboTwin 2.0 榜单协议(50 任务各 100 次)下 clean 86.98%、randomized 48.10%、平均 67.54%,高于 π0.5(58.4)、Fast-WAM(39.9)、X-VLA(44.5)等,仅次于用了随机化预训练的 ME-Dex-1.0(78.8);CALVIN ABC→D 每链 4.64 条指令(FLOWER 4.53);RoboDojo 综合 16.12 分、成功率 10.49%,两项均高于 π0.5、X-VLA、X-WAM;LIBERO 平均 97.4%,LIBERO-plus 零样本 86.8% 为对比最高(Fast-WAM 仅 49.1%)。真机 Green 人形打包任务(70 条指令、9 个 ID 与 5 个 OOD 场景配置)上 ID 95.6%、OOD 84.0%,均高于 Cosmos 3 Edge 策略(88.9/80.0)与 π0.5(84.4/76.0);蒸馏学生 91.1/80.0,延迟 35.4 ms(28.3 Hz),比未优化策略快 12.3 倍。受控消融(固定预算、配对差+层次 bootstrap):从 GreenWAM 而非 Cosmos 3 Edge 出发,世界模型轨迹精度 +3.0(44.4→47.4)、首块 PSNR +1.14 dB(RoboTwin 保留集前向 PSNR +1.26 dB,38/50 片段更准),策略平均成功率 +5.4%(clean +7.9%);适配开始时拆分动作专家再 +3.3%;两者合计 +8.4%(clean +10.8%);适配中保留世界模型模式 randomized +8.0% 而 clean 不变。想象分析:clean 成功 episode 的预测帧比'重复上一帧'基线高 9.6 dB(中位 PSNR);randomized 场景成功率从想象最准组的 85% 跌到最差组的 27%,且按前 100 步衡量想象准确的 episode 成功率翻倍;clean 失败中 19/20 想象正确(错在动作选择),randomized 失败中 13/20 想象偏离现实。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WorldArena 1.0 track 1(动作条件视频预测,1000 episode) | EWMScore(15 项指标、动态指标按真值封顶) | 63.31 | Motubrain 63.16;FlowWAM-FiveAges 62.99 | +0.15 / +0.32,为对比模型最高(真实视频参考 67.23) |
| WorldArena 1.0 保真度 | 轨迹精度 / 深度精度 / 3D 精度 | 56.0 / 98.2 / 93.4 | 对比的世界-动作模型与视频生成器(均低于本文) | 三项均为对比组第一 |
| RoboTwin 2.0(50 任务,榜单协议:每任务 50 条干净演示) | 平均成功率(clean/randomized) | 67.54%(86.98% / 48.10%) | π0.5 58.4%;Fast-WAM 39.9%;X-VLA 44.5% | +9.1(对 π0.5);仅次于使用随机化预训练的 ME-Dex-1.0 78.8 |
| CALVIN ABC→D(1000 条指令链) | 每链平均完成指令数 | 4.64 | FLOWER 4.53 | +0.11 |
| RoboDojo(五维能力加权综合) | 综合分 / 成功率 | 16.12 / 10.49% | π0.5、X-VLA、X-WAM | 两项综合均高于三个对比方法 |
| LIBERO / LIBERO-plus(零样本) | 平均成功率 / 扰动后成功率 | 97.4% / 86.8% | Fast-WAM 97.6% / 49.1% | LIBERO 基本持平(-0.2),LIBERO-plus 大幅领先 +37.7 |
| 真实 Green 人形打包任务(70 条指令) | 指令成功率(ID / OOD) | 95.6% / 84.0% | Cosmos 3 Edge 策略 88.9% / 80.0%;π0.5 84.4% / 76.0% | ID +6.7(对 Cosmos 3 Edge)/ +11.2(对 π0.5);OOD +4.0 / +8.0 |
| 策略推理延迟(RTX 4090) | 每策略调用中位延迟 | 35.4 ms(28.3 Hz,蒸馏后) | 未优化 GreenWAM 策略约 436 ms | ×12.3(对未优化);×3.8(对系统优化后的 134.6 ms 教师) |
局限与改进
作者承认的局限:策略对任务几何变化仍然敏感(RoboTwin 的桌面高度、LIBERO-plus 的机器人初始构型),因为本文的外观增强只改变观测、不产生新的运动演示;自回归长滚动从模型自己生成的帧继续,预测误差逐块累积;每个基准都要经过各自的后训练,尚未做到一次适配处处可用;真机评估只覆盖一个人形机器人与一类打包任务。我的补充观察:其一,RoboTwin 2.0 randomized 48.10% 与使用约 2.5 万条随机化演示做预训练或训练的方法(如 Motubrain 95.95%、LingBot-VA 2.0 93.6%)不可直接比较,在公平数据条件下第一梯队仍明显领先;其二,EWMScore 的动态指标封顶天然有利于运动保守的模型——GreenWAM 仅损失 0.05 而对手损失 6–11 分,评分规则的选择对排名影响巨大,虽然作者援引了 WorldArena 2.0 组织方采纳同一规则的证据;其三,真机每种设置仅 70 条指令、每条一次尝试,置信区间较宽,且成功率依赖超时定义;其四,蒸馏学生只在 RTX 4090 上验证,机载计算机上的实时性仍是未验证的承诺;其五,状态编解码依赖人工建立的 codec 与归一化统计,新本体的接入仍需不小的专家工作。
独立分析的弱点
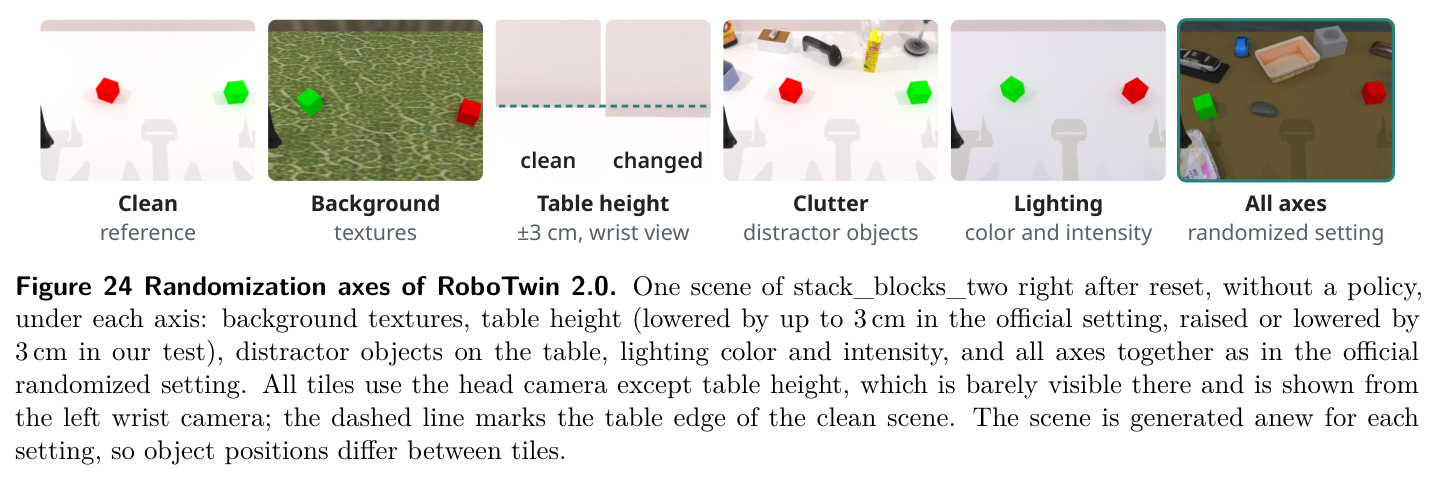
独立分析的弱点与改进方向。第一,几何鲁棒性缺口:单轴测试显示背景纹理使成功率降 12%、桌面高度 ±3cm 降 8%,而干扰物与光照影响不足 1%,说明脆弱点恰恰是现有外观增强覆盖不到的几何变化;可引入运动级增强(轨迹重定向、工作空间几何扰动、以世界模型生成几何变化的合成演示)。第二,长滚动漂移:WorldArena 上超过 20 秒的滚动全部条件于自身生成帧(Figure 10),误差逐块累积;可借鉴 DreamZero 在闭环执行中用真实观测刷新缓存预测,或在训练中对历史锚点加扰。第三,双臂语料偏置:20 个家族全部双臂,单臂 Franka 完全靠后训练适配,移动操作、腿式运动仅靠少量槽位表达;应把单臂与移动平台纳入语料与解剖空间验证。第四,数据管线复杂且级联:字幕、指令推导、质量过滤任何一级的系统性偏差都会进入七种模式的训练信号,'尝试记录'检查虽巧妙但仍可能漏检标签与动作错配的样本;可加入动作-文本对齐的自动审计与置信度加权采样。第五,专家塔使训练步时间增加约 8%、动作侧参数近乎翻倍,对小算力团队不友好;可探索低秩拆分或只拆部分层。第六,保留模式的份额(0.9/0.05/0.05)为手工设定,不同分布偏移程度下最优比例可能不同;可按目标域与预训练分布的距离自适应调整。
未来方向
作者明确提出的下一步:把蒸馏后的单步学生部署到人形机载计算机上(目前只在 RTX 4090 验证过 28.3 Hz);迁移到母模型与机器人学阶段都未见过的本体——'新机器人只需 codec'的设计正是为此准备;引入运动级增强以获得对任务几何变化(桌面高度、初始构型)的鲁棒性;利用世界模型角色在想象的 rollout 中离线评估与筛选策略。基于本文成果还可自然延伸:其一,把'想象准确性决定分布外成功率'的发现变成训练信号,例如对想象误差大的状态加权训练,或把世界模型预测误差作为策略的内在奖励/终止信号;其二,codec 目前靠文档、运动学与实测轨迹人工建立,可训练自动对应模型,从少量随机运动推断新本体的槽位映射与符号零点;其三,七个模式的采样比例可按下游需求自动搜索(当前 3/4 样本给视频类);其四,逆动力学模式可用于从无动作标注的人类视频自举新技能数据,进一步扩大语料;其五,把 WorldArena 上验证的动作跟随能力与真实机器人闭环结合,探索'先想象后执行'的模型预测控制框架。
复现评估
复现友好度中偏高。有利条件:作者承诺发布 RoboTwin 2.0、LIBERO、CALVIN 三个策略权重与 WorldArena 世界模型权重及全部评估代码,母体 Cosmos 3 Edge 4B 是公开检查点,四个模拟基准与 WorldArena 均为公开基准,协议(采样步数、引导尺度、重规划间隔)在 B.5 与附录中写得非常细,评估复现门槛低;消融采用配对差与层次 bootstrap 的统计规范也值得效仿。困难之处:完整预训练需要 64 张 H100、36500 步(934 万采样样本),且语料混合了公开数据与内部 Green 人形数据,第三方无法拼出同分布数据;数据管线依赖 Qwen3.8-27B 字幕、命令推导与多级质量过滤,工程量大且部分细节(如各来源的准入规则)散在附录。真机部分需要 Green 人形硬件,无法直接复现,但协议透明(70 条指令、9 个 ID 与 5 个 OOD 场景、每条一次尝试、超时判定)。综合判断:复现评估与下游适配(约 3000 步量级、单节点 8 卡可行)容易,完整复现预训练难;对多数研究者而言,加载权重+按论文配方适配到自己的机器人是最现实的路径。
论文图表
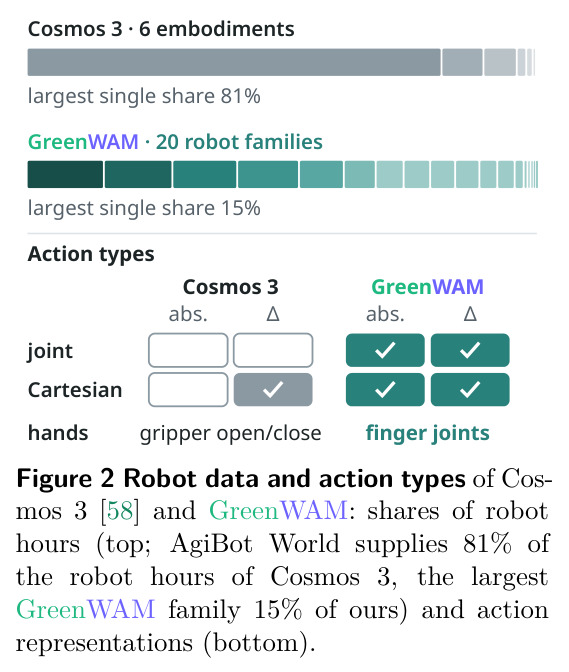
对比母模型与本文的数据与动作表示:Cosmos 3 仅 6 种本体、81% 机器人时数来自单一数据集(AgiBot World)、动作只有末端位姿增量加夹爪开合;GreenWAM 覆盖 20 个家族、最大单一来源仅占 15%、动作类型扩展为关节/笛卡尔、绝对/相对、以及灵巧手指关节。
用数据构成和动作类型的悬殊差异说明为什么要以 20 个家族重训、为什么要新动作空间,是动机部分最直观的证据。