重新思考多模态大语言模型中的投影器训练 Rethinking Projector Training in Multimodal LLMs
投影器对齐只是粗对齐:免训练最优传输闭式解 PORTAL 即可匹敌 558k 配对训练
前置知识
两阶段训练与投影器(Projector)
LLaVA 式多模态 LLM 的标准训练流程分两阶段:Stage-I 冻结视觉编码器和 LLM,仅训练一个小投影器(默认两层 MLP 加 GELU),用约 558k 图像-标题对把视觉 patch token 映射到 LLM 的输入嵌入空间;Stage-II 再用指令数据联合微调整个模型。投影器是两个冻结大模型之间唯一可训练的桥梁。
本文的全部问题就是 Stage-I 投影器训练到底在做什么、能不能不训练。理解这条流水线是读懂动机和实验设置(LCS-558k 对齐、LLaVA-665k 指令微调)的前提。
最优传输与 Bures-Wasserstein 映射
最优传输(Optimal Transport)研究把一个概率分布以最小代价变换成另一个分布的映射。当两个分布都近似为高斯时,OT 映射有闭式解:一个由均值和协方差构成的仿射变换,称为 Bures-Wasserstein 映射,等价于先白化源分布、再旋转到目标主轴、按目标方差重缩放、最后平移到目标均值。
PORTAL 的投影器权重正是这个闭式映射,是方法核心公式 $W_1 = V_t\,\mathrm{diag}(\sigma_t/\sigma_s)\,V_s^\top$ 的数学来源。
PCA 主子空间与有效维度
主成分分析(PCA)找出数据方差最大的若干正交方向,取前 $k$ 个构成 top-$k$ 子空间,对应特征值的平方根 $\sigma$ 刻画数据沿各主轴的散布。有效维度 $d_{\mathrm{eff}}(\Sigma)=(\mathrm{tr}\,\Sigma)^2/\mathrm{tr}(\Sigma^2)$ 衡量方差分布在多少个方向上:均匀铺开时等于 $d$,集中在一个方向时等于 1。
PORTAL 只在两侧 top-$k$(默认 $k=512$)PCA 子空间上对齐,秩 $k$ 消融(64 到 1024)和 $d_{\mathrm{eff}}$ 出现在理论命题中,不懂 PCA 就无法理解构造与消融。
RMSNorm 与余弦散度 ω
现代 LLM 在注意力前对每个 token 做 RMSNorm(或对 Q/K 归一化),缩放不改变 attention logits,因此注意力只依赖 token 方向。余弦散度 $\omega$ 定义为随机两个 token 余弦相似度的标准差,衡量方向散布;Proposition 1 证明当 token 范数集中($\kappa$ 小)时 $\omega^2 \approx 1/d_{\mathrm{eff}}(\Sigma)$,由协方差谱决定。
这是论文解释'为什么只匹配均值和协方差就够了、高斯假设不成立也依然有效'的关键论证,是读懂 4.2 节的门槛。
Cambrian-1 基准分类
本文把 16 个评测基准按 Cambrian-1 分类法分成四类:Knowledge(AI2D、SciQA、MathV、MMMU)、General(GQA、MME、SEED-Bench、MMBench)、OCR(TextVQA、OCRBench、DocVQA、ChartQA)、Vision-Centric(CV-Bench 2D/3D、BLINK、RealWorldQA),报告未加权平均分。
主表 Table 1 与所有类别级分析都按这四类展开,'缺口集中在 OCR/Chart'这一关键结论完全依赖该分类体系。
研究动机
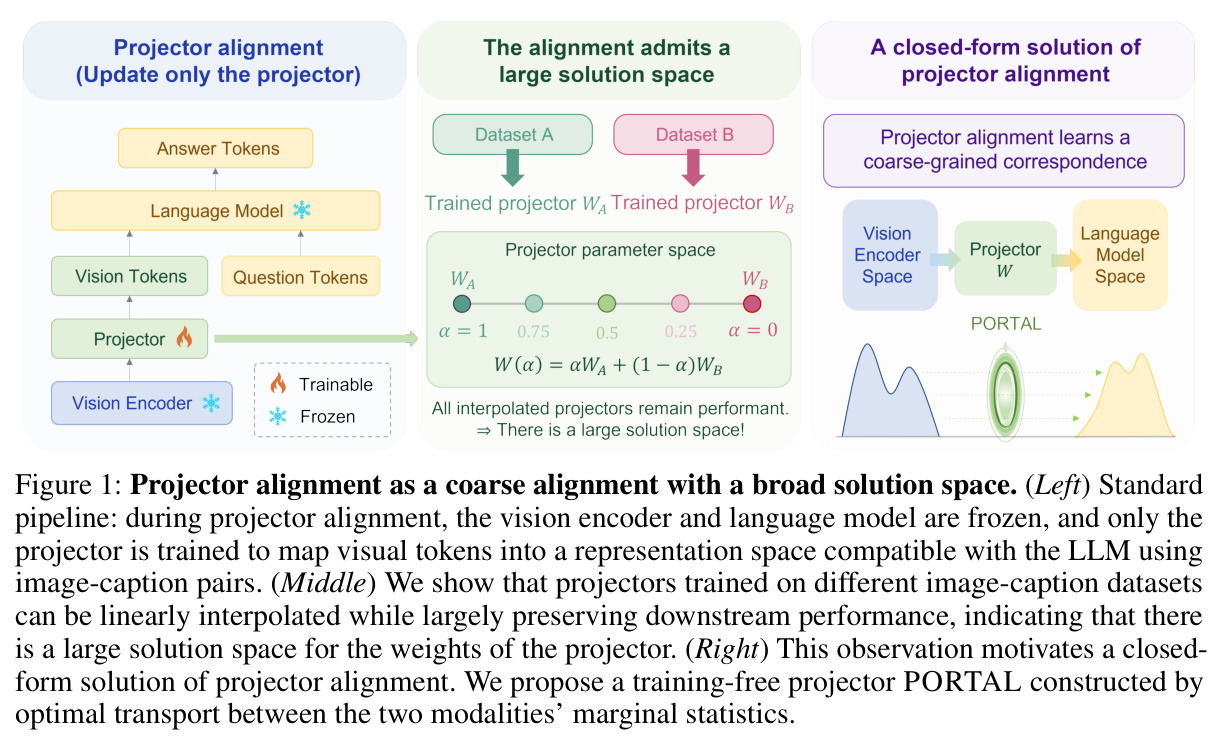
多模态 LLM 的标准流水线分两阶段:先用约 558k 图像-标题对(如 LCS-558k)训练投影器,把冻结视觉编码器的特征对齐到冻结 LLM 的输入空间,再用 LLaVA-665k 指令数据联合微调。这个第一阶段既耗时又依赖大规模配对数据,而它的作用却一直说不清:Prismatic 报告跳过投影器对齐性能甚至可能不降,Cambrian-1 却发现把对齐数据扩到 250 万对有帮助,MM1 认为分辨率和数据配比比投影器结构更重要。三个结论互相矛盾,根源在于没人真正回答'投影器对齐到底学到了什么'。如果这个阶段本质上只在做粗粒度对齐,那么花在 558k 配对样本上的训练算力和数据标注成本很可能大部分是浪费的,这正是本文要量化的问题。
本文的目标是本文的目标分两步:先从实证上回答投影器对齐的真实功能,再据此消除这一阶段。具体包括:(1) 用数据量缩放实验判断投影器学到的是精细的视觉-语言对应还是粗粒度的空间放置——若 10-20% 数据就饱和,则说明是后者;(2) 用跨数据集训练投影器的线性插值实验判断解空间是窄还是宽——若整条插值路径都保持性能,则说明大量不同权重都能胜任同一功能;(3) 若结论支持'粗对齐、宽解空间',就构造一个完全不需要配对图像-标题数据、不需要梯度优化的免训练投影器,使其在完全相同的 Stage-II 指令微调下匹配 558k 配对训练基线,并在有少量配对预算时作为更好的初始化大幅降低对齐成本。
与已有工作不同的是,以往工作把 Stage-I 当作需要更多数据或更好结构的黑盒:Cambrian-1 选择扩大数据规模,Prismatic 选择直接跳过,MM1 转向研究分辨率与数据混合。本文的独特之处在于先诊断、后开药方:用'数据饱和'与'跨数据集线性插值'两个受控实验,把矛盾的先前结论统一解释为同一现象——Stage-I 是把视觉特征条件化到 LLM 输入分布兼容区域的几何操作,而非精细语义学习。在这个视角下,跳过能行(Prismatic)、加数据边际收益递减(Cambrian-1)、分辨率和数据配比影响更大(MM1)都顺理成章。在此基础上,本文首次把高斯最优传输的闭式映射直接用作投影器权重,而非像 CORAL 那样仅作为域适应的统计对齐手段,实现了从'解释现象'到'给出可替代方案'的完整闭环。
核心方法
直觉上,如果投影器只需要把视觉特征'搬'进 LLM 能处理的输入分布区域,那这个搬运可以由两个分布的统计量直接算出,无需学习。PORTAL 把视觉 patch 特征分布近似为高斯 $N(\mu_s,\Sigma_s)$,把 LLM 输入嵌入分布近似为高斯 $N(\mu_t,\Sigma_t)$,在各自的 top-$k$(默认 $k=512$)PCA 主子空间上构造 Bures-Wasserstein 最优传输的闭式仿射映射,作为 LLaVA 式两层 MLP 投影器 $f(x)=W_2\,\phi(W_1x+b_1)+b_2$ 的第一层参数,其中 $W_2=I$、$b_2=0$、$\phi$ 为 GELU。构造只需要两侧各自的均值、主方向和沿主轴的散布(即 PCA 特征向量和特征值),全程无配对数据、无梯度下降。理论上作者还解释了为什么只匹配一阶和二阶矩就够:LLM 在注意力前做 RMSNorm,attention 只依赖 token 方向,而当 token 范数集中时方向散布由协方差唯一决定。随后照常进行 LLaVA-665k 指令微调。
核心公式为 $W_1 = V_t\,\mathrm{diag}(\sigma_t/\sigma_s)\,V_s^{\top}$,$b_1=\mu_t - W_1\mu_s$,其中 $V_s,V_t$ 是视觉与语言特征的 top-$k$ PCA 基,$\sigma_s,\sigma_t$ 是协方差特征值平方根。该映射先把源分布白化、再换到目标主轴、按目标散布重缩放并平移。与已有方法的本质区别有两点。其一是理论解释:Proposition 1 证明 $\mathrm{Var}(\cos\angle(z,z')-1/d_{\mathrm{eff}})\le 2\kappa+\kappa^2+\kappa^4$($\kappa$ 为 token 范数相对标准差),故匹配二阶矩即可继承目标分布的方向几何,解释了高斯近似在非高斯特征上依然有效——实测 PORTAL 把余弦散度从源侧 0.23 降到 0.09-0.10,逼近目标的 0.05-0.06。其二是用法:CORAL、Gromov-Wasserstein 等只把分布对齐当域适应损失或正则项,PORTAL 直接把闭式映射当投影器权重。
方法步骤详情
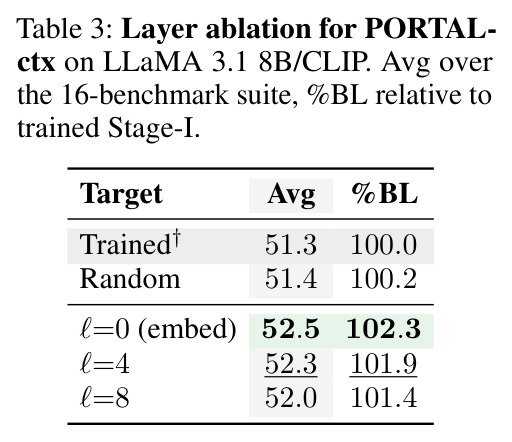
第一步,估计视觉侧统计:取约 1024 张无标注图像(1024 张 COCO val2017 已足够,平均分 44.0 优于 4096 张 9 源混合池的 43.4),过冻结视觉编码器得 patch token,计算均值 $\mu_s$、top-512 PCA 基 $V_s$ 与特征值平方根 $\sigma_s$。第二步,估计语言侧统计:默认以 LLM 输入嵌入表为目标($\ell=0$),也可用 PORTAL-ctx$^\ell$ 变体改用第 $\ell$ 块后的 hidden states,同样算出 $\mu_t,V_t,\sigma_t$;文本侧只需一份英文词组列表过一遍 LLM。第三步,代入闭式公式构造 $W_1$ 与 $b_1$,令 $W_2=I$、$b_2=0$,装配成标准两层 MLP 投影器,零训练、零配对数据。第四步,接入 LLaVA 流水线,与其他配置完全相同地做 LLaVA-665k 指令微调后评测 16 个基准;或作为 warm start,继续用小规模配对数据(扫描 0/1k/10k/100k/558k)做 Stage-I,度量对齐预算与性能的权衡。
技术新颖性
新颖性分三层。诊断层面:首次用受控实验证明 Stage-I 数据 10-20% 即饱和(30-40% 全类别进入平台,ShareGPT-1.2M 峰值也仅 38.1)、不同数据集训练的投影器可线性插值且混合更优($\alpha=0.5$ 时 49.0 分高于两端点 48.0/48.8),同时发现跨随机种子不可插值(CIDEr 从约 80 跌到 0.7),把'初始化选定损失盆地、数据在盆地内选解'刻画清楚,统一解释了 Prismatic、Cambrian-1、MM1 的矛盾结论。方法层面:PORTAL 是首个零配对数据、零梯度、纯闭式的多模态投影器构造,区别于 VPGTrans(迁移已学投影器)、LangBridge(词表瓶颈)、SEMI(超网络)、Tip-Adapter(缓存式适配器),只依赖每模态各自的摘要统计。理论层面:Proposition 1 的谱到余弦散度界不假设高斯性,为'二阶矩匹配为何足够'给出可证明解释。
实验结果
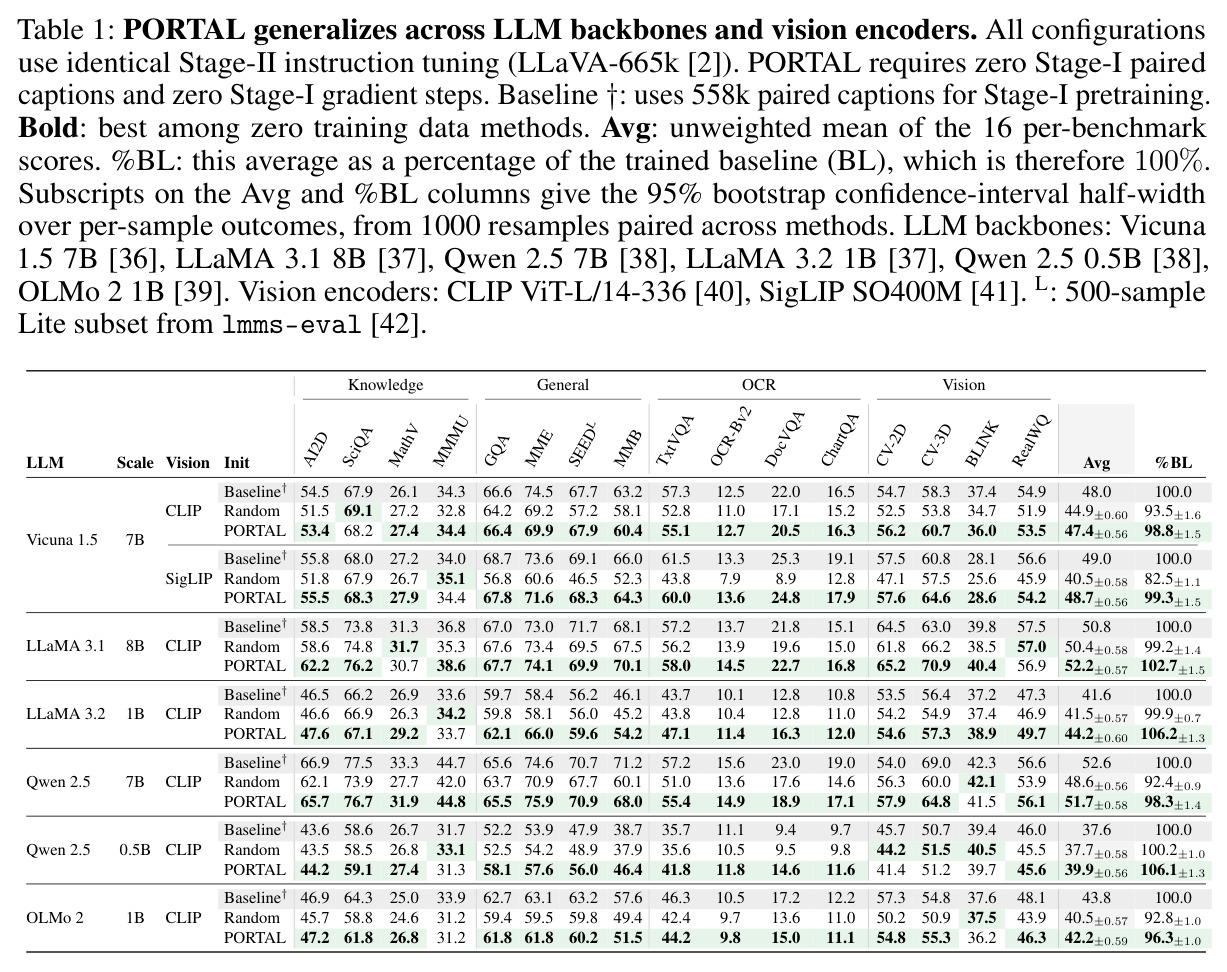
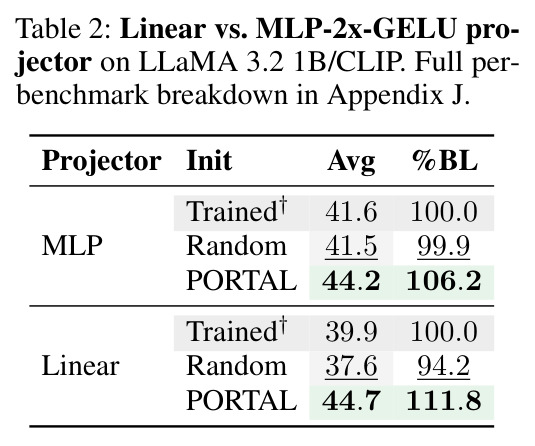
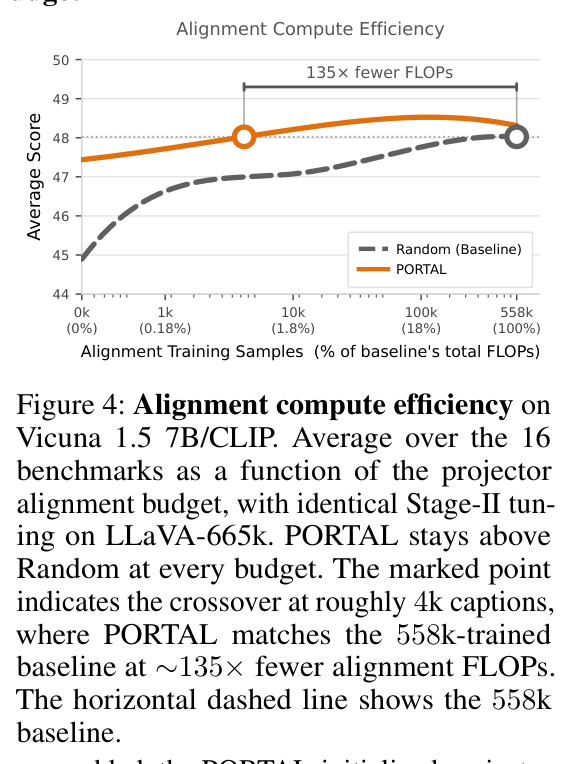
主实验覆盖 7 组模型配置(0.5B-8B)与 16 个基准。免训练 PORTAL 平均达 558k 配对基线的 96.3%-106.2%:LLaMA 3.1 8B/CLIP 102.7%、LLaMA 3.2 1B/CLIP 106.2%、Qwen 2.5 0.5B/CLIP 106.1%;Vicuna 7B 在 CLIP/SigLIP 为 98.8%/99.3%,Qwen 7B 与 OLMo 1B 为 98.3%/96.3%。Random 在 SigLIP 崩至 82.5%,PORTAL 拉回 99.3%,印证对齐即分布匹配。效率上:PORTAL 加 4k captions 即达 558k 基线,省 135 倍对齐 FLOPs。消融:线性投影器下 PORTAL 111.8% 对 Random 94.2%;C-Abstractor 持平(42.93 对 42.98);$k=512$ 最优;目标层 $\ell=0$ 最好。Knowledge/General/OCR/Vision 四类平均保留 100.7%/102.0%/102.4%/100.4%;POPE、3.2M 微调下持平或更好。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 16 基准平均(LLaMA 3.1 8B / CLIP) | 16 基准未加权平均分(%BL 相对训练基线) | PORTAL 52.2(102.7%) | 558k 配对训练投影器 50.8(100%);Random 50.4(99.2%) | 超过训练基线 2.7%,超过 Random 1.8 分 |
| 16 基准平均(LLaMA 3.2 1B / CLIP) | 16 基准未加权平均分 | PORTAL 44.2(106.2%) | 训练基线 41.6;Random 41.5(99.9%) | 超过训练基线 6.2%,全表最佳相对增益 |
| 16 基准平均(Vicuna 1.5 7B / SigLIP) | 16 基准未加权平均分 | PORTAL 48.7(99.3%) | 训练基线 49.0;Random 40.5(82.5%) | 几乎完全恢复基线,比 Random 高 8.2 分,最能体现分布匹配价值 |
| 对齐计算效率(Vicuna 1.5 7B / CLIP) | 达到 558k 训练基线所需的 Stage-I 配对样本与 FLOPs | 约 4k captions(0.18% 数据) | 标准流水线 558k captions(100% FLOPs) | 对齐 FLOPs 节省约 135 倍;10k 以上反超基线 |
| 16 基准平均(OLMo 2 1B / CLIP) | 16 基准未加权平均分 | PORTAL 42.2(96.3%) | 训练基线 43.8;Random 40.5(92.8%) | 低于基线 3.7%,差距集中在 OCR/Chart 类,是 PORTAL 最弱的设置之一 |
| 线性投影器消融(LLaMA 3.2 1B / CLIP) | 16 基准平均分与 %BL | PORTAL 44.7(111.8%) | 训练基线 39.9;Random 37.6(94.2%) | Random 到 PORTAL 差距从 MLP 下的 6.3 扩大到 17.6 个百分点 |
局限与改进
局限有四。其一,缺口集中在 OCR/图表类基准:Qwen 2.5 7B(98.3%)与 OLMo 2 1B(96.3%)低于基线的 bootstrap 置信区间,差距主要落在 OCR 与 Chart,说明字符级空间结构这类细粒度监督是配对 caption 的独有信息,边缘统计无法覆盖——这与 3.1 节'OCR/Chart 是 Stage-I 增益主要来源'互相印证;不过类别级平均 OCR 仍达 102.4%,并非系统性失败。其二,范围限定在冻结 backbone、单图输入、简单投影器(两层 MLP、线性、C-Abstractor),更丰富的 connector、多图、长上下文、音视频均未验证。其三,高斯近似在尾部和边缘形状上偏离真实分布(附录 H.1),Proposition 1 的界在 $\kappa$ 大时不紧,且 attention 还依赖学到的 Q/K 投影,$\omega$ 不刻画这部分。其四,跨随机种子不可插值(CIDEr 跌至 0.7)反衬初始化仍决定损失盆地,PORTAL 的固定构造不能保证在所有架构与规模下都落在好盆地内。
独立分析的弱点
弱点一,OCR/图表场景不足:DocVQA、ChartQA 需要字符级空间推理,PORTAL 在 Qwen 2.5 7B(98.3%)和 OLMo 2 1B(96.3%)上低于基线置信区间。改进方向:估计视觉统计时对含文字图像(渲染文本、图表)过采样,或基于 PORTAL 用 1k-10k 条 OCR 配对数据精修——135 倍节省曲线暗示这个量级即可补齐。弱点二,秩 $k$ 与目标层是手动超参数:$k=1024$ 时噪声特征向量稀释映射,隐含对 PCA 谱衰减形态的假设;改进方向是用 shrinkage 协方差估计或按参与率自动定秩。弱点三,语义对齐完全外包给 Stage-II:论文只测了 665k 与 3.2M 两档指令微调,若下游数据很小(垂直领域适配),PORTAL 与训练基线的差距可能被放大,低资源 Stage-II 未覆盖。弱点四,规模上限未探:LLaMA 3.1 8B 上 Random 已达 99.2%,说明模型越大基线的 Stage-I 增益本身越小,'PORTAL 匹配基线'在 30B+ 模型上是否仍有区分度需要复检。
未来方向
作者提出的方向:把粗对齐视角推广到更丰富的 connector 架构、长上下文 grounding、多图推理,以及音频、视频、3D 等其他模态,检验'粗对齐'论断的适用边界。基于本文成果可延伸的工作包括:一是把 PORTAL 变成即插即用的动态模态接入组件——新视觉编码器或新 LLM 发布时即时构造投影器,彻底免去重复 Stage-I,这对多编码器路由类系统(如 Cambrian-1 的混合视觉)特别有价值;二是与参数高效微调结合,研究 PORTAL 初始化在 LoRA、量化、蒸馏管线中的表现;三是把跨 seed 不可插值与损失盆地结构联系起来,搞清初始化如何决定盆地,可能催生比 PORTAL 更好的低成本有训练初始化;四是在 Gromov-Wasserstein 等不要求两侧坐标系一一对应的 OT 变体上系统化(附录 E.1 已初步证明 GW 也能恢复大部分性能),处理视觉与语言主轴不对齐的情形;五是理论上把 Proposition 1 从余弦散度推进到 attention logits 层面,给出对 Q/K 投影影响的更紧刻画,并解释 $k=1024$ 处性能回落的谱噪声机制。
复现评估
复现难度较低,但完整评测开销不小。方法核心是附录 F 给出的自包含 PyTorch 实现:两侧各做一次 PCA、代入闭式公式即可,视觉侧统计只需 1024 张无标注 COCO 图像(无配对 caption),PCA 与矩阵构造在单卡上代价可忽略,这一步任何实验室都能在数小时内完成。真正的算力大头在第二阶段:每组配置需完整跑一遍 LLaVA-665k 指令微调(7 组主配置加消融共十几组),再加 16 个基准的 lmms-eval 评测与 1000 次 paired bootstrap 置信区间估计,属于实验室级多卡 GPU 需求。所依赖数据全部公开(LCS-558k、LLaVA-665k、COCO val2017、Cambrian-737k、MobileLLaMA 等模型权重均可获取)。正文未给出官方代码仓库链接,但方法约百行代码、超参数给全($k=512$、目标层 $\ell=0$、两层 MLP、GELU、$W_2=I$),熟悉 LLaVA 生态的工程师预计数天内可复现单配置结果,属高可复现工作。
论文图表
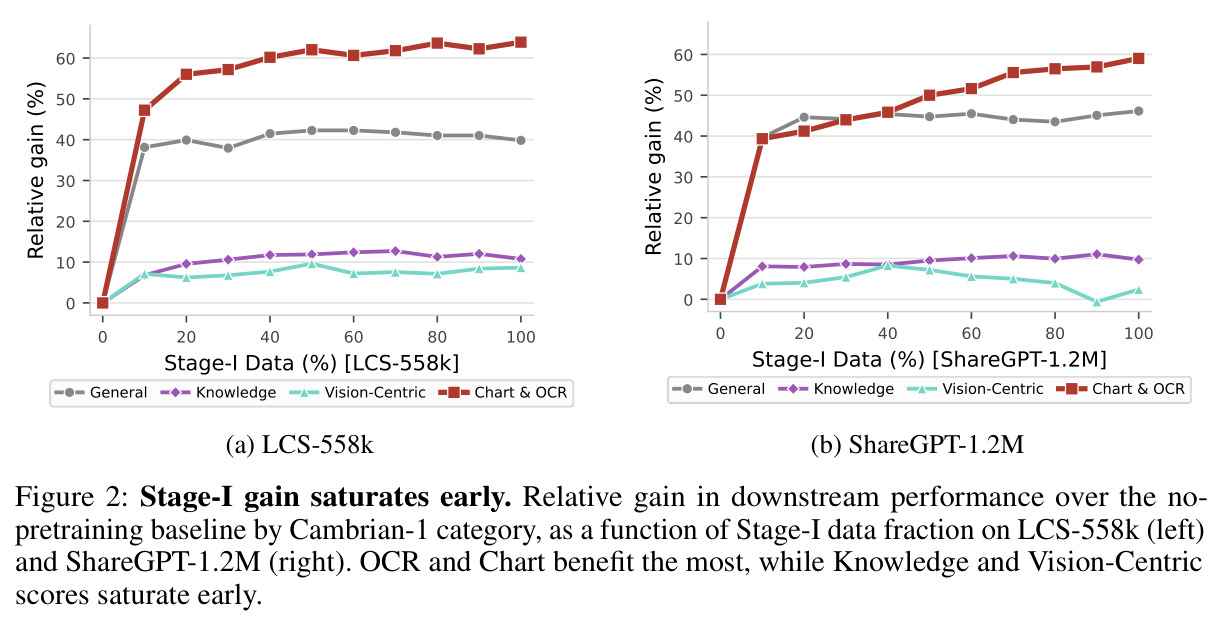
两幅折线图,分别以 LCS-558k(左)与 ShareGPT-1.2M(右)的 Stage-I 数据比例(0 到 100%)为横轴,按 Cambrian-1 四类基准画出相对无预训练基线的增益。10-20% 数据即恢复大部分下游增益,所有类别在 30-40% 处进入平台;OCR 与 Chart 类受益最大,Knowledge 与 Vision-Centric 早早饱和;ShareGPT-1.2M 数据量翻倍平均分峰值也仅 38.1(40% 数据处)。
支持'投影器对齐是粗对齐'的第一个核心证据:若投影器在学习精细的视觉-语言对应,性能不应在小比例数据上饱和。这是引出'免配对训练'动机的关键图。
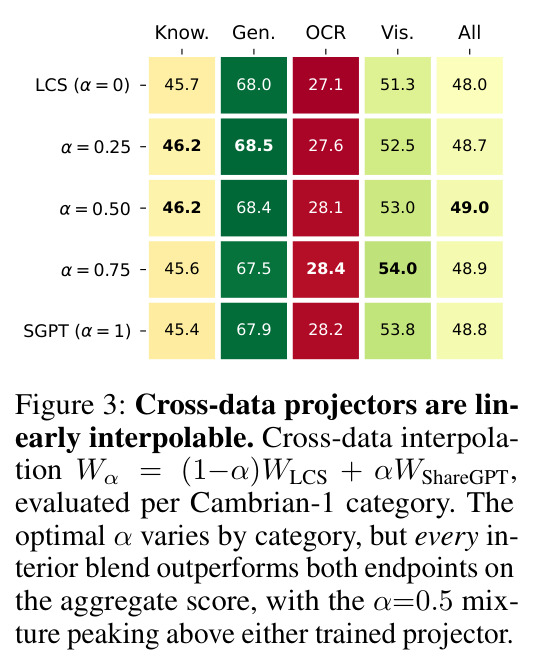
表格给出跨数据集线性插值 $W_\alpha=(1-\alpha)W_{\mathrm{LCS}}+\alpha W_{\mathrm{ShareGPT}}$ 在 $\alpha\in\{0,0.25,0.5,0.75,1\}$ 的各类别得分:聚合平均从两端点的 48.0(LCS)与 48.8(ShareGPT)升至 $\alpha=0.5$ 的 49.0,每个内部插值点都优于两个端点;类别最优 $\alpha$ 不同——OCR 峰值偏向 ShareGPT 端、Knowledge 偏向 LCS 端。
第二个核心证据:解空间宽到可以线性穿越,且不经任何额外 Stage-II 优化的简单混合就超过两个独立训练的投影器,直接否定了'投影器学到唯一精确映射'的假设。