LensErase:万物擦除基础模型 LensErase: A Foundation Model for Erase Anything
以1.01亿对配对数据和掩码感知RoPE,把文生图先验改造成通用图像擦除基础模型
前置知识
Flow Matching(流匹配)
连续归一化流的一种训练范式:在数据与高斯噪声之间定义线性插值路径 $z_t=(1-t)z^\star+t\epsilon$,训练网络预测目标速度 $v^\star=\epsilon-z^\star$,推理时沿 ODE 积分生成样本。相比 DDPM 目标路径更直、采样步数更少。本文进一步对掩码区域 token 加权,得到区域加权流匹配目标。
LensErase 的预训练与 SFT 损失就是式(3)的区域加权流匹配,理解速度场与 $z_t$ 的构造才能看懂整个训练目标和 $\omega_i=1+(\lambda-1)\tilde{M}_i$ 加权的含义。
RoPE(旋转位置编码)
通过对 attention 的 query/key 施加与位置相关的旋转变换来注入位置信息,使注意力内积只依赖相对位置,外推性好。原始 RoPE 用于 1D 序列,图像模型常扩展为 2D(行、列两个频率组)。本文将其扩展为 3D:新增一个「模态」维来携带掩码信息。
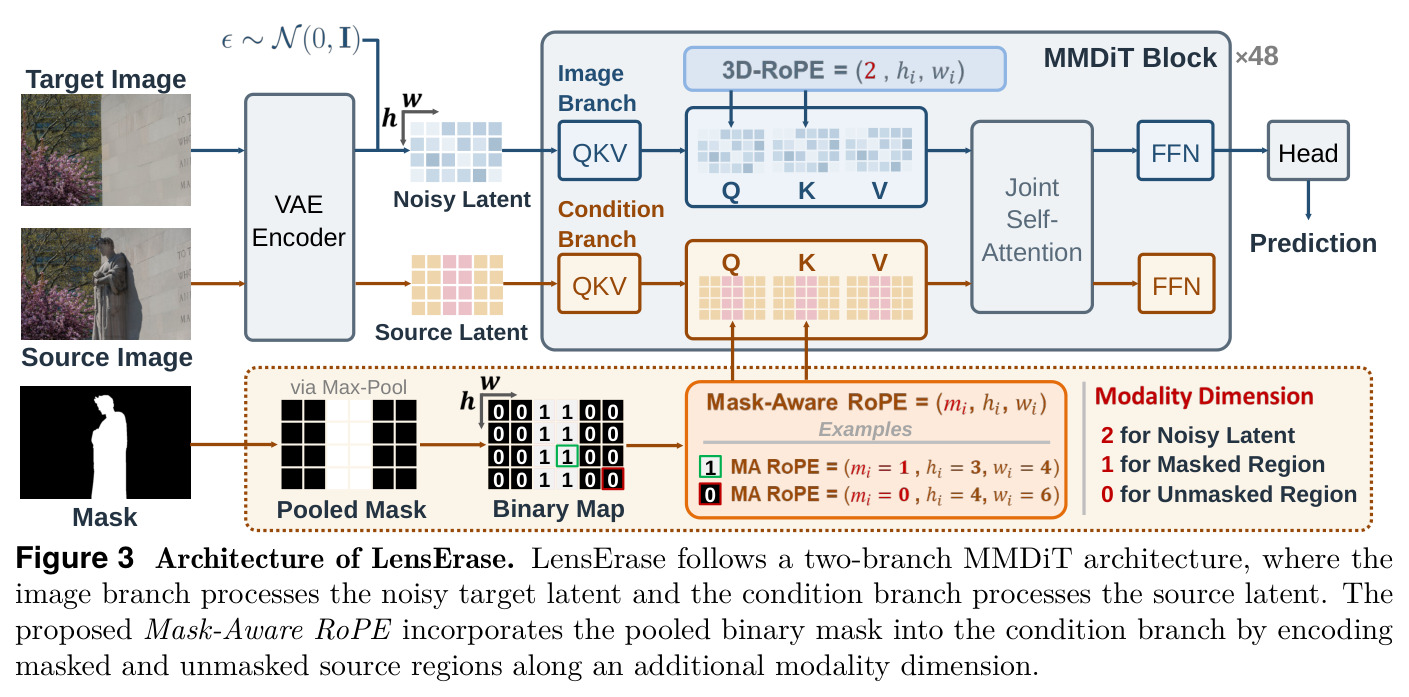
Mask-Aware RoPE 是本文最核心的架构创新,把掩码编码为 $p^{cond}_i=(m_i,h_i,w_i)$ 的第一维。不熟悉 RoPE 就无法理解掩码为何能「零开销」注入。
MMDiT(多模态扩散 Transformer)
Stable Diffusion 3 与 Lens 采用的双流骨干:图像流与条件流各有独立的 QKV/FFN 权重,但在每层自注意力中把两条流的 token 拼接做联合注意力,实现模态间信息交换。LensErase 的骨干为 48 层 MMDiT,且两个分支都从 Lens 的预训练 image 分支初始化(因为擦除任务的条件也是视觉的)。
看懂 Figure 3 的双分支结构(image branch 处理噪声潜变量、condition branch 处理源图潜变量)以及「为何不保留文本条件分支」都必须先理解 MMDiT。
VAE 与潜空间扩散
变分自编码器先把图像压缩到 8 倍下采样的潜空间($z=E(I)$),生成模型在潜空间训练与采样以节省算力,最后由解码器还原。代价是重建会引入轻微形变、色偏等伪影,即使 token 完全不变也可能有像素级差异。
VAE 重建偏差正是 TraceFusion 要补偿的对象:非编辑区的像素残差主要来自 VAE 而非模型改图,理解这点才能理解残差阈值(>4、>10)与「重建偏置补偿」的设计动机。
扩散模型的强化学习(DiffusionNFT)
把扩散/流模型当作策略:对同一条件采样多个随机 rollout,用(可来自 VLM 打分的)奖励信号直接优化策略似然,不需要配对目标图也不需要可微奖励,且免 KL 正则、训练稳定。本文在 SFT 模型上用它提升「擦干净且不伤邻域」的样本概率。
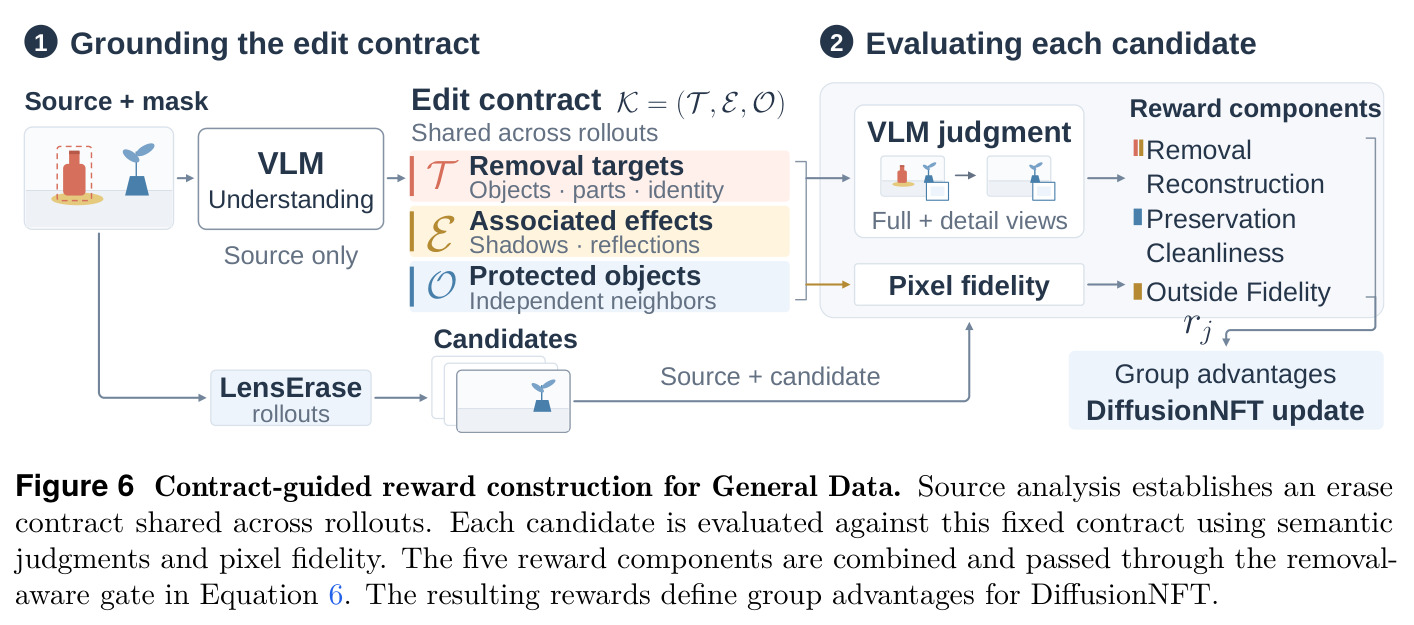
LensErase 第三阶段就是 DiffusionNFT:1.9 万个任务、契约式奖励、五分量加权加门控,全部建立在该框架上;Table 3 中 RL 使 HiFi Removal 从 70.80% 跳到 81.60% 即其效果。
VLM-as-Judge(大模型当裁判)
用大型视觉语言模型按文本评分细则给生成结果打分(本文为 0–4 整数分),适合「输出不唯一」的编辑类任务免参考评估;但存在自我偏好、prompt 敏感等已知偏差。LensErase-Bench 用 GPT-5.6 Sol 按移除/修复/保持/洁净四维评分,Overall 按 40%/20%/20%/20% 加权。
Table 2、Table 3 中 LensErase-Bench 的全部数字(Overall 95.22、HiFi Removal 82.80% 等)都由 VLM 判定,理解评测协议才能正确解读结果并识别潜在的裁判偏置。
研究动机
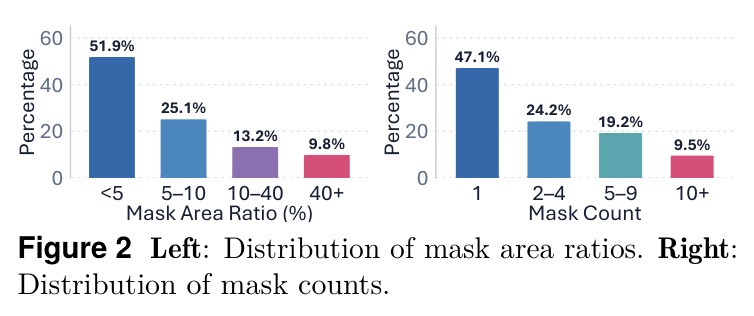
现有物体移除方法是「碎片化」的:通用物体擦除、文字擦除、水印去除各有专门模型(本文对比的 OSOR、ObjectClear、OmniPaint 等 12 个公开方法即是证据),而且训练集通常只有约 10 万到 100 万对样本,比本文的 1.01 亿对小两到三个数量级。小数据带来三个具体问题:其一,掩码面积分布严重失衡,大掩码(目标占画面 40% 以上)欠采样,模型面对「删除占半个画面的大物体」时缺乏监督;其二,用户框选目标后与之耦合的阴影、倒影往往落在掩码之外,现有模型容易留下「幽灵残影」;其三,半透明水印需要从混合像素中反解底层内容、视觉文字需要不伤笔画的精细重建,与普通物体填充的难度结构完全不同。此外扩散模型随机采样导致同一输入多次输出质量波动大——有的干净移除、有的残留碎片或改动无关背景,可靠性不足以支撑自动化生产管线,而效果最好的 GPT-Image 2.5-Sunburst、Flux2-Erase 又是闭源商业模型。
本文的目标是本文的目标是构建一个只接收「源图像 + 二值掩码」两个输入的通用 Erase Anything 基础模型:单一模型覆盖一般物体、视觉文字、各类水印、关联视觉效应(阴影/倒影)、多目标移除与高保真修复六大真实场景,并支持从不到 1% 到接近 50% 画面面积的目标尺度、任意长宽比与分辨率。配套目标是基础设施级的:构建 1.0107 亿对「源图-掩码-目标图」训练集 LensErase-100M 与 500 例免参考基准 LensErase-Bench,用参考指标(PSNR/LPIPS/FID 等 8 项)与 VLM 免参考评估双轨衡量,希望 LensErase 能作为擦除类应用和编辑系统的底座模型。
与已有工作不同的是,独特切入有三点。数据侧不做「真实的移除配对」,而是反过来利用「添加比删除可靠」的观察:用编辑模型往干净真实图里加物体再反转配对,以原始真实照片为监督目标,从根上避开移除模型易残留、乱改背景的缺陷;水印用程序化 alpha 合成(渲染区即掩码)、海报用带 z-order 的分层渲染、视觉文字用「教师编辑 + OCR 前后比对 + SSIM 筛选 + 泊松融合」。架构侧提出 Mask-Aware RoPE,把掩码作为第三维(模态维)写进旋转位置编码,不引入掩码 token 序列也不做通道拼接。训练侧在 SFT 之后用 DiffusionNFT 做契约引导的强化学习,奖励带「移除子准则为零则整体乘 0.5」的门控,推理阶段再用 TraceFusion 残差融合把非编辑区贴回源图,形成训练与推理两端共同保真的闭环。
核心方法
直觉上,擦除是以视觉为条件的生成任务:源图是条件,掩码指位置,干净图作监督。技术路线分四阶段。①预训练:从文生图模型 Lens 初始化 48 层 MMDiT 双分支(image branch 处理噪声目标潜变量、condition branch 处理源图潜变量),在 1.0107 亿对样本上以区域加权流匹配训练约两周(96 张 A100),用 Mask-Aware RoPE 注入掩码。②SFT:在 14 万条精选高分辨率数据上 LoRA 微调(16 卡约 3 天),保留同样加权目标。③RL:在 1.9 万个图像-掩码任务上用 DiffusionNFT 优化,奖励由 GPT-5.6 Sol 按共享「擦除契约」打分(16 卡约 5 天)。④推理:TraceFusion 从源图-输出残差估计有效编辑区,区内保生成、区外贴回源图。阶段消融显示 Overall 从预训练 86.51 升至 95.22,HiFi Removal 从 65.80% 升至 82.80%。
核心创新是把掩码做成位置编码的第三维。以往注入掩码要么沿通道拼接掩码特征(Channel Concat),要么在 image branch 里额外排一串掩码 token(Token Concat),两者都改变或挤占预训练结构。Mask-Aware RoPE 将 2D 空间 RoPE 扩展为 3D:先对二值掩码 max-pool 下采样到 token 网格得到 $m_i\in\{0,1\}$,源 token 坐标为 $p^{cond}_i=(m_i,h_i,w_i)$(1=待擦除、0=保留),噪声目标 token 赋代理模态坐标 $p^{img}_i=(2,h_i,w_i)$。掩码信息以可忽略的计算开销进入联合注意力,模型天然区分「待改/不改」区域。它与另外两个支柱配合:反添加数据构造(以真实原图为目标,监督信号落在真实分布上)与契约式 RL 门控奖励 $r=0.5^{n_0}\tilde{b}$(防止「重建好看但没删干净」的候选骗取高总分)。Table 4 证实该设计显著优于两种拼接基线。
方法步骤详情
①数据构造:五类共 1.0107 亿三元组 $(I_{input},I_{output},M)$——General 7760 万(GPT-4.1 生成插入指令→编辑模型加物体→DCT+DINOv3 差异并集提示 SAM2 出掩码);Watermark 999 万(随机字体/透明度 alpha 合成,渲染区即掩码);Large-Mask 402 万(BiRefNet 抠图 + YOLOE 避让后 copy-paste);Visual Text 144 万(PaddleOCR 检测→编辑模型教师去字→OCR 前后比对+SSIM 筛选→泊松融合);Poster 802 万(元素按 z-order 分层渲染,删元素后取可见区域为掩码)。②预训练:区域加权流匹配损失 $\mathcal{L}_{FM}$,权重 $\omega_i=1+(\lambda-1)\tilde{M}_i$($\lambda=5$,$\tilde{M}$ 为膨胀掩码)。③SFT:14 万条(8 万通用 + 水印/文字/海报各 2 万,GPT-5.6 Sol 全量筛选)LoRA 微调。④RL:GPT-5.6 Sol 产出契约 $K=(T,E,O)$,五分量归一化加权为 $\tilde{b}$,每个零分移除子准则额外乘 0.5 得 $r$,DiffusionNFT 优化。⑤推理 TraceFusion:补偿重建偏置后取残差,>4 灰度级入候选、连通域 >10 像素才保留,加 $\gamma=0.75$ 暗区分支补充,与膨胀掩码并成编辑支撑,羽化得 $\alpha$,在线性 RGB 中按式(7)融合。
技术新颖性
新颖性有四点。①数据规模与构造:1.01 亿对是现有移除数据集(10 万–100 万)的 100–1000 倍,「添加-反转」以真实原图为目标,规避合成目标图的伪影,且五类数据各配领域专用管线(DCT+DINOv3 提示 SAM2、程序化水印、分层海报等)保证配对可靠。②掩码注入机制:Table 4 显示 Mask-Aware RoPE 预训练 Overall 86.51、HiFi Removal 65.80%,优于通道拼接 84.32/58.80% 与 token 拼接 80.78/51.40%,位置编码注入既保留预训练结构又更有效。③RL 奖励设计:契约与源图绑定、跨 rollout 共享(candidate-independent),零分移除子准则的 0.5 指数门控直击「加权平均掩盖移除失败」的问题,HiFi Removal 从 70.80% 提至 81.60%。④TraceFusion:免训练推理期后处理,用残差(含 $\gamma=0.75$ 暗区分支)把编辑区从掩码扩展到阴影倒影等关联效应区,公共基准平均 PSNR 从 28.70 提到 30.82 dB、LPIPS 从 0.0816 降到 0.0684。
实验结果
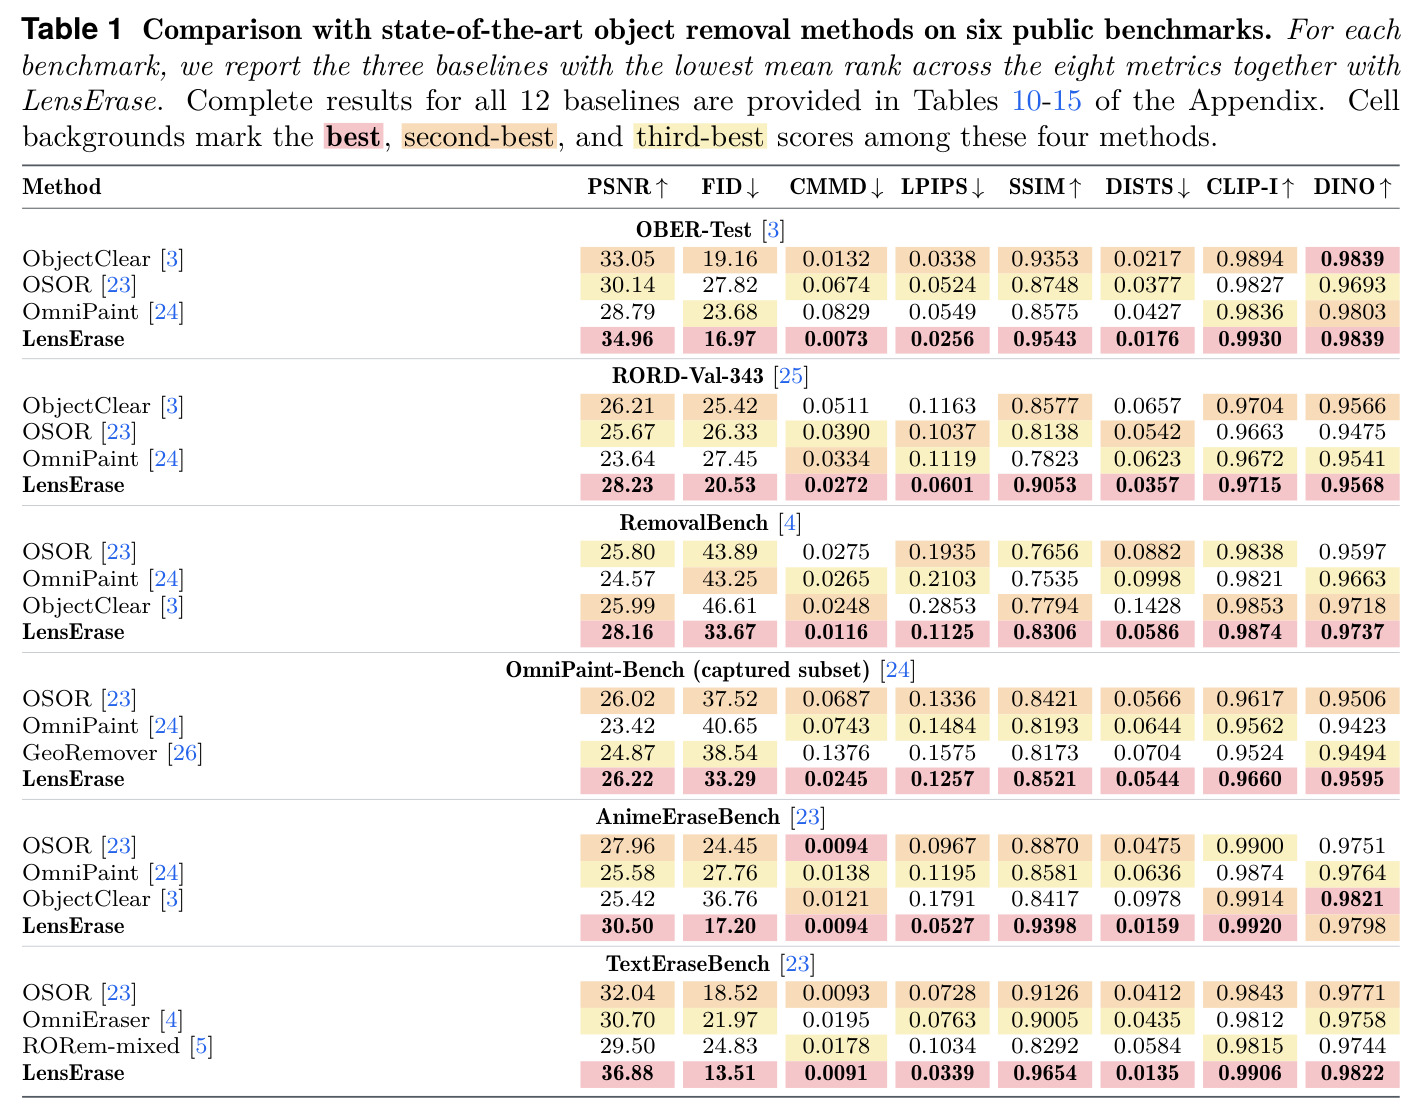
六个公开基准 + 自建基准对 12 个公开方法全面第一(Table 1):OBER-Test PSNR 34.96 dB(次优 ObjectClear 33.05)、LPIPS 0.0256、CMMD 0.0073;RORD-Val-343 PSNR 28.23(26.21);RemovalBench PSNR 28.16、LPIPS 0.1125(ObjectClear 25.99/0.2853);OmniPaint-Bench 捕获子集 LPIPS 0.0245(OSOR 0.0687,降约 64%);AnimeEraseBench PSNR 30.50、FID 17.20(OSOR 27.96/24.45);TextEraseBench PSNR 36.88(OSOR 32.04,+4.84 dB)、FID 13.51。自建 LensErase-Bench(Table 2,GPT-5.6 Sol 免参考评分)上 Overall 95.22、HiFi Removal 82.80%,远超最强基线 OmniPaint 的 73.59/42.80%,其中 Cleanliness 97.05、Removal 95.15。阶段消融(Table 3):Overall 86.51→89.91(+SFT)→94.41(+RL)→95.22(+TraceFusion);RL 主要拉升 Removal(88.65→94.95)与 HiFi(70.80%→81.60%),TraceFusion 主要拉升 Preservation(93.35→96.35)与公共基准 PSNR(28.70→30.82)。掩码注入消融(Table 4):Mask-Aware RoPE 86.51 > Channel Concat 84.32 > Token Concat 80.78。
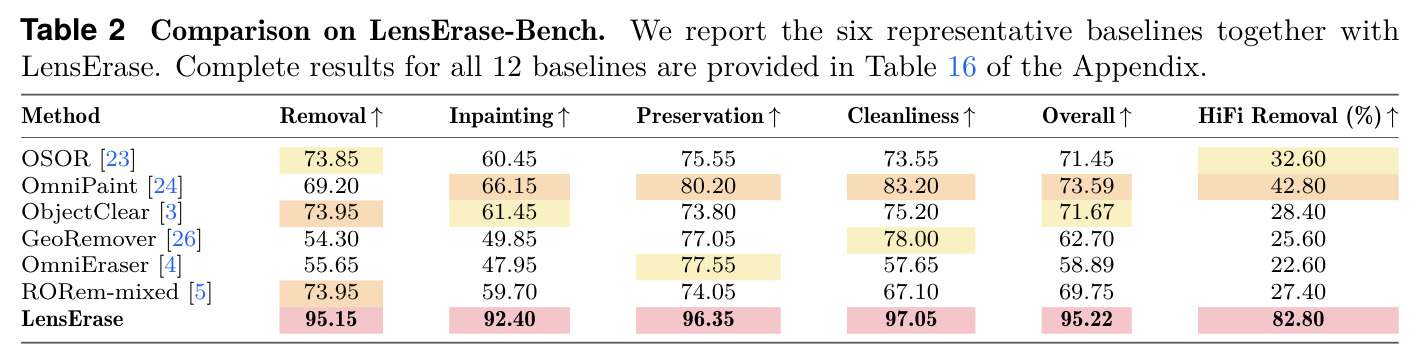
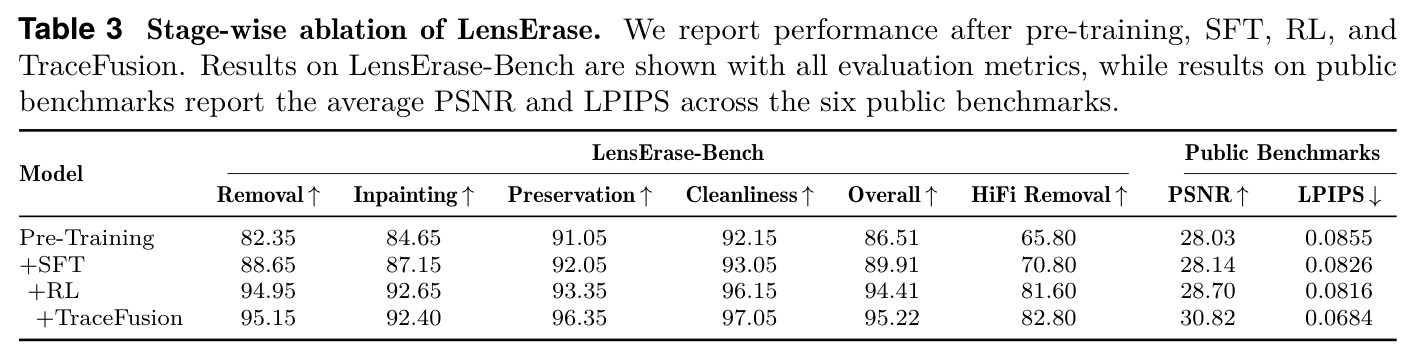
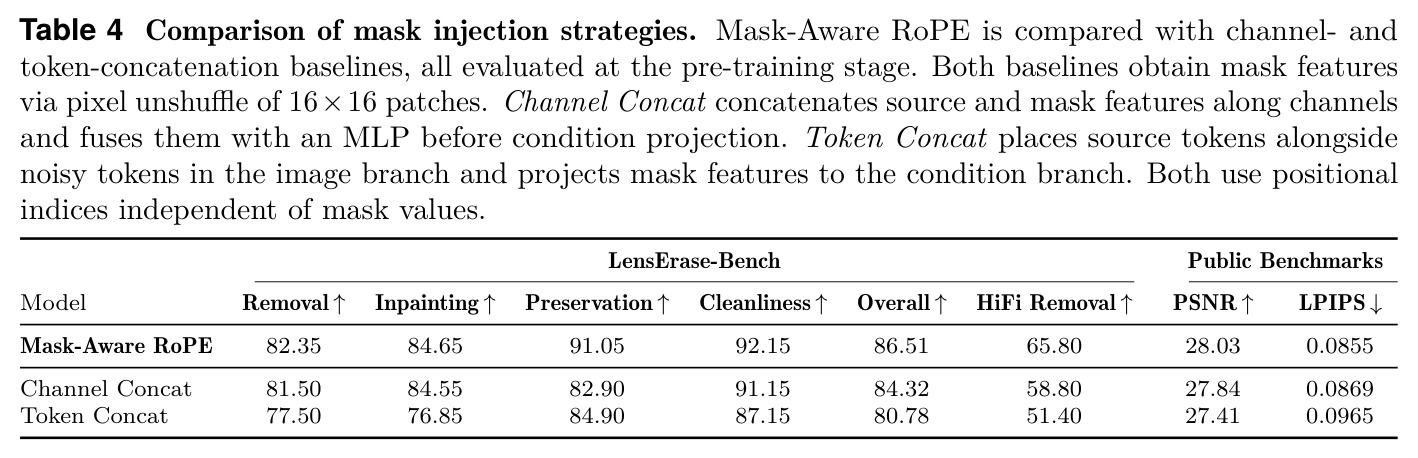
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 通用物体移除(OBER-Test) | PSNR | 34.96 dB | ObjectClear 33.05 dB | +1.91 dB,同时 LPIPS 0.0256、CMMD 0.0073 均为全场最优 |
| 真实捕获场景(RORD-Val-343) | PSNR | 28.23 dB | ObjectClear 26.21 dB | +2.02 dB,LPIPS 0.0601 亦为最优 |
| 物体移除(RemovalBench) | PSNR / LPIPS | 28.16 dB / 0.1125 | ObjectClear 25.99 dB / 0.2853 | PSNR +2.17 dB,LPIPS 降低约 61% |
| 文字擦除(TextEraseBench) | PSNR / FID | 36.88 dB / 13.51 | OSOR 32.04 dB / 18.52 | PSNR +4.84 dB,FID 降约 27% |
| 动漫图像擦除(AnimeEraseBench) | PSNR / FID | 30.50 dB / 17.20 | OSOR 27.96 dB / 24.45 | PSNR +2.54 dB,FID 降约 30% |
| 综合免参考评测(LensErase-Bench) | Overall / HiFi Removal | 95.22 / 82.80% | OmniPaint 73.59 / 42.80% | Overall +21.63,HiFi Removal 约为 2 倍 |
| 训练阶段消融(LensErase-Bench) | HiFi Removal | 预训练 65.80% → SFT 70.80% → RL 81.60% → TraceFusion 82.80% | SFT 阶段 70.80% | RL 贡献最大增量 +10.8 个百分点 |
局限与改进
作者承认的局限:合成数据(水印/海报/大掩码)与真实分布有差距,因此 SFT 阶段剔除 Large-Mask 数据、海报改用职业设计师作品;Visual Text 的 RL 只有「验证过的弱参考」可用于奖励;LensErase-Bench 依赖 VLM 主观评分,免参考评估本身可能漏掉参考指标能发现的问题。我补充四点:①数据管线与评测都深度绑定 GPT-4.1/GPT-5.6 Sol 等闭源模型,训练与评测共用同一裁判家族,自建基准 95.22/82.80% 存在裁判偏置风险,缺少人工评测或第三方 judge 交叉验证;②TraceFusion 的阈值(残差>4、连通域>10 像素、$\gamma=0.75$)全是手工启发式,在低对比度纹理、复杂光照或高频背景上可能误判编辑区边界;③全文未报告推理延迟、参数量与采样步数,预训练 96×A100×两周的成本只有大厂可负担;④水印擦除能力带明显双重用途风险(去除版权水印),论文未讨论合规与滥用防护。
独立分析的弱点
弱点一:全链路依赖闭源 VLM——数据指令生成(GPT-4.1)、SFT 质量筛选、RL 契约与奖励(GPT-5.6 Sol)、基准评测四个环节全是同族闭源模型,judge 的系统性偏差会同时渗入训练与评测;改进方向是引入开源 VLM 交叉打分并做人工抽检校准。弱点二:RL 奖励是单步即时评分,没有刻画「擦除结果在下游任务中的稳健性」(如是否留下可检测的篡改痕迹);可加入对抗判别器或多步一致性奖励。弱点三:TraceFusion 在像素残差层面估计编辑区,当用户其实想「删物体但留影子」时会被误删,反之复杂纹理下残留可能被误保;可把关联效应做成用户可控开关并在契约中显式建模。弱点四:没有推理效率与模型规模报告,48 层 MMDiT 多步采样难以实时;可做步数蒸馏或将 TraceFusion 移到潜空间执行。弱点五:多目标空间分离编辑的一致性只靠数据分布隐式保证,论文未给出专门失败案例分析,可补充按「掩码数量 × 间距」分桶的诊断实验。
未来方向
作者提出方向:把 LensErase 作为擦除基座嵌入视觉生成与编辑系统(Lens 家族的统一编辑框架),并以 LensErase-Bench 持续扩充场景覆盖。基于成果可延伸:①视频擦除——阴影/倒影在时序上更明显,TraceFusion 的残差思想可扩展为时序残差 + 光流一致性约束;②3D/多视角一致擦除,在多视图生成模型上复用 Mask-Aware RoPE 的模态维设计;③用自训练 verifier 或开源 VLM 替代 GPT-5.6 Sol 的契约与奖励,降低 RL 成本并提高可复现性;④把五类数据构造管线开源为「擦除数据工厂」,支持社区训练小型蒸馏模型;⑤与 SAM2/SAM3 级交互式分割端到端串联,实现「点选即擦」产品链路(附录 J 已验证手绘掩码与 SAM 掩码的泛化);⑥面向 AIGC 治理研究擦除模型的合规约束与水印政策边界。
复现评估
复现难度:高。论文仅给出项目页(lensfamily.github.io/LensErase),正文未提及开源代码、模型权重或 LensErase-100M 数据集,基座模型 Lens 的公开情况也未说明。算力门槛:预训练 96×A100 约 2 周,SFT 16 卡约 3 天,RL 16 卡约 5 天,总计约 2000+ A100 天。更强的障碍在数据与奖励管线:构建 1.01 亿对数据依赖 GPT-4.1(指令生成)与商业编辑模型,SAM2、PaddleOCR、BiRefNet、YOLOE 等开源工具可复现,但 SFT 筛选与 RL 契约/奖励依赖 GPT-5.6 Sol 这类闭源模型,成本高且版本不可锁定。评测方面:6 个公开基准与 12 个基线均可获得,但 LensErase-Bench 若不发布,其 95.22/82.80% 无法独立复核。建议关注项目页开源动态;学术复现可优先从最可迁移的两点入手——Mask-Aware RoPE(Table 4 消融协议明确)与 TraceFusion 后处理(免训练、只依赖残差阈值)。
论文图表
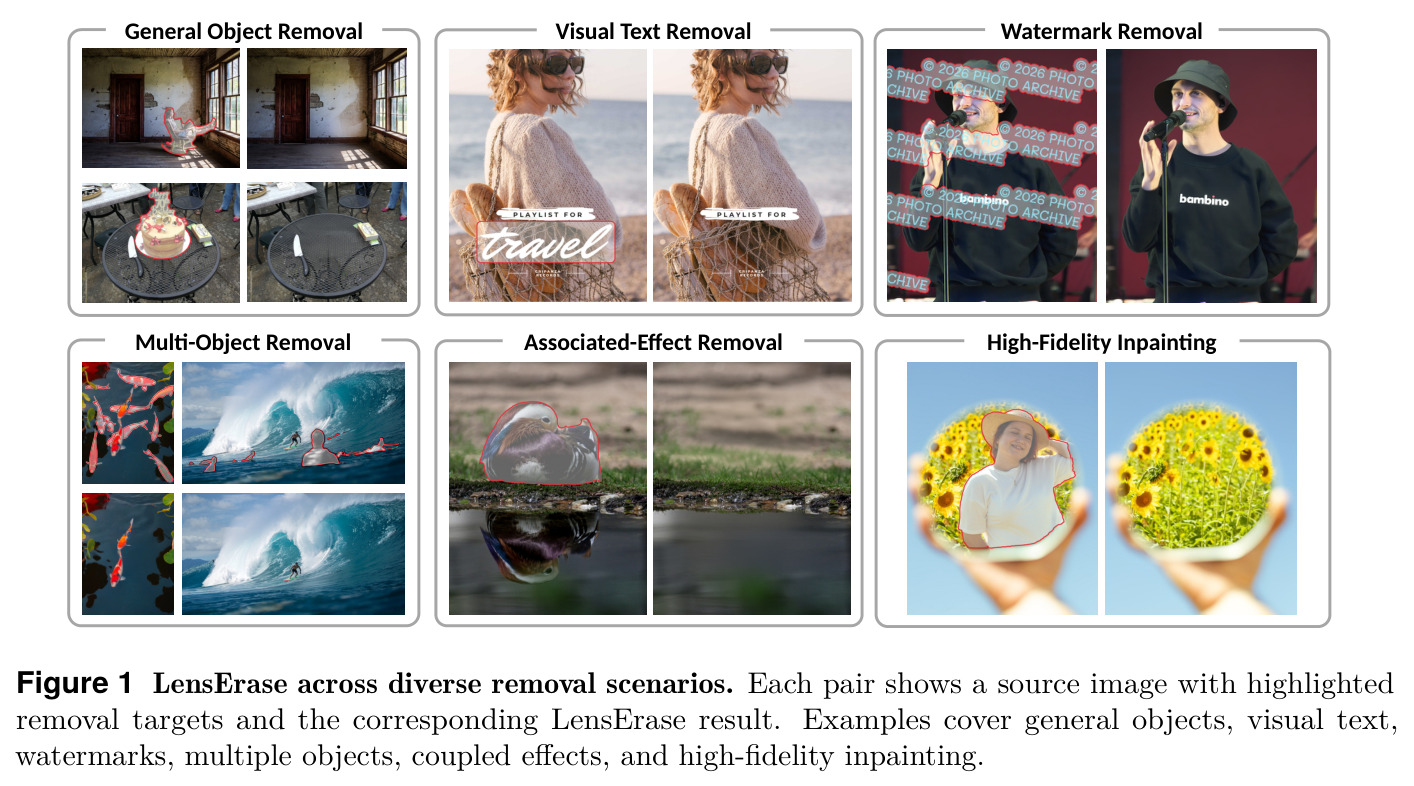
效果总览图:每对子图展示带高亮擦除目标的源图与 LensErase 输出,覆盖六大场景——一般物体移除、视觉文字移除、水印移除、多目标移除、关联效应(阴影/倒影)移除与高保真修复。
一眼看清模型的任务定义(只吃源图+掩码)和能力边界,是判断该模型是否覆盖自己应用场景的最快入口。