苏格拉底式技能学习:教学与实践交织的可迁移智能体技能 Socratic Skill Learning: Interleaving Teaching and Practice for Transferable Agent Skills
教学与实践交织的苏格拉底式指导让智能体技能迁移更准,专家监督成本降61.7%
前置知识
Agent Skills(智能体技能包)
Anthropic 于 2025 年提出的机制:用可复用的指令文件(SKILL.md)加上可选脚本、参考资料来扩展 LLM 智能体的任务能力,全程不更新模型权重。智能体接到任务时加载技能包,即获得该领域的操作知识。本文把技能包形式化为 $K=(M,R)$,其中 $M$ 是指令、$R$ 是脚本与资源,由学生撰写、冻结后交给全新求解器会话使用。
本文研究的对象就是这类技能包的获取与迁移,不理解技能包的结构与冻结评估方式,就无法理解导师评审评什么、留出测试测什么。
轨迹蒸馏(Trajectory Distillation)
从智能体成功执行轨迹中归纳可复用知识的方法族:Trace2Skill 把完整执行轨迹压缩成技能文档;SKILL-KD 用教师轨迹与学生轨迹的对比生成技能补丁,再让学生重跑验证。共同特征是"先把任务跑完,再事后总结",指导发生在证据收集结束之后。
它们是本文的核心对比基线。理解其"事后性"这个盲区——成功尝试无法检验程序背后的使用条件——才能明白"交织教学"的贡献点在哪里。
任务族与留出迁移评估
把同类型任务组织成"族":一个可执行锚点任务供练习,其余变体留作评估;用公开规范 $s_f$ 描述哪些目标不变、哪些维度允许变化(如 WAL 编码方式、完整性约束、恢复深度)。评估时把冻结的技能包交给从未见过该变体的全新求解器会话,避免记忆污染。
SKILLTRANSFERBENCH 的核心设计。论文所有效用数字都建立在这套"规范划界获取范围、留出成员检验迁移"的协议上,理解它才能正确解读实验结果。
苏格拉底式教学法
教师通过提问、质疑与对话引导学习者自己检验假设、得出结论,而非直接告知答案。理论基础包括建构主义学习(Chi et al., 2001):学习者主动建构的知识比被动接受更牢固;以及过程性反馈理论(Hattie & Timperley, 2007):针对学习过程而非结果的反馈更有效。
方法命名的来源。理解"导师只点拨、学生自己验证并写作"的角色分工——学生是唯一环境操作者与技能作者——是读懂整个方法设计的关键。
研究动机
现有智能体技能获取方法大多依赖事后蒸馏:Trace2Skill、SKILL-KD 等先把完整执行轨迹跑完再压缩成技能包,SkillLearnBench 的教师反馈也只在学生失败后才介入修订。这种"先做完再总结"的流程存在一个盲区——一次成功的任务尝试无法检验程序背后的使用条件,未被检验的假设可能被固化成错误的可复用规则;而失败后给建议又为时已晚,取证方向早已定型。评测侧同样有缺口:SkillsBench、SkillLearnBench、EconSkills 只度量技能效用与参数化复用,没有告诉学习者"锚点任务之外还应该调查什么"。此外,固定周期评审随学习推进会变得昂贵:第三轮评审中 85.8% 的评审 token 换来的只是导师的"沉默",平均每次评审 token 从第一轮到最后一轮膨胀 5.3 倍。
本文的目标是本文要同时回答两个问题:第一,如何评估"技能真正迁移到同族新任务"而不只是复现锚点?第二,外部专家应该在学习者仍在收集证据的什么时机、以什么方式介入?为此作者做了两件事:构建 SKILLTRANSFERBENCH——35 个任务族、408 个可执行案例、覆盖六个领域,每个族配公开的"不变量+允许变化"规范与留出评估案例,全部在全新求解器会话中冻结测试;提出苏格拉底式技能学习(SSL)协议,让学生在专家穿插指导下自主探索、验证并撰写技能包,并追求迁移效用与专家监督成本(导师 token)的联合最优。
与已有工作不同的是,本文的独特切入是三重设计:其一,教学时机从"失败后"前移到"调查进行中",在未检验假设固化为技能规则之前纠正学生的取证方向,论文用跨模型实验证明教学时机比"谁在调查"更能决定迁移质量;其二,学生保留唯一的环境操作权与技能写作权,导师只读评审,学生可以质疑、测试、改编甚至基于证据拒绝建议,避免教师代写造成的表面遵从;其三,用持续维护的"学习议题树"把教学需求显式建模为可追踪状态,只在议题开启、变化或重开时触发评审,把稀缺的专家注意力集中到真正未决的问题上。
核心方法
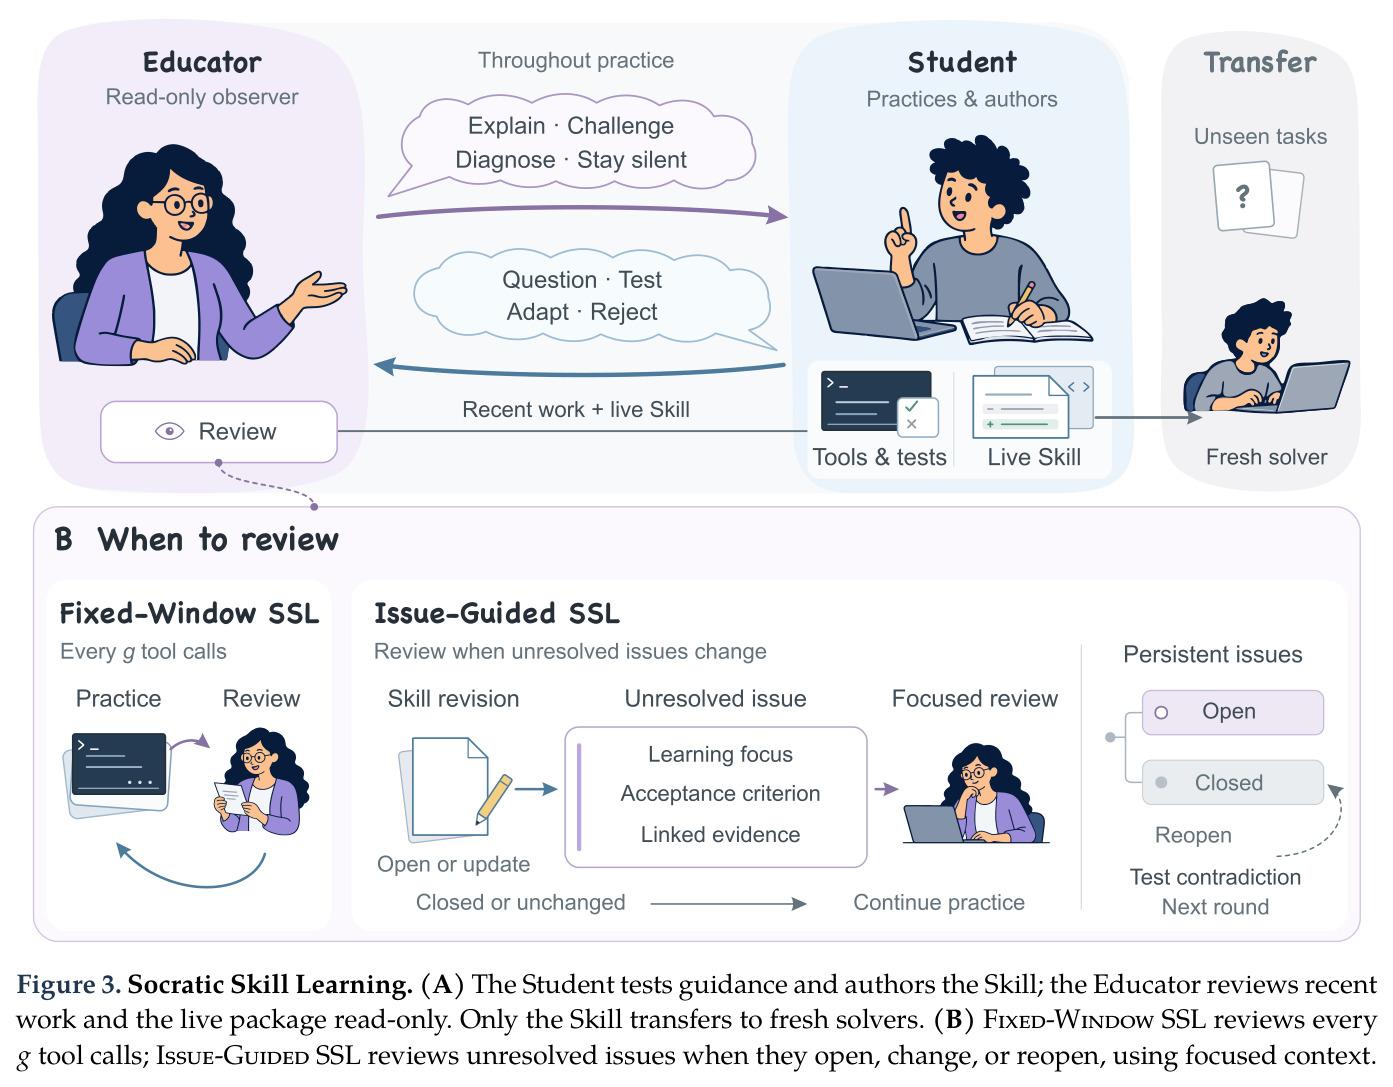
直觉上,学技能像师徒制:师傅不该替徒弟干活,也不该等徒弟做完才点评,而应在徒弟动手过程中观察、提问、点拨,让徒弟自己试出来。技术上,SSL 把一次技能获取组织为多轮"学生练习—导师评审"循环:学生(即目标求解器所用的模型)依据任务族公开规范在锚点任务上探索、运行测试、撰写技能包 $K=(M,R)$(SKILL.md 加可选脚本与资源);导师只读最近的学生工作与实时技能包,可以解释、质疑、诊断或保持沉默;每轮结束后用全新会话的求解器在重置锚点上测试当前包,轨迹与验证反馈进入下一轮,共 3 轮。只有最终冻结的技能包会迁移到留出案例。迁移效用定义为 $U_f(K;\pi_S)=\mathbb{E}_{x\sim D_f}[r_f(\pi_S(x,K))]$,其中 $\pi_S$ 是目标求解器、$r_f$ 是私有验证器打分。
核心创新是与已有范式的时序区别:Trace2Skill 蒸馏完整轨迹、SKILL-KD 用师生轨迹对比生成补丁,都是在证据收集结束后才总结;SkillLearnBench 的教师反馈在失败后才给出修订建议。SSL 把专家指导嵌入学生正在进行的调查中——评审发生在每 $g$ 次工具调用的窗口(Fixed-Window SSL)或未决议题变化之时(Issue-Guided SSL),能在假设被固化之前改变学生收集证据的选择,实验上交织教学在每个模型对上都超过专家直接代写与事后教学。同时学生始终是唯一的环境操作者与技能作者,可以质疑、检验、改编建议,甚至基于证据拒绝指导:技能中的每条规则都经过学生自己的执行证据检验,而非教师断言,这保证了技能的适用条件被真正写进文档。
方法步骤详情
完整流程分六步。第一步任务族准备:每族一个可执行锚点 $x_{f,0}$ 加公开规范 $s_f$,规定不变目标与允许变化(如 WAL 编码、完整性约束、恢复深度)。第二步学生实践:学生模型按规范探索锚点、运行验证,把一组文件编辑打包成一次"修订",声明摘要、证据与所回应的议题。第三步导师评审:Fixed-Window SSL 每完成 $g$ 次学生工具调用(主实验 $g{=}10$)评审一次;Issue-Guided SSL 维护 LEARNING-ISSUE TREE,每个议题含学习焦点与验收标准,仅在议题开启、变化或重开时评审,上下文为活跃议题及祖先、最新修订与近期工作。第四步回应与修订:学生可澄清、质疑或用实验检验建议后继续修订;议题在学生验证修订、记录适用性证据或给出证据拒绝指导后关闭,矛盾的锚点反馈可重开议题。第五步轮次迁移检查:每轮用全新求解器会话在重置锚点跑当前包,反馈进入下一轮。第六步冻结评估:最终包只交给留出案例的全新求解器,按家庭宏平均 $\bar{U}=\frac{1}{3|\mathcal{F}|}\sum_{r=1}^{3}\sum_{f\in\mathcal{F}}\frac{1}{|V_f|}\sum_{v\in V_f}R_{f,v,r}$ 计分,迁移增益为 $100(\bar{U}_{\text{Skill}}-\bar{U}_{\text{No Skill}})$ 个百分点。
技术新颖性
技术新颖性有三点。其一,"交织教学"协议本身是对技能获取时序的重新设计:把导师介入从轨迹终点移到调查中段,实验证明这一时机变化带来 3.99 到 4.99 个百分点的显著迁移提升,且比"换更强模型代写"更有效;其二,学习议题树把"教学需求"显式建模为可追踪、可关闭、可重开的状态机,使评审从固定节拍变成按需触发,在 Qwen 主队列上以 61.7% 更少的导师 token 保持甚至略升效用,效率比达 2.75 倍;其三,基准协议设计上用公开任务族规范划界获取范围、用留出成员加全新会话测迁移,把"技能泛化"从经验性陈述变成可复验的测量,并且评测协议与具体方法解耦,Trace2Skill、SKILL-KD 均可在其上公平比较。
实验结果
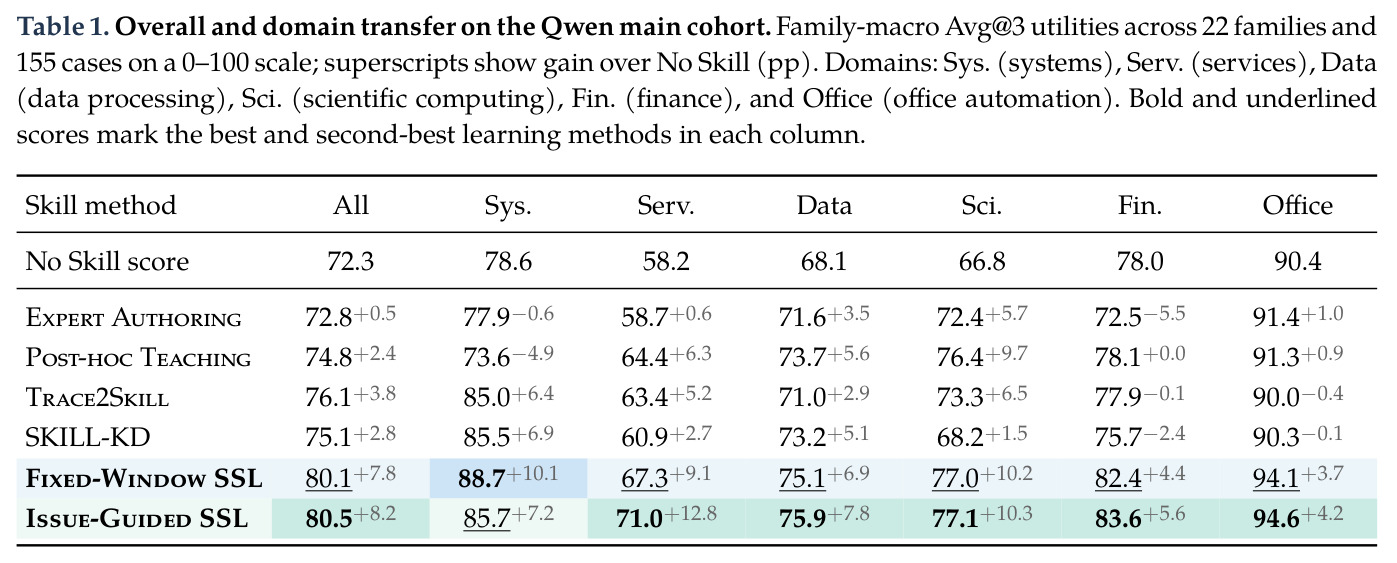
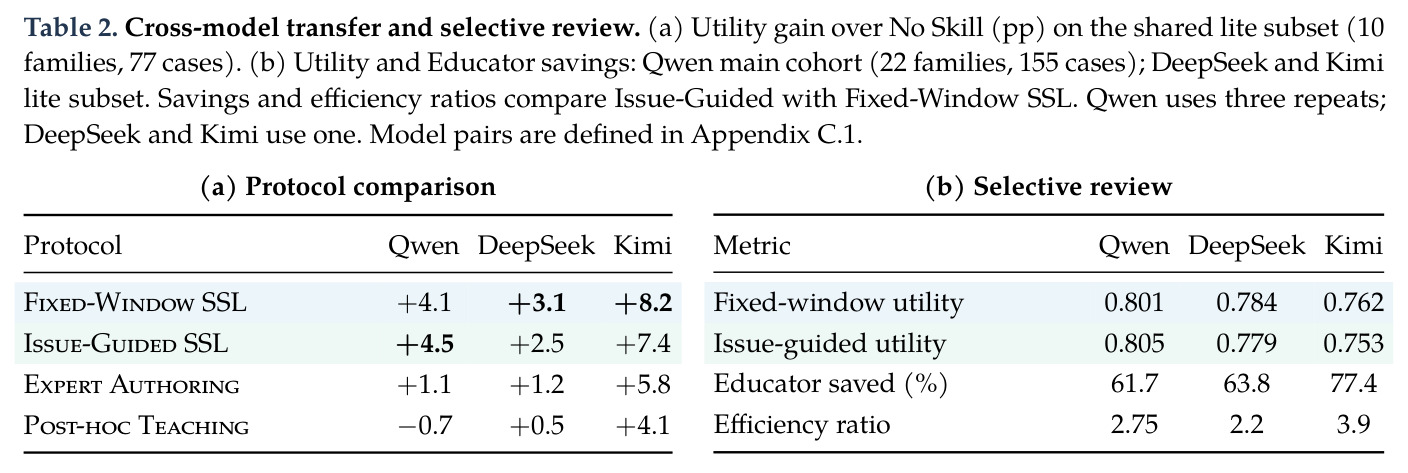
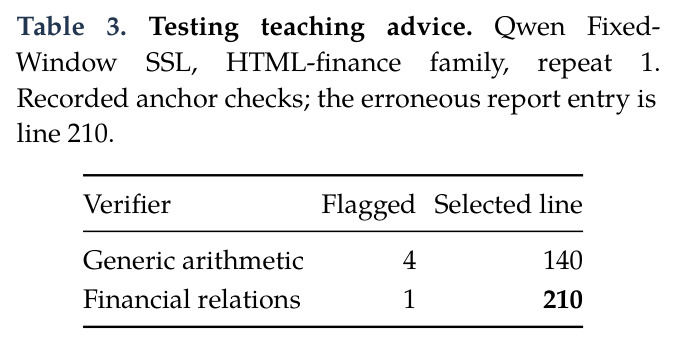
论文按四个研究问题组织实验。RQ1(Qwen 主队列 22 族 155 案例,家庭宏 Avg@3):Fixed-Window SSL 达 80.1,比无技能基线 72.3 高 7.8 个百分点,Issue-Guided SSL 达 80.5(+8.2),两者在六个领域均排前二,高于 Trace2Skill(76.1)、SKILL-KD(75.1)与 Expert Authoring(72.8);Fixed-Window 比 Trace2Skill 高 3.99pp(95% 自助 CI [1.45, 6.49]),完整通过率从 32.5% 升至 49.5% 与 50.8%。RQ2(Qwen/DeepSeek/Kimi 共享 10 族 77 案例):Fixed-Window 提升 +4.1/+3.1/+8.2pp,Issue-Guided +4.5/+2.5/+7.4pp;两个交织协议在每个模型对上都超过 Expert Authoring(+1.1/+1.2/+5.8),Post-hoc Teaching 反而更差(−0.7/+0.5/+4.1)。RQ3(66 次运行 630 次评审):授课率从第一轮 73.0% 降至第三轮 16.1%,授课使下次调用写文件概率 +23.9pp、十次调用内技能变更概率 +38.6pp;HTML-财务案例中,学生把通用算术校验的 4 项误报改为财务关系反推后精准定位第 210 行错误,新会话求解器在未见现金流报告上 4/4 通过。RQ4:Issue-Guided 以 0.92M 导师 token 保持 80.5 效用(Fixed-Window 为 2.40M、80.08),导师 token 省 61.7%、总获取 token 省 16.9%、评审次数省 47.8%,每百万导师 token 迁移增益 8.91pp,是 Fixed-Window(3.23)的 2.75 倍;DeepSeek/Kimi 省 63.8%/77.4% 导师 token,效用差均小于 1pp。
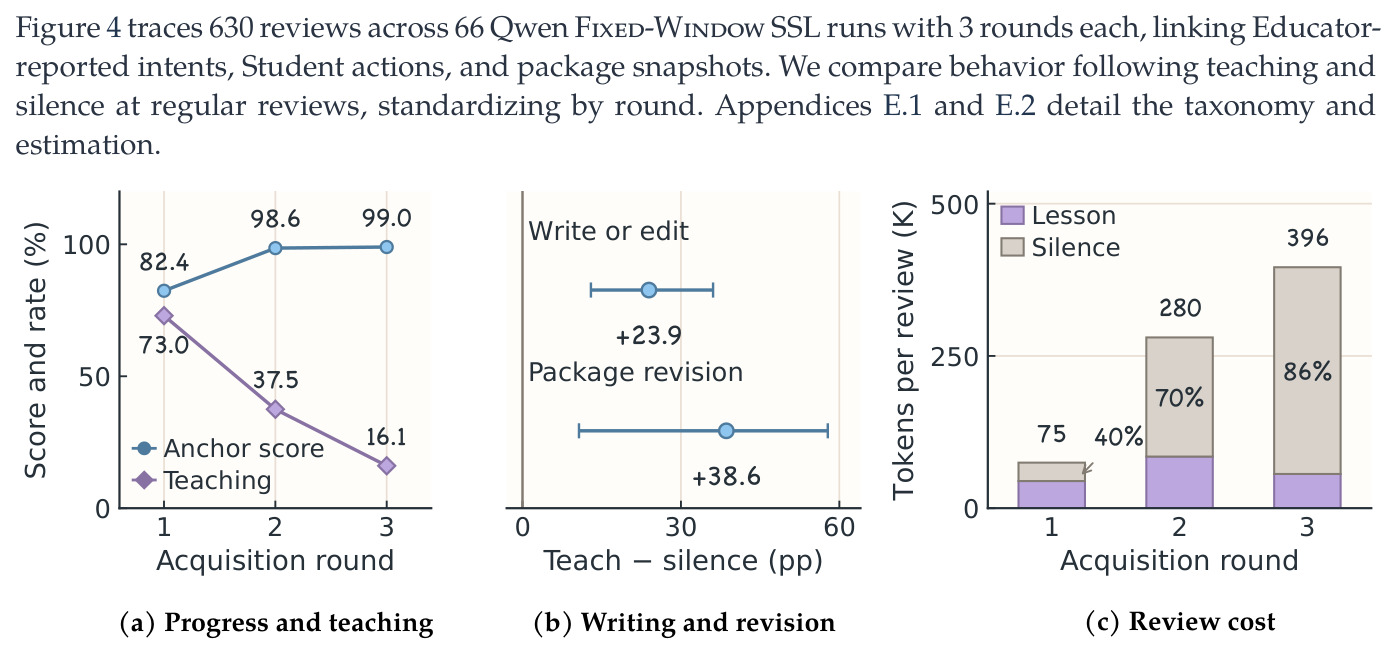
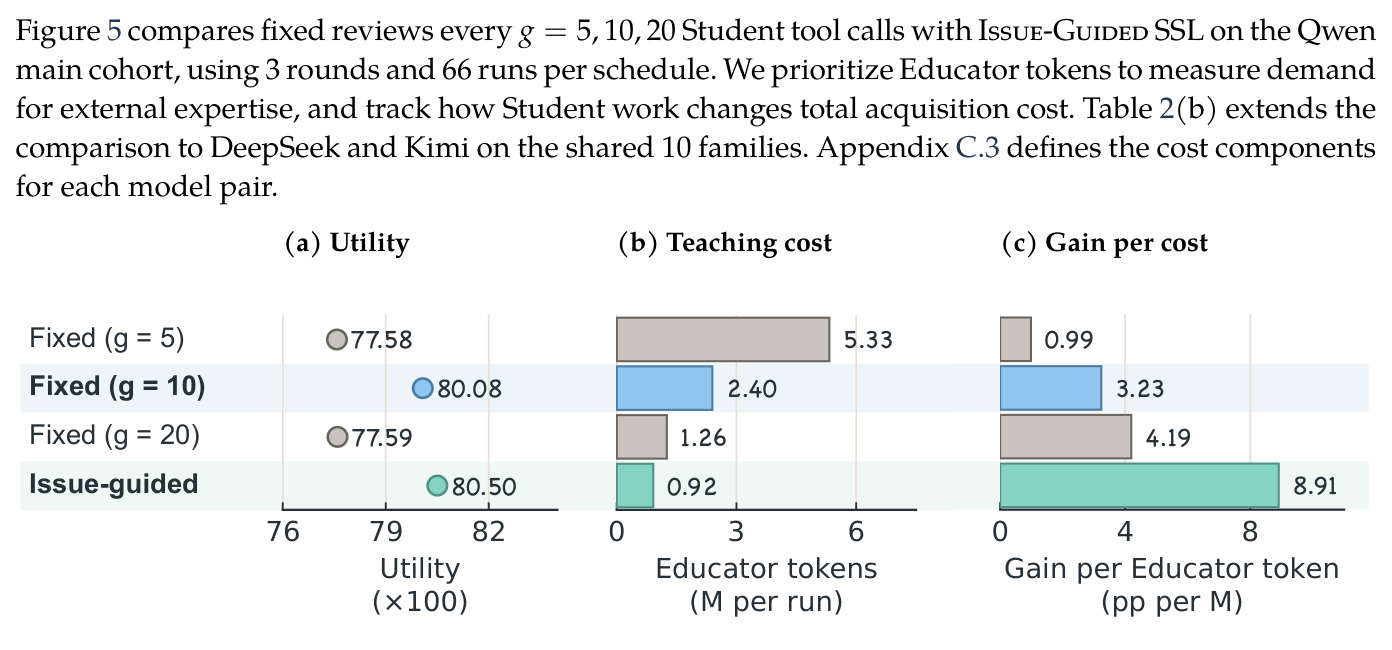
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SKILLTRANSFERBENCH 主队列迁移效用(22 任务族、155 留出案例,Qwen3.7 Plus 学生/求解器) | 家庭宏 Avg@3 效用(0–100) | Fixed-Window SSL 80.1;Issue-Guided SSL 80.5 | No Skill 72.3;最强外部方法 Trace2Skill 76.1;SKILL-KD 75.1 | 较 No Skill +7.8/+8.2 pp;较 Trace2Skill +3.99 pp(95% CI [1.45, 6.49]) |
| 主队列完整通过率(所有私有检查全部通过才算满分) | 家庭宏完整通过率(%) | Fixed-Window SSL 49.5%;Issue-Guided SSL 50.8% | No Skill 32.5% | +17.0/+18.3 pp |
| 跨模型协议对比(Qwen/DeepSeek/Kimi 共享 lite 子集:10 族 77 案例) | 相对 No Skill 的效用增益(pp) | Fixed-Window SSL +4.1/+3.1/+8.2;Issue-Guided SSL +4.5/+2.5/+7.4 | Expert Authoring +1.1/+1.2/+5.8;Post-hoc Teaching −0.7/+0.5/+4.1 | 交织协议在每个模型对上都超过两种非交织协议 |
| 专家监督成本与效率(Qwen 主队列,22 族、3 次重复) | 导师 token(M/次运行)与每百万导师 token 迁移增益(pp/M) | Issue-Guided SSL:0.92M 导师 token,8.91 pp/M | Fixed-Window SSL(g=10):2.40M,3.23 pp/M | 导师 token 省 61.7%,总获取 token 省 16.9%,效率比 2.75 倍 |
| 选择性评审的跨模型成本(DeepSeek/Kimi lite 子集,单次重复) | Issue-Guided 相对 Fixed-Window 的导师 token 节省(%) | DeepSeek 节省 63.8%(0.784→0.779 效用);Kimi 节省 77.4%(0.762→0.753) | Fixed-Window SSL 同队列效用 | 导师成本大幅下降且效用差均在 1 个百分点以内 |
局限与改进
作者承认的限制:Issue-Guided 在 DeepSeek 上虽省导师 token,学生侧开销上升导致总获取 token 反而增加;简单拉长评审间隔不可行($g{=}20$ 效用降至 77.59),说明按需调度本身不可替代;三轮协议下教学率降至 16.1%,后半段预算大量花在技能微调上。我自己的观察:其一,迁移只在同族变体内测试,规范定义的"允许变化"边界就是技能的泛化上限,跨任务族的迁移完全未验证;其二,408 个案例需专家审定(含 Docker 构建、参考解与私有测试),构建成本高且每族仅一个锚点;其三,评估完全依赖私有测试质量,验证器覆盖不到的维度(代码风格、健壮性)不计分;其四,导师用更强模型(Qwen3.7 Max)而学生用较弱模型(Plus),收益中难以剥离"模型能力差"与"教学机制"各自的贡献;其五,论文声明用生成式 AI 协助构建基准材料,尽管有人工审核,案例分布仍可能带偏置。
独立分析的弱点
独立分析几个弱点。第一,Issue-Guided 依赖学生正确声明议题与修订证据,若学生用偶然通过的锚点检查当作验收证据而错误关闭议题,评审会被错误抑制,论文未报告议题误关闭率;改进方向是引入独立审计器抽样复核已关闭议题。第二,学习议题树由师生共同维护,token 记账显示导师侧节省 61.7%,但学生的议题管理与修订声明开销没有单独量化,可能掩盖部分成本;可给学生配更轻量的议题摘要格式。第三,三模型对收益波动大(Issue-Guided 从 +2.5 到 +7.4pp,Kimi 上反而低于 Fixed-Window),提示协议对弱学生模型不稳定,可加入教学强度随学生能力自适应的机制。第四,技能包冻结后不再更新,部署环境发生漂移(库版本、格式变化)时技能会过期;可引入部署期增量评审或技能过期检测。第五,同族内变体高度相关,家庭宏平均可能高估真实世界跨场景泛化;可补充族间零样本迁移测试。第六,评审沉默占第三轮 token 的 85.8%,说明固定窗口协议本身已被作者证明低效,但 Fixed-Window 仍是默认对比对象,实际部署应直接采用 Issue-Guided。
未来方向
作者提出的方向是按教学需求组织评审,这可直接推广为通用的"教学预算分配"框架。基于本文成果还可延伸:一、跨任务族迁移与课程式学习,检验一个族的技能能否作为另一个族的先验,测量规范边界的真实宽度;二、把学习议题树接入持续部署的智能体,实现线上技能维护与过期重评;三、一名导师模型带多个学生(课堂模式),进一步摊薄专家成本并研究同伴效应;四、把导师指导蒸馏回学生模型权重,对比参数化与非参数化两条技能获取路径的性价比;五、自动生成任务族规范与变体,降低 408 案例的人工构建门槛;六、把议题机制迁移到学生自我评审,实现无外部导师的按需反思;七、在多模态与长周期任务(如 Office 自动化之外的 GUI 操作)上检验协议的适用范围。
复现评估
复现条件较好:代码、基准与全部获取/评估轨迹都在 GitHub(NJU-LINK/Socratic-Skill-Learning)开源,附录 B 记录基准构建与评估队列,附录 C 给出模型设置、获取协议、会话边界与复现命令,附录 E/F 详述过程分析与 token 记账。计算上只需调用 API 模型(Qwen3.7 Plus/Max、DeepSeek、Kimi 三个模型对),无需训练 GPU;单族获取 3 轮、每轮几十次工具调用,主要成本是 token——Qwen 主队列 Issue-Guided 每次运行约 0.92M 导师 token 加学生侧开销,主实验 22 族×3 重复×多协议叠加后预算可观。环境依赖可重置的 Docker 沙箱与私有测试。总体难度中等:方法流程与消融记录清晰,跑通单个族容易,但完整复现全部表格需要可观的 API 预算;第三方扩充新任务族需投入专家人力做案例审定。
论文图表
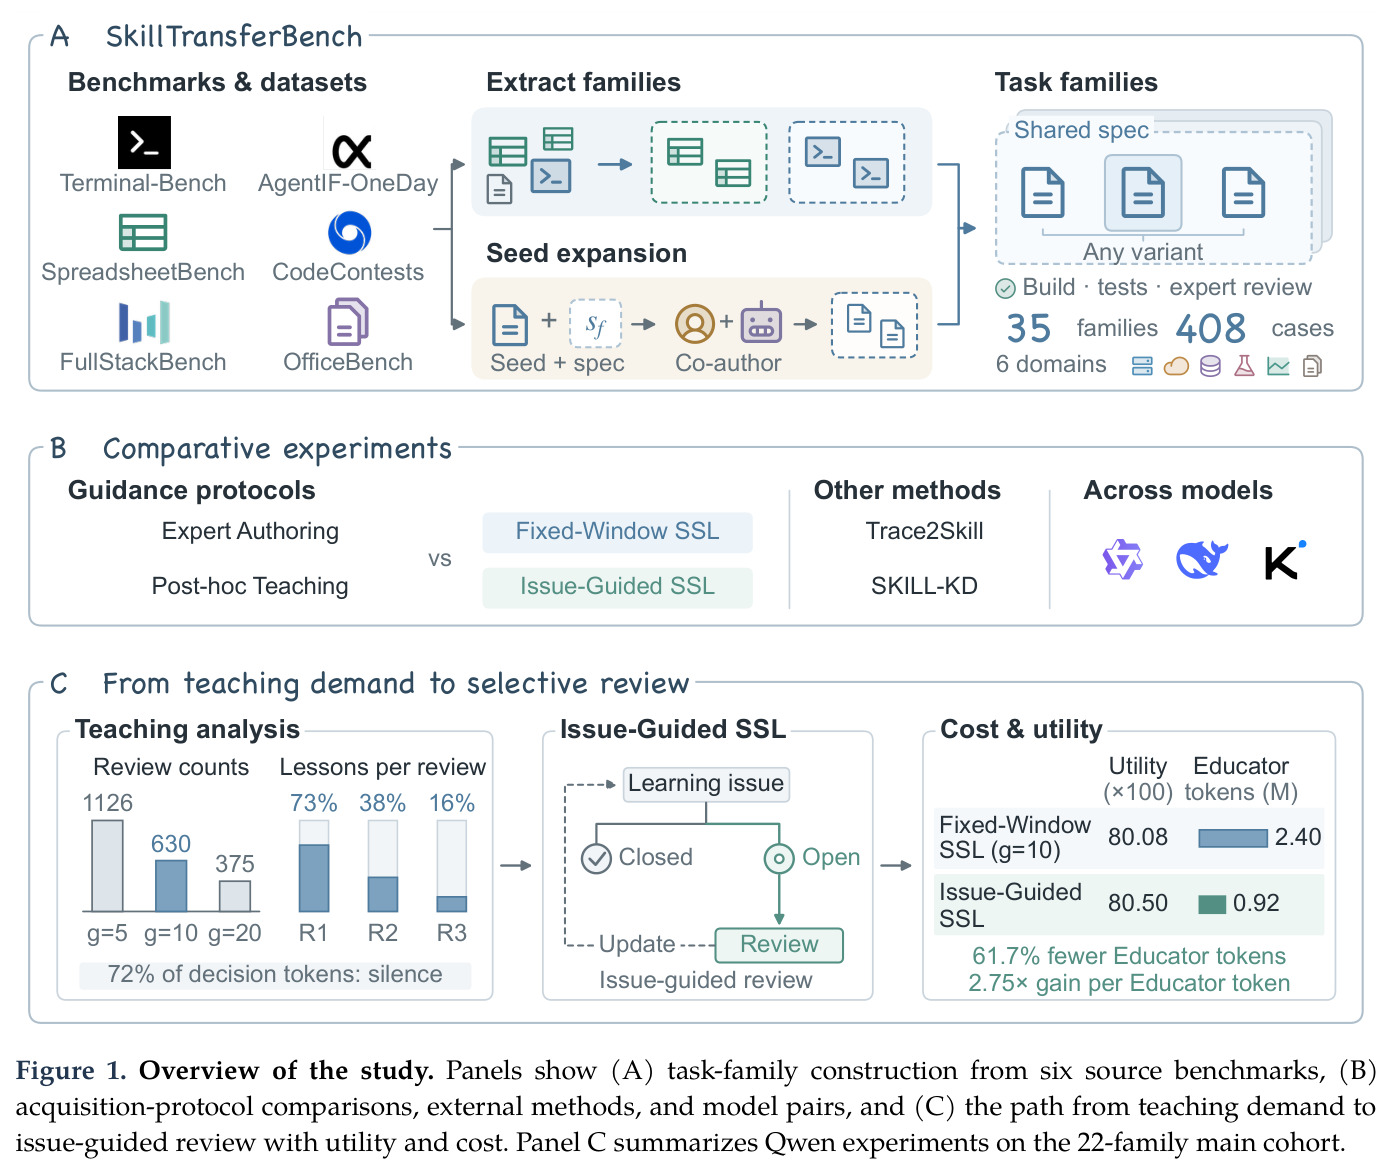
三面板总览图:面板 A 展示从 Terminal-Bench、AgentIF-OneDay、SpreadsheetBench、CodeContests、FullStackBench、OfficeBench 六个来源基准经"提取适配"与"种子扩展"两条路线构建任务族,得到 35 个族、408 个案例;面板 B 展示获取协议对比(Expert Authoring、Post-hoc Teaching vs Fixed-Window SSL、Issue-Guided SSL)与外部方法(Trace2Skill、SKILL-KD)及三个模型对;面板 C 展示从教学需求分析(375 次评审、72% 决策 token 为沉默)到议题引导评审的路径,Qwen 主队列上效用 80.08→80.50、导师 token 2.40M→0.92M、每 token 增益提升 2.75 倍。
这是全文的路线图,一图看懂研究的三条主线:基准怎么建、协议怎么比、成本怎么省。读正文前先看这张图能建立整体框架,面板 C 还提前给出了核心数字结论。
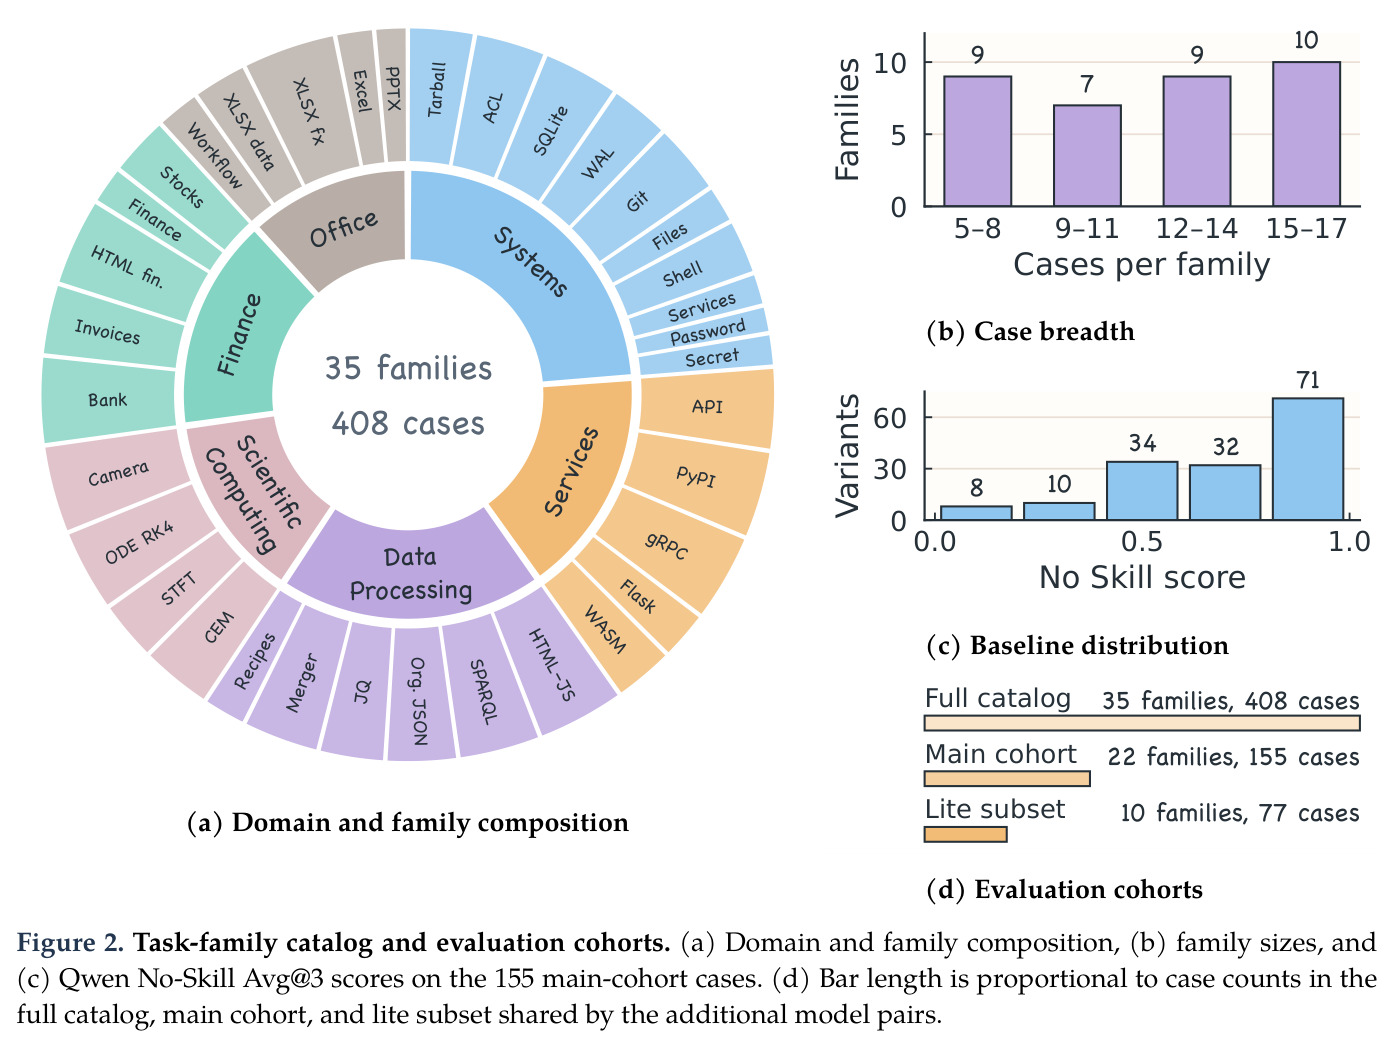
任务族目录与评估队列图:(a) 六个领域(系统、服务、数据处理、科学计算、金融、办公)的 35 族构成;(b) 每族案例数分布(5–17 个,含锚点);(c) 主队列 155 个案例的 Qwen 无技能 Avg@3 基线分布(约 30–60 分不等,用于筛除非满分任务);(d) 全目录 35 族 408 案例、主队列 22 族 155 案例、lite 子集 10 族 77 案例三套评估集的相对规模。
理解基准的构成与筛选逻辑必需:主队列如何从全目录中筛出(至少 5 个已验证留出案例+无技能下至少两次非满分),直接决定后续所有数字的统计口径与领域覆盖。