FlashVSR+:混合注意力与奖励-收益分布匹配的高效视频超分辨率 FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
混合注意力让一步VSR单卡免分块跑4K,Ry-DMD用黑盒奖励对齐蒸馏
前置知识
时空注意力与 DiT
视频扩散 Transformer(DiT)中把所有帧的全部 patch 拼成序列做自注意力,能建模长程时空依赖,但计算量与显存随 token 数平方增长,是高分辨率视频生成的主要瓶颈。
本文混合注意力正是针对它的冗余做稀疏化,理解其开销来源才能读懂 2 倍加速与省显存的逻辑。
流匹配(Flow Matching)
训练扩散类模型的一种方式:学习速度场,把噪声沿近似直线路径搬运到数据分布,训练目标是预测速度。采样可以多步,也可蒸馏成一步;论文 Stage 3 的再加噪公式 $x_\sigma=(1-\sigma)x_0^\theta+\sigma\epsilon$ 即来自流的插值形式。
论文三个训练阶段全部基于流匹配损失,读懂训练流程和噪声调度离不开它。
DMD(分布匹配蒸馏)
一种一步蒸馏框架:同时维护『真分数』逼近真实数据加噪后的 score、『假分数』逼近学生生成分布的 score,两者之差给学生提供梯度,把学生输出分布推向教师分布,从而把多步扩散压缩成单步映射。
Ry-DMD 就是在 DMD 的教师分数项 $s_T$ 上做奖励修正(Eq. 6),不熟悉真假分数博弈就读不懂核心公式。
奖励倾斜分布与 KL 正则化偏好对齐
在原分布上乘 $\exp(\beta r(x))$ 再归一化,得到偏向高奖励样本的新分布 $p^\star$;它是『最大化期望奖励 + KL 散度约束』的解析解,$\beta$ 控制倾斜强度。RLHF 中的偏好优化常用这一形式。
Ry-DMD 的理论核心就是用奖励倾斜后的教师目标替代原教师分布,理解倾斜才能看懂 $\delta_m$ 的含义。
保真与感知双轨评价指标
PSNR/SSIM 衡量像素级保真,LPIPS 衡量深度特征感知距离,MUSIQ/CLIPIQA/NIQE/DOVER 是无参考感知质量指标。生成式复原通常保真指标略降、感知指标大幅上升,二者存在感知-失真权衡。
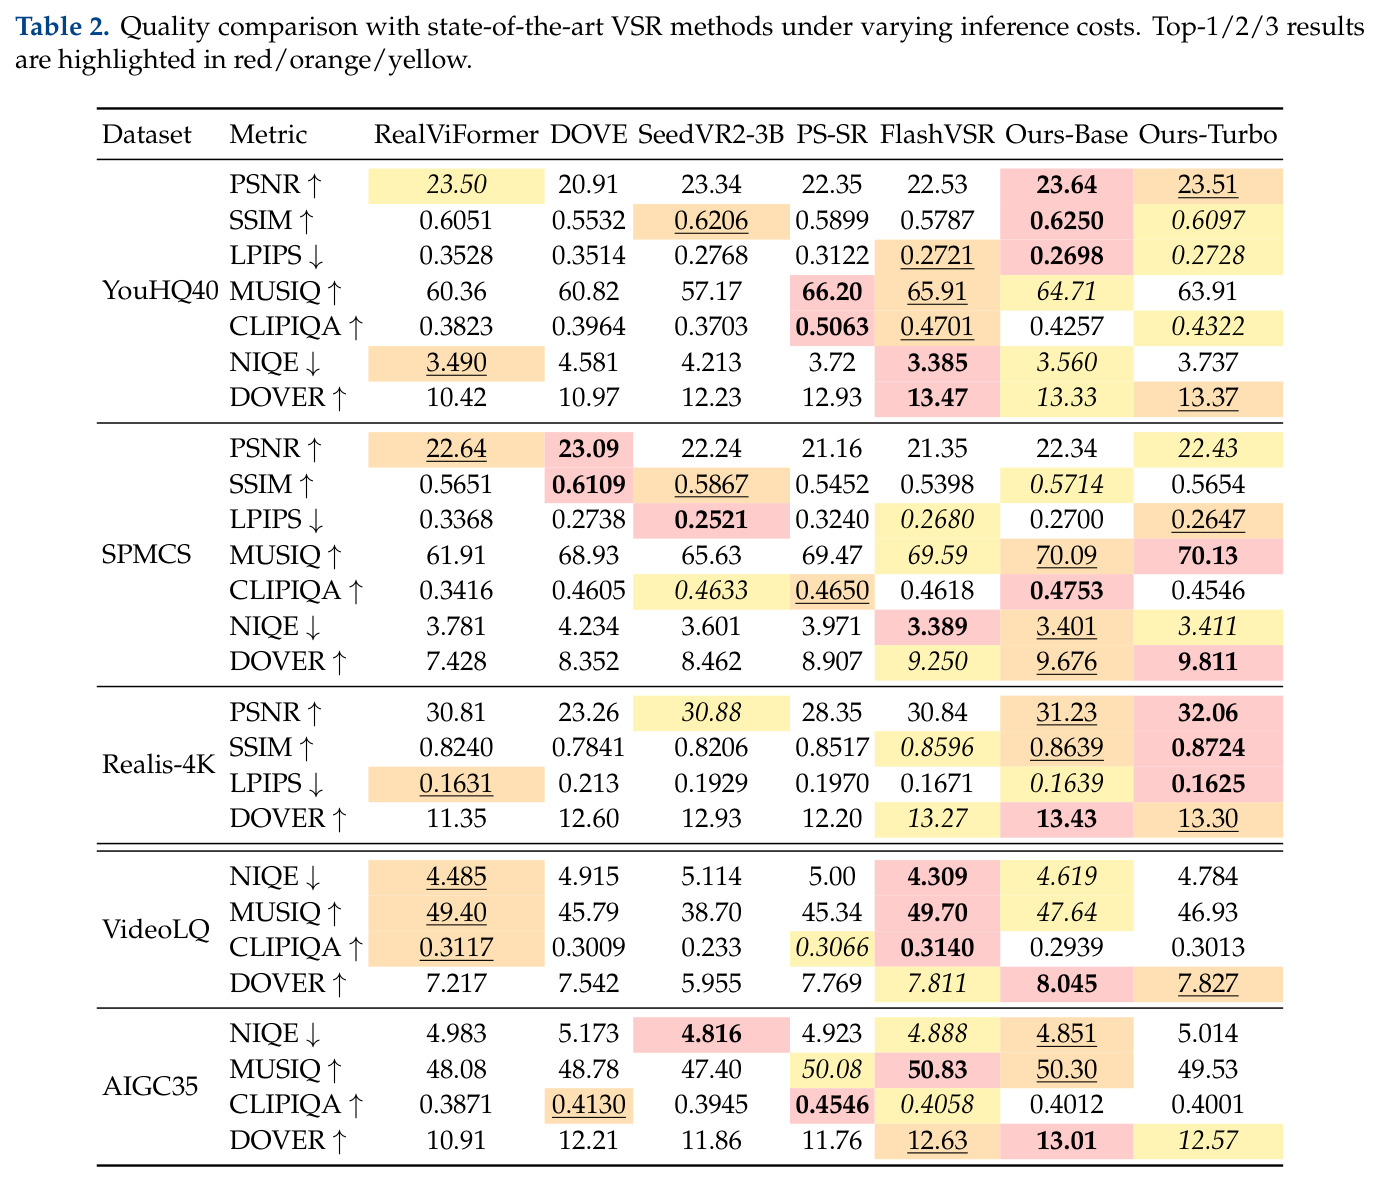
论文表 2 混合了两类指标,理解其张力才能正确解读『PSNR 更高同时 DOVER 也更高』意味着什么。
因果注意力
时间维上每帧只注意自身与之前的帧、不访问未来信息,支持流式推理和恒定显存的 KV-cache 管理,是可流式视频生成/复原的基础结构。
FlashVSR 系列的 DiT 采用因果结构,图 3 的注意力局部性分析就是在因果时空注意力上做的。
研究动机
现有生成式视频超分辨率(VSR)面临两大瓶颈。其一是计算效率:扩散式 VSR 依赖昂贵的多步去噪轨迹,即便用 DMD 等方法蒸馏成一步模型(如 FlashVSR),时空全注意力在 2K/4K 高分辨率下的计算与显存开销依然爆炸——在消费级 RTX 4090(24GB)上必须做空间分块推理,既丢失全局上下文又引入块边界伪影(论文 Fig. 1 中 SeedVR2 的 4K 结果即是例证)。其二是偏好对齐:标准一步蒸馏 DMD 只整体匹配教师分布,无法显式偏向人类偏好(例如视频中的文字更清晰可辨);而现有奖励引导方法要么依赖多步随机轨迹(如 DDPO 类策略优化),要么要求奖励信号可微以便反传梯度(如通过 OCR 模型回传),都与『确定性一步生成器 + OCR 等黑盒奖励』的组合不兼容。此外,社区普遍假设增加蒸馏训练步数能持续涨点,作者发现这一直觉并不成立。
本文的目标是本文的目标是同时攻克效率与偏好对齐两个瓶颈,让一步生成式 VSR 又快又符合人眼偏好。架构上,希望在不明显损失画质的前提下大幅稀疏化时空注意力,使模型能在单张 24GB RTX 4090 上实现免分块(spatially untiled)的 4K 视频超分,目标定在最高 2 倍 DiT 提速、峰值显存近乎减半。训练上,希望提出一种能把 OCR 这类不可微的黑盒标量奖励注入一步蒸馏的机制,让模型明确偏向高奖励输出,同时完全不通过奖励模型反传梯度,并验证该机制能泛化到文生图任务。此外还要回答一个更基础的问题:一步 VSR 的 DMD 训练到底应该如何扩展——是增加训练步数,还是改进学生初始化与教师容量。
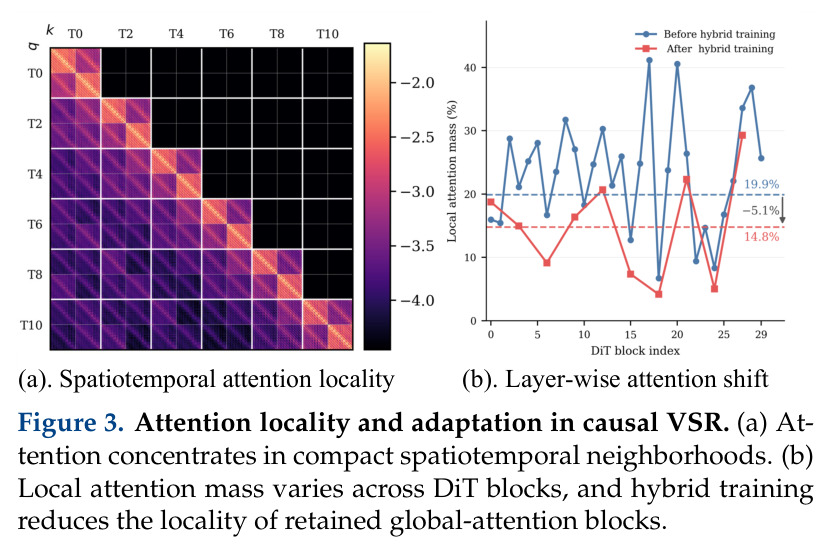
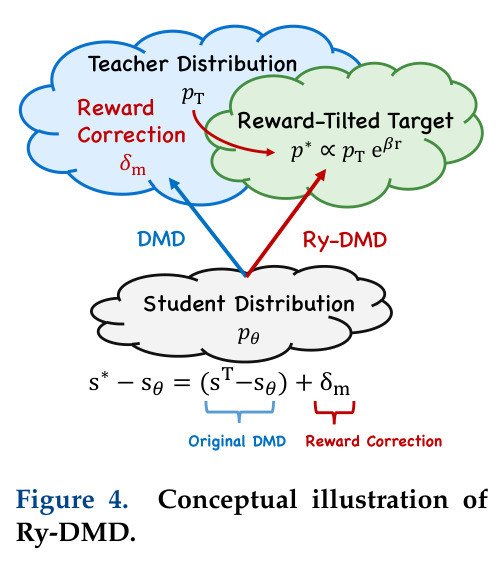
与已有工作不同的是,本文的独特切入有三点。第一,注意力稀疏化不靠凭空设计新机制,而是先实测预训练 VSR 模型的注意力图:局部时空邻域仅覆盖约 1% 的有效 key 块,却吸收了约 20% 的注意力质量,且局部性在 DiT 各层间差异巨大,因此选择『大部分局部 + 稀疏保留全局』的混合结构,而非一刀切的全局部注意力。第二,奖励对齐不改动 DMD 框架本身,而是把奖励改写成教师目标分布的指数倾斜 $p^\star_0(x_0|c) \propto p_{T,0}(x_0|c)\exp(\beta r(x_0,c))$,用多条教师 rollout 的奖励加权重心与原始重心之差作为教师项修正量,任何只输出标量的黑盒奖励都能即插即用。第三,用系统性消融揭示 DMD 训练步数与性能非单调,真正的缩放杠杆在学生初始化与教师容量,纠正了『堆算力堆步数』的直觉。
核心方法
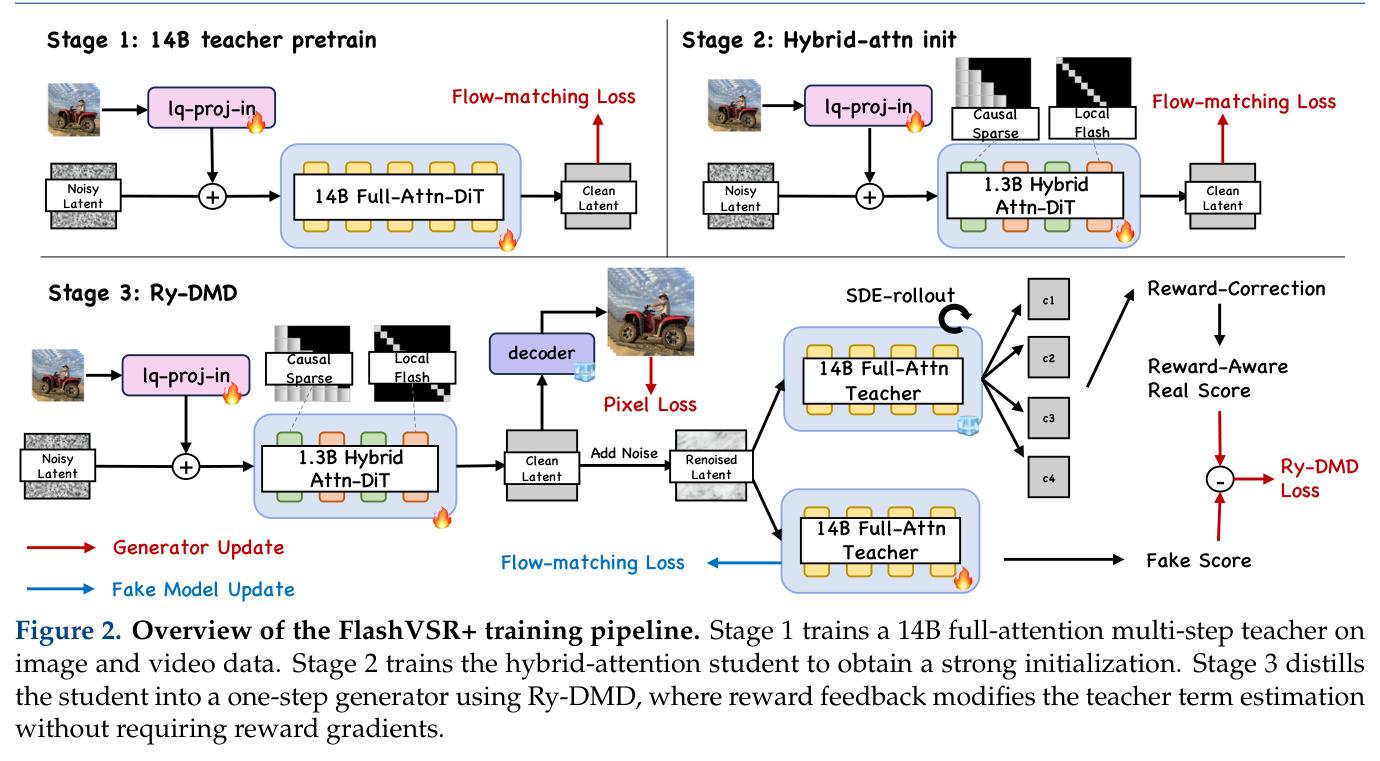
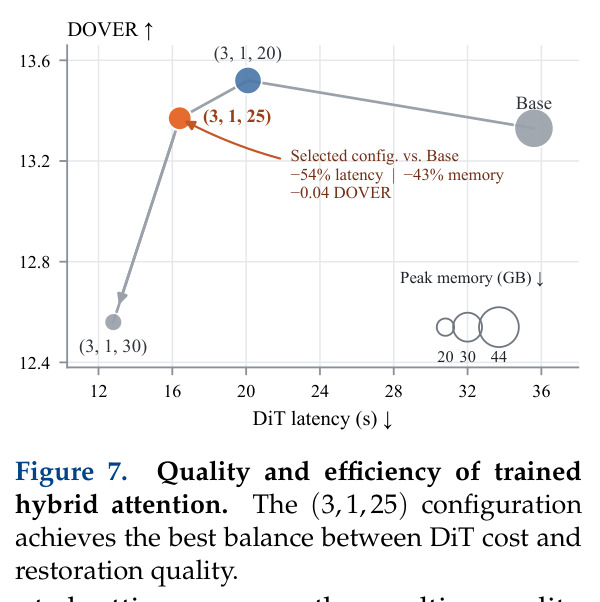
FlashVSR+ 沿用 FlashVSR 的三阶段训练框架并做两处升级。Stage 1 用流匹配损失在图像与视频数据上预训练一个 14B 全注意力多步教师模型,提供高质量生成先验;Stage 2 把 1.3B 学生骨干替换为混合注意力架构——大部分 DiT 块换成因果时空局部注意力,每 5 个块保留 1 个全局注意力块——继续用流匹配损失训练,为一步蒸馏提供强初始化;Stage 3 以 DMD 分布匹配加像素损失把学生蒸馏成一步模型,其中 Ry-DMD 在 DMD 的教师分数项中注入奖励修正。混合注意力配置记作 $(s,t,b)$:$s$、$t$ 分别是局部注意力使用的空间与前序时间 key 块数,$b$ 是被局部化的 DiT 块数。最终采用 $(s,t,b)=(3,1,25)$,带来最高 2 倍 DiT 加速与约 45% 峰值显存下降,再配合 KV-cache 卸载与异步预取,实现单张 RTX 4090 上免分块的 4K VSR 推理。
核心创新有两点。其一是『实测驱动的混合注意力』:预训练 VSR 的时空注意力天然高度局部化(局部邻域占约 1% key 块、约 20% 注意力质量),但逐层差异显著,全局部会因丧失长程一致性产生伪影;混合训练后被保留全局块的局部注意力质量反而下降,说明这些块自适应转向了真正的非局部交互,『结构先验 + 适配训练』优于直接替换。其二是 Ry-DMD 的『奖励倾斜教师目标』:一步生成器是确定性映射,随机性只来自输入噪声,黑盒奖励又不给梯度。Ry-DMD 用多条随机教师 rollout 提供局部随机性,按 $q^\beta_{KT} \propto q_{KT}\exp(\beta r)$ 做奖励加权,加权均值 $\bar{m}_\beta$ 与原始均值 $\bar{m}_T$ 之差 $\delta_m$ 就是教师目标应移动的方向,再折算成教师分数修正 $s_{RYT}=s_T+\lambda_{RY}\max(\sigma,\epsilon_\sigma)\delta_m$ 加回 DMD;全程只采样打分、无需奖励梯度,等价于用 KL 正则化期望奖励的指数倾斜解偏置教师分布。
方法步骤详情
Stage 1:14B 全注意力教师用流匹配损失训练成多步生成器。Stage 2:1.3B 学生按 $(s,t,b)$ 换成『因果+局部+稀疏全局』混合注意力,用流匹配损失训练出强初始化。Stage 3 每步六步走:① 学生预测 $x_0^\theta=G_\theta(z,c)$;② 重新加噪 $x_\sigma=(1-\sigma)x_0^\theta+\sigma\epsilon$;③ 从 $x_\sigma$ 做 $K$ 步随机教师 rollout,独立采 $J$ 条;④ 计算标量奖励(如 OCR 编辑距离),组内标准化得 $a_j$,取权重 $\pi_j\propto\exp(\beta a_j)$;⑤ 加权均值 $\bar{m}_\beta$ 与原始均值 $\bar{m}_T$ 之差 $\delta_m$ 即奖励修正方向;⑥ 教师分数修正 $s_{RYT}=s_T+\lambda_{RY}\max(\sigma,\epsilon_\sigma)\delta_m$,其余 DMD 与像素损失照常。推理时一步出图;4K 需 KV-cache 卸载与异步预取适配 24GB 显存。
技术新颖性
技术新颖性体现在三处。第一,与视频扩散中通用的稀疏/线性注意力工作不同,本文的稀疏模式来自对具体预训练模型的注意力实证测量,并首次展示适配训练会改变被保留全局块的行为(局部注意力质量下降、转向非局部交互),为『先局部化、再由少量全局块补位』的混合设计提供了机理证据。第二,与 DMDR 等在 DMD 内直接优化奖励(需可微代理,本文实验中对 OCR 用 CTC 代理反传且结果反而变差)不同,Ry-DMD 把奖励转化为教师目标分布的一阶位移(均值差),理论根基是 $p^\star_0\propto p_{T,0}e^{\beta r}$ 这一 KL 正则化最优解,因此任意标量黑盒奖励都能用,且不增加任何推理开销。教师 rollout 填补了一步模型缺失的随机性来源,回答了『确定性一步生成器如何做策略优化』这一开放问题。第三,给出 DMD 缩放的实证结论:步数收益非单调,初始化与教师容量才是主导因素。
实验结果
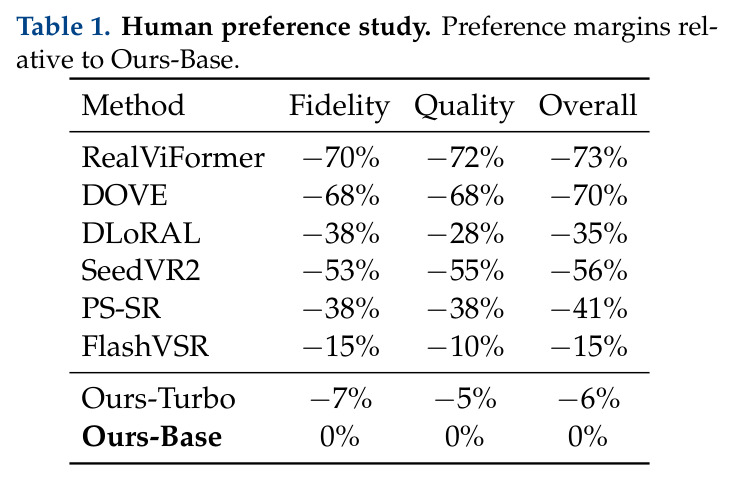
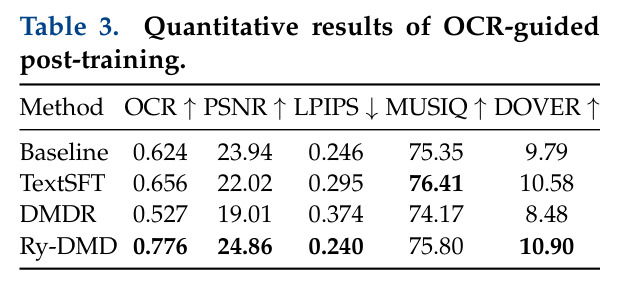
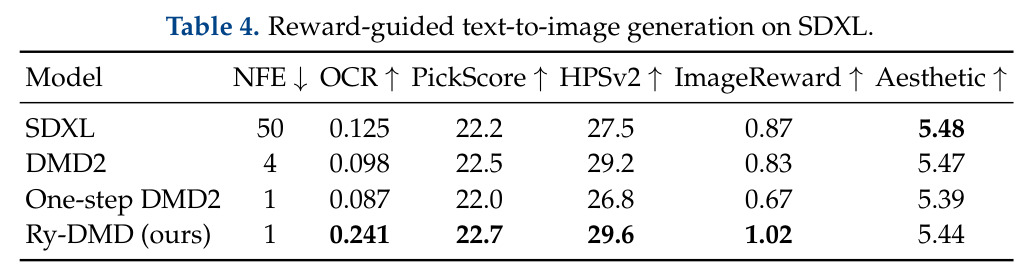
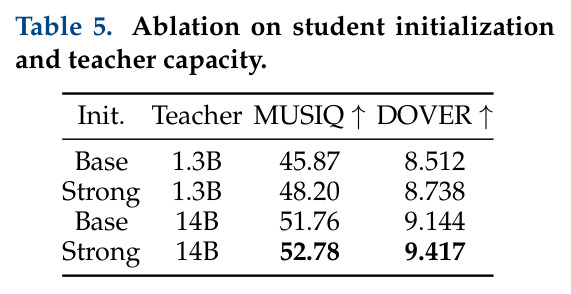
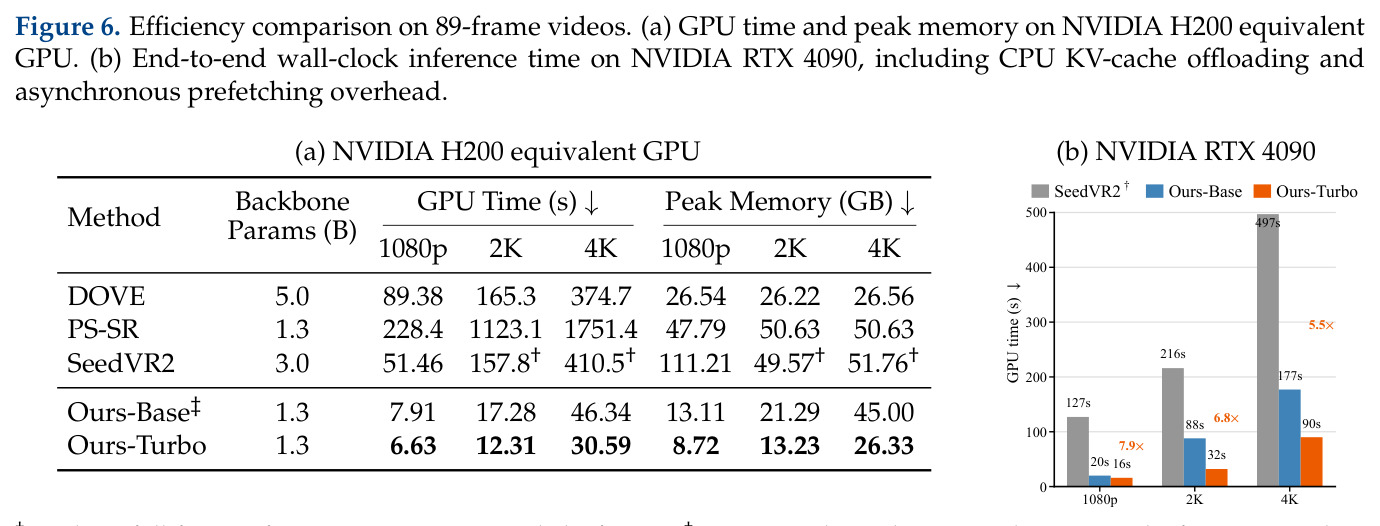
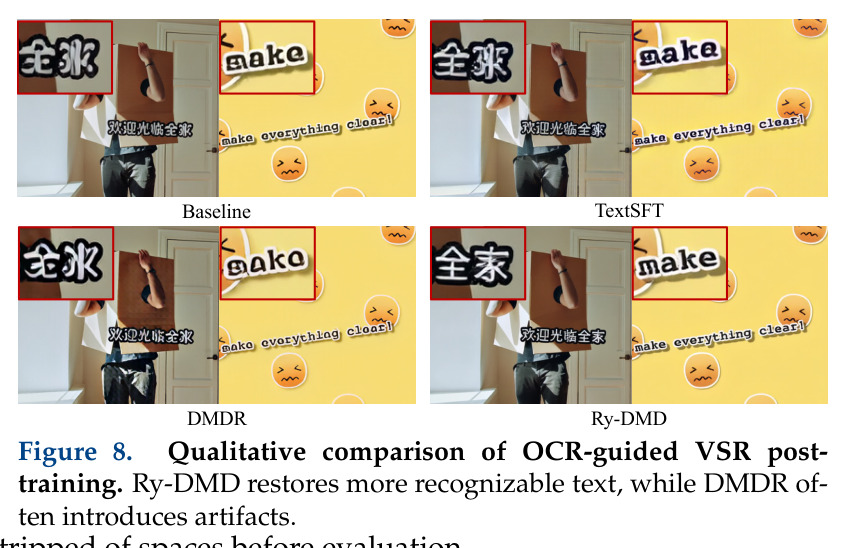
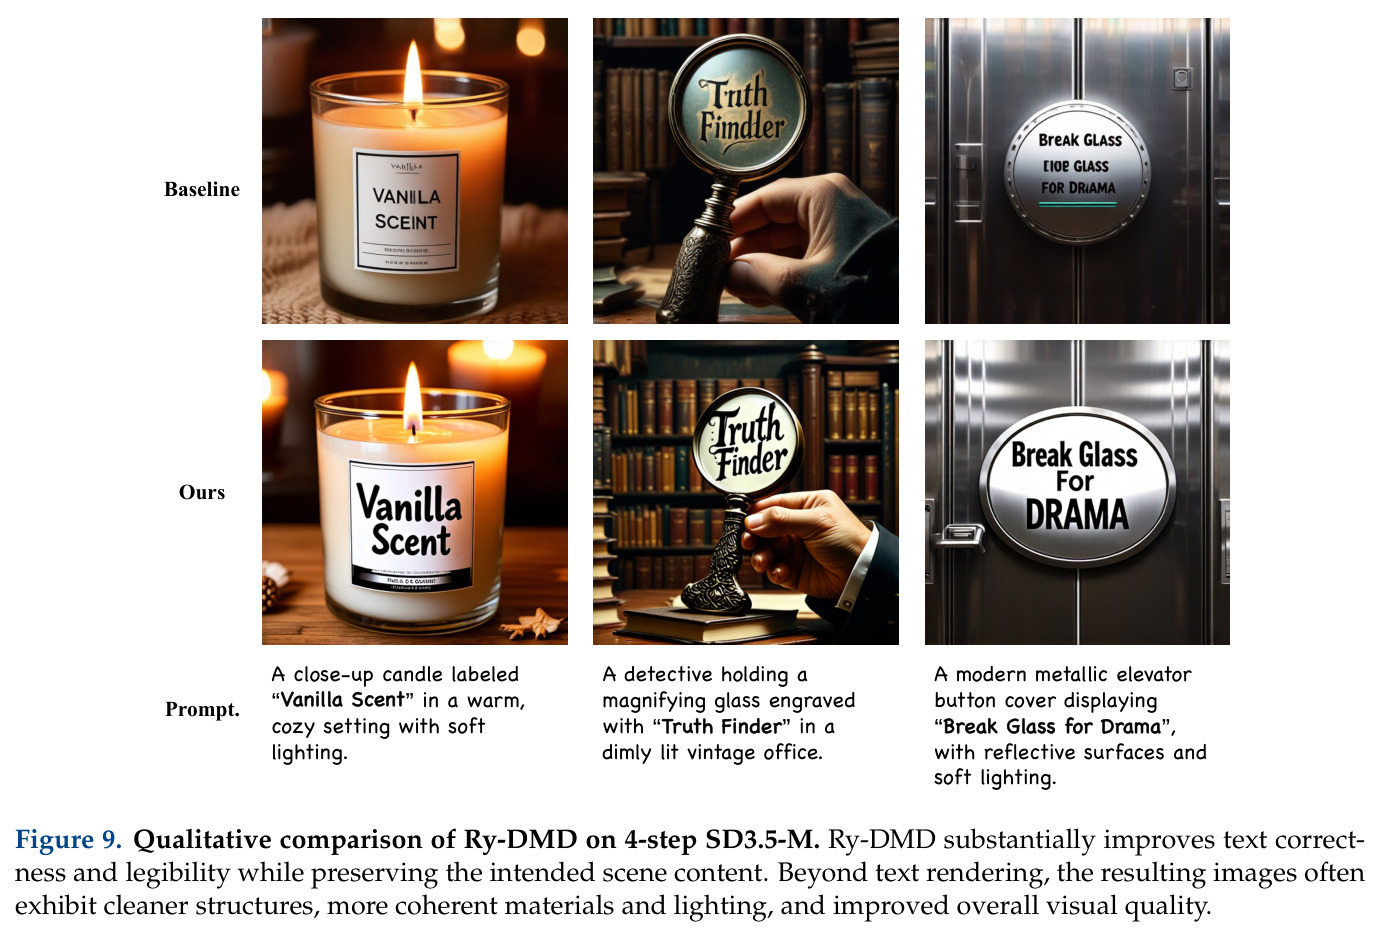
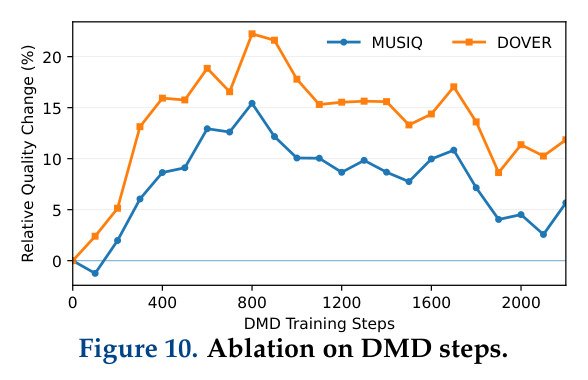
四维证据。① 质量:五基准上 Ours-Base 多数第一,Realis-4K PSNR 31.23 超 SeedVR2-3B 30.88;GSB 盲测各对手均大幅负偏好(SeedVR2 −53/−55/−56%、FlashVSR −15/−10/−15%),Ours-Turbo 仅 −7/−5/−6%。② 效率:H200 等效 GPU 4K 推理 30.59s/26.33GB(SeedVR2 410.5s);RTX 4090 端到端 1080p/2K/4K 仅 16/32/90s,较 SeedVR2† 提速 7.9×/6.8×/5.5×,单卡 24GB 免分块 4K。③ 混合注意力:免训练仅容忍 (3,1,15);适配后 (3,1,25) 最优,省 54% 延迟、43% 显存(DOVER 仅 −0.04)。④ Ry-DMD:OCR 引导 VSR 后训练 OCR 0.624→0.776、PSNR 24.86(DMDR 掉到 0.527);一步 SDXL 文生图 OCR 0.087→0.241 超 50 步;强初始化+14B 教师使 MUSIQ 45.87→52.78,加步数早峰回落。
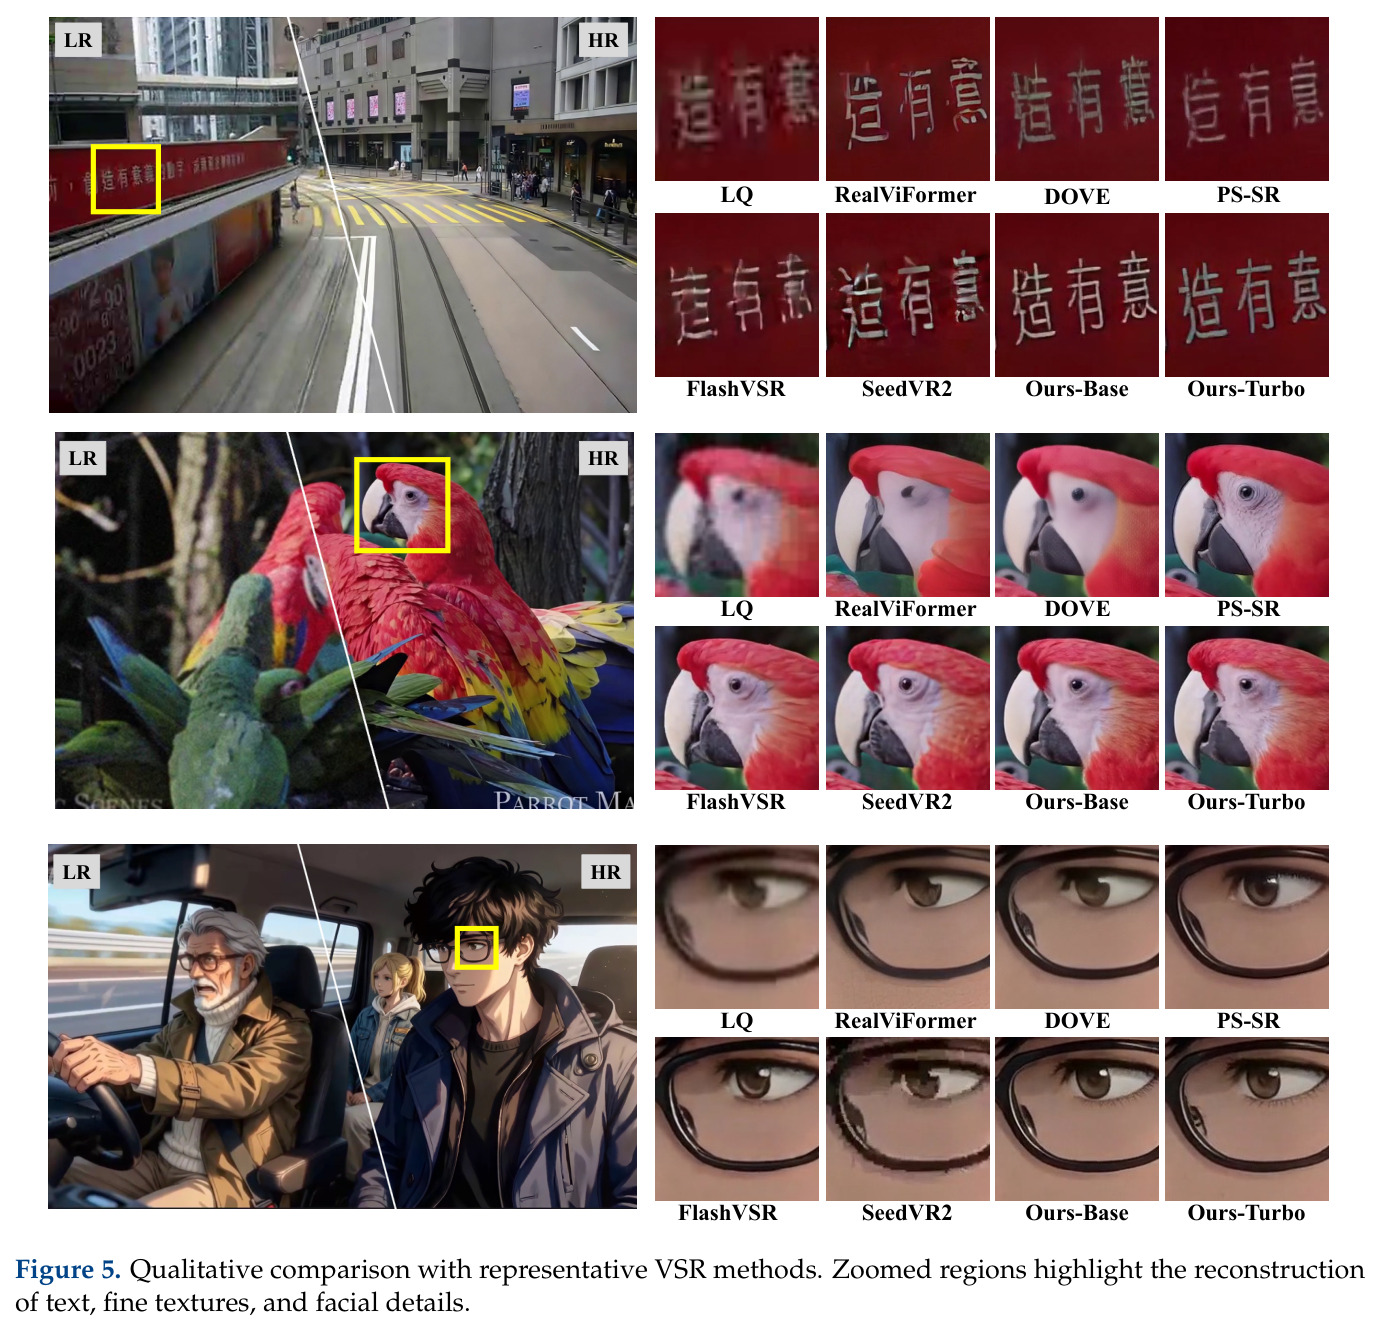
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 4K VSR 推理效率(89 帧视频,H200 等效 GPU) | GPU 时间 / 峰值显存 | Ours-Turbo 30.59s / 26.33GB | SeedVR2-3B 410.5s / 51.76GB(被迫分块);PS-SR 1751.4s / 50.63GB | 约 13.4× 提速,显存约减半 |
| RTX 4090 端到端 4K VSR(免分块) | 墙钟时间 | Ours-Turbo 90s(1080p 16s / 2K 32s) | SeedVR2† 497s(1080p 127s / 2K 216s) | 4K 5.5×、2K 6.8×、1080p 7.9× 加速 |
| RealisVideo-4K 重建质量 | PSNR / SSIM | Ours-Base 31.23 / 0.8639(Turbo 32.06 / 0.8724) | SeedVR2-3B 30.88 / 0.8206 | PSNR +0.35dB(Turbo +1.18dB)、SSIM +0.043 |
| 人工偏好盲测(GSB 协议,RealisVideo-4K/VideoLQ/AIGC35 各 20 段) | 相对 Ours-Base 的偏好边际(保真/质量/整体) | Ours-Turbo −7% / −5% / −6% | FlashVSR −15/−10/−15%;SeedVR2 −53/−55/−56%;DOVE −68/−68/−70% | 在效率大增的同时偏好差距缩小一半以上 |
| OCR 引导的 VSR 后训练 | OCR 准确率(编辑距离) | Ry-DMD 0.776(PSNR 24.86、LPIPS 0.240、DOVER 10.90) | Baseline 0.624;TextSFT 0.656;DMDR 0.527 | +24%,且保真指标同步提升而非受损 |
| 一步 SDXL 文生图(NFE=1) | OCR 分数 | Ry-DMD 0.241(PickScore 22.7、HPSv2 29.6、ImageReward 1.02) | One-step DMD2 0.087;SDXL 50 步 0.125 | 2.8×,一步超过 50 步教师 |
| 4 步 SD3.5-M 文生图 | OCR 分数 | 0.824 | 0.501(不增加 NFE) | +0.323 |
| DMD 训练缩放消融 | MUSIQ / DOVER(固定 held-out 集) | 强初始化 + 14B 教师:52.78 / 9.417 | Base 初始化 + 1.3B 教师:45.87 / 8.512 | MUSIQ +6.91、DOVER +0.905,远超加训练步数的收益 |
局限与改进
作者承认或文中可见的局限:混合注意力有局部化上限,(3,1,30) 出现明显质量下降;(1,1,15) 与 (3,0,15) 即使适配后仍有可见伪影而被排除;免训练直接替换在 $b\ge 20$ 时失败,说明结构改动必须付出重训练成本;RTX 4090 上的 4K 推理还依赖 KV-cache 卸载与异步预取等工程优化。我的补充观察:Ry-DMD 每步需要 $J$ 条 14B 教师 rollout 加打分,训练开销成倍增加,$\beta$、$\lambda_{RY}$ 等超参需逐任务调节;任务奖励与保真存在张力——表 3 中 TextSFT 仅靠文本数据继续 DMD,PSNR 就从 23.94 掉到 22.02,提示奖励倾斜也可能被 hack;在 VideoLQ 的 MUSIQ(47.64 对 PS-SR 的 50.08)与 CLIPIQA 上不敌部分对手,感知-失真权衡仍在;T2I 泛化实验集中在文字渲染类提示,开放域审美奖励的收益幅度未展示。
独立分析的弱点
独立分析几点弱点。① 配置选择靠网格搜索:$(s,t,b)$ 的安全边界((3,1,25) 可用、(3,1,30) 掉点)是试出来的,缺乏可跨模型迁移的准则;改进方向是用注意力熵或逐层局部性统计自动分配全局块,做显存/延迟预算约束下的模式搜索。② Ry-DMD 只用 rollout 分布的一阶统计量(均值差)来表示倾斜方向,在多峰或重尾的奖励分布下位移可能失真;可引入二阶矩修正或多模态加权倾斜。③ 训练成本:每个 DMD 步都要跑 $J$ 次 14B 教师 rollout,代价高;可缓存 rollout、用小型教师代理,或只在部分训练步注入奖励修正。④ 奖励维度单一:主验证只有 OCR 奖励,DOVER、审美、时序一致性等多维人类偏好的组合与冲突未探索,多奖励下 $\pi_j\propto\exp(\beta a_j)$ 的权重会很敏感,容易偏向某一维度。⑤ 部署场景未覆盖:直播、压缩域低码率输入、在线流式因果推理等场景的帧级延迟与鲁棒性缺少数据,仅在离线 89 帧视频上评测。
未来方向
可延伸的方向:把 Ry-DMD 推广到更多黑盒奖励(DOVER 视频质量、审美模型、人类偏好打分)和更多任务(视频编辑、插帧、音频生成),并研究多奖励组合下的倾斜强度 $\beta$ 调度;将混合注意力与线性注意力或硬件感知 kernel 融合,尝试把 (3,1,30) 的掉点补回,逼近更极致的稀疏化;基于『初始化与教师容量比步数更重要』的发现,建立一步蒸馏的缩放律,指导算力分配;从理论上把 $\delta_m$ 的蒙特卡洛估计方差与 $\beta$ 的选择关联,设计自适应 $\beta$ 或置信度加权;把教师 rollout 的奖励权重 $\pi_j$ 与 GRPO 类策略优化目标统一,形成蒸馏-强化学习的混合框架。作者已开源代码、模型与训练数据(www.flashvsr.tech),为上述延伸提供了直接基础。
复现评估
复现友好度中上。官方在 www.flashvsr.tech 放出代码、模型与训练数据,OCR 奖励基于 PaddleOCR,文本合成数据管线在附录 F 有描述,消融超参($\beta$、$\lambda_{RY}$、rollout 数 $J$、rollout 步数 $K$)在附录 C/D 有交代。但完整从零复现门槛很高:Stage 1 要预训练 14B 教师,Stage 3 每步还要多次 14B 教师 rollout,估计需要多卡 H100/H200 级算力与数周时间。对多数研究者,更现实的路径是验证性复现:下载开源的一步模型做推理与效率测试(单张 RTX 4090 即可复现 4K 免分块结果),再在冻结的师生组合上微调 Ry-DMD——OCR 奖励只需推理打分、无需梯度,单机多卡可承受。注意工程细节:原文提到 FlashVSR 的注意力算子在 RTX 4090 上不受支持,混合注意力的实现与 4K 场景的 KV-cache 卸载、异步预取都需要用作者提供的实现,自己重写需要相当的 CUDA 功底。
论文图表
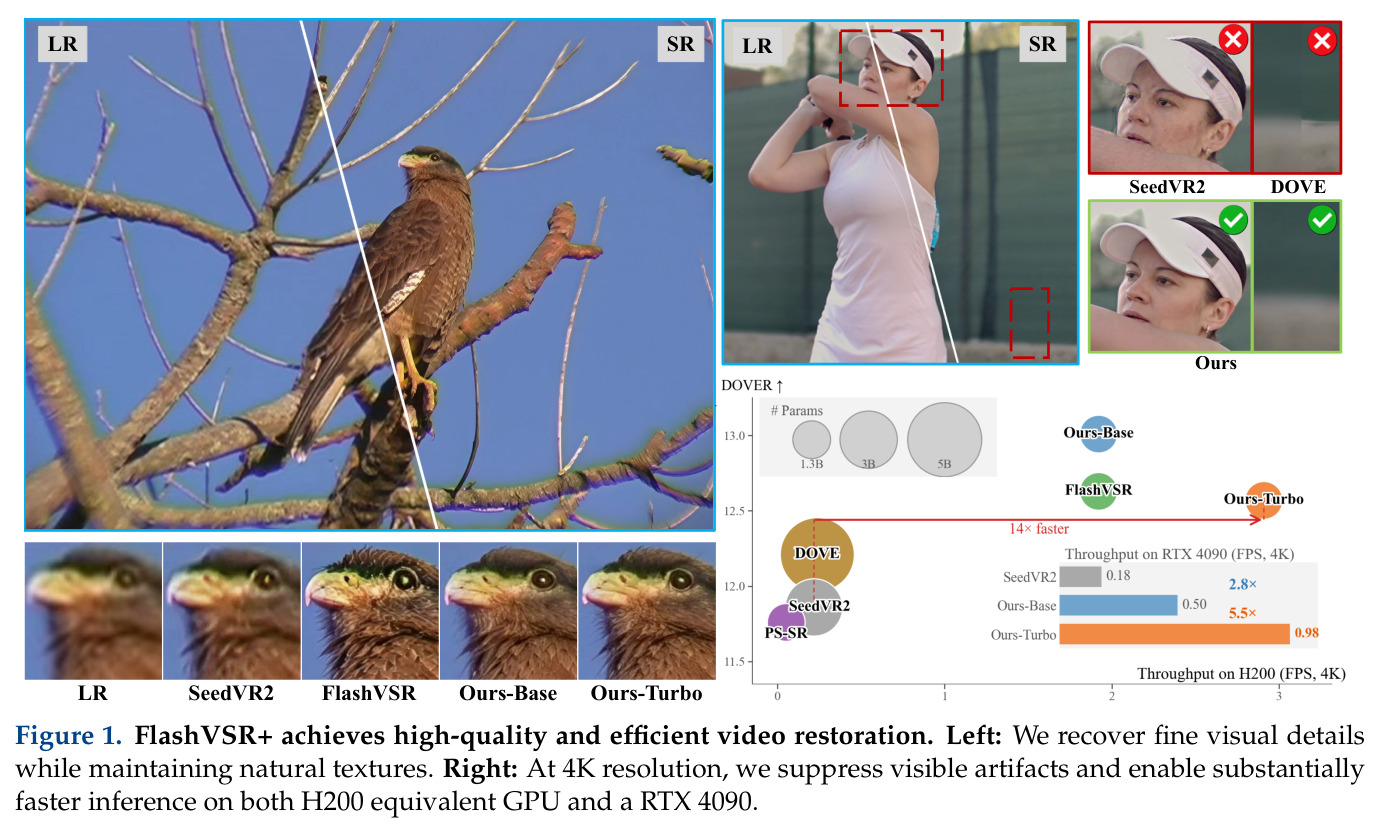
左侧展示与 FlashVSR 相比本文恢复了更精细自然的纹理细节;右侧展示 4K 分辨率下与 SeedVR2、DOVE 的对比,本文能抑制明显伪影,并在 H200 等效 GPU 与 RTX 4090 上显著提速。
一图总览论文两个卖点(质量+效率),SeedVR2 因分块推理产生的网格状伪影也在此可视化,是理解研究动机的起点。