WeFair:面向短视频搜索个性化查询改写的保真度感知人类反馈对齐 WeFair: Fidelity-Aware Alignment from Human Feedback for Personalized Query Rewriting in Short-Video Search
按保真度匹配SFT、DPO、GRPO三阶段监督,用2B小模型在短视频搜索中缓解改写意图漂移
前置知识
个性化查询改写
搜索引擎中用户的 query 往往极度简短含糊(如 anggwe、教育号)。查询改写利用查询时刻的上下文(近期搜索、浏览记录、点击历史等)把原始 query 纠错、补全或具体化为 $\hat{q}$,作为额外检索 query 提升召回。个性化版本要求改写反映这个用户此刻的需求,而不是泛化的大众意图。
这是本文的任务本身:训练一个小模型决定何时改写、如何改写,同时不偏离用户当前意图。
意图漂移(Intent Drift)
论文定义的核心错误类型:改写 $\hat{q}$ 加入了有上下文支持、但与用户即时需求不一致的信息,把搜索引向另一个任务。例如历史里看过菜谱教程的用户搜 crepe cake,模型改写成 how to make crepe cake 检索到菜谱,而非用户想看的吃播视频——信息有出处但方向错了。与之区分,幻觉(hallucination)指加入上下文不支持的额外信息(如 dairy-free)。
全文动机就是缓解意图漂移,评测指标 Intent Drift Rate 和 GRPO 阶段的严格验证奖励都围绕它设计。
SFT 与课程学习
监督微调(SFT)用输入-目标对优化 $\mathcal{L}^{(k)}_{\mathrm{SFT}}=-\mathbb{E}[\log\pi_\theta(v|u)]$ 让模型模仿目标输出;课程学习把多个训练阶段由易到难串联,每阶段从前一 checkpoint 继续。本文 SFT 分三阶段:上下文预测历史 query(C2Q)→ 带推理链的生成(CoT)→ 直接预测目标(HR)。
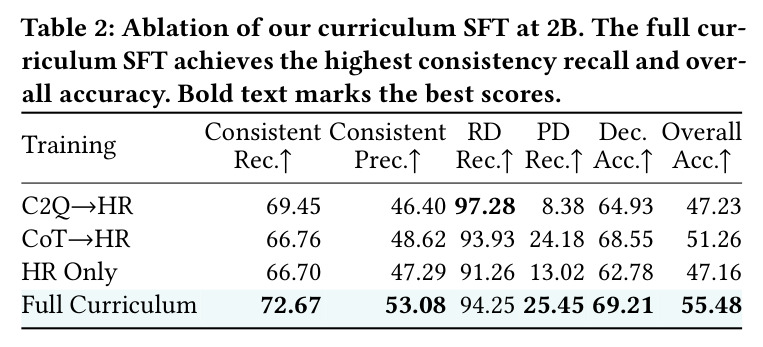
Table 2 消融证明宽覆盖、低保真的 C2Q 数据只在完整课程中才有收益,这是保真度匹配论点的第一块证据。
DPO(直接偏好优化)
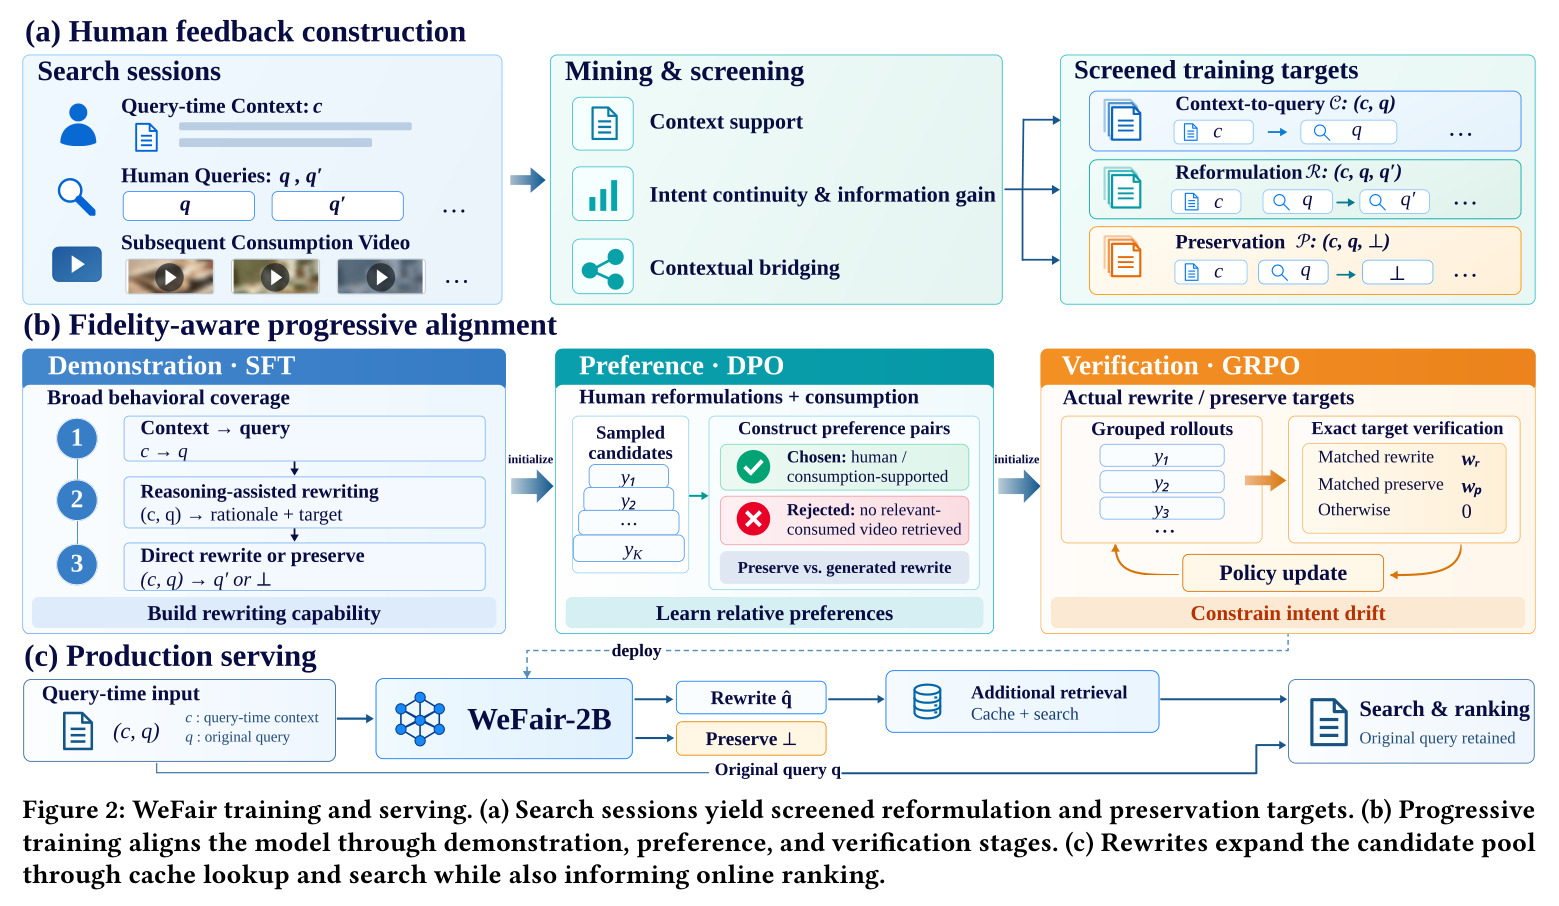
不单独训练奖励模型,直接用 chosen-rejected 偏好对提高被偏好回答的相对似然。本文偏好对来自后续消费反馈:chosen 候选的检索 top-10 中至少命中一个用户后续有效观看(超 10 秒)的视频,rejected 候选的 top-100 中一个都不命中,人工改写 $q'$ 也直接作为正例。
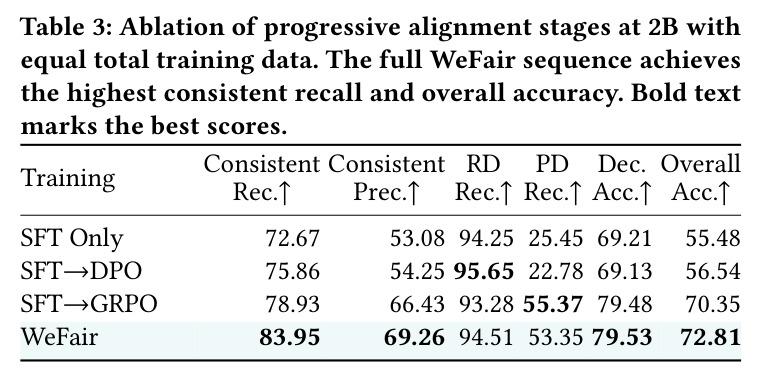
DPO 是三阶段的中间层,消融显示它单独增益小(55.48%→56.54%)但为最终 GRPO 铺路,是论证阶段间交互的关键一环。
GRPO(组相对策略优化)
对每个输入采样一组候选(本文 32 条),用组内相对优势做策略梯度更新,无需价值网络。本文配置:AdamW、学习率 $5\times10^{-7}$、KL 系数 0.02、温度 1.2,奖励为与人工目标的精确匹配(改写命中 $w_r=2$、保留命中 $w_p=0.5$、其余为 0)。
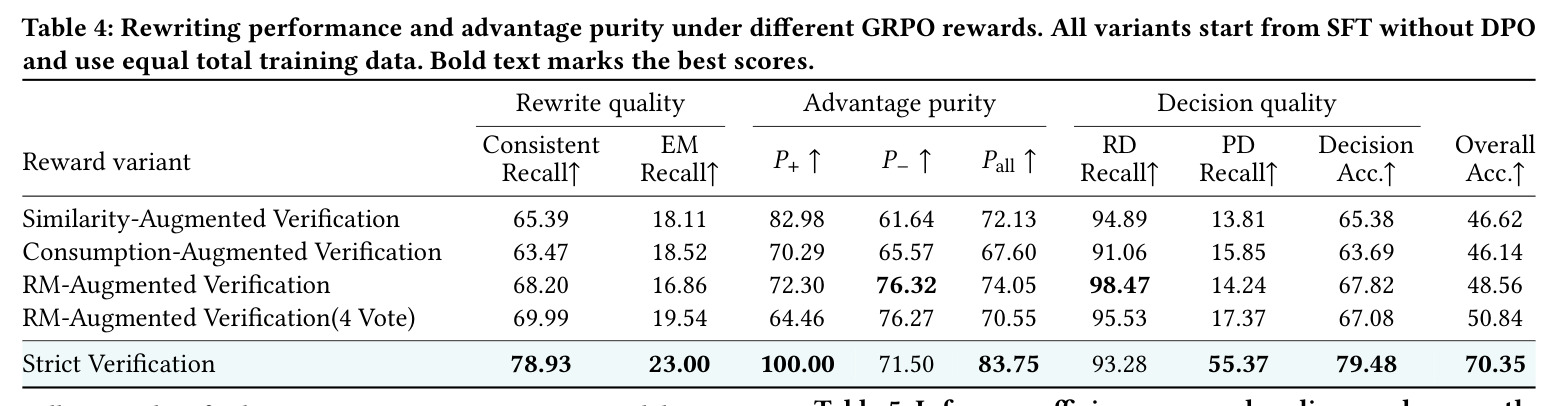
GRPO 是最后的验证阶段,其奖励设计的保真度是本文核心实验(Table 4 优势纯度分析)的载体。
优势纯度(Advantage Purity)
本文提出的诊断量:用 LLM 裁判判定 GRPO 组内每个候选是否正确,统计正优势候选中判对的比例 $P^+$(被鼓励的是否真的好)和负优势候选中判错的比例 $P^-$(被打压的是否真的差),加权得 $P_{all}$,衡量训练信号本身的可靠性。
严格验证奖励 $P^+=100\%$ 而辅助奖励只有 64%-82%,这是论文论证最后阶段必须严格保真的关键量化证据。
研究动机
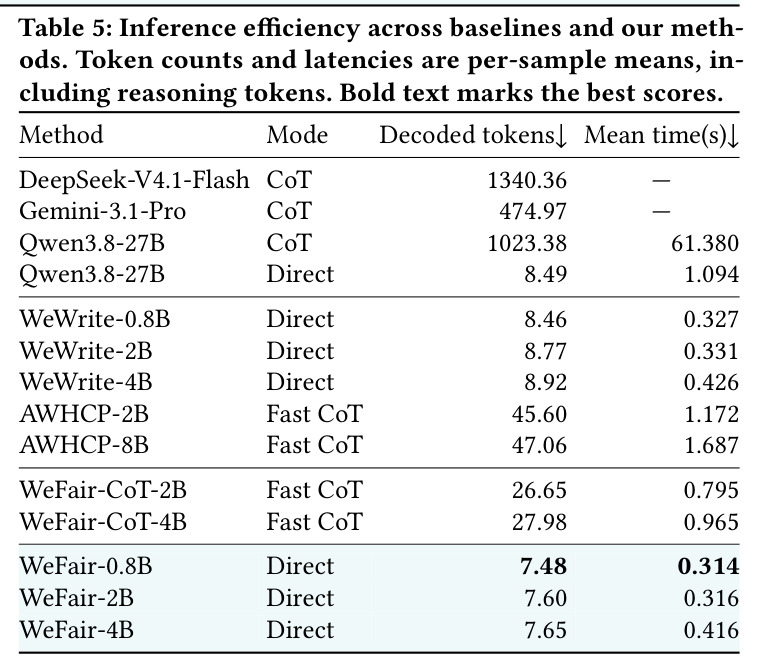
微信短视频搜索中,用户 query 往往极度含糊(如 anggwe、教育号),必须结合查询时刻上下文改写才能召回正确内容。工程上存在两难:通用大模型(DeepSeek-V4.1-Flash、Gemini-3.1-Pro、Qwen3.8-27B)推理能力强但带完整 CoT 的解码延迟不可接受——实测 Qwen3.8-27B 开 CoT 平均解码 1023.38 个 token、单样本 61.38 秒,无法用于实时搜索;而把大模型蒸馏到小模型后,业界普遍再用后续消费反馈(点击、观看)做对齐,但消费参与度不等于即时需求:历史里看过菜谱教程的用户搜 crepe cake 时,模型可能改写成 how to make crepe cake 去检索菜谱,而非用户此刻想看的吃播视频——这就是意图漂移。在作者统一复现的离线评测中,这类消费导向方法的 2B 模型 WeWrite 意图漂移率高达 16.45%、幻觉率 6.39%,整体准确率仅 47.28%,另一复现基线 AWHCP-8B 也只有 50.41%。
本文的目标是目标是训练一个紧凑(0.8B-4B)的个性化改写模型,在严格延迟约束(线上单样本约 0.3 秒、P95 推理 81 毫秒)下同时完成两件事:其一,当上下文明确支持补全、纠错或个性化时,生成有据可依的改写 $\hat{q}$;其二,当改写缺乏查询时刻证据时输出保留标记 $\bot$,让系统只用原始 query——即同时优化改写质量与改不改的决策。模型需上线微信短视频搜索主链路,服务每天超过 1 亿次 query,并在点击率、有效播放率等业务指标上取得统计显著的正收益。
与已有工作不同的是,已有工作证明真实用户改写(后续 query)比合成推理更有价值:PicQue 用人工核验的历史改写构造训练例,WeWrite 直接把挖掘的改写用于 SFT 和 GRPO 奖励构造。但它们把各类人类反馈当作同质信号使用,没有回答一个关键问题:上下文-查询日志、真实改写、后续消费这些信号反映个性化意图的直接程度(保真度)差别巨大,应如何在训练阶段间分配使用,此前一直未被系统研究。本文的独特切入是保真度感知对齐:宽而低保真的监督适合能力获取(SFT),中等保真的消费偏好适合候选筛选(DPO),严格精确匹配的验证才配得上最后的在策略优化(GRPO),并用消融实验和优势纯度分析系统验证这一匹配原则。
核心方法
直觉上,训练小改写模型如同教徒弟:先广泛见世面(大量上下文-查询对建立改写手感),再看带反馈的案例学偏好(哪些改写用户真的买账),最后用标准答案严格把关(与用户真实改写逐字对齐)。技术路线分三块:(1) 数据构建——从搜索会话挖掘三个监督池:上下文-查询池 $\mathcal{C}$(150 万条)、改写池 $\mathcal{R}$(13.8 万条)、保留池 $\mathcal{P}$(46.1 万条),经规则过滤和两级 LLM 多数票筛查提纯;(2) 三阶段渐进对齐——课程 SFT(C2Q→CoT→直接预测)建立能力,DPO 用消费反馈偏好对学相对好坏,GRPO 用与人工目标精确匹配的验证奖励收敛;(3) 线上集成——改写结果走缓存召回加轻量向量召回扩池,排序侧按首 token 保留概率门控融合原 query 与改写 query 的相关性,整体避免显式 CoT 以满足实时延迟。
核心创新是把监督保真度作为一等地设计原则,与各训练阶段的能力需求相匹配。与 WeWrite、AWHCP 等把语义相似度、消费信号、奖励模型等辅助奖励混入最终 RL 阶段不同,WeFair 论证:SFT 可容忍低保真的宽覆盖数据(150 万条 C2Q 对),因为此时只需建立改写能力;DPO 可引入由后续消费推断的相对偏好(chosen 候选检索 top-10 命中用户后续有效观看视频、rejected top-100 全不命中),因为它只学相对好坏;而 GRPO 必须严格锚定在筛查过的人工改写或保留目标上——任何偏离目标的辅助奖励都会降低优势纯度(严格验证 $P^+=100\%$、$P_{all}=83.75\%$,RM 辅助奖励仅 $P^+=72.30\%$、$P_{all}=74.05\%$),并显著损害保留能力。配套防 reward hacking 设计:因输出保留标记远比精确改写容易,模型可能过度保留,作者用改写/保留数据比例和非对称奖励 $w_r=2 > w_p=0.5$ 加以抑制。
方法步骤详情
数据构建:抽取带有效观看(>10 秒)的上下文与 query 构成 $\mathcal{C}_0$;同会话相邻 query(无点击→有效观看)构成改写候选。规则过滤(含 $J(a,b)\le 0.06$ 等四条规则)约砍掉一半;再经两级多数票检验 $I$(意图延续)、$G$(信息增益)、$B$(上下文桥接),约三分之一通过。保留标签含自然样本与困难样本(被桥接否决,教模型拒绝无据个性化)。课程 SFT:C2Q(150 万条)→ CoT(Gemini 推理链)→ 直接预测,目标 $\mathcal{L}^{(k)}_{\mathrm{SFT}}=-\mathbb{E}[\log\pi_\theta(v|u)]$。DPO:每输入采 64 候选构两个偏好对(人工改写或消费支持候选为正),保留样本配 $(x,\bot,y^-)$。GRPO:每输入采 32 条,精确匹配人工改写给 $w_r=2$、精确保留给 $w_p=0.5$,否则 0。线上集成:改写走缓存+向量召回,排序按 $p_{pres}(x)$ 与 $\tau_{rank}=0.06$ 门控融合原 query 与改写相关性。
技术新颖性
技术新颖性有四点:(1) 概念层面首次把保真度显式建模为监督信号选择的第一维度,给出宽监督利课程 SFT、严验证利在策略对齐的可迁移结论,并提出优势纯度 $P^+,P^-,P_{all}$(式 (4))把训练信号可靠性变成可测量的诊断量;(2) 数据层面用被桥接检验否决的改写候选反向构造困难保留样本,直接针对无据个性化错误训练,同时从 $\mathcal{C}_0$ 中剔除自然保留样本避免标签冲突;(3) 阶段间存在非平凡交互:完整课程 SFT 比只学人工目标高 8.32 个百分点整体准确率,SFT→DPO→GRPO 全序列(72.81%)优于 SFT→GRPO(70.35%),说明消费偏好层的价值超出其直接增益,为 GRPO 提供了更好的起始策略;(4) 工程层面用首 token 保留概率同时服务排序门控($\tau_{rank}=0.06$)与奖励黑客抑制($w_r=2$ 对 $w_p=0.5$),把改写模型无缝嵌入检索与排序链路且几乎不增加端到端延迟。
实验结果
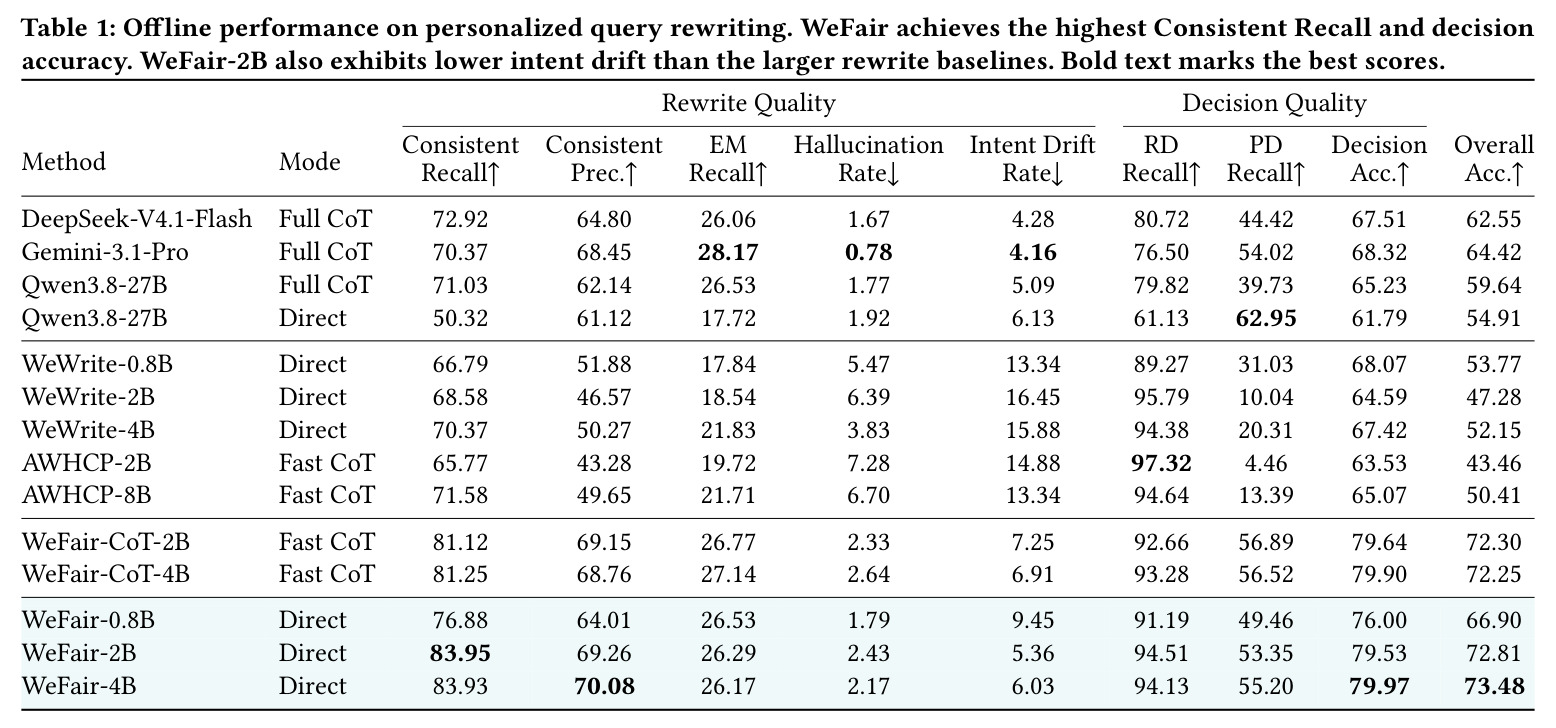
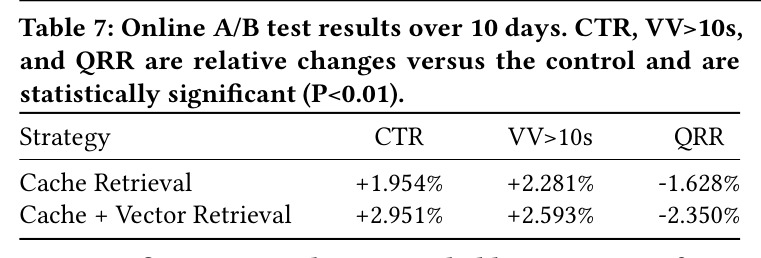
离线(Table 1,19696 条测试集):WeFair-2B 整体准确率 72.81%、一致召回 83.95%,超 Gemini-3.1-Pro(64.42%)约 8 个百分点,远超同规模基线(WeWrite-2B 47.28%);幻觉率 2.43%、漂移率 5.36%,为 WeWrite-2B(16.45%)的三分之一。缩放:0.8B→2B +5.91、2B→4B 仅 +0.67,直接模式优于 CoT 变体。消融:完整课程 SFT 55.48% 优于仅人工目标 47.16%;SFT→DPO→GRPO→全序列为 55.48%→56.54%→70.35%→72.81%。奖励纯度:严格验证 70.35% 远高于辅助奖励的 46.14-48.56%。效率(Table 5):直接模式仅 7.60 token、0.316 秒;裁判与人工一致率 96.6%。在线(Table 7):10 天 A/B 缓存+向量策略 CTR +2.951%、VV>10s +2.593%、QRR −2.350%(P<0.01),P95 推理 81 毫秒,已上线日均 1 亿+ 查询。
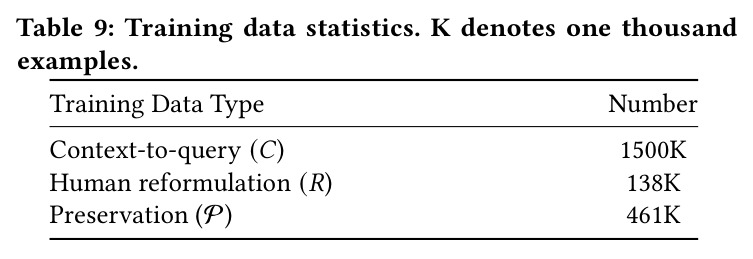
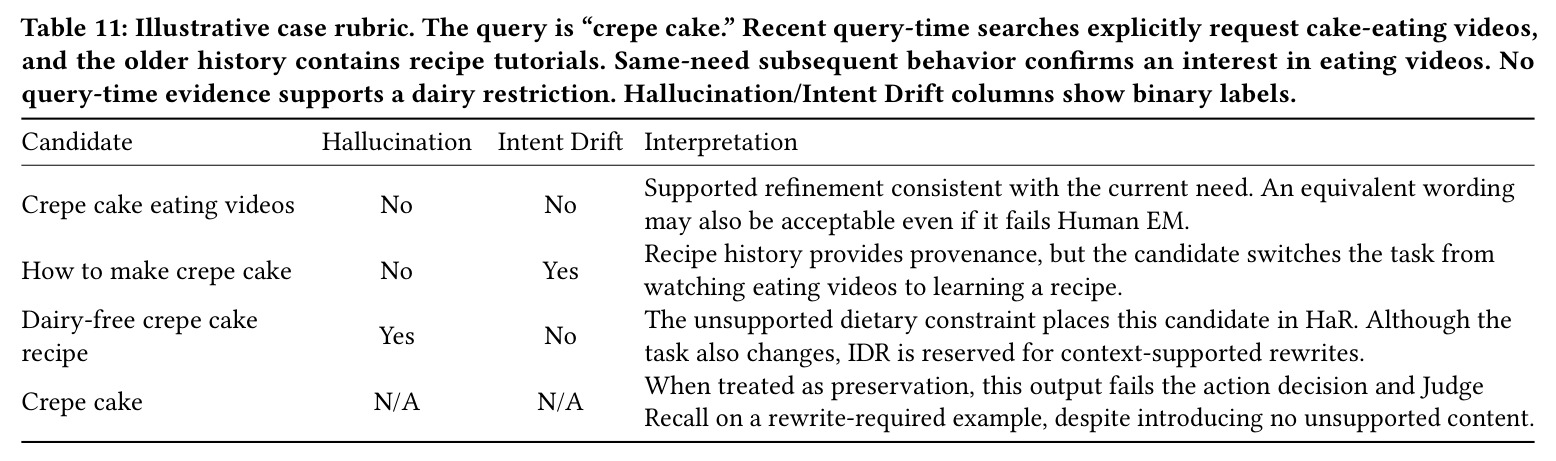
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 离线个性化查询改写(19696 条测试集) | 整体准确率 Overall Acc(%) | 72.81(WeFair-2B)/ 73.48(WeFair-4B) | 64.42(Gemini-3.1-Pro,最强基线);47.28(WeWrite-2B,同规模);50.41(AWHCP-8B) | 较最强基线 +8.39 个百分点,较同规模基线 +25.53 个百分点 |
| 改写一致性 | Consistent Recall(%) | 83.95(WeFair-2B) | 72.92(DeepSeek-V4.1-Flash);68.58(WeWrite-2B) | +11.03 个百分点 |
| 意图保真 | Intent Drift Rate(%,越低越好) | 5.36(WeFair-2B) | 16.45(WeWrite-2B);13.34(WeWrite-0.8B 与 AWHCP-8B) | 降至可比基线的约三分之一 |
| GRPO 奖励设计消融(2B,等量训练数据) | 整体准确率(%) | 70.35(Strict Verification,$P^+$=100%、$P_{all}$=83.75%) | 48.56(RM 辅助奖励);46.62(相似度);46.14(消费反馈) | +21.79 个百分点 |
| 在线 A/B 测试(10 天,微信短视频搜索) | CTR 相对变化(%) | +2.951(缓存+向量检索策略);+1.954(仅缓存) | 线上对照组为 WeWrite 系统 | 统计显著(P<0.01) |
| 在线 A/B 测试 | VV>10s 有效播放率相对变化(%) | +2.593(缓存+向量);+2.281(仅缓存) | 同上 | 统计显著(P<0.01) |
| 在线 A/B 测试 | QRR 查询改写率相对变化(%) | −2.350(缓存+向量);−1.628(仅缓存) | 同上 | 改写率下降意味着更多 query 无需二次改写即满足需求 |
| 推理效率(单卡 H20,批量 1) | 平均解码 token 数 / 单样本时延 | 7.60 token / 0.316 s(WeFair-2B 直接模式) | 26.65 token / 0.795 s(WeFair-CoT-2B);8.49 token / 1.094 s(Qwen3.8-27B 直接) | 较 CoT 变体 token −71.5%、时延 −60.3% |
局限与改进
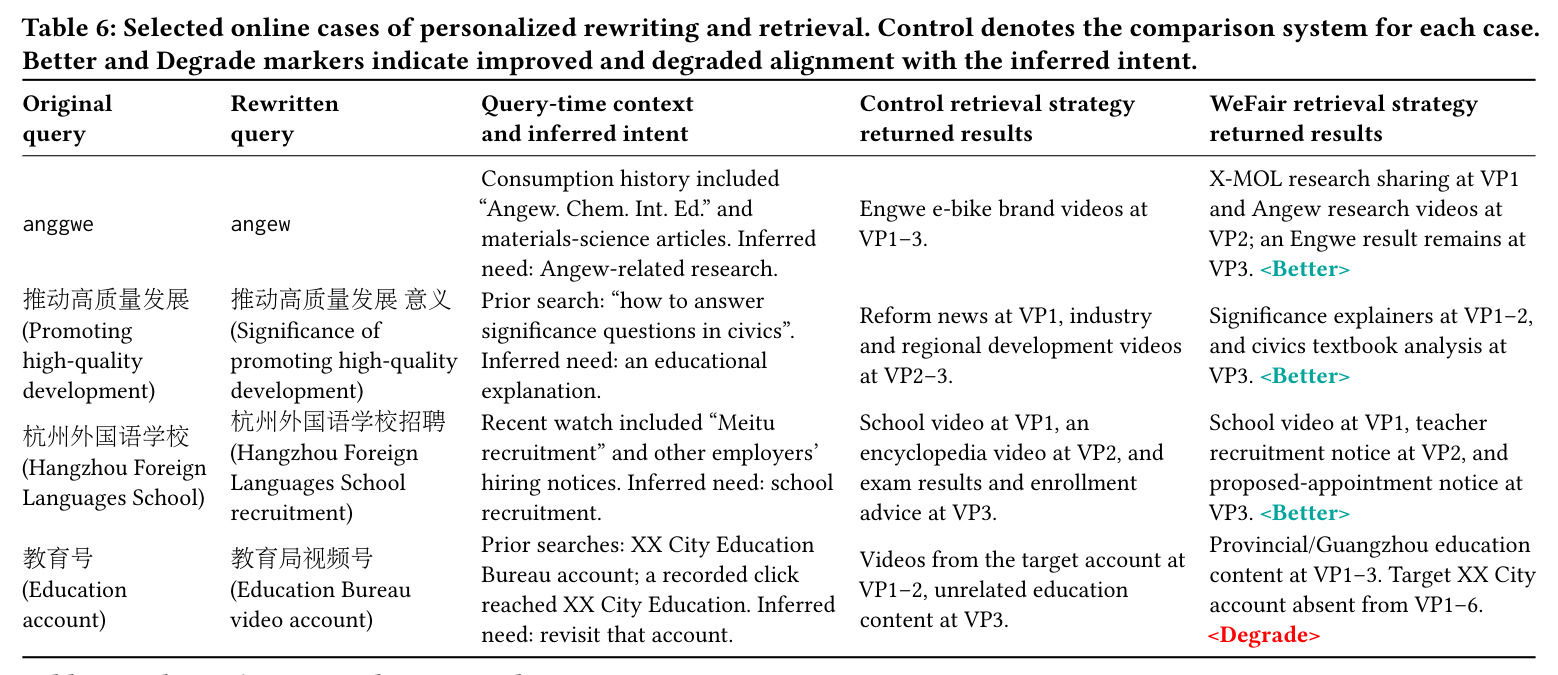
作者承认的局限:严格验证的负优势纯度($P^-=71.50\%$)低于 RM 增强变体(76.32%),说明精确匹配会错杀语义等价的正确改写;EM 指标天然严格,忠实但措辞不同的改写会被判失败。我补充的观察:(1) 线上退化案例(教育号→教育局视频号丢失限定词 XX市)暴露改写可能丢关键约束,而验证奖励只奖精确匹配、对部分正确没有梯度;(2) 评测裁判 DeepSeek-V4.1-Flash 与数据筛查模型同源,测试集又走与训练相同的过滤管线并经人工复核,可能存在系统性偏好;(3) 数据管道依赖多家商业大模型(Gemini-3.1-Pro-Preview 生成推理链、六个大模型分担两级多数票筛查),成本高且可复现性受限;(4) 优势纯度仅在 500 条采样上估计,统计功效有限;(5) 时延在单卡 H20 批量 1 的离线环境测得,与线上 16×L20、P95 81ms 的真实系统条件不同;(6) 结论绑定中文短视频场景与微信上下文字段,跨语言跨平台未验证;DPO 构造中缺失反馈样本被直接排除,可能引入幸存者偏差;意图漂移与幻觉按互斥类别统计(附录 A.5),复合错误会被归入单一天花板。
独立分析的弱点
(1) 精确匹配验证过于保守:$P^-$ 仅 71.5%,意味着近三成被打压的候选其实是对的(同义改写),改进方向是等价类验证——多参考答案、语义等价判定或对非精确候选给分级小奖励,但需监控纯度损失防止重蹈辅助奖励覆辙;(2) 验证奖励与端到端检索效果脱节:奖励是文本精确匹配而非召回/排序质量,可在严格验证为主的前提下,把 $r_{\mathrm{fused}}$ 相关性或滞后消费结果作为极低权重的检索接地信号;(3) 上下文推理会丢限定词(Table 6 退化案例),可加入实体覆盖约束解码或约束保持性校验头,在生成时强制改写保留原 query 中的关键实体;(4) 阈值 $\tau_{rank}=0.06$ 与奖励权重 $w_r=2,w_p=0.5$ 均为手工设定,可按查询类型/上下文置信度自适应校准保留概率;(5) 冷启动用户上下文稀薄时模型几乎必然输出保留,个性化能力无从发挥,可引入跨会话长期兴趣记忆并显式标注证据强度;(6) 困难保留样本只来自被桥接否决的候选,分布偏窄,可用对抗生成主动构造诱人但无据的改写来增强拒写能力。
未来方向
作者在结论中暗示的方向是把保真度与阶段匹配的原则推广到更广的搜索/推荐后训练场景。基于本文成果可延伸:(1) 分级验证奖励,在保持高 $P^+$ 的同时用等价表述参考集缓解 $P^-$ 损失,让验证既严格又不失弹性;(2) 与排序、召回端到端联合优化,让最终奖励从文本对齐进化为检索效果对齐,同时用纯度诊断守住信号质量;(3) 在线持续学习:利用线上曝光、改写率(QRR)等实时信号做 bandit 式更新,替代离线周期性重训;(4) 把 $p_{pres}$ 从硬阈值门控扩展为概率化排序特征,与相关性分数统一校准;(5) 多轮会话、语音与多模态查询下的意图漂移建模,处理跨模态的上下文桥接;(6) 本文已证明保真度训练产生隐式推理优于显式 CoT,可进一步把 2B 能力蒸馏到端侧更小模型,服务超低延迟或离线场景;(7) 把优势纯度作为通用工具发布,用于诊断任意 RLHF 管线的训练信号可靠性。
复现评估
论文未开源代码与数据。训练数据是微信短视频四周搜索日志(脱敏),外部无法获得;数据构建依赖 Gemini-3.1-Pro-Preview、DeepSeek-V4-Flash、Gemini-3.5-Flash、GLM 5.2、Qwen3.5-397B-A17B 等大规模模型的多数票筛查,附录 A.2 因隐私扣留部分管线细节。可复现部分:底座 Qwen3.5-0.8B/2B、Qwen3-4B 公开可得;训练超参完整(SFT 学习率 $5\times10^{-6}$、batch 32;DPO 学习率 $10^{-6}$、$\beta=0.5$;GRPO 学习率 $5\times10^{-7}$、KL 0.02、每查询 32 采样、$w_r=2/w_p=0.5$);提示模板与裁判协议已给出,测试集构造规则明确。复现难度:有类似日志平台与商业 LLM API 的团队可中等难度复现离线结果,2B 级 GRPO 算力适中;在线指标(CTR/VV/QRR、16×L20 部署)学术环境不可复现;核心思想(保真度分阶段匹配、纯度诊断)可在公开数据集上低成本验证。
论文图表
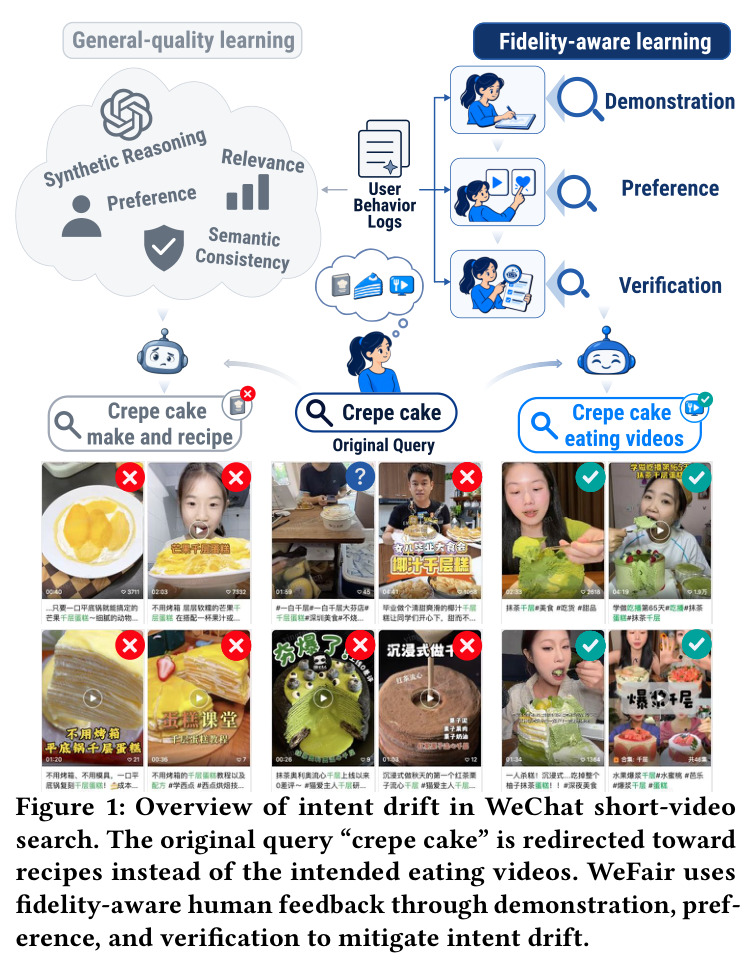
以 crepe cake 为例对比两条路径:泛化质量学习只优化推理相关性、语义一致性等通用指标,受历史菜谱教程影响把 query 改写成菜谱制作方向;保真度感知学习则综合演示、偏好、验证三级人类反馈,把 query 对齐到用户当下想看的吃播视频。
全文动机图,直观定义了意图漂移这一核心问题与 WeFair 的解决思路;crepe cake 例子贯穿全文,附录 Table 11 还用它细致区分幻觉与意图漂移。