EvoWeb:面向演化式 Web 应用的编码智能体评测基准 EvoWeb: A Benchmark for Coding Agents on Evolving Web Applications
用320个带DAG依赖的累积请求,评测编码智能体持续扩展Web应用的集成与保持能力
前置知识
编码智能体(Coding Agent)与 Scaffold
编码智能体是让大模型以循环方式工作的系统:读代码库、改文件、执行命令、观察输出、再迭代修改,直到完成任务。Scaffold(脚手架)是承载这个循环的框架,如 OpenHands,负责提供工具接口、管理上下文、控制轮数预算。论文中每请求最多 20 个 agent turn,仓库与对话历史跨请求持久化。
EvoWeb 评测的对象是智能体而非单次模型调用,理解 turn、持久仓库、上下文压缩这些 scaffold 概念,才能读懂实验设置与'生成努力'(轮数、token 数)的分析。
WebGen-Bench 与浏览器功能测试
WebGen-Bench 是从零生成完整 Web 应用的基准:每个应用规格配一组测试,每个测试形如'执行某个 UI 操作 + 期望某个结果',由 WebVoyager 浏览器智能体在真实浏览器里执行并判分,与人类标注的一致性为 86–94%。EvoWeb 直接复用它的 101 个应用规格作为种子和它的评测协议。
EvoWeb 的种子应用、测试格式、打分方式(YES/PARTIAL/NO)全部继承自 WebGen-Bench,理解前者是读懂后者构造管线的前提。
浏览器智能体(WebVoyager)与 Set-of-Marks
WebVoyager 是端到端网页操作智能体:把页面截图转成 Set-of-Marks 表示(给可交互元素打标签),用 Selenium 实际执行点击、输入等操作,最后根据观察到的结果返回 YES、PARTIAL 或 NO。EvoWeb 用更强的计算机操作模型 Sonnet 4.6 作为其骨干。
EvoWeb 的所有打分都出自这个浏览器判分器,需要知道它只支持点击-输入类交互(论文因此禁止 hover、拖拽、键盘导航等测试),才能理解测试设计的约束与判分误差来源。
功能依赖 DAG
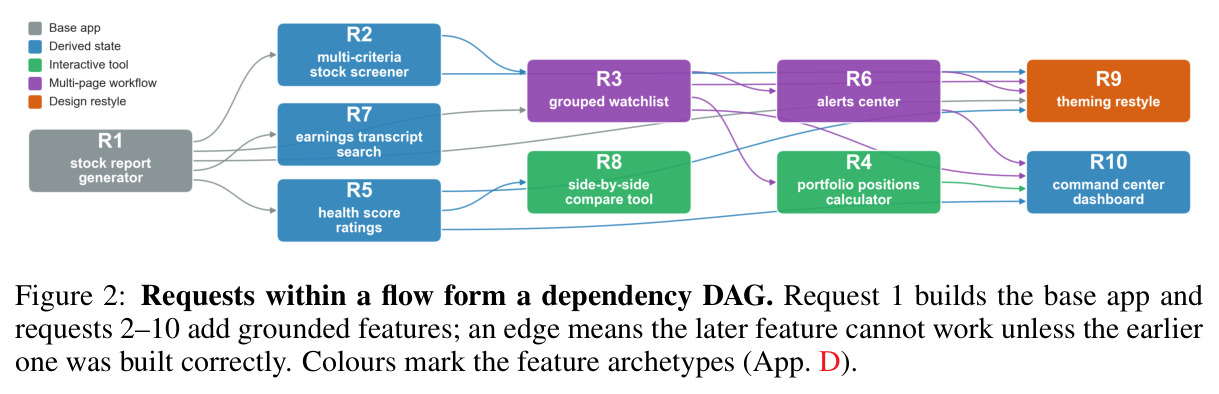
有向无环图,节点是请求引入的功能,边 $i \to j$ 表示请求 $j$ 若缺少请求 $i$ 引入的功能就无法正确实现。节点的深度指指向它的最长依赖链长度,入度指它直接依赖的早期请求数。EvoWeb 要求每条序列至少有一条深度 $\ge 3$ 的链,且 DAG 对被测智能体隐藏。
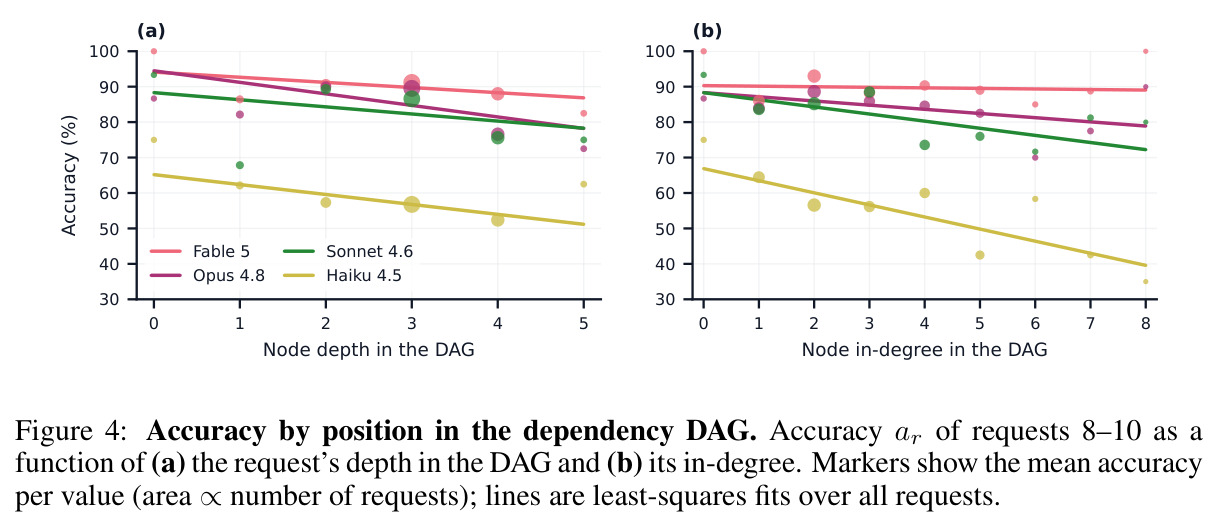
DAG 是本文的核心结构:集成测试沿 DAG 边出题,'依赖越深越难'的分析也以深度和入度为自变量。
LLM-as-Judge 与自我偏好
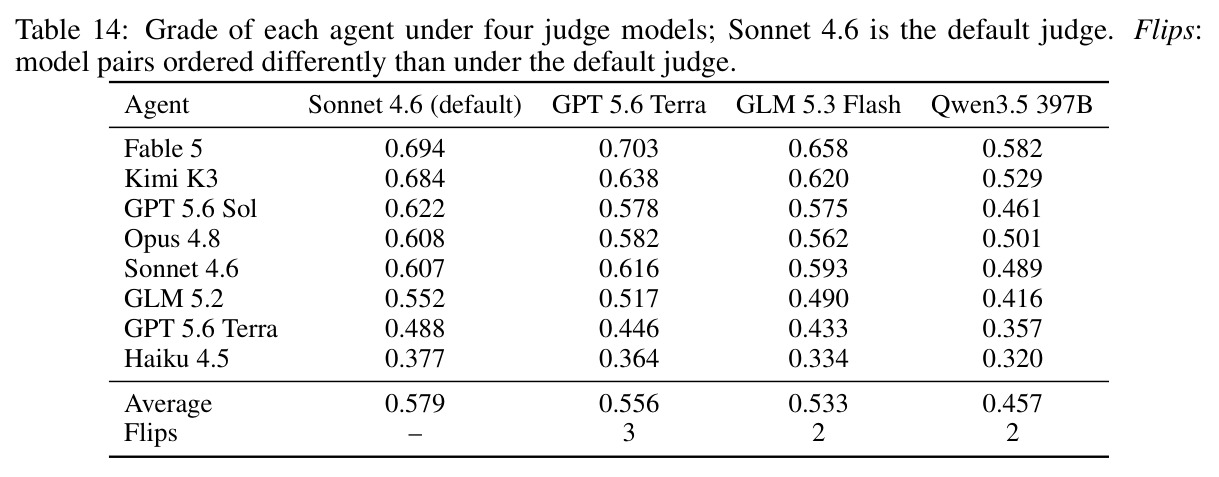
用大模型充当评判者给其他模型输出打分。已知风险是评判者可能偏爱自己(同家族)模型的输出,因此严谨的基准要做换评判者的鲁棒性实验,并用人类标注校验判分一致性。
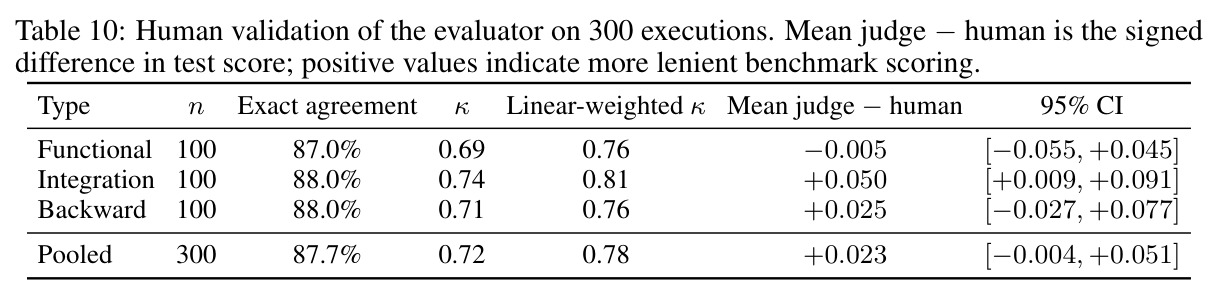
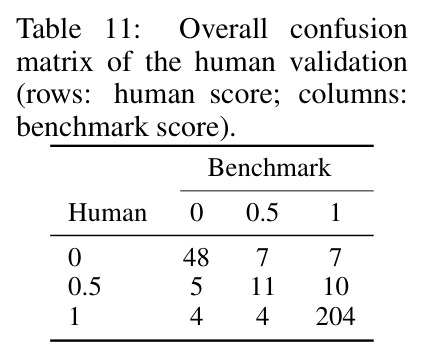
EvoWeb 的判分器是 Sonnet 4.6,而它同时也是被测模型之一;论文用另外 3 家厂商的评判者重评全部运行并做 300 例人类盲测(精确一致率 87.7%,$\kappa=0.72$),证明排名不是评判者造成的。
阈值曲线下面积(AUC)积分指标
把某个随阈值 $t$ 变化的曲线对 $t$ 积分,得到一个不依赖具体阈值选择的汇总分数,这一做法源自选择性预测(selective prediction)等领域的评估传统。
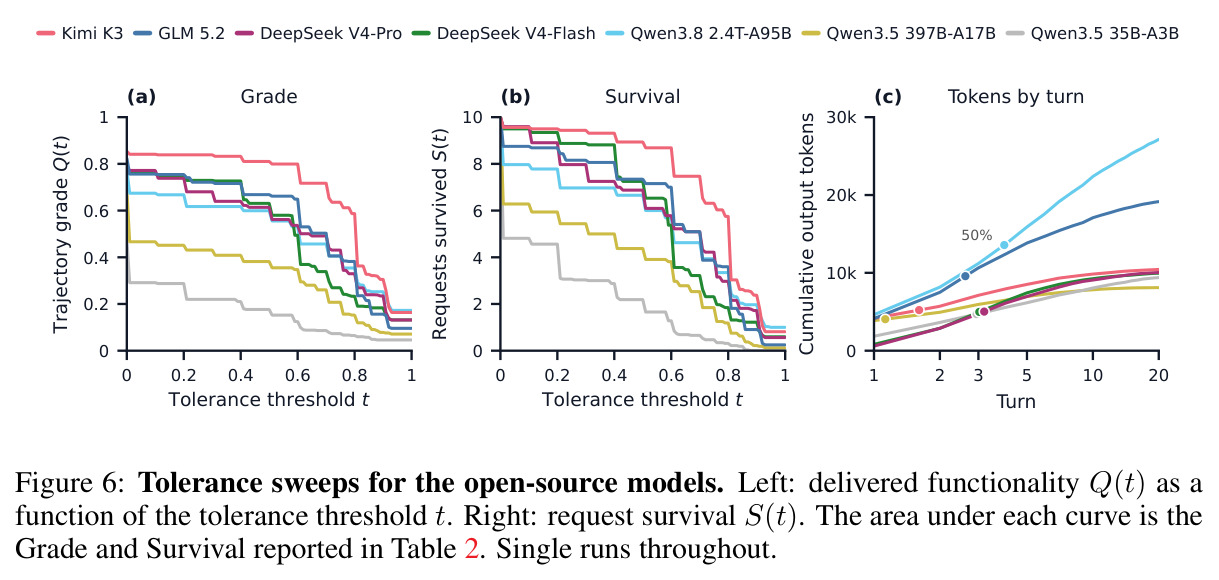
Grade 与 Survival 的定义正是 $\int_0^1 Q(t)\,dt$ 与 $\int_0^1 S(t)\,dt$,其中 $t$ 是'用户容忍度'阈值;不理解 AUC 思路就看不懂主指标为何这样设计。
研究动机
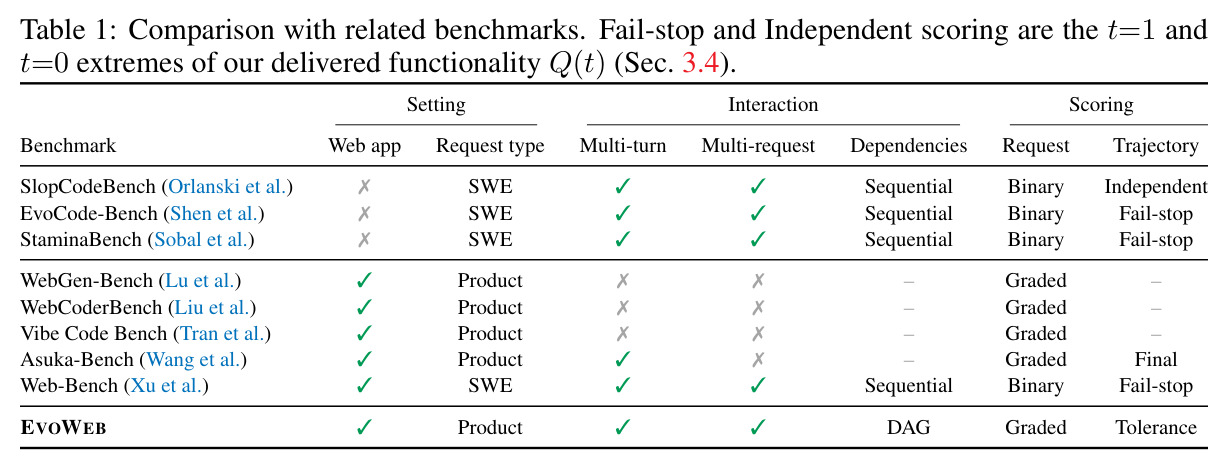
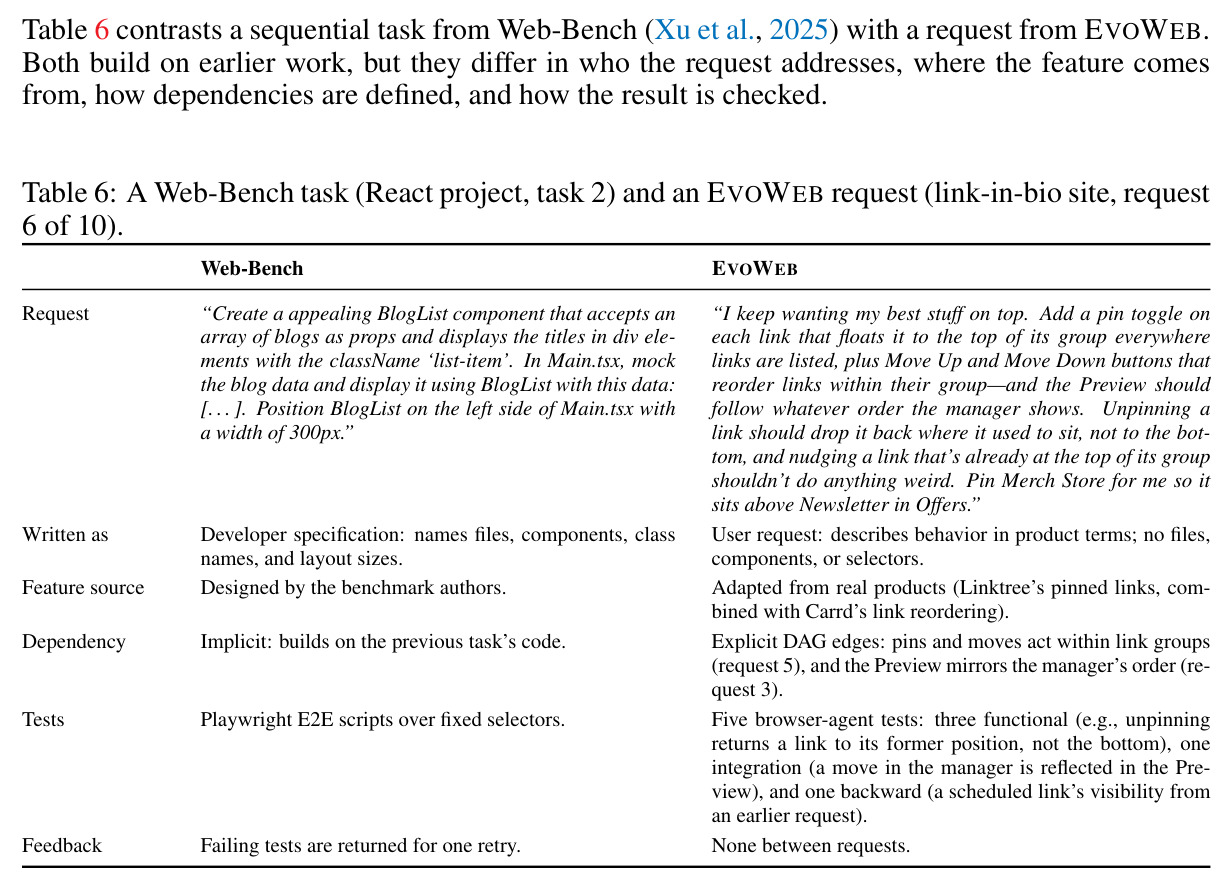
真实世界的 Web 开发很少一次成型:用户先让 Bolt.new、Lovable 这类系统搭出应用,之后不断回来追加功能、修改行为,后续请求往往要依赖此前请求引入的状态、接口和行为——新功能可能单独看没问题,一接入早期功能就失效,甚至破坏原本正常的行为。但 2025–2026 年的 Web 生成基准几乎都在评'从零单请求生成':WebGen-Bench、WebCoderBench、Vibe Code Bench 都只给一条高层规格;WebGen-Agent 和 Asuka-Bench 的多轮交互只是对着固定规格或既有意图反复细化;软件工程侧的 SlopCodeBench、EvoCode-Bench、StaminaBench 虽然研究多请求序列,但面向开发者级 SWE 任务,且用 fail-stop(一次失败即终止)或逐请求独立打分这两种极端用户模型;Web-Bench 的任务则是写死文件名、组件类名和布局尺寸的规格书。没有任何现有基准回答:智能体能否在自己持续构建的应用上可靠地做增量开发——新功能既用上早期功能,又不破坏既有行为。
本文的目标是本文要构建一个专门评测'演化式 Web 应用开发'的基准,并回答一个中心问题:编码智能体在一连串相互依赖的用户请求下,能多可靠地扩展一个持久应用、让不同阶段引入的功能协同工作、同时保持既有行为不回归?具体目标有四:其一,应用与后续请求要有真实依据,功能从真实在线产品中提取而非模型想象,使应用沿可信的产品路径生长;其二,请求序列要长程且相互依赖,最终形成 32 个应用 × 每应用 10 个请求共 320 个累积请求;其三,评测要用当代多轮智能体脚手架在真实浏览器中进行,且测试必须能区分三种能力——实现新请求的功能、交付早前请求的功能、跨请求组合功能;其四,序列评测必须处理'中间失败后用户去留'的问题,指标要覆盖从'失败即放弃'到'永远继续'的整个用户谱系,而不是武断选定一个停止规则。
与已有工作不同的是,独特切入角度有三。第一,把请求间的功能依赖显式建模为有向无环图(DAG):边 $i \to j$ 表示请求 $j$ 没有请求 $i$ 的功能就无法正确实现,要求每条序列含至少一条深度 $\ge 3$ 的依赖链和至少 3 个后续依赖,且 DAG 只用于构造与分析、对被测智能体完全隐藏——这不同于 Asuka-Bench 用 DAG 组织评测标准的做法。第二,每个后续请求固定配 5 个浏览器测试:3 个测新功能、1 个沿 DAG 边测与早期功能的集成、1 个向后重测早期功能,首次把'新功能/保持旧功能/跨请求组合'三种能力分离打分。第三,把'用户容忍度'而非系统属性作为扫描变量:用户在请求得分低于阈值 $t$ 时弃用应用,对 $t \in [0,1]$ 积分得到 Grade 与 Survival,不预设停止规则;$t=1$ 与 $t=0$ 恰好复现既有基准的 fail-stop 与逐请求独立两种范式。此外,所有请求一律用产品语言描述行为、绝不规定实现细节,并以嵌入请求的种子数据保证精确值可测,与 Web-Bench 的开发者规格形成鲜明对照。
核心方法
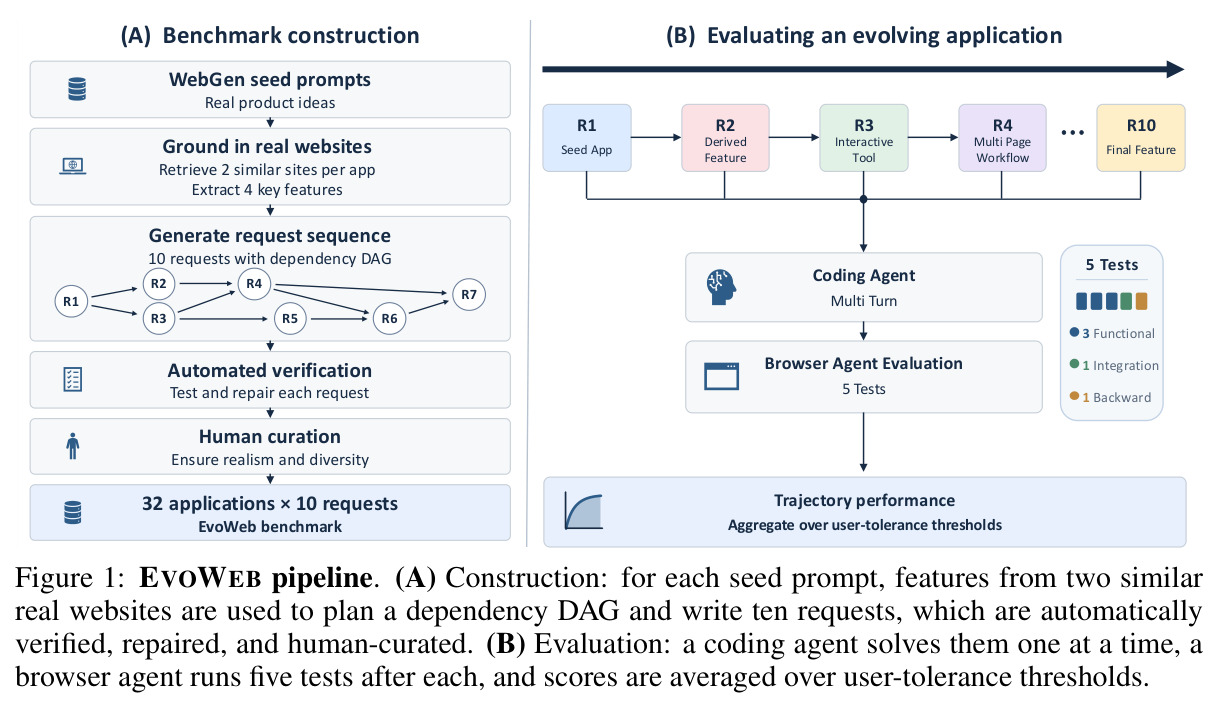
整体直觉是:要测'能不能把应用越做越大',就得让智能体在自己的代码库上接一连串真实用户会提的请求,再用浏览器逐个验收中间产物。技术路线分四步。(1)Grounding:从 WebGen-Bench 的 101 个应用规格中随机抽 40 个作种子,由带网页搜索与抓取工具的 Sonnet 4.6 检索智能体为每个种子找 2 个用途相似的真实网站、各提取 3–4 个种子之外的亮点功能(全程 202 个站点、801 个特征)。(2)生成:Fable 5 生成器依据这些真实功能设计 9 个后续特征,拓扑排序为请求 2–10,同时写出依赖 DAG、每请求 5 个验证测试、全局规则和钉死的种子数据;每个请求还须落进四种特征原型之一。(3)验证与修复:独立的 LLM 验证器按 12 条规则审计,违规给一次修复机会,仍不合格即丢弃;40 个候选淘汰 8 个,剩 32 条轨迹再经人工校准。(4)评测:14 个模型在 OpenHands 脚手架中逐请求实现,仓库与对话历史跨请求持久化、每请求最多 20 轮;WebVoyager(Sonnet 4.6 骨干)在隔离的无头浏览器中执行 5 个测试并打 YES/PARTIAL/NO。三个设计原则贯穿始终:真实(grounding 于真实产品)、累积(长程相互依赖)、智能体化(多轮交互式脚手架)。
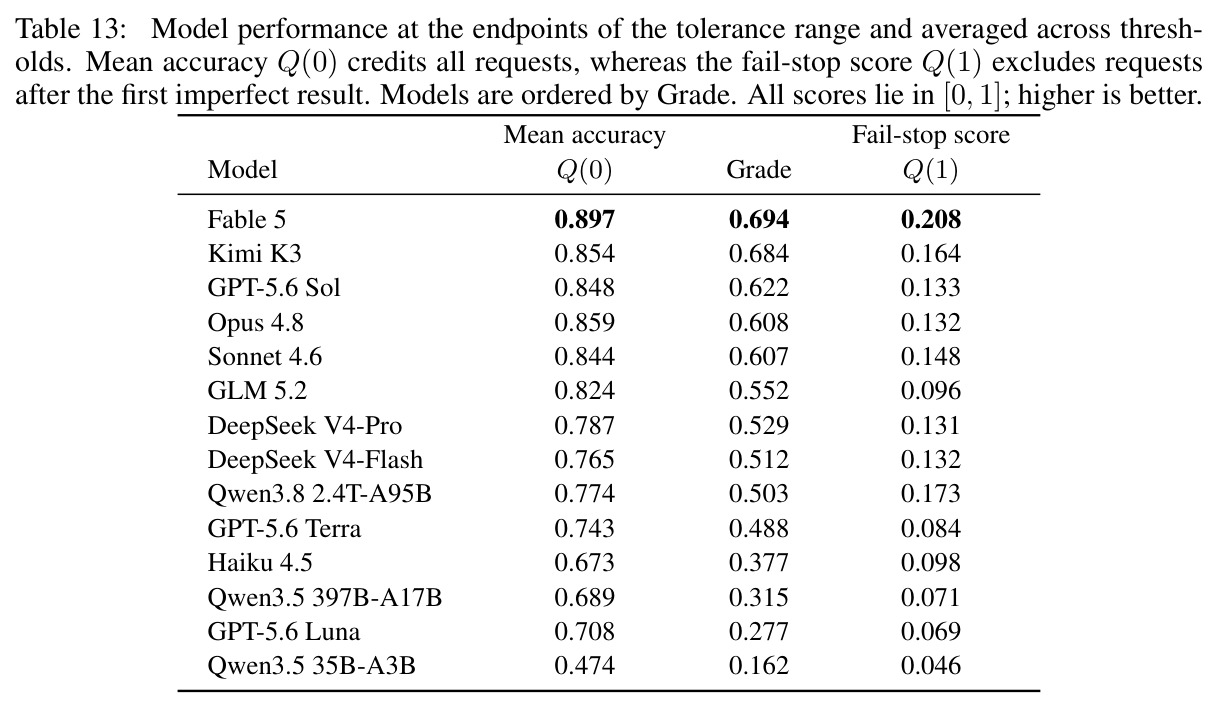
核心创新是'依赖结构 + 分层测试 + 容差积分'三位一体的评测设计。与已有工作的本质区别在于把'演化'本身当作被测对象:WebGen-Bench 只测单请求生成(选模板再生成两阶段),Asuka-Bench 的迭代是向预定义规格收敛,StaminaBench 等 fail-stop 范式把序列信息全部丢弃。具体地:其一,DAG 边要求'实质性'依赖——仅读同一份底层数据不算,必须是缺了早期功能后续请求就无法正确工作,且依赖要'公平',只经由早期请求明确要求的用户可见行为,保证早期请求的任何合法实现都能支撑后续请求;其二,每请求 5 测试的固定结构(3 功能 + 1 集成 + 1 向后)中,集成测试沿一条 DAG 边行动于早期功能并验证其效果正确出现在新功能里,直接测量跨请求组合;向后测试从早期请求逐字复制,用于近似回归检测;其三,引入阈值 $t$ 下的门控 $g_r(t)=\mathbf{1}[\min_{j \le r} a_j \ge t]$ 后,交付功能 $Q(t)=\frac{1}{R}\sum_r g_r(t)\,a_r$ 与存活 $S(t)=\sum_r g_r(t)\,\mathbf{1}[a_r \ge t]$ 对 $t$ 积分得 Grade 与 Survival,闭式为 $\text{Grade}=\sum_r \frac{1}{R} a_r m_{r-1}$($m_r=\min_{j \le r} a_j$),把'用户何时弃用'从评测假设变成被积的连续谱系。
方法步骤详情
完整流程如下。第一步 grounding(输入:种子规格;输出:每种子 2 站点 × 3–4 特征的结构化记录):检索智能体执行查询→选站→抓取提特征→落记录四步,特征须可在单页应用实现、属渐进增强、难度有梯度。第二步生成(输入:build prompt + grounding 记录;输出:9 个请求、DAG、45 个测试、全局规则、种子数据):生成器先想象应用长成的大产品,将 9 个特征拓扑排序为请求 2–10;每请求必须属于四种原型之一——derived state(112 个,39%)、multi-page workflow(77 个,27%)、interactive tool(67 个,23%)、design restyle(32 个,11%);第 2 或 3 个请求钉入 5–8 条精确记录的种子数据,使后续 derived-state 请求能出精确值测试;每条流引入 3 条此后不再复述的全局规则,靠后续测试静默检查。第三步验证:验证器只读生成序列,审计 12 条规则(测试结构、DAG 合法性与公平性、用种子记录重算精确值、实现无关性、可行性等),失败给一次修复。第四步评测:智能体逐请求修改持久仓库、请求间无任何测试反馈;每请求后浏览器判分器执行 5 个测试,分数 $s_{r,k} \in \{0, \tfrac{1}{2}, 1\}$,请求精度 $a_r = \frac{1}{n_r}\sum_k s_{r,k}$,再由式 (1)(2) 计算 $Q(t)$、$S(t)$ 及 Grade、Survival。
技术新颖性
技术新颖性可从四个维度分析。数据构造上,'真实产品 grounding + 依赖 DAG + 钉死种子数据'的组合是新的:grounding 使请求不至于坍缩成同一批通用功能——消融实验显示 4-gram 重叠降低 29%,三名不同厂商的评判者盲测偏好 grounded 版本 69.2–74.2%(95% 区间均高于 50%);钉死 5–8 条记录让 derived-state 请求可出精确值测试,杜绝含糊判分。测试设计上,集成测试首次直接沿依赖边测量功能组合,此前工作要么没有依赖结构、要么只是顺序排列;测试强制实现无关(只引用请求明确要求的元素与值),并针对浏览器判分器的能力约束了交互形式(禁 hover/拖拽/键盘,约 6 步内完成,所需数据一律以种子形式嵌入请求而非让判分器现场搭建)。指标上,容差积分把序列评测中被回避的'失败后去留'显式建模:端点 $Q(1)$ 与 $Q(0)$ 恰好复现 fail-stop 与逐请求独立两种既有范式,积分后成为连续谱系上的汇总,且论文证明任意加权下分数必落在 $[Q(1), Q(0)]$ 之间。协议上,全程无请求间反馈,使每个请求同时考察'维持已有成果'的能力,这是与允许失败重试的 Web-Bench 的关键差异。
实验结果
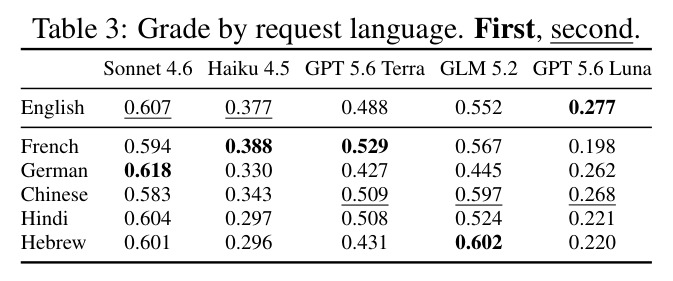
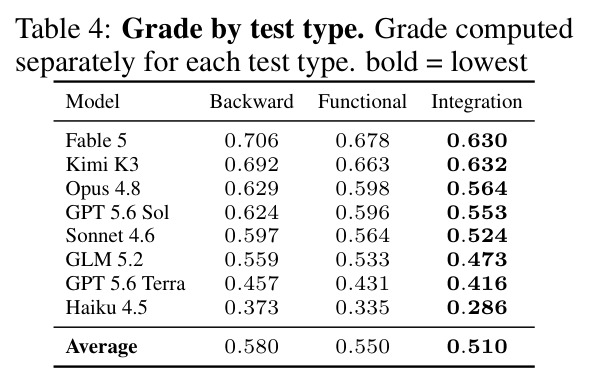
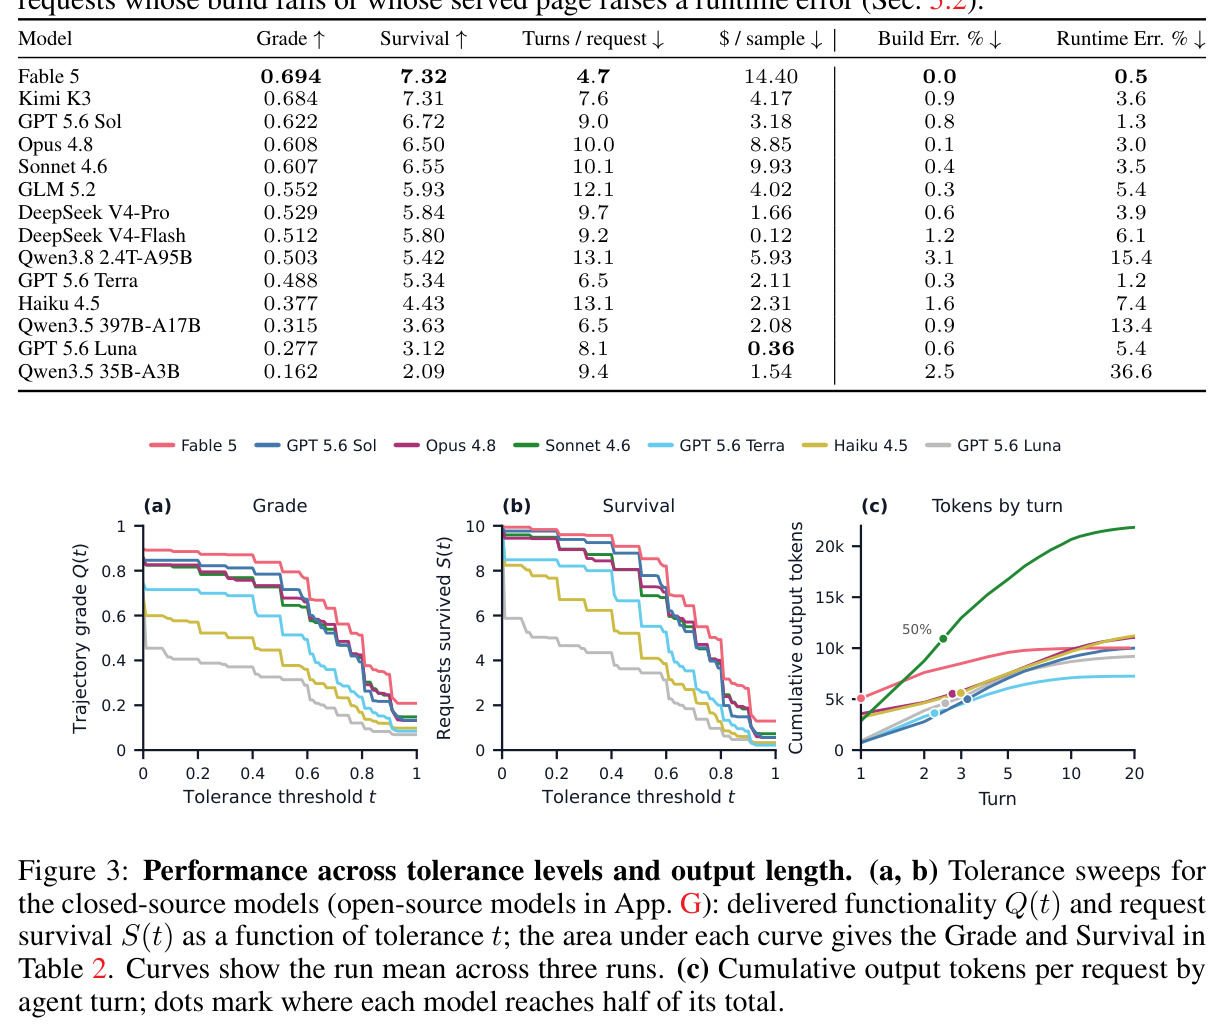
在 320 个请求上评测 14 个模型,核心发现有六。其一,头部与尾部差距巨大:Fable 5 以 Grade 0.694 居首(Survival 7.32/10),Kimi K3 以 0.684 紧随(0.010 差距在三次运行的噪声内,论文不做排序),GPT 5.6 Sol 0.622,最弱的 Qwen3.5 35B-A3B 仅 0.162;最佳模型也只能存活约 7.3/10 个请求。其二,跨请求集成是最薄弱环节:按测试类型分别计算 Grade,所有模型无一例外呈 backward > functional > integration 的次序,模型平均从 0.580 降至 0.550 再到 0.510。其三,依赖越深越难:对请求 8–10,精度随 DAG 深度和入度单调下降(图 4 中所有模型的最小二乘拟合线斜率为负)。其四,运行时可靠性随演化恶化:runtime error 率与 Grade 的 Spearman $\rho=-0.72$(build error 仅 $-0.52$),且错误率随请求序号递增;Qwen3.5 35B-A3B build 失败仅 2.5% 但 runtime 错误高达 36.6%,说明模型更能保住'能编译'而非'能运行';工具调用错误与成绩几乎无关($\rho=-0.06$)。其五,高分来自效率而非堆算力:Fable 5 每请求仅 4.7 轮、每条轨迹约 100K 输出 token(少于 Sonnet 4.6 的一半),尽管其单样本成本最高($14.40)。其六,请求语言有影响:把请求译成法/德/中/印地/希伯来语后,只有 Sonnet 4.6 稳定(波动 $\le 0.03$),GLM 5.2 希伯来语反升至 0.602 但德语跌至 0.445,GPT 5.6 Luna 法语 0.198 远低于英语 0.277。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 演化式 Web 应用开发(32 应用 × 10 累积请求) | Grade(容差积分交付功能,0–1) | Fable 5:0.694(最高;Kimi K3 0.684 次之) | Sonnet 4.6:0.607;最弱 Qwen3.5 35B-A3B:0.162 | 比同厂 Sonnet 4.6 高 +0.087(约 14%) |
| 轨迹存活长度 | Survival(可存活请求数,满分 10) | Fable 5:7.32 | Haiku 4.5:4.43;GPT 5.6 Luna:3.12 | 比 Haiku 4.5 多存活约 2.9 个请求 |
| 跨请求集成 vs 新功能/旧功能 | 分测试类型 Grade(14 模型平均) | 集成测试 0.510 | 功能测试 0.550、向后测试 0.580 | 集成比向后低 0.070(约 12%),且在全部 14 个模型上次序一致 |
| 运行时可靠性 | runtime error 请求占比(%) | Fable 5:0.5% | Qwen3.5 35B-A3B:36.6%(其 build error 仅 2.5%) | 最强与最弱相差约 36 个百分点 |
| 生成效率 | 每请求 agent 轮数 / 轨迹输出 token | Fable 5:4.7 轮,约 100K token/轨迹 | Sonnet 4.6:10.1 轮、token 超其两倍;Haiku 4.5 与 Qwen3.8 达 13.1 轮 | 以最少轮数与较少 token 取得最高分 |
| 评测器有效性 | 与人类标签精确一致率 / κ(300 例盲测) | 87.7% / κ=0.72(线性加权 κ=0.78) | WebGen-Bench 协议报告的人类一致性 86–94% | 持平,验证 EvoWeb 判分协议可靠 |
局限与改进
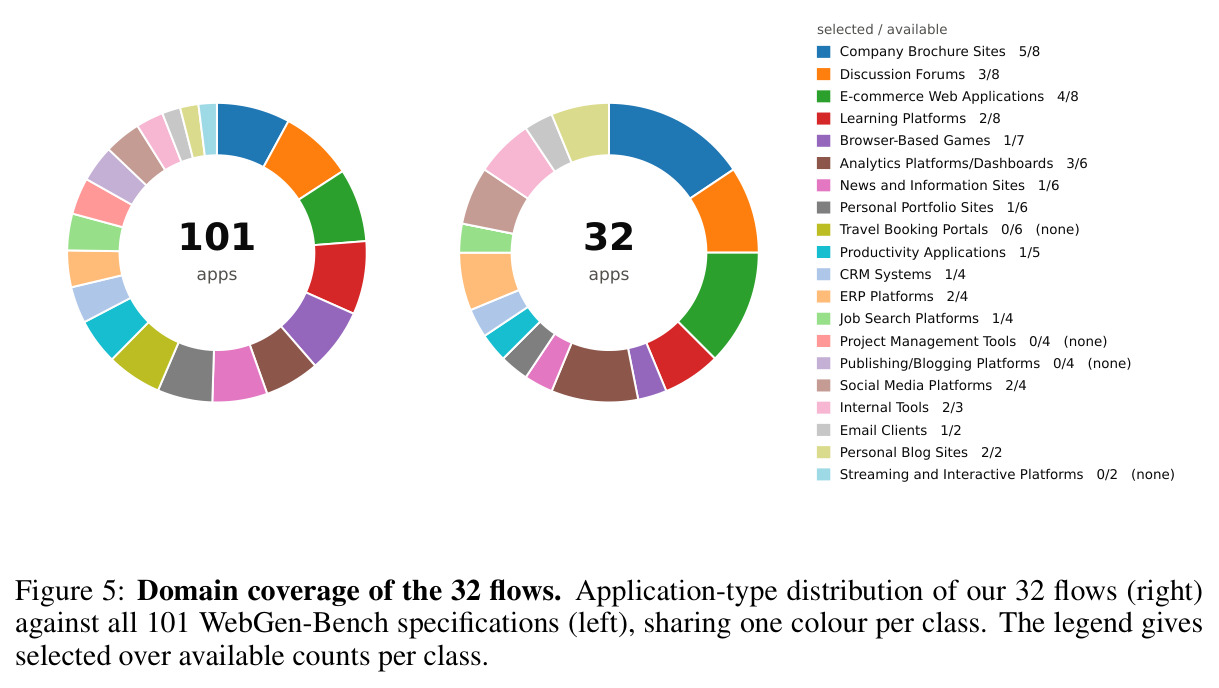
作者承认的局限:基准规模仍小(32 个应用,从 40 个候选淘汰 8 个而来,覆盖 WebGen-Bench 20 个域类中的 16 个);每条轨迹仅 10 个请求;每请求只有 1 个向后测试,是对早期功能的抽样复检而非穷尽回归审计;浏览器评测依赖 LLM 判分器,300 例人类盲测中精确一致率 87.7%、$\kappa=0.72$,且集成测试上判分器比人类宽松 +0.050(95% CI [0.009, 0.091],不含 0);39 例(13%)截图证据不足需人工上站复核,分歧集中于此;闭源模型只跑 3 次、开源模型只跑 1 次,0.01 量级的差距不足以下排名结论;语言与 DAG 分析没有置信区间;PARTIAL 记 0.5 分与均匀积分都是约定而非无假设的汇总。我的补充观察:所有应用都是纯客户端 React + 本地数据,禁止外部 API、认证、实时同步与文件上传,回避了真实演化中最难的后端状态迁移与 schema 演化问题;fail-stop 端点下最强模型也只有 $Q(1)=0.208$(平均精度 0.897),面对'一次不完美就弃用'的用户所有模型几乎不可用;固定 OpenHands 脚手架与每请求 20 轮预算可能系统性不利于某些模型;集成测试沿单条 DAG 边采样,无法覆盖多依赖联合失效的情形。
独立分析的弱点
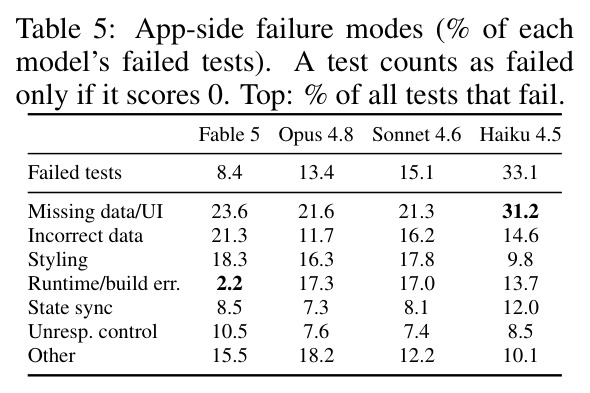
独立分析的弱点与改进方向:(1)回归覆盖稀疏——每请求仅 1 个向后测试,虽然论文数据显示早期通过测试的 94.8% 复检仍通过(5.2% 表观回归),但该估计基于抽样,可改为在每步全量重放早期测试的轻量断言子集,把回归率从'抽样估计'变成'精确测量';(2)应用域受限——纯前端本地数据设定使'missing data/各页各存一份数据'这类失败(占 Haiku 4.5 失败的 31.2%)只能靠前端状态管理解决,扩展到带数据库与 API 的技术栈才能测真实的状态迁移;(3)闭环缺失——智能体拿不到任何测试反馈,无法展示主动修复能力,而向后测试转移数据其实显示 29% 的早期失败会在后续请求中被顺带修好(21% 完全通过),说明模型有潜在自愈能力但当前协议测不到;(4)成本结构——Fable 5 单样本 $14.40,串行评测一个模型约 20 小时、需 6 vCPU 级隔离容器集群,学术组复现门槛高,可发布预计算缓存或更廉价的代理指标;(5)判分器残余偏差——+0.050 的宽松偏移恰好落在最关键的集成测试上,建议对集成测试补充确定性 DOM 断言做交叉验证;(6)每请求只允许一次修复、无请求间反馈,掩盖了 scaffold 级重试策略(如自动重跑失败测试)可能带来的收益差异。
未来方向
作者提出的方向:把轨迹延长到 10 个请求以上,考察更长视野下的性能退化;引入闭环交互,让用户报告失败并请求修复,研究智能体能否在继续演化的同时从错误中恢复。基于本文成果可延伸的方向:(1)把集成测试得分作为强化学习的奖励信号直接优化跨请求组合能力——本文已证明它是与'新功能能力'可分离的短板(0.510 vs 0.550);(2)研究面向演化的记忆与架构机制,例如让智能体在每次请求后维护功能-接口清单或自动生成回归测试套件,并对照本文隐藏的 DAG 验证其有效性;(3)把容差积分框架推广到其他长程智能体评测(多轮安全、长文档任务),因为'用户何时放弃'是普适问题,论文也给出任意加权下 $[Q(1), Q(0)]$ 的界;(4)分析上下文压缩策略(论文交由 OpenHands 处理)对远距依赖的影响——图 4 显示依赖深度直接损害精度,压缩可能是元凶之一;(5)利用 run-to-run 方差数据(Fable 5 的 Grade $\sigma=0.004$ vs Sonnet 4.6 的 0.028)研究输出稳定性与成绩的关系及降温/采样策略;(6)扩展到多用户并发、真实后端与移动端,检验结论的迁移性。
复现评估
复现条件相当友好。开源情况:数据集(全部请求、验证测试、依赖图、固定种子)与智能体运行、评分代码均已公开(论文首页链接),生成器、验证器、grounding 的完整 prompt 附在补充材料中;评测栈全部基于开源的 OpenHands 脚手架、WebVoyager 与 Selenium。数据:32 条轨迹可直接使用,无需重新构造;若要自建,需要 Sonnet 4.6(grounding 检索)、Fable 5(生成)与 LLM 验证器,外加人工校准环节。算力:每模型 320 请求 × 至多 20 轮,外加约 1600 次多步浏览器评测;浏览器验证是 CPU 密集型,单机串行一个模型约 20 小时,论文用 Kubernetes 集群并行 32 条流(每流独享 6 vCPU 的隔离无头浏览器容器),两小时内完成一个模型。API 成本:每样本 $0.12(DeepSeek V4-Flash)到 $14.40(Fable 5)不等,完整评测一个模型的 API 开销约在几十到数千美元量级。难度评级:中等——用官方数据与代码跑评测属于工程活,主要门槛是搭建浏览器集群与支付多模型 API/托管费用;复刻数据构造管线则较难,因为需要人工校准与约 200 次浏览器测试执行的构建期人工审计。
论文图表
14 个模型的完整成绩单:Grade、Survival、每请求轮数、单样本成本、build 错误率与 runtime 错误率。Fable 5(0.694,4.7 轮,0.5% runtime 错误)与 Kimi K3(0.684,$4.17/样本)领先,Qwen3.5 35B-A3B 最弱(0.162,36.6% runtime 错误)。
全文核心结果表,所有后续分析(效率、错误、鲁棒性)都以它为基准。
grounding 消融的盲测偏好:Grok 4.6 偏好 grounded 请求 74.2%、GPT 5.6 Sol 69.6%、Gemini 3.1 Pro 69.2%,95% 区间均高于 50%;另外 grounding 使无关应用间 4-gram 重叠降低 29%。
证明'真实产品 grounding'确实提升了请求真实性与多样性,支撑数据构造管线的关键设计。
数据集统计:32 条应用构建流、每流 10 个请求、每个后续请求 5 个验证测试、每应用平均提取 7.8 个真实功能、平均/最长依赖链为 4.75/6 个请求。
给出基准的规模与依赖深度的一手数字,是复现与比较的基础。
向后测试判定转移:早期通过的测试复检时 94.8% 仍通过、5.2% 变为不通过(表观回归);早期失败的测试有 29.0% 后来改善(21.0% 完全通过),说明失败不必然意味着新引入的回归,也可能随后续开发被顺带修复。
正确解读向后测试的语义与局限(抽样而非穷尽回归审计)离不开这张表。
闭源模型三次完整运行的均值与标准差:Fable 5 最稳定(Grade σ=0.004),Sonnet 4.6 与 Opus 4.8 约 0.025,GPT 5.6 Luna 达 0.043;说明 Table 2 中 0.01 量级的差距(如 Fable 5 vs Kimi K3)在噪声内,而 0.05+ 的层级间差距显著。
所有排名结论的统计前提,避免对微小差距过度解读。