ViewCraft:多模态智能体的证据接口与阅读程序联合演化 VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
冻结模型权重,联合演化多模态智能体「看什么」与「怎么读」,八基准平均提升6.1分
前置知识
技能演化(Skill Evolution)
不更新模型权重,而是通过执行反馈迭代优化可复用的指令、流程或工具调用。代表工作包括 DSPy、GEPA 对复合 LM 程序的提示优化,以及 ADAS、AFlow、AgentSquare 对智能体工作流的搜索。典型做法是在开发集上配对评估候选修改,只保留有效的改动,使冻结的基础模型在新任务上表现提升。
本文把「技能」的范畴从纯文本扩展到可执行的视觉证据接口,理解这一背景才能看清它的定位与差异。
证据接口与阅读程序(技能状态 $w=(\theta,\phi,\psi)$)
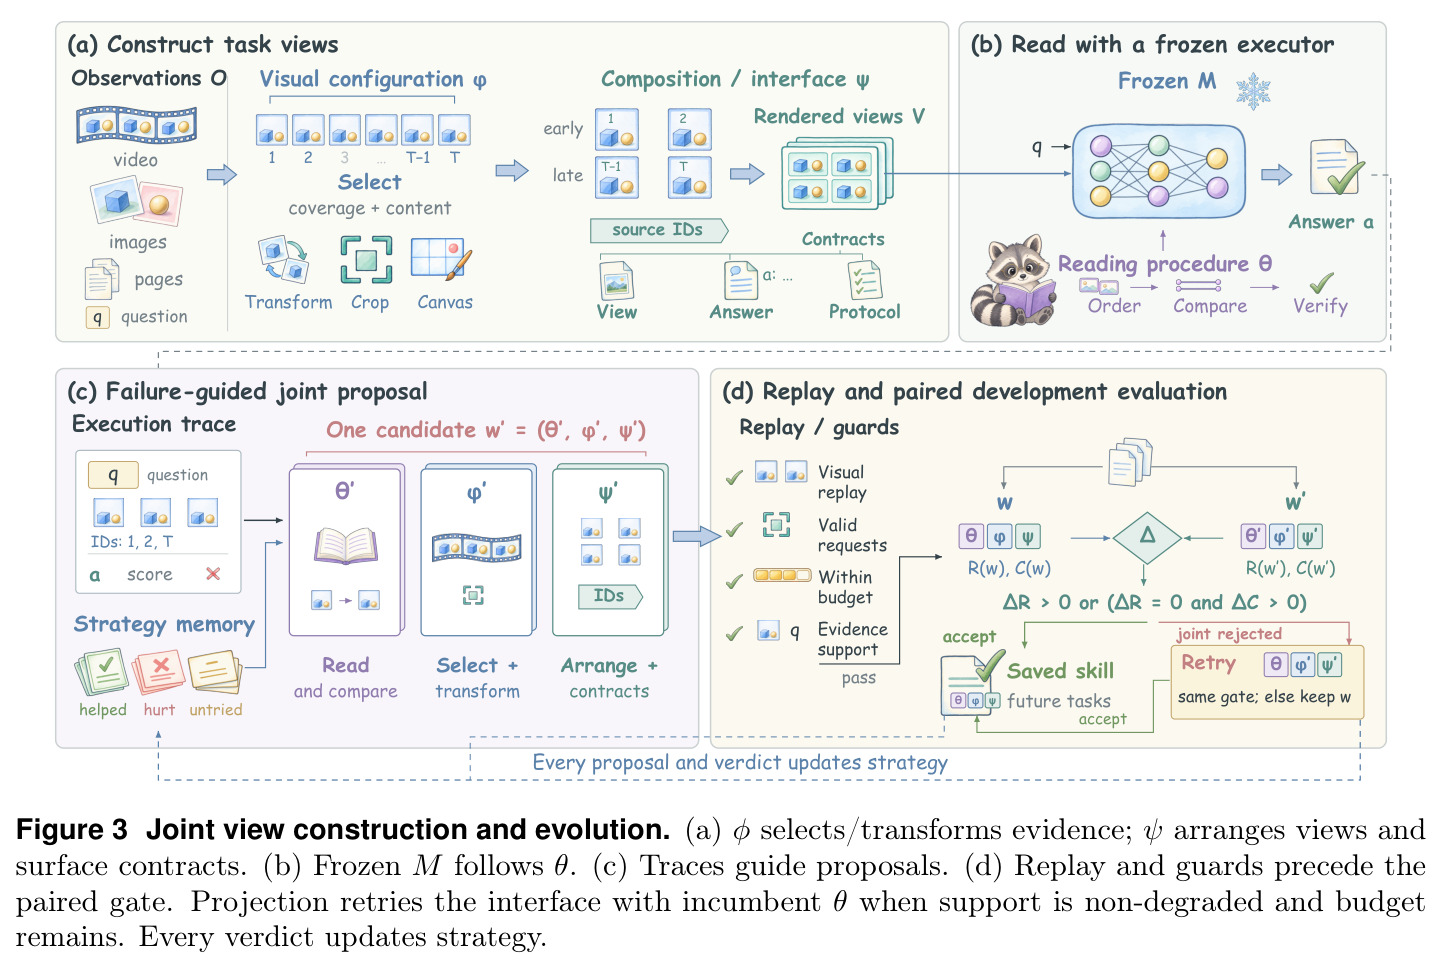
论文将技能定义为三元组:$\phi$ 从原始观测中选择证据(如取哪些视频帧、裁哪些表单区域),$\psi$ 决定视图的组织方式(拼贴、网格、时间标注行、分辨率),$\theta$ 是告诉冻结执行器如何解读这些视图的阅读程序。渲染器 $W_{\phi,\psi}$ 把前两者变成实际发给模型的图片附件。
全文所有机制(提案、回放、投影、坐标划分)都围绕这三个坐标的分工与联合演化展开。
配对评估门控(Paired Gate)
在同一组开发问题上同时执行现任技能与候选技能,计算任务得分的配对变化 $\Delta R$ 与证据支持度的变化 $\Delta C$,仅当 $\Delta R>0$ 或($\Delta R=0$ 且 $\Delta C>0$)时接受候选。配对设计让候选与现任面对相同的题目,抵消难度波动与采样噪声。
门控是保留修改的核心判据,消融实验显示去掉门控相关的保留机制会损失约 1.6 分。
ANLS 指标
Average Normalized Levenshtein Similarity,文档信息抽取的常用指标,基于预测值与真值之间的归一化编辑距离计算相似度,取值 0 到 1。论文在 FUNSD 表单任务上使用字段值 ANLS,要求字段标签与值的关联一起被正确读出。
理解 ANLS 才能明白「分辨率从 512px 降到 128px 导致 0.612 跌到 0.439」这类探针实验为何说明清晰度是可优化的接口属性。
终端交互效应(Terminal Interaction)
借鉴因子实验的交互项,在演化终点把阅读坐标从 $\theta_0$ 切到 $\theta_1$、接口坐标从 $v_0$ 切到 $v_1$,计算 $I = R(\theta_1,v_1)-R(\theta_1,v_0)-R(\theta_0,v_1)+R(\theta_0,v_0)$,衡量两侧是否互相成就而非独立起效。
这是论文检验「联合演化有必要」的关键统计手段,八个任务上交互项全部为正。
研究动机
多模态智能体答错题,往往不是模型不会推理,而是「没看到该看的」或「看到但读不出」。论文用四个探针实验量化这一点:在 VideoHolmes 的 96 个非测试问题上,均匀采样、运动分数、熵三种帧选择器的排名随帧预算(2/4/8/16 帧)变化而反转,运动分数在峰值后回落——「多给帧」并不总是赢;在输入完全不变的情况下,仅加强一条阅读提示反而使 12 个设置的平均准确率下降 2.1 分;把 64 个原本答对的问题的帧换成另一部影片,仍有 19%(Wilson 95% CI [11%,30%])能答对,说明约八成正确性依赖正确证据;把 oracle 表单裁剪图的分辨率从 512px 降到 128px,字段值 ANLS 从 0.612 跌到 0.439。然而现有技能演化工作只优化文本指令或工作流,「呈现什么证据、如何呈现」被写死在代码里,视觉侧从未成为可演化的持久状态。
本文的目标是本文的目标是:在完全冻结执行模型(executor)权重的前提下,把「智能体看到什么」(可执行的证据接口)与「它如何阅读」(阅读程序)作为一个耦合的可复用技能联合演化,使智能体在八个视觉基准上全面超越直接执行(Direct),并在一系列苛刻条件下保持优势:匹配输入 token 预算后仍领先(token 匹配的 Direct 只追回 6.1 分中的 0.9 分)、匹配提交次数下仍胜过同空间基线、演化出的技能迁移到未见执行器后每次至少超对应 Direct 1.5 分。同时要求演化过程本身可检验:候选视图可回放、保留决策与任务结果挂钩、五个多源任务的输入 token 相对初始技能下降。
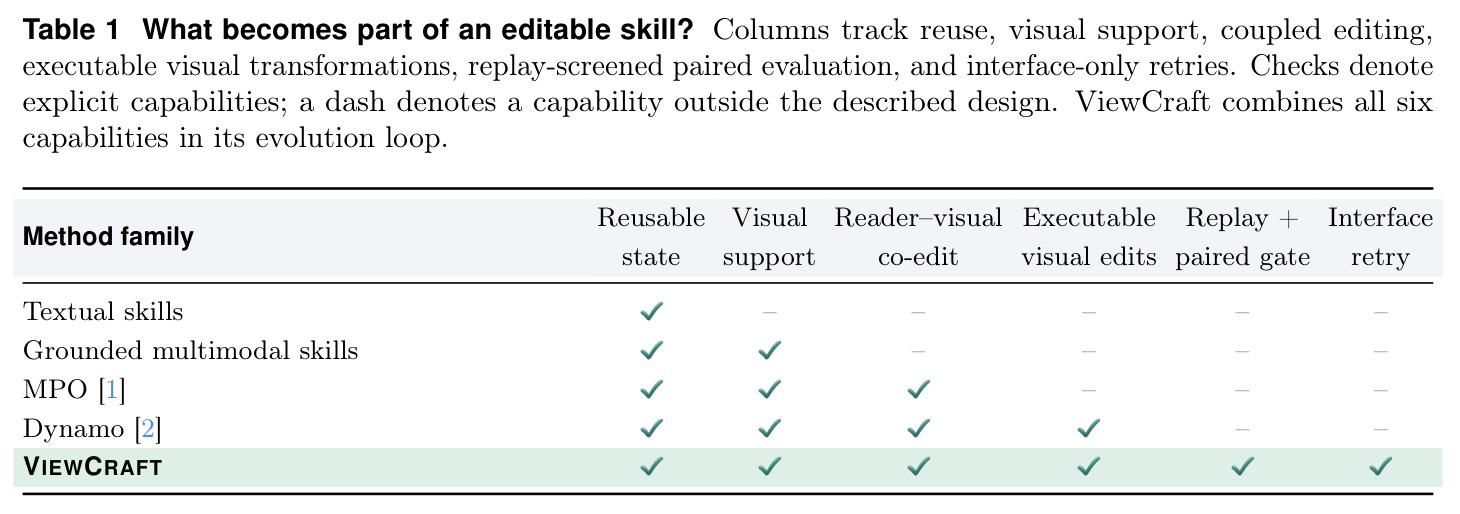
与已有工作不同的是,已有工作分三条线:文本技能与提示优化(DSPy、GEPA、ADAS、AFlow)的状态是纯文本;多模态提示优化 MPO 虽同时更新文本与非文本提示,但没有可执行的视觉变换、回放筛选与接口重试;Dynamo 联合演化推理技能与视觉工具,却把渲染原语锁在库代码里。被忽视的关键点是:一次联合提案被整体拒绝时,其中可能藏着「配现任阅读程序就有用」的视觉修改——单一接受/拒绝粒度会把这类修改一并丢弃。ViewCraft 抓住这一点,把证据接口做成可保存、可回放、可投影的持久状态:被拒联合提案中未损害证据支持的视觉部分会被单独重测(接口投影),回放则过滤渲染结果不变的无效编辑以省评估。论文还首次用终端交互项 $I$ 量化两侧互补性,这是以往方法没有的检验手段。
核心方法
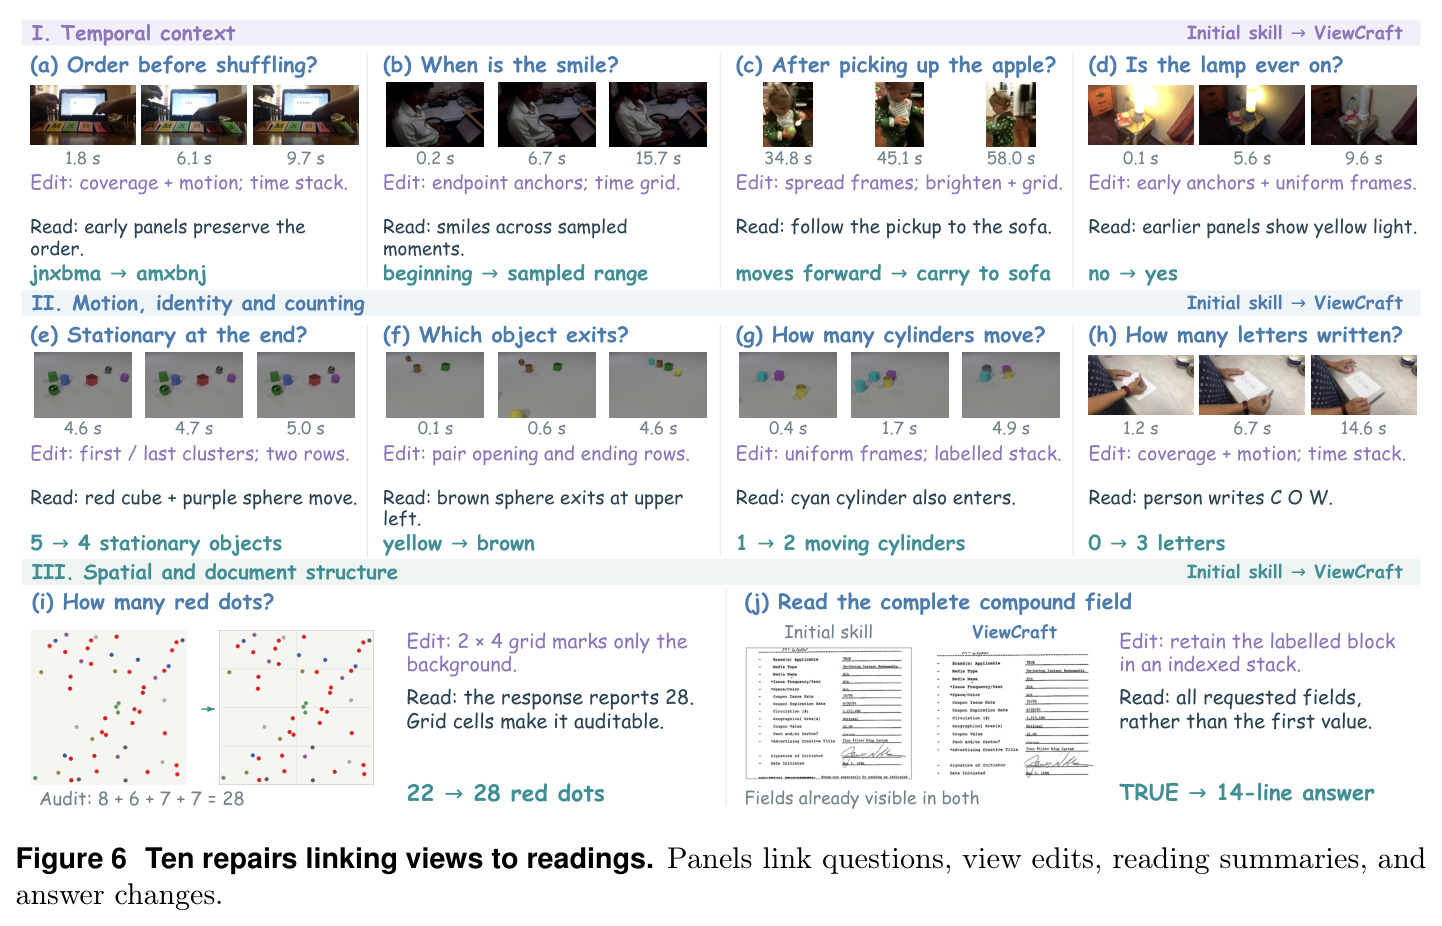
直觉上,这像给一位阅读能力固定(冻结执行器 $M$)的专家不断调配「取景器+笔记板+读图指南」:取景器决定取哪些画面($\phi$ 选择证据),笔记板决定怎么排版($\psi$ 组织视图),读图指南规定按什么步骤比对($\theta$ 阅读程序)。三者构成技能 $w=(\theta,\phi,\psi)$,渲染器 $W_{\phi,\psi}$ 把观测与问题变成实际发出的图片附件,优化目标是 $\max_{\phi,\psi,\theta}\ \mathbb{E}_{(\mathcal{O},q,y)\sim\mathcal{D}}\big[R(M(W_{\phi,\psi}(\mathcal{O},q),\theta),y)\big]$ 且 $M$ 冻结。技术路线是提案-评估-保留循环:失败轨迹驱动 LLM 提出候选(只改 $\theta$、只改 $(\phi,\psi)$ 或联合修改),经守卫检查与回放过滤后,在配对开发集上与现任技能同题对比,按门控决定去留,被拒联合提案的接口部分还可单独重测。坐标划分上,推理与判定规则(极性、判定表、缩放决定)归 $\theta$,渲染、视图元数据与答案格式归接口侧;分解 $P(\text{correct}) = P(E)\,P(\text{correct}\mid E) + P(\neg E)\,P(\text{correct}\mid\neg E)$ 说明增益来自证据可得与阅读成功两个互补因子。
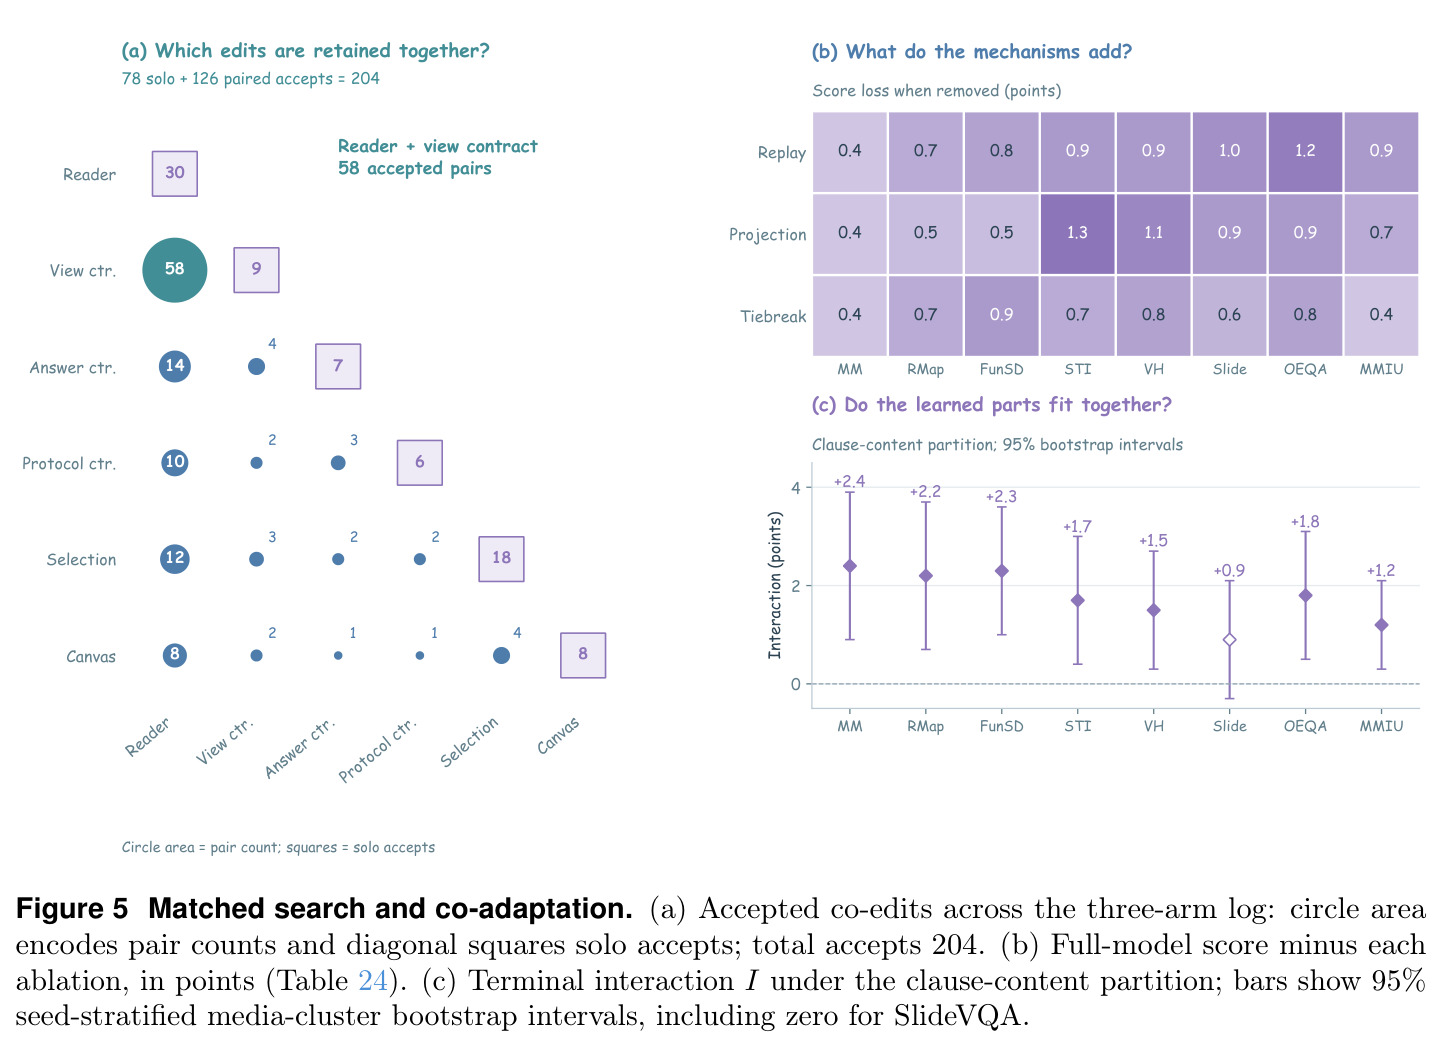
核心创新是「证据接口本身就是可演化、可复用的持久状态,且必须与阅读程序耦合演化」。支撑它的三个机制:(1) 回放(replay)——渲染类修改先重放像素,视图不变的编辑直接过滤,一次联合臂实验省下 30 次门控评估;(2) 配对门控——接受条件为 $\Delta R>0$ 或($\Delta R=0 \wedge \Delta C>0$),即任务分数提升,或分数持平但证据支持度提高,去留完全由任务结果决定;(3) 接口投影(interface projection)——联合候选改变视觉字段但任务分数下降($\Delta R<0$)时,只要证据支持未退化($\Delta C\ge0$)且提交与门控额度允许,就单独用候选 $(\phi,\psi)$ 配现任 $\theta$ 重测,把有用的视觉修改从被拒提案中救回,21 次重试全部进入最终技能。效果上,终端交互项 $I = R(\theta_1,v_1)-R(\theta_1,v_0)-R(\theta_0,v_1)+R(\theta_0,v_0)$ 在八个任务上全部为正(均值 +1.8 分,单侧符号检验 $p=0.004$,七个 bootstrap 区间排除零),直接证明学到的接口与阅读程序互相成就,而非各自独立起效。
方法步骤详情
演化分六步。第一步,从空接口起步(Initial skill)在训练问题上执行,记录轨迹:问题、发出的视图及其几何与来源、回答、得分。第二步,由轨迹与策略记忆(helped/hurt/untried)驱动 LLM 提出候选 $w'=(\theta',\phi',\psi')$,如「补上事件发生前的帧」「把面板重排成时间标注行」。第三步,外部守卫检查执行预算与请求合法性($C_{\text{exec}}$),冻结验证器核对视图是否覆盖问题衍生的证据需求($C_{\text{ground}}$,与人类共识一致率 89%)。第四步,回放:对渲染类修改重放像素,视图不变的直接过滤。第五步,在 48-240 道配对门控题上与现任技能同题对比,按 $\Delta R>0$ 或($\Delta R=0\wedge\Delta C>0$)决定接受与否。第六步,若联合候选有视觉改动但 $\Delta R<0$ 且 $\Delta C\ge0$、额度未用完,则做接口投影:仅保留 $(\phi',\psi')$ 配现任 $\theta$ 重测,过同一门控。预算为每轮至多 4 次提交、共 4 轮、96 次训练 rollout;每臂共提交 250 个候选、配对评估 200-208 次。测试时保存的技能直接给出视图、动作与阅读规则,不再优化。
技术新颖性
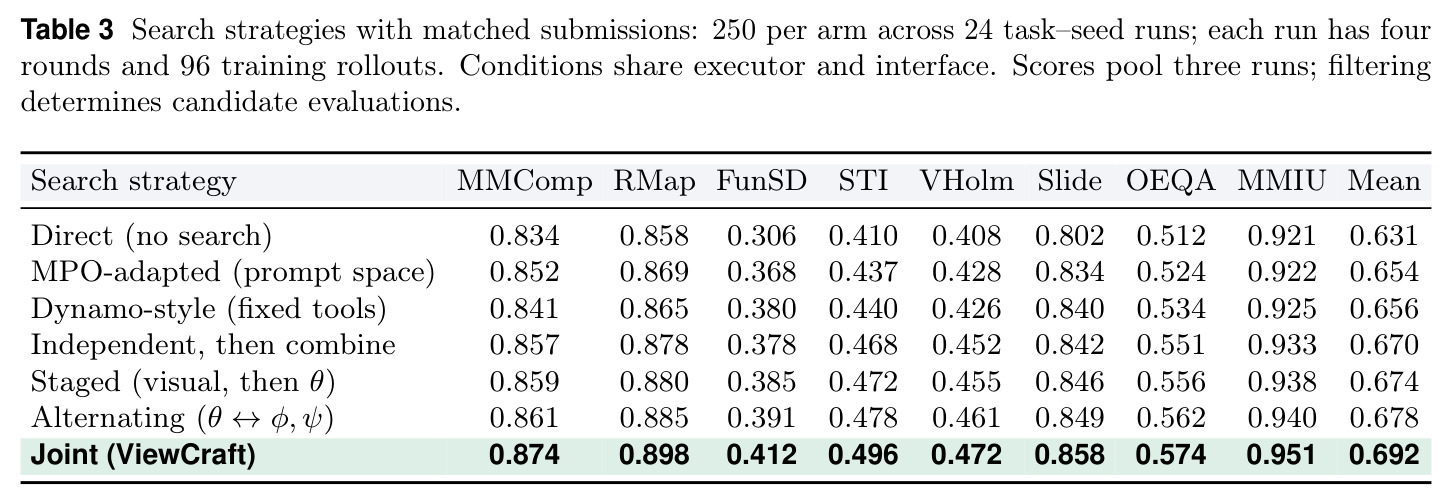
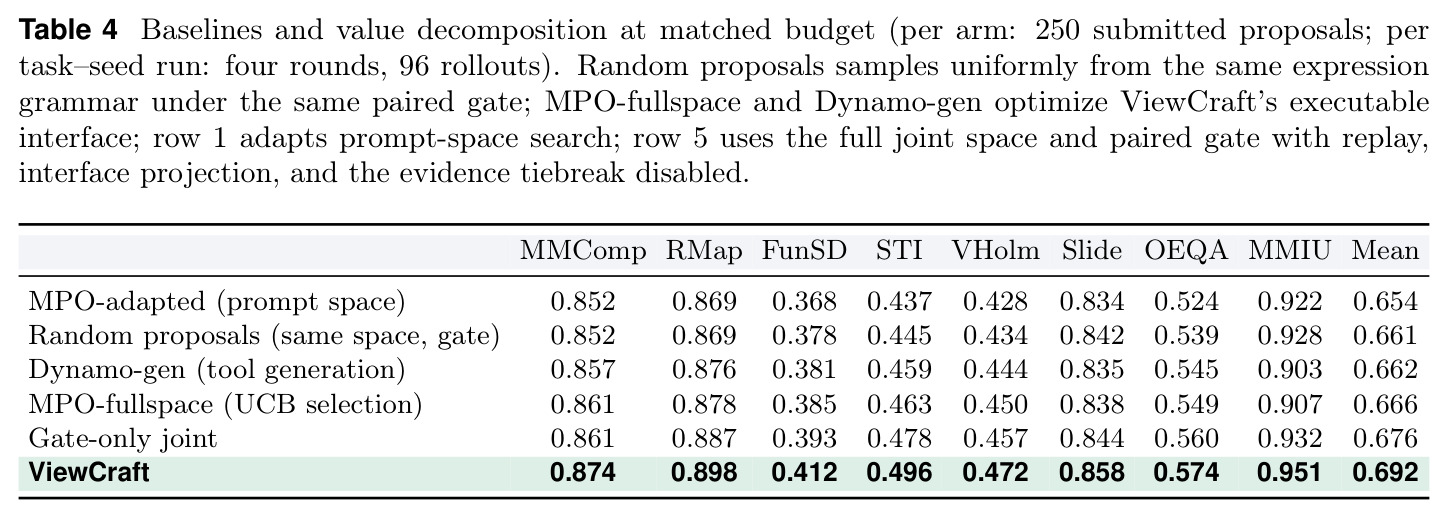
与文本技能演化(DSPy/GEPA 优化复合 LM 程序、ADAS/AFlow/AgentSquare 搜索工作流)相比,ViewCraft 首次把视觉证据的选取、变换与排版做成可执行的持久技能状态。与 MPO 相比,MPO 的图像侧只是提示,不具备可执行变换与回放筛选;与 Dynamo 相比,Dynamo 把渲染原语当库代码,且无回放、配对门控与接口重试。Table 1 用六个能力维度对比:可复用状态、视觉支持、接口-阅读联合编辑、可执行视觉变换、回放+配对门控、接口重试,只有 ViewCraft 全部具备。搜索机制上,一次联合提案可以同时修改「接口暴露的关系」与「解读该关系的规则」,在匹配 250 次提交预算下比交替搜索高 1.3 分、比同空间最强基线 MPO-fullspace 高 2.6 分;且轨迹引导比随机提案高 1.5 分、保留机制再加 1.6 分——共同的语法空间说明增益来自搜索机制设计而非更大的搜索空间。
实验结果
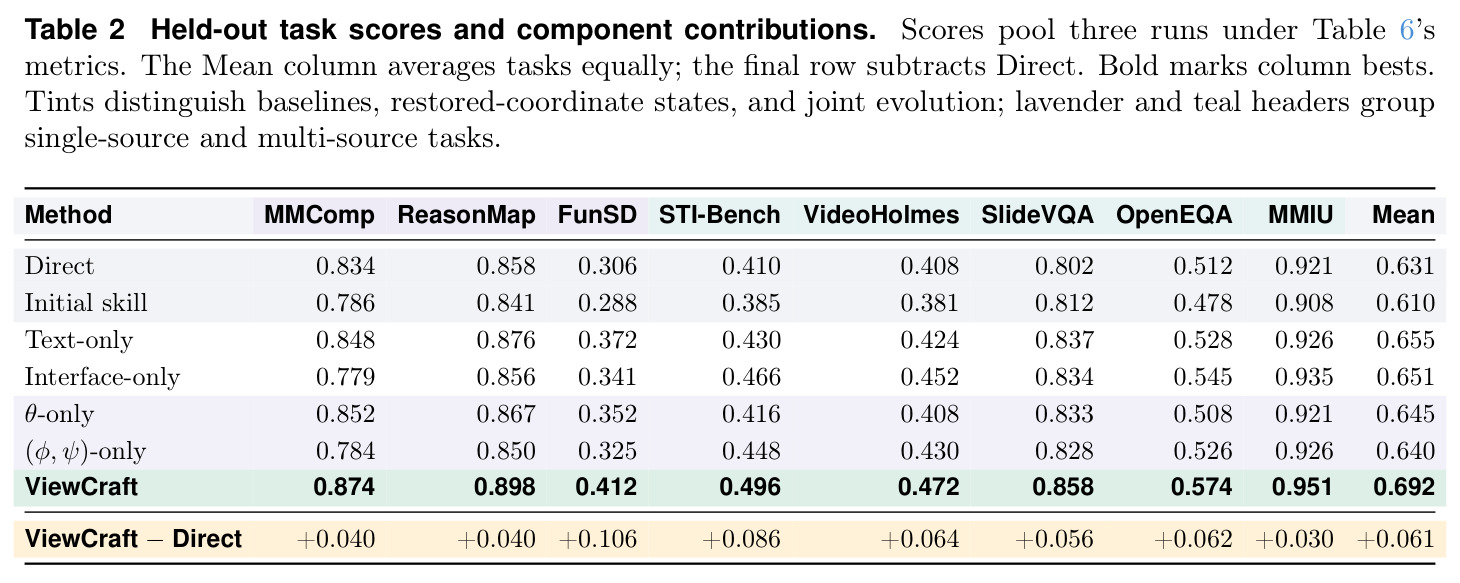
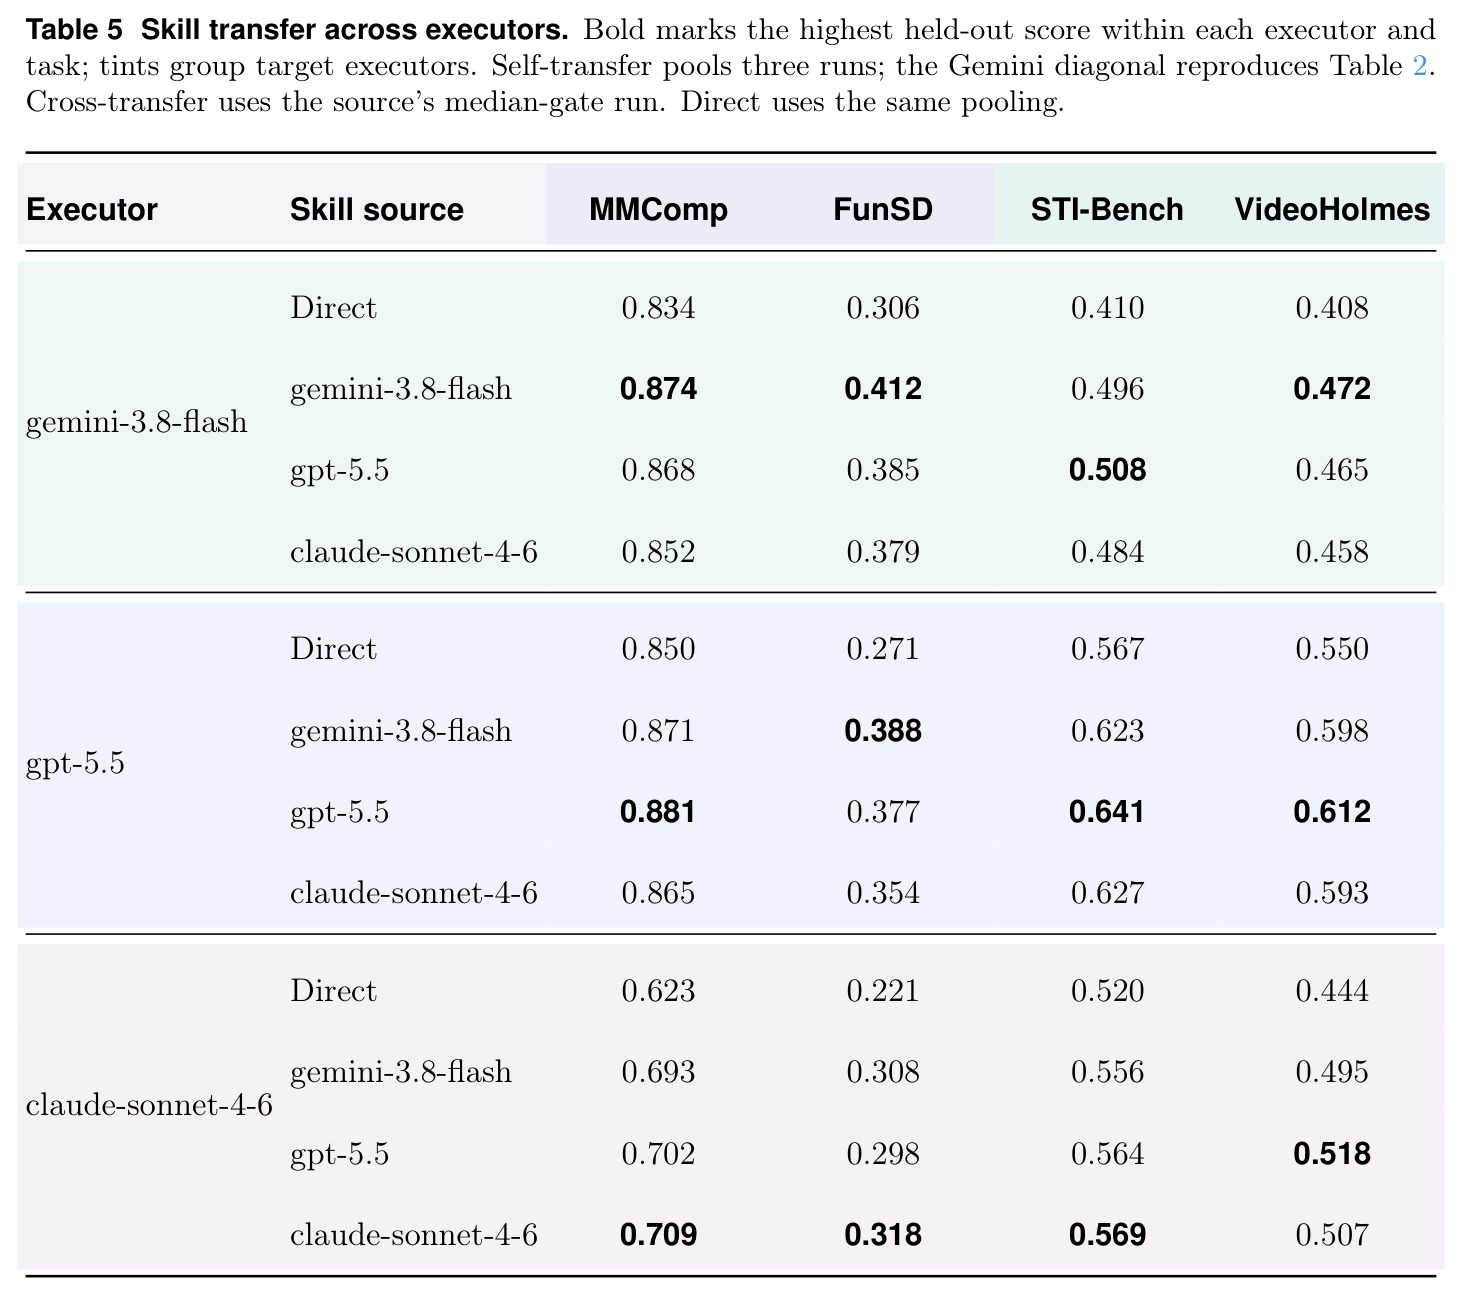
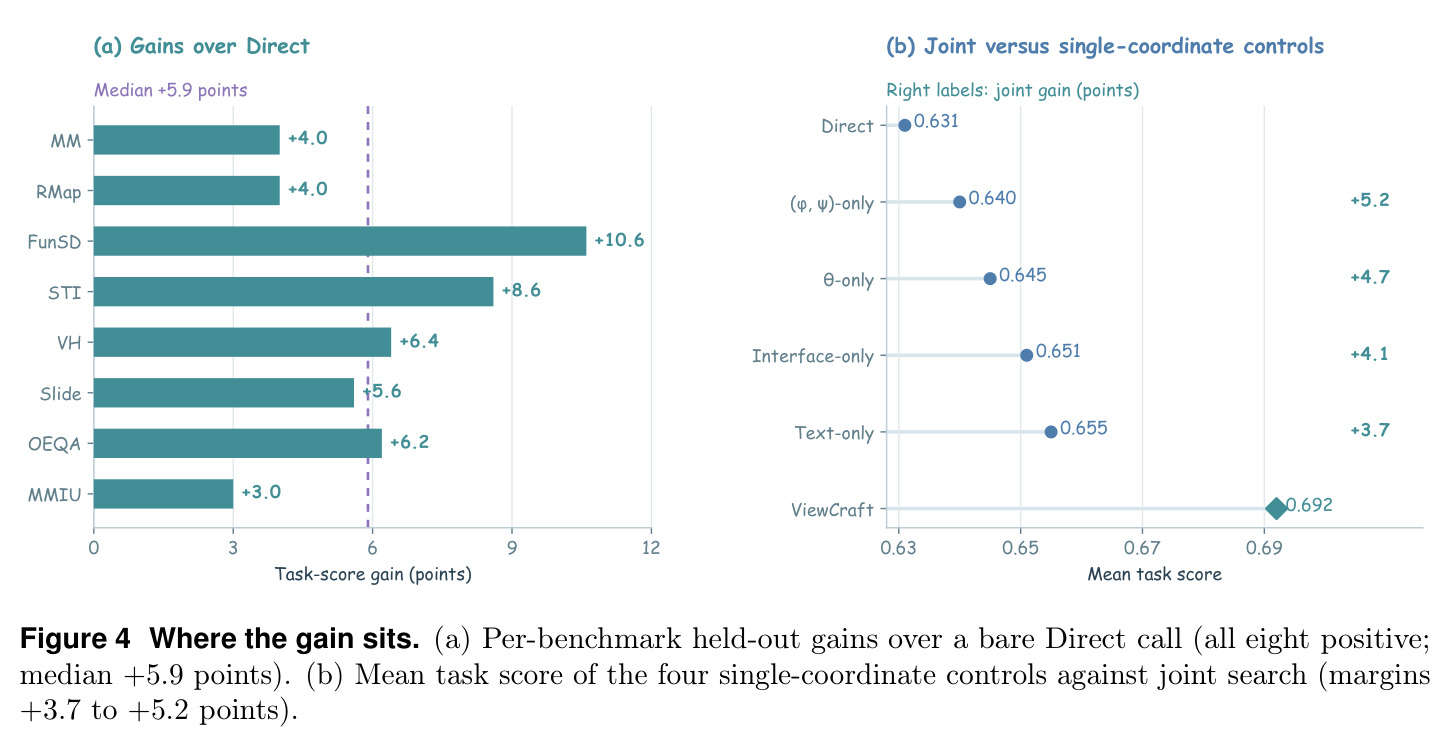
主结果(Table 2,三次运行合并):ViewCraft 平均任务得分 0.692,超 Direct 0.631 达 6.1 分,八个基准全部为正:FUNSD +10.6(0.412 vs 0.306)、STI-Bench +8.6(0.496 vs 0.410)、Video-Holmes +6.4、OpenEQA +6.2、SlideVQA +5.6、MMComp 与 ReasonMap 各 +4.0、MMIU +3.0,中位数 +5.9;匹配输入 token 预算后仍领先 5.2 分。单一坐标对照均落后:$\theta$-only 0.645、$(\phi,\psi)$-only 0.640、Text-only 0.655、Interface-only 0.651,差距 3.7-5.2 分。搜索阶梯(Table 3/4):联合 0.692 > 交替 0.678(+1.3,CI [+0.6,+2.1],符号检验 $p=0.008$)> 最强同空间基线 MPO-fullspace 0.666(+2.6,CI [+1.3,+3.9]);轨迹引导比随机提案高 1.5 分,保留机制再加 1.6 分。机制消融:去掉回放/投影/证据决胜各损失 0.7-0.9 分,全去掉损失 1.6 分;门控集减半或加倍得分变化不超过 0.2 分。跨执行器迁移(Table 5,三个执行器 × 4 任务):12 次迁移全部至少超目标 Direct 1.5 分,三次超过目标自演化技能(如 GPT-5.5 演化的技能让 Sonnet 在 VideoHolmes 得 0.518 > 0.507)。五个多源任务输入 token 比 Initial skill 少 8-15%;代价是每题延迟增加 7.6 秒。用 Initial 阅读程序执行演化视图可恢复 +8.2 分联合增益中的 +2.3 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 八基准平均(MMComp/ReasonMap/FUNSD/STI/VideoHolmes/SlideVQA/OpenEQA/MMIU) | 任务得分 | ViewCraft 0.692 | Direct 0.631;最强单坐标基线 Text-only 0.655 | +6.1 分(匹配 token 预算下仍 +5.2 分,超最强单坐标对照 3.7-5.2 分) |
| FUNSD 表单字段值抽取 | 字段值 ANLS | 0.412 | Direct 0.306 | +10.6 分(八个基准中最大单项增益,Holm 校正后仍个体显著) |
| STI-Bench 时空推理 | 任务得分 | 0.496 | Direct 0.410 | +8.6 分(Holm 校正后仍个体显著) |
| Video-Holmes 视频推理 | 任务得分 | 0.472 | Direct 0.408 | +6.4 分 |
| 多源任务输入成本(5 个多源任务) | 输入 token(相对 Initial skill) | 下降 8-15% | Initial skill(空起始接口) | 全部五个多源任务均下降(注意:相对 Direct 仍是增加输入) |
| 跨执行器迁移(3 执行器 × 4 任务) | 任务得分 | 12 次迁移全部为正,3 次超过目标执行器自演化技能 | 目标执行器 Direct | 每次迁移至少 +1.5 分 |
局限与改进
作者承认或数据显示的局限:延迟每题增加 7.6 秒,接口渲染与多视图拼接带来实际部署成本;演化依赖大量标注开发题与配对门控集(48-240 题)、每臂 250 次提交与每次运行 96 个训练 rollout,对低资源领域不友好;终端交互的 bootstrap 区间在 SlideVQA 上包含零,Holm 校正后仅 FUNSD 与 STI-Bench 保持个体显著,说明部分任务的两侧互补性证据较弱;证据支持验证器与人类共识一致率 89%,$\Delta C$ 决胜可能被误导;token 节省是相对 Initial skill 而非 Direct——相对 Direct,证据构造反而增加输入量。我自己的观察:增益幅度跨任务差异大(+3.0 到 +10.6 分),意味着收益高度依赖任务类型;实验未与「同预算微调执行器(如 LoRA)」对照,冻结权重的前提使结论对「能否用轻量权重更新替代」保持开放;三个执行器都是前沿商业 API,结论对开源小模型是否成立未知。
独立分析的弱点
第一,评估成本与数据依赖:演化需要成百上千次带标签多模态调用(24 个任务-种子运行 × 96 rollout × 每臂 250 次提交),在标注昂贵的垂直领域(医疗影像、工业质检)难以铺开;改进方向是用便宜的开源小模型做门控初筛、只在边际候选上调用强执行器,或引入无标注一致性信号替代部分配对得分。第二,7.6 秒/题的延迟来自每题重新渲染视图;改进方向是视图缓存与跨题复用稳定区域(如背景网格、索引栈),或预渲染高频视图模板。第三,搜索语法限于选择/裁剪/拼贴/画布等原语,无法表达标注箭头、动态放大镜等更丰富的视觉操作;改进方向是引入可增长的工具库,并让投影机制对工具级修改同样适用。第四,$\Delta C$ 依赖单一冻结验证器(89% 一致率意味着约 11% 误判),其系统性偏差会通过证据决胜被放大;改进方向是集成多验证器并做人校准审计。第五,迁移只在 3 个前沿商业执行器 × 4 任务上验证,未测 7B-70B 开源模型,而小模型恰恰最需要「外挂技能」;改进方向是补做弱执行器迁移实验并量化迁移损失(当前最多落后目标自演化 3.3 分)。
未来方向
作者方向:把策略记忆扩展为跨任务累积的知识库(类似 WikiSkill 的知识沉淀),让新任务的演化从相关经验热启动;投影机制目前只做接口侧的不对称重试,可扩展到阅读侧的对称重试或双向迭代;把「证据-阅读」耦合的技能单元推广到音频、3D 场景与具身控制等更多模态。可延伸方向:将配对门控与 test-time scaling(自一致性、搜索)结合,研究「演化时多花算力、部署时省算力」的权衡——论文显示三样本自一致性只能逼近而非超越 ViewCraft;把学到的技能库做成可检索的技能市场,按问题类型路由到不同 $(\theta,\phi,\psi)$ 组合;与轻量权重更新(LoRA)在同一预算下正面对比,界定「改输入」与「改权重」的适用边界;探索部署后的持续演化——用生产流量中的失败案例自动触发局部提案与投影,形成在线闭环。
复现评估
论文声称代码已在 GitHub 开源;八个基准全部公开(MMComposition、ReasonMap、FUNSD、STI-Bench、Video-Holmes、SlideVQA、OpenEQA、MMIU),划分协议在附录 A 给出(源不相交冻结划分、二值题按 $S/(3n)$ 计分、字段值 ANLS)。执行器为三个商业 API(gemini-3.8-flash、gpt-5.5、claude-sonnet-4-6),无需训练算力,但演化本身的 API 开销不小:每次运行 96 个训练 rollout、每臂 250 次提交、200-208 次配对评估、门控集 48-240 题,粗估单任务单种子需要数千次多模态调用,成本主要在 API 费用且随模型版本变动。复现难度中等偏高:回放、投影、坐标划分、契约定义等工程细节多,附录 D/H 有规格但接口契约的具体实现需仔细对照;预算有限者可先复现 Table 4 的 Gate-only joint(0.676)或消融版本验证主结论方向。
论文图表
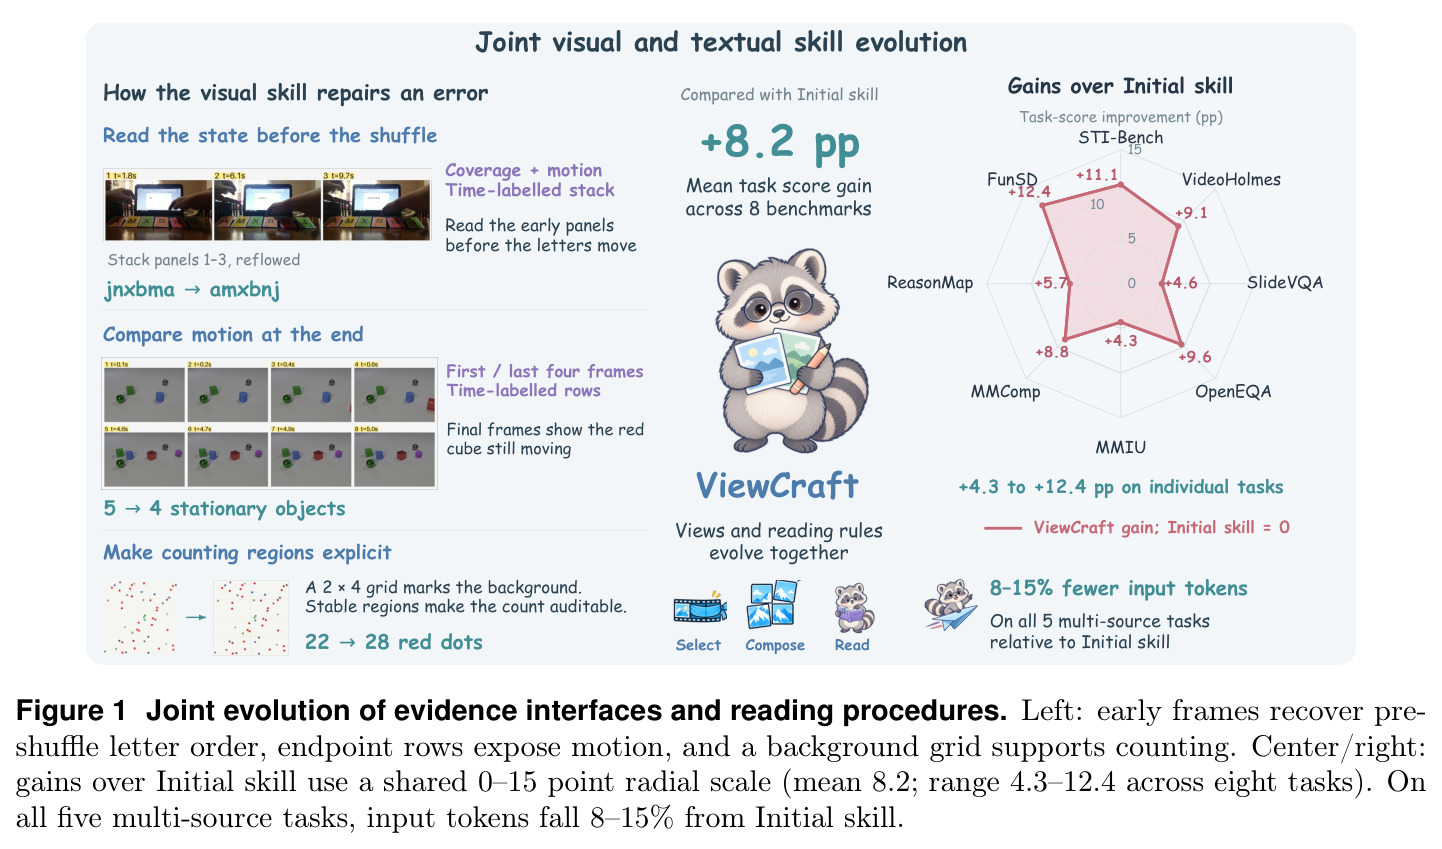
左列展示三个视觉修复示例:早期帧恢复洗牌前字母顺序(jnxbma→amxbnj)、首尾帧对比暴露运动(5→4 个静止物体)、2×4 背景网格让红点计数从 22 修正为 28 且可审计;中/右列以共享 0-15 分刻度对比八个任务相对 Initial skill 的增益(均值 +8.2,范围 +4.3 到 +12.4),并标注五个多源任务输入 token 下降 8-15%。
一图看懂论文解决什么问题、效果有多大,是全文的导航图。
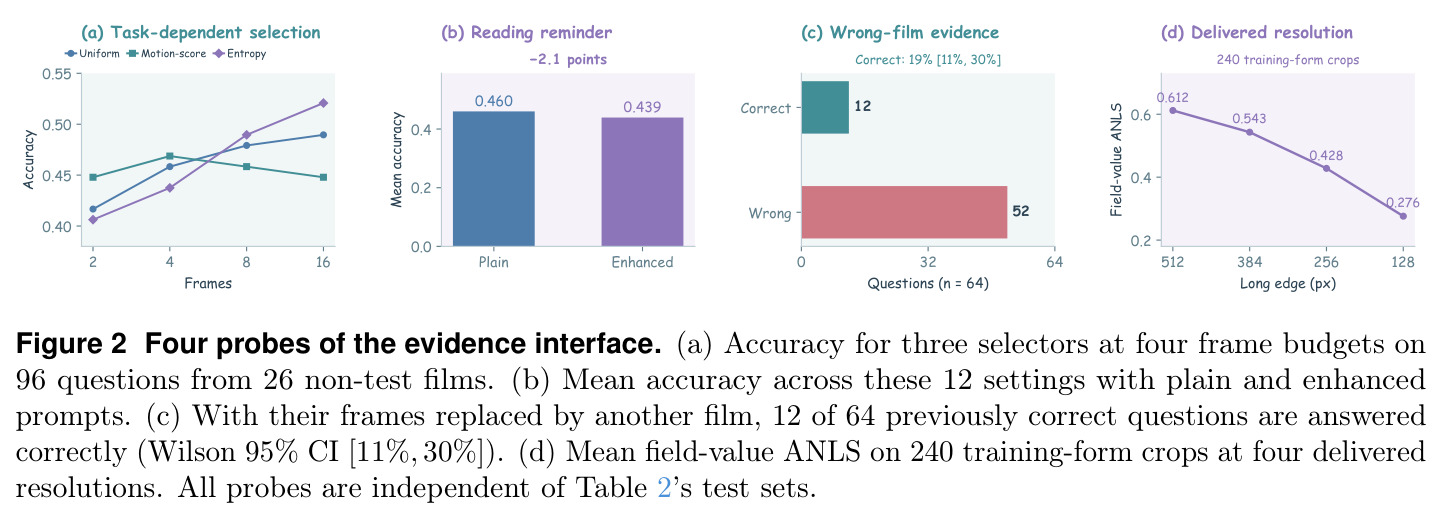
(a) 均匀/运动分数/熵三种帧选择器在 2/4/8/16 帧预算下排名反转,运动分数过峰后回落;(b) 更强的阅读提示使 12 个设置的平均准确率下降 2.1 分;(c) 换错影片后 64 个原本答对的问题仍有 19%(CI [11%,30%])答对;(d) oracle 表单裁剪图分辨率从 512px 降到 128px,ANLS 从 0.612 降至 0.439。
四个探针是全文动机的实证基础,直接说明证据选择与清晰度是可优化的接口属性。