Apertus 1.5:从开放文本模型到开放多模态推理器 Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
持续预训练将全开放文本模型升级为具备图像音频理解、262K上下文与思考模式的多模态推理器
前置知识
持续预训练 (Continued Pretraining)
在已完成预训练(通常已cooldown)的检查点上用新数据混合继续训练,让模型获得新能力(如多模态、长上下文)而不必从零重训。关键技术点包括学习率重新warmup、数据配比控制、以及防止灾难性遗忘——即新任务训练覆盖旧能力。本文从Apertus 1.0出发,用4T(8B)/2T(70B)token的继续预训练引入图像与音频,并在第2.4节用受控消融证明课程设计的必要性。
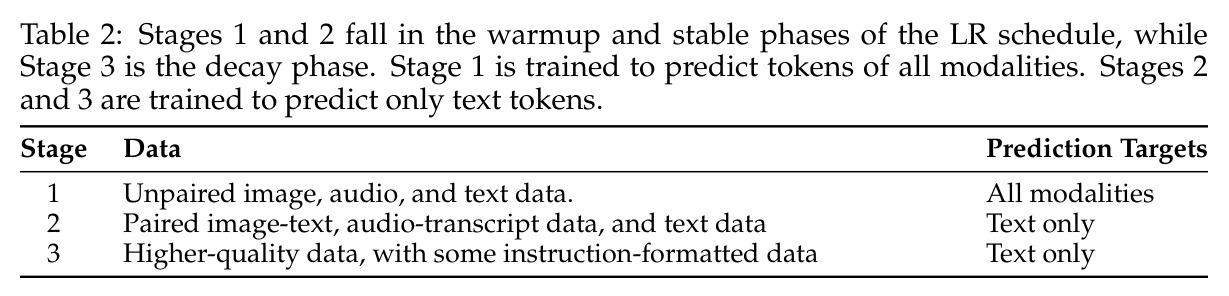
整篇论文的主线就是一次大规模持续预训练:四阶段划分、预测目标切换(全token→仅文本)、学习率调度与文本能力保持的消融全部围绕它展开,不懂这一框架就无法理解各阶段的设计动机。
离散多模态词元 / 向量量化 tokenizer
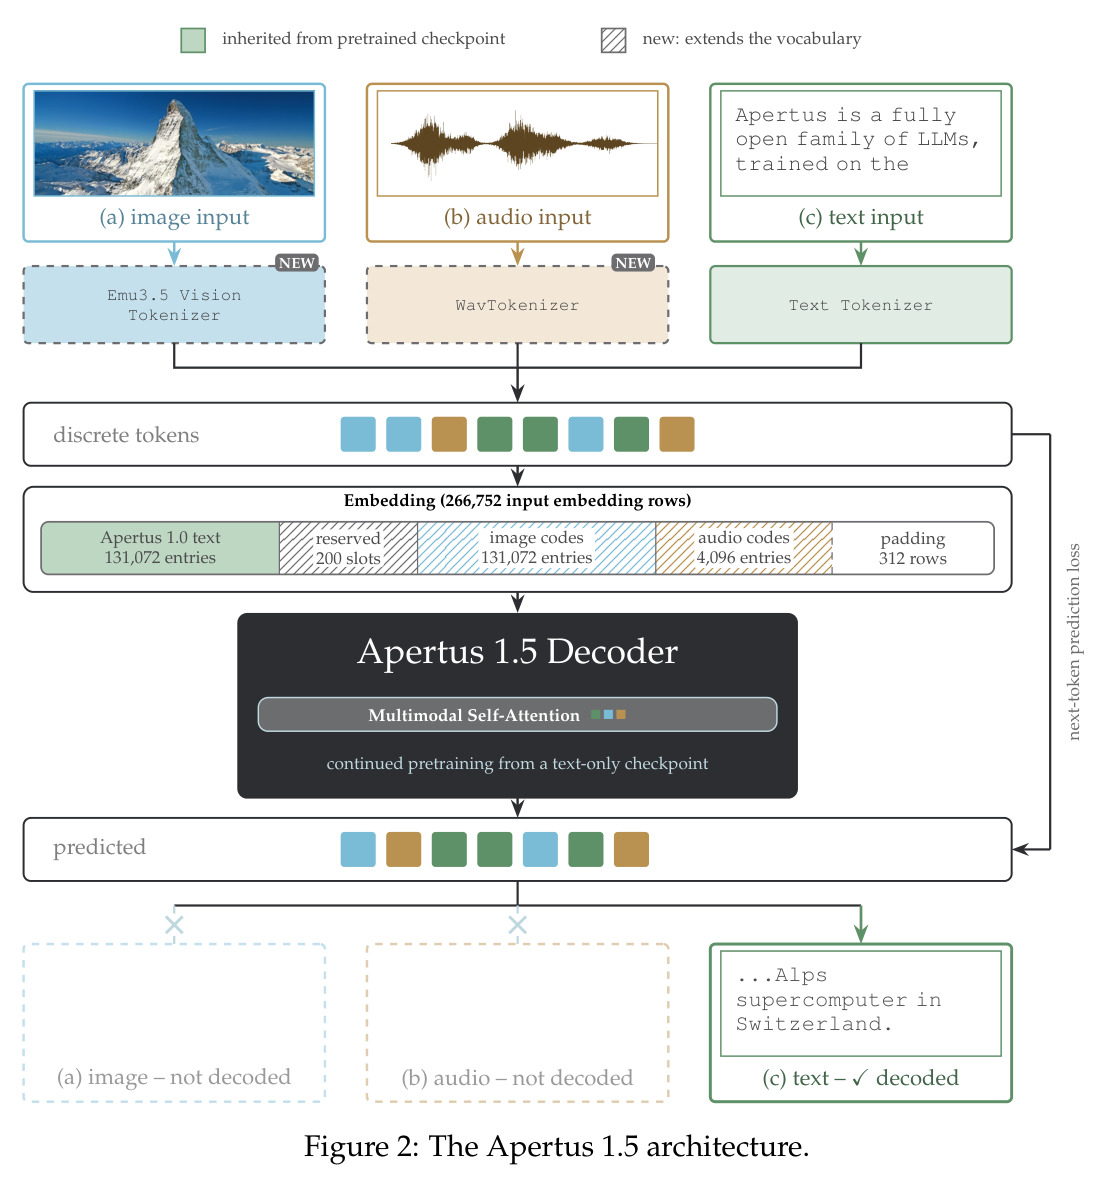
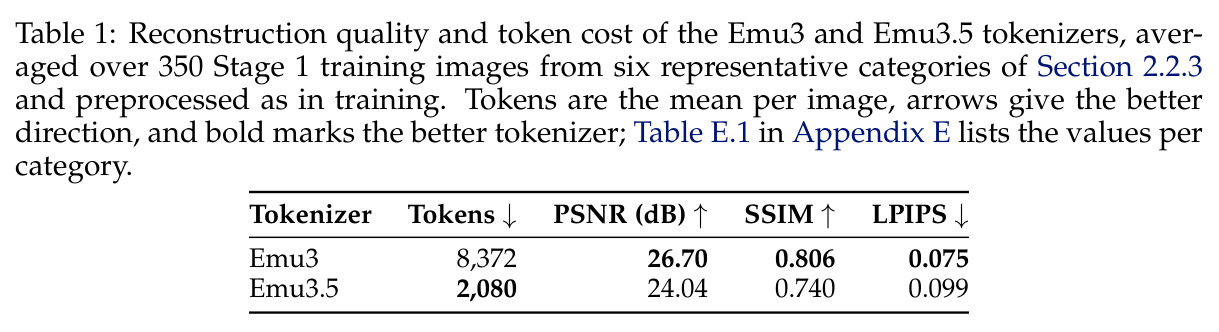
把图像或音频经编码器加码本量化为离散符号序列:Emu3.5视觉tokenizer每$16\times16$像素输出1个码(码本131,072条、维度256),512×512图像约1,024码;WavTokenizer每600个采样点输出1码(40码/秒,码本4,096)。这样图像/音频变成另一种文字,语言模型用同一个next-token预测目标处理它们,推理时无需运行独立编码器。
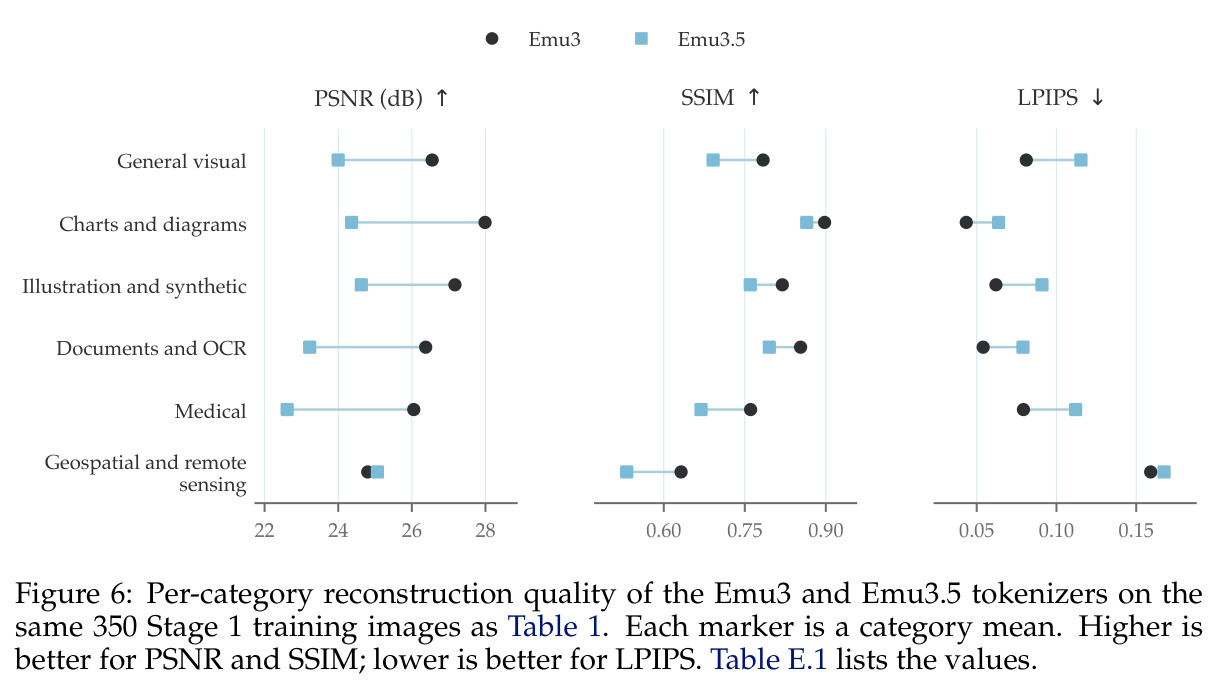
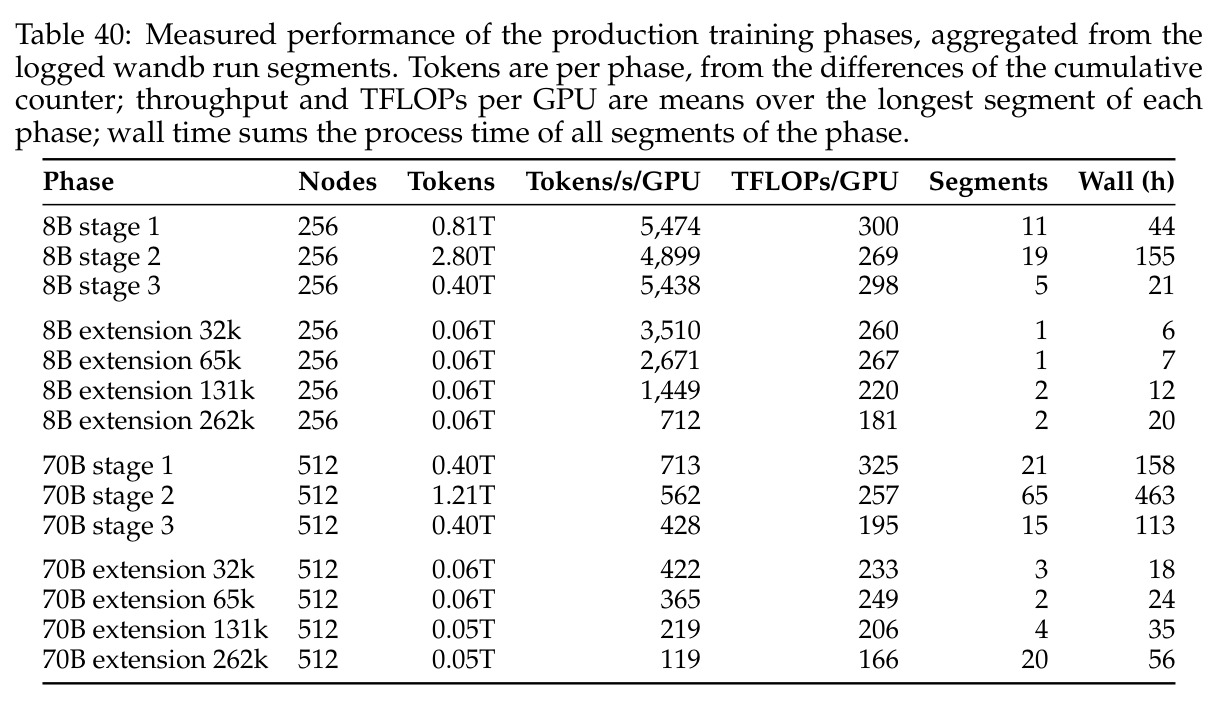
这是本文方法论的基石:多模态从tokenizer进入、Stage 1可以全token算loss、训练吞吐与纯文本持平(5,474 token/s/GPU),全部源于离散表示;tokenizer选择消融(Emu3 vs Emu3.5)也直接决定了模型OCR偏弱的短板。
可验证奖励强化学习 (RLVR)
奖励不来自人工偏好或模型裁判,而来自对答案的客观校验:数学用Math-Verify比对标准答案、代码在沙箱跑测试用例(全部通过给二元奖励)、指令遵循用形式化约束检查器(IFTrain/IFEval验证器)。模型采样轨迹后按组内相对优势更新策略(GRPO类),本文用verl的完全异步trainer在GH200集群上实现。
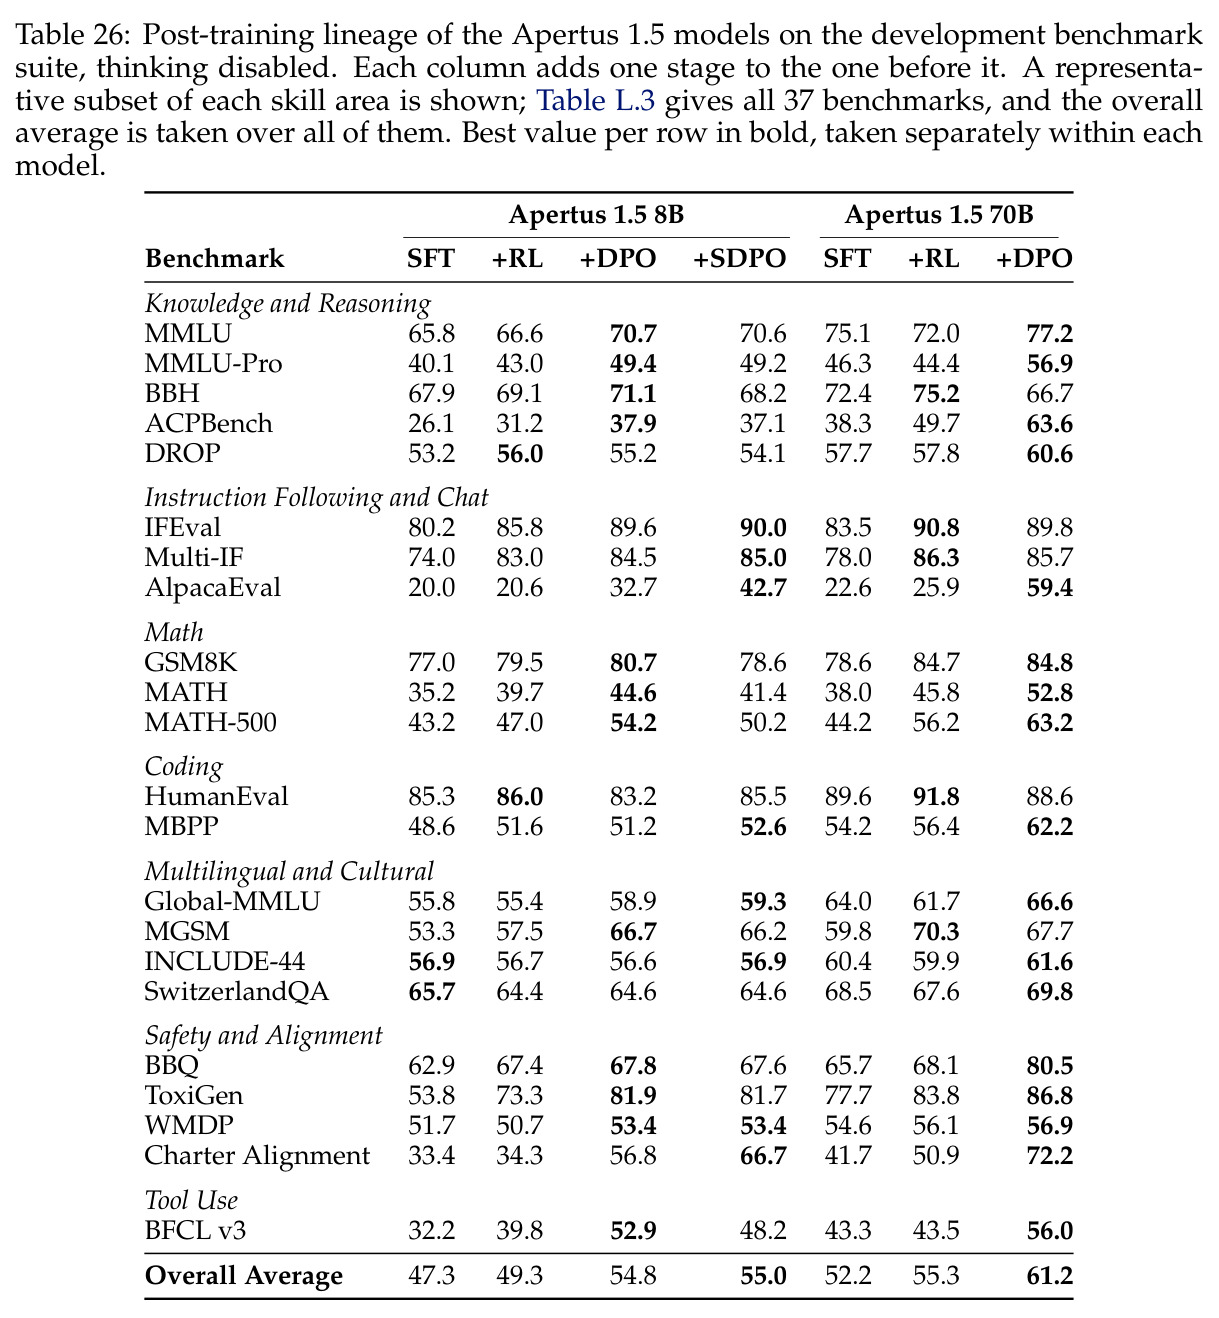
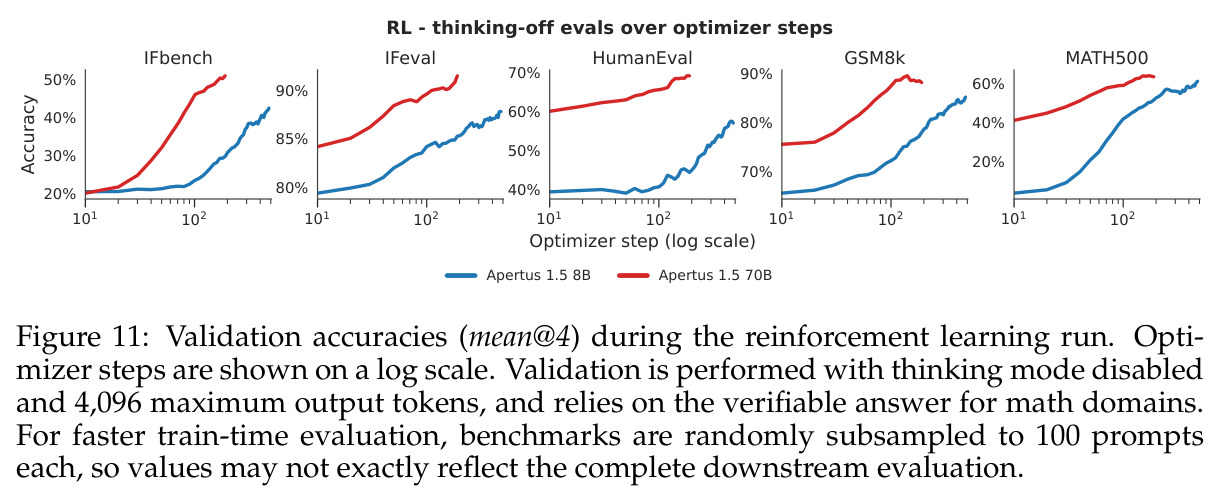
第4.5节的RL阶段是思考能力与指令遵循提升的主要来源:lineage表显示RL把IFEval提升5.6/7.3分、ACPBench提升5.1/11.4分。理解RLVR才能读懂Table 26中各后训练阶段的分工与消融。
DPO 直接偏好优化(离线/在线)
基于偏好对的策略优化:损失在抬升chosen相对rejected对数似然差的同时,用KL系数约束策略不偏离参考模型。离线DPO用静态数据集;在线DPO从当前策略实时采样rollout、由裁判打分、按MaxMin规则组对后当场更新。本文70B先用长度归一化变体(KL系数$\beta=25$)离线,再在线($\beta=0.1$);8B只做在线(12 rollouts/prompt,Qwen3.6-27B裁判)。
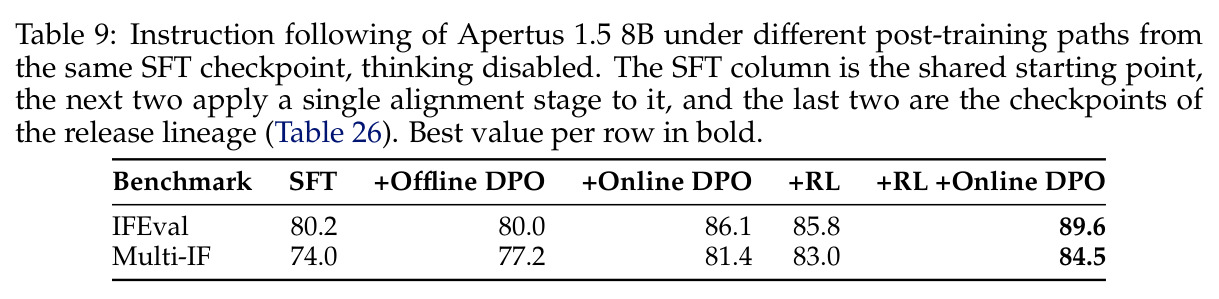
DPO阶段贡献了AlpacaEval(+12.1/+33.5分)、Arena-Hard与工具调用的大部分增益,且论文给出在线vs离线的对照实验(Table 9),是复现其对话质量与理解后训练路线的关键。
长上下文扩展与 RoPE 缩放
把模型上下文从8k阶梯式扩到262k:每阶段序列长度翻倍、重置优化器状态、RoPE基频从$5\times10^5$升至$4\times10^6$、缩放因子8→32,并用合成可验证任务(词频统计CWE、段落排序DocOrder、人工大海捞针)显式训练远距离信息使用能力。跨文档注意力掩码让131k训练成本约等于此前的65k。评测用RULER与HELMET。
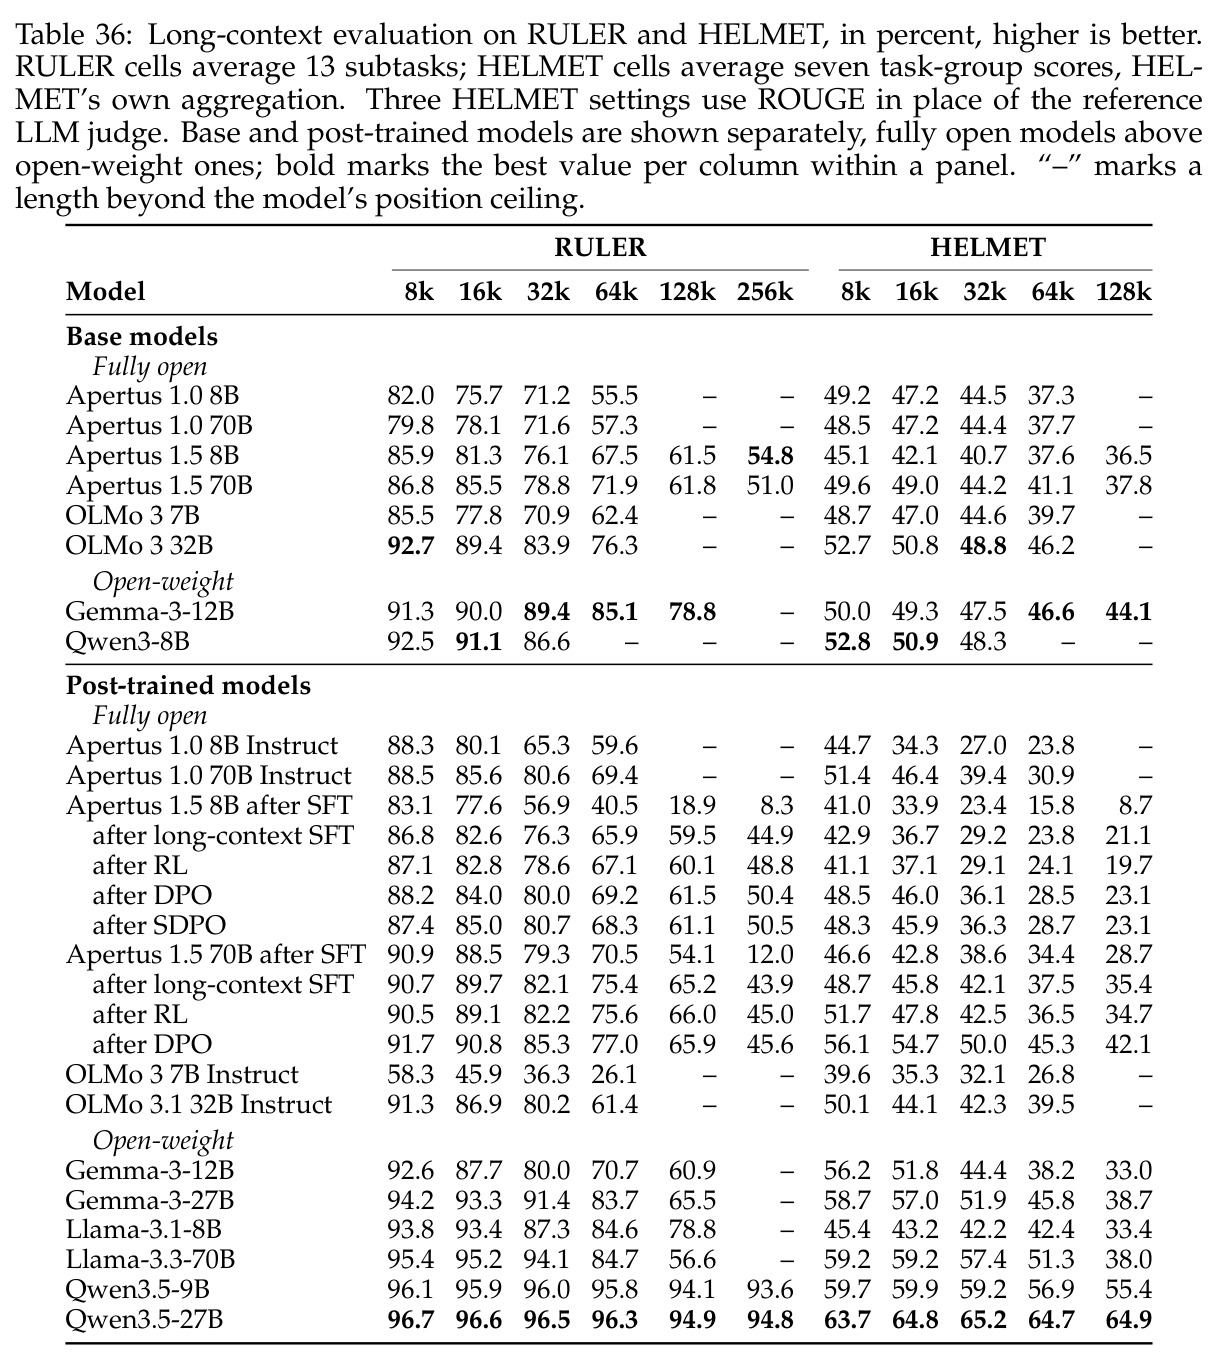
上下文4倍扩展是本发布的核心卖点;论文发现普通短上下文SFT会摧毁长程检索(RULER@262k从54.8跌到8.3),必须靠专门的长上下文SFT恢复到44.9——这是理解第3.3与4.3节设计的前提。
思考模式与思维链数据配平(能力过滤)
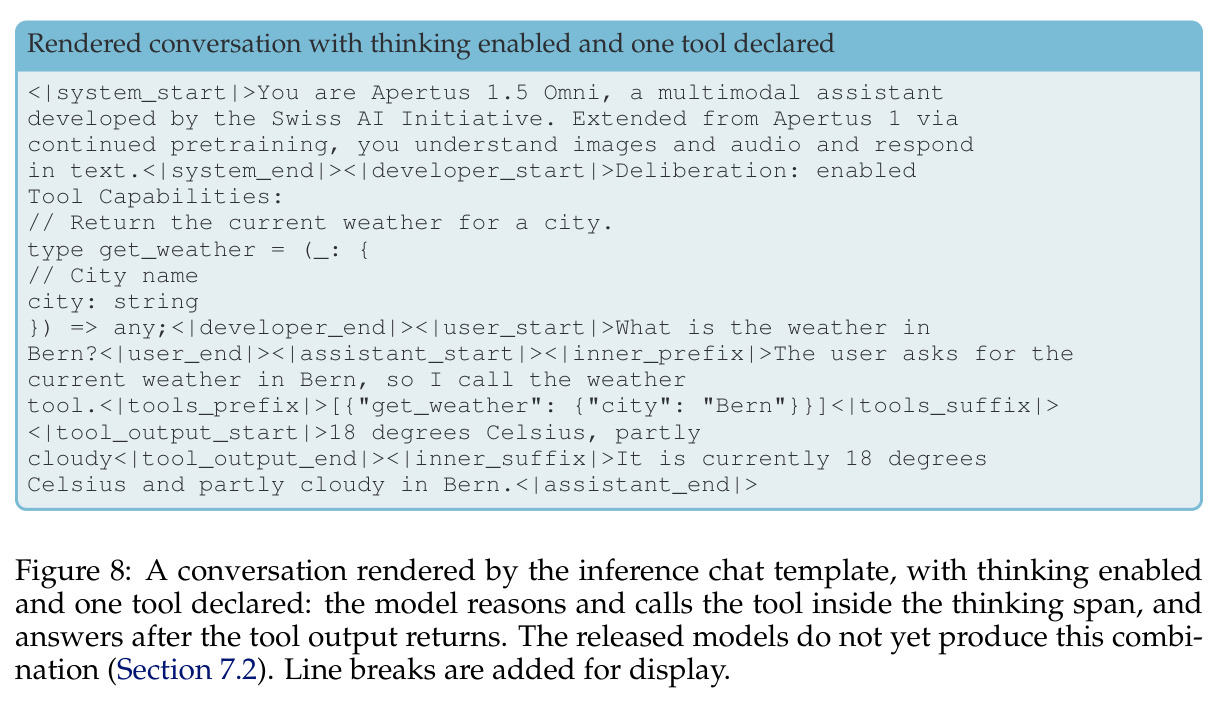
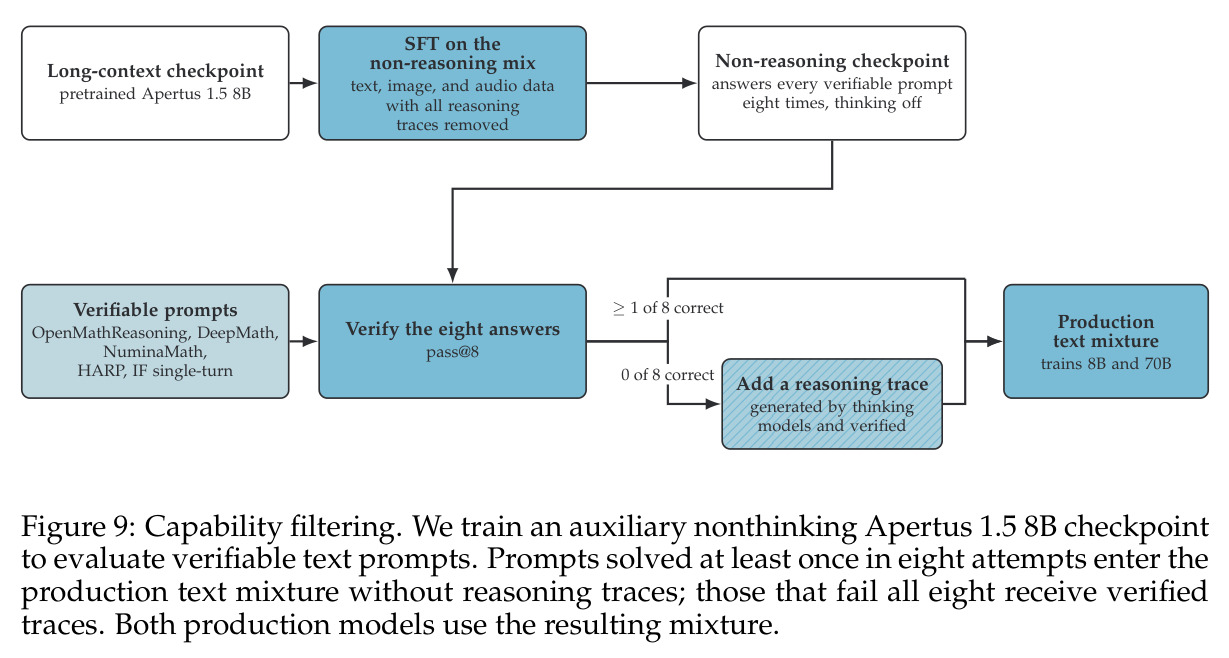
推理时让模型在$<|inner\_prefix|>$与$<|inner\_suffix|>$之间先生成推理再作答;本文思考只是聊天模板的请求级开关而非独立模型。训练侧通过能力过滤决定哪些题配推理轨迹:先用辅助非思考8B检查点对每个可验证prompt采样8次(pass@8),全部失败才配已验证trace。数学数据仅10–40%配trace,指令遵循99%不配。
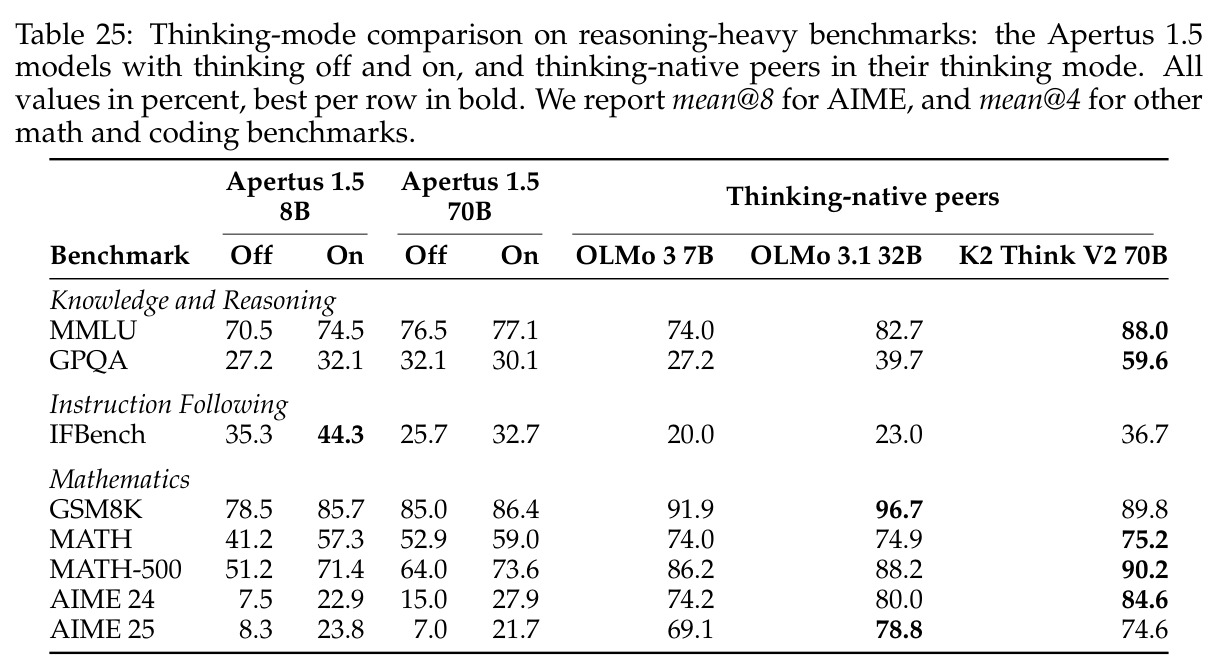
MATH-500提升20.2分的直接来源就是该模式;SFT消融显示trace监督在思考开启时数学+7~18分、但指令遵循−12~14分(约1/4的trace退化为复读),理解这一权衡才能明白数据管线设计的巧思。
研究动机
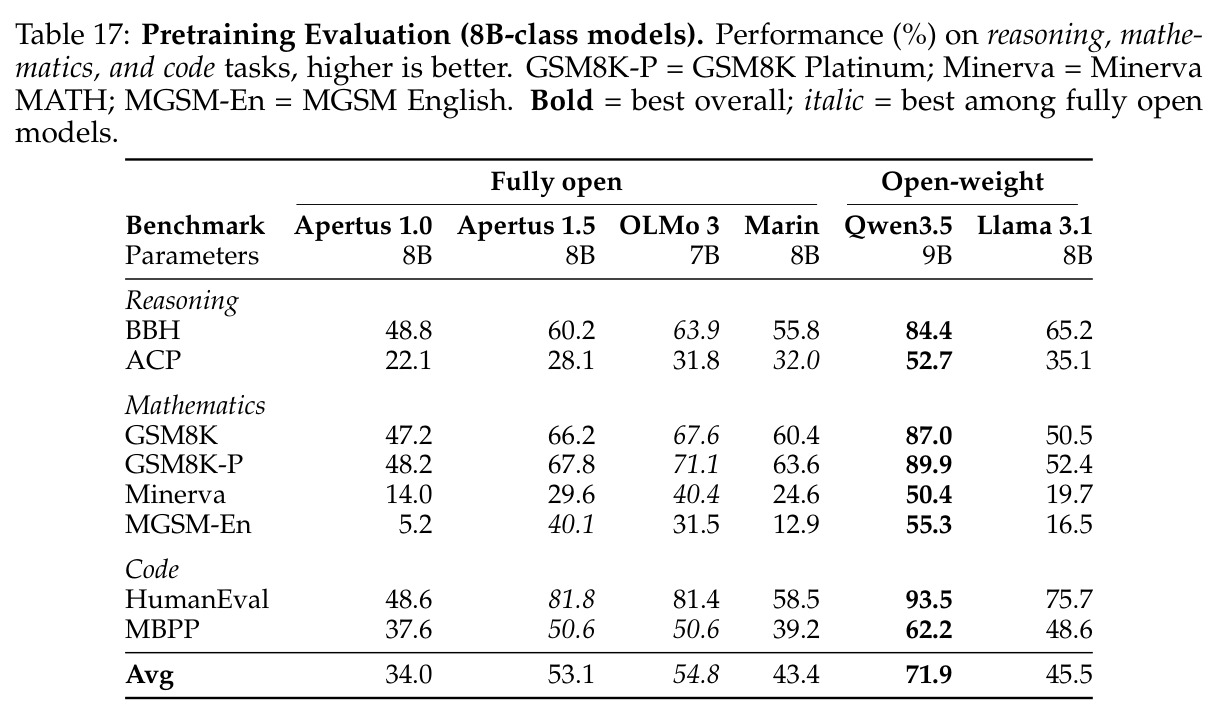
当前最强的大语言模型大多只能通过专有接口访问,即使是开放模型通常也只发布权重,训练数据、代码、配方与对齐所依据的价值观都不可审查。完全开放(权重+数据+代码+配方+价值观五轴)的模型随着研发成本攀升越来越稀少,且能力普遍落后于开放权重同行。Apertus 1.0(2025年9月发布,8B/70B,在CSCS的Alps超算上以15T token、1000多种语言的公开文档化数据从头训练)证明了全开放训练在规模上可行,但它只支持文本:没有图像与音频理解,上下文窗口仅约64K;数学与推理薄弱——8B基础模型HumanEval仅48.6%、GSM8K 47.2%、MGSM英文仅5.2%,AIME几乎无法解题。此外行业报告(如Kimi K2.5)显示向已预训练的文本模型引入视觉数据时文本能力会立即退化、之后恢复缓慢,这使就地升级看起来风险很高,而用编码器投影(LLaVA式)方案又要改架构并在推理时承担编码器开销。
本文的目标是本文的目标是把Apertus 1.0家族就地升级为多模态推理器,同时守住全开放与文本能力两条底线。具体包括:(1) 在架构不变的前提下,通过继续预训练让8B与70B模型获得图像与音频理解(只读不生成);(2) 把上下文窗口扩大4倍至262,144 token;(3) 引入可选的思考模式(聊天模板的请求级开关而非独立模型),使8B数学推理最高提升20分;(4) 显著改善指令遵循与工具调用,目标是8B在所有对比模型(含开放权重)中指令遵循第一、70B单轮函数调用逼近Llama-3.3-70B;(5) 在图像与音频上达到与完全开放多模态模型可竞争的水平,尤其实在文档/图表理解、长音频与低资源语音识别;(6) 发布权重、各阶段检查点、数据配方、训练与评测代码以及指导对齐的章程,全部使用宽松许可证(Apache 2.0)。
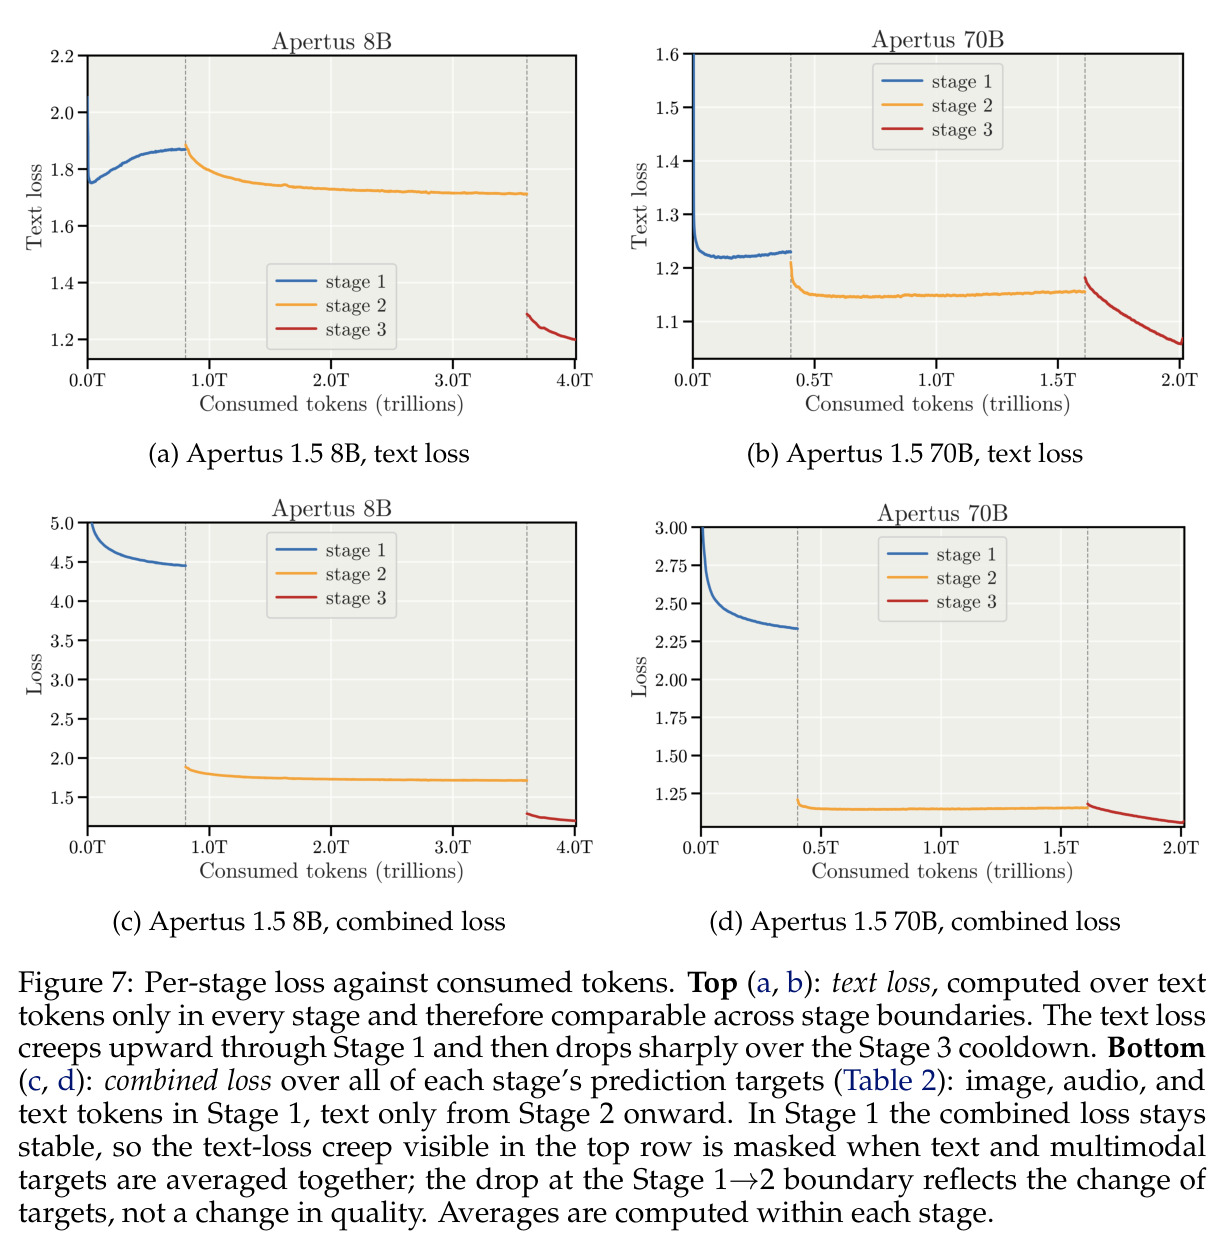
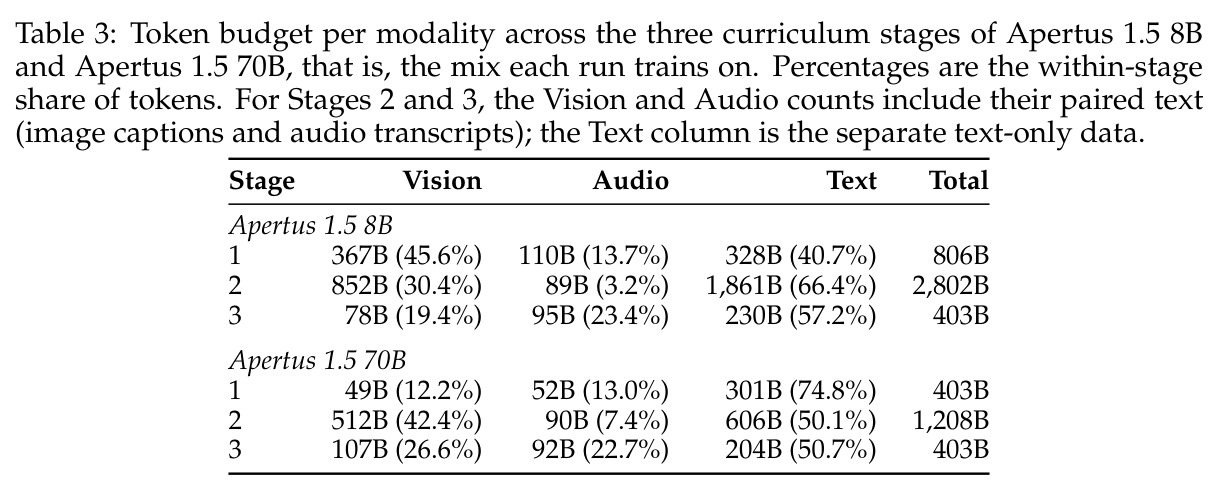
与已有工作不同的是,本文的独特切入角度有三点。其一是模态进入方式:不同于LLaVA式视觉编码器加投影层(架构改动大、推理有编码器前向开销),也不同于Chameleon/Emu3的从头统一训练,本文把图像/音频离线量化为离散token、只扩词表与输入嵌入、语言模型输出头保持纯文本,使持续预训练几乎跑在未改动的Megatron-LM上,多模态Stage 1吞吐5,474 token/s/GPU与纯文本消融的5,300–5,500持平。其二是用受控消融支撑课程设计:证明配对阶段对图像token权重设零是图像理解最强单一设置、非配对表示学习阶段有对数收益,并把Stage 1文本损失爬升的主因定位到cooldown后重新warmup的调度本身而非模态梯度冲突,直接回应了多模态引入伤害文本能力的行业难题。其三是激进的透明度:发布中途重启的8B Stage 1、70B SDPO回滚及事后定位到的tokenizer配置bug等负面结果,这在工业技术报告中极为罕见。
核心方法
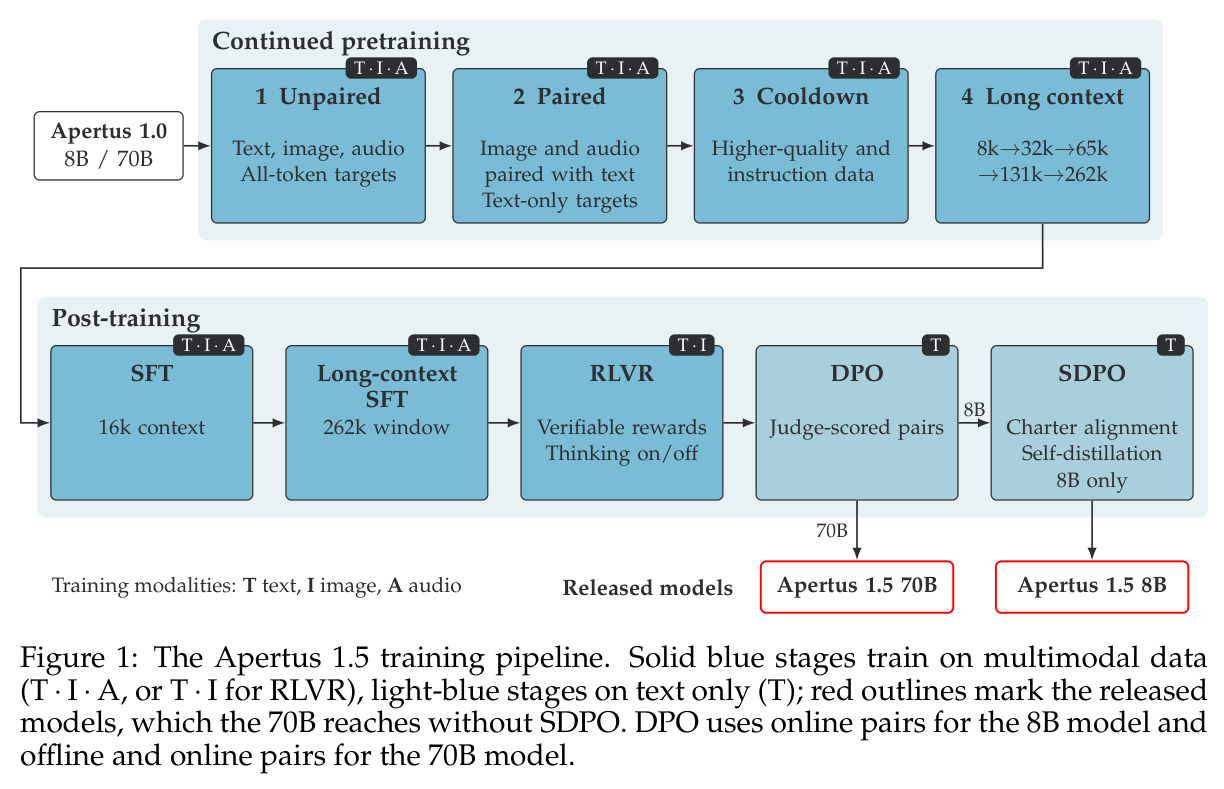
直觉:把图像和音频当作两门新语言的文本——模型学会读(编码进上下文)但永不生成。技术路线:离线用Emu3.5视觉tokenizer(每$16\times16$像素1码,码本131,072;512×512图≈1,024码)与WavTokenizer(24kHz、40码/秒)把媒体转成离散id;词表从131,072扩到266,440,输入嵌入扩至266,752行,输出头保持纯文本。持续预训练四阶段:Stage 1非配对数据全token预测;Stage 2配对图文/音文数据只对文本算loss;Stage 3 cooldown换入更高质量与推理型数据;Stage 4长上下文8k→262k。后训练五阶段:SFT(16k上下文、能力过滤决定推理trace分配)→长上下文SFT(262k修复检索)→RLVR(verl异步、349,300 prompt)→DPO(8B纯在线、70B先离线后在线)→SDPO章程对齐(仅8B发布)。优化用AdEMAMix,8B峰值学习率$1.1\times10^{-4}$、70B加倍至$2\times10^{-5}$。
核心创新一:tokenizer级融合加纯文本输出头。多模态以离散token进入共享词表,模型永不生成非文本token,因此可在几乎原版的Megatron-LM上训练,多模态Stage 1实测5,474 token/s/GPU与纯文本持平——编码器投影方案无法做到。创新二:两阶段课程与配对阶段零图像token权重。受控实验显示图文等权loss严重干扰对齐,而对齐阶段对图像token权重设零是图像理解最强设置;非配对Stage 1投入约57B图像token使GQA 0.50→0.54、DocVQA 0.67→0.71、SEED 0.61→0.65。创新三:能力过滤(pass@8)——辅助非思考检查点判断哪些prompt需要配推理trace(数学仅10–40%配、IF 99%不配),既拿到思考收益又规避trace退化副作用。创新四:SFT后专门的长上下文SFT恢复被摧毁的长程检索(RULER@262k从8.3回到44.9)。创新五:SDPO把公开章程变成可训练目标——裁判按章程写文本反馈,教师log概率经top-64反向KL蒸馏回学生。
方法步骤详情
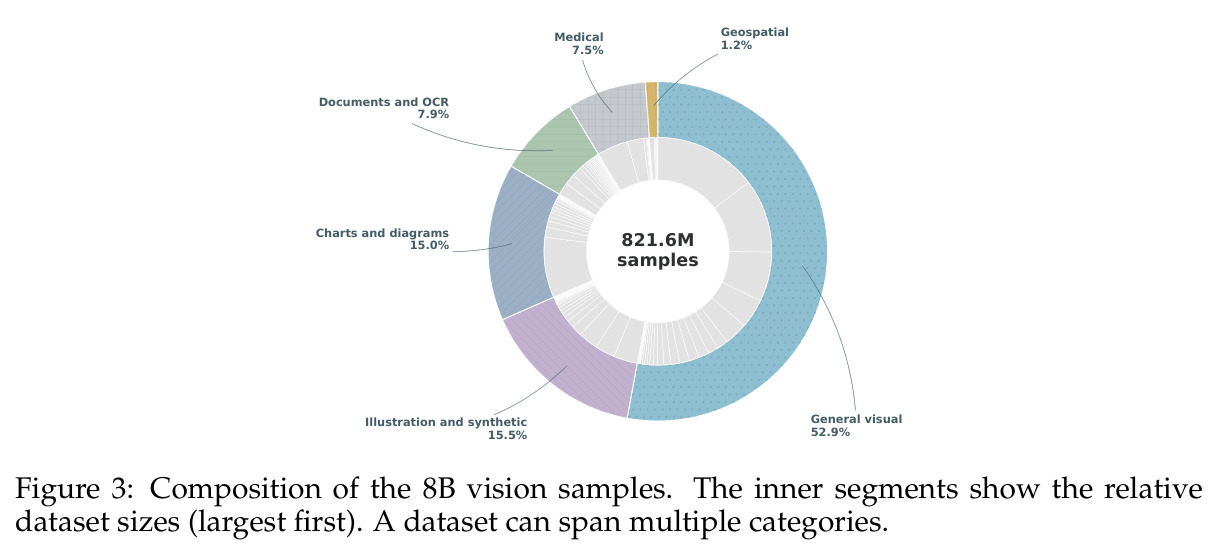
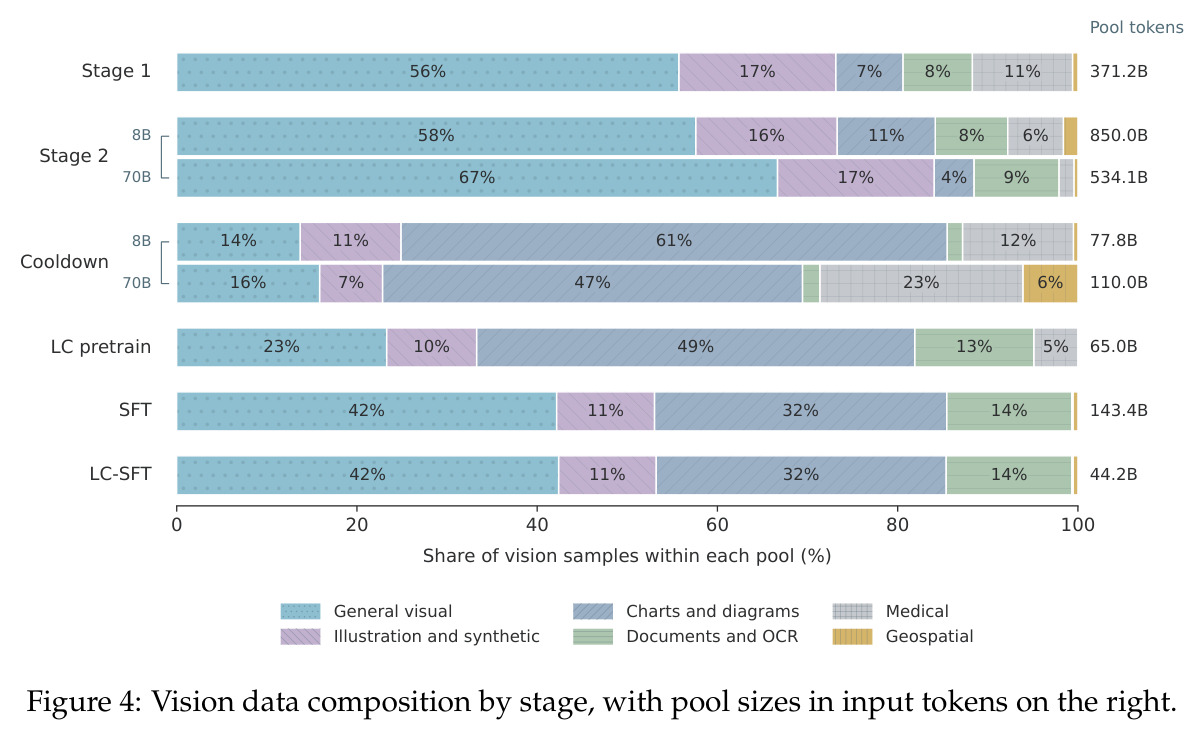
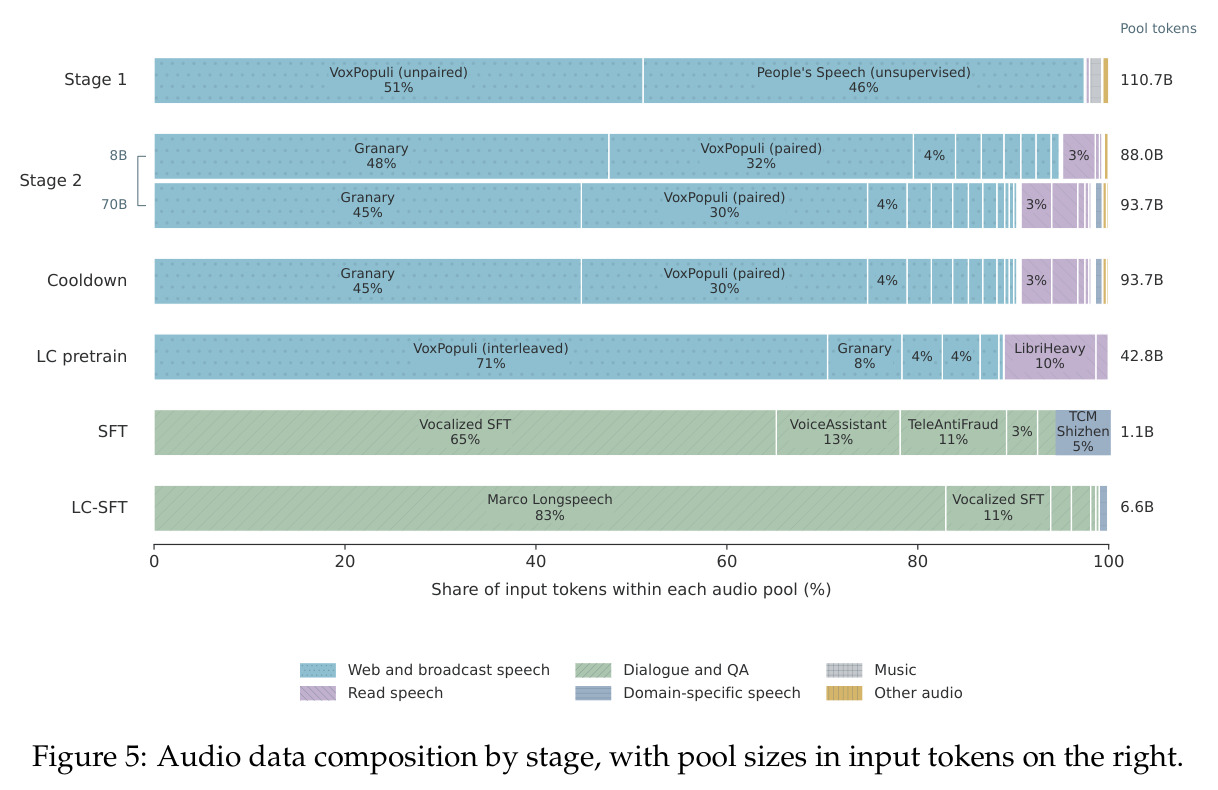
①数据:视觉8.216亿样本(通用52.9%、图表15.0%、文档OCR 7.9%等),感知哈希去重、VLM重标注;音频含转写对与交错序列;文本换入FineWeb2-HQ+、FinePDFs等。②Stage 1:8B训806B token(视觉45.6%/音频13.7%/文本40.7%),全模态算loss。③Stage 2:8B 2,802B token,仅文本目标。④cooldown:各403B,数学/代码占比大增,掺3B指令格式数据。⑤长上下文:4个子阶段各50–63B token,RoPE基频升至$4\times10^6$,混入CWE等合成任务。⑥SFT:370.8万文本样本+图像池143.4B token+语音池,16k上下文,8B 159B token、70B 155B。⑦长上下文SFT:262k窗口、30.3%长多模态。⑧RLVR:349,300 prompt(数学10万、IF 8万、代码3.67万)。⑨DPO:245,898 prompt池,8B在线12 rollouts/prompt,70B先离线再在线。⑩SDPO:8,354条安全prompt、117步、top-64反向KL、32节点2小时。
技术新颖性
(1)大规模验证了离散token持续预训练升级现成LLM的路线,与encoder-projection(LLaVA)和从头统一训练(Chameleon/Emu3)都不同,并首次给出吞吐不打折的工程证据(tokenizer用argmax替代softmax加TF32精度契约使吞吐翻倍且不改任何输出码)。(2)对引入多模态伤文本给出机理级诊断——Stage 1文本损失爬升主因是1.0已cooldown后重新warmup的调度本身,70B几乎无此现象说明代价与容量相关;消融排除了权重衰减、冻结参数等原因。(3)能力过滤把是否给CoT变成可测量的数据配平问题,并以消融证明k<8时数学过滤率可忽略。(4)在公开合规约束(追溯honors robots.txt、无付费墙来源、Goldfish损失防记忆)下完成扩展,给出严格allow-list会丢弃96%的MINT-1T而排除式规则只去2%的可操作结论。(5)SDPO将价值观文档→判词→反向KL自蒸馏链路连同判词模板发布,是少见的可审计对齐。(6)发布8B因学习率翻倍重启、70B SDPO因tokenizer配置bug回滚等事故复盘,负面结果罕见且有价值。
实验结果
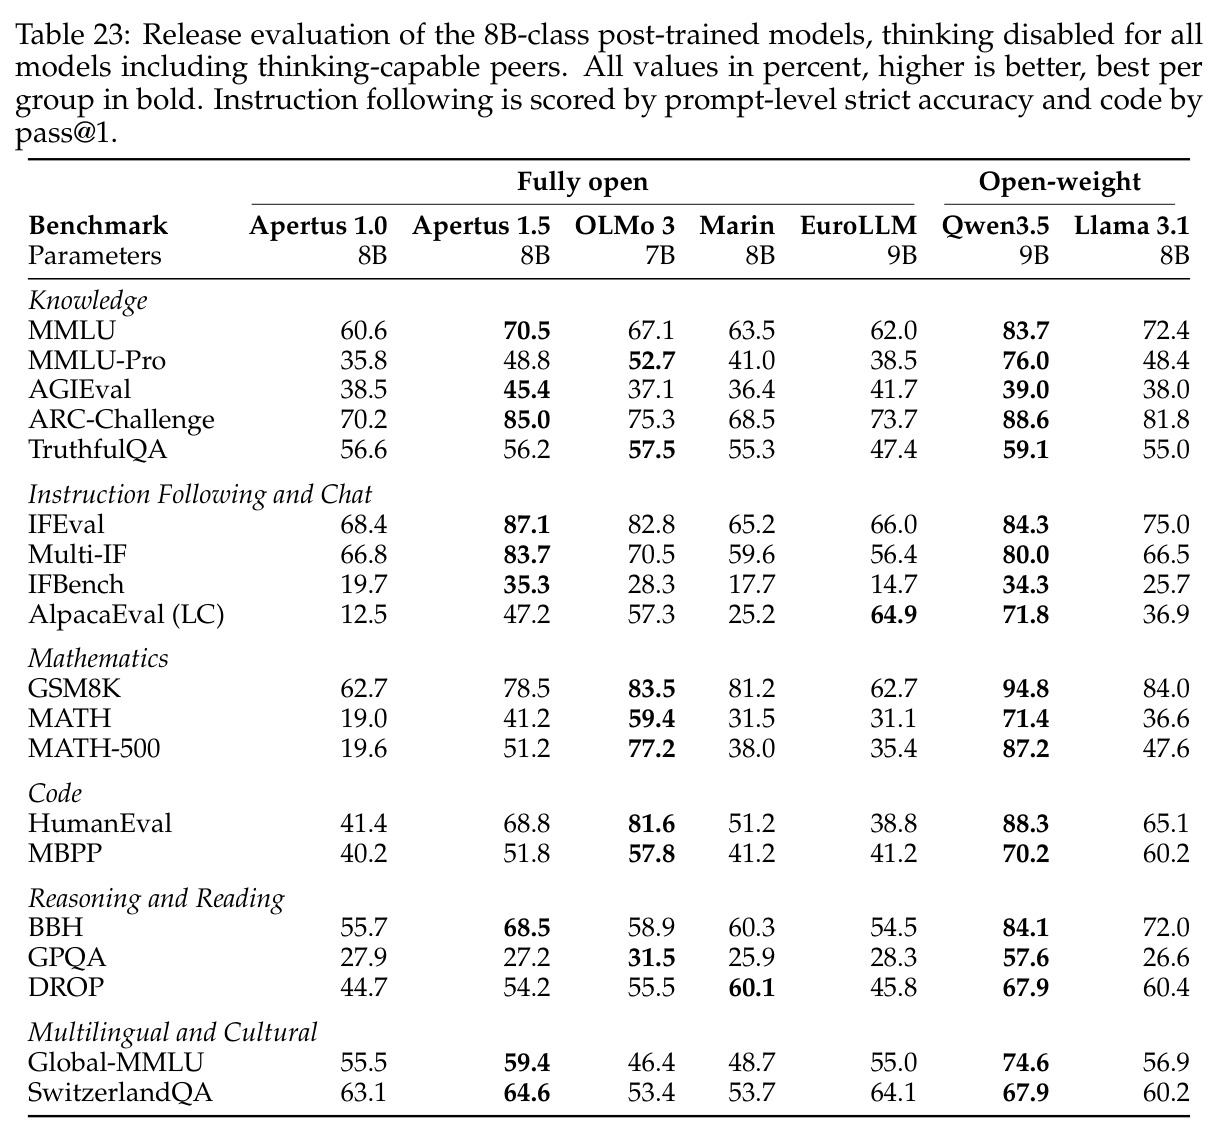
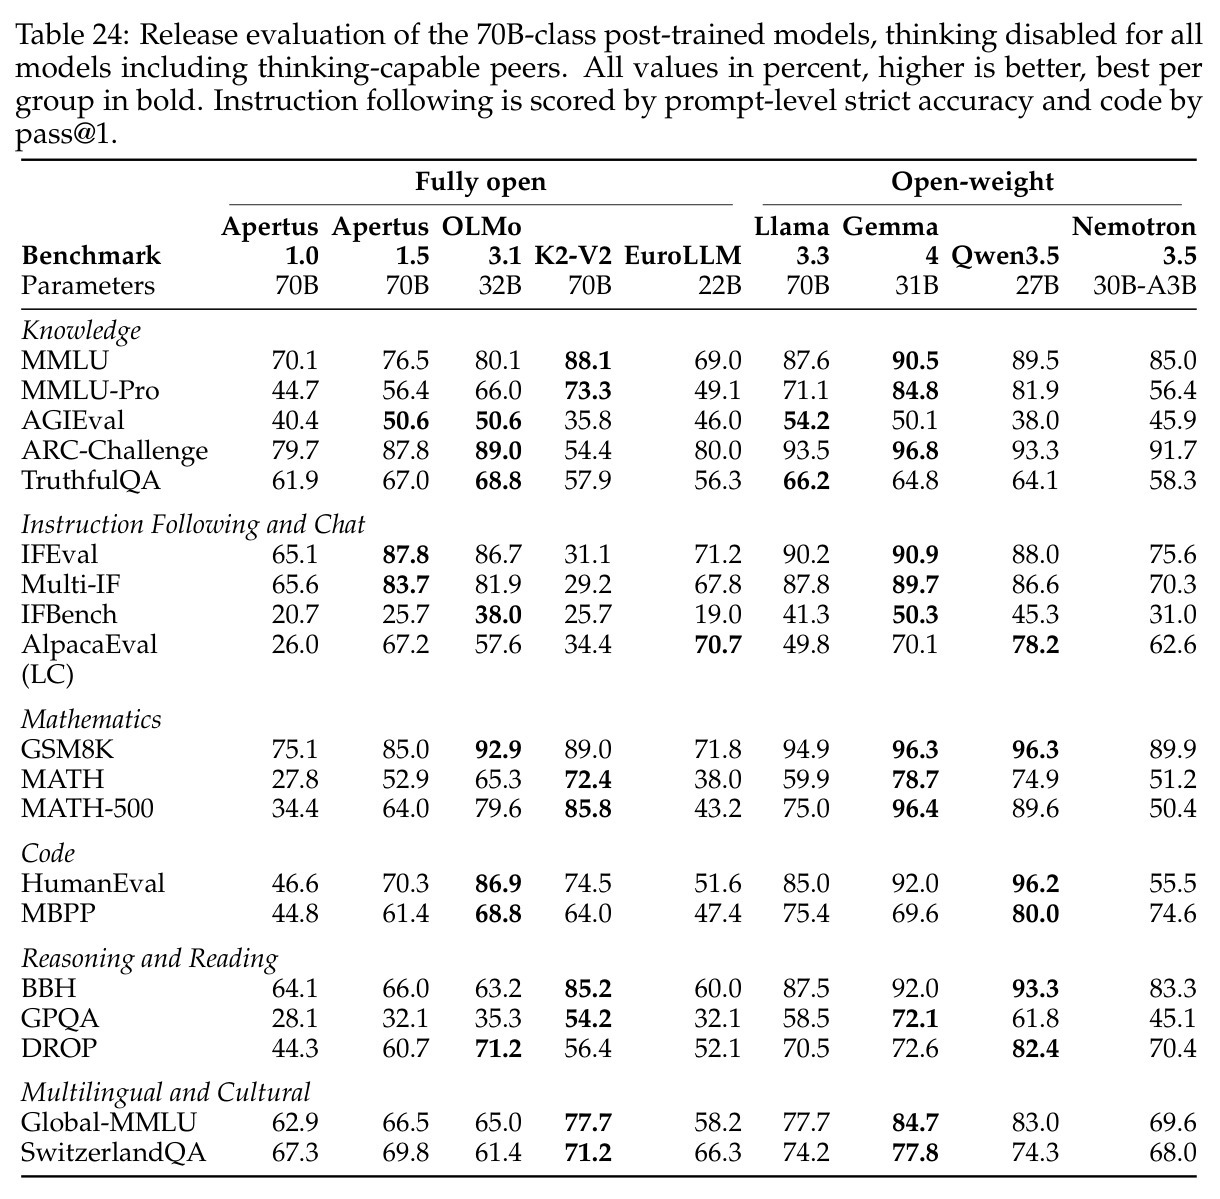
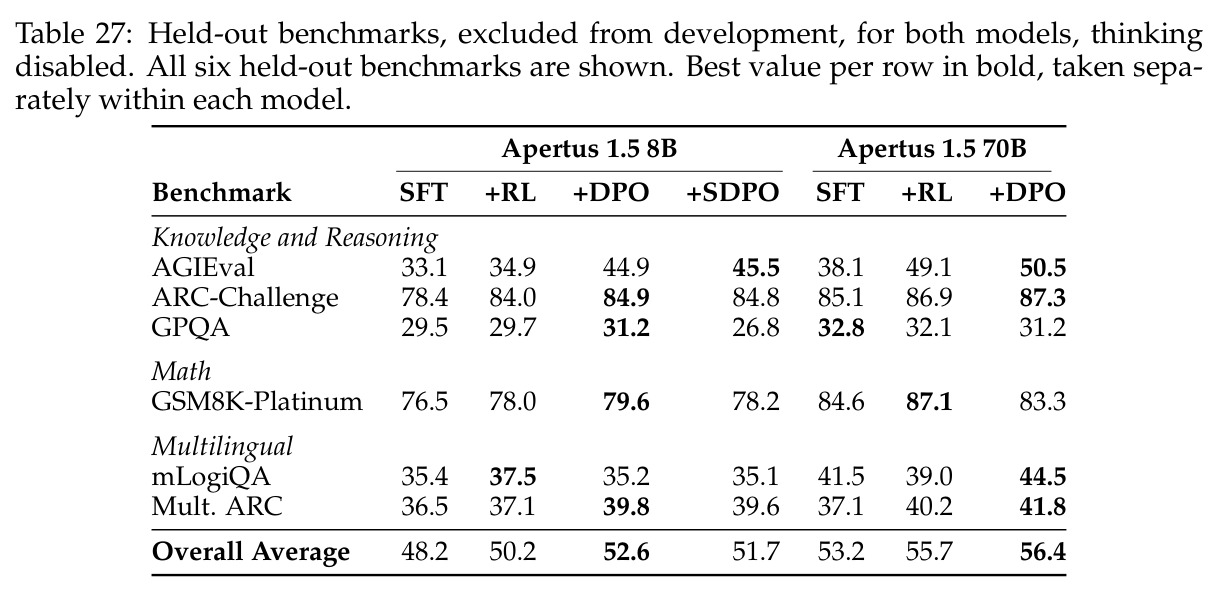
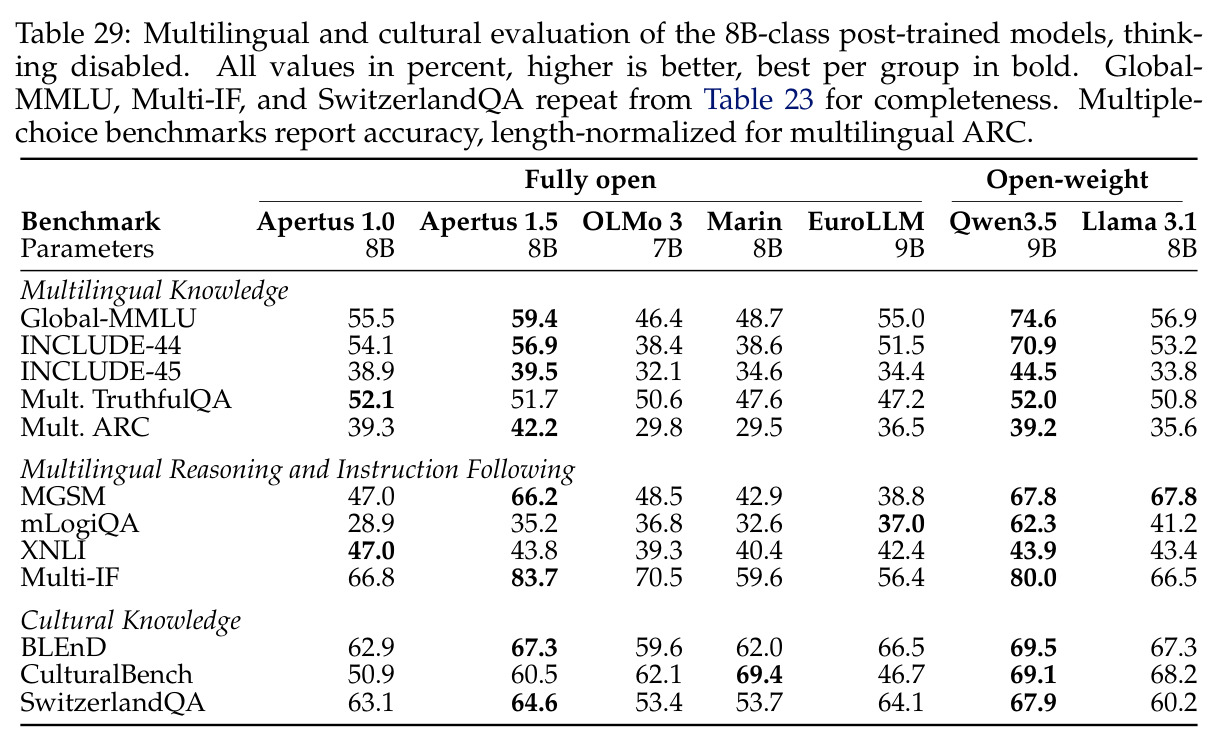
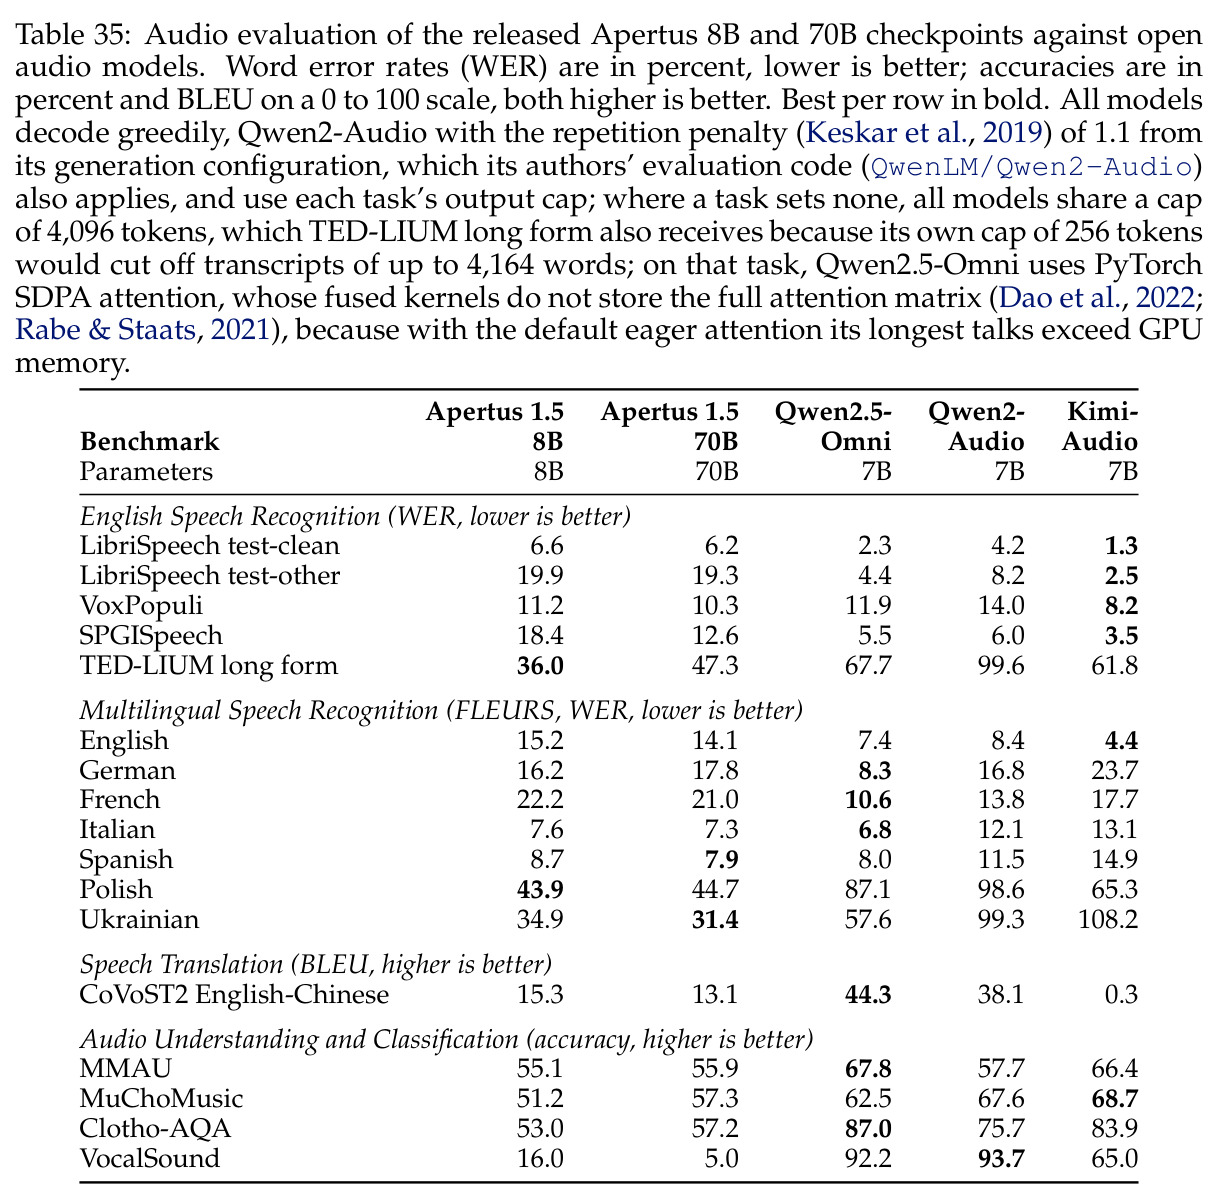
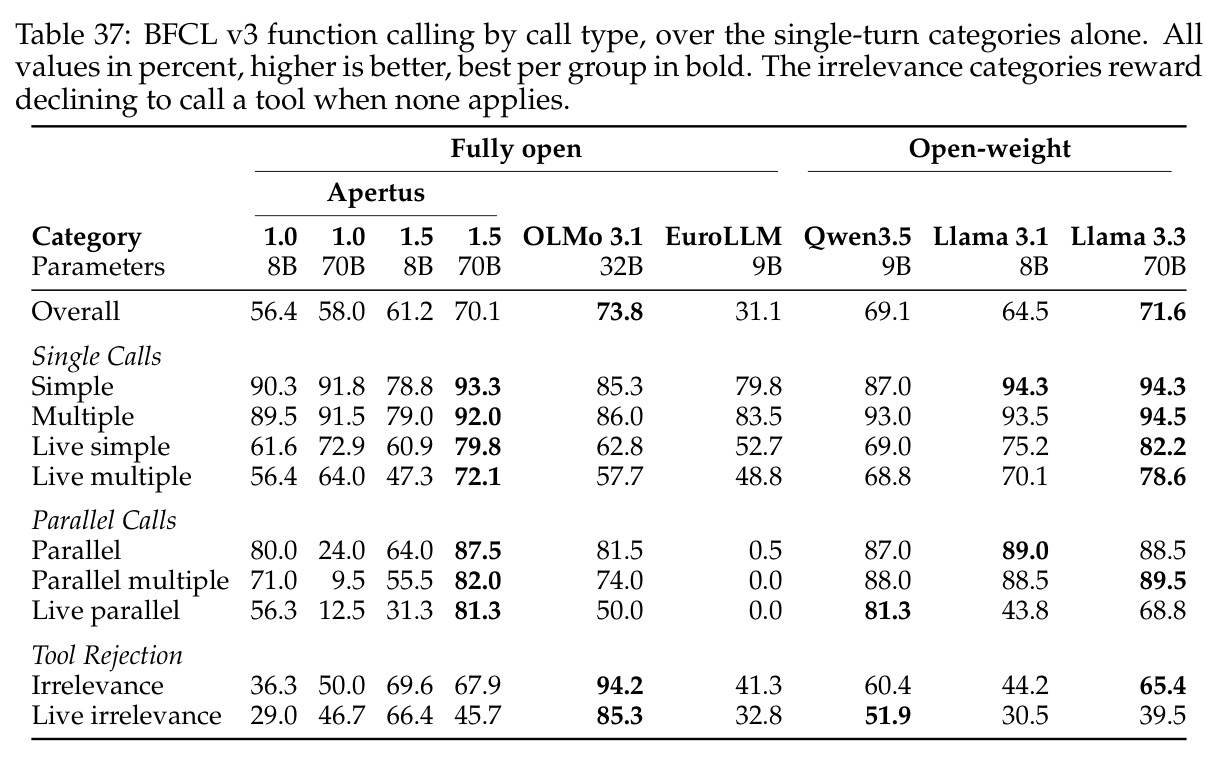
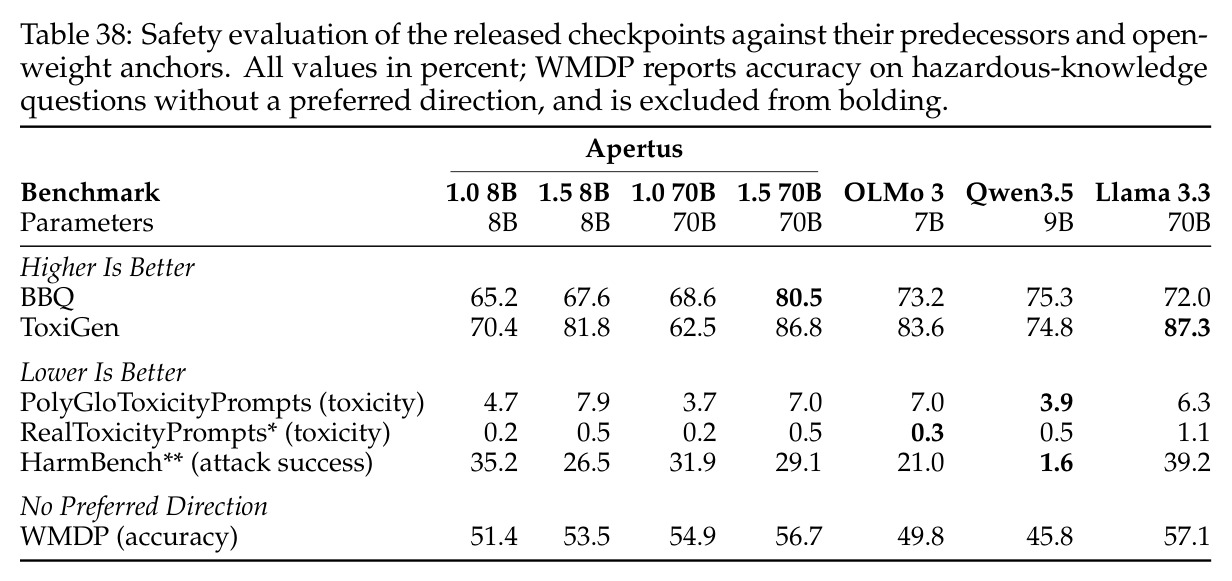
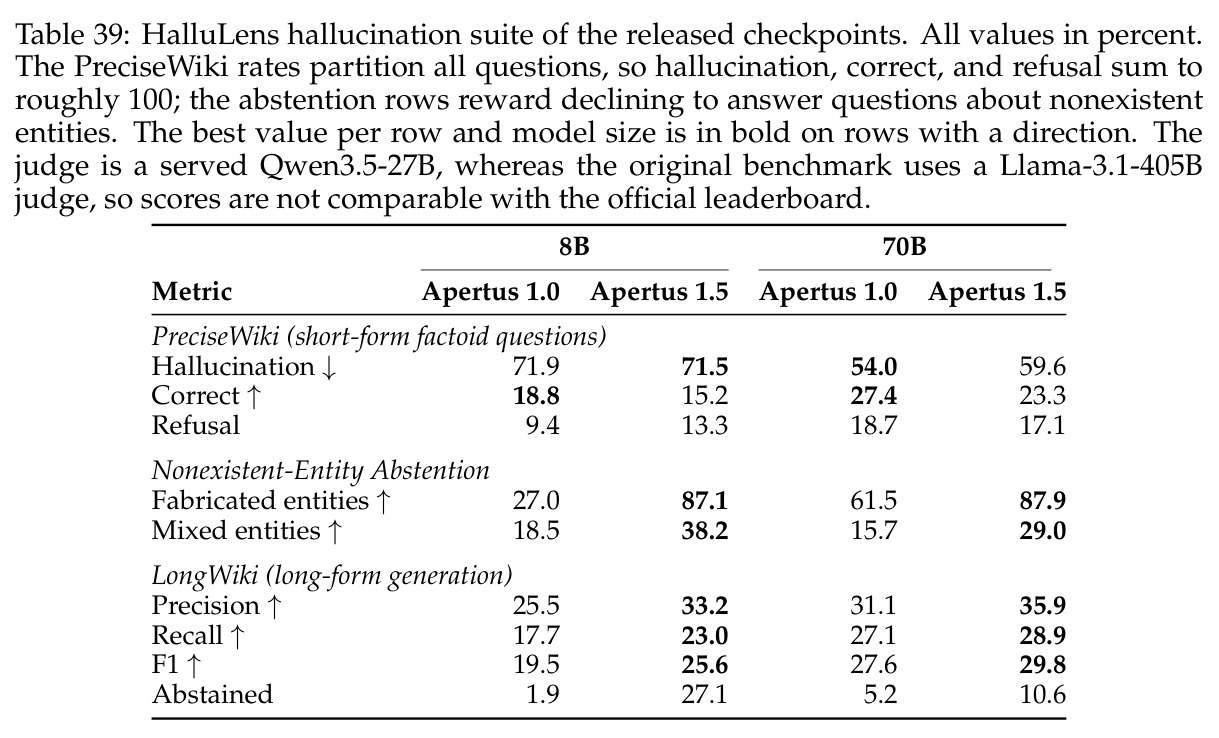
8B后训练模型除TruthfulQA与GPQA外全面超越1.0:IFEval 87.1、Multi-IF 83.7、IFBench 35.3为全部对比模型最高;70B每个基准超1.0。思考模式令8B MATH-500 51.2→71.4、MMMU 39.8→52.2;70B思考后GPQA反降。37个开发基准平均8B 47.3→55.0、70B 52.2→61.2,held-out同向;RL主攻推理与IF,DPO主攻对话/工具/安全(AlpacaEval +12.1/+33.5),SDPO章程对齐+9.9。70B工具调用58.0→70.1(距Llama-3.3-70B仅1.5分)。长上下文RULER@256k最终50.5/45.6。图像8B居完全开放组前列(ChartQA 78.7、DocVQA 84.8)但OCR落后Qwen3-VL(84.8对95.7)。音频长音频突出(TED-LIUM 36.0对同行61.8–99.6),但英语短语音(6.6对1.3)、语音翻译(15.3对44.3 BLEU)与非语音分类(16.0≈随机16.7)落后。安全上ToxiGen +11.4/+24.3、HarmBench 35.2→26.5,但拒绝率3.6%→81.5%、短式幻觉未改善。
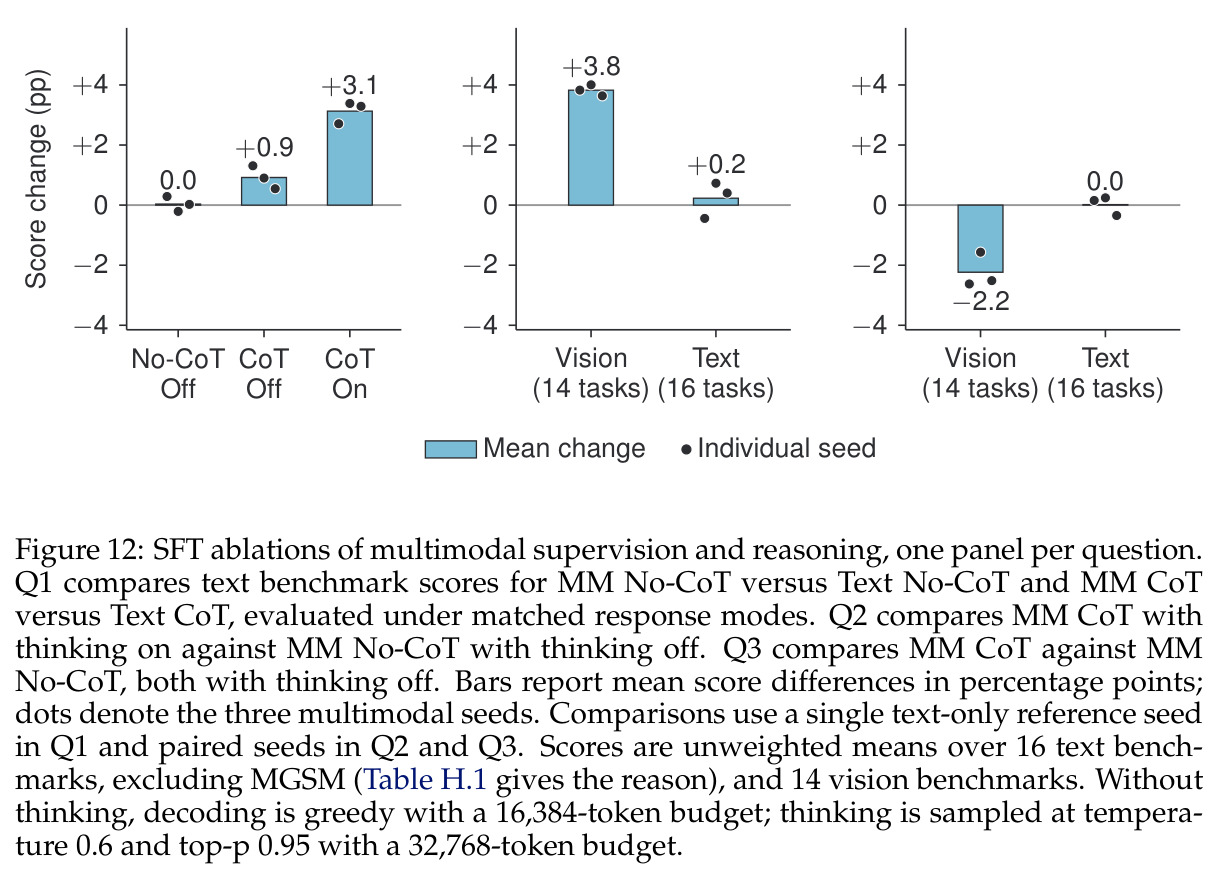
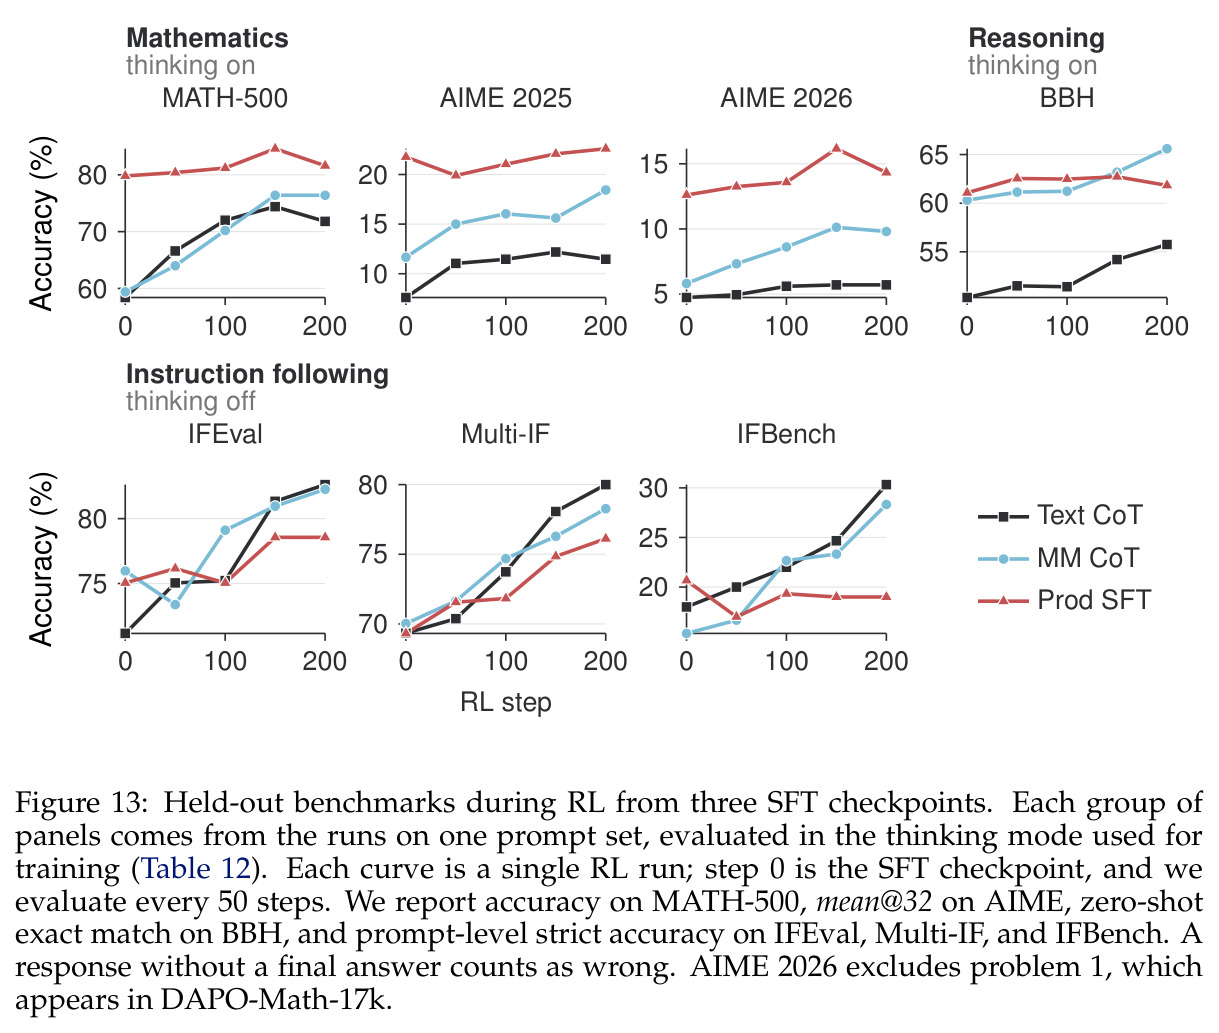
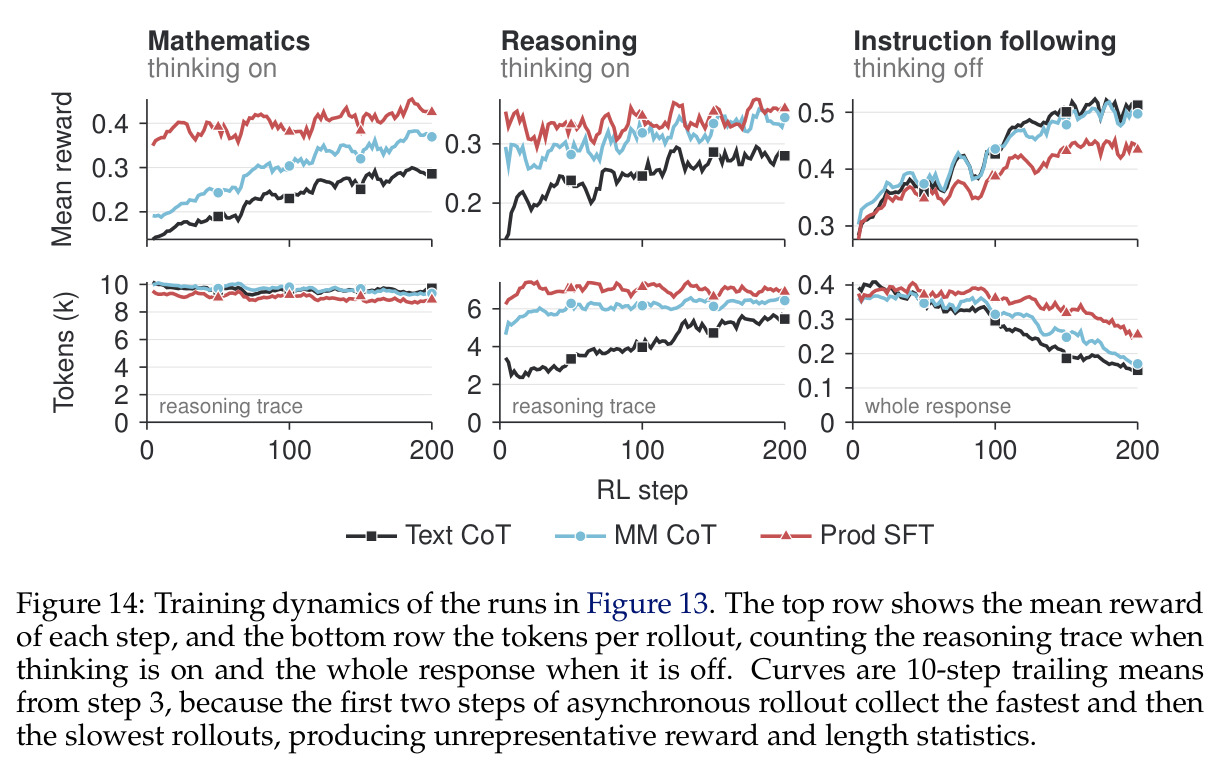
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 8B 指令遵循(思考关闭) | IFEval strict accuracy | 87.1% | Apertus 1.0 8B 68.4%;Llama-3.1-8B-Instruct 75.0% | +18.7分 vs 1.0,所有对比模型(含开放权重)中最高 |
| 8B 多轮/多语言指令遵循 | Multi-IF | 83.7% | Qwen3.5-9B 80.0%;Apertus 1.0 66.8% | +16.9分 vs 1.0,全组最高 |
| 8B 数学推理(思考开启) | MATH-500 (mean@4) | 71.4% | 同模型思考关闭 51.2% | +20.2分 |
| 8B AIME 2024(思考开启) | mean@8 | 22.9% | 同模型思考关闭 7.5% | +15.4分(1.0时代大量题目无法作答) |
| 70B 单轮函数调用 | BFCL v3 总体准确率 | 70.1% | Apertus 1.0 70B 58.0%;Llama-3.3-70B 71.6% | +12.1分,距最强开放权重仅1.5分,修复并行调用(24.0→87.5) |
| 8B 文档理解 | DocVQA | 84.8% | 完全开放最佳同行 Molmo2-8B 69.1% | +15.7分(但仍落后Qwen3-VL-8B的95.7%,OCR是短板) |
| 8B 长音频识别 | TED-LIUM 长音频 WER(越低越好) | 36.0% | Kimi-Audio 61.8%、Qwen2.5-Omni 67.7%、Qwen2-Audio 99.6% | 错误率比最佳同行低25.8分 |
| 8B 长上下文检索 | RULER @256k | 50.5%(SDPO后) | SFT后崩塌至8.3%;长上下文SFT恢复到44.9% | 各长度全面超过Apertus 1.0(1.0不支持256k) |
| 8B 价值观(章程)对齐 | Charter Alignment | 66.7%(SDPO后) | DPO检查点 56.8%;SFT 33.4% | SDPO阶段+9.9分 |
| 8B 安全(攻击成功率) | HarmBench** 平均ASR(越低越好) | 26.5%(直接请求仅1.3%,人工越狱31.5%) | Apertus 1.0 35.2% | −8.7分 |
| 8B 幻觉(捏造实体识别) | HalluLens 弃答率(越高越好) | 87.1% | Apertus 1.0 27.0% | +60.1分;但短式事实幻觉率71.5%基本未变 |
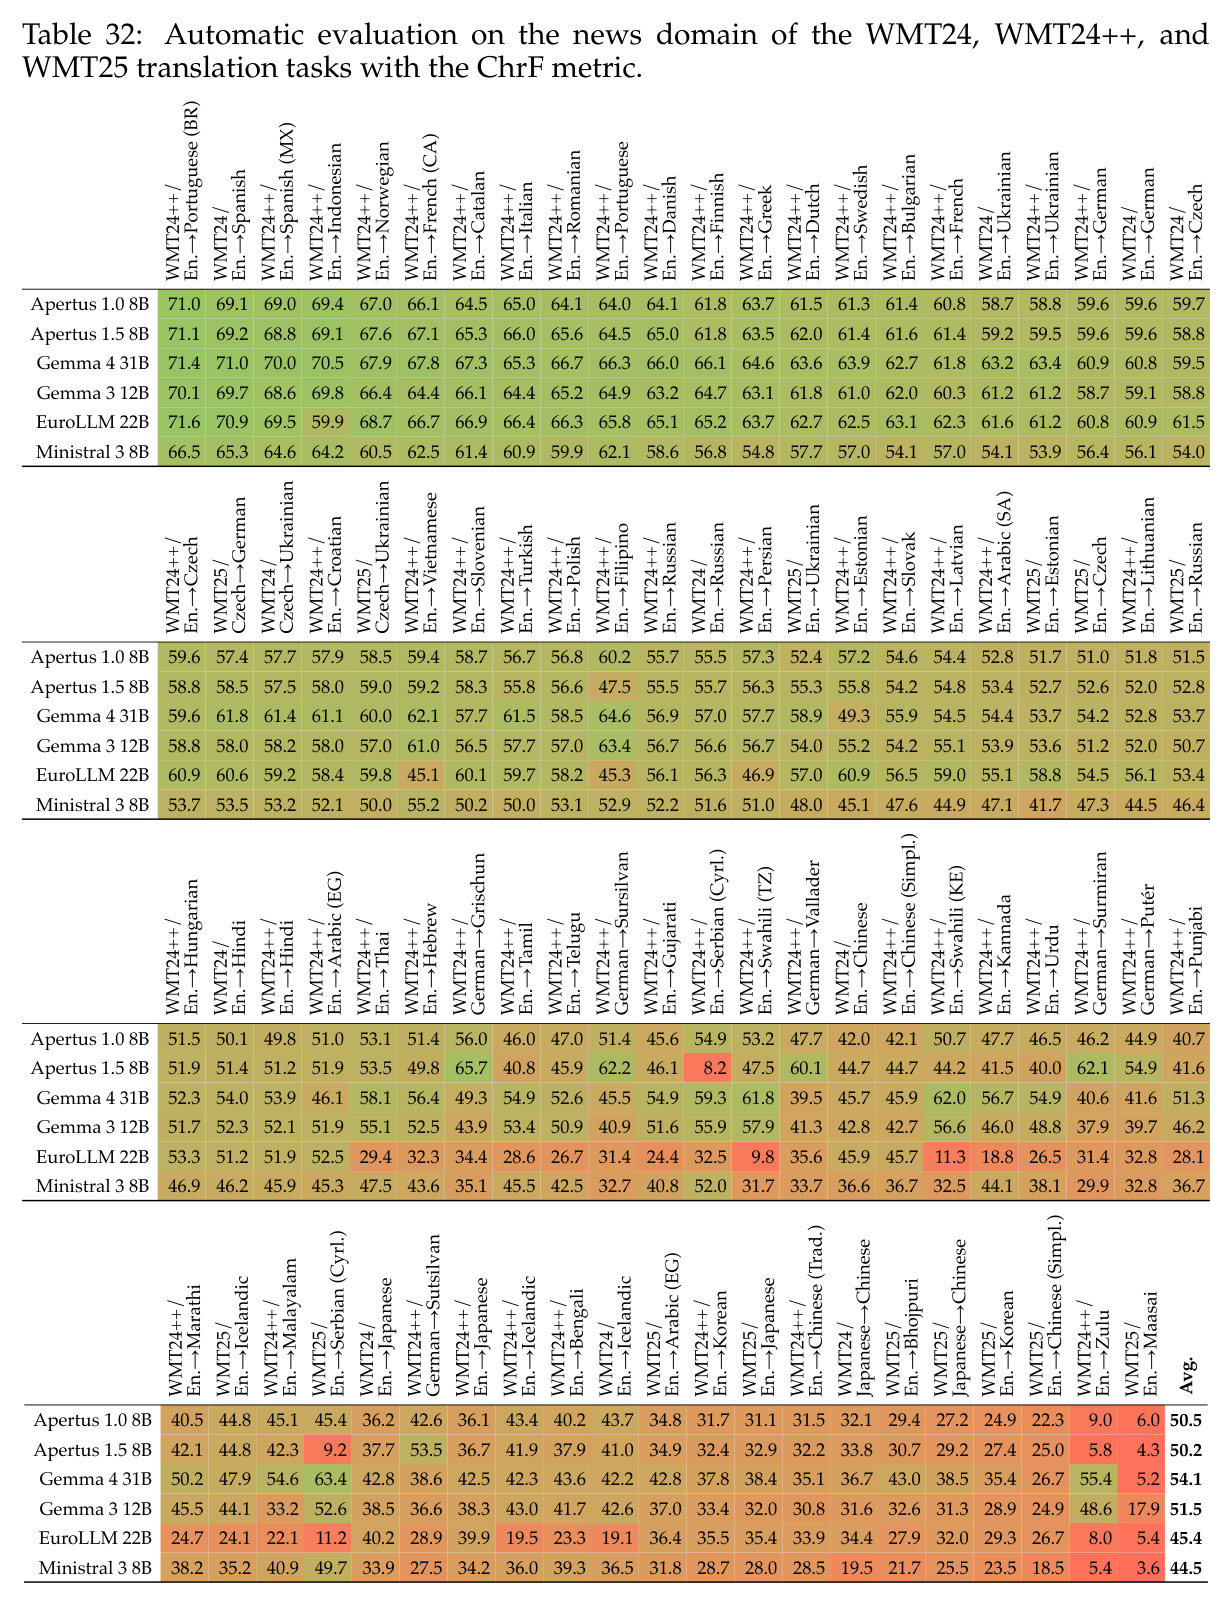
| 德→罗曼什各变体翻译 | ChrF | Grischun 65.7%、Surmiran 62.1% | Apertus 1.0 56.0%、46.2% | 各变体+9.7~+15.9分;人类评估德→Sursilvan 77.1 vs EuroLLM-22B 3.5 |
局限与改进
作者承认:短式事实幻觉未改善——PreciseWiki上10题中8题以上强行作答、其中6–7题幻觉,70B甚至略差于1.0(54.0→59.6);对齐后过拒绝激增(OR-Bench硬子集8B拒绝率3.6%→81.5%、70B 2.9%→67.6%);XNLI两档规模均退步(8B 47.0→43.8);模型只懂图像音频不会生成;70B多模态反而不如8B(配额被挤占、继承学习率过低);工具调用与思考互斥;8B并行调用弱;偏好对齐使RefCOCO系定位框系统性变松(约−17分);低资源语言偶发身份误认。我的观察:(1)OCR短板与Emu3.5每16×16像素1码的粗量化直接相关(文档与医学PSNR低3–4dB),是token效率换来的结构性代价;(2)音频名不副实——非语音分类近随机,音乐与环境声零监督;(3)评测用自家harness与公开判题模型,跨报告绝对值不可比;(4)AIME等小样本基准即便mean@8方差仍大;(5)70B的9倍参数收益甚微更多暴露数据预算被砍与LR校准问题,而非容量上限。
独立分析的弱点
①OCR/文档精细还原受限于16×16像素/码的粗粒度量化(消融中文档与医学PSNR损失3–4dB)。改进:混合分辨率tokenizer或对OCR数据提高分辨率。②非语音音频近随机(VocalSound 16.0%/5.0%),训练池纯语音且偏议会讲话。改进:加入AudioSet级环境声与音乐监督。③工具调用与思考互斥,源于SFT无相关轨迹、RL因工具服务器吞吐瓶颈剔除工具prompt。改进:SFT植入思考内调用工具的轨迹,再用已解耦的Kubernetes奖励沙盒做小规模RL。④对齐引发过拒绝与grounding框漂移。改进:DPO裁判维度加入OR-Bench式难负例与定位IoU检查。⑤短式幻觉率6–7/10未改善。改进:对事实类问题引入弃答奖励或检索增强。⑥学习率迁移规律不明——8B峰值翻倍即崩、70B继承LR过低限制模态适应。改进:推广保留优化器状态续训观察loss选LR的校准法。⑦身份混淆指向蒸馏数据携带隐性行为信号,需来源审计与合成身份对话对冲。
未来方向
作者提出:下一代以短式幻觉抑制与工具调用×思考组合为首要目标;加大多语言/多文化后训练投入(70B在Last Translation Benchmark退步到0.66%对8B的1.32%是明确信号);引入grounding-aware对齐奖励修复RefCOCO回退;修复tokenizer配置后把SDPO重新用于70B(事后实验:章程+2.4%、代码+1.1%、聊天−1.2%)。可延伸方向:(1)把SDPO的章程→判词→自蒸馏框架推广为可复用的开源对齐范式,让机构用自有价值观文档训练并公开判词模板;(2)走向真正的omni输出——交错语音文本生成(当前只读不生成);(3)长上下文×多模态组合评测与训练(262K图文文档问答);(4)用Claritas平台的探测结果做训练时干预:深层激活爆炸约百倍(修复后幻觉探针AUC 0.90)、层15+退化探针可预警,可接入RL奖励或早停;(5)跨模型多模态嵌入迁移——8B嵌入直接拼给70B会不稳定,值得研究投影对齐;(6)合成可验证长上下文任务与真实任务的差距及RL/DPO不训长文却提升RULER的迁移机制。
复现评估
复现性在同类工作中几乎最高:权重与全部阶段检查点(base/SFT/RL/DPO/最终,以Hugging Face仓库分支形式)以Apache 2.0发布;Megatron-LM fork、omni tokenizer、多模态与后训练数据清单及逐数据集许可表、SFT混合、偏好对、评测harness、tokenizer基准、合成长上下文任务生成器乃至数据消融的W&B链接全部公开;判题模型、解码参数与已知陷阱章节写明。算力门槛高:8B用256节点GH200、70B用512节点,持续预训练+长上下文扩展约200万GPU时≈1.1GWh。完全复现仅大型机构可行,但增量复现友好:SFT仅159B token、RL 480步、在线DPO 8B在24节点<12小时、SDPO 32节点2小时,基于发布检查点可低成本继续训练或换章程对齐。难点在数据侧:MINT-1T原始快照约700TB,URL型数据集抓取需与数据中心网络/安全团队协调(本文构建了FireHOL/URLhaus/Spamhaus驱动的代理过滤管线,仅拒绝<0.01%下载)。
论文图表
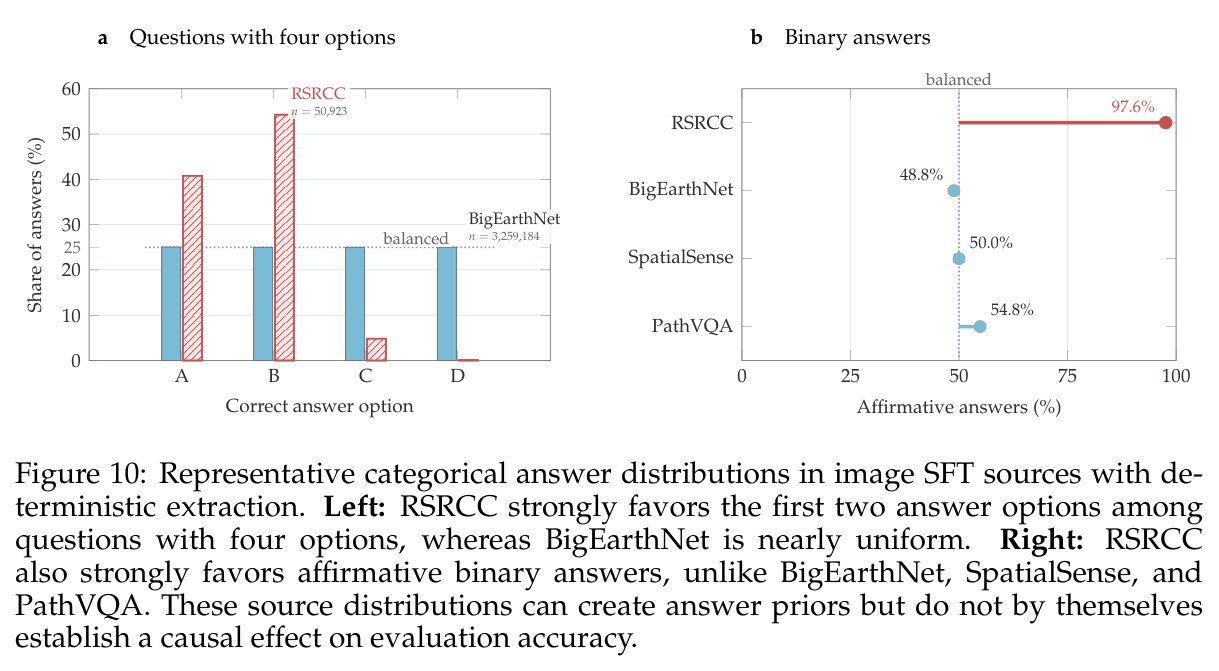
图像SFT数据源的分类答案分布:RSRCC的四选题中A/B合计约95.1%(40.8%+54.3%)、二选题97.6%为yes,而BigEarthNet近乎均匀、SpatialSense完全均衡。图注指出源分布可能造成答案先验并虚高同源评测,但本身不构成因果证据。
暴露多模态SFT数据的质量陷阱:答案偏置会让同源基准分数虚高,读图像评测数字(尤其RSRCC类数据相关项)时必须带着这个先验。