BigCell:吉像素级病理全切片图像生成 BigCell: Generating Gigapixel Whole-Slide Images
首个原生吉像素分辨率的全切片病理图像生成模型,自适应调度提速3倍,实现8k文本生图
前置知识
全切片图像(WSI)
病理组织经扫描仪数字化得到的超高分辨率图像,常超过 50,000×50,000 像素(吉像素级),是癌症诊断的主要依据。WSI 在不同放大倍数下呈现不同结构:细尺度是细胞形态,粗尺度是腺体与肿瘤架构,且染色特性全局一致、远处区域相互耦合,例如肿瘤细胞不应出现在正常组织区域。
本文的任务对象就是 WSI,理解其多尺度结构与全局一致性约束,才能明白为何传统小块生成器无法胜任。
流匹配与 SiT
流匹配是一类生成模型:训练网络预测从噪声到数据的连续插值路径上的速度场 $v_\theta(z_t, t)$,推理时对 ODE 做数值积分逐步去噪。SiT(Scalable Interpolant Transformer)是其 Transformer 实现,本文将其参数化为速度预测器 $v_\theta(z_t, t, y)$,与扩散模型同属迭代去噪范式。
BigCell 的生成主干就是流匹配 Transformer,滑窗推理与加速策略都建立在逐步去噪的迭代结构上。
无分类器引导(CFG)
提升条件生成质量的推理技术:同时计算条件速度 $v_\theta(z_t, t, y)$ 与无条件速度 $v_\theta(z_t, t, \varnothing)$,用外推放大条件影响。本文反向利用这个差值:以 $\|v_{cond} - v_{uncond}\|_1$ 作为每个窗口对条件依赖程度的免费重要性度量。
本文核心加速技巧(自适应调度)直接复用 CFG 中本就要计算的两个速度之差,理解 CFG 才能看懂加速原理。
病理基础模型
在大规模病理图像上自监督预训练的通用编码器:patch 级如 UNI-2、Virchow-2、H-Optimus-1,可将 256×256 小块编码为 1536 维特征;slide 级如 TITAN、MOOZY 聚合整张切片信息。它们是现代计算病理学两阶段范式(特征提取 + MIL 聚合)的基石。
本文的条件信号(UNI-2 特征网格)、文本编码器(TITAN)与几乎全部评价指标都构建在这些模型的特征空间之上。
滑窗生成
生成超出训练分辨率图像的推理时策略:把大图划成重叠窗口,在每个窗口上独立运行块生成器,将各窗口预测的速度聚合为全局速度场后统一做一步 Euler 更新,重叠区域保证拼接处连贯。LRDM 首先在病理领域引入该框架。
BigCell large 正是用滑窗把 2048 原生分辨率扩展到 32k,吉像素生成的开销与 3 倍加速也都发生在这一层。
研究动机
病理全切片图像(WSI)是癌症诊断的核心依据,但现有病理生成模型全部工作在块级:以语义图、文本描述或基础模型特征为条件,生成 256 到 1024 像素的固定大小小块,其中最强的 PixCell 也只能原生生成 1024×1024,距真实 WSI 常见的 50,000×50,000 像素相差几个数量级。这带来两个错位。其一是监督信号与生成尺度的错位:病理医生面对的是整张切片,临床报告描述的是病例级别(含多张切片)的发现,而像素级标注极其昂贵——Graikos 等人报告仅为单张 WSI 的小块写标注就花了 40 小时病理医生时间,真正大量存在的是 slide 级报告和标签。其二是独立小块与 slide 级形态的错位:染色特性必须全局一致、细胞形态必须与周围组织类型兼容(正常组织区不应出现肿瘤细胞),这些跨越数千像素的空间结构恰恰是诊断价值所在,一堆独立生成的小块无法忠实表达它们。同时,现代计算病理系统正走向 slide 级建模(TITAN、MOOZY 等),块级生成器也无法为其提供忠实训练数据。
本文的目标是本文要建造第一个能在原生吉像素分辨率下单阶段生成连贯病理全切片的生成模型。具体目标分四层:第一,训练一个 2048×2048 原生分辨率的流匹配 Transformer 块生成器(BigCell tile),在 120,703 张公开 WSI(涵盖多器官)上训练,并通过推理时滑窗管线合成最高 32,768×32,768 像素、相当于小型到中等 WSI 尺寸的完整切片;第二,引入免训练的自适应调度策略,用单个可解释超参数 $r$ 把生成计算量压缩约 $1/r$,实现 3 倍以上加速且质量几乎不降;第三,训练条件生成模型(CGM),从自由文本病理报告直接采样稠密条件网格,实现首个 8192×8192 分辨率的文本生图;第四,验证合成数据的实际价值——在少样本分类设定下,用合成样本增广真实训练集可带来最多 18% 的相对性能提升,并由三名委员会认证病理医生盲评确认合成图与真实图不可区分。
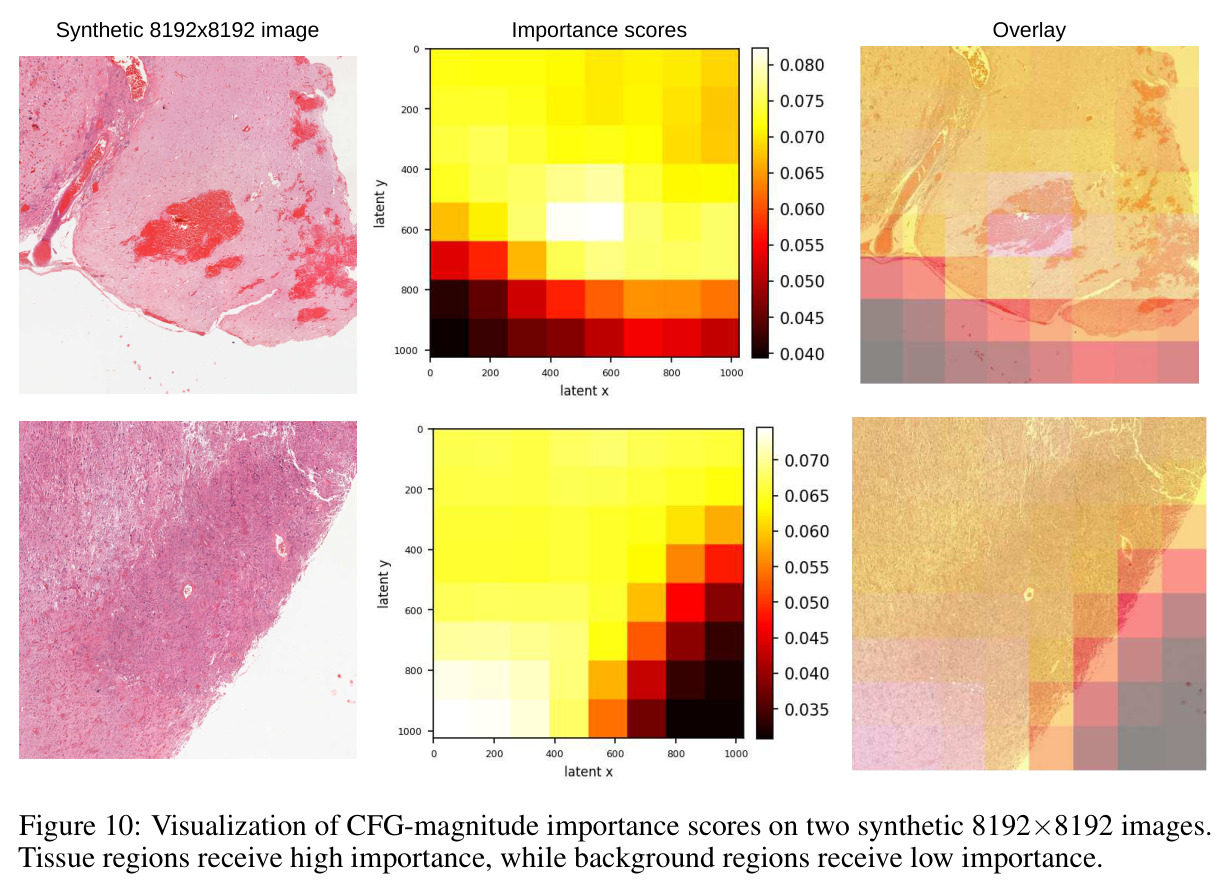
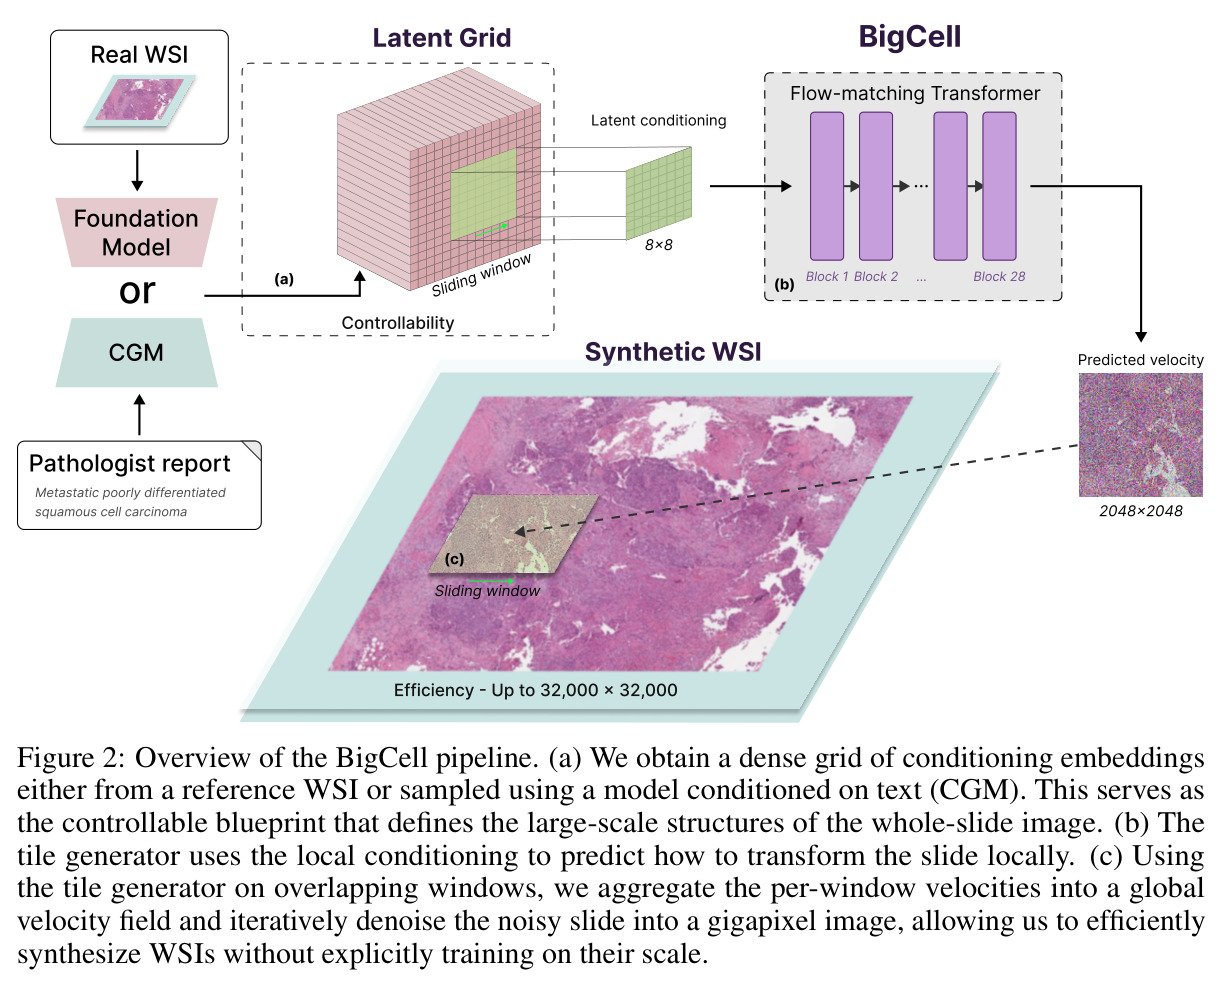
与已有工作不同的是,已有工作把大图生成处理成级联或独立补丁:Harb 等人先无条件采样 512×512 缩略图、再逐级超分到 65,536²,全图只在缩略图层被采样一次,后续各阶段只是局部锐化模糊裁剪;DiffInfinite 用逐像素组织类别掩码耦合远处小块,但掩码编码不了染色等全局属性,也未验证吉像素尺度。本文的独特视角有二。其一,用病理基础模型的稠密特征网格充当整张切片的全局蓝图:滑窗去噪的每一步、每个窗口都通过交叉注意力读取蓝图对应区域,被精确告知那里该是什么组织,全局连贯性由机制保证而非事后拼接。其二,观察到窗口对条件的依赖极不均匀——肿瘤边界等复杂形态强烈依赖条件信号,而背景或均质间质只靠无条件先验就能合成,于是把 CFG 中本就要计算的条件与无条件速度之差当作窗口重要性,跳过低重要性窗口的去噪并复用缓存速度。对异质难度的这一观察,同时催生了质量上的领先与 3 倍的效率提升。
核心方法
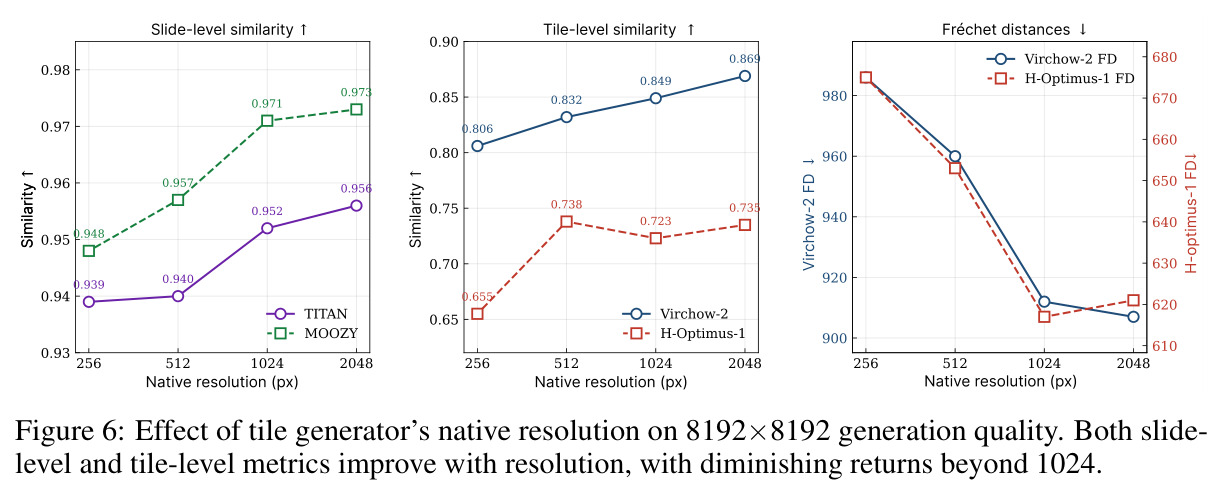
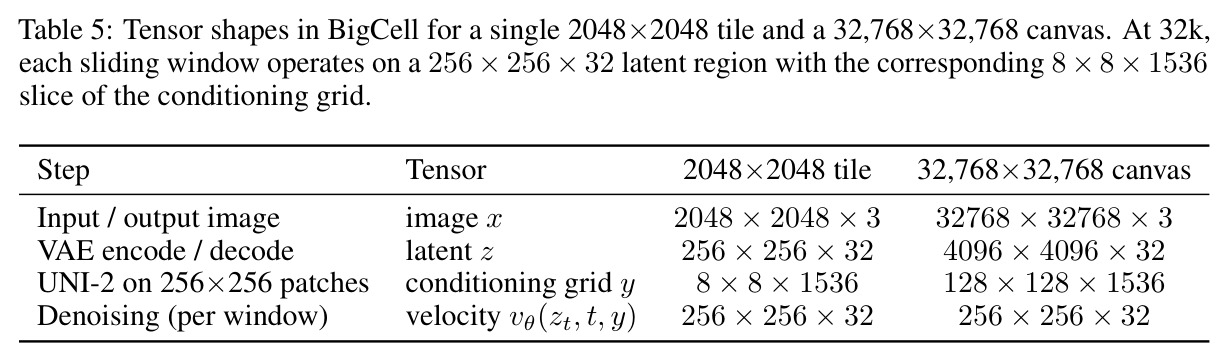
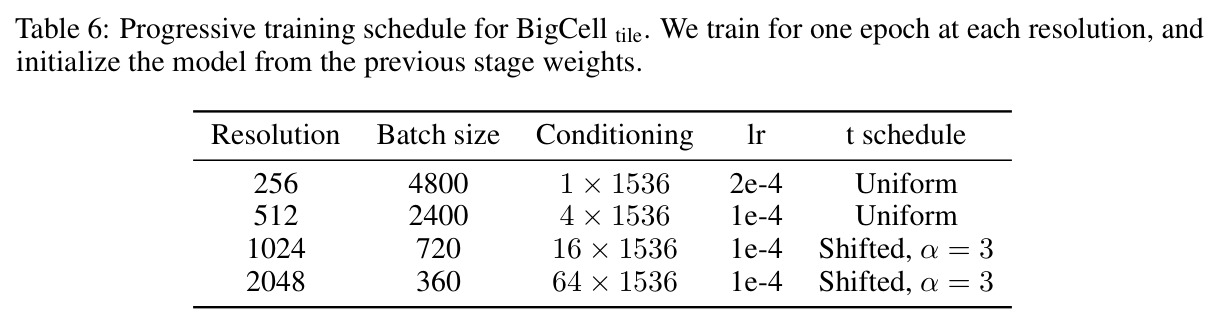
直觉上,BigCell 像『先画蓝图、再分片施工』:一张全切片先用病理基础模型的特征网格勾勒出每个位置应有什么组织(蓝图),再由一个只在 2048×2048 上训练的块生成器按蓝图逐窗口上色,重叠窗口保证拼接连贯。技术路线分三层。底层是 BigCell tile:在预训练 VAE 的潜空间(2048² 块编码为 256×256×32 潜变量)中训练的 SiT 流匹配 Transformer,速度预测器 $v_\theta(z_t, t, y)$ 以每个块对应的 8×8×1536 维 UNI-2 特征网格 $y$ 为条件(经交叉注意力注入),训练分辨率从 256 渐进提升到 2048,训练数据为 120,703 张公开 WSI 的约 1,600 万个块。中层是 BigCell large:推理时把目标图组织成重叠窗口,每个去噪步对各窗口独立求速度、聚合成全局速度场后做一步确定性 Euler 更新,最终由 VAE 解码出最高 32,768² 的像素图。上层是效率与文本控制:自适应调度跳过低重要性窗口实现 3.1 倍加速;CGM 从病理报告采样条件网格,实现 8192² 文本生图。消融显示吉像素质量随原生分辨率从 256 到 2048 单调提升,1024 后收益递减。
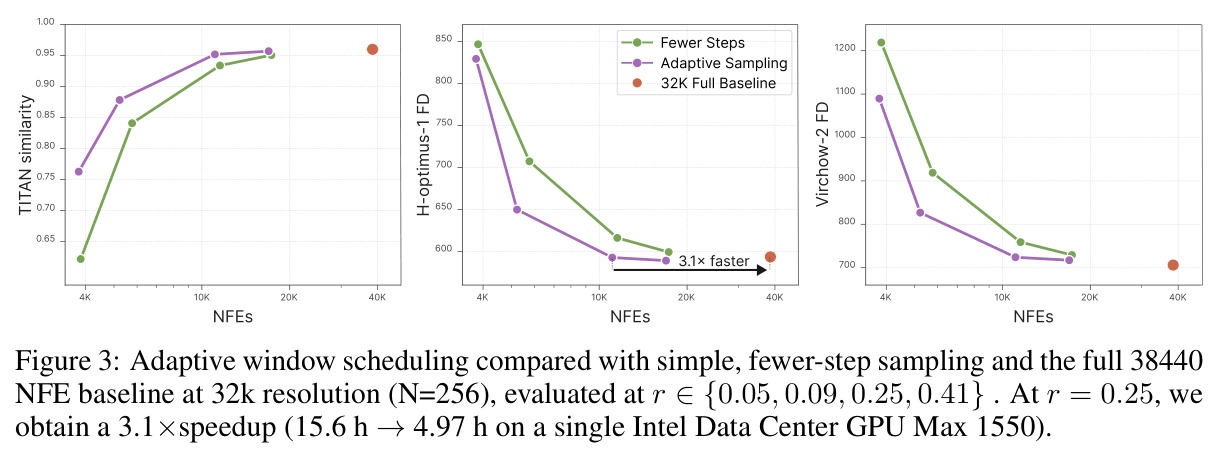
核心创新有两个。第一个是把全局一致性问题转化为稠密条件网格问题:不像级联方法只在缩略图层采样全局结构,BigCell 让一张 $\mathbb{R}^{(H/256)\times(W/256)\times1536}$ 的 UNI-2 特征网格充当整张切片的蓝图,滑窗去噪的每一步、每个窗口都通过交叉注意力读取蓝图的对应区域,『哪里是肿瘤边界、哪里是正常间质』在生成全程被精确约束,染色一致性与组织兼容性作为蓝图约束的自然推论涌现出来,这是先验级联或掩码耦合方法机制上做不到的。第二个是效率上的洞察:窗口难度异质——复杂形态区域强烈依赖条件,均质区域无条件先验就足够。于是用 CFG 中本就要计算的 $I_{ij}(t) = \lVert v_\theta(z_{ij}, t, y_{ij}) - v_\theta(z_{ij}, t, \varnothing) \rVert_1$ 作为重要性分数,每步只对 top-$r$ 重要窗口做完整去噪,被跳过的窗口直接复用最近一次缓存的速度。这是免训练、只有一个可解释超参数的加速方案,把 32k 生成从 15.6 小时压到 4.97 小时,且在同等算力预算下始终优于简单减少去噪步数的基线。
方法步骤详情
完整流程分六步。第一步,构造条件网格:对参考 WSI 的每个 256×256 块提取 UNI-2 特征,拼成 $(H/256)\times(W/256)\times1536$ 的稠密网格 $y$;若无参考图,则由第五步的 CGM 从文本采样。第二步,训练 BigCell tile:VAE 把 2048² 块编码为 256×256×32 潜变量,SiT 在约 1,600 万个训练块上做流匹配学习,分辨率从 256 渐进升至 2048。第三步,滑窗去噪:给定目标 $H\times W$,每个去噪步把 BigCell tile 独立应用于所有重叠窗口,把各窗口速度聚合为全局速度场,做一步确定性 Euler 更新,最后 VAE 解码整张潜画布,得到最高 32,768² 图像。第四步,自适应调度:首步计算全部窗口的重要性 $I_{ij}(t)$,之后每步仅对 top-$r$(如 $r=0.25$)窗口计算速度并更新分数,其余窗口复用缓存速度,计算量约降为 $1/r$。第五步,CGM 文本到网格:用 TITAN 编码约 3 万份报告,在 50 万对(网格,文本嵌入)样本上训练另一个流匹配 Transformer,在 UNI 表示空间联合采样 32×32×1536 网格(对应 8192² 区域),经 BigCell large 解码成图。第六步,数据增广:对真实样本的 UNI 网格加噪至 $t'=0.5$,再以类专属提示去噪回 $t=0$,生成保持全局结构、带类一致变化的图像加入训练集。
技术新颖性
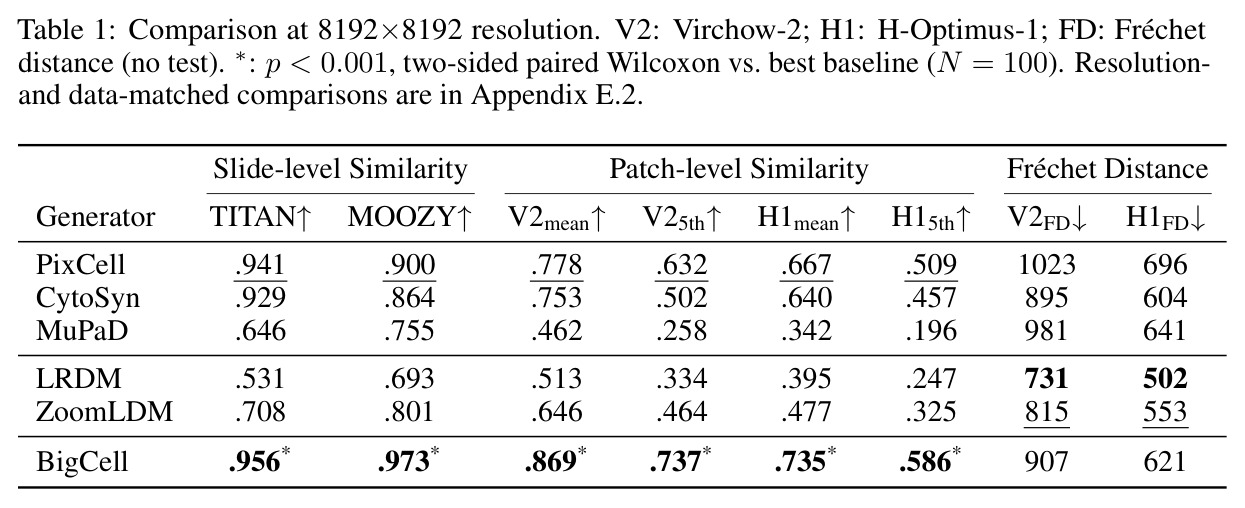
与最近的相关工作逐项对比可看清新颖性。对 PixCell(原生 1024、拼接可达 4096):BigCell 原生分辨率提升到 2048,且单阶段联合去噪整张潜画布到 20 倍尺寸;对 LRDM(滑窗推理的开创者):BigCell 把该框架扩展到流匹配,并以更大的原生分辨率与更强的条件跟随能力显著超越它(TITAN 相似度 0.956 对 0.531);对 ZoomLDM:BigCell 不做显式跨尺度一致性建模,而靠单阶段高分辨率训练;对 Harb 等人的多级级联:BigCell 拒绝『缩略图采样 + 逐级超分』的范式,全图在每个去噪步被联合精化;对 Wu 等人的单图 token 级算力分配:BigCell 的调度以窗口为单位、跨去噪步缓存并复用速度,这是其方法做不到的。文本生图方面,CGM 直接在基础模型表示空间联合生成整张条件网格以捕捉长程依赖,是首个 8k 病理文本生图;自适应调度则是病理生成领域首个利用 CFG 幅度做免训练加速的方案。
实验结果
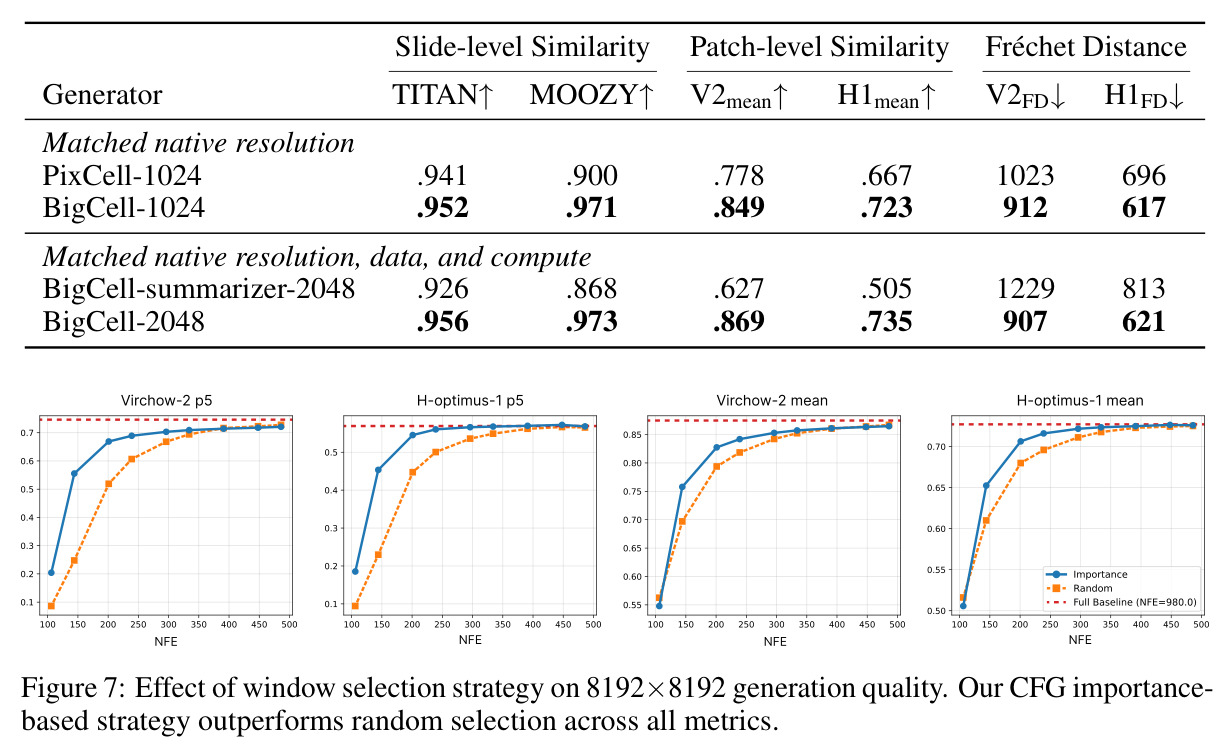
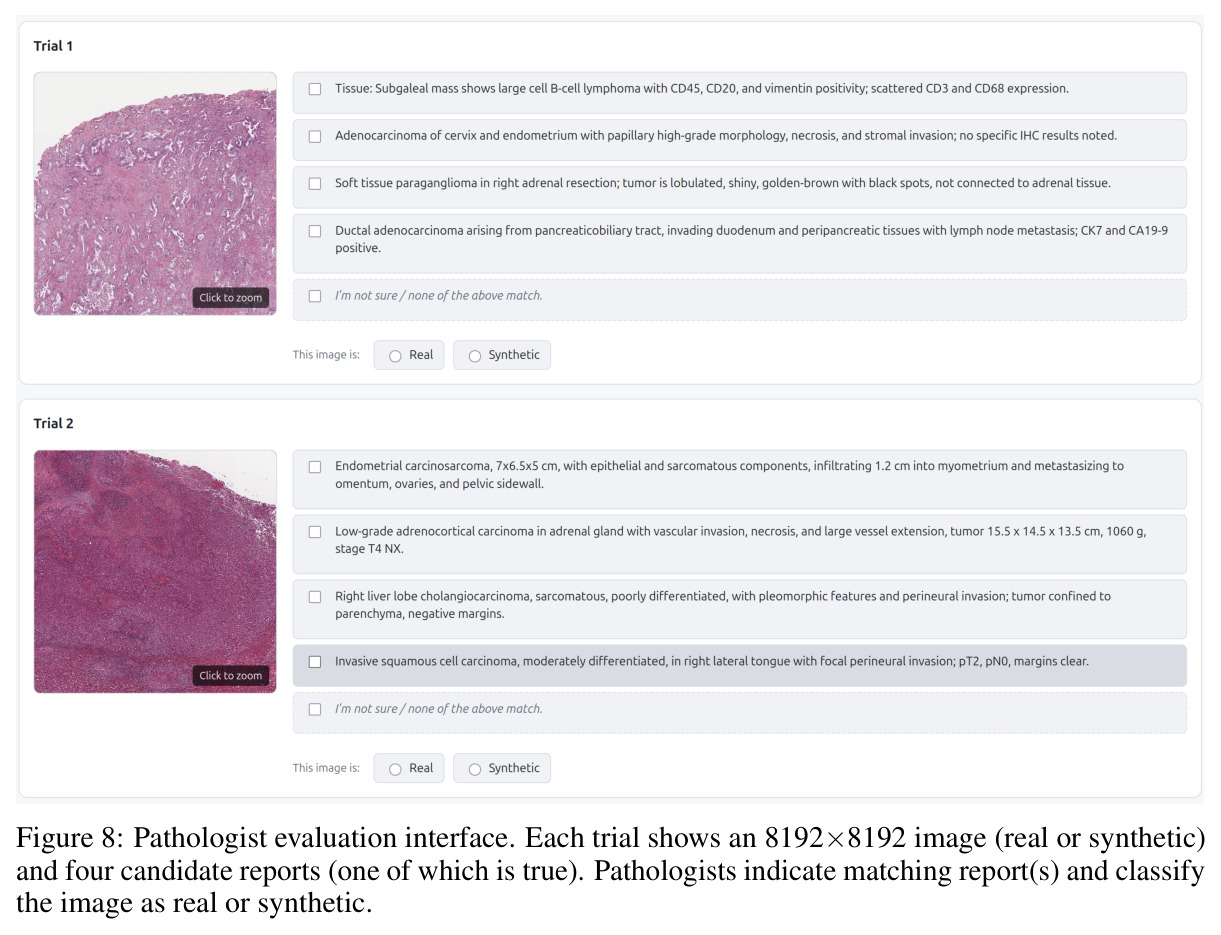
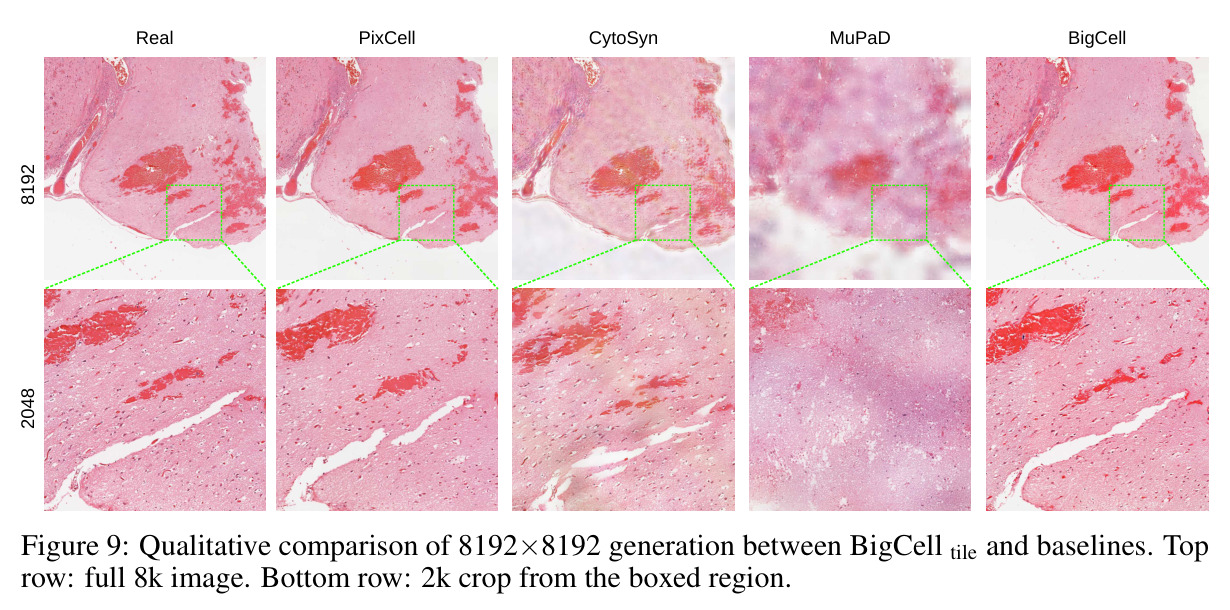
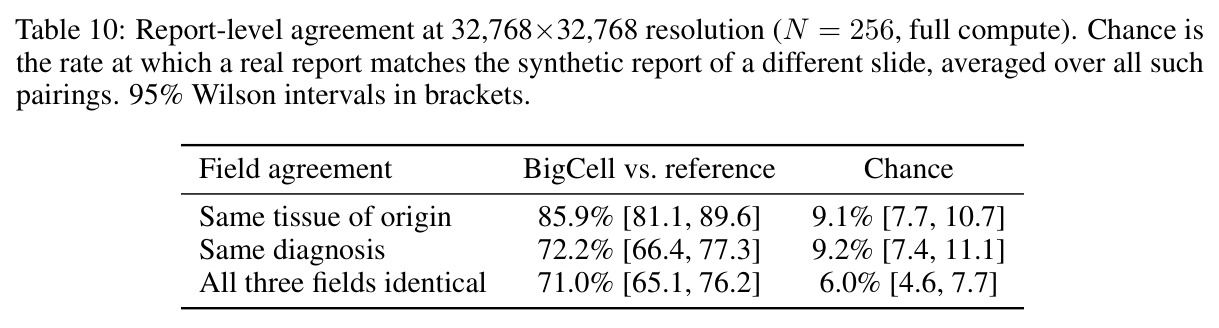
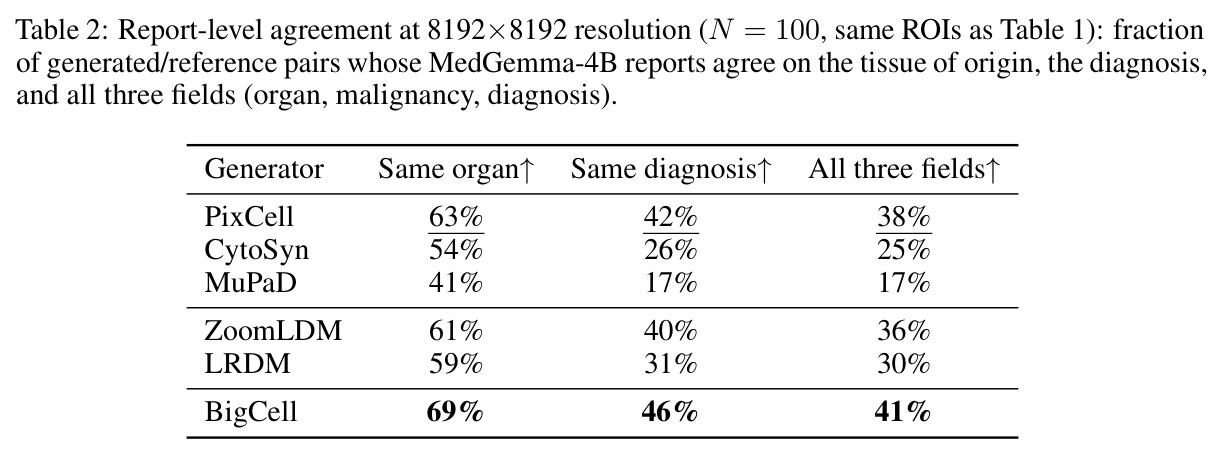
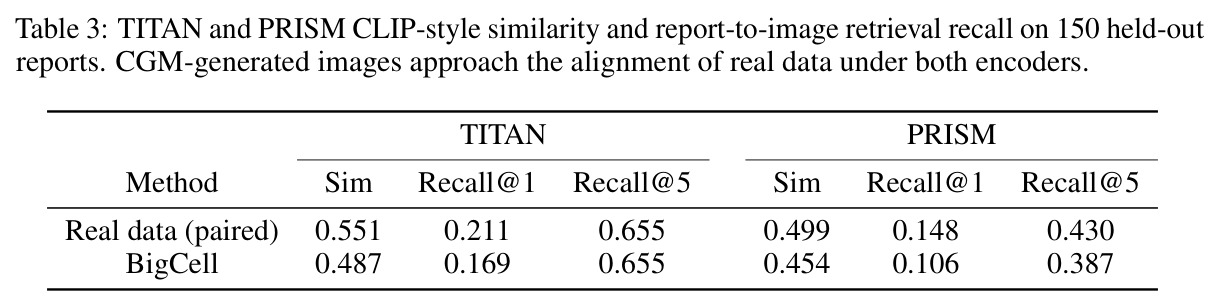
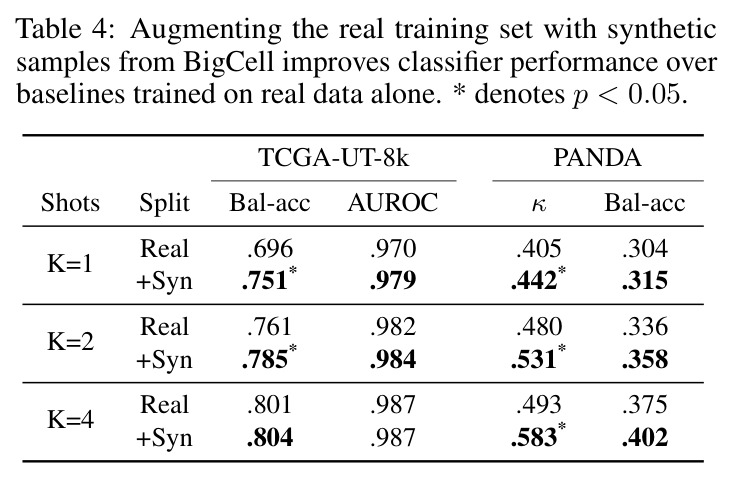
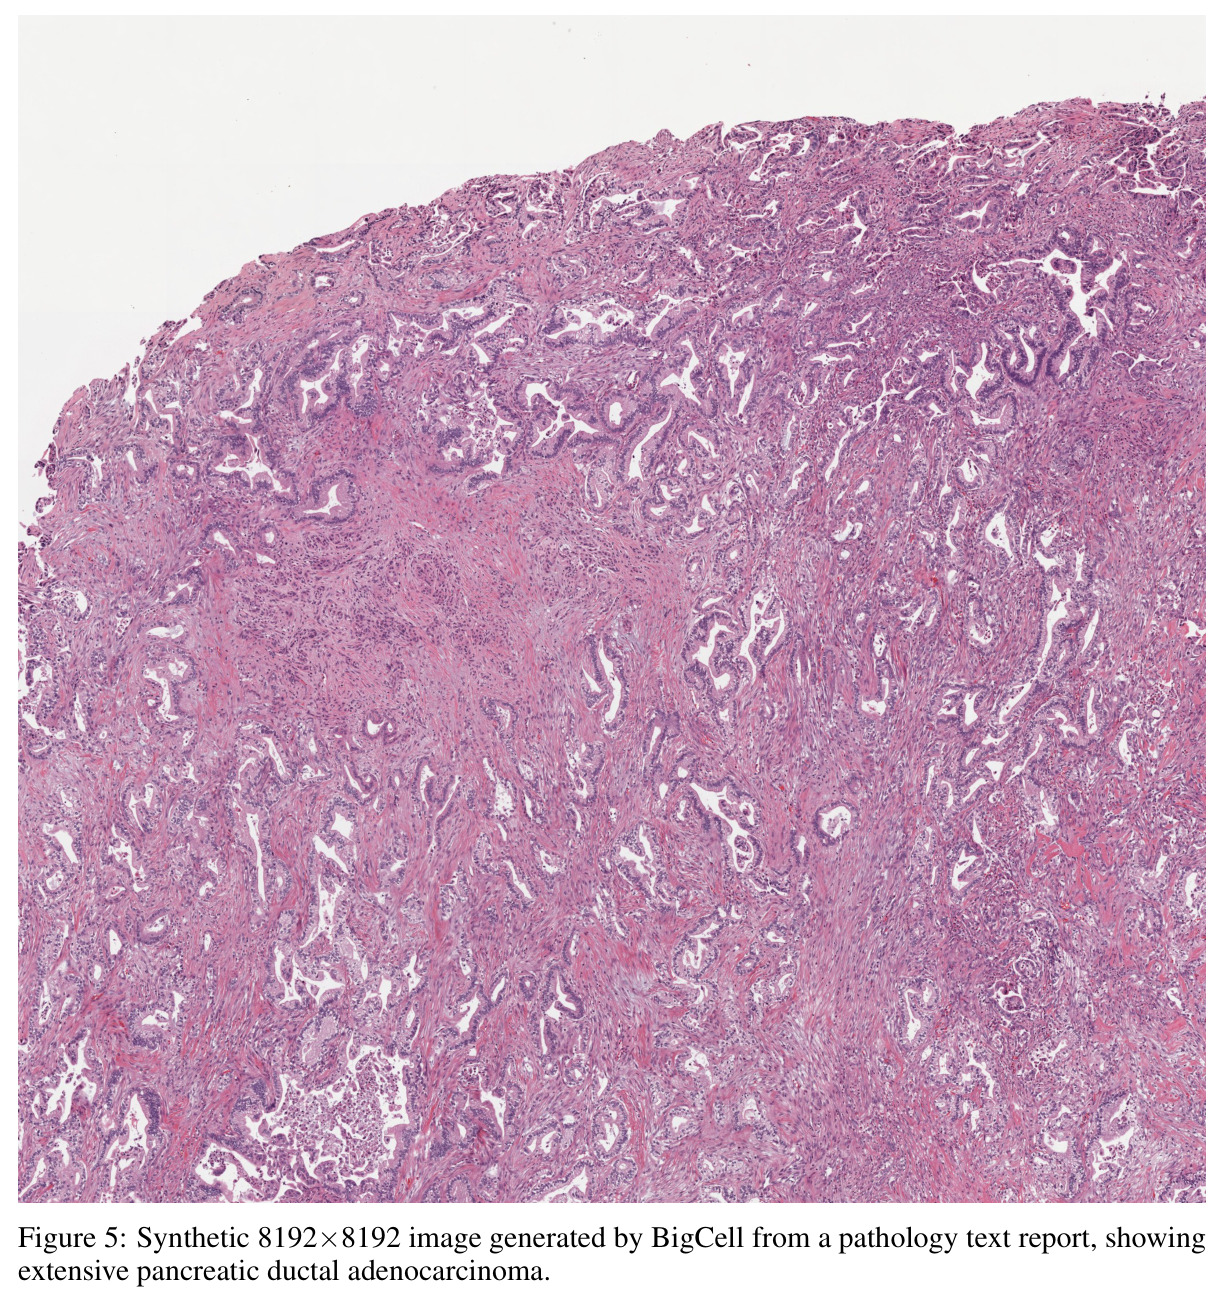
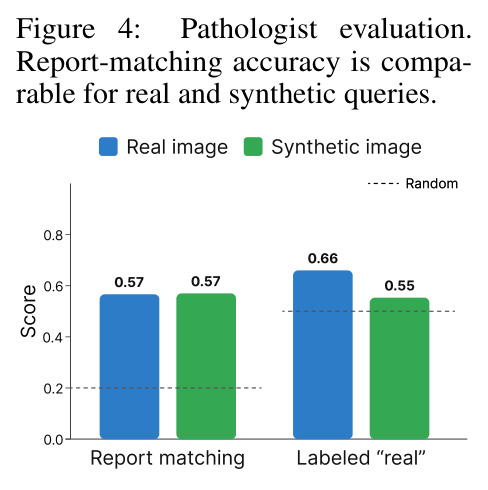
五方面实验支撑全部主张。其一,8k 生成质量(表 1,100 个 ROI):BigCell slide 级相似度 TITAN 0.956、MOOZY 0.973,显著高于最强基线 PixCell 的 0.941/0.900($p<0.001$);Virchow-2 平均相似度 0.869 对 0.778,尾部指标 $V2_{5th}$ 0.737 对 0.632,严重局部伪影大幅减少。其二,报告级一致性(表 2,MedGemma-4B):器官一致 69%、诊断一致 46%、三项全对 41%,均超 PixCell 的 63%/42%/38%。其三,效率(图 3,32k,N=256):$r=0.25$ 时 TITAN 相似度 0.951,几乎等于全算力的 0.957,NFE 从 38,440 降到约 11,000,单卡从 15.6 小时降到 4.97 小时,3.1 倍加速;同预算下始终优于少步基线(NFE≈4000 时 0.76 对 0.63)。其四,文本生图与盲评(表 3、图 4):TITAN 图文相似度 0.487 接近真实配对的 0.551(随机配对仅 0.118),recall@5 的 0.655 与真实持平;三名病理医生对合成/真实图的报告匹配准确率同为 0.57,合成图被判为真实占 55%,判别准确率 55.3%(95% CI 50–61%)不显著,评分者间 $\kappa=0.020$。其五,少样本增广(表 4):PANDA k=4 加权 $\kappa$ 从 0.493 提到 0.583(相对 +18%),TCGA-UT-8k k=1 平衡准确率从 0.696 提到 0.751(约 +7%),且 PANDA 留出 CGM 训练,属分布外验证。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 8192×8192 全切片区域生成质量 | TITAN slide 级相似度 | 0.956 | PixCell-1024: 0.941(LRDM 仅 0.531) | +1.6%,相对全部基线 p<0.001 |
| 8k 生成局部质量(尾部) | Virchow-2 bottom-5% patch 相似度 | 0.737 | PixCell: 0.632;CytoSyn: 0.502 | +16.6%,严重局部伪影显著减少 |
| 32k 吉像素生成效率 | 单卡墙钟时间 | 4.97 小时(r=0.25,TITAN 0.951) | 全量调度 15.6 小时(TITAN 0.957) | 3.1× 加速,质量几乎无损 |
| 8k 文本生图对齐(150 份报告) | TITAN CLIP 式相似度 | 0.487(recall@5 = 0.655) | 真实配对 0.551;随机配对 0.118 | 接近真实配对,recall@5 与真实持平 |
| 病理医生盲评(各 100 试验) | 真伪判别准确率 / 评分者间 κ | 55.3%(95% CI 50–61%,不显著)/ κ=0.020 | 真实图判为真实 66%,合成图 55% | 专家无法可靠区分合成与真实组织 |
| 少样本分类增广(PANDA, k=4) | 加权 κ | 0.583(real + syn) | 仅真实数据 0.493 | 相对提升 18% |
| 少样本分类增广(TCGA-UT-8k, k=1) | 平衡准确率 | 0.751 | 仅真实数据 0.696 | 相对提升约 7%(p<0.05) |
| 报告级一致性(8k,N=100) | MedGemma-4B 报告一致率 | 器官 69% / 诊断 46% / 三项全对 41% | PixCell: 63% / 42% / 38% | 三项指标全面领先 |
局限与改进
作者承认三点局限:文本条件生图被限制在 8192²(更大分辨率如 32k 的报告配对区域样本骤减,不足以训练 CGM);即使加速后,32k 生成仍需约 4.97 小时单卡时间,对高通量应用不现实;合成病理图像有滥用风险,只能用于研究、不能替代真实组织做临床诊断。我的补充观察:其一,诊断一致率 46% 说明文本生图与报告的语义对齐仍有明显差距,文本控制粒度还比较粗;其二,评价体系与条件信号同源——条件来自 UNI-2,slide 级指标用 TITAN/MOOZY,patch 级用 Virchow-2/H-Optimus-1,存在『优化到编码器偏好』的循环风险,好在 MedGemma 报告一致性与病理医生盲评部分缓解了这一点;其三,Fréchet 距离上 LRDM/ZoomLDM 反而最佳,说明 BigCell 优化的是对参考图的条件保真,无条件分布覆盖并非强项;其四,评估规模较小(100–256 个 ROI、150 份报告、3 名医生),统计功效有限;其五,消融承认基线性能差异部分混淆了原生分辨率与架构两个因素。
独立分析的弱点
独立分析四个弱点。第一,默认管线依赖参考 WSI 提取条件网格,『生成』更接近『按蓝图重绘』,样本多样性受限于已有切片库,难以凭空产生新形态;改进方向是把 CGM 扩展到 32k 尺度网格、或在器官/染色层级上建立分层无条件先验,让吉像素网格本身可被采样。第二,重要性分数 $I_{ij}(t)$ 用 CFG 幅度近似窗口难度,它更可能反映染色均质度而非诊断重要性——大片空白背景被跳过没有问题,但 CFG 幅度低的细微病变区也可能被系统性牺牲;改进方向是引入病理显著性信号(如细胞密度、有丝分裂检测图)或学习式重要性预测器替代纯 CFG 幅度。第三,调度收益与质量在 $r$ 很小时急剧恶化($r=0.05$ 时质量明显下降),且每步仍需对 top-$r$ 窗口做完整前向,加速上限是 $1/r$;改进方向是把少步蒸馏(一致性模型、蒸馏采样器)与自适应调度正交结合,先压步数再乘调度收益。第四,CGM 只有约 3 万份报告、50 万对样本,覆盖受限于 TCGA 与 HistAI 的病例分布,罕见病与少见器官可能泛化差(诊断一致率仅 46% 也与此相关);改进方向是接入多中心临床档案的更大报告库,或用检索增强以相似真实报告锚定采样。
未来方向
作者展望了三个方向:用报告生成 WSI,为数字化之前的病理档案和无扫描基础设施的地区做切片补全;把条件模态从文本扩展到空间转录组、多重免疫荧光成像,实现多模态生成;最终服务于数字孪生系统,模拟医疗场景与干预结局。文中还提到更近期的应用:为鉴别诊断生成细微差异的反事实对照图、把报告发现可视化以与患者切片交叉核对从而辅助质控、以及生成罕见形态学变体的教学案例。基于本文成果可自然延伸的研究包括:把自适应调度抽象为任意滑窗生成器的通用加速层并给出质量收敛的理论保证;在 slide 级基础模型(TITAN/MOOZY 类)的预训练中注入合成切片,检验能否缓解标注稀缺;以及层次化报告到 32k 的文本生图——先采样粗分辨率网格锚定全局,再逐区域条件细化,绕开报告配对数据不足的瓶颈。
复现评估
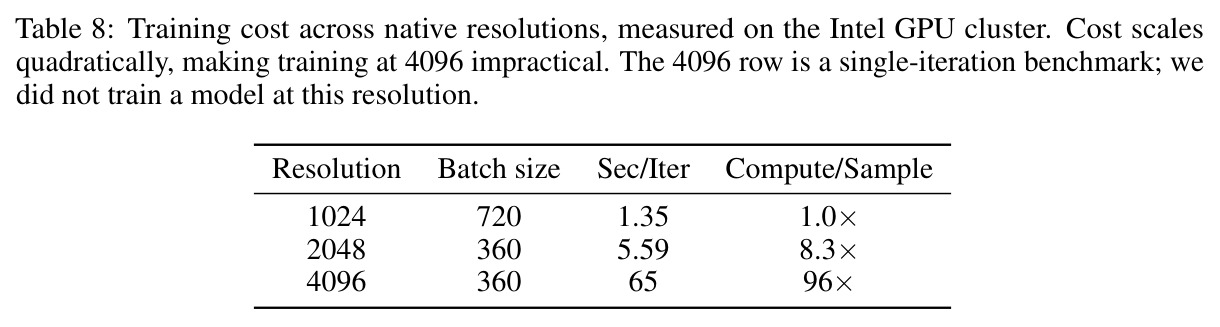
复现条件相当好。模型与代码承诺公开(论文注明 Code and models provided at the project page),整条管线只用公开数据:训练用 TCGA、CPTAC、GTEx、HistAI、PTRC-HGSOC、NLST 共 120,703 张 WSI(约 1,600 万个 2048² 块),CGM 用 TCGA 诊断与 HistAI 的约 3 万份患者级报告(50 万对网格-文本样本,150 份留出测试),下游用 PANDA 和 TCGA-UT-8K,无任何专有数据。难点在算力:渐进训练到 2048² 的 28 层 SiT 与千万级块数据管线需要数据中心级 GPU 集群(作者使用阿贡国家实验室 ALCF),个人或小团队复现完整训练不现实。但复现推理可行:滑窗管线免训练,8k 文本生图用官方 CGM + BigCell large 权重在单张数据中心 GPU 上即可完成;32k 生成全量约 15.6 小时、$r=0.25$ 调度下约 4.97 小时。注意官方耗时数据来自 Intel Data Center GPU Max 1550,NVIDIA 平台实际耗时可能不同。总体评级:推理易、训练难,适合先在 8k 文本生图上试用。
论文图表