AutoEnvScaling:用终端智能体自动化数据飞轮 AutoEnvScaling: Automating the Data Flywheel with Terminal Agents
把RL环境设计变成终端任务,让智能体自建训练环境、实现递归自我提升
前置知识
终端智能体(Terminal Agent)
在命令行环境中通过执行 shell 命令完成任务的 LLM 智能体:给定任务指令后,它在容器里依次发出命令、读取输出、迭代操作,直到完成任务或耗尽步数。软件工程修 bug、数据分析、运维等场景常用这种形态,Terminal-Bench 是其代表性评测基准。
本文全部设计都建立在「环境设计本身就是写代码、跑测试的终端任务」这一观察上,不理解终端智能体的工作方式就无法理解方法。
可验证奖励强化学习(RLVR)
用程序化测试或验证器代替人类标注给智能体轨迹打分的 RL 训练范式:agent 每做一道任务,验证器自动运行测试并按通过比例给分,奖励客观可复现,因此能用 GRPO/DPPO 等策略梯度算法大规模训练。其瓶颈在于需要大量多样、难度合适且可验证的任务环境。
本文要自动化的正是「训练环境供给」这个 RLVR 最大的瓶颈,理解 RLVR 才能明白环境为什么稀缺、为什么会随训练「过时」。
数据飞轮与 Proposer-Solver 结构
一种自我强化的训练循环:proposer(出题者)根据 solver(解题者)的失败模式生成新任务,solver 在新任务上训练变强,其新轨迹又指导 proposer 出更有针对性的题,如此往复。课程难度随能力动态匹配,避免任务过易(无梯度信号)或过难(无奖励)。
AutoEnvScaling 的核心就是把出题者从「写死的流水线」升级为「会自己进化的智能体」,飞轮能否转起来是全文成败的关键。
Harbor 任务格式
Harbor 是开源的终端智能体训练/评测框架(harborframework.com),一个完整任务包含四要素:自然语言指令、可执行的容器环境、参考答案(oracle solution)和自动化测试。出题者写全四件套,解题者只能看到指令,在容器内工作,测试在环境外判定。
本文 proposer 每一轮的产出物就是一个完整的 Harbor 任务,验证、校准、奖励计算都围绕这个格式展开。
递归自我提升(RSI)
指 AI 系统参与构建更强后续版本(或自身的下一版本)的闭环:模型改进训练数据、算法或基础设施,产物又用于训练它自己,能力理论上可复合增长。现有工作多集中在改进脚手架、GPU 内核、芯片设计或研究流程本身,风险与可行性都是前沿争论焦点。
本文让同一个模型既出题又解题、用自己的新权重出下一轮题,是 RSI 在「训练数据」维度上的一个具体落地实验。
研究动机
终端智能体依靠 RL 提升能力,而 RL 的效果高度依赖大量多样、可验证的训练环境。现实是这些环境基本仍靠人类研究员手工设计:高质量环境稀缺,且一旦 agent 学会了它所教的内容就迅速贬值,研究者必须不断诊断模型短板、再设计新环境,环境供给的增长速度被人手完全限制——业界据报每年在 RL 环境上的投入已超过 10 亿美元。已有的自动化尝试各有明显短板:流水线式合成(Tmax、Endless Terminals、TermiGen 等)按预定义的领域分类或固定步骤批量生成,池子在训练前就冻结,不会随 agent 变强而调整;反馈驱动方法(RST、T1、Environment Evolution 等)虽会根据运行结果修复或调整任务难度,但「如何使用反馈」仍是人工设计好的规则;agentic 方法如 AutoData 只生成 QA 数据、EnvHarness 只能定制既有环境,都无法新建完整环境;self-play 方法中的 proposer 也依然经由固定流水线出题。一句话:所有现有方法都预先固定了「环境如何被生成」这件事。
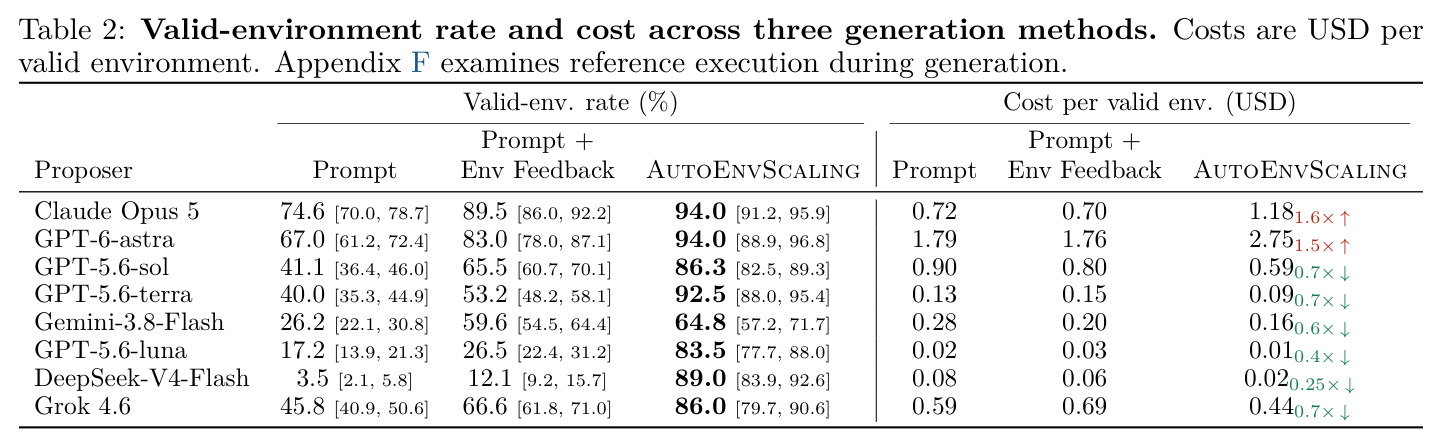
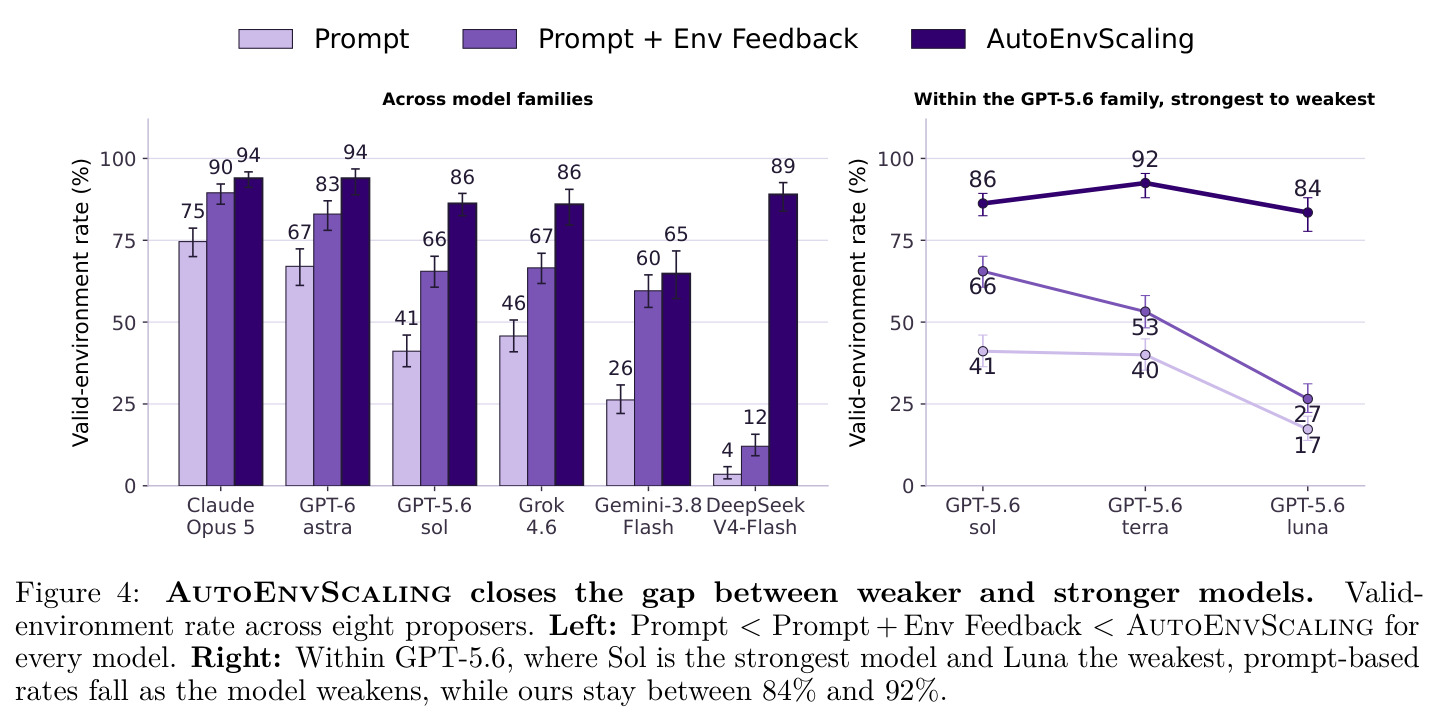
本文的目标是本文的目标是把环境设计整体交给智能体,并分三层验证。第一层:把环境生成做成终端任务后,有效环境率要大幅超过纯 prompt 生成——实测在 8 个前沿模型上最高提升 25 倍(DeepSeek-V4-Flash 从 3.5% 到 89.0%),每个有效环境成本最多降低 75%。第二层:用前沿模型(GPT-5.6-sol、Claude Opus 5)作为 proposer 生成动态课程,在与静态池相同的 proposer 和相同训练步数下稳定胜出——Qwen3.5-9B 在 Terminal-Bench 2.1 上提升 6.3~7.4 分,Qwen3.5-35B-A3B 提升 3.8~4.3 分。第三层是更长线的目标:让同一个模型同时扮演 proposer 和 solver,用自己设计的环境训练自己,迈出递归自我提升(RSI)的第一步——Qwen3.6-35B-A3B 在 Terminal-Bench 2.1 上从 41.1 提到 53.3。此外,流水线还应能泛化到软件工程、计算机操作、专业工作和 GPU kernel 等多个智能体领域。
与已有工作不同的是,本文的独特视角是一次身份转换:与其发明新的「环境生成流水线」,不如把设计环境本身定义为一种终端任务——写环境就是写代码、跑测试、debug,恰好是终端智能体被训练去做的那类工作。于是 proposer 不再是被 prompt 驱动的一次性文本生成器,而是被放进带沙箱、子容器、网络和工具链的真实工作环境,像研究员一样阅读 rollout、决定造什么、动手构建并自测。这一统一步带来两个别人没有的性质:其一,出题和解题共享同一种动作接口(终端命令),同一个策略的权重可以在两个角色之间迁移,使单模型 RSI 成为可能;其二,闭源前沿模型也能通过持续优化自己的 harness(记忆、技能、工具)跨轮进步,改进通道不再局限于 open-weight 模型。作者还用 mismanaged geniuses 假说解释收益来源:很多模型并不缺能力,缺的是能让能力施展出来的脚手架,DeepSeek-V4-Flash 从 3.5% 到 89.0% 的跃升正是佐证。
核心方法
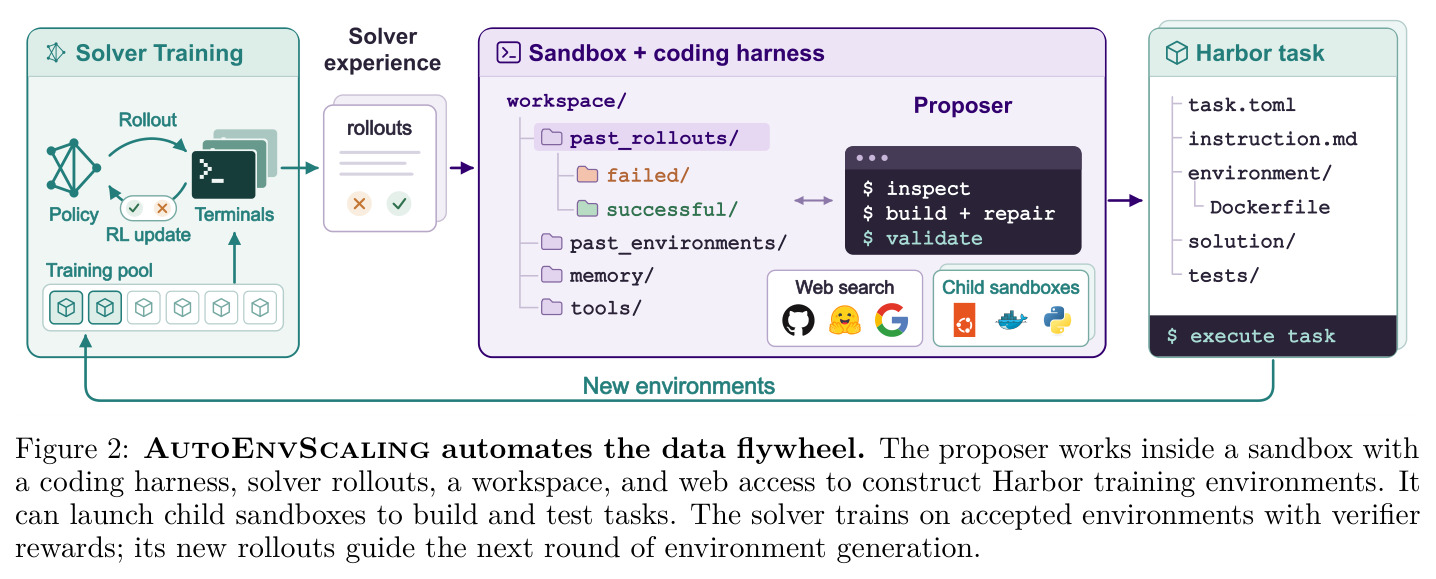
直觉上,AutoEnvScaling 复刻了人类研究员的出题流程:先看学生最近哪些题做错、错在哪,再针对薄弱点编新题,编完自己先验证一遍并控制难度,然后让学生再做,如此循环。技术上整条流水线分三方。proposer 智能体待在隔离沙箱中,拥有工作区(内含 solver 的历史 rollout 及验证器输出、已生成环境、Harbor 写题指南、它自己的记忆与工具)、受限网络(可查文档和真实数据,但 egress 规则屏蔽 Terminal-Bench 等评测页面),还能派生子容器构建和测试任务;host 负责环境准入——每轮开始下发 assignment(指定父环境、solver 通过率、最常见失败),结束后做验证与校准;solver 在被接纳的环境池上用 DPPO 做 RL,奖励为通过测试的比例。solver 的新 rollout 会刷新 proposer 的工作区、指导下一轮出题,proposer 自身则通过 harness 优化或权重训练跨轮变强,构成自动运转的数据飞轮。
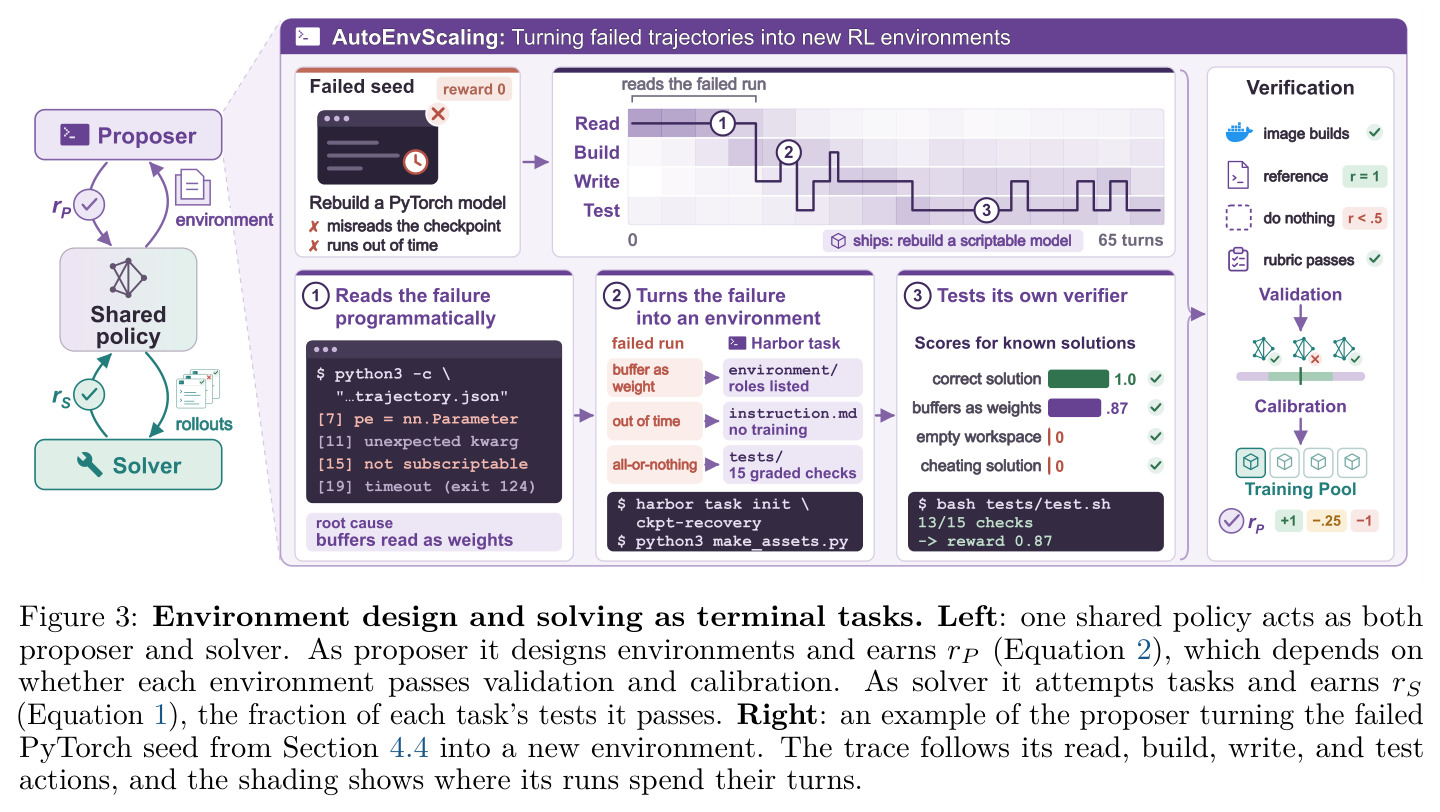
核心创新是把「环境设计」从被 prompt 的生成步骤,变成 agent 在沙箱里自主完成的终端任务,并让出题者进入训练循环。与已有方法的本质区别有三。第一,端到端自主:Tmax、SETA 等方法预先固定生成阶段或改写算子,这里 proposer 自行决定造什么、何时算完成,只遵循 Harbor 官方 create-task 技能流程。第二,两个角色统一为终端任务并各有奖励:solver 轨迹按通过测试比例计分 $r_S(\tau_S) = \frac{1}{N}\sum_{i=1}^{N}\mathbb{1}[\text{test}_i\ 通过]$;proposer 轨迹按产出环境质量计分 $r_P(\tau_P)$——验证失败 −1,验证通过但校准失败 −0.25,两者都通过 +1。两角色动作空间相同(都是终端命令),因此同一个 open-weight 策略可兼任两角。第三,进化通道有两条:open-weight 模型用 DPPO 更新权重并分组计算优势;闭源模型沿 Continual Harness 思路跨轮优化自己的记忆、技能与工具(如把验证步骤合并成更快脚本、把有用的 GitHub 任务存成 web-cache 技能),而准入检查始终在沙箱外由 host 执行,防止被篡改。
方法步骤详情
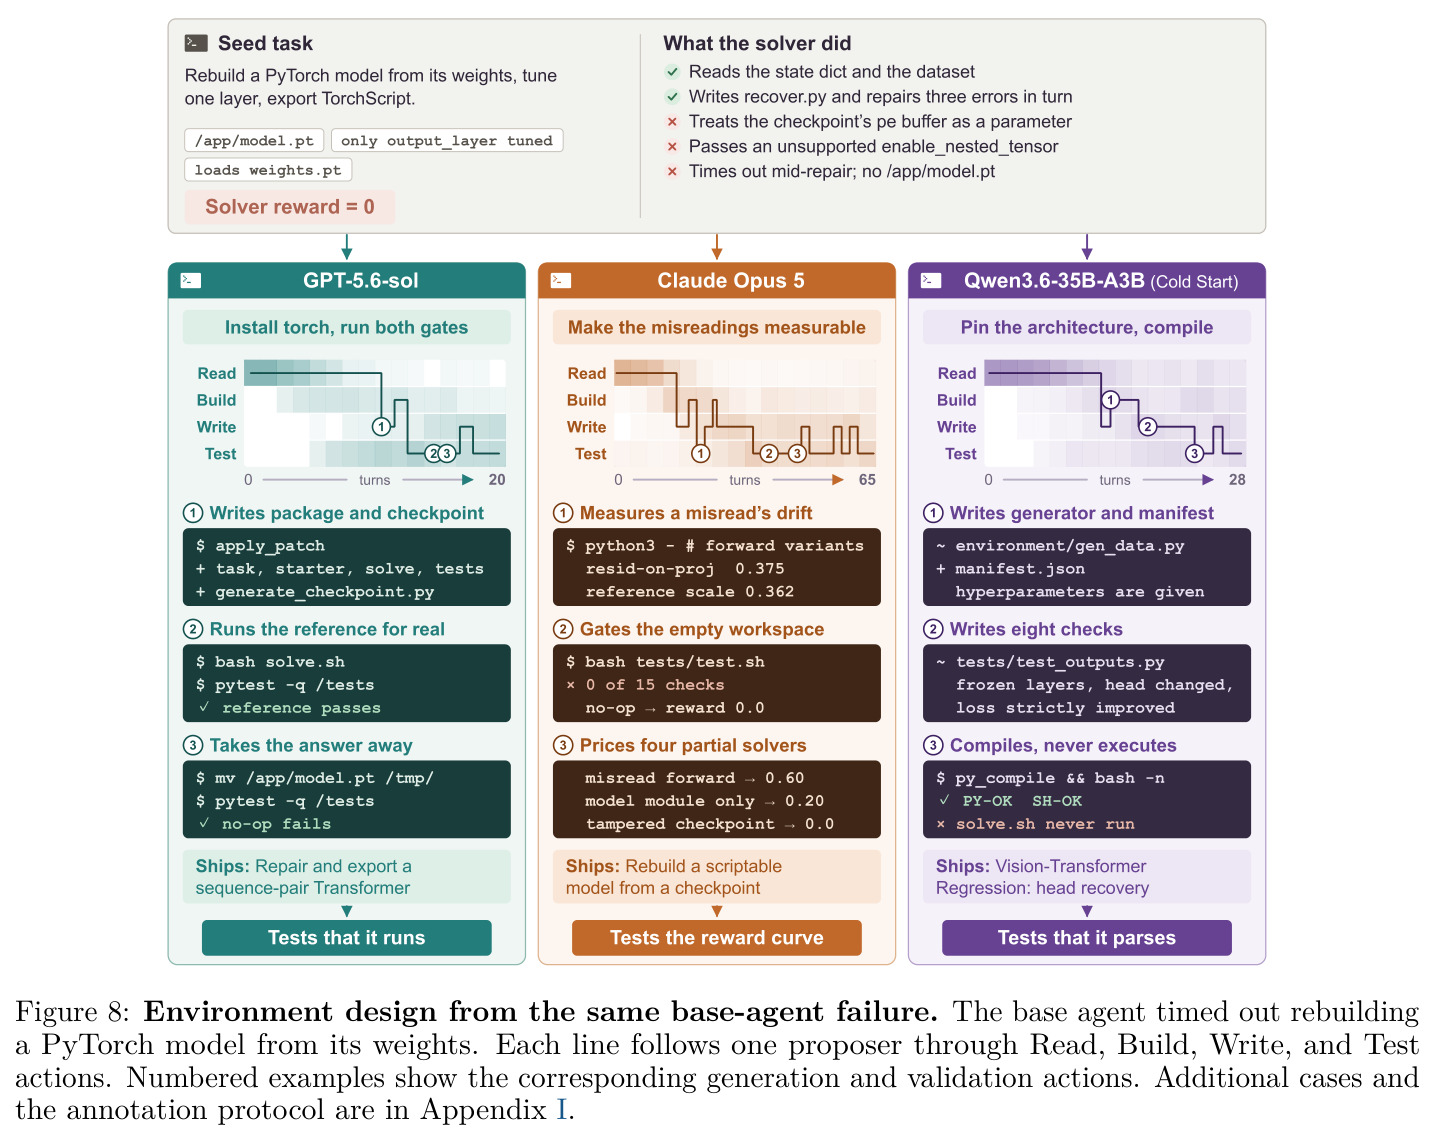
完整流程每轮六步。①派工:host 从训练池选父环境,把 solver 在其上的通过率和最常见失败打包成 assignment 发给 proposer;例如一次失败的 PyTorch 权重重建中,Claude Opus 5 发现 solver 把 buffer 当权重加载,据此设计新环境。②构建:proposer 读父环境的 solver 轨迹,决定出更简单还是更难的变体,在工作区写全 Harbor 任务四件套(指令、执行环境、参考答案、测试),派生子容器构建镜像、跑参考答案和测试并迭代修复,也可调用 solver_model 工具试跑 solver 预估难度。③验证:host 在沙箱外检查参考答案须拿满奖励、空答案须低于一半(防「测试全绿」放水),指令与 held-out 任务共享 13-gram 即判污染(沿 Tmax 做法),再跑 harbor check 审查捷径。④校准:当前 solver 多次尝试候选环境,平均奖励落在 0.25~0.75 且各次有波动才保留;失败环境退回修改。⑤solver 训练:用 DPPO 在已接纳池上做 RL,每步都训 solver。⑥刷新与 proposer 进化:host 重跑 solver、剔除跑出校准带的环境并索要替换;proposer 若权重开放则每 k 步用 $r_P$ 训练(优势 $\hat{A}_{q,i} = r_{q,i} - \frac{1}{G_q}\sum_{j=1}^{G_q} r_{q,j}$ 按角色分组,沿用 DAPO 丢弃无波动组),否则执行 harness 优化。
技术新颖性
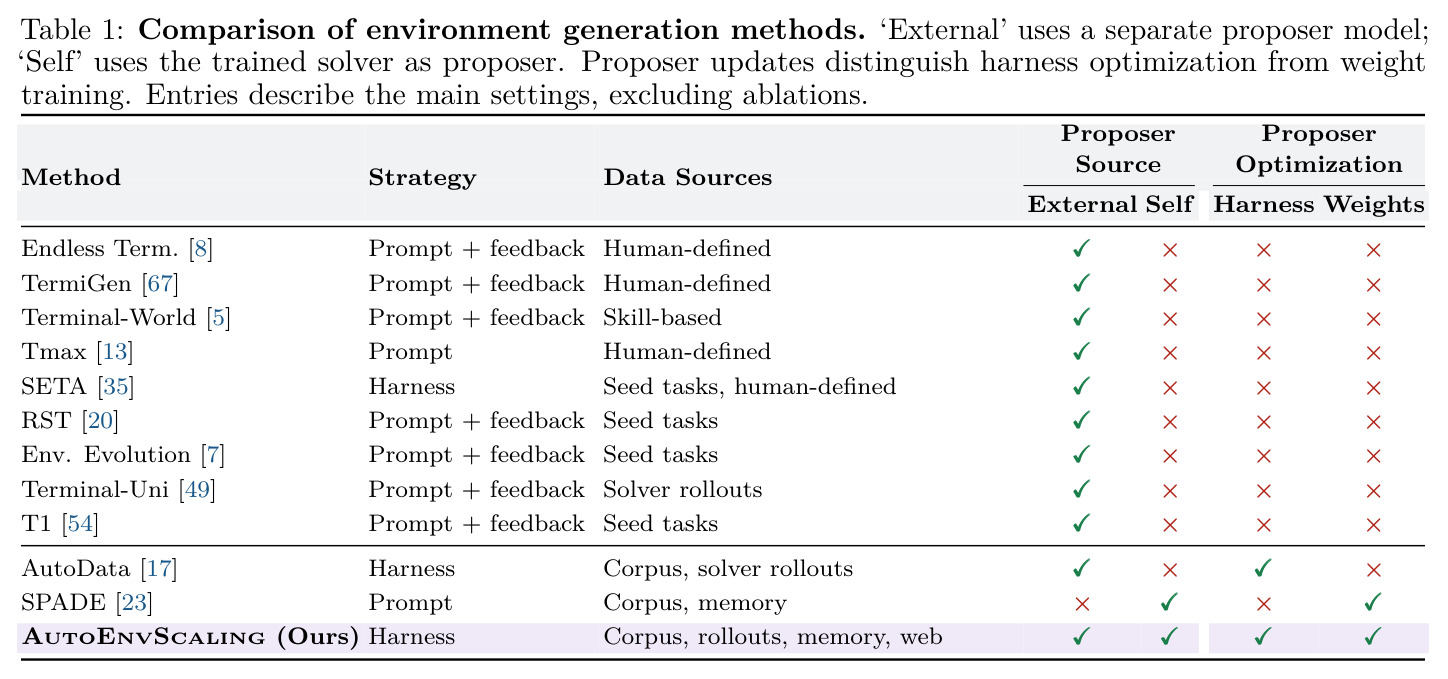
对照 Table 1 可以精确定位新颖性。相对流水线合成(Tmax、Endless Terminals、TermiGen、Terminal-World),训练池不再是训练前固定的,而是随 solver 能力共同演化;相对反馈驱动方法(RST、Environment Evolution、T1),「反馈如何被使用」不再由人工规则决定,而是由 proposer 读懂轨迹后自主决策;相对 AutoData 和 EnvHarness,这里产出的是带参考答案与测试的完整可执行环境,而非 QA 对或对现有环境的包装;相对 self-play 工作(SPADE、Self-Challenging、SSR),SPADE 用基于提示的 regret 奖励在 Gym 式环境上训练设计者,本文则在真实终端环境里用区分「坏环境」(−1)与「不合适环境」(−0.25)的准入式奖励,并同时支持 harness 优化,使 GPT-5.6-sol 这类闭源模型也能跨轮进步。把出题和解题统一到同一动作空间,是此前 LLM self-play 未曾做到、也是单策略 RSI 得以成立的关键前置。
实验结果
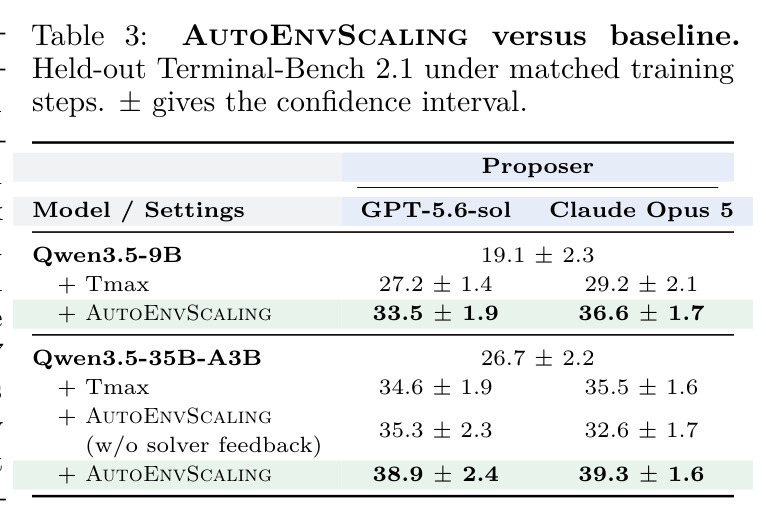
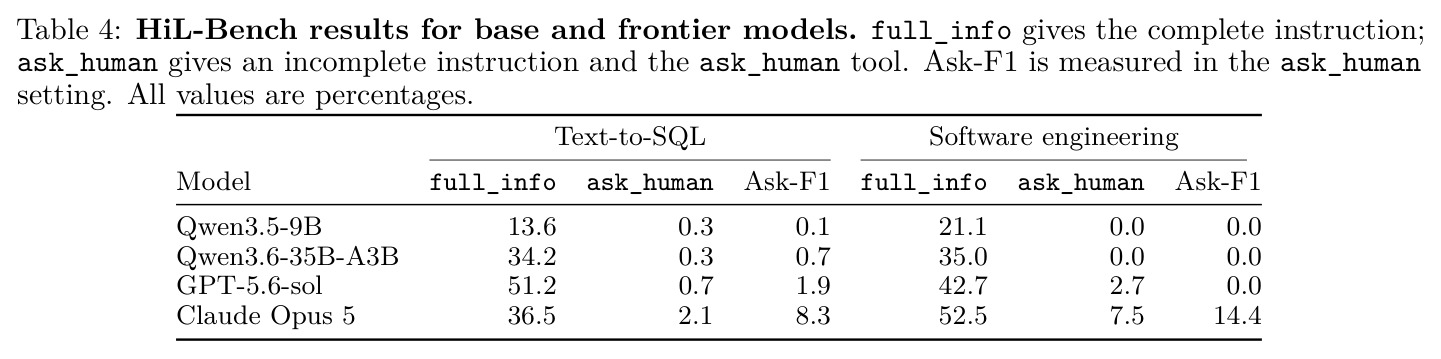
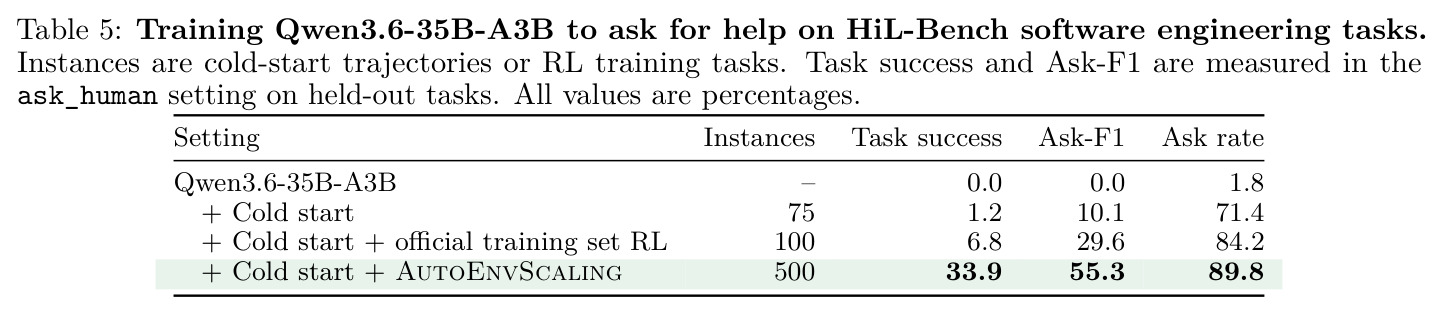
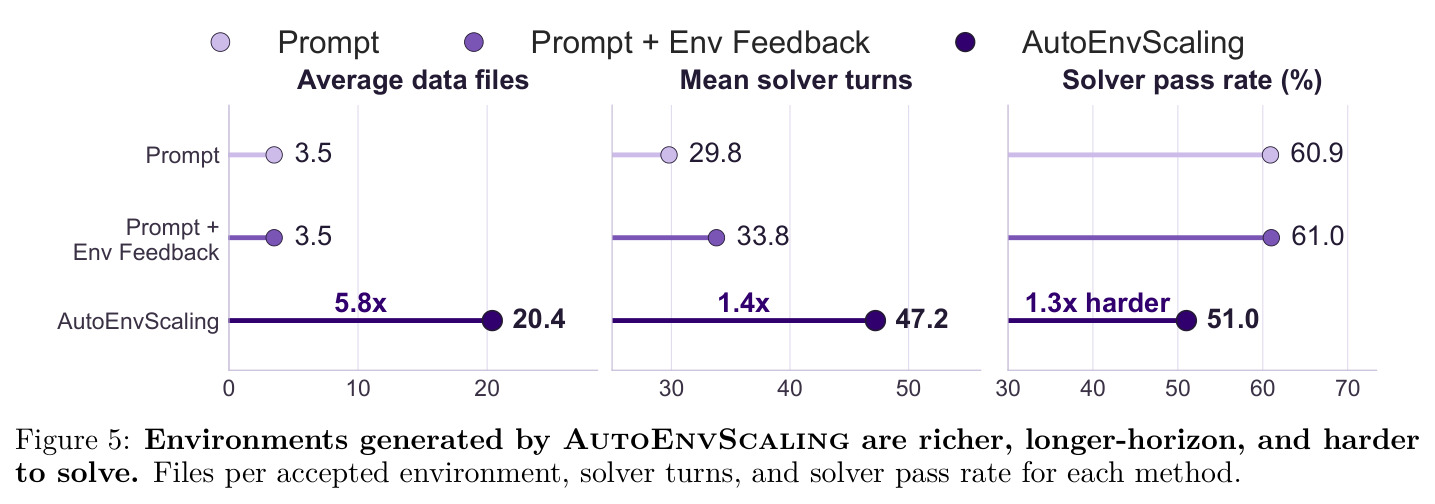
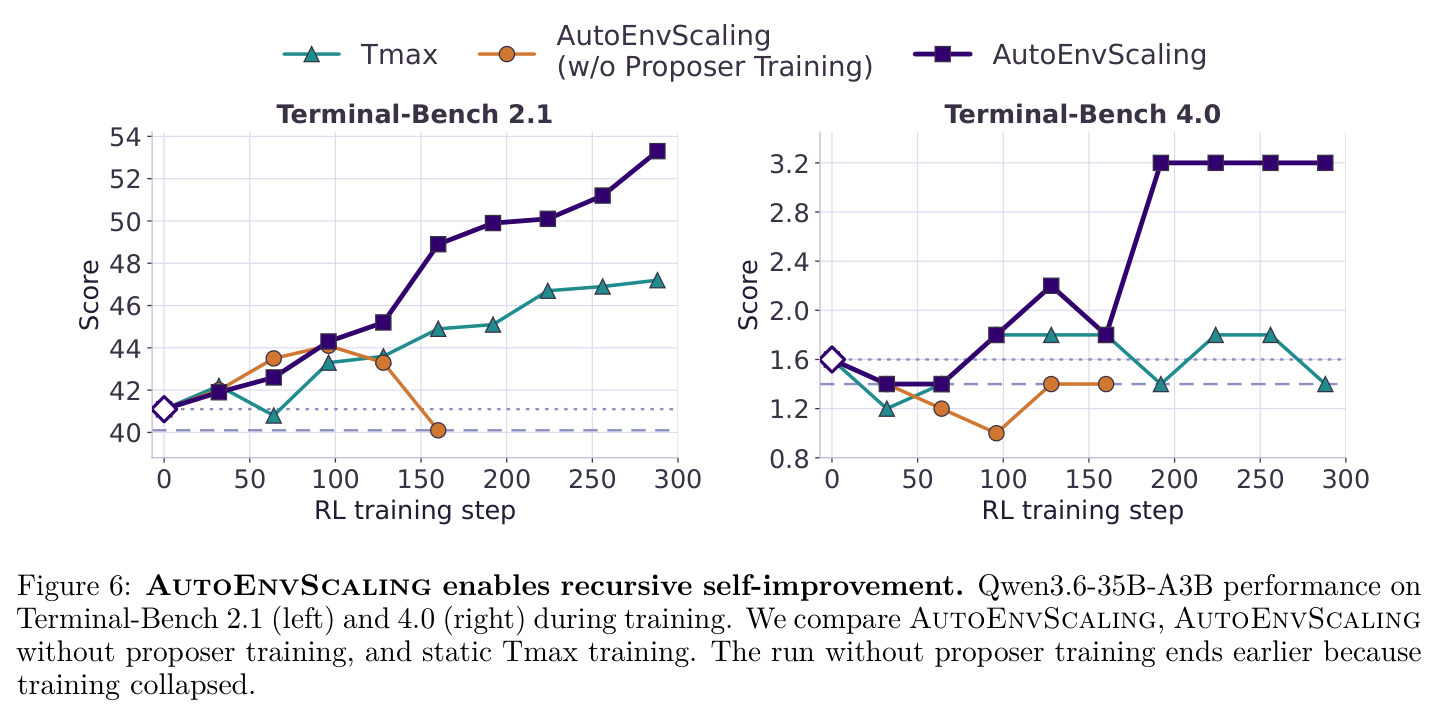
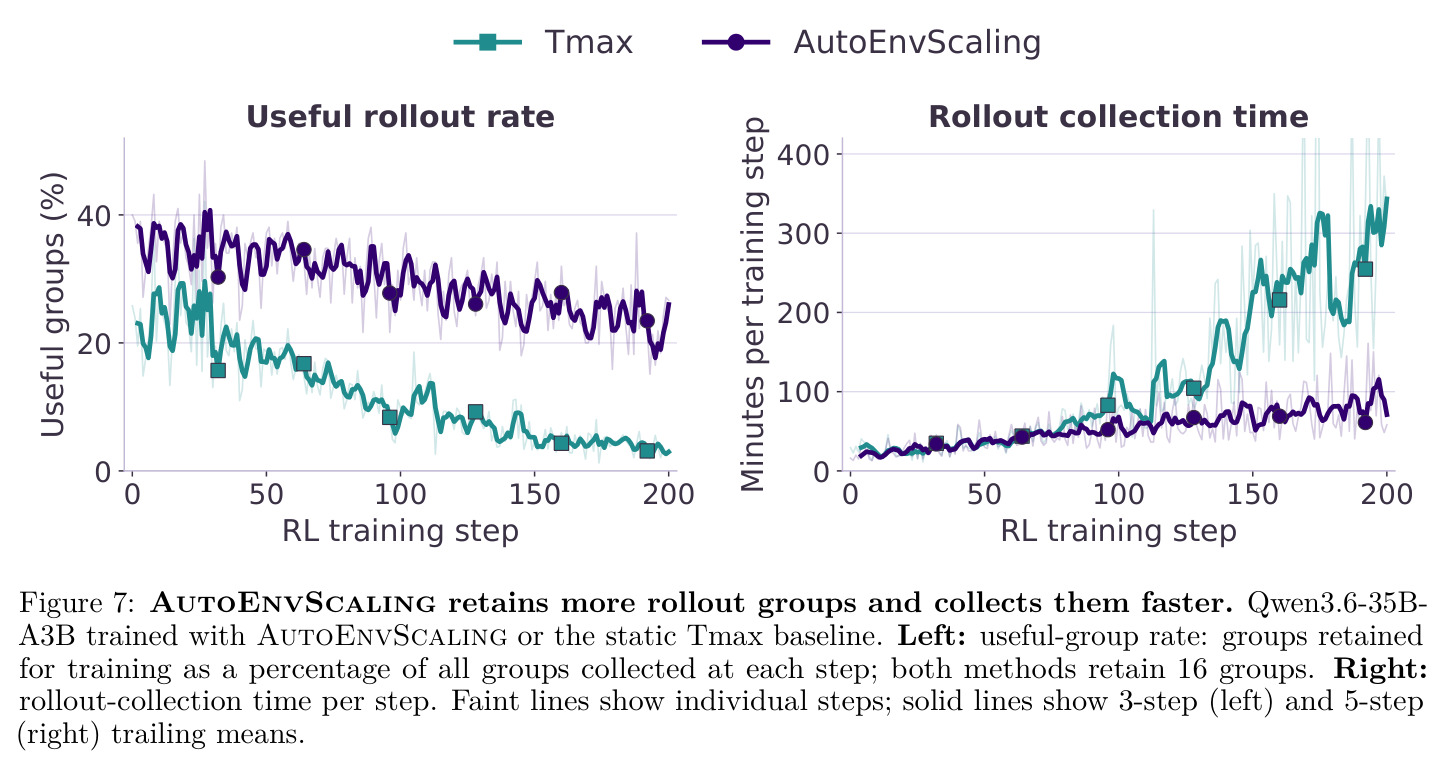
实验覆盖四层面。①生成质量:8 个前沿 proposer 上有效率呈 Prompt < Prompt+Env Feedback < AutoEnvScaling,DeepSeek-V4-Flash 从 3.5% 升至 89.0%(约 25 倍),GPT-5.6-luna 从 17.2% 到 83.5%,最强的 Claude Opus 5 从 74.6% 到 94.0%;GPT-5.6 家族内 prompt 法随模型变弱退化(41.1%→17.2%),本文稳定在 83.5%~92.5%。成本上六模型每个有效环境最多省 75%(DeepSeek 0.08→0.02 美元),但 Claude Opus 5(0.72→1.18 美元)反而更贵。②课程质量:GPT-5.6-sol 出题把 Qwen3.5-9B 的 Terminal-Bench 2.1 从 Tmax 的 27.2 提到 33.5(+6.3),Claude Opus 5 从 29.2 到 36.6(+7.4);Qwen3.5-35B-A3B 从 34.6→38.9(+4.3)、35.5→39.3(+3.8);去掉历史 solver 轨迹后 35B-A3B 掉 3.6 和 6.7 分。生成环境数据文件多 5.8 倍、solver 轮次 33.8→47.2、pass 率 61.0%→51.0%。③RSI:Qwen3.6-35B-A3B 基线有效率仅 32.3%,600 条轨迹冷启动后达 86.8%;双角色训练把 Terminal-Bench 2.1 从 41.1 提到 53.3(+12.2,比 Tmax 高 6.1),Terminal-Bench 4.0 从 1.6 到 3.2;去掉 proposer 训练则中途崩溃。有用 rollout 组比例为 Tmax 的 3.1 倍,每步采集省时 42%。④泛化:HiL-Bench 上用 500 个生成的须提问任务训练后,任务成功率 0→33.9%、Ask-F1 达 55.3%,远超官方 100 任务的 6.8%/29.6%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 有效环境生成(8 个前沿 proposer) | 有效环境率 | DeepSeek-V4-Flash 3.5%→89.0%;Claude Opus 5 达 94.0% | 纯 Prompt 生成(同模型)3.5%~74.6% | 最高约 25 倍(DeepSeek-V4-Flash) |
| 每个有效环境的生成成本 | USD / 有效环境 | 低至 0.01~0.09 美元(8 个模型中 6 个下降) | Prompt 法 0.02~1.79 美元 | 最多降低 75% |
| Terminal-Bench 2.1(Qwen3.5-9B,GPT-5.6-sol 出题) | avg@5 | 33.5 | 静态 Tmax 池 27.2(未训练基线 19.1) | +6.3 |
| Terminal-Bench 2.1(Qwen3.5-9B,Claude Opus 5 出题) | avg@5 | 36.6 | 静态 Tmax 池 29.2 | +7.4 |
| Terminal-Bench 2.1(Qwen3.5-35B-A3B) | avg@5 | 38.9(GPT-5.6-sol)/ 39.3(Claude Opus 5) | Tmax 34.6 / 35.5 | +4.3 / +3.8 |
| Terminal-Bench 2.1(Qwen3.6-35B-A3B 自我提升) | avg@5 | 53.3(Cold-Start 41.1) | 同 checkpoint 静态 Tmax 训练 47.2 | +12.2(对 Cold-Start),+6.1(对 Tmax) |
| Terminal-Bench 4.0(Qwen3.6-35B-A3B) | avg@5 | 3.2 | Cold-Start 1.6;Tmax 1.4 | +1.6 |
| HiL-Bench 软件工程(澄清提问行为) | 任务成功率 / Ask-F1 | 33.9% / 55.3% | 官方 100 任务 RL:6.8% / 29.6%;Claude Opus 5:7.5% / 14.4% | 成功率约 5 倍 |
局限与改进
作者层面较坦诚的点包括:校准要求对每个候选环境多次运行当前 solver,是实打实的推理开销;13-gram 污染检查较粗糙,只能挡住与 held-out 任务字面重合的题;验证无法发现参考答案与测试共有的错误或奖励捷径,只能靠 harbor check 部分缓解。我的观察:其一,RL 实验全部围绕 Qwen 家族 solver(Qwen3.5-9B/35B-A3B、Qwen3.6-35B-A3B),结论能否迁移到其他基座模型缺乏证据;其二,Terminal-Bench 4.0 上 1.6→3.2 的绝对分数仍然很低,RSI 在更难基准上的效果尚未真正证明;其三,对最强闭源 proposer(Claude Opus 5、GPT-6-astra)每个有效环境成本反而上升 1.5~1.6 倍,「更便宜」的结论依赖模型档次;其四,RSI 实验依赖 600 条精选轨迹做冷启动,小模型直接自举不可行(基线有效环境率仅 32.3%);其五,proposer 拥有网络访问,防泄漏只靠 egress 黑名单屏蔽评测站点,防线较薄;其六,训练仅约 300 步,飞轮长期动力学(坍缩、多样性衰减)未验证。
独立分析的弱点
独立分析几个弱点。①proposer 奖励过于稀疏:整条轨迹最后只拿 −1/−0.25/+1 三档,读轨迹、写文件、调试等中间步骤没有信用分配,长轨迹下策略梯度方差大;改进方向是引入塑形信号,如用 harbor check 评分做部分奖励。②校准带宽 0.25~0.75 是全局常数,对极简单或极难的分布不普适,且每次校准要多次 solver rollout,对 35B 模型是显著开销;可改为随训练进度自适应的带宽,或用难度预测模型预筛。③harbor check 由 proposer 同款模型审查自己的题,既当运动员又当裁判,共享盲区难消除;可引入异构模型交叉审查。④沙箱有网络但只靠 egress 黑名单防泄漏,网页内容诱导 proposer 泄漏 held-out 任务或放水测试的 prompt 注入风险未被讨论;应加域名白名单与输出审查。⑤环境多样性缺乏度量,飞轮可能反复围绕 solver 当前失败点出近亲题,长期分布塌缩;应加入多样性正则或技能覆盖追踪。⑥有效率与成本结论高度依赖前沿模型的 API 定价与能力快照,时效性差。
未来方向
作者在结论中提出要让环境设计成为「agent 自己学习并改进的能力」,并已展示流水线可泛化到软件工程、计算机操作、专业工作和 GPU kernel 四个域。自然的延伸包括:把同样的飞轮用于不可验证或主观任务(写作、研究品味),这需要先解决奖励建模问题;研究 proposer-solver 的异构配对(弱出题者配强解题者)以及角色间能力差与课程质量的关系;把训练拉长到数千步、多代 RSI,观察复合增益与稳定性,检验 harness 优化与权重训练的互补性;把 harness 优化扩展到自动挖掘新工具、新数据源甚至新验证器;以及在真实工业代码库上验证环境合成的安全性与合规性。另一个有价值的方向是把 proposer 的 $r_P$ 与下游 solver 增益做关联分析,研究「出题质量」能否成为可提前预测的中间指标,从而在不跑完 RL 的情况下筛选环境。
复现评估
论文首页给出 Project Page 与 Code 链接,环境基于开源的 Harbor 框架,方法依赖的 DPPO、DAPO、Continual Harness、Tmax 均有公开论文或代码,复现路径清晰。但要完整复现需要相当资源:solver 训练使用 35B 级 MoE 模型、group size 16、每批 16 个 prompt、最长 128k token 序列,需要多卡 RL 基础设施;环境生成依赖 GPT-5.6-sol 或 Claude Opus 5 等 API(每个有效环境约 0.01~2.75 美元,视模型而定),外加校准时的 solver rollout 开销;RSI 实验还需 600 条高质量 proposer 轨迹做冷启动。分层来看:复现 4.1 节的环境生成对比最容易(API 加沙箱即可),适合学术实验室先做,用于验证 harness 设计本身;复现 4.2/4.3 节的 RL 训练则需要完整训练栈与数百 GPU 时,难度中上。建议路线是先复现有效环境率实验,再评估是否值得投入训练部分。
论文图表
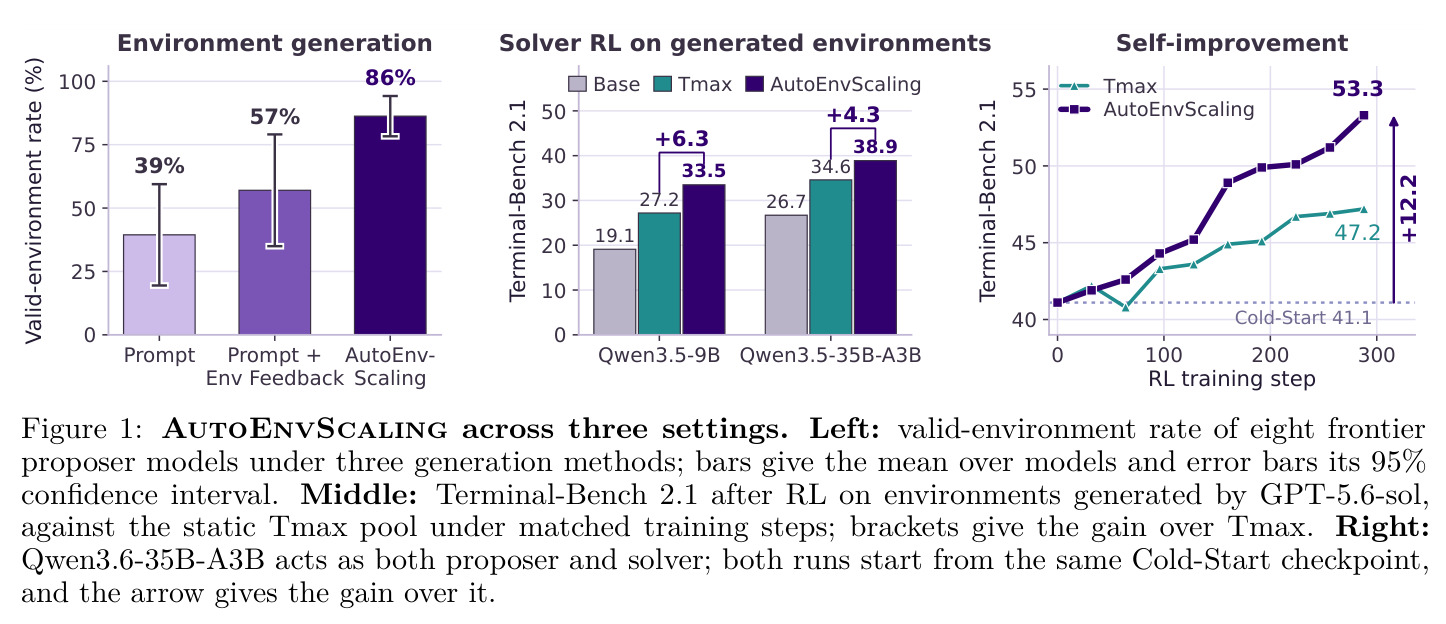
三联概览图:左为 8 个前沿 proposer 在三种生成方式下的有效环境率(Prompt 30%→Prompt+Env Feedback 39%→AutoEnvScaling 86% 均值);中为 GPT-5.6-sol 生成环境上 RL 训练 Qwen3.5 系列后 Terminal-Bench 2.1 对比静态 Tmax 池;右为 Qwen3.6-35B-A3B 同时担任 proposer 和 solver 的自我提升曲线。
一张图概括论文全部三个层次的实验主张,是快速判断这篇论文价值的入口。