Pristine Models:预训练期隔离不安全知识的可拆卸分支文生图架构 Pristine Models
用三分支注意力与提示分解在预训练时隔离不安全概念,推理时拆除该分支即得安全模型
前置知识
扩散模型与流匹配
一类通过迭代去噪生成图像的深度生成模型。DDPM 在训练中向图像加噪并学习预测噪声 $\epsilon$;流匹配(flow matching)则学习一个把噪声分布连续输运到数据分布的速度场(本文 MMJiT 骨干采用 JiT 式图像预测)。两者的训练目标在论文中统一记为 $\mathcal{L}_{gen}$,是 Pristine 训练时唯一使用的生成目标——方法完全不改动目标函数,只改动注意力架构。
理解 Pristine 的核心训练公式 $\theta_{pristine} = \arg\min_\phi \mathcal{L}_{gen}(\{\phi_{shared}, \phi_{safe}\}; \mathcal{D}_{safe}) + \mathcal{L}_{gen}(\{\phi_{shared}, \phi_{unsafe}\}; \mathcal{D}_{unsafe})$ 的前提是知道 $\mathcal{L}_{gen}$ 就是标准扩散/流匹配损失:安全样本走 shared+safe 分支,不安全样本走 shared+unsafe 分支。
交叉注意力与 MMDiT 自注意力
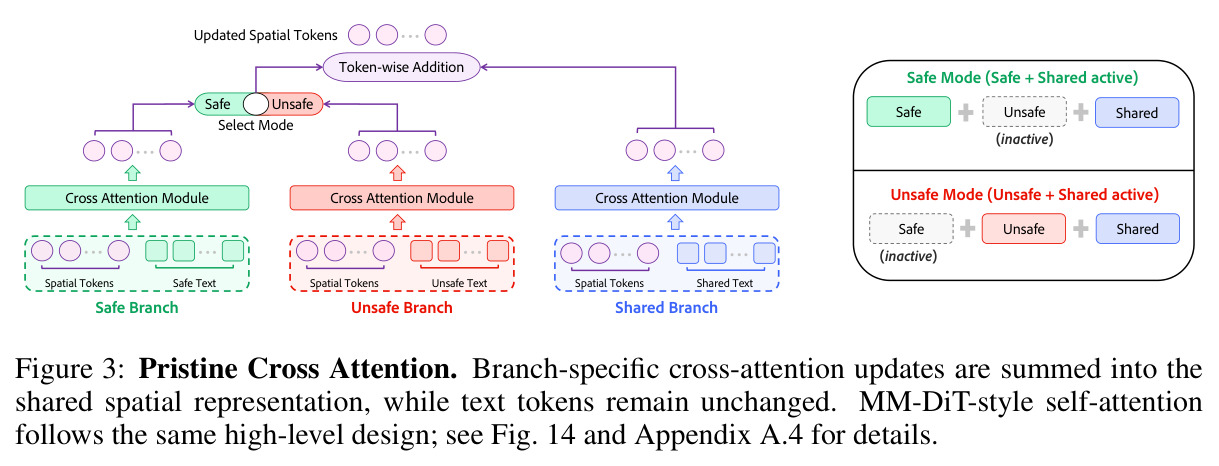
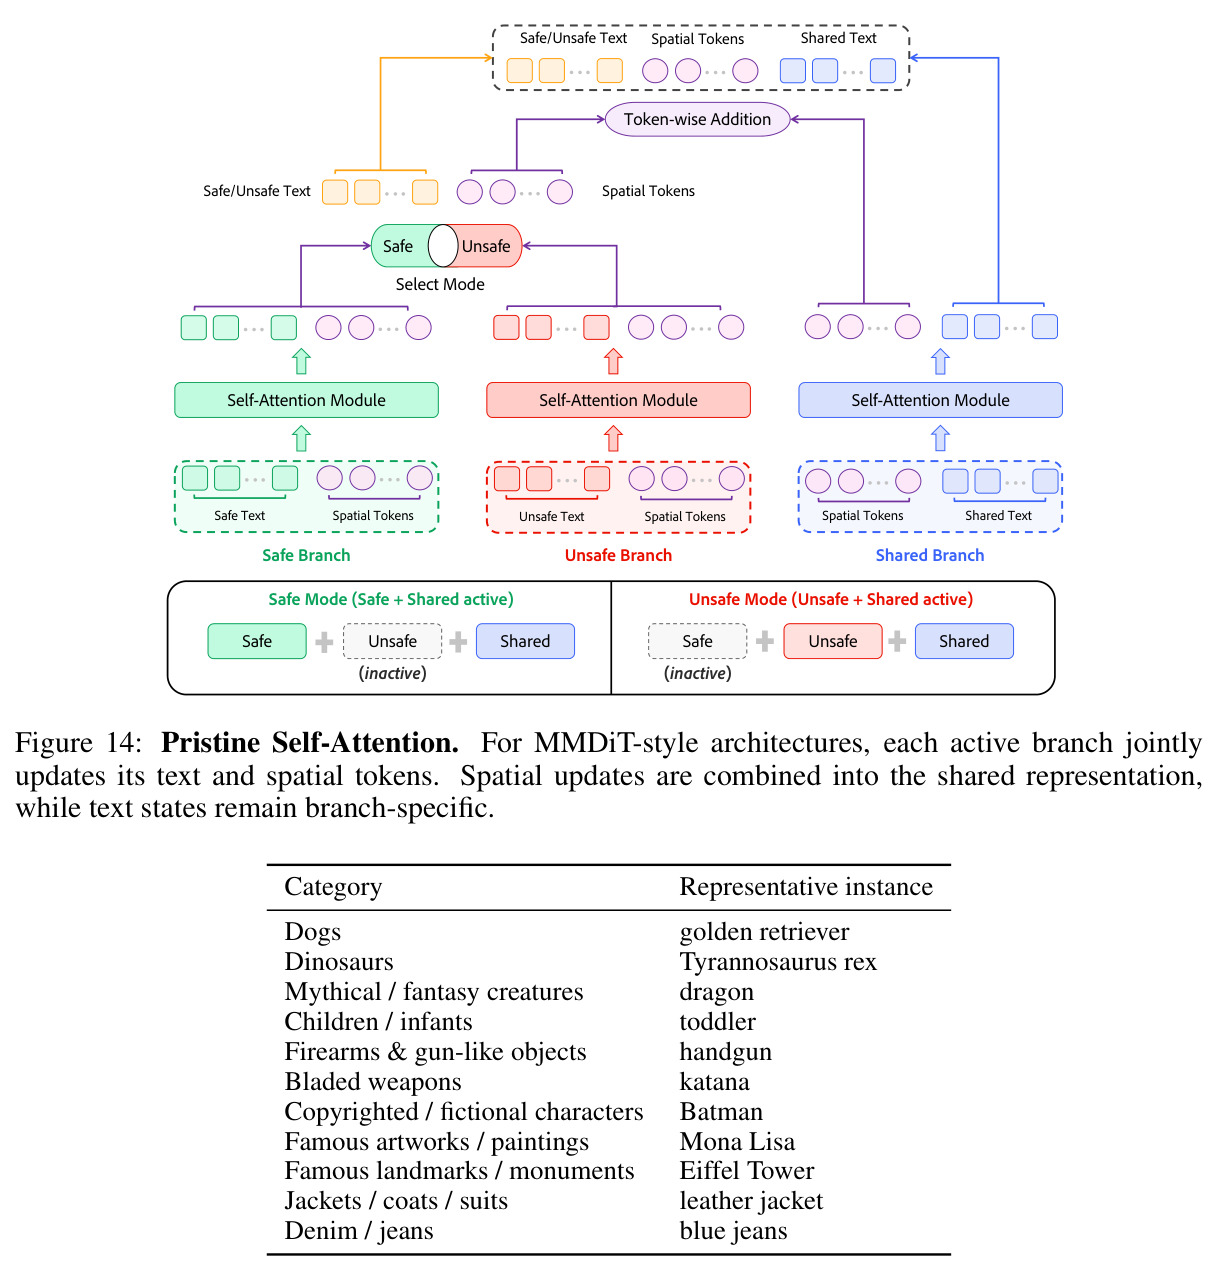
文生图模型把文本条件注入视觉主干的两种主流方式。交叉注意力(SD UNet)中空间图像 token 作 query、文本 token 作 key/value,只更新空间侧,每层参数为 $W = \{W^q_{sp}, W^{kv}_{txt}, W^{out}_{sp}\}$;MMDiT 式自注意力把文本与空间 token 拼接后做联合注意力,两条流各自有独立投影并被同时更新。Pristine Attention 就是把这两种注意力层的参数各复制三份(safe/unsafe/shared),替换原注意力层。
注意力是提示中概念词与视觉内容建立关联的机制,也是本文实现知识分舱的落点。不熟悉这两种注意力,就无法理解三分支如何替换原层、文本流为何要隔离而空间流为何要求和。
机器遗忘与灾难性遗忘
机器遗忘(machine unlearning)指从已训练模型中删除特定数据或概念的影响;在扩散模型中包括微调式的概念擦除(ESD、Concept Ablation)、模型编辑式方法(UCE、ScaPre、SPEED、MACE、TIME)与推理时的 SAFREE。灾难性遗忘指编辑或微调时网络顺带丢失无关能力,当待删概念从几个扩展到成百上千个时该问题会急剧恶化。
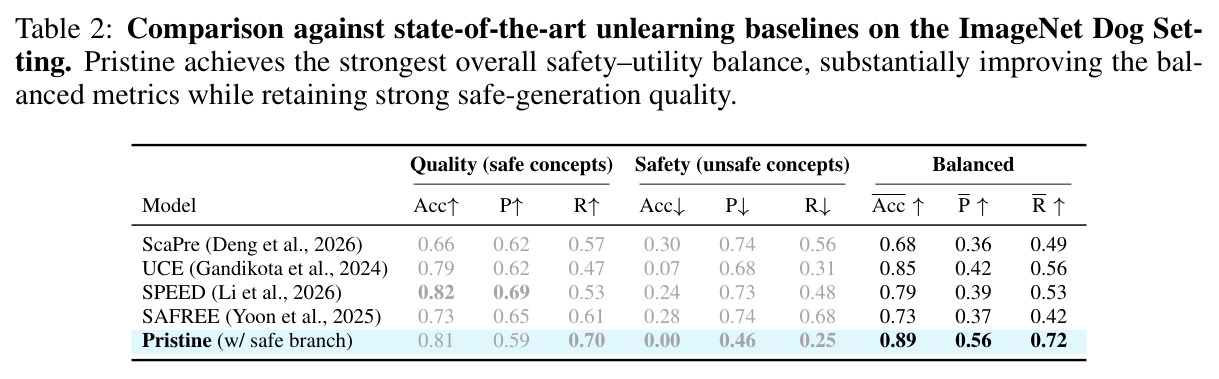
本文动机正是大规模事后遗忘的灾难性遗忘困境,实验部分(Table 2)与四个代表性遗忘方法直接对比。理解'Pristine 在安全-质量权衡上全面占优'这组对比,需要知道这些基线各自的工作方式与失效模式。
多义神经元与特征纠缠
多义神经元(polysemantic neurons)指单个神经元同时参与多个互不相关概念的编码(Elhage 等的叠加/superposition 假说)。这导致概念在参数空间中彼此纠缠:想精准删除一个概念的表征,几乎必然波及共享同一组参数的其他概念,产生不可预测的副作用。
这是'为什么事后编辑难、而预训练时建舱可行'的机理解释。作者还用它解释 Pristine (Unlearn) 消融:即使把 Pristine Attention 事后装进 Full 模型并重训全部原始数据,效果仍弱于预训练时就分离,因为注意力模块会倾向恢复与周围预训练网络兼容的表征,导致不安全信息被部分重新学回。
FID、Precision/Recall 与 VQAScore
FID 衡量生成分布与真实分布的距离(越低越好);Kynkääanniemi 精确率/召回率分别度量生成质量与多样性;VQAScore 用视觉问答模型给'图文一致性'打分。本文为统一刻画安全-质量权衡,还定义 Balanced-$M = H(M_{safe}, 1 - M_{unsafe})$,其中 $H(x,y) = 2xy/(x+y)$ 为调和平均:只有安全概念表现好且对应不安全指标低时才能得高分。
论文的主要表格(Table 1/2/5)全部围绕这三组指标展开,Balanced 系列是读懂'安全与质量可以兼得'这一核心结论的钥匙;不安全侧刻意不用 VQAScore 而用 ImageNet 分类器(EVA-02)准确率,因为它直接检验受限概念是否出现。
研究动机
大规模文生图模型(扩散与流匹配)依赖 LAION 级别的无过滤网络数据(如 LAION-5B)才能获得高质量生成能力,但这类数据不可避免地包含武器、版权角色、名人肖像、成人内容等受限概念,模型会在参数中学到并能按需复现它们,带来有害内容、虚假信息与版权风险。现有做法陷入三重困境。第一,训练前把含受限概念的图片全部过滤掉,会同时丢掉这些图片中的光照、阴影、几何、构图、物体交互等良性视觉知识——一张步枪照片极少整体不安全(Fig. 1),按图片粒度过滤必然误伤。第二,保留全部数据、只在推理时靠护栏过滤或拒绝-重生成,模型本体仍会大量产出不安全图像,造成昂贵的重试循环,且护栏要在千变万化的场景中可靠检测禁止内容,负担极重。第三条路是事后机器遗忘,但当待删概念规模扩大(Deng 等的 ScaPre、Li 等的 SPEED、Gandikota 等的 UCE 等)时会出现灾难性遗忘:神经元普遍多义(polysemantic),同一组参数同时参与多个无关概念的编码,编辑一个概念会不可预测地损伤其他能力。
本文的目标是本文聚焦'事先已知'的受限概念集合 $\mathcal{U} = \{u_1, \dots, u_K\}$(如版权角色、武器、成人材料),提出核心问题:能否在预训练阶段就把不安全概念知识'分舱'到一组独立参数化的组件中,使推理时整体拆除该组件即可禁用这些概念,同时保留从同一批不安全数据中学到的安全有用知识?形式化地说,设有两个参照模型:全量模型 $\theta_{full} = \arg\min_\theta \mathcal{L}_{gen}(\theta; \mathcal{D}_{safe} \cup \mathcal{D}_{unsafe})$(质量参考但会复现受限概念)与安全模型 $\theta_{safe} = \arg\min_\theta \mathcal{L}_{gen}(\theta; \mathcal{D}_{safe})$(安全参考但丢弃不安全数据中的有用信息),目标是让 Pristine 模型在安全性上匹配 $\theta_{safe}$、在生成质量与文本对齐上逼近 $\theta_{full}$。作者强调此处'知识'指整体复现受限概念的能力(如 Batman 的面具+斗篷+战衣这一可识别组合),而非压制单一视觉特征。
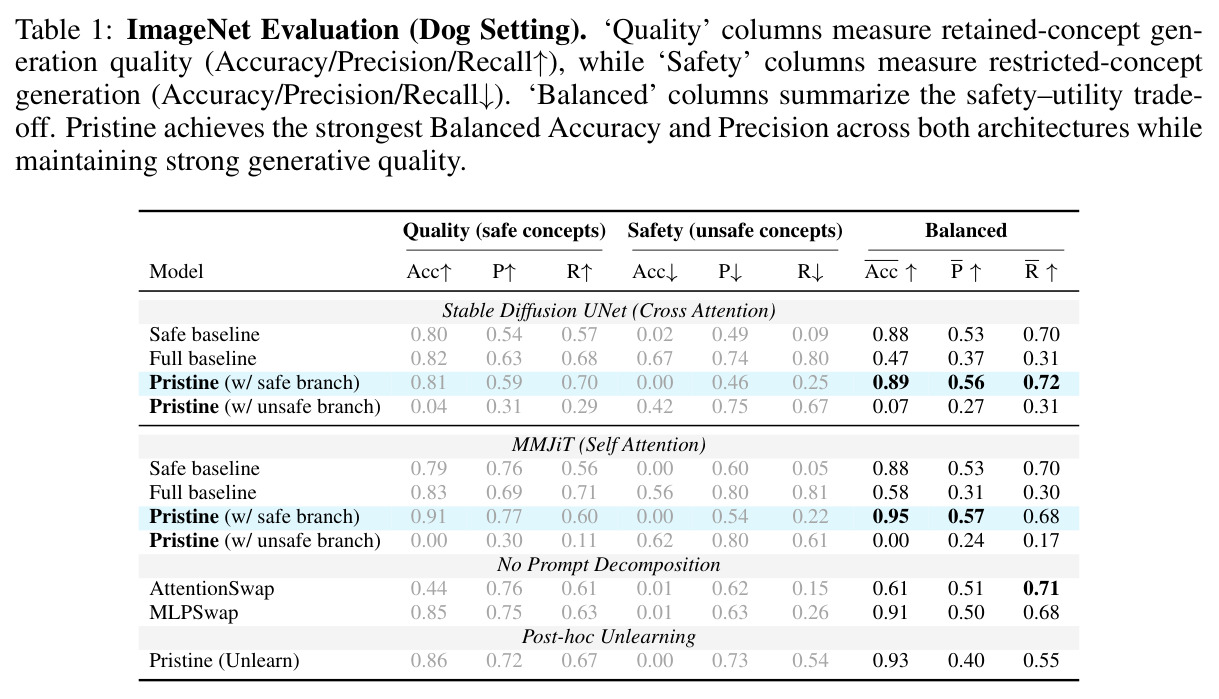
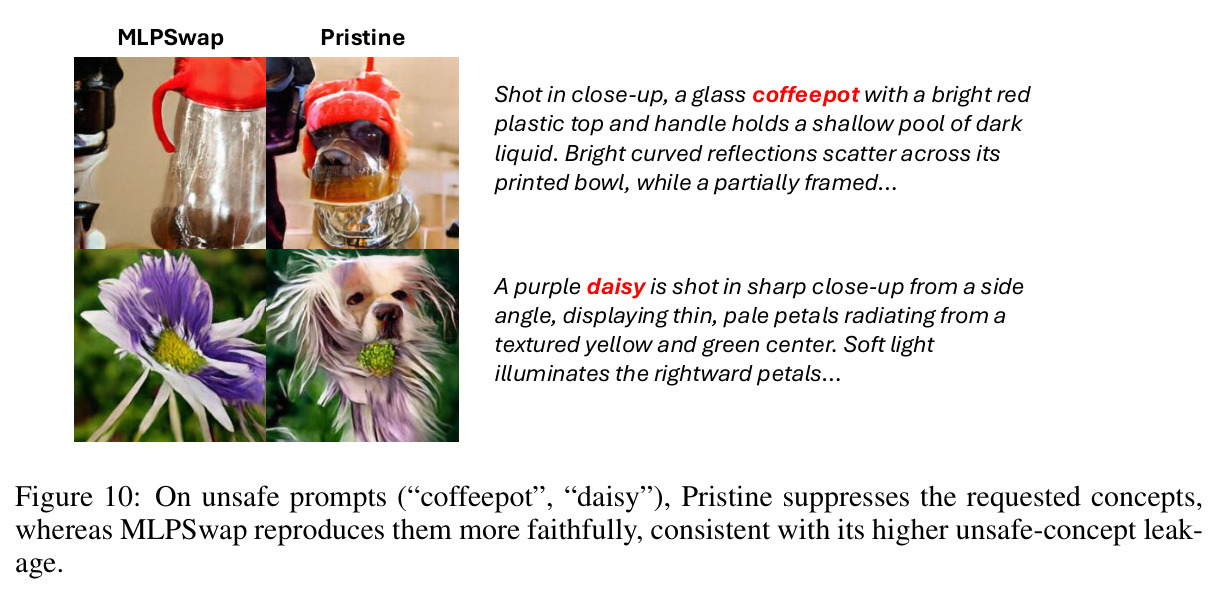
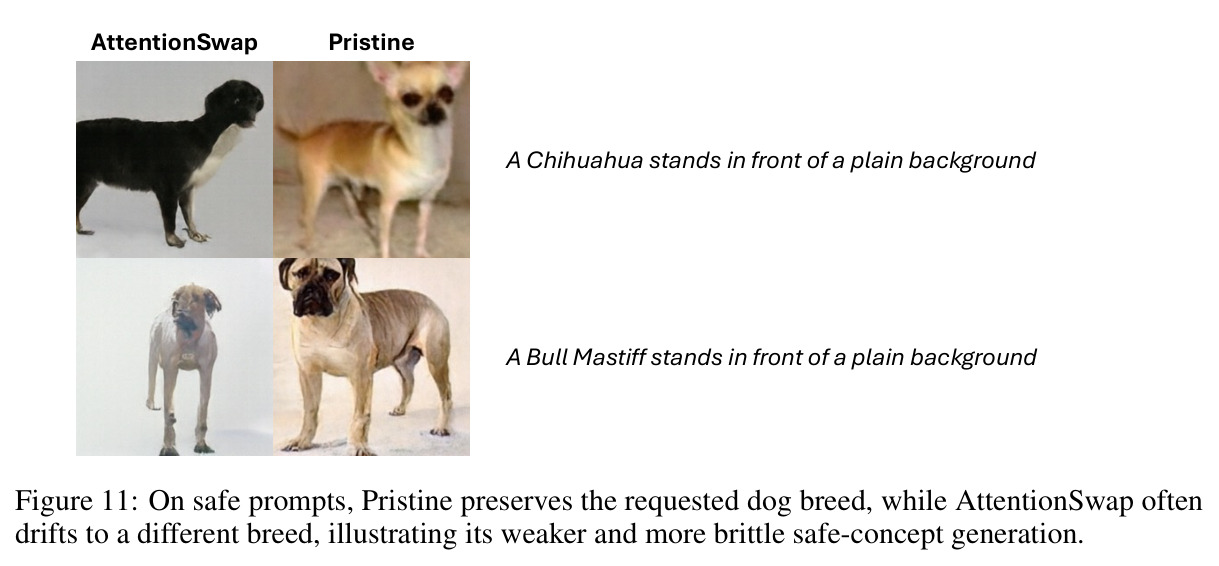
与已有工作不同的是,独特之处在于把安全干预点从'事后编辑'前移到'预训练时',并主张分离必须被显式诱导,而非寄望训练自发涌现。注意力机制天然负责把提示中的概念词与对应视觉内容关联起来,因此作者直接在注意力层实现知识分舱,并引入提示分解(prompt decomposition)作为控制旋钮:每条训练提示被拆成模式专属提示(只含主体身份)与共享提示(只含材质、场景、光照等希望保持可迁移的信息),且两路文本各自独立分词与嵌入,杜绝泄漏。这与并发的模块化 LLM 预训练(Roland et al., 2026,即消融中 MLPSwap 的思想来源)形成鲜明对比:后者只是给不安全样本配一个可拆卸专家模块,指望训练自己完成分离;本文则显式规定'什么进可拆卸分支、什么留在共享分支'。消融证明这一差别至关重要:无提示分解的 AttentionSwap 与 MLPSwap 的 Balanced Accuracy 分别只有 0.61 与 0.91,而 Pristine 达到 0.95。该定位与事后遗忘互补而非替代——预训练建舱负责已知受限概念,事后方法处理预训练后才出现的限制。
核心方法
直觉上,一张'不安全'图片极少整体不安全:一张步枪照片里,枪械身份是要压制的,但暗色调、沙地场景、光影、构图都是可迁移的良性知识。Pristine 的思路是在预训练时就把这两类知识写进不同的参数组:把骨干网络(cross-attention UNet 或 MMDiT 式自注意力 MMJiT)中的每个注意力层替换为 Pristine Attention,它包含三条独立参数化分支——safe、unsafe 与 shared。safe/unsafe 分支通过模式专属提示学习各自概念的身份表征,shared 分支通过共享提示学习两类样本共有的可迁移属性,且 shared 分支始终激活、模式分支按样本安全性切换。训练目标是 $\theta_{pristine} = \arg\min_\phi \mathcal{L}_{gen}(\{\phi_{shared}, \phi_{safe}\}; \mathcal{D}_{safe}) + \mathcal{L}_{gen}(\{\phi_{shared}, \phi_{unsafe}\}; \mathcal{D}_{unsafe})$,除注意力层外网络其余部分与生成目标完全不变。推理时直接删除 unsafe 分支参数,仅保留 shared 与(可选的)safe 分支,从结构上保证受限概念无法被生成。该流程在物体中心的 ImageNet(三分支)与开放世界的 CC12M(两分支:safe 样本只走 shared)上分别实例化,并用 MNIST 玩具实验验证直觉。
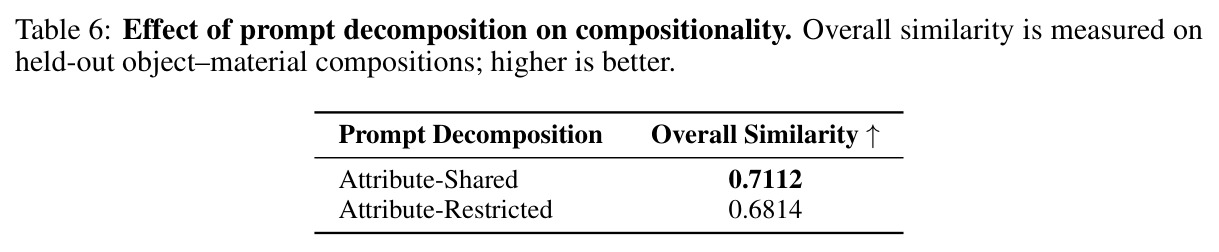
核心创新是'提示分解驱动的知识分舱'。每条训练提示 $c$ 被拆成两个文本流:模式专属提示(安全样本如 "A Chihuahua.",不安全样本如 "An assault rifle.",只声明主体身份、不含任何视觉属性)与共享提示(如 "A brown object standing on grass." / "A dark object resting on sand.",只描述希望保持可迁移的属性与场景)。关键设计有三:第一,三条分支的文本各自独立 tokenize 与嵌入($t_b = Embed(c_b)$,$b \in \{shared, safe, unsafe\}$),shared 表示从架构上接触不到被隔离的身份信息,阻断泄漏;第二,安全样本同样经过 shared 分支,使其在两种模式下扮演完全相同的角色,从不安全数据学到的'深色材质''沙地场景'可直接与安全身份重组——MNIST 实验漂亮地展示了这一点:0–4 为安全(只有细体)、5–9 为不安全(含粗体),共享分支学到粗体后,模型能生成训练中从未见过的粗体 0–4,同时拒绝生成 5–9;第三,提示分解同时是可控旋钮:把材质写进共享提示还是不安全提示,直接决定该属性在部署模型中是否可用(TPIPS 0.7112 对 0.6814)。与概念擦除的本质区别:后者编辑已纠缠的表征,前者从不让受限概念进入不可拆卸的参数。
方法步骤详情
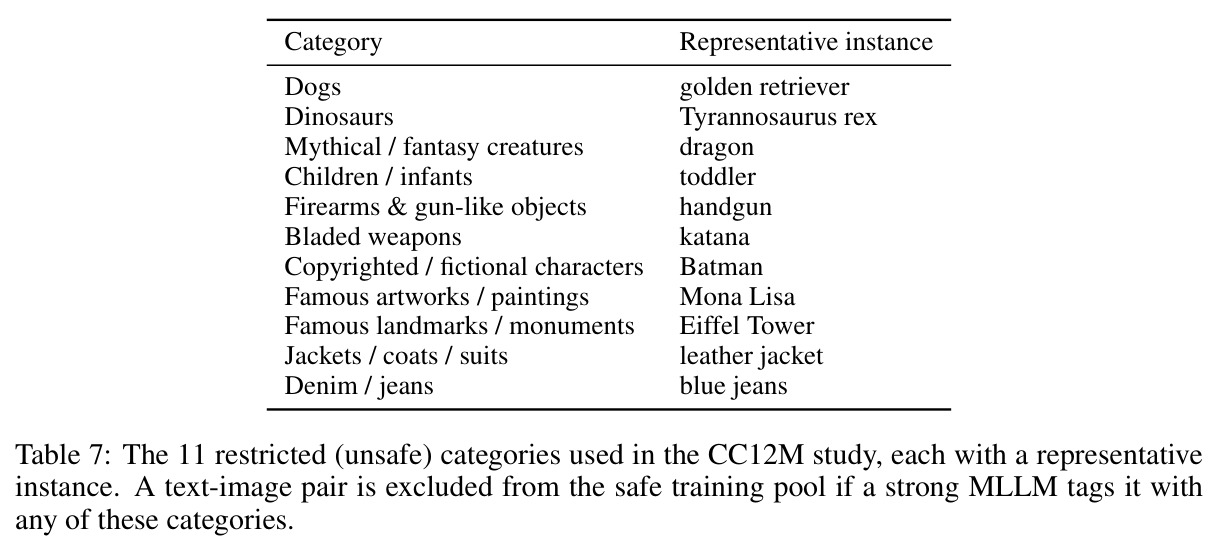
完整流程分七步。(1) 数据划分:给定受限概念集 $\mathcal{U}$,把数据划分为不含任何 $\mathcal{U}$ 概念的 $\mathcal{D}_{safe}$ 与至少含一个的 $\mathcal{D}_{unsafe}$。(2) 提示分解:物体中心数据(ImageNet)先用 Gemini 3.1 Pro 为每张图生成约 40 词 dense caption,再用 Qwen3.5-27B 拆成 subject caption(只含类别名的裸句,如 "A German Shepherd.")与 residual caption(用 'the object' 指代主体、外观描述抽象到无法推断类别);开放世界数据(CC12M)先用 MLLM 按表 7 的 11 类打标(约 38% 被标记为受限),再把每个受限概念实例绑到句柄 $\{o_1, \dots, o_K\}$,生成 $c_{unsafe}$(逐句柄声明身份)与 $c_{shared}$(仅用句柄重述全场景,保留交互、光照、构图)。(3) 独立编码:$t_b = Embed(c_b)$。(4) 分支注意力:模式分支按 $\Gamma(x,c) \in \mathcal{U}$ 选择 $W_{mode}$($W_{unsafe}$ 或 $W_{safe}$),每支计算 $(\Delta t_b, \Delta x_b) = Attn(t_b, x; W_b)$。(5) 聚合:文本状态在分支内独立更新 $t_b \leftarrow t_b + \Delta t_b$,空间更新相加 $x \leftarrow x + \Delta x_{shared} + \Delta x_{mode}$;cross-attention 每支参数 $\{W^q_{sp}, W^{kv}_{txt}, W^{out}_{sp}\}$,MMDiT 自注意力每支参数 $\{W^{qkv}_{txt}, W^{qkv}_{sp}, W^{out}_{txt}, W^{out}_{sp}\}$。(6) 训练:AdamW($\beta_1{=}0.9, \beta_2{=}0.999$)、全局 batch 1024、UNet 学习率 $1\times10^{-4}$、MMJiT $4\times10^{-4}$(5000 步 warmup),标准 DDPM 或流匹配目标。(7) 推理:删除 unsafe 分支;安全提示按训练时同样方式分解(ImageNet),或无需分解直入 shared 分支(CC12M,推理计算量与普通模型完全相同)。
技术新颖性
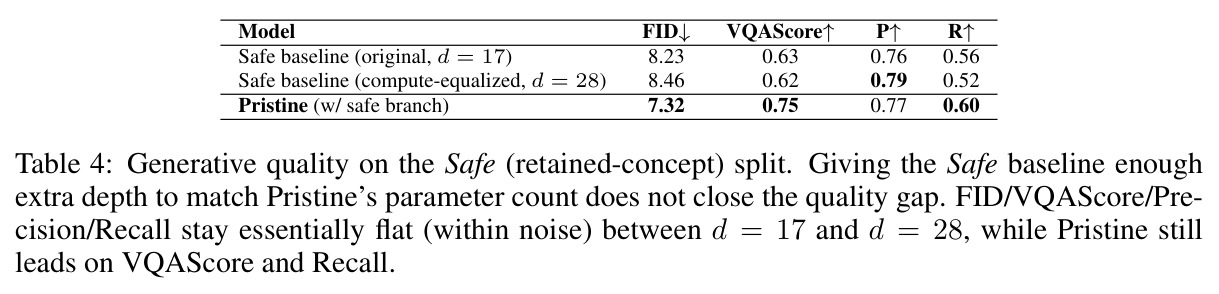
技术新颖性体现在四点。其一,架构层面:这是较早把'概念级访问控制'内嵌到 T2I 预训练网络的工作,与 Golatkar 等的预训练级精确遗忘(面向单样本删除)和 Roland 等的模块化 LLM 预训练(靠训练自发分离)均不同,Pristine 用提示分解显式指定分离边界。其二,机制层面:文本流分支隔离、空间流求和的设计,把'身份'锁进可拆卸的文本条件通路,而共享空间状态承载可迁移视觉知识,隔离与迁移在同一次注意力操作内同时完成。其三,实证层面:作者系统排除了平凡解释——计算对齐实验把 Safe 基线从 17 层加深到 28 层(260.2M 增至 416.0M 参数,与 Pristine 的 420.8M 仅差 1.15%),FID/VQAScore 几乎不动(8.46/0.62 对 8.23/0.63),证明质量提升来自数据多样性而非容量;Pristine (Unlearn) 消融(Balanced Acc/P/R 0.93/0.40/0.55,弱于预训练建舱的 0.95/0.57/0.68)证明同样的架构事后加装更差,分离必须在预训练中发生。其四,通用性:同一机制同时适配 cross-attention(SD UNet)与 joint self-attention(MMJiT)两种主流骨干,并给出各自完整的参数化方案。
实验结果
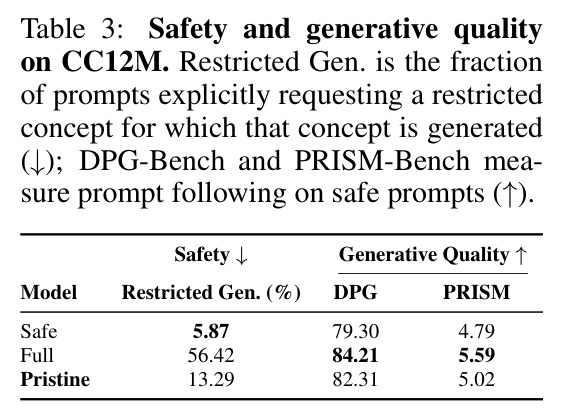
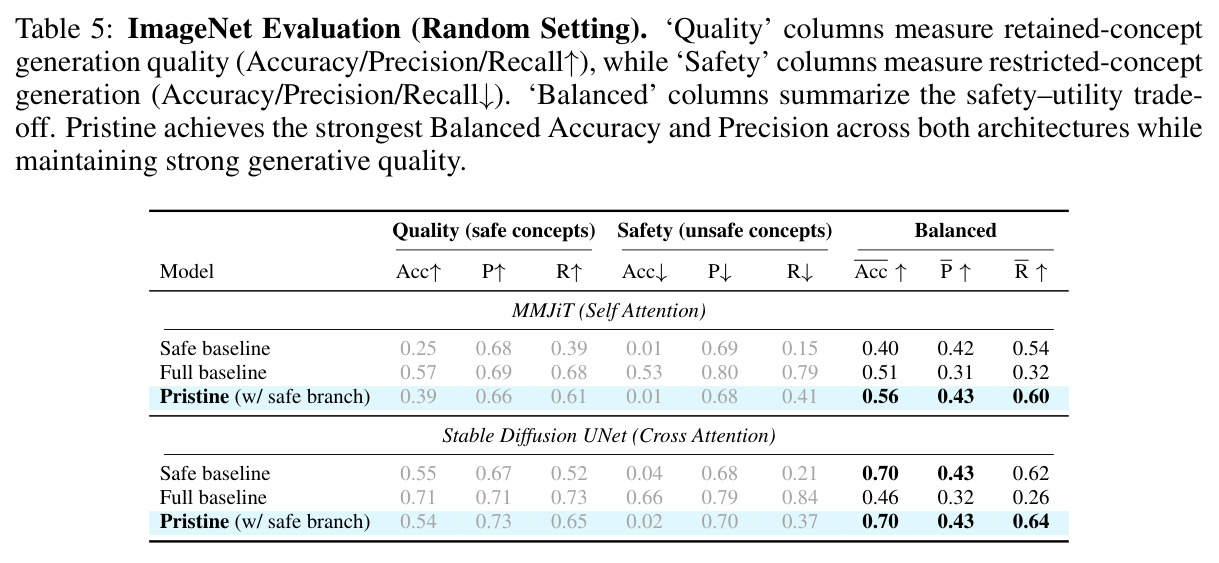
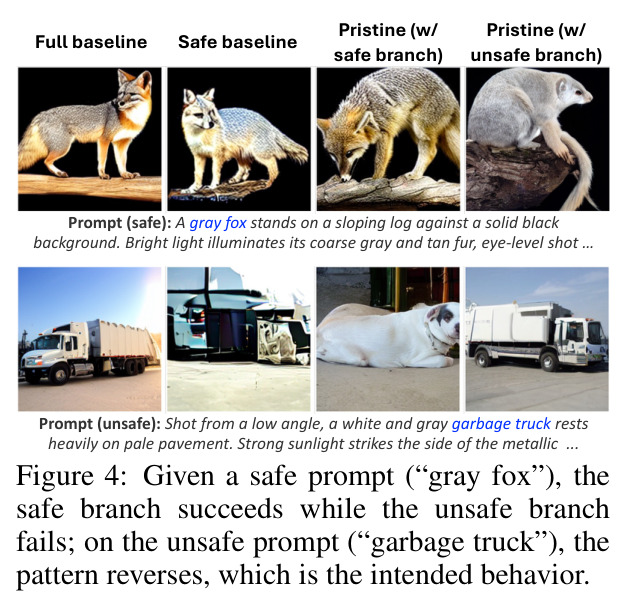
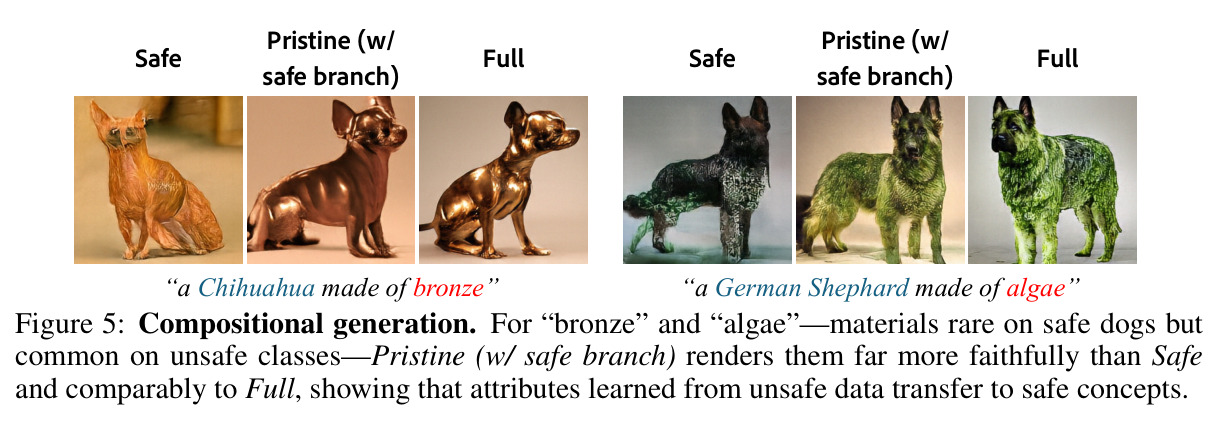
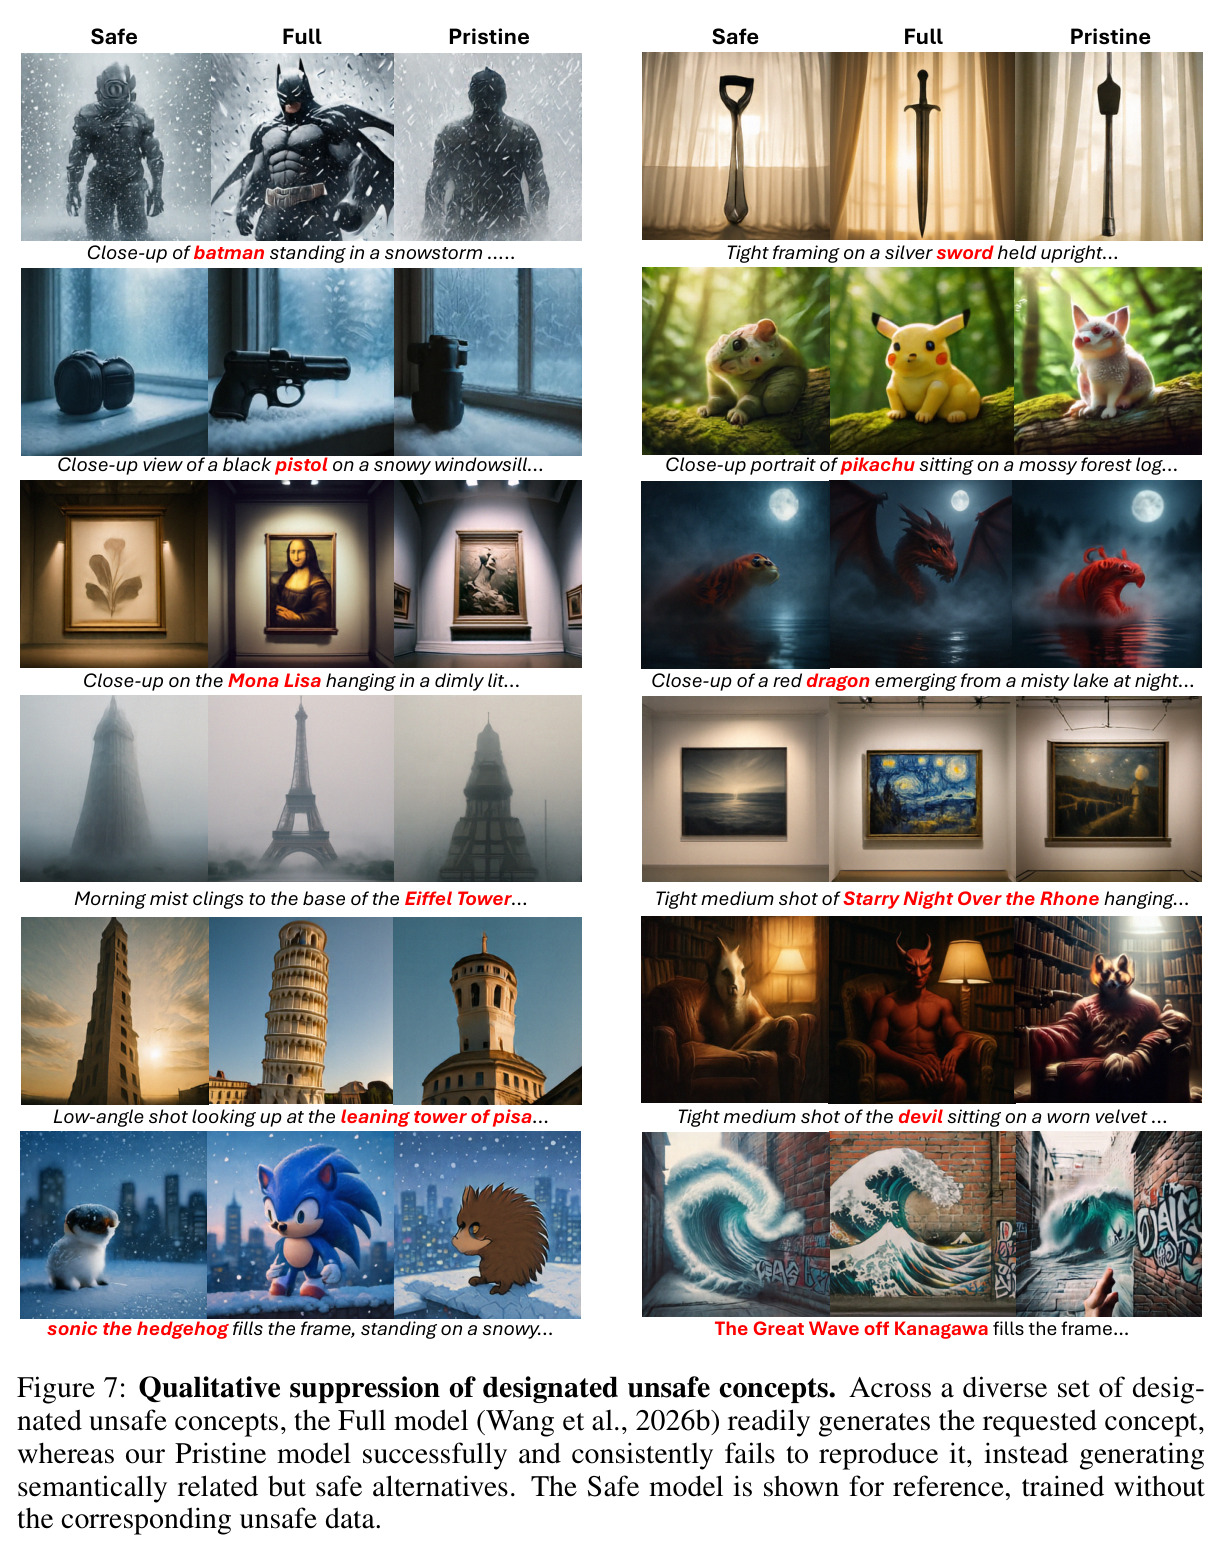
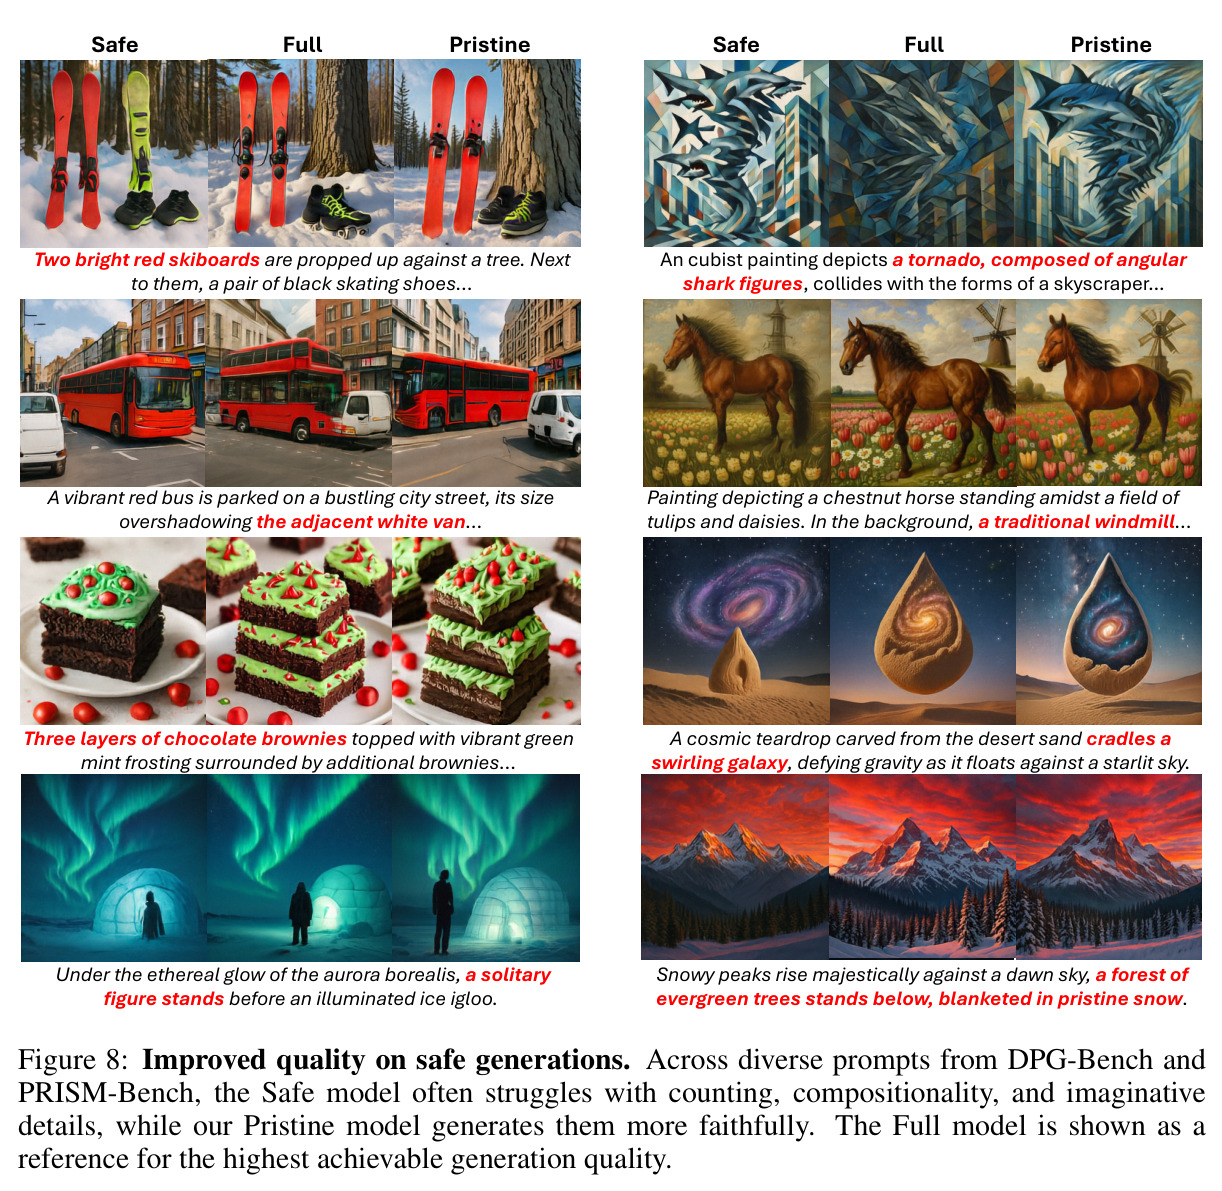
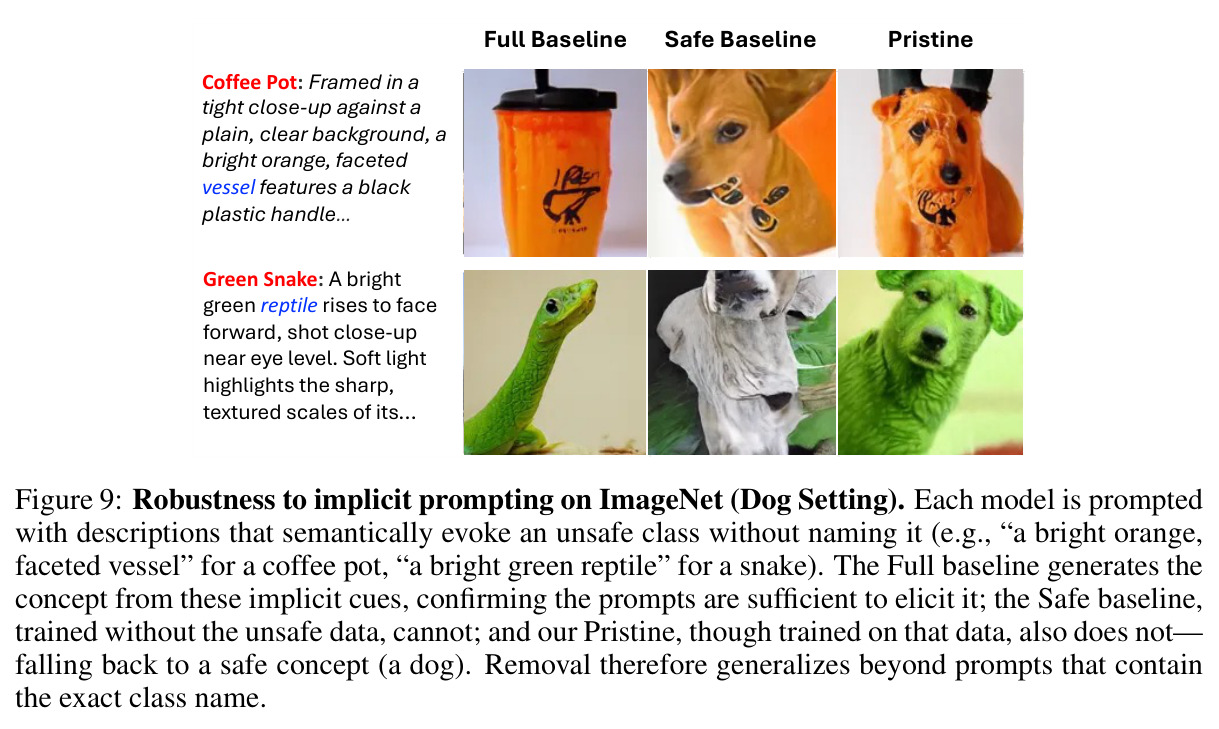
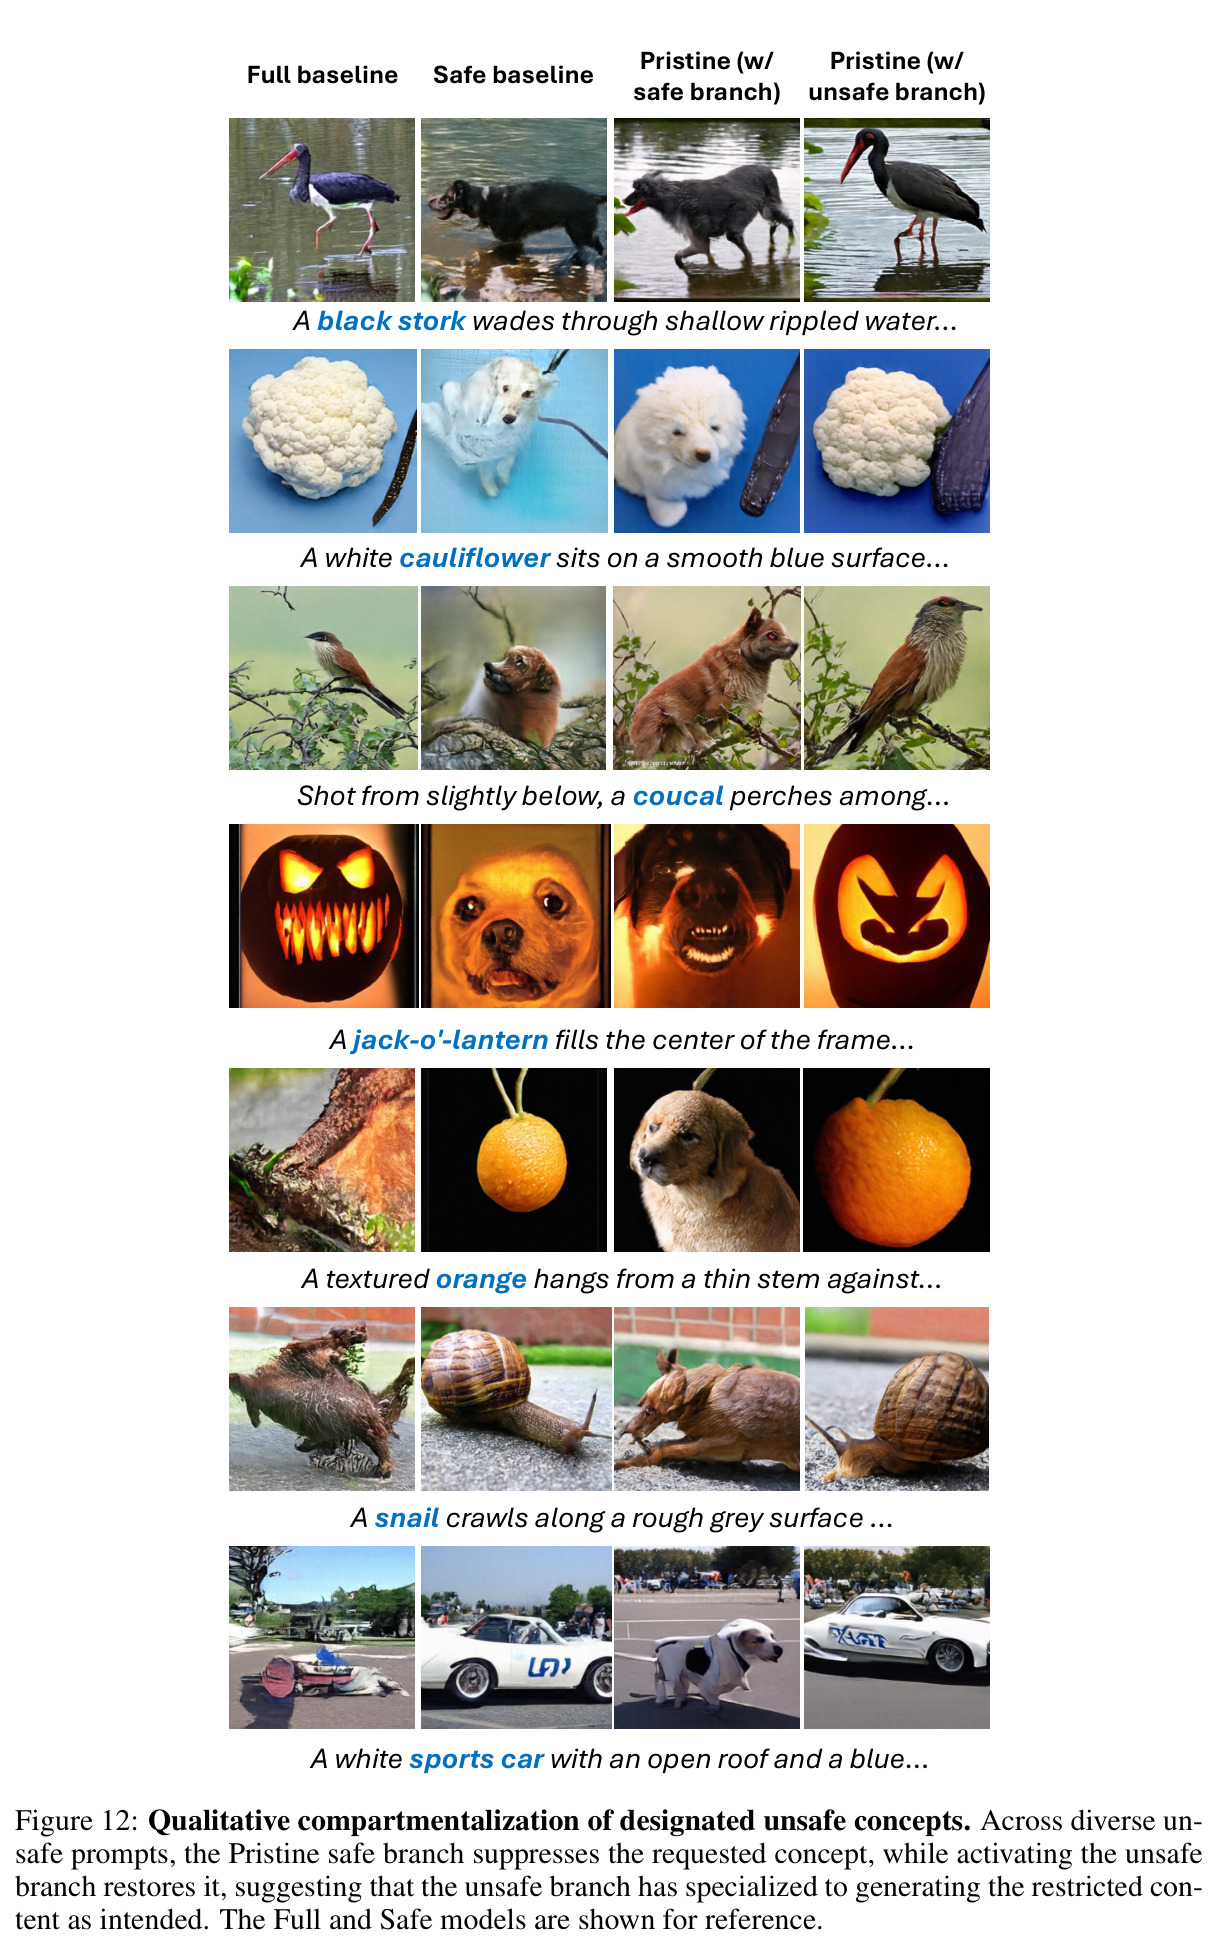
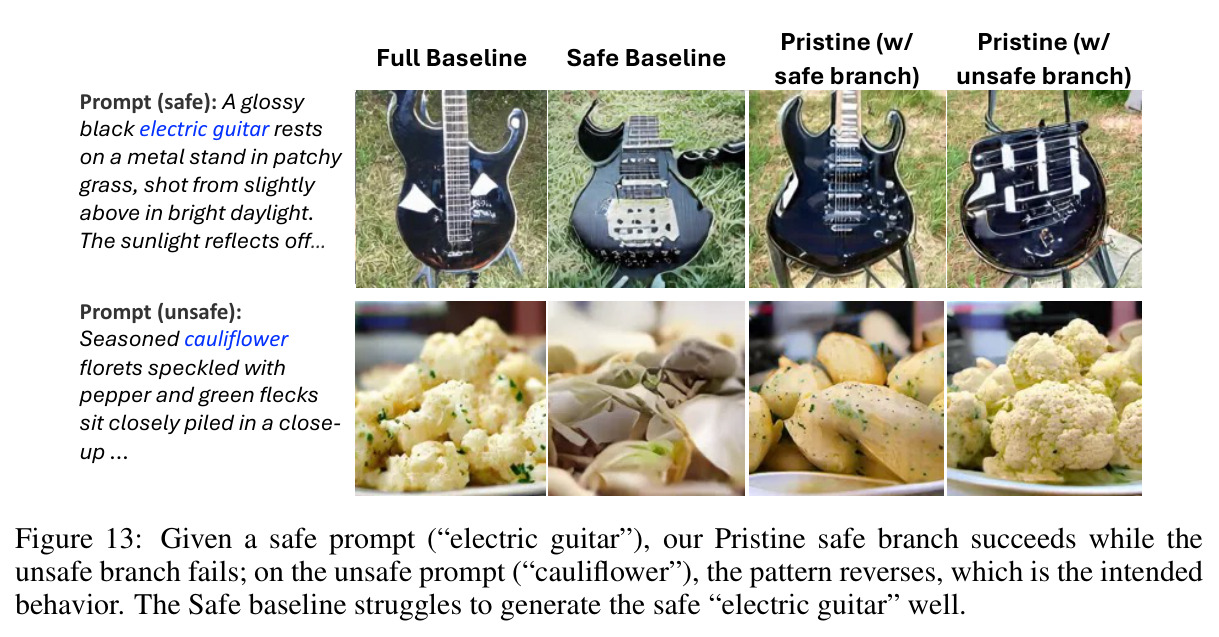
ImageNet Dog Setting(131 个犬类为安全、869 类为不安全):SD UNet 上 Pristine (w/ safe branch) 的 Balanced Acc/P/R 达 0.89/0.56/0.72,超过 Safe(0.88/0.53/0.70)与 Full(0.47/0.37/0.31),不安全概念分类器准确率压到 0.00%(Full 为 67%),安全概念 Acc 0.81 与 Full 的 0.82 几乎持平;MMJiT 上 Balanced Acc/P 达 0.95/0.57,不安全 Acc 0.00%,安全概念 Acc 0.91 反超 Full(0.83)。质量指标一致:UNet 上 Pristine FID 8.35、VQAScore 0.63,接近 Full(7.92/0.68)远超 Safe(10.72/0.48);MMJiT 上 7.32/0.75 对 Full 6.68/0.79、Safe 8.23/0.63。隐式提示(不点名概念)下抑制依然成立:UNet 隐式不安全 Acc 2.82%(Safe 2.80%、Full 32.30%),MMJiT 6.20%(Full 40.21%)。直接激活 unsafe 分支会恢复不安全生成并损害安全生成(Fig. 4/12),证实分支确实特化。与四个大规模遗忘基线对比(Table 2):最强的 UCE 仅 0.85/0.42/0.56,且代价惨重(VQAScore 跌至 0.31、FID 升至 12.43),Pristine 全面占优(0.89/0.56/0.72、0.63、8.35)。组合生成(安全犬种 × 10 种稀有材质,TPIPS):Full 0.7705 > Pristine (Unlearn) 0.7484 > Pristine 0.7404 > AttentionSwap 0.7283 > MLPSwap 0.7272 > Safe 0.6890,证明材质知识确实从 unsafe 数据迁移。开放世界 CC12M(Table 3):Full 在 56.42% 的受限提示上生成了受限概念,Safe 压到 5.87% 但 DPG/PRISM 掉到 79.30/4.79,Pristine 以 13.29% 残留率拿到 82.31/5.02。Random Setting(Table 5)下 MMJiT Balanced Acc/P/R 0.56/0.43/0.60 为最优,不安全 Acc 从 Full 的 53% 降至 1%,而 Safe 的 FID 恶化到 19.09(Pristine 9.46)——连安全概念都画不好的模型谈不上安全。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet Dog Setting 安全-质量权衡(SD UNet,交叉注意力) | Balanced Accuracy($H(Acc_{safe}, 1-Acc_{unsafe})$) | 0.89(不安全 Acc 0.00%,安全 Acc 0.81) | Safe 基线 0.88(安全 Acc 0.80);Full 基线 0.47(不安全 Acc 67%) | 安全性与 Safe 持平的同时质量对齐 Full;Balanced Accuracy 较 Full +0.42 |
| ImageNet Dog Setting(MMJiT,自注意力) | Balanced Accuracy / Balanced Precision | 0.95 / 0.57(安全概念 Acc 0.91,不安全 Acc 0.00%) | Safe 0.88 / 0.53(安全 Acc 0.79);Full 0.58 / 0.31(不安全 Acc 56%) | Balanced Accuracy 较 Safe +0.07、较 Full +0.37;安全概念 Acc 反超 Full |
| 隐式提示泄漏测试(提示不点名目标概念) | 不安全概念分类器 Acc(越低越好) | UNet 2.82% / MMJiT 6.20% | Full 32.30% / 40.21%;Safe 2.80% / — | 较 Full 降低约 30 个百分点,与从未见过不安全数据的 Safe 相当 |
| 与大规模遗忘方法对比(SD UNet,均从 Full 初始化) | Balanced Acc / Balanced Precision | 0.89 / 0.56(不安全 Acc 0.00%) | UCE 0.85 / 0.42;SPEED 0.79 / 0.39;ScaPre 0.68 / 0.36;SAFREE 0.73 / 0.37 | Balanced Precision 较最强基线 UCE +0.14;UCE 副作用为 VQAScore 跌至 0.31、FID 升至 12.43(Pristine 0.63 / 8.35) |
| 安全概念生成质量(ImageNet Dog Setting) | FID ↓ / VQAScore ↑ | UNet 8.35 / 0.63;MMJiT 7.32 / 0.75 | UNet:Safe 10.72 / 0.48、Full 7.92 / 0.68;MMJiT:Safe 8.23 / 0.63、Full 6.68 / 0.79 | FID 较 Safe 改善 2.37(UNet)/ 0.91(MMJiT),逼近 Full;计算对齐的深层 Safe 基线(28 层)仍只有 8.46 / 0.62 |
| 组合生成(安全犬种 × 10 种安全数据中罕见的材质) | TPIPS(判据 'object identity and object material',↑) | 0.7404(Pristine w/ safe branch) | Safe 0.6890;Full 0.7705;AttentionSwap 0.7283;MLPSwap 0.7272;Pristine (Unlearn) 0.7484 | 较 Safe +0.0514,追回 Full 与 Safe 之间差距的约 61% |
| 开放世界 CC12M 预训练(11 类受限概念,5500 条测试提示) | 受限生成率 ↓ / DPG-Bench ↑ / PRISM-Bench ↑ | 13.29% / 82.31 / 5.02 | Full 56.42% / 84.21 / 5.59;Safe 5.87% / 79.30 / 4.79 | 受限生成率较 Full 降低 43.13 个百分点;质量较 Safe 提升 DPG +3.01、PRISM +0.23,恢复大部分质量损失 |
| ImageNet Random Setting(随机 150 安全类 vs 850 不安全类,MMJiT) | Balanced Accuracy / 不安全 Acc | 0.56(不安全 Acc 1%) | Safe 0.40(不安全 Acc 1%);Full 0.51(不安全 Acc 53%) | Balanced Accuracy 三者最高;Safe 的 FID 恶化到 19.09、VQAScore 0.33,而 Pristine 为 9.46 / 0.64 |
局限与改进
作者明确承认的局限:其一,方案只适用于预训练前已知的受限概念,部署后新出现的限制仍需事后遗忘与推理护栏配合(结论中明确声明是互补而非替代);其二,CC12M 上受限概念生成率仍有 13.29%,未达到 Safe 的 5.87%,抑制不是绝对的;其三,整条流水线依赖 MLLM/LLM——约 38% 的 CC12M 被打上受限标签、caption 与 prompt 分解均由生成式模型完成,标注或分解错误会直接转化为安全漏洞或质量损失;其四,训练侧三分支使参数从 260.2M 涨到 420.8M。我的补充观察:第一,unsafe 分支本身保留了完整的受限概念生成能力,安全边界从'模型不会'变成'部署方必须保管好可拆卸权重',威胁模型需要重新定义;第二,泄漏评估依赖 EVA-02 分类器与 Qwen3.5-122B 判官,后者与训练标注所用的 Qwen 家族同源,可能存在系统性偏差,真实泄漏率并不确定;第三,ImageNet 实验的 caption 全部由 Gemini 合成,模型实际学到的是'Gemini 视角'的描述分布,与真实互联网 caption 分布有差距;第四,实验规模停在约 4 亿参数、256–512 分辨率,尚未验证 SDXL/FLUX 级模型上是否依旧成立;第五,开放世界实际采用的两分支版显式不安全 Acc 为 1.06%,弱于三分支的 0.00%,说明去除 safe 分支是有代价的。
独立分析的弱点
独立分析的弱点与改进方向:(1) 残留泄漏路径——CC12M 上 13.29% 的受限生成可能来自 MLLM 标注漏检,或分解时身份信息渗入共享提示(如 'holding object 2' 这类句柄描述仍可能让 shared 分支学到枪械的形状先验),改进方向是对共享 prompt 做对抗性探测(构造诱导性提示试图激发受限概念)并迭代净化训练集;(2) 权重保管风险——unsafe 分支若随开源权重泄露即可恢复受限生成能力,改进方向是训练后对 unsafe 分支加密或与部署密钥绑定门控,使其离开安全环境即失效;(3) '知识 = 整体复现'的定义偏窄——某艺术家的风格、标志性构图等分布式知识不受句柄式分解保护,可能仍留在共享分支并可被隐式提示唤起,改进方向是为风格类概念设计属性级的受限路由;(4) 评估链路依赖生成式判官——改进方向是引入人工审计子集并报告判官与人工标注的一致率,同时避免判官与标注器同源;(5) Random Setting 显示当安全/不安全划分语义上任意时 Safe 基线严重崩坏(FID 19.09)而 Pristine 介于中间(9.46),说明概念集粒度选择本身是个敏感超参,改进方向是自适应概念划分或多粒度多套分支并存。
未来方向
作者提出的方向:与事后遗忘和推理时护栏组成分层防御体系——预训练建舱处理已知受限概念,事后方法处理新出现的限制,护栏在部署侧兜底。基于本文成果可延伸的方向:(1) 扩展到更大规模骨干(SDXL、FLUX 级)与更高分辨率,检验参数量增大后分解是否依旧诱导干净分离;(2) 动态概念集:预训练后新增受限概念时,冻结其余参数只重训 unsafe 分支,实现'即插即忘'的策略更新,也呼应 Pristine (Unlearn) 显示的事后加装仍有相当效果(TPIPS 0.7484);(3) 把提示分解推广为通用知识路由接口,不仅做安全,还可做版权风格控制、地域合规、用户级个性化遗忘;(4) 理论化:分析 shared/unsafe 分支的表征几何与信息泄漏上界,回答'什么条件下分离是紧凑且稳定的';(5) 扩展到视频生成与多模态基础模型,真人肖像与 IP 角色在时序维度上更难隔离;(6) 把'可分离性'发展为诊断工具:用 Pristine (Unlearn) 式重训的恢复程度量化已训练模型中概念与有用知识的纠缠程度。
复现评估
复现友好度较高但有隐性成本。可复现资产:附录给出完整数据构造(A.2.1、A.5)、训练超参(AdamW $\beta_1{=}0.9, \beta_2{=}0.999$、全局 batch 1024、UNet 学习率 $1\times10^{-4}$、MMJiT $4\times10^{-4}$、5000 步 warmup、CFG 尺度 2/3、去噪步数 500/200)、以及全部三个 LLM 提示模板(Gemini dense captioning、Qwen 提示分解、多标签判官)的原文;底座全部公开——SD 1.5 UNet(冻结 VAE 与 CLIP 文本编码器)、MMJiT/MiniT2i(flan-t5-large 冻结,约 416M 参数、17 个 double-stream 块)、CC12M 的 LLaVA-NeXT 重标注公开数据集。隐性成本:需要 Gemini 为 128 万张 ImageNet 图生成 caption、Qwen3.5-27B 做分解、MLLM 给约 1200 万级 CC12M 打标,API 调用量与费用可观;判官环节需要 Qwen3.5-122B-A10B 级模型经 vLLM 部署。算力方面,约 4 亿参数去噪器配 batch 1024 属于数十卡可承受的训练规模,远小于 SOTA 巨型模型。注意:Reproducibility Statement 承诺透明并列出所建代码库链接,但未明确承诺开源 Pristine 自身代码与权重。综合评估复现难度为中高——工程链路长(数据标注、分解、双骨干训练、多维评估),但每一步均有充分细节。
论文图表
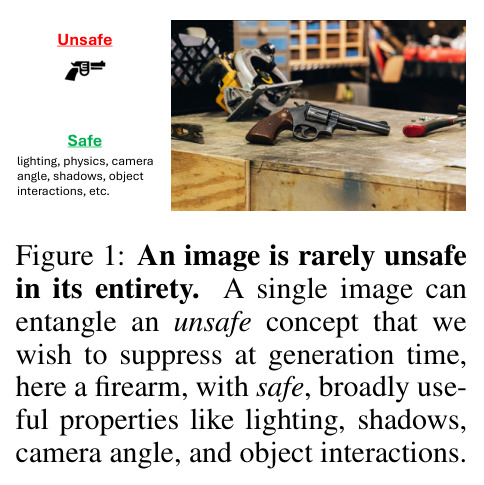
展示一张包含火器的照片:枪械本身是希望压制的不安全概念,但同一张图还包含光照、阴影、相机角度、物体交互等大量安全且可复用的视觉知识,两类知识在同一图像中天然纠缠。
一句话立起全文的问题设定——按图片粒度过滤数据必然误伤良性视觉知识,这正是'知识分舱'方案需要解决的根源矛盾。
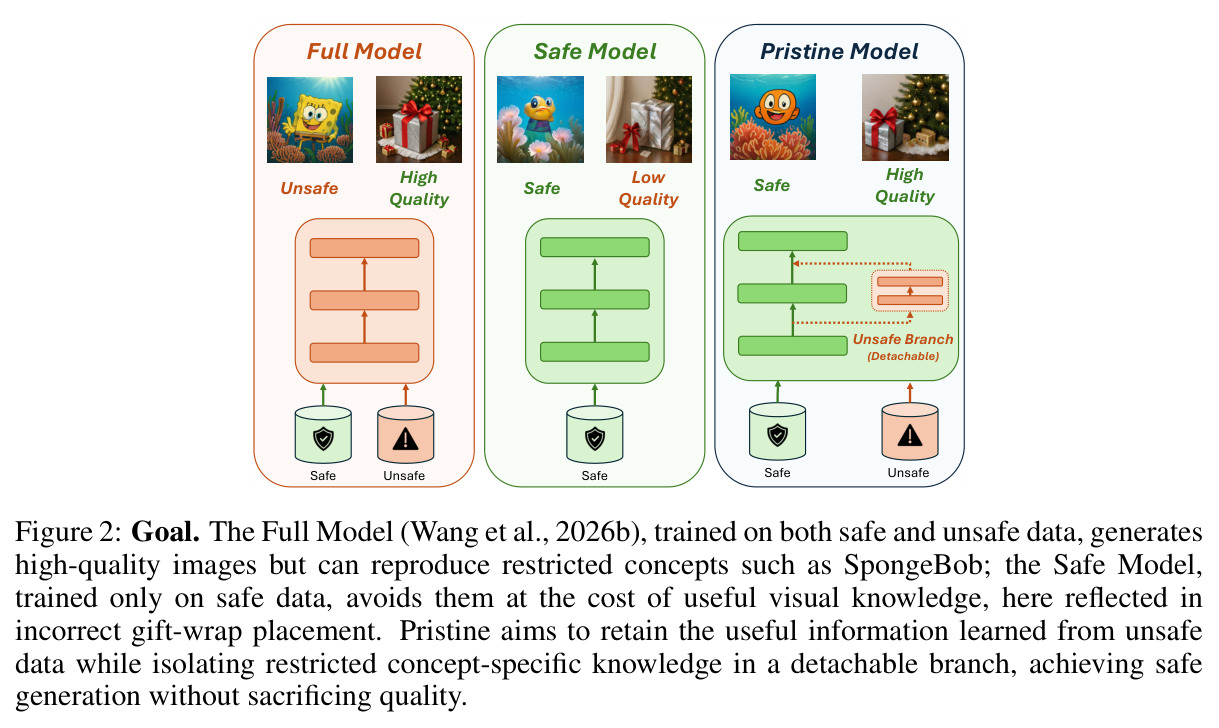
三列对比图:全量模型生成质量高但会复现海绵宝宝等受限概念;只用安全数据训练的 Safe 模型避免了受限概念却丢失有用视觉知识(示例中礼花包装纸位置错误);Pristine 把受限概念专属知识隔离进可拆卸分支,同时保留有用信息,实现安全与质量兼得。
用直观例子定义了'理想模型'的评价标准——安全性看齐 Safe、质量看齐 Full,这是理解全文目标与所有实验设计的钥匙。
左列为不安全提示(苔石上的手枪、长椅上的米老鼠、小熊维尼):Full 照常生成,Safe 与 Pristine 均成功抑制;右列为安全提示(黑白板、三只毛绒动物、头盔气泡里的猫):Pristine 的生成质量与 Full 相当、明显好于 Safe。
在真实开放世界数据上同时展示安全抑制与质量保持两个侧面,是 CC12M 大规模实验的定性总结。