OPMD:超越输出监督的在策略机制蒸馏 OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
构建学生兼容教师把教师中间计算翻译成学生可用形式,再在策略上内化,超越输出监督。
前置知识
在策略蒸馏(On-Policy Distillation, OPD)
一种知识蒸馏范式:让学生模型自己采样生成前缀 $\hat{y}\sim p_{\theta_S}(\cdot|x)$,再在这些“学生自己会走到的状态”上用反向 KL 把学生的下一 token 分布对齐教师。相比在教师生成文本上做 SFT,它消除了训练与部署之间的分布偏移(曝光偏差),因为学生在自己容易犯错的位置上也能获得教师的纠正信号。
OPMD 是 OPD 的直接扩展,全文反复对比的对象就是输出级 OPD 基线;理解 OPD“只监督输出空间”的局限是理解本文动机的前提。
反向 KL 散度
方向性的分布差异度量 $\mathcal{D}_{KL}(p\|q)=\sum_x p(x)\log\frac{p(x)}{q(x)}$。蒸馏中的“反向”指以学生分布为第一参数的 $\mathcal{D}_{KL}(p_S\|p_T)$,倾向模式寻找而非模式覆盖,学生集中模仿教师最主要的生成模式。本文中的 KL 在全部词表上求和,而不是只对采样到的 token 计算一项。
OPMD 第一阶段训练投影器、以及 OPD 基线的目标函数都是全词表反向 KL(公式 1 和公式 4),不理解它就看不懂方法。
激活补丁(Activation Patching)
可解释性分析技术:把模型内部某一层的隐状态替换成来自另一个模型(跨模型版本)或另一输入的对应激活,其余计算保持不变,观察输出行为变化,从而建立“内部状态 → 下游行为”的因果关系。它能直接检验某个隐状态是否携带可被后续层使用的任务信息。
本文用跨模型激活补丁做动机实验(Figure 1),并把“教师信息对学生可用”操作性定义为“补丁进学生后能改善下游准确率”。
LoRA 低秩适配
参数高效微调方法:冻结预训练权重 $W_0$,为每个权重学习低秩增量 $\Delta W = BA$,其中 $B\in\mathbb{R}^{d\times r}$、$A\in\mathbb{R}^{r\times k}$、秩 $r\ll d$,只训练极少量新增参数即可适配模型。本文所有学生更新均使用 rank = alpha = 64、无 dropout 的 LoRA。
第二阶段内化和所有对比方法的学生训练都基于 LoRA,这是复现实验的关键配置之一。
表示蒸馏 / 隐藏层匹配
让学生中间层表示与教师对应层对齐的蒸馏方法族(FitNets、TinyBERT、MiniLM、OPRD 等),通常用 MSE 或关系型损失;当师生架构或维度不同时,需要学习投影映射或人工指定层对应关系。本文对比基线 OPRD-Bridge 就是在学生采样轨迹上用冻结低秩映射做表示对齐。
OPMD 的核心论点“几何对齐 ≠ 计算可用”正是针对这一方法族的根本局限提出的,理解它才能体会本文的差异化贡献。
研究动机
在策略蒸馏(OPD)让学生在自身采样的前缀上用全词表反向 KL 对齐教师输出分布,解决了 SFT 的曝光偏差问题,但监督信号始终停留在输出空间。作者指出:下一 token 分布一致并不代表内部计算一致——输出相似的两个模型可能在表示空间中以不同方式组织证据、在不同深度依赖不同计算通路(引 Belrose et al. 2025、Nikankin et al. 2025 的机制差异证据)。输出级监督对产生这些预测的隐状态只有间接约束,在复杂推理任务上会漏掉大量有价值的中间计算信息。作者的初步实验给出了直接证据:在 AMC 2023 上做跨模型激活补丁,把 RL 优化后的 JustRL-1.7B 的隐状态注入 Qwen3-1.7B-Base,第 14 层补丁即把准确率从基座的 14.53% 提升到 28.91%,更深的层(21/27 层)更达到 83% 以上(最高 85.63%,教师本身 87.50%),说明 RL 后的隐状态确实含有可被基座模型后续计算直接使用的任务信息。但直接跨模型迁移并不可行:用 MSE 训练的投影器把 Qwen3-4B 的隐状态映射进 Qwen3-1.7B-Base 后,在所有补丁深度(7/14/21/27 层)准确率全部归零,学生生成被彻底破坏。
本文的目标是本文的目标是把蒸馏从“迁移教师预测什么”升级为“迁移教师如何计算”:把教师中间隐状态承载的推理机制转移给学生,同时满足两个约束。其一是可用性:迁移的信息必须以学生后续层能够有效利用的形式表达——因为师生隐藏维度和表示几何可能差异巨大,最小化重建误差(MSE)并不能保证映射后的状态对学生的下游计算有意义,Figure 1(b) 中 MSE 投影器补丁导致 0% 准确率就是反例,而按任务行为训练的投影器在各深度可取得 31.88%–50.63%。其二是可内化性:学生最终必须脱离教师和外部桥接模块独立运行,收益要落在学生自己的参数里,而不是依赖推理时挂载教师。作者选择在学生的计算接口内直接构造“教师信息的最优表达”,再让原生学生在自身策略采样的轨迹上把这些隐状态轨迹内化。
与已有工作不同的是,本文的独特切入是不做几何对齐,而是按“对下游计算的功能效用”来优化教师信息的注入方式。它把两条已有线路组合并反转用途:激活补丁原本是事后分析工具,这里被改造成可学习的残差注入 $\tilde{h}^{i}_{S} = h^{i,-}_{S} + P_{\phi}(h^{j}_{T})$,主动构造因果上有效的中间状态;ControlNet 式的条件注入原本用于给冻结扩散骨干加控制通路,这里用于向冻结的学生语言模型骨干注入教师信息。与 OPRD、PHF 等表示级 on-policy 蒸馏把传递定义为“表示对应或轨迹匹配”不同,OPMD 先构造出经过任务优化、学生计算上可用的中间目标,再让学生内化这些目标;与特权信息内化(context distillation)也不同,这里内化的是隐状态机制而非上下文内容。关键的观念转变是:衡量标准从“映射后的状态离学生表示多近”变成“注入后的学生行为离教师行为多近”。
核心方法
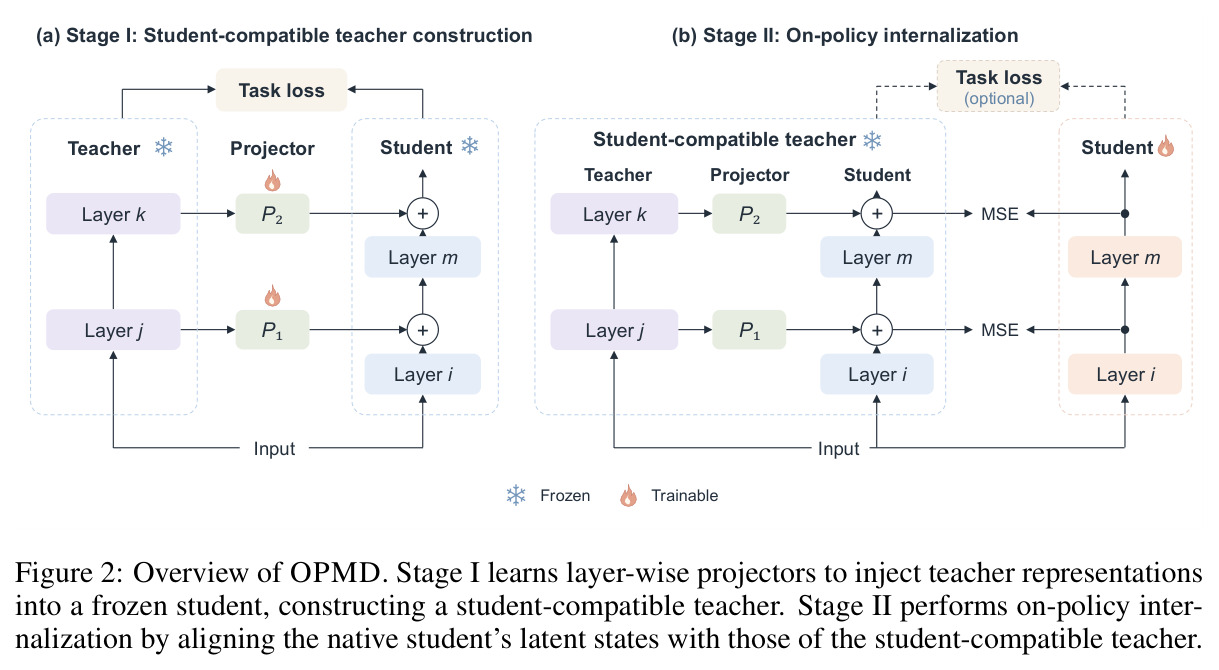
直觉上,与其逼学生直接模仿教师隐状态的几何位置,不如先造一个“翻译器”,把教师隐状态翻译成学生网络真正用得上的残差更新,再把翻译结果当作蒸馏目标让学生背下来。技术路线分两阶段。Stage I 学生兼容教师构造:教师 $p_{\theta_T}$ 与初始学生 $p_{\theta^0_S}$ 的骨干全部冻结,对选定的一组师生迁移层对 $\mathcal{I}=\{(j_r,i_r)\}_{r=1}^{R}$,为每对学习投影器 $P_{\phi_r}: \mathbb{R}^{d_T}\to\mathbb{R}^{d_S}$,把教师第 $j$ 层隐状态映射为学生在第 $i$ 层干预前的残差更新:$\tilde{h}^{i}_{S}(c) = h^{i,-}_{S}(c) + P_{\phi_r}(h^{j}_{T}(c))$。冻结教师 + 学习投影器 + 冻结学生骨干的组合即“学生兼容教师”,其预测分布记为 $\tilde{p}_{\phi}$。Stage II 在策略内化:原生学生(LoRA 初始化自 $p_{\theta^0_S}$)自己采样回复 $\hat{y}$,在相同的学生生成前缀上,用带 stop-gradient 的 MSE 让原生学生的隐状态逐 token 对齐学生兼容教师的隐状态(公式 5)。推理时教师与投影器整体丢弃,只保留原生学生。
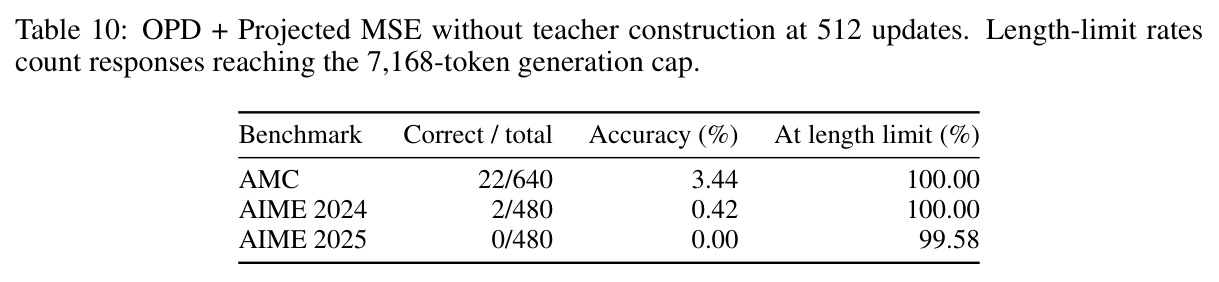
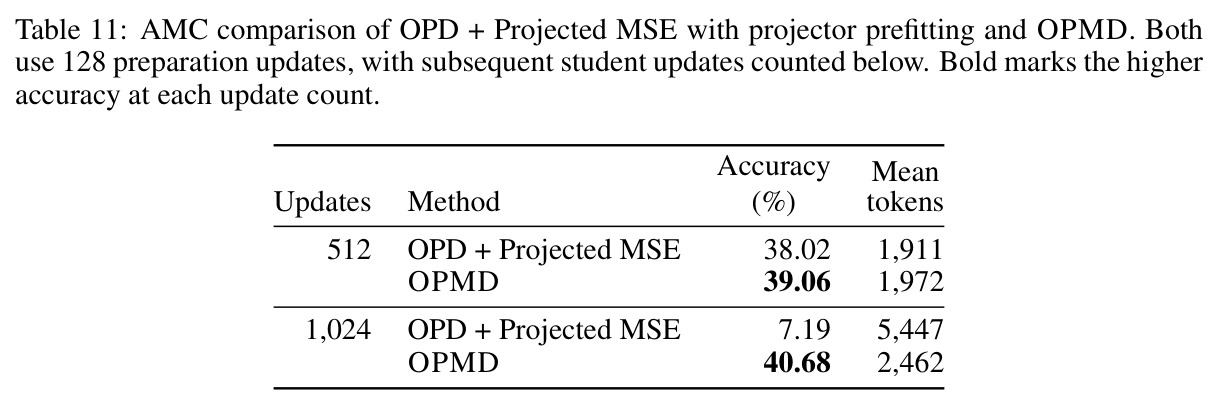
核心创新是把训练准则从“表示匹配”换成“功能效用优化”。已有表示蒸馏最小化 $\mathcal{L}_{MSE}(P)=\mathbb{E}_c\|P(h^{j}_{T}(c))-h^{i}_{S}(c)\|^2_2$ 这类几何距离,但几何上接近不等于学生的后续层能计算性地使用它:Figure 1(b) 中 MSE 投影器在所有深度把准确率打到 0%,而完全不使用几何损失的投影器反而有效。OPMD 的投影器训练信号只来自冻结学生骨干诱导的输出行为——共享分词器时最小化与教师输出的全词表反向 KL $\mathcal{L}_{build}(\phi)=\mathbb{E}_{c\sim C}[\mathcal{D}_{KL}(\tilde{p}_{\phi}(\cdot|c)\|p_{\theta_T}(\cdot|c))]$,即只有真正改善下游行为的注入方式才被保留。第二个关键点是内化目标天然位于学生自己的表示空间:目标由“冻结学生骨干+投影器”产生,因此第二阶段不需要任何跨模型映射,从机制上绕开了跨模型 MSE 不稳定的难题(附录 D 证明直接加投影 MSE 会在长训中崩溃)。这与 OPRD“在学生轨迹上对齐原始教师表示”有本质区别。
方法步骤详情
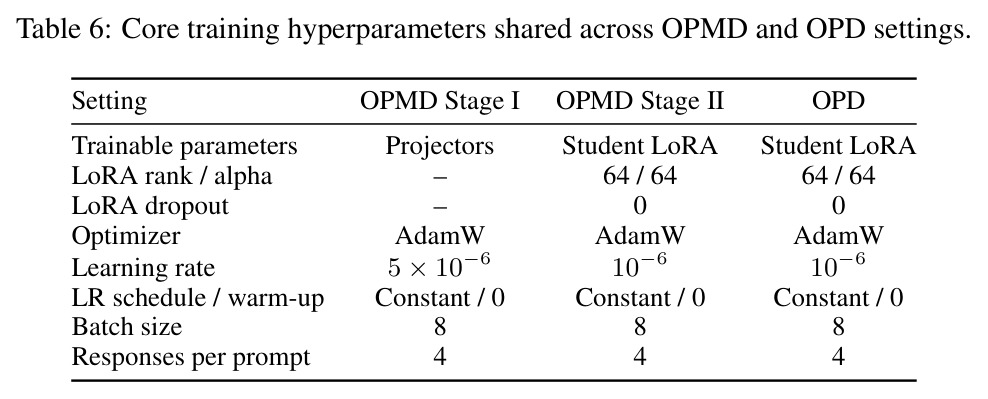
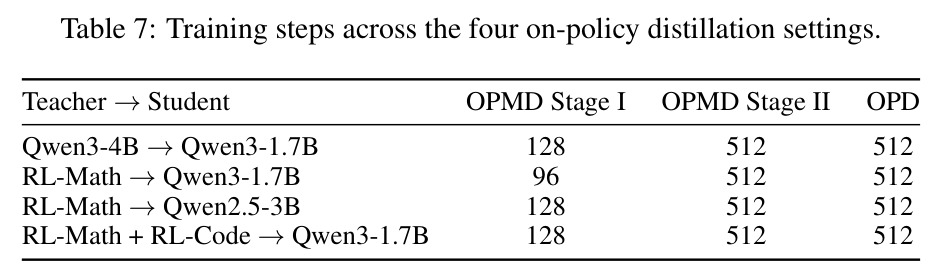
完整流程分四步。(1) 选定迁移层对 $\mathcal{I}=\{(j_r,i_r)\}$(师生分词器不同时,同一文本前缀各自分词,隐状态在语义位置上对应)。(2) Stage I:只训练投影器 $\phi$(两骨干冻结,学习率 $5\times10^{-6}$,训练 96–128 步),共享分词器时最小化公式 (4) 的反向 KL;分词器不同时改用教师生成回复上的 SFT 目标(公式 6),将教师回复按学生分词器切分后只更新投影器。(3) Stage II:初始化原生学生(LoRA rank/alpha = 64,AdamW 学习率 $10^{-6}$),每次 rollout 从 64 个 prompt 各采 4 条回复(温度 1.0、top-p 1.0,prompt/响应/总序列上限 1024/7168/8192 token),对每个前缀 $c^{+}_{t}=(x,\hat{y}_{\leq t})$ 在全部响应 token 位置、全部监督层上最小化 $\mathcal{L}_{int}(\theta_S)=\mathbb{E}\,\frac{1}{|\mathcal{H}||\hat{y}|}\sum_{i\in\mathcal{H}}\sum_{t=1}^{|\hat{y}|}\frac{1}{d_S}\big\|h^{i}_{S}(c^{+}_{t};\theta_S)-\mathrm{sg}[\tilde{h}^{i}_{S}(c^{+}_{t})]\big\|^2_2$,on-policy 实验只用心智状态损失、不加任务损失,主实验训练 512 步。多教师版本按 prompt 领域把样本路由到对应教师及其投影器组(Stage II 的 MSE 监督 28 层全部块输出,取 RMSNorm 之前)。(4) 部署:丢弃教师与投影器,只保留原生学生。
技术新颖性
技术新颖性体现在三点。第一,把激活补丁从“分析工具”升级为“构造工具”:以往跨模型激活补丁只用于事后检验隐状态是否重要,OPMD 用可学习残差注入主动构造教师信息在学生接口内的最优表达,且训练信号完全来自下游输出行为而非几何距离,这直接回应了“最小化隐藏状态重建误差不等于可用性”这一被 Figure 1 证实的关键观察。第二,“构造—内化”两段式设计解耦了可用性与可实现性两个需求:Stage I 用冻结学生做载体确保目标可被计算使用,Stage II 再让原生学生内化这些已经任务优化的目标;由于内化目标在学生自身表示空间中,避开了 TinyBERT 式联合投影 MSE 的训练崩溃(附录 D:OPD+投影 MSE 从 512 步的 38.02% 崩到 1024 步的 7.19%,而 OPMD 升至 40.68%)。第三,扩展性设计:多教师通过按领域路由投影器组实现,跨家族 SFT 通过“教师回复前缀上的隐状态 MSE + NLL、无 logit KL”验证了机制监督可脱离 KL 框架存在。
实验结果
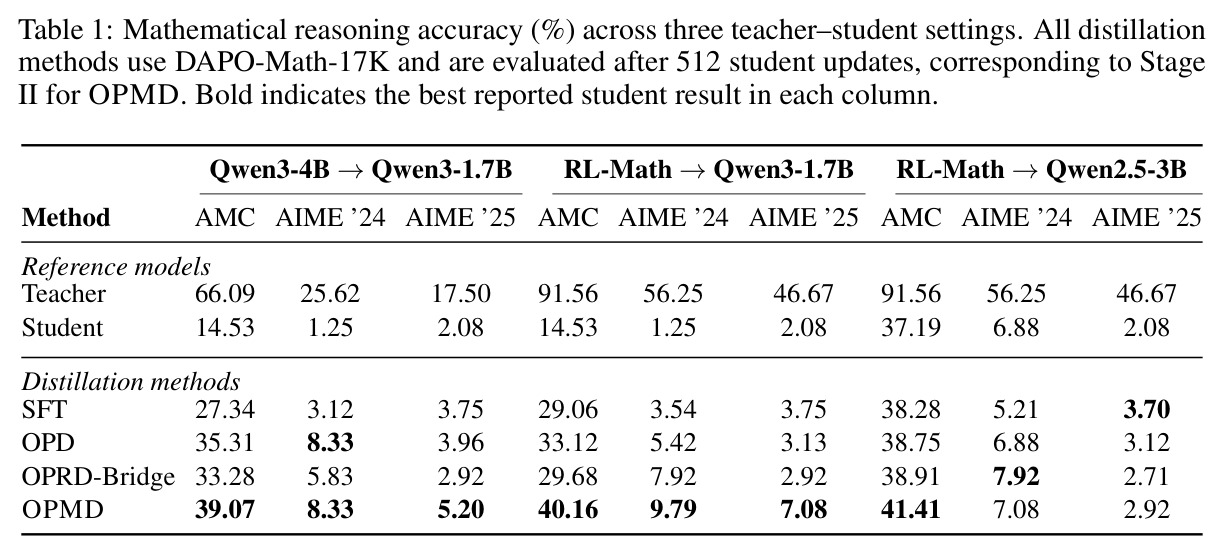
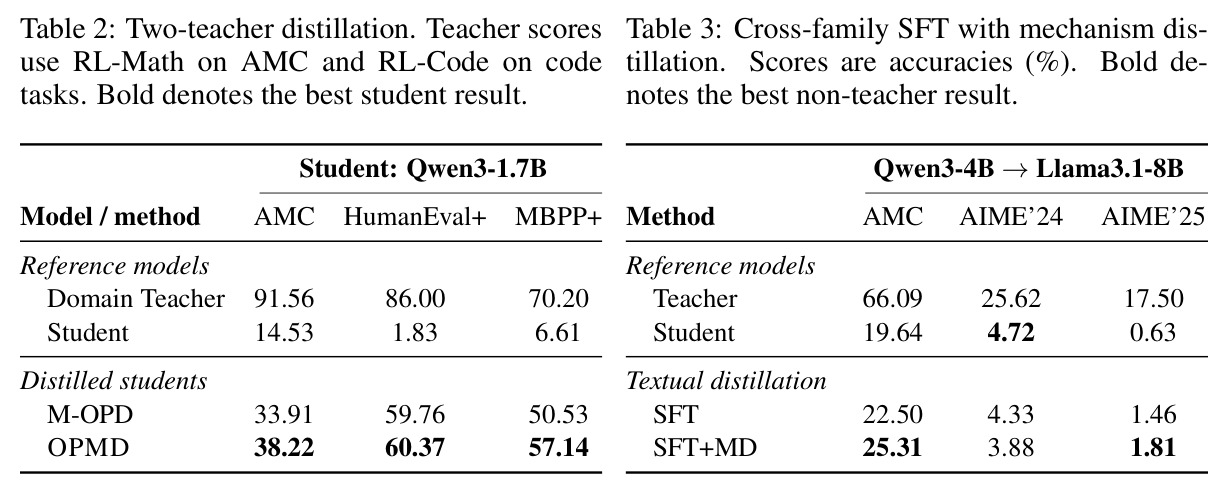
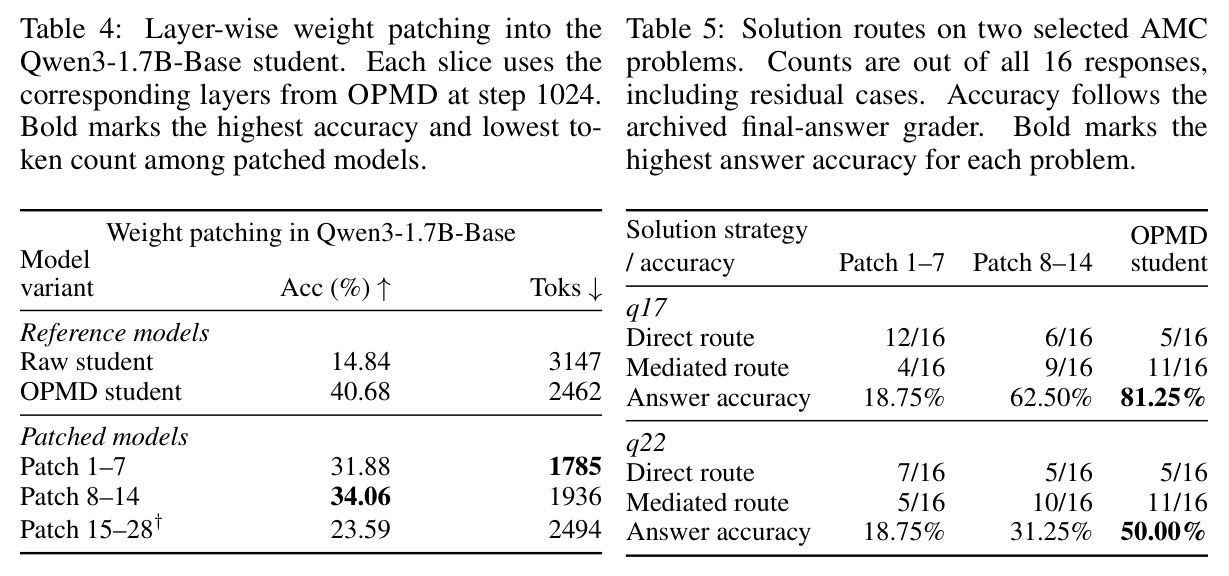
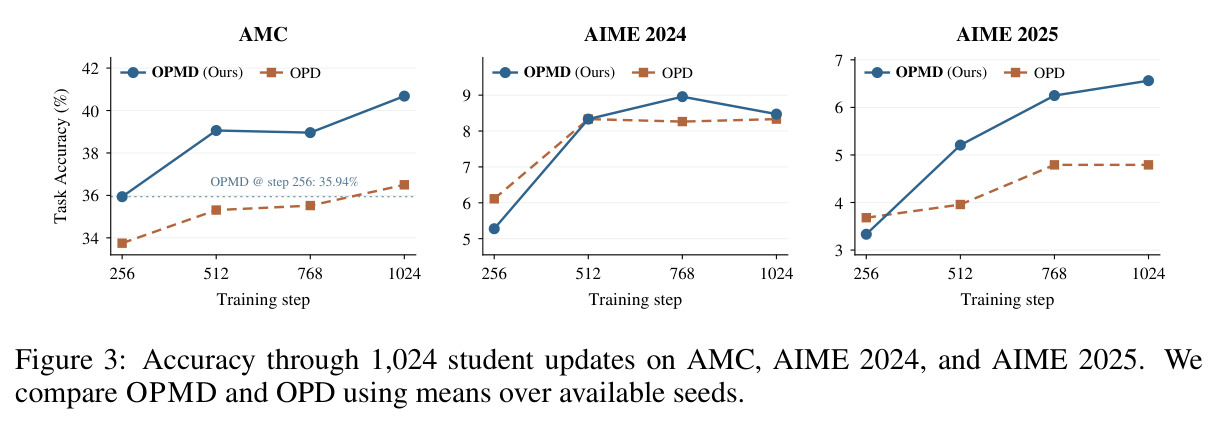
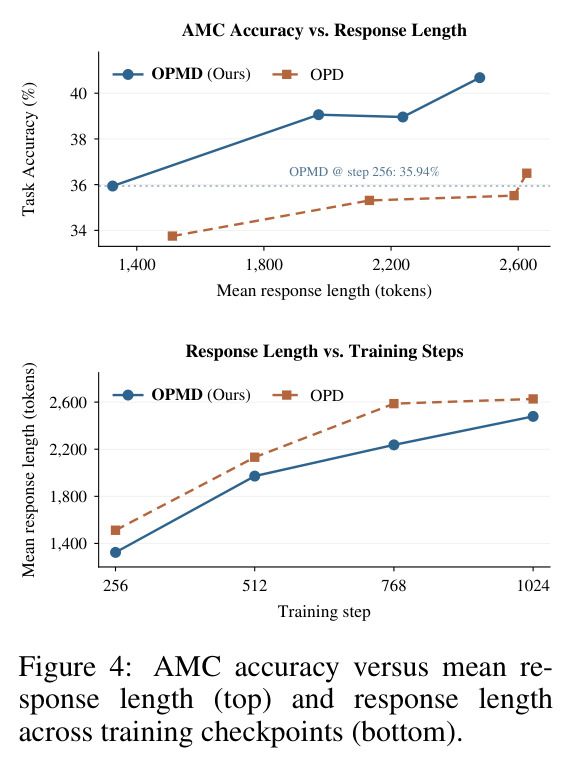
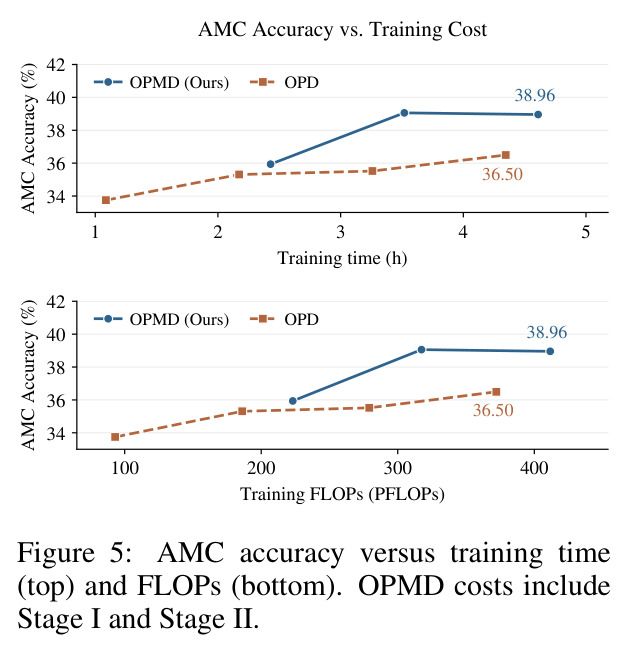
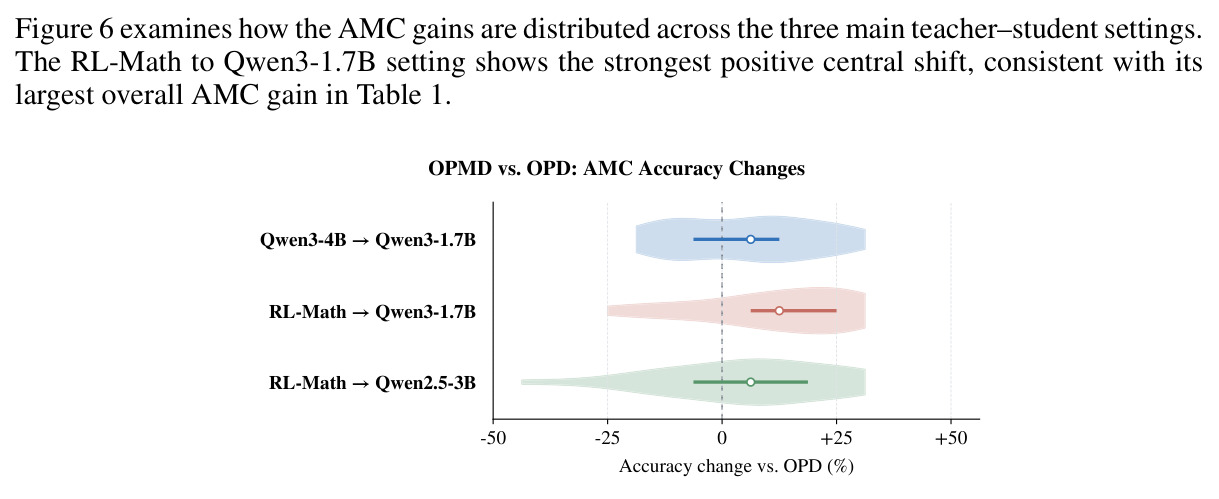
核心结果有七组。(1) 主实验(DAPO-Math-17K 训练、512 步、avg@16):三组设置下 OPMD 的 AMC 相对 OPD 分别提升 +3.76、+7.04、+2.66 个百分点。RL-Math→Qwen3-1.7B 下 OPMD 达 40.16/9.79/7.08(AMC/AIME24/AIME25),全面超过 OPD 的 33.12/5.42/3.13 和 OPRD-Bridge 的 29.68/7.92/2.92;Qwen3-4B→Qwen3-1.7B 下 OPMD 39.07/8.33/5.20 vs OPD 35.31/8.33/3.96。值得注意的是更强的教师不自动带来更强的学生:换成 RL-Math 后 OPD 的 AMC 从 35.31% 降到 33.12%,OPMD 反而升到 40.16%。(2) 延长训练(Figure 3):1024 步时 OPMD 在 AMC 与 AIME25 达到最高点,AIME24 在 768 步达峰,说明主表未穷尽内化收益。(3) 长度控制(Figure 4):OPD 靠生成更长回复换取小幅提升,OPMD 在每个 checkpoint 都以更短回复取得更高准确率——256 步的 OPMD(35.94%)已超过 OPD 512/768 步的水平,且两者评测上限同为 7168 token。(4) 多教师(Table 2):RL-Math+RL-Code→Qwen3-1.7B,相对 M-OPD 在 AMC/HumanEval+/MBPP+ 分别 +4.31/+0.61/+6.61,数学收益不以牺牲代码为代价。(5) 跨家族 SFT(Table 3):Qwen3-4B→Llama3.1-8B,SFT+MD 无 logit KL 下 AMC 25.31% vs SFT 22.50%,AIME25 1.81% vs 1.46%,但 AIME24 反降(3.88% vs 4.33%)。(6) 层分析(Table 4/5):把 OPMD 学生第 1–7/8–14 层权重补丁回原始学生,准确率从 14.84% 恢复到 31.88%/34.06% 且回复更短;中段层(8–14)在案例题上恢复与完整学生一致的“中介路线”偏好(q22 上 10/16 vs 完整学生 11/16)但准确率仍低(31.25% vs 50.00%),说明“学会策略”与“能执行成功”可分离。(7) 成本(Figure 5):2×H100 上计入 Stage I 的 OPMD 在 768 步达 38.96%,优于 OPD 1024 步的 36.50%;Stage II 用 vLLM 后每步吞吐与 OPD 几乎相同。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理 AMC(Qwen3-4B → Qwen3-1.7B) | avg@16 准确率 (%) | 39.07 | OPD 35.31 / SFT 27.34 / OPRD-Bridge 33.28 | +3.76 个百分点(vs OPD) |
| 数学推理 AMC(RL-Math → Qwen3-1.7B) | avg@16 准确率 (%) | 40.16 | OPD 33.12 / OPRD-Bridge 29.68 | +7.04 个百分点(vs OPD) |
| 数学推理 AIME 2024(RL-Math → Qwen3-1.7B) | avg@16 准确率 (%) | 9.79 | OPD 5.42 | +4.37 个百分点(vs OPD) |
| 数学推理 AIME 2025(RL-Math → Qwen3-1.7B) | avg@16 准确率 (%) | 7.08 | OPD 3.13 | +3.95 个百分点(vs OPD) |
| 数学推理 AMC(RL-Math → Qwen2.5-3B) | avg@16 准确率 (%) | 41.41 | OPD 38.75 / OPRD-Bridge 38.91 | +2.66 个百分点(vs OPD) |
| 多教师蒸馏 AMC(RL-Math + RL-Code → Qwen3-1.7B) | pass@1 准确率 (%) | 38.22 | M-OPD 33.91 | +4.31 个百分点 |
| 多教师蒸馏 MBPP+(同上) | pass@1 (%) | 57.14 | M-OPD 50.53 | +6.61 个百分点 |
| 多教师蒸馏 HumanEval+(同上) | pass@1 (%) | 60.37 | M-OPD 59.76 | +0.61 个百分点 |
| 跨家族 SFT AMC(Qwen3-4B → Llama3.1-8B) | 准确率 (%) | SFT+MD 25.31 | SFT 22.50 | +2.81 个百分点(无 logit KL) |
局限与改进
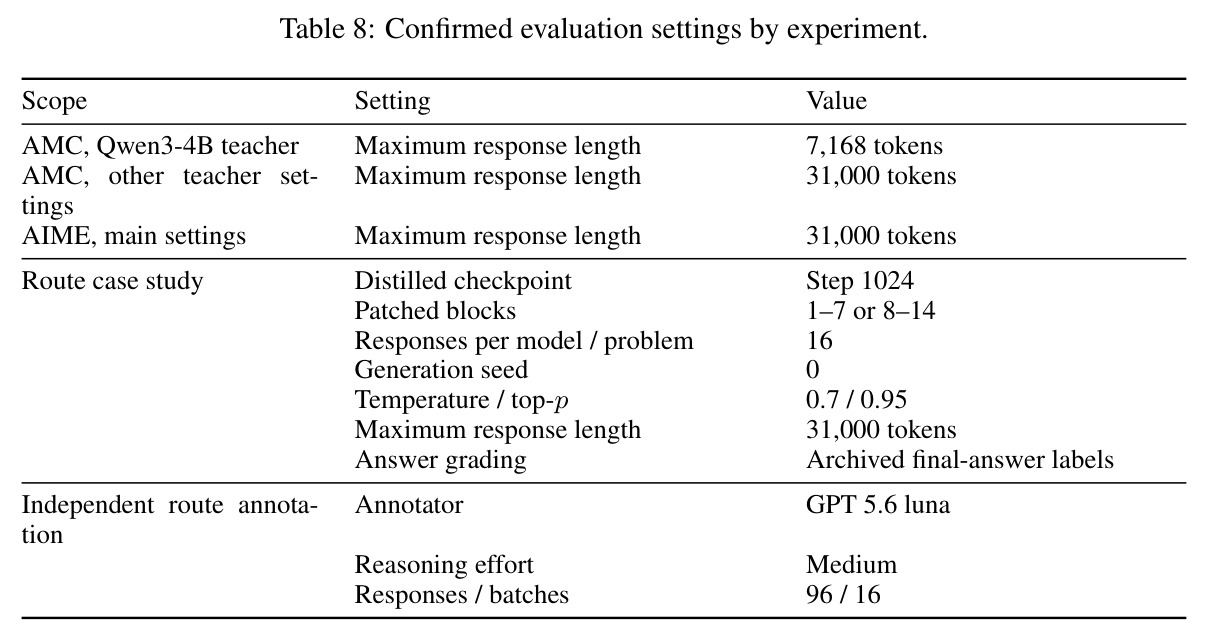
作者承认的局限:评测只覆盖少量师生配对与任务(数学和代码),能否推广到更大模型、更多架构与任务尚待验证;4.3 节的两个案例题(q17、q22)是特意挑出 OPMD 学生优于 Patch 1–7 的样本,不能证明一般性的层功能特化或因果机制;案例中的解法路线标注由 GPT 5.6 luna 完成(q22 上 42/48 一致、Cohen's κ=0.777),只是模型间一致性而非人类金标准。我自己的观察还有:AIME 两个榜各只有 30 题、avg@16,绝对准确率都在 10% 以下,小样本带来的统计噪声不可忽视,且跨家族 SFT 中 AIME24 出现回退(3.88% vs 4.33%);迁移层对 $\mathcal{I}$ 完全人工指定,论文没有给出层选择的敏感性或自动化方案;轨迹曲线是“可用种子均值”,种子数与方差报告不充分;RL-Math→Qwen2.5-3B 的 AIME 收益微弱(2.92% vs 3.12%,反而略低于 OPD),说明机制蒸馏收益与师生组合强相关;内化用逐位置 MSE,对跨分词器时的 token 对齐只做了“仅用可见前缀可复现的教师 token”这种较弱假设。
独立分析的弱点
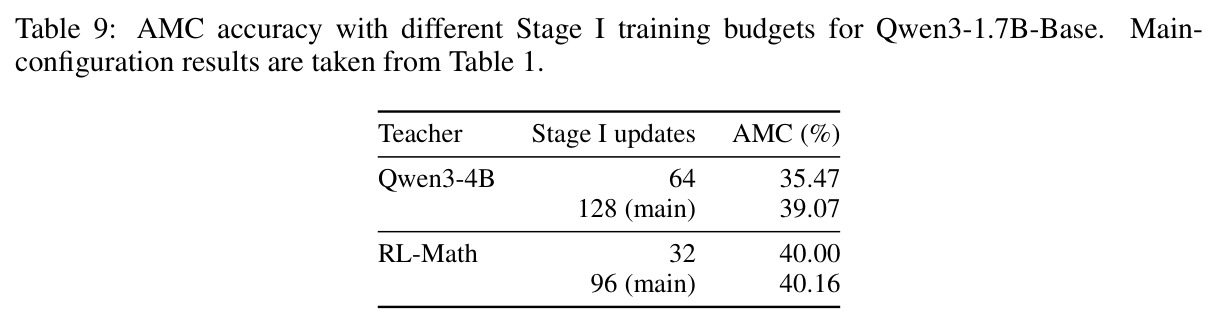
独立分析出五个弱点。其一,迁移层对 $\mathcal{I}$ 依赖手工指定:投影器组放在哪些层缺乏原则性方法,层选错可能浪费 Stage I 预算,改进方向是用激活补丁扫描或可微分层选择自动搜索师生层配对。其二,MSE 内化目标对位置与尺度敏感且只约束被选层/全部块的输出,缺少关系型约束,改进方向是加入 CKA、注意力图或相对几何正则,避免过度约束导致学生丧失多样性。其三,评测规模偏小:AIME 每榜 30 题、种子数有限(轨迹曲线用“可用种子均值”),结论的置信区间不明,改进方向是扩大评测集、报告多种子方差与显著性检验。其四,训练成本结构性偏高:Stage I 需要教师与学生同时前向并反向到投影器,Figure 5 显示计入 Stage I 后 OPMD 约需 4–5 GPU·小时达到最优,改进方向是缓存教师隐状态、用低秩/稀疏投影器、或按 Table 9 的结论自适应缩短 Stage I(RL-Math 只需 32 步,但 Qwen3-4B 缩到 64 步会损失 3.6 个点)。其五,泛化半径未知:全部实验集中在 1.7B–8B 的 Qwen/Llama 家族和数学/代码两类任务,且案例标注由 LLM 完成,改进方向是在更大师生规模差、开放域任务和人工标注下复验。每个弱点都对应明确可操作的后续实验,不损害主结论的可信度,但限制了直接外推。
未来方向
作者提出的方向包括:把评测扩展到更多师生配对、更大模型、更多架构以及数学与代码之外的任务;用更大规模、无选择偏差的实验建立(或否定)层功能特化的一般结论。基于本文成果可以自然延伸的方向有:(1) 用任务奖励(RL)而非输出 KL 来训练 Stage I 投影器,把“学生兼容教师构造”变成纯强化学习问题,可能缓解对教师输出分布的依赖;(2) 把学生兼容教师本身做成即插即用的推理增强模块——不内化时作为 teacher-forcing 式的运行时加速器,内化后作为轻量学生,探索两者的连续谱;(3) 多教师设置下的路由策略学习:目前按 prompt 领域硬路由,可学习软路由或教师权重;(4) 机制内化的动力学分析:哪些层何时收敛、隐状态 MSE 与任务损失联训时的干扰机制(论文只在 SFT+MD 中联训过);(5) 把跨模型激活补丁标准化为蒸馏质量诊断工具,用补丁曲线预测蒸馏收益;(6) 在长链推理、智能体与多模态任务上检验“机制迁移”是否仍然成立;(7) 与特权信息内化(context distillation、PHF)统一成“内化什么信息”的一般理论框架。
复现评估
复现条件较好。开源方面:作者承诺论文接收后发布代码;教师与学生模型(Qwen3-4B、Qwen3-4B-Non-Thinking-RL-Math/Code、Qwen3-1.7B-Base、Qwen2.5-3B-Instruct、Llama3.1-8B-Instruct)与训练数据(DAPO-Math-17K、G-OPD-Training-Data,每域 25276 prompt)全部公开。超参交代充分:附录 A 给出两阶段的完整配置(Stage I 投影器 lr $5\times10^{-6}$ 训练 96–128 步;Stage II LoRA rank/alpha=64、AdamW lr $10^{-6}$、batch 8、每 prompt 4 条采样、序列上限 8192,Tables 6/7),附录 B 给出评测协议(温度 0.7/top-p 0.95、avg@16、AIME 生成上限 31000 token)以及案例标注的完整 prompt 与分歧处理。算力方面:主实验仅需 2 块 NVIDIA H100,OPMD 全程数小时内可达最优精度,单机即可复现。难度评估:中等偏高——需要实现双模型同时前向、隐状态残差注入(取 RMSNorm 前的块输出)、逐位置 stop-gradient MSE 与跨分词器对齐等工程细节,熟悉 RLHF/蒸馏框架的团队预计 1–2 周可复现主表结果;最大的不确定性在于轨迹实验的种子信息不完整,逐点数值可能有出入。
论文图表
动机实验,两个子图。(a) 同构补丁:把 RL 优化的 JustRL-1.7B 的隐状态注入 Qwen3-1.7B-Base(基座准确率 14.53%,JustRL 本身 87.50%),第 14 层补丁即达 28.91%,更深层(21/27 层)达 83% 以上、最高 85.63%,且随补丁深度加深收益增大。(b) 异构补丁:把 Qwen3-4B 的隐状态映射进 Qwen3-1.7B-Base,MSE 训练的投影器在第 7/14/21/27 层全部导致 0% 准确率,而按任务行为训练的投影器在各深度取得 31.88%–50.63%(峰值 50.63%)。
这是整篇论文的立论基础:同时证明了“教师隐状态含可用的任务信息”和“最小化 MSE 重建误差不等于计算可用性”两个关键命题,直接引出学生兼容教师的设计。
多教师蒸馏结果:把 RL-Math(Step500)和 RL-Code(Step300)经领域路由蒸馏进 Qwen3-1.7B-Base。领域教师参考值 91.56(AMC)/86.00(HumanEval+)/70.20(MBPP+),基座学生 14.53/1.83/6.61;M-OPD 得 33.91/59.76/50.53,OPMD 得 38.22/60.37/57.14,即在数学与代码上同时占优。
验证框架可扩展到多领域教师:一个学生同时吸收两个专项教师的机制且互不牺牲,证明方法不是单一师生配对的特例。
层级权重补丁实验:把 1024 步 OPMD 检查点的不同层块拷入原始学生。原始学生 14.84%(平均 3147 token),完整 OPMD 学生 40.68%(2462 token);Patch 1–7 达 31.88%(1785 token),Patch 8–14 达 34.06%(1936 token),Patch 15–28 仅 23.59%(2494 token)。所有补丁模型都比原始学生更短。
给出“内化的推理机制位于哪一层”的直接证据:中前层承载了大部分增益,为机制级解释和后续层特化研究提供量化基础。