InstantFusion:面向异构图像生成器的共享潜空间接口 InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators
用轻量潜空间自编码器对齐异构生成器的状态与去噪速度,实现冻结模型间无缝轨迹交接
前置知识
Flow Matching(流匹配)
扩散/流模型把生成建模为从噪声到数据的连续传输。Flow Matching 学习速度场 $v_\theta(x_t, t, c)$ 去拟合路径速度 $\epsilon - x_0$,中间状态按 $x_t=(1-t)x_0+t\epsilon$ 构造($t=1$ 为纯噪声,$t=0$ 为干净数据),训练目标是最小化速度预测的均方误差 $\mathcal{L}_{\text{FM}}$,生成时从 $t=1$ 数值积分到 $t=0$。
本文的全部操作对象就是这条去噪轨迹上的中间状态 $x_t$ 与局部速度,LAE 的输入输出和 $\mathcal{L}_{\text{dyn}}$ 对齐的位移都定义在流匹配框架里,不懂它就无法理解跨模型交接在数学上意味着什么。
VAE 潜空间
现代文生图模型不直接在像素上扩散,而是先用变分自编码器把图像压缩为低分辨率潜码(如 16 通道、空间缩小 8 倍),再去噪器在潜空间工作。本文涉及的 SD3、FLUX.1、Z-Image、Qwen-Image 恰好都在 16 通道潜空间工作,潜张量空间尺寸接近:Qwen-Image 为 $[1,16,1,128,128]$,SD3/FLUX.1 为 $[1,16,128,128]$。
论文观察到的潜空间组织相似性正建立在各模型潜码维度一致之上;同时方法要求所有模型共享同一个冻结 VAE,这是理解方法适用边界与局限的前提。
跨架构在线策略蒸馏(On-policy Distillation)
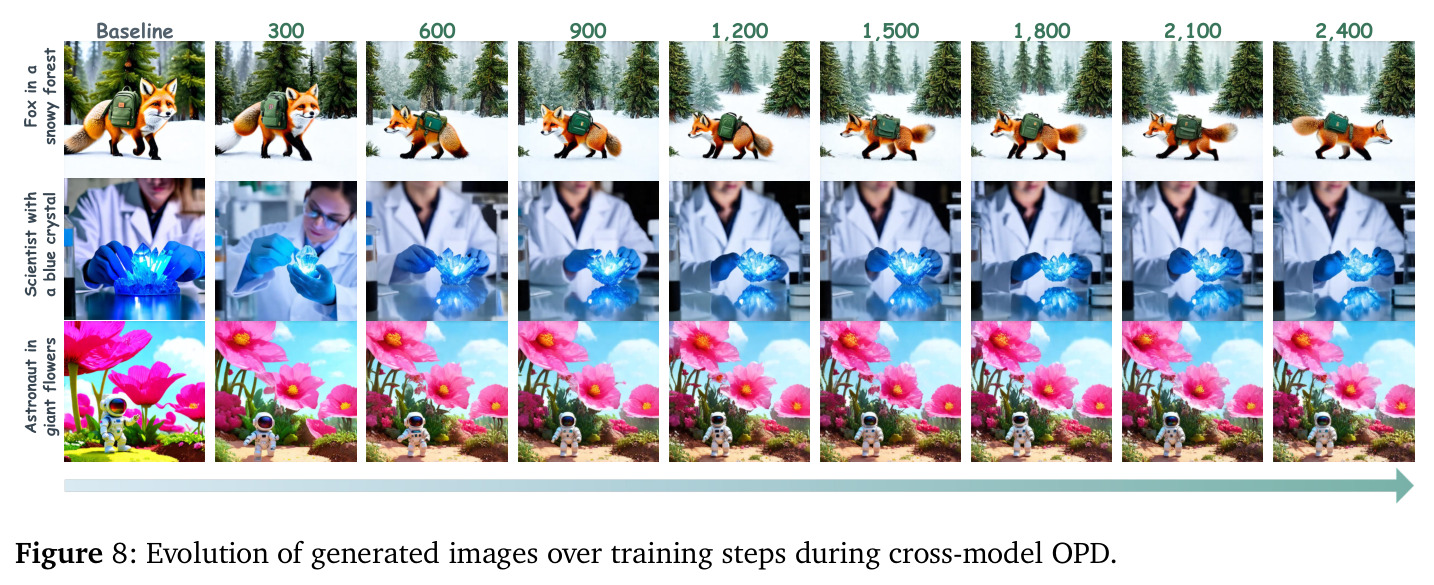
传统蒸馏用教师预生成的固定样本监督学生(off-policy),在线策略蒸馏则在学生自己的采样轨迹上施加教师监督,避免训练与推理分布偏移。本文中教师 Qwen-Image 借助共享潜空间,直接在学生 SD3 的轨迹中间态上计算速度目标,实现架构完全不同的师生迁移。
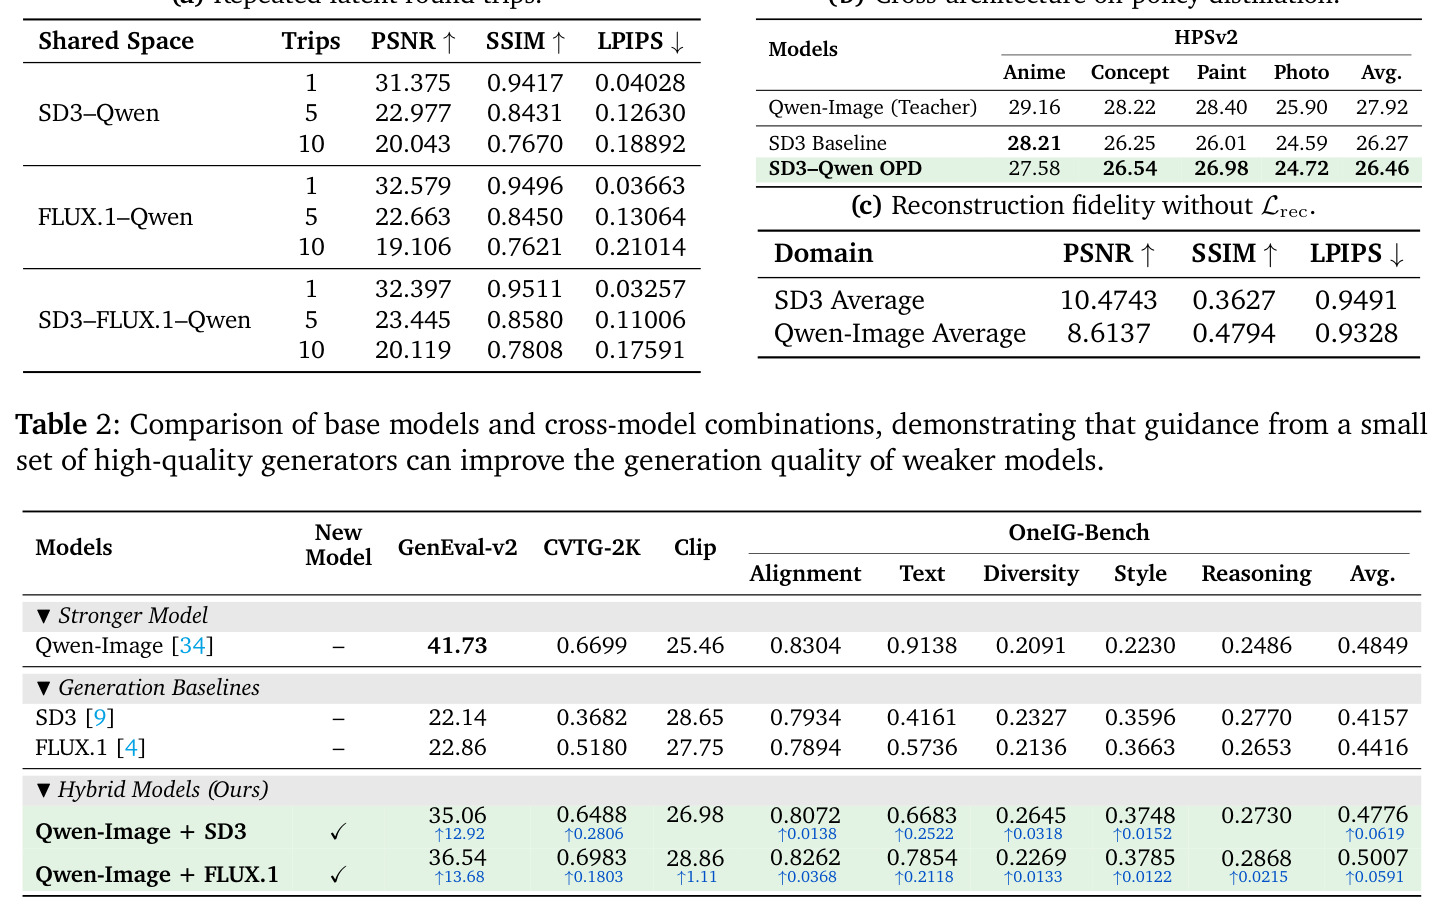
这是 InstantFusion 的三大下游应用之一,Table 1b 中 SD3 的 HPSv2 从 26.27 提升到 26.46 的实验设计与 $\mathcal{L}_{\text{OPD}}$ 都依赖这一概念。
奖励模型与 GRPO
奖励模型为生成图像打分,如 HPSv2/HPSv3 衡量美学与图文匹配(分 Anime/Concept/Paint/Photo 四域),GenEval-v2 衡量属性与指令遵循;GRPO 是用组内相对优势做强化学习微调、使生成器对齐特定奖励的算法。单一奖励专家往往过拟合自身偏好,而多奖励联合训练成本高且相互牵制。
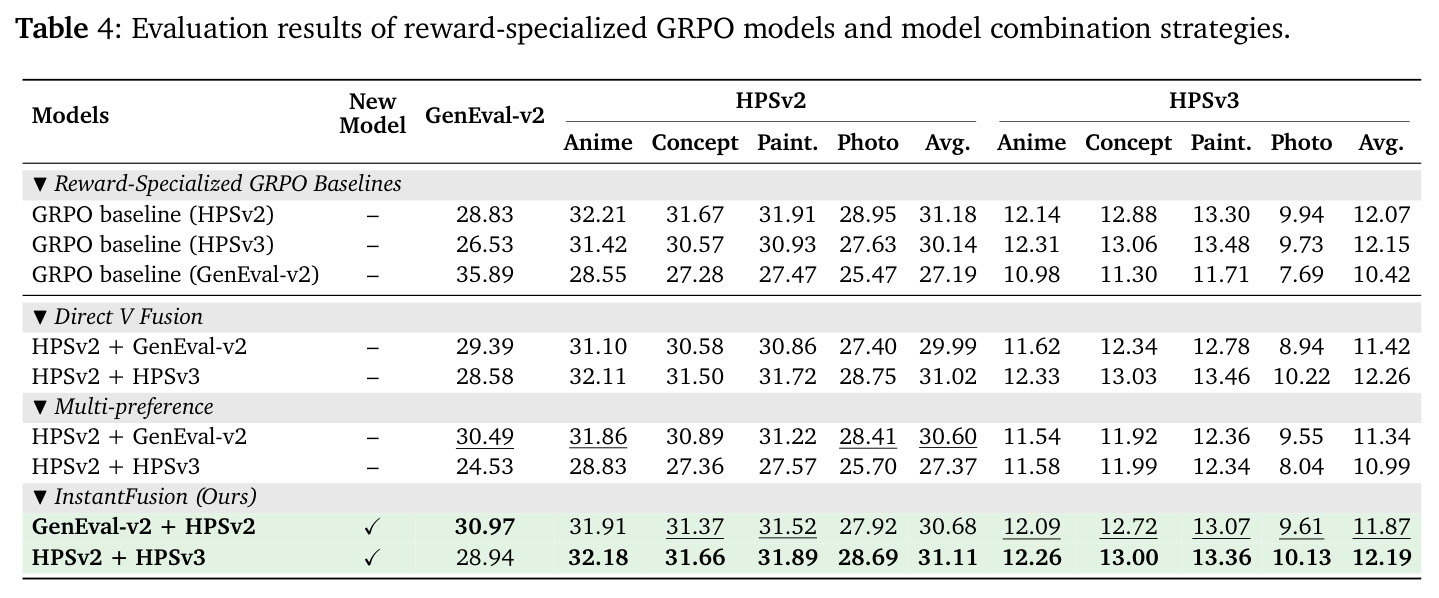
论文的多偏好组合实验(Table 4)用 InstantFusion 在采样中途切换不同 GRPO 奖励专家,无需联合训练即可平衡多种偏好,是读懂该表对比逻辑的前提。
PSNR / SSIM / LPIPS 图像质量指标
PSNR 基于像素均方误差衡量重建保真度(单位 dB,越高越好);SSIM 从结构、亮度、对比度三方面比较相似性(0 到 1);LPIPS 用深度网络特征度量感知差异(越低越好)。三者结合可从像素、结构、感知三个层面评估图像失真程度。
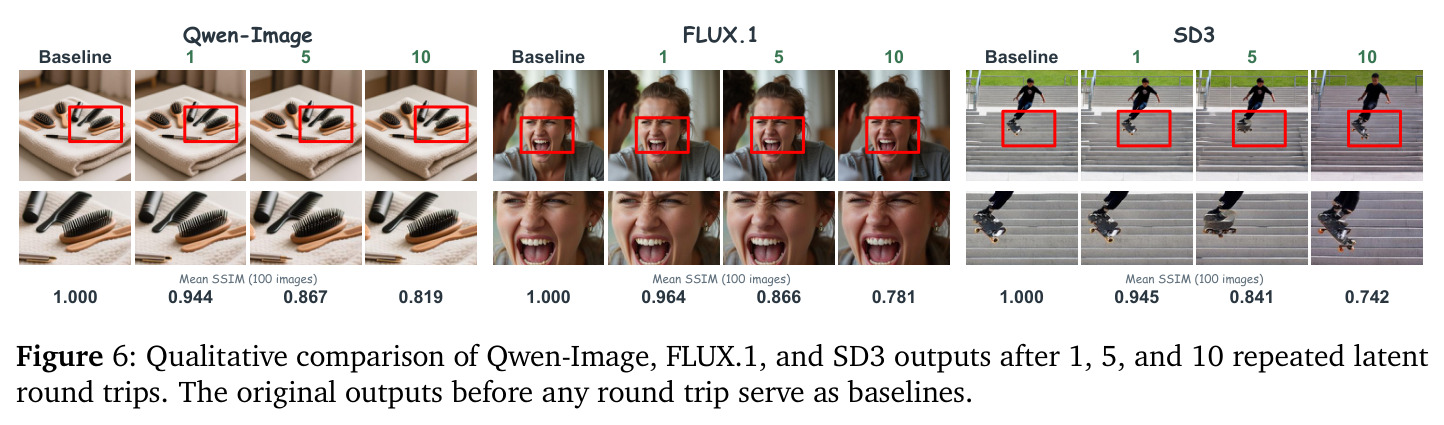
论文用潜码往返 1/5/10 次后的这三个指标量化共享空间的信息保真度(Table 1a、Figure 6),不熟悉这些指标就读不懂接口质量评估与衰减趋势。
研究动机
现代文生图模型虽同属扩散/流框架,却已高度异构:潜空间参数化、条件机制、网络结构与参数规模、训练与蒸馏配方各不相同——Qwen-Image(约 20B 参数)与 SD3(约 2B)、FLUX.1(约 12B)的潜张量形状是 $[1,16,1,128,128]$ 对 $[1,16,128,128]$,去噪器架构更是完全不同。这些模型几乎总被当作孤立系统研究和部署,留下两个根本问题:不同模型学到的潜表示能否有意义地对齐?底层去噪动力学是否彼此兼容?已有工作只能部分回答:跨模型潜对齐方法(线性映射、相对表示、闭式变换、VAE 桥接)建立的是逐对专用的静态映射,既没有能容纳多个生成器的共享空间,也不处理动力学;轨迹拼接方法(如 T-Stitch)虽允许多个去噪器接力采样,但假设所有模型共享同一潜空间,实测其在异构模型上 GenEval-v2 仅 7.762,出现严重质量崩塌。作者进一步实验表明,跨家族模型不经对齐直接交接中间态会引入明显局部伪影,说明原生潜空间不能直接互换。
本文的目标是本文要构建一个轻量、可复用的共享潜空间接口,把任意多个异构图像生成器的去噪轨迹连接起来:所有生成器保持冻结,每个模型只需训练自己的小型接口模块(LAE)即可接入,任意模型对之间无需专用的成对映射;接口必须同时保证两种基础能力——忠实重建(状态翻译不丢信息)与跨模型状态迁移(翻译后的状态能落在接收方的去噪轨迹上顺利续采样);交接时机应自动决定而非逐对手工调参;在此之上,接口要能统一支撑生成加速、跨架构在线策略蒸馏、多偏好组合与跨模型组合等下游应用,成为异构生成器之间通用的能力迁移与组合通道。
与已有工作不同的是,切入角度是先给兼容性证据、再建模接口。作者首先给出两个观察:(1) 尽管潜维度与 token 化方式不同,独立训练的模型中间态呈现相近的空间自相似模式(Figure 2a),暗示信息密度的空间组织一致;(2) 零训练、不对齐地把 SD3 去噪到一半的中间态交给 SD3.5 或 FLUX.1 续采样,虽出现局部伪影,但主体(一个杯子)和粗布局被保留(Figure 2b),说明潜空间之间可能只隔着一层薄薄的坐标变换。与已有工作的本质区别有二:其一,不止对齐静态状态,还首次显式对齐共享空间中的局部去噪速度——作者用 UMAP 与余弦相似度证明仅对齐状态时速度仍彼此分离,这正是先前方法在轨迹迁移上失败的隐患;其二,采用每模型一个 LAE 的星型结构,$M$ 个模型只需 $M$ 个轻量模块而非 $M(M-1)/2$ 个成对映射,新模型即插即用。
核心方法
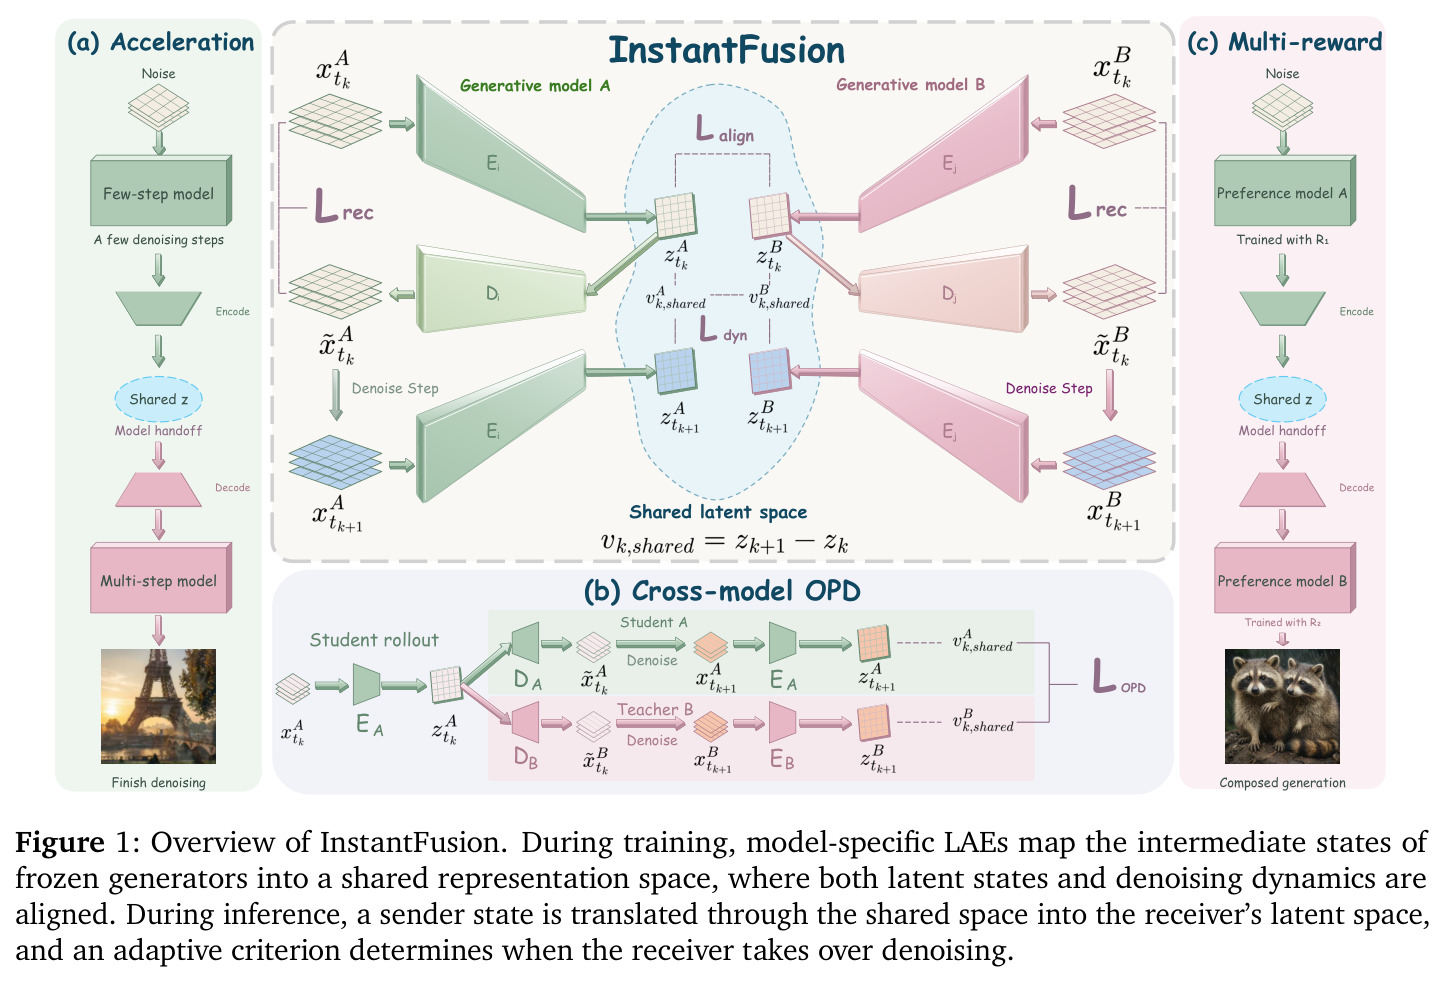
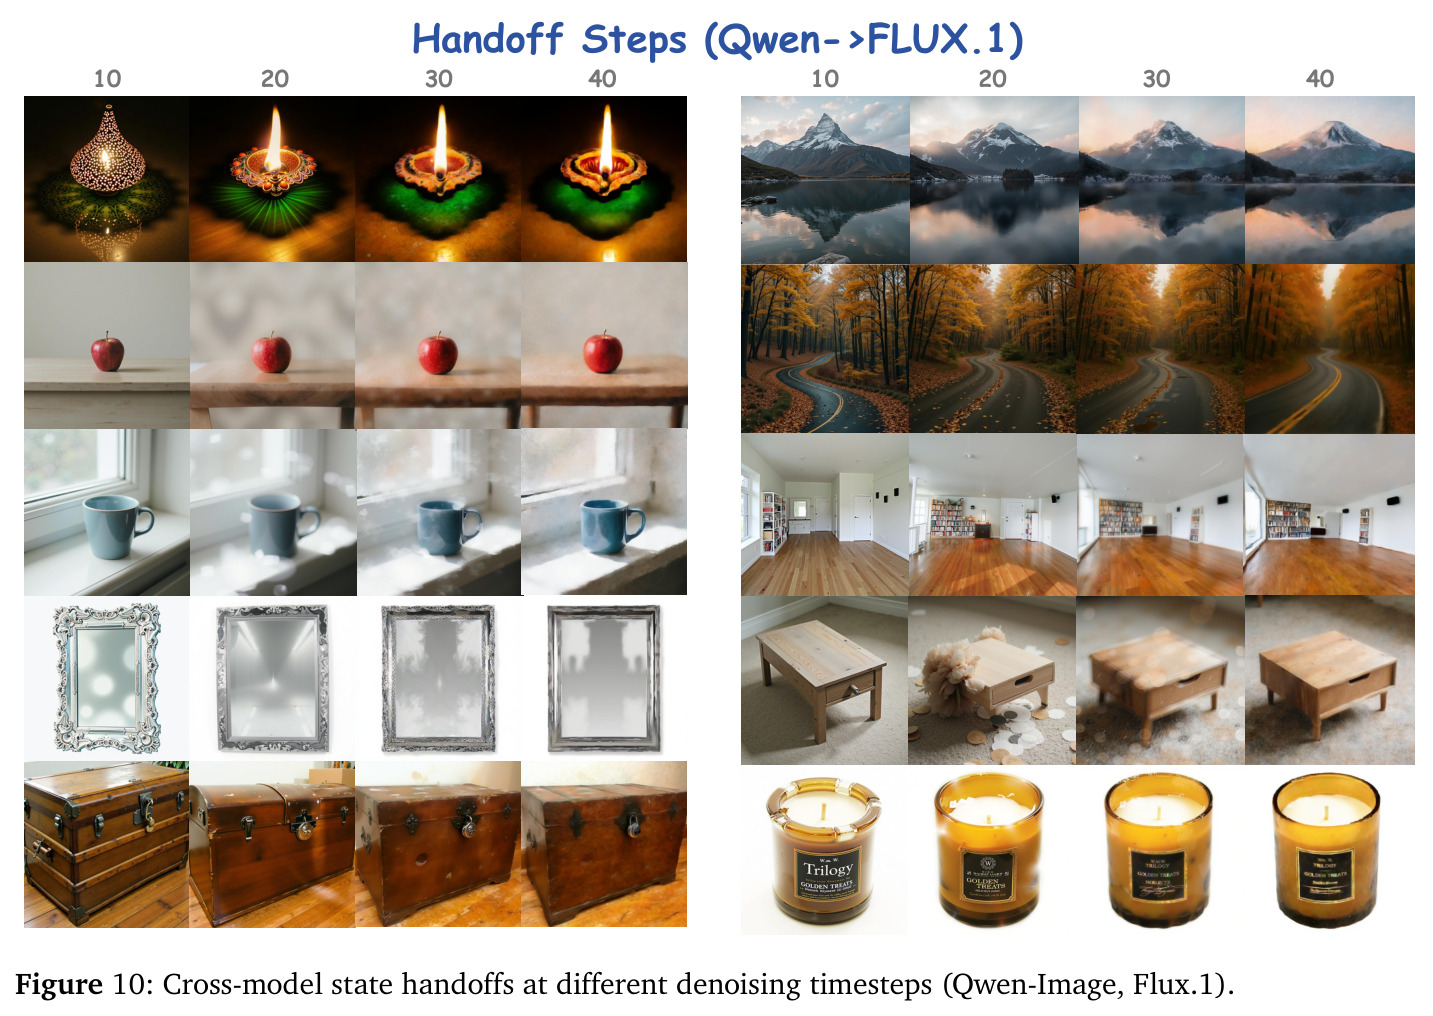
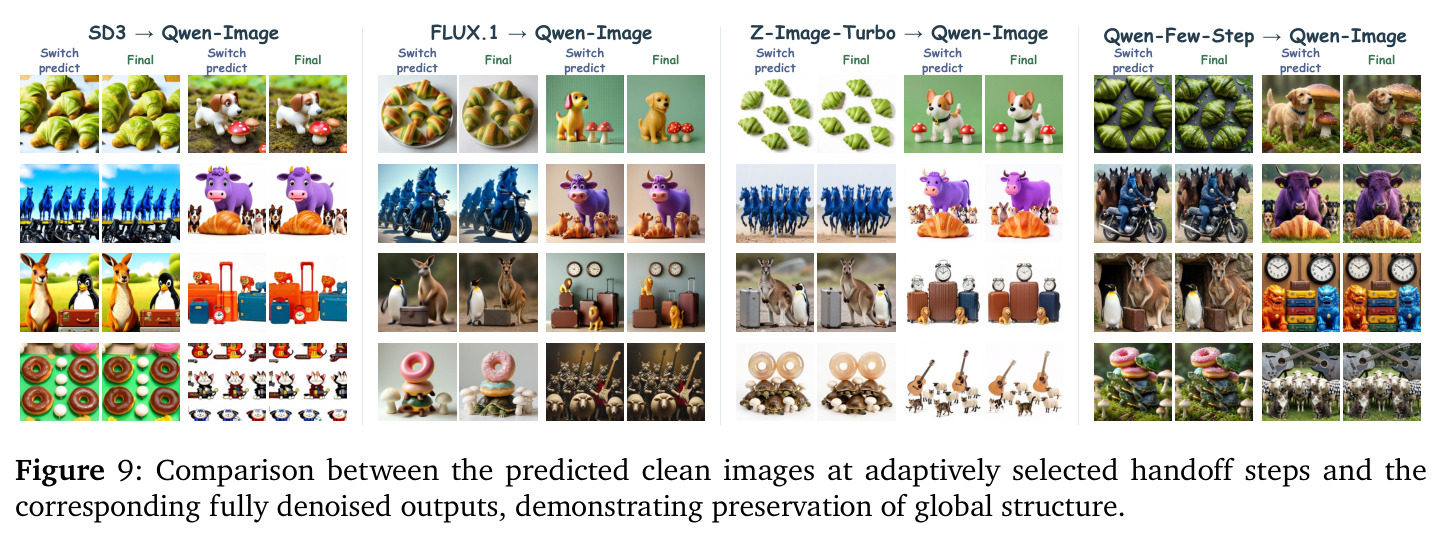
直觉上,各生成器的潜空间像不同的方言,描述的却是同一个视觉世界,只需在每个模型门口安排一个翻译官,大家就能在共同的普通话里交接工作。技术上,为每个冻结生成器 $m$ 配备一个时间条件化潜自编码器:编码器 $E_m$ 把中间态 $x_t$ 连同噪声水平 $t$ 编码为共享表示 $z_m^t$,解码器 $D_m$ 把共享码还原到该模型潜空间。训练时用同一张图、同一份噪声在相同噪声水平下构造各模型的配对中间态,施加四项互补损失:状态对齐 $\mathcal{L}_{\text{align}}$、重建 $\mathcal{L}_{\text{rec}}$(防编码器坍缩成丢信息的平凡解)、范数正则 $\mathcal{L}_{\text{reg}}$(稳定表示幅度)、动力学对齐 $\mathcal{L}_{\text{dyn}}$(同步一步去噪位移)。推理时,发送方状态经 $E_A$ 编码、$D_B$ 解码翻译为接收方潜空间的等效状态,再由自适应判据(连续两步预测干净潜码的相对变化首次超过阈值 $\gamma$)选择交接步,接收方从中途继续去噪;交接只翻译潜码,不增加任何神经网络前向评估。
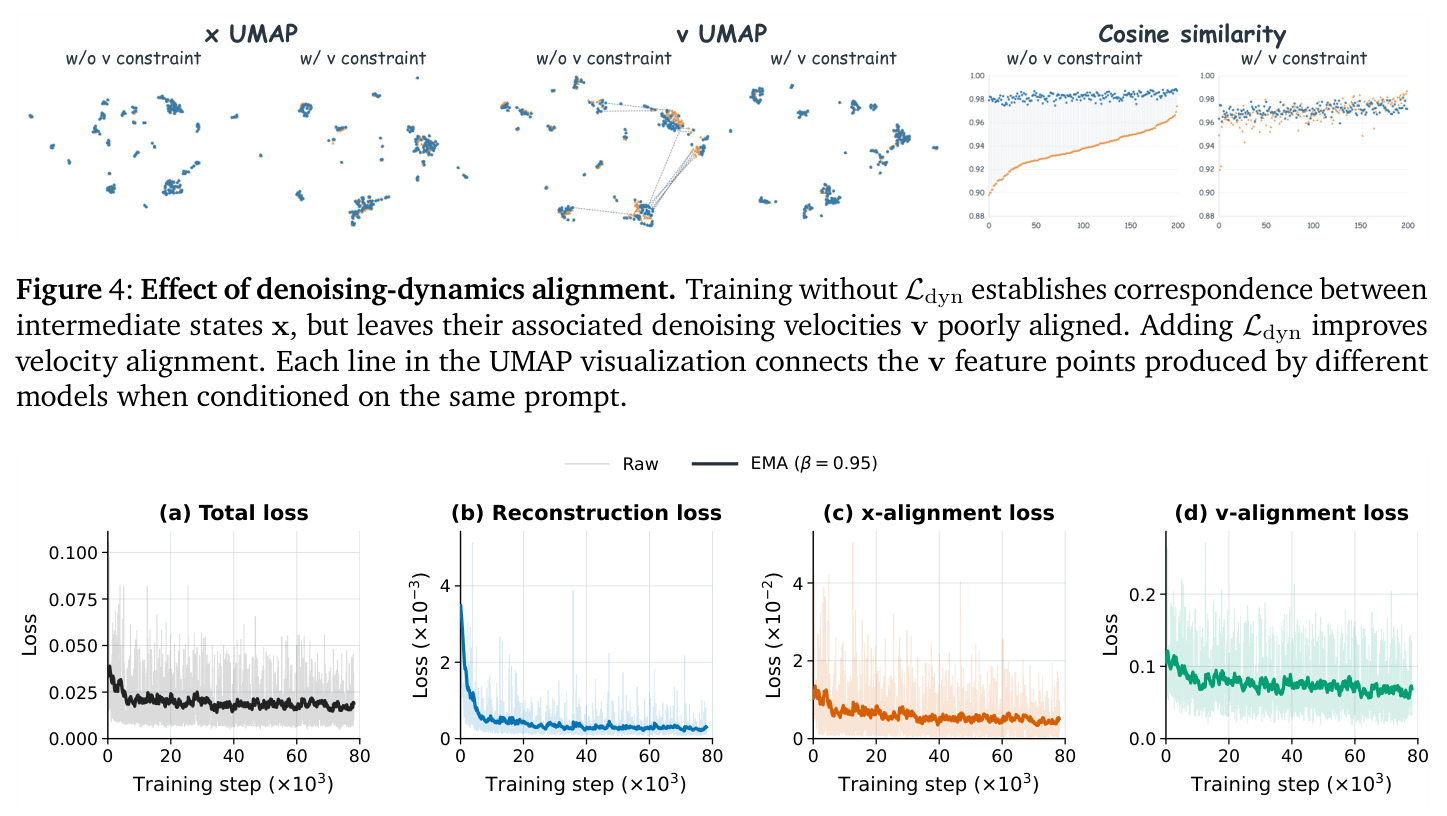
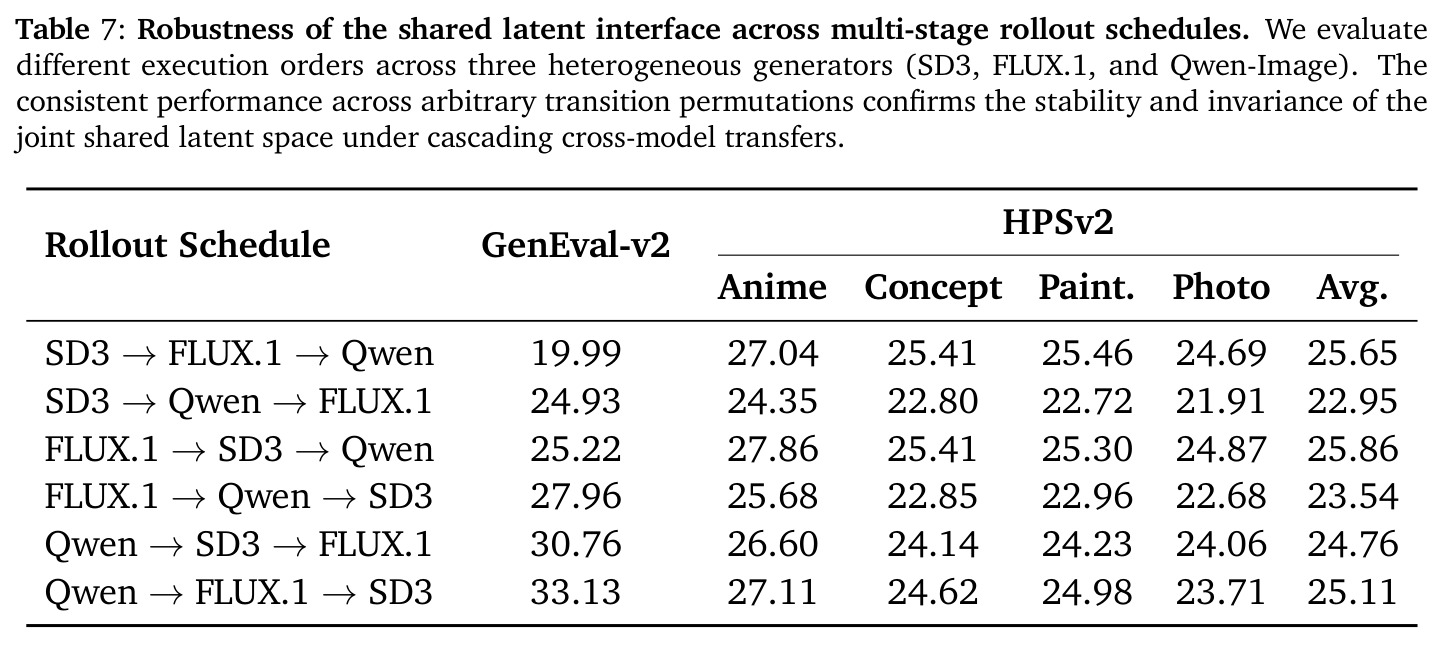
核心创新是把共享潜空间约束为状态与动力学双重对齐,并让接口复杂度随模型数线性增长。第一,论文证明仅对齐静态状态远远不够:Figure 4 的 UMAP 显示状态对齐后各模型的一步去噪位移仍然分离,去掉 $\mathcal{L}_{\text{dyn}}$ 时跨架构在线蒸馏会直接发散;$\mathcal{L}_{\text{dyn}}$ 把每个模型用冻结速度场走一步的位移 $\Delta z_m^k$ 拉到一致,才让翻译后的状态真正落在接收方轨迹上——这是对去噪动力学兼容性的首次显式建模。第二,星型接口设计:任意模型对 $A\to B$ 的翻译由同一对 $E_A$、$D_B$ 组合完成,$M$ 个模型只需 $M$ 个 LAE,无需成对桥;Table 7 中三模型全部六种级联排列指标基本一致,说明得到的是全局一致的共享空间而非两两妥协。第三,交接时机自动化:利用干净预测 $\hat{x}_0 = x - t\,v_\theta(x,t,c)$ 的逐步稳定性 $S_k$ 判断全局结构是否已凝出,避免过早交接把纯噪声阶段交给不适配的接收方。
方法步骤详情
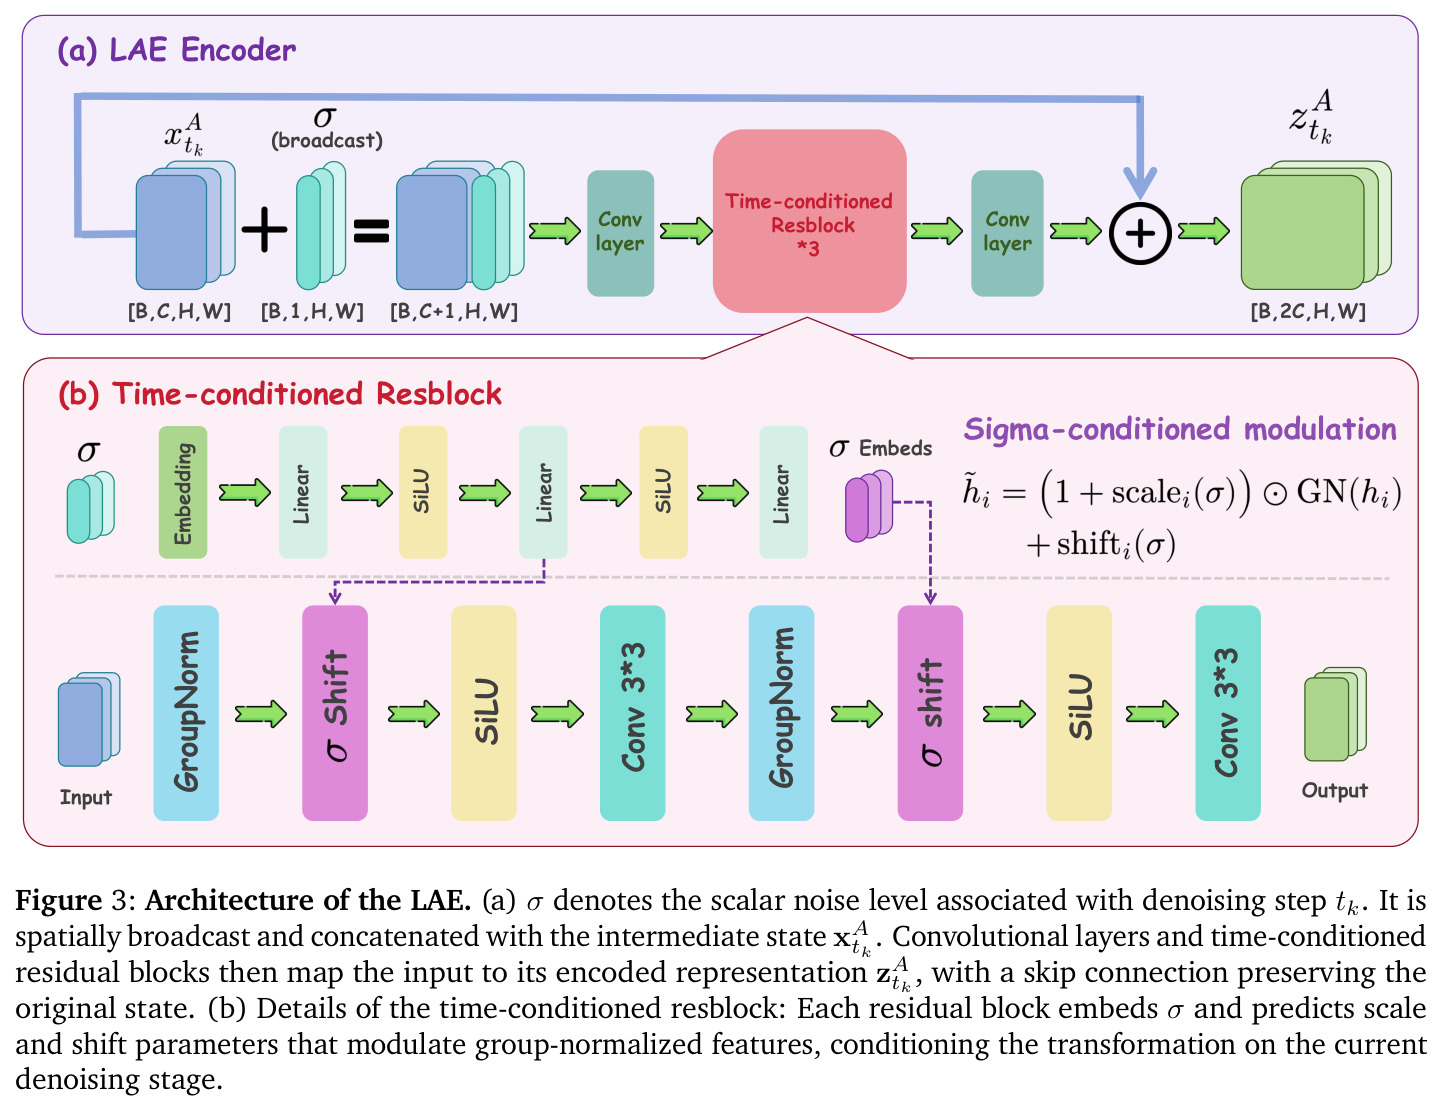
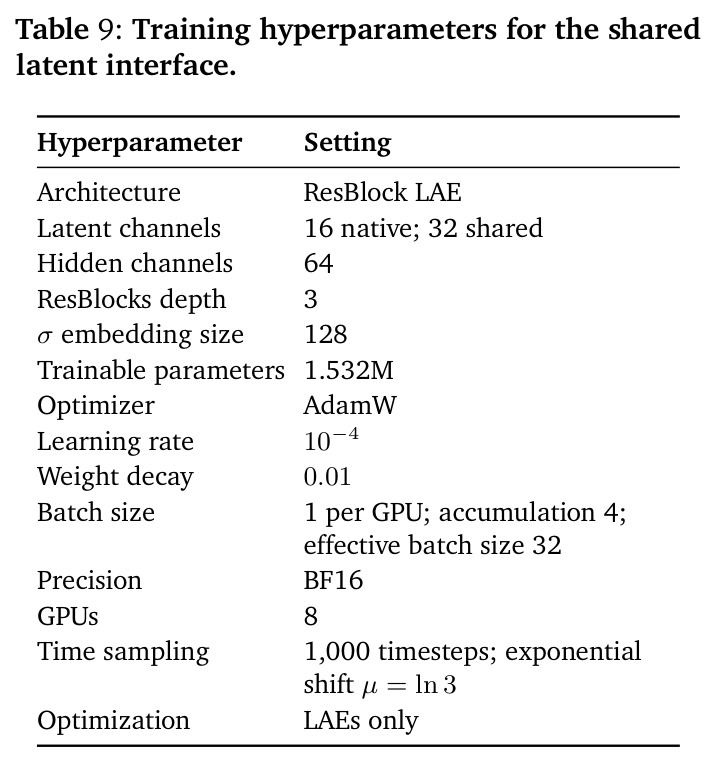
第一步,构造配对数据:共享冻结 VAE 把图像编码为干净潜码 $x_0$,采样噪声 $\epsilon$ 与时间 $t$,按 $x_t=(1-t)x_0+t\epsilon$ 得到各模型相同噪声水平下的输入。第二步,LAE 前向:计算 $z_m^t=E_m(x_t,t)$ 与重建 $\tilde{x}_m^t=D_m(z_m^t,t)$;LAE 由卷积层加 3 个 σ 条件化 ResBlock 构成(结构细节见 Figure 3)。第三步,联合优化:$\mathcal{L}=\mathcal{L}_{\text{rec}}+\mathcal{L}_{\text{align}}+\lambda_{\text{reg}}\mathcal{L}_{\text{reg}}+\lambda_{\text{dyn}}\mathcal{L}_{\text{dyn}}$,权重 1.0、1.0、$10^{-4}$、0.1;其中 $\mathcal{L}_{\text{dyn}}$ 在每步 $k$ 用各模型冻结速度场算出 $x_{t_{k+1}}$,编码为共享位移 $\Delta z_m^k$ 后取 MSE。训练用 VisPrompt 5 万图文对,学习率 $10^{-4}$,约 8 万步收敛,骨干全程冻结。第四步,推理交接:状态翻译 $\tilde{x}_{A\to B}=D_B(E_A(x_A,t),t)$;以干净预测 $x_{0,k}=x-t\,v_\theta(x,t,c)$ 的逐步相对一致度 $S_k$ 首次超过阈值 $\gamma$ 的步作为交接点($\kappa=10^{-8}$),接收方从翻译态续去噪至 $t=0$。
技术新颖性
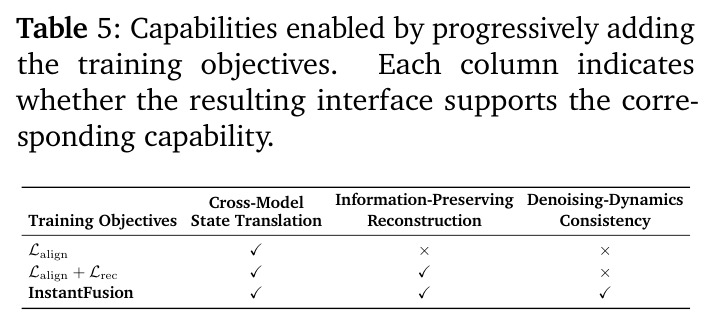
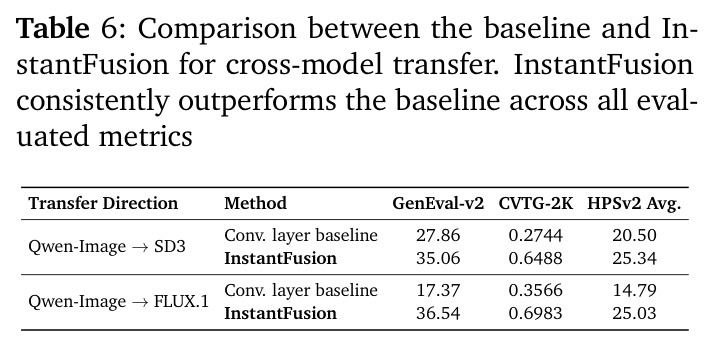
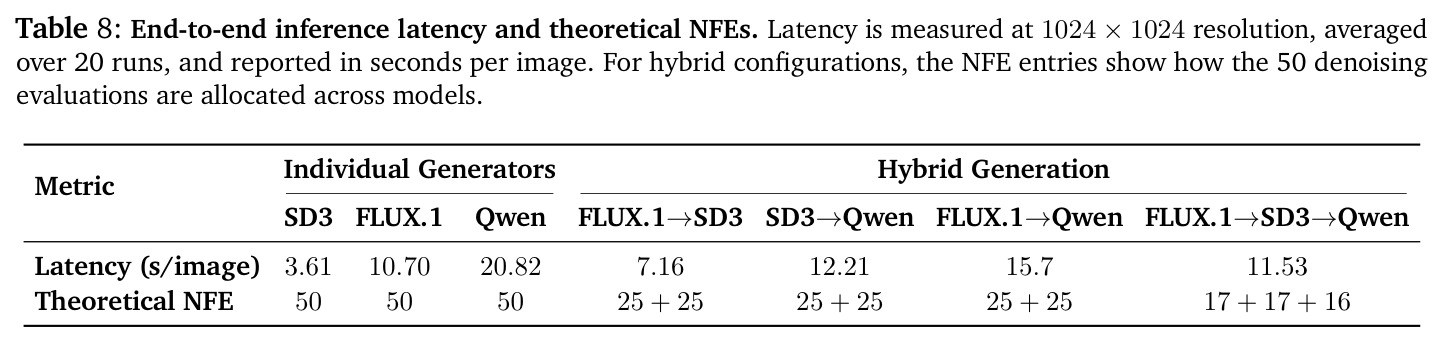
技术新颖性体现在四处。(1) 接口范式:不同于逐对桥接方法(线性映射、相对表示、闭式变换、VAE 桥),共享空间让任意模型即取即用,且六种三模型级联排列(Table 7)证明空间全局一致,可扩展到多段接力。(2) 动力学对齐:首次把局部去噪速度一致性写成一阶训练目标,Table 5 显示去掉 $\mathcal{L}_{\text{dyn}}$ 后状态翻译与重建能力仍在、但动力学一致性丢失,跨架构 OPD 发散,说明速度对齐是独立且必要的对齐维度。(3) 结构设计:σ 条件化 ResBlock 是性能关键,换成普通卷积层后 Qwen→SD3、Qwen→FLUX.1 的 GenEval-v2 分别从 35.06、36.54 跌到 27.86、17.37(Table 6)。(4) 自适应交接:以干净预测稳定性 $S_k$ 选步,替代逐对手工调步,Figure 9 显示所选交接点的干净预测已锁定最终图像的全局布局。此外交接只翻译潜码、不调用额外去噪评估,理论上零 NFE 开销(Table 8:三段级联 NFE 17+17+16)。
实验结果
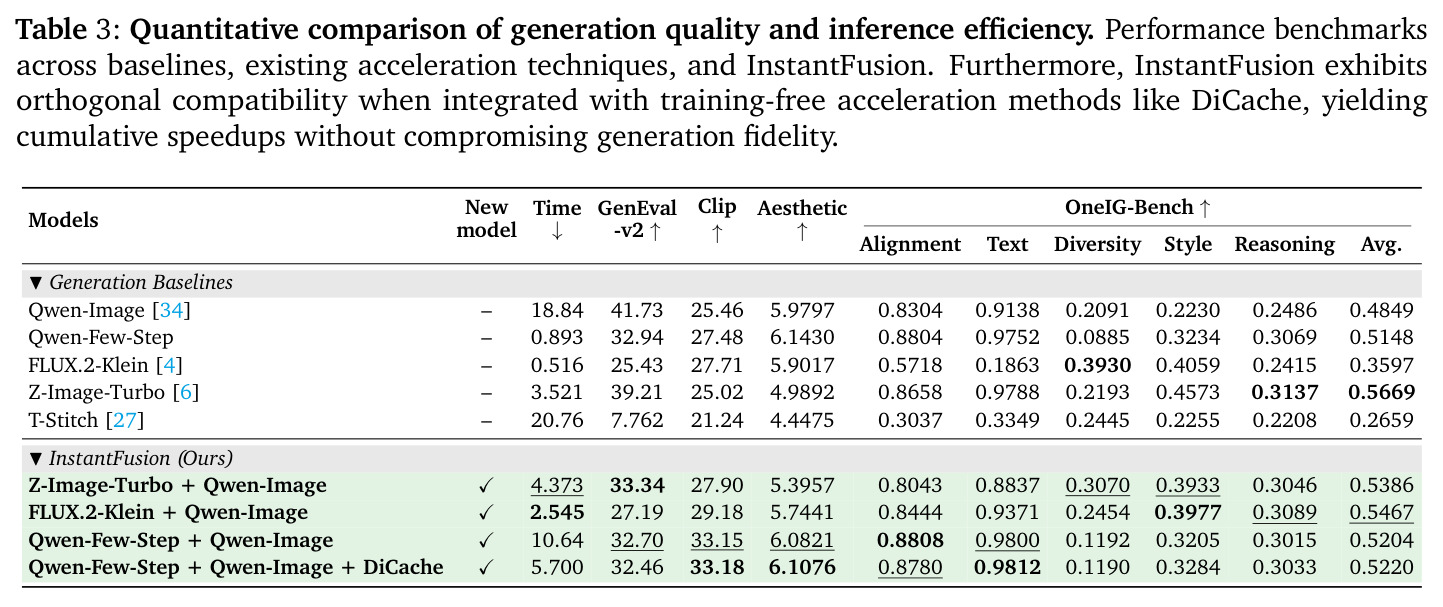
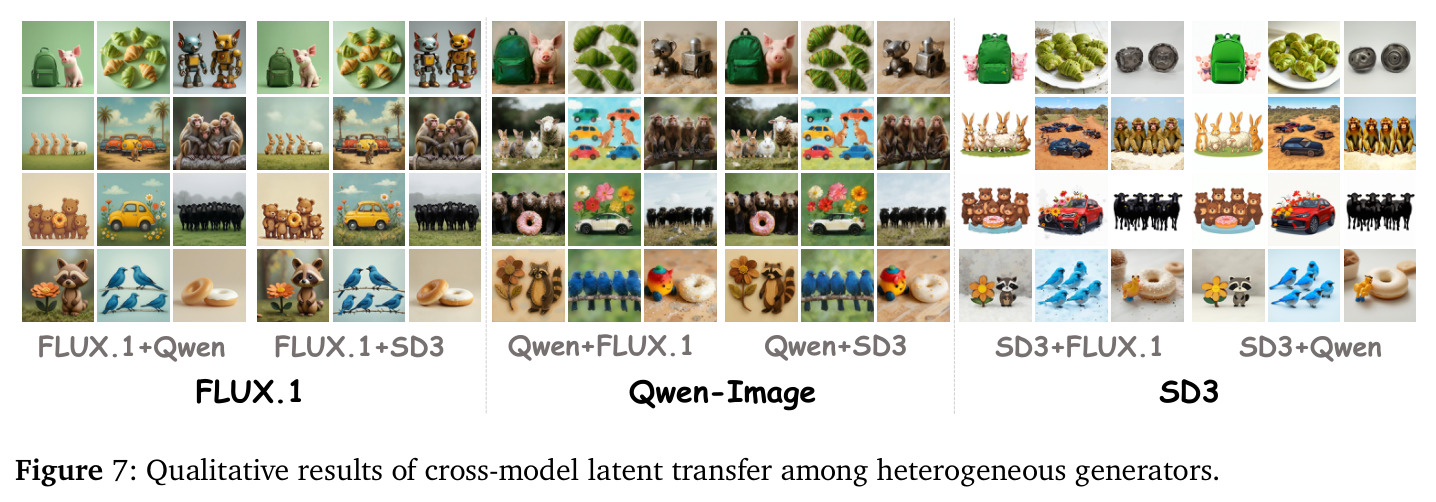
实验覆盖 SD3、Z-Image、FLUX.1、Qwen-Image 四类生成器。接口保真度(Table 1a):单次潜码往返重建 PSNR 31.375、SSIM 0.9417(SD3–Qwen),三模型共享空间单程 PSNR 32.397;但 10 次往返退化到 PSNR 约 20,适合少量级联。跨模型组合(Table 2):Qwen 引导使 SD3 的 GenEval-v2 从 22.14 升至 35.06(+12.92),CVTG-2K 从 0.3682 升至 0.6488;Qwen+FLUX.1 达 36.54(+13.68)、0.6983,OneIG-Bench 均分 +0.0619/+0.0591。加速(Table 3):Z-Image-Turbo+Qwen 把 18.84s 压至 4.373s(GenEval-v2 33.34),FLUX.2-Klein+Qwen 至 2.545s,远好于 T-Stitch 的 7.762 分崩塌;叠加 DiCache 把 10.64s 降至 5.70s 而 GenEval-v2 仅 32.70→32.46,证明与训练免费加速正交。跨架构 OPD(Table 1b):SD3 经 Qwen 蒸馏 HPSv2 均分 26.27→26.46。多偏好组合(Table 4):GenEval-v2+HPSv2 双专家达 30.97/30.68,超过速度融合的 29.39/29.99。效率(Table 8):FLUX.1→SD3→Qwen 时延 11.53s,NFE 17+17+16,交接零额外 NFE。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨模型组合(Qwen-Image 引导 SD3) | GenEval-v2 | 35.06 | SD3 单模型 22.14 | +12.92 |
| 跨模型组合(Qwen-Image 引导 FLUX.1) | GenEval-v2 | 36.54 | FLUX.1 单模型 22.86 | +13.68 |
| 跨模型组合(Qwen-Image 引导 SD3) | CVTG-2K | 0.6488 | SD3 单模型 0.3682 | +0.2806 |
| 加速生成(Z-Image-Turbo → Qwen-Image) | 推理时延(s/图,1024×1024)与 GenEval-v2 | 4.373s,GenEval-v2 33.34 | Qwen-Image 单模型 18.84s(41.73);T-Stitch 20.76s(7.762) | 提速 4.3 倍,质量远超 T-Stitch 且接近少步基线 |
| 加速生成(FLUX.2-Klein → Qwen-Image) | 推理时延 | 2.545s(GenEval-v2 27.19) | Qwen-Image 单模型 18.84s(41.73) | 提速 7.4 倍 |
| 加速并叠加 DiCache(Qwen-Few-Step → Qwen-Image) | 推理时延 / GenEval-v2 | 5.70s / 32.46 | InstantFusion 单独使用 10.64s / 32.70 | 再提速 1.87 倍,质量基本无损 |
| 跨架构在线策略蒸馏(Qwen-Image → SD3) | HPSv2 平均分 | 26.46 | SD3 基线 26.27 | +0.19 |
| 多偏好组合(GenEval-v2 + HPSv2 奖励专家) | GenEval-v2 / HPSv2 平均 | 30.97 / 30.68 | 速度融合 29.39 / 29.99;联合多奖励 GRPO 35.89 / 27.19 | 优于速度融合,HPSv2 高于联合训练 3.49,GenEval-v2 接近联合训练 |
| LAE 结构消融(Qwen-Image → FLUX.1) | GenEval-v2 | 36.54(σ 条件化 ResBlock) | 普通卷积层版 17.37 | +19.17 |
局限与改进
作者承认的局限:方法依赖所有生成器共享同一自编码器和兼容的时间参数化,异构 VAE 场景不适用;混合推理需同时驻留多个冻结骨干(Qwen-Image 约 20B、FLUX.1 约 12B、SD3 约 2B),显存开销显著,动态加载/卸载留作未来工作。我的补充观察:(1) 往返保真度衰减快,10 次往返 PSNR 跌至约 20,长链级联会累积信息损失;(2) 加速有明确质量代价,Z-Image-Turbo+Qwen 的 GenEval-v2 33.34 相比纯 Qwen 的 41.73 下降约 8.4 分,速度-质量权衡只是被缓和而非消除;(3) Table 7 中三段级联的 GenEval-v2 实际在 19.99–33.13 间波动,交接顺序对属性遵循类指标的影响可能被低估;(4) 共享空间是全体模型联合训练的产物,成对损失计算量随 $M$ 平方增长,新增模型如何增量接入未验证;(5) 阈值 $\gamma$ 的选取与敏感性未报告;(6) OPD 增益较小(+0.19),共享空间中的速度监督可能仍有噪声。
独立分析的弱点
弱点一:可扩展性。成对对齐与动力学损失是全体模型对的平均,加入新模型需重训与其相关的损失乃至整个共享空间,与即插即用的叙事有差距;改进方向是冻结旧 LAE、只训新模型的 LAE 加一个轻量适配层,或引入持续学习机制。弱点二:共享 VAE 假设。一旦模型采用不同自编码器(通道数、压缩率不同)接口即失效;可在 LAE 前置跨 VAE 潜码翻译器,或上移到更高层语义空间建桥。弱点三:交接策略仍偏规则。阈值 $\gamma$ 与步数分配(两模型 25+25、三模型 17+17+16)依赖手工设定,缺乏搜索过程与敏感性消融;可训练轻量策略网络或用多臂老虎机在线优化交接点。弱点四:部署成本。同时加载多骨干使消费级显卡无法运行,需要系统级卸载、量化或参数共享配合。弱点五:评测广度。全部实验限于文生图与既有基准,未涉及图像编辑、可控生成、视频等任务,接口通用性声明还需更多证据;另外 Figure 6 的 SSIM 统计仅基于 100 张图,样本量偏小。
未来方向
作者提出的方向:把接口扩展到异构自编码器;优化多模型的动态加载与卸载以降低显存开销;把学到的共享空间发展为预训练可复用接口,让新生成器以最小适配接入,并成为模型组合、知识迁移与下游优化的公共起点。基于成果可延伸的研究:(1) 把接口推广到视频生成与多模态扩散模型,时间维潜码的跨模型对齐价值更大;(2) 在共享空间中做功能级插值与语义编辑,例如把 A 模型学到的风格或概念潜码搬进 B 模型;(3) 训练一个统一调度器,针对 prompt 自动选择最优模型序列与交接点,把 Table 7 中的排列选择变成可学习问题;(4) 探索共享空间的几何结构,回答跨模型兼容性是否源于某种规范坐标,为观察到的现象提供理论解释;(5) 结合在线强化学习,在共享空间内跨模型采样以扩大探索并共享奖励信号,降低多目标对齐的训练成本。
复现评估
复现条件较好:代码已开源(GitHub:InternLM/InstantFusion),训练数据为公开的 VisPrompt 5 万图文对,四个骨干 SD3、Z-Image、FLUX.1、Qwen-Image 均有公开权重;LAE 本身很小(32 个共享通道、64 隐藏通道、128 维 σ 嵌入的卷积加 3 个 ResBlock 结构),论文给出完整损失权重(1.0/1.0/$10^{-4}$/0.1)、学习率 $10^{-4}$、$\kappa=10^{-8}$ 等关键超参,Figure 5 显示约 8 万步内各项损失平稳收敛。主要门槛在算力与显存:训练需同时前向多个大骨干提取配对中间态(含 Qwen-Image 级别的 20B 模型),需要 A100/H100 级多卡环境;混合推理需同时驻留多个模型,显存压力大。评测基准 GenEval-v2、CVTG-2K、OneIG-Bench、HPSv2/HPSv3 均公开可得,但部分 SSIM 统计仅基于 100 张图;Table 4 的奖励专家 GRPO 基线来源需参考附录。总体复现难度中等,核心结论(跨模型组合与加速)在公开配置下可信。
论文图表
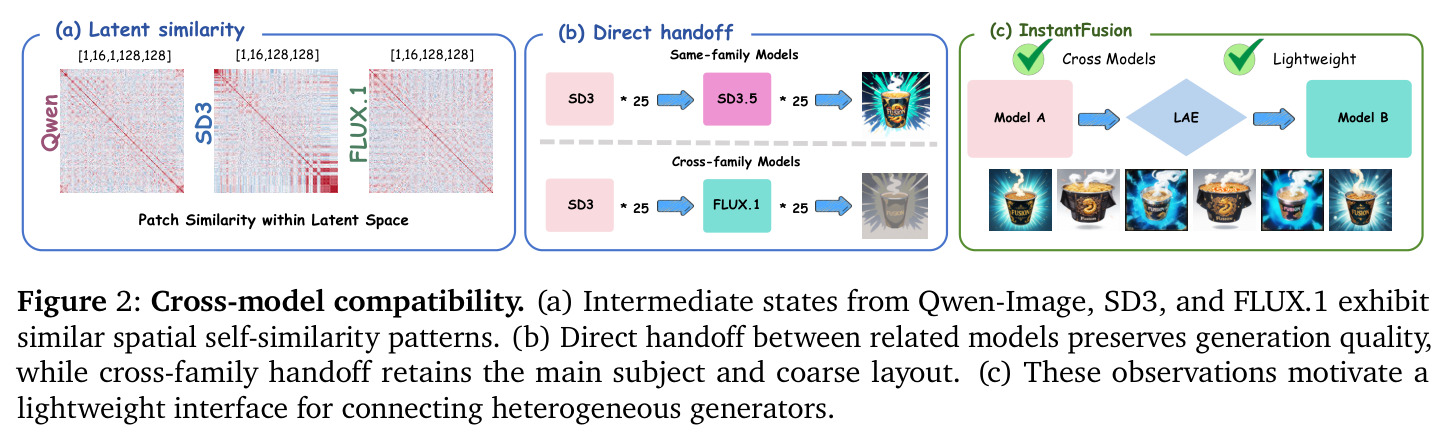
动机证据图。(a) 展示 Qwen-Image($[1,16,1,128,128]$)与 SD3、FLUX.1($[1,16,128,128]$)中间态的潜空间内 patch 相似度模式高度相近;(b) 展示同家族交接(SD3→SD3.5)图像无缝,而跨家族交接(SD3→FLUX.1)虽带局部伪影但保留杯子主体与粗布局;(c) 据此提出轻量接口构想。
这是论文立项的核心实验证据,说明为什么跨模型交接原则上是可行的,理解了它才能理解后面对齐损失设计针对什么问题。