PreSTO:面向快速 LLM 幂采样的预测式子树预取 PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
把未来MH接受/拒绝结果组织成预取子树,一次批量调用生成提议,转移核不变地将幂采样加速2.3倍
前置知识
Metropolis–Hastings(MH)采样
一种 MCMC 方法,用于从仅已知归一化常数的目标分布 $\pi(x)$ 采样。给定当前状态 $x$,从提议分布 $q(\cdot|x)$ 抽候选 $y$,以接受概率 $A(y,x)=\min\{1,\pi(y)q(x|y)/(\pi(x)q(y|x))\}$ 决定是否移动:接受则链走到 $y$,拒绝则停在 $x$。如此构造的马尔可夫链稳态即为目标分布。
PowerMH 与 PreSTO 的每一步都是一次 MH 转移,接受规则 (1) 与'提议生成→接受/拒绝'的结构是理解预取树分支语义的基础;论文命题 1 证明的正是 PreSTO 保持 MH 转移核不变。
幂采样与分布锐化
对基座 LLM 的分布做指数锐化:$\pi_\alpha(x_{1:n}|x_0)\propto p_0(x_{1:n}|x_0)^\alpha$。当 $\alpha>1$ 时高似然延续被放大、低似然延续被压制。近期研究表明直接从锐化分布采样可以达到与 RL 后训练(如 GRPO)相当的推理效果,是无需训练的测试时增强手段。
这是本文加速的采样目标。理解 $\pi_\alpha$ 为什么会让 MH 接受概率趋于 0 或 1($\epsilon$-确定性观察),是掌握预测式遍历规则的动机前提。
MCMC 预取(prefetching)
利用 MH 转移的接受/拒绝二叉结构做推测计算:提前为'如果接受'与'如果拒绝'两种未来都生成候选并算好接受概率,等随机数揭晓后沿实际路径直接使用预计算结果,从而把本质串行的链式过程部分并行化(Brockwell 2006;Angelino et al. 2014;Ye & Lu 2024)。
PreSTO 的方法框架直接源自这一思想,但针对昂贵的 LLM 提议做了预算化不规则子树的改造;理解经典预取有助于看清本文在假设与约束上的关键差异。
前缀缓存(prefix caching)
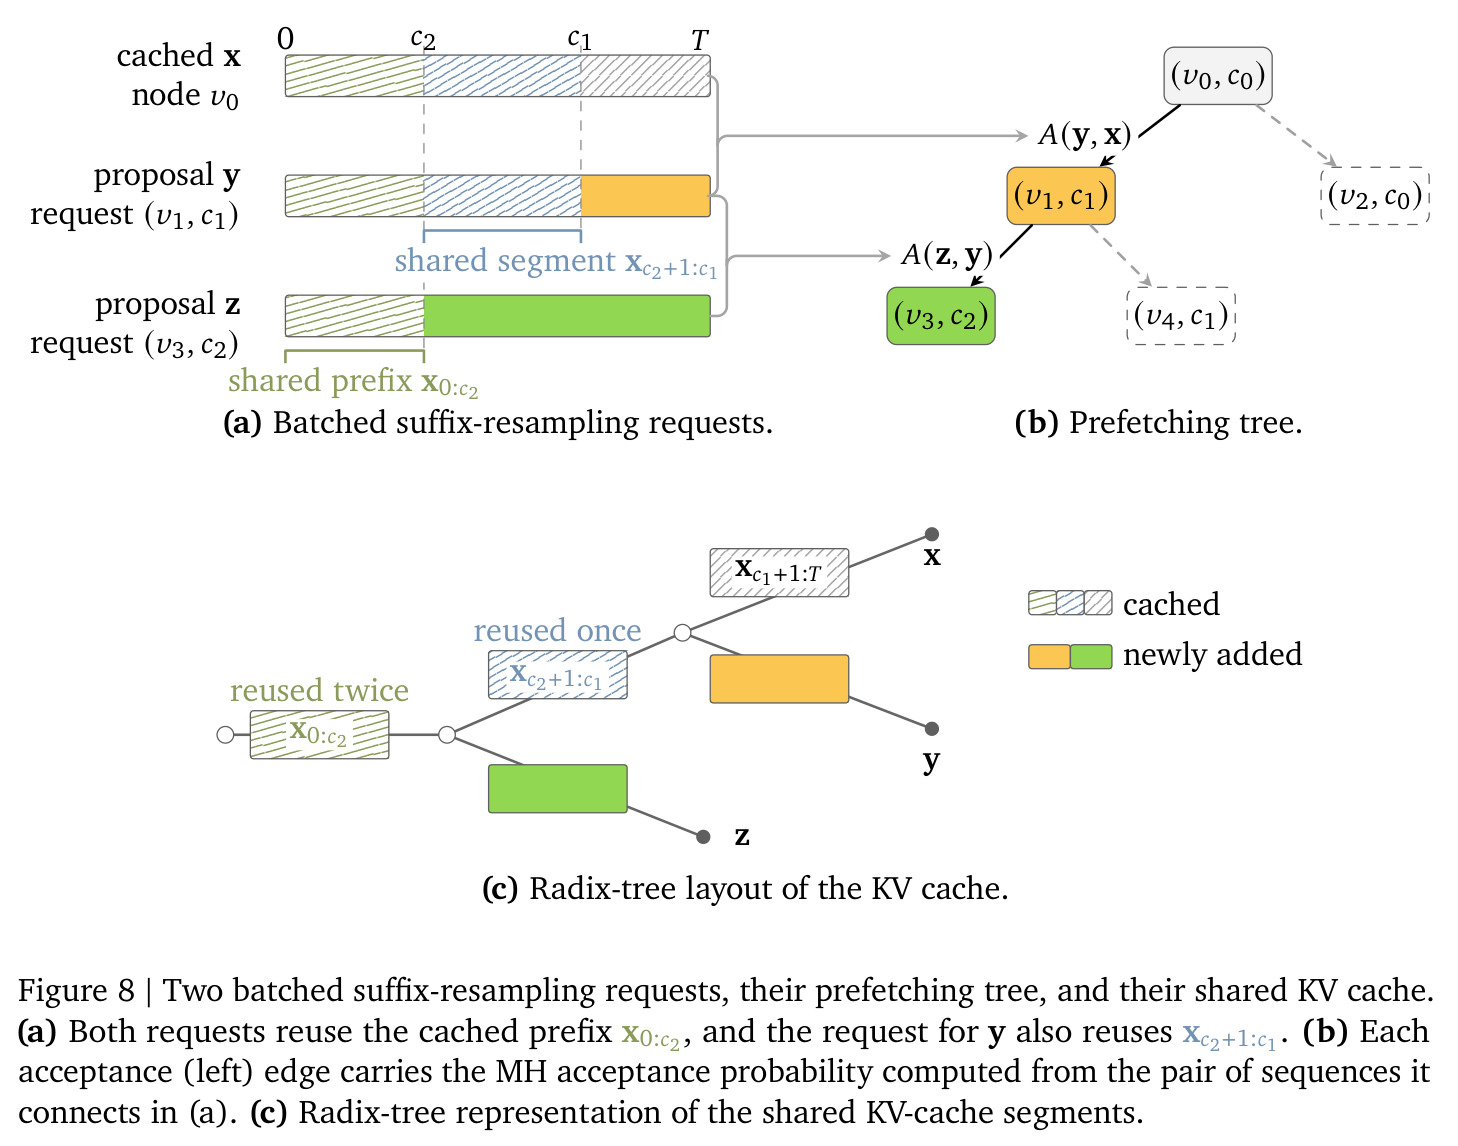
LLM 推理服务引擎(vLLM、SGLang)对共享相同前缀的多个请求只计算一次 KV 缓存并复用。自回归生成中长前缀的重复计算占推理成本大头,前缀缓存能显著降低批量请求的边际成本。
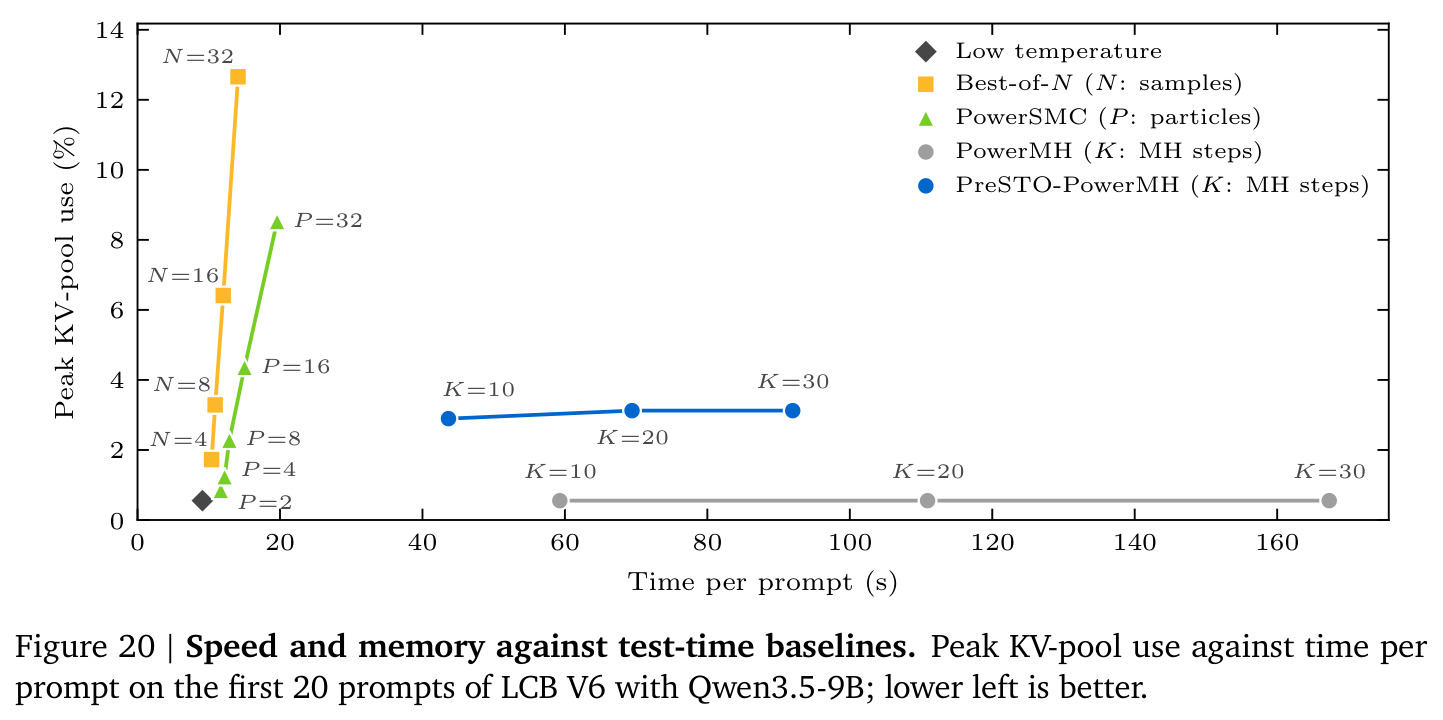
PreSTO 的批量预取调用之所以划算,靠的正是同批请求共享前缀(Condition 1 保证可行请求只依赖已缓存前缀 $x_{0:c'}$);论文指出预取的 KV 缓存额外开销不超过预分配池的 3.1%。
TOST 等价性检验
双单侧检验(Two One-Sided Tests):与'证明两组有差异'的显著性检验相反,TOST 在给定等价边际(本文取 0.2 个基线标准差)内证明两组统计量分布等价,常用于验证算法替换不改变输出分布。
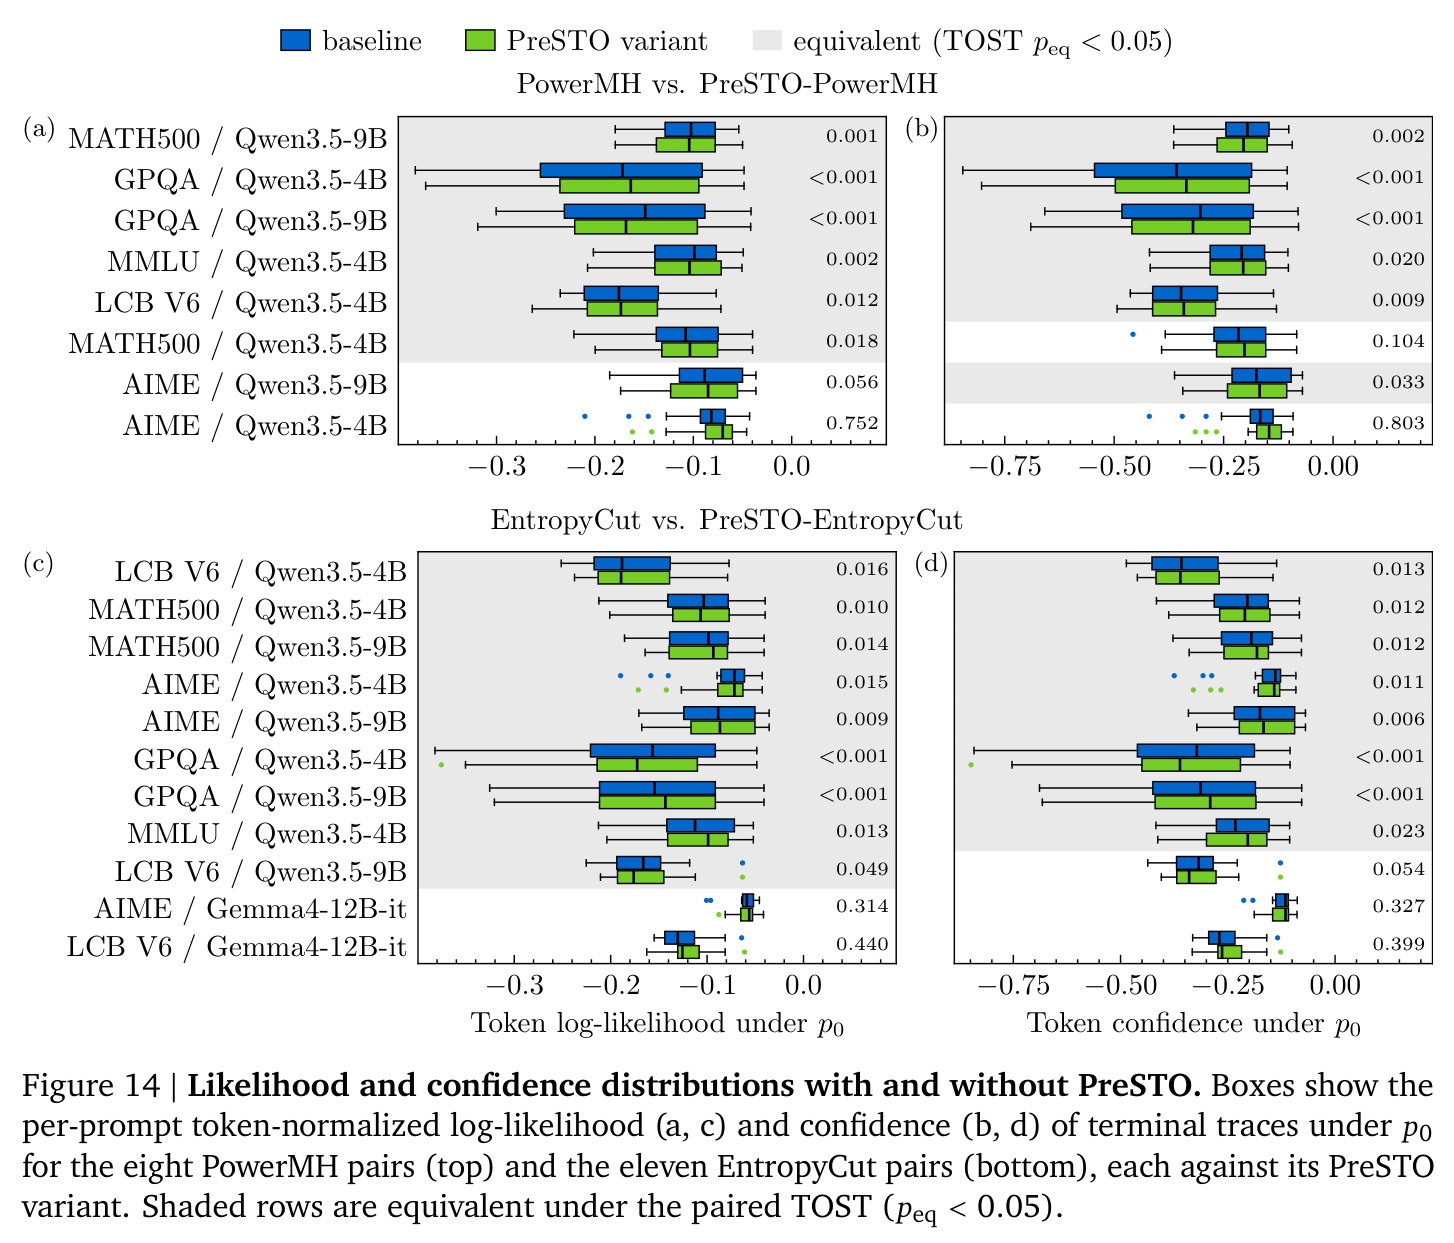
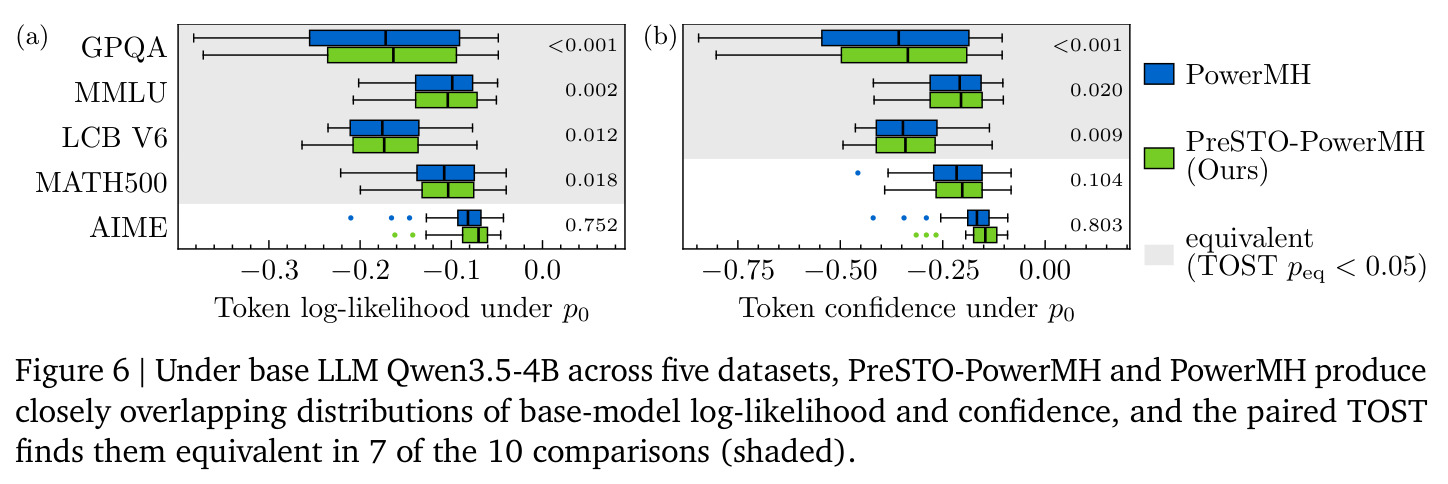
论文用它验证 PreSTO 与基线输出的 token 对数似然与置信度分布等价(38 个比较中 29 个通过,$p_{eq}<0.001$),是'转移核不变'这一核心主张的实证支撑。
研究动机
幂采样通过从锐化分布 $\pi_\alpha(x_{1:n}|x_0)\propto p_0(x_{1:n}|x_0)^\alpha$($\alpha>1$)直接采样来获得接近 RL 后训练的推理增益,但其标准采样器 PowerMH 非常昂贵:MH 更新本质串行,第 $k+1$ 步的提议必须等第 $k$ 步接受/拒绝结果确定下一状态后才能生成。论文实测:在 MATH500 上 PowerMH 生成的 token 最多是标准采样的 8.8 倍;在 LCB V6 + Qwen3.5-9B 上,$K=10,20,30$ 步 MH 的单 prompt 耗时分别是低温单次采样的 6.5×、12.2× 和 18.4×。现有改进要么更换采样器(SMC、副本交换),要么近似幂目标、按 token 熵精炼切点、或修改目标函数与训练流程——它们都改变了采样器或模型本身,缺少在不破坏目标分布与接受规则的前提下直接减少串行调用次数的方案。
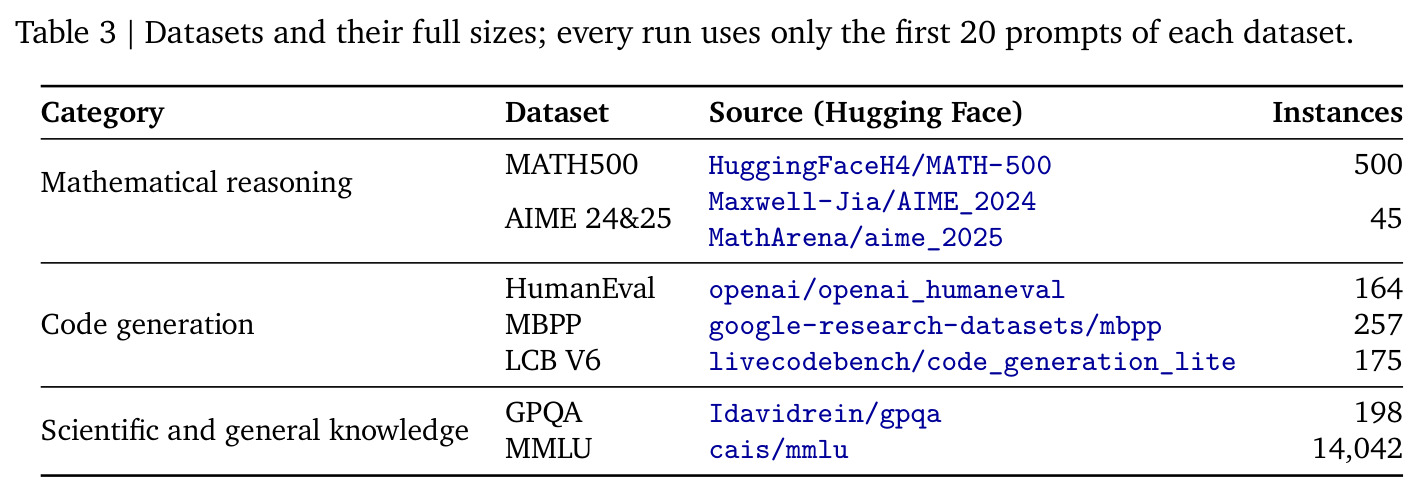
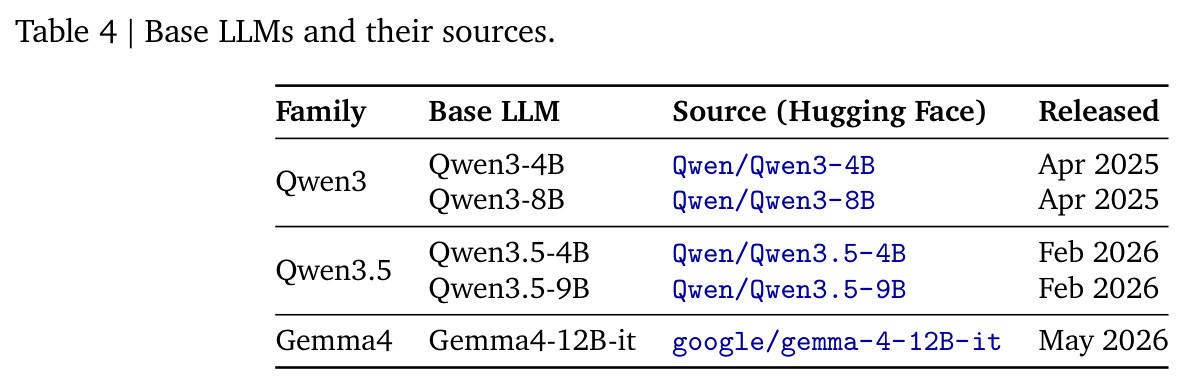
本文的目标是本文的目标是在完全不改变 PowerMH 及其后续变体(EntropyCut、MultiTryMH)的 MH 转移核的前提下,大幅减少串行模型调用次数、降低端到端延迟。具体要求是:给定每块 $K$ 步 MH 预算,最终样本仍须近似服从目标分布 $\pi_\alpha$,即预取只改变提议的生成与评估调度而不动接受规则;速度提升应来自'每次调用完成更多转移',即用更少但更大批量的调用替代更多次串行调用;提升还须在五个基座 LLM(Qwen3-4B/8B、Qwen3.5-4B/9B、Gemma4-12B-it)与七个数据集(MATH500、AIME 24&25、MBPP、GPQA、HumanEval、MMLU、LCB V6)上稳健成立——理想情况是任何设置都不慢于基线,且输出分布能通过统计等价性检验加以验证。
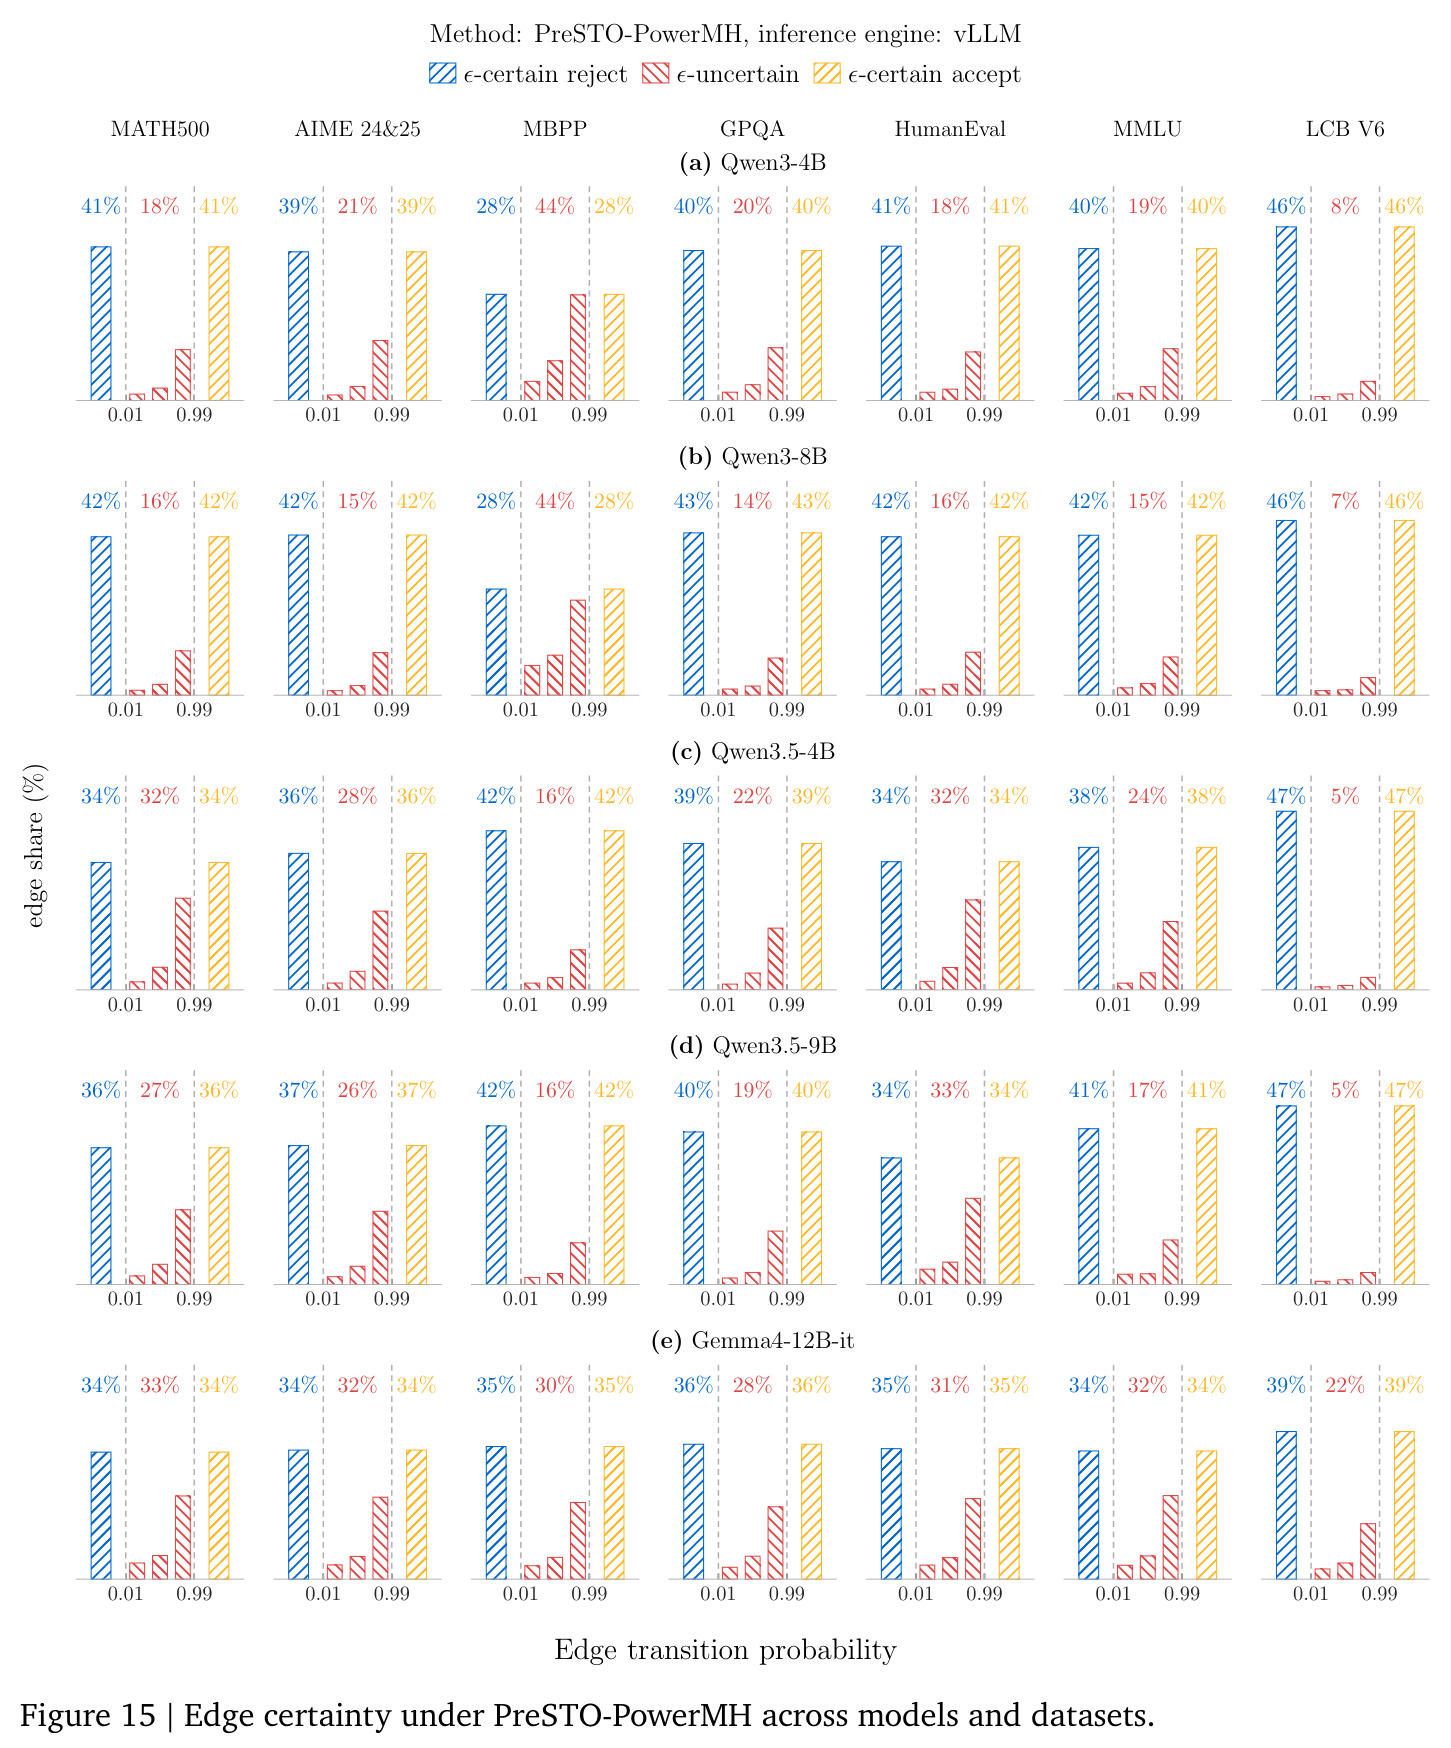
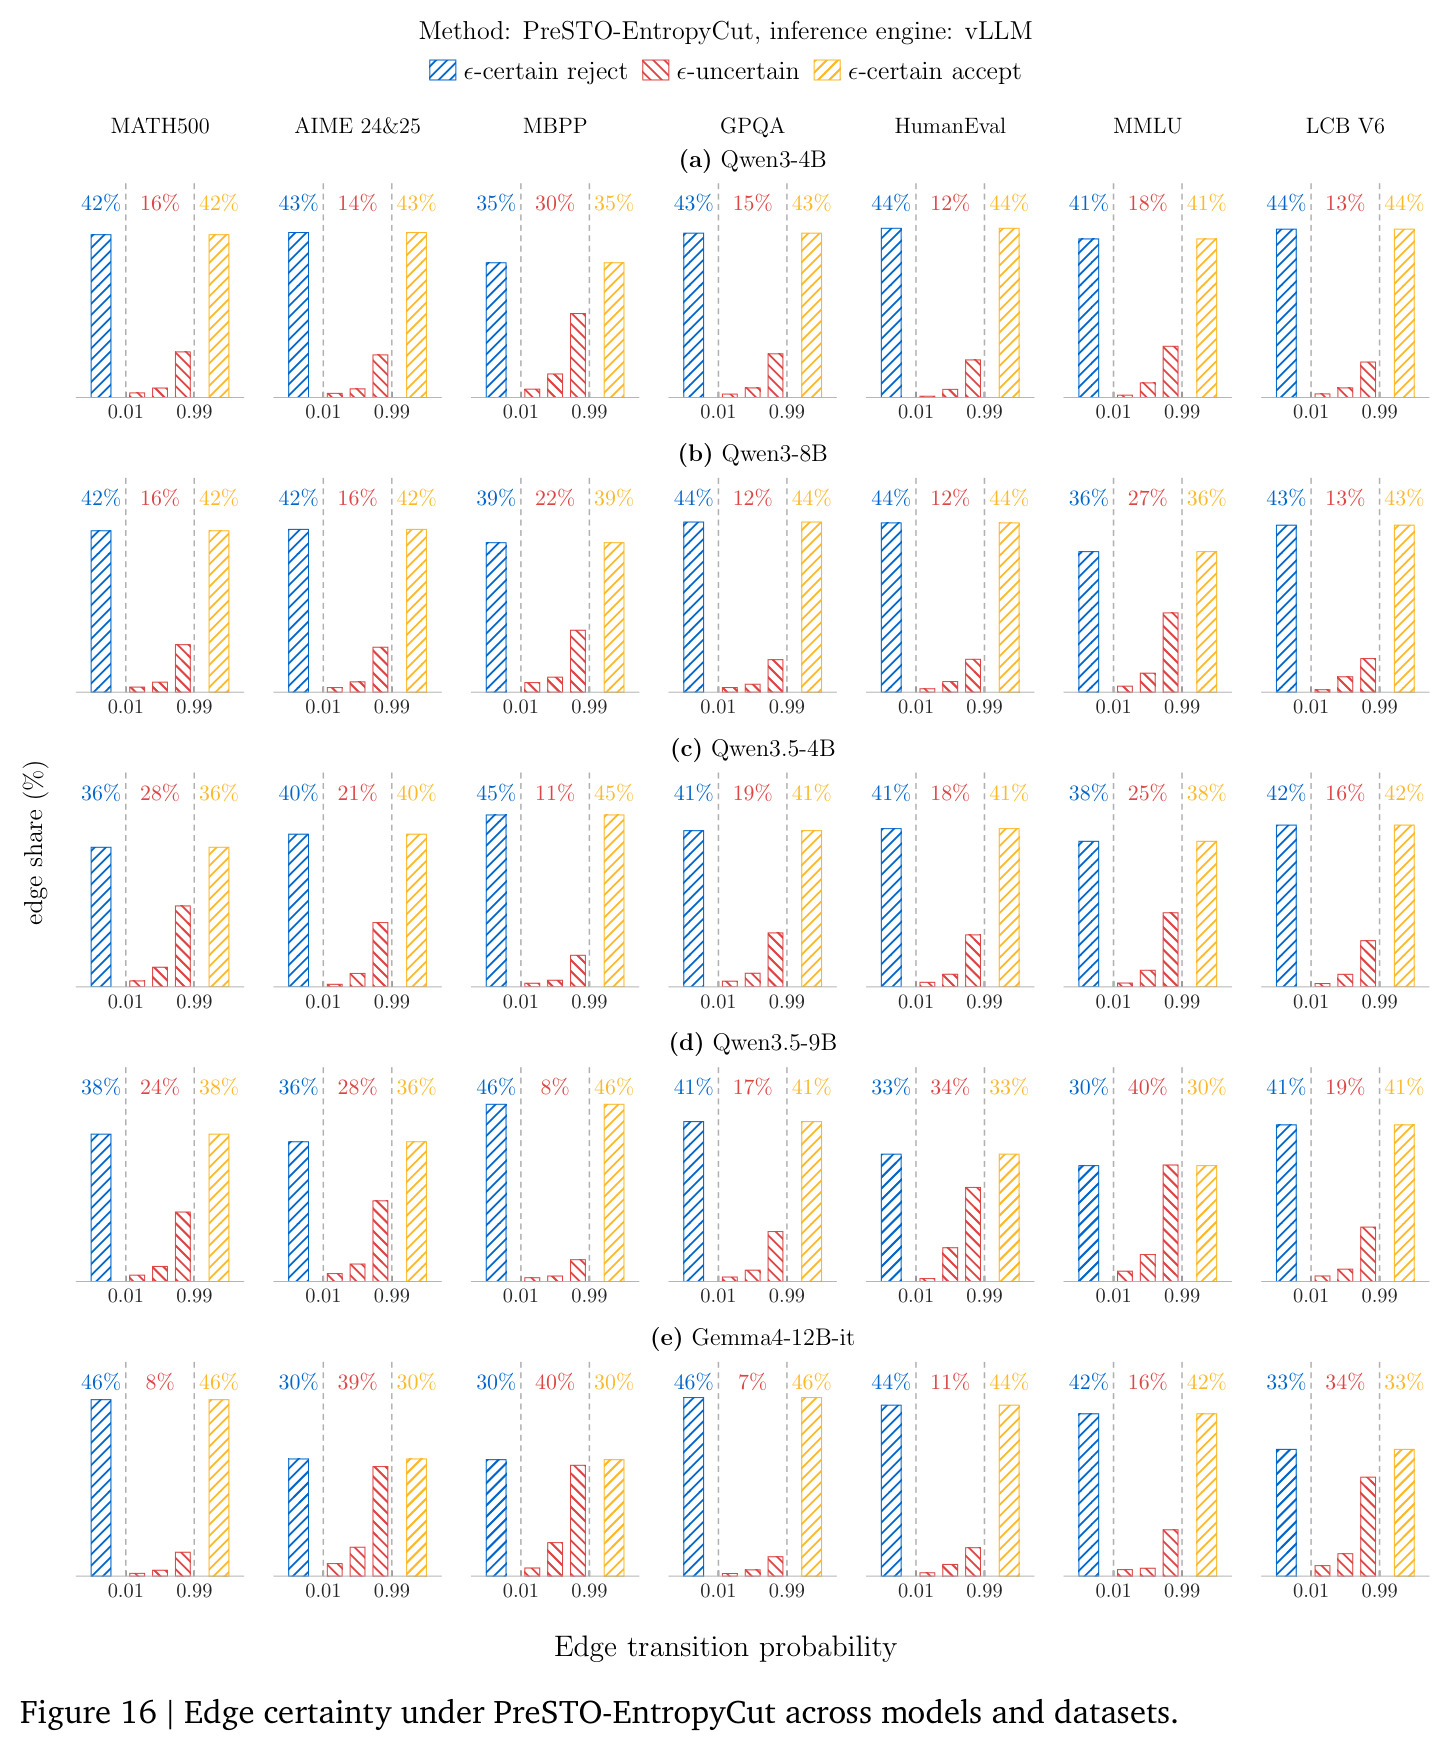
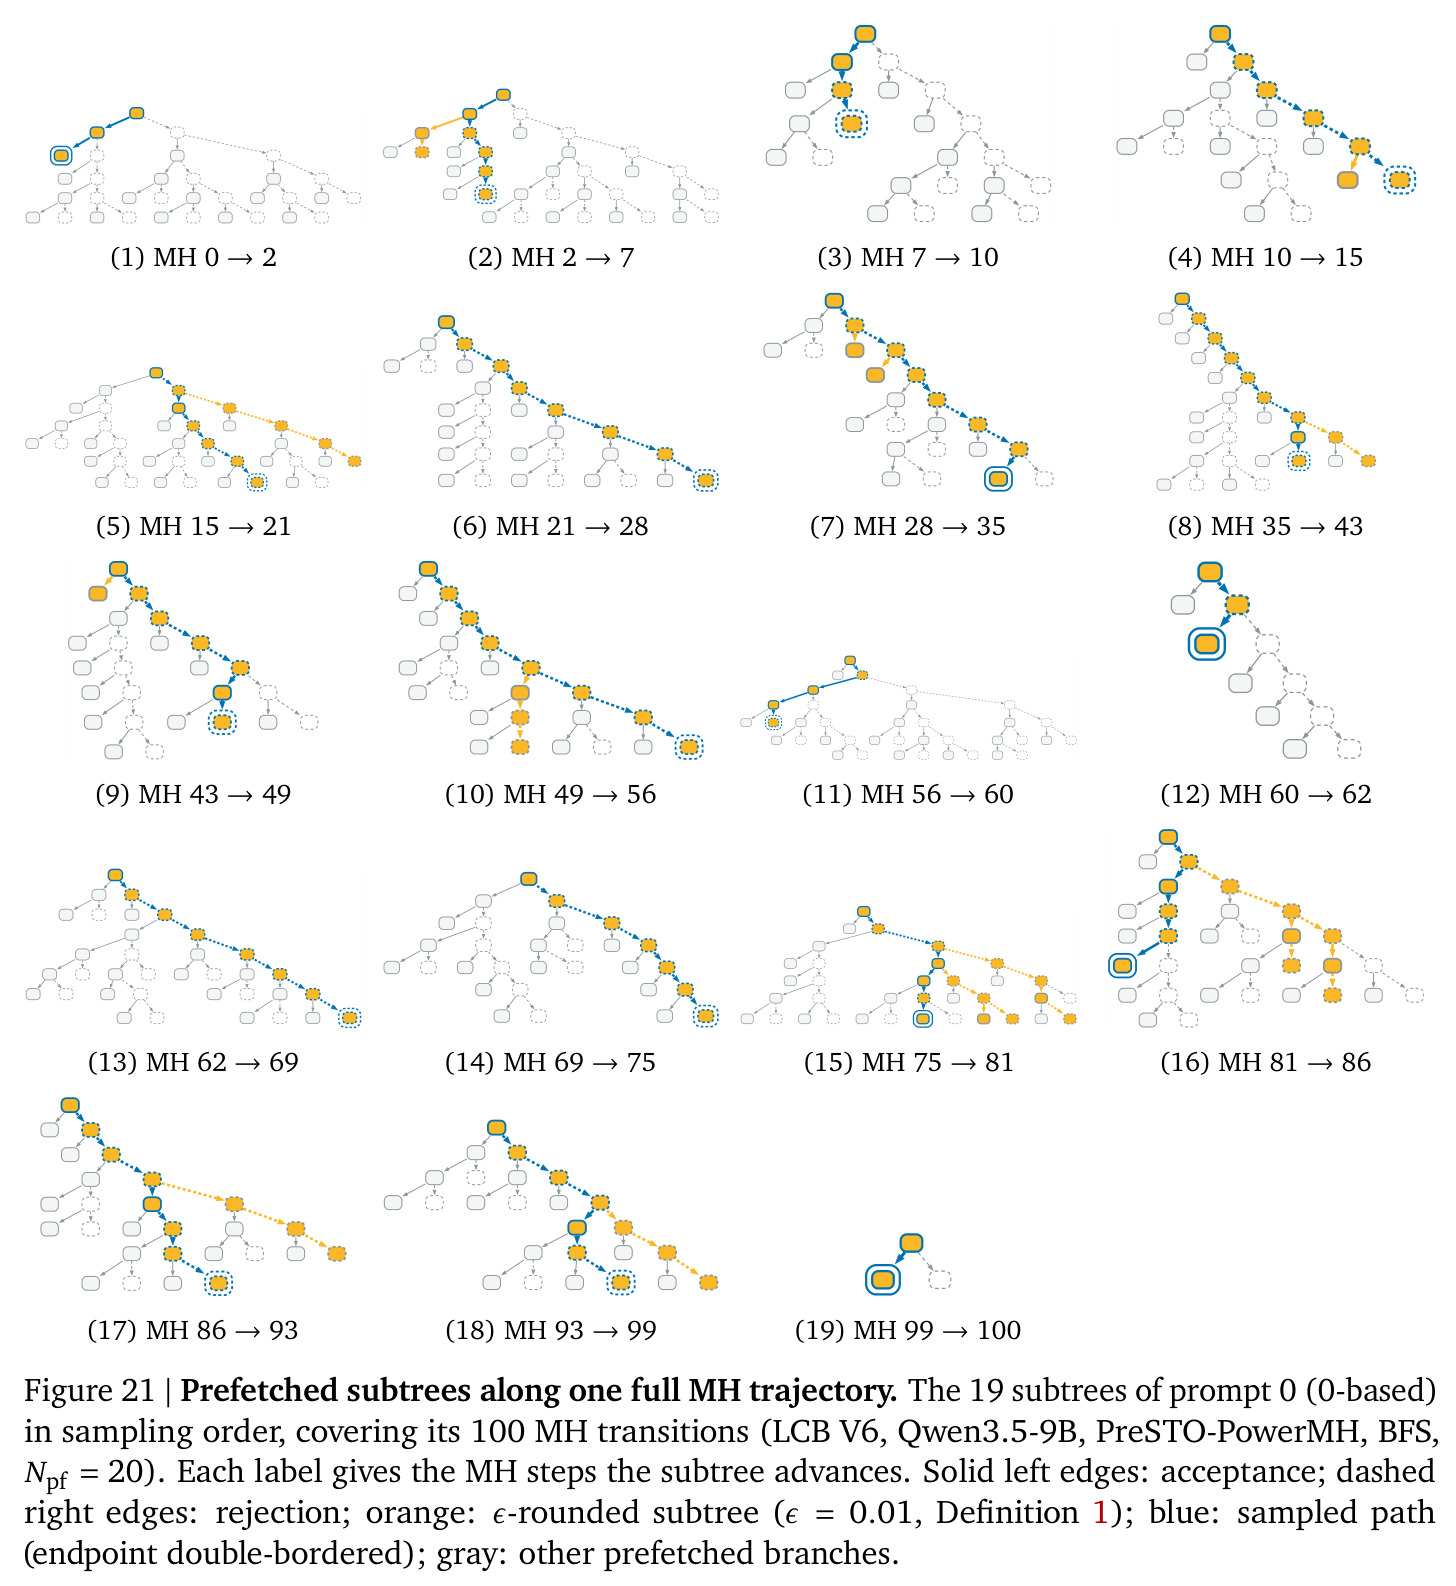
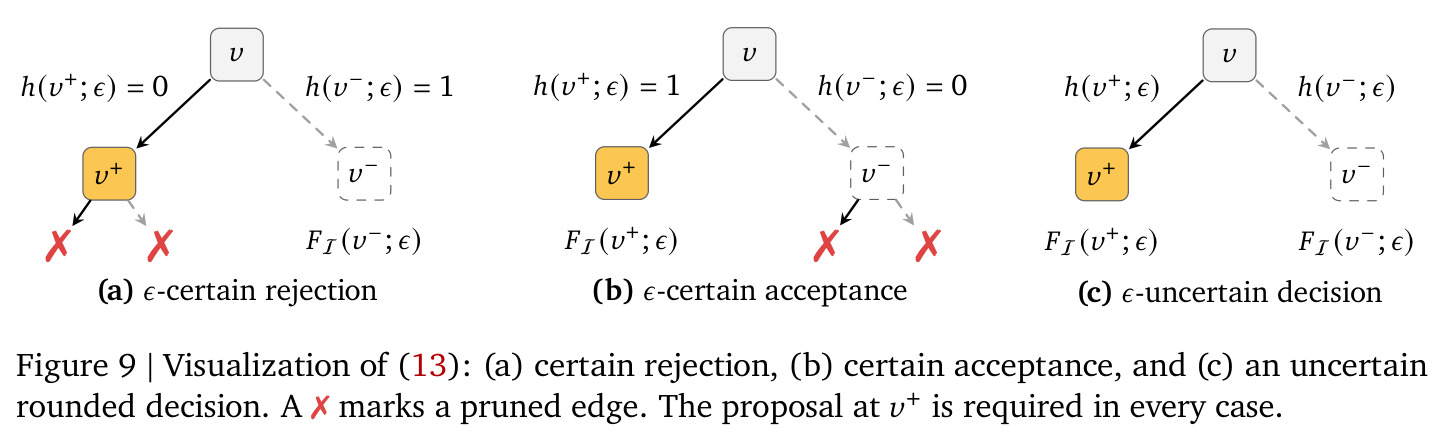
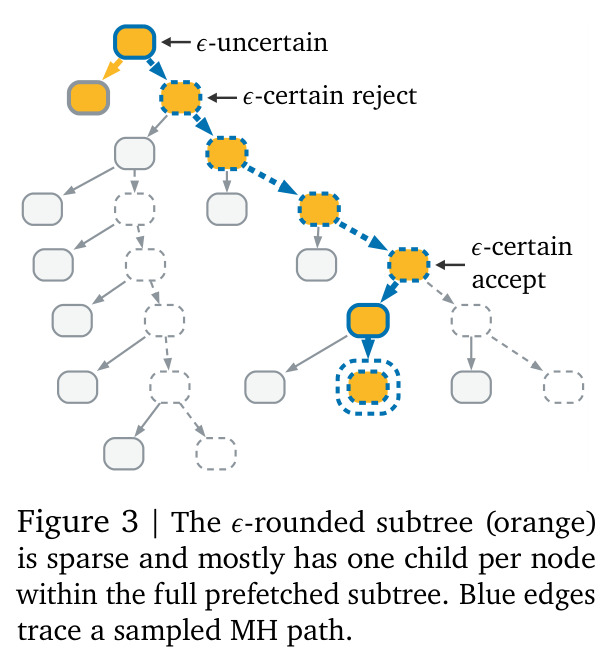
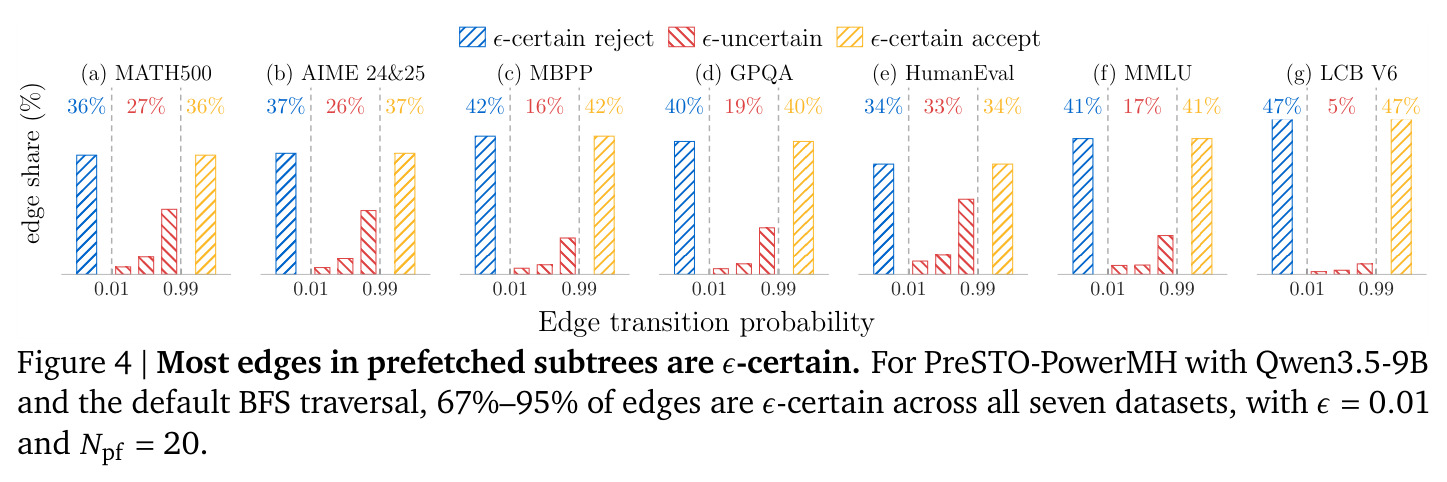
与已有工作不同的是,作者的独特切入点是把经典 MCMC 预取思想移植到 LLM 场景并做三处关键改造。其一,Brockwell (2006) 与 Angelino et al. (2014) 假设提议生成近乎免费、可以预取远超实际使用的候选;而 LLM 提议昂贵,必须把预取限制在预算 $N_{pf}$ 内的不规则子树上。其二,作者提出可行性条件(Condition 1):当接受子节点的切点 $c'$ 不超过父节点切点 $c$ 时,自回归分解保证该提议只依赖已缓存前缀 $x_{0:c'}$,可在真实状态确定前与其他提议同批生成且条件分布精确不变——这使预取在数学上是精确的而非近似。其三,作者观察到幂锐化目标使绝大多数 MH 决策接近确定(七个数据集上 67%–95% 的边在 $\epsilon=0.01$ 下 $\epsilon$-确定),真实链只会走一棵稀疏近一元子树,因此用三分类逻辑回归加动态规划的预测式遍历替代盲目等价扩展的 BFS。
核心方法
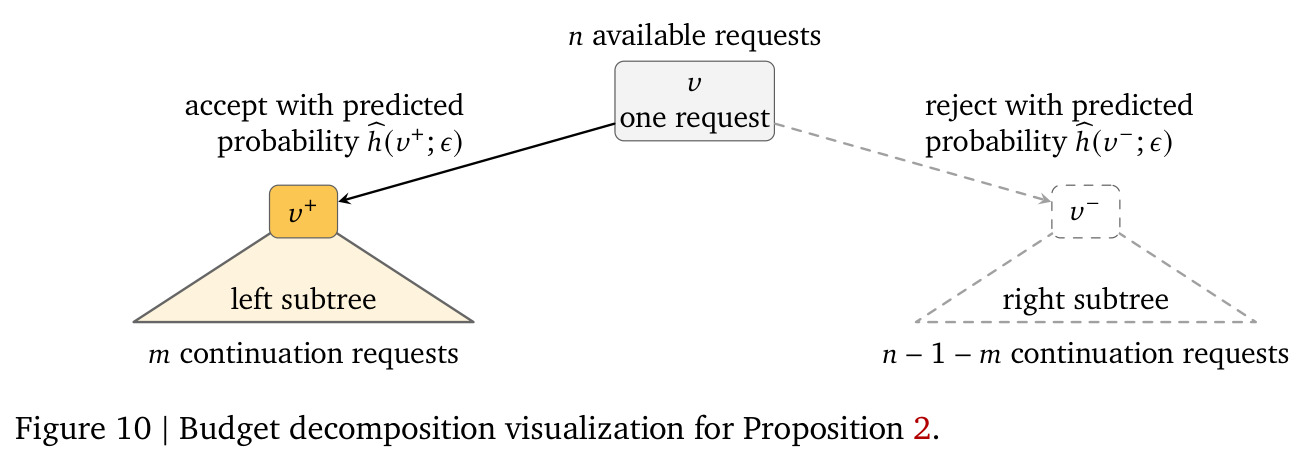
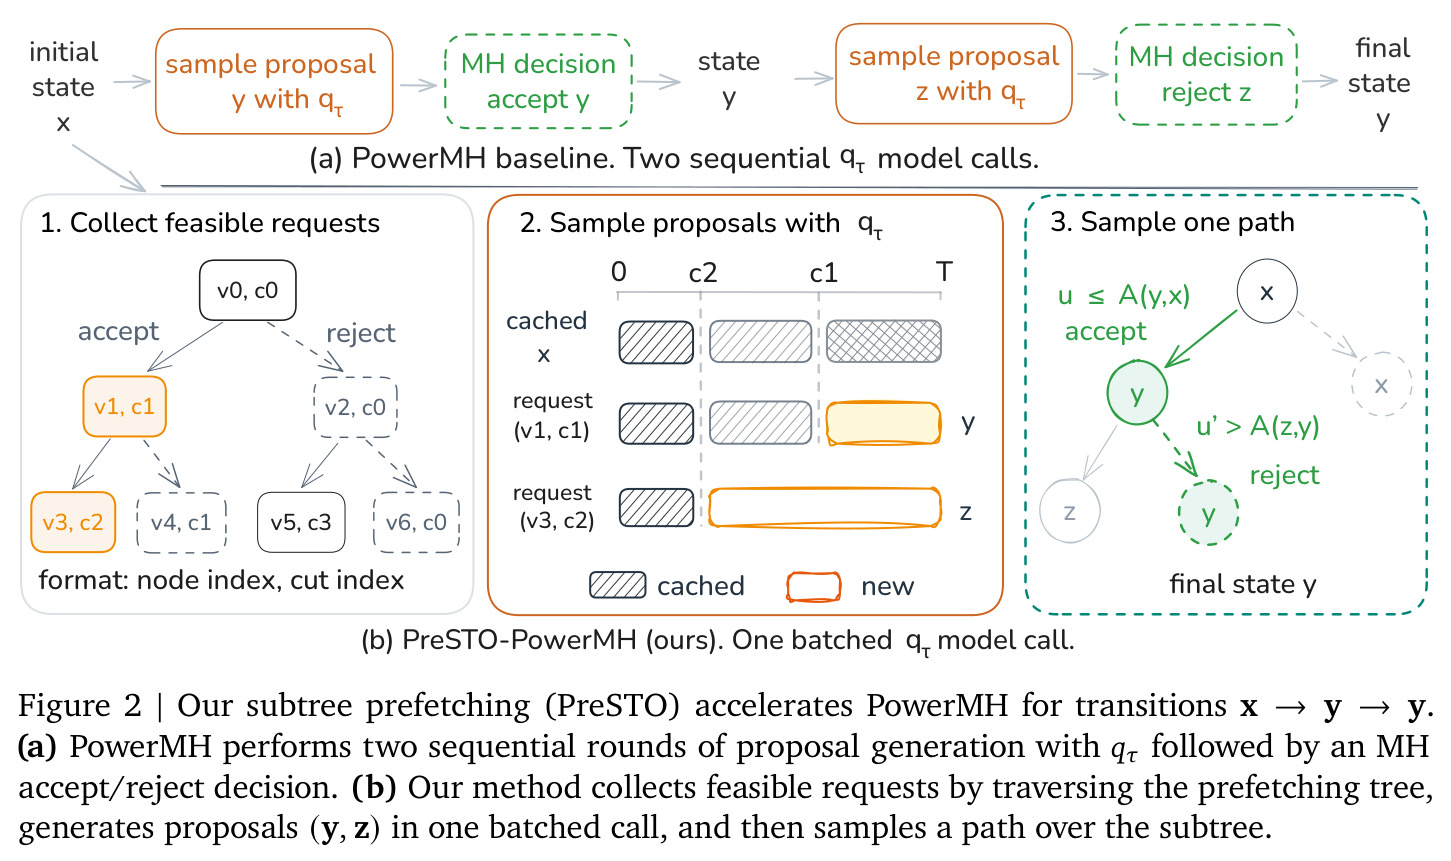
PreSTO 的直觉是:$K$ 步串行 MH 的所有可能未来构成一棵深度为 $K$ 的二叉树——每个节点的左分支对应接受提议、右分支对应拒绝,真实运行只是沿其中一条根到叶路径行进。既然提议生成后即可算出接受概率 $A(y,x)=\min\{1,\pi_\alpha(y)q_\tau(x|y)/(\pi_\alpha(x)q_\tau(y|x))\}$,就能提前把树中一段'可行'提议放在一次批量调用中全部生成,等随机数揭晓后沿实现路径免费完成多个转移。技术路线分三步:先用遍历规则(默认 BFS 或预测式)收集至多 $N_{pf}$ 个可行后缀重采样请求;再一次性提交给 vLLM/SGLang,利用前缀缓存共享重复前缀,返回后缀及 token 级对数概率并计算 $\log A$;最后从根出发按原始 MH 规则模拟路径,每轮完成 $k_\Delta\ge1$ 个转移。命题 1 证明 PreSTO-PowerMH 的转移核与 PowerMH 完全一致。
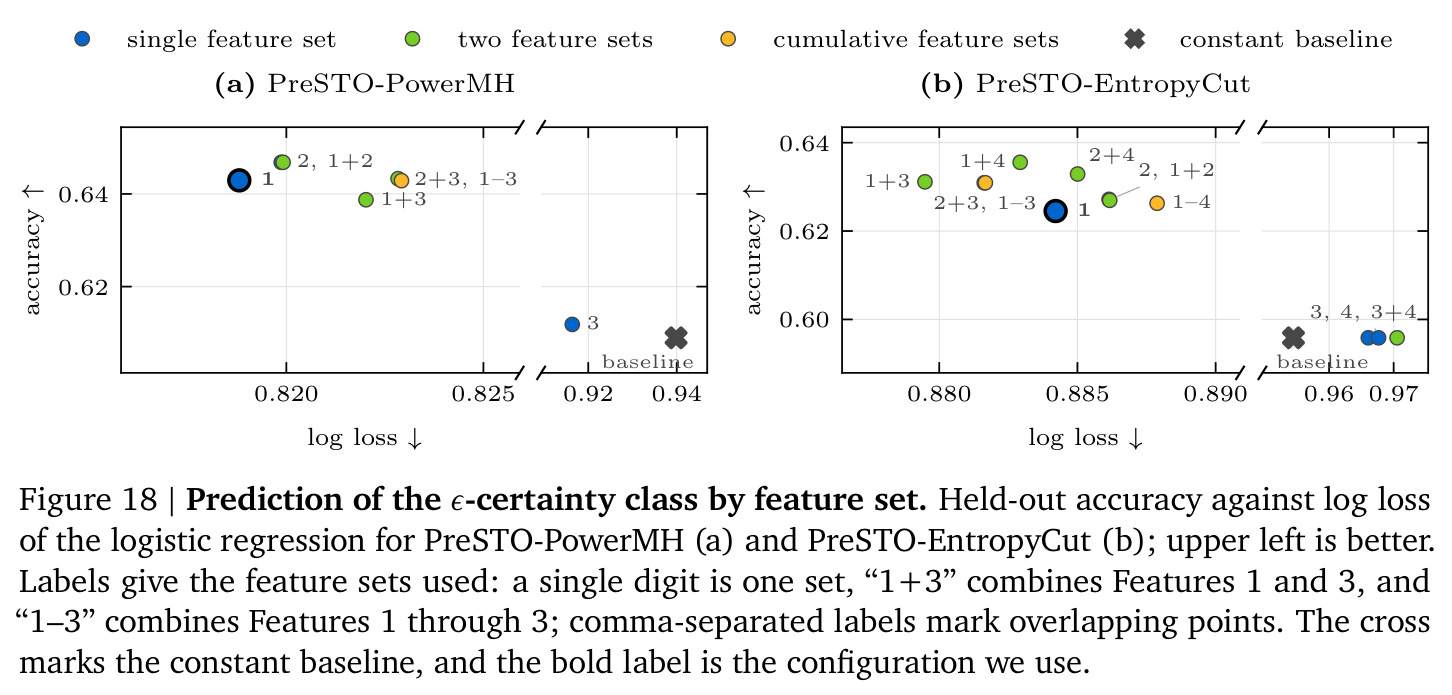
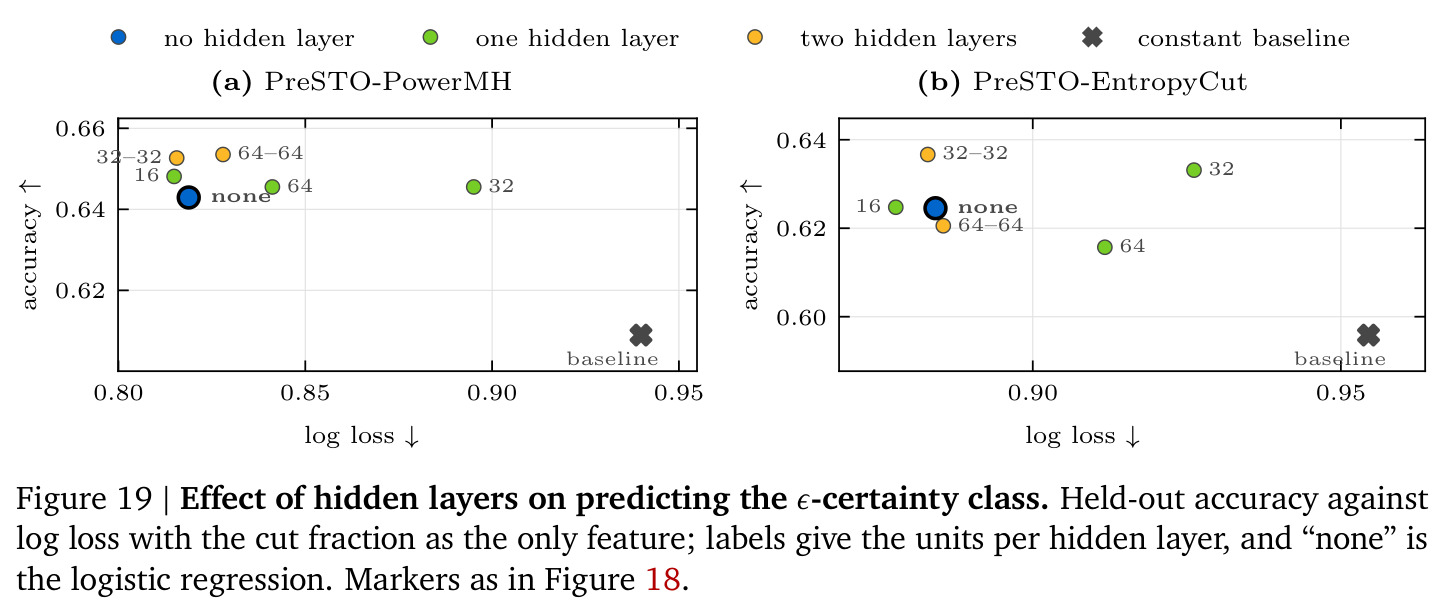
核心创新有两点。第一是可行性切点条件(Condition 1):切点为 $c$ 的状态 $x$ 经后缀重采样得到候选 $y=(x_{0:c},y_{c+1:T})$ 后,任何切点 $c'\le c$ 的后续提议 $z$ 满足 $q_\tau(z_{c'+1:T}|y_{0:c'})=q_\tau(z_{c'+1:T}|x_{0:c'})$,因为两者共享前缀 $x_{0:c'}$。这意味着父提议尚未被接受/拒绝时,子提议就可在同一批量调用中生成且分布精确不变——预取不引入任何近似,与树状推测解码(TreeSD)不同:分支是完整序列 MH 提议的接受/拒绝结果,沿实现路径走完即精确复现串行轨迹。第二是 $\epsilon$-圆整子树观察:目标 $\pi_\alpha\propto p_0^\alpha$ 放大高似然、压制低似然延续,使接受概率大多趋于 0 或 1——七个数据集上 67%–95% 的边在 $\epsilon=0.01$ 下确定。据此用以切点比例 $c_j/T$ 为特征的三分类逻辑回归预测确定性类别并转成分支概率,再用动态规划在预算 $N_{pf}$ 内选出预测完成转移数最大的请求集合(Lemma 1),替代等价对待所有节点的 BFS。
方法步骤详情
以块内 $K$ 步 MH 为单位。输入:当前状态 $x_{0:L}$($L=(\ell-1)B$)、提议分布 $q_\tau$、幂系数 $\alpha$、预算 $N_{pf}$。第一步'块扩展':用 $q_\tau$ 把 $x_{0:L}$ 延拓为 $x_{0:T}$($T=\ell B$)作为初始 MH 状态。第二步'收集请求':以根节点(切点 $c_0=T$)做遍历;为接受(左)子节点独立采切点 $c\sim\mathrm{Unif}\{0,\dots,T-1\}$ 并检查可行性 $c'\le c$,不满足则推迟并保留原切点;拒绝(右)子节点继承父状态、无需新提议;直到集满 $N_{pf}$ 个请求或树深达到 $K-k$。第三步'批量生成与打分':把请求一次性发给 vLLM/SGLang,共享前缀由前缀缓存复用,返回后缀及 $p_0,q_\tau$ 的 token 级对数概率,按式 (6) 计算每个节点的 $\log A$。第四步'树上转移':从根出发,在每个节点 $v$ 以概率 $A(v_+,v)$ 走左边、否则走右边,沿实现路径至多推进 $K-k$ 个转移,返回到达状态 $x_\Delta$ 与完成数 $k_\Delta$;被推迟的请求保留切点进入下一轮,循环直到 $k=K$。
技术新颖性
技术新颖性体现在三个层面。相对经典 MCMC 预取(Brockwell 2006;Angelino 2014;Ye & Lu 2024):他们假设提议近乎免费、可预取远多于使用的候选,或使用固定规模的规则多提议树;PreSTO 面向昂贵的 LLM 提议,构建受预算约束的不规则子树,用 Condition 1 筛选可行后缀请求并按预测到达概率分配预算。相对树状推测解码(TreeSD):TreeSD 的分支是草稿 token 的备选延续、由目标模型验证并提交前缀;PreSTO 的分支是完整序列 MH 提议的接受/拒绝结果,且每个被访问的扩展节点无论接受与否都推进链一步,'进度单元'完全不同。相对其他幂采样加速路线(SMC、近似目标、熵引导切点、改目标/训练):PreSTO 不动目标分布、后缀提议与 MH 接受规则,只改变提议生成与评估的调度,因此能证明转移核不变(命题 1),并可通过 TOST 等价检验实证输出一致——这是'系统级加速'而非'算法替换'。预测式遍历则进一步把经验观察($\epsilon$-确定性)转化为可用动态规划求解的预算分配问题。
实验结果
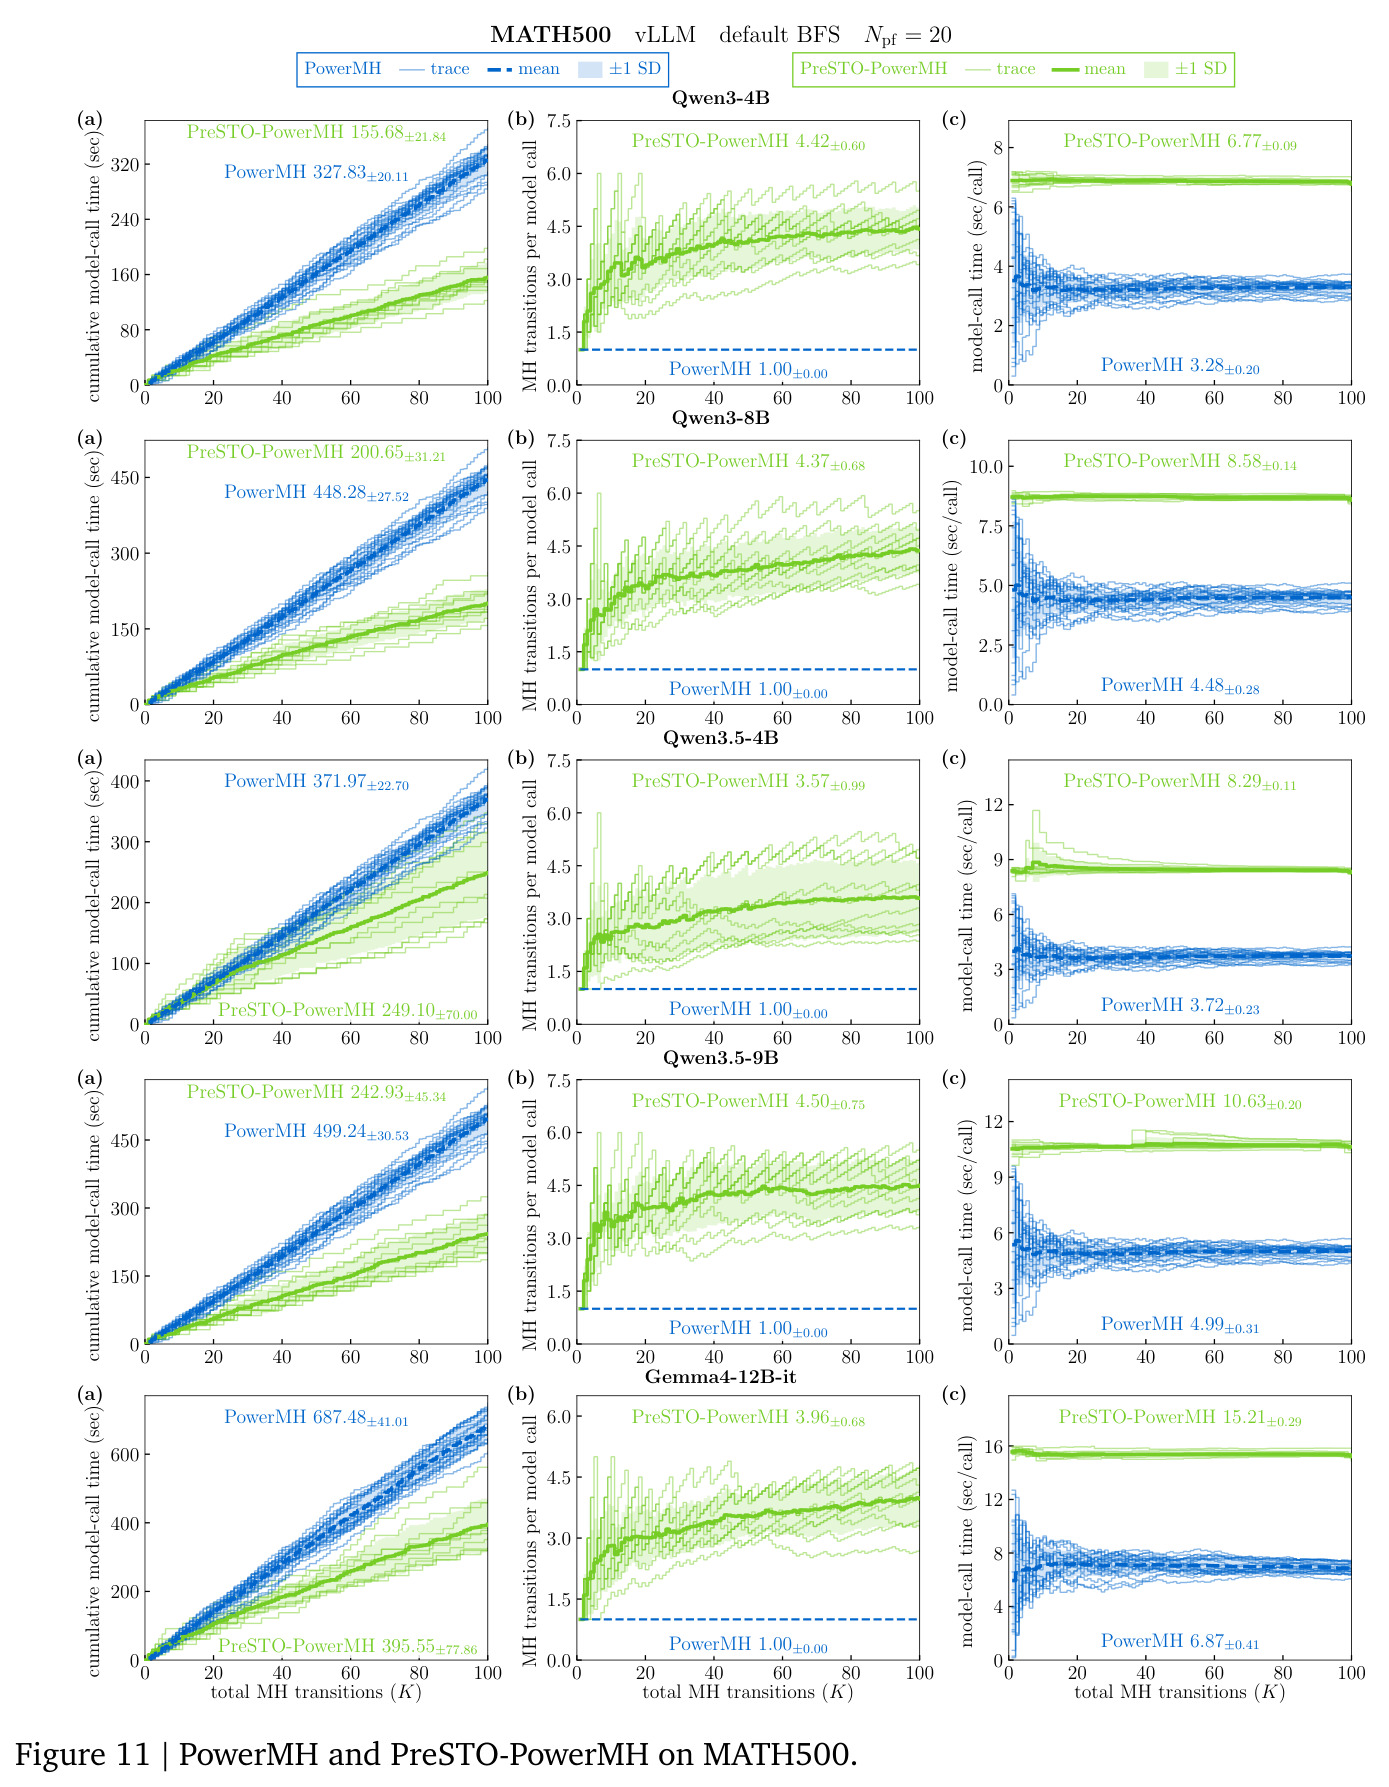
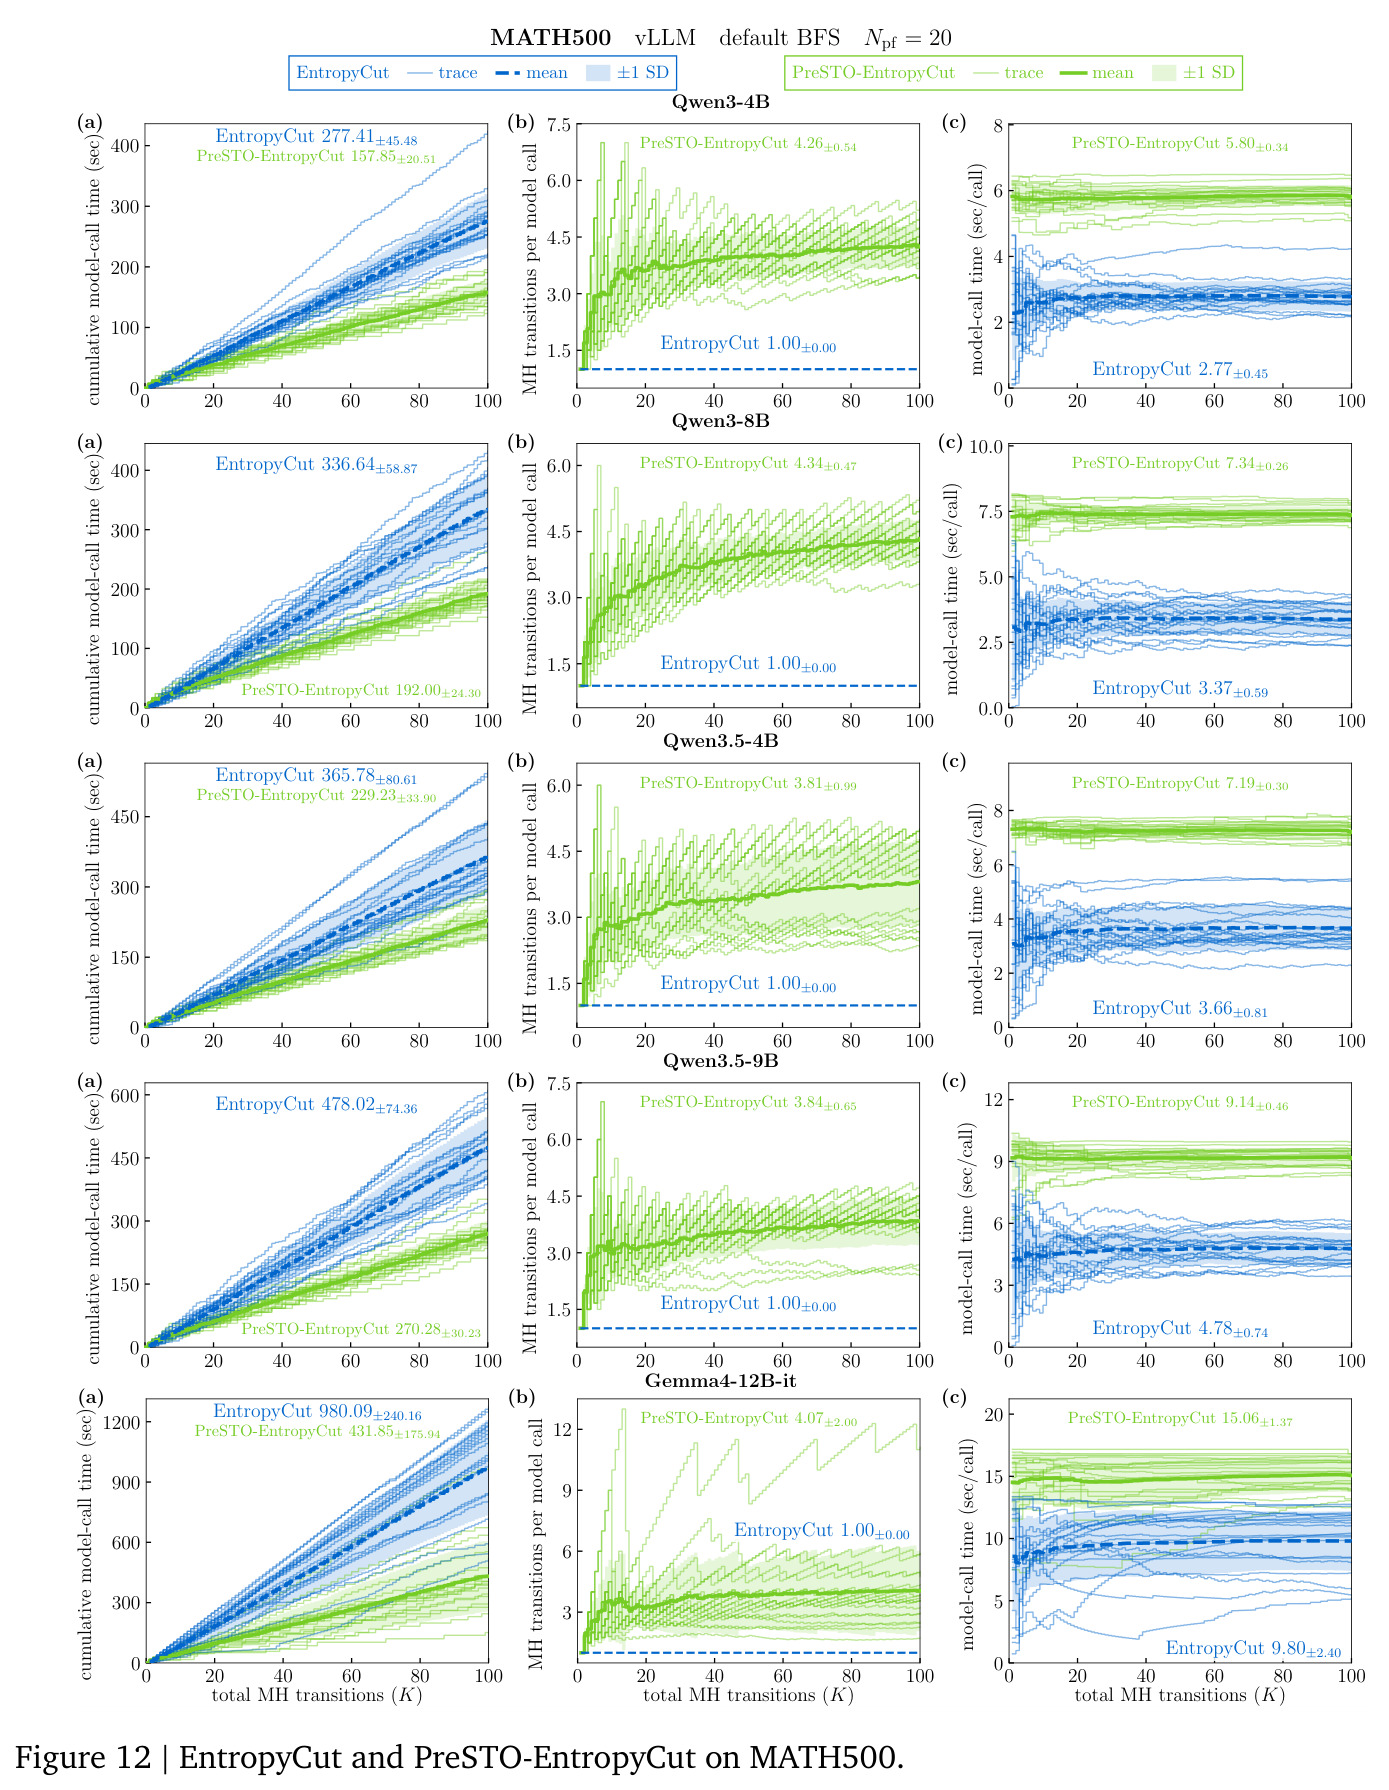
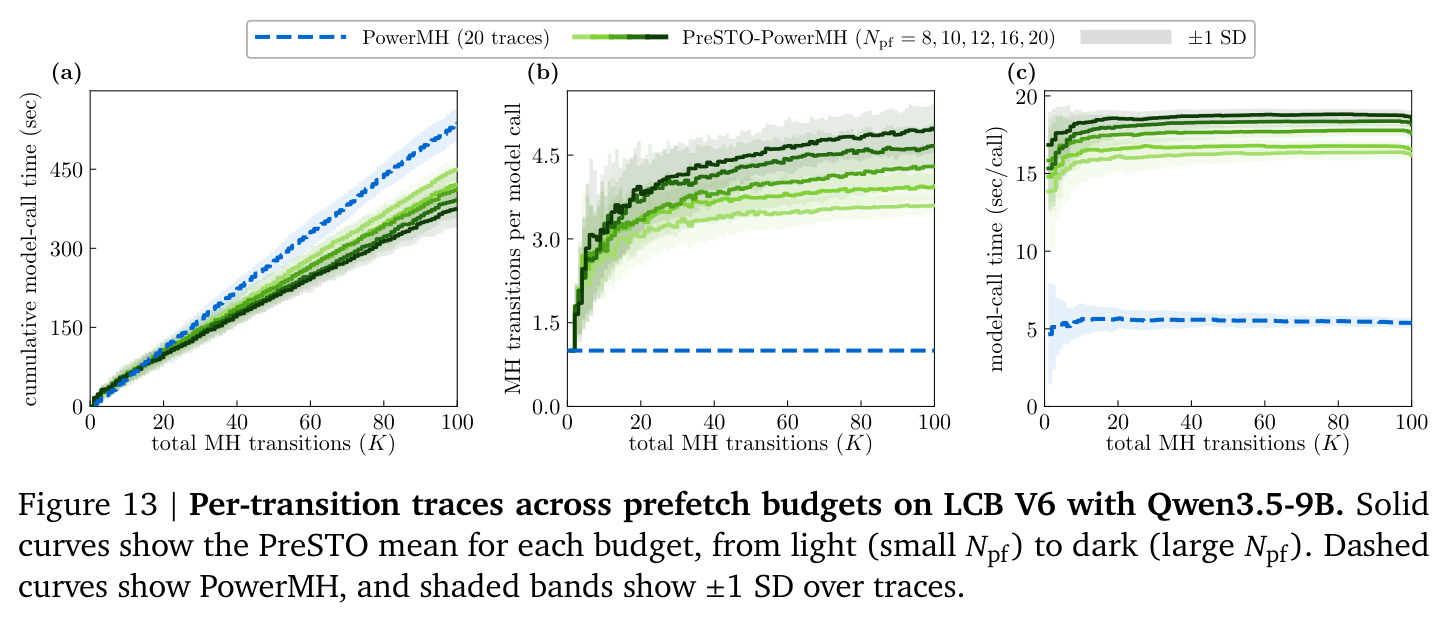
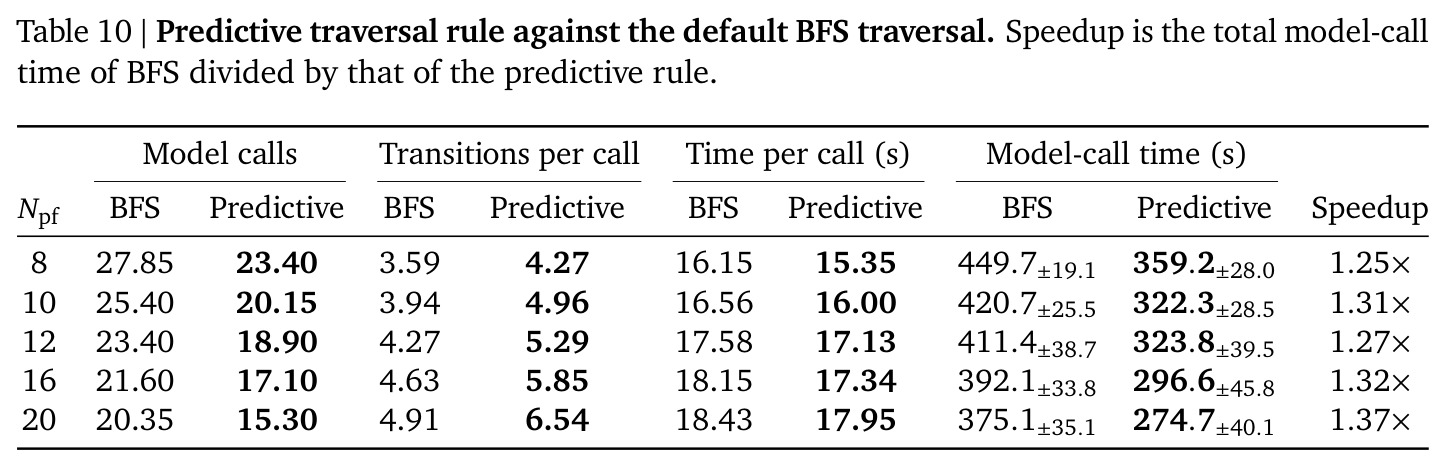
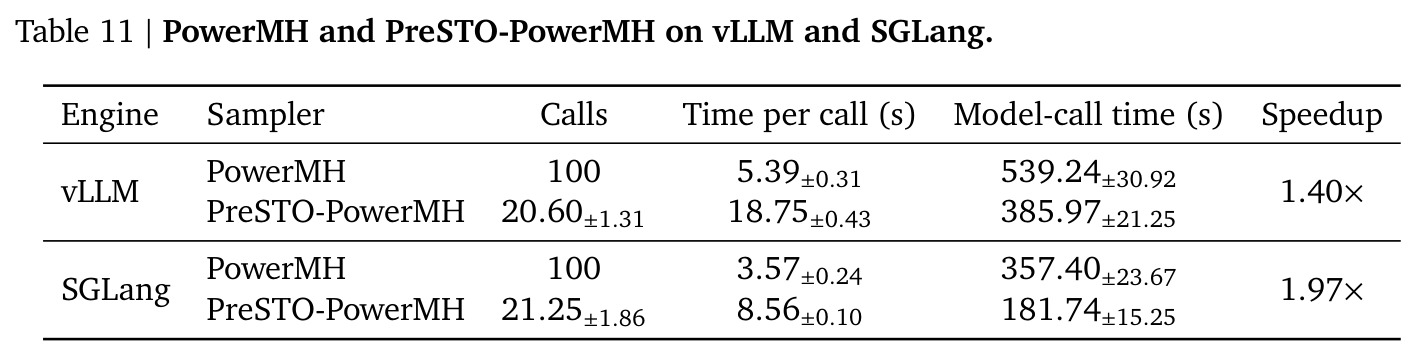
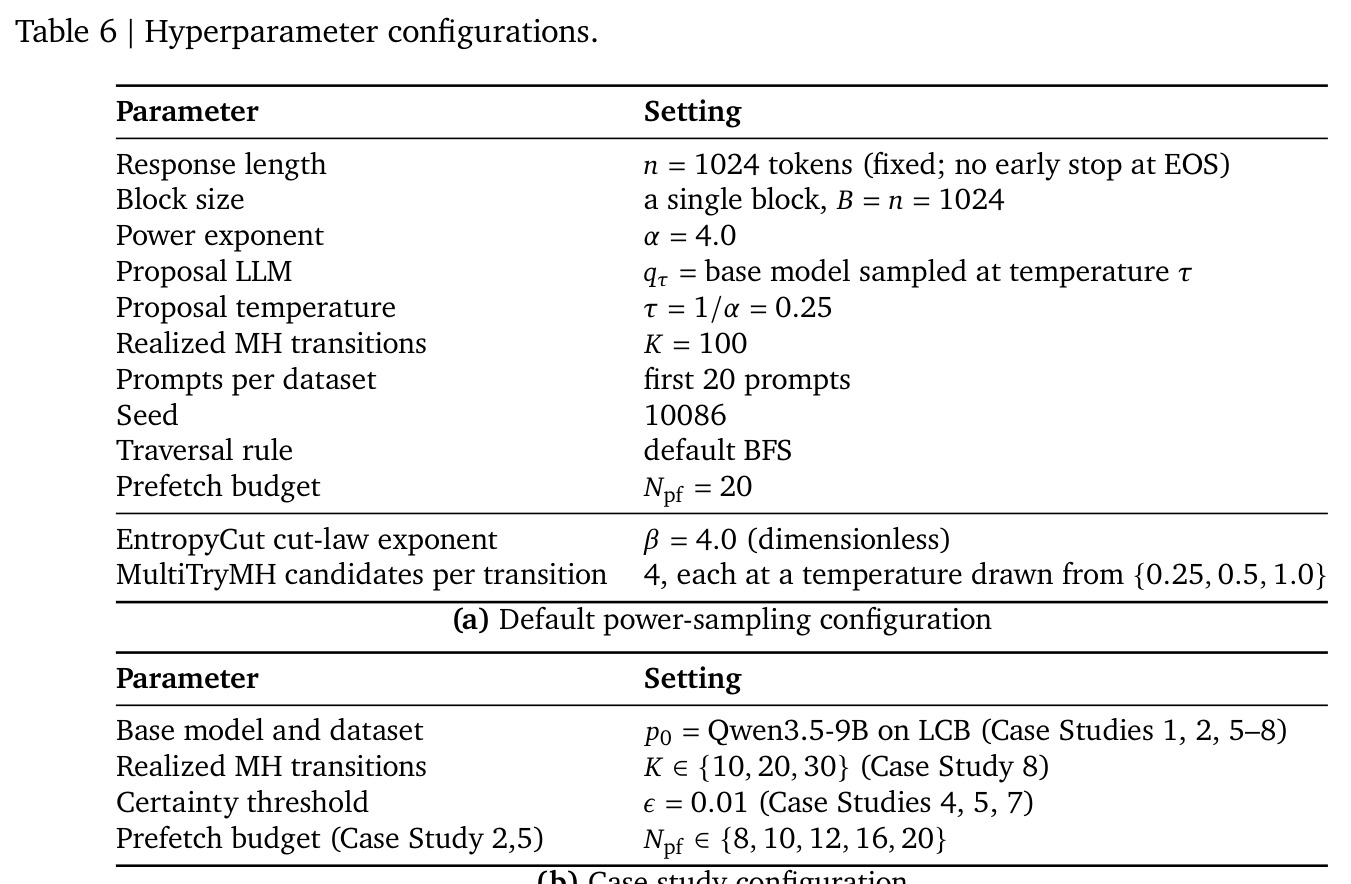
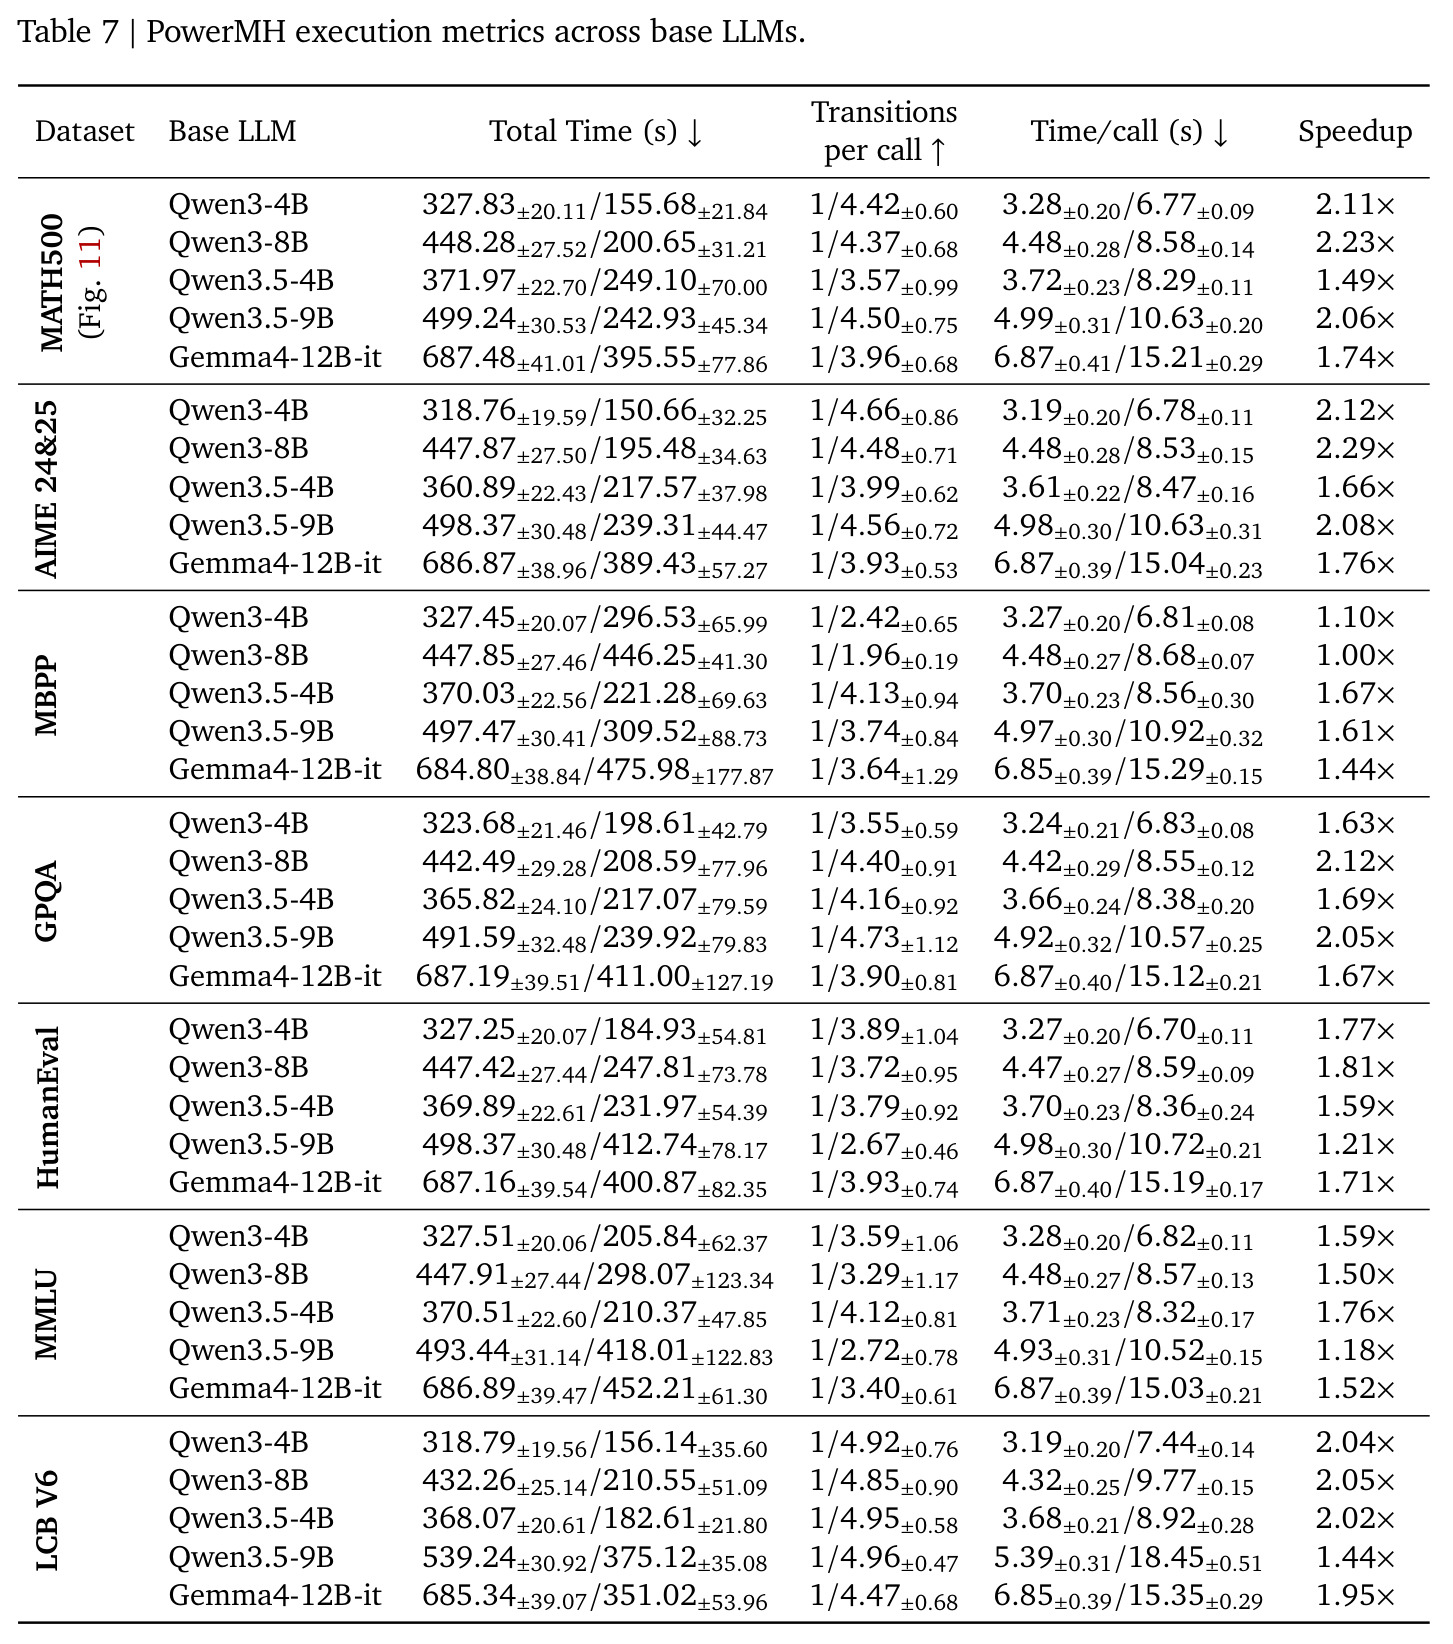
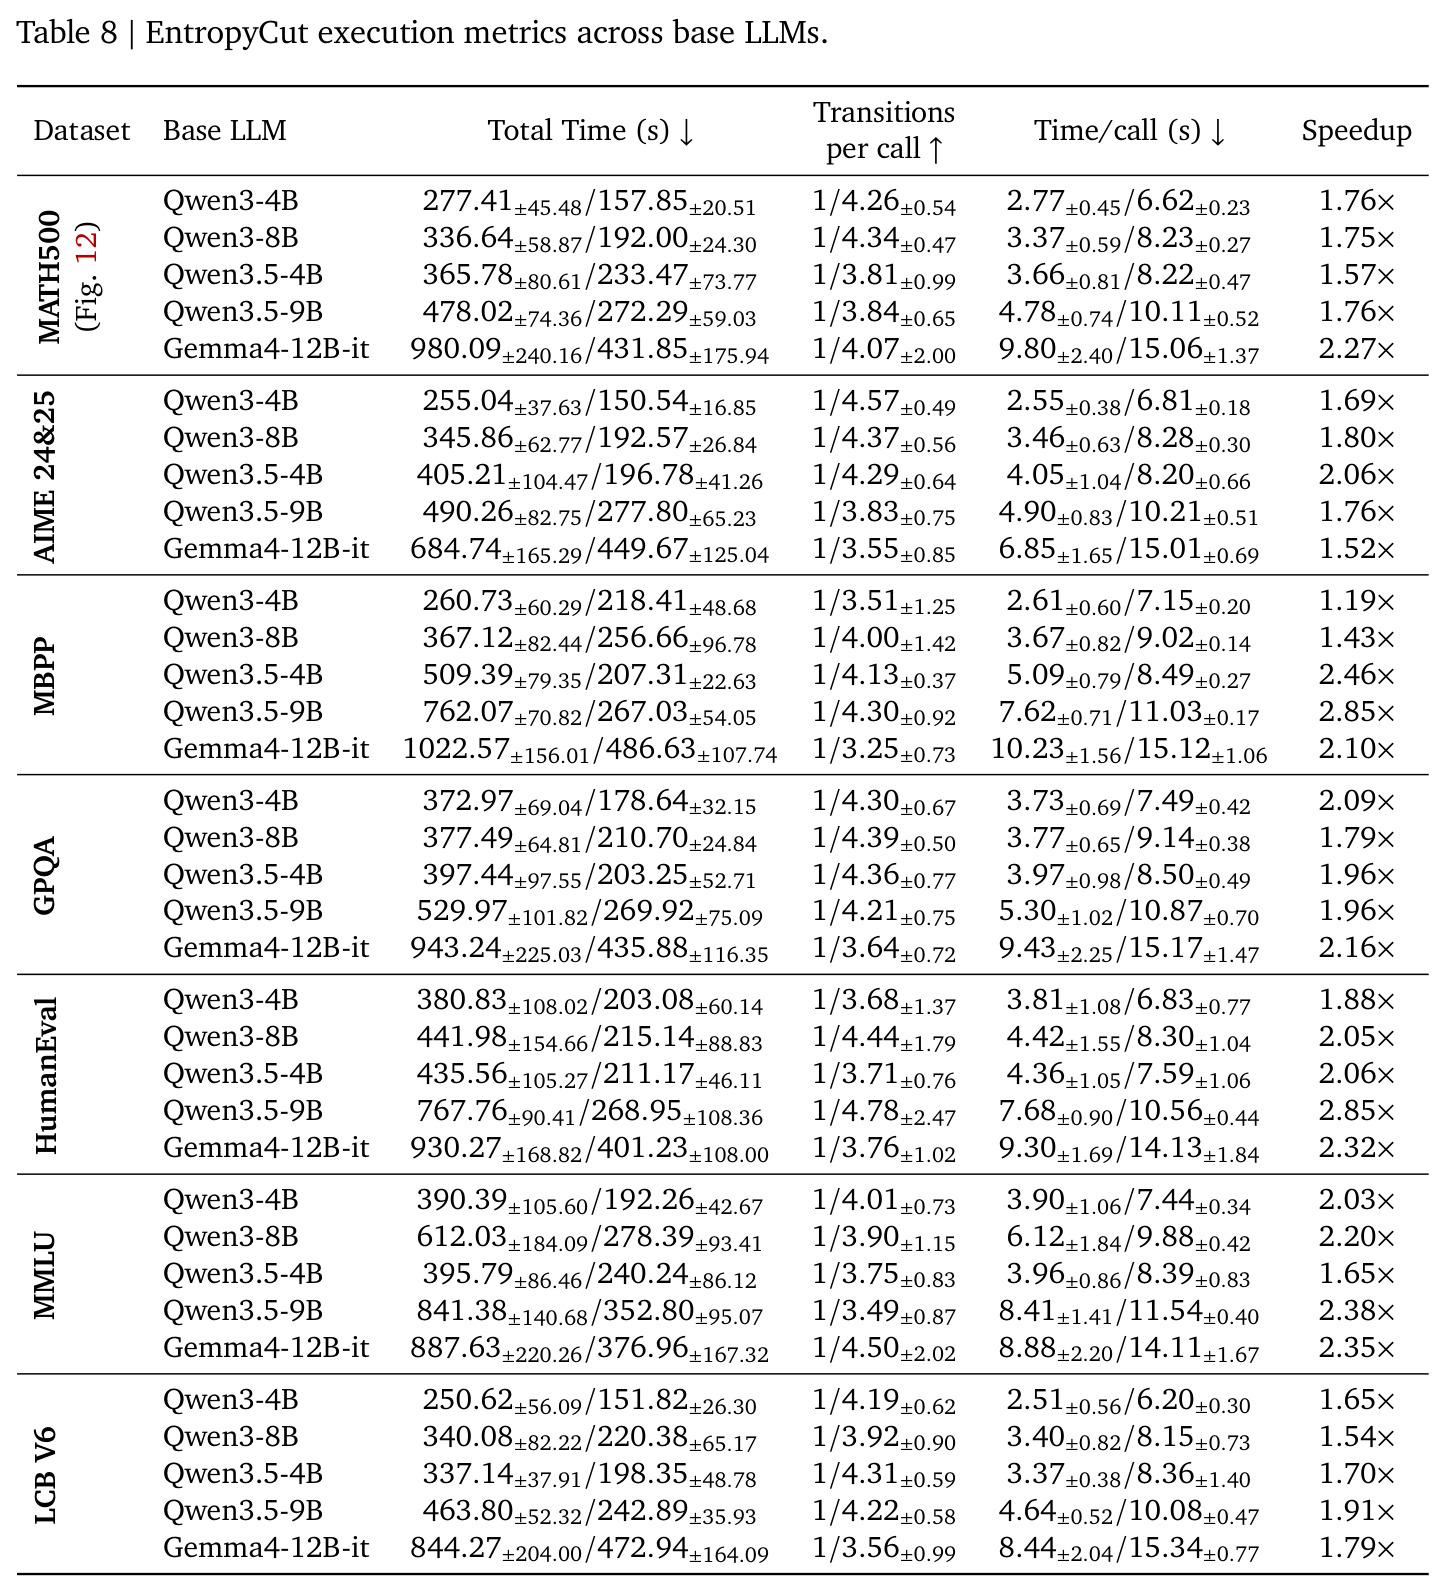
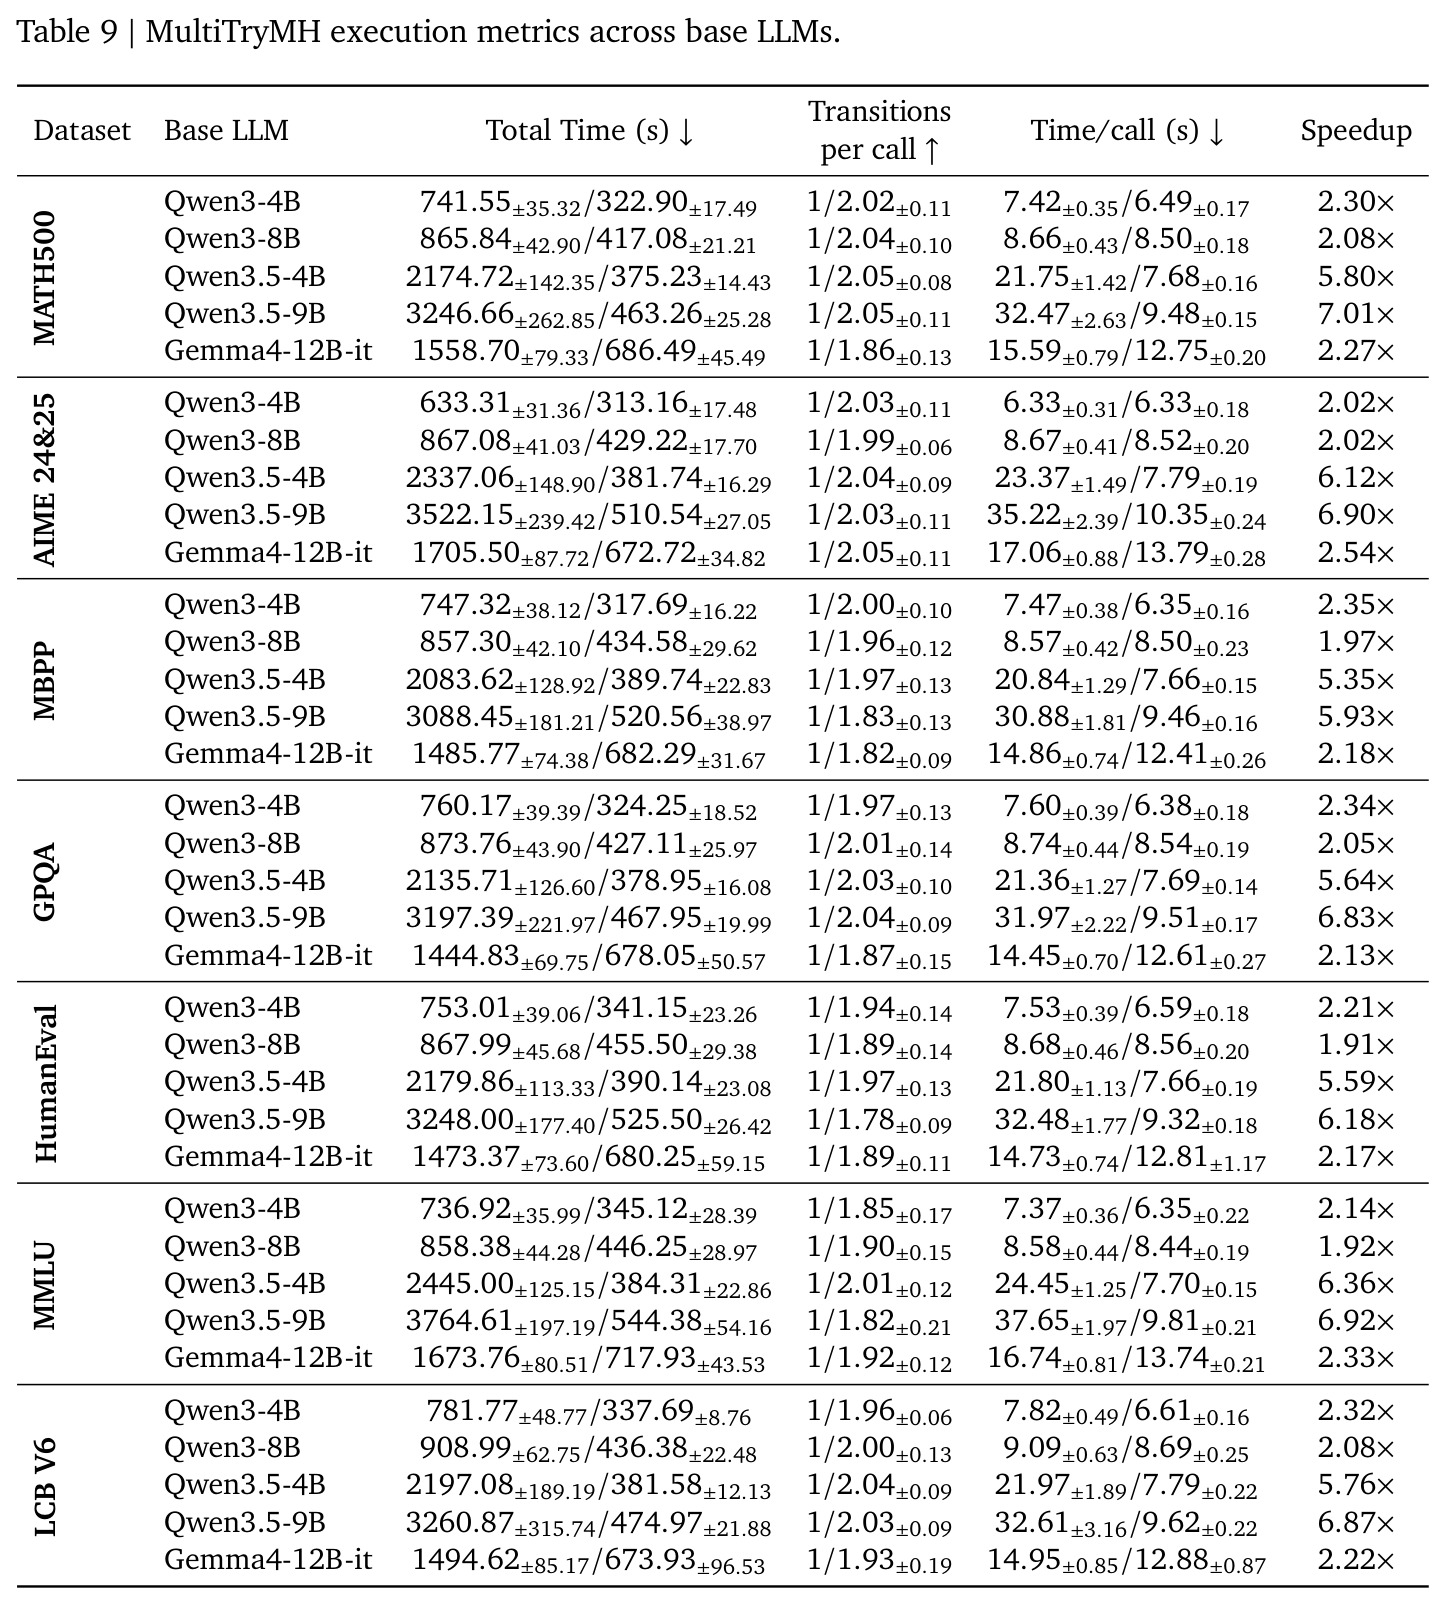
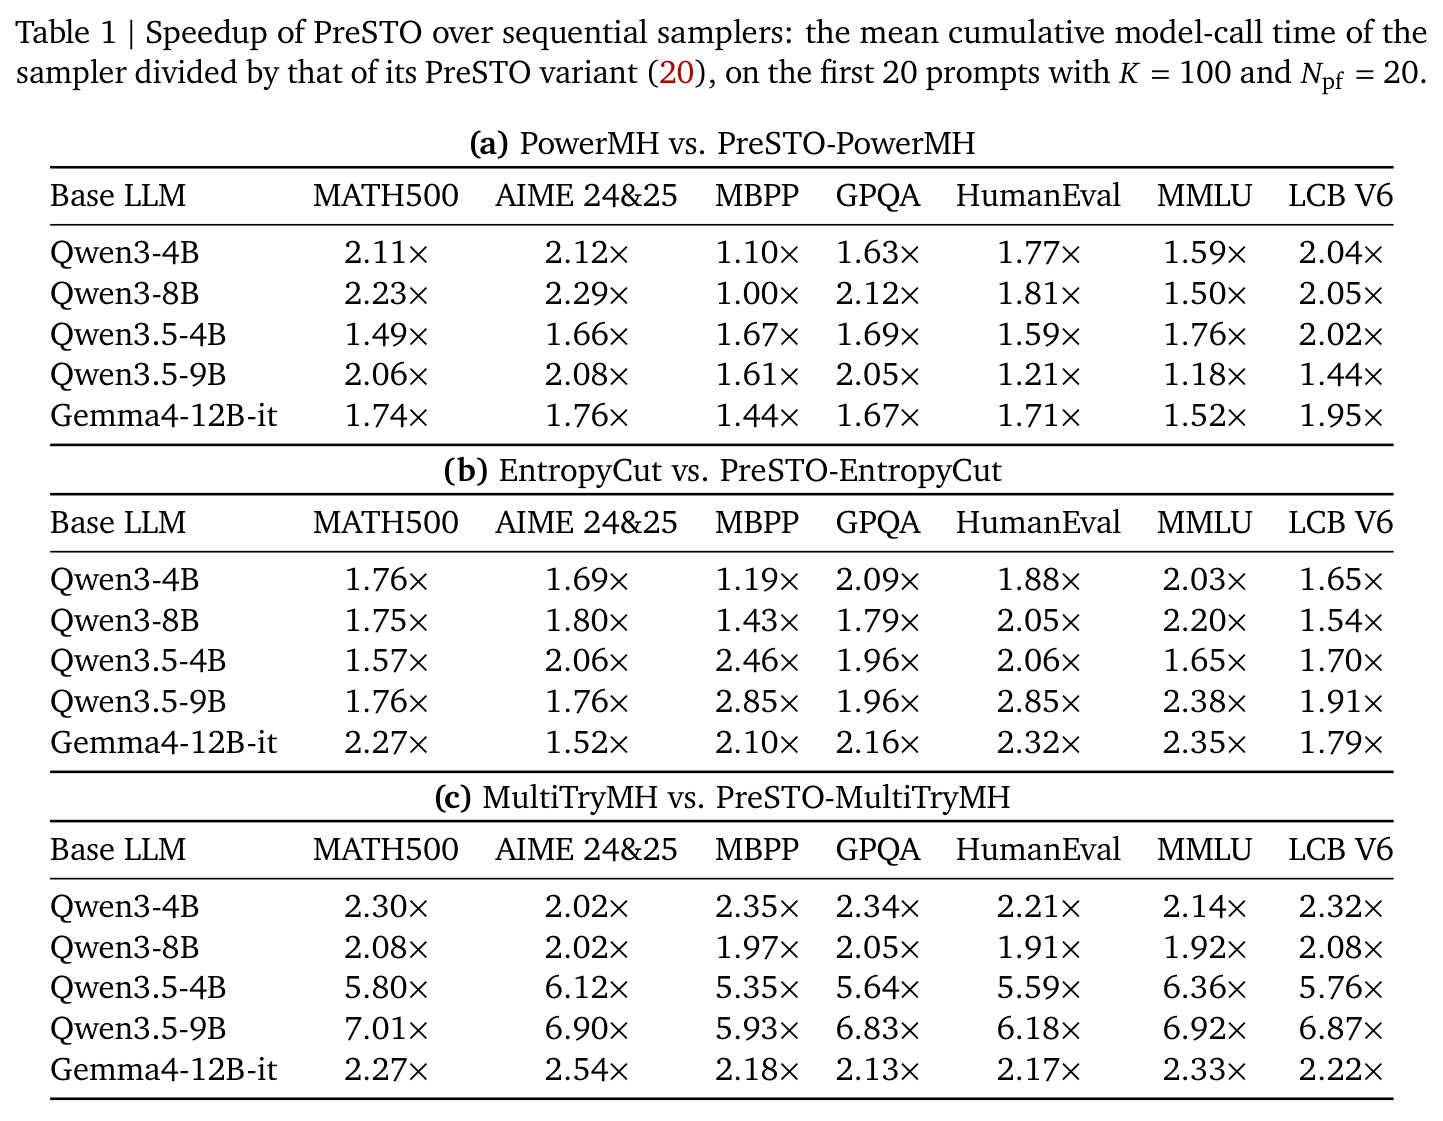
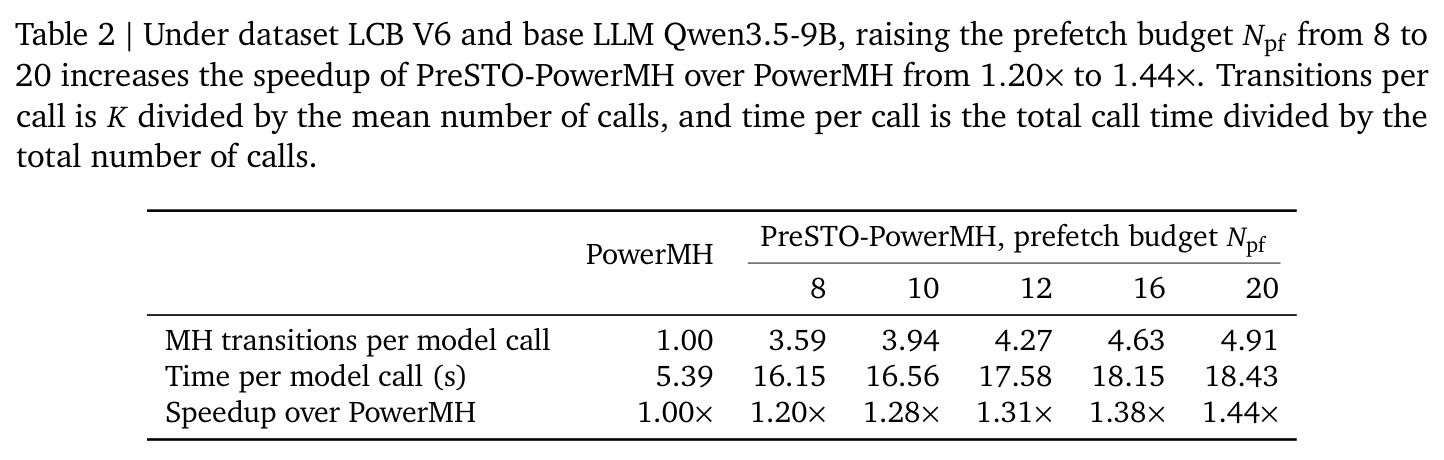
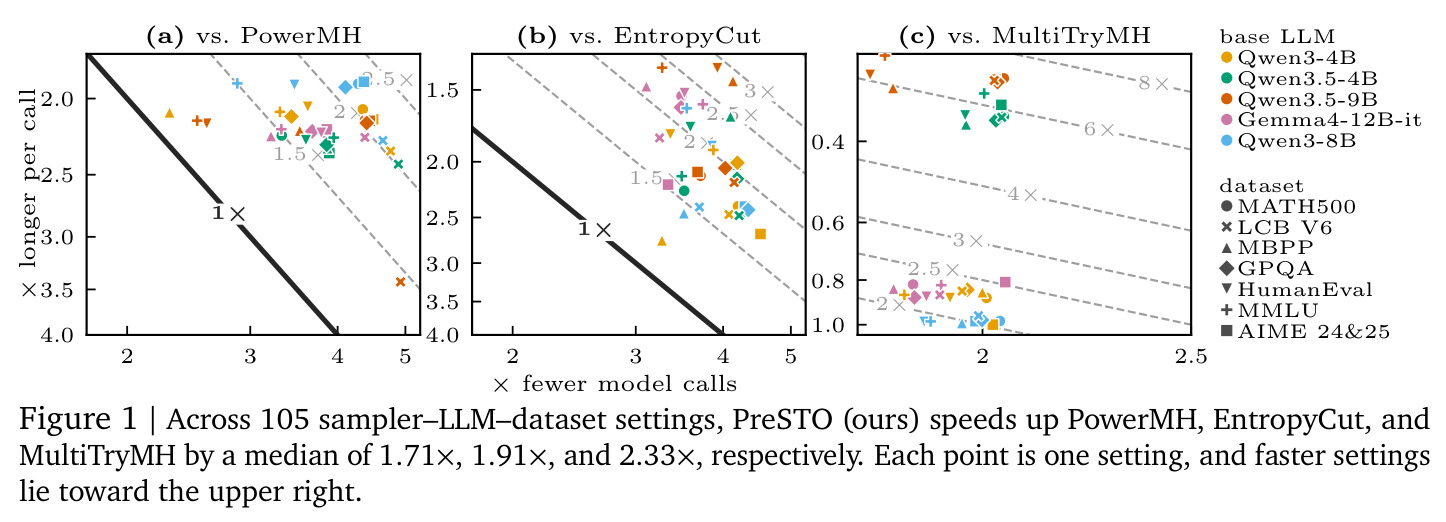
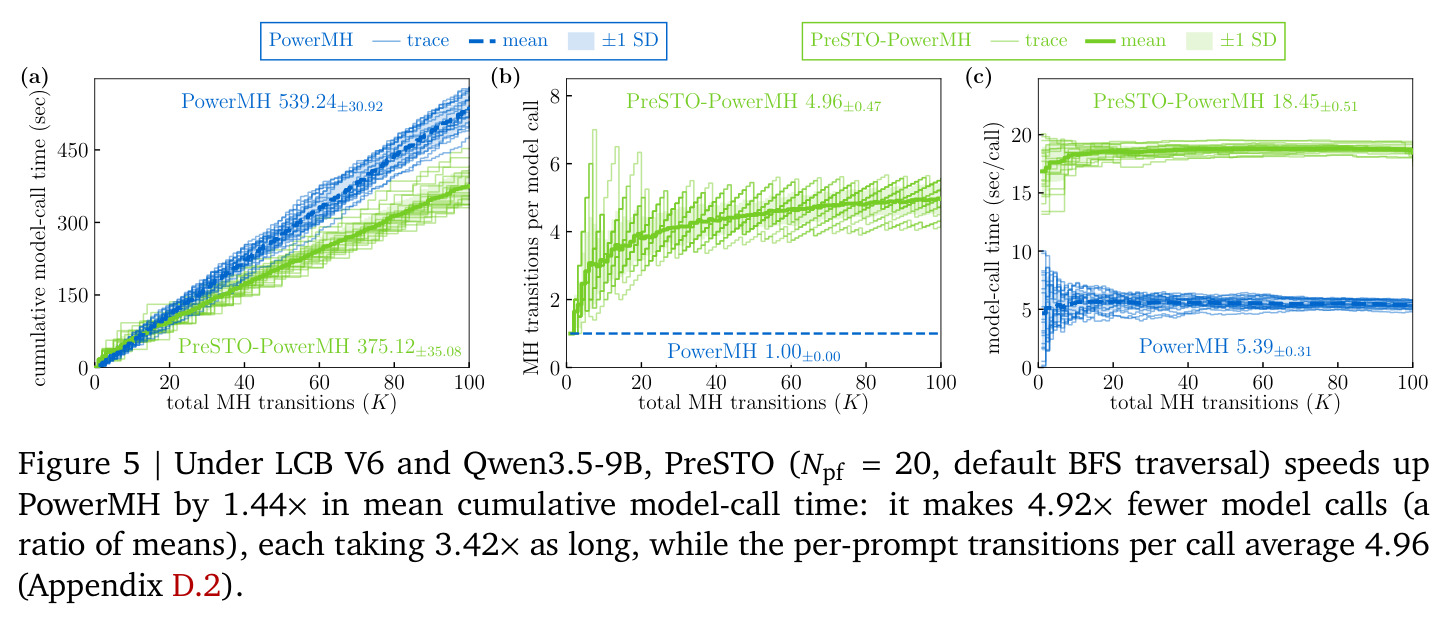
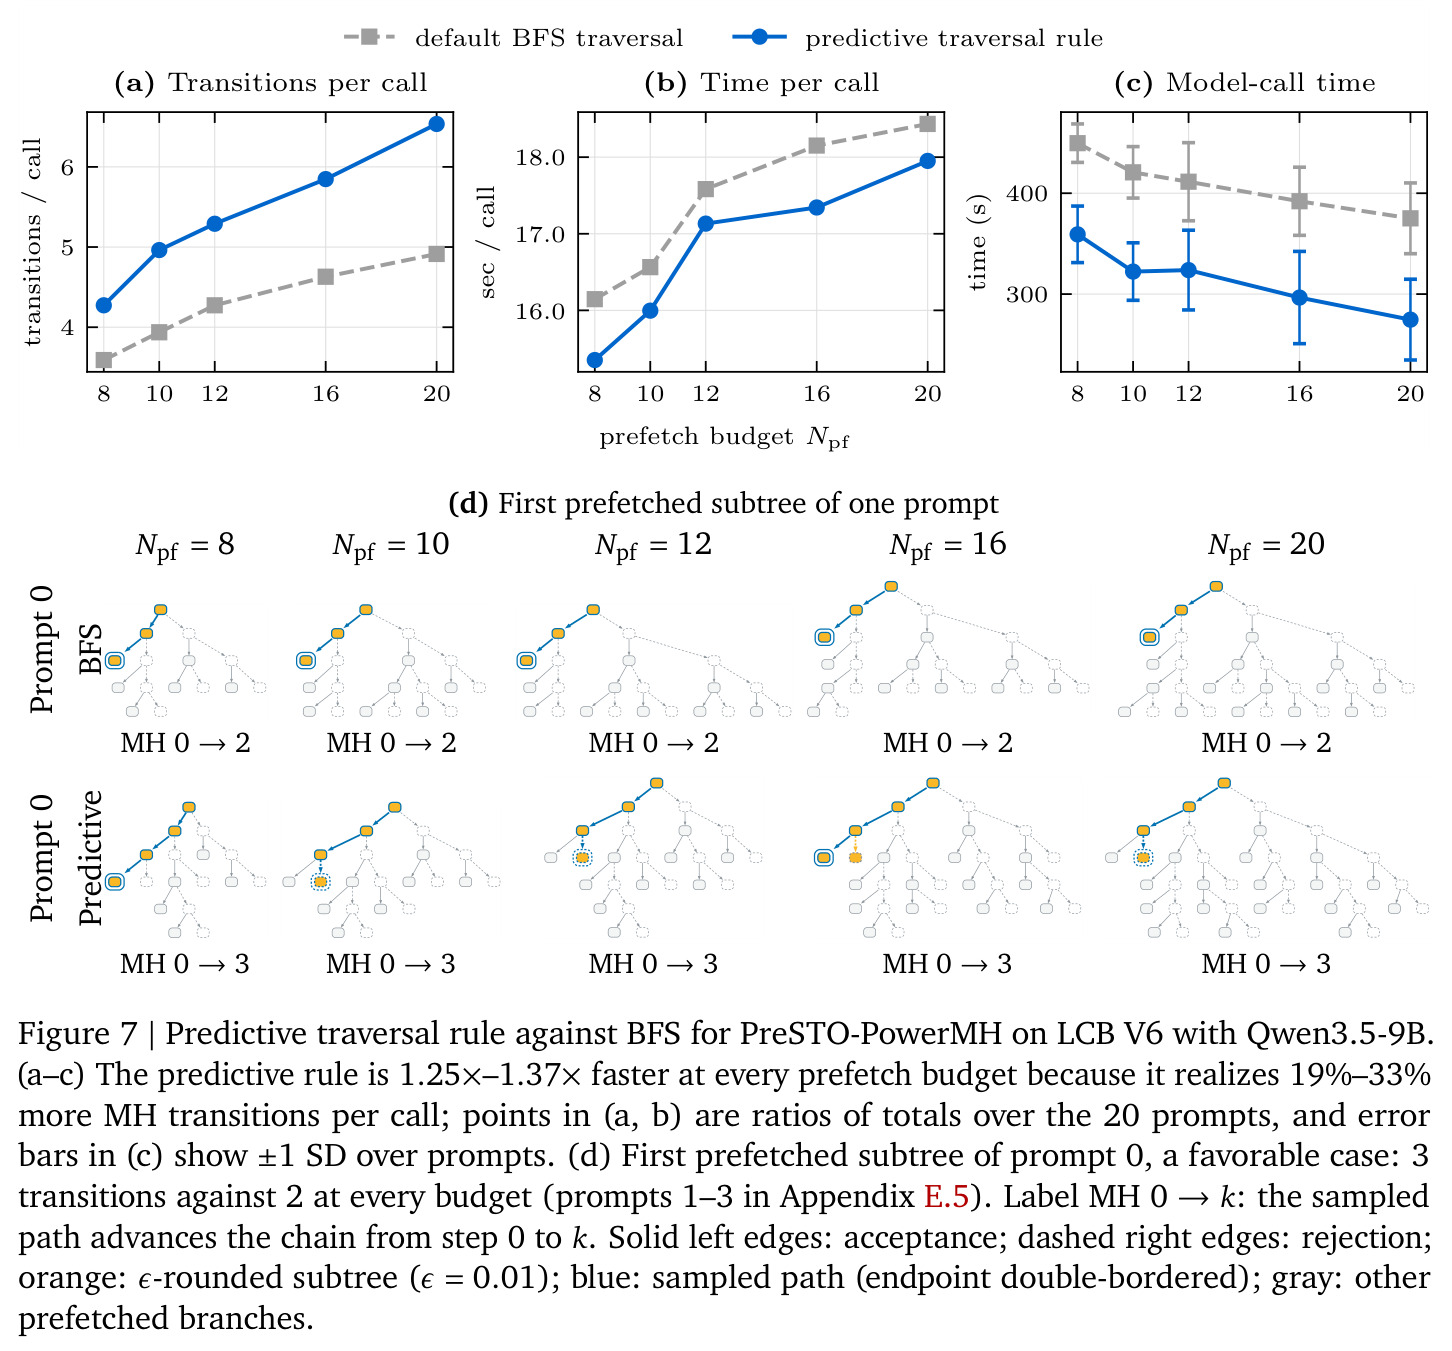
论文在 3 个采样器 × 5 个基座 LLM × 7 个数据集共 105 个设置上评测($K=100$、每数据集 20 个 prompt、1024 token 单块)。(1) 主结果:PreSTO 中位数加速 1.71×(对 PowerMH,范围 1.00×–2.29×)、1.91×(对 EntropyCut,1.19×–2.85×)、2.33×(对 MultiTryMH,1.91×–7.01×),无一慢于基线,96 个设置至少 1.5×;对 MultiTryMH 的部分增益来自复用对数概率的实现改进。(2) 案例 1(LCB V6 + Qwen3.5-9B):完成 $K=100$ 转移耗时 375.12±35.08 秒 vs PowerMH 的 539.24±30.92 秒(1.44×),每调用完成 4.96±0.47 个转移,单次调用 18.45±0.51 秒 vs 5.39±0.31 秒;调用次数减少贡献加速方差的 95%($R^2=0.78$)。(3) 案例 2:预算 $N_{pf}$ 从 8 升到 20,每调用转移从 3.59 升至 4.91,加速从 1.20× 升至 1.44×。(4) 案例 3:TOST 等价检验(0.2 SD 边际)在 Qwen3.5-4B 上 7/10 通过,汇总 38 个比较 29 个通过($p_{eq}<0.001$)。(5) 案例 4:$\epsilon$-确定边占比 Qwen 系 56%–95%、Gemma4-12B-it 67%–78%。(6) 案例 5:预测式遍历在所有预算下比 BFS 快 1.25×–1.37×,$N_{pf}=20$ 时每调用转移从 4.91 升至 6.54。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PowerMH 加速(5 LLM × 7 数据集,105 设置之一) | 累计模型调用时间加速比(中位数) | PreSTO-PowerMH 1.71×(范围 1.00×–2.29×) | PowerMH(串行 MH) | 1.71× 中位加速,105 个设置全部不慢于基线,96 个 ≥1.5× |
| EntropyCut 加速 | 累计模型调用时间加速比(中位数) | PreSTO-EntropyCut 1.91×(最高 2.85×,MBPP/HumanEval + Qwen3.5-9B) | EntropyCut(熵引导切点) | 1.91× 中位加速 |
| MultiTryMH 加速 | 累计模型调用时间加速比(中位数) | PreSTO-MultiTryMH 2.33×(Qwen3.5-9B 上最高 7.01×) | MultiTryMH | 2.33× 中位加速(部分来自复用对数概率的实现改进) |
| 预测式遍历 vs 默认 BFS(LCB V6 + Qwen3.5-9B) | 累计模型调用时间 | 快 1.25×–1.37×,每调用转移数提升 19%–33%($N_{pf}=20$ 时 4.91→6.54) | 默认 BFS 遍历 | 全部 5 个预算均更快,100 个 prompt-预算对中 98 个获胜 |
| 输出分布等价性(对数似然/置信度) | 配对 TOST 等价检验通过数(0.2 SD 边际) | 38 个比较中 29 个等价($p_{eq}<0.001$) | 对应串行采样器(PowerMH/EntropyCut) | 支持转移核不变的主张 |
局限与改进
作者承认并可观察到的局限:(1) PreSTO 用更少但更贵的调用换加速——单次调用中位变长约 2.1×(案例 1 中 18.45 秒 vs 5.39 秒),净收益依赖服务引擎的前缀缓存复用,缓存效率低的后端上收益会缩水。(2) 当每调用实际完成的转移少时加速变小:五个低于 1.25× 的设置中四个(MBPP 两个 Qwen 模型、HumanEval 与 MMLU 的 Qwen3.5-9B)每调用仅完成 1.96–2.72 个转移而成本约 2×;LCB V6 单次调用 18 秒,远高于其他六个数据集的 10.5–10.9 秒。(3) 等价性检验并非全部通过:38 个比较中 29 个通过,AIME 两个统计量与 MATH500 置信度等 9 项未建立等价。(4) 预算收益递减:$N_{pf}$ 从 8 到 20 加速仅从 1.20× 到 1.44×,因为预取的提议无论是否被走到都要生成。(5) 实验规模有限:每数据集 20 个 prompt、单种子、1024 token 单块,主文未报告下游任务准确率对齐;默认 BFS 仍对推迟节点下方的不可达分支浪费约 19% 的请求(附录 E.7)。
独立分析的弱点
独立分析可见的弱点:(1) 默认 BFS 遍历存在结构性浪费——对推迟请求的子树仍会生成并打分约 19% 永远不会被 MH 走到的请求($N_{pf}=10$,LCB V6 + Qwen3.5-9B),应把预测式规则设为默认,或在收集阶段直接剪掉推迟节点的后代。(2) 确定性预测器仅用切点比例 $c/T$ 一个特征的三分类逻辑回归,表达能力有限;加入后缀熵、token 位置、块内进度、历史接受率等特征或换用梯度提升模型,可能进一步压低误判率并在更大预算下保持优势。(3) 加速对前缀缓存命中率敏感,论文未提供自适应机制:可按实测命中率动态调节 $N_{pf}$,在缓存收益差的设置自动退回小预算或串行模式。(4) 预取深度对所有 prompt 统一,而 $\epsilon$-不确定边比例随数据集在 5%–47% 间波动(LCB V6 仅 5%、MBPP 16%),按不确定比例自适应分配深度比统一预算更优。(5) 理论上只证明了核不变,未量化有限批量下的方差或遍历性差异;$\epsilon$-确定性与 $\alpha$、块大小 $B$ 的关系也缺理论刻画,可补充稳定性分析。
未来方向
论文提出的与可延伸的方向:(1) 把 PreSTO 推广到其他 MH 型 LLM 采样器与并行多链场景——预取树天然适合与副本交换、SMC 组合,用同一批调用同时服务多条链。(2) 预测器在线学习:用运行中真实接受/拒绝结果持续更新分支概率模型,替代静态逻辑回归,并研究 $\epsilon$-确定性随 $\alpha$、$B$、模型规模的变化规律,给出预算的理论最优解。(3) 服务引擎协同设计:为共享前缀的推测请求设计调度与显存策略(论文指出 KV 缓存额外开销不超过预分配池的 3.1%),或与投机解码统一到同一批量框架。(4) 更大规模与下游指标验证:在更长回复、多块生成($n>1024$)以及真实任务准确率(MATH/GPQA 正确率)上确认分布不变带来性能对齐。(5) 与蒸馏/训练路线互补:PreSTO 是纯推理侧加速,与 Tomihari & Sato (2026) 等训练侧方案正交,可叠加使用。(6) 自适应预取:按每 prompt 的不确定边比例与实测缓存命中率动态调整 $N_{pf}$ 与树深,进一步压低低收益设置的成本。
复现评估
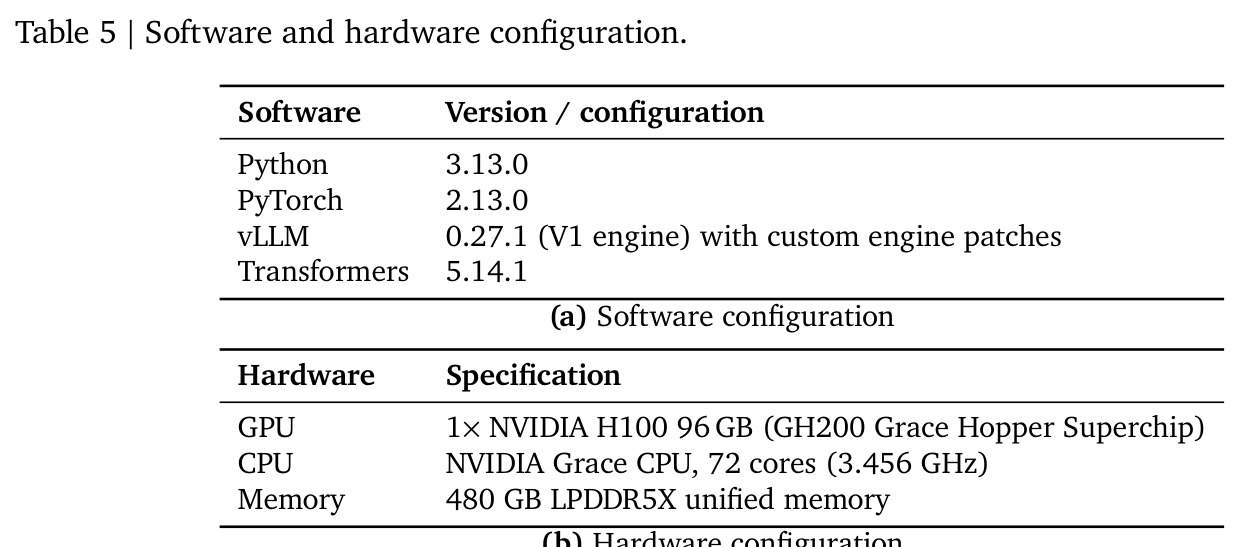
复现条件较好。代码开源于 https://github.com/nan-jiang-group/PreSTO,项目页为 nan-jiang-group.github.io/PreSTO;基座模型全部是公开权重(Qwen3-4B/8B、Qwen3.5-4B/9B、Gemma4-12B-it),数据集为社区标准基准(MATH500、AIME 24&25、MBPP、GPQA、HumanEval、MMLU、LCB V6);提议引擎用 vLLM(另与其他服务引擎对比,见案例 6)。超参数交代完整:$K=100$、$N_{pf}\in\{8,10,12,16,20\}$、$\epsilon=0.01$、1024 token 单块、每数据集前 20 个 prompt;分类器细节在附录 E.7,遍历与动态规划在附录 C。实验在单台主机上三天内完成,属于单机多卡服务级算力。需注意时间测量对硬件与负载敏感(作者让同一预算共享主机并限时记录以控制噪声);复现加速比必须使用支持前缀缓存的推理后端。总体难度中等,适合有 LLM 推理服务经验的团队,主要成本在于跑满 105 个设置需要的 GPU 时间。
论文图表