通过长尾表现评估大语言模型创造力 Evaluating LLM Creativity through Long-Tail Performance
用预训练语料长尾上的任务质量统一刻画创造力基准,并提出低成本诊断指标q@Tail
前置知识
参考分布与长尾
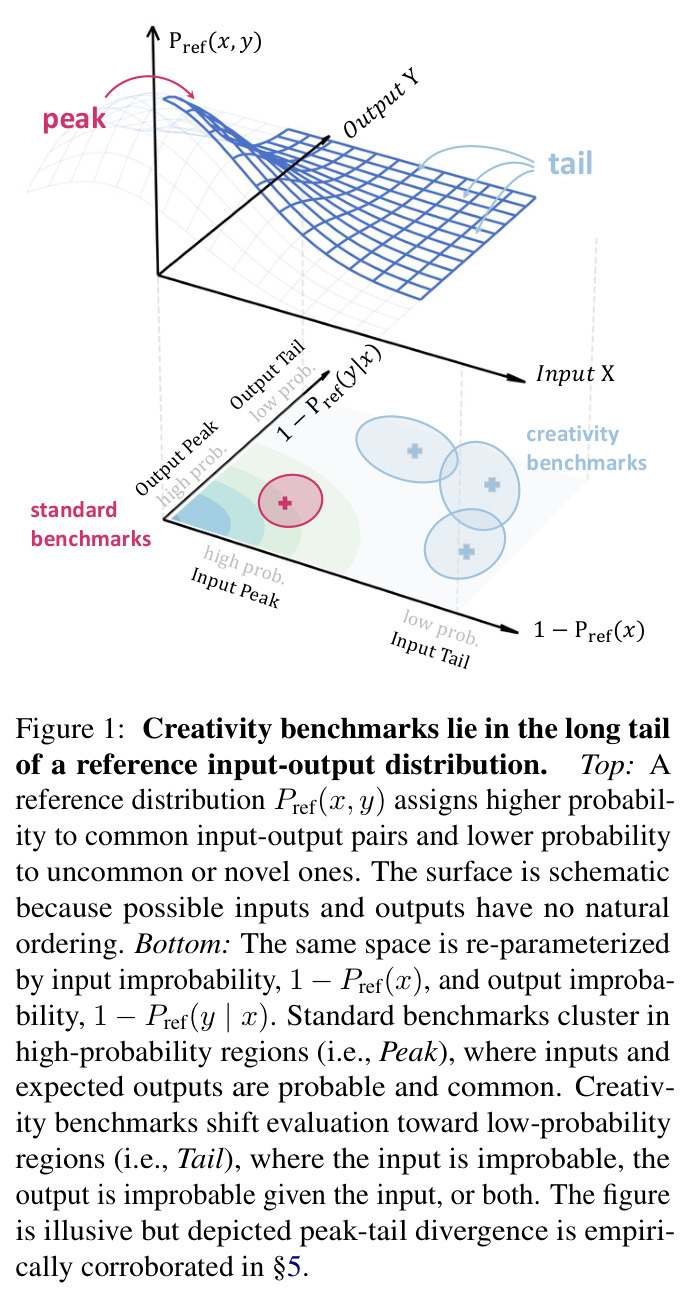
参考分布 $P_{ref}(x,y)$ 度量输入-输出对 $(x,y)$ 相对某个文本来源(如预训练语料)的常见程度:概率高的区域是峰值(peak),概率低的区域是长尾(tail)。按 $P_{ref}(x)P_{ref}(y|x)$ 分解后,长尾可细分为输入尾(输入罕见)、输出尾(输出在给定输入下罕见)与联合尾(两者都罕见),对应新颖度平面的四个象限。
本文核心主张就是“创造力 = 长尾区域的高质量任务表现”,所有实验坐标与 q@Tail 指标都建立在这个概念上。
新颖性-质量乘积公式
心理学对创造力的主流定义是“新颖且有价值”(Stein 1953、Barron 1955 等)。Padmakumar et al. (2025) 将其形式化为 $\mathrm{Creativity}(x,y)=\mathrm{Novelty}(x,y)\cdot\mathrm{Quality}(x,y)$:模型 $\pi$ 在基准 $B$ 上的创造力分数 $C_{\pi,B}=E[S_B(X)\bar{q}_\pi(X)]$,即 prompt 新颖度对期望质量的加权,新颖度充当质量的权重。
本文全部理论结果——尾部积分表示与 q@Tail 指标——都从这个乘积公式推导而来,不理解它就无法理解 §3.2。
n-gram 新颖度
文本新颖度的可计算代理:统计文本中多大比例的 n-gram(本文取 n=4)在参考语料中从未出现,比例越高说明文本越“陌生”、越位于分布尾部。本文通过 Infini-Gram-Mini 直接查询 the Pile 的 n-gram 出现统计,避免依赖某个神经语言模型拟合好坏带来的偏移(附录 E.3 另用基座模型困惑度交叉验证)。
这是把抽象参考分布落地的具体手段,novelty(x) 与 novelty(y|x) 两个坐标轴都由它算出,全部结论的稳健性也依赖它。
Kendall τ 与 Spearman ρ
两个衡量排序一致性的非参数统计量。Kendall $\tau$ 基于两个排名中一致对与不一致对的数量差,Spearman $\rho$ 是排名变量的皮尔逊相关,取值均为 $[-1,1]$,越接近 1 表示排序越一致,且可配 p 值做显著性检验。
论文用 $\tau$ 衡量“某基准(或其某个新颖度分箱)上的模型排名”与 LM Arena 人类创意写作排名的一致程度,这是“尾部对齐人类判断”的核心证据指标。
奖励模型与 LLM-as-Judge
开放式生成没有标准答案,通常用奖励模型或强 LLM 当裁判给输出打质量分。本文写作任务固定使用 Skywork-Reward-V2-Llama-3.1-8B(RewardBench-v2 排名第一)的归一化分数,数学/QA 则用精确匹配,从而在每个任务域内固定质量指标,避免指标选择混淆尾部与峰值的对比。
实验中所有“质量”都来自这套设定,判断结果可信度与局限性(如奖励模型的风格偏差)都需要先知道质量分是怎么来的。
研究动机
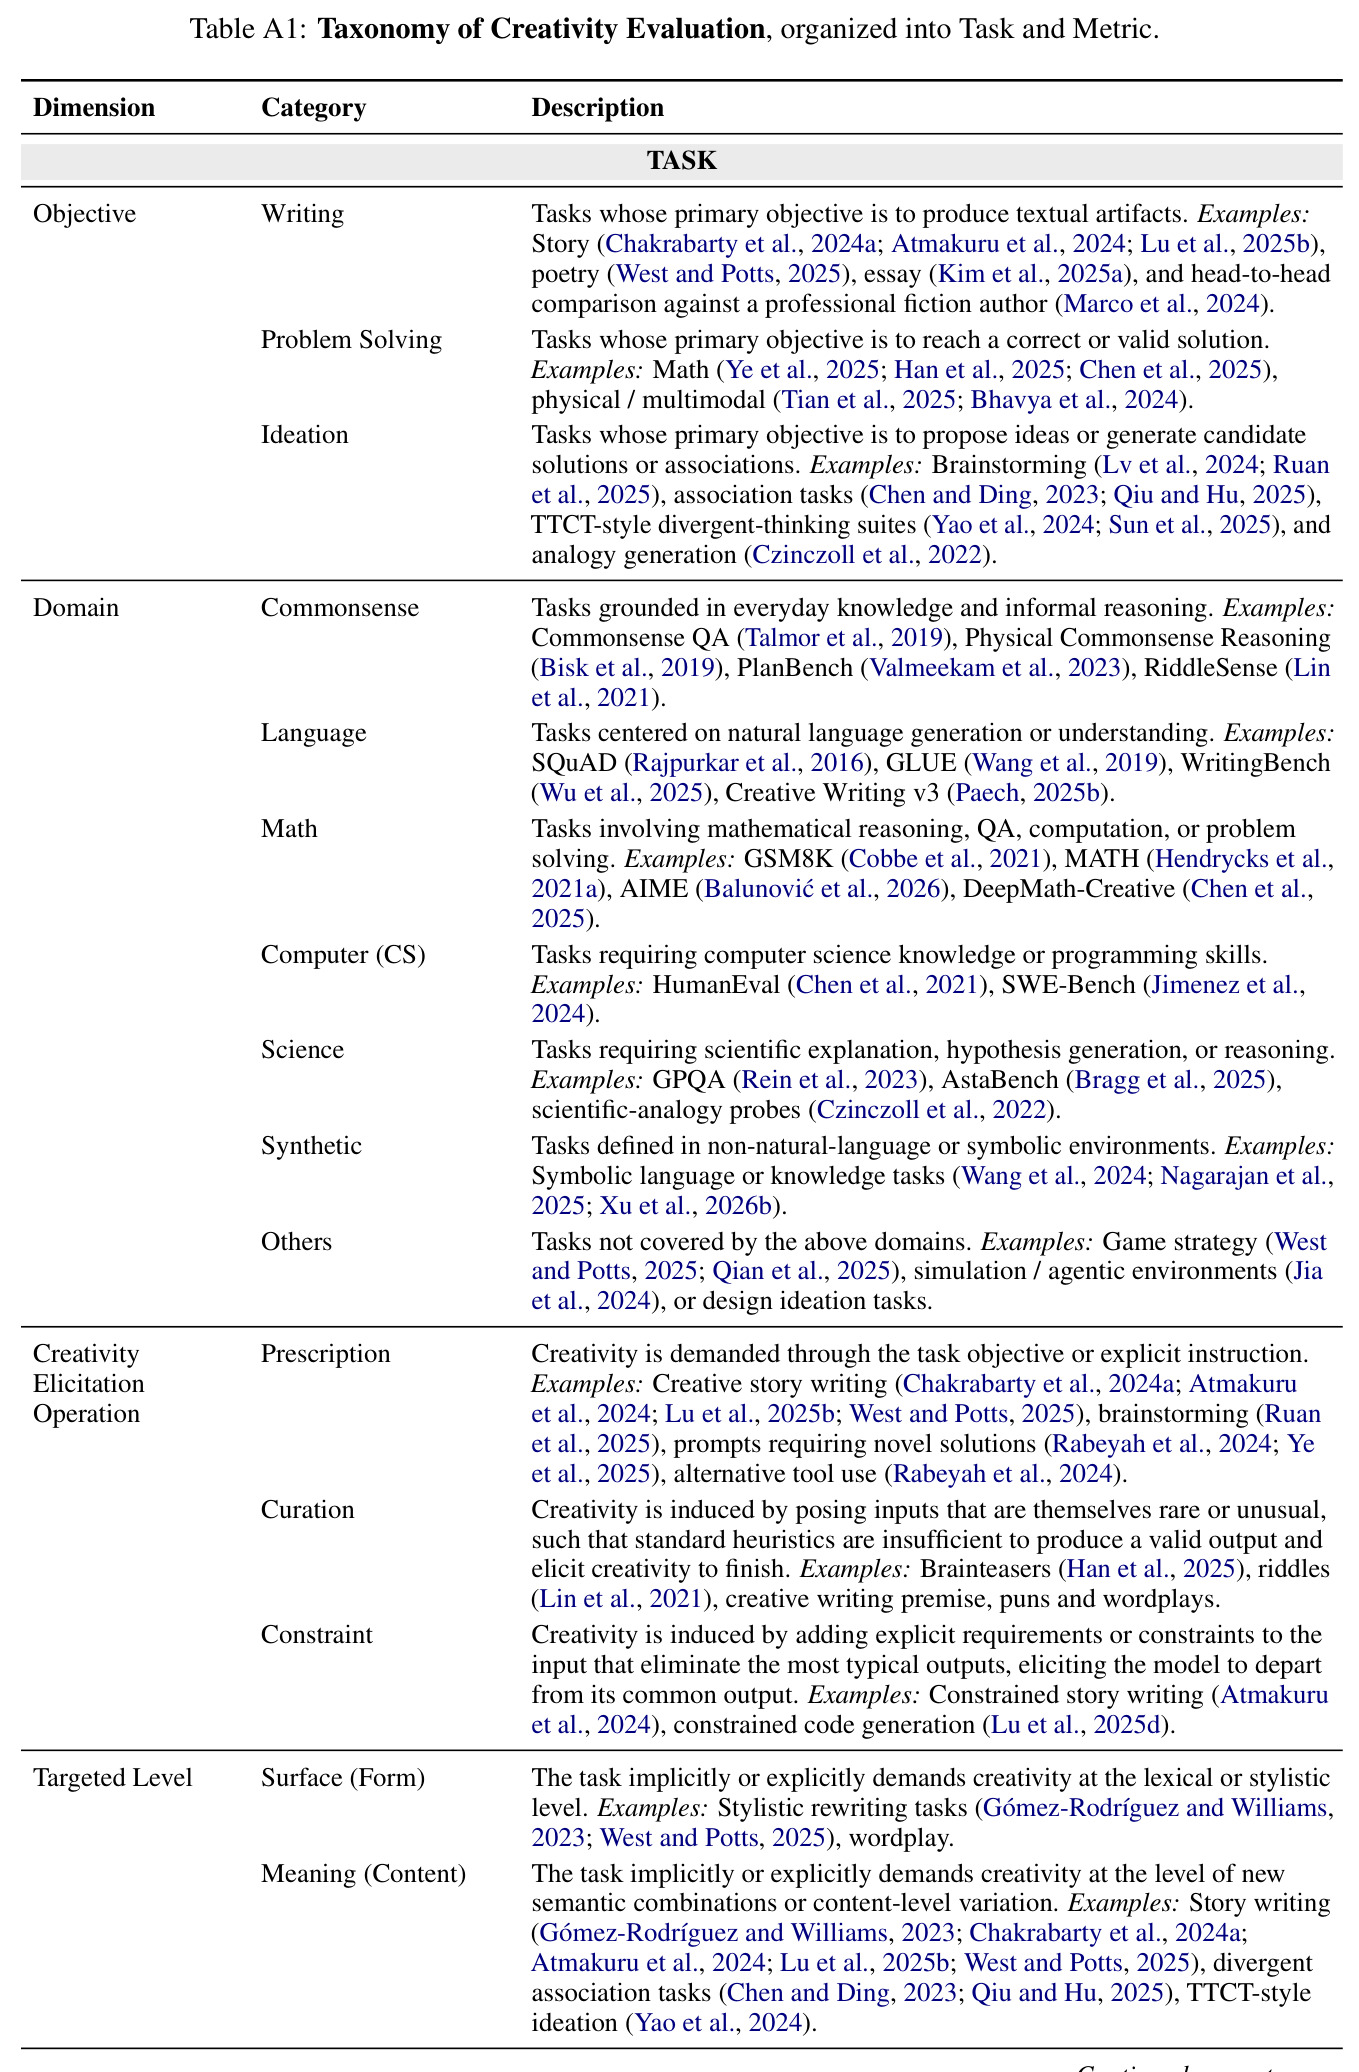
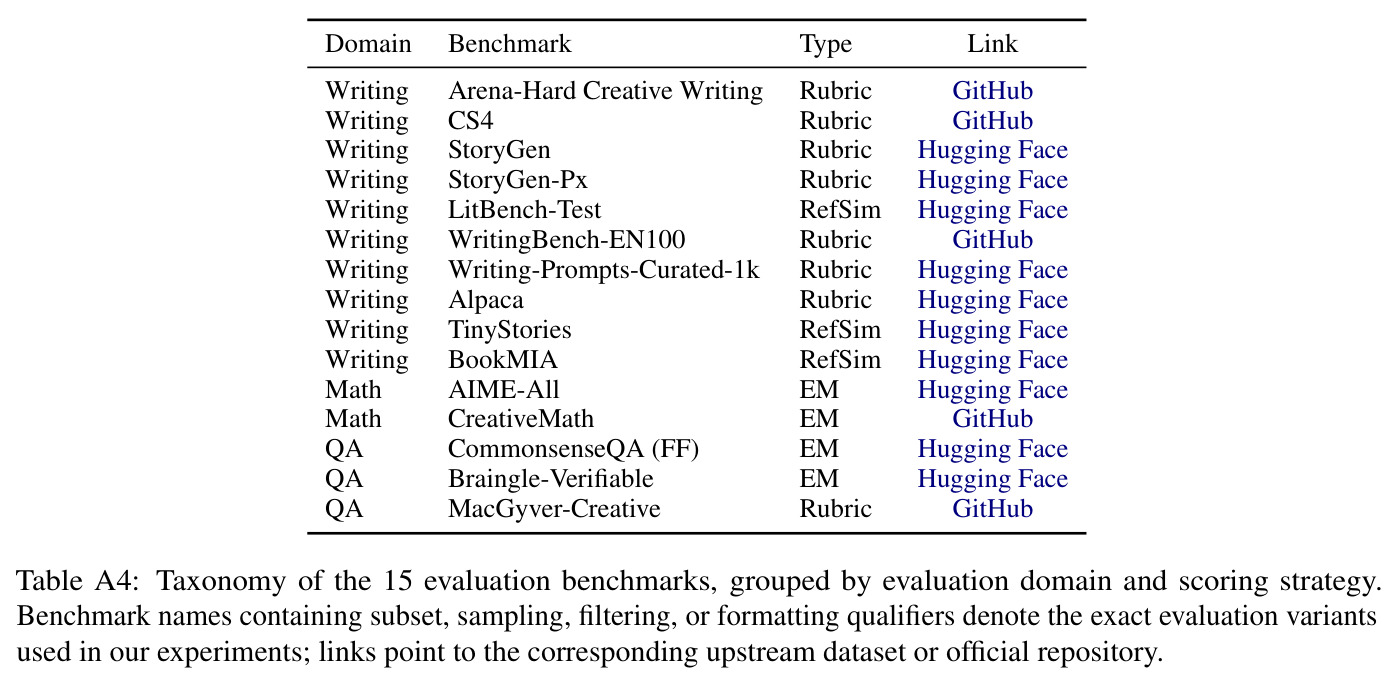
LLM 创造力基准在任务与指标两个维度上差异极大:任务覆盖写作(Arena-Hard Creative Writing、CS4)、问题求解(CreativeMath、MacGyver)、构想与开放 QA;指标上 n-gram、句子、段落等粒度并存,LLM-as-Judge、奖励模型、参考相似度打分五花八门。作者系统调研 82 篇论文,整理出九维分类法。这种异质性已造成结论互相矛盾:采用语义指标的研究报告 LLM 创造性表现很强,而采用专家量规的研究发现明显不足;相对网页文本度量新颖性时看到模型扩展带来收益,而度量生成多样性时反而观察到下降。于是根本问题悬而未决:这些设计迥异的基准究竟是否在度量同一个“创造力”?若没有统一目标,新基准的设计、验证与横向比较都缺乏原则性依据。
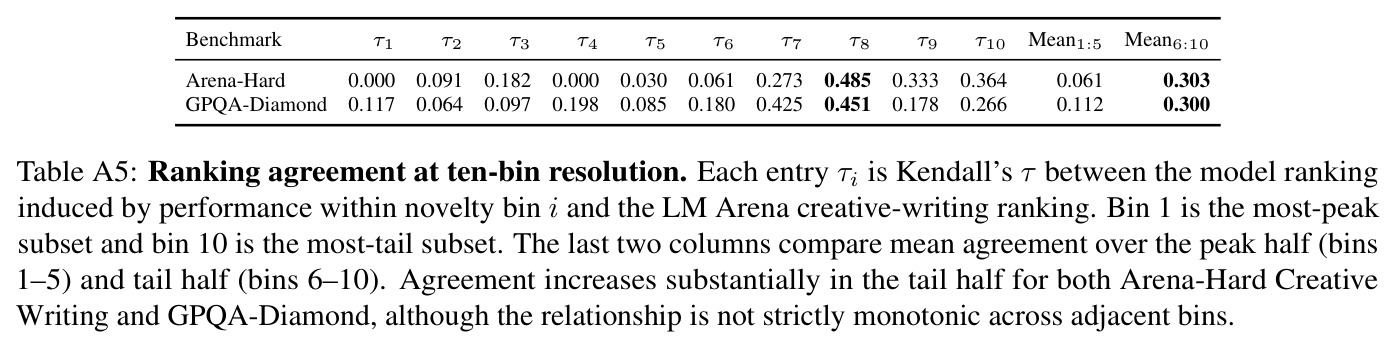
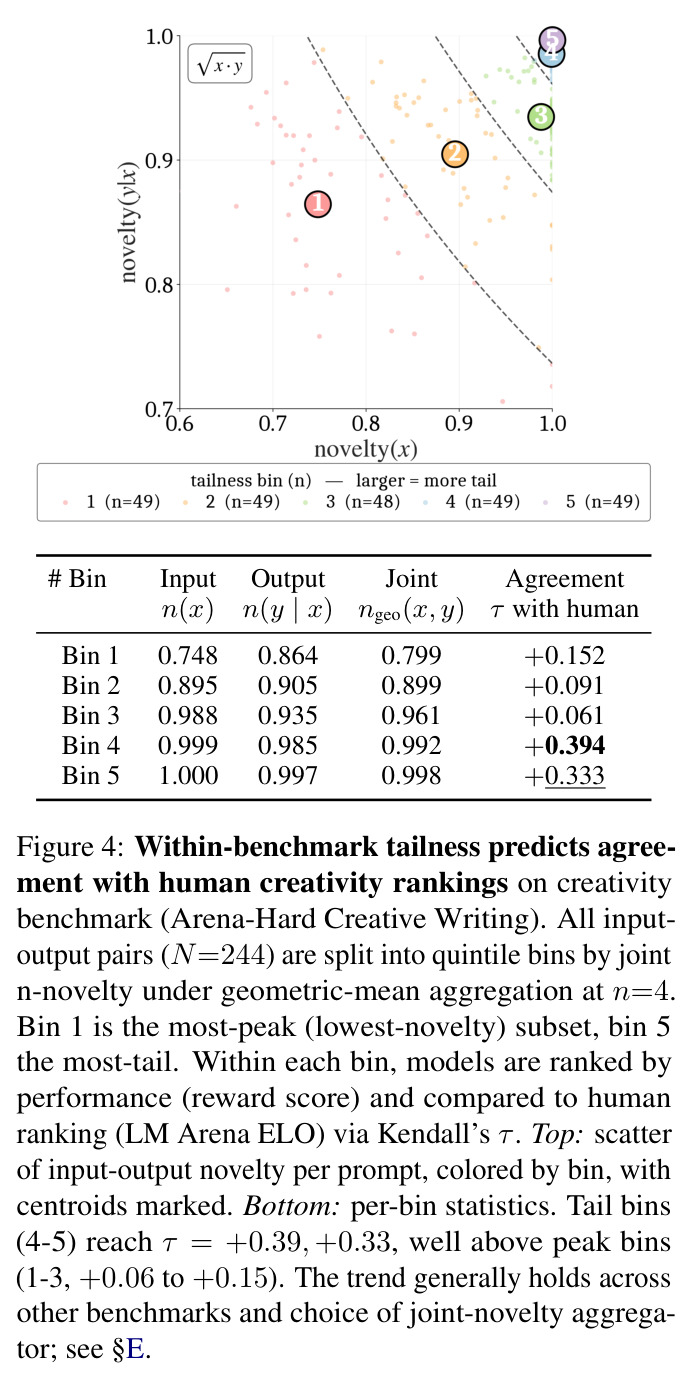
本文的目标是本文要为 LLM 创造力评测找一个统一且可操作的形式化目标:把“任务在参考输入-输出分布长尾上的表现”确立为各创造力基准共同捕捉的对象,并给出三重支撑——理论上从 novelty×quality 乘积公式推出尾部积分表示;实证上在 15 个基准 × 26 个开源权重模型上证明创造力基准比同域标准基准更靠近尾部,且尾部子集上的模型排名与 LM Arena 人类创意写作排名更一致(Arena-Hard 尾部箱 $\tau=+0.39$ vs 峰值箱 $+0.06\sim+0.15$);工程上发布低成本诊断指标 q@Tail(α),无需新数据即可审计创造力促进方法,揭示它们“增新颖不增尾部质量”的共性缺陷。
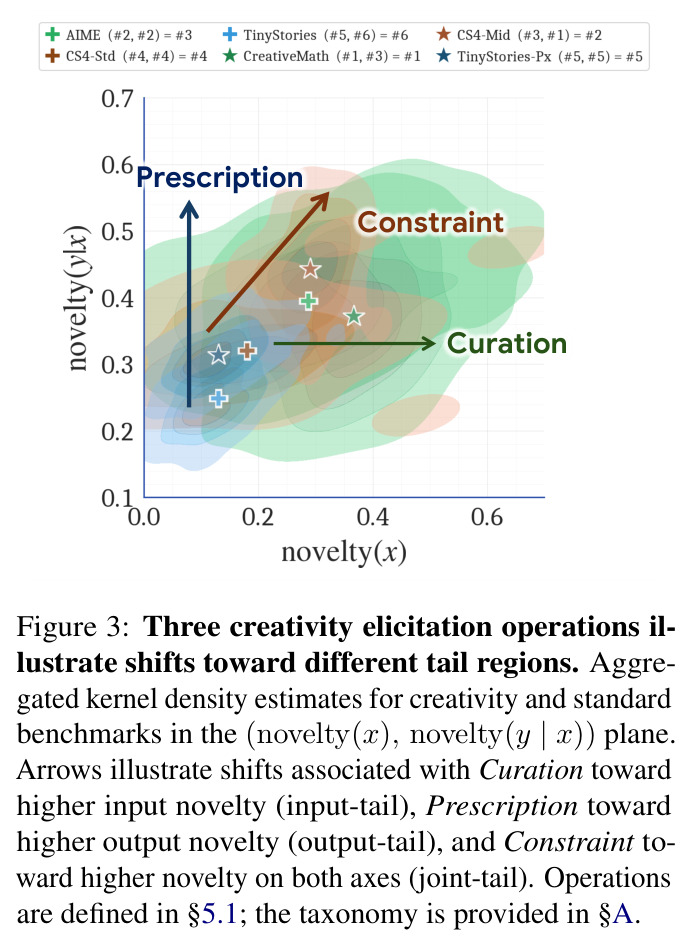
与已有工作不同的是,指标侧早有 novelty×quality 的形式化(Padmakumar et al., 2025),但任务侧始终缺位:为什么这些被设计来“引出创造力”的任务会指向同一个评测目标?本文的切入是把任务设计翻译成分布上的操作。作者注意到文献中的创造力任务大致由三类操作产生:Curation 从大语料筛出罕见输入(如专家从 AMC/AIME 挑非常规题造出 CreativeMath)、Prescription 用指令直接要求有创意的输出、Constraint 添加罕见约束(如要求故事用海滨小镇设定加主角青年期闪回),三者分别把评测点推向输入尾、输出尾与联合尾。此前没有工作把任务分类学与尾部几何对应起来,也没人验证“尾部上的质量”是否真正对齐人类创造力判断,更没人检验长尾与难度是否正交(MATH 上选样重叠仅 0.07)。
核心方法
直觉:把评测想象成在“常见程度”地图上选考点——标准基准考人人都熟的热点,创造力基准考偏僻的角落。形式化:参考分布 $P_{ref}(x,y)$ 度量输入-输出对的常见程度,按 $P_{ref}(x)P_{ref}(y|x)$ 分解为峰值、输入尾、输出尾、联合尾四个象限;定义新颖度 $s_{ref}(x,y)=\phi(P_{ref}(x)P_{ref}(y|x))\in[0,1]$($\phi$ 单调递减),聚合成基准 $B$ 上 prompt 级共享分数 $S_B(x)$。在乘积公式 $C_{\pi,B}=E[S_B(X)\bar{q}_\pi(X)]$ 上,Tonelli 定理给出精确等价 $C_{\pi,B}=\int_0^1 H_B(t)A_{\pi,B}(t)\,dt$,其中 $H_B(t)=\Pr(S_B(X)\ge t)$ 是尾部质量、$A_{\pi,B}(t)$ 是尾部条件质量。关键推论:新颖度为 $S_B(x)$ 的输入上的质量优势在每个阈值 $t\le S_B(x)$ 都被计入,总权重恰为 $S_B(x)$——同样的质量差异,出现在越新颖的区域对创造力分数贡献越大。工程落地即 $q@Tail(\alpha)=A_{\pi,B}(Q_{B,\alpha})$:前 $\alpha$ 比例尾部子集上的平均任务质量。
核心创新是把异质创造力基准的共同目标统一为“参考分布长尾上的任务质量”,并证明这不是又一个新指标,而是既有框架的理论必然。与已有工作的本质区别有三:(1) 过去对评测分歧的讨论停留在描述层面(82 篇论文的九维分类只是罗列差异),本文第一次给出任务侧的统一解释——三类设计操作分别对应输入尾、输出尾、联合尾,基准的“尾部位置”由构造方式决定;(2) Padmakumar et al. 的乘积公式此前只被当作动机,本文用 Tonelli 定理把它精确改写为 $C_{\pi,B}=\int_0^1 H_B(t)A_{\pi,B}(t)\,dt$,得到可证伪预测:模型排名在更高尾部子集上应更接近人类创造力判断——该预测在创造力基准和 GPQA-Diamond 这类标准基准上都被证实;(3) 由此派生的 q@Tail(α) 只需对现有基准做一次 n-gram 查询和子集筛选,无需新 prompt、新 judge 或新数据集,就能把任意基准(包括非创造力的标准基准)变成创造力诊断工具。
方法步骤详情
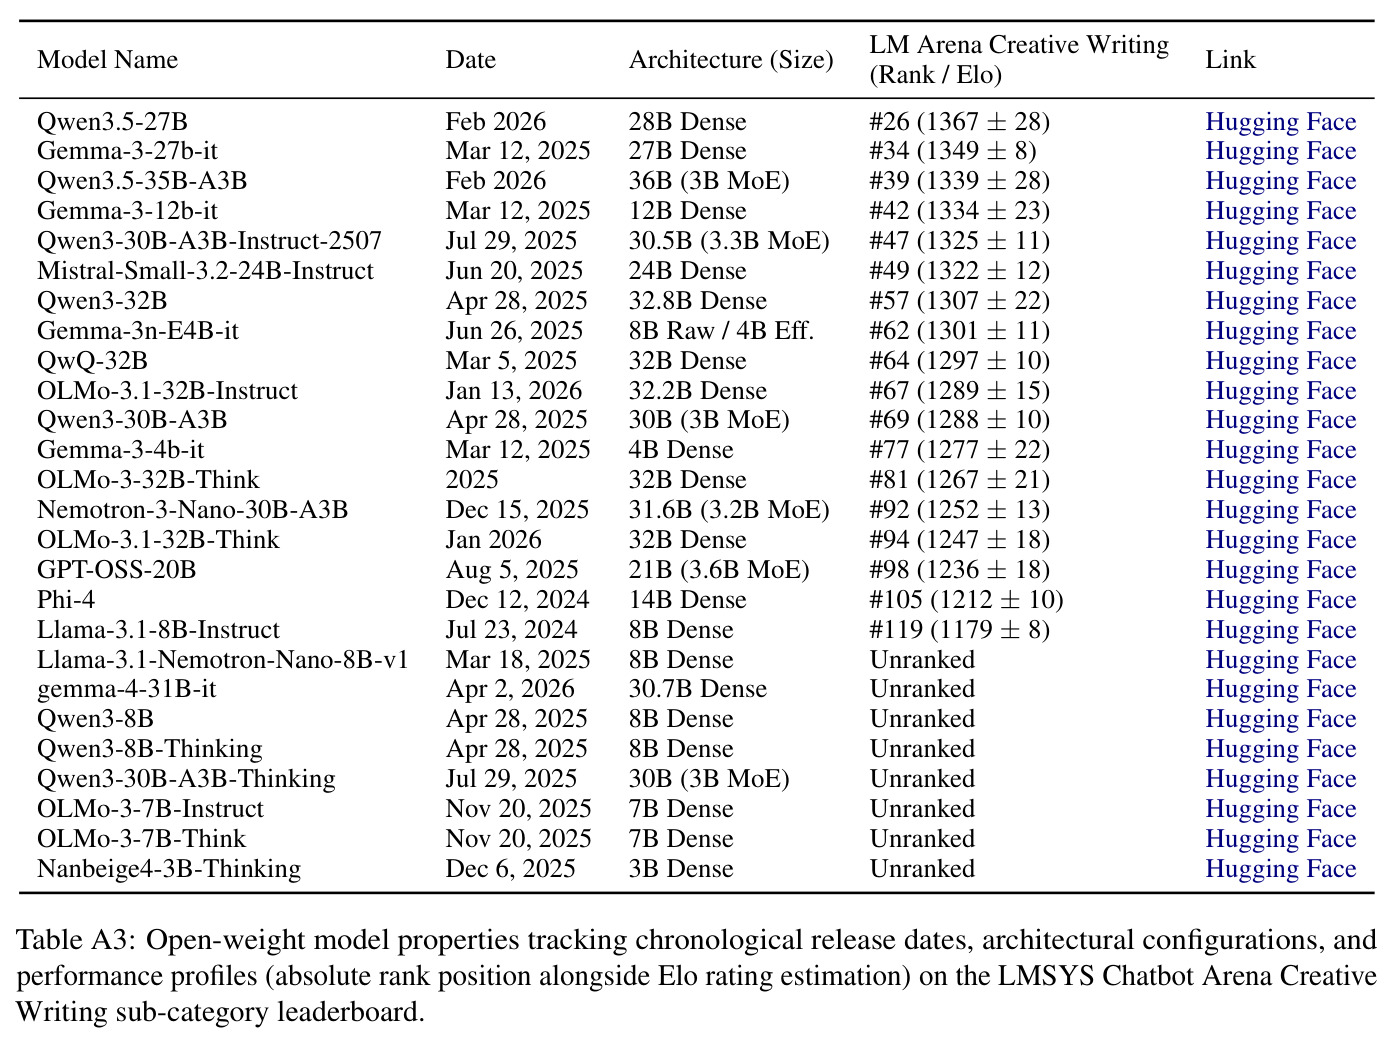
流水线五步:(1) 实例化参考分布——用 the Pile 作参考文本源,经 Infini-Gram-Mini 直接查询 n-gram 出现统计;Pile 早于所有被评基准,避免污染。(2) 计算新颖度——对每个输入 $x$ 和各模型输出 $y$,以缺失的 4-gram 比例为 novelty(x) 与 novelty(y|x)(n=5、6 冒烟测试结论一致);对同一 $x$ 先跨模型平均输出新颖度,再与输入新颖度取几何平均得共享分数 $S_B(x)$;同输入样本一起入选或排除,确保所有模型在同一批 prompt 上比较。(3) 评分——数学与 QA 用 LM-Eval-Harness 抽取最终答案做精确匹配,开放式写作用 Skywork-Reward-V2-Llama-3.1-8B 归一化奖励,域内固定指标。(4) 排名对齐——每个基准按平均质量排出模型排名,与 LM Arena 创意写作 ELO 排名算 Kendall $\tau$;样本按 $S_B(x)$ 分成 5 或 10 箱逐箱计算,检验尾部-峰值差异。(5) q@Tail 诊断——在 $\alpha=25\%$ 尾部子集上评估 min-p、温度缩放、Persona、Branch-Solve-Merge、Self-consistency、Meta-prompting、CRPO 等方法,覆盖 4 个模型家族共 26 个开源模型。
技术新颖性
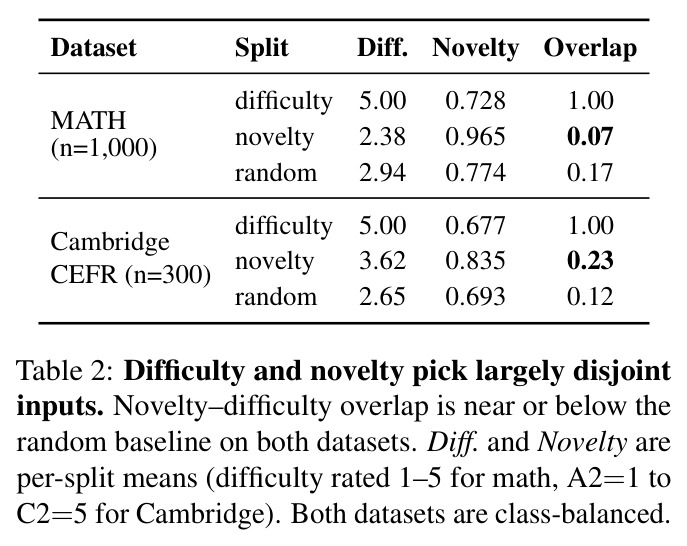
本文不训练新模型也不造新数据集,新颖性在评测理论层面:其一,把 82 篇文献中异质的任务设计归纳为 Curation、Prescription、Constraint 三种操作,并实证它们分别推向输入尾、输出尾、联合尾(图3),把分类学升级为几何解释;其二,用 Tonelli 定理把乘积公式等价为尾部积分,推出“质量差异按新颖度 $S_B(x)$ 加权”的精确结论,使创造力评测从经验分歧变成有理论保证、可证伪的框架;其三,q@Tail 是“复用现有基准子集”的低成本设计,与设计全新基准(收集 prompt、训练专属 judge)相比几乎零额外成本。与 long-tail 学习文献(Kandpal et al., 2023 等)也不同:后者用长尾解释性能退化或构造更难的题,本文证明难度与新颖性选样重叠接近随机(MATH 0.07、Cambridge CEFR 0.23),两者研究的是不同的维度。
实验结果
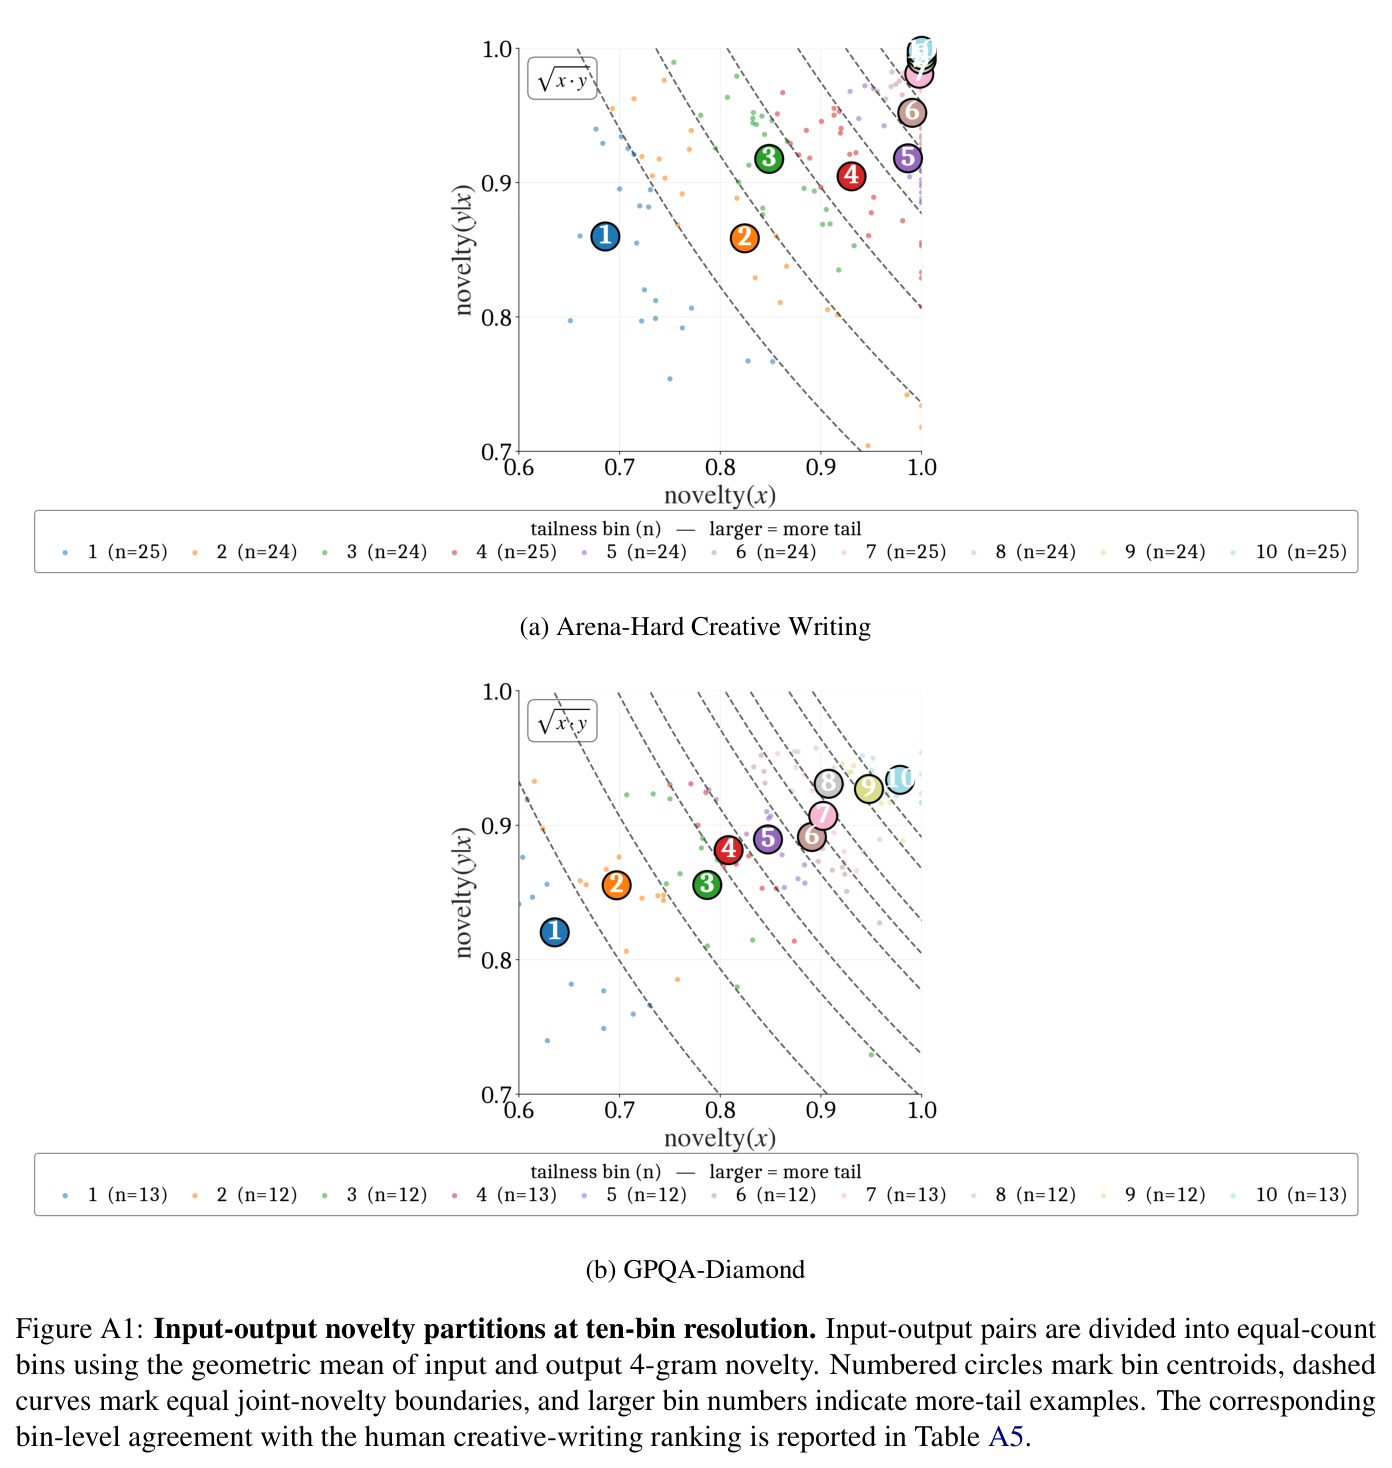
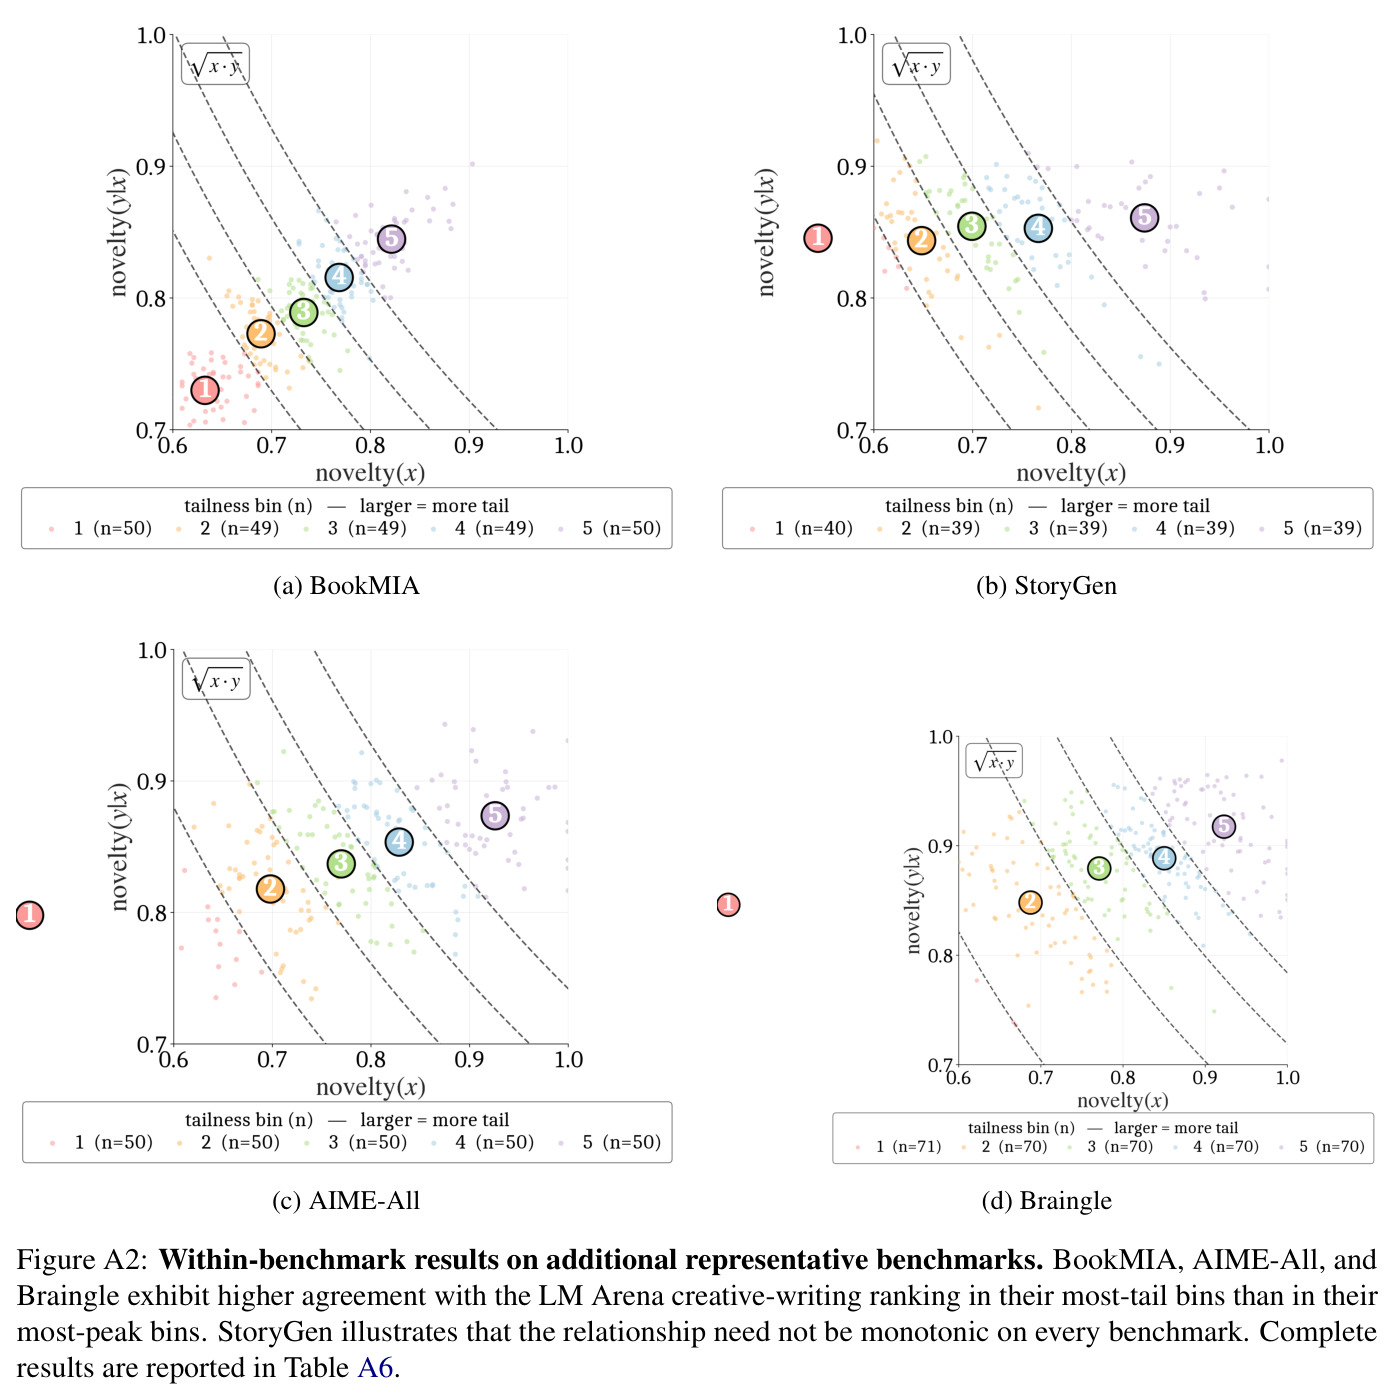
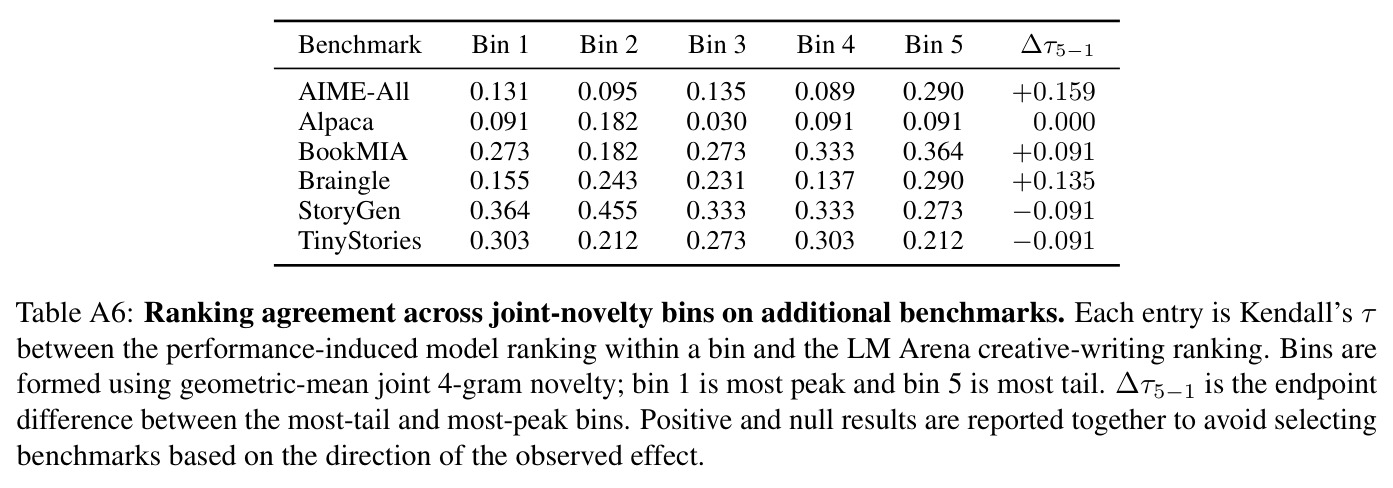
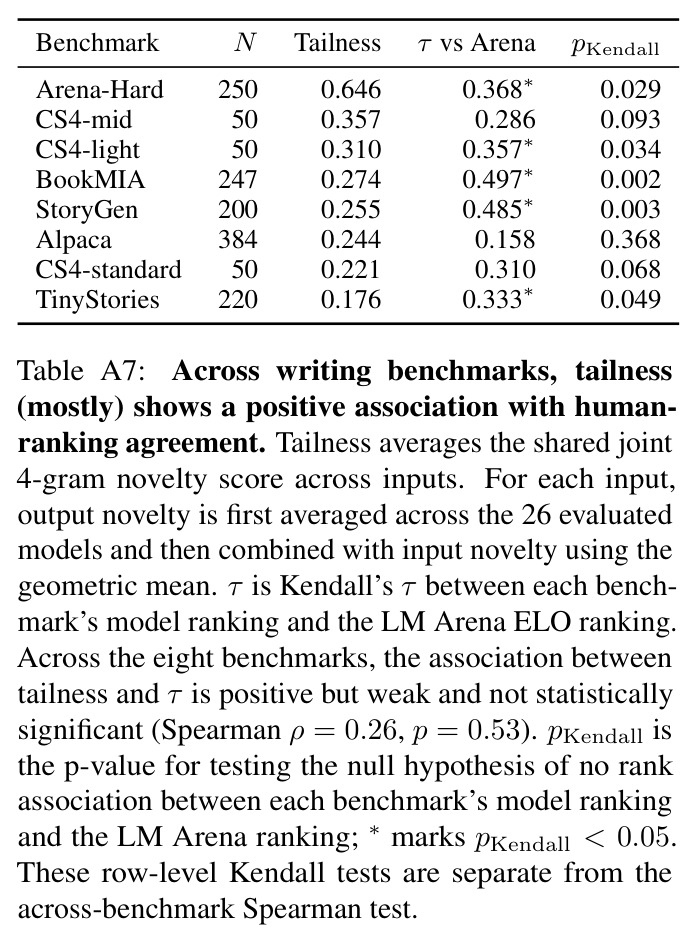
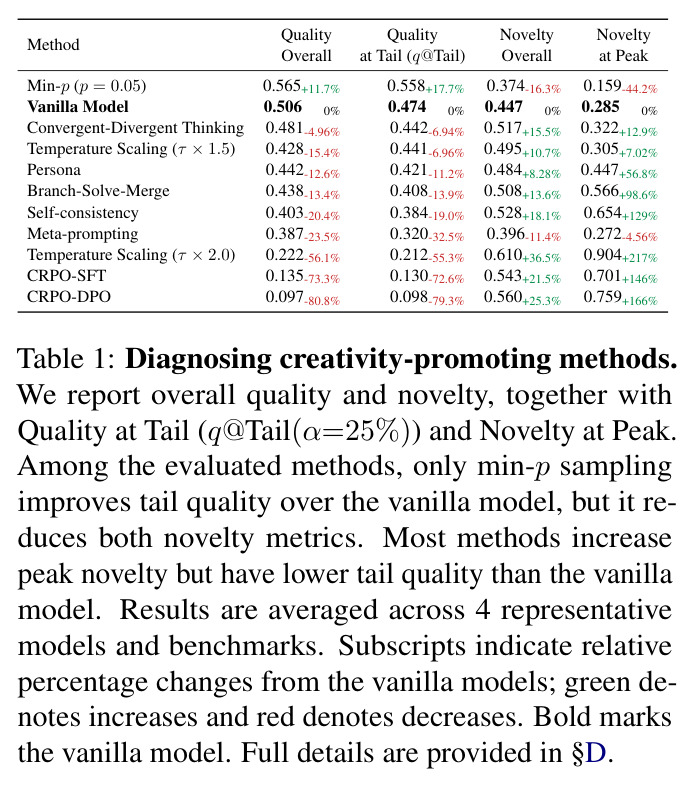
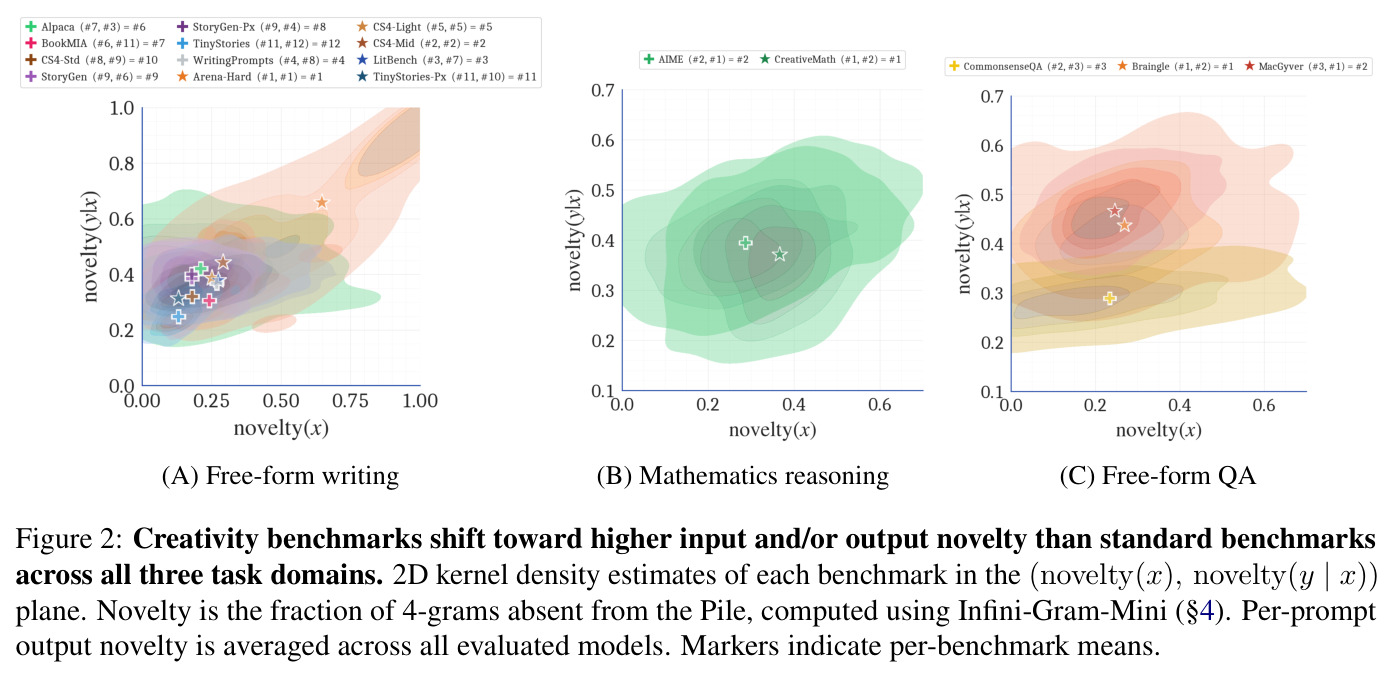
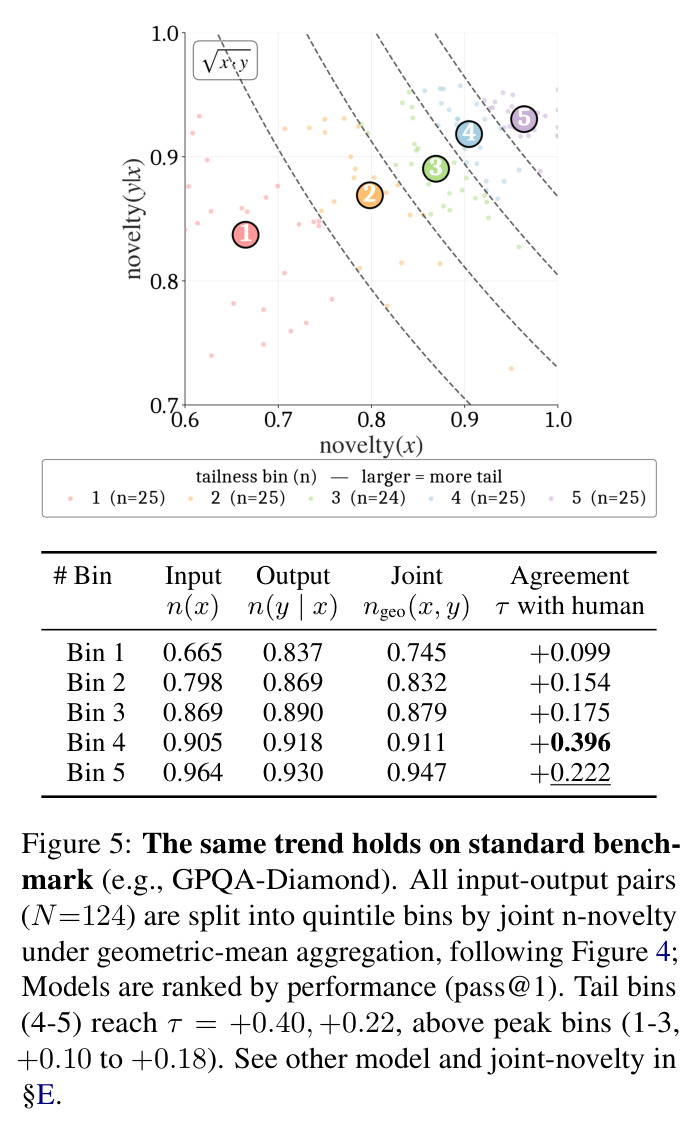
四个核心发现。(1) 创造力基准位于尾部:15 基准 × 26 模型的三域核密度估计显示创造力基准系统性移向更高 novelty(x) 和/或 novelty(y|x)——Arena-Hard Creative Writing 两轴均达 0.6-0.7,远高于 Alpaca 等标准基准;CreativeMath 在 novelty(x) 上位于 AIME-All 右侧;MacGyver 与 Braingle 在 novelty(y|x) 上高于 CommonsenseQA。写作域混合检验 p<0.001,对 n∈{4,5,6} 稳定。(2) 尾部子集更对齐人类判断:Arena-Hard(N=244)分 5 箱,尾部箱 τ=+0.394/+0.333,峰值箱仅 +0.061~+0.152;GPQA-Diamond(N=124)尾部箱 τ=+0.396/+0.222;十分箱下 Spearman ρ=0.661-0.855(p=0.0016-0.0376)。跨基准:最尾部的 Arena-Hard τ=0.37(p=0.029),低新颖的 Alpaca τ=0.16(p=0.37 不显著),8 写作基准整体 ρ=0.26。(3) q@Tail(α=25%) 诊断:vanilla 质量 0.506/尾部 0.474;仅 min-p 尾部质量 +17.7%(→0.558)但新颖度 −16.3%、峰值 −44.2%;Self-consistency 峰值新颖度 +129% 但尾部质量 −19.0%;温度×2 新颖度 +217% 但质量 −56.1%;CRPO-DPO 质量 −80.8%。无方法同时改善尾部质量与峰值新颖度。(4) 新颖性≠难度:MATH 选样重叠 0.07(随机 0.17),Cambridge CEFR 0.23。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 写作基准内模型排名对齐(Arena-Hard Creative Writing) | Kendall τ(vs LM Arena 创意写作排名) | 尾部第4/5箱 τ=+0.394/+0.333 | 峰值第1-3箱 τ=+0.061~+0.152 | 尾部箱一致性高出约 +0.24~+0.27 |
| 标准基准内排名对齐(GPQA-Diamond,pass@1) | Kendall τ(vs LM Arena 创意写作排名) | 尾部第4/5箱 τ=+0.396/+0.222 | 峰值第1-3箱 τ=+0.099~+0.175 | 尾部箱最高提升 +0.30 |
| 跨写作基准排名对齐 | 基准级 Kendall τ | Arena-Hard(最尾部)τ=0.37(p=0.029,显著) | Alpaca(低新颖)τ=0.16(p=0.37,不显著) | τ 提升 0.21,且仅高尾部基准显著;8 基准整体 Spearman ρ=0.26 |
| min-p 采样的尾部质量(q@Tail α=25%) | 相对 vanilla 的质量/新颖度变化 | 尾部质量 +17.7%(0.474→0.558),整体质量 +11.7% | vanilla:整体 0.506 / 尾部 0.474 / 新颖度 0.447 / 峰值新颖度 0.285 | 尾部质量 +17.7%,代价是新颖度 −16.3%、峰值新颖度 −44.2% |
| 其他创造力促进方法(Self-consistency、温度×2、CRPO-DPO 等) | q@Tail 质量与峰值新颖度的相对变化 | 峰值新颖度大涨(Self-consistency +129%、温度×2 +217%、CRPO-DPO +166%)但尾部质量全线下滑 | vanilla 尾部质量 0.474 | 无任何方法同时改善尾部质量与峰值新颖度(CRPO-DPO 质量最差 −80.8%) |
| 新颖性与难度选样重叠(MATH / Cambridge CEFR) | 选样重叠率 | 0.07 / 0.23 | 随机基线 0.17 / 0.12 | 接近或低于随机,说明难度与新颖性近似正交 |
局限与改进
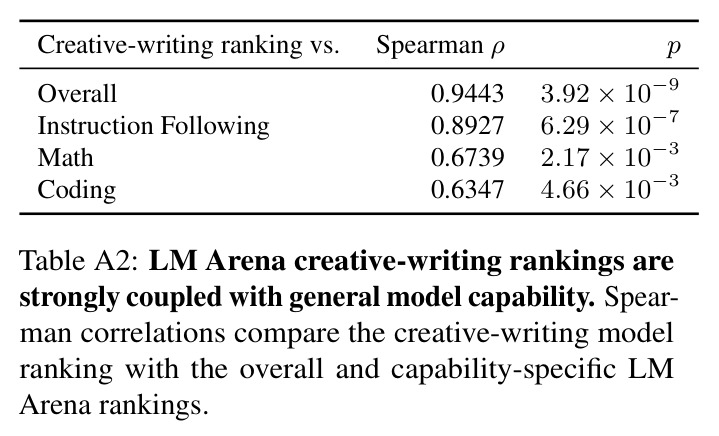
作者承认的局限:n-gram 新颖度只捕捉表层词汇稀有性,不度量语义、概念或文化层面的新颖;参考分布选取是评测参数,换成人工创作语料或模型自采样结论可能变化;质量估计器(奖励模型)存在架构、长度、风格、领域偏差,换 judge 的稳健性未探索;最强的人类对齐分析依赖 LM Arena 创意写作排名,其用户自选且未隔离创造力维度,对数学/科学/设计等域代表性不足;跨基准相关(ρ=0.26)噪声大,尾部性是重要因素但非完整解释;方法诊断限于 7-8B 开源模型,Meta-prompting 等复杂指令方法在更大或闭源模型上可能不同;q@Tail 只是诊断近似而非替代,且 Arena 排名与整体能力强耦合(§B.2),无法把尾部信号完全归于创造力。我补充两点:论文自己发现主例的一致性在最后箱之前达峰,说明极端尾部非单调、α 的选取缺乏指导原则;共享分数把输出新颖度跨模型平均,衡量的是“prompt 的尾部性”而非“模型输出是否更尾部”,可能系统性低估增加输出新颖度类方法的价值。
独立分析的弱点
独立分析五点:(1) 4-gram 缺失率对同义改写完全不敏感——把 Pile 高频句式换个说法即“变新颖”,可能奖励表面改写而非真创意;改进方向是引入 embedding 级或模型自采样分布做参考(§A 提及但未实验)。(2) 写作质量完全依赖单一奖励模型 Skywork-V2-8B,而奖励模型往往偏好流畅、低多样文本,与尾部质量测量存在内在张力;改进:多 judge 交叉重算 τ 做消融。(3) q@Tail 只报 α=25% 单点,且作者发现主例一致性在最后箱前达峰,α 敏感性需要系统分析;改进:报告完整的 α-τ 曲线并给出选择准则。(4) Arena 排名与通用能力强耦合意味着“尾部对齐”无法排除通用能力解释——改进方向是构造能力匹配的对照组(如同分数段弱创造力模型)再观察尾部是否仍有区分度。(5) 26 个模型以 7-8B 为主,min-p 在 8B 上 +17.7% 的尾部收益未必迁移到百亿以上模型;改进:先在小模型筛选方法、再到 70B 级验证,成本可控。这些弱点均不动摇主结论方向,但影响“q@Tail 测的到底是不是创造力”的解释强度。
未来方向
作者提出:开发在保持质量的同时提高尾部表现的方法——min-p 采样与 frontier 模型 sanity check 都显示尾部质量有提升空间;把 long-tail learning 的 post-training/pretraining 工作(Ramasubramanian et al., 2026;Badhe et al., 2026 的数据增强与算法干预)与尾部创造力结合;用语义级参考分布(人工创作语料、模型自采样、领域语料)替代 n-gram 统计;建立数学、科学、设计等其他创造域的人类判断参照。基于成果可延伸:把 q@Tail 做成在线诊断服务,n-gram 查询成本极低,可对任意基准实时输出尾部画像;用该框架审计奖励模型能否区分“安全的新颖”与“胡言乱语的新颖”;研究推理模型(thinking mode)在尾部输入上的退化模式;把新颖度-质量 Pareto 曲线纳入模型卡的标准报告项,使“创造力改进”可被纵向追踪。
复现评估
复现条件较好:代码与数据开源(github.com/YichenZW/longtail-creativity),并附 82 篇文献的分类清单(awesome_llm_creativity)。n-gram 查询走 Infini-Gram-Mini 公共服务,无需自建 the Pile 索引,这是复现成本最低的一环。26 个模型全部为开源权重(Llama/Qwen/OLMo/Gemma/Mistral 家族加 GPT-OSS-20B、Phi-4 等,7-8B 为主),写作质量分用公开的 Skywork-Reward-V2-Llama-3.1-8B,数学/QA 走 LM-Eval-Harness 精确匹配。主要算力开销在 26 模型 × 15 基准的推理(开放式写作需多输出求平均新颖度),单卡 A100 级别分批可完成;闭源 frontier 的 sanity check 可选。整体难度中等:环境搭建简单,但推理预算、奖励模型版本、LM Arena 排名时点都会造成 τ 数值漂移——定性结论(尾部箱 > 峰值箱)预计稳健,数值不宜逐一对比。
论文图表