冲浪激活波:面向投机解码的大模型隐状态信息与几何分析 Surfing the Activation Wave: Analyzing the Information and Geometry of LLM Hidden States for Speculative Decoding
用矩阵熵和CKA为投机解码自动挑选信息量大且冗余低的目标层组合
前置知识
投机解码(Speculative Decoding)
一种无损 LLM 推理加速技术:小草稿模型先快速草拟多个 token,目标模型一次前向并行验证,被接受的 token 直接保留,输出分布与单独用目标模型完全一致。核心指标是平均接受 token 数 $\tau$,即目标模型每次前向平均能推进多少 token,直接决定加速比。
本文的层选择就是为投机解码服务的,所有实验指标(SpecBench 上的 τ)都建立在这个框架上,不懂草拟-验证-接受机制就读不懂表 2/3 的数字含义。
EAGLE 系列与隐状态条件化
EAGLE 是最主流的投机解码方法家族:草稿模型除词元嵌入外,还接收目标模型若干层的隐状态作为条件。EAGLE3 把多层隐状态沿特征维拼接后经下投影矩阵 $W_{\text{down}}\in\mathbb{R}^{|L|d\times d}$ 融合喂给草稿模型,选哪些层直接决定草稿模型能"看到"多少目标模型内部信息。
本文全部动机就是替换 EAGLE2/3 中 $[N-1]$、$[2, N//2, N-3]$ 的固定选层规则,最终产出也是 EAGLE3 风格的层组配置,不懂条件化机制就无法理解选层为何重要。
矩阵熵(Matrix Entropy)
对表示矩阵 $X\in\mathbb{R}^{T\times D}$ 的 Gram 矩阵谱定义的熵:归一化谱 $p_i=\lambda_i(K_X)/\mathrm{tr}(K_X)=\sigma_i^2(X)/\|X\|_F^2$,Rényi-$\alpha$ 熵 $S_\alpha=\frac{1}{1-\alpha}\log\sum_i p_i^\alpha$,$\alpha\to 1$ 时退化为香农熵 $S_1=-\sum_i p_i\log p_i$。谱越平(信息方向越分散)熵越大。
它是 ELSI 算法的核心评分函数:拼接表示的 $S_1$ 直接衡量一组层联合提供的信息量,整个选层搜索就是围绕它展开的,是读懂算法 1/2 的前提。
CKA(中心核对齐)
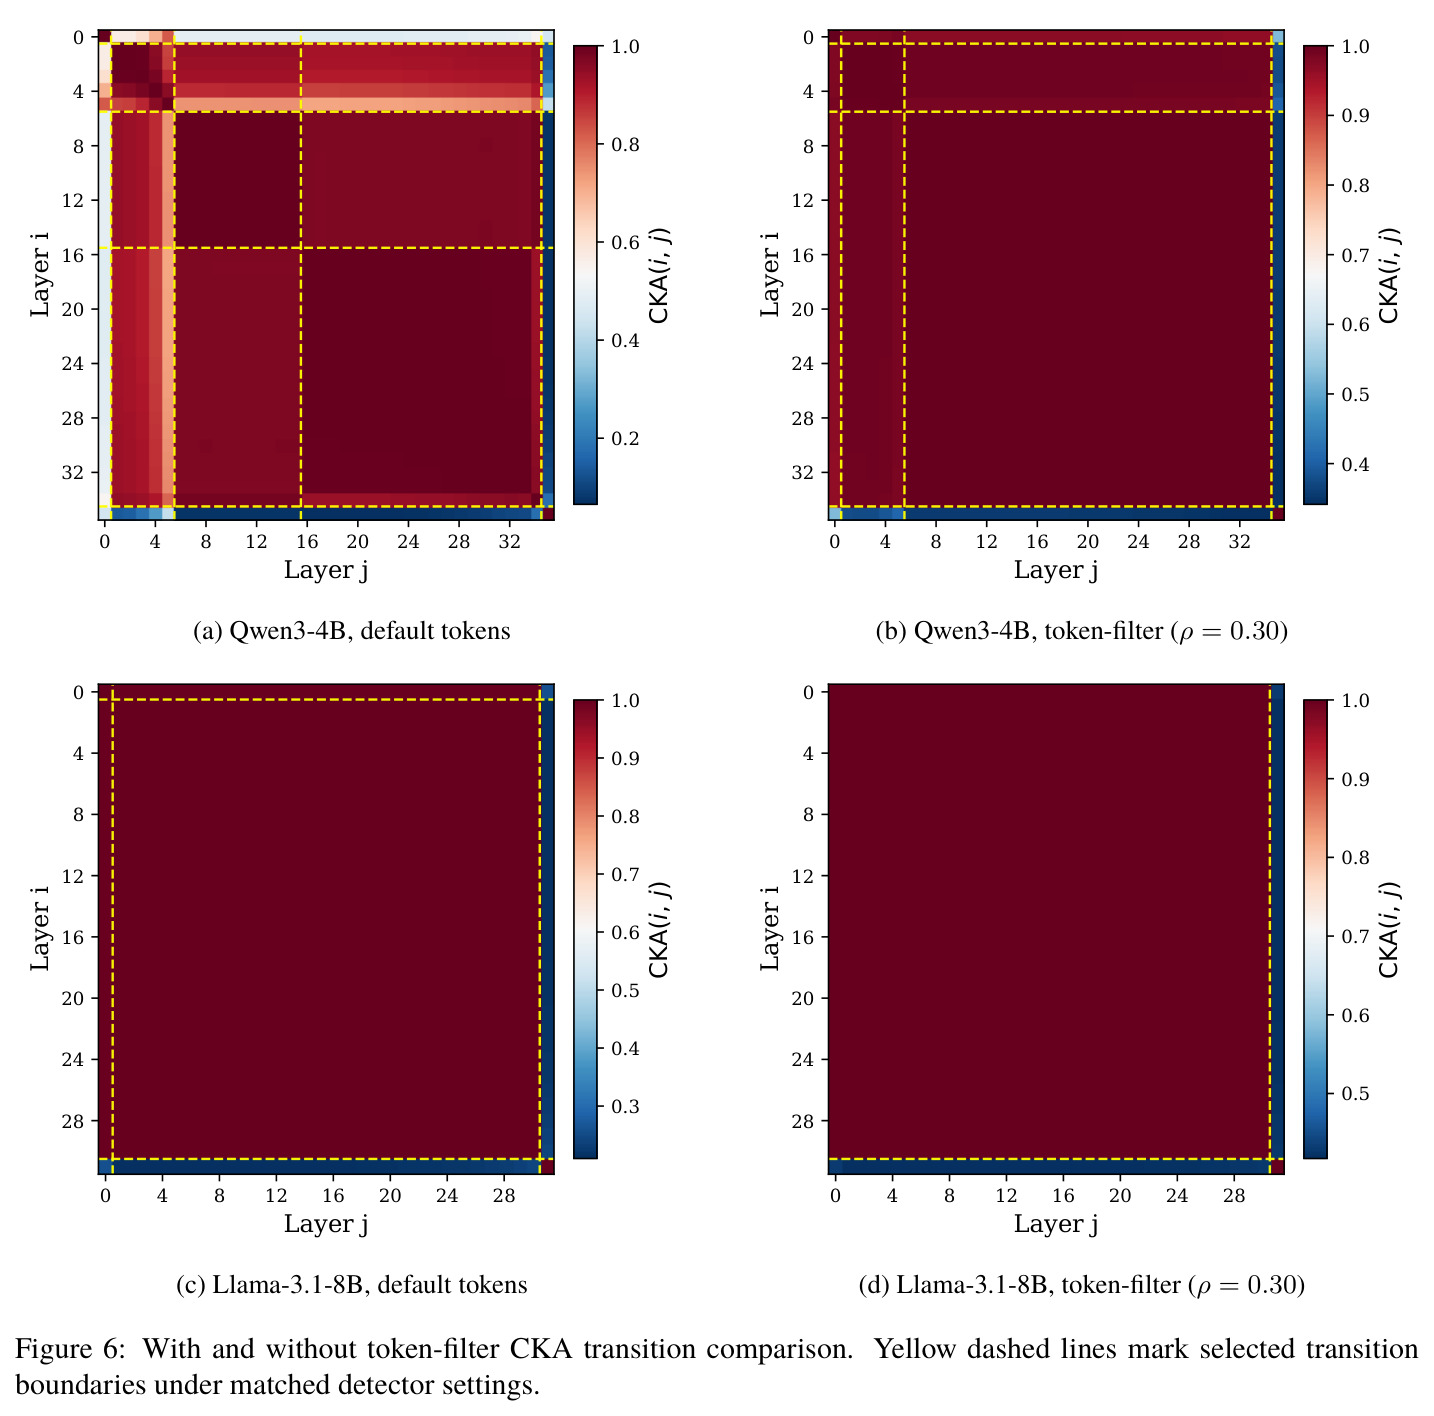
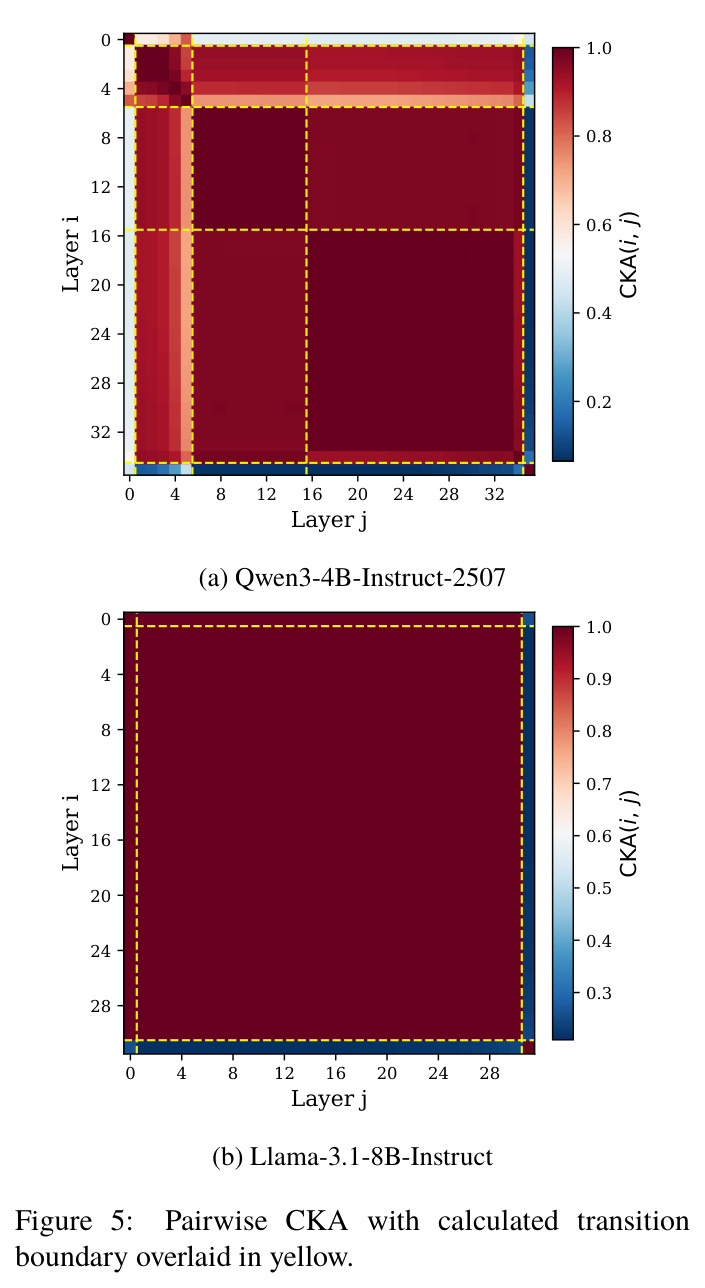
度量两组表示相似性的核方法:$\mathrm{CKA}(X,Y)=\langle HKH,HLH\rangle_F/(\|HKH\|_F\|HLH\|_F)$,其中 $H=I-\frac{1}{T}\mathbf{1}\mathbf{1}^\top$ 做中心化,值越高表示两组表示越相似、越冗余。对全部层两两计算得 CKA 矩阵 $M_{ij}$,相邻行差 $\delta_\ell=\|M_{\ell+1,:}-M_{\ell,:}\|^2$ 的峰值即表示"跃迁"边界,可划分深度方向的区室。
本文用它量化层间冗余并定位表示区室,是 ELSI-C 多样性扩展的信号来源,也是解释 Llama 上层选择收益小、固定基线仍具竞争力的关键分析工具。
预测熵(Predictive Entropy)
模型在某个 token 位置输出分布 $p_t$ 的香农熵 $H_t=-\sum_{v\in V}p_t(v)\log p_t(v)$,衡量该位置预测的不确定性。低熵 token 多为高置信度的局部填充内容,高熵 token 是承载语义的内容位,两类位置对层间统计的贡献截然不同。
论文发现低熵 token 的隐状态会稀释层间差异、放大跨 prompt 方差,token-熵过滤(保留熵最高的前 30% 位置)正是基于它构建的,是理解方法第一阶段的必要概念。
研究动机
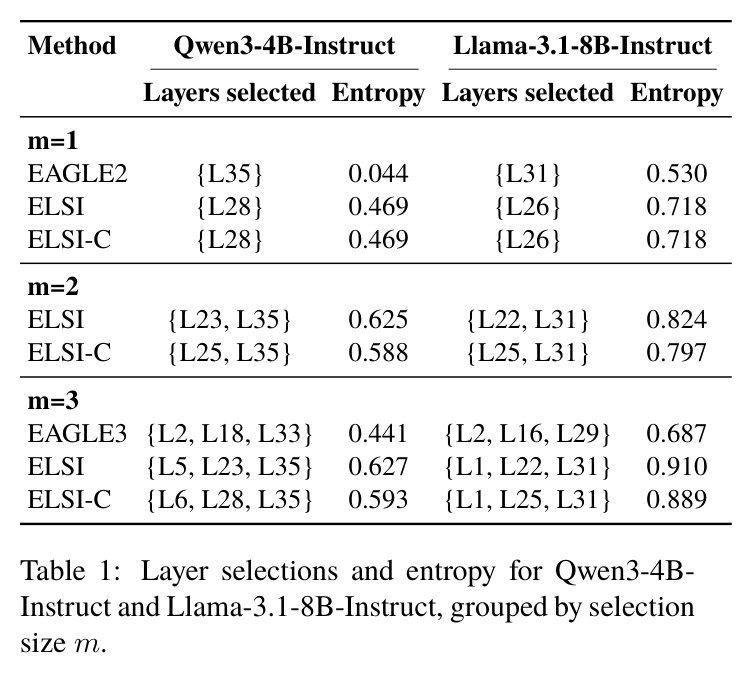
投机解码中,EAGLE 系列方法会把目标模型多个层的隐状态融合后喂给草稿模型,但实践中这些层几乎都按固定位置规则挑选:EAGLE2 只取最后一层 $[N-1]$,EAGLE3 用 $[2, N//2, N-3]$。问题在于最优层组合本质上是个组合优化难题:对 36 层模型选 3 层就有数千种组合,更深的模型根本无法穷举评估。更麻烦的是固定规则缺乏原理解释——没人说清楚哪些层组合真正信息互补、哪些只是几何冗余,导致默认规则在某些场景碰巧好用、在另一些场景明显次优。论文实测 EAGLE3 在 Qwen3-4B 上选的三层组 $\{L2, L18, L33\}$ 拼接矩阵熵只有 0.441,而 ELSI 选出的 $\{L5, L23, L35\}$ 熵达 0.627,说明默认规则确实存在可观的信息重叠与提升空间。
本文的目标是本文要把"给投机解码草稿模型选哪些目标层"从手工启发式变成有原理支撑的自动算法。具体目标有四:(1)建立一个同时衡量信息量与冗余度的选层框架——用矩阵熵刻画一组层拼接表示的信息量,用线性 CKA 刻画层间表示冗余;(2)设计能在真实模型深度(32–36 层)上高效运行的自动选层算法 ELSI 与 ELSI-C,把数千量级的组合搜索压到可行规模;(3)引入校准阶段的 token-熵过滤,提升选层统计量跨 prompt 的稳定性;(4)在 EAGLE3 风格投机解码中验证所选层组能超越 $[N-1]$ 和 $[2, N//2, N-3]$ 等固定基线,并反过来解释为什么某些默认规则依然有竞争力,为现有实践补上理论注脚。
与已有工作不同的是,已有层分析工作各管一段:层级函数研究(如 Transformer layers as painters)与 ShortGPT 等剪枝工作关注"哪些层可删";LoRA 自适应秩分配关注模块参数预算;表示几何研究刻画隐状态随深度的演化结构,但都不回答"为下游草稿条件化该联合选哪一组层"。本文的独特切入是把选层显式建模为"信息最大化 + 冗余最小化"的集合级目标:不是孤立评估每层再排序拼接,而是用拼接表示的矩阵熵 $S_1(\bar{Z}_L)$ 直接度量层集合的联合信息量——这与 EAGLE3 下投影融合的使用方式在数学上严格对应;再用 CKA 转移边界定位表示的"区室"结构,为搜索扩展提供多样性信号。"集合级联合优化 + 束重叠诊断"这一视角是本文区别于所有先前层分析工作的地方。
核心方法
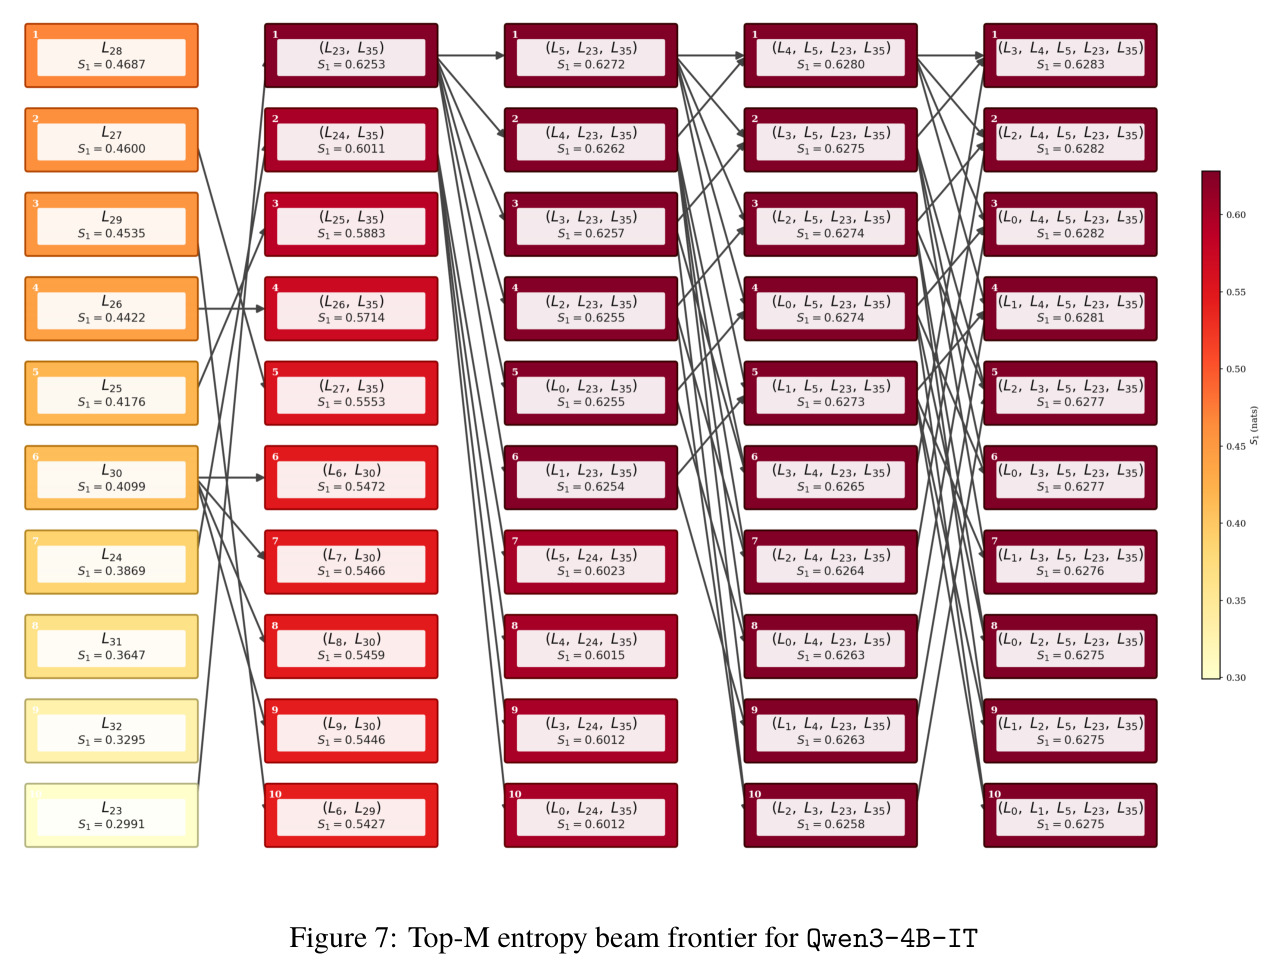
直觉上,草稿模型能看到什么信息完全由被选层集合这个"瓶颈"决定:不同深度的层携带互补信息,选得好多胜过选得多,因此需要一个能度量"一组层"联合信息量的函数来指导搜索。技术路线分三阶段。第一阶段是 token-熵过滤:对每个 token 位置计算预测熵 $H_t=-\sum_v p_t(v)\log p_t(v)$,只保留熵最高的前 $\rho=0.3$ 比例位置的隐状态,把跨 prompt 的逐层熵方差降低约 36%–48%。第二阶段构建层代表:对 200 条 ShareGPT 校准样本过滤后的隐状态,按块大小 $B=32$ 分块平均,得到每层的代表矩阵 $Z_l\in\mathbb{R}^{B\times d}$。第三阶段双算法选层:ELSI 用拼接表示的香农矩阵熵 $S_1(\bar{Z}_L)$ 做束搜索,直接寻找高信息量层组;ELSI-C 在熵初始化基础上改用条件 CKA 的转移分数引导扩展,避免选到表示冗余的层。整个流程只需一次校准前向,无需训练。
核心创新是把"一组层"当作整体来度量信息量:对拼接表示 $\bar{Z}_L$ 计算矩阵熵,归一化谱 $p_i=\sigma_i^2(X)/\|X\|_F^2$ 给出香农熵 $S_1=-\sum_i p_i\log p_i$。这比逐层熵高明在:拼接后谱的集中程度恰好反映层间互补性——冗余层拼在一起谱仍集中、熵几乎不涨,互补层会拉平谱、熵显著上升(图 3 显示不同种子层受益的伴层完全不同)。在此之上,ELSI 用束搜索把 $O(\binom{N}{m})$ 的组合空间压缩为每步只评估 $K_{\text{beam}}\times K_{\text{expand}}$ 个候选;ELSI-C 进一步用条件 CKA 矩阵的行差 $\delta_L(r)=\|M_L(r,:)-M_L(r-1,:)\|^2$ 度量候选层带来的"表示跃迁",优先扩展能让表示进入新区室的层,从机制上抑制冗余。token-熵过滤是配套的质量保障:低熵 token 多为高置信填充内容,其隐状态会稀释层间判别统计,滤掉后跨 prompt 方差降低 35.6%–48.4%。
方法步骤详情
完整流程五步。第一步,收集与过滤:对 200 条 ShareGPT 校准 prompt 前向记录全部 $N$ 层隐状态,计算每个 token 的预测熵 $H_t$,仅保留熵最高的 30% 位置。第二步,层代表构建:把 token 轴切成大小 $B=32$ 的不重叠块,块内平均并跨样本聚合,得到每层代表 $Z_l$。第三步,ELSI 束搜索(算法 1):[S1] 按单层熵选 $K_{\text{beam}}=10$ 个初始单层;[S2] 对束中每个集合 $L$,按拼接熵 $S_1(\bar{Z}_{L\cup\{l\}})$ 取 top-$K_{\text{expand}}$ 个扩展;[S3] 去重相同层组;[S4] 按集合熵剪回 $K_{\text{beam}}$ 个;从规模 2 迭代到 $m$,[S5] 输出熵最大的集合。第四步,ELSI-C(算法 2):同样熵初始化,但候选层 $r$ 的得分改为条件 CKA 转移分数——先算 $M_L(i,j)=\mathrm{CKA}(\bar{Z}_{L\cup\{i\}},\bar{Z}_{L\cup\{j\}})$,再取行差范数 $\delta_L(r)$,保留 top-$K_{\text{pool}}$ 候选后仍用熵去重剪枝。第五步,按 EAGLE3 方式用所选层组训练草稿模型,在 SpecBench 上以 30/60 节点、T=0/1 评估平均接受 token 数 τ。
技术新颖性
技术新颖性有三点。其一,目标函数新:用拼接表示的 Rényi 矩阵熵(取 $\alpha\to 1$ 的香农极限 $S_1$)作为层集合的联合信息量度量,与 EAGLE3 式下投影融合的线性组合方式严格对应;而先前工作(DIME、无穷可分核熵估计等)只把它用于单层表示分析或互信息估计,从未用于层组选择。其二,算法机制新:ELSI 首次把束搜索引入选层,使复杂度从组合爆炸降为与深度线性相关、可扩展到真实模型规模;ELSI-C 的"条件 CKA 转移分数"是把表示几何区室边界检测 $\delta_\ell=\|M_{\ell+1,:}-M_{\ell,:}\|^2$ 嵌入搜索过程的首例,让冗余控制在搜索中而非事后。其三,诊断视角新:论文用束重叠分析解释了为什么 $[2, N//2, N-3]$ 这类位置规则有时依然有效——它们恰好落在高熵束区域内,为理解现有方法提供了可解释性框架,而不只是报告一个更强的数字。
实验结果
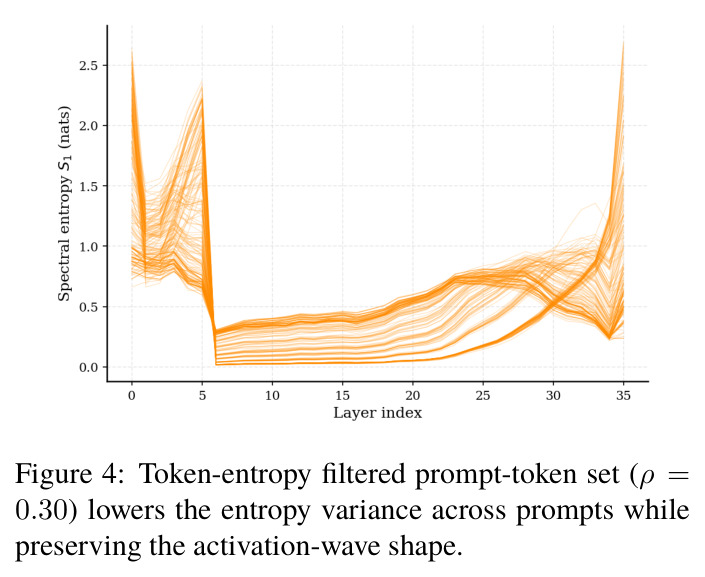
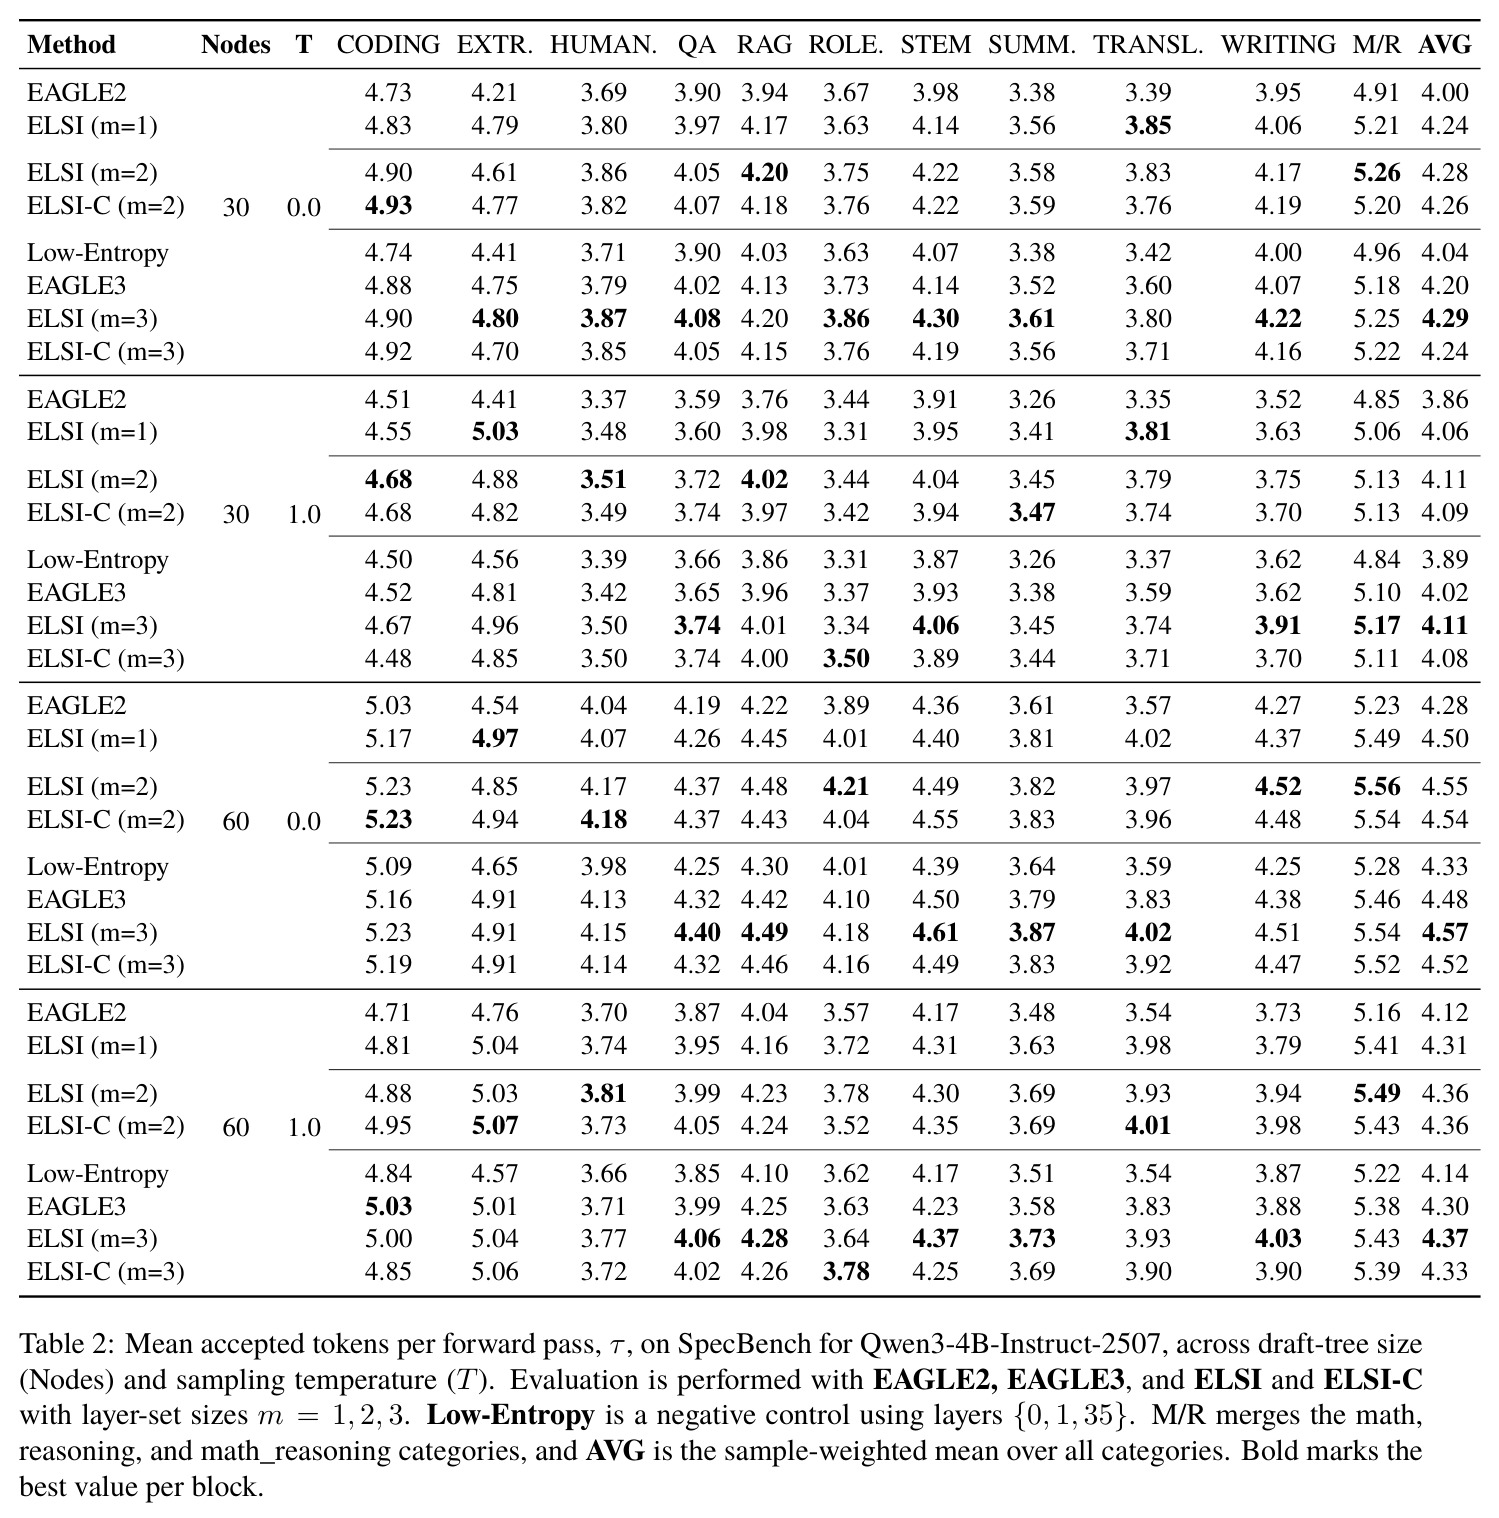
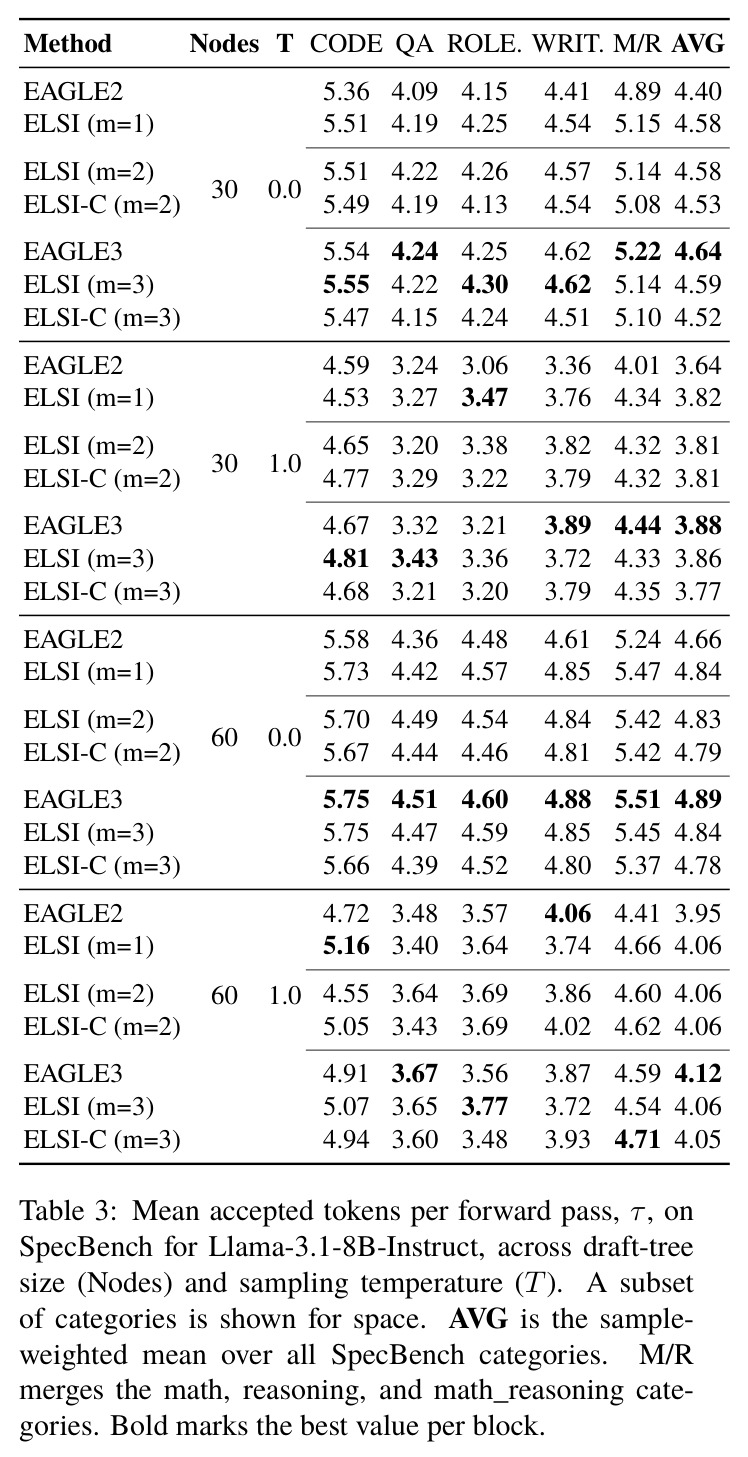
分析层面:两模型都呈"激活波"——逐层熵沿深度非均匀起伏,可划分为早期(0–6)、中期(7–28)、晚期(29–35)三个区室;Qwen3-4B 峰值在第 28 层,Llama-3.1-8B 约在第 27 层。CKA 分析显示 Qwen 区室边界更多,Llama 中部存在大范围高冗余区。token-熵过滤把跨 prompt 熵方差在早/中/晚期分别降低 48.4%/45.8%/35.6%。选层质量(表 1):Qwen3 的 ELSI 三层组 $\{L5,L23,L35\}$ 熵 0.627,显著高于 EAGLE3 $\{L2,L18,L33\}$ 的 0.441;Llama 的 ELSI 组熵 0.910 vs 0.687。解码性能(表 2):Qwen3-4B 上 ELSI($m{=}3$) 全设置平均最优,比 EAGLE3 提升 1.6–2.2%(+0.085 τ)、比 EAGLE2 提升 6.1–7.3%,如 30 节点/T=0 时 4.29 vs 4.20 vs 4.00;单层 ELSI 即匹敌 EAGLE3 三层。翻译、摘要、STEM 分别提升 2.6–5.6%、2.1–4.2%、2.4–3.9%;低熵负对照 $\{0,1,35\}$ 全程垫底(AVG 4.04)。Llama 上(表 3)收益收窄:ELSI($m{=}1$) 比 EAGLE2 高 2.8–4.9%,单层达 EAGLE3 约 99.0% 效率(60 节点/T=0:4.84 vs 4.89),$m{=}1{..}3$ 的 AVG 差异仅 0.017 τ,ELSI($m{=}3$) 平均落后 EAGLE3 1.0%,但 T=1.0 时 Roleplay 反超 4.7–5.9%、Coding 反超 3.0–3.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 投机解码(SpecBench,Qwen3-4B-Instruct-2507,30 节点/T=0) | 平均接受 token 数 τ | ELSI (m=3) 4.29 | EAGLE3 4.20;EAGLE2 4.00 | 较 EAGLE3 +2.1%,较 EAGLE2 +7.3% |
| 投机解码(SpecBench,Qwen3-4B-Instruct-2507,60 节点/T=0) | 平均接受 token 数 τ | ELSI (m=3) 4.57 | EAGLE3 4.48 | +2.0%(四设置全平均 +1.6~2.2%,+0.085 τ) |
| 投机解码(SpecBench,Llama-3.1-8B-Instruct,60 节点/T=0) | 平均接受 token 数 τ | ELSI (m=1) 4.84(仅 1 层隐状态) | EAGLE3 4.89(3 层);EAGLE2 4.66 | 单层达 EAGLE3 约 99.0%,超 EAGLE2 +3.9%(全设置 +2.8~4.9%) |
| 层组信息量(200 条 ShareGPT 校准,m=3) | 拼接表示矩阵熵 S1 | Qwen3: 0.627;Llama: 0.910 | EAGLE3: 0.441 / 0.687 | 分别 +42.2% 与 +32.5% |
| 校准统计稳定性(token-熵过滤,ρ=0.30) | 跨 prompt 逐层熵方差降幅 | 早期层(0–6)降低 48.4% | 不过滤(全量 token 统计) | 同时中期(7–28)降 45.8%、晚期(29–35)降 35.6%,且保留激活波形态 |
局限与改进
作者承认的局限:收益在层间冗余大的模型(如 Llama-3.1-8B)上明显缩水,$m{=}3$ 时平均反落后 EAGLE3 1.0%,说明选择的价值依赖表示多样性这一前提;更少层数带来的更小下投影层($|L|d\times d$)的吞吐优势未在带宽受限的边缘设备上实测,留作未来工作。我补充几点:(1)每个候选层组都要重训一个 EAGLE 草稿模型(8×H100 上用 ShareGPT+Ultrachat 蒸馏),熵与最终接受率之间只有相关性证据,搜索并未用接受率闭环,Llama 上熵最高的组并非最优即为佐证;(2)选层统计来自 200 条 ShareGPT 校准分布,跨域(代码、多语言、长文)迁移未验证;(3)只测了两个 32/36 层模型,更深模型以及 $K_{\text{beam}}$、$\rho$、$B$ 等超参敏感性缺少系统消融;(4)评估只报 SpecBench 的平均接受 token 数 τ,未报端到端延迟、显存与实际吞吐;(5)论文未提及开源代码。
独立分析的弱点
独立分析几点弱点。第一,熵最大化只是接受率的代理指标:低熵负对照($\{0,1,35\}$,AVG 4.04)只证明"差层组确实差",未证明"更高熵必然带来更高接受率"——Llama 上 ELSI($m{=}3$) 熵 0.910 全场最高,平均却落后 EAGLE3 1.0%,暴露代理与真实目标之间的缝隙。改进方向:把草稿训练后的接受率作为束搜索最终剪枝信号,或发展免训练的接受率估计器先粗筛。第二,校准分布单一且样本少:仅 200 条 ShareGPT 样本,而图 1 显示熵随 prompt 波动很大,过滤只降低未消除方差,面对代码、长文等分布漂移可能选出不稳健的层组,可引入多域混合校准或按域路由的选层。第三,静态选层假设:整条流水线假定层组一次选定、全程固定,而不同任务下各层价值不同(表 2 中翻译与写作的提升差异很大),方向是输入自适应的动态层融合或 per-token 门控。第四,搜索与训练成本耦合:评估每个候选层组都需在 8×H100 上重训草稿模型,无法真正大规模搜索,可用线性探针、logit 蒸馏损失等轻量代理指标先做粗粒度筛选。
未来方向
作者提出的方向:把框架推广到更多样的目标模型与草稿条件化策略;在边缘设备上验证小层组($m{=}1,2$)因下投影参数减少而带来的内存带宽与吞吐收益;把多层隐状态选择扩展到投机解码之外的任务,尤其是嵌入/表示学习任务和可解释性研究。基于其成果还可延伸:一是理论层面,建立矩阵熵与接受概率之间的量化关系,回答"熵提升 0.1 大约值多少 τ",让代理指标有明确刻度;二是把 ELSI 与量化、层剪枝、KV 缓存压缩联合优化——它们共享"哪些层值得保留表示"这一核心问题,CKA 区室边界(如 Llama 首末层外普遍高冗余)可直接指导剪枝;三是探索逐输入或逐任务的动态层组(MoE 式条件化),把静态选择升级为路由;四是将 CKA 区室分析用于训练动力学监控,在预训练/微调中定位值得加大投入或提前收敛的深度区间。
复现评估
复现条件中等偏上。有利因素:两个目标模型(Qwen3-4B-Instruct-2507、Llama-3.1-8B-Instruct)与校准/训练数据(ShareGPT、Ultrachat)、评测集(SpecBench)全部公开可得;算法 1/2 伪代码完整,关键超参明确($\rho=0.3$、块大小 $B=32$、200 条校准样本、$K_{\text{beam}}=10$,另有 $K_{\text{expand}}$、$K_{\text{pool}}$ 记号);矩阵熵与线性 CKA 都是几十行代码即可实现的成熟度量,选层分析部分(激活波、CKA 区室、表 1 熵值)单卡数小时即可复现。不利因素:论文未附开源代码链接;复现表 2/3 的解码性能需基于公开 EAGLE 代码库,对每个候选层组在 8×H100 上用 ShareGPT+Ultrachat 蒸馏训练草稿模型,算力门槛高;训练轮数、学习率、草稿结构等细节正文未给出,需自行对齐 EAGLE3 官方配置。总体判断:分析与选层结论易复现,端到端性能数字复现成本高但路径清晰。
论文图表
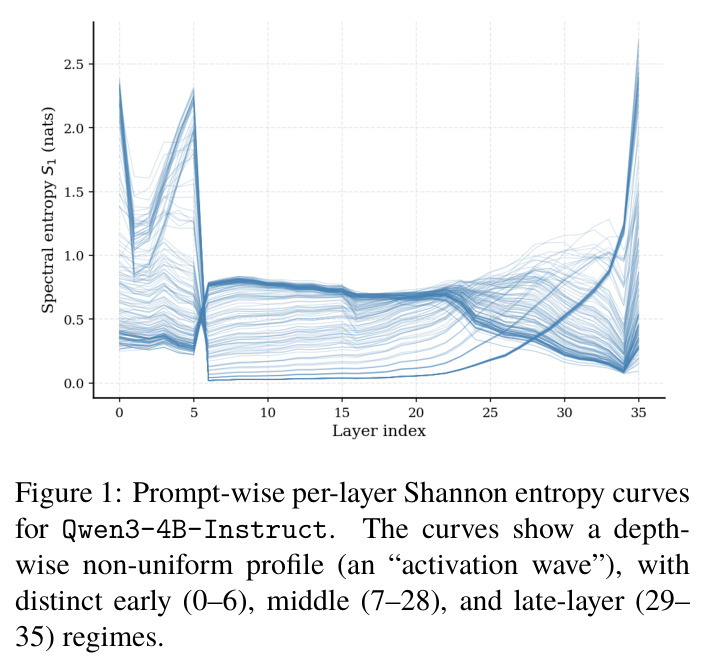
展示不同 prompt 下逐层香农熵曲线:呈深度方向的"激活波"非均匀轮廓,可清晰划分为早期(0–6)、中期(7–28)、晚期(29–35)三个区室;且初始层与末层的熵在不同 prompt 之间方差极大,导致逐 prompt 的层排序不稳定。
这张图是论文标题'激活波'的直接来源,一图同时交代两个动机:层信息量沿深度非均匀分布(值得挑选)、跨 prompt 方差大(需要 token 过滤来稳定统计)。
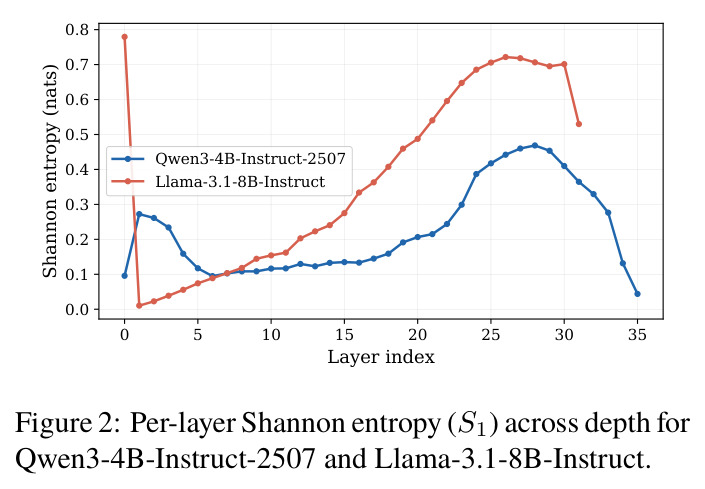
两模型逐层矩阵熵 $S_1$ 对比:Qwen3-4B 呈高-低-高形态、峰值在第 28 层;Llama-3.1-8B 首层高熵、随后骤降、约在第 27 层回升达峰。据此论文为单层选择增加了"层索引须位于中层之后"的约束。
证明激活波轮廓跨模型族普遍存在,是方法从 Qwen 推广到 Llama 的经验基础,也解释了 EAGLE2 只取末层(如 Qwen 的 L35,熵仅 0.044)为何次优。
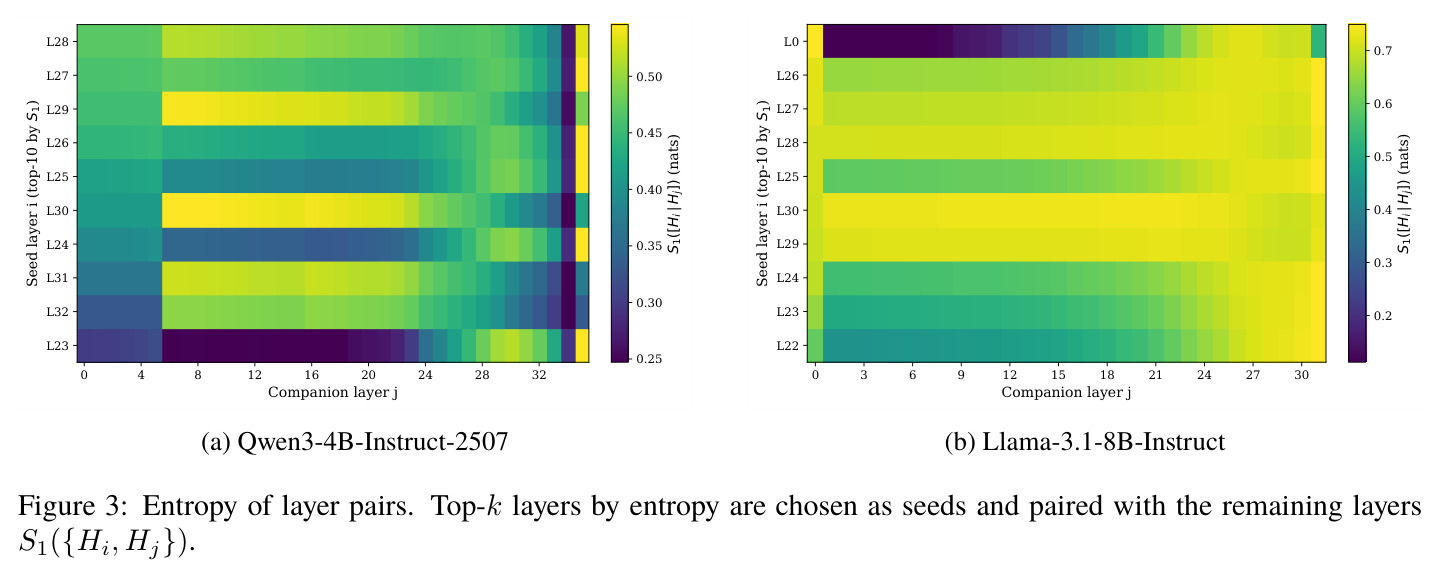
以逐层熵 top-k 层为种子,展示其与所有伴层拼接后的对熵 $S_1(\{H_i,H_j\})$ 曲线:部分层对提供强互补方向、拼接熵大幅上升,另一些近乎冗余、熵几乎不变;且不同种子层受益的伴层完全不同。
这是'必须联合优化层集合、而非逐层独立挑选再拼接'的直接证据,论证了以拼接表示熵作为集合级目标函数的合理性,是方法成立的前提。