AI 智能体能学上巅峰吗?长期游戏智能体竞赛中的启发式学习评估 Can AI Agents Learn Their Way to the Top? Evaluating Heuristic Learning in a Long-Running Game Agent Competition
构建 AAArena 基准,评估 AI 智能体通过改写游戏代码登顶人类天梯的能力
前置知识
启发式学习
与通过梯度下降更新网络参数的强化学习不同,启发式学习让 AI 智能体通过直接修改可编辑的软件结构来积累经验:策略代码、状态表示、测试、配置和记忆都可以被改写,而基础模型权重保持不变。反馈可以是奖励、测试结果、日志或对局回放。可执行策略及其配套软件与记录合称“启发式系统”。
本文提出的对抗启发式学习(AHL)就是 HL 在对抗任务上的实例化,理解 HL 才能明白论文里“学习”发生在代码修订而非参数更新层面。
Elo 等级分
通过 pairwise 胜负结果估计选手相对实力的评分体系,分差对应期望胜率。AAArena 中对手池的 Elo 全程冻结,被评智能体的成绩取整个运行期间所有官方评估快照的最高分,即 $\mathrm{Score}(B_s, B_\ell) = \max_{P \in V} \mathrm{br}(P)$,其中 $V$ 是官方评估过的快照集合。
主表、雷达图和所有学习轨迹图都以 Elo 和排名为核心指标,不懂 Elo 就无法读懂数据。
On-policy 与 Off-policy
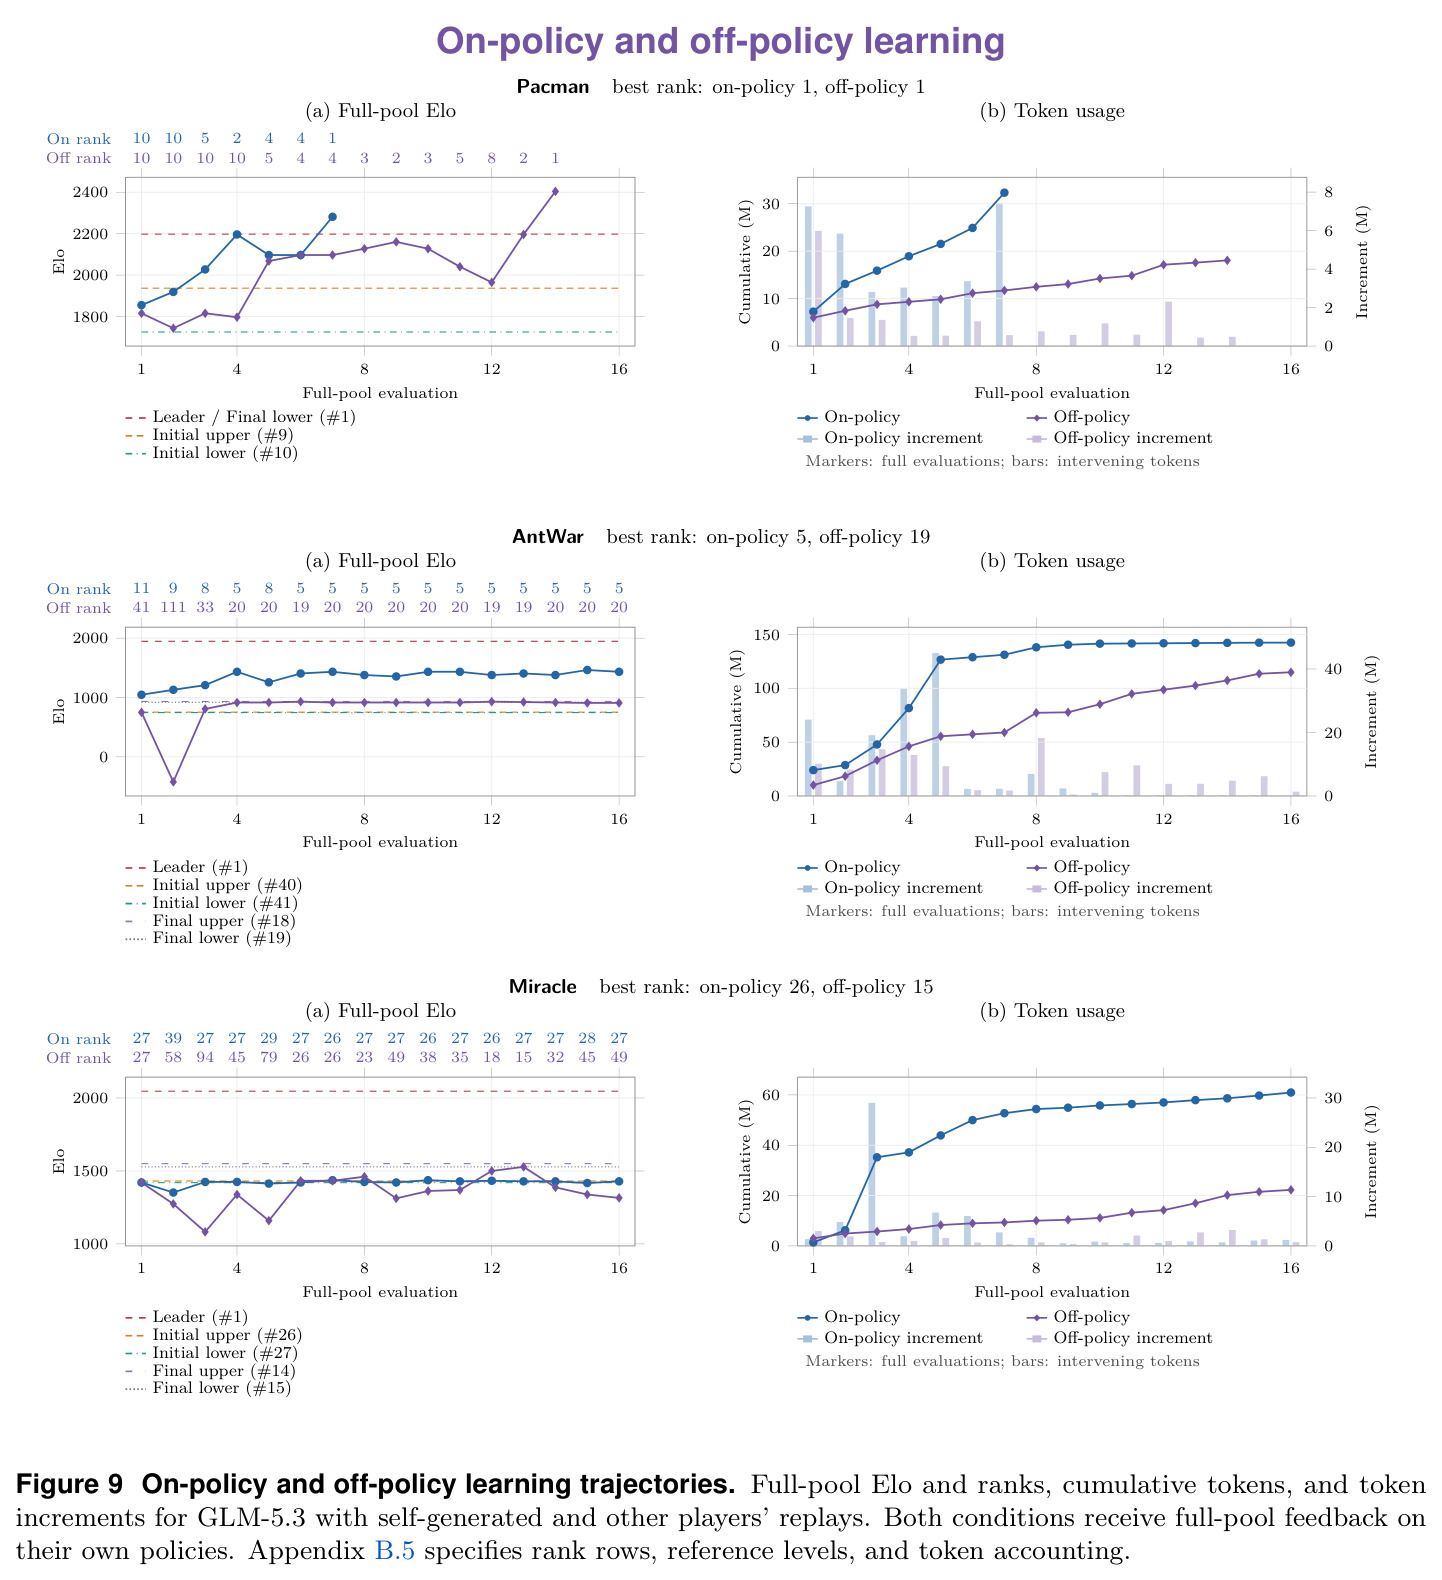
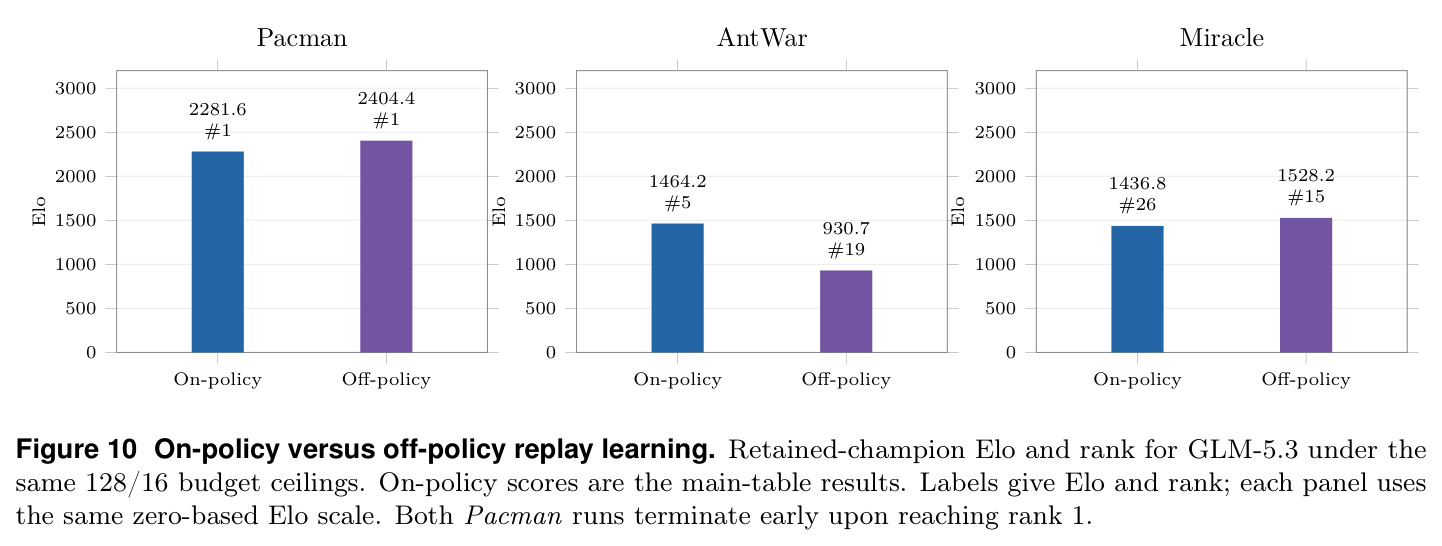
在本文语境中只标注回放经验的来源:on-policy 指自己策略参加对局产生的回放,off-policy 指对手池中其他程序之间对局的回放。这与强化学习中按训练算法划分 on/off-policy 的含义不同,作者特别做了说明。
第 4.5 节的核心实验证明智能体能从“别人的对局”中学习并突破自对弈平台期,是该文最有启发的发现之一。
规则复杂度度量(AST 节点数与规则原子数)
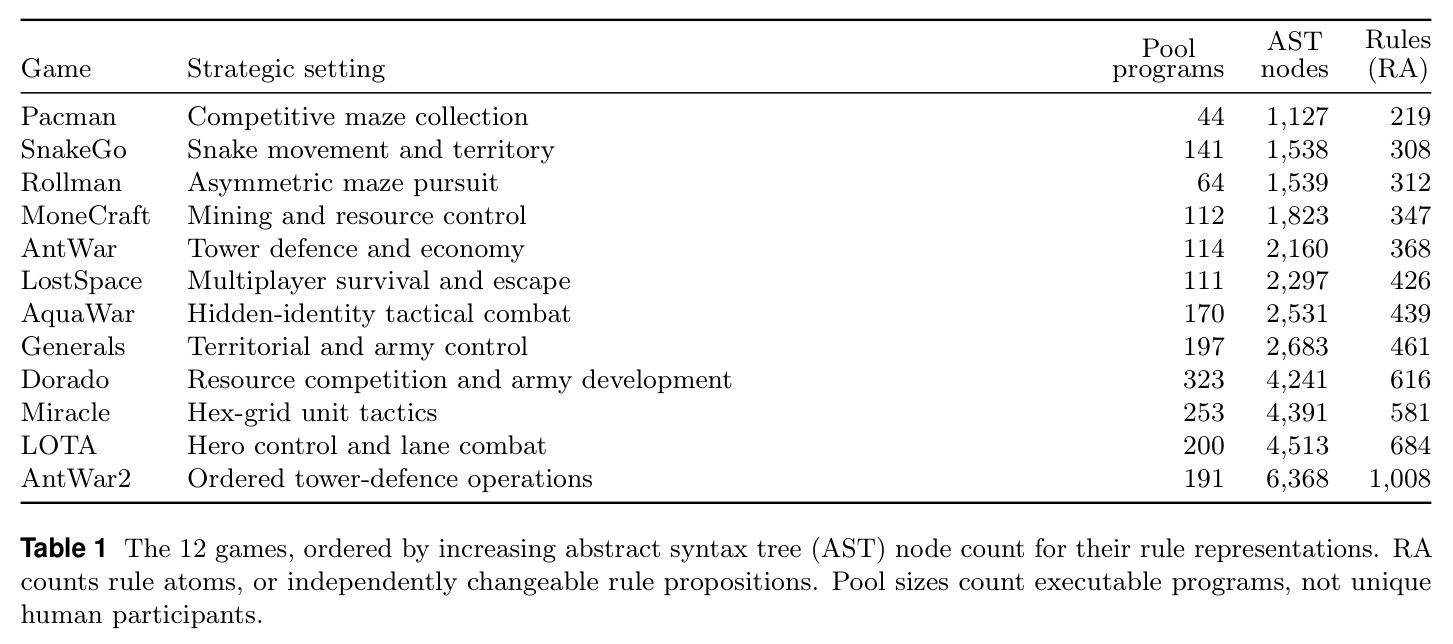
$\mathit{CAST}(G) = |\mathrm{AST}(R_G)|$ 是游戏规则文本解析后的抽象语法树节点数;规则原子 RA 是可独立修改的规则命题数量。二者是表示相关的代理度量,作者强调它们不估计精确的 Kolmogorov 复杂度 $K(R)=\min_{p:U(p)=R}|p|$ 或最优博弈难度。参照系:围棋 501 AST/125 规则,国际象棋 1,551 AST/238 规则。
论文最重要的相关性结论——规则描述越复杂 AI 越难登顶——就是用这两个度量对 12 个游戏排序得出的。
Agent Harness
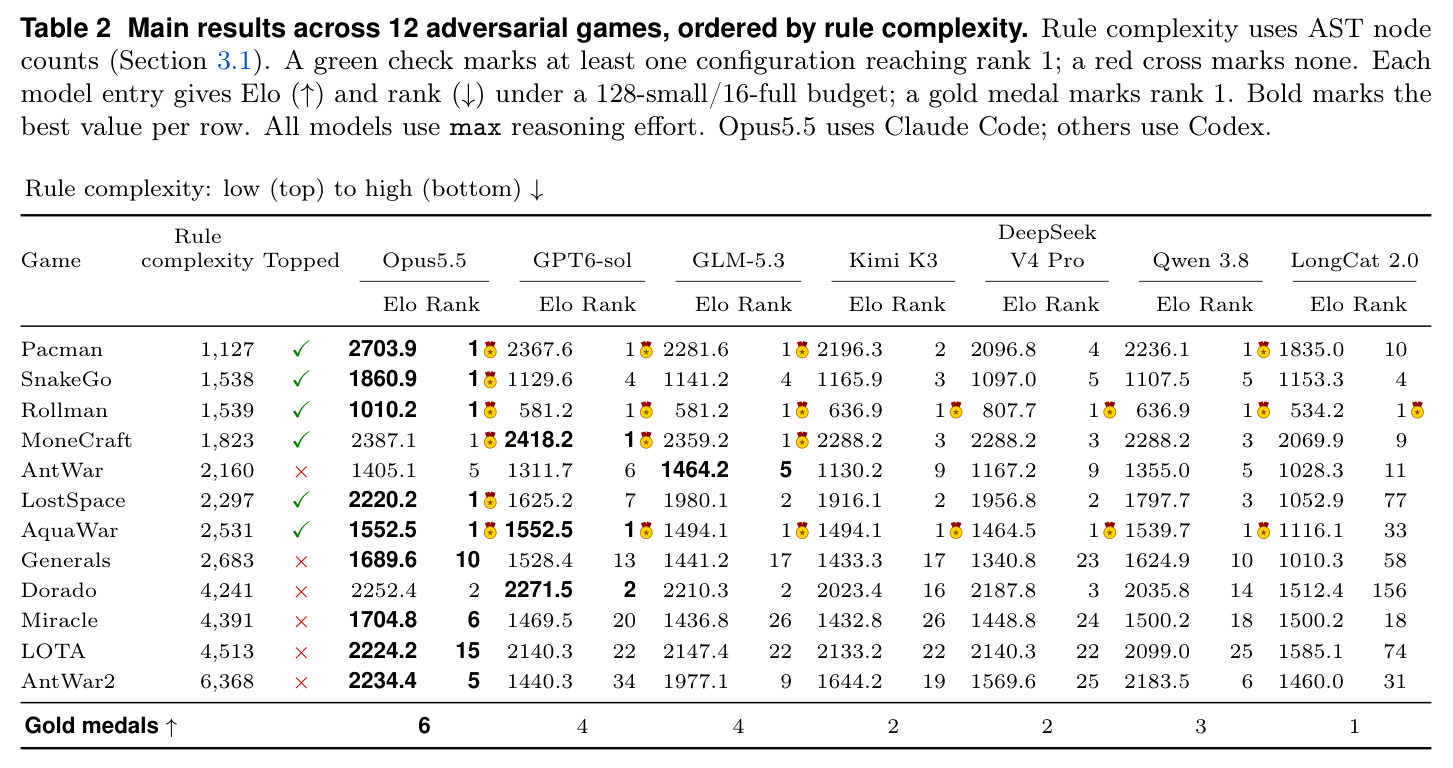
包裹基础模型的执行框架,为模型提供读写文件、运行程序、调用工具的代理环境。本文主实验中只有 Opus5.5 搭配 Claude Code harness,其余六个模型(GPT6-sol、GLM-5.3、Kimi K3、DeepSeek V4 Pro、Qwen 3.8、LongCat 2.0)统一搭配 Codex,全部使用最大推理力度。
主结果比较的是“模型 + harness”整体配置,理解这一点才能正确解读金牌数差异并注意其中的混淆因素。
研究动机
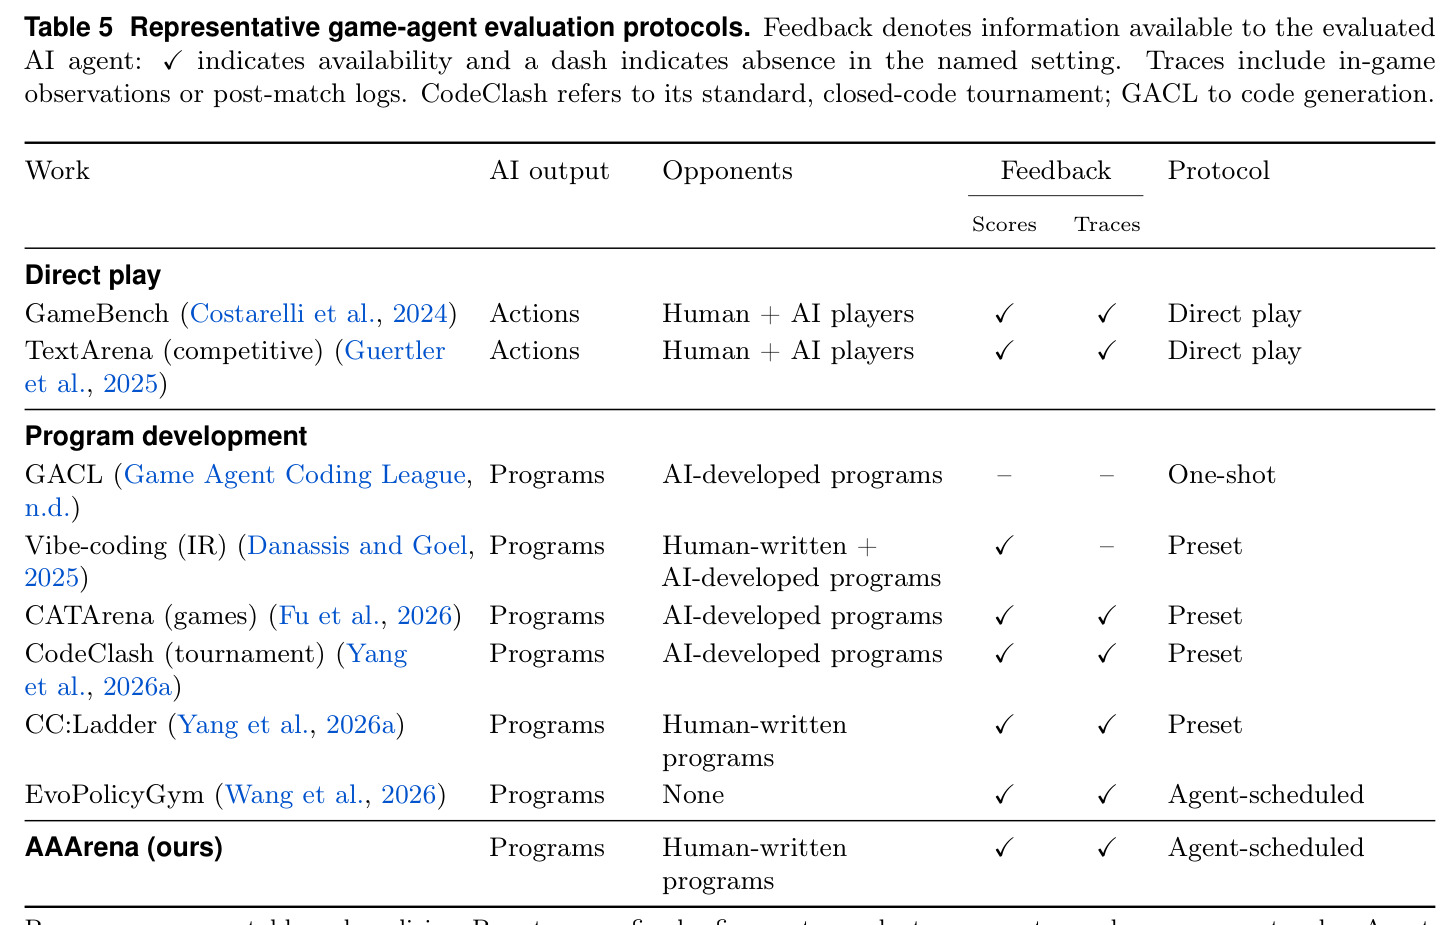
现有游戏类评测存在两个断层。直接对战类基准(GameBench、TextArena、BALROG、LMGame-Bench 等)测的是模型在对局中的即时决策,衡量的是“玩家”而非能把游戏理解转化为可执行程序的开发者;程序开发类评测(GACL 一次性生成、CATArena/CodeClash/CC:Ladder 的预设轮次、vibe-coding 锦标赛)要么缺少人类程序对手池,要么由外部固定日程驱动,智能体无法自主决定何时测试、与谁测试。另一边,强化学习虽在围棋、将棋等取得突破,却需要海量交互样本,且对手构成环境的一部分,对手策略一变学习目标就漂移,在有限交互下持续适应仍是公开难题。真实竞赛中“读规则→选对手→复盘回放→改代码→在预算内爬天梯”的完整闭环,此前没有任何基准能够衡量。
本文的目标是本文目标有三层。第一,把清华大学智能体竞赛(Saiblo 平台)多年积累的 12 个真实对抗游戏、可运行后端和 1,920 个人类参赛程序打包成统一基准 AAArena,覆盖战术战斗、领地控制、资源管理和生存四类玩法。第二,形式化对抗启发式学习(AHL):AI 智能体解读规则、SDK 与回放,修订可执行游戏策略代码,在 $B_s = 128$ 次小对局单位与 $B_\ell = 16$ 次全池评估两个预算内自主安排修订、本地验证与反馈请求,目标是登上冻结人类天梯的第一名。第三,在 7 个模型-harness 配置上系统评测,并拆解对手选择、反馈密度、批大小、on/off-policy 回放来源等因素对策略改进的影响。
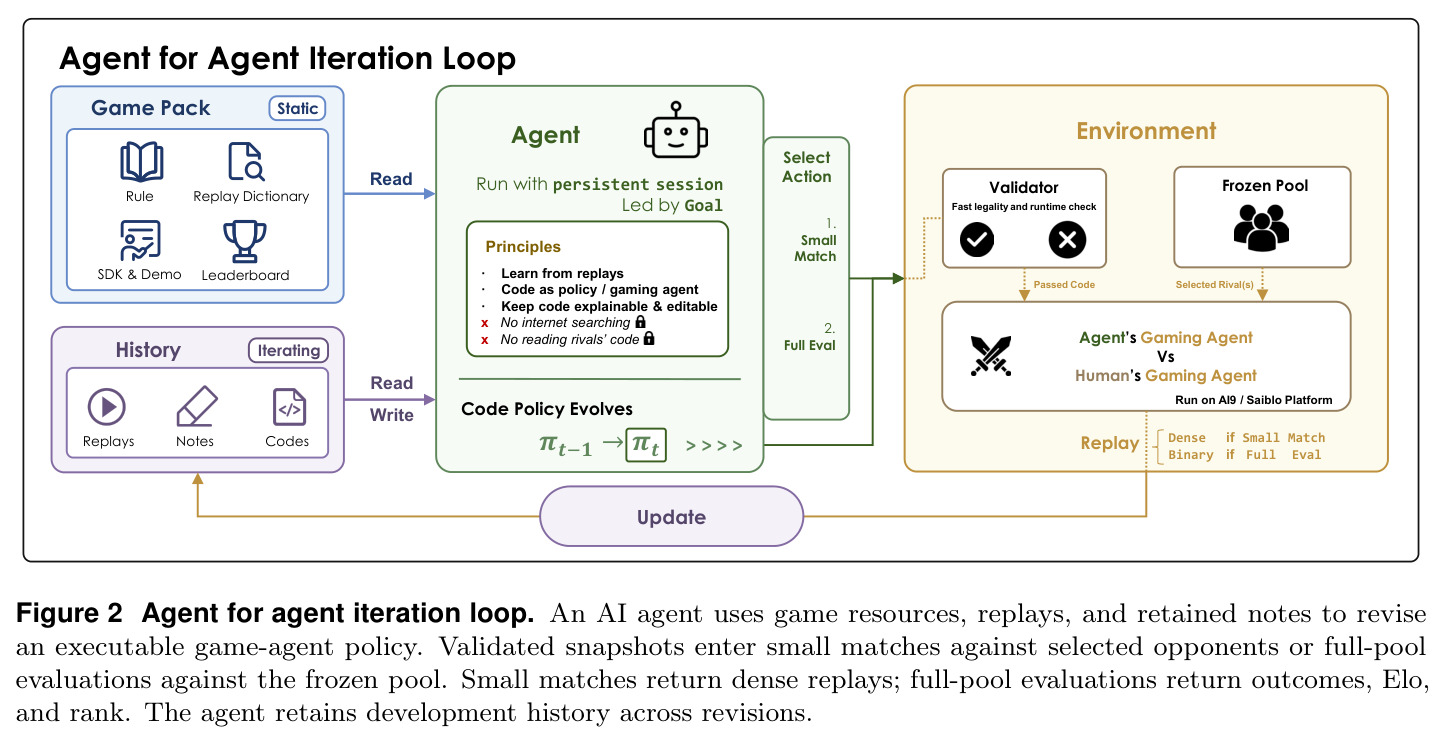
与已有工作不同的是,本文的独特切入是把“AI 智能体本身当作学习引擎”:与调参数的强化学习相反,它改写的是代码与配套软件,基础模型参数 $\theta$ 全程冻结。与 Table 5 中已有协议对比,AAArena 的差异点清晰可辨:对手是 1,920 个人类撰写的存档程序而非 AI 生成的程序;反馈同时包含分数与完整对局回放 trace;外层日程是 agent-scheduled——智能体自己决定何时小对局诊断、何时全池评估,而非 preset 固定轮次或 one-shot 单次生成。再叠加保留冠军计分、双预算分离“定向假设检验”与“全局排名校准”,这套协议第一次把长程策略开发能力变成可量化、可比较的任务。
核心方法
直觉上,这是把真人选手“赛后复盘、修改棋谱”的整个过程交给 AI 智能体。技术上,启发式系统由可执行策略 $P$ 和开发状态 $C$(配套工具、测试、实验记录、记忆)组成。Algorithm 1 循环执行三步:智能体通过交互或现成记录获取对局经验;结合游戏资源 $R$ 与历史 $(P, C)$ 解读反馈;然后修订 $P$ 与 $C$,全程权重 $\theta$ 不变。有效的代码快照经本地校验后,可发起两类反馈请求:小对局(智能体选定 1–8 个对手,返回稠密回放,用于定向诊断)或全池评估(对完整冻结人类程序池打分,返回 Elo、排名与逐对手结果,用于全局校准)。运行结束取 $\mathrm{Score}(B_s, B_\ell) = \max_{P \in V} \mathrm{br}(P)$,即历史最高官方评估 Elo,这保证后期探索性改坏代码不会丢掉已到手的最好成绩。
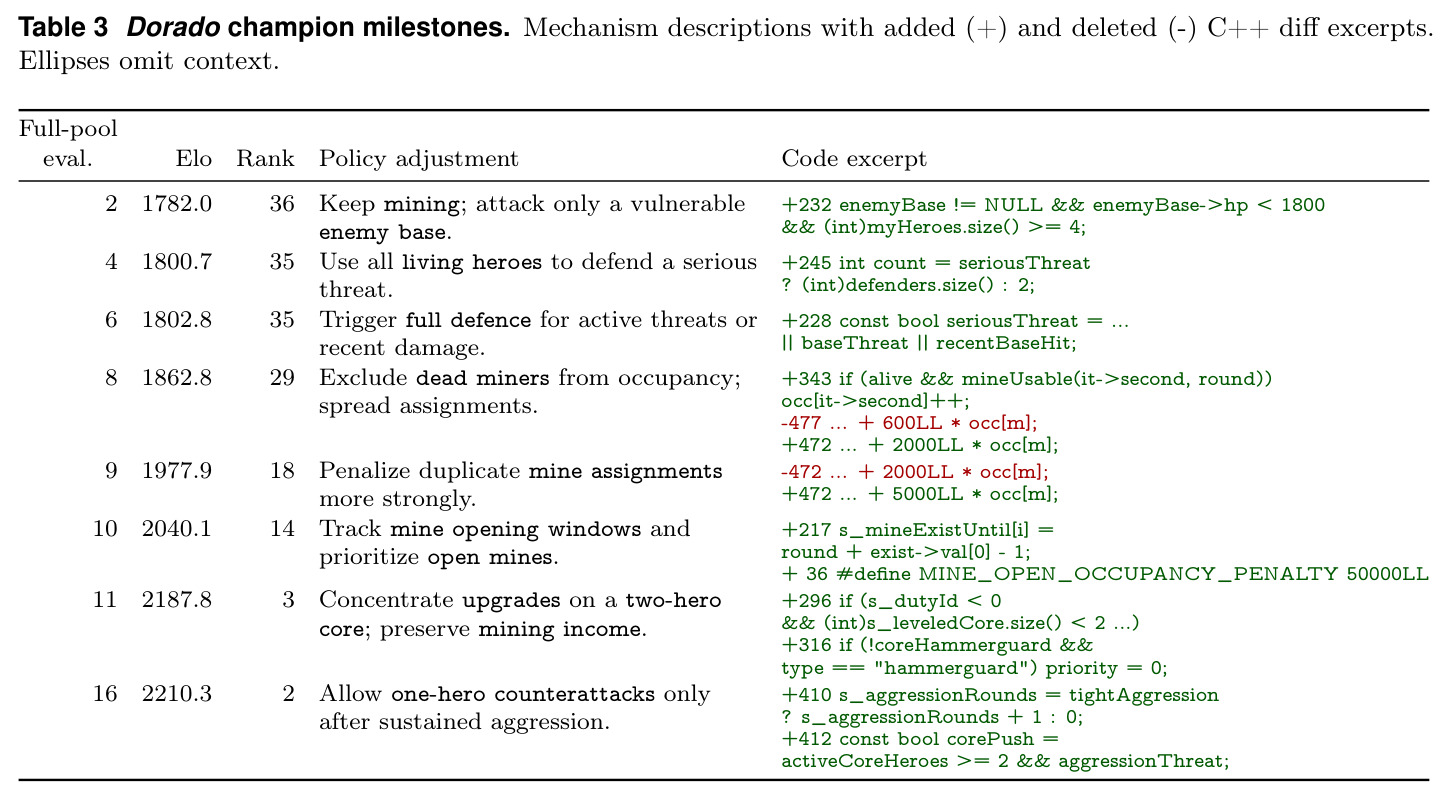
核心创新有三。其一,AHL 把“学习”重定义为对软件的直接修订:不需要梯度、不需要重训,反馈形态是回放与胜负,学习产物是可解释、可回滚的策略代码(Dorado 案例中可以看到逐条 C++ diff)。其二,双预算协议 $B_s = 128$、$B_\ell = 16$ 把两类反馈分开计价并由智能体自主调度,这是与 CATArena、CodeClash 等 preset 轮次基准的本质区别——评测对象变成了“会不会安排实验”这一元能力。其三,保留冠军计分 $\max_{P \in V} \mathrm{br}(P)$ 配合“登顶即停”规则,模拟真实竞赛的冲榜激励,同时避免全池评估次数浪费在已确认的退步快照上。三者合起来,使基准既测策略质量又测探索与预算管理策略。
方法步骤详情
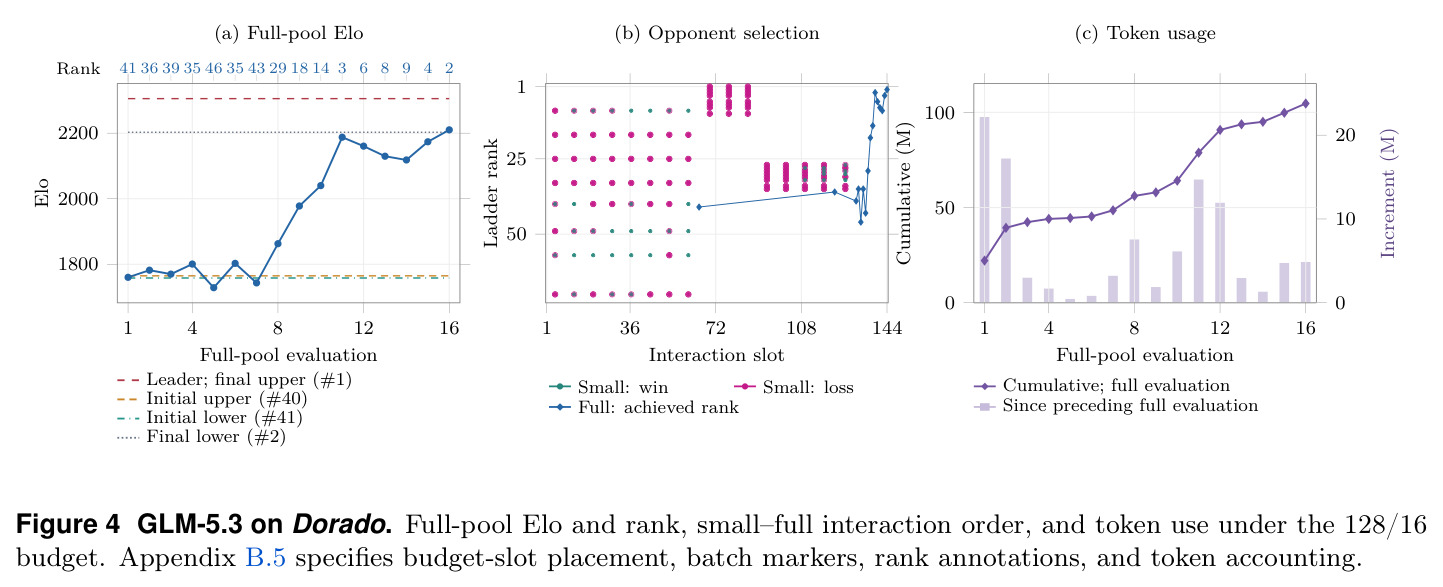
第一步资源下发:智能体获得规则文本、SDK、demo 程序、回放文档、排行榜与一个允许参考的程序,初始策略 $P_0$ 来自 SDK。第二步静态校验:每次提交先过 validator 与规则字典,做快速合法性与运行时检查。第三步小对局:消耗 $B_s$ 配额(每对手一单位),智能体选 1、2、4 或 8 个对手,返回逐回合状态-动作-后果的稠密回放(消融条件下退化为仅胜负的二值反馈)。第四步全池评估:消耗 $B_\ell$ 配额之一,对完整冻结池(44–323 个程序不等)打分,返回 Elo、排名与逐对手结果。第五步复盘修订:智能体阅读回放、失败日志与自己的开发笔记,改写 $P$ 或更新 $C$,失败修订可参照历史快照回滚。第六步终止与计分:用尽 128/16 预算或达到 rank 1 即停,输出历史最高 Elo 快照。Dorado 案例完整展示该流程:rank 41→36→14(修正矿井分配、排除死矿工、追踪矿开放窗口)→3(集中升级两核心英雄,+147.7 Elo)→2(仅在持续受压后允许单英雄反击)。
技术新颖性
技术新颖性在于评测对象与协议的双重重构。对象上,测的是“培养玩家的教练”(AI agent)而非“玩家”(游戏程序本身),填补了 GameBench 类直接对战评测与 GACL 类一次性生成之间的空档。协议上,agent-scheduled 双预算设计没有先例:EvoPolicyGym 虽也由智能体调度回合数,但对手池为空且验证反馈隐藏;AAArena 用人类程序构成真实天梯并全程公开 Elo 与排名。规则复杂度谱系(1,127–6,368 个 AST 节点、219–1,008 条规则原子)使“规则理解难度”第一次能与成绩定量关联。此外,对回放来源(on/off-policy)、对手选择策略、回放密度、批大小的控制变量消融,把“智能体如何学习”本身变成了研究对象,而不只是给出一个分数排行榜。
实验结果
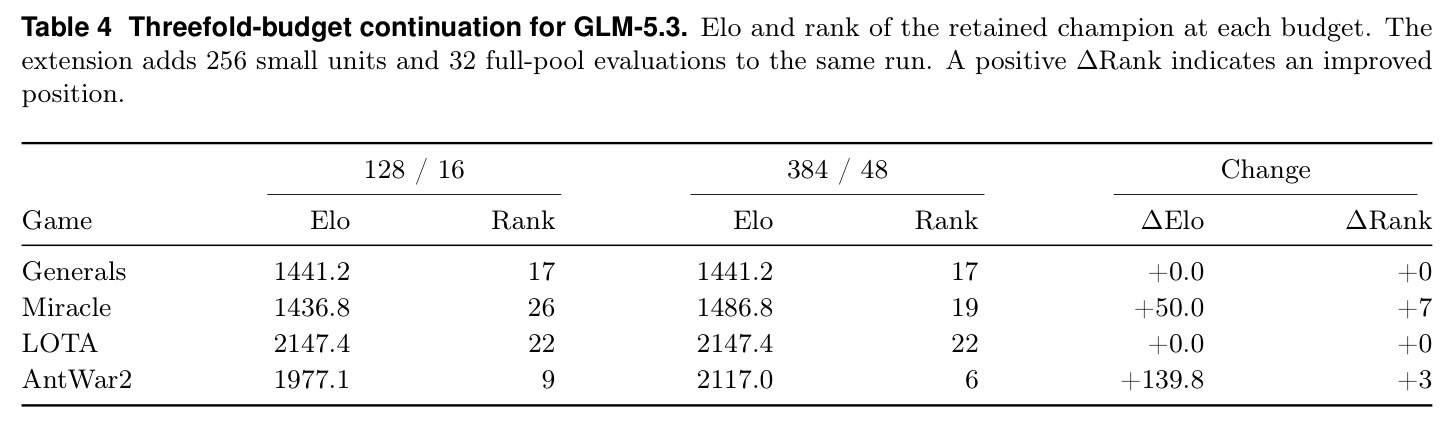
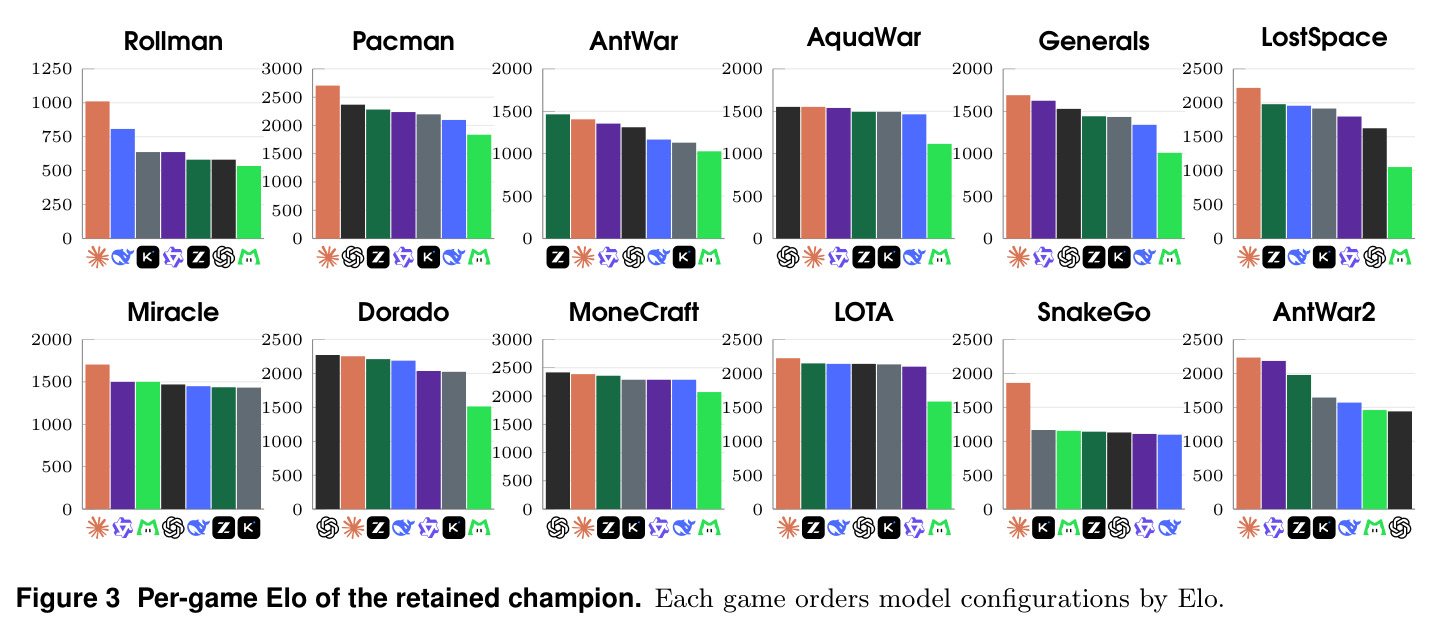
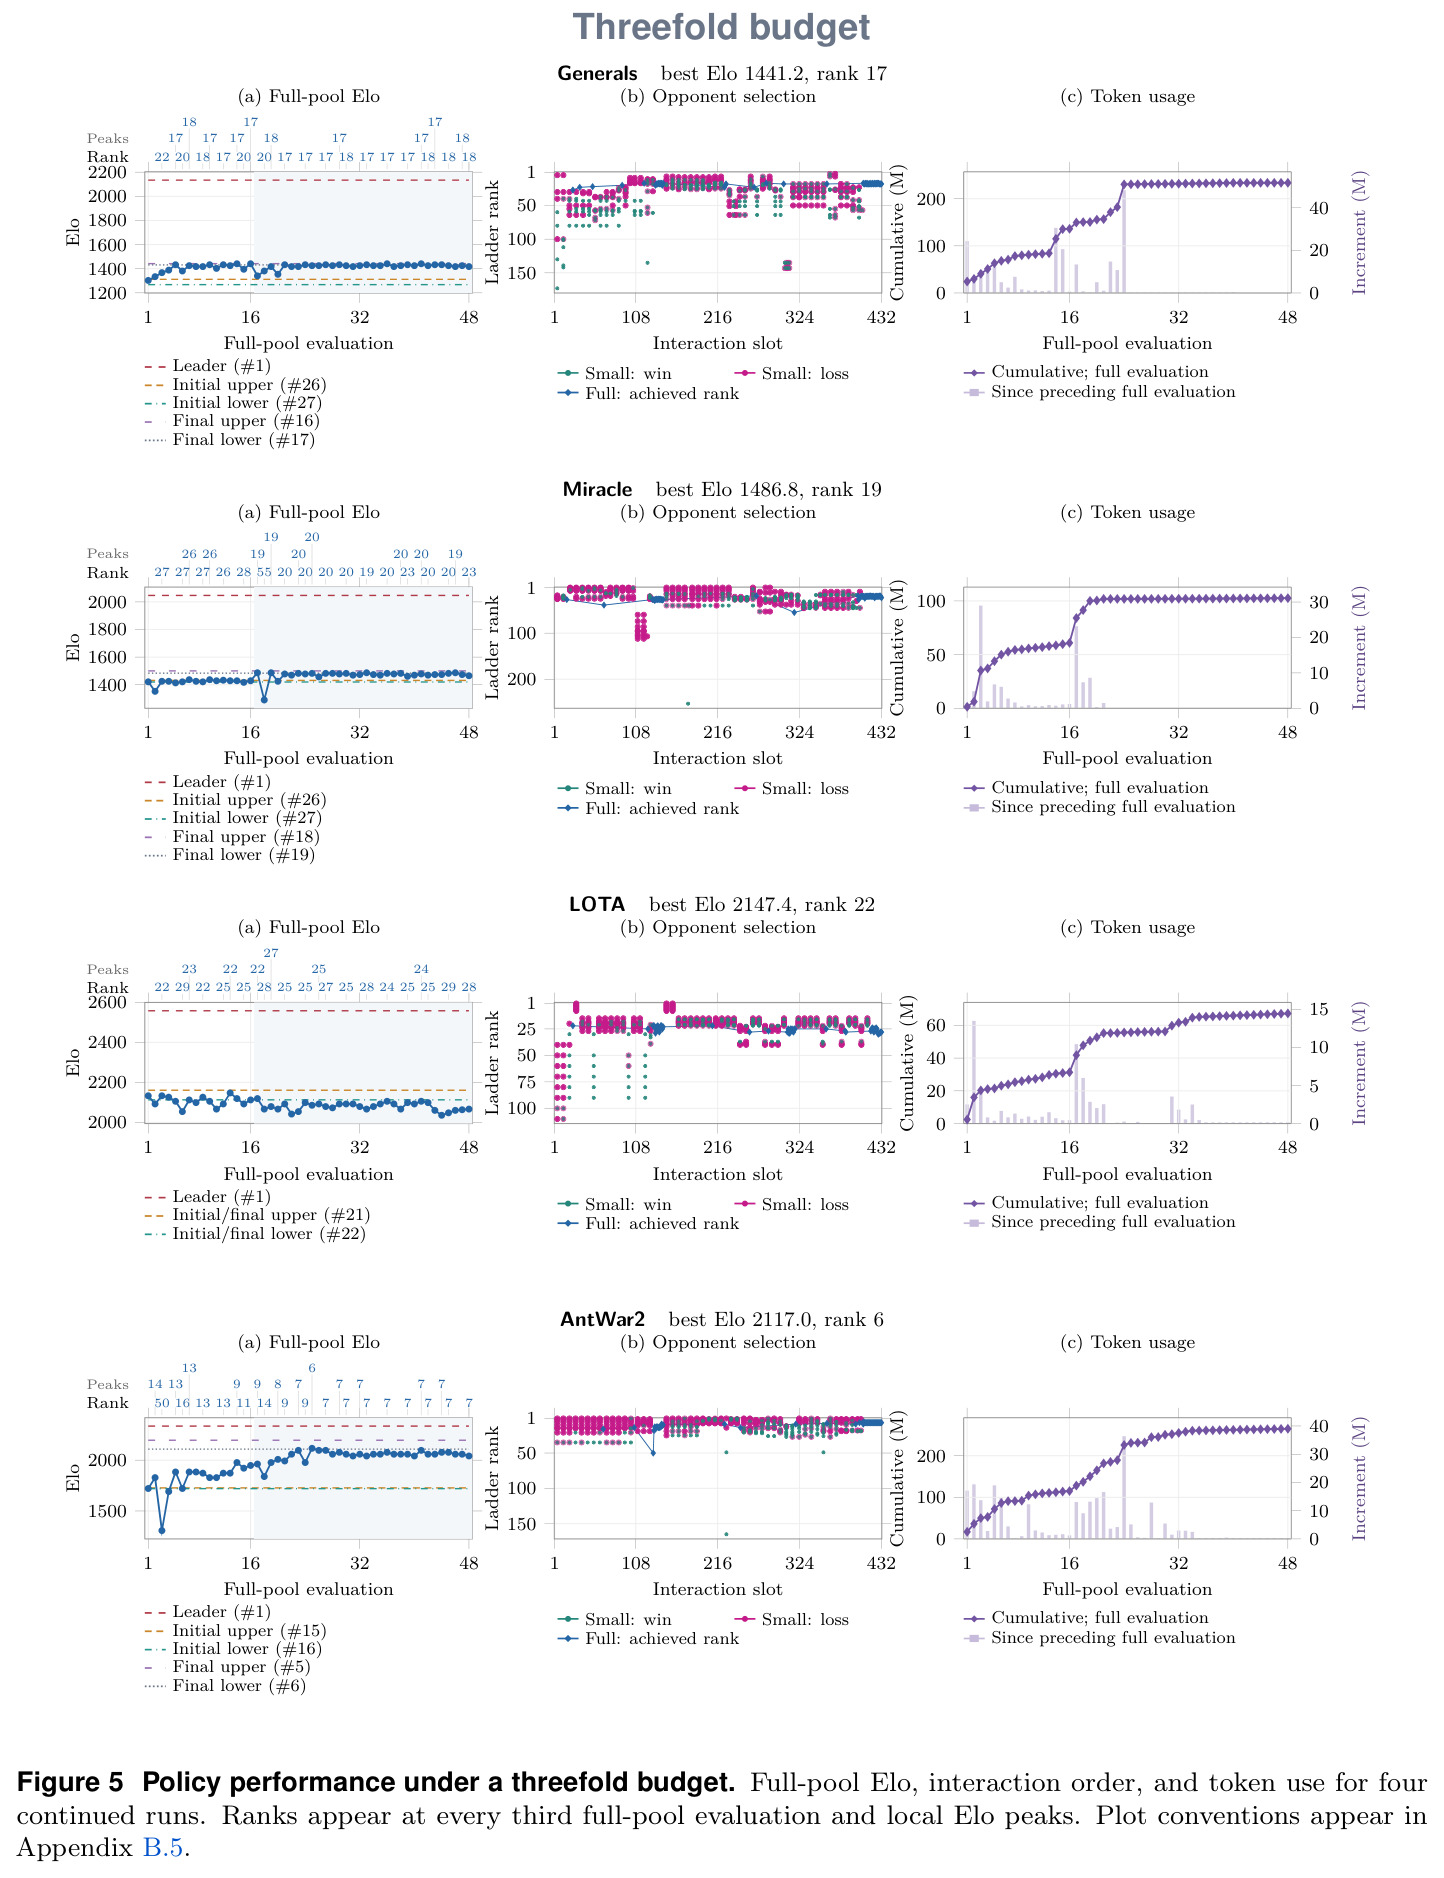
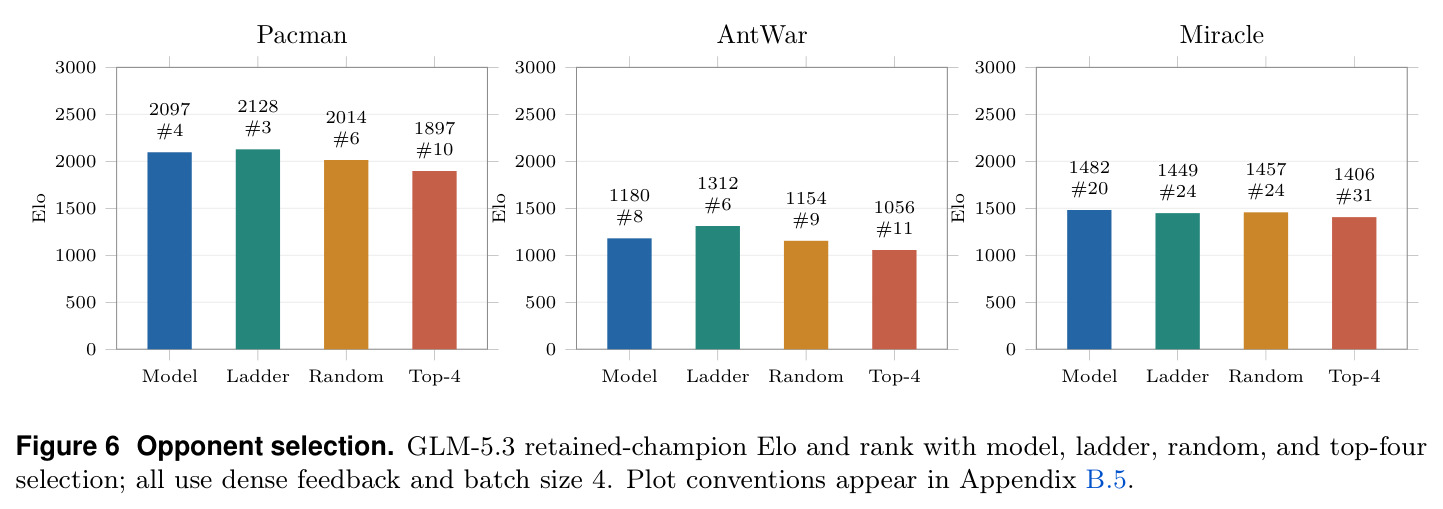
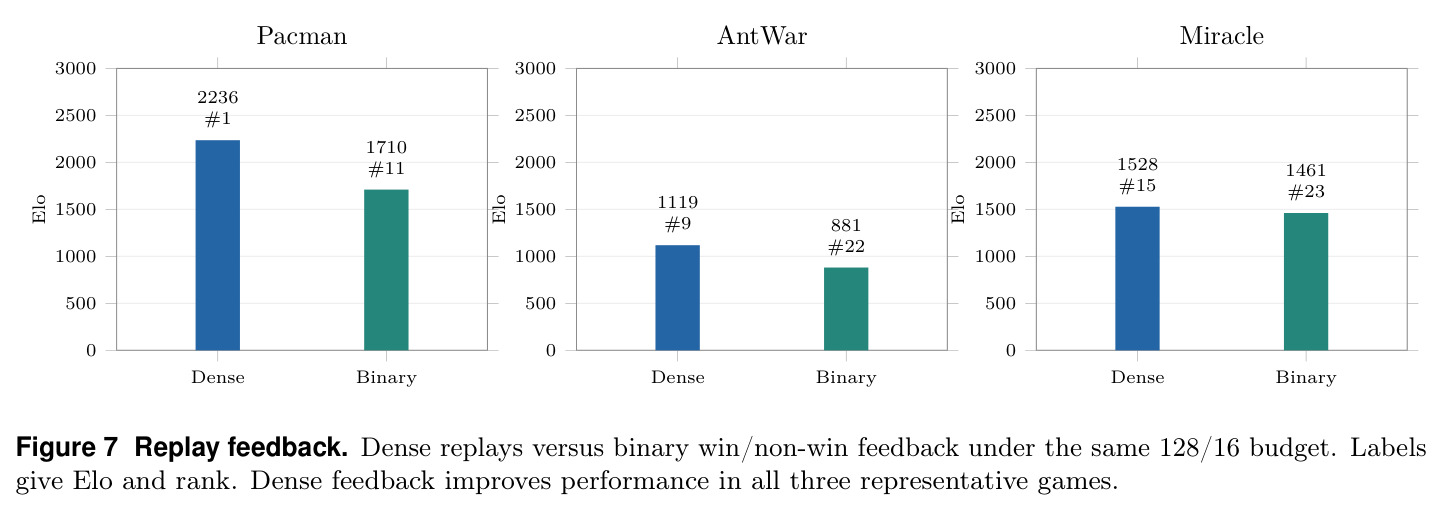
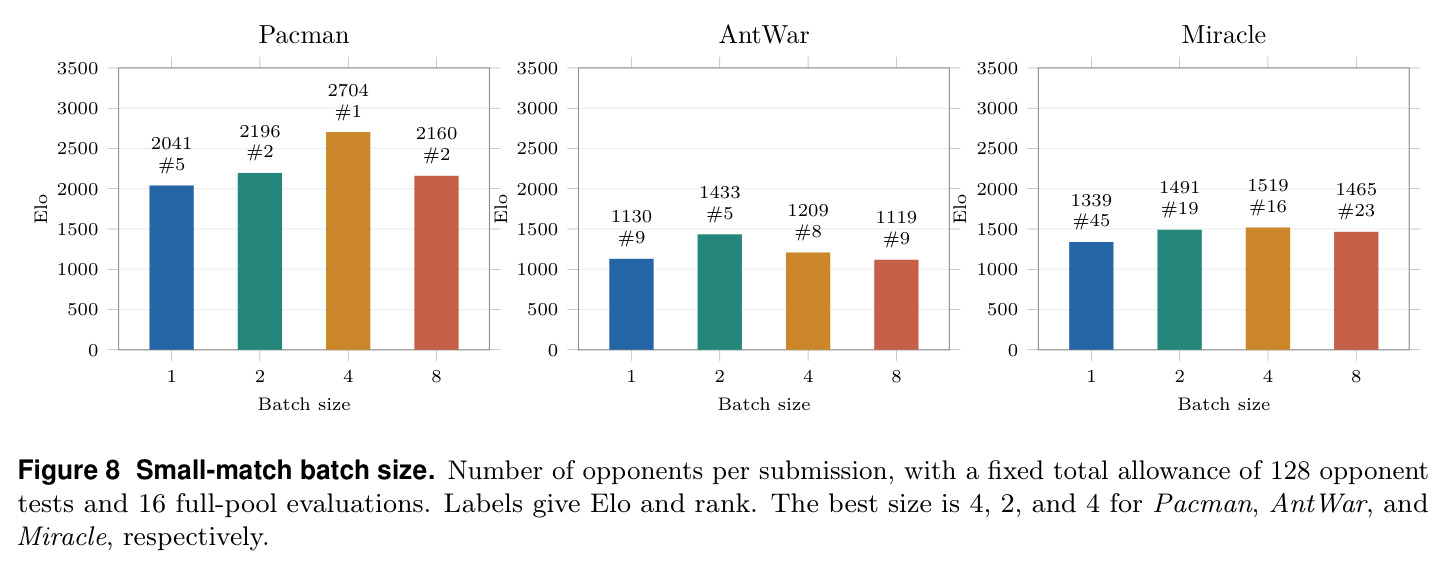
主实验(Table 2):Opus5.5+Claude Code 在 128/16 预算下拿下 6 枚金牌(rank 1),9 个游戏取得最高 Elo(Pacman 2703.9 等);GPT6-sol 与 GLM-5.3 各 4 金,Qwen 3.8 3 金,Kimi K3 与 DeepSeek V4 Pro 各 2 金,LongCat 2.0 仅 1 金;其余 6 局无任何配置登顶。规则越复杂越难登顶:AST 最少的 6 局 5 局被登顶,最大的 6 局仅 AquaWar(2,531 AST)登顶。GLM-5.3 轨迹分三类:4 局提前登顶、5 局涨跌上行、3 局长期平台。Dorado 案例从 rank 41 升至 2,最大单步 +147.7 Elo。三倍预算续跑只改善 Miracle(+50.0,26→19)与 AntWar2(+139.8,9→6),无一登顶。消融显示稠密回放全面优于二值反馈(Pacman 2236 vs 1710),中等批大小最优(4/2 个对手);off-policy 可破平台:Miracle 从 rank 26 跃至 15(1528.2),但 AntWar 上 on-policy(rank 5)仍更好。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 12 局对抗游戏综合 | 金牌数(rank 1 数量) | Opus5.5+Claude Code 6 金,9 局最高或并列最高 Elo | GPT6-sol 4 金、GLM-5.3 4 金、Qwen 3.8 3 金、Kimi K3 2 金、DeepSeek V4 Pro 2 金、LongCat 2.0 1 金 | 金牌数第一;但其余 6 局所有配置均未登顶,人类仍守住了复杂规则游戏 |
| Pacman(1,127 AST,最简单) | Elo / 排名 | Opus5.5 2703.9(rank 1);稠密反馈消融 2236(rank 1) | LongCat 2.0 1835.0(rank 10);二值反馈 1710(rank 11) | 对最弱配置 +868.9 Elo;稠密回放对二值反馈 +526 Elo |
| Dorado(GLM-5.3 案例研究) | 全池排名 / Elo | rank 41 提升至 rank 2(Elo 2210.3),最大单步 +147.7 Elo(rank 14→3) | 初始 demo 策略 rank 41 | 提升 39 位,逼近人类第一名;错误修订(四英雄阵容、无条件 Sacrifice)曾回落至 rank 46/43 后回滚 |
| AntWar2 三倍预算续跑 | Elo / 排名 | 384/48 预算下 2117.0(rank 6) | 128/16 预算 1977.1(rank 9) | +139.8 Elo、上升 3 位,但仍未登顶,表明接近性能平台 |
| Miracle off-policy 回放学习 | Elo / 排名 | off-policy 1528.2(rank 15) | on-policy 1436.8(rank 26,自对弈平台期) | +91.4 Elo、上升 11 位,突破 on-policy 平台;但 AntWar 上 on-policy(rank 5)优于 off-policy(rank 19) |
| AquaWar(2,531 AST,高复杂组唯一登顶局) | Elo / 排名 | 多个配置并列 rank 1,最高 1552.5(Opus5.5 / GPT6-sol) | LongCat 2.0 1116.1(rank 33) | 隐藏身份战术玩法上出现罕见的配置并列登顶 |
局限与改进
作者承认:6 个复杂规则游戏无一登顶,三倍预算也只带来有限改善,说明默认预算已接近平台、单纯增加交互无法自动克服差距;主实验把模型与 harness 绑定(仅 Opus5.5 用 Claude Code,其余用 Codex),无法分离二者贡献;每设置仅 3 次重复取中位数,未报告方差或置信区间;AST/RA 只是表示相关的代理度量,不代表最优博弈难度,且各游戏 Elo 尺度不同、不可跨游戏平均。我自己的观察:对手池完全冻结,考察不了对手共适应与非平稳环境下的持续学习;off-policy、批大小等消融只在 Pacman/AntWar/Miracle 三个游戏、单一模型(GLM-5.3)上做,外推性存疑;保留冠军计分可能高估“最终版本”策略的实际水平;“登顶即停”使 Success 类运行的预算消耗天然偏低,跨轨迹类型比较预算效率时需谨慎。
独立分析的弱点
其一,模型与 harness 完全混淆:Opus5.5 独享 Claude Code,其余全用 Codex,无法回答“是模型强还是框架强”,补充同一模型跨 harness、同一 harness 换模型的控制实验是显而易见的改进。其二,统计功效薄弱:3 次重复取中位数会掩盖竞赛型任务对随机初始化的高敏感性,应报告完整分布与置信区间并增加重复次数。其三,消融覆盖面窄:对手选择、反馈密度、批大小、off-policy 均只用 GLM-5.3 在 3 个代表游戏上验证,“批大小 2–4 最优”这类结论可能随模型或游戏漂移,应在更多配置上复核。其四,冻结池给 Elo 改进设了天花板且无对手共适应,衡量不了真实持续对抗能力;可引入定期更新的对手池或注入新程序,观察排名保持能力。其五,金牌数把“登顶与否”二值化,会掩盖 Dorado rank 2 与 rank 30 之间的巨大差距;论文用逐局 Elo 弥补,但主叙事仍以金牌为主,建议配套报告归一化名次分。
未来方向
作者提出三个方向:扩展 AAArena,加入新游戏、受控规则变体和动态变化的对手群体,把评测从单局排名扩展到适应速度、跨游戏迁移与持续学习;系统比较代码修订(HL)与参数更新(RL)如何从经验中学习并分配信用,探索“HL 改策略结构 + RL 训练组件”的混合学习者;从被动使用回放走向主动学习——先从外部回放形成战略假设,再有针对性地选对手验证,并把验证过的策略固化为可复用的策略模块。基于本文成果还可延伸:把 Elo 轨迹与代码 diff 对齐建模,自动定位“哪类修改导致涨分或跌分”,形成可解释的策略改进归因工具;将 AHL 范式迁移到游戏之外的对抗域(安全攻防演练、量化交易策略、机器人对抗调度);研究多智能体共同进化时启发式系统的稳定性与收敛性质。
复现评估
开源情况良好:代码在 GitHub(THU-CST-SAST/AAArena)公开,项目页 aaarena.net 提供说明;游戏源自清华 Saiblo 平台历史赛事,后端可运行,1,920 个人类程序(每局 44–323 个)为冻结存档资源。复现的主要成本是基础模型 API:每个配置需在 12 个游戏各跑 3 次,每次含 128 次小对局与 16 次全池评估,单次运行累计 token 达数千万至约一亿量级(见 Figure 4c 与 Figure 9b 的累计 token 曲线),推理费用可观;对局在 AI9/Saiblo 平台执行,本地复现需要游戏后端。整体难度中等偏高:协议与代码齐备,但结论依赖特定闭源模型版本(Opus5.5、GLM-5.3 等),模型迭代后金牌分布可能显著变化;对只想验证单游戏、单配置的复现者,预算可缩至十二分之一并可复用公开回放目录,门槛会低很多。
论文图表
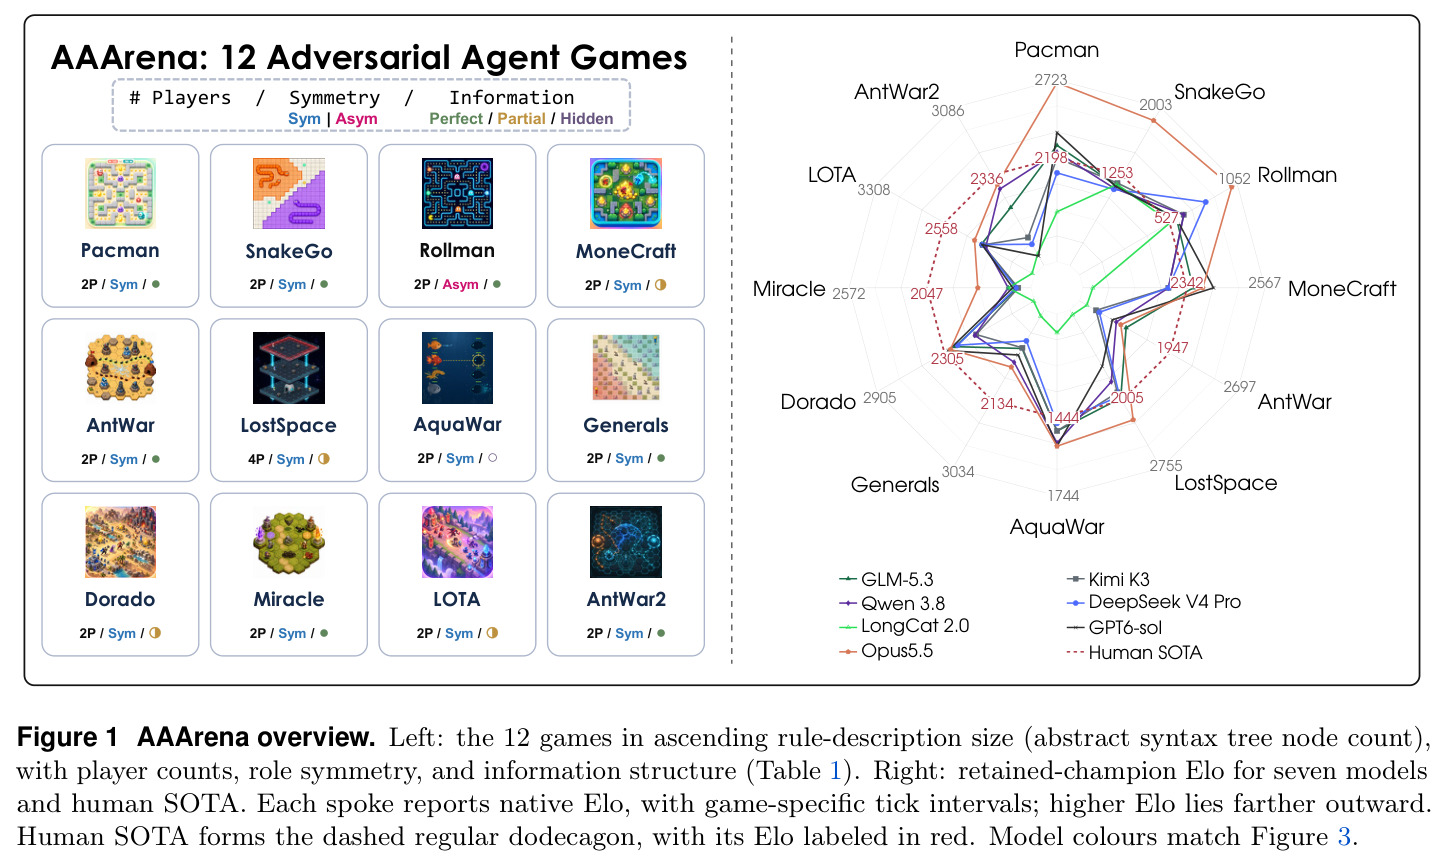
左侧列出 12 个游戏,按规则描述规模(AST 节点数)升序排列,并标注玩家人数、角色对称性与信息结构;右侧是 7 个模型与人类 SOTA 的保留冠军 Elo 雷达图,人类 SOTA 构成红色虚线正十二边形,各轴使用游戏专属刻度。
一图总览基准构成与主结果:哪些游戏被 AI 登顶、哪些留白,以及各模型相对人类顶尖水平的差距形状,是进入论文前必看的全景图。