DataVista:诊断多模态大模型数据视频理解能力的基准 DataVista: Diagnosing Multimodal LLMs on Data Video Understanding
首个数据视频理解基准:961个视频、6775题,最强模型70.0%仍落后人类21.7个百分点
前置知识
多模态大模型(MLLM)
能同时处理文本与图像(部分还支持音频、视频)的大语言模型,代表如 Gemini、GPT、Claude、Qwen-VL、InternVL 系列。它们通常将视觉编码器输出的特征与语言模型对齐,用统一的自回归方式“看图说话”,能力一般用多选题准确率衡量。本文评测了 5 个闭源(Gemini-3.1-Pro、GPT-5 等)和 14 个开源(Qwen3-VL、InternVL3.5 等)模型。
本文的评测对象就是 19 个 MLLM,理解这类模型的输入形态与能力边界,才能看懂实验设计与结论的含义。
帧采样(Frame Sampling)与帧预算
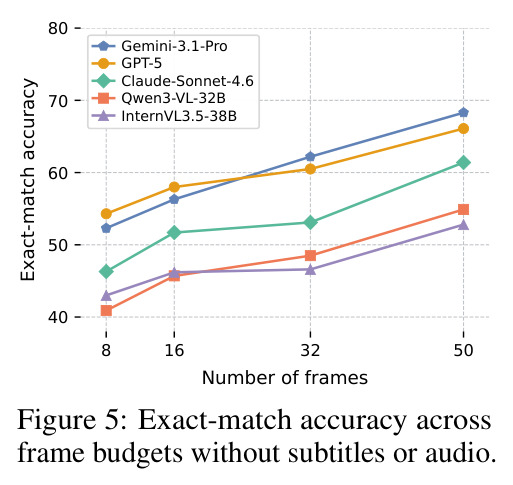
多数 MLLM 不直接处理原始视频流,而是把视频均匀采样为若干帧图像输入模型。帧数(frame budget)是关键变量:帧太少会漏掉转瞬即逝的图表状态,帧太多则超出上下文与算力预算。本文主实验统一用 50 帧并合并同一视频的全部问题为一次请求,另系统测试了 8/16/32/50/100 帧的影响。
数据视频的信息分布在时间轴上,模型答对与否很大程度取决于采样是否覆盖关键图表帧,这构成论文的核心诊断维度之一。
Bloom 认知分类法
教育学中把认知目标从“记忆、理解”到“分析、评价”逐级排列的经典框架,广泛用于试题设计以保证考察能力有梯度。本文借它把数据视频理解组织成 L1 数据感知→L2 时序推理→L3 叙事理解的三级递进结构,并细分出 10 种题型。
这是 DataVista 三级能力框架的直接理论来源,理解它才能明白 10 种题型为何如此分层、每级考查什么。
叙事可视化与数据视频
数据视频是把动态图表、动画、旁白与场景切换组合起来讲数据故事的媒体形态,Bloomberg、Vox、NYT 等机构大量生产。可视化研究为其建立了分类体系:Segel & Heer (2010) 的叙事结构、Shi (2021) 的动画设计空间(entrance/emphasis/exit/transition/data-driven/temporal 六类)、Yang (2022) 的 14 种叙事模式设计空间。
L3 叙事理解题的选项直接取自这些设计空间的真实类别,不了解这一背景就难以理解 L3 题目的设计逻辑与干扰项原则。
数据污染(Data Contamination)
基准题目若来自模型预训练语料可能见过的内容(如老视频、高播放量内容),模型可能“背过答案”导致虚高成绩。常见对策是选用新发布内容并做分组对比分析。本文 68.5% 的视频发布于 2025 年 6 月之后,并按上传时间和播放量分组验证老视频无系统性优势。
基准可信度取决于防污染设计,论文用整个附录 E.9 回应此问题,是判断该基准能否长期使用的关键。
研究动机
数据视频(data video)是把动态图表、动画与旁白叙事结合的媒体形态,Bloomberg Graphics、NYT The Upshot、Vox 等机构大量生产,已成为数据新闻、商业报道与科学传播的重要载体。理解这类视频需要三种相互咬合的能力:从连续播放的动画图表中准确读数、跨图表跨时间点整合证据、理解叙事组织与视觉设计如何传达论点。但现有评测两头都不沾:通用视频理解基准(Video-MME、MVBench、MLVU、LongVideoBench 等)考察一般内容的感知与推理,不涉及量化数据证据;静态图表基准(ChartQA、PlotQA、ChartQAPro、MultiChartQA 等)把图表当作孤立图片或预先组装的静态集合,不需要在含大量干扰画面的视频流里定位证据,更不考察叙事。于是在“连续视频中的动态图表阅读 + 跨时间证据整合 + 叙事理解”这一完整任务上,始终缺少系统评测,模型在数据视频上到底差在哪一级能力,无从诊断。
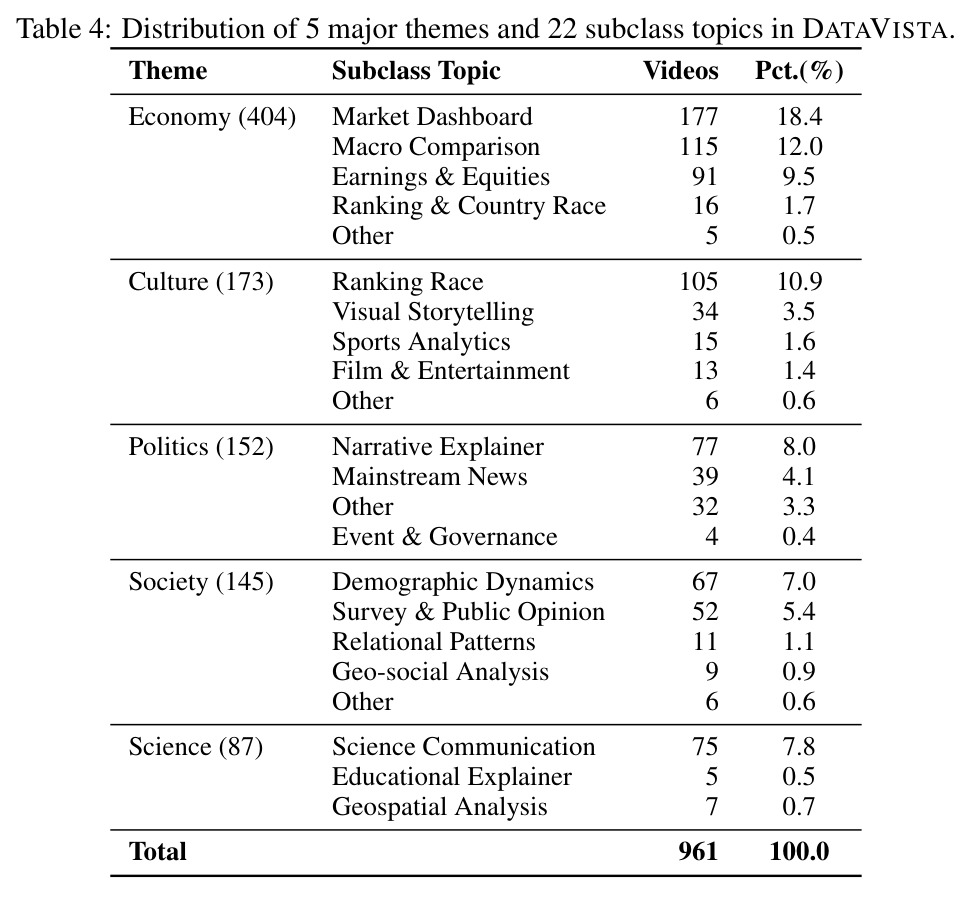
本文的目标是本文要构建首个数据视频理解基准 DataVista,并用它系统诊断多模态大模型。具体目标包括:从 YouTube 收集并筛选 961 个真实世界专业制作的数据视频(时长 28 秒到 15 分钟,中位数约 5.6 分钟),覆盖经济、社会、科学、政治、文化五大主题域 22 个子类;借鉴 Bloom 认知分类法、可视化素养测评框架与数据故事设计空间,建立“数据感知→时序推理→叙事理解”三级递进框架,细分 10 种题型;配上 6,775 道经过纯文本过滤和双人复审的选择题(含单选与多选);最终评测 19 个主流 MLLM(5 个闭源加 14 个开源),量化它们与人类专家(91.7%)的差距,并回答帧数、字幕等输入条件对各级能力的贡献以及模型的典型失败模式。
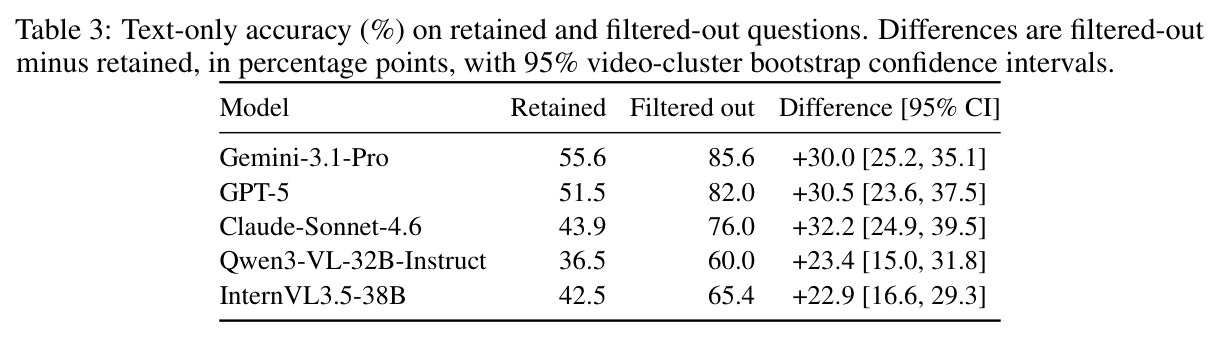
与已有工作不同的是,已有工作各占一段却没人补中间地带:视频基准不做数据,图表基准不做视频,数据视频研究(Data Player、DataMagic 等生成系统)只关心怎么生成、不关心模型能否理解。本文的独特切入有三点。其一,把评测对象从静态图表推进到连续叙述视频中的动态图表,要求模型先在多个视觉状态中定位证据再读数。其二,把通常被视为“太主观”的叙事理解操作化成可判分的题型:选项直接取自数据故事设计空间的 14 种叙事模式、动画技术六分类等真实类别,让设计判断题也能客观评分。其三,工程质量上采用人机协作管线:Gemini-3-Flash 负责预筛与结构化预抽取、人类逐段校验,再用纯文本过滤剔除不看视频就能答对的捷径题,并用五个不同家族的模型交叉验证过滤有效性(被过滤题的纯文本准确率高 22.9–32.2 个百分点)。
核心方法
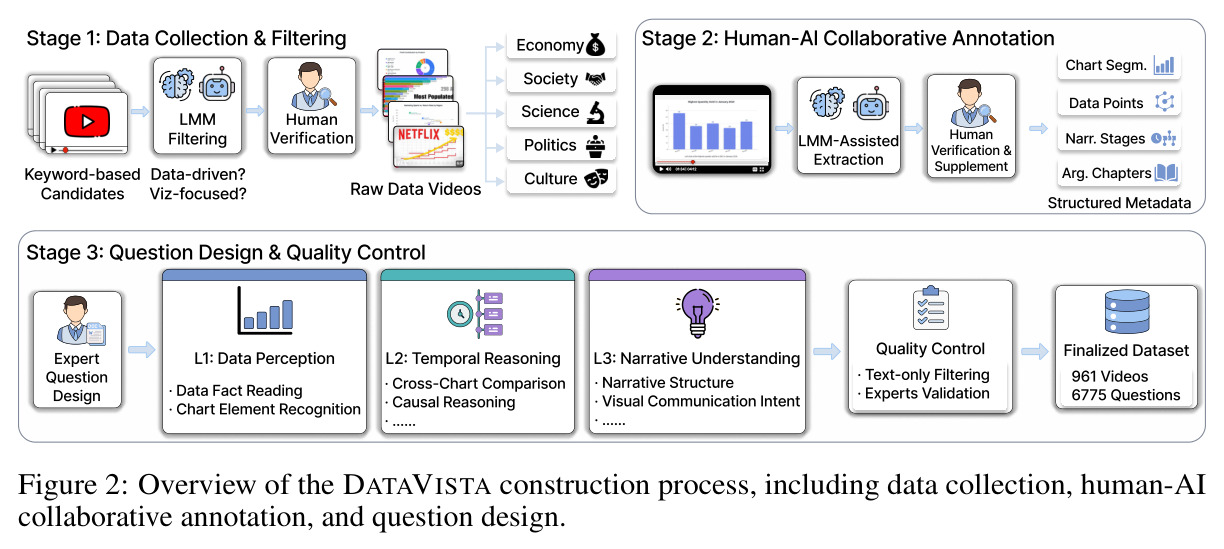
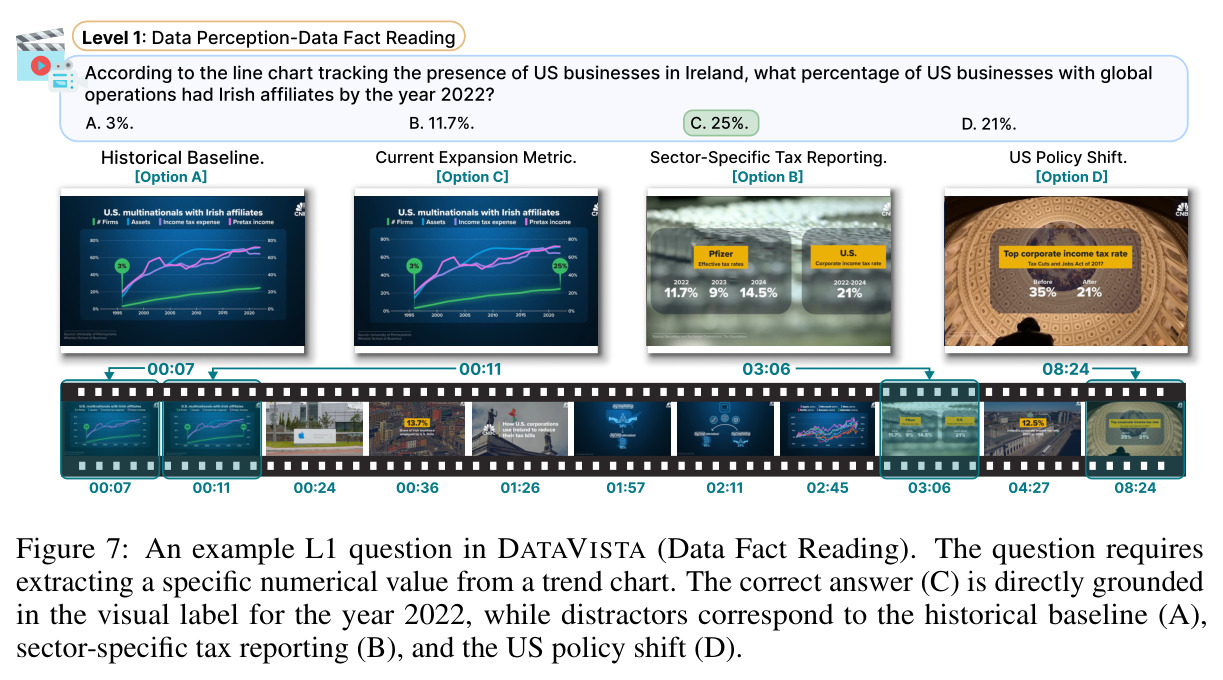
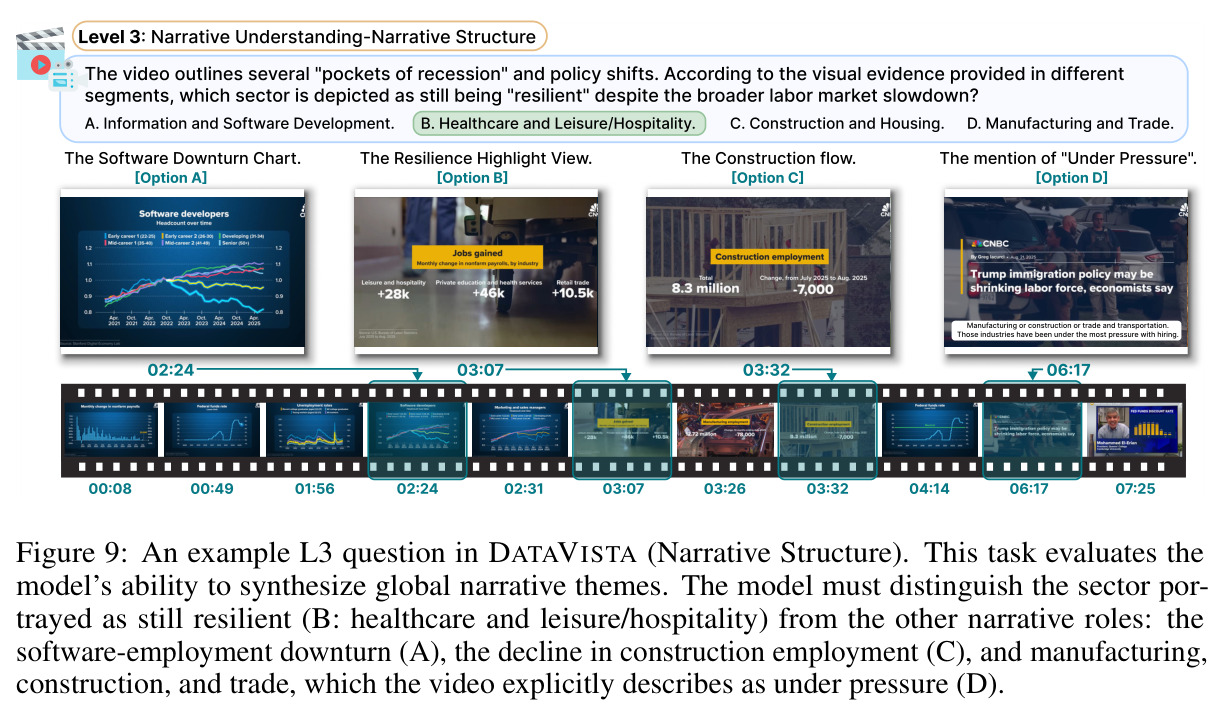
直觉上,DataVista 是给多模态大模型出的一场“数据新闻从业资格考试”:先考读图(2022 年美国在爱尔兰的企业占比是多少),再考对账(从 2021 年低点到 2024 年中期失业率变了几个百分点),最后考编辑思维(这个视频用什么叙事模式、为什么把风险表放在后面讲)。基准建设分三个阶段。第一阶段视频收集与过滤:频道爬取(Bloomberg、FT、Economist、WSJ、Vox、Our World in Data、Kurzgesagt、TED-Ed 等)加关键词搜索得到 5,604 个候选,Gemini-3-Flash 按“数据驱动、可视化核心且持续、有明确信息传达意图”三条标准预筛,人工确认后 967 个通过,题目构建后覆盖 961 个视频。第二阶段设计三级能力框架与 10 种题型,并为每一级制定差异化干扰项原则。第三阶段出题与质控:5 名有数据视频制作或可视化研究经验的标注员看完整视频设计题目(每个视频约 1–2 小时),Gemini-3-Flash 只看题干选项做纯文本过滤(28,897 题筛掉 75.5%),再由 4 名未参与设计的评审两两独立复审,最终 6,775 道题定稿。
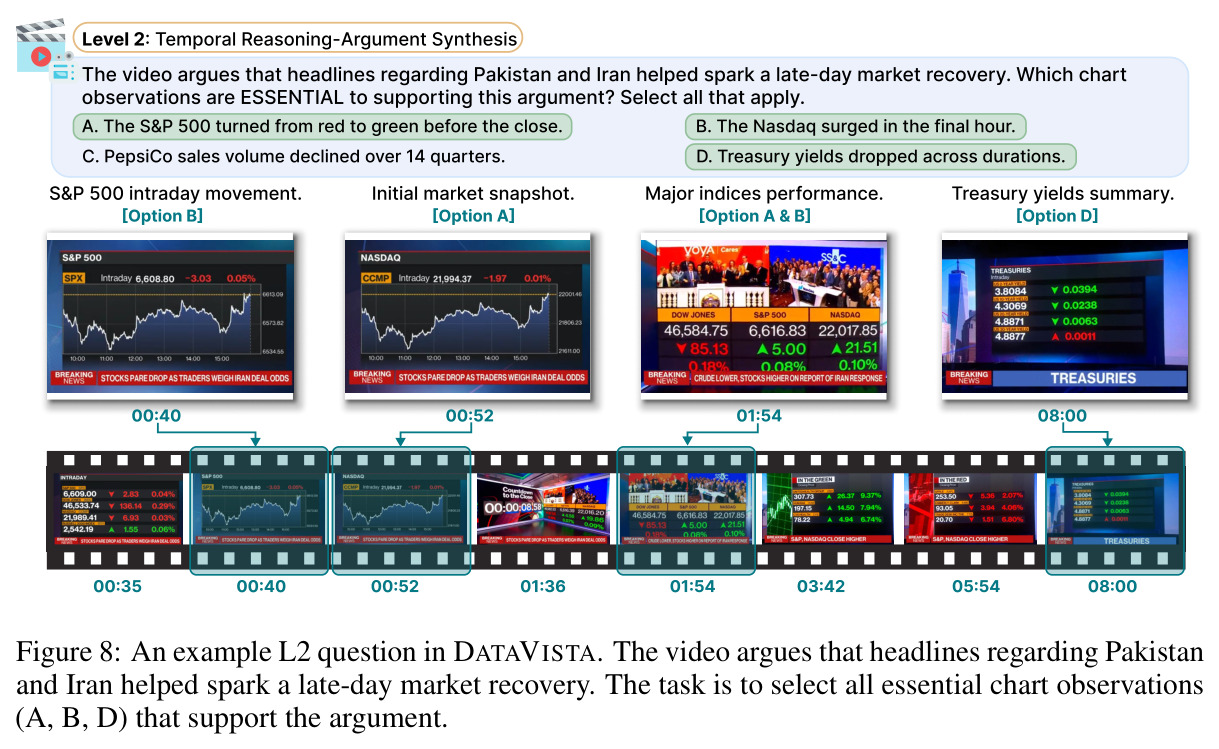
核心创新是“三级递进能力框架 + 系统性防捷径设计”的组合,与已有基准有本质区别。第一,评测对象是连续视频中的动态图表而非孤立图片:L1 数据感知题要求模型先在含多个视觉状态的视频流中定位相关图表再读数,而静态图表问答默认目标图已经给出。第二,把叙事理解操作化为四种可判分题型(叙事结构、视觉传达意图、反事实分析、质量评估),所有选项取自可视化文献中的真实设计类别(如 Setting 阶段的 Statistic Hook、动画的 entrance/emphasis/transition 等六类技术),干扰项是“同域真选项”而非域外编造项,避免模型靠常识排除假选项。第三,系统性防捷径:L1 数值题设 ±15% 内的近似数值干扰项,L2 跨图表题设“只看单张图也能选中”的陷阱项,质量评估题所有选项同为正面语气、只差所识别的视觉机制,杜绝按情感极性答题;再加纯文本过滤——只给 Gemini-3-Flash 题干和选项即可答对的题全部剔除(共过滤 21,804 题),并用五个模型验证被过滤题确实更容易从文本猜中。
方法步骤详情
第一步,视频收集与预处理:频道爬取加关键词搜索得 5,604 个候选;Gemini-3-Flash 输入帧、字幕和元数据,输出是否为数据视频的判断及结构化标注(18 类可视化类型、叙事阶段、拒绝理由、证据时间戳),标注员在审核界面逐条确认或纠正。第二步,结构化预抽取:Gemini-3-Flash 观看全片输出图表段(chart_segments)、三段式叙事阶段(setting/rising_climax/resolution)、论证章节和带精确时间戳的证据索引,标注员逐段校验补充。第三步,出题:5 名标注员按三级框架和各级干扰项原则撰写题干、选项与答案,并为关键数据点标注时间戳。第四步,纯文本过滤:Gemini-3-Flash 仅凭题干选项作答,预测与参考答案完全一致的候选被剔除(28,897 题中过滤 21,804 题,75.5%),另用五个代表模型交叉验证。第五步,人工评审:4 名未参与设计的评审每题两人独立检查措辞、证据与干扰项,分歧对照原视频讨论,80.1% 直接通过、15.4% 修改后通过、4.5% 拒绝。第六步,评测:统一输入 50 帧均匀采样(无音频)、温度 0 解码、精确匹配计分,多选要求预测集合与真实集合完全一致($\hat{S} = S^{*}$);6 名人类评审看完整视频带原声作答构成人类基线。
技术新颖性
新颖性主要体现在评测框架而非模型结构。第一,它是首个把图表理解从静态域搬到动态视频域的基准:ChartQA、ChartQAPro、MultiChartQA 等都把图表作为独立图片或静态集合,DataVista 则要求在含大量干扰帧的视频中先定位证据,且不同题型有明确的证据需求定义(单帧、多帧无序聚合、跨段证据、叙事上下文)。第二,它给叙事理解提供了可复用的题目化方案:把 Yang 2022 数据故事设计空间、Shi 2021 动画设计空间和 VisJudge-Bench 的保真度–表现力–美学质量框架直接转译为选项生成器与干扰项规则。第三,质量控制流程比一般基准更严格:纯文本过滤加五模型交叉验证、双人独立复审、视频级 bootstrap 置信区间(半宽约 1.2–1.4 个百分点),并附上传时间与播放量分组的数据污染分析。与其同组的 VisJudge-Bench(静态可视化质量评估)相比,本文把时间维度与叙事维度纳入了评测范围。
实验结果
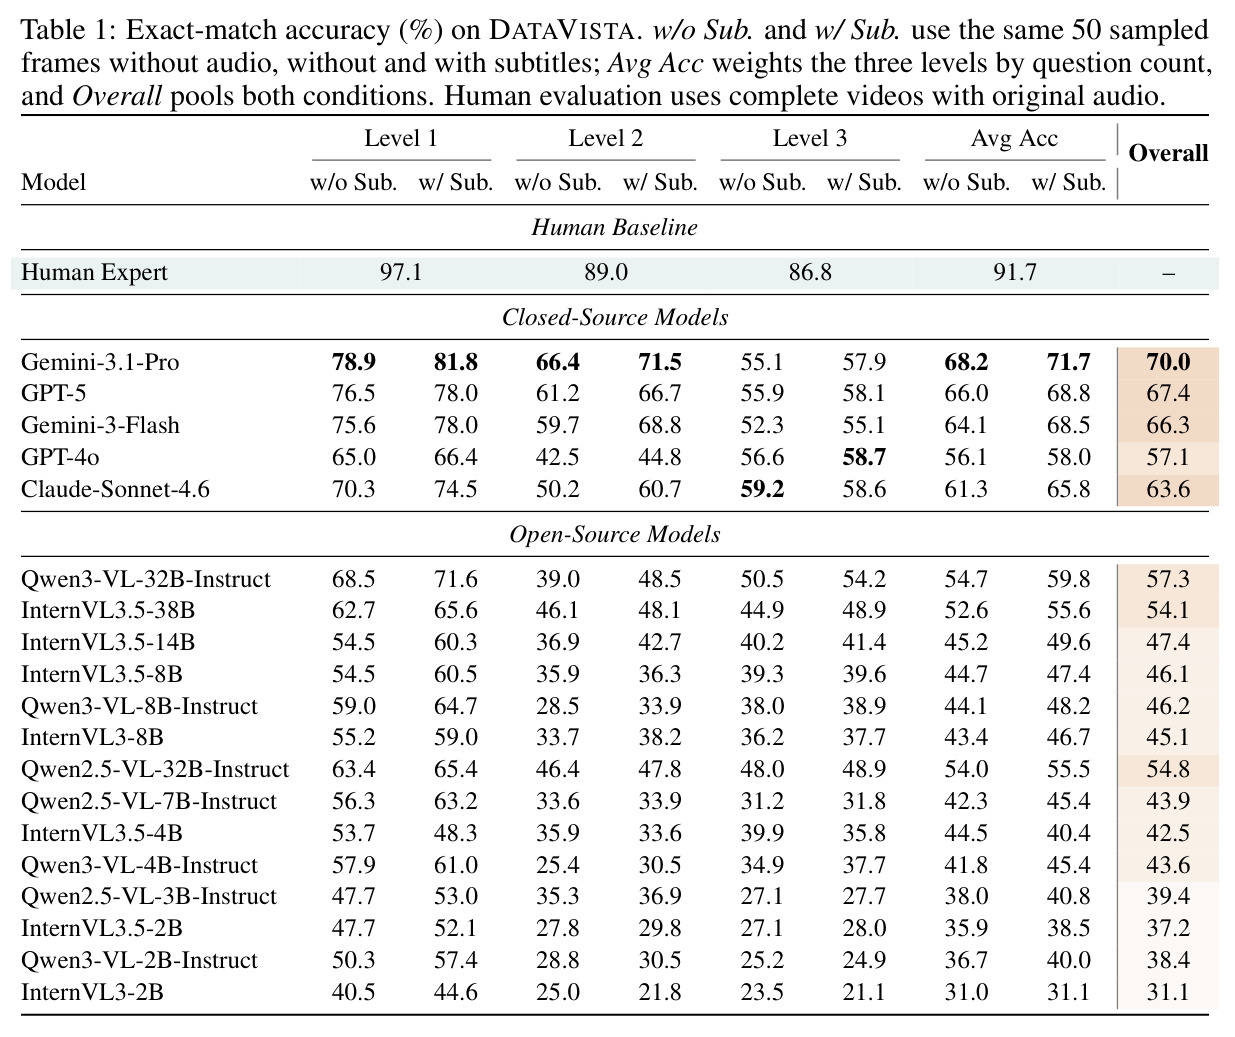
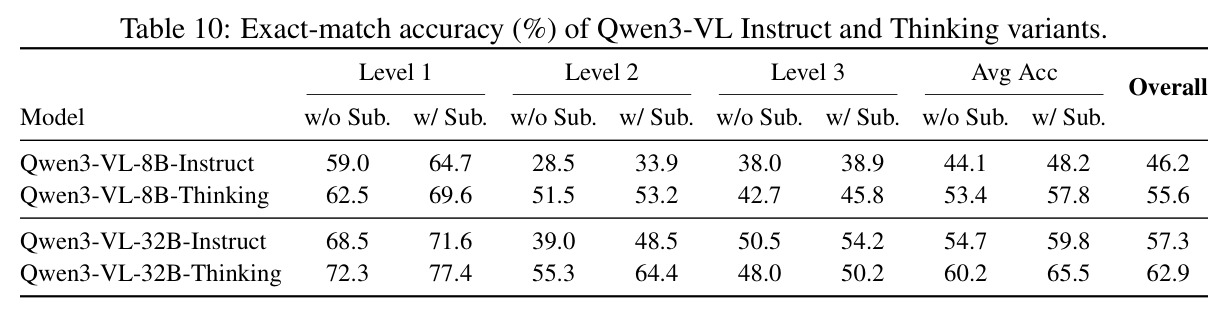
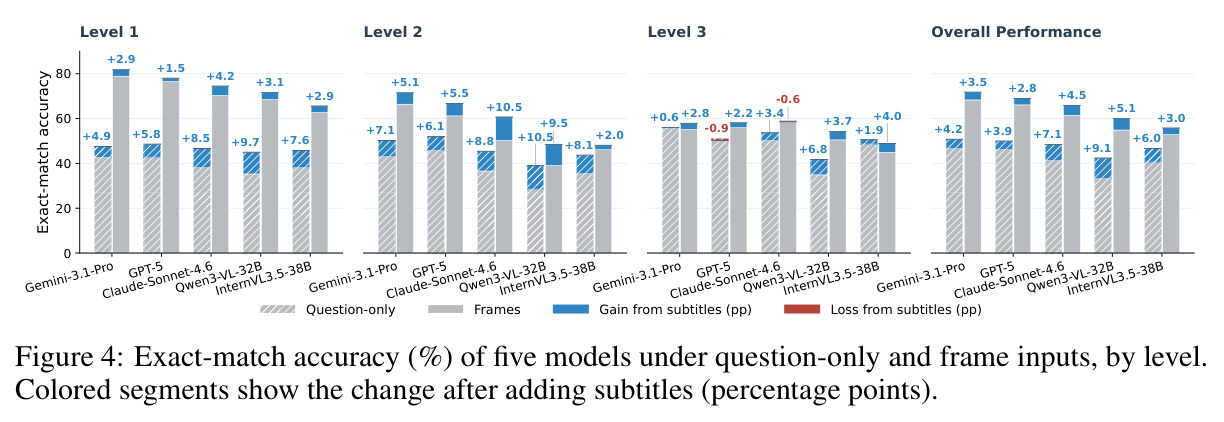
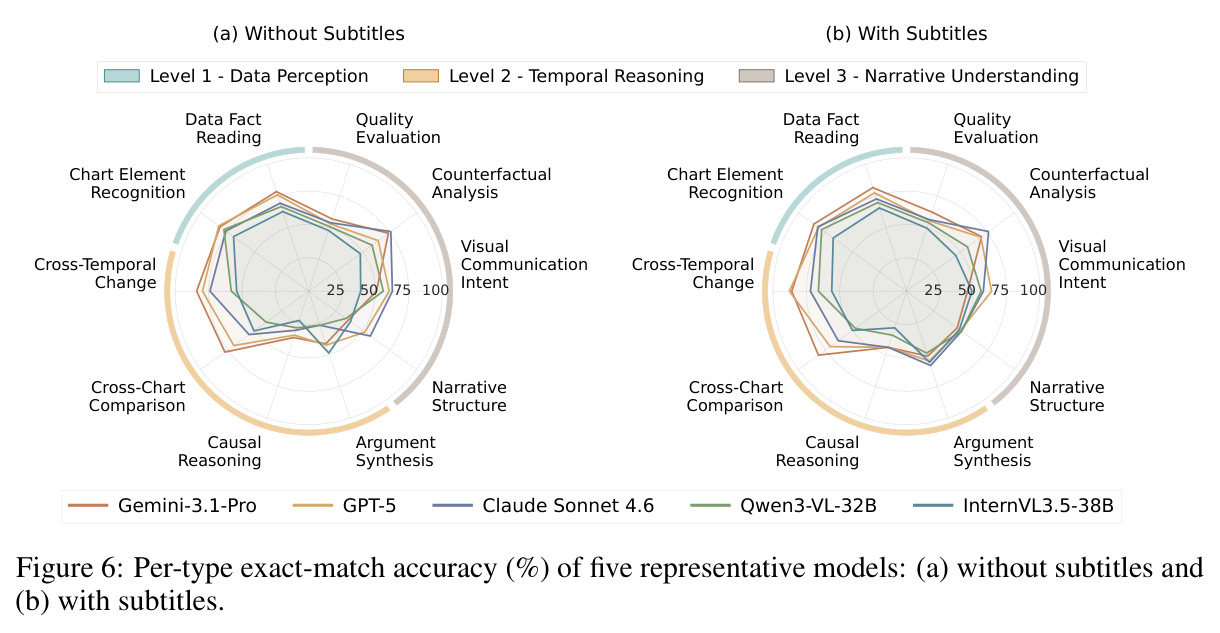
主实验:Gemini-3.1-Pro 以 70.0% 居首,GPT-5 67.4%、Claude-Sonnet-4.6 63.6%、GPT-4o 仅 57.1%;最强开源 Qwen3-VL-32B 57.3%(Thinking 模式升至 62.9%),最弱 InternVL3-2B 31.1%,全部显著低于人类的 91.7%。分级看:模型最好 L1 成绩 81.8%(差人类 15.3 个百分点),L3 最高仅 59.2%(差 27.6),叙事理解是最大鸿沟;L2 区分度最强,Gemini-3.1-Pro 领先 Qwen3-VL-32B 25.3 个百分点(L1 仅 10.3、L3 仅 4.2)。输入条件分析:加帧主要帮读图——五模型平均 L1 从 39.4% 升到 71.4%(+32.0pp),L2 仅 +14.7、L3 仅 +5.1;加字幕对 L2 增益最大(52.6%→59.1%,+6.5pp);帧预算 8→32 帧 L1 平均 +11.6pp 而 L3 仅 +2.1。分题型:Cross-Temporal Change 平均 73.6%,但 Causal Reasoning 仅 39.2%(最佳 44.2%),Narrative Structure 全体挤在 46.9–51.0%。错误分析(120 个错例):感知错误占 47.5%(数值/文字读错 36.7%),推理错误 42.5%(证据判断 37.5%、纯算术仅 0.8%),指令理解 10.0%。多选诊断:Argument Synthesis 的 F1 达 88.0% 但精确匹配仅 53.9%,模型找得到大部分证据却凑不齐完整答案。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数据视频理解(总体) | 精确匹配准确率(%) | Gemini-3.1-Pro:70.0 | 人类专家:91.7 | 最强模型仍落后人类 21.7 个百分点 |
| L3 叙事理解 | 精确匹配准确率(%) | 所有模型最高 59.2 | 人类:86.8 | 落后 27.6 个百分点(对比 L1 仅落后 15.3),为最大人机鸿沟 |
| Causal Reasoning(因果推理) | 精确匹配准确率(%) | 五模型平均 39.2,最佳模型 44.2 | 同为 L2 的 Cross-Temporal Change 平均 73.6 | 低约 34 个百分点,为全部 10 种题型中最弱 |
| 开源模型最好成绩 | 精确匹配准确率(%) | Qwen3-VL-32B:57.3(Thinking 模式 62.9) | 闭源最强 Gemini-3.1-Pro:70.0 | 落后 12.7 个百分点(开启 Thinking 后仍落后 7.1) |
| 字幕对总体准确率的贡献 | 增益(百分点) | 19 模型中位数 +3.1,最大 +5.1(Qwen3-VL-32B) | 无字幕 50 帧设置 | 对 L2 增益最大(五模型平均 +6.5pp),对 L3 仅 +2.4 |
| 统计基线对照 | 精确匹配准确率(%) | 19 个模型区间 31.1–70.0 | 随机选择 20.8 / 最高频答案 27.5 | 全部模型显著高于随机基线,基准有效且具区分度 |
局限与改进
作者承认的局限(附录 F):只覆盖理解,不覆盖数据视频的生成与编辑;只有选择题、没有开放式主观题,无法测细粒度表达能力;以英语视频为主(961 个中 921 个有英文字幕,其中 535 个还是自动生成字幕,40 个回退到其他语言),无法评测多语言场景。我的补充观察:第一,50 帧统一采样与能力评测混杂——附录 E.2 中篮球问题的结果表恰好落在两帧之间导致 Gemini-3.1-Pro 答错、换原生视频输入即答对,说明约 5 个百分点的成绩波动来自采样而非能力;第二,人类基线只有 6 名评审、每题 2 人作答,未报告置信区间,91.7% 这个数的精度有限;第三,多选精确匹配把部分正确归零,Causal Reasoning 39.2% 这样的低分混合了“证据找不全”与“找错”两种性质不同的失败;第四,L3 选项取自固定设计空间分类学,模型若在训练中接触过该分类体系可能获得先验优势;第五,闭源模型以 API 为主、榜单尚未上线,结论的时效性依赖后续维护。
独立分析的弱点
弱点一:帧采样与能力混淆。关键证据落在采样帧之间时模型会答错(如结果表恰在两帧之间的篮球问题),这类误差约 5pp 却被计入能力分。改进:利用已标注的证据时间戳构建“检索式输入”赛道,评测模型主动定位证据的能力,或报告按关键帧覆盖率校准后的成绩。弱点二:多选精确匹配过于严苛。Argument Synthesis 的 F1 高达 88.0% 但 EM 仅 53.9%,模型选对了大部分证据只是凑不齐集合,EM 下的排名会掩盖进步空间。改进:把 option-level F1 纳入主榜或采用分级计分。弱点三:叙事题型绑定特定分类学。L3 选项全部来自 Yang 2022 等设计空间的固定类别,出题空间受限且存在被针对性训练“背分类”的可能。改进:引入开放式叙述生成加 rubric 判分,或用同一数据、不同叙事设计的反事实视频对做对比评测。弱点四:字幕质量不可控。535 个视频用自动生成字幕、40 个非英语视频直接回退其他语言,可能引入噪声。改进:人工校对字幕或报告字幕质量分层结果。弱点五:防污染依赖时间窗口,2026 年视频(36.2%)观察期尚短,榜单机制尚未落地。
未来方向
作者提出的方向:把评测扩展到数据视频生成与编辑;引入开放式题目和自动评分方案;扩展多语言数据集;基于已有的结构化标注(图表段、叙事阶段、证据时间戳)构建微调数据集来训练数据视频理解模型;上线官方评测网站与公开排行榜,定期纳入新视频并支持研究者提交模型。基于成果可延伸的方向:其一,错误分析显示证据判断(占错例 37.5%)是最大推理瓶颈,可据此构建证据–主张对齐训练数据,或设计带证据定位辅助的 agent 推理管线;其二,Thinking 模式在 L2 增益显著(32B 字幕下 48.5%→64.4%)却在 L3 反降(54.2%→50.2%),值得研究自适应决定“何时深思考”的策略;其三,字幕能把 GPT-5 长视频(大于 9 分钟)的短板差距从 8.9pp 压到 1.4pp,提示音频–视觉–文本跨模态对齐训练的价值;其四,把三级框架反向用于自动评估 DataMagic、Data Player 等生成系统的产物质量,打通“理解评测反哺生成”的闭环。
复现评估
开源情况:题目标注、证据时间戳与视频源记录已在 GitHub(HKUSTDial/DataVista)开源,并承诺发布官方自动评测服务和公开排行榜。数据:961 个视频来自公开 YouTube(版权归原作者、仅限学术使用),6,775 道题与结构化元数据完整释放;但评测需自行获取视频,存在视频下线或地域限制的风险,长期可复现性取决于官方是否提供存档。算力:闭源模型走 API(Gemini、GPT 系列),开源模型需能推理 2B–38B 级多模态模型;主设置把同一视频的全部题目合并为一次请求、50 帧输入、温度 0,成本可控。数据集构建成本高(5 名标注员每视频 1–2 小时、4 名评审双人复审、多轮过滤),复现整个构建流程不现实,但直接使用数据集没有门槛;附录 D 给全了 prompt 模板、帧采样策略和 10,000 次视频级 bootstrap 细节,透明度好。总体判断:用其数据复现模型评测难度中等偏低,复现基准构建难度高。
论文图表
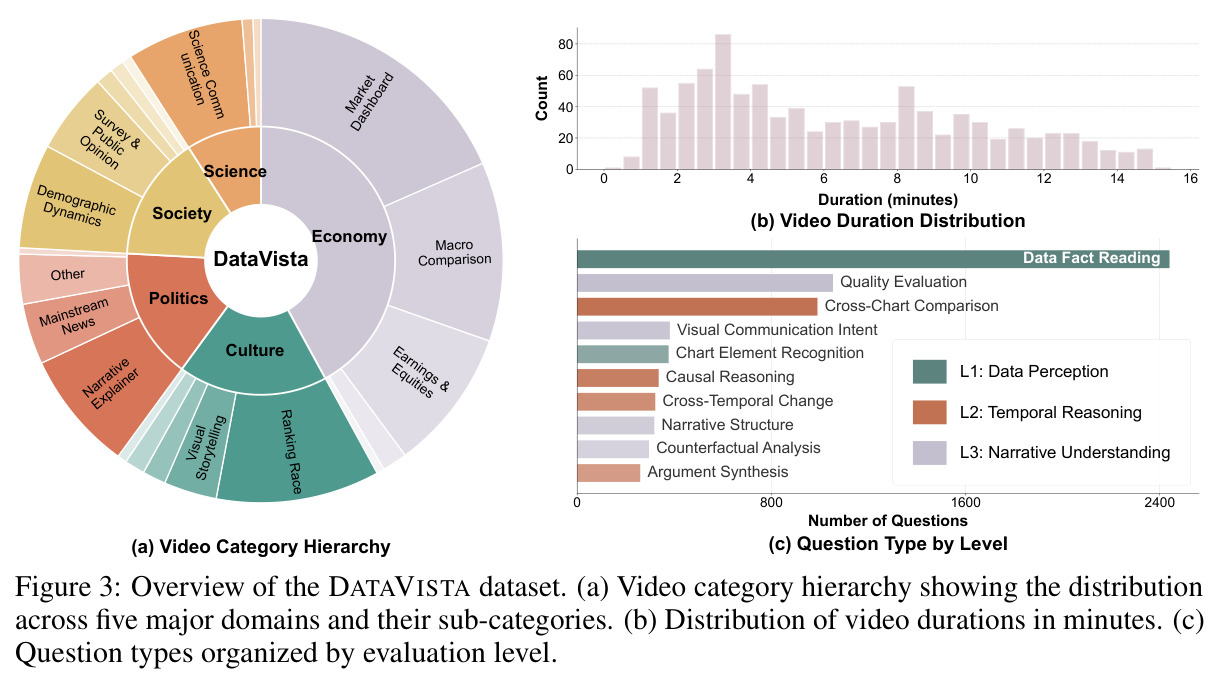
三张子图:(a) 五大主题域及 22 个子类的视频数量层级分布(经济类 404 个最大,占 42.0%);(b) 视频时长分布(中位数约 5.6 分钟);(c) 按三级能力组织的 10 种题型的问题数量分布(L1 2,817、L2 1,908、L3 2,050 题)。
数据集的域、时长与题型构成决定了评测结论的适用范围,是判断该基准是否均衡、是否有偏的依据。