ALIVE:首帧引导视频编辑中的交互对齐物体插入 ALIVE: Interaction-Aligned Object Insertion for First-Frame-Guided Video Editing
构建交互配对数据并训练VLM预测时间提示,让插入物体随源视频动作连贯响应
前置知识
首帧引导视频编辑
一种视频编辑范式:用户只需在视频第一帧上完成编辑(如把物体画进去或P图插入),模型负责把首帧的改动沿时间传播到整个视频,同时保持源视频的相机运动和场景内容。代表方法有 AnyV2V、I2VEdit、Señorita、PropFly 等。关键在于编辑首帧精确定位了物体的初始外观和位置,后续行为交给模型从源动作中推断。
ALIVE 正是这个范式下的物体插入任务,理解输入接口(源视频+编辑首帧+物体指令)是读懂任务定义、实验对比与基线选择的前提。
流匹配与扩散编辑器
流匹配是扩散模型的一类训练目标:模型学习速度场 $v_\theta$,使噪声分布沿 $z^t=(1-t)z^Y+t\epsilon$ 的插值路径流向数据分布,损失为 $\mathbb{E}\|v_\theta-(\epsilon-z^Y)\|^2$。视频扩散编辑器(如 LTX-2.5、Wan)在其上通过额外条件(视频潜变量、文本)实现受控生成。
ALIVE 的编辑器以 LTX-2.5 为骨干、用流匹配目标训练,公式 (4)、通道拼接条件设计与推理步数设置都建立在这个框架上。
LoRA 低秩适配微调
LoRA 冻结预训练权重,只训练注入的低秩矩阵 $BA$(秩 $r \ll d$),用极少量参数适配大模型。本文编辑器用 rank-128 的 LoRA 微调 LTX-2.5,VLM 用 rank-64 LoRA 微调 Qwen3.6-27B,使 22B 级模型在 16 张 A100 上可训练。
论文的算力分析(4.95 秒/步、16 卡、5k 步约 8.1 小时)和复现评估都依赖 LoRA 设置,附录 A.1 的超参数均围绕它展开。
VLM 视觉语言模型
能同时接收图像/视频帧与文本并生成文本的多模态模型。本文用它做两件事:数据阶段辅助标注与质检(Qwen3.6-27B + GPT-5.6),以及训练一个专用于预测交互提示 $\hat{p}_4$ 的 LoRA 适配版 VLM,输入 21 帧源视频+E0+P1,输出带时间区间的分块描述。
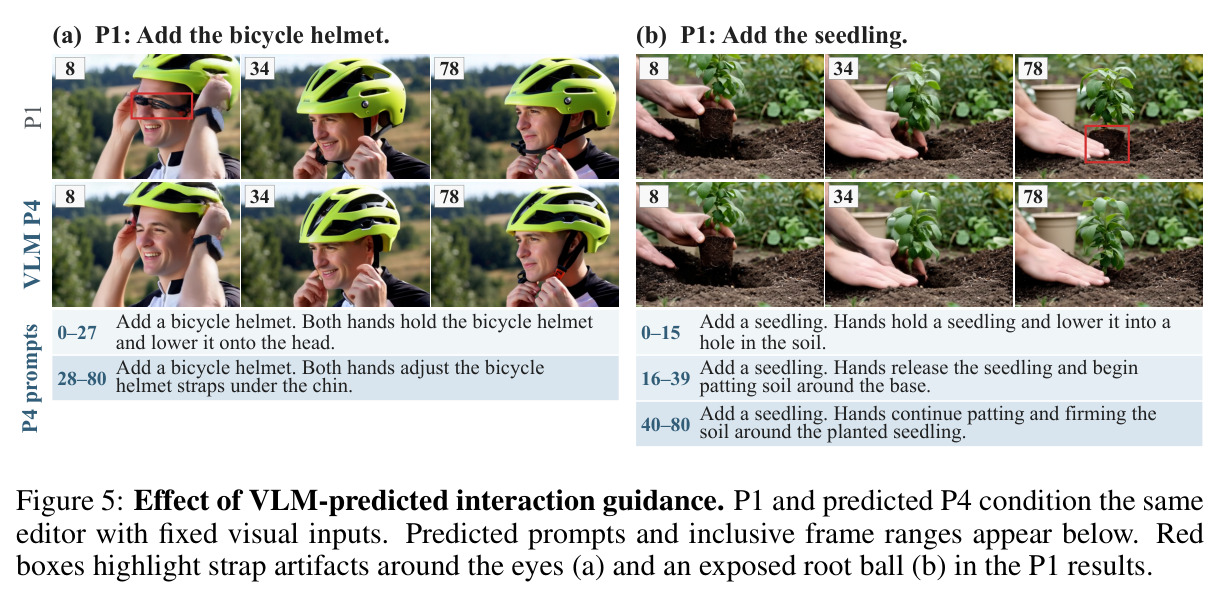
VLM 预测的 P4 指导是 ALIVE 的第二大贡献,把交互理解变成监督学习而非 prompting,Table 3 中 +0.95 分的提升即来自它。
研究动机
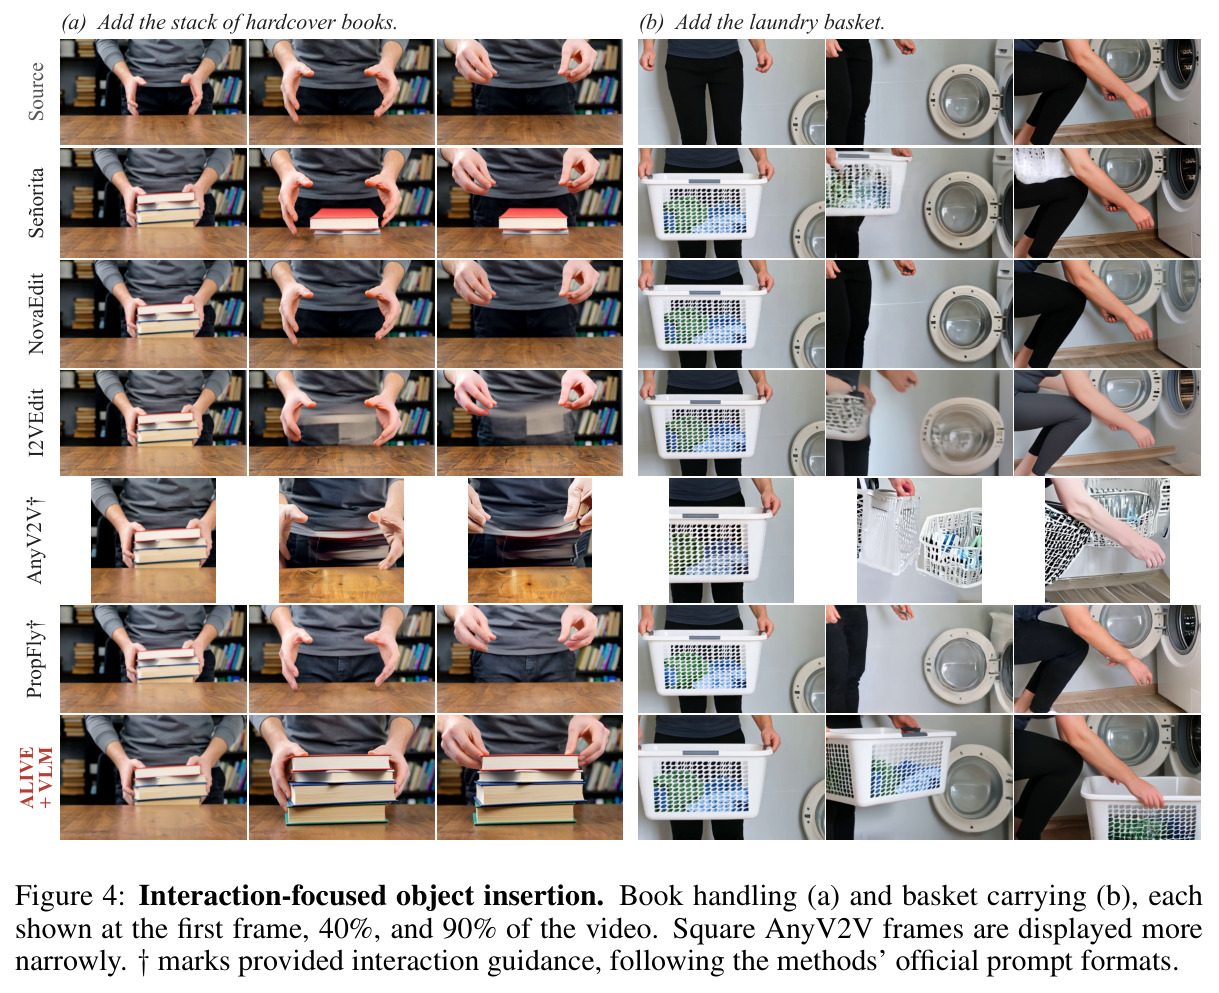
现有视频编辑器已经能插入外观逼真的物体(带阴影、反射),但插入的物体往往是“死”的:Figure 1 中,加入的陶瓷马克杯应该随手动被拿起、面团应该随刀被切开,而现有方法(Señorita、NovaEdit、I2VEdit、AnyV2V、PropFly)生成的物体要么静止在原地、要么中途消失、要么形变扭曲。在作者构建的交互基准上,最强基线 Señorita 的 Overall 只有 60.24 分,Motion/传播维度更是低至 36.52。困难有两层:其一,交互编辑配对数据稀缺——构造一对数据需要找到交互视频、只改变目标物体的存在性而保留周围场景和动作;其二,交互建模困难——源视频只提供动作线索,并不直接展示新物体应该如何响应,编辑器必须自行推断物体随动作展开的运动或状态变化。
本文的目标是本文要让插入的物体“活”起来:给定物体缺失的源视频 $X$、编辑好的首帧 $E_0$ 和只命名物体的指令 $p_1$(如“Add the ceramic mug”),生成一个插入物体连贯参与源动作、无关场景内容保持不变的编辑视频 $\hat{Y}=G_\theta(X,E_0,p_1)$。物体应该被拿起、戴上、打开或切开,而不是悬空漂浮。为此论文设定三个具体交付:一套 35,800 对、覆盖交互与通用插入的编辑配对数据;一个能从视觉输入推断物体响应的首帧引导扩散编辑器;一个能从相同输入自动预测交互指导、免除用户书写交互描述或提供掩码轨迹的 VLM。
与已有工作不同的是,与已有工作的差异化切入有三点。数据上,此前的配对数据集(Señorita-2M、ROSE、EffectErase)面向通用编辑或去物体/插物体本身,没有“物体必须响应交互”的监督;ALIVE 组合 3D 渲染、模型生成、真实世界与 ROSE 反转对四条互补路线,专攻交互。条件机制上,标准编辑器把整段 prompt 编码成所有帧共享的上下文,ALIVE 引入时间局部化的 P4 分块提示,通过注意力路由把每段描述对齐到对应视频区间。指导来源上,VOID 研究删除后的物理修正、DynaEdit 用文本改动力学、DynVFX 用 VLM 描述增强场景,但都需要额外输入或只做增强;ALIVE 训练 VLM 从与编辑器完全相同的输入预测指导,无需用户提供任何交互描述。
核心方法
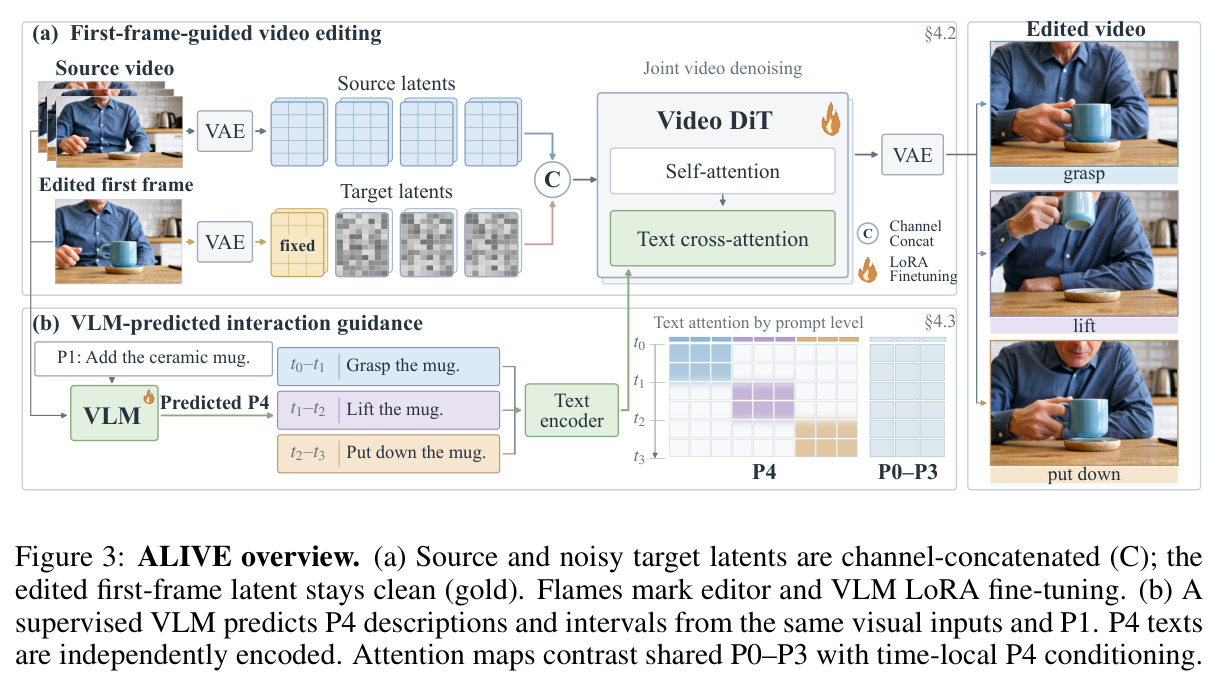
直觉上,让物体“活”需要两样东西:见大量“同场景有/无物体”的配对数据,以及知道物体该如何响应的语义指导。技术路线分两支。编辑器:以 LTX-2.5(22B)为骨干的首帧引导扩散模型,冻结的视频编码器把源-目标视频对映射到对齐潜网格 $z^X$、$z^Y$,干净源潜变量与噪声目标潜变量沿通道拼接 $h^t=\mathrm{Win}[z^t;z^X]_{\mathrm{channel}}+b$(目标半边继承预训练投影、源半边置零初始化),$E_0$ 的潜变量在整个去噪过程中保持干净以锚定首帧。文本条件支持 clip 级(P0-P3)与时间局部化(P4)两种模式,在 35,800 对数据上以 rank-128 LoRA、流匹配目标、混合提示层级训练。VLM:另一个 rank-64 LoRA 微调的 Qwen3.6-27B,从 21 帧源视频、$E_0$ 和 $p_1$ 预测 P4 区间提示,推理时以 $\hat{p}_4=F_\phi(X,E_0,p_1)$ 替换 $p_1$ 作为编辑器文本条件。
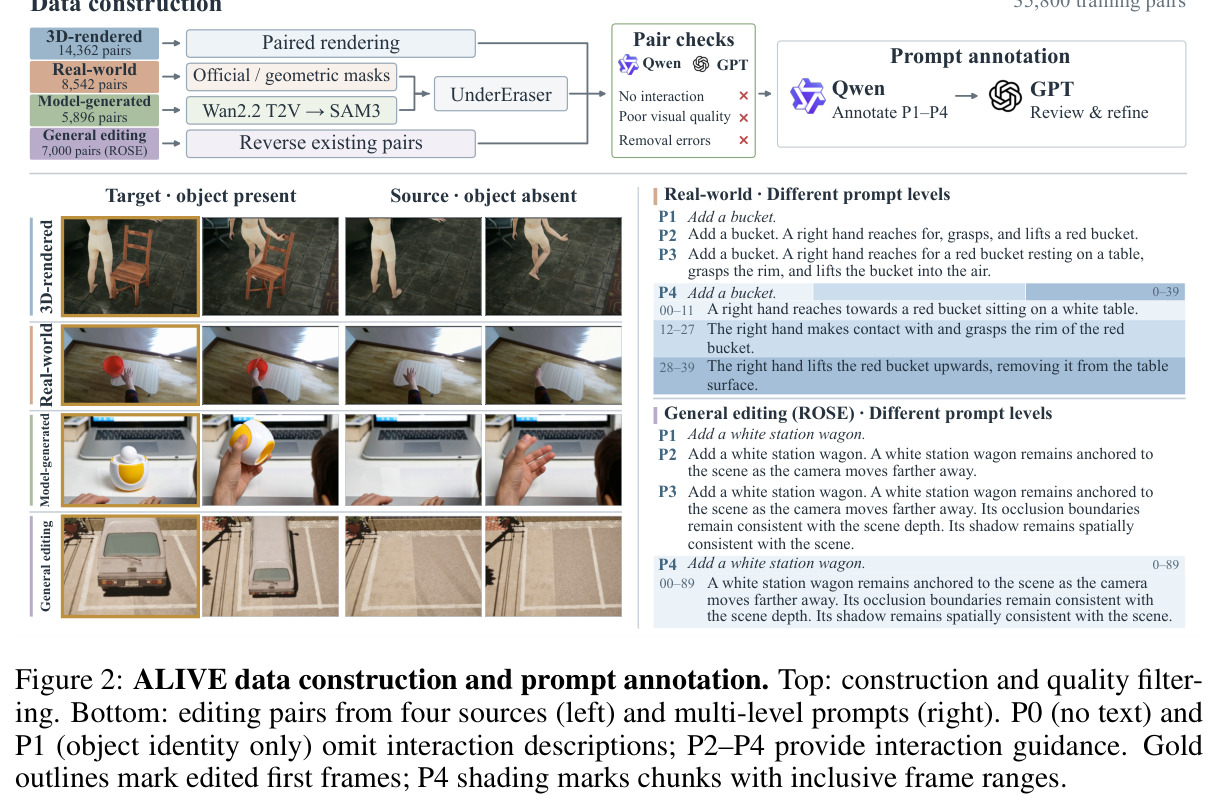
核心创新有三。第一是交互配对数据构造:3D 渲染对(SpaceTimePilot 资产多视角渲染有/无物体序列,同相机轨迹同动画,像素级对齐并附带掩码)、模型生成对(GPT 设计提示→Wan2.2 生成→SAM3 分割跟踪→UnderEraser 移除构造源视频)、真实世界对(ARCTIC/HOCap/HOI4D/HOT3D 剪辑+官方或几何投影掩码+移除)、以及 ROSE 去除对反转为插入对,四源互补。第二是 P4 时间路由:把每段描述 $d_k$ 独立编码为上下文 $C_k$,对视频 token $i$ 计算其与区间 $I_k$ 的归一化时间重叠 $w_{ik}$,交叉注意力改为 $A_{ij}=\mathrm{softmax}_j(q_i^\top k_j/\sqrt{d}+\log(w_{ik}/L_k))$,除以长度 $L_k$ 防止长描述凭长度获得注意力先验;只修改视频到文本的交叉注意力,所有 chunk 联合去噪。第三是 VLM 预测交互指导:标注时可用目标视频,但预测只用源侧输入,把“物体该怎样动”从人工 prompting 变成监督学习问题。
方法步骤详情
完整流程如下。数据构造:四源共 35,800 对——3D 渲染 14,362、模型生成 5,896、真实世界 8,542、ROSE 反转 7,000;Qwen3.6-27B 与 GPT-5.6 质检,排除无交互、画质差、移除错误的配对;每对标注 P1(只命名物体)到 P4(时间分块)。编辑器训练:P0-P4 按 0.1/0.3/0.2/0.2/0.2 采样,81 帧 832×480,AdamW 学习率 $10^{-4}$ 线性衰减,batch 16,20,000 步,损失 $\mathcal{L}_{edit}=\mathbb{E}\|v_\theta(z^t,t;z^X,E_0,p)-(\epsilon-z^Y)\|^2_M$,只在非 $E_0$ 条件 token 上求平均。VLM 训练:输入 21 帧源+$E_0$+$p_1$,只在响应 token 上交叉熵,rank-64 LoRA,学习率 $5\times10^{-5}$,取 2,048 步检查点。推理:81 帧 768×512,30 步去噪,$\hat{p}_4$ 替换 $p_1$ 作文本条件。
技术新颖性
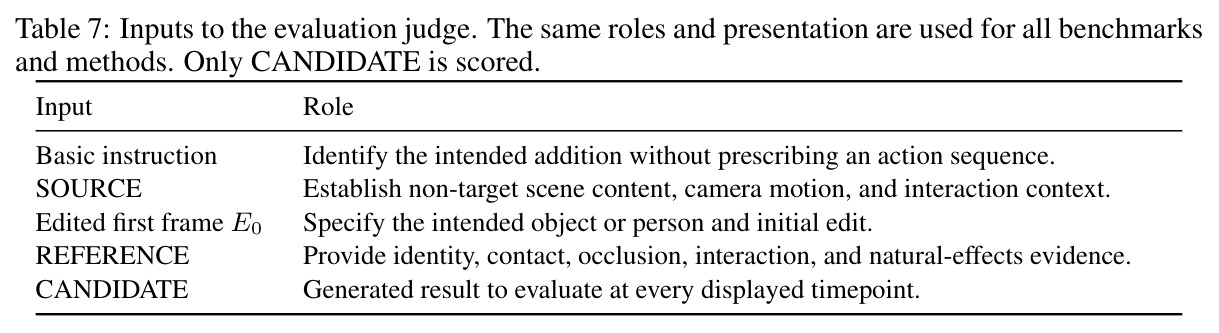
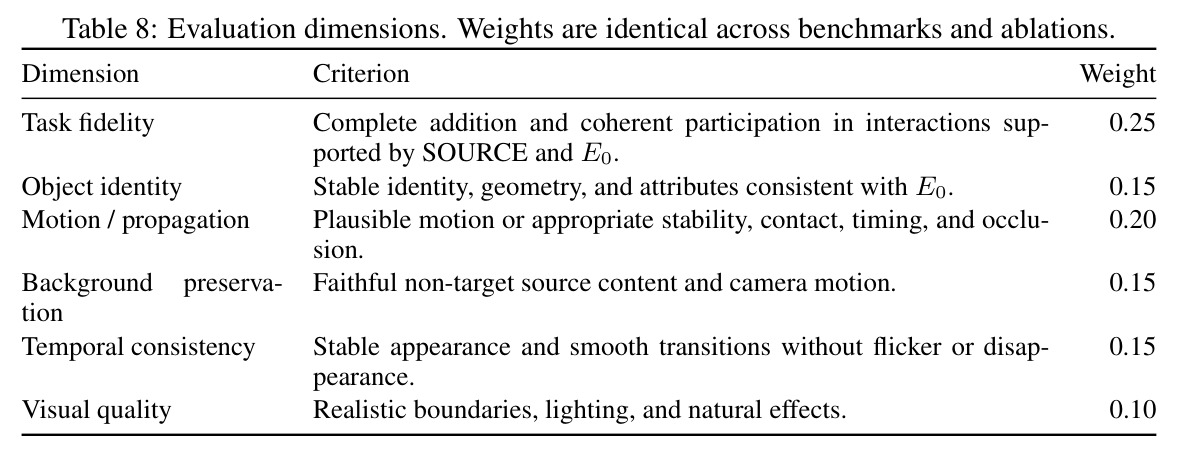
技术新颖性体现在四个层面。任务与数据:首个针对“插入物体参与交互”的大规模配对数据与专用基准,此前 ROSE/EffectErase 的插入对不含物体响应监督,ROSE-only 训练在交互基准仅得 60.12 直接证明了这一空白。条件机制:$\log(w_{ik}/L_k)$ 的加性时间偏置是一种新的文本条件方式,区别于整段 prompt 全帧共享的标准做法,实现软性时间对齐且不动主干结构。指导生成范式:把 VLM 从“场景描述器”(DynVFX)升级为用 P4 标注监督训练的“交互预测器”,预测输入与编辑器输入严格一致,消除训练-推理鸿沟,Table 3 显示预测 P4 把 Overall 从 86.71 提到 87.66。评测协议:统一 VLM judge、六维加权(Task 0.25、Motion 0.20 等)的 0-100 评分体系配合允许合理时空差异的 reference-aware 细则,同时披露 PickScore、ViCLIP、TC-CLIP 等自动指标交叉验证。
实验结果
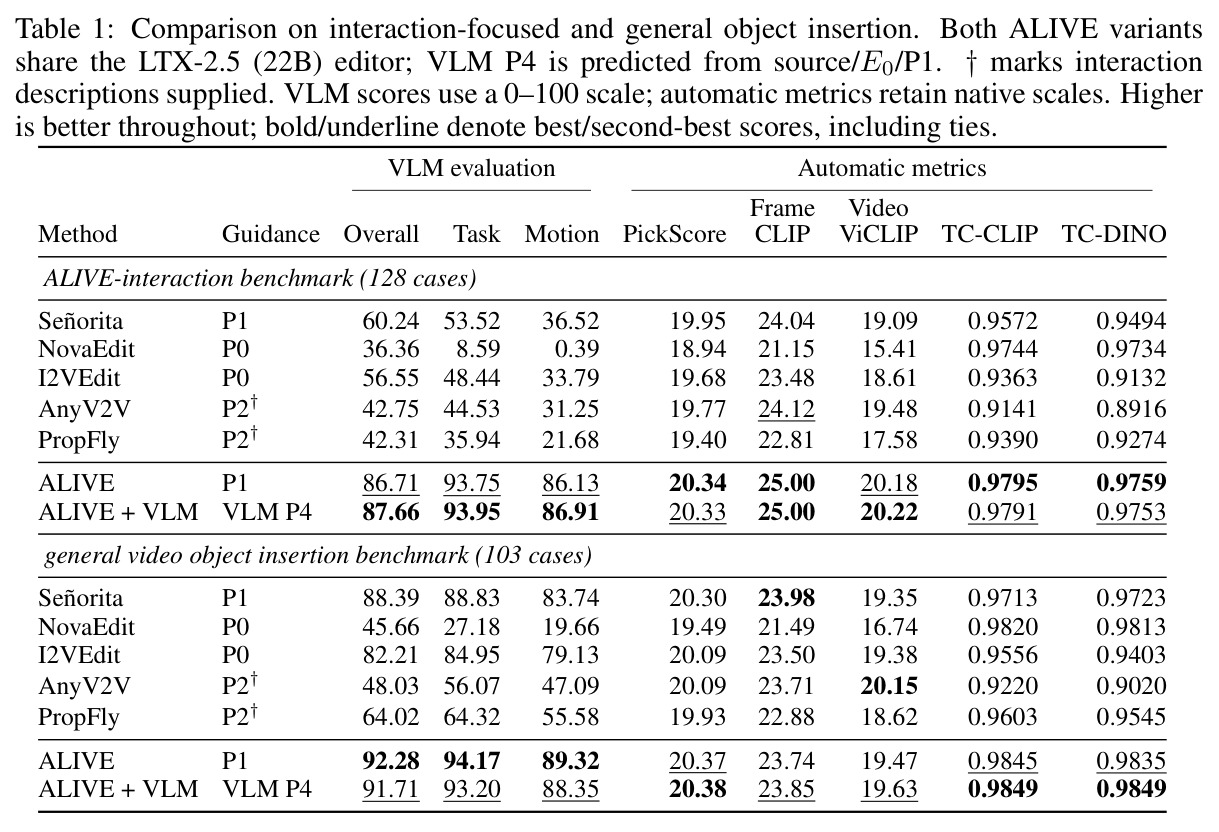
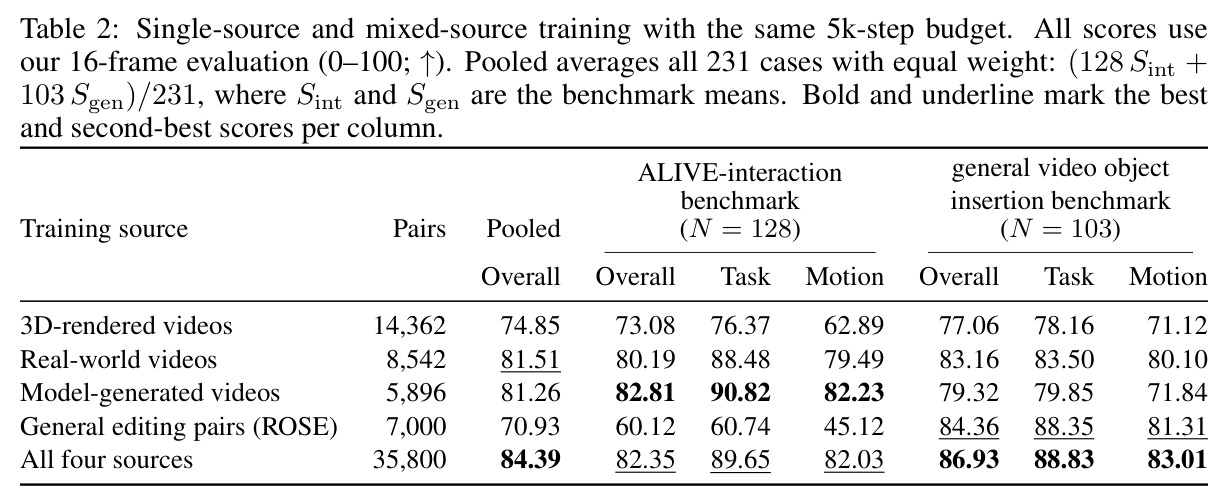
主实验(Table 1):交互基准上 ALIVE(P1)Overall 86.71,超最强基线 Señorita 的 60.24 达 26.46 分(43.9%),Motion 86.13 对 36.52;通用插入基准 92.28 对 88.39(+3.89,4.4%);ALIVE+VLM 再提到 87.66。数据消融(Table 2):混合四源 pooled 84.39 最佳;ROSE-only 交互仅 60.12 而混合 82.35,交互数据不可或缺。提示消融(Table 3):P0-P4 依次 85.38/86.71/86.68/87.37/88.69,P4 最优,VLM 预测 P4 为 87.66。骨干消融(Table 6):5k 步 Wan 14B 89.82/89.44 高于 LTX 82.35/86.93,但 LTX 每步 4.95 秒(16 卡)对 Wan 45.4 秒(32 卡),20k 步 LTX 升至 86.46/89.20。效率(Table 4):P4 编辑 184.5 秒+VLM 22.75 秒≈207 秒/条,远快于 I2VEdit 863.62 秒。
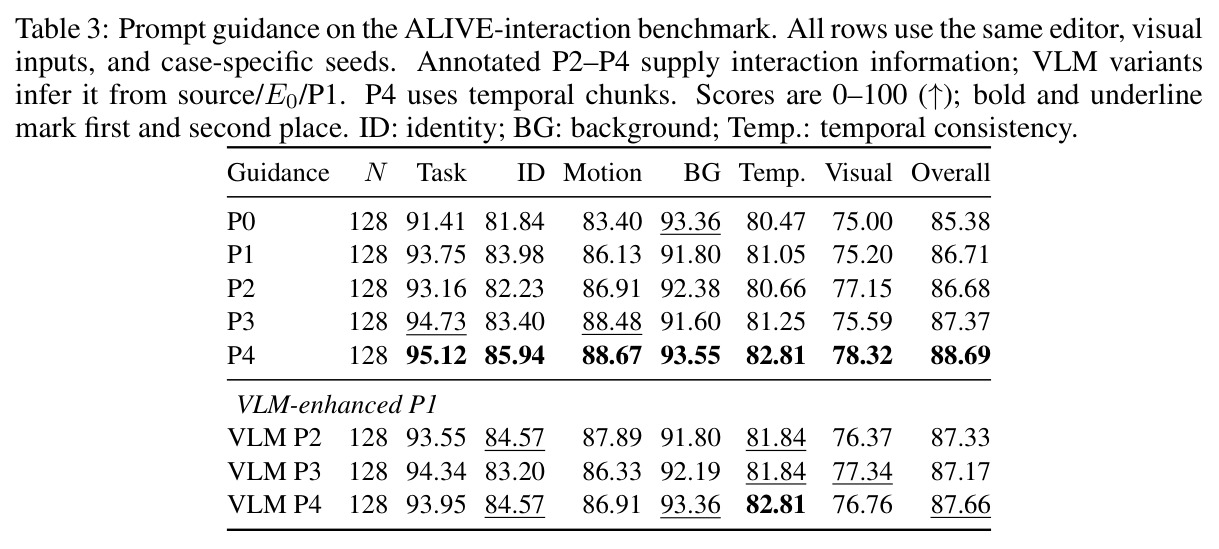
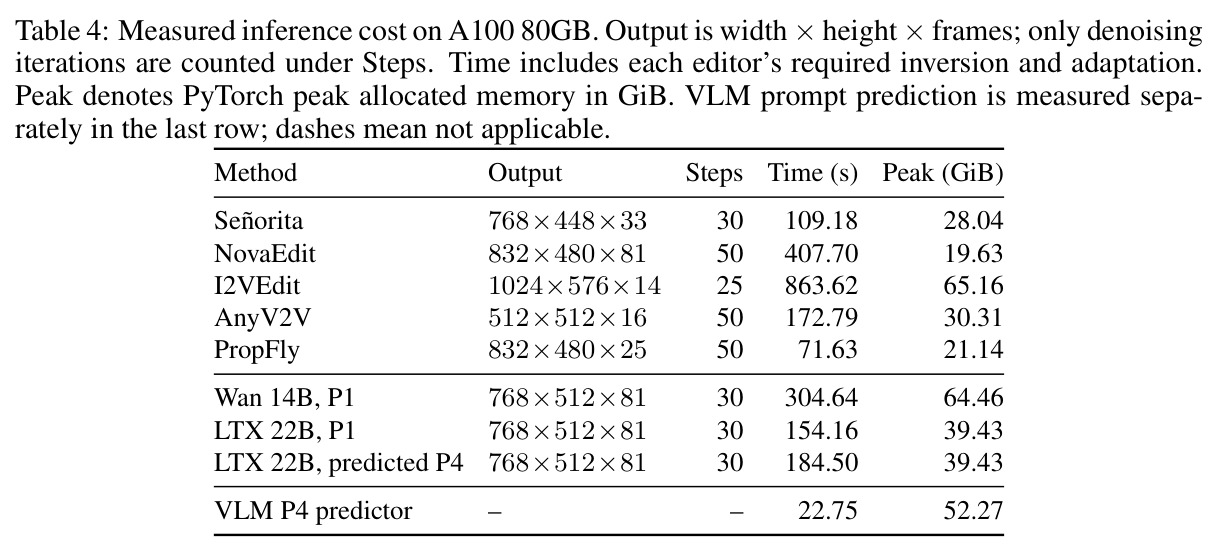
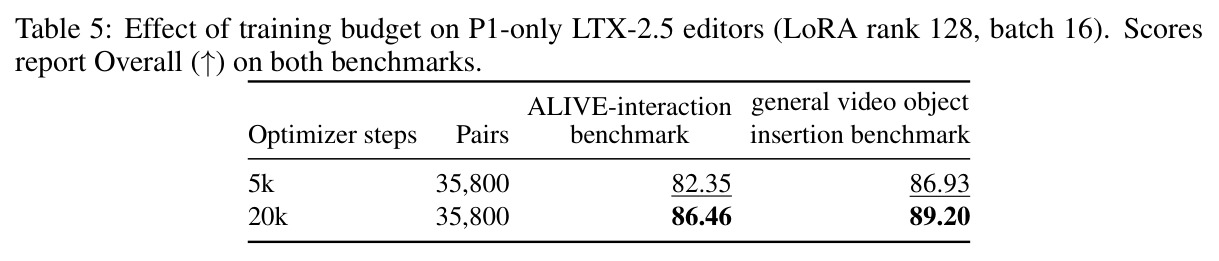
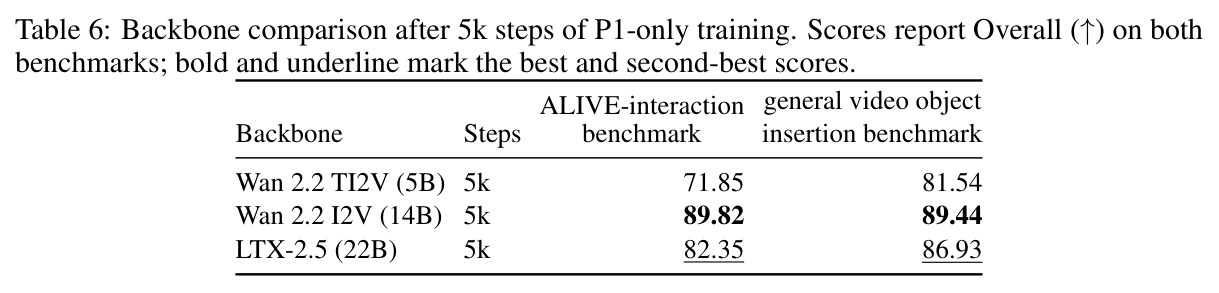
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 交互式物体插入(ALIVE-interaction 基准,128 例) | VLM 评审 Overall(0-100,六维加权) | ALIVE(P1) 86.71;ALIVE+VLM 87.66 | 最强基线 Señorita 60.24(其余:I2VEdit 56.55、AnyV2V 42.75、PropFly 42.31、NovaEdit 36.36) | +26.46 分,相对提升 43.9% |
| 通用视频物体插入基准(103 例,ROSE 60+EffectErase 43) | VLM 评审 Overall(0-100) | ALIVE(P1) 92.28;ALIVE+VLM 91.71 | Señorita 88.39 | +3.89 分(4.4%) |
| 交互基准 Motion/传播维度 | Motion 得分(0-100) | 86.13 | Señorita 36.52 | 约 2.4 倍,体现物体随源动作运动的根本改善 |
| 提示层级消融(交互基准,同一编辑器) | Overall(0-100) | 标注 P4 88.69;VLM 预测 P4 87.66 | P1 86.71 / P0 85.38 | P4 比无文本 P0 高 3.31 分,VLM 预测再为 P1 带来 +0.95 |
局限与改进
作者承认的限制:源视频与 $E_0$ 不能完全指定几何、接触条件与受力,物体响应存在多种合理解释——软物体受压形变取决于刚度,部分遮挡的抓取中杯子可能保持直立也可能倾斜,因此 ALIVE 只追求与源动作一致的合理响应而非唯一正确答案;VLM 预测的指导出错会直接导致错误行为;复杂布料形变与快速大角度旋转仍是弱项。我补充的观察:其一,评测完全依赖 gpt-5.6-sol 的 VLM judge(16 帧采样、0-4 整数打分较粗),存在评审模型偏好与自评偏差风险,而 PickScore 等自动指标上 ALIVE 仅 20.34 对基线 19.95,差异微小,主要结论系于 VLM 分数;其二,通用基准上预测 P4 反而把 Overall 从 92.28 拉低到 91.71,说明指导收益局限于交互场景;其三,3D 渲染数据占 40%,存在仿真-真实域差距;其四,配对构造依赖 UnderEraser 的移除质量,移除伪影可能被当作监督学入编辑器;其五,训练需 16 张 A100/H100 级算力,门槛高。
独立分析的弱点
弱点一:物理不可控。没有显式刚度、质量、接触约束,同一输入可产生多个“都合理”却不同的行为,用户无法选择或约束物体响应;改进方向是引入轻量控制信号(关键点轨迹、接触点热图)或可微物理先验。弱点二:错误级联无纠错。VLM 预测的 P4 区间或描述错误会直接误导对应时间段的生成,且推理中无法修正;可加入预测置信度、多候选提示重排序或生成后回验机制。弱点三:非流式、固定 81 帧。约 207 秒/条的处理时长与固定长度限制长视频与实时场景,需分段处理且段间一致性无保证。弱点四:评测单薄。judge 只看 16 帧,抓不住快速瞬态交互,也没有人类用户研究佐证;建议补充小规模人评与逐帧密集评测。弱点五:交互类型偏窄。训练数据集中于手-物交互(ARCTIC/HOI4D 等均为 HOI 数据集),对人物-人物协作、动物、多物体联动等交互泛化能力未知,可扩充交互类型库验证。弱点六:通用插入与交互目标存在轻微张力,P4 指导在通用基准略降分,两条能力的平衡机制未深入研究。
未来方向
作者提出的方向:提高 VLM 指导的可靠性(预测错误是当前失败主因之一);增强编辑器生成复杂交互的能力(布料形变、快速大角度旋转);引入显式物理信息以获得更准确、更可控的物体响应;结合 Self Forcing 或 EditStream 实现实时流式物体插入。基于本文成果可延伸的研究:把 P4 时间路由机制推广到音频-视频对齐生成、字幕驱动剪辑等跨模态时间对齐任务;将交互感知的六维评测协议发展为社区标准基准;用世界模型或基于仿真的响应预测替换 VLM,获得物理一致的物体行为;扩展到多物体同时插入与物体间碰撞、传递等复合交互;跨视角一致约束下的插入使物体状态在多机位间保持 3D 一致;自动化数据管线(GPT 提示设计→Wan2.2 生成→SAM3 跟踪→UnderEraser 移除)可低成本扩到百万级配对。
复现评估
正文提到项目页但未明确声明开源代码与数据。可复现性信息相当充分:数据配方完整(35,800 对=14,362 3D 渲染 SpaceTimePilot + 5,896 Wan2.2/SAM3/UnderEraser 生成 + 8,542 ARCTIC 等真实数据 + 7,000 ROSE 反转),训练超参齐全(LTX-2.5 22B、rank-128 LoRA、81 帧 832×480、batch 16、lr $10^{-4}$、20k 步;VLM rank-64、2,048 步),推理设置明确(81 帧 768×512、30 步),评测协议完全透明(judge prompt 见 Figure 6,打分锚点与六维权重见附录 A.4)。主要障碍:LTX-2.5 与 Qwen3.6-27B 的权重获取许可、16 卡 A100 级算力(5k 步约 8.1 小时)、UnderEraser 与 SAM3 的部署、3D 渲染数据人工挑选片段难以自动化;若两个基准(128+103 例)随项目页发布,评测可直接复现。
论文图表
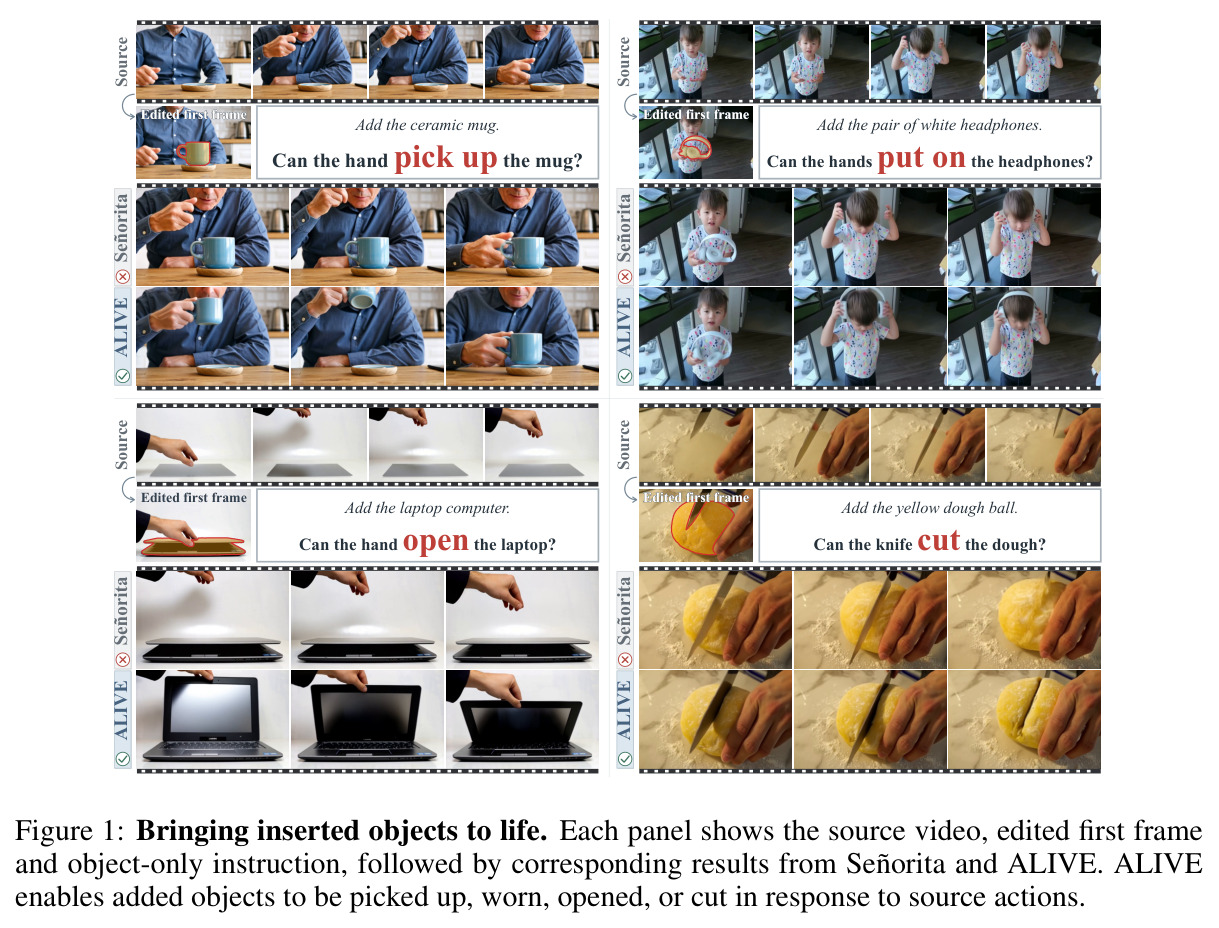
四个交互案例(添加陶瓷马克杯、白色耳机、笔记本电脑、黄色面团),每个面板依次展示源视频、编辑首帧与 P1 物体指令,然后并排对比 Señorita 与 ALIVE 的生成结果:基线中物体基本静止不动,ALIVE 中物体被拿起、戴上、被手翻开、被刀切开。
一图点明任务本质与现有方法的核心差距,是理解论文动机的最快入口。
评审 VLM 的完整任务提示词:16 个归一化时间点上 SOURCE/REFERENCE/CANDIDATE 并排呈现、$E_0$ 单独给出,六个维度的 0/2/4 打分锚点逐条列出,明确允许与参考合理的时空位置差异、禁止奖励冻结视频、要求引用早中晚期证据并返回结构化 JSON,另附预处理对齐说明(cover resize、中心裁剪、时间标签为归一化位置)。
评测协议完全透明,是判断本文所有 VLM 分数可信度与复现其评测的直接依据。