无状态语言智能体:扩展长时程自动化研究 Stateless Language Agents: Scaling Long-Horizon Automated Research
让框架持有研究状态、智能体彻底无状态,十亿token长程实验全面领先且省84%以上token
前置知识
状态与上下文之分
智能体的「状态」指跨调用持久存在的信息,如候选解代码、评测分数、实验记录;「上下文」指模型单次调用实际看到的提示内容。传统智能体把两者混在持续增长的对话历史里,本文主张状态由外部框架持有,上下文每次按角色从状态重建。
这是全文的核心概念区分,标题里的「无状态」、方法的每一条设计都建立在对这两个词的严格区分之上。
自动化研究
指用 LLM 智能体迭代地提出、实现、评测解决方案的闭环系统,面向有可测量目标但无已知最优解的开放问题,如内核优化、算法设计。代表工作有 FunSearch、AlphaEvolve、CORAL、SwarmResearch 等。
本文的应用场景就是自动化研究,所有实验任务(SWE、GPU 内核、算法设计)都属于这一范式,理解任务形态才能理解长时程的含义。
LLM 引导的进化搜索
把 LLM 生成的程序嵌入进化循环:变异生成候选、自动评测打分、择优保留。早期方法每次候选只依赖一两次模型调用;CORAL、SwarmResearch 等新框架改用可调用工具的编码智能体,让智能体自己查代码、跑测试、多步改写。
本文的三个基线 EvoX、CORAL、SwarmResearch 分别代表不同代际的搜索框架,理解它们才能看懂对比实验设计和 SLA 改进了什么。
累计 token 预算
以输入加输出 token 的累计消耗量作为衡量运行进度的横轴,替代常见的迭代次数或墙钟时间。在模型和推理设置固定时,它可控且可复现,还能公平比较并行度不同的多智能体系统。
本文所有实验都按 25%、100% 等多个累计 token 预算点报告结果,「排名随预算反转」这一核心发现完全依赖这种度量方式。
上下文窗口与自动压缩
上下文窗口是模型单次能处理的最大 token 数;自动压缩指当对话接近上限时,智能体框架自动把早期历史折叠成摘要以继续运行。Codex、Claude Code 等编码智能体都默认开启压缩。
长会话回放和压缩正是 SLA 要规避的失败来源;SLA 中压缩只在单次调用内起作用,因为会话本身不跨调用存在。
基准饱和
当所有方法都逼近某个基准的最优解后,分数差距消失,基准只能测出谁更快到顶,而测不出谁能把更多算力持续转化为进展。例如 26 圆填充问题在 5M token 内四个方法分差已小于 $2.3\times10^{-10}$。
作者论证现有评测因基准饱和而失真,这是本文选择 FrontierSWE、内核优化等有余量任务并用多预算点评测的直接原因。
研究动机
长时程自动化研究系统存在两类被作者用真实运行轨迹证实的失败。其一是记忆回放失控:把不断增长的历史对话塞进上下文既烧 token 又损害智能体行为,作者复现的 CORAL 在 FrontierSWE libexpat 任务上,两个智能体从同一父候选出发实现了同一个功能、得到相同分数,之后又再次重叠,尽管其中一方早已在共享记忆里发帖声明认领了该功能。其二是停止探索但 token 继续烧:某次 GPU 内核任务的 CORAL 运行中,最后一次改进出现在 2.31 亿 token 处,此后智能体反复宣称解已最优,最后 1500 个会话里 98% 没有任何工具调用,而 token 消费一路涨到 10 亿。评测方式也失真:多数工作按迭代次数或模型调用数计预算,且常用基准早早饱和——26 圆填充上四个方法在 5M token 内分差就小于 $2.3\times10^{-10}$,完全测不出长程差异。
本文的目标是本文要回答的核心问题是:当推理预算从百万 token 涨到十亿量级时,如何让额外算力持续转化为研究进展而非空转?具体目标有三。第一,提出并严格落实「状态化搜索、无状态智能体」这一架构原则:研究状态(候选解与测量结果)由 harness 统一持有,任何智能体包括规划者都不携带对话跨调用,每次调用看到什么成为显式的设计选择而非历史的副产品。第二,实现一个由无状态 Advisor 和多个并行 Worker 组成的框架,在软件工程、内核优化、算法设计三类任务上、最高 10 亿累计 token 预算下与 EvoX、CORAL、SwarmResearch 正面对比。第三,揭示短预算评测会系统性误判方法与组件,倡导在多个 token 预算点上报告结果。
与已有工作不同的是,已有智能体框架把研究史主要存在智能体自己的长会话里:CORAL 在每次心跳、停滞或重启后恢复同一会话,重启的智能体从「自己刚决定停止」的那段对话继续,于是额外的推理只是重复那个停止的决定;SwarmResearch 的 Shepherd 协调者本身是长会话,而且被明确指示不得给搜索智能体分配具体想法。本文的独特切入是把「状态存在哪」和「谁来决定下一个实验」这两个隐含选择显式化:状态归 harness,决策权归每轮重生的无状态 Advisor,Worker 只看分配到的任务和自己的局部候选。方法学上它还首次统一以累计 token 为横轴,并利用可 checkpoint 的研究状态从同一状态续跑做受控消融,使「聚焦上下文」「显式分配」这些组件的贡献能被因果地测量。
核心方法
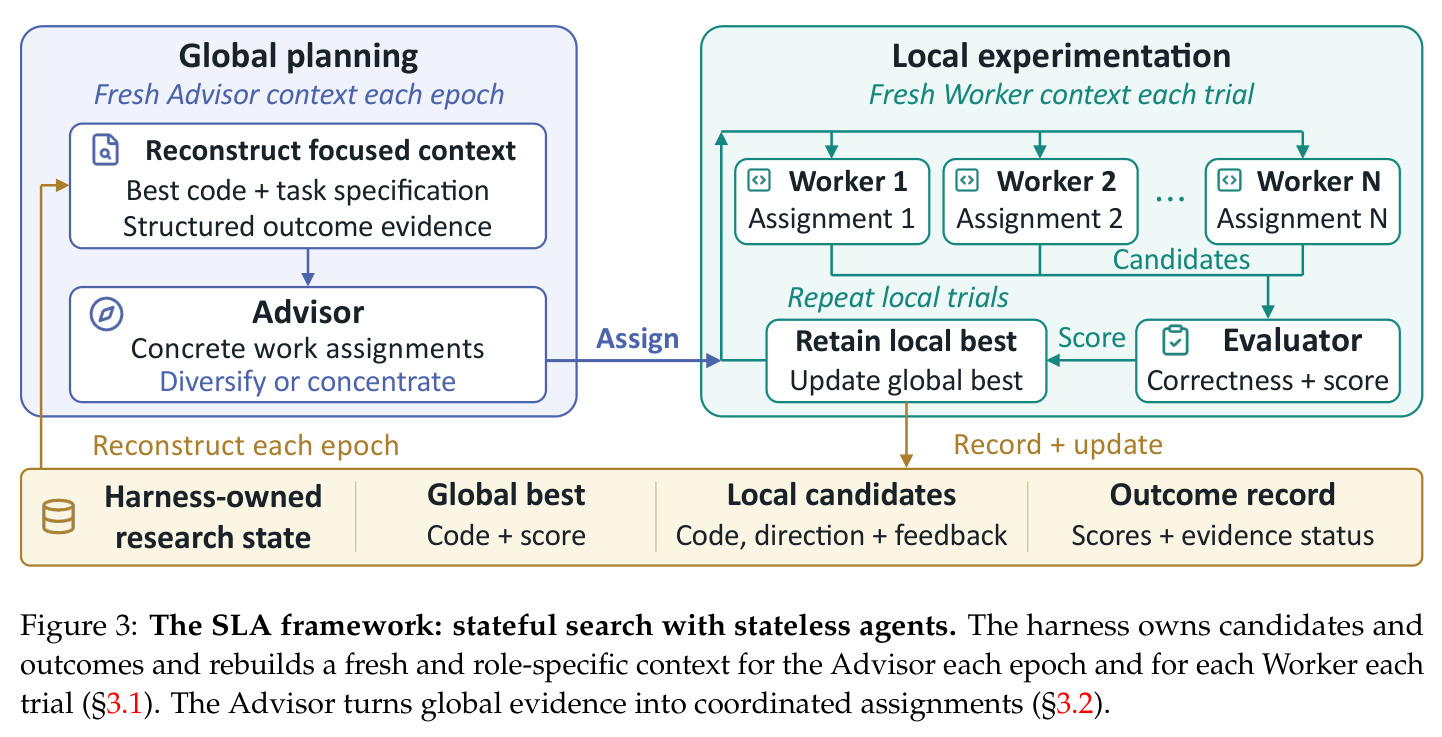
直觉上 SLA 像一个科研组:Advisor 相当于 PI,每个 epoch 读一份由系统整理好的全局证据摘要,决定把哪些具体实验派给谁;Worker 相当于学生,各自在隔离工作区里反复做局部试验,只看到自己的任务、自己保留的候选代码和紧凑的局部反馈;独立评测器在沙箱外打分。技术上,harness 持有三类研究状态:全局最优(代码加分数)、每个 Worker 的局部候选(代码、方向、反馈)、完整 chronological 实验记录。每个 epoch 的循环是:harness 从状态重建 Advisor 上下文,Advisor 输出对并行 Worker 的具体分配,每个 Worker 跑若干局部 trial,独立评测器给每个候选打分,harness 记录结果并更新局部与全局最优,直到预算耗尽。每次 Advisor epoch 和每次 Worker trial 都是一次全新调用,只有 harness 记录在研究状态里的内容才会延续到下一次调用。
核心创新是把智能体的「状态」(跨调用持久的信息)与「上下文」(单次调用看到的内容)严格区分,并让所有智能体彻底无状态:对话不跨调用携带,harness 每次从研究状态重建角色化上下文。与 CORAL、SwarmResearch 的本质区别在于:它们的记忆存在智能体对话里,编排者自身有状态并决定子智能体看什么、何时停;而 SLA 中连 Advisor 也无状态,「每个角色看到什么」成为显式设计。这带来三点实质差异。第一,Advisor 的证据摘要把「测量出的不改进」与「实现、运行或正确性导致的未决失败」分开,避免把工程失败误读成方向枯竭。第二,显式任务分配把全局证据转化为人不重复的具体实验,Worker 的并行不再互相撞车。第三,状态可 checkpoint,使消融能从完全相同的状态续跑,实现组件贡献的因果归因。
方法步骤详情
第一步 Advisor 轮:输入是任务说明、当前全局最优代码与分数、harness 构建的证据摘要(按搜索方向分组的近期尝试与结果、Worker 状态、近期进展及可选任务诊断),输出是给每个 Worker 的具体实验分配,可分散探索也可集中攻坚;Advisor 每轮开新会话。第二步 Worker trial:输入是任务说明、收到的分配、自己保留的局部候选代码、紧凑局部反馈(上一 trial 状态、测量分数、正确性诊断),输出是修改后的候选代码;Worker 读不到其他工作区与完整历史,跨方向信息只能经 Advisor 的分配流入。第三步评测:候选在 Worker 环境之外用受保护的评测器打分。第四步更新:harness 记录结果,改进则更新局部与全局最优;局部候选即使落后也保留,给替代方向成熟时间;Advisor 改派方向时 Worker 从全局最优重启,首个成功评测的候选成为新的局部基线。第五步工程强制:Landlock 文件系统限制、受限网络、每次 trial 清空保存的会话、按角色记录 token、定期 checkpoint 全部研究状态。
技术新颖性
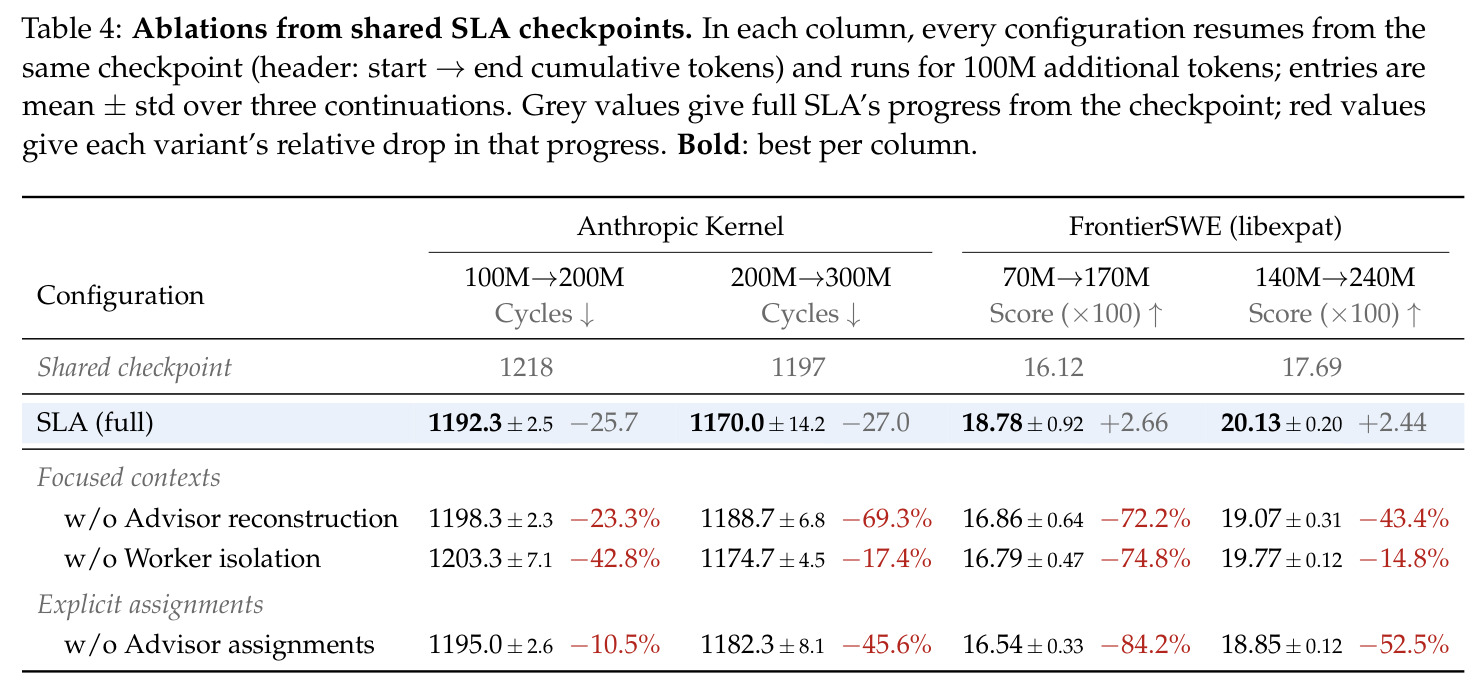
技术新颖性有四点。其一,无状态是工程强制而非提示请求:新会话加 Landlock 沙箱加清空保存会话,从架构上杜绝状态泄露,这与靠 prompt 约束的做法有本质区别。其二,上下文重建是计算出的视图而非历史裁剪:区分「测得无改进」与「未决失败」的证据摘要在已有工作中没有先例,它直接针对长时程搜索中把运行失败误判为方向枯竭的痛点。其三,与 SwarmResearch 明确不给具体想法的 Shepherd 相对,SLA 把「决定下一个实验」显式交给 Advisor,消融证明去掉分配后并行 Worker 会重复实现同一功能。其四,checkpoint 式研究状态让「移除某组件后从同一状态继续」成为可能,并据此发现组件效应随预算超线性增长:去掉 Worker 隔离在 100M token 续跑中只损失 5–11 个 cycles,而在完整 1B token 运行中损失扩大到 224 个 cycles。
实验结果
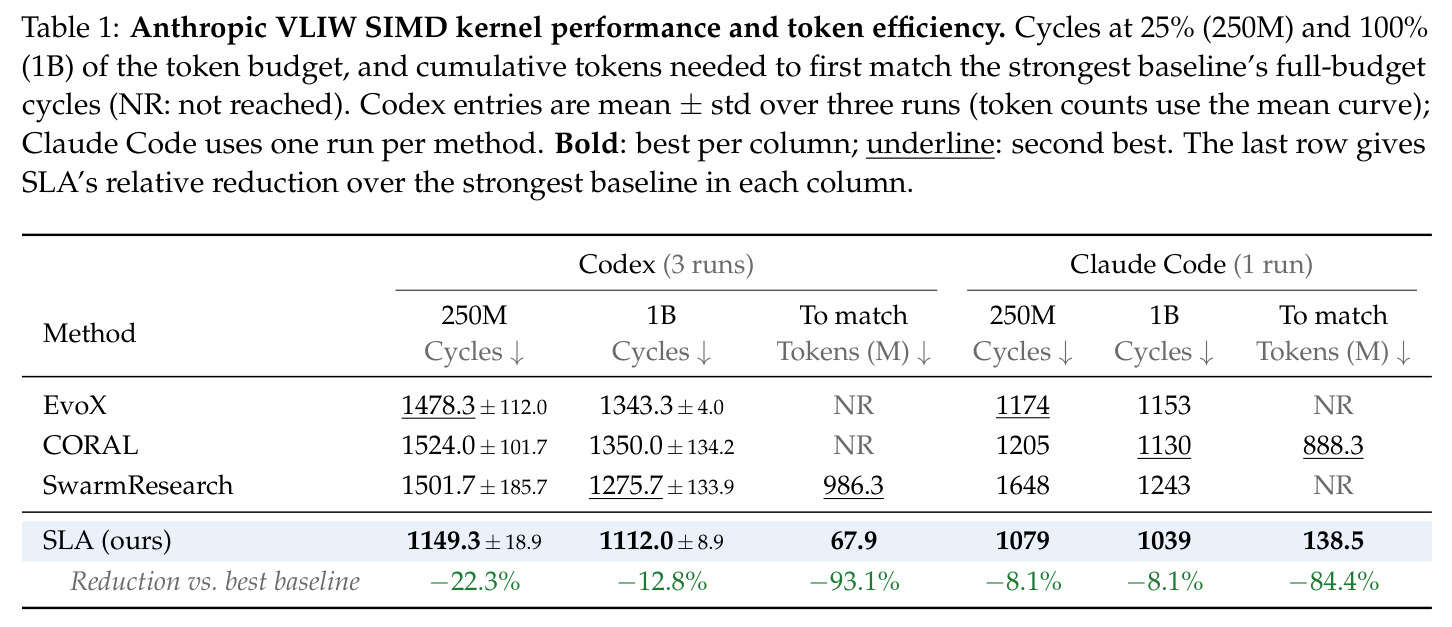
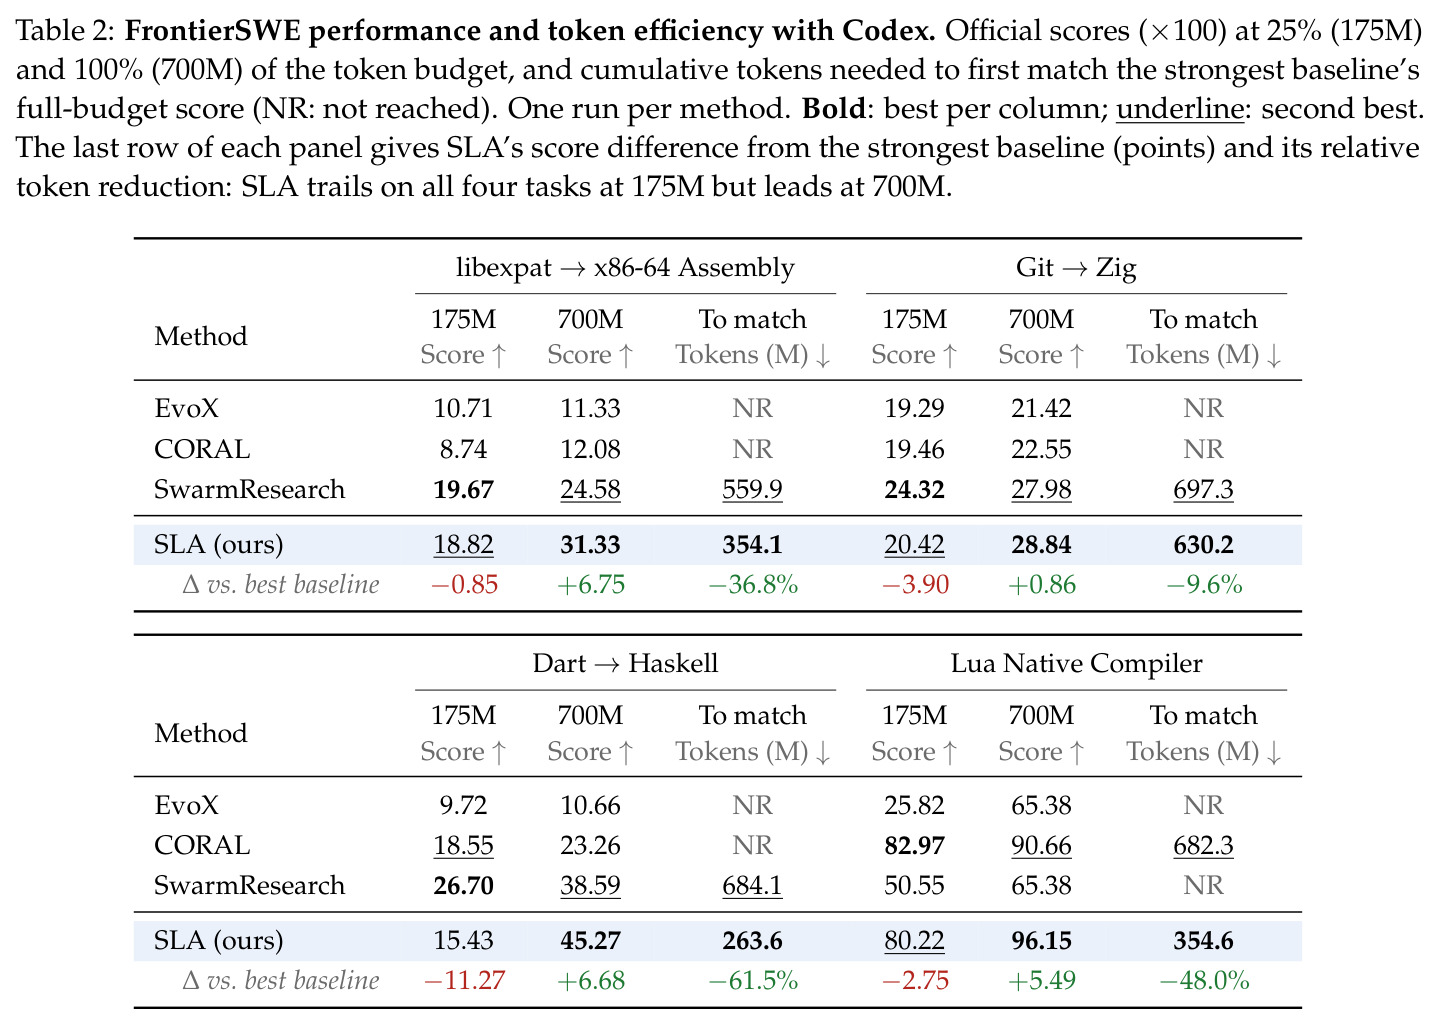
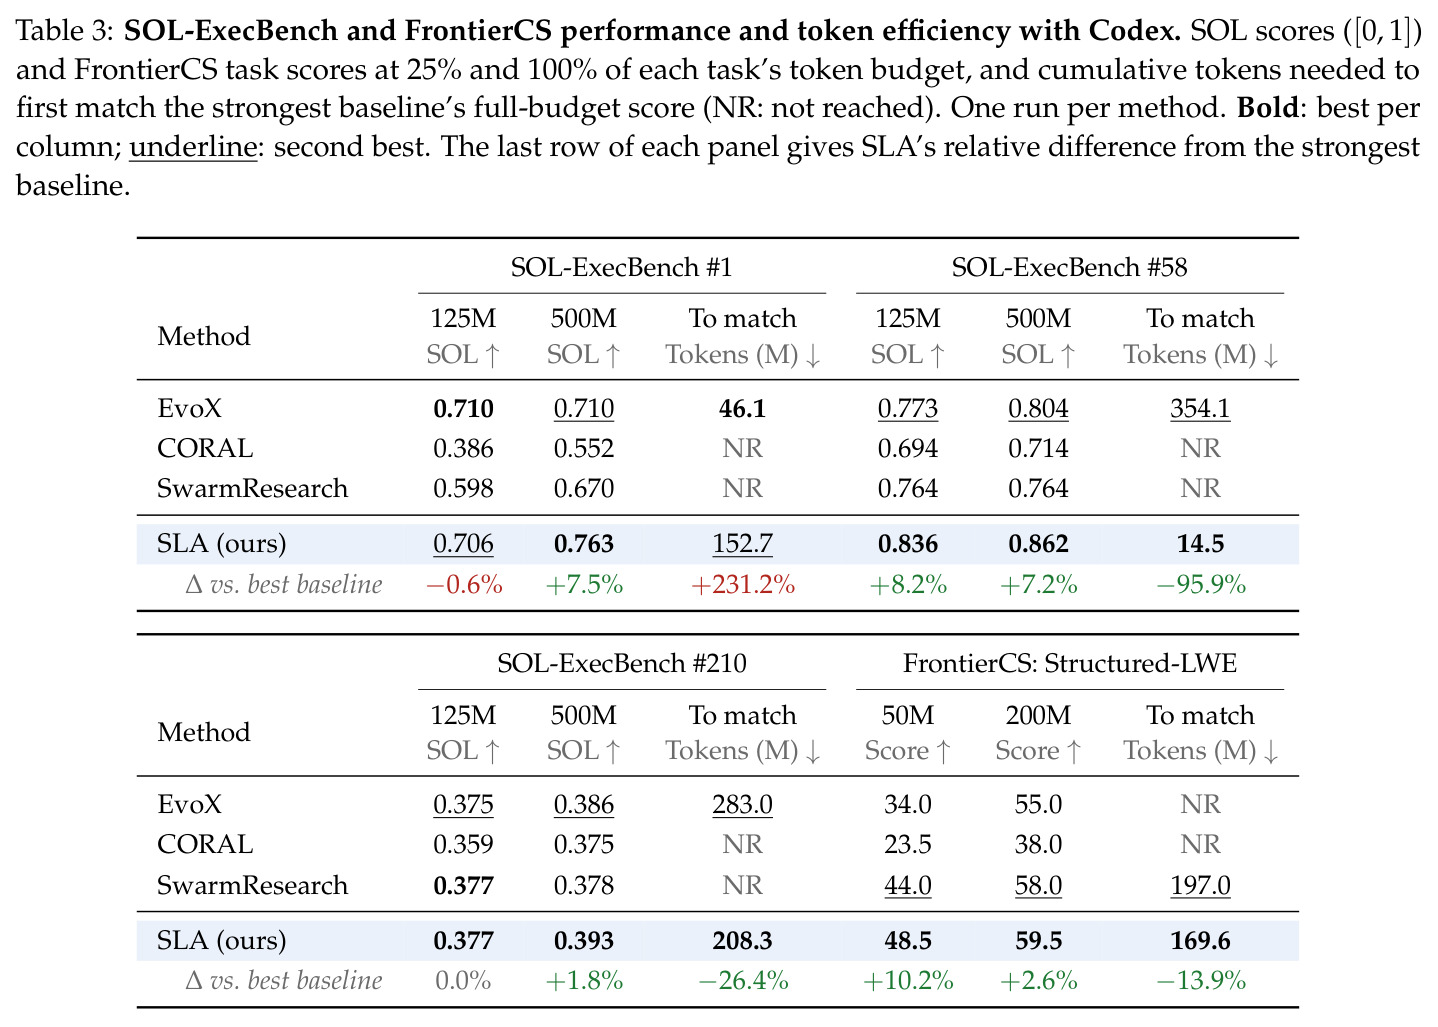
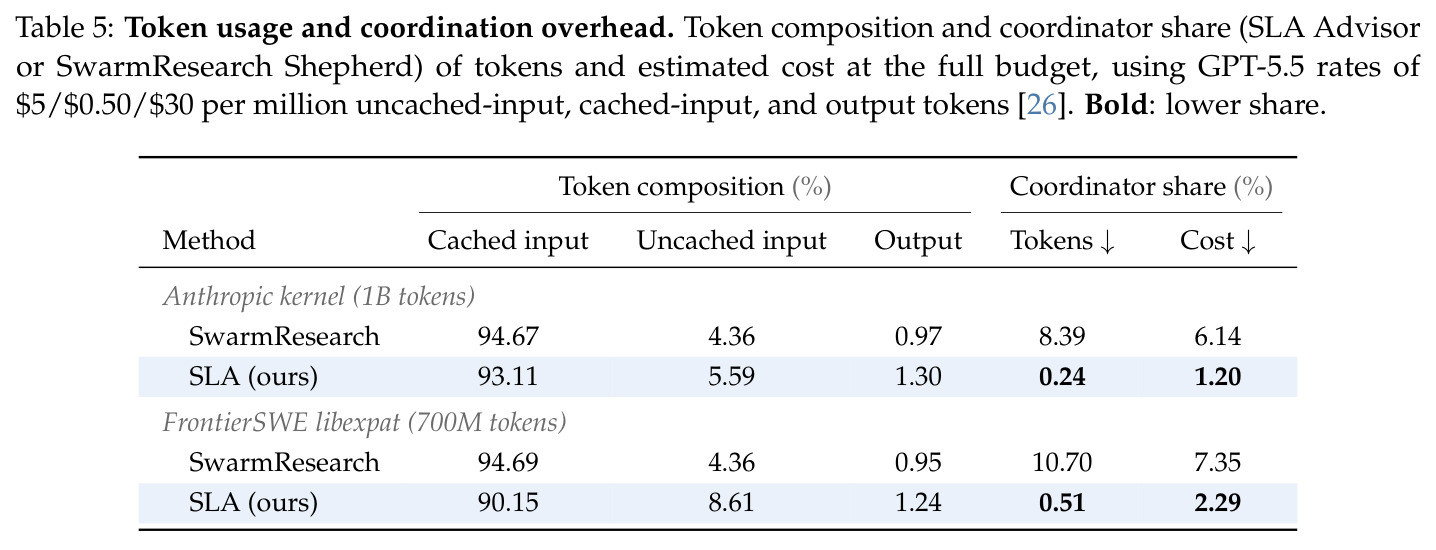
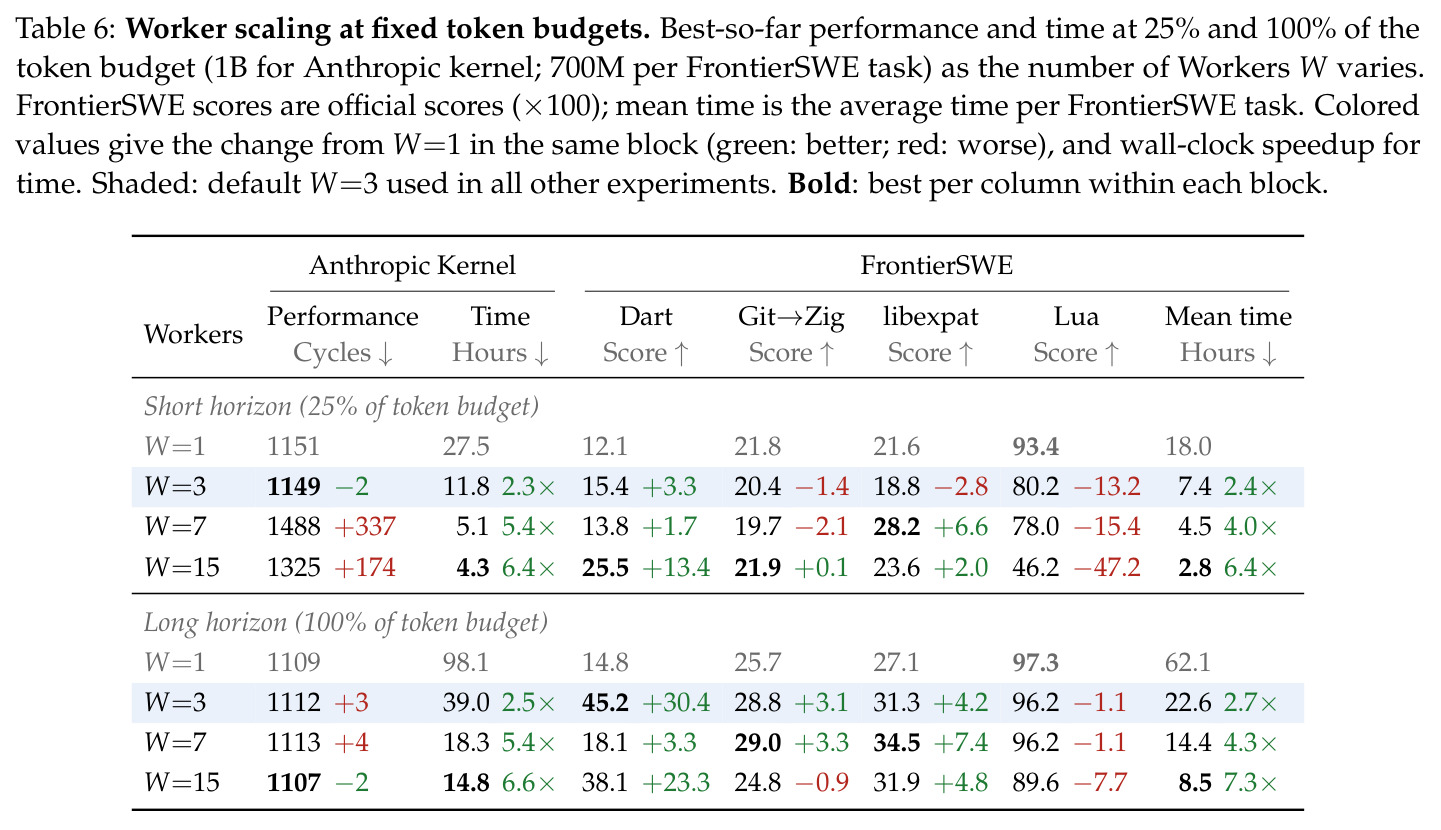
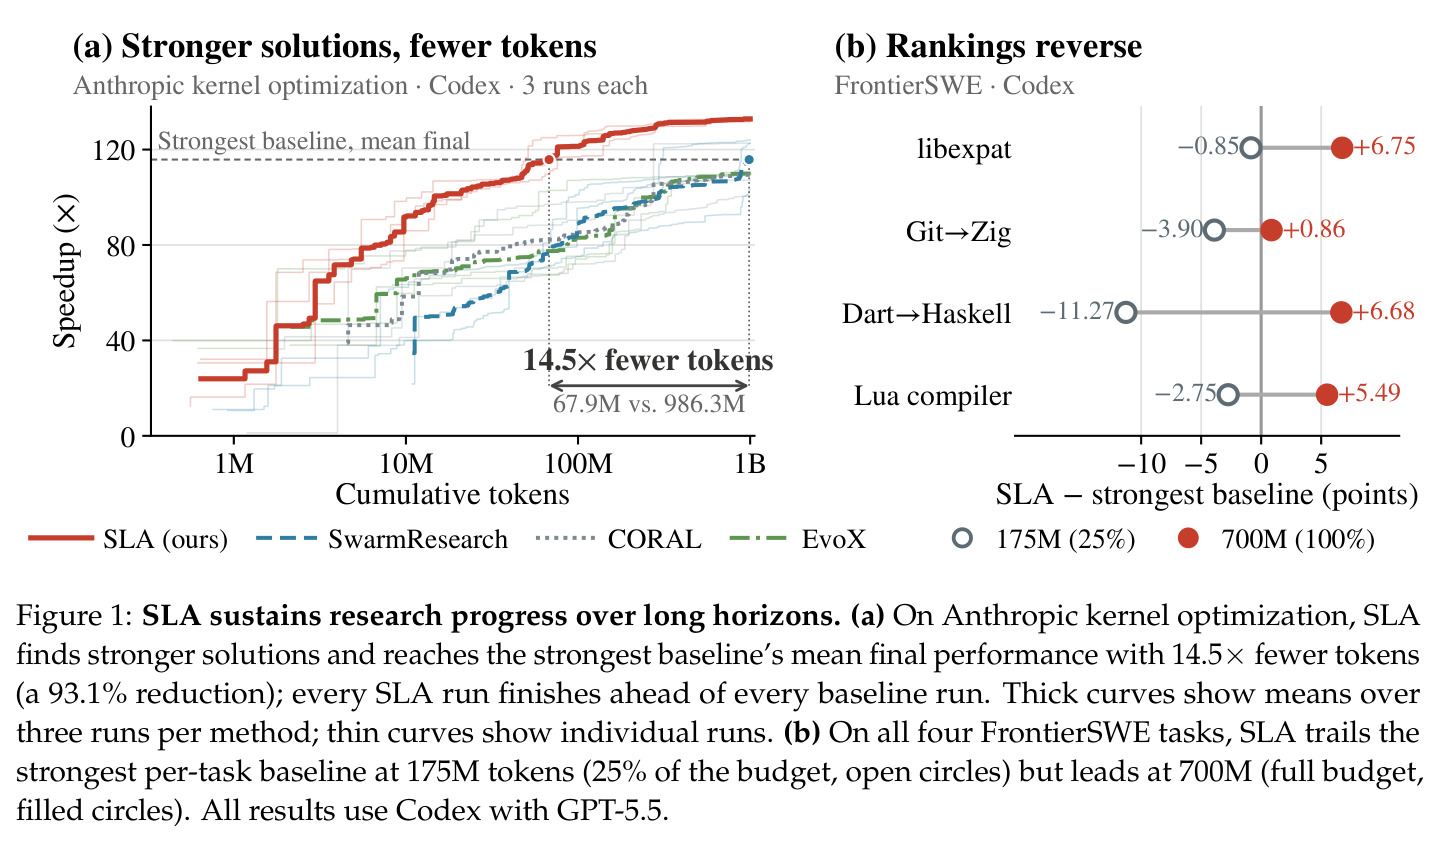
SLA 在全部 7 个任务上取得最佳满预算结果。Anthropic 内核优化(Codex,3 次重复):$1112.0\pm8.9$ cycles 对最强基线 SwarmResearch $1275.7\pm133.9$,三次 SLA 运行全部好于九次基线(最差 SLA 1122 对最好基线 1191);达到基线终值仅需 67.9M token 对 986.3M,省 93.1%(14.5 倍);Claude Code 下 1039 对 1130,token 省 84.4%。FrontierSWE:175M 时四任务全部落后($-0.85$ 至 $-11.27$ 分),700M 全部反超($+0.86$ 至 $+6.75$),平均 $+4.95$ 分,排名随预算反转。SOL-ExecBench:#58 得 0.862 对 0.804,达标 token 省 95.9%;#1 终值 0.763 对 0.710(EvoX 达标更早);#210 仅 $+1.8$%。FrontierCS Structured-LWE 59.5 对 58.0。共享 checkpoint 续跑消融:去重建、去隔离、去分配均降低进展,最大损失 84.2%;去隔离代价从 100M 续跑的 5–11 cycles 膨胀到整程 224 cycles(1336 对 1112.0)。Advisor 仅占 0.24–0.51% token 与 1.2–2.29% 成本,Shepherd 占 8.39–10.7% token。$W\in\{1,3,7,15\}$ 时 1 到 15 Worker 墙钟缩短 6.6–7.3 倍,内核任务满预算四宽度收敛于 1107–1113 cycles,FrontierSWE 最优宽度因任务而异;同 $100 成本下 GPT-5.4 mini 在 Git→Zig 得 20.88 高于 GPT-5.5 的 19.68。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Anthropic VLIW SIMD 内核优化(Codex,3 次重复) | 内核 cycles(越低越好)+ 达到强基线终值所需累计 token | SLA 1112.0±8.9 cycles;达标仅需 67.9M token | 最强基线 SwarmResearch 1275.7±133.9 cycles;需 986.3M token | cycles 降低 12.8%,token 减少 93.1%(约 14.5 倍),且最差 SLA 运行(1122)优于最好基线运行(1191) |
| Anthropic 内核优化(Claude Code,Opus 4.8) | cycles + 达标 token | SLA 1039 cycles,138.5M token | CORAL 1130 cycles,888.3M token | cycles 降低 8.1%,token 减少 84.4% |
| FrontierSWE 四任务(libexpat→x86-64、Git→Zig、Dart→Haskell、Lua 编译器) | 官方分数×100(700M token 满预算) | SLA 31.33 / 28.84 / 45.27 / 96.15 | 各任务最强基线 24.58 / 27.98 / 38.59 / 90.66 | 平均 +4.95 分;25% 预算(175M)时 SLA 全部落後,满预算全部反超 |
| SOL-ExecBench #58(MoE token 排序 GPU 内核) | SOL 分数 [0,1] + 达标 token | SLA 0.862,达标仅 14.5M token | EvoX 0.804,需 354.1M token | 分数 +7.2%,token 减少 95.9% |
| SOL-ExecBench #1 与 #210(attention 反向传播 / 融合 RMS 归一化) | SOL 分数 [0,1] | #1 得 0.763 对 0.710;#210 得 0.393 对 0.386 | #1 最强基线 EvoX(达标更快但终值更低);#210 SwarmResearch 0.378 | #1 +7.5%;#210 仅 +1.8%(该任务接近饱和) |
| FrontierCS Structured-LWE(密码学算法设计) | 任务分数(越高越好) | SLA 48.5(25% 预算)/ 59.5(满预算),169.6M token 达标 | SwarmResearch 44.0 / 58.0,197.0M token | 满预算 +2.6%(25% 预算时 +10.2%),token 减少 13.9% |
局限与改进
作者承认的局限:多数配置只跑一次,仅有 Codex 内核任务与消融实验有 3 次独立重复,而基线方差高达 $\pm133.9$ cycles,单次运行的结论存在噪声风险;所有比较按 token 匹配,未计入运行与评测实验所需的算力成本;消融只改变「智能体看到什么」,没有测试「保留对话但做好记忆管理」的有状态对照;所有任务都有可执行评测器,目标模糊或评测缓慢的场景未被覆盖;SOL #210 上包括 SLA 在内所有方法从 25% 到 100% 预算的改进都小于 0.02,说明该任务在本预算下接近饱和。我的补充观察:结论完全建立在 GPT-5.5、Claude Opus 4.8 这类前沿闭源模型和 Codex、Claude Code 之上,向开源模型迁移的效果未知;harness 本身的工程复杂度、维护成本和证据摘要器可能引入的偏差都未量化;单一无状态 Advisor 在 W=15 时是否成为决策瓶颈(论文自己发现 15 Worker 在 FrontierSWE 从未最优)值得进一步研究;token 份额因缓存输入占比超过 90% 而低估 Advisor 成本,成本模型较为粗糙。
独立分析的弱点
第一,证据以单次运行为主:除内核任务外每个格只有一次运行,而表 1 显示同一方法方差可达 $\pm133.9$ cycles,FrontierSWE 分数波动也不小,「排名反转」这一最核心的论断恰恰建立在单次运行上——建议至少对 1–2 个任务做 3 次重复以确认反转的统计稳定性。第二,token 匹配不等于成本匹配:W=15 的 SLA 同时占用 15 份智能体进程与评测算力,墙钟加速与算力开销应并列报告,否则「更省 token」可能掩盖「更费机器」。第三,缺少强的有状态对照:基线的长会话记忆管理都较朴素,未对比「长会话加上优秀压缩或检索式记忆」的配置,无法完全排除收益部分来自基线实现粗糙——建议实现一个记忆管理精良的状态体作对照。第四,只覆盖可执行评测器的任务,候选代码 gaming 评测器的风险也只是被提及而未量化,可加入对抗性评测鲁棒性实验。第五,Advisor 决策质量没有被直接度量,论文只有「它很便宜」的证据,建议引入「分配命中率」「方向覆盖度」等指标直接评估规划质量。
未来方向
作者提出的方向:Worker trial 是上下文有界、以评测分数收尾的短 episode,可直接作为强化学习训练数据,模型无需在长达十亿 token 的整程上训练;Advisor 的分配与对应测量结果可用于训练实验规划模型,且因上下文短,这类模型对长上下文能力的依赖更低;安全方面,全部持久状态集中在 harness,可检查、可 checkpoint、可回滚,注入指令无法随对话传播,但需防护候选代码对评测器的 reward hacking;Advisor 因无状态可拆分为多个各看部分研究状态的 Advisor,突破单规划者扩展性。基于成果可延伸的方向:把「多预算点报告」标准化为社区评测协议,避免短预算误判;用 AutoML 思路按任务与预算自动搜索 Worker 数量与 Worker 模型组合;把 SLA 原则移植到开源模型与本地智能体框架验证普适性;研究证据摘要器本身的信息损失与偏差如何影响搜索方向选择。
复现评估
复现门槛较高但要素基本齐全。任务公开:FrontierSWE、Anthropic 内核任务、SOL-ExecBench、FrontierCS 均有公开渠道;基线 EvoX、CORAL、SwarmResearch 使用 pinned 的上游官方实现。智能体栈是 Codex CLI v0.152.1 加 GPT-5.5、Claude Code v2.1.258 加 Claude Opus 4.8,均为付费闭源服务。成本方面论文明确说单次长程运行需数百到数千美元,覆盖 9 种方法乘多个任务的全表估计需数千至数万美元,还要管理 1B token 级别的会话与 checkpoint 存储。值得注意的是正文未提及开源 SLA 框架代码,Landlock 沙箱、会话清空、证据摘要生成、按角色记账等工程细节需要自行实现,这是复现的最大障碍。建议复现策略:先在单任务上以 50M–200M 小预算验证 SLA 对基线的相对优势是否显现(论文显示 25% 预算处内核任务已有明显差距),再决定是否放大到 1B。
论文图表
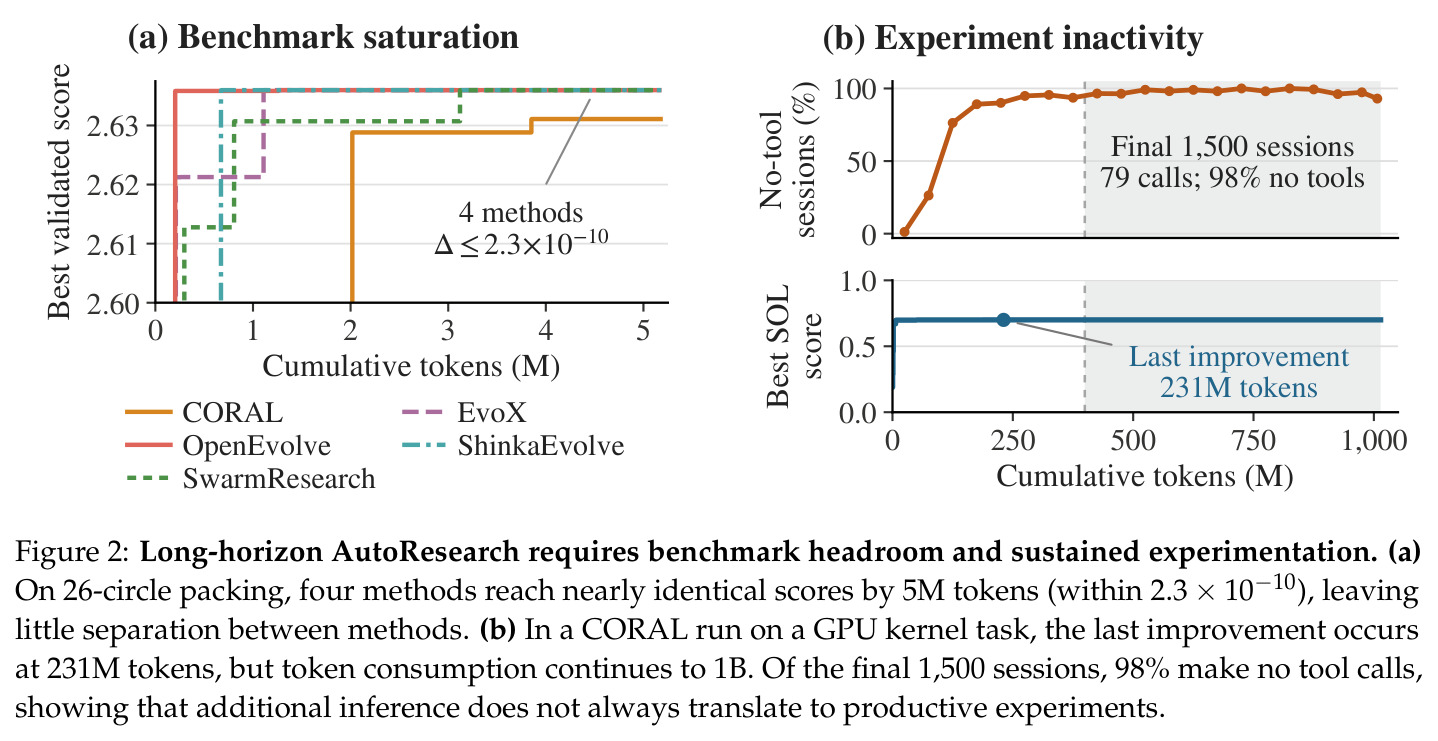
(a) 基准饱和:26 圆填充问题上 CORAL、EvoX、OpenEvolve、ShinkaEvolve 四个方法在 5M token 内分数差距已小于 $2.3\times10^{-10}$,失去区分度;(b) 实验停摆:某 CORAL GPU 内核运行中最后一次改进出现在 231M token,之后消费继续到 1B,最后 1500 个会话中 98% 没有任何工具调用。
这是动机部分两大痛点的实证数据,解释了为什么需要新架构(防止智能体空转)和为什么必须换任务、换评测方式(避开饱和基准)。