基于跨平台用户历史的个人智能体中介推荐 Personal-Agent Mediated Recommendation with Cross-Platform User History
个人LLM智能体用跨平台历史中介平台推荐,PAMO教它何时干预何时保留
前置知识
协同过滤与 SASRec
协同过滤利用全体用户的共现行为("与你相似的用户还喜欢……")做推荐,单一平台因此握有海量群体级证据。SASRec 是经典的自注意力序列推荐模型,把用户交互序列编码后预测下一个物品;本文平台侧用它(64 维嵌入、两层注意力块)排序后再加 LLM 重排。
本文的平台排序正由 SASRec 加 Claude 重排构成,是智能体必须尊重的"强默认值";理解这些群体证据从哪来,才能明白中介任务为何困难。
HR@K 与 NDCG@K
HR@K(命中率)衡量目标物品是否进入 top-K 列表;NDCG@K 兼顾位置,折扣因子 $1/\log_2(k+1)$ 使排名越靠前得分越高。论文将单目标 NDCG@K 精确写成 $U_{NDCG}=\sum_{k=1}^K \alpha_k z_{g,k}$ 的 cutoff 级分解,其中 $\alpha_k=\ell_k-\ell_{k+1}$。
中介效用定义、训练奖励和优势分解全部建立在这两个指标上,是读懂 PAMO 数学框架的前提。
GRPO(组相对策略优化)
一种免价值网络的 RL 算法:对同一提示采样一组响应(本文 $G=8$),用组内成功率 $p_k$ 做基线,优势为 $z_{g,k}-p_k$ 的中心化形式,再配合 PPO 式 clip 目标更新策略。DeepSeek-R1 等模型广泛使用。
PAMO 的对照基线就是 GRPO;它的全部改动集中在"组内优势如何分配"这一层,不熟悉 GRPO 就看不出 PAMO 到底改了什么。
反事实掩码
因果推断思路:保持其余条件不变、仅从输入中移除某段信息(这里是跨平台历史),比较模型对同一输出的似然变化,以归因该信息的贡献;似然比越大说明输出越依赖被移除的信息。
PAMO 的"个人中介支持分" $c_g$ 完全由反事实掩码定义,这是全文最核心的创新机制。
SFT(监督微调)
用强模型或人工生成的"输入-输出"示范数据有监督地训练语言模型,使其掌握任务格式与基础行为,通常是 RL 训练前的初始化步骤。
所有 RL 方法都从同一份 SFT 检查点(2000 条 Claude Sonnet 4.6 示范)出发,这保证了 GRPO 与 PAMO 对比的公平性。
信息不对称
博弈论/经济学概念,指协作双方掌握的信息不同。本文中平台掌握群体协同信号却看不到跨平台历史,个人智能体恰好相反,双方各有所长且互不可替代。
这种双向信息不对称就是中介任务的定义:智能体既要敬畏自己看不到的群体证据,又要在私有证据足够具体时果断干预。
研究动机
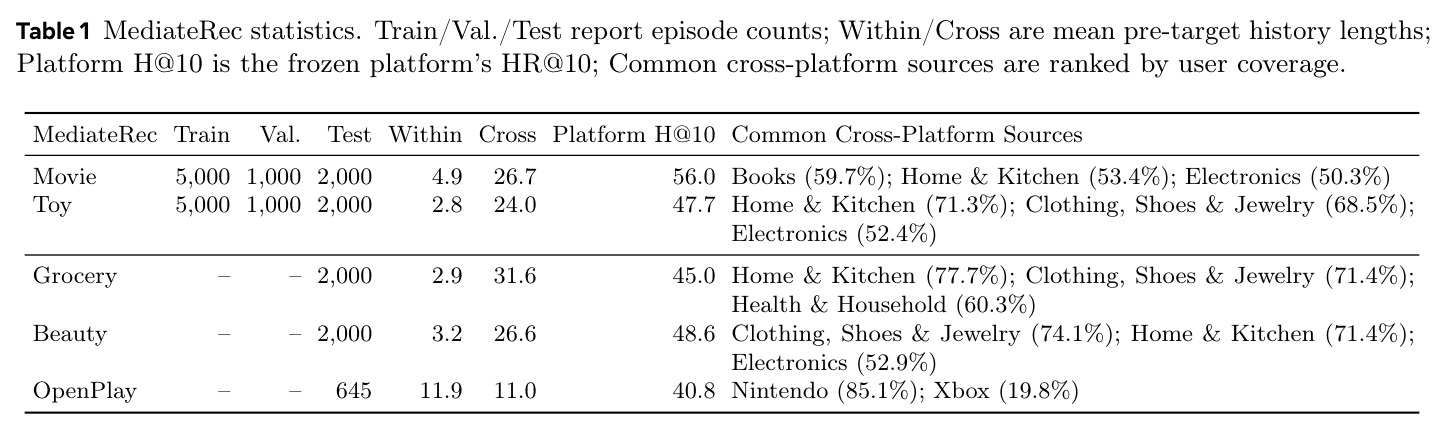
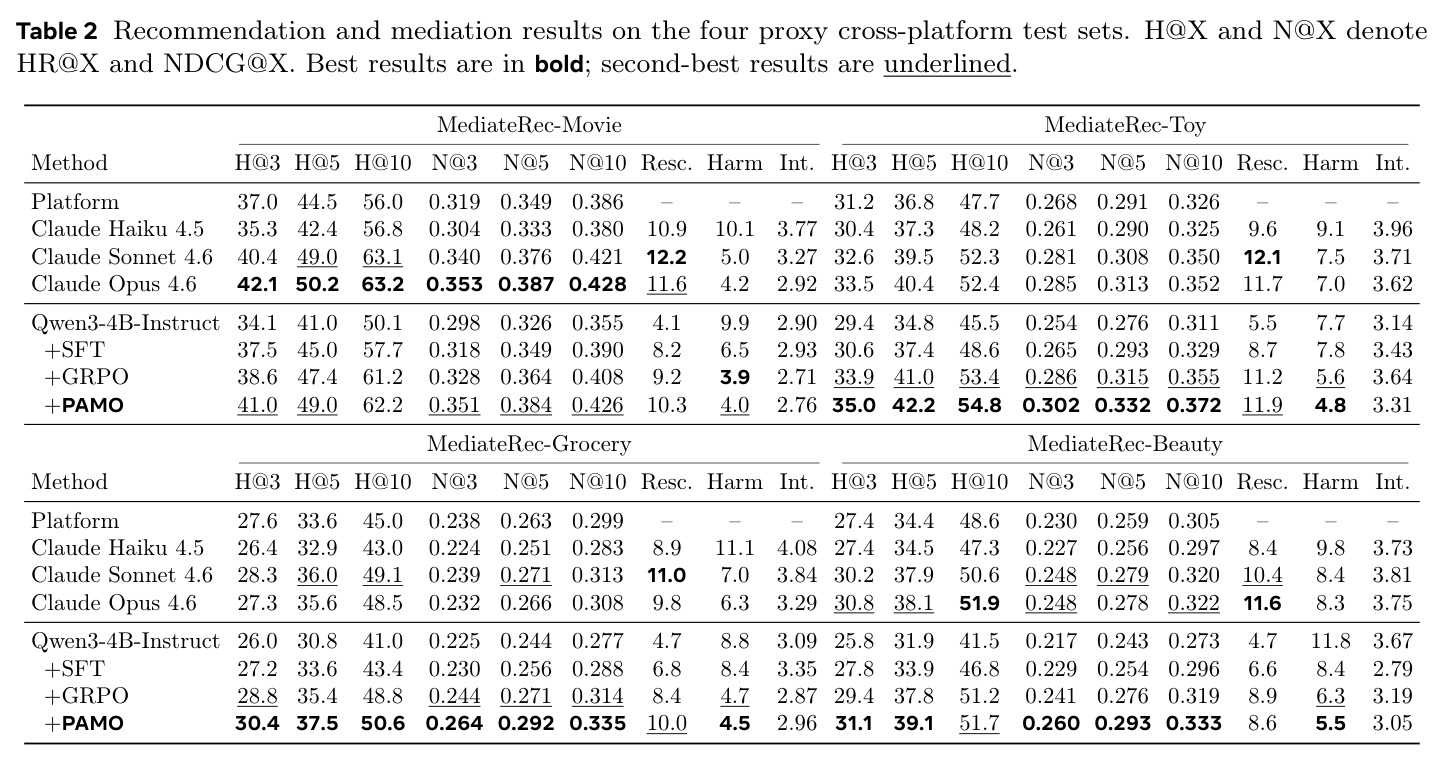
现代推荐系统完全以平台为中心:每个平台只基于本服务内观察到的交互建模用户,而用户兴趣天然分散在多个平台——引言的例子中,用户点赞过演出帖、分享过巡演链接、浏览过台灯,目标平台永远看不到这些行为。平台侧的 agentic recommender(工具增强、多智能体协调、记忆演化如 MemRec/MARS/SAGER,以及 RL 后训练)无论多强,能用的信息都不超出本平台;Meta Muse 这类用户授权的个人 LLM 智能体虽能跨服务维护历史并代表用户行动,但此前没有工作研究"个人智能体拿到一个现成的强平台排序后,何时该用跨平台历史修正它、何时应该保留"。难点在于平台排序编码了大量智能体观察不到的群体协同证据:贸然修改可能把平台排对的目标挤出 top-K,形成有害覆盖。实验也证实了这一点:仅把跨平台历史喂给 Qwen3-4B,Movie 上 HR@10 只有 50.1(平台为 56.0),有害覆盖率 9.9% 反超救援率 4.1%——有私有数据不等于会正确使用。
本文的目标是本文目标有三层。第一,形式化 Personal-Agent Mediated Recommendation 任务:平台用平台本地信息对候选集排序给出提议 $B=(C,\rho_P,M)$,个人智能体结合用户授权历史 $H=(H_{\text{within}},H_{\text{cross}})$ 生成最终 top-K 列表,并以平台相对中介价值 $\Delta(S;P,Y)=U(S,Y)-U(P,Y)$ 区分救援与有害覆盖。第二,构建 MediateRec 基准:用 Amazon Reviews 2023 的四个类目构造可扩展代理环境(Movie、Toy 各 5000 训练/2000 测试,Grocery、Beauty 各 2000 仅测试),用 OpenPlay(Steam/Nintendo/Xbox 通过同一人标识真实打通的 645 用户)做真实外部测试,严格控制"平台只见平台内信息、跨平台历史只属于智能体"的信息边界。第三,提出 PAMO 训练方法,让智能体学会选择性中介:保留强平台决策,只在跨平台证据足够具体时干预,并给出优势质量保持与一阶局部最优的理论证明。
与已有工作不同的是,独特切入在于把"冻结的强平台排序"当作必须尊重的默认值,研究个人智能体的选择性中介,而非从零排序或增强平台侧推荐器。训练层面的关键洞察是 outcome-only RL 存在盲区:一次成功的平台修正可能真正依赖跨平台历史,也可能只是通用重排碰巧成功,两者在最终指标上获得完全相同的奖励,模型无从学会"私有证据要够具体才干预"。PAMO 用反事实掩码补上这一环:保持响应不变、只从输入移除跨平台历史,用同一条 rationale 的似然比量化响应对该历史的真实依赖,再把结果优势按此支持分在平台分歧响应之间再分配,并用价值下界保证不牺牲平台相对 NDCG。与 iAgent(随机采 1 个目标+9 个负例构造列表)和并行的 ClawRec(直接合并多源列表)不同,这里平台排序是 SASRec+Claude 构造的强基线;评估上 MediateRec 也是首个要求同一 episode 具备"平台排序+智能体私有历史"成对信息视角的基准。
核心方法
直觉上,平台排序是很强的先验:它由 SASRec(编码全体用户协同模式)加 Claude Sonnet 4.6 重排(用平台内历史)构成,四个 Amazon 数据集平均 HR@10 达 49.3%(OpenPlay 40.8%);个人智能体看不到这些群体证据,但它独有的跨平台历史(Movie 场景平均 26.7 条,平台内仅 4.9 条)能揭示兴趣、家庭与生活方式。因此正确行为是:证据弱则保留平台排序,证据具体到点才把被低估的候选提上来。技术上分三步:(1)把任务形式化为 $(R,S)\sim\pi_\theta(\cdot\mid B,H)$,平台提议 $B=(C,\rho_P,M)$、历史 $H=(H_{\text{within}},H_{\text{cross}})$;返回平台 top-10 本身是合法输出,任务本质是选择性中介。(2)MediateRec 在受控信息边界下生成冻结平台排序与智能体独享的跨平台历史,覆盖已见/未见目标平台与真实外部测试。(3)PAMO 对每条采样响应做反事实掩码得支持分 $c_g$,把 NDCG@K 精确分解为各 cutoff 的组相对优势,在平台分歧集内做带价值下界的优势再分配,合并成响应级优势后代入 GRPO 目标更新。
核心创新是反事实"个人中介支持分"。GRPO 等结果驱动方法中,一个成功救援无论是否真正依赖跨平台历史,都拿到相同的组相对优势,训练信号无法区分"私有证据驱动的修正"与"通用重排的运气"。PAMO 保持响应与平台提议不变,仅把输入中的跨平台历史替换为空($H^-=(H_{\text{within}},\varnothing)$),teacher-forced 重算同一条可见 rationale 的似然,定义 $c_g=\frac{1}{|R_g|}\log\frac{\bar\pi_\theta(R_g\mid B,H)}{\bar\pi_\theta(R_g\mid B,H^-)}$。两个精巧细节:评分对象是 FINAL: 标记前的 rationale 而非最终 ID span——ID 在固定前缀条件下对历史已不敏感,而 rationale 直接承载历史条件下的推理;$c_g$ 长度归一化、stop-gradient,且 rollout 对数概率已缓存,只多一次 teacher-forced pass。第二个关键设计是价值下界:再分配须保持平均方向对齐 NDCG 幅度 $v_{g,k}=s_k(r_g-r_P)$ 不低于均匀分配的 $\bar v_k$,防止"依赖历史但救援力度弱"或"严重有害覆盖"的响应仅凭历史依赖性占便宜。由此训练目标第一次同时回答"改得对不对"和"是不是靠私有证据改的"。
方法步骤详情
第一步(平台构建):每个 episode 由目标 $Y$ 与 49 个按流行度采样的负例组成 50 候选集;目标平台 SASRec(64 维嵌入、两层注意力)先用平台内数据排序,再由 Claude Sonnet 4.6 在 temperature 0 下以平台内历史重排,得到冻结排序 $\rho_P$;跨平台历史从不暴露给平台侧。第二步(智能体接口):智能体收到按平台序排列的 50 张候选卡、至多 30 条平台内与 50 条跨平台记录,单次调用输出 rationale 和 FINAL: 后的 top-10;看不到平台分数、群体交互与模型内部状态。第三步(采样):每轮 64 个 prompt、每个采 $G=8$ 条响应。第四步(支持分):对每条响应增加一次 within-only 输入的 teacher-forced pass,算长度归一化的 $c_g$。第五步(cutoff 分解):令 $z_{g,k}=\mathbf{1}\{\text{rank}_{S_g}(Y)\le k\}$,$\ell_k=1/\log_2(k+1)$、$\alpha_k=\ell_k-\ell_{k+1}$,组内中心化 $A^{grp}_{g,k}=z_{g,k}-p_k$,每侧优势质量 $m_k=Gp_k(1-p_k)$;分歧集合 $D_k$ 之外的响应保持原优势。第六步(价值保持再分配):在 $D_k$ 上解带价值下界的凸优化,唯一最优解 $w^*_{g,k}=\frac{\exp(\eta c_g+\lambda_k v_{g,k})}{\sum_{j\in D_k}\exp(\eta c_j+\lambda_k v_{j,k})}$,$\lambda_k$ 一维搜索,$\eta$ 由 $\kappa$ 校准。第七步(合并更新):$A^{PAMO}_g=\sum_k\alpha_k A^{PAMO}_{g,k}$ 代入 clip GRPO 目标;不增加 rollout、无推理开销。
技术新颖性
技术新颖性有四层。信号层面:首次把"响应是否依赖跨平台历史"变成独立于结果的可估计量,用一次反事实 teacher-forced pass 获得,不增加采样、无推理开销。优势构造层面:利用单目标 NDCG 的精确分解 $U_{NDCG}(S_g,Y)=\sum_{k=1}^K\alpha_k z_{g,k}$ 把信用分配做到 cutoff 粒度——目标从第 8 名提到第 3 名会自然作用于 3 到 7 全部受影响 cutoff;且 $\eta=0$ 时重组严格还原匹配 GRPO 的中心化 NDCG 优势,保证对基线的严格泛化。理论层面:命题 1 证明每个活跃 cutoff($0<p_k<1$)上正负优势总质量 $m_k$ 被保持,平均价值与平均支持分均不低于均匀分配;定理 1 证明在"保持质量且不降价值"的一阶再分配锥 $\mathcal{K}_k$ 内,PAMO 方向是中心化支持向量 $\tilde c$ 的欧氏投影,即支持增益的最速上升方向。问题定义层面:MediateRec 首次在推荐中实现受控的平台-智能体信息边界,要求同一 episode 具备成对信息视角。
实验结果
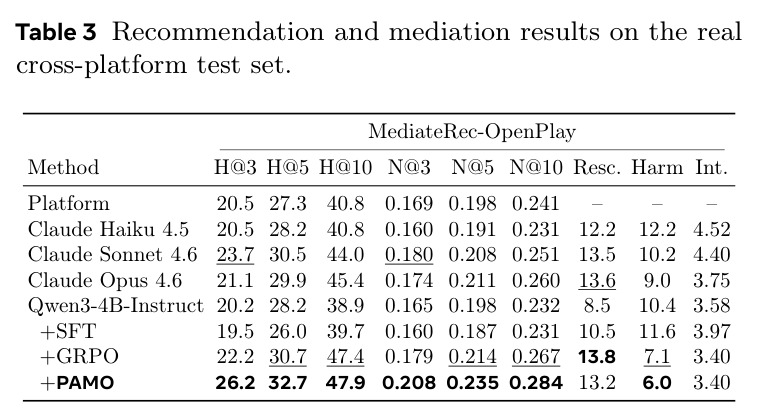
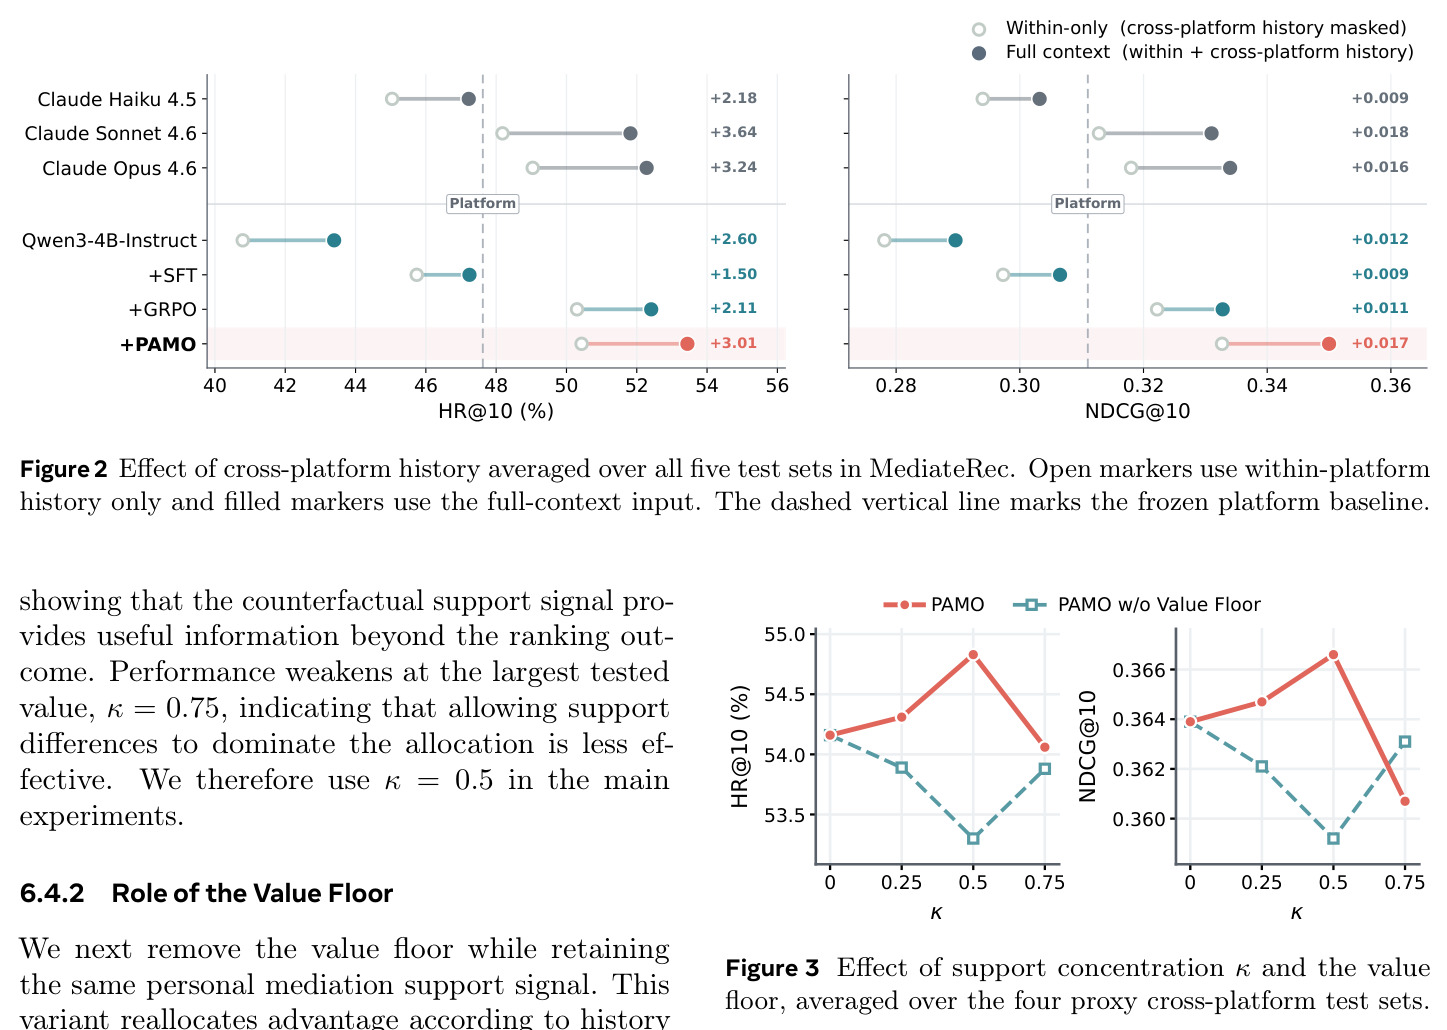
RQ1:base Qwen3-4B 在五个数据集全部低于平台(Movie HR@10 50.1 vs 56.0)且有害覆盖持续高于救援(9.9% vs 4.1%),说明仅有跨平台历史反而有害;Haiku 4.5 勉强持平平台,Sonnet 4.6 与 Opus 4.6 在全部数据集 HR@10 超过平台(Movie 63.1/63.2 vs 56.0),但仍留有不可忽略的有害覆盖。训练方法上 PAMO 在五个数据集的 HR@10 与 NDCG@10 全面超过 GRPO:Movie 62.2 vs 61.2、Toy 54.8 vs 53.4、Grocery 50.6 vs 48.8、Beauty 51.7 vs 51.2、OpenPlay 47.9 vs 47.4;增益不来自更激进干预(平均干预 2.76 vs 2.71),且四个数据集有害覆盖下降;OpenPlay 上 H@3 26.2 vs 22.2、NDCG@10 0.284 vs 0.267,4B 开源模型在多个未见平台与真实测试指标上超过专有模型。RQ2:掩蔽跨平台历史后所有模型都下降——Sonnet -3.64、Opus -3.24、PAMO -3.01、GRPO 仅 -2.11 HR@10,证明收益来自跨平台证据而非通用重排。RQ3:$\kappa$ 呈倒 U 型,0.5 最优;去价值下界变体低于 $\kappa=0$ 基线。RQ4:900 个救援中 72% 由跨平台上下文驱动(兴趣与粉丝圈 28%、家庭 19%、生活方式 14%),25% 偶然、仅 2% 归因平台内品味。
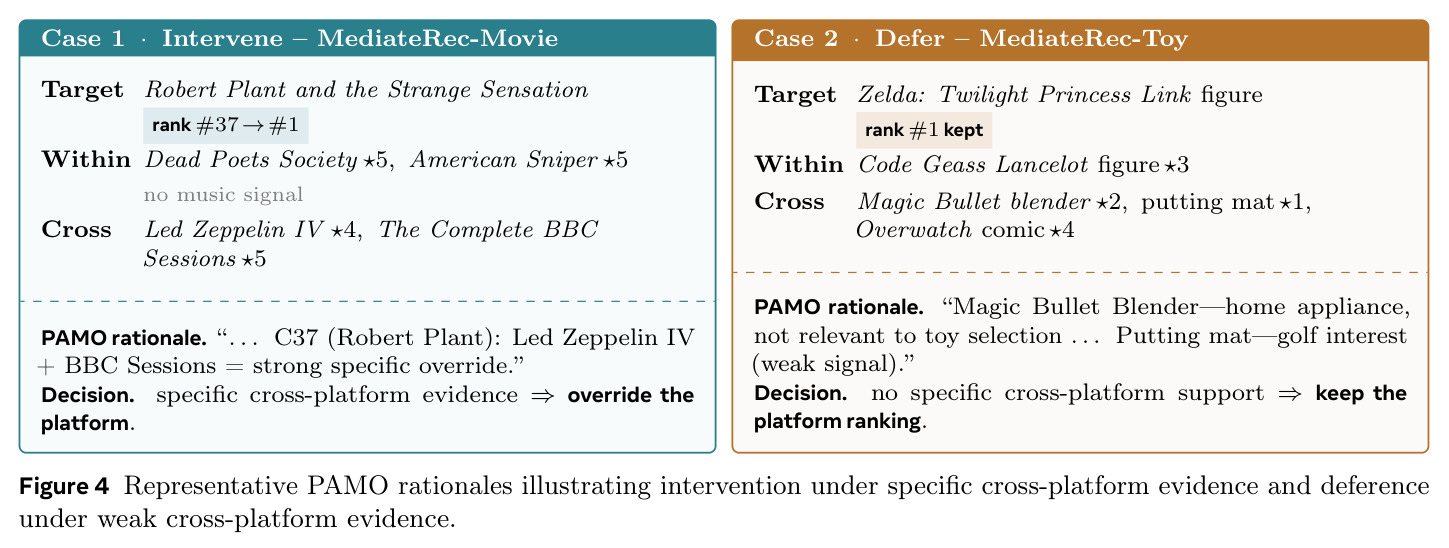
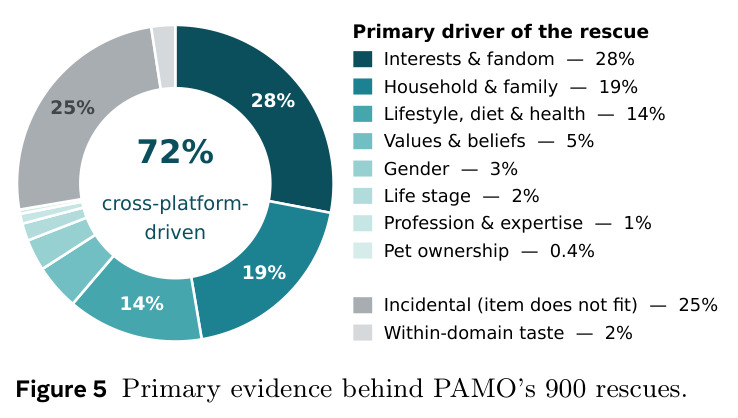
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MediateRec-Movie(已见目标平台) | HR@10 | 62.2(PAMO) | 冻结平台 56.0;GRPO 61.2 | 较平台 +6.2,较 GRPO +1.0 |
| MediateRec-Toy(已见目标平台) | HR@10 | 54.8(PAMO) | 冻结平台 47.7;GRPO 53.4 | 较平台 +7.1,较 GRPO +1.4 |
| MediateRec-Grocery(未见平台迁移) | HR@10 | 50.6(PAMO) | 冻结平台 45.0;GRPO 48.8 | 较平台 +5.6,较 GRPO +1.8 |
| MediateRec-Beauty(未见平台迁移) | HR@10 | 51.7(PAMO) | 冻结平台 48.6;GRPO 51.2 | 较平台 +3.1,较 GRPO +0.5 |
| MediateRec-OpenPlay(真实跨平台外部测试) | HR@3 | 26.2(PAMO,全场最佳) | 冻结平台 20.5;GRPO 22.2;Opus 4.6 21.1 | 较平台 +5.7,较 GRPO +4.0 |
| MediateRec-OpenPlay(真实跨平台外部测试) | NDCG@10 | 0.284(PAMO,全场最佳) | 冻结平台 0.241;GRPO 0.267;Opus 4.6 0.260 | 较平台 +0.043,较 GRPO +0.017 |
| 五数据集宏平均(掩蔽跨平台历史的归因实验) | HR@10 下降幅度 | PAMO -3.01;Sonnet 4.6 -3.64 | GRPO -2.11;SFT -1.50 | PAMO 对跨平台历史依赖更强,证明增益来自私有证据而非通用重排 |
局限与改进
作者承认的局限:Amazon 类目并非真正独立服务,只是保留信息不对称的代理平台;评估是候选条件化排序而非端到端检索(目标必在 50 候选中);构造使用静态目录与全量流行度计数,未限制在目标时间戳之前可得,存在时间泄露;OpenPlay 仅 645 个 Steam 用户,Xbox 只有 genre 级证据且剔除了移动端;理论结果只刻画固定 rollout 组内的分配性质,不保证神经策略全局最优或留出集效用提升。我的补充观察:平台排序由 SASRec+Claude 模拟,真实工业推荐器的实时特征、探索机制、商业与多样性约束远比这复杂,"强默认值"假设在真实部署中未必成立;隐式反馈把用户最终交互当正样本,无法区分满意与否的交互;支持分 $c_g$ 是模型相对量,度量"用了多少历史"而非"历史是否可靠",若模型形成依赖历史的捷径(如机械引用跨平台记录),该分数反而会奖励捷径;RQ4 的 rationale 归因由 Sonnet 4.6 充当标注者,存在模型自评偏置;跨平台历史以明文进入 prompt,隐私与合规完全未讨论;$\kappa$ 的倒 U 型敏感性暗示方法对支持信号噪声的鲁棒性有限。
独立分析的弱点
弱点一:模拟平台边界——SASRec+Claude 构造的"平台"缺少真实推荐系统的在线特征与商业逻辑,学到的中介策略未必迁移;改进方向是与真实平台合作获取脱敏日志或做 A/B 实验。弱点二:50 候选、目标必在其中的设定回避了检索难题,流行度比例负采样直接影响任务难度;改进是在开放目录上做检索-中介一体化评估,报告不同负采样下的方差。弱点三:支持分是模型相对的(作者自己强调它度量历史依赖而非历史正确性),可能奖励对历史的表浅依赖(如机械引用跨平台记录的捷径);改进是引入独立的证据质量校验或双模型互评。弱点四:价值下界只约束集合均值,个别严重有害覆盖的响应仍可能获得较大正优势;可改为逐响应上限或 CVaR 型尾部约束。弱点五:隐私缺位——智能体读取全量明文跨平台历史并生成可见 rationale,未考虑差分隐私、联邦学习或最小化披露。弱点六:单轮单次调用、无用户反馈回路,错误中介无法在线纠正;可引入多轮交互与用户确认。弱点七:训练只在 Movie/Toy 两个同源(Amazon)代理平台进行,跨"生态"(如电商到内容平台)的泛化仍未检验。
未来方向
作者方向:MediateRec 基准与代码计划在内部审批后发布,以推动个人智能体中介研究。基于本文成果可延伸:(1)把中介从单次重排扩展为对话式持续个性化,智能体主动询问用户以消解证据模糊,并用用户反馈在线修正错误干预;(2)理论推进——把组内局部最优强化为策略层面的泛化保证,研究历史依赖性与分布漂移下稳健性的关系;(3)多智能体协商架构——平台侧 agent 与个人侧 agent 双向协商而非单向中介,平台在保护隐私前提下披露部分协同证据;(4)把反事实归因思想迁移到更广的个人智能体任务(跨应用日程、购物、通信代理),"何时该用私有上下文否决公共服务默认行为"是通用问题;(5)跨平台冷启动:Toy 场景平台内历史均值仅 2.8 条,说明纯靠跨平台历史冷启动推荐具有现实可行性,值得专门研究;(6)安全与对抗——研究恶意第三方能否通过伪造跨平台记录操纵个人智能体的中介决策,并设计防御;(7)在更受限的信息边界(平台只返回 top-K 而不给完整候选集或分数)下研究中介的现实可行性。
复现评估
中等偏易。有利条件:骨干 Qwen3-4B-Instruct-2507 开源;Amazon Reviews 2023 公开,基准构造规则极详细(0-core、seed 7、固定划分、候选采样协议、prompt 模板全在附录);OpenPlay 公开;训练配方完整(SFT:2000 条 Sonnet 示范、3 epoch、lr $10^{-5}$、batch 64;RL:64 prompts $\times$ $G=8$、lr $10^{-6}$、clip 0.2、400 updates,VeRL+vLLM);PAMO 相对 GRPO 只多一次 teacher-forced pass,4B 模型 RL 训练单机多卡可行。不利条件:MediateRec 基准注明"will be released upon internal approval",发布时间不确定,是复现最大变数;平台排序构建依赖 Claude Sonnet 4.6 API,既有费用又随版本漂移,精确复刻平台基线困难;rationale 归因同样依赖 Claude 标注;专有基线数字无法严格复现。总体:若基准如期发布,用 4B 开源模型复现"PAMO 优于 GRPO"核心结论可行(数个 GPU 日量级),但平台侧数字只能近似重现。
论文图表
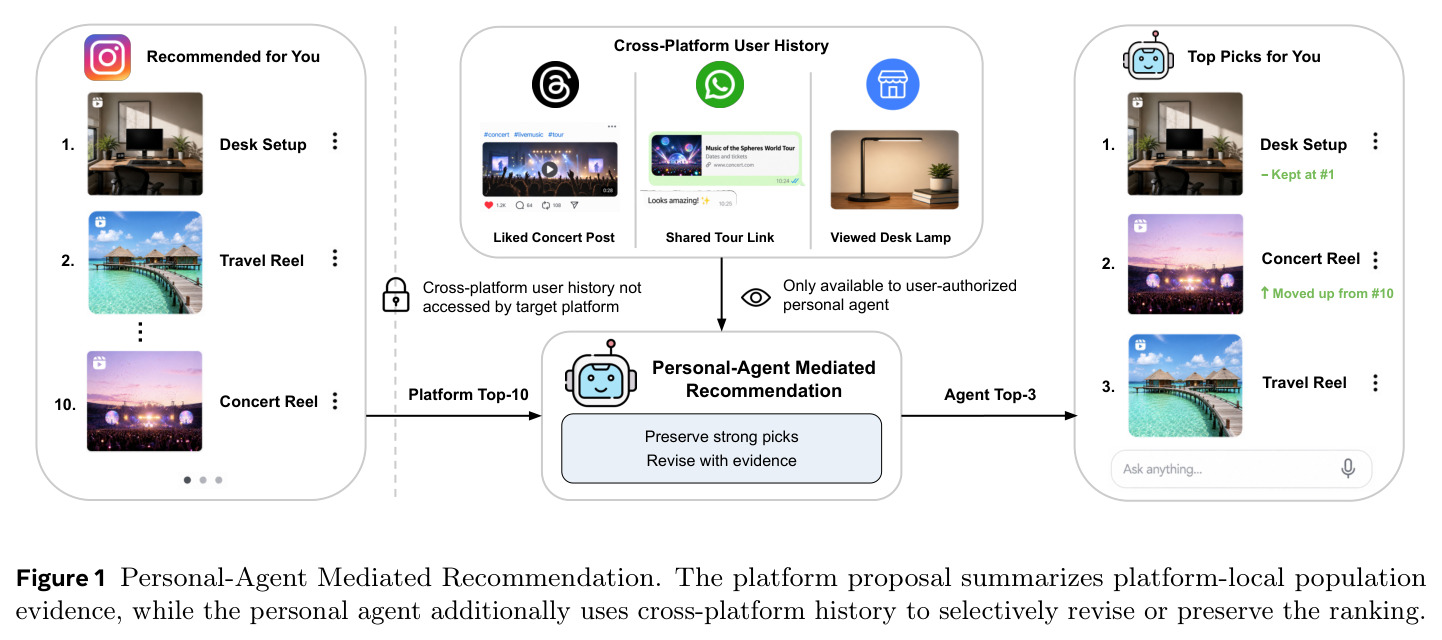
任务示意图:左侧平台"Recommended for You"把 Concert Reel 排在第 10 位;中间展示用户在其他平台的记录(点赞演出帖、分享巡演链接、浏览台灯)——这些跨平台历史只有用户授权的个人智能体可见;右侧智能体输出 Agent Top-3:保留平台第 1 的 Desk Setup(保留强选择)、把 Concert Reel 从 #10 提到 #2(用跨平台证据修正)。
一图涵盖任务全部要素:平台提议、平台-智能体信息边界、"保留"与"修正"两类动作。理解了这张图就理解了论文要解决的问题,是全文的开场图。
五数据集宏平均的哑铃图:空心点为仅平台内历史输入,实心点为全上下文输入。加入跨平台历史后所有模型 HR@10 都提升:Sonnet +3.64 最大、Opus +3.24、PAMO +3.01,而 GRPO 仅 +2.11、SFT 仅 +1.50;NDCG@10 同向(Sonnet +0.018、PAMO +0.017)。
直接回答"收益是否来自跨平台历史而非通用重排"的归因问题(RQ2),是排除替代解释的核心证据。