理性引导策略优化:以自适应提示支架学习推理 Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding
把标准答案当临时脚手架,自适应提示加奖励门控蒸馏,破解RLVR奖励稀疏
前置知识
RLVR(可验证奖励强化学习)
用可自动验证的奖励信号(如检查模型最终答案是否与标准答案一致)对语言模型做策略梯度训练的范式。相比人类偏好奖励模型,验证器噪声小、成本低,能激发长链条推理行为。DeepSeek-R1 等工作证明大规模 RLVR 可以在不完全依赖监督推理轨迹的情况下学出复杂推理能力,已成为前沿模型后训练的关键组件。
RGPO 的整个框架建立在标准 RLVR 训练循环之上,其要解决的核心问题正是 RLVR 中的奖励稀疏;读懂本文必须先知道 RLVR 的奖励如何产生、优化什么。
GRPO(组相对策略优化)
对同一提示采样一组 $G$ 个回答,用组内归一化计算优势 $\hat{A}_i=(r_i-\text{mean}(\{r_j\}))/\text{std}(\{r_j\})$,以此替代 PPO 的价值网络基线,再优化 PPO 式裁剪目标。REINFORCE++ 则改用全局 batch 归一化。当某提示的组内全部回答同错或同对时,奖励无方差,优势信号为零。
RGPO 以 GRPO 或 REINFORCE++ 为主 RL 目标;论文对奖励稀疏的分析(全失败事件下组中心归一化的 GRPO 优势为零)正是基于 GRPO 的机制。
奖励稀疏与全失败事件
当训练题难度超出模型当前推理能力时,一个提示的全部 $K$ 条采样轨迹都解错,验证器给出一致的零奖励,组内无方差、无可学习的梯度信号,训练恰好 stagnate 在最需要提升的难题上。对小模型尤其严重:大量算力花在采样失败轨迹上却拿不到任何正例。
这是论文的出发点。RGPO 的引导式第二轮采样正是为了在全失败事件下以概率 $(1-p)^K[1-(1-s)^{K_g}]$ 挖掘出可用的正例轨迹。
提示泄露与捷径学习
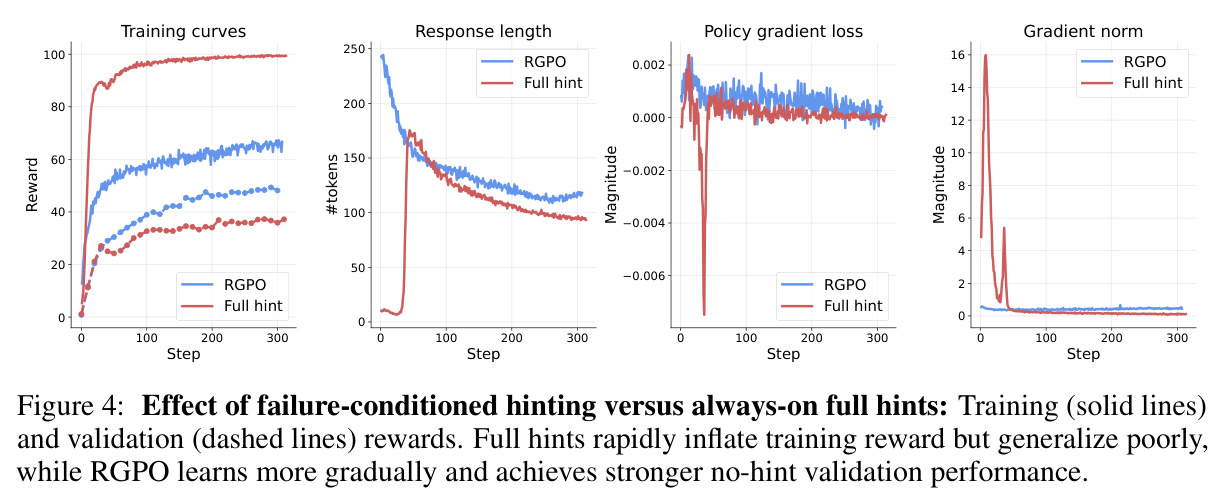
若训练时始终把完整参考答案放在上下文里,模型会学会直接从提示中抄答案:输出变得极短、训练奖励虚高,但推理能力并未提升;评测时去掉提示性能立刻崩塌(论文模拟中跌到 1% 的随机水平),且策略梯度损失与梯度范数出现剧烈尖峰,优化不稳定。
RGPO 的两大设计——奖励门控、以及把辅助 SFT 条件在原始提示而非提示增强提示上——正是为了规避这一陷阱;理解捷径风险才能理解方法各项设计的动机。
混合 SFT–RL 训练
将离线策略数据(专家轨迹、拒绝采样结果、更强模型生成的解)以监督似然损失的形式混入 RL 目标,代表工作有 LUFFY(对离线轨迹做策略塑形)、CHORD(动态加权 SFT 辅助项)等。核心难点是演示分布偏离当前策略,直接最大化其似然容易导致模仿式记忆、分布失配与泛化差。
RGPO 属于该家族但机制不同:它的辅助样本由当前策略在提示引导下在线生成、经验证器奖励门控筛选、并条件在原始提示上蒸馏,是与离线轨迹模仿的本质分界。
研究动机
纯在线策略 RLVR 的有效性受限于当前策略自身能力:当训练题难度超出模型推理能力时,一个提示的全部 $K$ 条采样轨迹可能全错,奖励全为零且组内无方差(GRPO 的组相对优势直接归零),优化在最需要突破的难题上完全停滞,对小模型尤其严重。论文的受控模拟量化了这一点:无引导的 GRPO 在简单题测试集上可达 99.1%,但在难题测试集上训练三个 epoch 后仍是 0.0%。现有补救办法是引入外部引导——离线策略演示、专家轨迹、或从更强模型拒绝采样——但它们通常要求辅助数据与 RL 任务的最终答案格式一致,且直接最大化参考解似然会强迫模型模仿远离自身分布的轨迹,造成分布失配、记忆化和泛化差:模拟中直接对含系统性错误的参考解做 SFT 只得到 12.8% 的难题测试准确率;小模型(2B)在 Mulberry 式复杂模板下甚至难以优化。
本文的目标是本文目标是让训练在不要求离线数据匹配 RL 任务格式的前提下,充分利用训练集里现成的标准答案推理链(rationale),系统性地缓解奖励稀疏。具体包括三点:把参考解当作临时的『脚手架』而非直接的模仿目标——引导只用于帮助模型自己探索出正确轨迹;只把奖励更高、由模型自己生成的解传回无引导的原始任务分布;引导强度随模型当前能力逐题自适应调节——能独立解出的题减少或撤掉提示,反复失败的题逐步揭示更多参考解段落。最终希望在纯文本与视觉语言两类模型的推理后训练中,同时取得更快的训练收敛、更高的最终准确率,并保证无提示评测时的性能与健康的探索熵。
与已有工作不同的是,本文的独特切入有两条线。其一是认知科学动机:『辅助困境』指出帮助太少学习者卡住、太多则诱发浅层加工损害迁移;先独立尝试再受指导的『有效挣扎』能激活先验知识、帮助内化后续讲解;逐步淡出的解题范例优于永久支持。RGPO 把这套原则工程化为训练算法:先无引导采样、失败才加提示、成功即撤提示。其二是机制上的本质区别:LUFFY/CHORD 直接对离线参考轨迹做塑形或加权 SFT,GHPO 按解题能力调整引导量但仍依赖参考解格式匹配,QuestA 给难题拼接部分解,BREAD 从专家前缀分支采样,HINT 提供启发式提示并强调训练亲和性。RGPO 则把引导仅当作提议分布:引导下的新回答必须通过奖励门控(超过同题所有无引导采样的最高奖励加边际 $\delta$)才进入辅助缓冲区,且监督损失条件在原始提示 $x_i$ 而非提示增强的 $\tilde{x}_i$ 上,从而把引导收益迁移回部署时的无提示分布。
核心方法
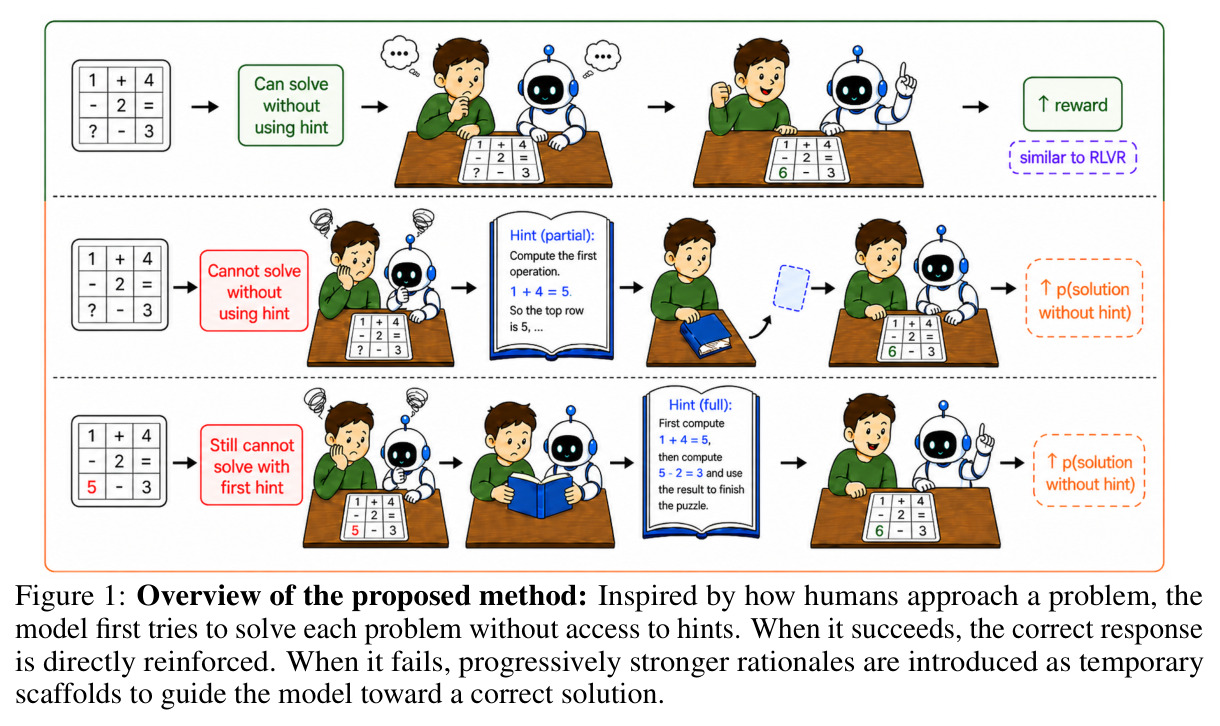
直觉上 RGPO 模仿人类做题:先不看书自己解;解出则直接强化该回答;解不出才翻开参考解的一小段当提示,引导自己再独立写一遍完整解答,且只有当带提示的重写确实更好时才把功劳记在自己名下。技术路线是在标准 RLVR 循环上加两件事。其一,每 epoch 双轮采样:第一轮从原始提示 $x_i$ 无引导采样 $K$ 条用于主 RL 目标(GRPO 或 REINFORCE++,$\beta=0$);若该题有非空提示,再在引导提示 $\tilde{x}_i^{(t)}$(参考解前缀加验证器反馈)上采 $K_g$ 条。其二,奖励门控的辅助 SFT:引导回答仅当 $\tilde{r}_{i,k}>\max_j r_{i,j}+\delta$ 时进入缓冲区,损失为条件在原始提示上的 $\mathcal{L}_{\text{SFT}}=-\mathbb{E}[\log\pi_\theta(\tilde{y}|x_i)]$,总目标 $\mathcal{L}_{\text{total}}=\mathcal{L}_{\text{RL}}+\lambda_t\mathcal{L}_{\text{SFT}}$。
核心创新可概括为『引导即脚手架、门控定真伪、原题收功劳』三件套。与已有方法的本质区别在于:辅助训练信号不是外部参考解本身,而是当前策略在提示下生成、且被验证器确认更优的自己的轨迹,天然对齐策略分布。奖励门控确保错误参考解不污染训练——模拟中参考解对 8 类困难决策中的 3 类系统性出错,去门控消融立刻退化到与直接 SFT 相同的 12.8%,而直接 SFT 参考解也只有 12.8%。条件在原始提示 $x_i$ 而非 $\tilde{x}_i$ 上做蒸馏是防『提示依赖』的关键:若在 $\tilde{x}_i$ 上训练,模型学会的是依赖提示而非独立推理。自适应提示按题维护已揭示段数 $g_i^{(t)}$,且有负漂移保证 $\mathbb{E}[g_{t+1}-g_t|\mathcal{H}_t]=2(1-p_t)^K-1$,当成功率超过 $p^\star=1-2^{-1/K}$ 后提示量自然衰减回零。
方法步骤详情
第一步,设定与分段:训练集 $\mathcal{D}=\{(x_i,s_i,a_i)\}$ 含提示、参考推理链、标准答案与可验证奖励 $r(x,y,a)$;参考解切成 $N$ 段,初始 $g_i^{(0)}=0$。第二步,无引导首轮:估计可解性 $C_i^{(0)}=\mathbb{I}[\max_k r_{i,k}^{(0)}\ge\tau_{\text{correct}}]$,全错则下 epoch 揭示 $1/N$ 段。第三步,提示升降级:无正确轨迹 $g^{(t+1)}=\min(g+1,N)$,有则 $g^{(t+1)}=\max(g-1,0)$,自动趋向『恰好可学』的最小提示量。第四步,双轮采样:无引导轮供主 RL 损失;引导轮在$\tilde{x}_i^{(t)}$ 上采 $K_g$ 条。第五步,奖励门控:仅保留 $\tilde{r}_{i,k}>\max_j r_{i,j}+\delta$ 的引导回答入池。第六步,联合优化:主 RL 用组相对优势裁剪目标,辅助项条件在 $x_i$ 上、权重 $\lambda_t$。理论上 Proposition 1 给出$\mathcal{P}_{\text{RGPO}}=1-(1-p)^K(1-s)^{K_g}$,只要 $s>p$ 即优于纯采样;Theorem 2 证明到达阈值 $\tau$ 的期望时间为 $O(\frac{1}{p_0}\log\frac{1}{p_0})$,优于纯 GRPO 的 $\Omega(\frac{1}{p_0})$。
技术新颖性
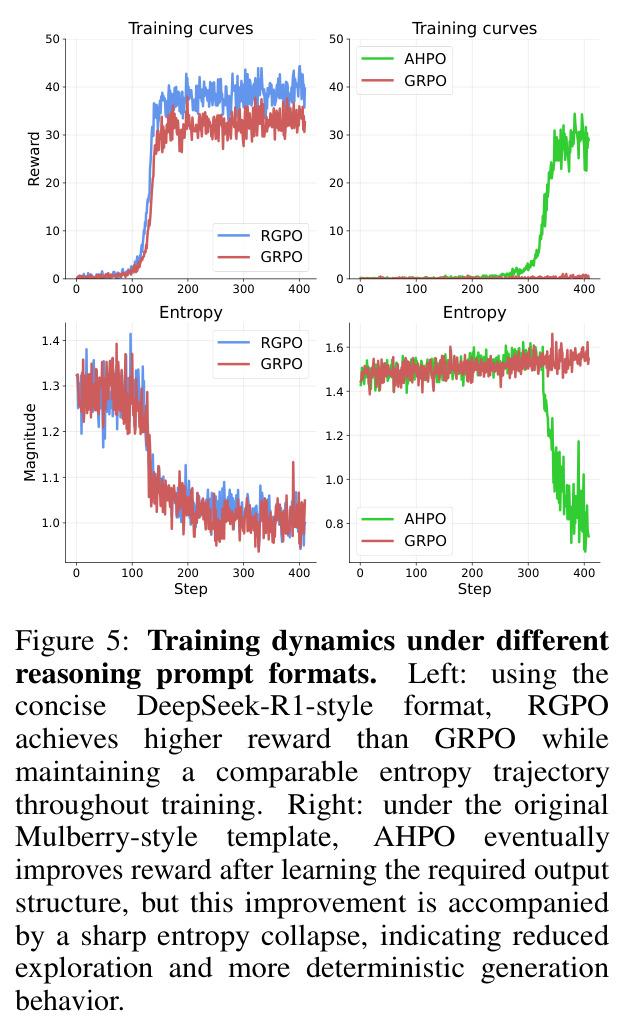
技术新颖性体现在四个层面。第一,数据机制:辅助样本不是现成的离线数据,而是『引导提议—奖励筛选』在线产生的自生成轨迹,天然对齐当前策略分布,既规避了离线专家轨迹的分布失配,也不要求辅助数据匹配 RL 答案格式,更无需从更强模型拒绝采样。第二,训练信号:辅助 SFT 条件在原始提示上,把引导收益迁移回部署分布——与 Hint-conditioned RL(始终在有提示的上下文里做 RL,评测去掉提示即崩到 1%)和 full hint(学会抄答案捷径、输出极短)形成鲜明对照。第三,调度机制:逐题成败驱动的提示升降级而非固定课程或全局调度,并有 Proposition 1 的发现概率刻画与 Theorem 2 的样本复杂度界支撑,提示量在 $p_t>p^\star=1-2^{-1/K}$ 后具有可证的负漂移。第四,稳健性:因为从不训练参考解文本本身,RGPO 对推理模板不敏感——DeepSeek-R1 简洁模板下奖励平台期高于 GRPO 且熵轨迹相当,而 Mulberry 复杂模板下混合离线 SFT 的 AHPO 出现尖锐的熵坍缩,RGPO 则不受影响,这解释了其格式的无关性优势。
实验结果
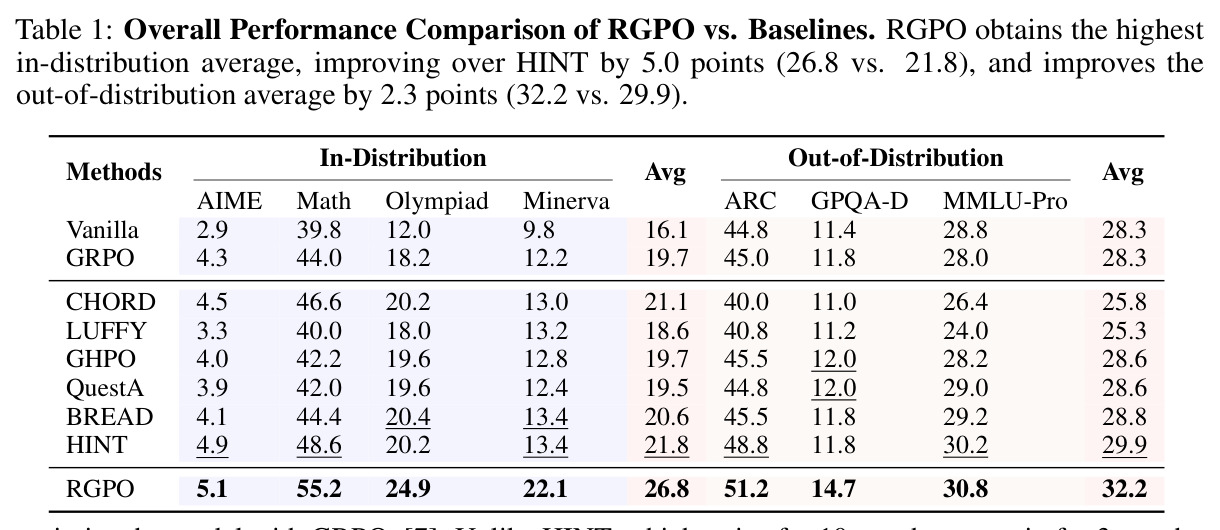
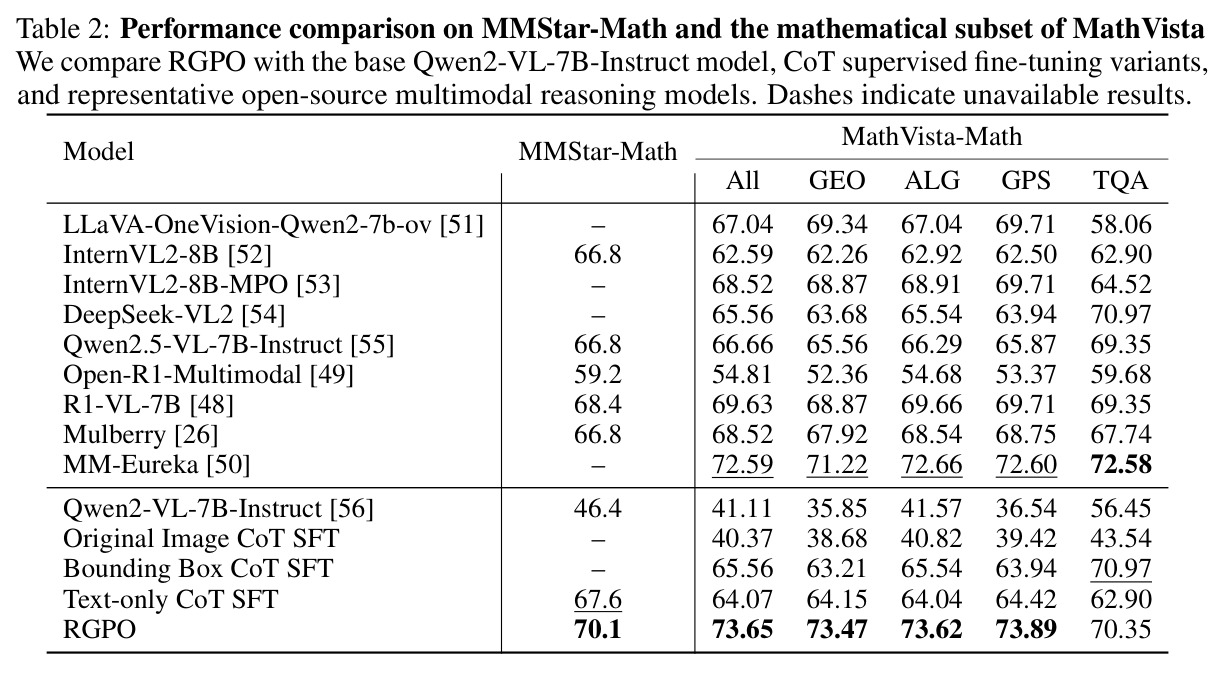
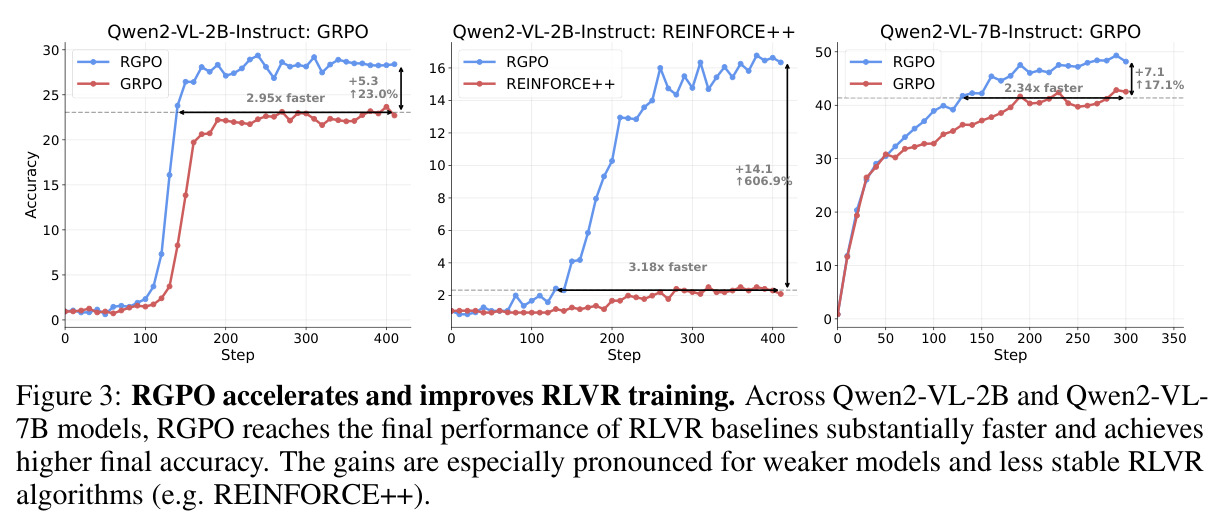
三组实验。受控模拟:无引导 GRPO 简单题 99.1%、难题 0.0%;RGPO 难题测试 99.5% 且不损简单题;直接 SFT 含系统性错误的参考解仅 12.8%,去门控消融同样退化;全提示设定评测去提示后跌至 1%;全程平均仅 7.4 条引导回答被接受即可自举学习。语言模型(Qwen2.5-3B,3 epoch 对比 HINT 的 10 epoch):分布内平均 26.8,超 GRPO(19.7)7.1 分、超 HINT(21.8)5.0 分;MATH-500 55.2(+6.6),Minerva 22.1(+8.7),OlympiadBench 24.9,AIME24 avg@32 5.1;分布外平均 32.2 对 29.9(+2.3),ARC 51.2、GPQA-D 14.7、MMLU-Pro 30.8 均最高。视觉语言模型(Qwen2-VL-2B/7B):2B 上比 GRPO 少 2.95 倍步数追平基线且终值更高,比 REINFORCE++ 快 3.18 倍、终值 +5.3;7B 快 2.34 倍、终值高 14.1 分。MMStar-Math 70.1(基座 46.4,+23.7);MathVista-Math 73.65(基座 41.11,超 MM-Eureka 的 72.59),GEO/ALG/GPS 三子集最佳,TQA 70.35 提升有限。Figure 4 显示全提示训练奖励虚高、输出极短、梯度尖峰频发,RGPO 平滑且无提示验证更强。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理·语言模型分布内平均(AIME24/MATH-500/OlympiadBench/Minerva) | 四基准平均分 | 26.8 | GRPO 19.7;最强基线 HINT 21.8 | +7.1 vs GRPO,+5.0 vs HINT |
| MATH-500(Qwen2.5-3B) | pass@1 | 55.2 | HINT 48.6 / GRPO 44.0 | +6.6 vs HINT |
| Minerva Math(Qwen2.5-3B) | pass@1 | 22.1 | HINT 13.4 / GRPO 12.2 | +8.7 vs HINT |
| 分布外推理平均(ARC-C/GPQA-Diamond/MMLU-Pro) | 三基准平均分 | 32.2 | HINT 29.9 / GRPO 28.3 | +2.3 vs HINT |
| MMStar-Math(Qwen2-VL-7B) | 准确率 | 70.1 | 基座 Qwen2-VL-7B 46.4 / R1-VL-7B 68.4 | +23.7 vs 基座 |
| MathVista-Math 全集(Qwen2-VL-7B) | 准确率 | 73.65 | 基座 41.11 / MM-Eureka 72.59 | +32.54 vs 基座,+1.06 vs MM-Eureka |
| 训练样本效率(Qwen2-VL-2B vs GRPO / REINFORCE++) | 追平基线终值所需训练步数 | 分别减少 2.95 倍 / 3.18 倍步数 | 标准 GRPO / REINFORCE++ | 同预算终值更高(REINFORCE++ 下 +5.3) |
局限与改进
作者承认的成本与前提:引导轮需要额外 $K_g$ 次采样,虽然样本效率更高,但单步计算开销接近翻倍;方法假设训练集配有标准答案推理链和可自动验证的奖励,对无参考解或奖励不可验证的任务不直接适用;验证主要集中于数学推理类基准,AIME24 上 5.1 对 HINT 4.9 的提升其实很小。我自己的补充观察:模拟中参考解的错误是系统性的且比例已知(8 类困难决策中 3 类出错),真实数据里参考解噪声的分布未知,门控在更隐蔽错误下能否完全过滤尚待检验;分段粒度 $N$、门控边际 $\delta$、辅助权重 $\lambda_t$ 三个超参没有系统消融;SFT 项对输出多样性的长期影响只通过熵曲线间接观察;2B 模型在 Mulberry 模板下的失败说明方法仍偏好简洁模板生态;多模态训练集与 MathVista 存在域重叠,TQA 子集仅 70.35 的有限提升也暗示了泛化边界。
独立分析的弱点
第一,每步近双倍的采样开销:无引导 $K$ 条加引导 $K_g$ 条,实现中每个提示都要跑两轮推理,即使多数题并不需要引导。改进方向:仅对上一 epoch 失败的题触发引导轮、引导轮早停或用投机解码降本。第二,依赖高质量参考解:若参考解整体错误率高,接受池虽受门控保护,但『提示无用』时仍白花 $K_g$ 次采样。改进:用引导成功率在线估计提示质量,动态关闭低质量提示或改用教师模型生成候选推理链。第三,超参鲁棒性未知:$N$、$\delta$、$\lambda_t$ 均无敏感性分析,跨域使用需重新调参。改进:报告敏感性曲线,或把 $\lambda_t$ 设计成随接受池大小自适应的函数。第四,辅助 SFT 可能压缩策略多样性:训练中熵接近 GRPO,但更长训练或更大 $\lambda$ 下未验证。改进:对引导前策略加 KL 约束或定期回放无引导数据。第五,评测集中于数学与二元验证奖励:agentic、代码、长程任务未测。改进:扩展到过程奖励或可执行测试用例等连续奖励场景。
未来方向
作者提出的方向是把 RGPO 作为降低奖励稀疏、稳定 RL 训练、提升文本与多模态推理后训练的通用方案继续推进。基于其成果可延伸的研究:(1)无标准答案场景——用教师模型生成候选推理链再由验证器筛选,或把模型自己历史上的正确解作为脚手架,摆脱对人工标注推理链的依赖;(2)把提示调度推广到过程奖励或部分得分场景,让 $g$ 的升降依据连续奖励而非二元成败;(3)与课程学习、数据难度估计结合,把有限的引导预算优先分配给高价值难题;(4)理论延伸:在非二元奖励、非平稳成功率 $p_t$ 与随机分段质量下收紧 Theorem 2 的界,并分析 $\lambda_t$ 的收敛作用;(5)迁移到 agentic RL,把工具调用轨迹当作推理链,用环境反馈作验证器;(6)研究提示调度状态 $g_i$ 跨模型规模或训练运行的迁移,减少冷启动开销;(7)多模态上探索图像区域提示(bounding box 提示已被证明优于纯文本 CoT SFT 的 65.56 对 40.37)与 RGPO 的结合。
复现评估
复现条件较好。代码开源:https://github.com/VietHoang1512/rgpo,基于社区广泛使用的 verl 框架实现,兼容 GRPO 与 REINFORCE++。数据公开:语言实验沿用 HINT 的 DAPO-Math-27K 划分(源自 DAPO-Math-170K),多模态沿用 MINT-CoT 协议;评测基准 AIME24、MATH-500、OlympiadBench、Minerva、ARC-C、GPQA-Diamond、MMLU-Pro、MathVista、MMStar 均公开。超参完整:AdamW 学习率 $10^{-6}$,batch 256(语言)/512(多模态),最大提示长度 1024/768,最大回答长度 4096/1024,每题 8 条采样(4 带 4 不带提示),训练 3 epoch,bfloat16 + FSDP2 + 梯度检查点、不开启 offload。未详述 GPU 数量与时长,但 3B/7B 规模用数张 A100 级显卡可复现;受控模拟为合成环境、计算量小。总体复现难度中等偏低,主要工作量在 verl 分布式环境搭建。
论文图表
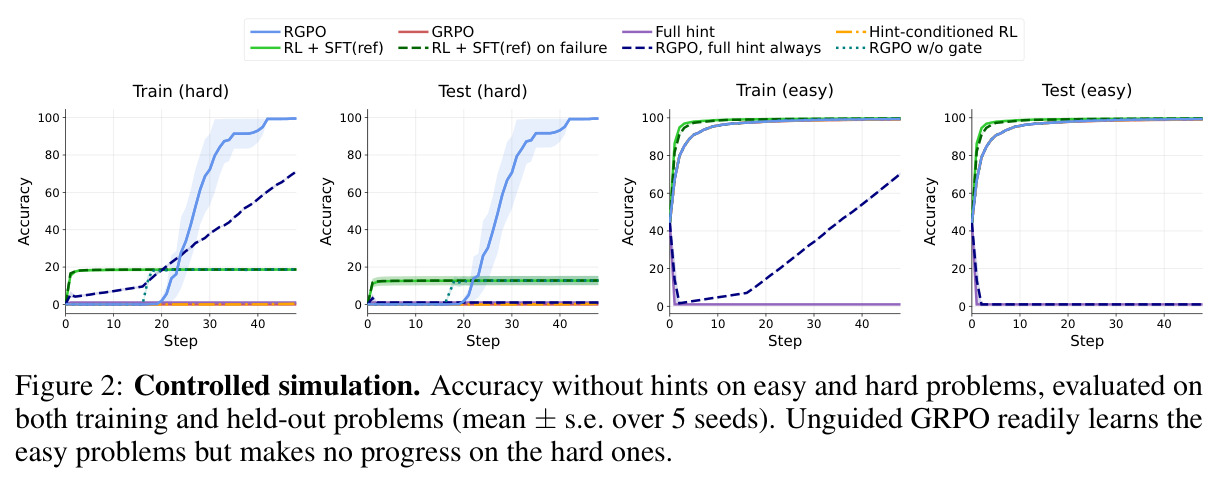
受控模拟中 RGPO、GRPO、RL+SFT(ref)、失败时 SFT、始终全提示、提示上下文 RL、去门控 RGPO 等设定在简单/难题的训练与留出测试上的无提示准确率曲线(5 个种子):GRPO 简单题测试 99.1% 但难题 0.0%;RGPO 难题 99.5%;直接 SFT 参考解 12.8%;全提示设定评测掉到 1% 随机水平。
在合成环境中干净地隔离了论文的两大动机——难题上的奖励稀疏、以及『更多引导未必更好』,同时展示了奖励门控消融,是理解方法必要性的关键证据。