分布鲁棒混合专家训练(DRMoET) Distributionally Robust Mixture-of-Experts Training
把每层专家当作内生鲁棒组做分布鲁棒优化,显著提升稀疏MoE的路由鲁棒性与精度
前置知识
混合专家模型(MoE)
把 Transformer 中的单个 FFN 替换为 $E$ 个并行专家子网络,由路由器为每个 token 打分并只选 top-k 个专家计算,输出按路由概率 $F_i(x)$ 加权合并。这样总参数量增大而每 token 计算量近似不变,是 Switch Transformer、GShard 等大规模模型缩放的核心技术。论文实验基于 FLAME-MoE 配方,290M-746M 模型用 32 专家 top-8(含 2 个共享专家),1.7B-10.3B 模型用 64 专家。
DRMoET 的全部机制都建立在'每层多专家+稀疏 top-k 路由'的结构上:专家即鲁棒组,路由概率 $p_{l,i}$ 与专家输出范数构成归因权重,不懂 MoE 前向计算就无法理解损失归因的设计。
负载均衡与无辅助损失均衡
MoE 训练中路由易塌缩到少数专家。标准做法是加辅助均衡损失 $\mathcal{L}_{aux}=n\sum_i f_i P_i$ 惩罚流量倾斜($f_i$ 为硬 token 频率,$P_i$ 为路由概率质量);Wang 等 2024 的 Loss-Free Balancing 则去掉辅助损失,改为每步按专家 token 数调整路由 logits 上的偏置 $b_i\leftarrow b_i+u\,\mathrm{sign}(\bar{n}-n_i)$。
论文把负载均衡路线定位为只优化'分配'而非'能力'的对照方法,表 1 中的 aux-free 基线(290M 规模 0.5084/0.5055,1.7B 规模 0.6431)正是 DRMoET 卖点的参照物。
分布鲁棒优化(DRO)与 Group DRO
DRO 在经验分布附近的不确定集上最小化最坏情况损失:$f$-散度球导出方差正则化目标,CVaR 对应 $\alpha$ 分位数特例。Group DRO(Sagawa 等 2019)把数据划分为预定义组(人群、主题等),维护组上的分布并把权重上移到高损失组,从而最小化最坏组风险;Oren 等 2019 将主题级 CVaR 用于语言建模。
DRMoET 本质是 Group DRO 在 MoE 上的推广,区别在于'组'由每层专家内生定义而无需外部标注;理解 DRO 的鞍点问题与对偶更新,才能看懂算法 1 和 Theorem 4.1 的收敛保证。
指数滑动平均(EMA)与熵镜像上升
EMA 用 $\hat{\ell}^{(t)}=\beta\hat{\ell}^{(t-1)}+(1-\beta)\ell^{(t)}$ 平滑批次间高方差的统计量,本文取 $\beta=0.999$。镜像上升是处理单纯形约束的梯度上升推广,熵正则版本的更新恰好是 $\mu=\mathrm{softmax}(\mu+\eta\hat{\ell})$——论文实现的对偶规则即为此形式,区别于对数空间乘性权重 $\mathrm{softmax}(\log\mu+\eta\hat{\ell})$。
算法 1 的第 5、6 步分别对应 EMA 与熵镜像上升,附录 A 与 Theorem 4.1 对该更新的收敛分析($O(T^{-1/2})$ 率)是全文理论部分的核心。
研究动机
稀疏混合专家(MoE)通过每个 token 只激活少数专家来扩展模型容量,但这埋下一个隐蔽的可靠性问题:路由从不完美,负载均衡压力或分布偏移会把 token 送到'合理但非最优'的专家那里。这些低排名、低频次的专家在标准训练下获得的任务对齐梯度更弱,训练明显不充分,于是偶发误路由会造成不成比例的损失。主流补救是 Switch Transformer 与 GShard 式的辅助负载均衡损失,或 Wang 等 2024 提出的无辅助损失均衡(给路由 logits 加偏置 $b$,过载则减、欠载则加),但它们优化的是'分配'而非'能力':流量均匀并不能保证次优专家被选中时足够胜任,而且均匀推路由还可能与真正有价值的专家分工相冲突。论文的核心诊断是:问题不在于利用率不均,而在于不完美路由下专家能力的不均。
本文的目标是本文的目标是把'路由鲁棒性'变成一个显式的训练目标,作为负载均衡的补充而非替代。具体而言,作者希望在不改变路由器结构、MoE 稀疏前向/反向计算和标准训练配方的前提下,通过重加权任务损失来压低分层最坏专家归因风险,使得路由器发生合理但次优的选择时损失退化尽可能小。作者为该目标设定了三个可证伪的预期:降低专家间质量离散度(最终最坏专家损失降 2.05%、损失标准差降 8.58%)、改善非最优专家被选中时的行为(强制误路由下超额损失降 4.3%)、保留而非抹平专家分工(专业化指标全面上升)。工程上还要求开销可忽略——最终实测吞吐反而提高 4.7%。
与已有工作不同的是,本文的独特切入角度是把 DRO 的'分组'概念内生化。传统 Group DRO(Sagawa 等 2019)依赖预先定义的人群或主题分组,Oren 等 2019 的主题级 CVaR 也需要外部话题标注;而 DRMoET 的鲁棒组由 MoE 计算本身产生——每一层的每个专家就是一个组,组损失通过路由概率与激活范数加权归因得到,无需任何外部标签。与负载均衡路线的本质区别在于:GShard 的 KL 辅助损失、Switch 的 top-1 简化、Expert-Choice 路由、Loss-Free Balancing 等方法控制'哪些专家收到 token',DRMoET 则保持路由不变,只改善'这些专家被选中时是否可靠',二者正交互补。由此作者把路由鲁棒性而非利用率平衡确立为稀疏 MoE 可靠缩放的实用目标。
核心方法
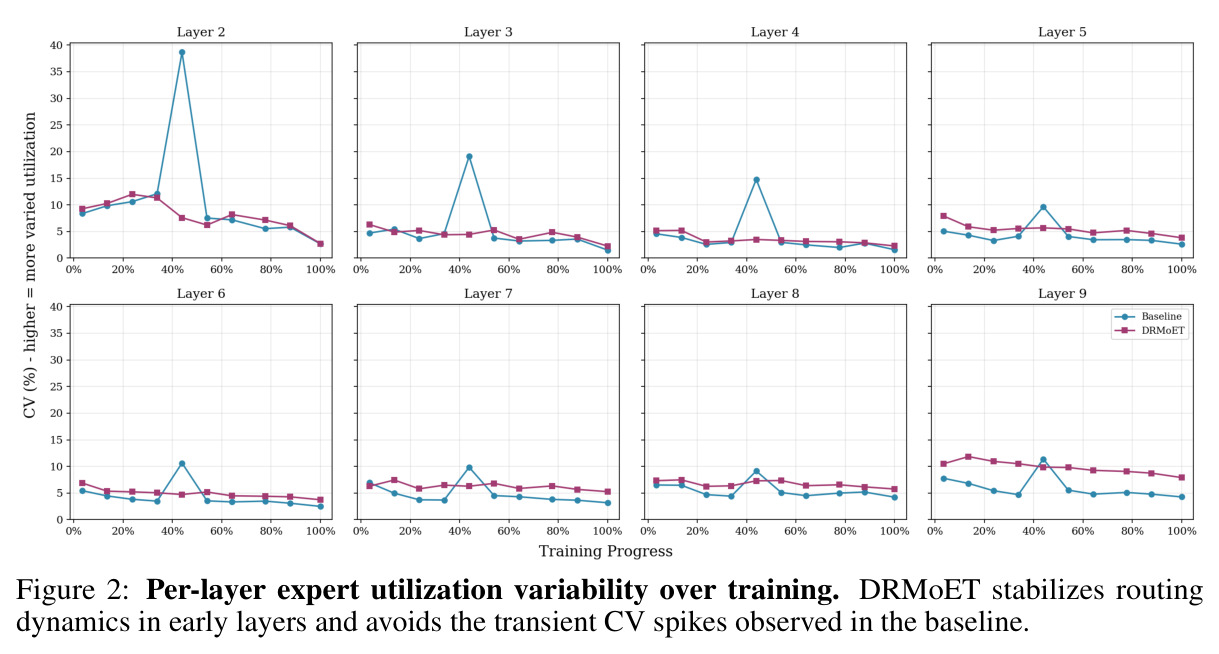
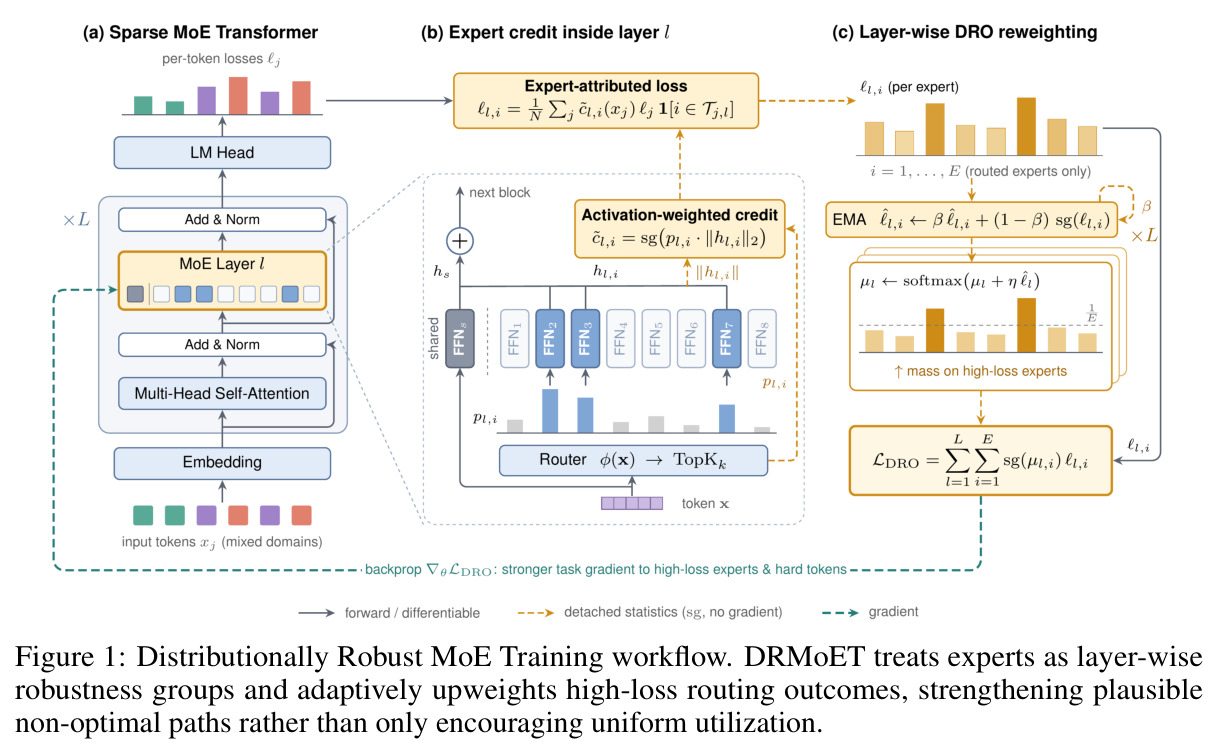
直觉上,如果路由器偶尔把 token 送给次优专家,就应让这些'合理但非最优'路径上的专家也被充分训练,使任何一次合理路由都不至于灾难性失败。技术路线是把每层专家的归因损失纳入分层 DRO 鞍点问题:$\min_\theta \max_{\mu\in(\Delta^E)^L} F(\theta,\mu)=\sum_{l,i}\mu_{l,i}R_{l,i}(\theta)$,其中 $R_{l,i}$ 是第 $l$ 层专家 $i$ 的归因总体风险,$\mu_{l,\cdot}$ 位于该层单纯形 $\Delta^E$。由于 $F$ 对每个 $\mu_{l,\cdot}$ 线性,内层最大化等价于逐层取 $\max_i R_{l,i}$。实现上无需真正解鞍点:维护每层归因损失的指数滑动平均 $\hat{\ell}$,用熵正则 softmax 规则更新对偶权重 $\mu$,再把 detach 后的 $\mu$ 作为权重对当前归因损失加权求和得到 $\mathcal{L}_{\mathrm{DRO}}$,与主任务损失共用一次反向传播,路由器与稀疏计算完全不动。实验在 10.3B 总参、67B tokens 下把七任务平均从 0.6625 提到 0.6767。
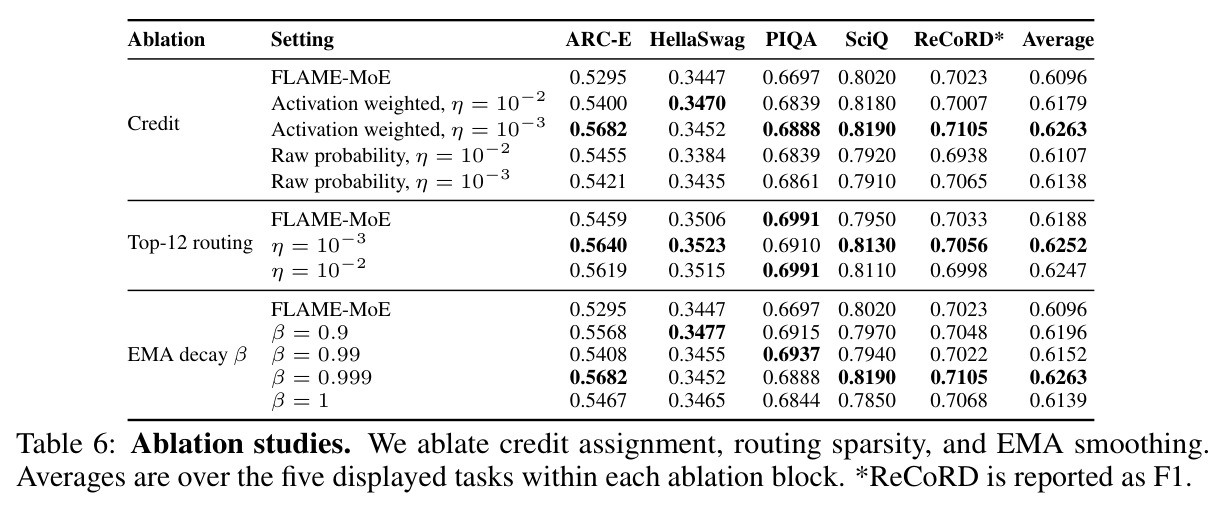
核心创新有三。第一,专家作为内生生成的鲁棒组:与 Group DRO 需要外部分组不同,DRMoET 把每层每个专家直接当作组,组间差异完全由当前路由器的实际行为诱导,优化目标自动跟踪路由动态。第二,激活加权损失归因:专家 $(l,i)$ 的信用为 $\tilde{c}_{l,i}(x)=\mathrm{sg}\!\left(p_{l,i}(x)\cdot\lVert h_{l,i}(x)\rVert_2\right)$,即路由概率乘以专家融合前输出的 $L_2$ 范数并停止梯度;由于 MoE 前向中路由概率本身就是激活的缩放因子,这比只用原始概率更忠实于计算图,消融显示七任务平均从 0.6138 提升到 0.6263。第三,归因系数与对偶权重全部 detach,使 $\mathcal{L}_{\mathrm{DRO}}$ 只是 token 损失的归一化重加权:不产生扭曲路由器或激活范数的额外梯度通路,不需要任何辅助损失,路由器的自然分工得以保留,代码改动极小。
方法步骤详情
按算法 1,每个 minibatch($N_t$ 个 token)依次:(1)前向算出各 token 损失 $\ell_j^{(b)}$,收集每层门控 logits $r_{l,i}$ 与专家融合前输出 $h_{l,i}$;(2)按 logits 取 top-k 得 $T_{j,l}$,选中集内 softmax 得 $p_{l,i}$;(3)算激活加权信用 $\tilde{c}_{l,i}=\mathrm{sg}(p_{l,i}\lVert h_{l,i}\rVert_2)$;(4)归因 $\ell_{l,i}^{(t)}=\frac{1}{N_t}\sum_{b,j}\tilde{c}_{l,i}\ell_j^{(b)}\mathbf{1}[i\in T_{j,l}^{(b)}]$,按 token 数归一化;(5)EMA 平滑 $\hat{\ell}_{l,i}^{(t)}=\beta\hat{\ell}_{l,i}^{(t-1)}+(1-\beta)\mathrm{sg}(\ell_{l,i}^{(t)})$,$\beta=0.999$;(6)对偶更新 $\mu_{l,\cdot}^{(t)}=\mathrm{softmax}(\mu_{l,\cdot}^{(t-1)}+\eta_t\hat{\ell}_{l,\cdot}^{(t)})$,$\eta_t=\eta_0/\sqrt{E}$;(7)以 $\mathcal{L}_{\mathrm{DRO}}=\sum_{l,i}\mathrm{sg}(\mu_{l,i}^{(t)})\ell_{l,i}^{(t)}$ 反向传播更新 $\theta$。全程只在 autograd 外维护 $O(LE)$ 个标量状态,无额外专家前向、单次反向。
技术新颖性
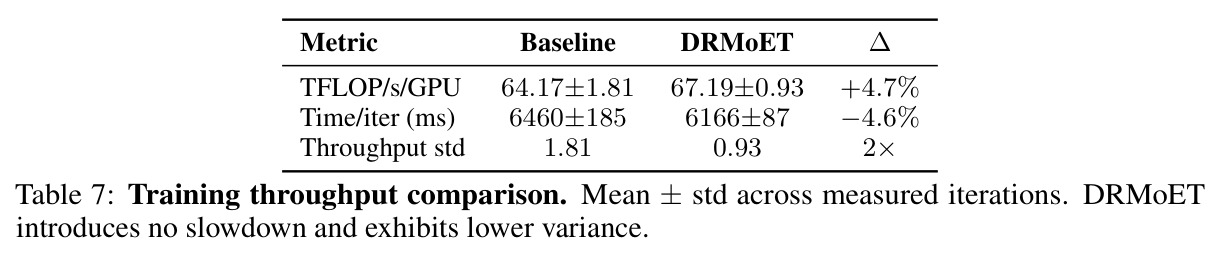
技术新颖性有四。其一,把 DRO 从'外部分组'范式推广到'架构内生分组',使鲁棒优化与 MoE 稀疏计算天然耦合。其二,概率空间的 softmax 对偶更新 $\mu=\mathrm{softmax}(\mu+\eta\hat{\ell})$ 并非对数空间乘性权重规则,附录 A 证明它是熵正则目标 $\Phi_\eta$ 上的熵镜像上升,Theorem 4.1 给出 $O(T^{-1/2})$ 的期望梯度范数收敛率,且对硬 max 目标 $\Phi(\theta)=\sum_l\max_i R_{l,i}$ 的近似偏差由 $\mathcal{L}\log E/\eta$ 控制。其三,开销分析严谨:额外算力 $O(LN_tkd+LE)$,相对专家 FFN 的 $O(LN_tkdd_{ff})$ 可忽略,状态仅 $O(LE)$ 个标量。其四,实测吞吐 67.19 对 64.17 TFLOP/s/GPU(+4.7%)、迭代时间降 4.6%,鲁棒机制在系统层面近乎免费。
实验结果
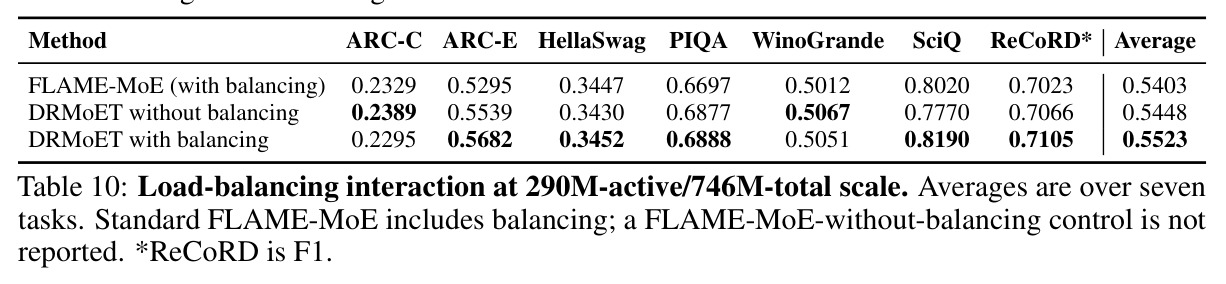
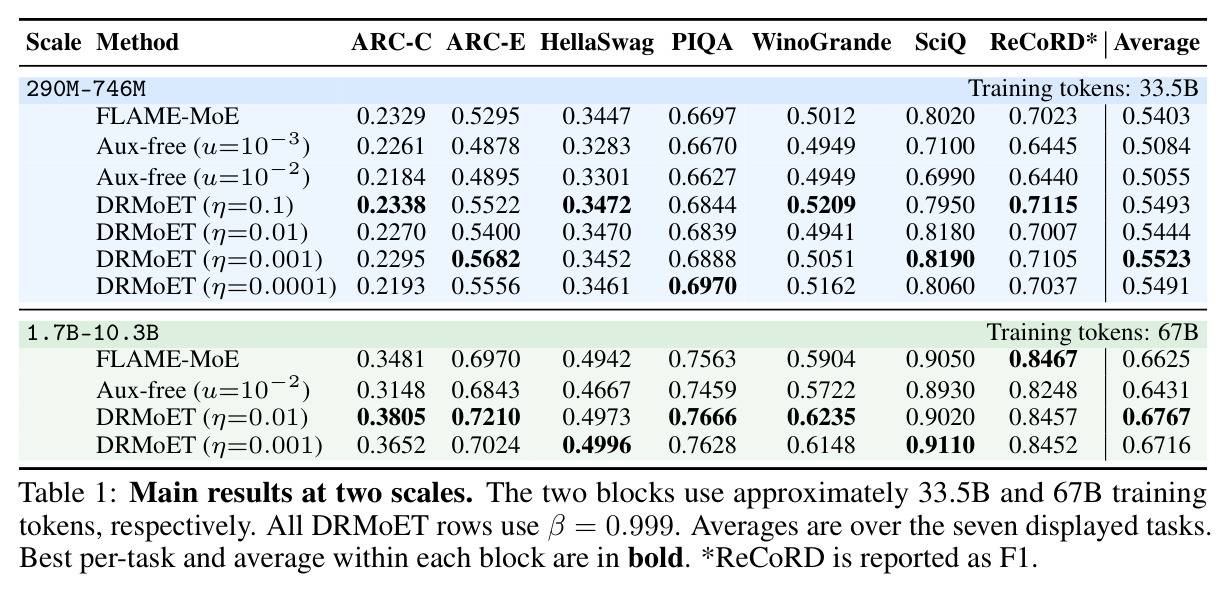
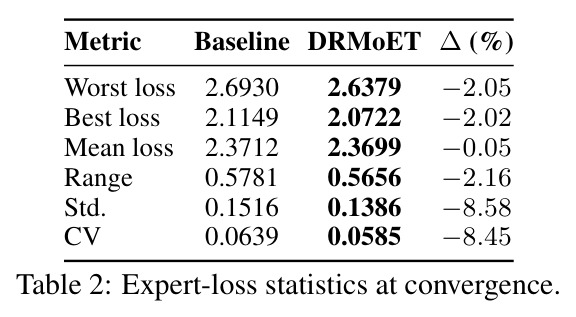
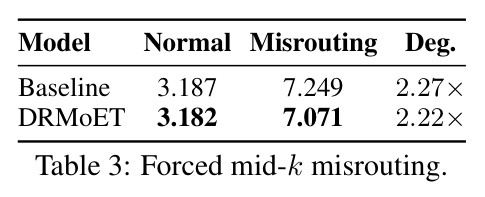
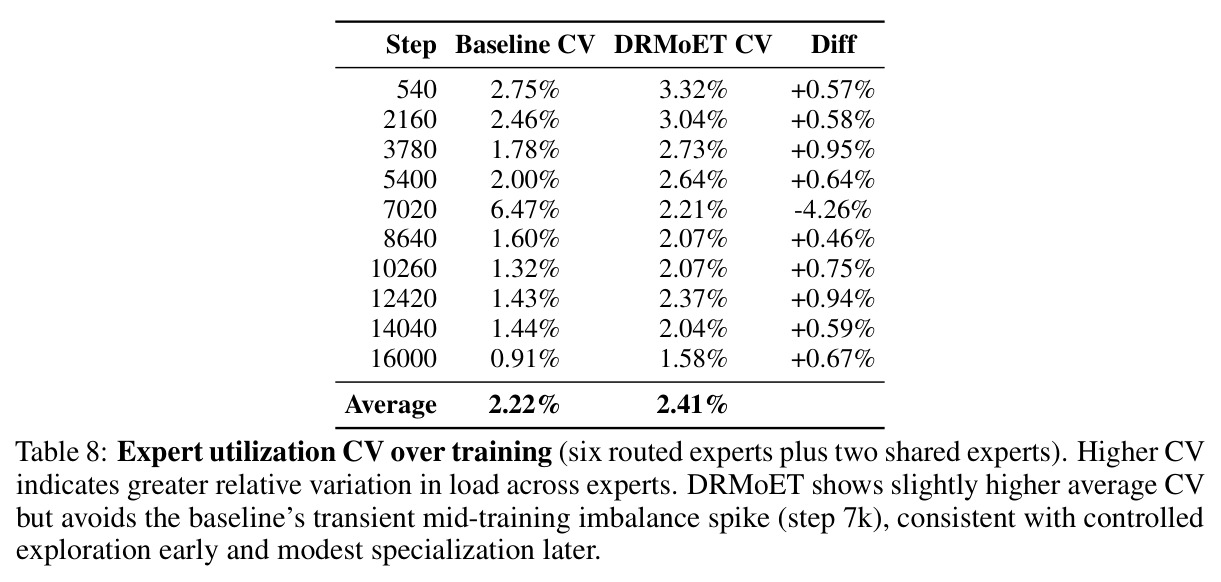
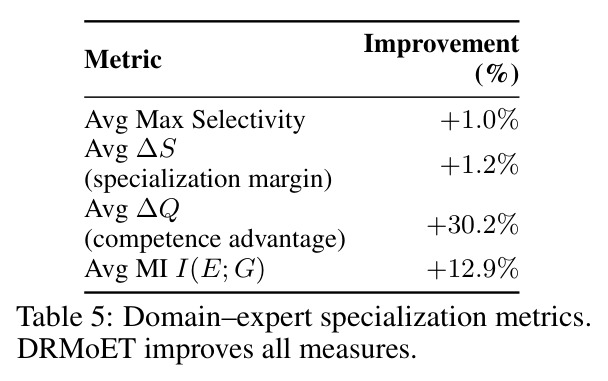
主实验遵循 FLAME-MoE 配方在两个规模从头预训练(表 1)。290M-746M(32 专家、33.5B tokens)上,FLAME-MoE 七任务平均 0.5403,DRMoET 所有 $\eta$ 均更优,最佳 $\eta=0.001$ 达 0.5523,aux-free 基线仅 0.5084/0.5055。1.7B-10.3B(64 专家、67B tokens)上,DRMoET $\eta=0.01$ 把平均从 0.6625 提至 0.6767(+1.42pp、相对 +2.14%,7 项中 5 项提升),$\eta=0.001$ 达 0.6716,aux-free 0.6431 反而比 FLAME-MoE 低 1.94 点。机制层面:最坏专家损失 2.6930→2.6379(-2.05%),平均损失几乎不变(-0.05%),标准差与 CV 分别降 8.58%/8.45%(表 2);强制 middle-k 误路由下退化倍数 2.27×→2.22×,超额损失少 4.3%(表 3);中位专家受益最大(+0.7%),OOD 损失极差降 7.0%(表 4);专业化指标全面提升(表 5)。消融(表 6)确认激活加权信用优于裸概率(0.6263 对 0.6138),top-12 下增益收窄仍为正,$\beta=0.999$ 最佳;表 7 显示吞吐 +4.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 七任务平均(290M-746M,33.5B tokens) | 0-shot 平均准确率 | 0.5523(DRMoET,η=0.001) | 0.5403(FLAME-MoE) | +1.2 个百分点(相对 +2.2%) |
| 七任务平均(1.7B-10.3B,67B tokens) | 0-shot 平均准确率 | 0.6767(DRMoET,η=0.01) | 0.6625(FLAME-MoE);0.6431(Aux-free u=10⁻²) | 对 FLAME-MoE +1.42pp(相对 +2.14%),对 Aux-free +3.36pp |
| 最坏专家损失(收敛时,52M tokens 验证集) | per-expert 最坏损失 | 2.6379 | 2.6930(FLAME-MoE) | -2.05%(均值几乎不变 -0.05%) |
| 专家质量离散度 | 损失标准差 / 变异系数 CV | 0.1386 / 0.0585 | 0.1516 / 0.0639 | -8.58% / -8.45% |
| 强制 middle-k 误路由探针(6 个领域) | 损失退化倍数 | 2.22×(误路由损失 7.071) | 2.27×(误路由损失 7.249) | 超额损失降低 4.3% |
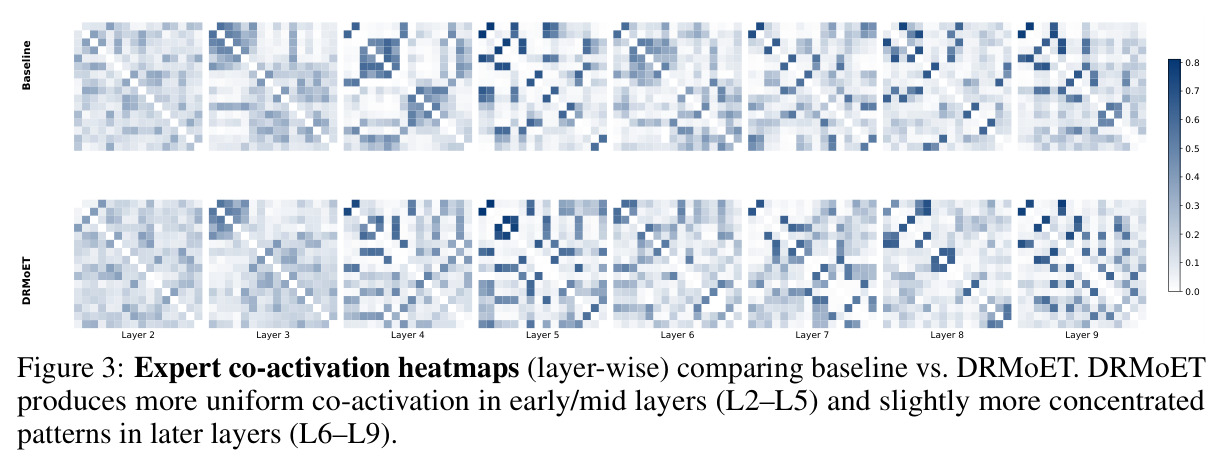
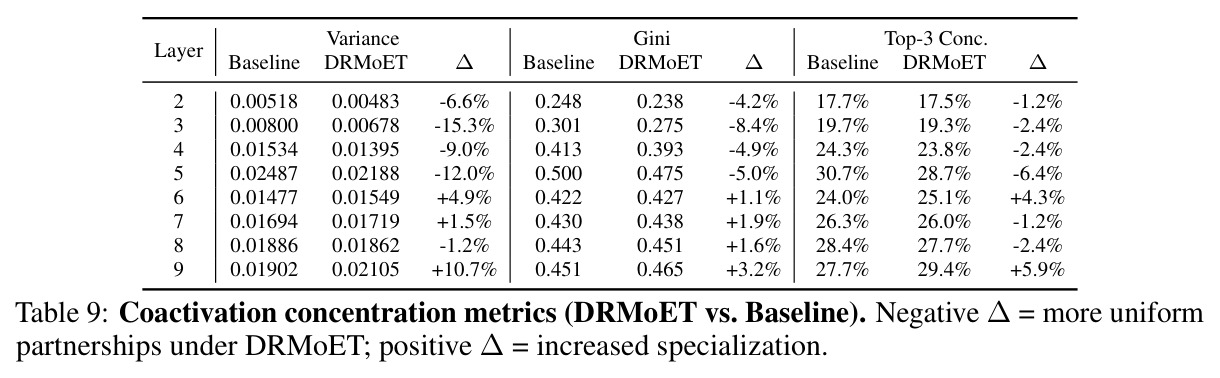
| 领域-专家功能专业化 | 竞争优势 ΔQ / 互信息 I(E;G) | +30.2% / +12.9% | FLAME-MoE | 选择性 +1.0%,ΔS +1.2%,四项指标全部为正 |
| 训练吞吐(同软件环境) | TFLOP/s/GPU 与迭代时间 | 67.19±0.93 TFLOP/s/GPU;6166±87 ms/iter | 64.17±1.81 TFLOP/s/GPU;6460±185 ms/iter | +4.7% 吞吐,-4.6% 迭代时间,方差减半 |
局限与改进
作者承认的局限:只在两个模型规模和固定专家配置(32/64 专家、top-8)上验证,未覆盖更广的模型家族、专家数量与路由深度;实验限于标准预训练与基准,未构造高度不平衡的预训练混合或长尾评测套件,而这恰是鲁棒方法理论上最应发挥的场景;强制误路由与专家分层/OOD 分析都是训练后 checkpoint 上的诊断性探针,没有贯穿训练全程追踪鲁棒性与专业化的涌现。我的补充观察:第一,最佳 $\eta$ 在两个规模间不同(0.001 对 0.01),依赖超参扫描;第二,OOD 均匀性改善偏弱(CV 仅 -1.3%、std -2.1%),鲁棒收益主要体现在分布内探针;第三,290M 规模存在单项任务 tradeoff(如 $\eta=0.01$ 时部分任务略降,FLAME-MoE 保有最高 ReCoRD 0.7023/0.8467);第四,理论保证针对熵正则近似目标 $\Phi_\eta$ 而非硬 max,近似偏差依赖 $\eta$ 与 $E$;第五,aux-free 基线在小 micro-batch(16)下表现异常差,对比公平性存疑,作者自己也承认这点。
独立分析的弱点
独立分析可见以下弱点。第一,激活加权信用 $\tilde{c}=p\lVert h\rVert_2$ 是启发式设计,作者未与梯度归因、反事实归因等更原则化的方案比较,也未论证范数加权为何是最优尺度;改进方向是系统比较多种归因函数并给出偏差-方差分析。第二,缺少真正的压力测试:没有长尾或不平衡数据实验,'鲁棒'主张目前主要靠 middle-k 一种误路由探针支撑;应构造人为倾斜的领域混合,展示 DRMoET 在显著分布偏移下的相对优势。第三,误路由探针只测了 middle-k 替换,未覆盖随机 k、bottom-k、专家剪枝后路由等更多失效模式,结论的外推性有限。第四,$\beta$ 与 $\eta$ 的扫描较粗(各 4 个值),且 $\beta=0.9$ 在 ARC-E/HellaSwag 上更强,暗示不同任务需要不同平滑时间尺度;可引入自适应 EMA 或逐层 $\eta$。第五,吞吐提升 4.7% 被作者归因于 straggler 方差降低,属观察性系统结果而非算法保证,需要受控复现来确认。
未来方向
作者提出的方向:把路由鲁棒性检验推广到更广的模型家族、专家数量与路由深度;显式构造高度不平衡的预训练混合与长尾评测,直接压测专家鲁棒性;在训练全程持续度量误路由退化与分层损失,刻画鲁棒性与专业化的动态涌现。基于本文成果可自然延伸:将 DRMoET 与 Loss-Free Balancing 组合(论文只验证了去掉均衡损失的 DRMoET 达 0.5448、仍高于 FLAME-MoE 的 0.5403,组合配方可能更优);把内生 DRO 组思想移植到多头 MoE(MH-MoE)、注意力层 MoE 与参数高效 MoE 等新兴稀疏结构;探索逐层自适应的 $\eta_t$ 与 $\beta$;在代码、数学、多模态等域差距更大的语料上验证;理论上补齐硬 max 目标($\eta\to\infty$)的收敛分析与归因偏差 $\varepsilon_{\mathrm{bias}}$ 的显式上界;还可以研究 DRMoET 对下游微调、量化与专家剪枝等部署环节鲁棒性的外溢收益。
复现评估
复现条件较好。代码与项目页开源(https://drmoet.github.io/),训练遵循公开的 FLAME-MoE 配方(Megatron-LM 实现),数据为公开的 DataComp-LM(DCLM),优化超参完整:Adam、峰值学习率 $3\times10^{-4}$、全局 batch 1024、序列长 2048、WSD 调度、均衡与 z-loss 系数 $10^{-3}$;方法超参 $\beta=0.999$、$\eta_t=\eta_0/\sqrt{E}$,290M 规模附完整 $\eta$ 扫描。算力是主要门槛:290M-746M 需 33.5B tokens(micro-batch 16),1.7B-10.3B 需 67B tokens(micro-batch 8),按约 65 TFLOP/s/GPU、6.5 秒/迭代估计,1.7B 规模需数十卡集群训练数周。方法本身极易移植:归因、EMA 与对偶更新全部 detach、单次反向、$O(LE)$ 状态,仅需极小代码改动。建议先在 290M 规模复现表 6 消融验证实现,再上大规模。
论文图表