AutoSciBench:面向科学智能体评测的自主基准生成框架 AutoSciBench: Autonomous Benchmark Generation for Evaluating Scientific Agents
用概念-配方双层规划与求解器反馈迭代,自动生成可持续进化的科学智能体评测基准
前置知识
LLM 智能体(Agent)
以大模型为核心的系统,通过「规划→工具执行→观察→分析」循环与外部环境(数据、代码、API)交互完成任务;所需信息往往不在输入或参数知识中,须主动通过工具调用获取。本文以 Claude Code CLI 与 Codex CLI 等编码智能体作为被评测的求解器。
本文的评测对象是科学智能体而非普通 LLM,因此自动生成的任务必须包含配套的数据文件与可交互环境。理解智能体的交互式解题方式,是理解任务为什么要绑定数据、为什么难度要用解题率衡量的前提。
基准饱和(Benchmark Saturation)
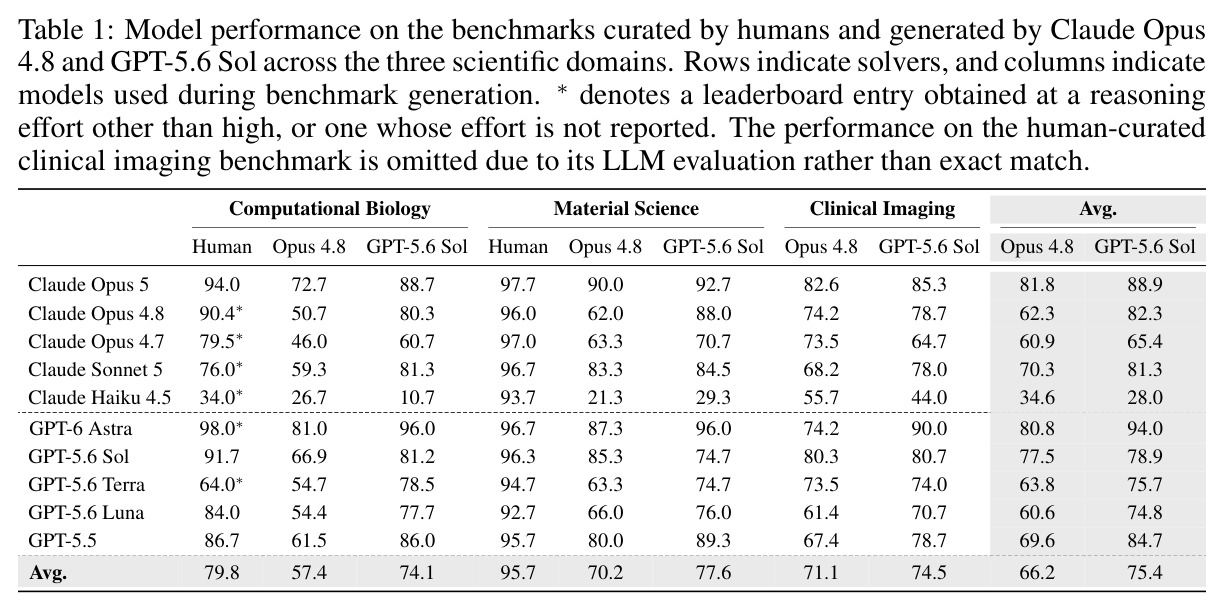
当模型能力超过基准难度后,几乎所有模型都接近满分,基准便失去区分模型强弱、暴露剩余失效模式的能力。本文实验中,材料科学人工基准 MatTools 上十个前沿求解器的平均准确率已达 95.7%,几乎贴着天花板,这正是饱和的典型表现。
基准饱和是全文的问题起点:人工构建基准的速度跟不上智能体进化。论文的整个框架设计(反馈精炼、经验引导、把新模型纳入生成环)都是为了对抗饱和、维持评测区分度。
精确匹配与可验证性(Exact Match & Verifiability)
精确匹配指把智能体的最终答案与标准答案做字符串级比对计分,要求任务设计保证在给定数据和问题下存在唯一、可复现检验的答案。可验证性则是「问题+数据是否支持唯一可判分答案」这一性质,是评审器判定任务是否可用的第一道门槛。
AutoSciBench 把「可验证且难」作为任务的保留标准,只有可验证的任务才能用解题率定义难度(K 次独立求解全部成功为 easy、部分成功为 moderate、全失败为 hard),这是整个难度量化体系的基础。
UMI(独特分子标识符)
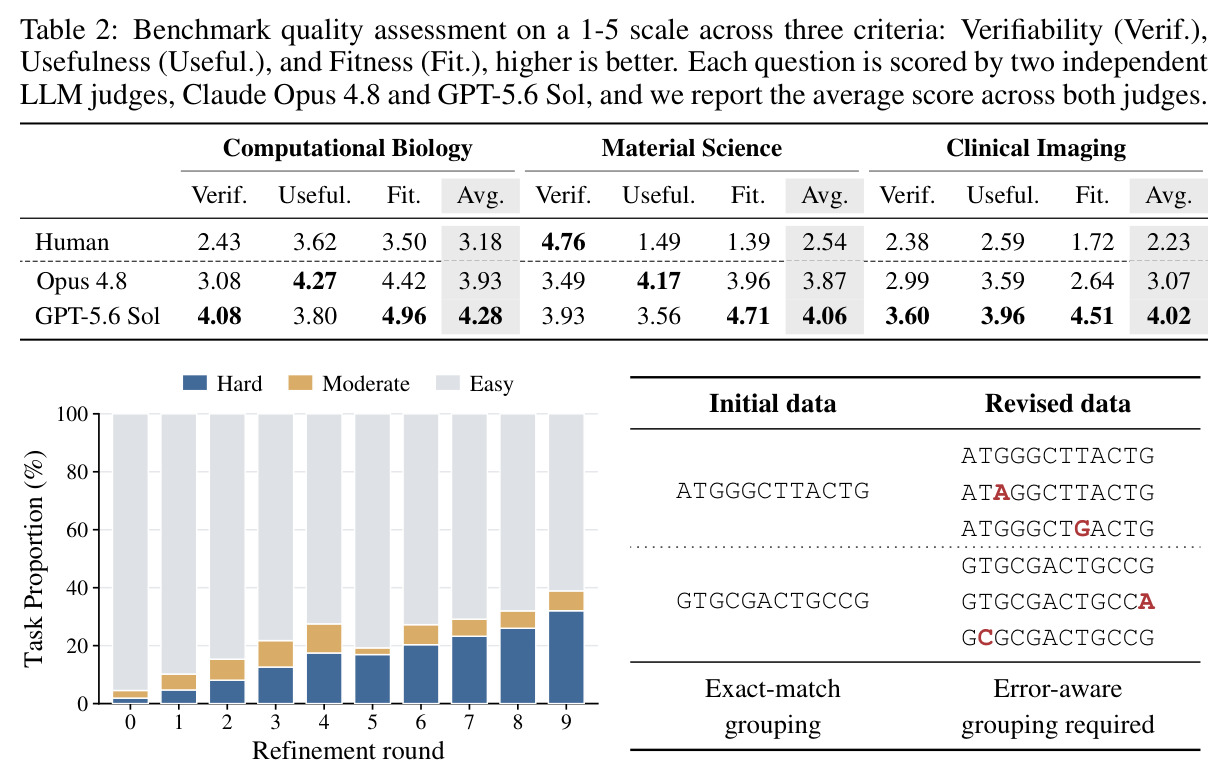
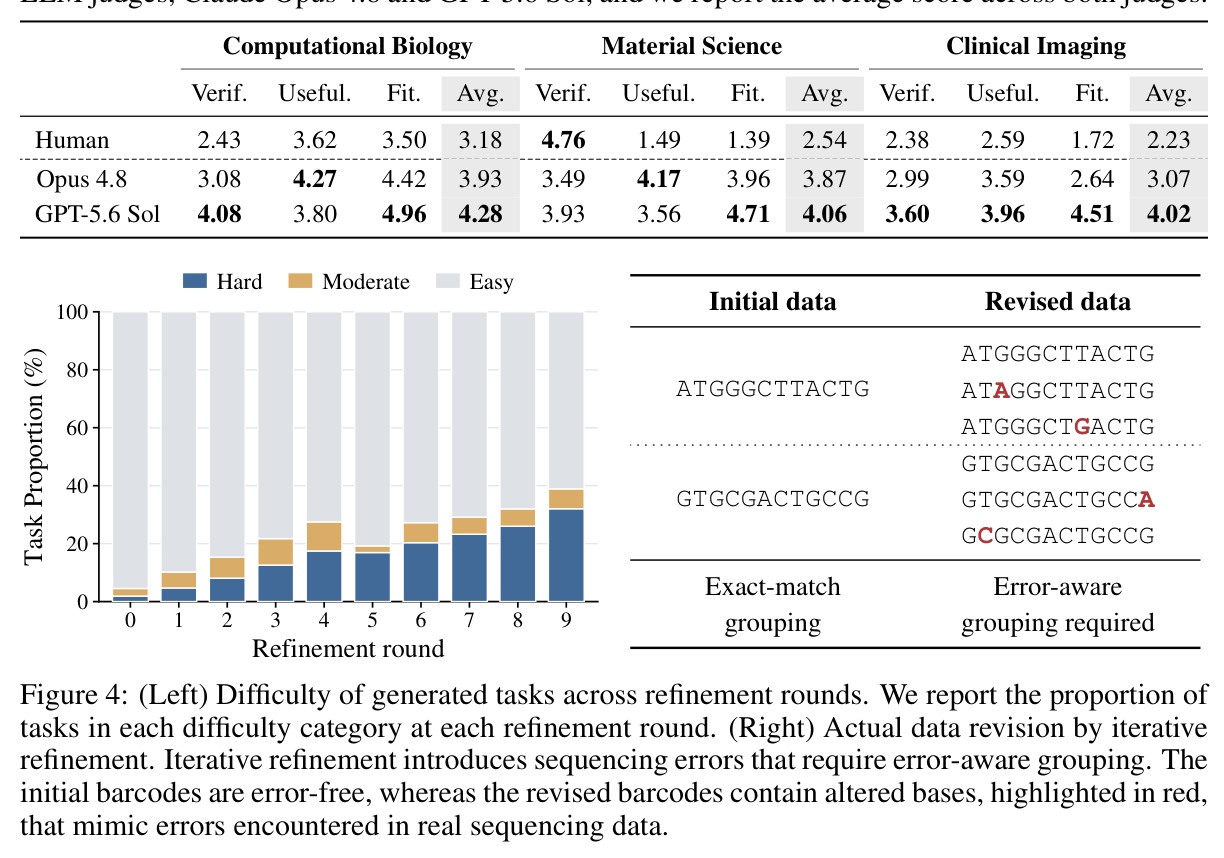
Unique Molecular Identifier,测序时加在每条原始 DNA/RNA 分子上的短随机条码序列,用来标记原始分子、消除 PCR 扩增重复。真实测序中 UMI 自身也会携带测序错误,必须结合读数支持度做错误校正,否则会把同一个 UMI 的错误变体误计成多个原始分子。
论文在 Figure 4 右侧用 UMI 计数任务作为案例,展示迭代精炼如何把「直接数中间结果」改造成「需要建立错误模型、重审原始数据」的难题——这是理解本文核心机制的最好具体例子。
研究动机
现有科学智能体基准完全依赖人工构建,需要大量时间、人力和领域专家知识;而智能体能力正在快速迭代(文中引用 Anthropic 和 OpenAI 在短时间内连续发布多代模型的节奏),固定基准迅速饱和失效。以本文实验为证:材料科学人工基准上,十个前沿求解器的平均准确率高达 95.7%,各家都挤在天花板附近,既分不出强弱也暴露不出残余失效模式;计算生物学人工基准的平均准确率也达到 79.8%。更麻烦的是,科学领域基准的构建成本远高于通用 LLM 问答——不仅要设计问题,还要准备配套的科学数据、执行环境和可验证的标准答案,往往依赖昂贵的专家标注。而近期的自动基准生成研究(AutoBencher、BenchMaker、BenchAgents、S-Eval 等)都只面向「给定上下文即可作答」的 LLM 问答评测,无法覆盖科学智能体所需的「通过与环境交互获取信息」和「从间接证据做科学推理」两类能力。评测建设跟不上智能体进化,在药物发现这类对分析可靠性要求极高的领域,这一鸿沟尤其危险。
本文的目标是本文要回答的核心问题是:科学智能体的评测基准能否被自动生成,并随智能体能力的演进而自动迭代升级?具体目标有三层。第一,构建一个能自动产出「问题 + 科学数据文件 + 经验证的标准答案」完整三元组的框架,并在计算生物学、材料科学、临床影像三个领域验证可行性。第二,生成的任务必须既可验证(存在唯一、可精确匹配的答案)又足够难(当前最强求解器也无法轻松做对),能够关闭「单次工具输出即得答案」的捷径,迫使智能体重新审视原始数据、解释中间结果、整合多源证据。第三,框架要能从既有基准和科学文献出发完成冷启动,并把每轮精炼过程的经验沉淀下来指导后续概念生成,最终形成一条可持续进化的评测流水线,让基准与被评测的智能体共同成长。
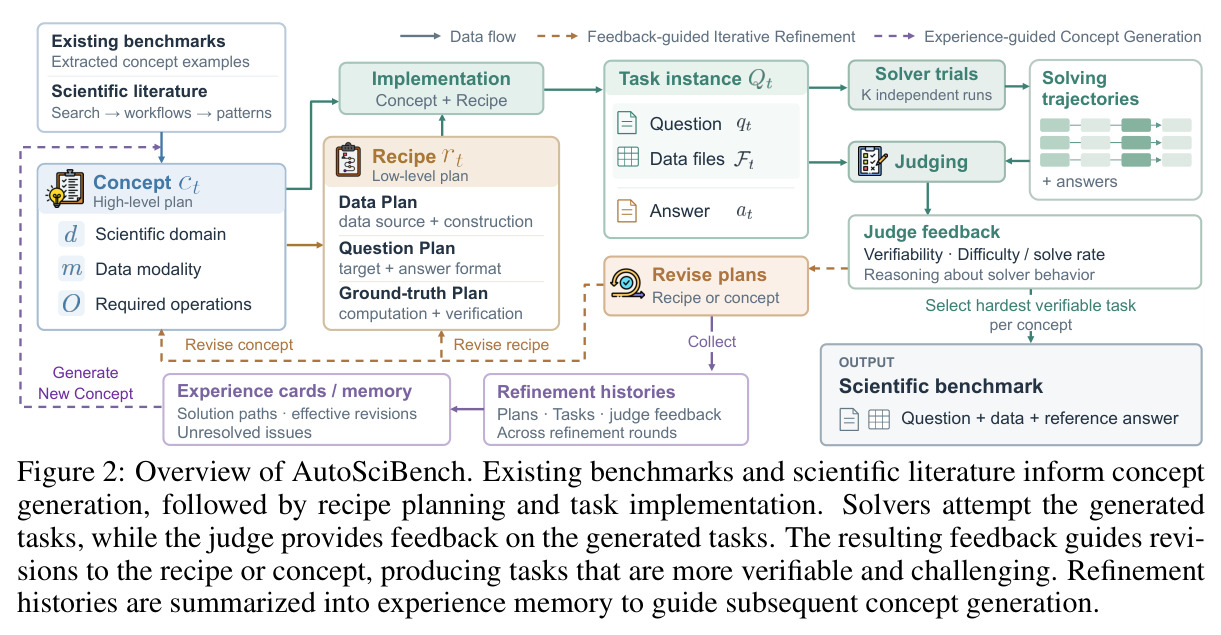
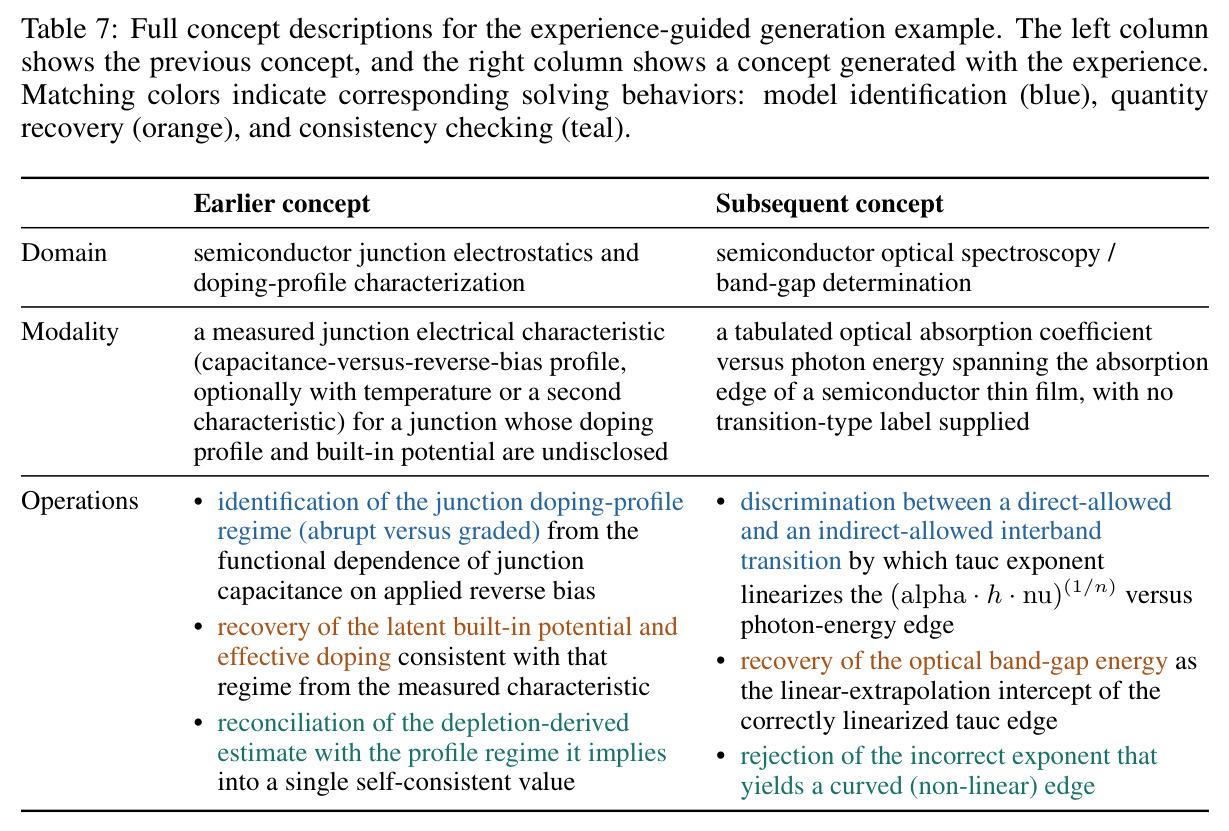
与已有工作不同的是,本文的独特切入点是把基准构建显式拆解为「概念(concept)」与「配方(recipe)」两级可修订的显式计划:概念 $c=(d,m,O)$ 用科学领域 $d$、数据模态 $m$、所需操作集合 $O$ 三个维度抽象描述「评什么」,配方则具体规定「怎么造」——数据从哪来、答案如何计算与隐藏、问题如何措辞。与既有方法直接生成或变换题目不同,本文把求解器行为本身当作反馈信号:让生成器自己的智能体去解题,评审器从解题轨迹中识别捷径与错误,进而修订配方或概念,把任务逐步推向间接证据推理。更进一步,跨任务的精炼历史被蒸馏成经验卡片存入记忆,使「识别-恢复-一致性检验」这类高层解题行为模式能跨领域迁移到新概念中。这种「求解器在环的双层计划进化 + 经验记忆」的组合,是与既有自动基准生成工作的本质区别。
核心方法
直觉上,AutoSciBench 把「出题」变成一个自我博弈式的闭环:先决定考什么(概念),再规划怎么出(配方),实际造出任务后让自己的智能体去解答,评审器根据解题轨迹判断任务是否可验证、是否够难,不够好就修改计划重新造,直到得到可验证且困难的任务,最后把整个过程的教训存入经验库供下次出题使用。技术路线为:概念是三元组 $c=(d,m,O)$(科学领域、数据模态、所需操作);配方包含数据策略、数据计划、构造机制、标准答案计划、答案格式、工具资源、问题隐藏策略七个字段;每轮实现任务 $Q_t=(q_t, F_t, a_t)$,即问题、数据文件集、标准答案;跑 $K=3$ 次独立求解,评审器按全部/部分/零次成功分为 easy/moderate/hard;若任务未同时满足「可验证且难」则迭代修订(连续 4 次配方修订失败后升级为概念修订),最多 10 轮;每个概念最终选出最难的可验证任务,5 轮经验引导的概念生成迭代 × 每轮 10 个概念 = 每领域 50 题。
核心创新是「可修订的双层显式计划 + 求解器行为反馈」。已有自动基准生成方法把任务当作直接操作对象,而本文引入概念与配方两个中间表示:概念声明评测目标(领域、模态、操作),配方规定实例化细节(哪些信息直接给出、哪些必须通过分析恢复)。这一抽象使「评什么」与「怎么造」解耦,同一分析能力可以实例化为不同问题与数据,修订也可以只发生在计划层。反馈信号来自生成器自身智能体的解题轨迹:评审器据此识别「一次工具输出就能得到答案」的捷径解法,配方修订据此在数据中注入误差源或隐藏关键信息(例如给 UMI 序列加入模拟测序错误),概念修订则在现有评测目标无法引发目标推理时直接更换目标本身。经验记忆进一步把单任务教训变成跨任务资产,让后续概念继承有效的高层行为要求、规避已知失败模式。这与 Benchmark Self-Evolving 的预定义变换、AutoBencher 的声明式目标生成、BenchMaker 的预定义质量标准都有本质区别。
方法步骤详情
流程分六步。(1) 源先验构建:从种子基准各取 100 题提取概念,同时检索近五年文献抽取「输入数据→分析步骤→中间检查→目标输出」的工作流并泛化为复用模式。(2) 概念生成:结合源先验与经验记忆(最多 12 张经验卡、120 个已有概念以防重复)批量生成新概念,每批 5 个。(3) 配方规划:生成七字段配方,明确数据来源(复用/检索/模拟)、答案如何计算与隐藏、问题如何措辞而不泄露解法。(4) 任务实现:智能体构造数据文件 $F_t$、按隐藏策略写问题 $q_t$、执行代码计算并验证标准答案 $a_t$,格式化以支持精确匹配。(5) 求解与评审:$K=3$ 次独立解题,评审器判定可验证性(区分题目歧义与解答错误)、按成功次数定难度并给出文字推理。(6) 反馈精炼与经验沉淀:不达标则修订配方($c_{t+1}=c_t$)或修订概念(连续 4 次配方失败后触发),循环至多 10 轮;结束后把历史总结为五字段经验卡(摘要、有效模式、反模式、选择与生成指引)写入经验记忆。各阶段推理强度设为 high,单阶段超时 3600 秒。
技术新颖性
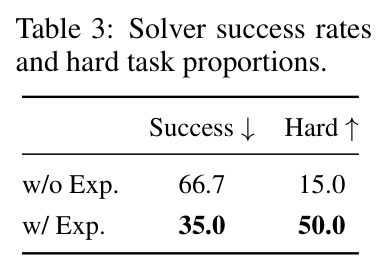
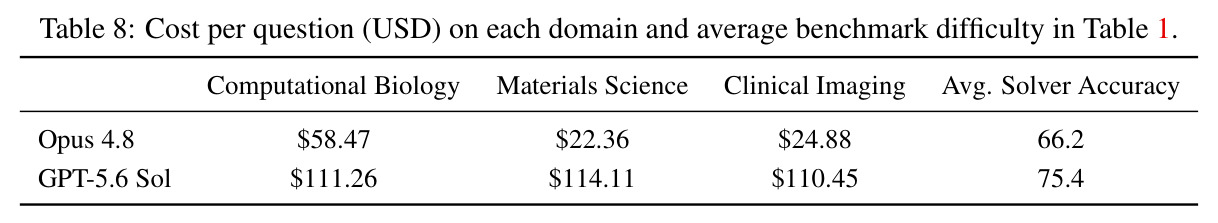
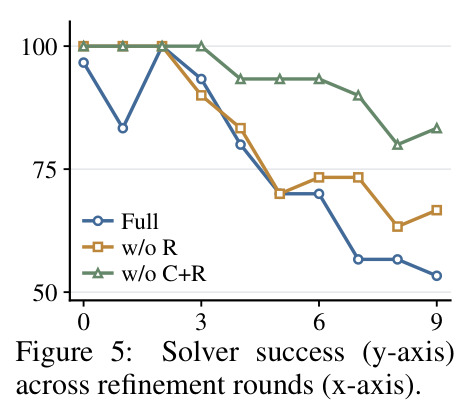
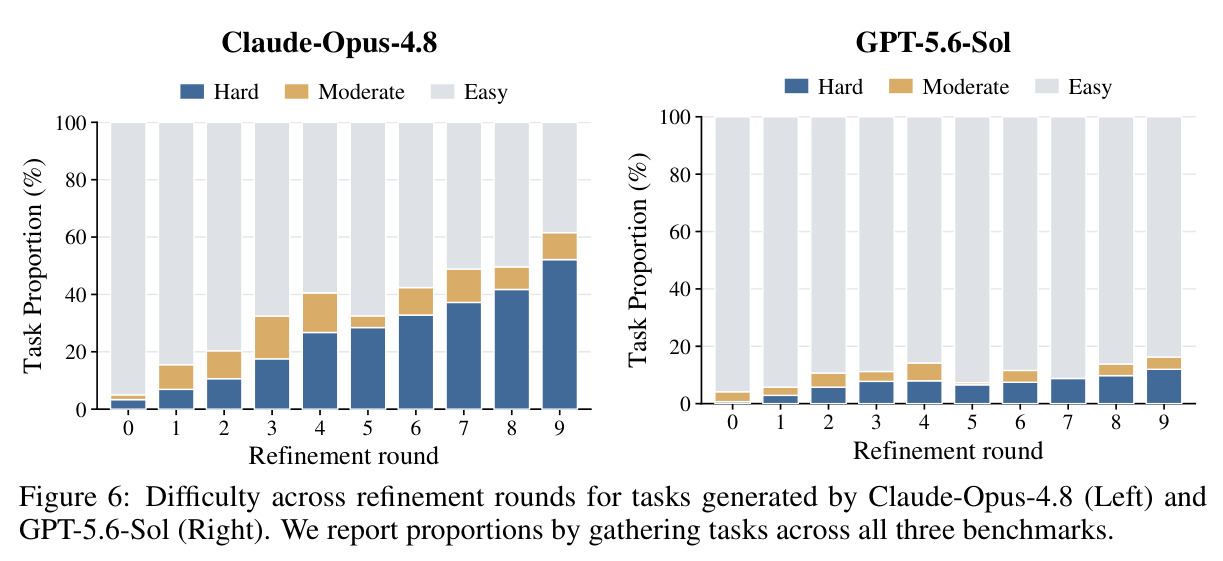
技术新颖性体现在四个层面。其一,评测目标的形式化:概念三元组把「领域-模态-操作」作为一等公民,实现了能力级而非题目级的抽象与复用。其二,闭环式任务改造:以求解轨迹中观察到的捷径为信号修订计划,使难度增长有明确机制——Figure 4 显示初始任务以 easy 为主、hard 比例随精炼轮次持续上升,而非靠随机加噪碰运气。其三,双层计划可修性的消融验证(Figure 5):完整框架的求解成功率随轮次下降最快,去掉配方或同时去掉概念与配方后精炼效果明显变弱,说明修订结构化计划比直接改实例化任务更有效,中间表示本身有独立价值。其四,经验记忆的跨任务迁移:Table 7 展示半导体结静电学概念精炼出的「识别-恢复-一致性检验」行为结构被完整迁移到光学带隙测定这一全新的领域-模态组合;Table 3 消融证明经验引导把 hard 任务比例从 15.0% 提升到 50.0%。此外,论文把基准构建的成本-难度收益透明量化(Table 8:每题 22.36-114.11 美元)在基准文献中也较为少见。
实验结果
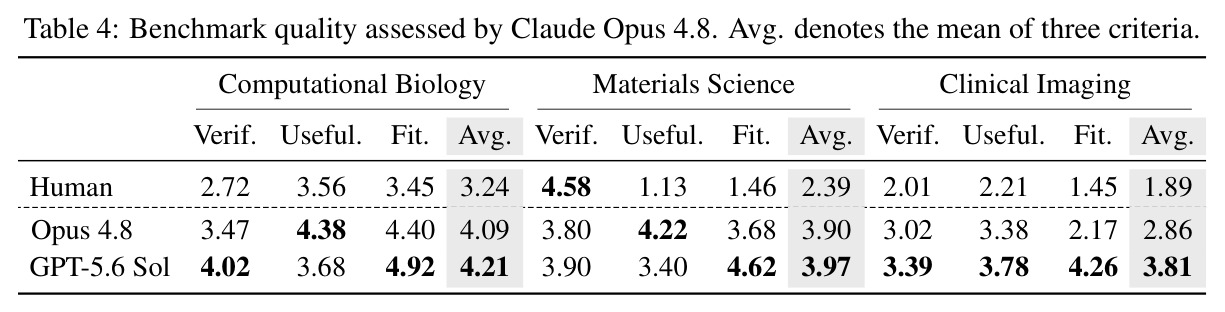
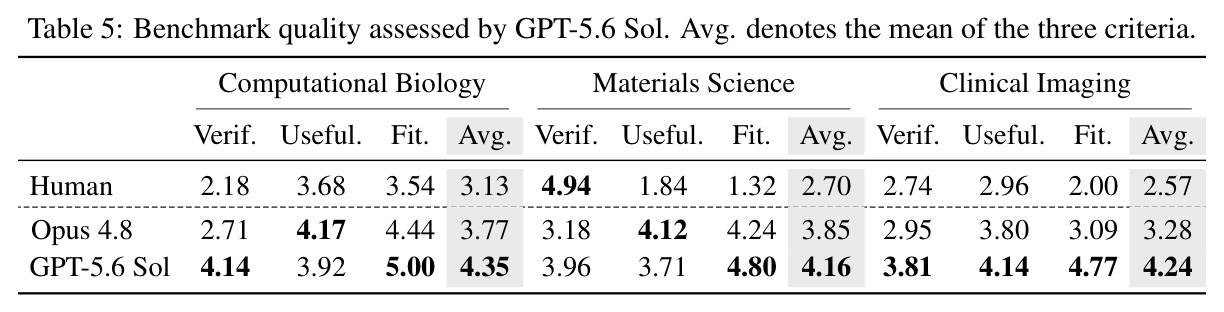
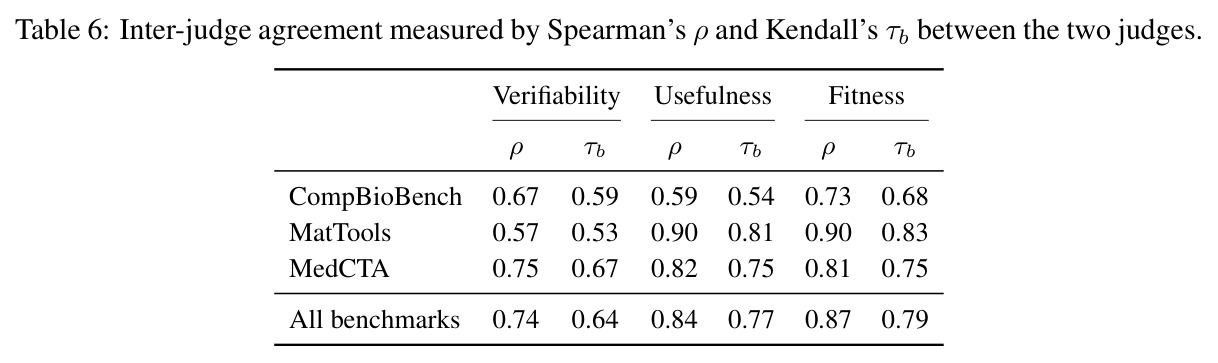
结果有三组。难度:计算生物学上,十个求解器平均准确率从人工基准的 79.8% 降至 Opus 4.8 生成版的 57.4%(-22.4pp)与 GPT-5.6 Sol 生成版的 74.1%;材料科学从 95.7% 降至 70.2%(-25.5pp)与 77.6%。在已饱和的材料科学上生成版重新拉开差距:Haiku 4.5 仅 21.3/29.3,GPT-6 Astra 达 87.3/96.0,难度可跨求解器迁移。质量与进化信号:双评审三维评分上生成版全面超过人工版(4.28 对 3.18、4.06 对 2.54、4.02 对 2.23);更新的模型大幅领先——Opus 5 比 Opus 4.8 高 19.5pp、GPT-6 Astra 比 GPT-5.6 Sol 高 15.1pp。组件有效性:难度随精炼轮次上升;UMI 案例注入测序错误后 3 次求解全部答错;经验引导消融使成功率 66.7%→35.0%、hard 比例 15.0%→50.0%;成本上 Opus 4.8 每题 $22.36-58.47,远低于 GPT-5.6 Sol 的 $110.45-114.11 且产出更难的任务。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 计算生物学智能体任务求解(CompBioBench 种子) | 10 个求解器平均准确率(%,精确匹配) | 57.4(Opus 4.8 生成基准) | 79.8(人工精选 CompBioBench) | 难度提升 22.4 个百分点(准确率下降) |
| 材料科学智能体任务求解(MatTools 种子) | 10 个求解器平均准确率(%,精确匹配) | 70.2(Opus 4.8 生成基准) | 95.7(人工精选 MatTools,已近饱和) | 难度提升 25.5 个百分点,打破天花板效应 |
| 基准任务质量评估(三领域,双 LLM 评审均值) | 可验证性/有用性/适配度综合平均分(1-5) | 4.28 / 4.06 / 4.02(GPT-5.6 Sol 生成版,依次为计算生物/材料/影像) | 3.18 / 2.54 / 2.23(对应人工基准) | 三领域平均分提升 1.10-1.79 分 |
| 经验引导概念生成消融(材料科学,Opus 4.8 生成) | 求解成功率(越低越难)/ hard 任务比例(%) | 35.0 / 50.0(有经验引导) | 66.7 / 15.0(无经验引导) | hard 比例提升 35pp,成功率下降 31.7pp |
| 概念与配方规划消融(材料科学,Opus 4.8) | 求解成功率随精炼轮次的变化 | 完整框架成功率随轮次下降最快 | 去掉配方(w/o R)或概念+配方(w/o C+R)后下降明显变缓 | 验证双层计划表示对反馈精炼的必要性 |
局限与改进
作者未设专门的局限性章节,但可从文中推出若干限制,再加上我自己的观察。其一,质量与可验证性判定都由 LLM 评审完成,且评审与生成器同属两个前沿模型家族,存在自偏好与循环性风险,缺少人类专家的系统校验——临床影像的人工基准甚至因其使用 LLM 评分而非精确匹配,无法与生成版直接比较难度。其二,精确匹配评分把任务限定为有唯一封闭答案的分析题,无法覆盖开放式科学解释、假设生成、实验设计等重要科研能力。其三,每个概念只选出 1 道最终任务、每领域仅 50 题,规模偏小,且选任务时偏向最难者,可能高估整体难度分布。其四,生成器与求解器是同一个模型,任务难度可能部分过拟合到该模型的特定失效模式(虽然实验显示可跨求解器迁移,但覆盖面有限)。其五,大量任务依赖模拟数据,与真实科研数据的噪声、缺失和不一致仍有差距;成本不低(每题 22-114 美元)且深度依赖闭源前沿模型与商业 CLI。其六,正文未明确承诺开源框架代码与全部生成任务,若不开源,社区难以直接复用。
独立分析的弱点
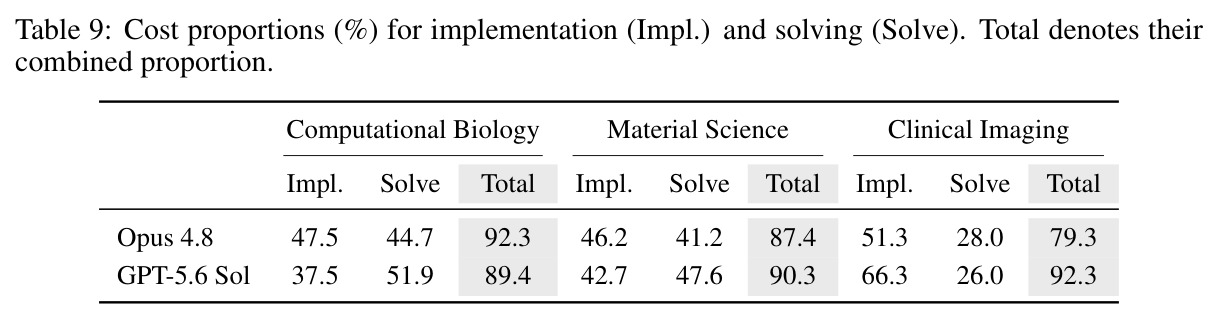
弱点一:评审循环性——用 Opus 4.8/GPT-5.6 Sol 既生成又评审质量,评分可能偏袒自家产出(Table 2 中 GPT 生成版总被两个评审打出最高分);改进方向是引入领域专家盲评子集并报告人机一致性。弱点二:难度仅由 3 次求解的解题率定义,方差大,一道任务可能只是提示词敏感;可增大 $K$、报告解题率置信区间,或多求解器集合定义难度。弱点三:可验证性判断本身可能出错,被误判为可验证的歧义题会污染 hard 集;可增加独立重推导标准答案或人工抽检。弱点四:精确匹配无法奖励部分正确的科学推理,也无法诊断失败发生在哪个分析步骤;可引入 rubric 或单元测试式检查点的过程评分。弱点五:成本集中于实现与求解两个阶段(占 79.3-92.3%);可通过缓存可复用数据构造、并行化求解、小模型预筛不可验证任务来降低门槛。
未来方向
作者明确提出的方向是把更新一代的智能体纳入生成-精炼闭环(Opus 5 和 GPT-6 Astra 的大幅领先已说明必要性),让基准随被评测者共同进化。基于本文成果还可延伸:(1) 把经验记忆从单领域独立扩展为跨领域共享库,检验「识别-恢复-一致性检验」这类高层行为模式能否迁移到化学合成、药物发现、基因组工程等更多领域;(2) 把生成的困难任务转化为训练信号(RL 或蒸馏),研究「评测-训练协同」是否带来可迁移的真实能力提升,同时需防范对评测分布的过拟合;(3) 引入人机协同模式,让领域专家只审核最终入选任务而非全程参与构建,定量测量节省的专家工时与质量损失;(4) 研究生成基准的数据污染检测与防泄漏机制,特别是生成器见过种子基准和公开文献的情况下;(5) 把封闭答案扩展为可执行验证(单元测试、复现性检查、数值容差判定),覆盖更广的真实科学工作流;(6) 探索难度可控生成——以目标解题率(如 30%)为约束的闭环控制器,使基准难度可以按需调节。
复现评估
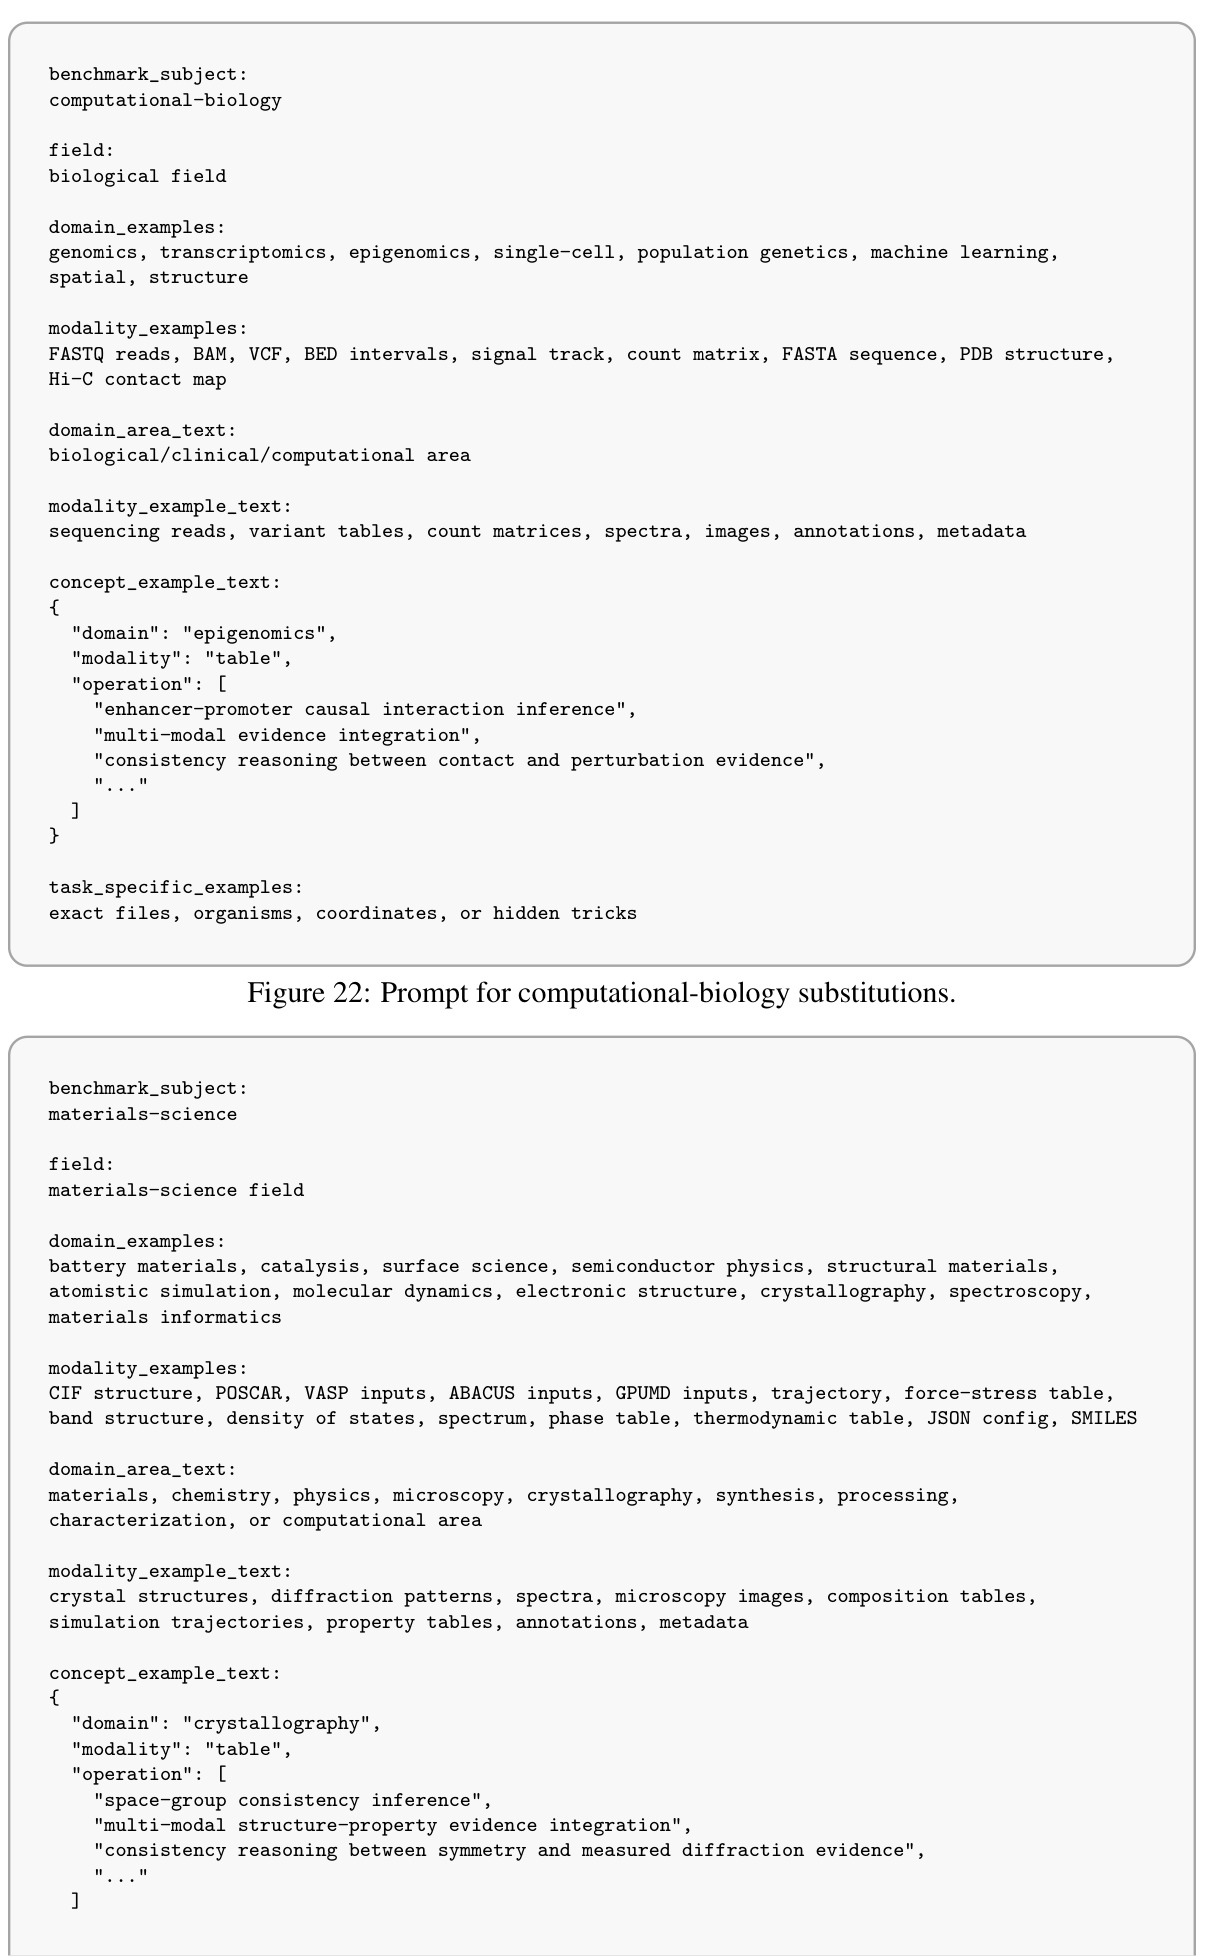
复现难度中等偏高。有利条件:附录给出全部阶段提示词(Figure 8-21)与三领域替换示例(Figure 22-25),配方七字段、经验卡五字段、难度三级定义均清晰;种子基准 CompBioBench、MatTools、MedCTA 公开可获取;附录完整展示了多个生成任务的题目、数据节选与标准答案。不利条件:深度依赖闭源前沿模型(Claude Code CLI + Opus 4.8 或 Codex CLI + GPT-5.6 Sol),所有阶段需将推理强度设为 high;成本不低——Opus 4.8 每题 $22.36-58.47、GPT-5.6 Sol 每题 $110.45-114.11,复现三领域 150 题约需数千至上万美元;单阶段 3600 秒超时意味着流水线耗时长,实现与求解占 79-92% 成本;正文未说明是否开源框架代码与生成任务,若不开源需按提示词重写编排逻辑。总体而言,有 API 预算与工程能力的团队可复现核心结论,但无法在本地开源模型上低成本验证。
论文图表
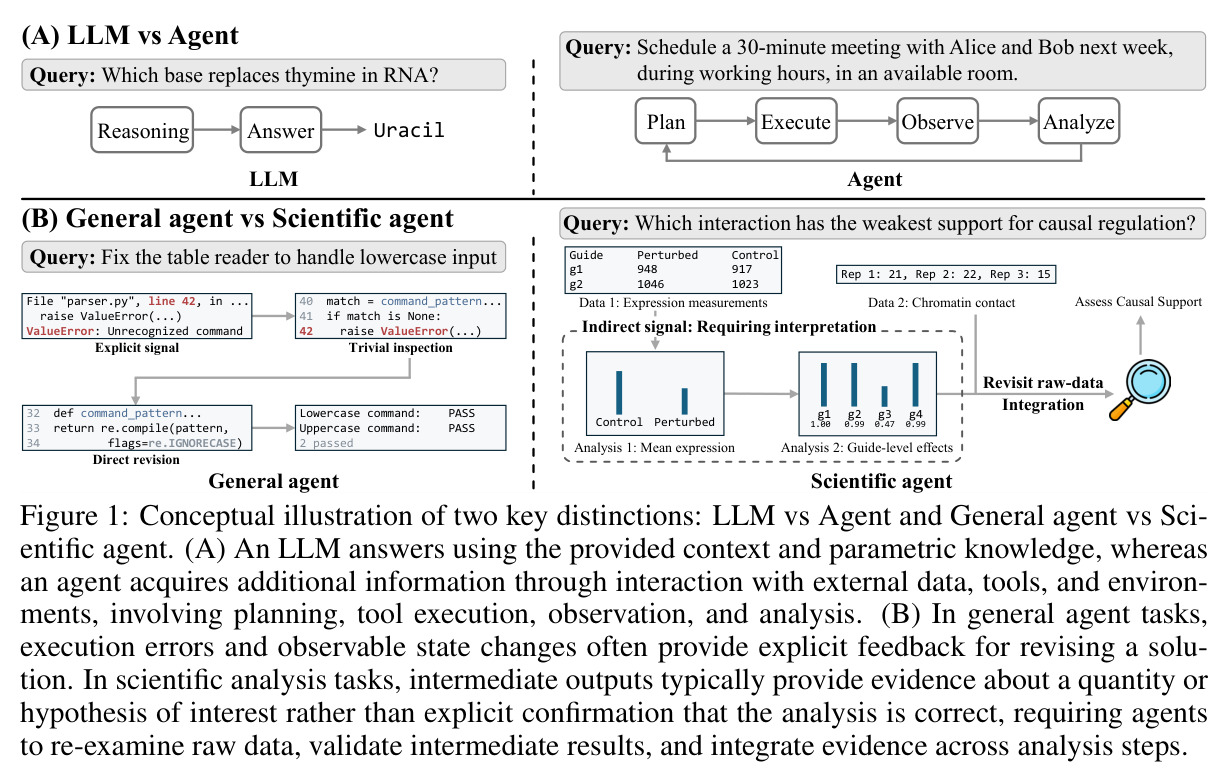
(A) 对比 LLM 与智能体:LLM 仅凭上下文和参数知识回答「RNA 中哪个碱基替代胸腺嘧啶」,而智能体需要通过规划、工具执行、观察、分析的循环与外部环境交互来安排下周与 Alice 和 Bob 的 30 分钟会议。(B) 对比通用智能体与科学智能体:代码任务中执行错误给出显式修复信号(lowercase 报错改为 IGNORECASE 后 PASS),而科学分析任务中中间结果只提供关于目标量的间接证据——需结合表达测量与染色质接触数据评估因果调控支持度,要求智能体重审原始数据、验证中间结果、跨步整合证据。
这张图定义了全文的问题空间:科学智能体评测必须同时考察「交互式信息获取」与「间接证据推理」两种能力,直接决定了概念与配方的设计动机,是理解整篇论文的起点。