DiffGate:难度门控的教师引导在线策略蒸馏 DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
验证器决定哪些失败轨迹获得教师引导,按组难度加权,弥补GRPO盲区
前置知识
在线策略蒸馏(OPD)
知识蒸馏的一种:学生自己采样生成轨迹,教师在这些轨迹经过的状态 $c_t=(x,y_{<t})$ 上打分,通过最小化师生反向 KL($\mathcal{L}_{OPD}=-\sum_t \log\frac{\pi_\theta(y_t|c_t)}{\pi_T(y_t|c_t)}$)提供逐 token 的稠密监督。相比在教师轨迹上做 SFT 的传统蒸馏,它消除了训练与推理时状态分布的不匹配。
本文的基线与被改造对象,DiffGate 的教师项正是由这里采样 token 的对数概率差 $\Delta_{i,t}$ 导出,不懂 OPD 就无法理解教师信号的来源。
GRPO(组相对策略优化)
RLVR 中常用的无 critic 算法:对同一提示采样 $n$ 条响应,用组内奖励归一化得到轨迹级优势 $A^{GRPO}_i=\frac{R_i-\bar{R}}{\sigma_R+\epsilon}$,再把同一优势广播给该轨迹所有 token,用 PPO 式裁剪目标更新。当组内奖励完全相同(全对或全失败)时优势严格为零。
DiffGate 保留 GRPO 作为全局结果信号,其“全失败组无信号”的盲区正是论文要填补的核心缺口,主公式的第一项就是它。
RLVR(可验证奖励强化学习)
用可自动核验的结果(数学答案比对、代码执行测试)作为二值奖励 $R(x,y)\in\{0,1\}$,直接优化序列级正确性。奖励客观、无需人工标注,但信号稀疏且粗糙:一条轨迹只产生一个标量,无法指出哪个 token 出了问题,全失败组更是完全没有梯度。
论文的问题设定就在 RLVR 框架内,判定器(verifier)在 DiffGate 中扮演“路由器”角色,决定哪些轨迹需要教师介入。
avg@8 与 pass@8
两种采样评测指标,从每题 16 个生成中估计。avg@8 是 8 次采样正确率的均值,衡量平均可靠性;pass@8 是 8 次中至少一次正确的比例,衡量解空间覆盖率。两者来自同一生成池,通常温度 0.6 采样,是近年推理类论文的标准报告口径。
DiffGate 的卖点是显著提升 pass@8(解覆盖)而 avg@8 基本持平,读懂 Table 1/2 与结论必须先分清这两个指标的分工。
策略熵塌缩
RL 训练中策略分布熵持续下降、输出趋于确定性的现象。熵过低意味着探索停止、易过拟合到少数解模式,并常伴随训练不稳定(梯度尖峰)。文中 GRPO 训练后期熵跌破 0.1,数学上梯度尖峰达 213、代码上 65,而 DiffGate 保持更高熵且峰值仅 0.7/2.6。
作者用熵差解释 pass@8 提升:保留更多合理解模式,多次采样更可能命中,这是理解“为何覆盖率上升”的关键机制。
反向 KL 与采样 token 优势
反向 KL 的策略梯度形式为 $\nabla_\theta J=E[A(a,c)\nabla_\theta\log\pi_\theta(a|c)]$,其中 token 级优势 $A(a,c)=\log\pi_T(a|c)-\log\pi_\theta(a|c)$。只需在学生实际采出的 token 上评估即可蒙特卡洛近似,配合 stop-gradient 使用,无需遍历整个词表。
DiffGate 的教师项 $\Delta_{i,t}$ 就是这个采样 token 优势,理解它才能理解 $2\tanh(\Delta/2)$ 有界化到底在对什么做变换。
研究动机
后训练大模型的两条主流路线各有盲区。在线策略蒸馏(OPD)在学生自采样的轨迹上用教师分布提供逐 token 稠密监督,但这种监督是“结局无关”的:只要师生分布不一致就产生更新,哪怕整条轨迹答案正确。论文用冻结的 Qwen3-8B 教师检验蒸馏后的 Qwen3-1.7B 学生,发现 token 级师生分歧区分对错轨迹的能力几乎等同随机——数学上 AUROC 仅 0.50 和 0.49,代码上也只有 0.60,且错误轨迹中分歧最大的往往不是导致失败的关键 token。另一边,带可验证奖励的 RLVR(GRPO)直接优化轨迹正确性,但信用分配粗糙:同组所有 token 共享同一个轨迹级优势,且当组内奖励完全一致时组相对优势严格为零。训练早期 14%–36% 的提示构成全失败组;0.6B 代码训练临近结束时仍有约 20% 的提示全失败,这些样本完全没有学习信号。此外 GRPO 后期策略熵跌破 0.1,引发严重梯度尖峰(数学上最大 213,代码上 65),训练不稳定。
本文的目标是论文目标是把两条路线的优点合进单一目标函数:由判定器决定“哪些轨迹需要教师修正”,由教师决定“这些轨迹内部每个 token 往哪个方向更新”。具体希望新目标满足四个性质:(1) 教师信号只作用于验证失败的轨迹,不扰动已正确的解;(2) 教师引导强度随组求解率 $p$ 下降而增强,在全失败组(GRPO 完全无信号处)达到最大,精确填补奖励盲区;(3) 教师的 token 信号必须有界,防止个别师生分歧极大的 token 主导优化、破坏稳定性;(4) 可控可退化:设 $\lambda=0$ 精确恢复 GRPO,设 $\gamma=0$ 恢复无难度加权的加性 GRPO+OPD 基线,便于隔离各组件贡献。最终在 Qwen3-0.6B/1.7B/4B 学生上同时改善数学与代码的 pass@8 与 avg@8,并提升跨域迁移。
与已有工作不同的是,已有结合蒸馏与 RL 的工作——KDRL(联合 GRPO 与反向 KL 但教师项无逐 token 有界)、RL-aware distillation(信任域平衡)、CoDistill-GRPO(大小策略联合训练)、Uni-OPD(按结果信息校准 token 引导)——本质上都把师生分歧当作 token 级信用分配信号或无差别正则。本文的独特切入是彻底否定这一假设:Figure 1 证明分歧信号区分对错只有随机水平(AUROC 0.50/0.49),因此“选路”应上移到轨迹级、交给判定器完成,教师只负责轨迹内部方向。在此之上叠加两个正交设计:用组求解率幂函数 $(1-p)^\gamma$ 做难度门控,把教师火力集中到奖励最弱处;用 $2\tanh(\Delta/2)$ 平滑有界化对数概率差,保号、零点近线性、大分歧时饱和。“判定器管路由、教师管方向、难度管剂量”的三元分工是该领域此前没有的组合。
核心方法
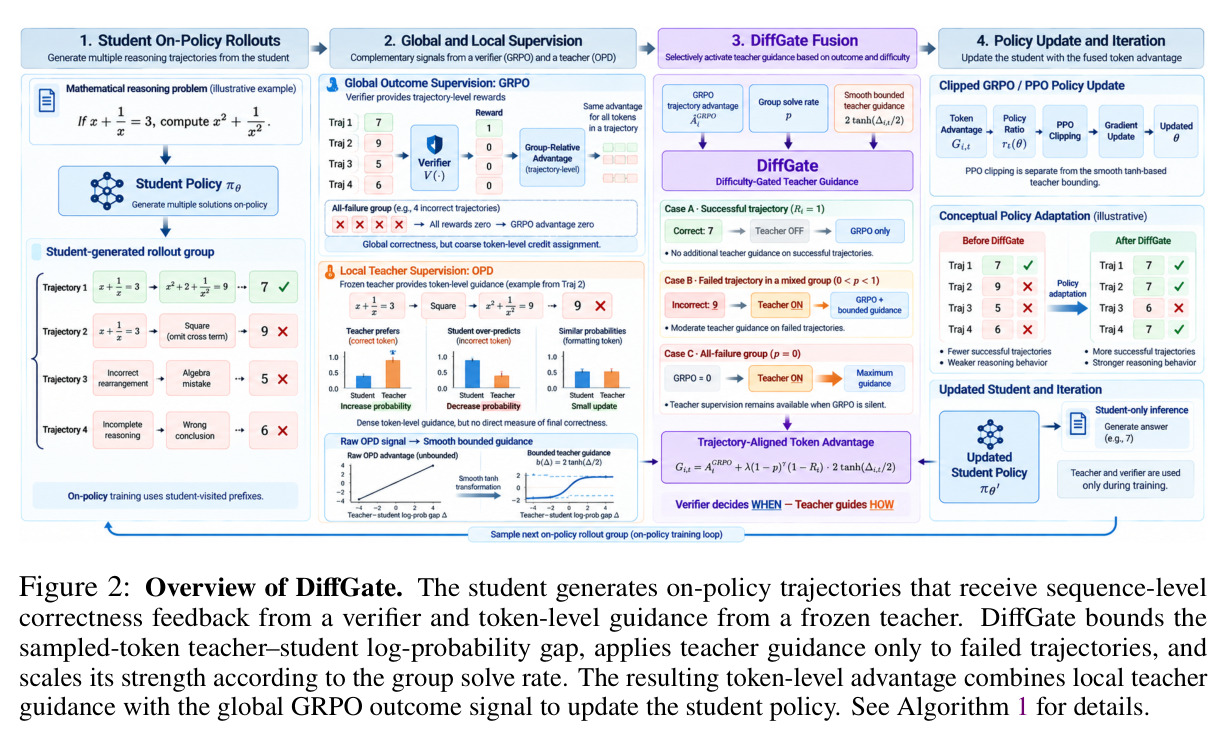
直觉上:GRPO 的组相对优势知道“哪条轨迹好”,但在全失败组失效且粒度粗糙;OPD 的师生对数概率差知道“每个 token 往哪边挪”,却不知整条轨迹对错。DiffGate 用统一的 token 级优势 $G_{i,t}=A^{GRPO}_i+\lambda(1-p)^\gamma(1-R_i)\,2\tanh(\Delta_{i,t}/2)$ 拼接两者,其中 $\Delta_{i,t}$ 为行为策略采出的 token 上教师与学生对数概率之差,$R_i\in\{0,1\}$ 是验证奖励,$p$ 是组求解率,$\lambda$ 控制教师总强度,$\gamma$ 控制难度依赖。边界行为干净:$R_i=1$ 时 $G_{i,t}=A^{GRPO}_i$,成功轨迹不受教师扰动;全失败组 $p=0$、$A^{GRPO}_i=0$ 时 $G_{i,t}=2\lambda\tanh(\Delta_{i,t}/2)$,教师引导达到峰值。训练时 $G_{i,t}$ 作为 stop-gradient 优势,经 PPO 式裁剪代理目标更新学生,实现上只需在 GRPO 损失中追加一项。
核心创新是“结局门控的难度加权有界教师引导”,与已有方法的本质区别有三。第一,路由与方向解耦:判定器在轨迹级决定谁需要纠正,教师在 token 级决定怎么纠正,而不是像标准 OPD 那样把师生分歧本身当信用分配信号——论文证明后者区分对错只有随机水平(数学 AUROC 0.50/0.49,代码 0.60)。第二,难度门控 $w_i=(1-p)^\gamma(1-R_i)$:教师火力随组求解率降低而增强,恰好覆盖 GRPO 的零信号盲区(早期 14%–36% 提示为全失败组,0.6B 代码末期仍约 20%),并随学生变强自动衰减——去掉门控(即加性 GRPO+OPD)平均损失 1.3–2.4 个 avg@8 点,证明门控本身而非教师项是关键。第三,有界化 $2\tanh(\Delta/2)\in(-2,2)$:保符号、小信号近似线性、极端分歧平滑饱和,把教师项压到与 GRPO 优势同量纲,实测把 0.6B 代码最大梯度范数从 342 压回 4.3。
方法步骤详情
流程如下。第一步,对每个提示 $x$ 从行为策略采样 $n=16$ 条轨迹。第二步,判定器给出二值奖励 $R_i\in\{0,1\}$,计算组求解率 $p$ 与优势 $A^{GRPO}_i=(R_i-\bar{R})/(\sigma_R+\epsilon)$。第三步,冻结 Qwen3-8B 教师对每个位置打分,得到采样 token 的 OPD 差 $\Delta_{i,t}$。第四步,有界变换 $B_{i,t}=2\tanh(\Delta_{i,t}/2)$。第五步,计算轨迹门 $w_i=(1-p)^\gamma(1-R_i)$,合成优势 $G_{i,t}=A^{GRPO}_i+\lambda B_{i,t}w_i$。第六步,把 $G_{i,t}$ 作为 stop-gradient 优势,用 PPO 裁剪目标更新学生。数据与设定:数学用 DeepMath、代码用 TACO;主设定 0.6B/1.7B 学生 × 数学/代码(教师 Qwen3-8B),另有 4B 扩展(数学配 14B 教师)。
技术新颖性
技术新颖性有三。其一,首次把“组难度”作为蒸馏强度的显式调制变量:此前 OPD 系方法各有校准机制——EOPD 按教师不确定性调整散度、Uni-OPD 按结果信息校准 token 引导——但都没利用组内奖励分布的结构信息,$(1-p)^\gamma$ 把“这组题有多难”直接翻译成教师剂量。其二,理论刻画:论文证明有界教师信号可经 f-散度获得固定前缀策略梯度解释、难度门控保证全失败组有引导且随求解率衰减、教师项与合成优势均有界,为设计提供了初步理论支撑(不涉及完整 PPO 目标的收敛性)。其三,工程上是 GRPO 损失的一行级扩展:$\lambda=0$ 与 $\gamma=0$ 两个旋钮即可精确退化为 GRPO 与加性 GRPO+OPD 两个匹配基线,消融体系干净,这是论文结论可信度的重要来源。相较 KDRL、CoDistill-GRPO 等联合目标,“失败轨迹路由 + 难度权重 + tanh 有界”的三元组合是新贡献。
实验结果
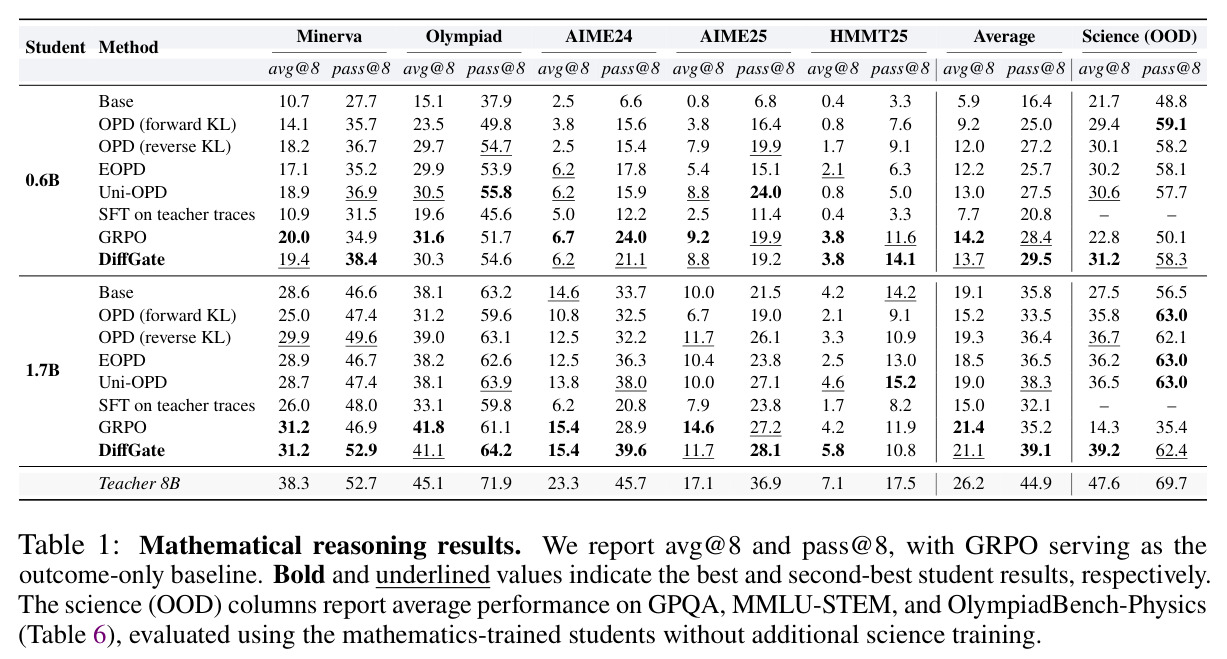
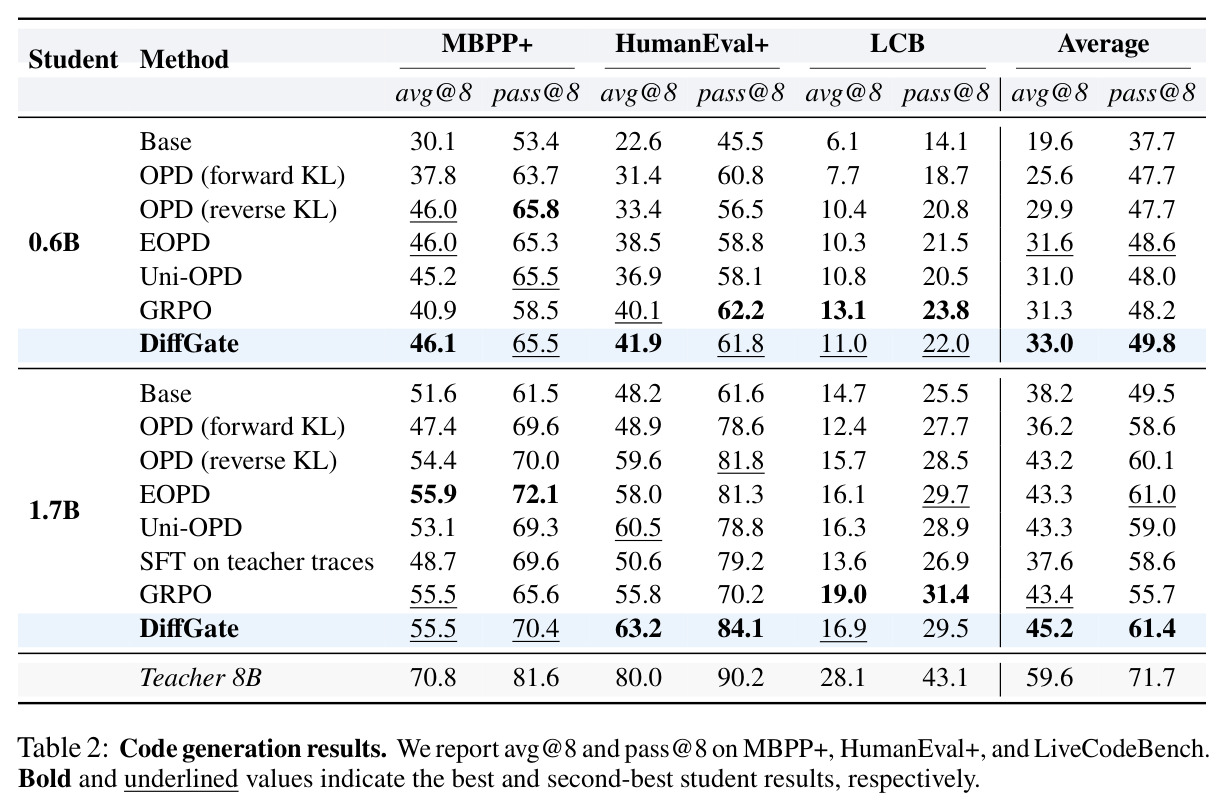
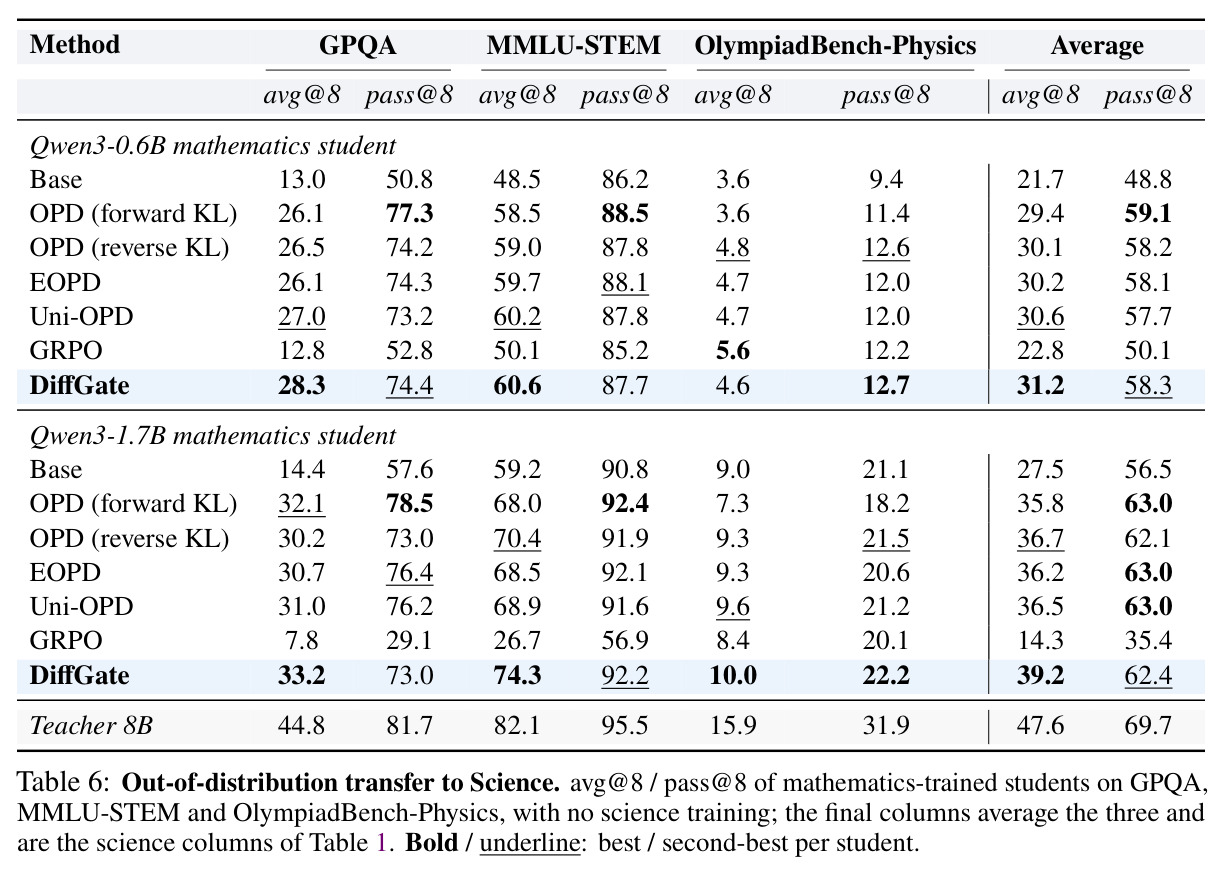
设定:0.6B/1.7B 学生 × 数学/代码四格,GRPO 为匹配基线。数学:DiffGate 的 pass@8 比 GRPO 高 1.1 和 3.9 点,avg@8 仅低 0.5/0.3,并超所有蒸馏基线。代码:双指标领先,0.6B/1.7B 分别提升 1.7/1.6 和 1.8/5.7 点(avg@8/pass@8),1.7B HumanEval+ pass@8 达 84.1。OOD:数学模型零样本测科学基准,avg@8 达 31.2/39.2(基座 21.7/27.5)。4B 学生:数学 30.0/47.2、代码 57.3/70.5,均超最强 OPD。机理上,早期 14%–36% 的提示为全失败组,DiffGate 在 GRPO 无信号处继续引导:失败轨迹师生分歧降至 0.37 nats/token(GRPO 0.56),梯度尖峰仅 0.7/2.6(GRPO 213/65)。消融:去难度门控损失 1.3–2.4 avg@8;无界信号损失 1.0–1.5 点且梯度范数增 1.4–3.3 倍;$n$ 由 16 降 4 时 GRPO 掉 1.9 点、DiffGate 仅掉 1.2。
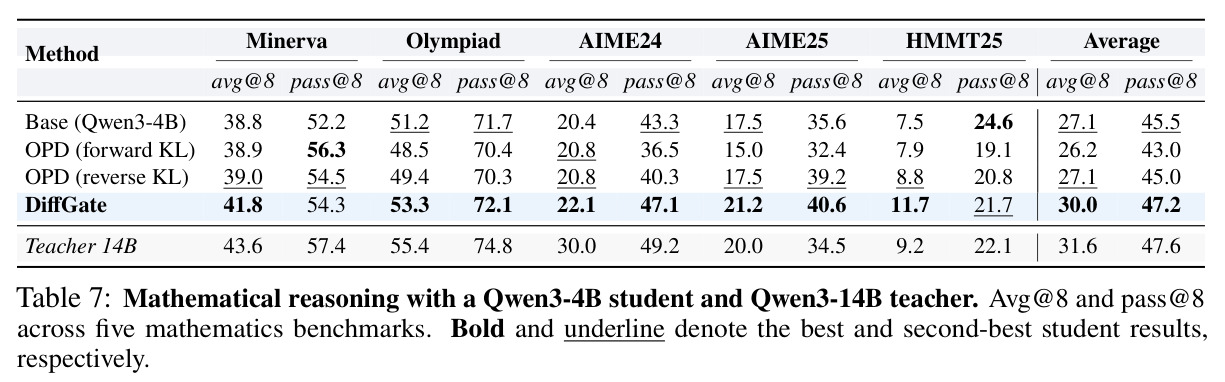
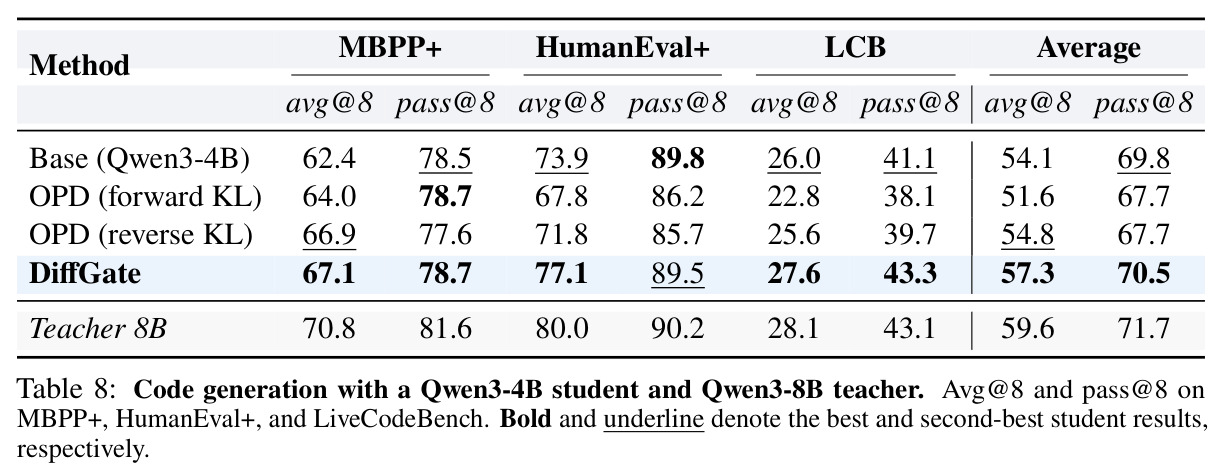
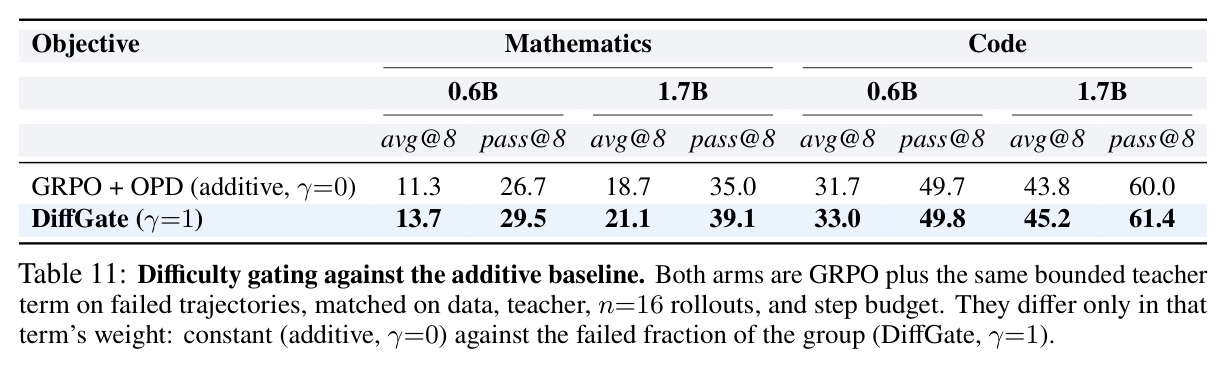
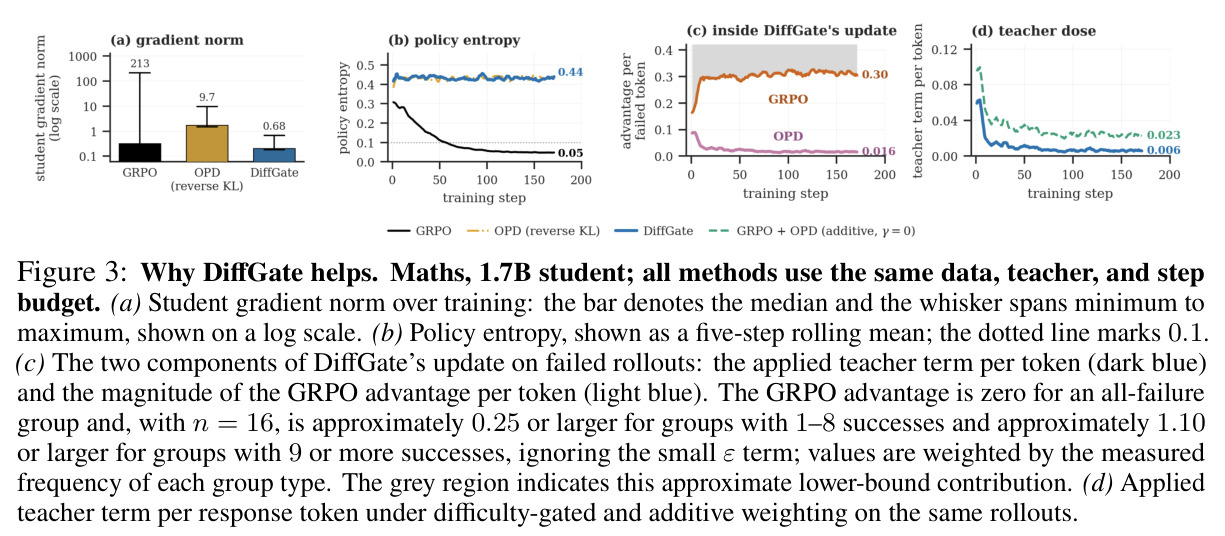
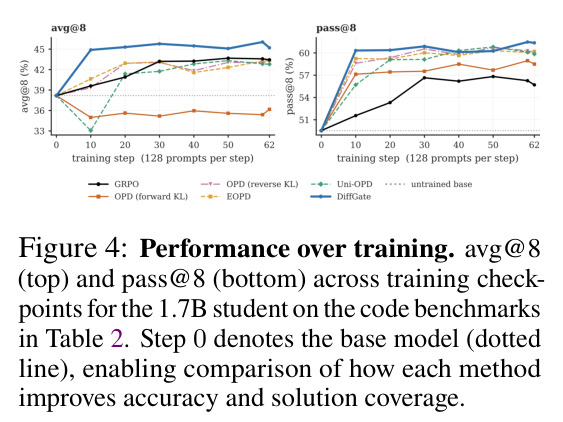
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(0.6B) | avg@8 / pass@8(五基准平均) | 13.7 / 29.5 | GRPO 14.2 / 28.4 | avg@8 -0.5,pass@8 +1.1 |
| 数学推理(1.7B) | avg@8 / pass@8(五基准平均) | 21.1 / 39.1 | GRPO 21.4 / 35.2 | avg@8 -0.3,pass@8 +3.9 |
| 代码生成(0.6B) | avg@8 / pass@8(三基准平均) | 33.0 / 49.8 | GRPO 31.3 / 48.2 | avg@8 +1.7,pass@8 +1.6 |
| 代码生成(1.7B) | avg@8 / pass@8(三基准平均) | 45.2 / 61.4 | GRPO 43.4 / 55.7 | avg@8 +1.8,pass@8 +5.7 |
| 科学 OOD 迁移(数学训练直接迁移) | avg@8(GPQA+MMLU-STEM+OlympiadBench-Physics) | 31.2(0.6B)/ 39.2(1.7B) | 最强 OPD 30.6 / 36.7;基座 21.7 / 27.5 | +0.6 / +2.5(相对最强 OPD) |
| 数学推理(4B 学生,14B 教师) | avg@8 / pass@8 | 30.0 / 47.2 | 最强 OPD 基线 | +2.9 / +2.2 |
| 代码生成(4B 学生,8B 教师) | avg@8 / pass@8 | 57.3 / 70.5 | 最强 OPD 基线 | +2.5 / +2.8 |
局限与改进
作者承认的局限:实验只覆盖数学推理与代码生成两类可自动验证任务,学生规模最大 4B,对 agentic 推理、长程决策等任务的适用性未验证。我的补充观察:(1) 方法依赖可靠的二值判定器与高水平冻结教师,教师在难题上系统性出错时会以最大门控权重(全失败组门控=1)把错误注入学生,论文未报告教师在失败轨迹上的错误率;(2) 数学上 avg@8 略低于 GRPO(13.7 vs 14.2、21.1 vs 21.4),存在以平均精度换解覆盖的权衡,温度 0 贪心推理下收益存疑;(3) 门控在轨迹级运作,论文明确放弃了 token 级错误定位,对长链推理“错一步废全程”的精细归因无能为力;(4) OOD 增益主要由 GPQA 与 MMLU-STEM 驱动,OlympiadBench-Physics 变化很小;(5) 最优超参按域不同(数学 $\lambda\in[0.25,1]$ 平坦、代码峰值约 0.5),跨域不共享;(6) 每个 rollout token 都需教师前向,训练成本显著高于纯 GRPO。
独立分析的弱点
弱点一:判定器与教师的强耦合假设。二值奖励在数学/代码上廉价可得,但开放域任务(写作、对话、开放问答)没有可靠验证器,轨迹级门控 $(1-R_i)$ 直接失效。改进方向:用 LLM-as-judge 或过程奖励模型替代二值判定,把 $(1-R_i)$ 推广为软奖励门。弱点二:教师错误不可检测。门控只看学生是否失败、不看教师是否可靠,教师在难题上系统性错误时会被全权重注入。改进方向:教师多次采样一致性检验,或按教师自置信度缩放 $\lambda$。弱点三:训练开销。失败轨迹每个 token 都要教师前向,8B/14B 教师推理成本可能超过学生训练本身。改进方向:只在轨迹片段(如错误高发段)采样计算教师信号,或分层缓存教师 logprob。弱点四:avg@8 轻微回退与贪心场景的潜在不一致,应补充温度 0 与多数投票评测。弱点五:师生能力差很大时(8B 教 0.6B 学),tanh 界 $\pm2$ 的量纲适配缺乏原则性推导,换更强教师后是否仍合适未知,可研究自适应界。
未来方向
作者提出的方向:扩展到 agentic 推理与长程决策等更复杂任务;扩展到 4B 以上学生。基于成果可延伸:(1) 把轨迹级门控细化为段级/步级门控,结合过程奖励模型定位错误步骤,弥补论文明确放弃的 token 级归因;(2) 难度门控天然构成课程学习,可按 $(1-p)^\gamma$ 动态调度训练数据,并研究与动态采样(DAPO 式难例重采样)的组合——文中已显示组大小 $n$ 变小时 DiffGate 优势放大(GRPO 掉 1.9 点、DiffGate 仅掉 1.2),两者应正交;(3) $\lambda$ 随训练进程自适应退火:诊断显示训练后期加性基线每 token 教师项(约 0.024)仍是 DiffGate(0.006)的四倍而效果更差,调度式衰减有明确空间;(4) 能力迭代:用 DiffGate 训出的学生作下一代教师,研究蒸馏—RL 循环中的能力传递与退化;(5) 理论补全:论文只证了有界性、门控行为与 f-散度解释三条局部性质,完整 PPO 裁剪目标的收敛性仍开放;(6) 迁移到工具调用、多模态等有验证器但轨迹更长的场景。
复现评估
复现条件较友好:所有模型公开(Qwen3-0.6B/1.7B/4B 学生,Qwen3-8B/14B 教师),训练数据公开(DeepMath、TACO),评测基准全公开(Minerva-Math、OlympiadBench、AIME24/25、HMMT25、MBPP+、HumanEval+、LiveCodeBench、GPQA、MMLU-STEM),无私有数据。关键协议有披露:rollout 组大小 $n=16$、每题 16 个生成估计两指标、温度 0.6、top-p 1.0、重复惩罚 1.15、最大生成长度 16384 token;$\lambda/\gamma$ 扫描在附录 D.4,消融在附录 E。方法本身是 GRPO 损失的小改动(约数十行),工程难度低。主要成本是每个 rollout token 的教师前向(8B/14B 推理),0.6B–4B 学生的 RL 训练估计需要多卡 A100/H100 级算力与数天时间。文中未提及开源训练代码,复现者需自行实现损失修改并到附录 D 核对学习率、总步数等细节,整体难度中等偏上但完全可行。
论文图表
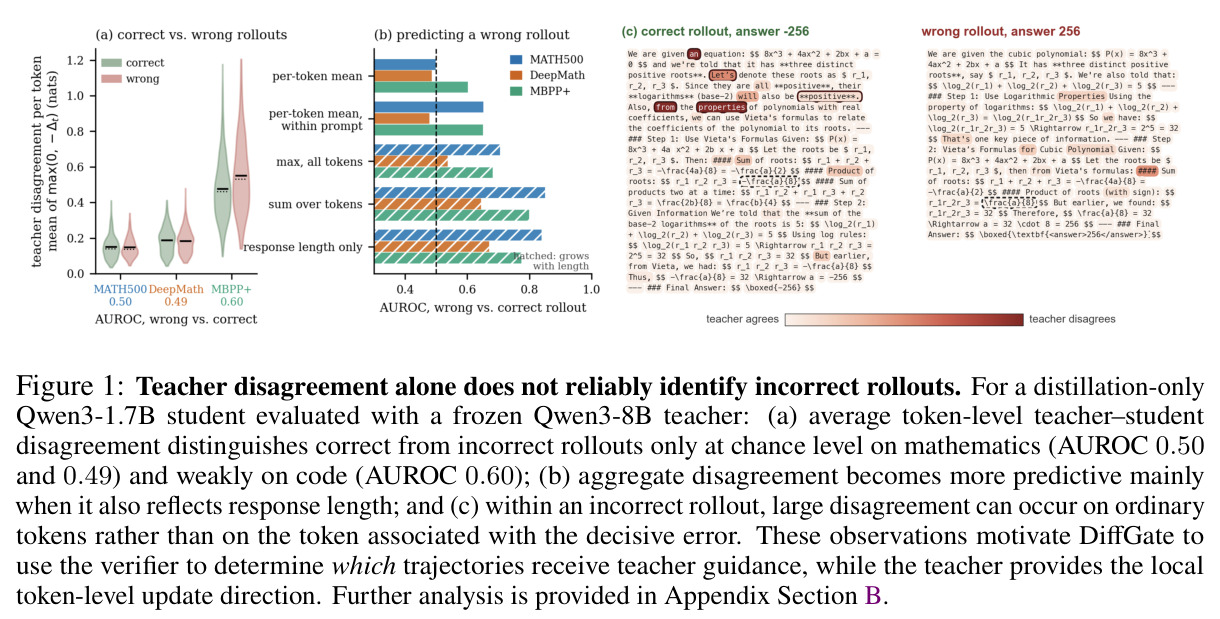
用冻结 Qwen3-8B 教师评估蒸馏后的 Qwen3-1.7B 学生:(a) token 级师生平均分歧区分对错轨迹在数学上只有随机水平(AUROC 0.50 和 0.49),代码上较弱(AUROC 0.60);(b) 聚合分歧变得更有预测性主要因为它同时反映了回答长度;(c) 在一条错误轨迹内部,大分歧常出现在普通 token 上而非导致错误的关键 token。
这是全文动机的实验根基:直接证明“把师生分歧当 token 级信用分配信号”这一 OPD 惯用假设不成立,从而论证必须由判定器在轨迹级做路由、教师只负责轨迹内部方向。