同一输出,不同金标:衡量参考答案选择如何撼动多语言基准分数 Same Output, Different Gold: Measuring How Reference Choice Moves a Multilingual Benchmark Score
固定输出只换金标:参考选择就能移动近5个F1点,甚至让排名变号
前置知识
跨度抽取(Span Extraction)
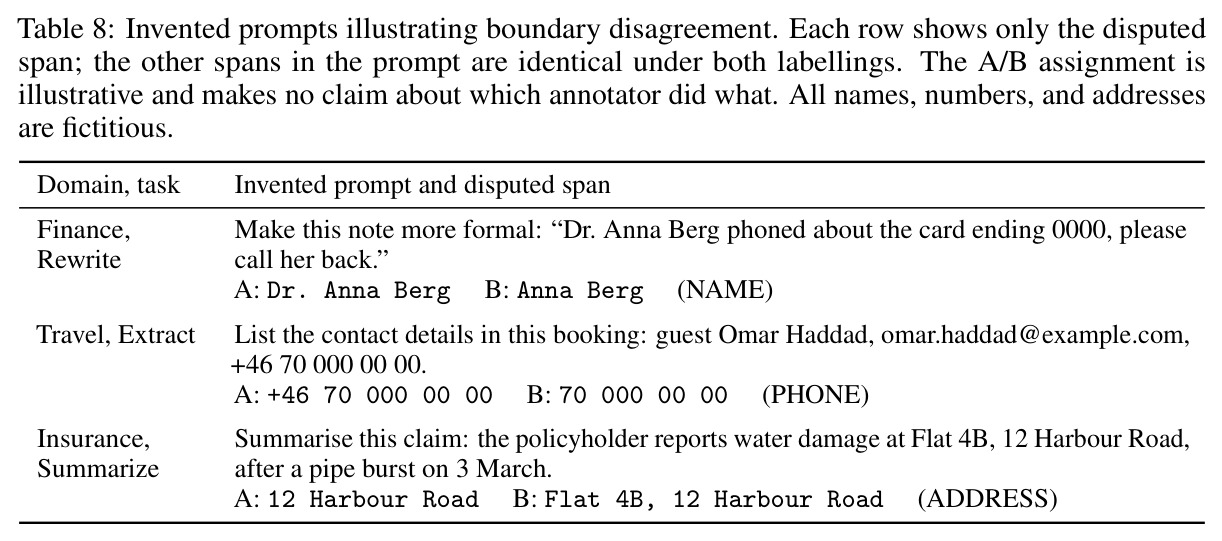
从文本中抽取子串并赋予类型,每个实体表示为(起始偏移, 结束偏移, 类型)三元组。PII 抽取即找出姓名、电话、地址等敏感片段。评分通常要求预测与 gold 在三部分上完全一致(STRICT),或忽略类型只看边界(RELAXED)。
本文审计的正是这类基准的评分协议:标注者的分歧主要发生在边界约定上,理解跨度的表示方式是理解'换参考为何移动分数'的前提。
micro-F1
先把所有提示上的真正例、假正例、假负例求和,再计算精确率与召回率的调和平均。长提示权重更大,对类别不平衡不敏感;作为对称指标,它无需指明哪一方更'正确'。
论文所有分数、一致性与移动量都用 micro-F1 表示,如池化标注者间一致性 79.6(STRICT),核心结果 $\Delta=+4.95$ F1。
标注者间一致性
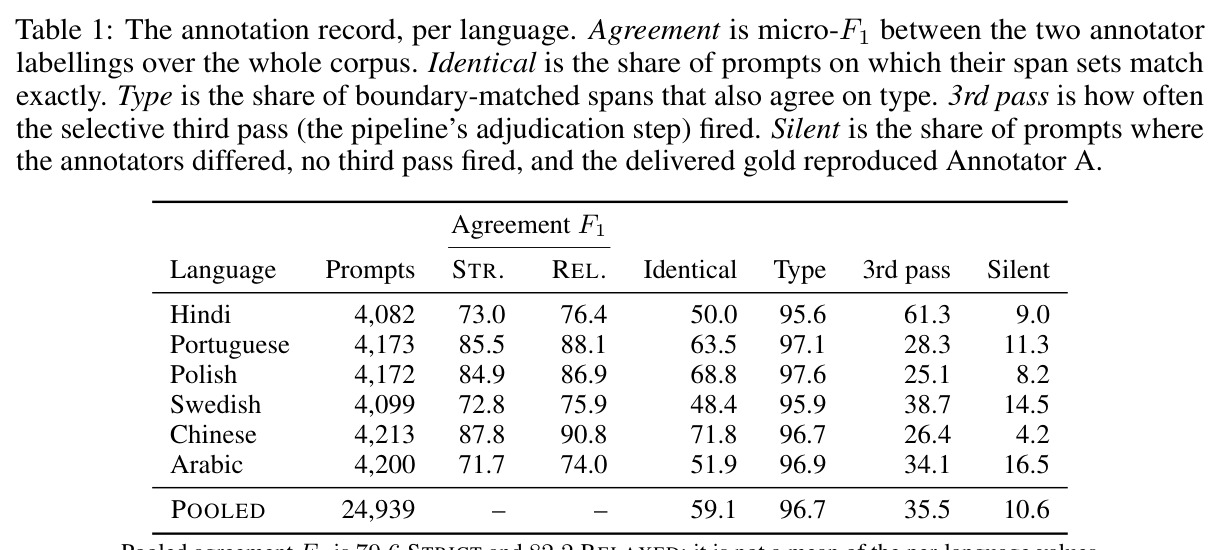
衡量两名标注者对同一批数据给出相同判断的程度。传统上用 Cohen's κ 等机会校正系数,但作者指出标注者自由选择边界时'机会一致'无法定义,因此直接报告 micro-F1 与跨度集完全一致的提示占比。
参考答案正是一致性处理的产物:六种语言一致性相差 16 点、边界一致时类型一致率高达 95.6–97.6%,这些数字是解读分数的必要背景。
bootstrap 置信区间
对数据有放回重采样(本文 2,000 次、以提示为单位、池化时按语言分层),反复计算统计量并取分位数作为区间。配对设计要求差值的两侧在同一组重采样内计算,这样差值才是配对的。
论文每个核心数字都带 bootstrap 区间,且交互项的可检验性完全依赖'同一重采样内配对'这一设计。
交互项与 Holm 校正
交互项指'两种条件下差值之差',此处为两标注者边际在交付 gold 与 reviewer gold 下的差值之差。Holm 校正按 p 值从小到大逐步收紧显著性阈值,以控制多重检验的族错误率。
排名是否改变必须检验交互而非比较两个置信区间(Gelman-Stern 谬误);池化交互 +2.95 经 Holm 校正后仍 p<0.01 是全文最关键的结论。
金标与聚合规则
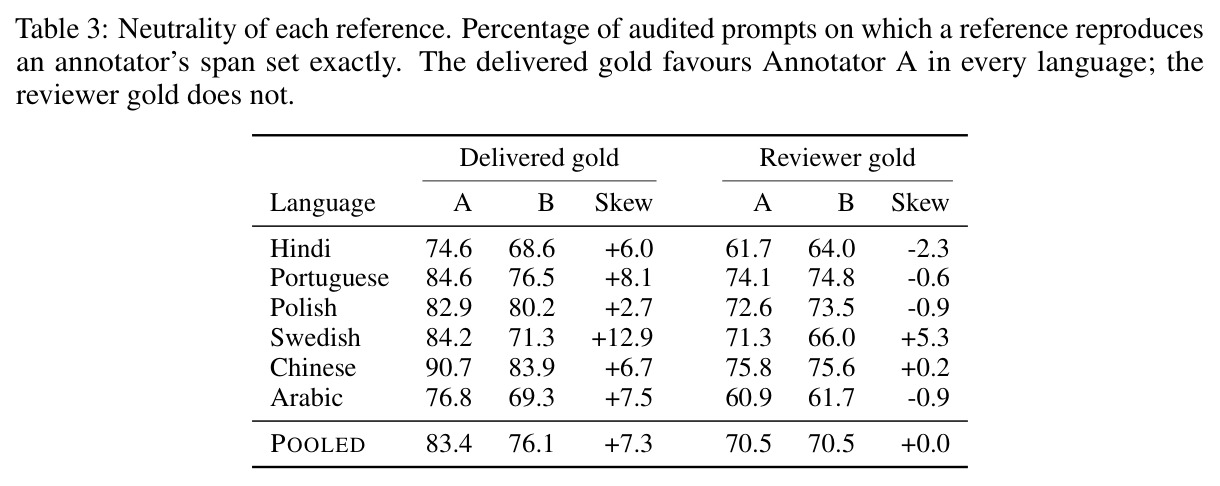
基准参考答案由标注流水线生成:多人独立标注后按某条规则合并或选择。本文的流水线在分歧未被仲裁时 98.7% 保留第一位标注者,且 gold 是'选择'而非'合并'——94.9% 的受审提示上它逐字等于某一位标注者的标注。
这条未文档化的聚合默认正是本文发现的核心偏差来源,理解'gold 是选择而非合并'是全文论证的枢纽。
研究动机
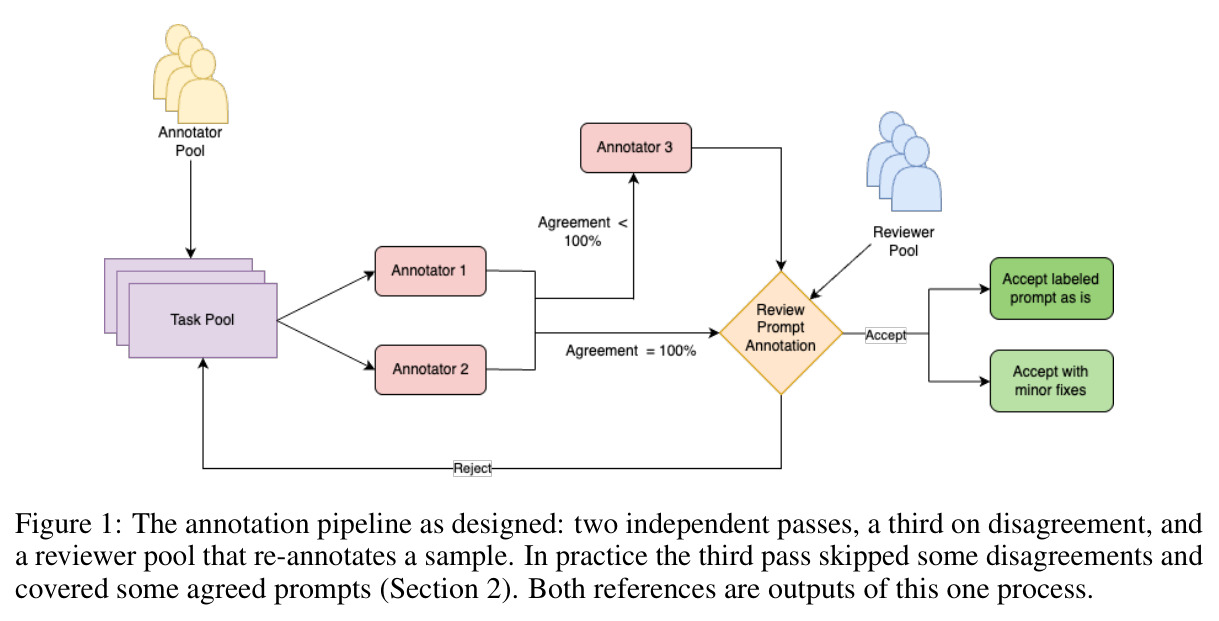
基准分数由'系统输出'和'参考答案'两部分相减得到,但方法学讨论几乎全部聚焦前者:参考答案被当作数据集的固定属性,发布时报告一次之后便不再被追问。事实上参考答案是标注流程的产物——标注者之间会有分歧,分歧要靠某条聚合规则裁决,换一条规则就会得到另一个参考答案。本文审计的生产级六语言 PII 抽取基准(印地语、葡萄牙语、波兰语、瑞典语、中文、阿拉伯语,去重后 24,939 条提示,每语言约 4,100 条,21 种共享加 77 种本地化 PII 类型)暴露了这一隐患:当两名标注者意见不合且第三遍仲裁未触发时,流水线在 98.7% 的情况下默认保留标注者 A 的结果,这发生在 10.6% 的提示上(阿拉伯语高达 16.5%)。结果是被当作 gold 发布的参考在 94.9% 的受审提示上与某一位标注者的标注逐字符相同——参考答案部分复制了被评分的对象,而这一聚合默认在任何公开描述中都未记载。更糟的是,第三遍仲裁的触发率跨语言严重不均(波兰语 25.1% 对印地语 61.3%),同一个基准实际上没有对六种语言应用同一条协议。
本文的目标是本文的目标是把'参考答案的选择'本身变成一个可测量的量。具体而言:固定被评分的输出不变,仅在'交付 gold'与'独立专家重标的 reviewer gold'之间交换参考,量化分数移动的幅度及其置信区间;再检验两个输出之间的排名是否在换参考后依然成立——不是分别比较两次显著性,而是直接检验配对交互项;最后把测得的移动幅度总结为'reference-sensitivity band'(参考敏感度带宽),主张该带宽应与基准分数并列发布。作者还追问偏斜的来源:交付 gold 是否系统性地偏向某位标注者,这一偏斜是仲裁规则还是未文档化的聚合默认造成,以及其中有多少是'用 gold 给其来源打分'的自评效应。整个研究不需要任何新的标注,只需要流水线保留(而非丢弃)完整的标注记录,因此方法论可以推广到任何保留了多份标注的基准。
与已有工作不同的是,已有工作要么在事后用算法修正标签错误,要么关注分歧对训练的意义:Northcutt 等(2021)证明修正测试集标签错误可重排模型排名,但他们在分类任务上事后重构参考;Aroyo-Welty、Plank、Uma 等主张分歧是系统性信号,但问的是分歧对训练意味着什么而非对评分意味着什么;Bonagiri 等(2026)发现排行榜排序对评分者选择的敏感度高于系统能力,但他们的参考只是同一评分者池的子样本、仅英语、且针对偏好判断。本文的独特切入是:使用同一条生产流水线产生的、同样站得住脚的两份参考(交付 gold 与专家重标),在多语言跨度抽取任务上做'固定输出、只换参考'的实验;在多语言跨度抽取上量化'换一份同样合理的参考,分数和排名会移动多少',并用配对交互检验直接回答'排名是否幸存',这是此前文献没有给出的测量。
核心方法
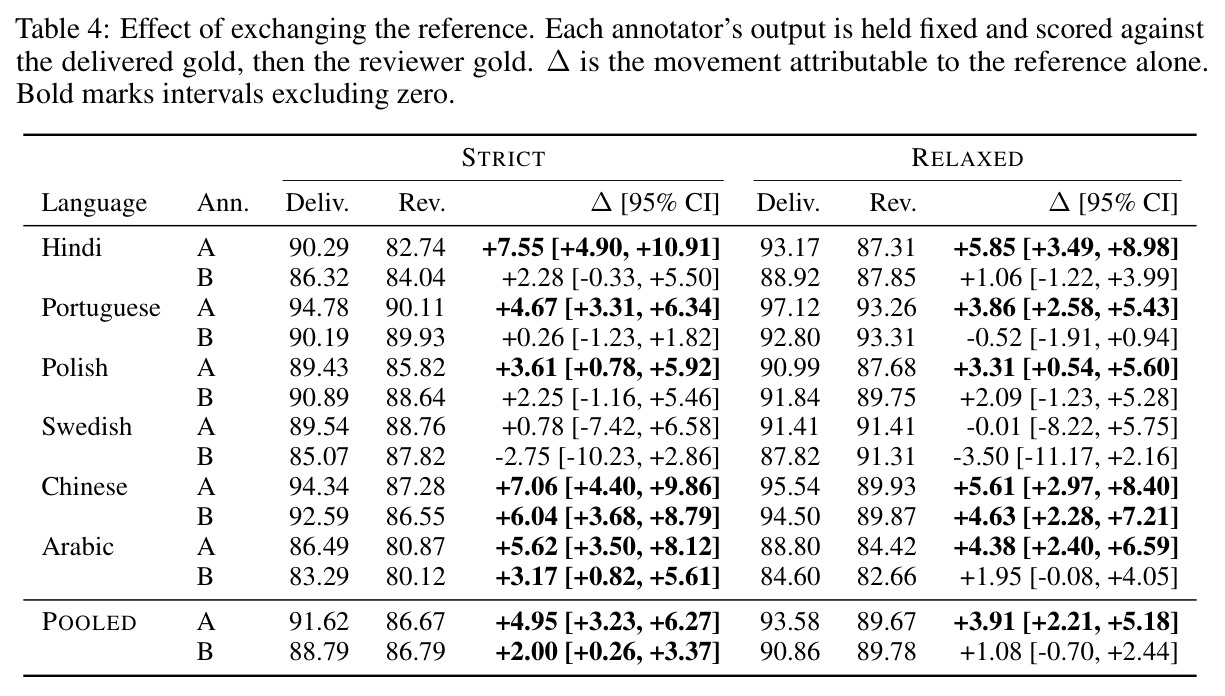
整体思路是把评测协议本身当作测量对象:不再'变系统、固定参考',而是'固定输出、变参考'。数据基础是一份保留了冗余的标注记录——每条提示最多有四份标注:标注者 A、标注者 B(99.6% 的提示上两者都在)、作为 gold 发布的聚合结果,以及覆盖 10.5% 语料的独立专家从头重标。四份标注只在 reviewer 抽样的'受审子集'上同时存在,因此所有测量都限制在该子集(去重后 $n=2{,}628$:印地语 350、葡萄牙语 630、波兰语 339、瑞典语 341、中文 623、阿拉伯语 345,两份标注分别含 9,101 和 9,186 个跨度)。评分采用跨度 micro-F1,两种匹配规则并行:STRICT 要求(起始偏移,结束偏移,类型)三元组完全相等,RELAXED 只要求(起始偏移,结束偏移)边界相等,两者之差恰好隔离出'边界已一致时类型分歧'的代价。所有不确定性用 2,000 次重采样的提示级配对 bootstrap 估计,池化时按语言分层,同一单元复用同一组重采样,保证所有差值与边际都是配对的。
核心创新是两个'反转'。第一,把参考从常量变成实验变量:分数的任何移动只能归因于参考的选择,因为被评分的输出没变。作者明确意识到'交付 gold 通常等于两位标注者之一的标注'带来的自评混淆——用 gold 给其来源打分会抬高对应标注者的分数——因此同时报告朴素版(全受审子集,这是实际使用者会得到的数字)与去污染版(剔除 gold 与任一被评标注相同的提示,仅 $n=135$)。第二,排名稳定性不靠'两个 CI 一个含零一个不含零'的朴素读法(Gelman 与 Stern 2006 指出这不构成证据),而是把交互项定义为'交付 gold 下的边际减去 reviewer gold 下的边际';由于两者在同一 bootstrap 重采样内计算,交互是配对的,可直接检验并做 Holm 校正。此外,'gold 对每位标注者跨度集的逐字再现率之差'成为一个两行代码即可执行的偏斜诊断,把聚合默认从'标注细节'提升为'可检验的评测偏差'。
方法步骤详情
第一步,确定受审子集:取 reviewer 覆盖的提示,去重后 $n=2{,}628$,确认其占语料 10.5%。第二步,诊断偏斜:分别计算交付 gold 与 reviewer gold 逐字再现 A、B 跨度集的提示比例。第三步,参考交换:固定 A 的标注为'系统输出',分别以交付 gold 与 reviewer gold 计算 micro-F1,差值 $\Delta$ 即为参考选择单独造成的移动;对 B 重复;池化与每语言、STRICT 与 RELAXED 并行。第四步,不确定性:提示级配对 bootstrap 2,000 次(固定种子),池化时按语言分层,给出 95% 百分位区间。第五步,交互检验:在同一组重采样内计算'两种参考下标注者边际之差'的差值,报告点估计与 CI,并对 14 个检验做 Holm 校正。第六步,去污染:剔除 gold 既不等于 A 也不等于 B 的提示($n=135$)重算,仅判断自评成分。第七步,汇总带宽:取最大池化 $\Delta$ 的 95% 上界(STRICT 6.3 点、RELAXED 5.2 点;用 B 的 $\Delta$ 则为 3.4 点),并在四种重复数据处理策略下重复全部分析验证稳健性(附录 D 的重复缺陷已全程排除)。
技术新颖性
技术上的新颖性不在算法而在测量设计与因果识别。其一,这是首个在多语言跨度抽取基准上量化'参考敏感度'的工作:不注入人工标签噪声(Northcutt 等 2021 的事后算法修正路线),也不做评分者池的子采样(Bonagiri 等 2026),而是利用生产流水线天然保留的两份独立参考,使参考交换是'两个同样站得住脚的选择'之间的交换。其二,把标注流程中的实现默认(分歧未仲裁时按位置保留第一位标注者,98.7% 落在 A)确立为评测偏差而非数据质量问题,并给出可在任意标注记录上两行代码完成的偏斜检验——gold 再现率之差。其三,用配对交互项而非两次独立显著性判断来回答排名稳定性,避免 Gelman-Stern 谬误;配合 $n=135$ 的去污染子集,把'自评'与'真实偏倚'分开讨论并坦承其统计力不足。其四,提出 reference-sensitivity band 作为应与分数并列报告的新指标,并明确其三条使用约束(描述性而非推断界、受自评膨胀、属于特定流水线)。
实验结果
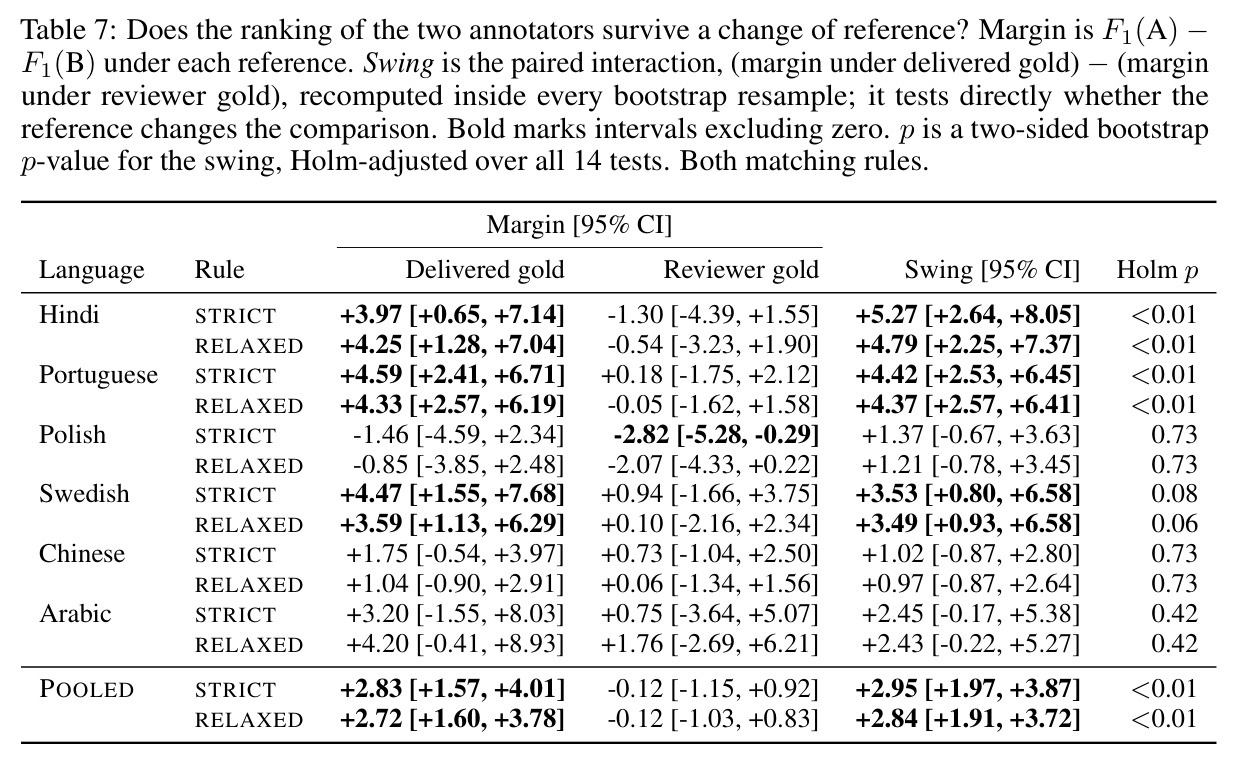
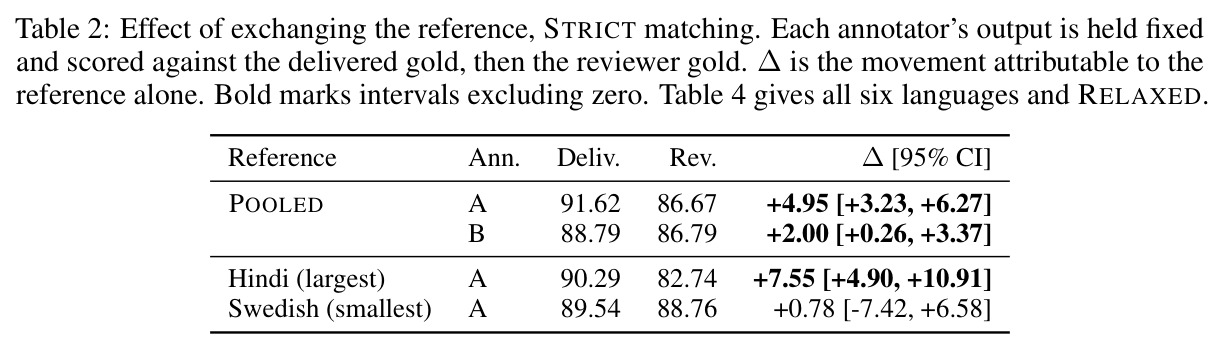
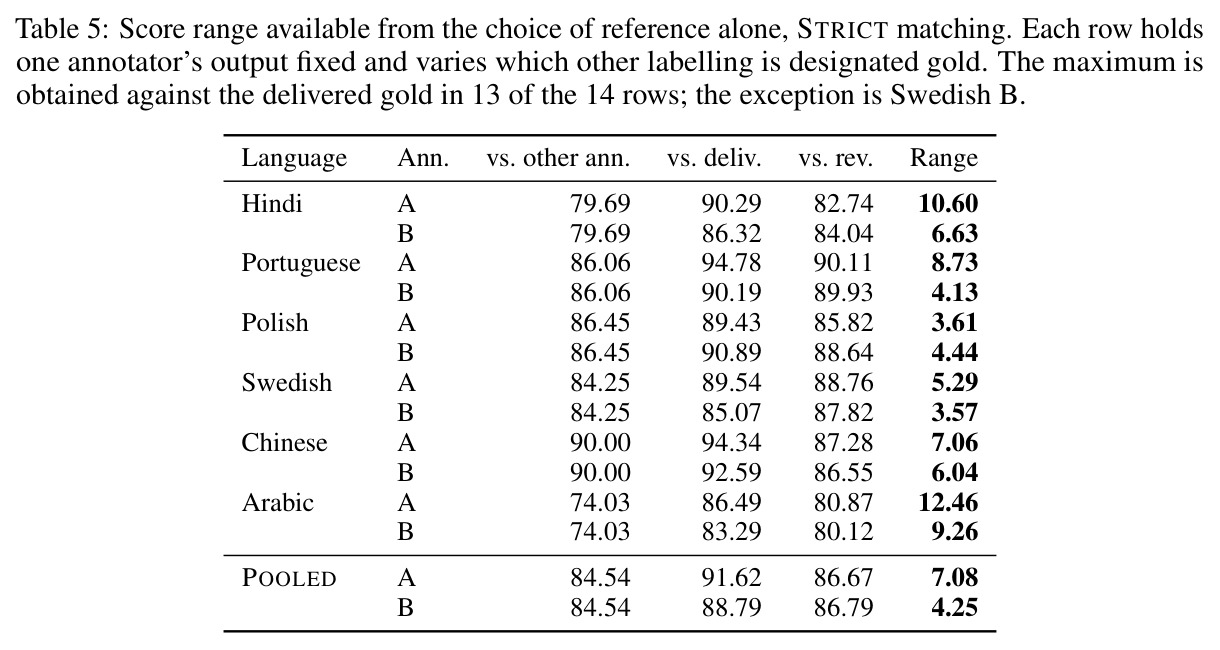
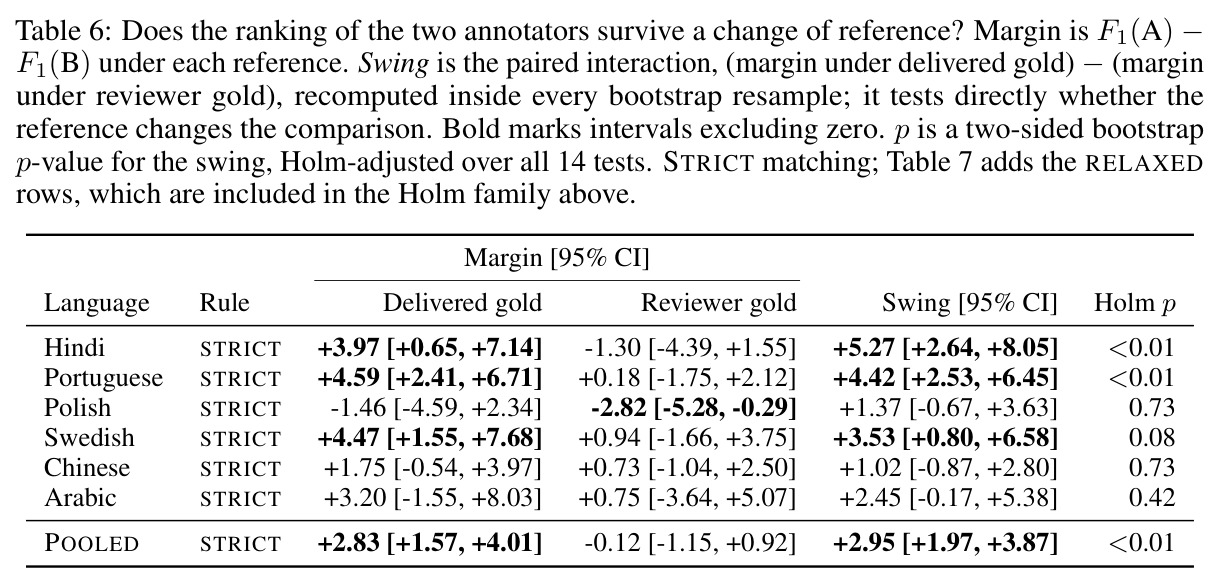
核心数字如下。(1) 换参考移动分数:固定 A 的输出,交付 gold 下得 91.62、reviewer gold 下得 86.67,$\Delta=+4.95$ F1(95% CI [+3.23, +6.27]);固定 B 则 $\Delta=+2.00$(CI [+0.26, +3.37])。最大单语言移动在印地语(+7.55,CI [+4.90, +10.91]),中文 +7.06(CI [+4.40, +9.86]);24 个语言×系统×规则组合中 13 个区间不含零;瑞典语为干净零效应(+0.78,CI [-7.42, +6.58]),因其 reviewer gold 本身偏向 A +5.3 点——两份参考共享偏斜时交换测不出东西。(2) 排名改变:池化配对交互 +2.95(CI [+1.97, +3.87]),Holm 校正后 p<0.01;印地语 +5.27(CI [+2.64, +8.05])、葡萄牙语 +4.42(CI [+2.53, +6.45])亦显著;印地语边际变号——交付 gold 下 A 领先 3.97(CI [+0.65, +7.14]),reviewer gold 下 A 落后 1.30(CI [-4.39, +1.55]),作者谨慎声明反向腿本身不显著。(3) 机制证据:交付 gold 再现 A 83.4%、B 76.1%,偏斜 +7.3 点且六语言全正(+2.7 至 +12.9);reviewer gold 偏斜仅 +0.04(70.55% 对 70.51%)。(4) 去污染检验:$n=135$ 上 A 的优势从 +2.83 跌至 -0.09(CI [-4.52, +4.51]),交互降至 +0.10,与自评解释一致但统计力不足。(5) 带宽对比:标注者边际池化 2.83、各语言 1.46–4.59,全部低于 6.3 点 STRICT 带宽,三个超过 3.4 点的严格带宽。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 固定输出换参考(六语言池化,STRICT) | $\Delta$ F1(95% CI) | A +4.95 [+3.23, +6.27];B +2.00 [+0.26, +3.37] | 同参考下 $Δ=0(分数按定义不变) | 参考选择单独造成的移动超过文中所有标注者间边际(最大 4.59 点) |
| 固定输出换参考(单语言极值) | $Δ$ F1 | 印地语 +7.55 [+4.90, +10.91] | 瑞典语 +0.78 [-7.42, +6.58](干净零效应) | 10 倍于瑞典语,说明敏感度是流水线性质而非普适常数 |
| 两输出排名稳定性(配对交互) | 交互点数(Holm 校正后 p 值) | +2.95 [+1.97, +3.87],p<0.01 | 朴素读法:分别比较两个 CI 是否含零 | 印地语边际变号(+3.97 → -1.30),朴素读法会漏掉真实变化 |
| gold 对标注者的偏斜诊断 | 再现率之差(百分点) | 交付 gold +7.3(A 83.4% vs B 76.1%),六语言全为正 | reviewer gold +0.04(70.55% vs 70.51%) | 系统性偏斜只出现在交付 gold,两行代码即可复检 |
局限与改进
作者承认的局限:测量来自单一标注记录,效应大小是该流水线的性质而非普遍规律,方法可迁移、数字不可迁移;reviewer 抽样的随机性只是文档声称、无法从导出验证,且受审子集比全语料更'容易'(池化一致性 84.5 对 79.6 STRICT),选择偏差更可能低估而非夸大效应;导出不含标注者 ID,所有结论是'标注遍'级别而非'人'级别,无法区分技能差异与惯例差异;受审子集仅 2,628 条,每语言 13–30 条的去污染子集区间全部跨零,无法确认或否定交互在去除自评后是否存续;被评输出是人工标注遍而非模型预测,效应量是否迁移到模型输出仍是经验问题;两名标注者共享指南、供应商与协议,相关性高于独立开发的系统。我的补充观察:RELAXED 规则仍要求边界完全相等、不给部分重叠记分,因此无法把残余差异分解为边界漂移与漏检;保密条款导致零数据公开,外部无法独立审计'98.7% 默认保留 A'等关键主张;带宽取 24 个 Δ 中最大值的 95% 上界、事后选择且未校正,作者虽自我声明,仍易被下游读者误读为误差棒。
独立分析的弱点
独立分析的弱点:第一,只评了人工标注遍,缺少模型输出实验,'自评膨胀'的大小只能靠 $n=135$ 间接推断,改进方向是构造合成流水线(已知聚合规则加模拟标注者)来分离自评与真实偏倚。第二,reviewer gold 虽近乎中立(+0.04),但每语言偏斜在 -2.3 到 +5.3 间波动,池化中立可能靠语言间抵消,改进方向是要求 reviewer 抽样按语言分层并记录随机化过程。第三,导出无标注者 ID,'谁更一致'不可追问,改进方向是在合同允许范围内发布匿名化的标注者级一致性指标。第四,第三遍仲裁的触发规则未记录(波兰语 25.1% 对印地语 61.3%,印地语在已一致的提示上也触发约 40%),跨语言比较因此被污染,改进方向是把仲裁策略作为显式配置写进数据卡。第五,只有两种匹配规则且都不给部分重叠记分,引入 IoU 阈值或软匹配可进一步定位边界约定的代价并分解误差。第六,单基准证据使外部效度存疑,最直接的补强是在公开多语言 NER 数据集(如 WikiANN、MultiNERD)上重复同一测量。
未来方向
作者建议的四项实践构成近期议程:保留并发布标注记录而非只发布聚合 gold;与分数并排报告参考敏感度带宽(小带宽是好结果而非实验失败);文档化聚合规则并做中立性检验(gold 对每位标注者的逐字再现率);按语言报告标注者一致性(本文六语言相差 16 点)。基于本文可延伸的方向:其一,把带宽计算做成开源工具,输入任意保留多份标注的数据集即可输出带宽与配对交互检验,供排行榜采用;其二,在模型输出上重复测量,检验人工遍上的效应量对模型间比较是低估还是高估;其三,做聚合规则的因果实验——用同一份双标注数据分别模拟'保留 A''保留 B''随机选择''合并'四种规则,直接测量规则选择对排行榜排序的重排幅度;其四,把边界分歧当作信号而非噪声,为分歧大的提示生成多参考评分或软标签;其五,系统审计仲裁策略不均(印地语 61.3% 对波兰语 25.1%)对跨语言结论的影响,避免跨语言排名隐含协议差异。
复现评估
复现难度较高,卡点在数据而非方法。论文因客户合同与保密协议不发布任何语料文本、实体值或标注者 ID,只报告聚合统计与类型标签,因此'98.7% 默认保留 A''94.9% 逐字再现'等关键数字无法用原始数据独立验证,文中也没有公开代码仓库链接。方法本身描述充分:受审子集构成($n=2{,}628$ 及每语言条数)、STRICT/RELAXED 定义、micro-F1 汇总方式、2,000 次固定种子的提示级配对分层 bootstrap、Holm 校正、去污染协议、四种重复数据处理稳健性检查全部写明,附录还给出一致性的完整定义(附录 E)和虚构示例(附录 F),任何持有双标注数据集的团队都能照公式重实现,计算成本可忽略(纯 CPU 统计)。务实的复现路径:取一份保留双标注的公开多语言 NER/PII 数据集,实现 gold 再现率诊断与配对交互检验,即可得到本文核心结论的可迁移版本;要精确复现本文数字则需要拿到该生产基准的标注导出,对学术研究者基本不可行。
论文图表