SILSA:基于滑动窗口切片潜变量的拓扑保持高分辨率三维生成 SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation
以三轴滑动窗口切片潜变量取代体素token,单阶段生成拓扑正确的高分辨率3D形状
前置知识
切片潜变量(Slice Latents)
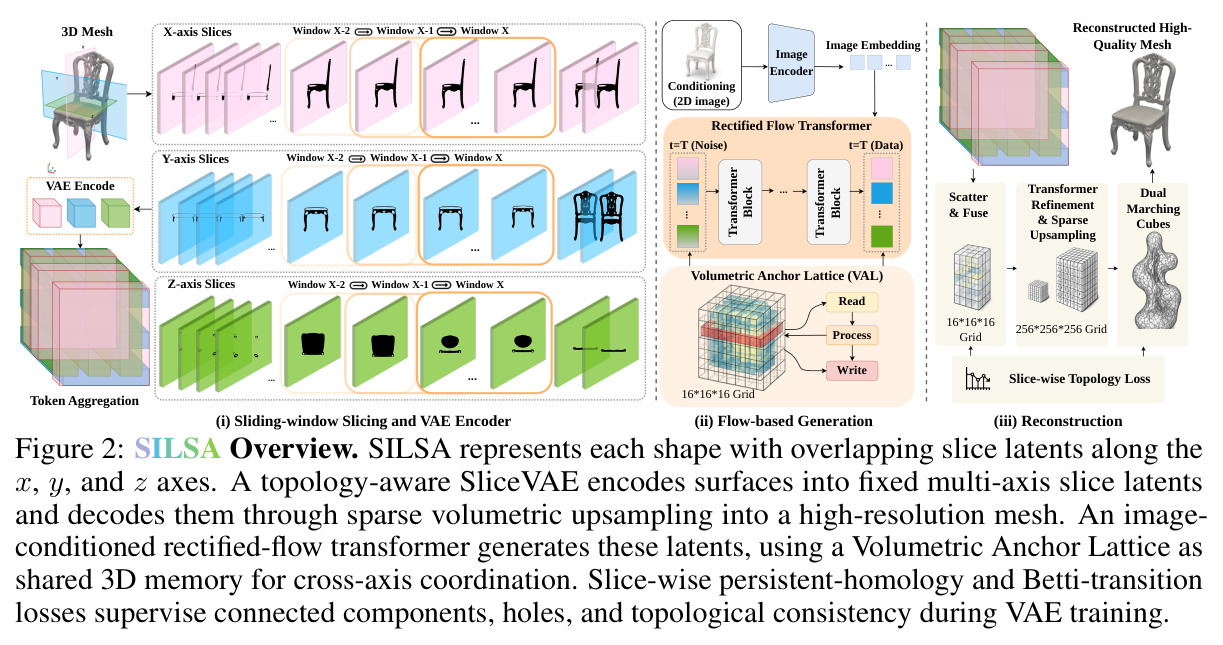
把三维形状沿 $x$、$y$、$z$ 三个正交轴各切成 $N$ 个带厚度的平面 bin,每个 bin 用一个潜变量 token 概括滑动窗口内(前后各 $w/2$ 个 bin)的局部几何。token 总数固定为 $3N$,与物体占用率和复杂度无关,且因窗口重叠而保持截面连续性。
这是本文的核心表示,理解它才能理解为何能固定 token 数、单阶段生成并保住拓扑结构。
变分自编码器(VAE)
编码器把输入映射为高斯后验参数 $(\mu, \log\sigma)$,训练时从后验采样并施加 KL 散度正则把潜空间拉向标准正态分布 $\mathcal{N}(0, I)$;训练完成后用后验均值作为确定性潜变量。它让潜空间平滑规整,便于后续生成模型建模。
SILSA 的 SliceVAE 是流水线第一步,整流流模型学的正是这个 VAE 潜空间的分布。
整流流(Rectified Flow)
一类流匹配生成模型:把数据 $\mathcal{Z}^{(0)}$ 与噪声 $\epsilon$ 沿直线插值 $\mathcal{Z}^{(t)}=(1-t)\mathcal{Z}^{(0)}+t\epsilon$,网络学习该直线路径上的速度场 $(\epsilon-\mathcal{Z}^{(0)})$,采样时积分常微分方程即可生成。训练目标简单稳定、推理步数少。
SILSA 的生成器就是一个以 DINOv2 图像特征为条件的整流流 transformer。
持久同调与持久图(Persistent Homology)
拓扑数据分析工具:对占用图做超水平集过滤,记录每个拓扑特征(连通分量 $d=0$、孔洞 $d=1$)出现与消失的时刻,构成(出生,死亡)对集合即持久图;持久度 $pers = b_p - d_p$,持久度大的是真实结构,小的是噪声。可配合瓶颈距离或匹配损失比较两个持久图。
论文的切片级拓扑损失 $\mathcal{L}_{PH}$ 靠匹配预测与真值截面的持久图来保持每个切片内部的拓扑正确。
Betti 数与 Betti 转变
Betti 数 $\beta_d$ 统计第 $d$ 维同调类的个数:$\beta_0$ 是连通分量数、$\beta_1$ 是孔洞数。沿切片轴计算相邻截面的 Betti 数之差 $\Delta B_{k,d} = B_{k+1,d} - B_{k,d}$,非零转变对应拓扑事件(分量或孔洞的出现、消失、合并、分裂)发生的深度位置,据 Morse 理论与临界点一一对应。
$\mathcal{L}_{trans}$ 通过对齐相邻切片的 Betti 转变序列,约束拓扑沿深度轴在正确位置演化。
SDF 与 Dual Marching Cubes
符号距离场(SDF)在每个网格角点存储点到表面的带符号距离;Dual Marching Cubes 在 SDF 的对偶网格上放置顶点并连接成面,从 $256^3$ 体素网格中抽取三角网格。SILSA 使用其可微版本,使渲染损失能够一路反传到 SDF 预测头。
解码器的最终输出就是 $256^3$ 分辨率的 SDF 网格加顶点形变,经 Dual Marching Cubes 得到网格。
研究动机
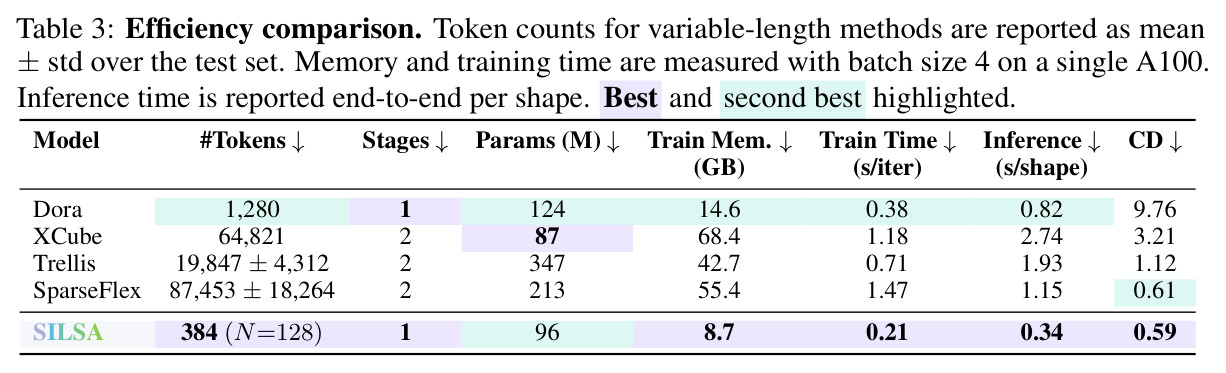
高分辨率三维生成普遍依赖体素潜变量与多阶段流水线:先预测哪些体素活跃,再为活跃体素合成局部几何。稠密体素的显存与计算随分辨率立方增长;稀疏体素、八叉树与层级 token 化器(Trellis、XCube、SparseFlex 等)虽只建模被占用区域,但 token 数量随表面积数据相关地膨胀——实测 Trellis 平均需 19,847 个 token,SparseFlex 高达 87,453 个,且都要两阶段生成。另一类紧凑表示(集合形潜变量、三平面、基元)虽然便宜,却削弱了 token 与局部几何的对应:模型可以在表面或渲染误差很低的同时填掉孔洞、打断细支撑、把相邻部件粘连成虚假桥接。自行车轮辐条、植物分支这类薄而强连通的结构尤其容易损坏,拓扑一致性难以保证。
本文的目标是本文目标是构建一个拓扑感知的图像到三维生成框架:在保留高分辨率几何细节(薄壁、孔洞、重复部件、长程连通)的同时,把潜变量序列压缩为与物体复杂度无关的固定长度,从而去掉活跃体素预测阶段、实现真正的单阶段生成。量化目标包括:在 Toys4K 的 200 个资产与 50 张真实图像上超越最强基线 SparseFlex 和 Trellis 的 FD、PSNR、COV、MMD 等指标;Betti 误差相对最强重建基线降低 9.2%;token 数压缩到固定 384 个,比次紧凑基线少 70.0%,训练显存降低 40.4%,单形状推理时间缩短 58.5%。
与已有工作不同的是,作者的独特洞察在表征层面:一个带厚度的切片能在单个 token 内连贯地捕获整个平面区域的拓扑,而体素 token 把连续表面切碎成大量局部单元、集合潜变量又丢失了空间对应;沿轴排列的切片序列还天然暴露连通分量、孔洞与部件边界沿深度方向的演化规律。据此 SILSA 把形状分解为沿 $x/y/z$ 三轴的滑动窗口切片潜变量。与只在重建任务中利用切片几何线索的 OReX 不同,本文首次把多轴切片作为可学习的生成式潜变量;拓扑监督也刻意只在切片内匹配持久图、在相邻切片间对齐 Betti 转变,从而避免了全体积拓扑匹配的高昂计算开销。
核心方法
SILSA 由三部分组成:拓扑感知 SliceVAE、切片级拓扑损失,以及带体积锚格(Volumetric Anchor Lattice, VAL)的单阶段整流流生成器。整体流水线是:给定网格先采样带法向的点云 $P$,把包围盒沿每轴切成 $N=128$ 个平面 bin,用宽度 $w=8$ 的滑动窗口聚合邻近 bin 内的点,经共享 MLP 与最大池化得到 $3N=384$ 个切片潜变量。生成阶段冻结 VAE,训练整流流 transformer 从 DINOv2 图像特征生成这 384 个潜变量:每个切片 token 按自身轴与深度位置读写 VAL 中 $16^3$ 共享网格的对应平面,让三轴证据在同一三维工作区累积,保证跨轴一致。解码时把三轴潜变量散射进粗网格并归一化求和融合,经稀疏 transformer 与两级自剪枝上采样把分辨率从 $16^3$ 提到 $256^3$,线性头预测 SDF 值、顶点形变与插值权重,最后用可微 Dual Marching Cubes 抽取高质量网格。
核心创新有三点。其一,切片 token 概括的是一个局部深度窗口而非无限薄平面,因此单个 token 就能完整保留截面上的薄壁、孔洞与近邻表面,且 token 数固定为 $3N$,与占用率、表面积和部件复杂度无关——这是与稀疏体素/层级 token 化器(token 数随形状变化、需两阶段)的本质区别。其二,VAL 把跨轴一致性转化为空间通信机制:三个轴的切片流在去噪过程中读写同一个 $D^3$ 网格中各自轴向的锚平面,token 与平面的对应是纯几何的、无需学习,无约束的轴间注意力被共享空间记忆取代。其三,切片级拓扑监督只在切片内匹配持久同调、在相邻切片间对齐 Betti 转变,把“拓扑正确性”以极小代价直接写进训练目标,而以往方法要么不监督拓扑,要么做昂贵的全体积匹配。
方法步骤详情
第一步(编码):点按 $\lfloor p^{(j)} N \rfloor$ 落入各轴的 $N=128$ 个 bin,第 $k$ 个 bin 聚合 $[k-w/2, k+w/2)$($w=8$)内的点,每点附加深度偏移 $\delta(p)=\lfloor p^{(j)} N \rfloor - k$,共享 MLP 加最大池化得 $h^j_k$,映射为高斯后验 $(\mu^j_k, \log\sigma^j_k)$;流训练用后验均值,空 bin 用可学习嵌入。第二步(解码):三轴潜变量按 $\Pi_a(u) \mathrel{+}= \frac{1}{|K_u|}\sum_{k \in K_u} W_a z^a_k$ 散射进 $16^3$ 网格,稀疏 transformer 精炼后经两级自剪枝上采样至 $256^3$,线性头预测 SDF、顶点形变与插值权重,Dual Marching Cubes 抽取网格。第三步(VAE 训练):$\mathcal{L}_{VAE} = \mathcal{L}_{render} + \beta_{KL}\mathcal{L}_{KL} + \lambda_{topo}\mathcal{L}_{topo}$,渲染损失为深度/法向/轮廓图的 L1;在 $N_s$ 个采样截面上把 SDF 转为软占用 $\hat{S} = \sigma(-\hat{s}/\kappa)$,$\mathcal{L}_{PH}$ 匹配持久图、$\mathcal{L}_{trans}$ 对齐 Betti 转变 $\Delta B$,离散 Betti 计数经直通估计器反传。第四步(流生成):以 $\mathcal{Z}^{(t)} = (1-t)\mathcal{Z}^{(0)} + t\epsilon$ 训练速度场;每个 transformer 块依次执行轴内自注意力、VAL 锚读取、门控锚写入 $\mathcal{G}_{j(k)} \leftarrow (1-z_g) \odot \mathcal{G}_{j(k)} + z_g \odot f_w$、图像交叉注意力与 FFN。
技术新颖性
技术新颖性体现在三个层面。表征上,多轴滑动窗口切片首次被用作生成式潜变量:固定 384 个 token 比 Trellis、XCube、SparseFlex 少 98% 以上,却仍保留 token 与空间位置的几何对应,兼得紧凑表示的效率与体素表示的空间接地性。监督上,把持久同调与 Betti 转变限制在切片与相邻切片对上,是首个以切片为单位的拓扑损失设计,并用直通估计器解决离散 Betti 计数的梯度问题,避免了全体积拓扑匹配的开销。架构上,VAL 是持久三维特征网格形式的共享空间记忆,消融显示其优于无约束的轴间直接交叉注意力(CD 0.59 对 0.60,Betti 1.58 对 1.64,且 IoU 权衡更稳),$D=16$ 的分辨率取得最佳性价比,整个生成器为单阶段、96M 参数。
实验结果
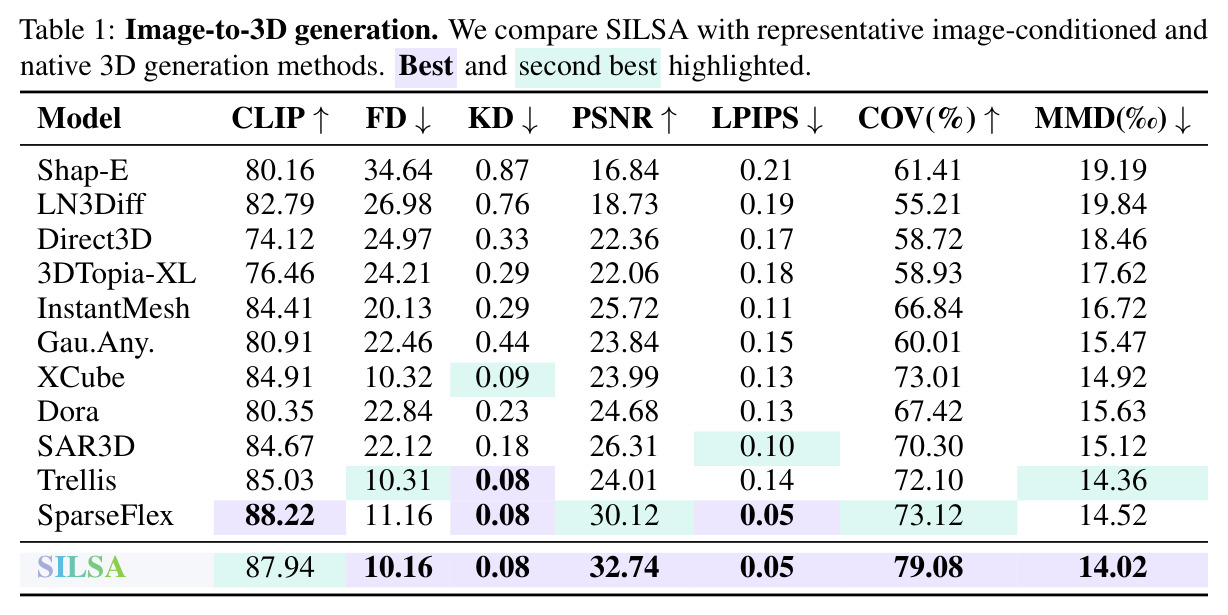
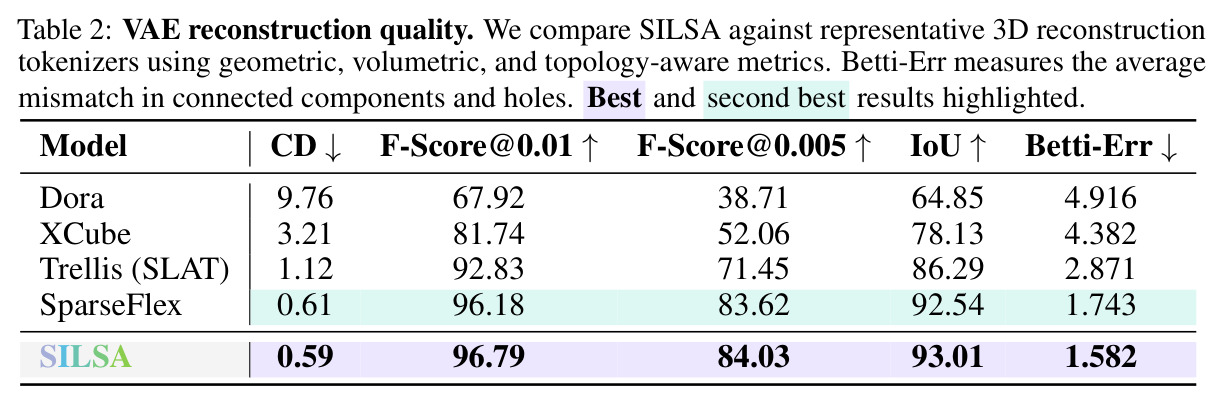
图像到三维(Table 1):SILSA 取得最佳 FD 10.16、PSNR 32.74、COV 79.08%、MMD 14.02‰,较最强基线 SparseFlex(PSNR 30.12、COV 73.12%)提升 8.7% 与 5.96 个绝对点,KD 0.08 与 LPIPS 0.05 并列最佳,CLIP 87.94 略低于 SparseFlex 的 88.22。VAE 重建(Table 2):CD 0.59、F-Score@0.01 96.79、F-Score@0.005 84.03、IoU 93.01 全面领先,Betti 误差 1.582 较 SparseFlex 的 1.743 降低 9.2%,表明连通分量与孔洞被真实保留而非只改善表面误差。效率(Table 3):384 个固定 token 较次紧凑的 Dora(1,280)少 70.0%、较 Trellis/XCube/SparseFlex 少 98% 以上;单阶段、96M 参数、训练显存 8.7GB(Dora 14.6GB)、0.21s/iter、推理 0.34s/形状(Dora 0.82s)。消融(Table 4):去掉拓扑损失 Betti 误差升至 4.43;$\mathcal{L}_{PH}$ 与 $\mathcal{L}_{trans}$ 单用分别为 2.91 和 2.87,合用最优 1.58,二者互补;无跨轴通信时崩溃(CD 5.87、IoU 49.26、Betti 17.91),直接交叉注意力(0.60/93.18/1.64)略逊于 VAL(0.59/93.01/1.58);VAL 分辨率 $D=16$ 优于 $D=8$ 与 $D=32$。
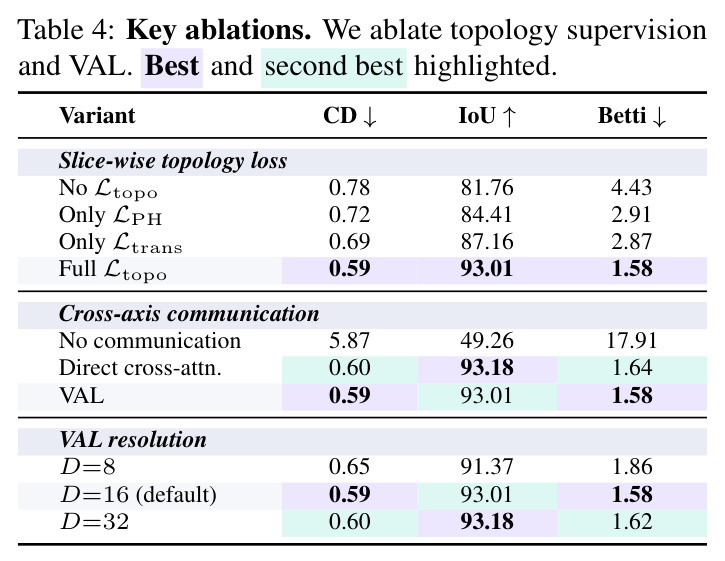
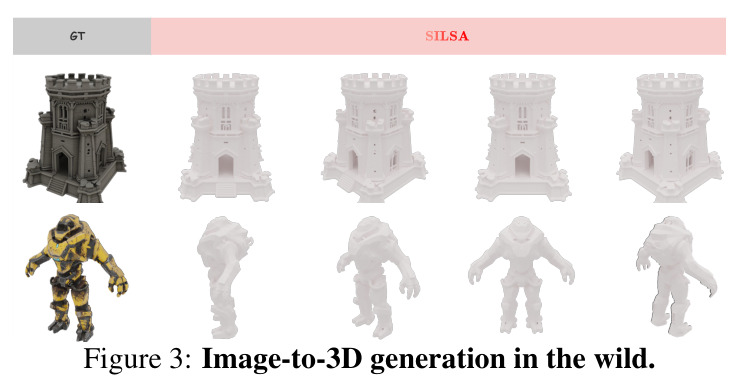
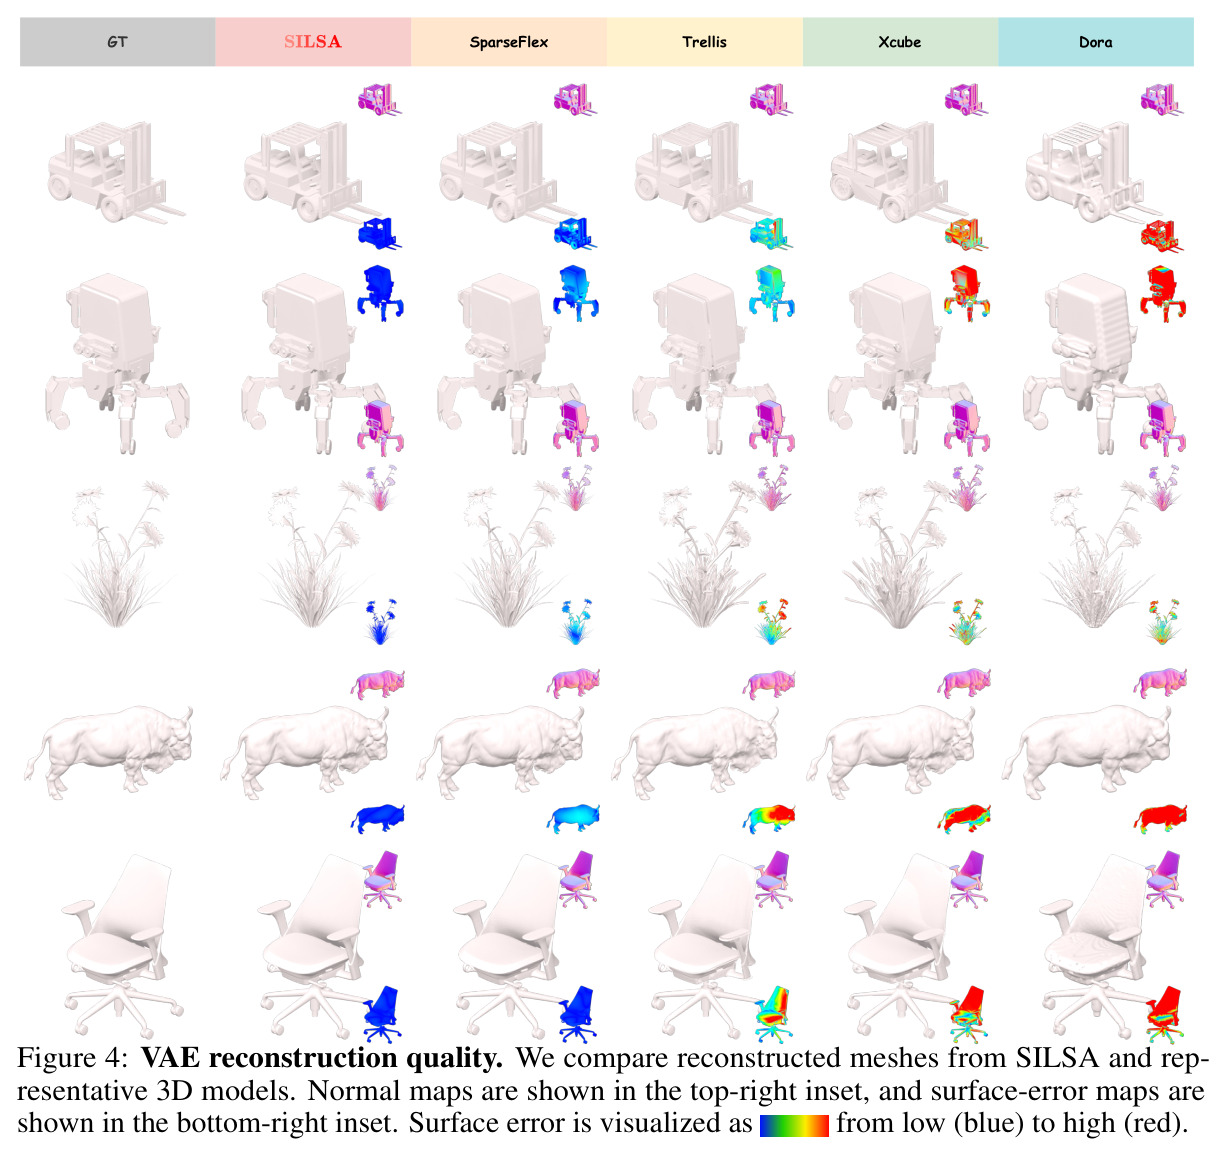
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像到三维生成(Toys4K 200 资产 + 50 真实图像) | FD ↓ | 10.16 | Trellis 10.31 / SparseFlex 11.16 | 全场最低,比 Trellis 低 0.15 |
| 图像到三维生成 | PSNR ↑ | 32.74 | SparseFlex 30.12 | +8.7% 相对提升 |
| 图像到三维生成 | COV (%) ↑ | 79.08 | SparseFlex 73.12 | +5.96 绝对点 |
| 图像到三维生成 | MMD (‰) ↓ | 14.02 | Trellis 14.36 | 全场最低 |
| 图像到三维生成 | CLIP ↑ | 87.94 | SparseFlex 88.22 | 次佳(-0.28),图像对齐略让步 |
| VAE 重建 | CD ↓ | 0.59 | SparseFlex 0.61 | 全场最低 |
| VAE 重建 | F-Score@0.01 ↑ | 96.79 | SparseFlex 96.18 | +0.61 |
| VAE 重建 | IoU (%) ↑ | 93.01 | SparseFlex 92.54 | +0.47 绝对点 |
| VAE 重建 | Betti-Err ↓ | 1.582 | SparseFlex 1.743 | -9.2% 相对降低,拓扑保真核心证据 |
| 效率 | Token 数 ↓ | 384(固定) | Dora 1,280 / SparseFlex 87,453±18,264 | 较 Dora 少 70.0%,较稀疏/层级 token 化器少 98%+ |
| 效率 | 训练显存 ↓ | 8.7 GB | Dora 14.6 GB | -40.4%(单张 A100,batch 4) |
| 效率 | 推理时间 ↓ | 0.34 s/形状 | Dora 0.82 s/形状 | -58.5%,且为单阶段生成 |
局限与改进
作者与本文共同观察到的局限:其一,固定 $N=128$ 个 bin 与 $w=8$ 的窗口均为人工设定的超参,对极端复杂或极细密的结构可能容量不足,窗口边界处靠 clamp 处理也略显粗糙;其二,拓扑损失只覆盖 $d=0,1$ 维(连通分量与孔洞),未处理三维空腔等高阶同调,且仅在 $N_s$ 个均匀采样的截面上计算而非全体积监督;其三,Betti 计数是离散的,前向阈值化加直通估计器的梯度存在偏差,作者未分析该偏差的影响;其四,评测规模偏小(200 个 Toys4K 资产 + 50 张真实图像),缺少 GSO、OmniObject3D 等更大基准与用户研究;其五,SDF 与 Dual Marching Cubes 隐含水密表面假设,对 SparseFlex 所擅长的开放薄壳是否适用文中未讨论;另外 VAL 每次锚写入把单一向量广播到整个 $D^2$ 平面,平面内没有空间变化,可能限制表达容量,CLIP 分数也以 0.28 之差略逊于 SparseFlex。
独立分析的弱点
独立分析几处弱点并给出改进方向。第一,固定 384 token 对拓扑极端复杂的物体(密集格栅、植被分支)可能欠拟合,且滑动窗口使相邻 bin 特征高度相关、信息冗余,可尝试按几何熵自适应调整切片密度或引入粗细两级切片。第二,拓扑监督止步于 $H_0/H_1$,无法约束三维空腔与更全局的结构关系,可扩展 $H_2$ 持久性或 Reeb 图监督。第三,直通估计器对离散 Betti 计数的梯度有偏,可改用可微持久同调层或软化的拓扑计数。第四,VAL 的锚写入把一个向量广播到整个 $D^2$ 平面,截面内的局部差异无法编码,可让 token 只写对应空间邻域或写入低秩平面特征。第五,SDF 假设水密表面,对布料、叶片等开放薄壳需改用 UDF 或符号无关场;第六,评测偏玩具类别且规模小,需在真实扫描数据上验证泛化,拓扑损失的 $\lambda_{PH}, \lambda_{trans}, \kappa, N_s$ 等超参也需要敏感性分析。
未来方向
作者方向之外的延伸:其一,把切片潜变量推广到文本条件、多视图条件生成乃至场景级多物体生成,切片的轴向结构对场景分解天然友好;其二,拓扑监督可推广到更高阶同调、跨分辨率切片一致性,甚至引入对抗性拓扑判别器;其三,VAL 的共享空间记忆思想可迁移到 4D 动态生成(把时间作为第四维锚格)与可编辑生成——用户直接修改某个切片的拓扑,再让模型协调其余切片保持整体一致;其四,切片表示与 Marching Cubes 结合天然支持增量式 LOD 与流式传输,适合下游图形管线;其五,把渲染损失换成 PBR/纹理监督可实现带材质的一体化生成;与可微持久同调库结合做端到端拓扑梯度、以及把拓扑指标作为生成质量评测标准,都是值得探索的方向。
复现评估
论文附有项目主页(plan-lab.github.io/silsa),实现细节在 Appendix C 中给出,但提供的正文未明确承诺开源代码与权重,复现前需先确认。训练数据为公开的 Trellis-500K,评测用 Toys4K 的 200 个资产与 50 张真实图像;模型仅 96M 参数,效率测试在单张 A100(batch size 4)完成,训练显存 8.7GB,实验室级算力即可承担。复现难度中等偏高:需要点云采样与法向估计、持久同调计算库(gudhi/ripser)、直通估计器、自剪枝稀疏上采样与可微 Dual Marching Cubes 的正确实现,拓扑损失的 $\lambda_{PH}, \lambda_{trans}, \kappa, N_s$ 与 $w, N$ 等超参较敏感;若官方开源代码与配置,成本将大幅降低。
论文图表
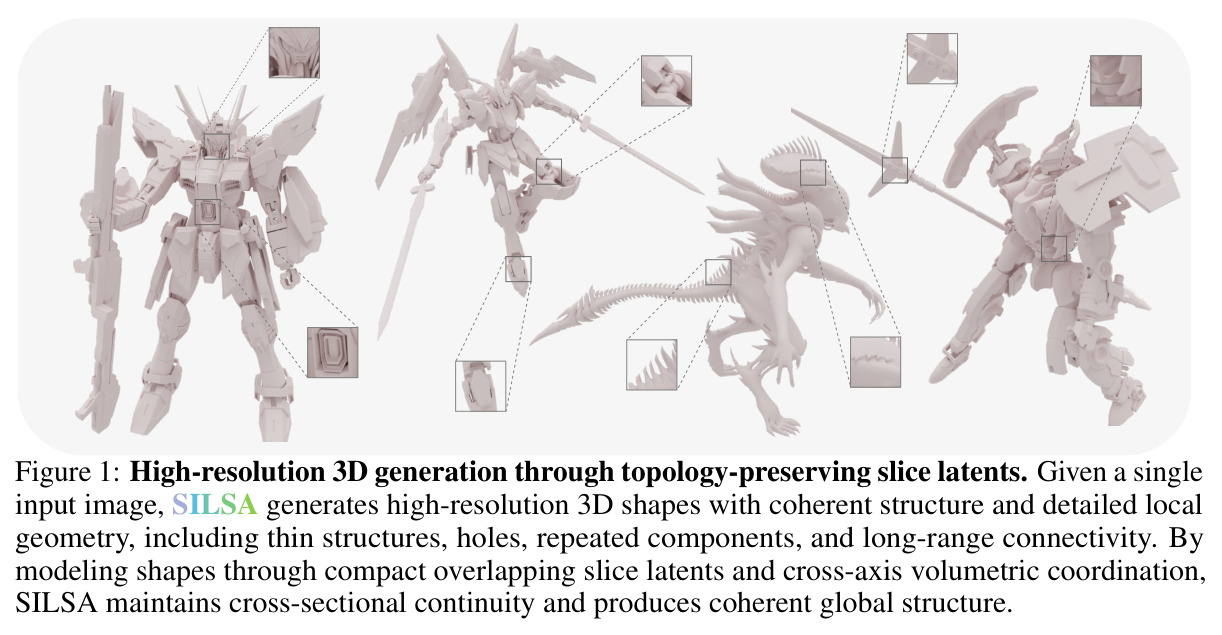
开篇 teaser 图:输入单张图像,SILSA 生成具有连贯全局结构和精细局部几何的高分辨率三维形状,重点展示细薄结构、孔洞、重复部件与长程连通性的保持效果,并通过重叠切片潜变量与跨轴体积协调维持截面连续性。
直观呈现论文的核心卖点——拓扑保持能力——以及任务设定(单图输入、高分辨率输出),是理解论文动机的最佳入口。