HumanoidToolBench:从工具选择到移动执行的类人机器人工具使用基准 HumanoidToolBench: Benchmarking Humanoid Tool Use from Selection to Mobile Execution
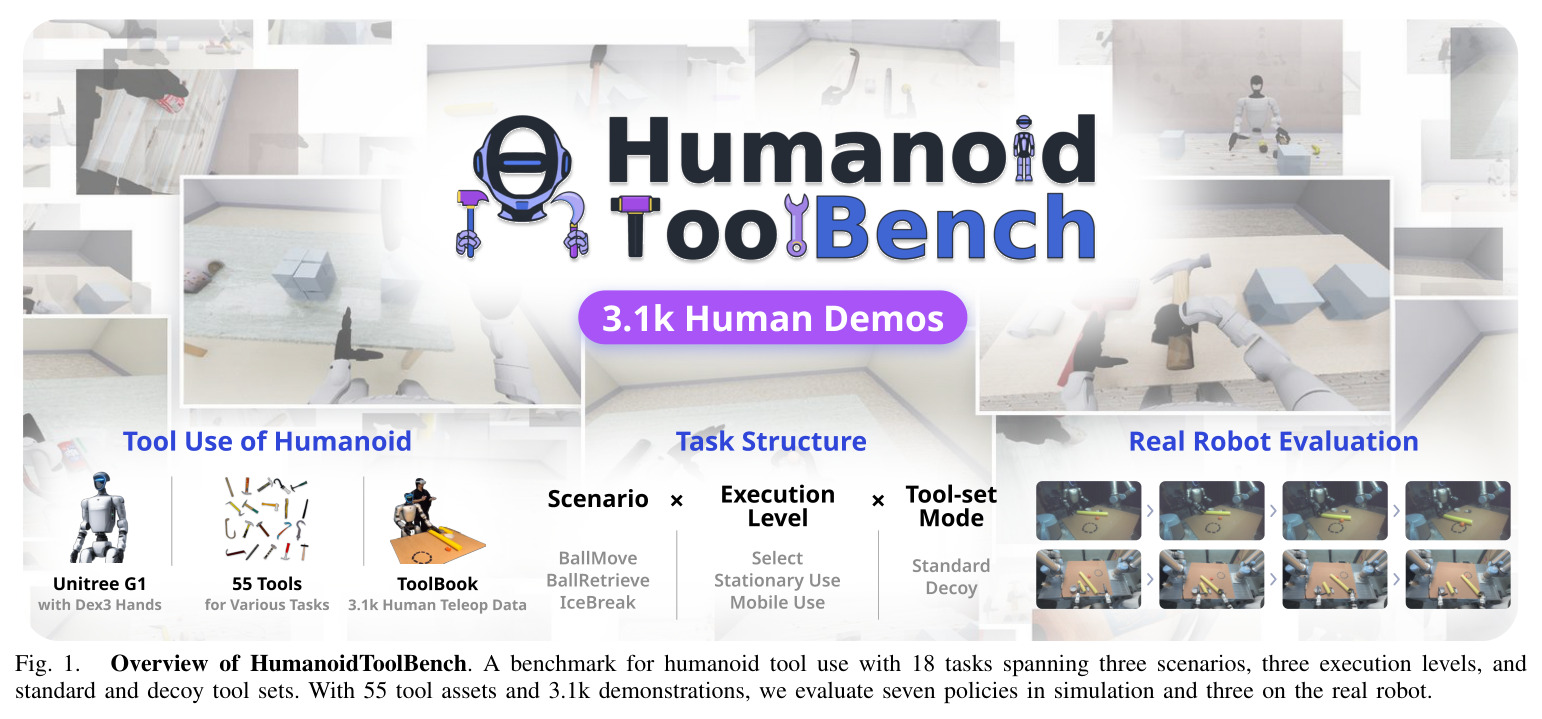
首个贯通工具选择、站立使用与移动使用的 18 任务人形机器人基准
前置知识
VLA(视觉-语言-动作模型)
在大规模视觉-语言模型基础上,用机器人操作演示数据微调出的端到端策略:输入头部相机图像与语言指令,直接输出机器人关节动作序列,通常配合扩散或流匹配动作头,并以动作分块方式一次预测多步。本文比较的 GR00T N1.7(3.14B)、Ψ0(2.63B)、π0.5(3.62B)都属于这一类。
本文 7 个被测策略中 3 个是 VLA,『VLA 会选工具却不会用工具』的核心结论正是围绕这类模型得出的。
POMDP(部分可观测马尔可夫决策过程)
智能体无法直接观测环境完整状态,只能获得观测 $o_t$,需基于历史 $h_t=(o_0,a_0,\dots,o_t)$ 决策。本文将每个任务建模为 $M=(S,A,O,P,\Omega,G)$,用二元成功判据 $G(\tau)\in\{0,1\}$ 替代奖励函数,策略评估即估计成功率。
论文第 III 节的任务形式化完全建立在 POMDP 上,语言目标不点名合适工具、只能从图像推断,正是部分可观测性的体现。
动作分块(Action Chunking)
策略一次预测未来 $k$ 步动作并开环依次执行,再重新查询观测。好处是降低查询频率、动作时序更连贯,代价是开环执行期间无法根据环境反馈中途纠错。不同模型的分块长度差异很大。
评估协议规定每个策略用各自训练时的 chunk 长度开环执行(ACT 100 步、GR00T N1.7 40 步、FastWAM 32 步等),这直接影响长时程工具任务的失败模式。
Sim2Real 迁移与少量真机微调
在仿真数据上训练的策略迁移到真实机器人时通常因视觉与动力学差异而性能下降,常见补救是用少量真实演示在仿真权重基础上继续微调。本文用 91 条真机演示对仿真训练好的策略再微调 5,000 步即上真机评估。
真机实验的核心设定是 sim+real training,『仿真强弱排序能否在真机保持』是验证基准有效性的关键一环。
诱饵对照(Decoy)实验设计
在候选集中加入一个与正确答案仅在任务关键属性上不同的干扰项:如与合格工具等质量但只有 0.30 m 的短棍、长度质量相同但无弯钩的直棍、代替金属锤的轻质苍蝇拍。指令与无关物体完全不变,只改变替代选项。
标准/诱饵双模式是本文『功能性选择』原则的落地方式,诱饵模式下成功率的系统性下降才能归因于属性推理而非外观熟悉度。
研究动机
机器人社区的评测长期把『会用工具』这件事拆散在不同基准里,没人把链条接起来。HumanoidBench 在人形平台上只有勺子进食和擦窗两类固定任务,从不要求机器人在功能属性相互冲突的候选中做选择;PhysToolBench 用视觉问答考多模态大模型对物理工具的理解,完全不动手执行;DexCraft 限定单臂、且工具由系统直接提供,只考察抓取;RoboWits 让双臂机器人在意外情境下选工具,却缺少渐进难度层级,更不涉及行走中使用工具。于是一个关键问题悬而未决:一个人形机器人即使挑对了工具,能否真的拿着它走过去完成推球、勾球、砸冰?『选择能力』与『执行能力』之间的对应关系从未被联合测量过,失败到底出在挑错工具还是用不好工具也无从定位。
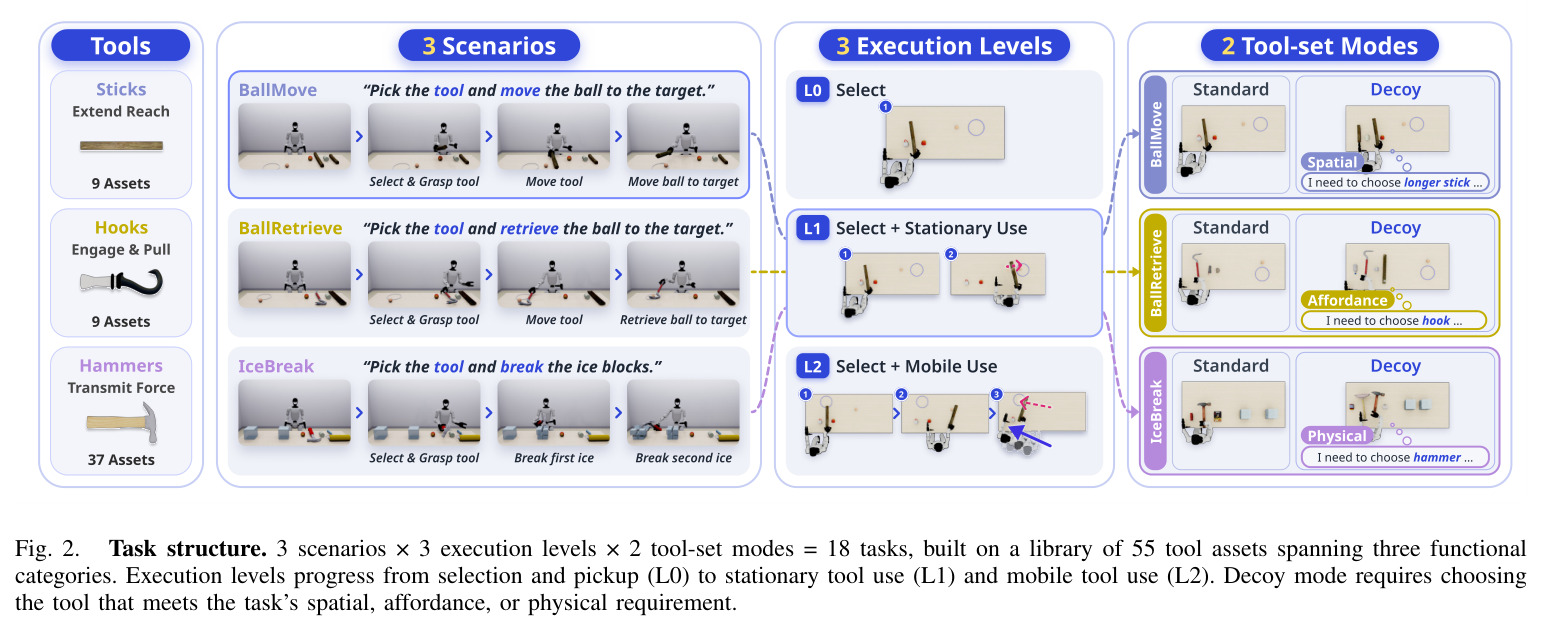
本文的目标是本文要构建一个把工具使用全流程拆成可定位阶段的评测体系,目标有三层。第一,设计 18 个任务:3 个场景(BallMove 需要足够长的棍把球推进 0.12 m 圆形目标区,考察延伸触达;BallRetrieve 需要钩子勾住球的远侧拉回,考察形状可供性;IceBreak 需要金属锤砸碎两块冰,考察传力属性)× 3 个执行层级(L0 选择并拾起、L1 原地站立使用、L2 边移动边使用)× 2 种工具集模式(Standard 含唯一合适工具加两个无关物,Decoy 额外加入仅在关键属性上欠缺的诱饵工具)。第二,发布 ToolBook 数据集:3,003 条仿真轨迹加 91 条真实 Unitree G1 演示共 3,094 条人类遥操作数据。第三,用 7 个策略的仿真横向对比和 3 个策略的真机验证,量化『会选』与『会用』之间的鸿沟。
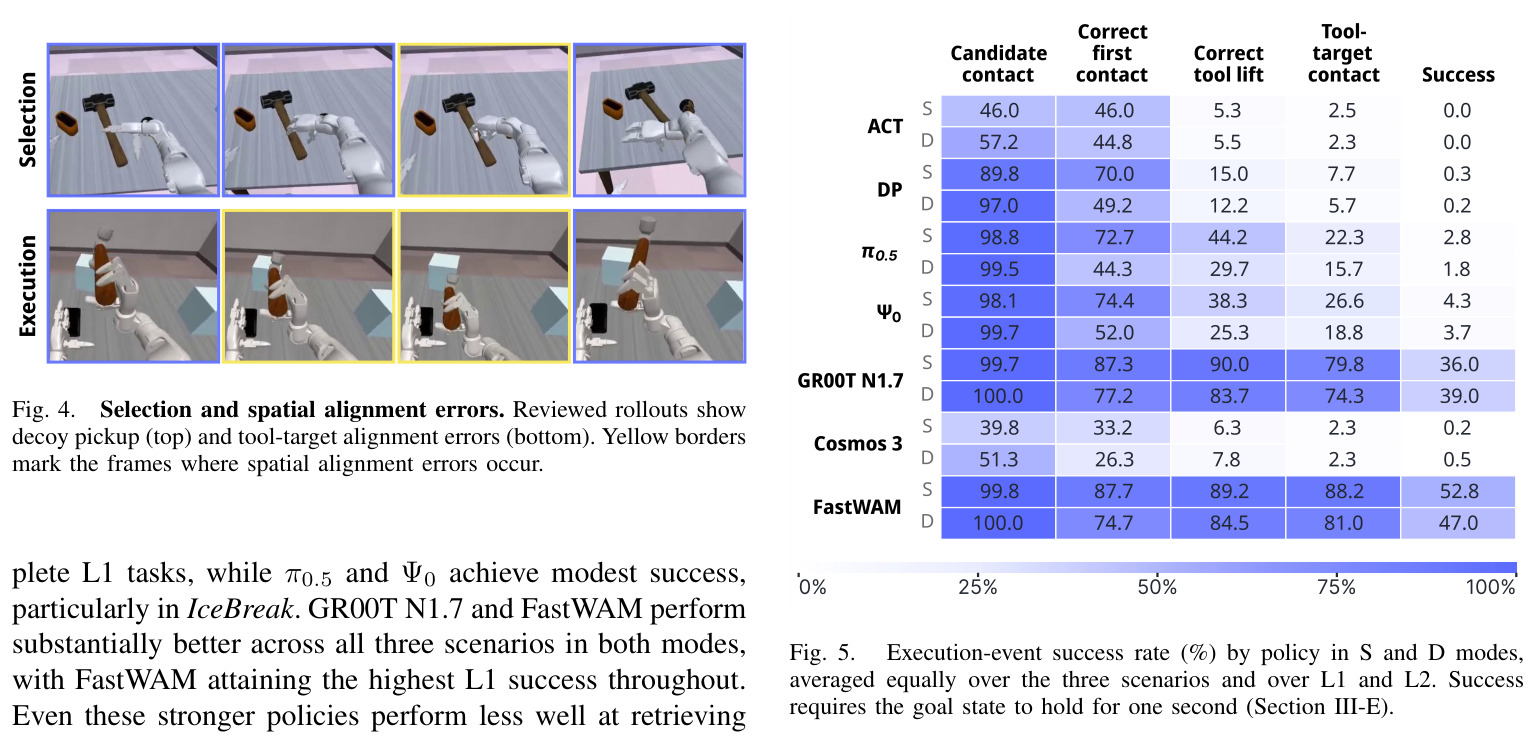
与已有工作不同的是,本文的独特切入是把『选择』与『执行』解耦为两条正交评估轴。此前的基准要么测理解不测执行(PhysToolBench),要么执行时工具是给定的(DexCraft),要么有意外选择但无层级递进(RoboWits),且没有任何工作在人形平台上做这件事。HumanoidToolBench 用 L0/L1/L2 把『获取工具』与『用工具达成目标』分开计分;用 decoy 模式在完全相同的指令下只增删一个属性受控的诱饵;再配合 episode 内自动记录的五类交互事件(候选接触、正确首次接触、正确工具抬升、工具-目标接触、任务成功),把最终成败归因到具体环节。这套组合能揭示单一成功率掩盖的现象:比如策略先摸了诱饵再中途换对工具、或者频繁接触正确工具却始终完不成任务。
核心方法
直觉上,这个基准像一场『自己去工具箱挑家伙再干活』的实践考试,而不是给定工具的实操考试。形式化上,每个任务是目标条件 POMDP $M=(S,A,O,P,\Omega,G)$:语言目标 $g$ 只描述任务而不点名合适工具 $b^\star$,策略必须从候选集 $B$ 中推断选谁。观测 $o_t=(I_t,x_t)$ 由头部相机图像和 32 维机器人状态(14 手 + 14 臂 + 3 腰关节 + 1 底座高度指令)组成,不含物体信息,候选识别只能靠图像与 $g$;动作 $a_t\sim\pi_\theta(\cdot\mid h_t,g)$ 为 36 维(含 4 维移动指令 $u_t=(v_x,v_y,m,\psi^\star)$),双足步态由预训练 GR00T Balance/Walk 强化学习控制器执行。成功判据 $G(\tau)\in\{0,1\}$ 替代奖励:L0 要求 $b^\star$ 抬升至少 0.08 m,L1/L2 要求达成场景目标(球进入 0.12 m 圆形区域或冰块碎裂)并保持 1 秒,最终报告成功率 $\hat{J}(\pi_\theta)=\frac{1}{N}\sum_{i=1}^{N}G(\tau^{(i)})$。
全文最重要的设计是三个原则的叠加,其中最有区分度的是『功能性选择』。环境在 MuJoCo 中实现,机器人是带双 7 自由度 Dex3 手的 Unitree G1;55 个工具资产来自 Objaverse 并经 MolmoSpaces 筛选,分三类:9 根延伸触达的棍、9 个勾取的钩、37 把传力的锤,且扫描件在颜色纹理上也有变化。诱饵工具经过精确的属性控制——只在任务要求的关键属性上与 $b^\star$ 不同:BallMove 的诱饵是等质量但仅 0.30 m 的短棍(合适者为 0.50 m),BallRetrieve 的诱饵是长度质量与钩相同的直棍,IceBreak 的诱饵是轻质可变形的苍蝇拍、油漆滚筒或搋子(对手为金属锤)。这样诱饵模式下成功率的下降可以直接归因于功能属性推理的失败,而不是外观不熟悉。配合『可解释性』原则(层级 + 事件日志)与『真实世界效用』原则(三种日常工具功能),构成了与既有基准的本质区别。
方法步骤详情
第一步,数据收集:8 名操作员用 Meta Quest 遥操作,在仿真中完成 1,959 次 L1/L2 尝试,12 个 L1/L2 任务各留 100 条成功演示共 1,200 条;所有 $b^\star$ 抬升超过 0.08 m 的尝试在首次达标帧截断,自动生成 1,803 条 L0 轨迹(1,189 条来自成功、614 条来自失败尝试,因此含捡错工具的教训);再加 91 条真实 G1 演示,合计 3,094 条。第二步,训练:7 个被测策略(ACT 52.1M、DP 84.7M、Ψ0 2.63B、GR00T N1.7 3.14B、π0.5 3.62B、Cosmos 3 Edge 3.37B、FastWAM 6.02B)都在 3,003 条仿真轨迹上训练 40,000 步、每步 128 样本、保证 18 个任务各至少采样一次;GR00T N1.7/π0.5/Cosmos 3 从 DROID 检查点初始化,ACT/DP 用冻结 CLIP ViT-L/14 文本编码器获取语言条件;真机评估的 ACT、GR00T N1.7、FastWAM 再用 91 条真实演示微调 5,000 步。第三步,评估:仿真 18 任务 × 100 episodes、策略间共享初始种子、50 Hz 下 $H=3000$ 步限时 1 分钟;真机测 L1 BallMove/BallRetrieve 的 S/D 模式各 10 次;各策略按训练时的 chunk 长度开环执行(16 到 100 步不等)。第四步,诊断:用单独在 1,593 条标准模式演示上训练的 GR00T N1.7 做工具替换与指令改变两组探针。
技术新颖性
新颖性体现在评估协议层面而非模型层面。第一,首次在人形平台上把功能选择、站立使用、移动使用纳入同一基准,Table I 显示此前没有任何工作同时覆盖人形本体、55 个工具资产、选择评估、层级任务与诱饵对照加真机演示。第二,把过程性事件记录(候选接触、正确首次接触、正确工具抬升、工具-目标接触、成功)作为正式评估输出,使失败定位成为可能,这在操作类基准中很少见。第三,decoy 模式把受控实验思想搬进机器人基准:指令、无关物体、采样规则完全不变,只增删一个属性受控的诱饵,因此 S 与 D 的成功率差可干净地解读为候选对比难度。第四,L0 数据通过对 L1/L2 遥操作尝试自动截断生成,绕开了单独采集的成本,也让 L0 与后续层级在同一批 rollout 上可比。相比之下,PhysToolBench 只分理解档位不执行,DexCraft 与 RoboWits 没有渐进层级,只有 RoboWits 变化了任务所需的决策。
实验结果
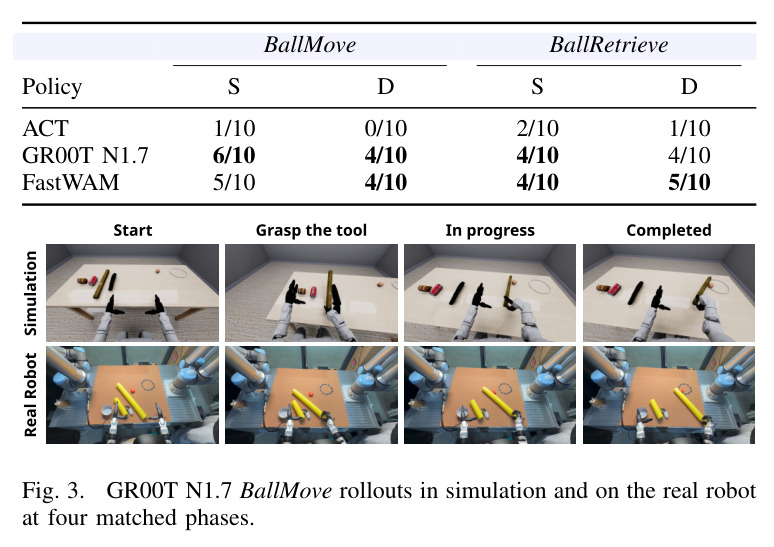
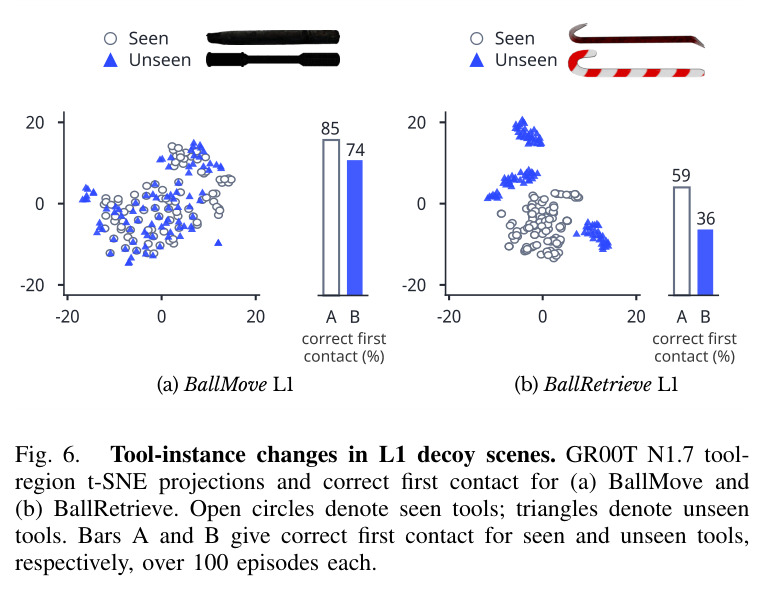
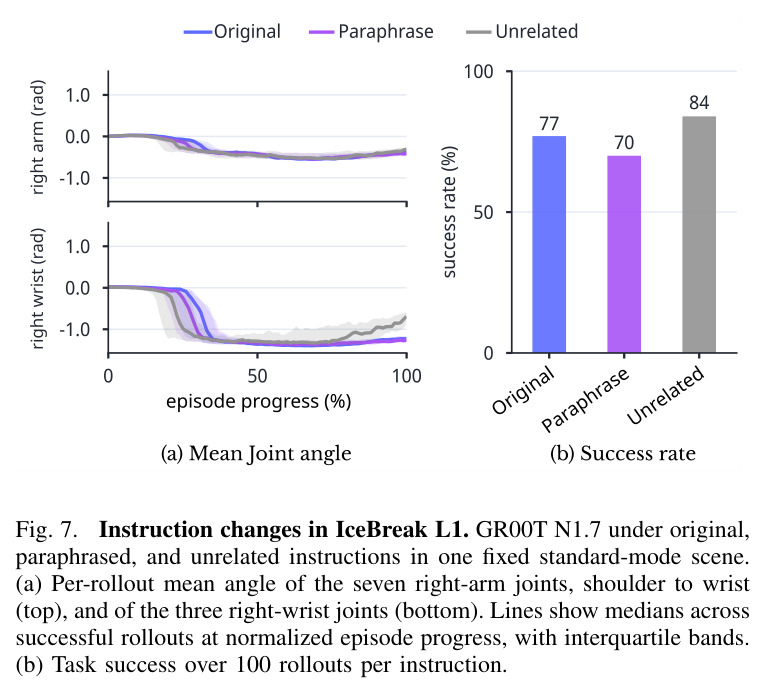
仿真主结果(Table III,数值顺序 BallMove/BallRetrieve/IceBreak):ACT、DP、Cosmos 3 几乎无法完成 L1,π0.5 与 Ψ0 处于中游(标准 L1 分别 4/0/12 与 9/0/13),GR00T N1.7(64/36/66)与 FastWAM(76/57/86)大幅领先,FastWAM 标准 L1 全场最高。L2 暴露移动使用的普遍短板:FastWAM BallMove 从 76% 跌至 9%,GR00T N1.7 两个球类任务从 64%/36% 跌到 10%/9%,但 IceBreak 相对抗跌(66→31、86→69),说明移动难度取决于所需交互类型而非单纯距离。诱饵模式系统性削弱强策略 L1(FastWAM BallRetrieve 57→45),但 GR00T N1.7 BallMove L2 反而从 S 的 10% 升到 D 的 30%。事件分析(Fig. 5)揭示强弱差异的根源:DP 候选接触率 89.8% 却只抬对工具 15.0%、成功 0.3%,π0.5 接触 98.8% 但成功 2.8%;GR00T N1.7 抬对 90.0%、工具-目标接触 79.8%、成功 36.0%,FastWAM 达 89.2%/88.2%/52.8%。诱饵主要打击首次选择(正确首次接触 GR00T N1.7 87.3→77.2、FastWAM 87.7→74.7),最终成功几乎不变(36.0→39.0、52.8→47.0),说明策略常先摸诱饵再中途换对。真机(Table IV):sim+real 微调后标准 BallMove 上 GR00T N1.7 6/10、FastWAM 5/10、ACT 1/10,仿真强弱排序保持。探针显示:未见工具使正确首次接触从 85%→74%(BallMove)、59%→36%(BallRetrieve);固定 IceBreak 场景中无关指令下成功率 84%,反高于原指令的 77%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 仿真 L1 站立工具使用(标准模式,BallMove/BallRetrieve/IceBreak) | 成功率 (%) | FastWAM 取得 76/57/86,为全场最高;GR00T N1.7 为 64/36/66 | π0.5 仅 4/0/12,Ψ0 为 9/0/13,ACT 与 DP 接近 0 | 最强与中游 VLA 差距超过 70 个百分点,量化了基准的区分度 |
| 仿真 L2 移动工具使用(BallMove,标准模式) | 成功率 (%) | 最强策略 GR00T N1.7 仅 10%,FastWAM 仅 9% | 同一策略各自的 L1 成绩为 64% 与 76% | 加入行走后骤降 54-67 个百分点,确立移动工具使用为核心未解挑战 |
| 真机 L1 BallMove(标准模式,10 次试验,sim+real 训练) | 成功次数 (/10) | GR00T N1.7 6/10,FastWAM 5/10 | ACT 仅 1/10 | 仿真强弱排序在真实机器人上保持,且仅用 91 条真机演示微调 5,000 步即达成 |
| 诱饵模式对初始选择的影响(L1/L2 事件平均,标准→诱饵) | 正确首次接触率 (%) | GR00T N1.7 从 87.3 降至 77.2,FastWAM 从 87.7 降至 74.7 | 两者最终成功率几乎不变(36.0→39.0、52.8→47.0) | 分离出『先摸错后纠正』现象:诱饵影响选择而非最终执行 |
| 未见工具泛化探针(L1 诱饵场景,各 100 episodes) | 正确首次接触率 (%) | BallRetrieve 从已见 59% 降至未见 36% | BallMove 仅从 85% 降至 74% | 揭示钩类工具的外观泛化显著弱于棍类,属性差异越大衰退越重 |
局限与改进
作者明确承认的局限:每个策略只训练一次,没有训练种子方差,episode 间差异只反映场景与 rollout 变化;真机只评 3 个策略、2 个 L1 场景;L0/L1/L2 不仅移动需求不同、桌面布局也不同,层级效应与空间配置变化混在一起;正确首次接触只是初始选择的代理指标,工具区域 t-SNE 只刻画特征组织而未控制外观;指令探针只用一个固定 IceBreak 场景,未测试指向不同目标的指令。我补充几点:其一,每格 100 episodes 下 36.0→39.0、52.8→47.0 这类幅度在统计噪声范围内,据此断言『诱饵不影响最终成功』略显大胆,应报告置信区间;其二,事件指标是『包含该事件的 episode 占比』,不含时序与次数,无法衡量摸错后纠正的代价;其三,L0 数据由 L1/L2 尝试截断生成且 614/1,803 条来自失败尝试,这种构造性分布与真实 L0 任务分布的关系未验证;其四,Fig. 4 把空间对齐失败归因于自我中心视觉提供的深度与朝向信息不足,只是看视频后的假设,没有控制变量实验;其五,所有场景都围绕一张长桌,任务空间狭窄,对家庭环境的泛化说明力有限。
独立分析的弱点
第一,语言指令近乎冗余:无关指令(今天天气不错)下成功率反而最高(84% vs 原指令 77%),说明 18 个任务每场景目标固定、语言模板统一,策略靠场景模式匹配就能得分,所谓指令跟随并未被真正测到。改进方向是加入指令-场景冲突设计:同一场景轮换两种目标,或要求用诱饵完成任务,让语言输入成为成功与否的关键变量。第二,L2 的诱饵效应方向不一致(GR00T N1.7 BallMove 诱饵 30% 高于标准 10%,FastWAM 则全面下降),论文未给出解释;诱饵同时改变了布局几何,建议补充诱饵位置随机化的消融,把『选择更难』与『布局不同』两个因素分开。第三,事件粒度太粗:只记录事件是否发生过,不记录时间线与重复次数,无法区分快速纠正与侥幸擦过。建议输出事件序列并统计换工具行为的频次与耗时。第四,泛化探针只覆盖工具实例与措辞两个维度,缺少对光照、桌面材质、干扰物数量等的系统扫描,尽管环境本身支持这些随机化。第五,固定 50 Hz、1 分钟时长的协议可能系统性惩罚需要多次尝试或长时间纠错的策略,可增设更长时程预算的对照组。
未来方向
作者在讨论中提出的方向:扩展更广的工具、场景、目标并增加训练种子以估计方差;通过控制相机视角与空间观测(如加入深度或多视角)的对比实验,检验自我中心视觉是否是空间对齐失败的根因;把仿真训练与真实数据适配的贡献分开度量,单独量化微调的收益;测试指向不同目标的指令以真正评估目标切换能力。在此之上可以延伸:把五类交互事件用作过程奖励或失败归因信号反哺策略训练,例如对『正确首次接触』做针对性干预或 DAgger 式数据补充;针对 L1→L2 的巨大落差(最强策略骤降 54-67 个百分点)开发 loco-manipulation 专用的分阶段策略或上层技能调度;引入显式的工具功能推理模块,让 VLM 先对候选的长度、形状、材质属性打分再交给执行策略;把诱饵难度分级(属性差距逐渐缩小)构造从易到难的课程;扩展到双手工具操作、工具制造乃至跨人形平台的可迁移性研究。
复现评估
代码与数据在项目主页 https://snu-pi.github.io/HumanoidToolBench/ 开源,数据按场景×层级×模式给出清晰切分(Table II),对策略对比实验友好。复现仿真环境需要 MuJoCo、Unitree G1 模型和改造自 GR00T-WholeBodyControl 的解耦控制栈,环境本身门槛中等;但完整复现 7 个策略训练需要可观算力——3 至 6B 参数的 VLA/WAM 各做 40,000 步、batch 128 的训练,单卡难以承担,若只下载官方策略权重跑 18×100 episodes 的评估则便宜得多。真机部分门槛最高:需要 Unitree G1 加双 Dex3 灵巧手加 Meta Quest 遥操作套装,8 名操作员完成 1,959 次仿真尝试与 91 条真机演示的人力投入不可忽视。总体评估:用基准做评估(中等难度,可行)、从头复现训练(偏难,需多卡)、复现真机实验(难,硬件与人力双门槛)。
论文图表
固定场景下改写指令(原指令 77%、同义改写 70%、无关语句 84%)的成功率与右臂/右腕关节角度轨迹对比。
证明策略在无关语言下仍照常完成熟悉任务,暴露指令跟随未被真正测量的关键问题。
从本体类型、工具使用范围、工具资产数、选择评估、层级结构、诱饵变体、仿真/真机演示数等维度对比 LIBERO、RoboTwin 2.0、HumanoidBench、SIMPLE、WOLF-VLA、PhysToolBench、DexCraft、RoboWits 与本文。
论证研究空白的核心表格:没有任何已有基准同时覆盖人形本体、55 工具、选择评估、层级、诱饵与真机演示。
列出仿真 3,003 条轨迹在各场景×层级×模式下的分布(L0 如 BallMove 289/244),以及真机 91 条演示的分布(BallMove L1 29/21、BallRetrieve L1 20/21)。
数据集构成的权威清单,复现训练配比或评估采样时必须参照。
7 个策略在 18 个任务上的完整成功率矩阵,每格给出 BallMove/BallRetrieve/IceBreak 三个数值,按 IL/VLA/WAM 三族排列。
主结果表:L1 到 L2 的骤降(FastWAM BallMove 76→9)与诱饵模式的影响都从这里读出。
ACT、GR00T N1.7、FastWAM 在真机 L1 BallMove 与 BallRetrieve 的标准/诱饵模式各 10 次试验的成功数,如 GR00T N1.7 为 6/4/4/4。
验证仿真结论在真实世界成立的关键证据,也是 sim2real 少样本微调有效性的展示。