基于选择的结构化推理:迈向高效的多模态搜索智能体 Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
把逐词生成推理改为从可复用候选库中选择,推理延迟降90%以上且性能持平
前置知识
ReAct 范式
ReAct 是大模型智能体的经典设计:模型在每一轮先生成一段自由文本推理(thought),再输出一个动作,动作可以是调用工具或给出最终答案;工具返回的观察结果被拼回上下文进入下一轮,形成“观察-推理-行动”交替循环,是多轮任务求解的基本骨架。
本文的研究对象正是 ReAct 式多模态搜索智能体,SSR 替换的恰恰是其中“推理”这一步的生成方式,只有理解 ReAct 才能明白替换发生在流水线的哪个位置。
KV 缓存与 teacher forcing 预填充
自回归解码时每生成一个 token 都要对全部历史做注意力计算,KV 缓存把历史 token 的键值状态存下来避免重复计算。teacher forcing 则是把一段已知文本整体作为输入做一次前向传播,一次性得到每个位置的 log 概率,完全不需要逐词生成。
SSR 能并行打分的全部技术基础在于候选推理文本是预先写好的:可以用 teacher forcing 一次前向算出候选内所有 token 的似然,并复用历史的 KV 缓存,这是延迟降低 90% 的来源。
GRPO(组相对策略优化)
GRPO 是 DeepSeekMath 提出的强化学习算法:对同一问题采样一组轨迹,用组内奖励的均值和标准差归一化得到优势估计,再用 clip 代理目标更新策略,配合对参考策略的 KL 正则,省去价值网络。重要性比 $\rho$ 定义为当前策略与旧 rollout 策略的概率之比。
论文在 GRPO/GSPO/SAPO 三种 RL 目标下训练 SSR,核心改动是把整段推理 token 的逐 token 重要性比换成一次候选选择的类别分布比值,理解这一点才能看懂 SSR 如何与 RL 训练兼容。
长度归一化对数似然
直接比较不同长度文本的联合对数似然会系统性偏向短文本(许多小于 1 的概率连乘)。对长度做归一化 $S_\theta = \frac{1}{K}\sum_{j} \log p(r_j \mid \cdot)$ 得到平均每 token 对数似然,可消除长度偏差,相当于困惑度的对数形式。指数 $\alpha$ 控制归一化强度。
SSR 用这个量作为候选打分函数 $S_\theta(r_i \mid h_t)$(论文取 $\alpha=1$),它决定了“哪条候选最贴合当前上下文”的公平比较方式,也直接影响选择质量。
计算深度(关键路径)与 FLOPs
计算深度指并行计算中必须串行执行的最少步骤数:注意力对 $m$ 个 token 的 softmax 加权和需要 $O(\log m)$ 的并行深度。自回归生成 $L$ 个 token 的深度与 $L$ 成正比,而一次批处理前向的深度只与序列长度呈对数关系;深度不同于总计算量(FLOPs)。
论文用关键路径深度 $D_{\text{freeform}}=O(L\log(H+L))$ 对比 $D_{\text{SSR}}=O(\log(H+K_{\max})+\log N)$ 来刻画延迟优势,并单独讨论 FLOPs 与 KV 内存的代价,混淆这两个概念会误读其效率分析。
研究动机
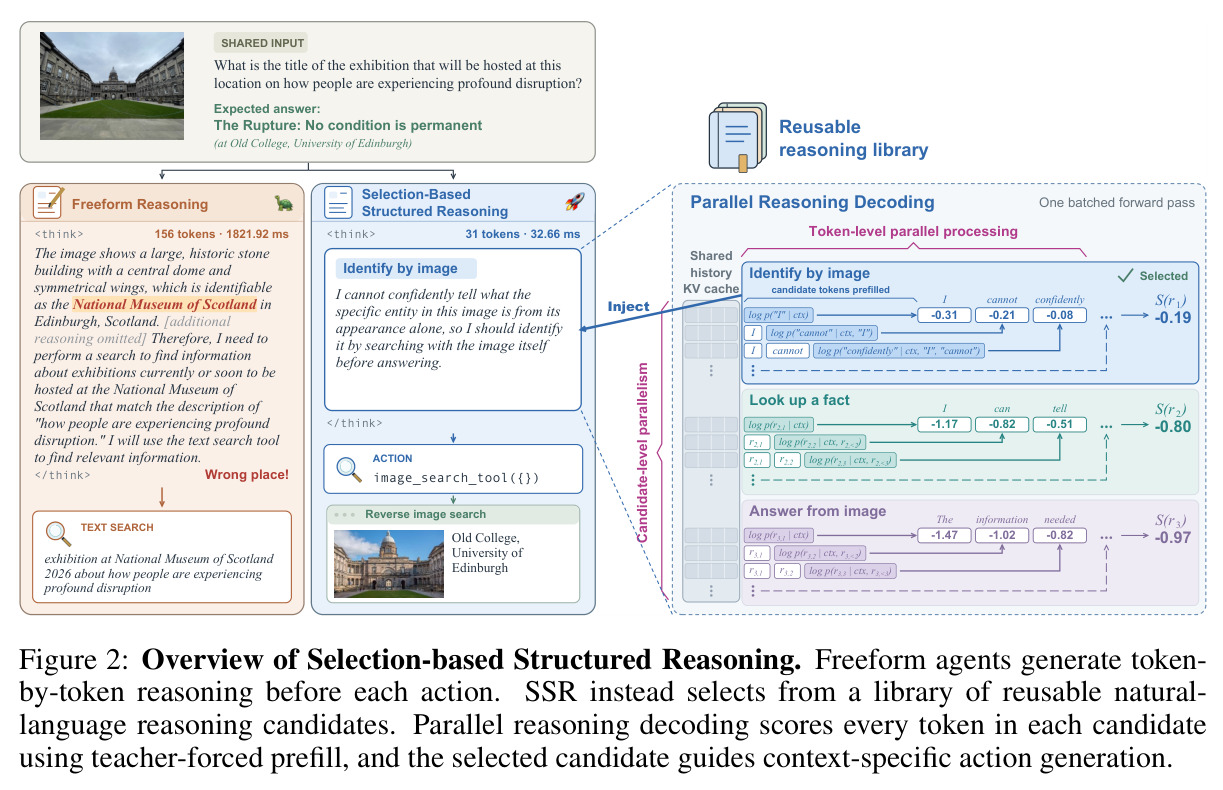
多模态搜索智能体普遍沿用 ReAct 式设计:每执行一个动作前先自由生成一段推理文本。这对 2B/4B 级小模型是沉重负担——论文在图 2 的实例中展示,4B 模型为决定“是否该用图片搜索”生成了 156 个 token、耗时 1821.92ms 的推理,而它真正要产出的动作不过一个工具调用;统计上,freeform 模型每轮推理平均耗时 0.770–1.113 秒,单个问题全程模型推理延迟达 5.2–6.1 秒。更糟的是小模型容量有限,冗长推理常沦为复述图像内容,对动作生成几乎没有引导价值,算力花了却没换来更好的决策。已有高效推理方案各有局限:Chain-of-Draft、Sketch-of-Thought 等提示压缩方法和效率奖励 RL 只能缩短生成文本的长度,token 之间的串行自回归依赖依然存在,压缩后每轮推理仍需 0.4–0.9 秒;HyperEyes 通过并行派发查询减少交互轮数,却不触及每一轮内部推理段的开销。
本文的目标是本文的目标是彻底消除每轮推理的串行解码成本,同时不牺牲任务成功率。作者的关键观察是:多模态搜索中实体、查询、观察随问题千变万化,但决定下一步动作的高层推理模式高度重复——例如“已知实体但不知道所问的属性,去搜该属性”这一条理由,同时适用于查 AI 会议举办地和查乐高创立年份。因此搜索智能体所需的推理空间不必覆盖整个自然语言空间,一小撮候选就足以支撑可观的成功率。SSR 框架把反复出现的高层推理固化为 6 条可复用的自然语言候选,每轮由模型基于当前上下文用似然打分从中选择,选中的候选作为推理轨迹插入上下文,指导实例化的动作生成(具体搜索词、裁剪框、最终答案)。量化目标:在 GRPO、GSPO、SAPO、SFT 四种训练目标和 2B/4B 两种模型规模下,成功率与 freeform 对手持平,同时把每轮推理延迟降低 90% 以上、每问题总模型延迟降低 28–54%。
与已有工作不同的是,本文切入角度的独特之处在于改变“推理的表示形式”本身,而非调节推理的长度或时机。与压缩式方法不同,SSR 不是生成更短的思考,而是根本不逐词生成思考:推理被离散化为候选库上的分类问题,用 teacher forcing 一次前向并行完成打分。与思路模板类工作(Buffer of Thoughts、ReasoningBank)相比,SSR 不依赖任何外部知识管理或检索系统,直接用执行动作的那个语言模型自身充当候选打分器,通过长度归一化似然做上下文匹配,既不需要辅助分类头也不需要 SFT 预热。与语法约束解码(XGrammar 一类)不同,SSR 对完整候选整体并行打分并把语义直接注入上下文,而不是只约束输出 token 的表面形式。与轨迹级策略抽象 StraTA(开局定一次策略、全程不变)不同,SSR 每轮基于更新后的交互历史重新选择,新观察可以即时改变后续引导。此外,把推理选择建模为类别分布并代入策略梯度,使 RL 可以直接从 base 模型训练,这在同类搜索智能体中很少见。
核心方法
SSR 重新定义了 ReAct 智能体中“推理”这一步。给定交互历史 $h_t=[x, z_0,a_0,o_0,\dots,z_{t-1},a_{t-1},o_{t-1}]$($x$ 为用户请求,$z/a/o$ 分别为推理、动作、观察),模型不再自由生成推理 $z_t$,而是从推理库 $\mathcal{R}=\{r_1,\dots,r_N\}$ 中选一条。直觉上,这相当于把“每步现场写一篇小作文”换成“从一张决策清单里挑一句最贴合当前处境的话”。技术上分两步:先用 teacher forcing 对每条候选做一次前向传播,按式 (1) 计算长度归一化对数似然 $S_\theta(r_i \mid h_t)=\frac{1}{K_i}\sum_{j=1}^{K_i}\log p_\theta(r_{i,j}\mid h_t, r_{i,<j})$(取 $\alpha=1$);再对分数做温度为 $\tau$ 的 softmax 得到选择分布 $q_\theta(\cdot \mid h_t)$,从中采样一条候选插入上下文,随后照常自回归生成动作(搜索查询、裁剪框或最终答案)。打分和动作生成共用同一套模型参数与系统提示,所有候选共享历史的 KV 缓存并发打分——候选内 token 级并行、候选之间候选级并行,整个推理阶段模型不需要生成任何新 token。论文还从计算深度角度给出理论刻画:freeform 的深度 $O(L\log(H+L))$ 被 SSR 压到 $O(\log(H+K_{\max})+\log N)$,消掉了主导项 $L$。
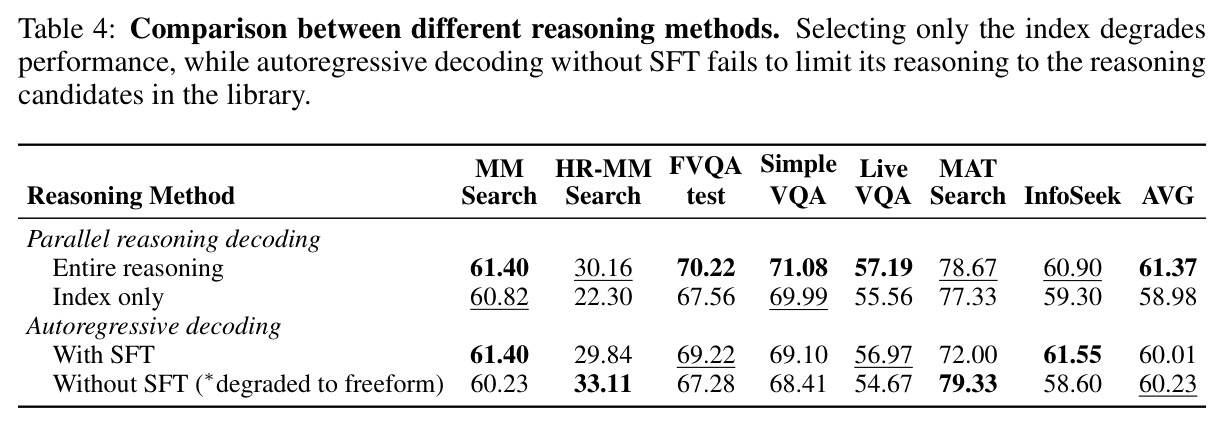
核心创新是“推理即选择”加上“并行推理解码”,与已有方法的本质区别有三层。第一,推理文本预先存在,因此可以在 token 级(候选内所有 token 在一次 batched forward 中同时打分)和候选级($N$ 条候选并发计算、共享历史 KV cache)两个粒度上完全并行,把自回归生成的串行链彻底砍断,推理延迟不再随思考长度 $L$ 线性增长。第二,语言模型本身充当候选分类器:不需要额外分类头、不需要 SFT 热启动,模型的语言理解能力直接转化为“哪条候选最贴合当前上下文”的判断力,index-only 消融证明完整文本语义是选择质量的关键。第三,该机制硬性约束了推理的支撑集——无论基座模型初始分布如何发散,推理永远落在库内,这使得 GRPO 等 RL 算法可以从 base 模型直接训练(freeform 推理通常需要 SFT 预热教会模型输出格式),同时选择比值作为单一标量进入重要性采样,训练目标端到端联合优化选择与动作生成。
方法步骤详情
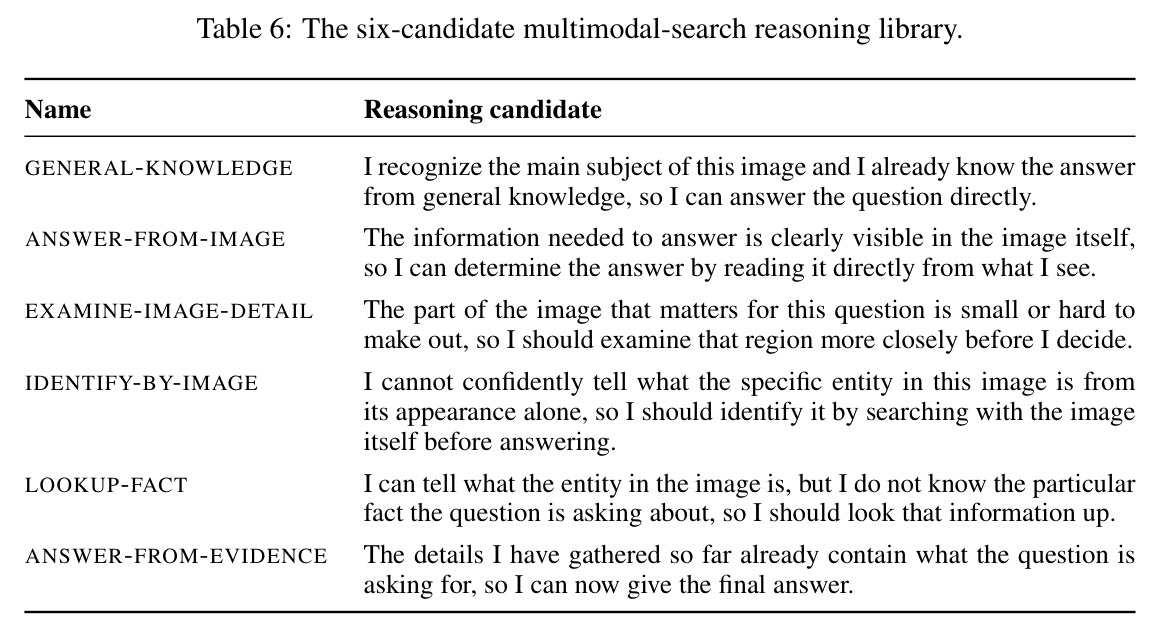
完整流程分推理与训练两段。推理侧:第一步,构建推理库——默认 6 条人工编写的自然语言候选(附录 E),如“图片中实体光凭外观认不准,应先用图片本身去识别”“已知实体但缺所问事实,应检索该事实”等,训练与评测共用同一库。第二步,候选打分——每轮把 $N$ 条候选分别拼到历史 $h_t$ 后,通过 SGLang 的 prefill-only generate 调用($\text{logprob\_start\_len}=L_t-1$ 对齐边界)返回每条候选全部 token 的对数概率,按 $\alpha=1$ 求均值得到分数 $S_{t,i}$,历史 KV 缓存被前缀复用。第三步,选择与注入——$\tau>0$ 时按 $\mathrm{softmax}(S_t/\tau)$ 采样候选下标($\tau=0$ 时取 argmax),harness 把选中候选的完整 token 序列作为 thinking 块插入上下文。第四步,动作生成——模型自回归产出一个符合 JSON schema 的工具调用(反向图搜 / 文本搜索 / 图片放大)或 $\langle\text{answer}\rangle$ 终止;环境执行工具后把观察拼回上下文进入下一轮。训练侧:SFT 用式 (4) 的选择损失与动作 token 损失加权和($\lambda^{\text{reason}}_{\text{SFT}}=1$),真值轨迹由 Gemini 3.1 Pro 生成并映射到候选标签;RL 用式 (6) 的 GRPO 目标,推理选择用类别比值 $\rho^{\text{reason}}_t=q_\theta/q_{\text{old}}$、动作用逐 token 比值 $\rho^{\text{action}}_{t,k}$,组内归一化优势加 clip 代理,$\gamma^{\text{reason}}_{\text{RL}}=1$、$\beta=10^{-3}$,选择器梯度用 detached-competitor 近似(式 10,只对选中候选回传梯度,避免对所有候选做反向传播)。奖励为准确率加 0.5 倍格式分,SSR 还要求动作类型与所选候选一致才能拿满格式分。
技术新颖性
技术新颖性可以从四个对照面看清。对压缩式高效推理(Chain-of-Draft、Sketch-of-Thought、效率奖励 RL):它们缩短串行链长度 $L$,SSR 直接把串行链变成一次词级并行批处理,延迟对 $L$ 不敏感,代价是每轮要处理 $K_{\text{tot}}$ 个候选 token(论文给出 SSR 更快的充要条件 $K_{\text{tot}}/L < v_{\text{score}}/v_{\text{dec}}$,并在 RTX PRO 6000 上估算处理 15200 token 的库约等于生成 100 个 freeform token 的时间)。对语法约束解码:那是强制输出符合文法的形式,SSR 是对完整候选做语义级并行打分并直接供给推理轨迹。对思路模板与推理记忆(Buffer of Thoughts、ReasoningBank、AutoGuide):它们依赖外部知识管理/检索系统,SSR 用动作模型自身的似然完成匹配,零辅助组件;对 StraTA 这类轨迹级抽象(初始状态定策略、全程固定),SSR 逐轮重选、观察可即时改变引导;对 HyperEyes(并行派发查询减少轮数):SSR 压缩轮内推理段开销,两者正交可叠加。训练技术上,把整段推理浓缩为单一类别分布的重要性比、配合 detached-competitor 梯度近似的 on-policy GRPO 分析,也是此前没有的具体贡献。
实验结果
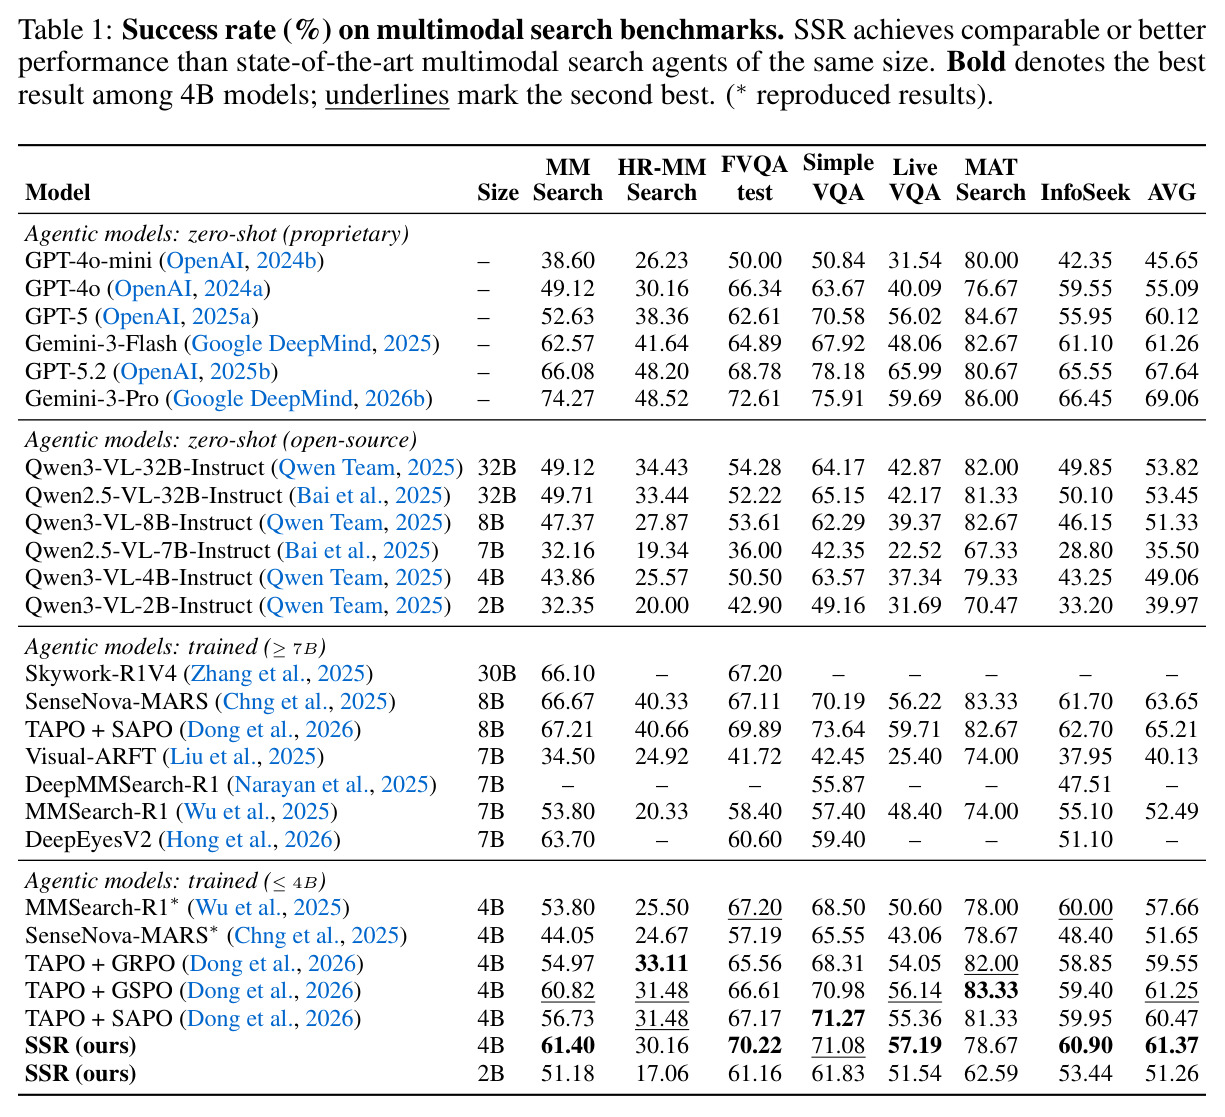
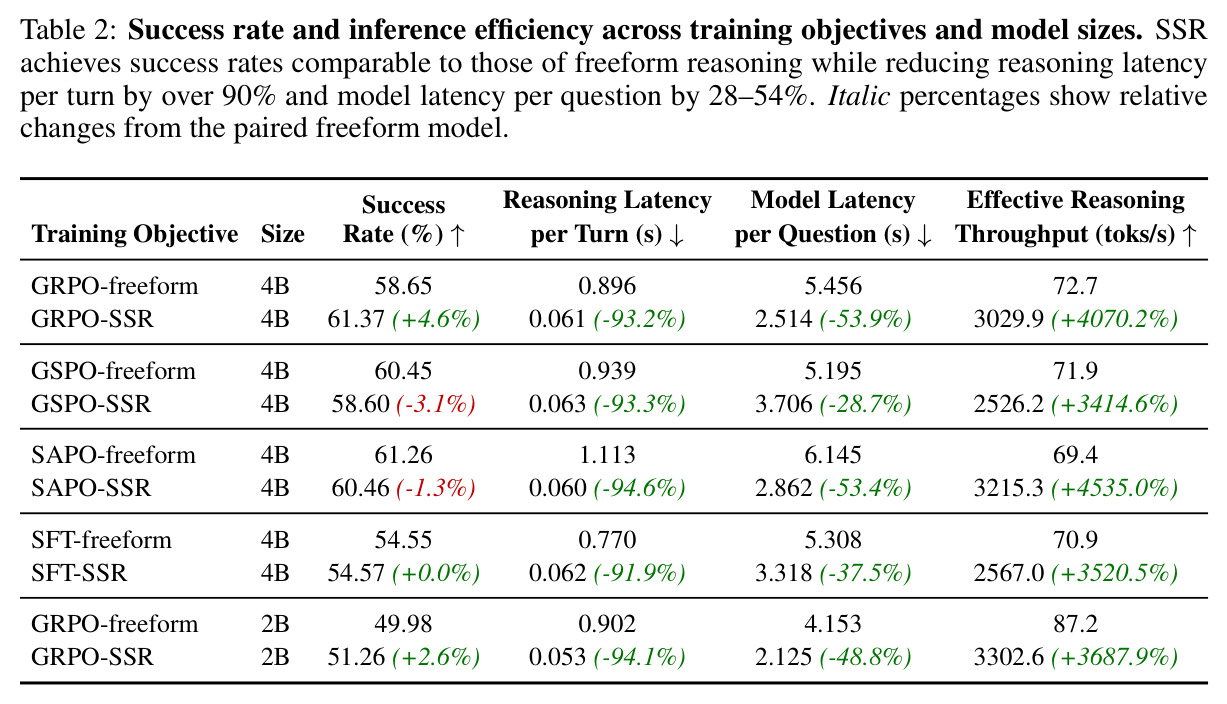
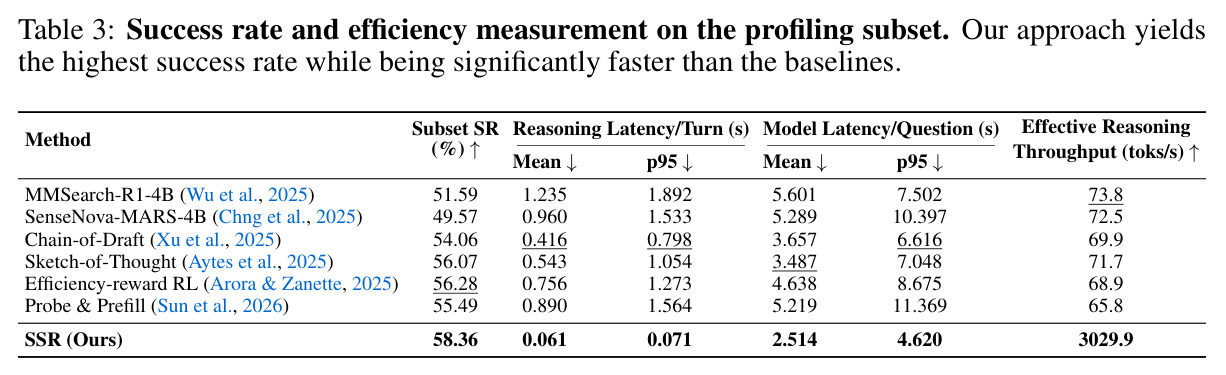
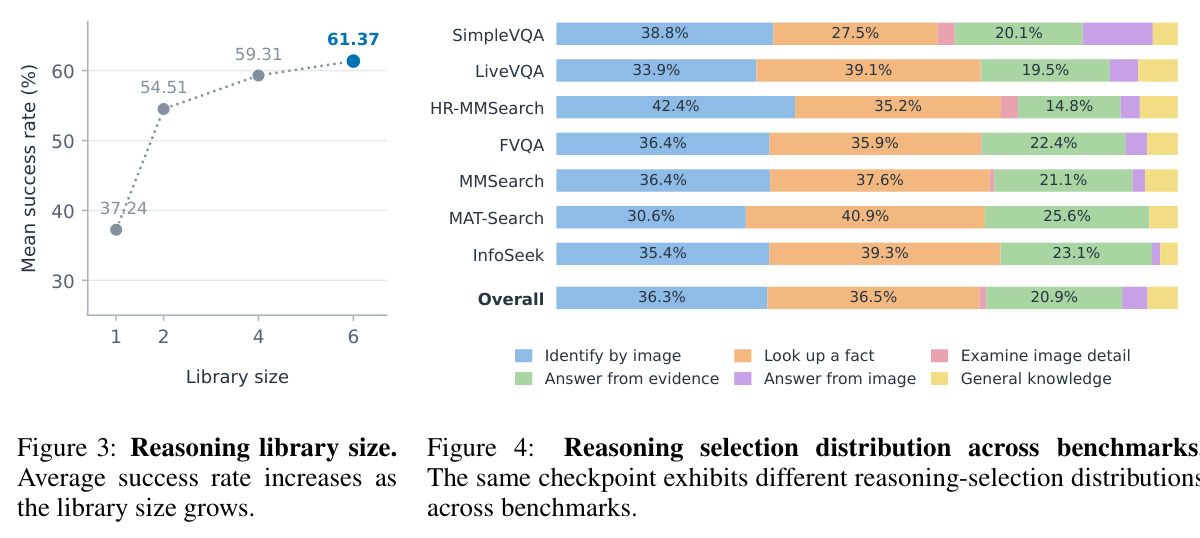
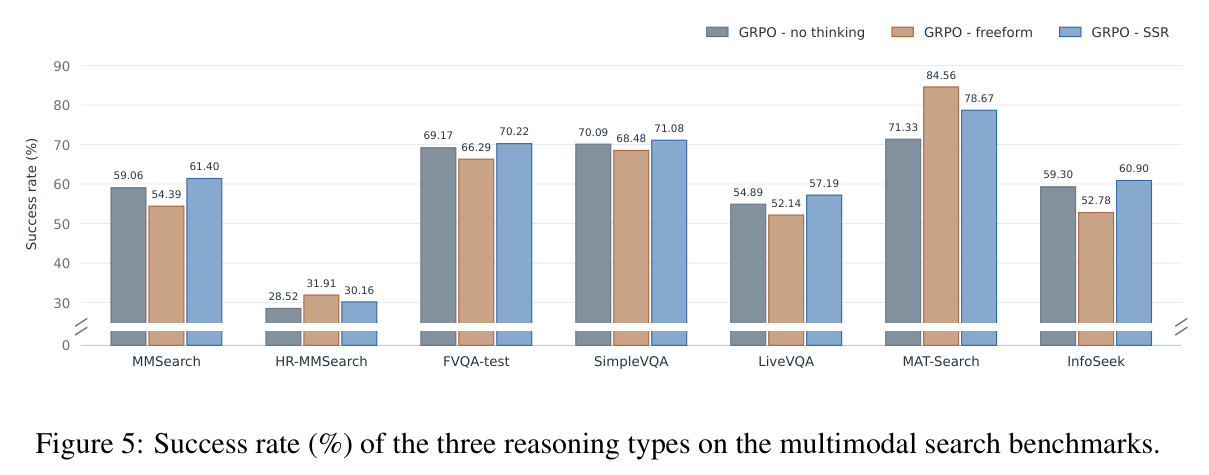
逐一梳理核心实验。任务性能(Table 1):4B SSR+GRPO 在七个基准上取得 MMSearch 61.40 / HR-MMSearch 30.16 / FVQA-test 70.22 / SimpleVQA 71.08 / LiveVQA 57.19 / MAT-Search 78.67 / InfoSeek 60.90,平均 61.37%,与最强 4B 同规模模型 TAPO+GSPO 的 61.25% 持平,超过 MMSearch-R1(57.66%)和 SenseNova-MARS(51.65%);2B SSR 平均 51.26%,几乎追平零样本 8B 模型的 51.33%。效率(Table 2):GRPO 4B 下每轮推理延迟从 0.896s 降到 0.061s(-93.2%),每问题模型延迟从 5.456s 降到 2.514s(-53.9%),有效推理吞吐从 72.7 涨到 3029.9 toks/s(+4070%);该模式在四种训练目标下一致——GSPO/SAPO 成功率分别 -3.1%/-1.3%(作者归因于选择器梯度近似在多次更新后失准),SFT 持平(54.57 vs 54.55),2B GRPO 成功率反而 +2.6%。与高效推理基线对比(Table 3):在每基准采样 100 题、共 700 题的 profile 子集上,SSR 成功率 58.36% 最高,推理延迟均值 0.061s、p95 仅 0.071s,比最快的 Chain-of-Draft(0.416s)快约 7 倍,且 mean-p95 差距只有 10ms,延迟极其稳定;每问题模型延迟 2.514s、p95 4.620s,比最快的 Sketch-of-Thought(均值 3.487s)低约 28%。消融(Table 4):只对候选下标打分(丢失候选语义)平均成功率降到 58.98%(相对 -3.9%,七个基准全跌);自回归复述候选需要 SFT 热启动才达 60.01%,无 SFT 则退化为 freeform(60.23%),说明并行选择在接口约束和延迟上都更优。库规模(Figure 3):1/2/4/6 条候选对应 37.24/54.51/59.31/61.37%,从 1 条万能候选到 2 条就提升 17.27 个百分点。选择分布(Figure 4):同一 checkpoint 在不同基准上选择分布显著不同(如 SimpleVQA 偏好“看图作答”,HR-MMSearch 偏好“细看图像区域”),且 99.9% 的轮次中生成动作类型与所选候选预期一致。附录 Figure 5:SSR 平均 61.37% 高于无思考 58.91% 和 freeform 58.65%,7/7 基准胜过无思考(提升 0.99–7.34 点),5/7 胜过 freeform。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态搜索七基准平均(4B 训练模型) | 平均成功率 (%) | 61.37(SSR+GRPO) | TAPO+GSPO 61.25;MMSearch-R1 57.66;SenseNova-MARS 51.65 | 与最强同规模基线持平,超 MMSearch-R1 +3.71 点 |
| 小模型平均成功率 | 平均成功率 (%) | 51.26(2B SSR+GRPO) | 零样本 Qwen3-VL-8B 51.33 | 以约 1/4 参数量追平零样本 8B |
| 每轮推理延迟(GRPO 4B) | 秒 | 0.061 | freeform GRPO 0.896 | -93.2%(四种训练目标下均超 90%) |
| 每问题模型推理延迟(GRPO 4B) | 秒 | 2.514 | freeform 5.456 | -53.9%(跨目标 28–54%) |
| 有效推理吞吐(GRPO 4B) | toks/s | 3029.9 | freeform 72.7 | +4070% |
| 对高效推理基线(700 题 profile 子集) | 成功率 (%) / 每轮推理延迟均值 (s) | 58.36 / 0.061 | Sketch-of-Thought 56.07 / 0.543;Chain-of-Draft 54.06 / 0.416 | 成功率最高,速度快约 7 倍,p95 延迟 0.071s 最稳 |
| 选择-动作一致性 | 动作类型与所选候选匹配率 | 99.9% | — | 证明候选选择确实在指导动作生成 |
局限与改进
作者承认的局限:GSPO/SAPO 下成功率小幅下降(-3.1%/-1.3%),源于 detached-competitor 选择器梯度近似在批内多次梯度更新后与真实分数脱节;库从 4 条扩到 6 条时收益递减(59.31% 到 61.37%),说明固定库的信息量上限。我观察到的额外局限:其一,推理被硬约束在 6 条人工候选内,遇到库未覆盖的状态(多轮反思、计算、多来源对比)模型无从表达,论文也未报告“所有候选都不适合”时的表现;其二,HR-MMSearch(30.16)和 MAT-Search(78.67)上仍落后于 freeform/TAPO(TAPO+GRPO 分别 33.11、82.00),粗粒度候选对高分辨率细粒度检查和多跳任务帮助有限;其三,每轮都要处理全部候选 token,计算量随 $K_{\text{tot}}$ 线性增长,KV 缓存需存 $H+K_{\text{tot}}$ 的状态,库变大后优势会收窄(论文自己给出 $K_{\text{tot}}/L < v_{\text{score}}/v_{\text{dec}}$ 的成立条件);其四,评测只覆盖三个工具的搜索场景,延迟测量明确剔除了工具执行等环境侧时间,真实端到端收益会小于报告值;其五,结论只在 2B/4B 小模型上验证,大模型上 freeform 推理本身质量更高,选择式是否仍占优是未知数。
独立分析的弱点
独立分析几点弱点并给出改进方向。第一,静态人工库:6 条候选由作者手工编写并跨所有基准共享,粒度粗、无法覆盖长尾推理模式,换一个任务域就得重写;改进方向是论文附录 A 已暗示的从轨迹反馈自动演化库(借鉴 SkillOpt),或先聚类成功的 freeform 推理再摘要成候选。第二,选择信号与决策价值可能错位:长度归一化似然衡量的是“模型觉得这句话顺不顺口”,未必等于“这句话对当前决策最有用”,index-only 消融(-3.9%)证明语义有用,但语义匹配好不代表决策最优;可引入基于结果的选择器训练信号,或在 RL 中对选择分布施加任务奖励塑形。第三,缺少“跳过推理”通道:SSR 每轮必须选一条候选,即使当下最优决策是不加思考直接行动,可增设一条空候选或自适应门控,与 no-thinking 基线在部分基准上的优势结合起来。第四,泛化与规模未验证:结论限定在单库搜索智能体与 2B/4B 模型,库在 GUI、具身、深度研究等域之间的可组合性、以及 7B+ 模型上的相对收益都值得检验。第五,效率测量口径偏理想:离线 H100+SGLang、剔除环境开销,边缘设备在线服务场景的真实收益和内存压力需另行评估。
未来方向
作者明确提出的方向:用 SkillOpt 类技能演化方法从轨迹反馈中自动构建和精炼推理库(附录 A.1),并让候选集合覆盖智能体将遇到的所有状态。基于本文成果可自然延伸的:把 SSR 与 HyperEyes 式的轮内并行工具派发叠加,同时压缩交互轮数与轮内推理开销;研究库的规模定律与候选自动剪枝/合并(4 到 6 条收益递减提示存在冗余);混合模式——让模型在“选择”与“自由生成”之间自适应切换,难例生成、易例选择,兼得覆盖率与效率;把选择机制从推理推广到动作本身(候选动作模板加参数生成);用低秩或稀疏近似实现精确 softmax 选择器梯度(当前 detached-competitor 近似是 GSPO/SAPO 小幅退火的嫌疑来源);利用 SSR p95 延迟高度可预测的特性做在线服务的 SLA 工程调优;以及在更大模型和更长程任务(深度研究、多跳网页操作)上检验该表示是否依然高效。
复现评估
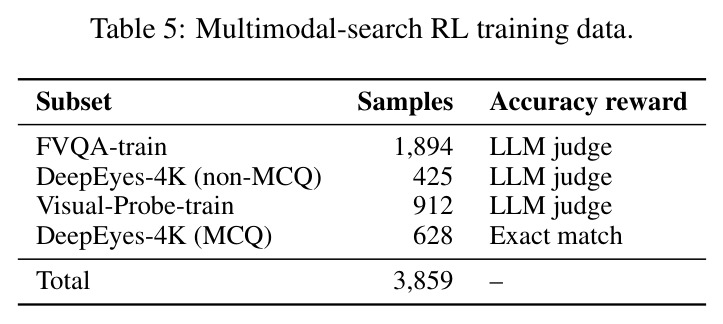
复现条件总体较好。模型是公开的 Qwen3-VL 2B/4B;训练集是 TAPO/SenseNova-MARS 的公开混合数据共 3,859 条(Table 5 给出各子集规模与奖励类型:FVQA-train 1894、VisualProbe 912、DeepEyes MCQ 628、非 MCQ 425);6 条推理候选全文在 Table 6 公开;Algorithm 1(推理)与 Algorithm 2(GRPO 训练)伪代码、超参(学习率 $10^{-5}$、单阶段单 epoch、全局 batch 64、每问题 8 条 rollout、最多 10 轮、每轮 8192 token、全程 32768 token)、奖励公式(准确率 + 0.5 格式分)都在附录写明。工程栈为 VeRL(训练)+ SGLang(推理),延迟 profile 在单张 H100 上完成。门槛在于:RL 训练 4B 模型需要多卡集群(具体卡数未披露);SFT 变体依赖专有的 Gemini 3.1 Pro 生成真值轨迹;评测需要 Serp API 网络搜索和 Qwen3-VL-32B 做 LLM 裁判,训练期文本检索用本地 Wikipedia 索引;论文未明确承诺开源代码,仅给出项目主页。若自行实现 harness 与打分接口,复现难度中等,伪代码细节足以支撑对齐。
论文图表
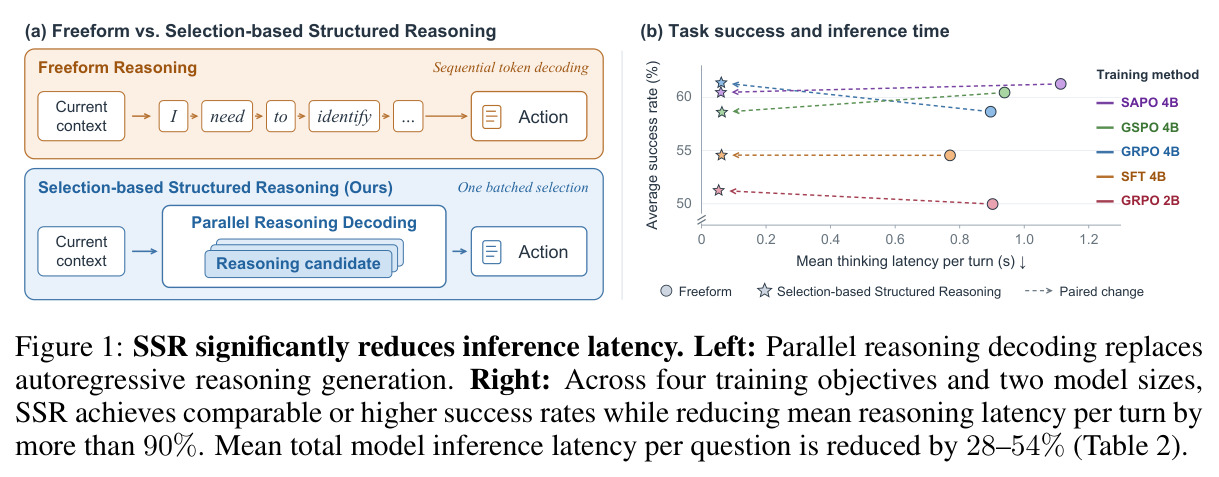
左图对比 freeform 推理的逐 token 串行解码与 SSR 的一次批量选择打分流程;右图是四种训练目标(GRPO/GSPO/SAPO/SFT)× 两种模型规模(2B/4B)下的成功率对每轮平均思考延迟的散点图,SSR 的配对点全部落在延迟更低、成功率持平或更高的左上区域。
这是全文结论的最直观概括:一张图同时呈现“性能不降”与“延迟降 90%+”两大卖点,适合作为理解论文价值主张的入口。
堆叠柱状图展示同一 checkpoint 在七个基准上对六条候选的选择频率:SimpleVQA 最高频选择“看图作答”,HR-MMSearch 最高频选择“细看图像区域”,整体分布随基准特性明显变化;并给出 99.9% 的轮次中生成动作类型与所选候选预期一致。
证明 SSR 的选择是上下文自适应的而非退化的固定模式,是“选择机制真的在起作用”这一主张的核心证据。
推理伪代码:预热系统提示缓存后,每轮用 prefill-only 调用对 N 条候选 teacher forcing 打分(logprob_start_len 对齐边界),按 α=1 归一化得到分数,τ>0 时按 softmax 采样、否则 argmax,把选中候选拼入上下文后自回归生成动作,经 harness 执行工具并拼接观察,直到出现合法答案或超限。
工程实现的核心参考:说明了如何用 SGLang 的采样参数接口实现候选打分与 KV 缓存复用,是复现推理路径的精确规范。
训练伪代码:每组对同一问题用旧策略采样 n 条轨迹并计算组内归一化优势;更新时用 teacher forcing 重算当前参数下的选中候选分数,把未选中对手的分数固定为 rollout 旧值(detached competitors)构造 N 维选择器 logits,得到单个类别重要性比 ρ_reason 与逐 token 的 ρ_action,进入 clip 代理目标,加参考策略 KL 后一步更新。
解释了 RL 如何与类别选择兼容以及梯度近似的具体实现,是理解 GSPO/SAPO 下性能小幅下降这一局限的前提。