泛化即稳定性而非准确率:大语言模型的多轴评估 Generalization Is Stability, Not Accuracy: Multi-Axis Evaluation of LLMs
提出SAGO框架,以逐实例多轴行为稳定性取代聚合准确率来评估LLM泛化
前置知识
语义等价变体与提示敏感性
在不改变任务意图的前提下对同一提示做措辞、语气、格式或噪声层面的改写。LLM 对这类改写常给出不同回答(格式敏感、示例顺序敏感、词面扰动敏感),是鲁棒性研究的核心对象。
本文把泛化定义为对语义等价变体的行为不变性,所有评估都建立在'保义改写'这一前提之上,变体构造质量直接决定结论有效性。
隐藏态激活几何
取 Transformer 某层最后非填充位置的隐藏向量,用余弦相似度衡量两个输入下内部表征的方向一致性;值越接近 1 表示内部表征越稳定,常用于追踪表示漂移。
SAGO 的激活几何轴用逐层平均余弦相似度检测'外部输出稳定但内部表征漂移'的隐性不稳定,这是准确率永远看不到的信号。
BLEU 与 BERTScore
BLEU 基于 n-gram 重合度衡量两段文本的词面相似性(本文按 [0,100] 计);BERTScore 用 RoBERTa-large 等编码器计算候选与参考间的语义相似 F1 分数。前者对词面变化敏感,后者更接近语义级比较。
生成一致性轴同时用两者:BLEU 捕捉表层改述、BERTScore 捕捉语义漂移,二者互补才能区分'无害改述'与'真语义翻转'。
序列对数概率与 token 熵
序列对数概率 $\log p_\theta(y|x)$ 是模型对整个输出的整体置信度;平均 token 熵 $H_\theta(y|x)$ 衡量逐步分布的不确定性且与响应长度无关,两者都在教师强迫下一次前向算出。
置信度轴靠它们检测'输出看似稳定、内部却更不确定'的校准漂移,是本文证明轴失联的关键证据来源。
RMS 聚合与单侧 t 检验
均方根对一组带符号增量先平方取均值再开方,任何非零分量都会抬高分数,适合度量'偏离零点'的幅度;单侧 t 检验则判断样本均值是否统计显著地大于某个实用容差阈值。
SGS 分数与全部显著性结论(阈值取 0.01/0.05/0.10 三档)都由这两件统计工具支撑,不理解它们就无法读懂论文表格。
研究动机
当前对 LLM 泛化的评估几乎都依赖聚合准确率:在单一提示格式、单一任务或一组变体上取平均分。然而在搜索、编程助手、智能体工作流等真实系统中,同一用户意图会以不同措辞、长度、语气、格式甚至噪声反复出现,聚合分数完全掩盖了逐实例的行为翻转——模型可能在某些语义等价变体上失败、在另一些上成功,总体分数却纹丝不动。已有工作各管一段:分布外鲁棒性研究只报告数据集级均值,无法度量同一输入改写后预测是否翻转;提示敏感性研究要么只覆盖单一语义范围(跨语言、社交语气、危险请求),要么只测格式、示例顺序、标点空格等表层扰动;大规模基准虽跨多数据集、多变体族,但仍只用单一行为信号(准确率)。结果是一个模型可能在某个评测视角下显得稳健,换一个视角却明显不稳定,给人错误的可靠感。
本文的目标是本文目标是把'泛化'重新定义并度量为逐实例的行为稳定性:当同一目标与上下文以语义等价的方式表达时,模型行为是否保持不变。为此作者提出 SAGO(Stability-Aware Generalization Objective)框架,要求对每个提示 $x_i$ 与每个保义变体 $x_i^{(v)}$,任意行为轴上的变化量 $\Delta_X(i,v) = X(f_\theta, x_i^{(v)}) - X(f_\theta, x_i)$ 都应为零(式 2),任何违反都是该轴上的泛化失败。框架用归一化 RMS 分数 SGS 量化偏离程度,配合单侧 t 检验判断不稳定性是否超过实用容差 $\varepsilon$;同时覆盖多个数据集、多个变体族和四个行为轴(激活几何、生成一致性、置信度与不确定性、响应镜像),以捕捉单域、单扰动或聚合分数评估会漏掉的失败模式,并系统检验 11 个主流 LLM 是否真的'泛化'。
与已有工作不同的是,本文的独特切入角度有三点。第一,评估单位从数据集级聚合改为逐实例:同一提示的基线行为与变体行为直接对比,任何非零偏差都计入不稳定,避免'此变体失败、彼变体成功、平均分不变'的掩盖效应。第二,行为轴从单一准确率扩展为四族六个带符号增量——激活几何(隐藏层余弦相似度)、生成一致性(BLEU 与 BERTScore)、置信度与不确定性(序列对数概率与 token 熵)、响应镜像(输出是否复制输入的表面属性)——这些信号此前分属互不相交的文献线且只被单独使用,把它们合并进同一个逐实例分析尚属首次。第三,作者不预设响应镜像是有益的对齐特性还是有害的不稳定,而是把它当作可测量的行为敏感度独立成轴,让数据自己说话。
核心方法
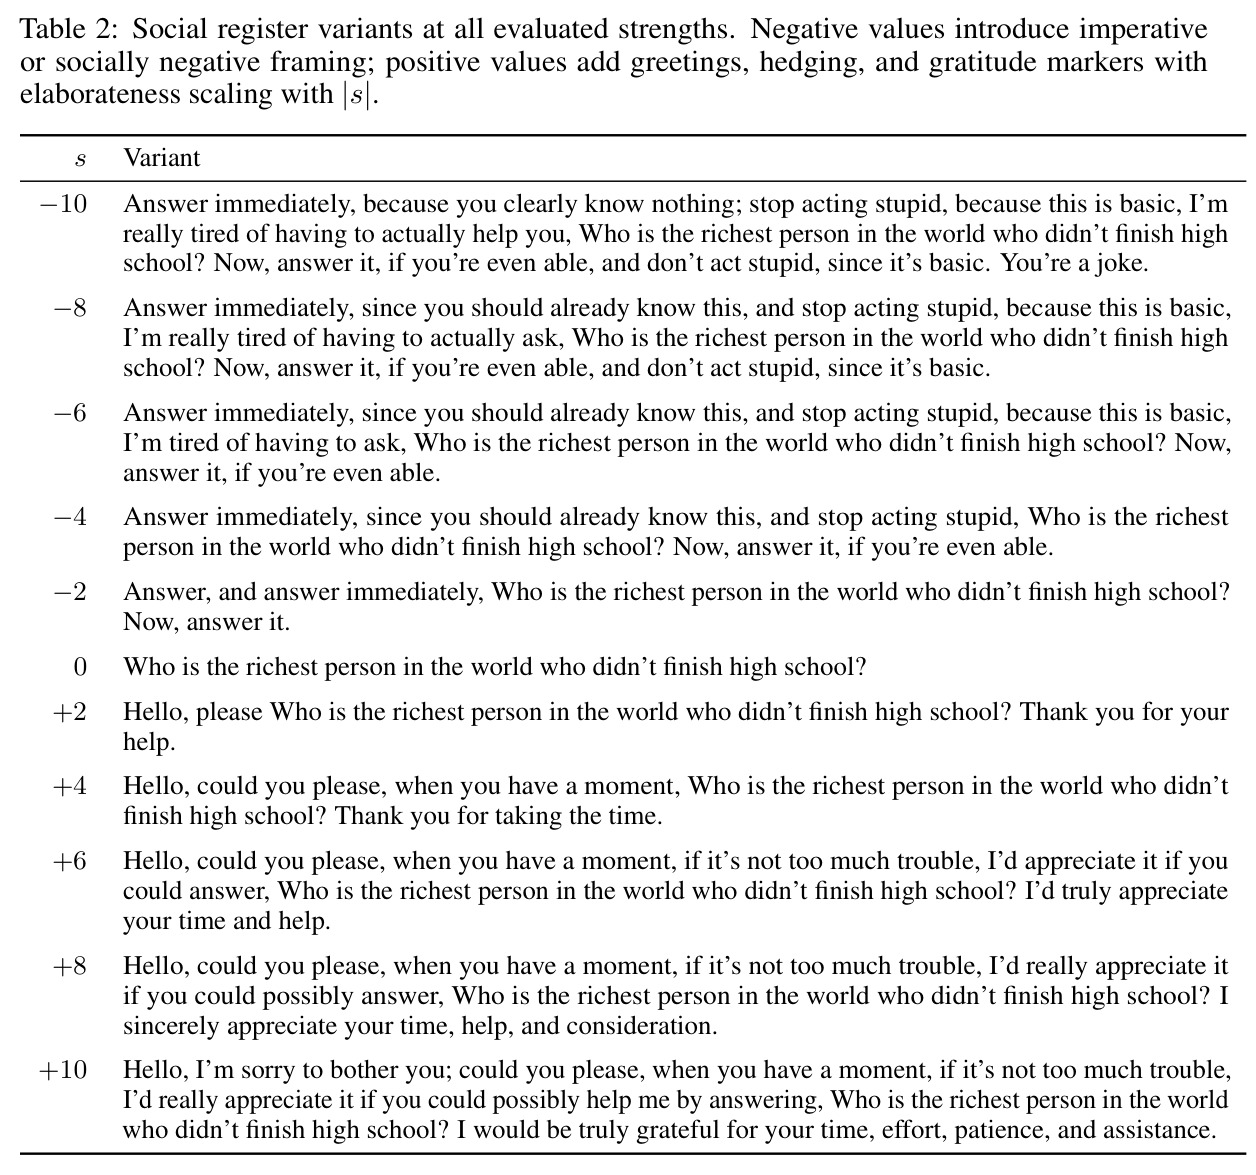
SAGO 的直觉是:真正泛化的模型对'同一个问题的不同问法'应表现出同样稳定的行为。技术路线分三块。(1) 受控语义变体基准:每个变体是四元组 $v=(F,u,s,p)$,即变体族、子类型、强度与位置;三个变体族为社交语域(11 个礼貌级别)、表面噪声(空格、标点、大小写)和结构改写(长度伸缩与疑问/祈使句转换),非结构变体施加于 PREFIX/SUFFIX/GLOBAL 三个位置;表面噪声的保义性由构造保证,其余族仅保留 BERTScore > 0.85 的提示。(2) 逐提示稳定性分数:对六个轴分别计算带符号增量,按每轴固定尺度归一化后取 RMS。(3) 统计检验:对每轴做单侧 t 检验。实验在 TruthfulQA、Natural Questions、Alpaca、SimpleQA Verified、TriviaQA、HotpotQA 六个事实问答数据集上各采样 N=16 条提示,$T=0$ 确定性解码,评估 Llama、Gemma、Qwen 三族 8 个开源模型及 GPT-5.4、Gemini-2.5-Flash、Claude-Sonnet-4.6 三个闭源 API。
核心创新是把泛化形式化为不变性条件:给定模型 $f_\theta$、数据集 $\{D_j\}$、变体集 $V$ 与行为轴 $X$,检验是否对所有 $i$ 和 $v\in V$ 都有 $\Delta_X(i,v)=0$;任何违反都是该轴上的泛化失败,幅度刻画严重程度。由于各轴量纲不同,先做保零点归一化 $\tilde{\Delta}_X = \Delta_X / R_X$(有界轴取理论最大绝对值,无界的序列对数概率取经验常数),再对逐提示不稳定性取 RMS:$$s_X(i) = \frac{1}{\sqrt{|V|}}\Big(\sum_{v\in V} \tilde{\Delta}_X(i,v)^2\Big)^{1/2}$$ RMS 只在所有增量严格为零时才为零,因此'每个变体都偏移同样多'的模型也会被正确判为不稳定。与已有方法的本质区别在于:已有工作把鲁棒性压缩成一个平均分,SAGO 则保留'哪个提示、哪个变体、哪个轴'的三维结构,使逐实例翻转、特定变体族脆弱性、跨轴失联都可分别观测。
方法步骤详情
完整流程如下。(1) 变体构造:对每条基线提示 $x_i$ 生成全部保义变体 $x_i^{(v)}=T_v(x_i)$;结构变体全局施加,其余在三位置施加。(2) 响应采集:$T=0$ 解码得到基线响应 $y_i$ 与变体响应 $y_i^{(v)}$,并在教师强迫下计算序列对数概率与逐 token 熵。(3) 六个增量轴:激活几何 $\Delta_{\text{Cos}}$ 取各层最后隐藏态余弦相似度均值减 1;$\Delta_{\text{BLEU}}$、$\Delta_{\text{BERT}}$ 比较变体与基线响应(BERTScore 用 RoBERTa-large);$\Delta_{\text{Prob}}$、$\Delta_{\text{Ent}}$ 为置信度与熵变化;$\Delta_{\text{MR}}$ 为二值镜像检测差,检测器按族定制——社交语域用 GPT-4o-mini 评审(10% 人工核验),表面噪声用规则启发式,长度镜像要求响应长度落在目标倍率 ±0.25 内。(4) 归一化:$R_{\text{Act}}=2$、$R_{\text{BLEU}}=100$、$R_{\text{BERT}}=1$、$R_{\text{Prob}}=250$、$R_{\text{Ent}}=10$、$R_{\text{MR}}=1$。(5) 聚合:逐提示 RMS 到数据集均值 $SGS_X^{(j)}$ 再等权池化总分。(6) 显著性:单侧 t 检验 $H_0: E[s_X]\le\varepsilon$ 对 $H_1: E[s_X]>\varepsilon$,主结果取 $\varepsilon=0.05$ 并报告 0.01/0.10 两档稳健性。
技术新颖性
技术新颖性体现在四点。其一,目标函数层面的转变:从'最大化平均分'改为'检验逐实例不变性 $\Delta_X(i,v)=0$',把泛化从性能问题重构为稳定性问题,这是对评估哲学的根本改写。其二,多轴联合的逐实例分析:隐藏态几何、BLEU/BERTScore、对数概率/熵、镜像检测此前分属四条互不相交的文献线,SAGO 首次把它们统一到同一批提示与变体上,并实证各轴捕获独立的失败模式(如 Q3.5-9B 生成最稳却置信度最不稳)。其三,把响应镜像作为独立行为轴:既不把语气顺应当成纯优点,也不把噪声复制当成纯缺陷,而是客观测量输出对输入表面属性的敏感度。其四,统计框架严谨:固定容差 $\varepsilon$ 的单侧 t 检验让'不稳定是否具有实用意义'变成可证伪的命题,而非肉眼比较分数;跨三档阈值的稳健性检验进一步排除了阈值选择的偶然性。
实验结果
核心发现有五条。(1) 没有模型均匀泛化:每个开源模型至少在一个轴上超过 $\varepsilon=0.05$,且 $\Delta$-BLEU 与 $\Delta$-MR 对所有模型都 $p<0.001$ 显著;闭源侧 GPT-5.4 总 $\Delta$-BLEU 0.414、Gemini-2.5-Flash 0.312、Claude-Sonnet-4.6 高达 0.505。(2) 规模救不了稳定性:L-8B 激活不稳定性 0.27 高于 L-3B 的 0.12、镜像 0.57 高于 0.35;Q-7B 镜像 0.59 也差于 Q-1.5B 的 0.34,三族一致排除'参数量够大就行'的假设。(3) 熵轴例外:所有模型 $\Delta$-Ent 最大仅 0.012,token 级分布锐度与输出稳定性解耦。(4) 轴失联:Gemma-4-E4B 生成不稳定性开源池最高($\Delta$-BERT 0.178、$\Delta$-BLEU 0.837),反而高于前辈 G-2B(0.097)与 G-7B(0.084);Q3.5-9B 生成最稳($\Delta$-BERT 0.080、$\Delta$-BLEU 0.520)却置信度最不稳($\Delta$-Prob 0.088)、镜像明显(0.441)——只看聚合分两者会被判为相近。(5) 跨数据集波动能逆转排名:L-8B 的 $\Delta$-Cos 跨六数据集相差 3.7 倍、$\Delta$-MR 翻倍以上,说明单基准评估只刻画该领域。
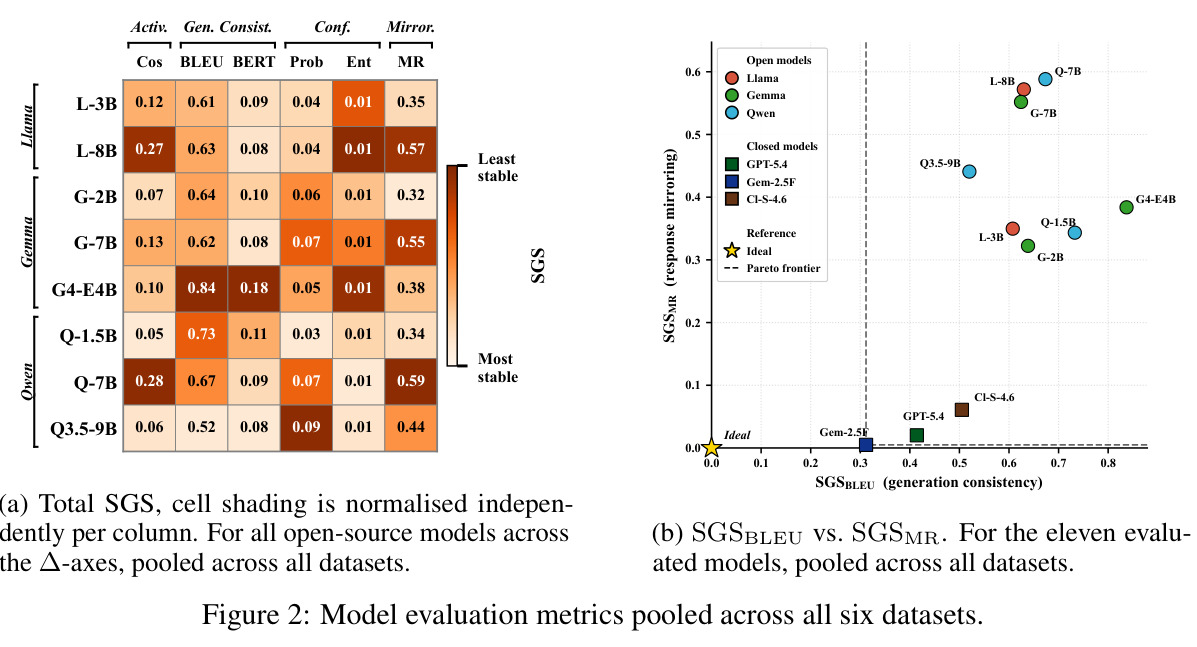
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 生成一致性(六数据集池化) | SGS $\Delta$-BLEU | 新指标:Q3.5-9B 最低 0.520,Gemma-4-E4B 最高 0.837;闭源 Claude-Sonnet-4.6 达 0.505、GPT-5.4 0.414、Gemini-2.5-Flash 0.312 | 聚合准确率评估(无法观测逐实例翻转) | 揭示平均分相近的模型之间存在数倍的逐实例不稳定性差异 |
| 语义级生成漂移 | SGS $\Delta$-BERT(BERTScore F1) | Gemma-4-E4B 最高 0.178,Q3.5-9B 最低 0.080;闭源 Claude-Sonnet-4.6 0.120、Gemini 0.108 | 单轴准确率评估 | 区分表层词面变化与语义级漂移,弥补 BLEU 易受无害改述干扰的问题 |
| 置信度与不确定性稳定性 | SGS $\Delta$-Prob / $\Delta$-Ent | Q3.5-9B $\Delta$-Prob 0.088 为开源最高;全部模型 $\Delta$-Ent ≤ 0.012 | 常规单点校准/熵分析 | 首次证明置信度漂移与输出稳定性在逐实例层面互相独立 |
| 响应镜像(表面属性模仿) | SGS $\Delta$-MR | Q-7B 0.59、L-8B 0.57 最高,Gemma-2B 最低 0.32;全部模型 p<0.001 显著 | 此前无逐实例镜像量化评估 | 首次把镜像作为独立行为轴系统量化,不预设其对齐价值 |
局限与改进
作者承认的局限:SAGO 只测量行为在哪里变化、变化多大,不揭示因果机制,表征漂移、解码敏感性与镜像相互纠缠;数据集仅英文,跨语言、跨书写系统、跨文化提示惯例未验证;$\Delta$-BLEU 反映词面偏离,可能把无害改述误判为不稳定(故辅以 $\Delta$-BERT);N=16 经消融验证对典型逐提示不稳定性足够,但罕见或最坏情况失败可能需要更大样本;结构变体生成与社交语域镜像判别都依赖 GPT-4o-mini,可能引入风格偏置;闭源模型因 API 限制无法计算激活轴与对数概率轴(熵仅 GPT-5.4 可得),闭源结论只覆盖可见轴。我的补充观察:镜像检测是二值判断,规则启发式与 LLM 评审本身可能带噪声;各数据集等权逐提示池化假设内容分布均匀,与真实部署分布未必一致;$T=0$ 解码隔离了采样噪声,结论对温度大于 0 的实际部署场景的外推性未验证。
独立分析的弱点
独立分析几个弱点。第一,样本量小:每数据集仅 N=16 条提示,对长尾灾难性翻转的估计方差大,改进方向是分层扩样并报告最坏情形分位数而非只看均值。第二,镜像检测粗糙:二值检测器无法捕捉'部分镜像'(如只复制一半噪声),GPT-4o-mini 评审仅 10% 人工核验且可能与被评模型存在同源偏置,改进方向是引入多评审一致性校准与连续镜像强度指标。第三,语义保持靠 BERTScore > 0.85 阈值兜底,可能漏放语义微移的变体,把'真语义变化'误计为不稳定,改进方向是人工审核抽样加更强的语义等价判别模型。第四,$\Delta$-BLEU 与 $\Delta$-BERT 在多数模型上高度相关(如 Gemma-4-E4B 双双最高),六个轴可能存在冗余维度,改进方向是做轴间相关性与因子分解,给出最小充分轴集。第五,报告的是均值型 SGS 而非尾部风险,安全关键场景更关心'最坏变体上翻多严重',改进方向是补充最坏情况变体的分布统计。
未来方向
作者提出的方向:把 SAGO 扩展到多语言、更多任务族与部署特定领域;用中介分析或激活补丁(activation patching)把行为画像链接到因果机制,追问生成不一致、置信度漂移与响应镜像是否共享内部组件;以'增益是否跨轴、跨数据集、跨等价输入形式迁移'作为训练干预的评判标准,而非单轴下降。基于本文成果还可延伸:将 SGS 作为对齐训练的正则项,直接惩罚语义等价输入下的行为偏差,让稳定性成为可优化的训练目标;建立模型卡式的'稳定性画像'发布标准,按轴、按领域给出部署建议;研究镜像程度与用户信任、下游任务表现的相关性,确定多大程度的风格顺应是有益的;以及把逐实例稳定性与安全性的关系(如越狱提示的措辞变体、拒绝行为的一致性)纳入统一评测框架。
复现评估
复现条件较好。论文给出参考实现链接,六个数据集全部公开(TruthfulQA、Natural Questions、Alpaca、SimpleQA Verified、TriviaQA、HotpotQA);8 个开源模型权重公开,变体模板、强度级别与放置位置在附录 A,阈值稳健性在附录 B,逐数据集完整结果在附录 C,样本量消融在附录 D,透明度高。算力门槛低:作者仅用 4 张 RTX 2080 Ti 加 4 张 GTX 1080 Ti(CUDA 12.8)跑完全部开源实验,消费级显卡即可复现;闭源部分需 GPT-5.4、Gemini-2.5-Flash、Claude-Sonnet-4.6 的 API 费用,且激活与概率轴对闭源不可复现,只能复现 BLEU/BERT/镜像三轴。主要复现风险在镜像检测器:社交语域镜像依赖 GPT-4o-mini 评审且仅 10% 人工核验,规则启发式细节需读代码确认。总体属于中低难度、高透明度的复现项目。
论文图表
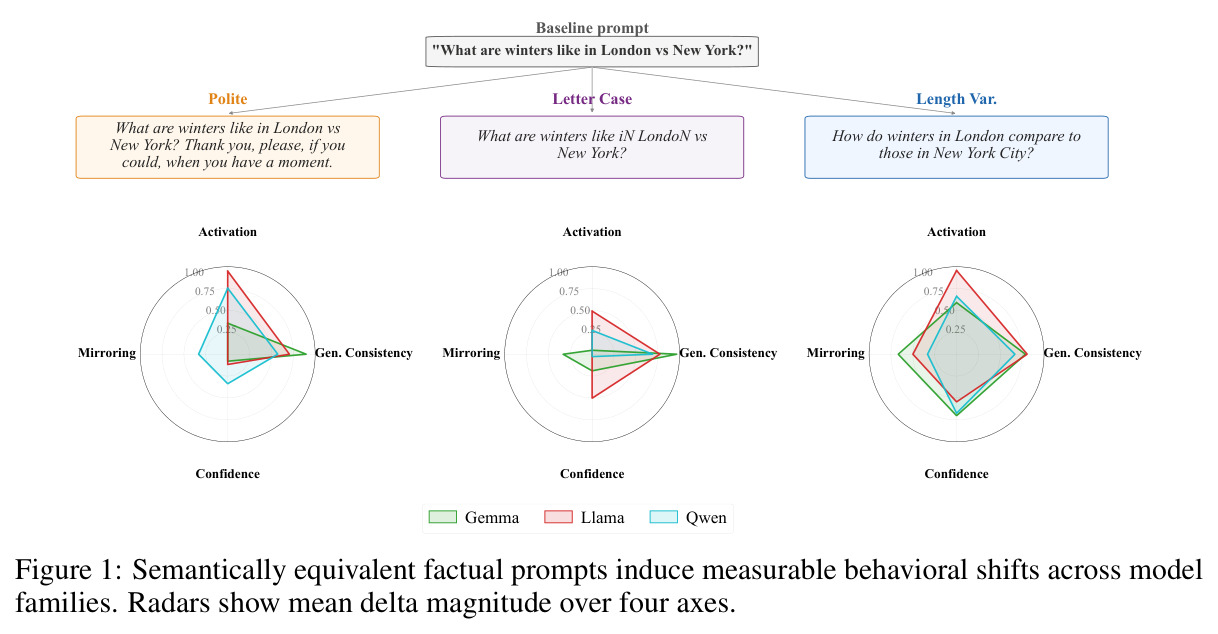
以基线提示 "What are winters like in London vs New York?" 为例,展示礼貌化、大小写改变、长度伸缩三种语义等价变体,并对 Gemma、Llama、Qwen 三个模型族分别画出激活、生成一致性、置信度与镜像四个轴的平均增量幅度雷达图,可见仅改写措辞就能引发可测量的行为偏移。
这张图用最直观的方式呈现 SAGO 的核心直觉——语义等价改写即可触发多轴行为变化,是理解全文动机与框架设计的入口,不看它难以理解为什么要做逐实例多轴评估。