AutoGUIWorld:将图像生成器作为 GUI 智能体的视觉世界模型 AutoGUIWorld: Image Generators as Visual World Models for GUI Agent
免部署软件环境,用图像生成器合成 GUI 训练轨迹并成功迁移
前置知识
GUI 智能体(GUI Agent)
通过观察屏幕截图、输出鼠标点击/拖拽和键盘输入来自动完成软件任务的模型。它把人机交互形式化为 POMDP:智能体看不到操作系统内部隐状态 $s_t$,只能看到渲染后的截图 $\tilde{s}_t = \Omega(s_t)$,并根据截图、历史 $h_t$ 和任务指令 $\tau$ 输出原子动作 $a_t$。OSWorld、ScreenSpot-Pro 等基准就是用真实虚拟机评测这类智能体的任务完成率。
本文的全部目标就是为这类智能体合成训练数据,理解其输入输出形式(截图进、坐标动作出)才能明白为什么数据需要空间标注和上下文保持。
视觉世界模型与转移分布
世界模型指能预测'执行某个动作后环境会变成什么样'的模型。在 GUI 场景中,关键对象是观测层转移分布 $P(\tilde{s}_{t+1} \mid h_t, a_t)$:给定历史和动作,下一张截图的分布。本文提出'交互保真度'松弛——训练数据只由 $P$ 决定,无需重建文件系统、应用内部等隐状态,只要合成截图分布与真实系统一致即可。
这是论文的理论支点:正是这个松弛让通用图像生成器可以充当免训练的世界模型,跳过隐状态建模。
图像到图像编辑(Image2Image)
以一张原图为参考、按文字提示对图像做局部修改的生成技术(本文用 gpt-image-2)。它与从零生成不同:模型需要在改动指定区域的同时保留布局、风格和无关内容。本文将其用作动作条件的视觉状态转移模型 $\tilde{s}_{t+1} \sim M_V(\tilde{s}_t, r_t)$,逐帧编辑出轨迹。
方法的核心引擎就是图像编辑,其'保留上下文'能力直接决定合成轨迹质量,也是后续局限性分析(文本输入、拖拽出错)的根源。
分布对齐度量:MMD 与 C2ST
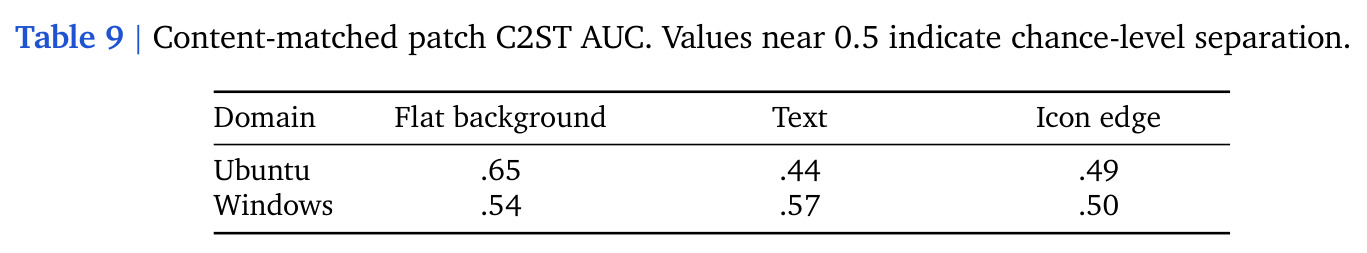
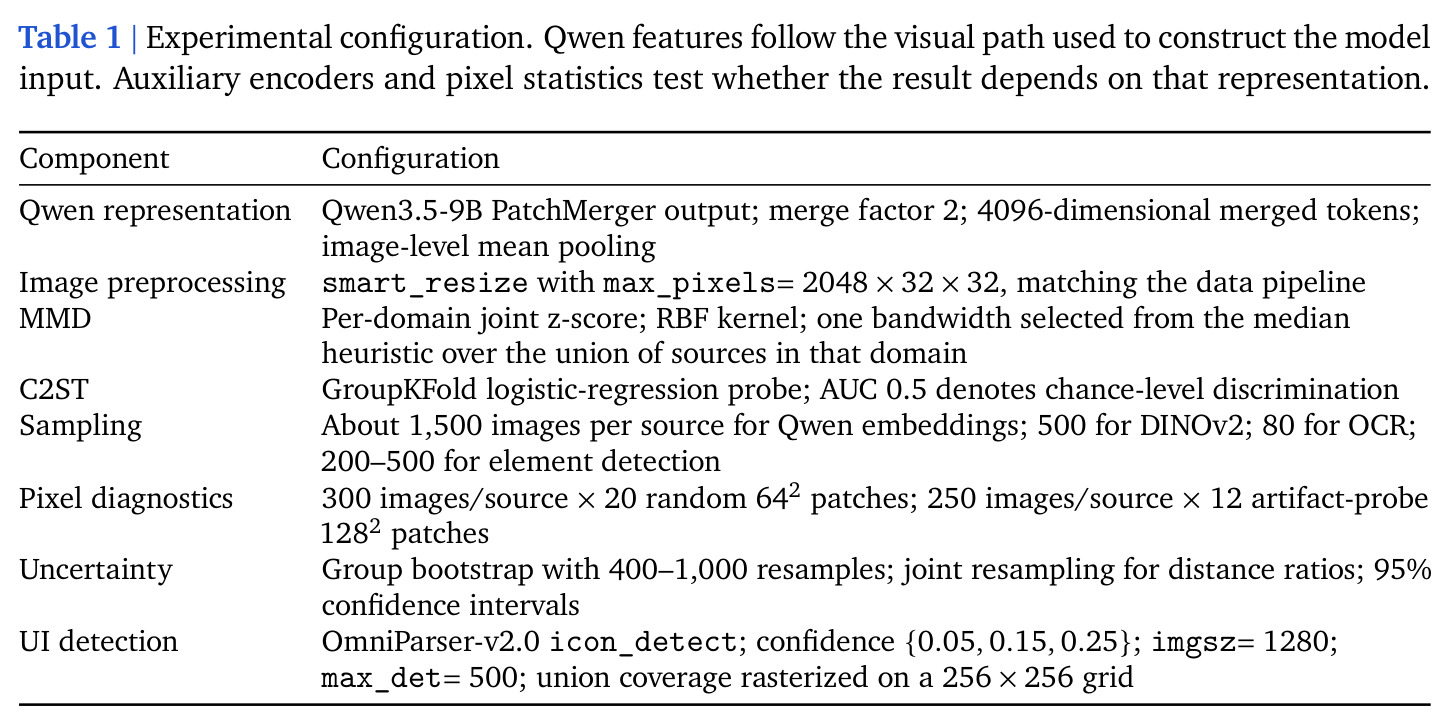
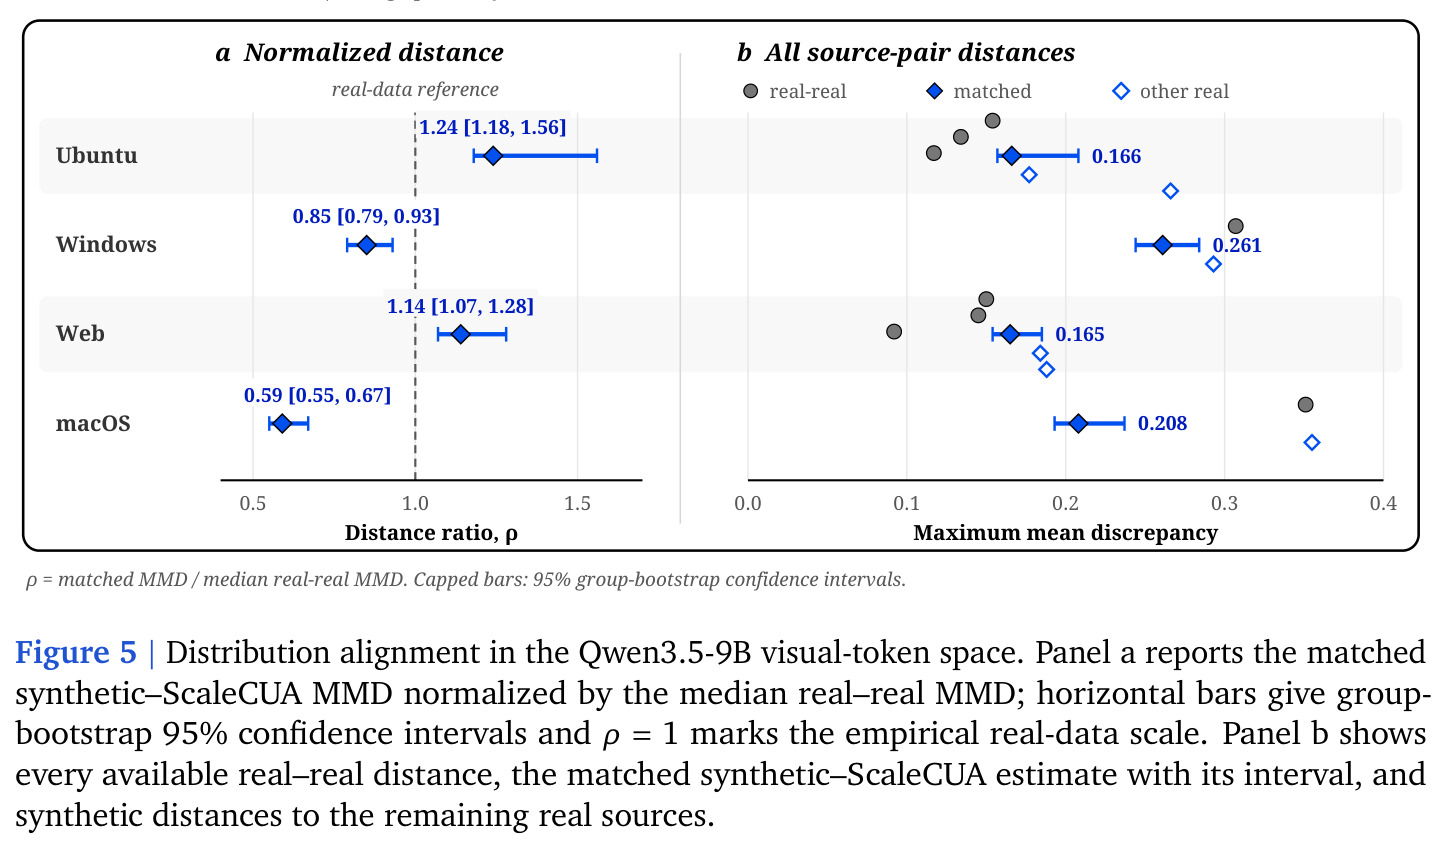
MMD(最大均值差异)用再生核希尔伯特空间中的均值嵌入距离衡量两个样本分布差异,本文用 RBF 核、按域联合标准化后计算;C2ST(基于分类器的双样本检验)训练一个逻辑回归分类器区分两组样本,AUC 接近 0.5 说明两组不可分、接近 1 说明极易区分。两者常用于判断合成数据与真实数据的特征分布是否一致。
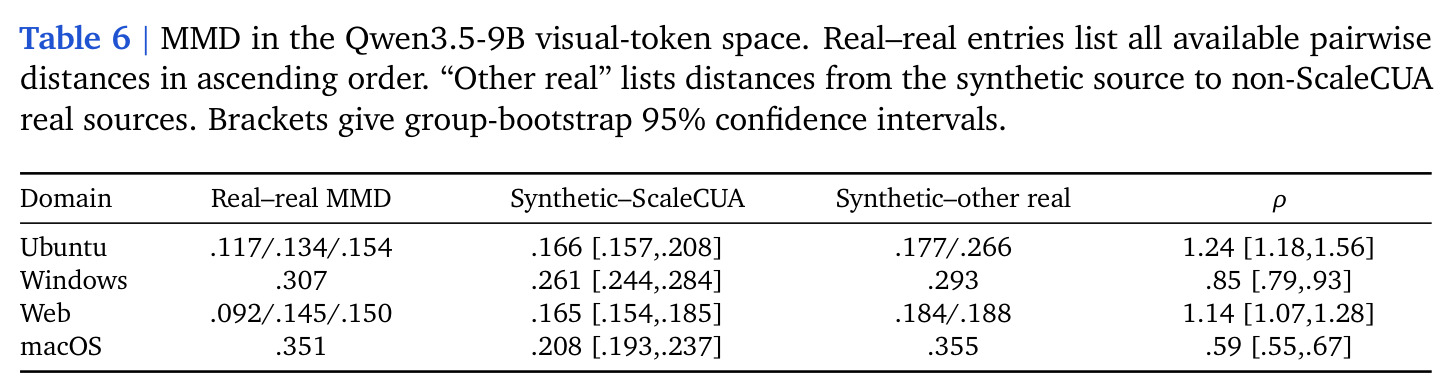
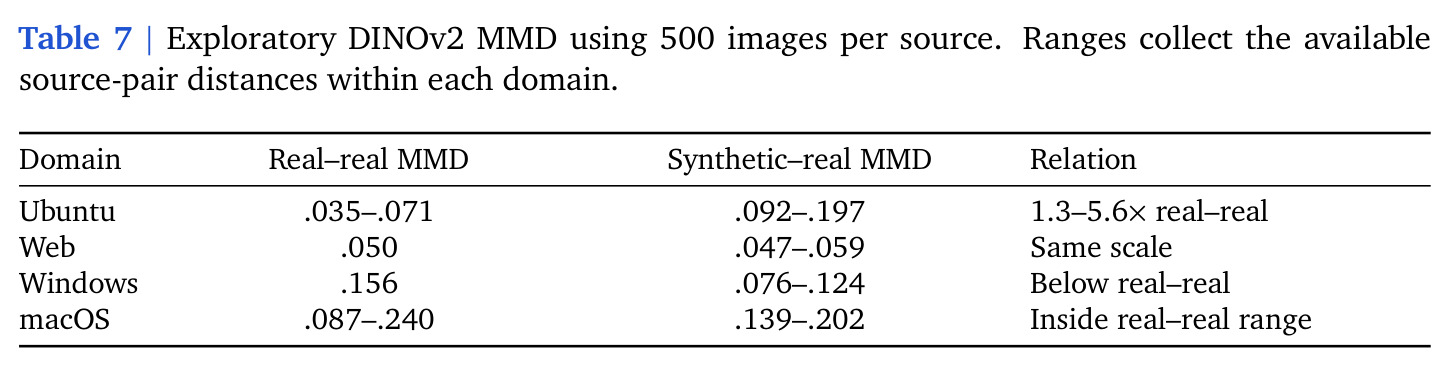
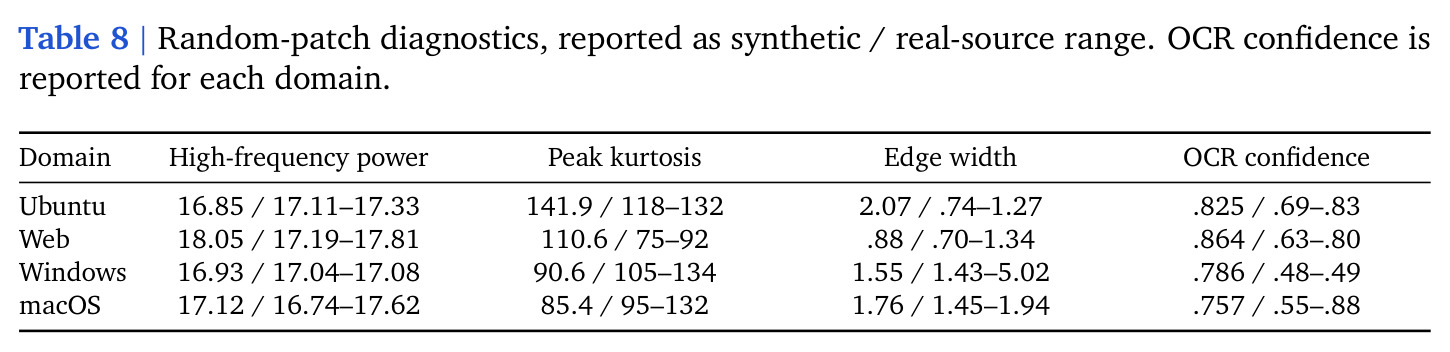
论文第 4 节用 Qwen/DINOv2 特征上的 MMD 和 C2ST 量化合成截图与 ScaleCUA 等真实数据的对齐程度,读懂数据质量论证必须理解这两个指标。
监督微调(SFT)与后训练
在预训练模型上用'输入-目标输出'成对数据继续训练。GUI 智能体的 SFT 实例通常是:多轮历史截图+任务指令作为输入,下一步动作(含坐标)作为目标。本文把合成轨迹转成 79,266 条单步训练样本,微调 Qwen3.5-35B-A3B 得到 AGW-35B,并与用 35 万条真实人类演示(AgentNet)训练的模型对比。
理解训练实例如何从轨迹构造,以及'8 万合成样本胜过 35 万真实样本'这一对比的含义,是评估本文贡献的关键。
研究动机
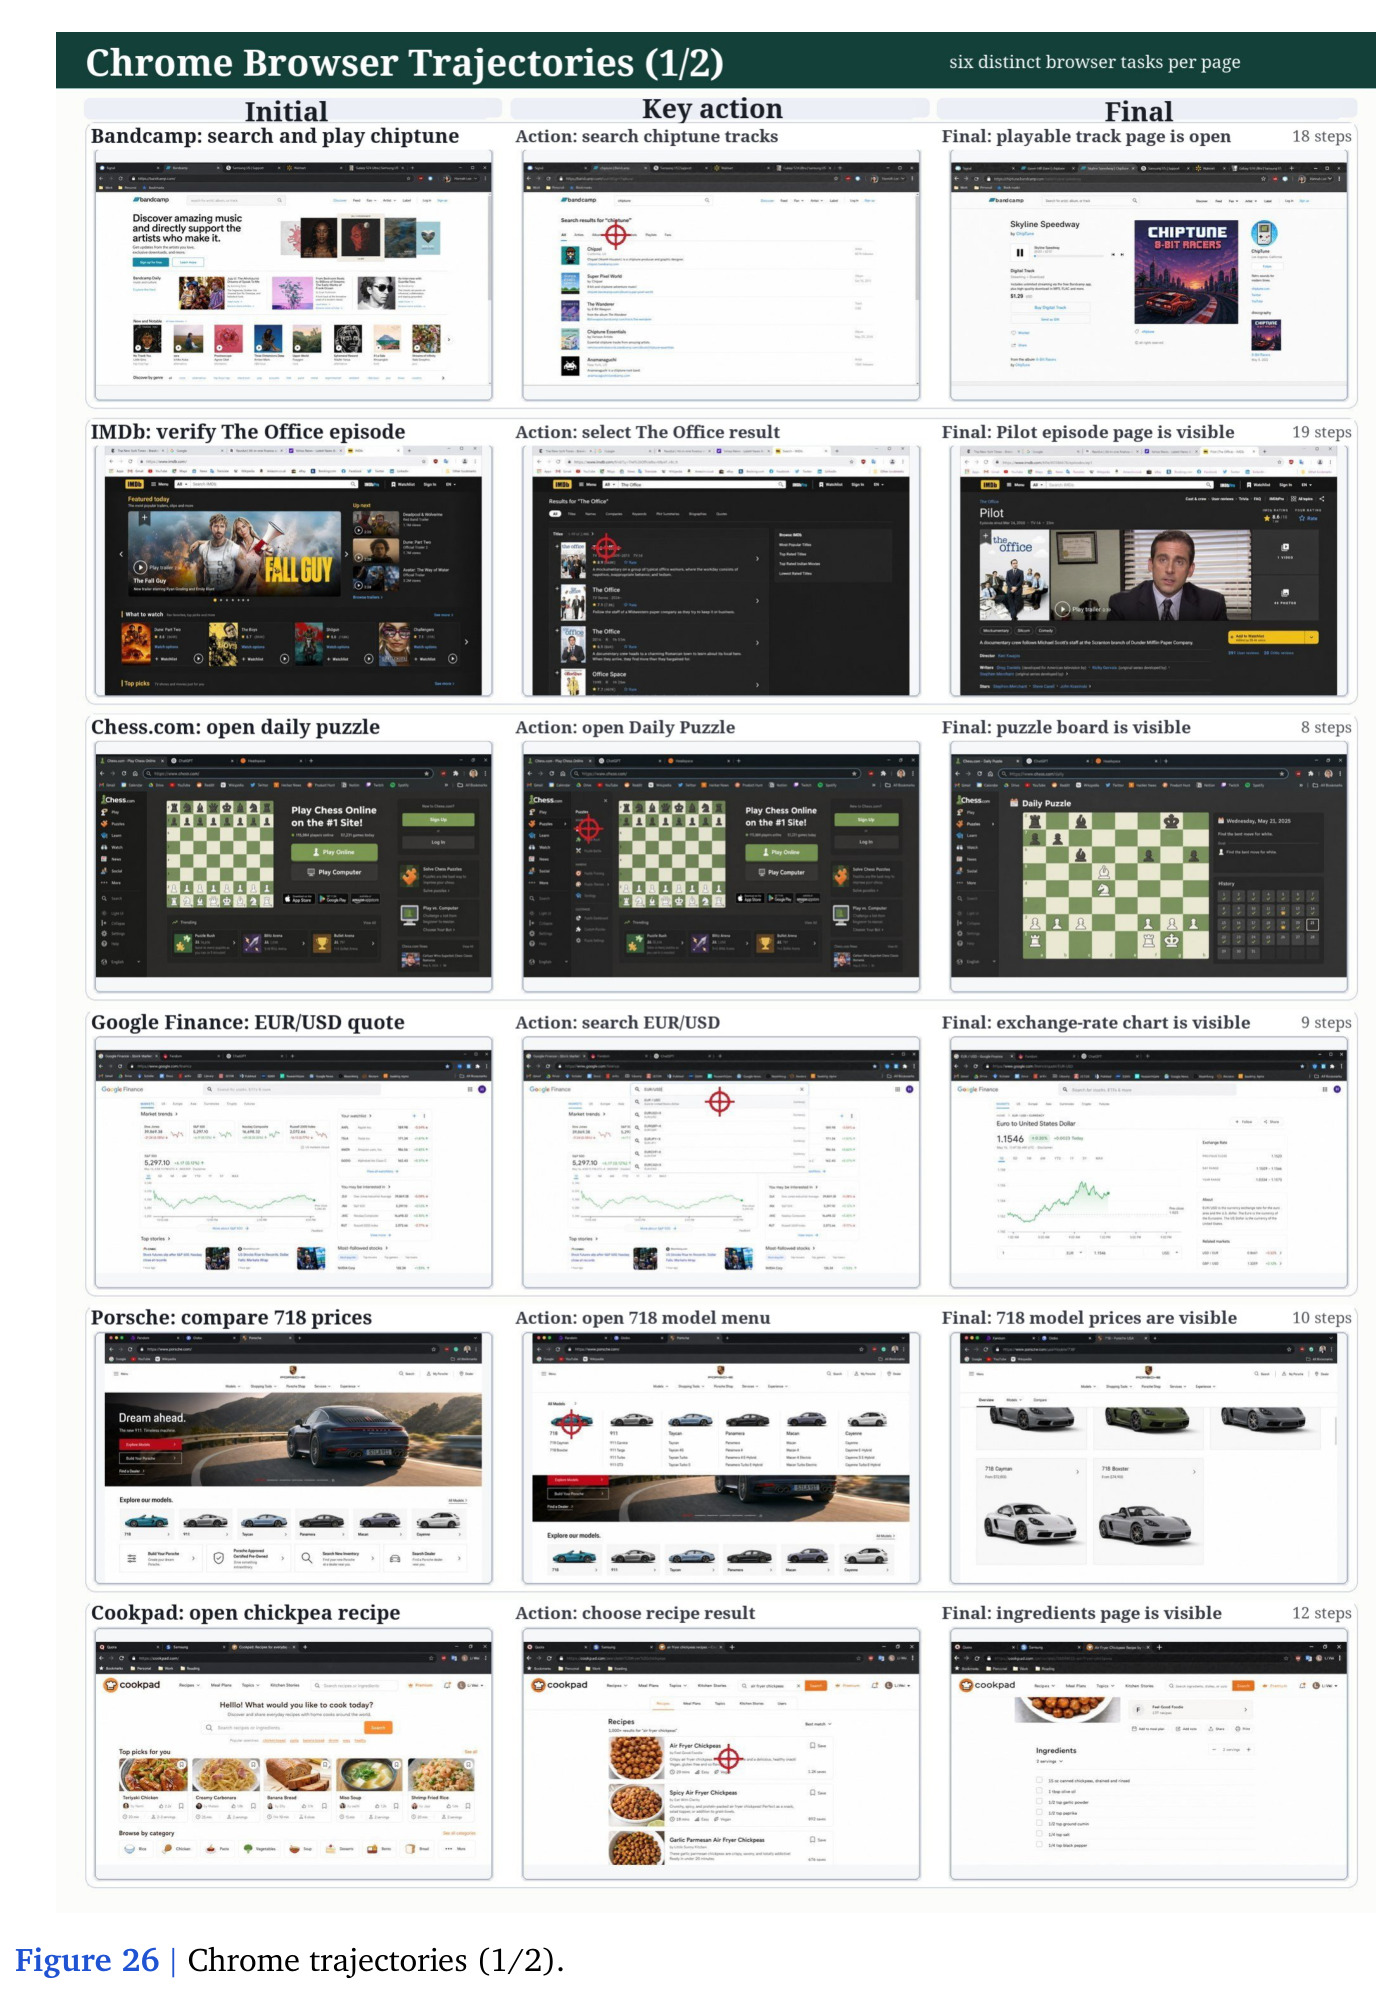
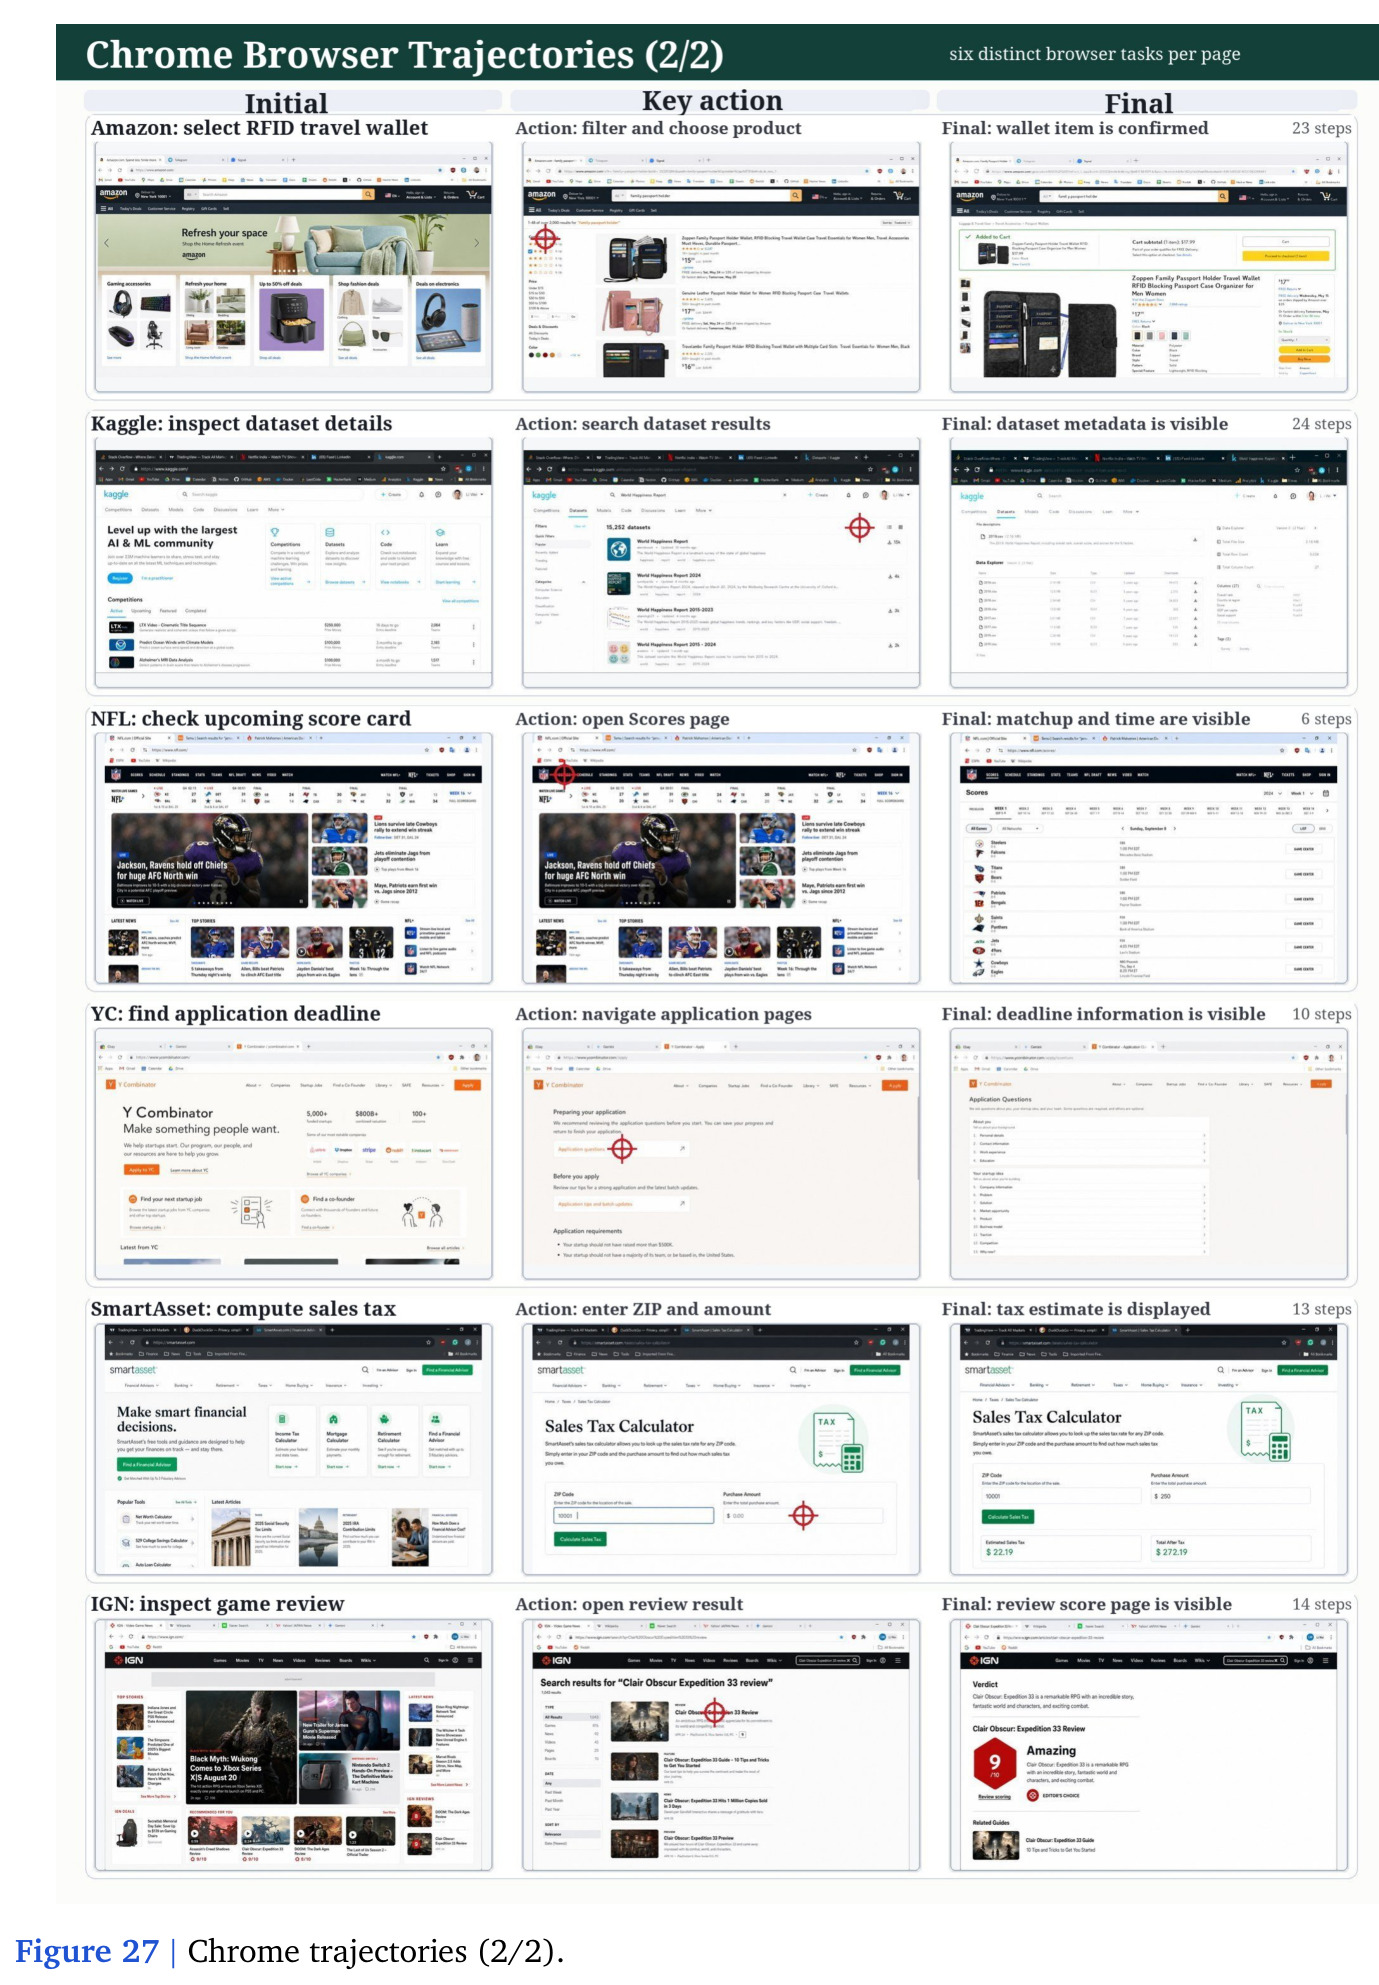
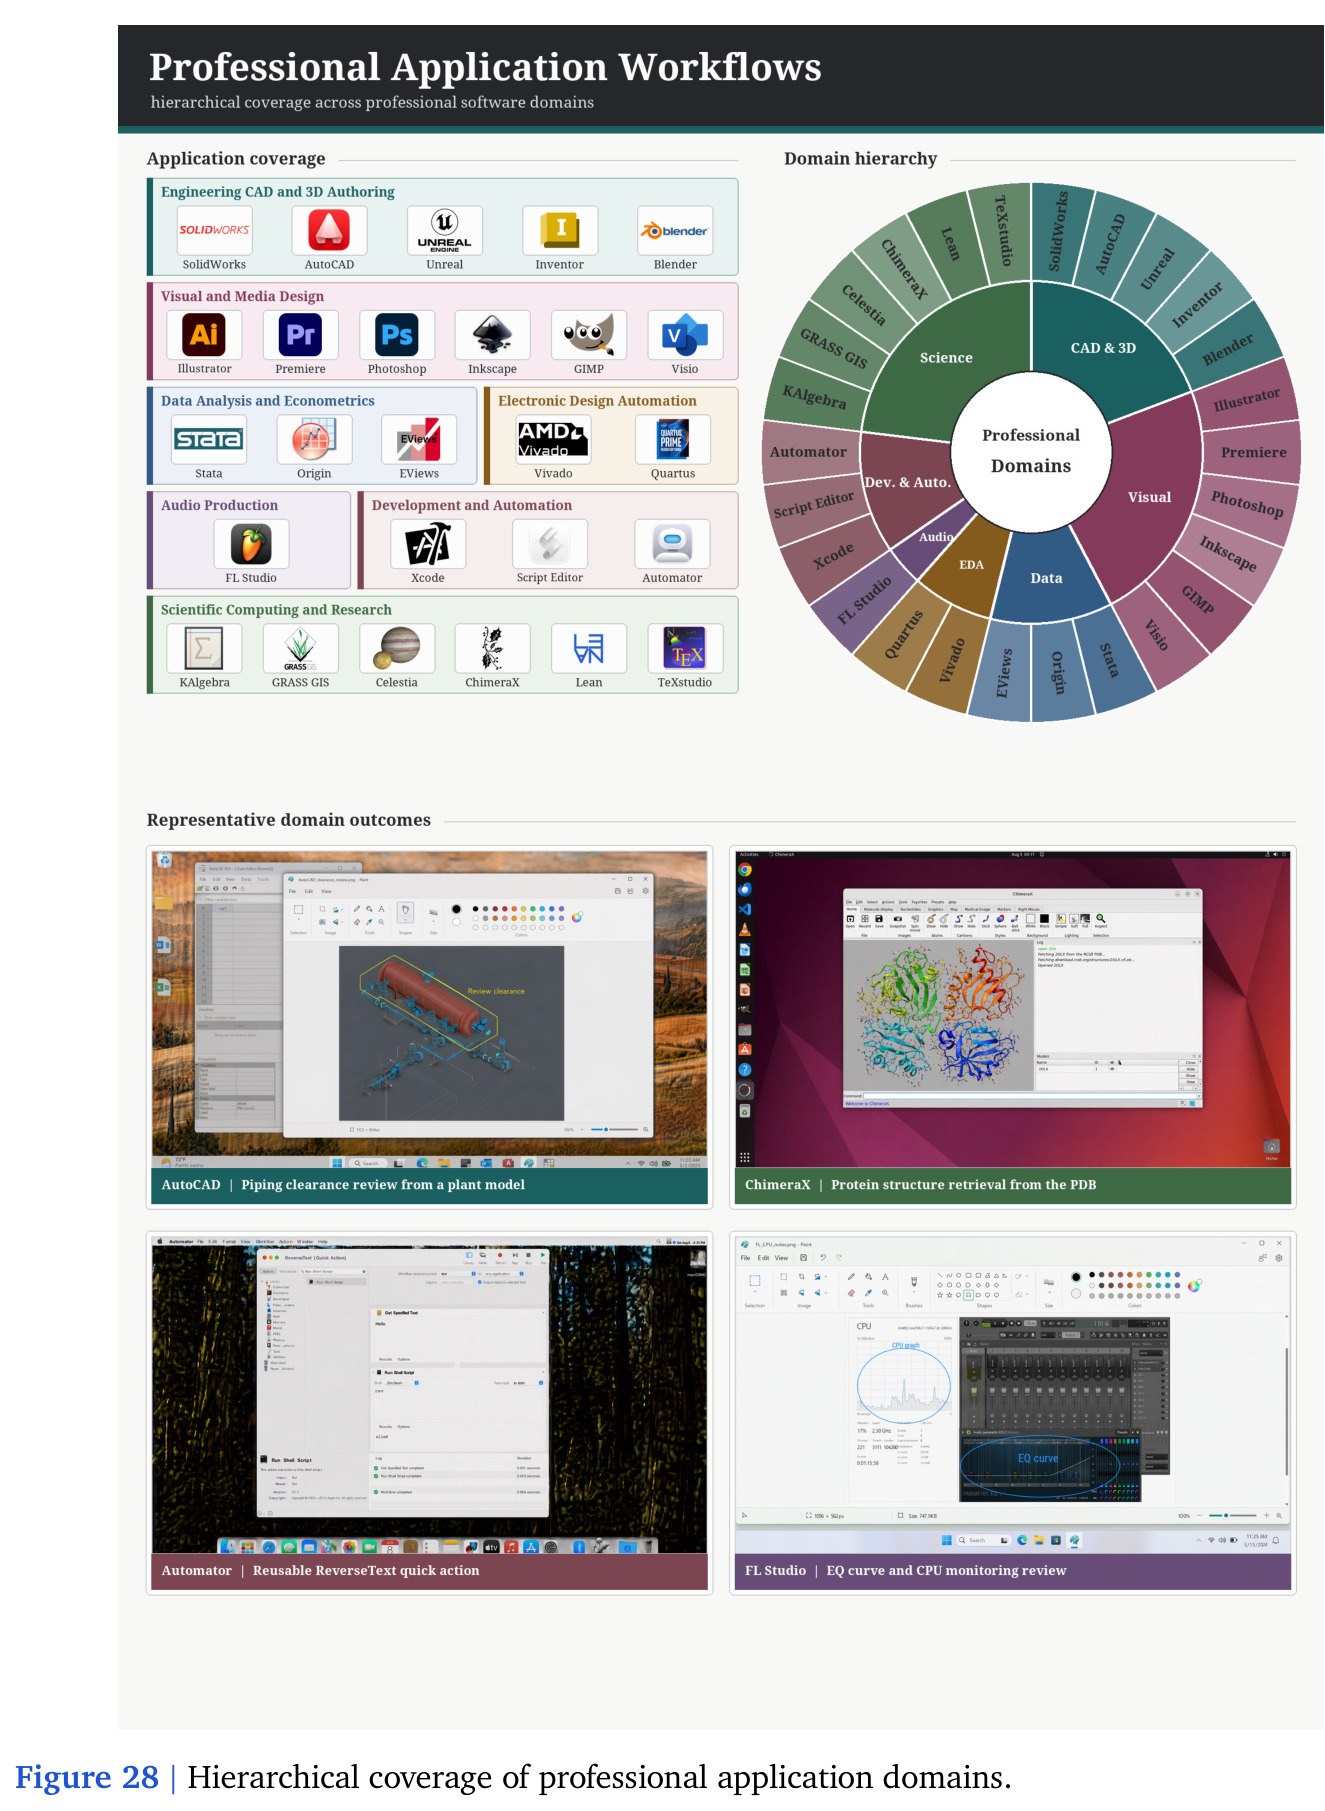
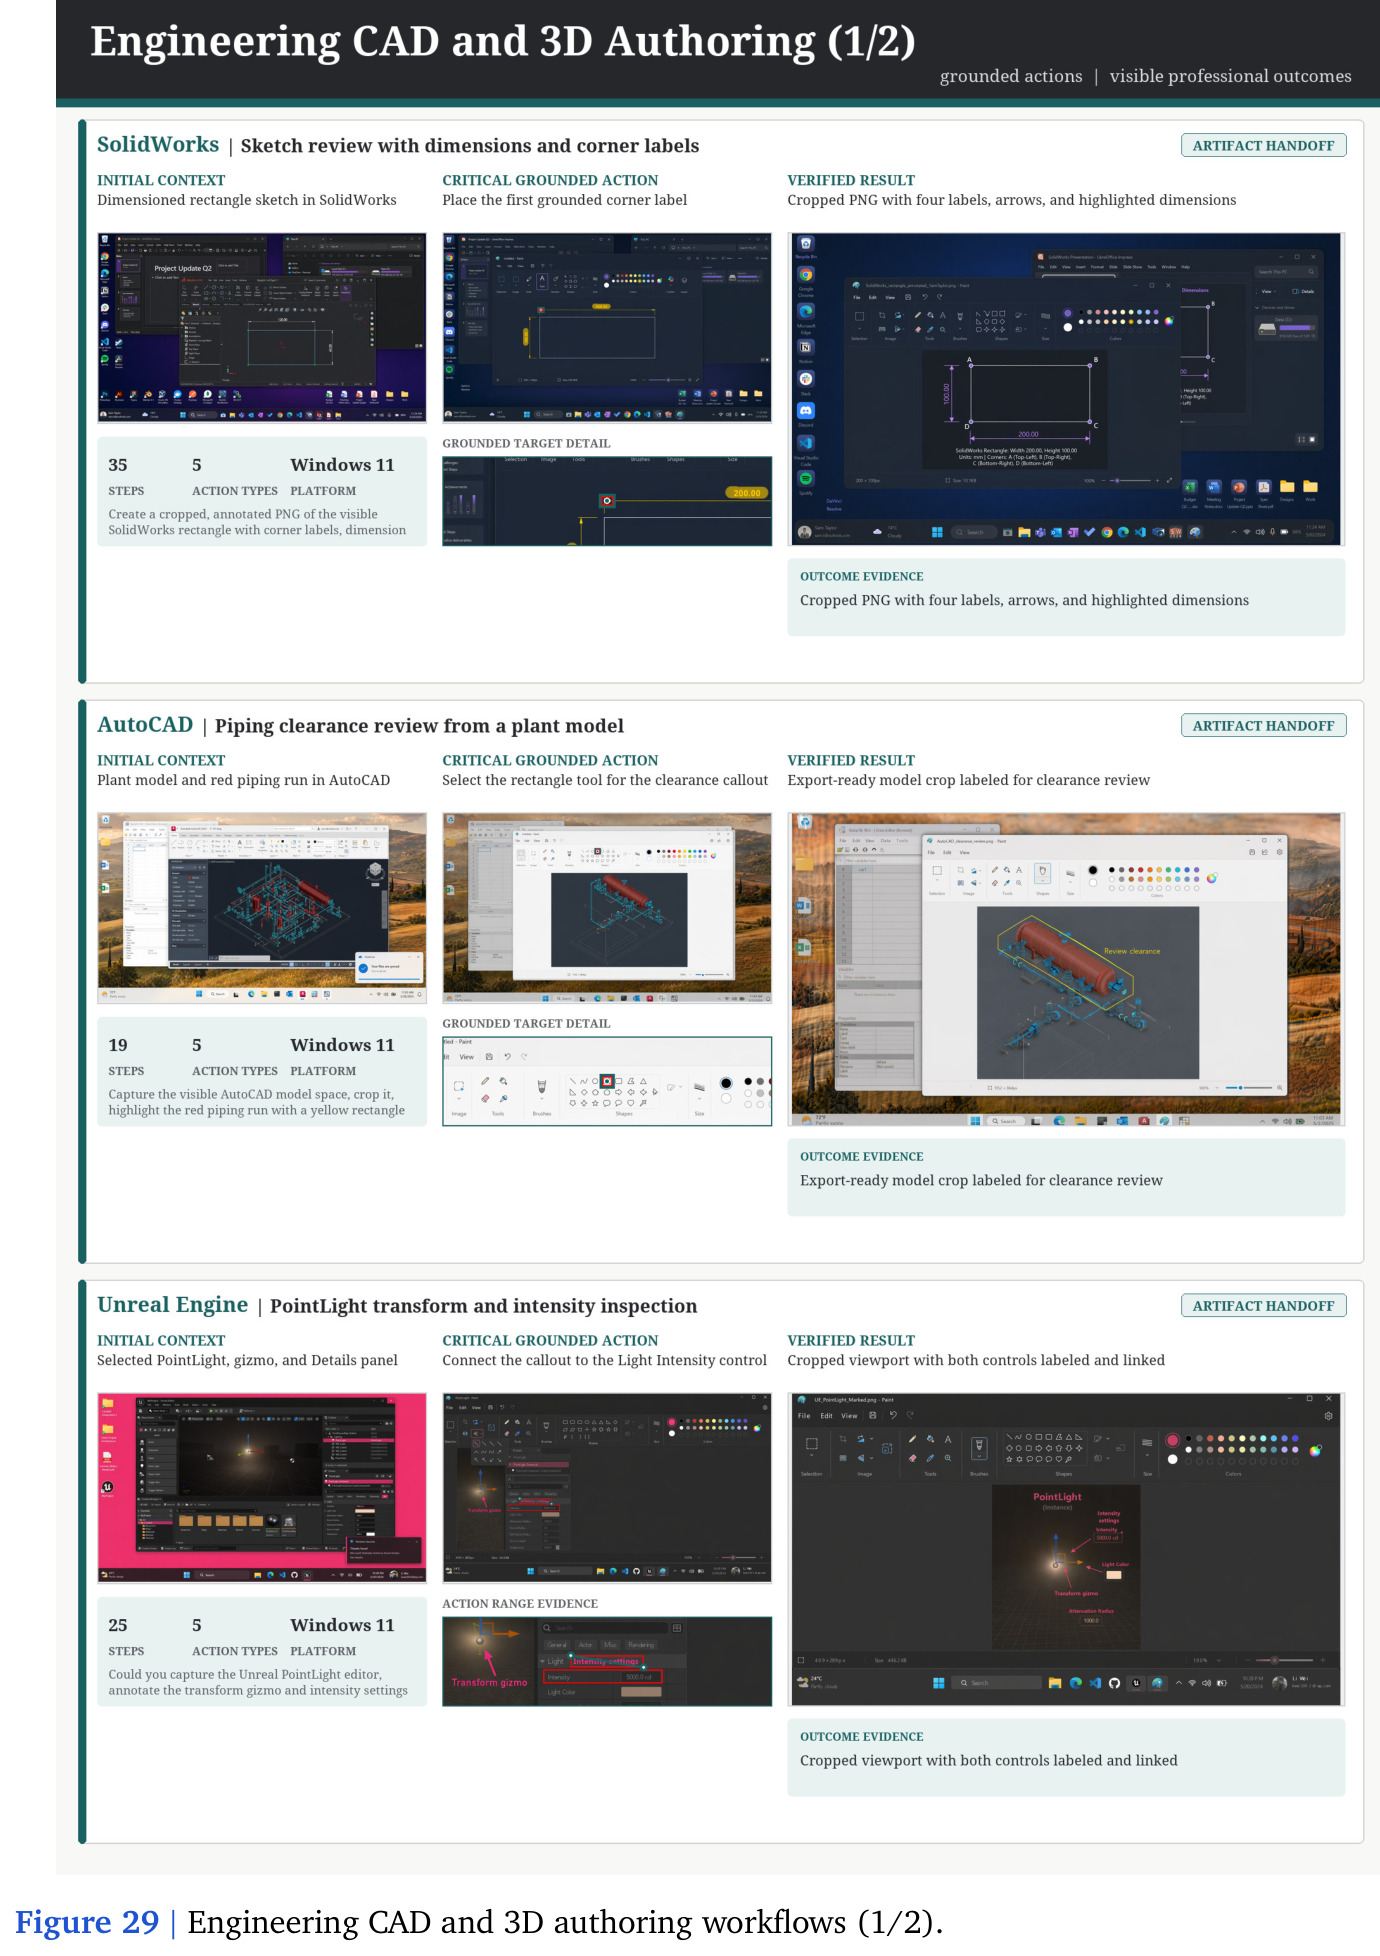
GUI 智能体的能力高度依赖大规模、多样的交互轨迹,但轨迹多样性受限于可部署的应用、界面状态和工作流。要收集新数据就得真实部署软件:为 CAD、电子设计自动化、科学计算等专业软件准备依赖、运行时和初始化流程,还要应对许可与账号限制,成本随环境池扩大线性增长。现有获取路线各有天花板:人类演示(如 AgentNet 的 35 万条轨迹)覆盖受限于演示者用过的软件;自动探索与任务合成依赖可执行环境;从教程和录屏提取则被记录中出现的界面锁死。在同一环境内堆更多轨迹无法弥补缺失软件的交互经验,而论文实验表明专业软件恰恰是智能体的短板——基线模型在 ScienceBoard 科学软件上成功率仅 14.0%,GRASS GIS 上只有 2.9%。
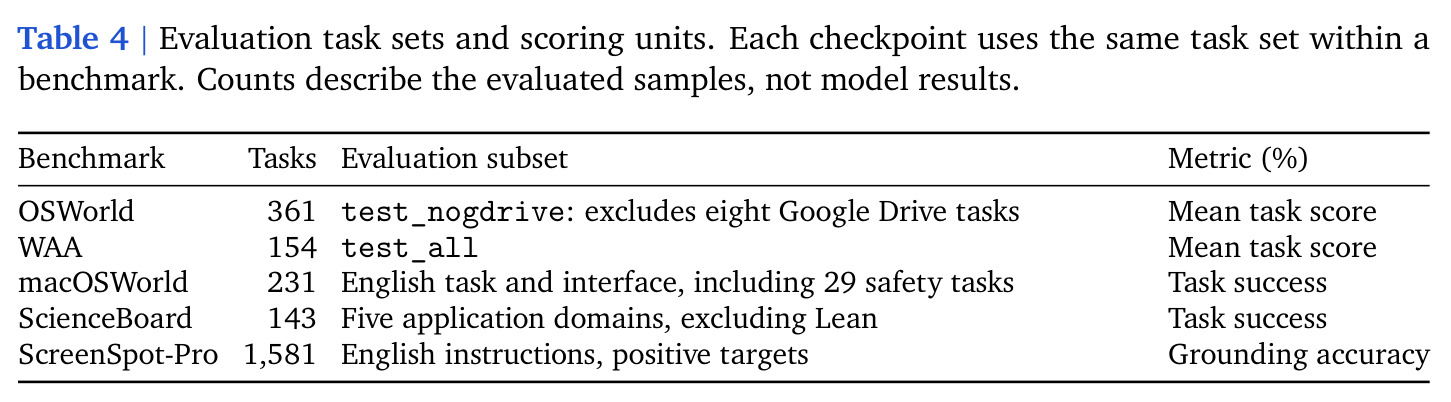
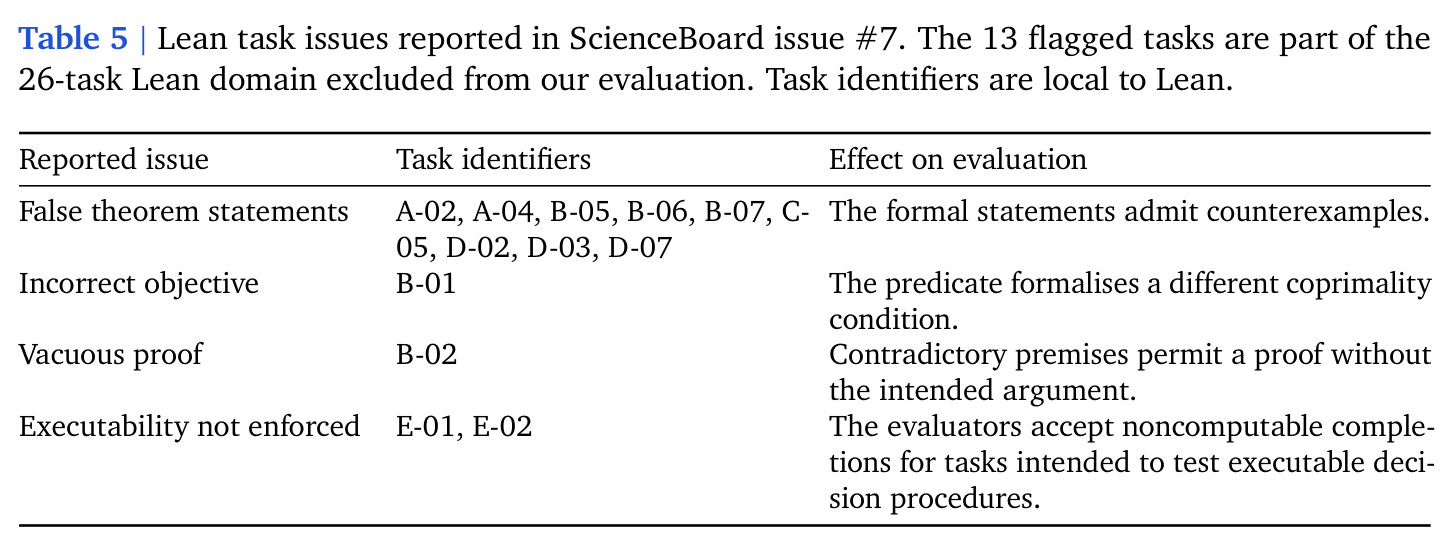
本文的目标是本文目标是构建一个'免环境'的 GUI 数据引擎:不部署、不运行任何真实软件,就合成出状态转移连贯、带空间动作坐标的多步截图-动作轨迹,并证明这些数据能有效迁移到真实评测。具体要同时满足三个生成式方法长期难以兼顾的约束:一是动作忠实性,后一帧截图必须真实执行前一帧动作的语义(如打开保存对话框时应保留背后的文档内容);二是上下文保持,编辑一个区域时无关内容必须原样保留;三是空间监督,每个指向性动作都要有截图上的可训练坐标标签。最终检验标准是:用合成数据微调 Qwen3.5-35B-A3B 后,在 OSWorld、Windows Agent Arena、macOSWorld、ScienceBoard 四个真实交互基准和 ScreenSpot-Pro 定位基准上取得可测量、可复现的提升。
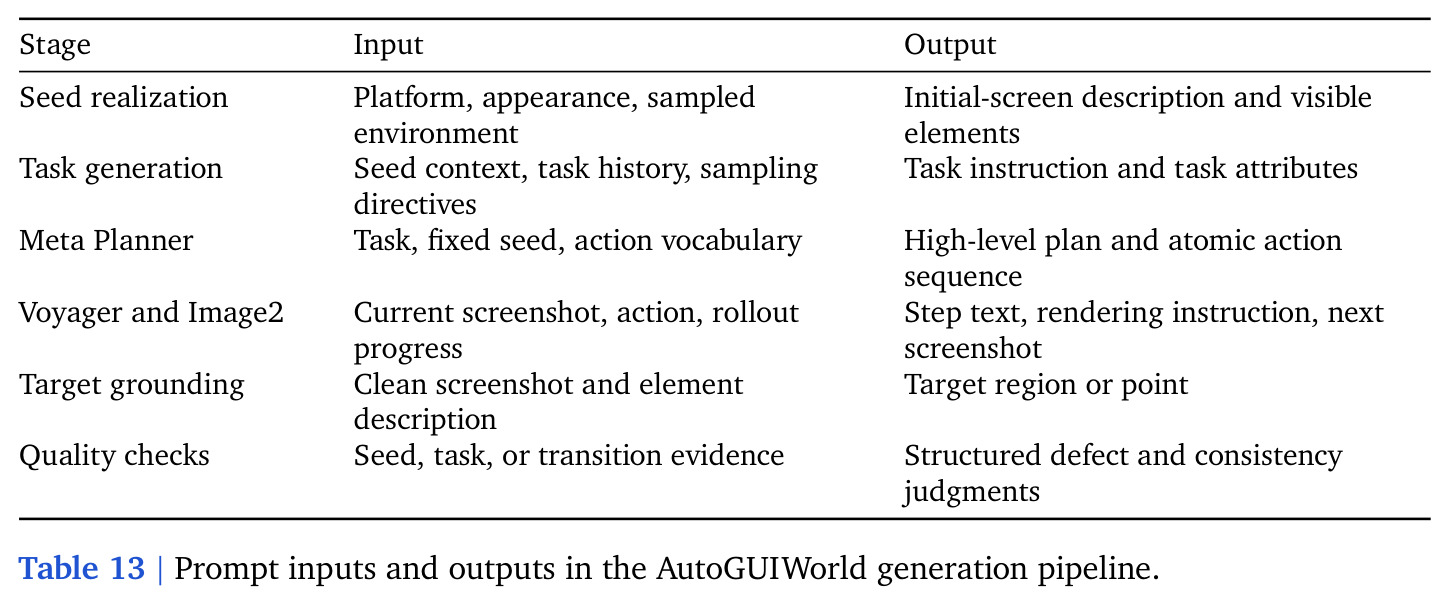
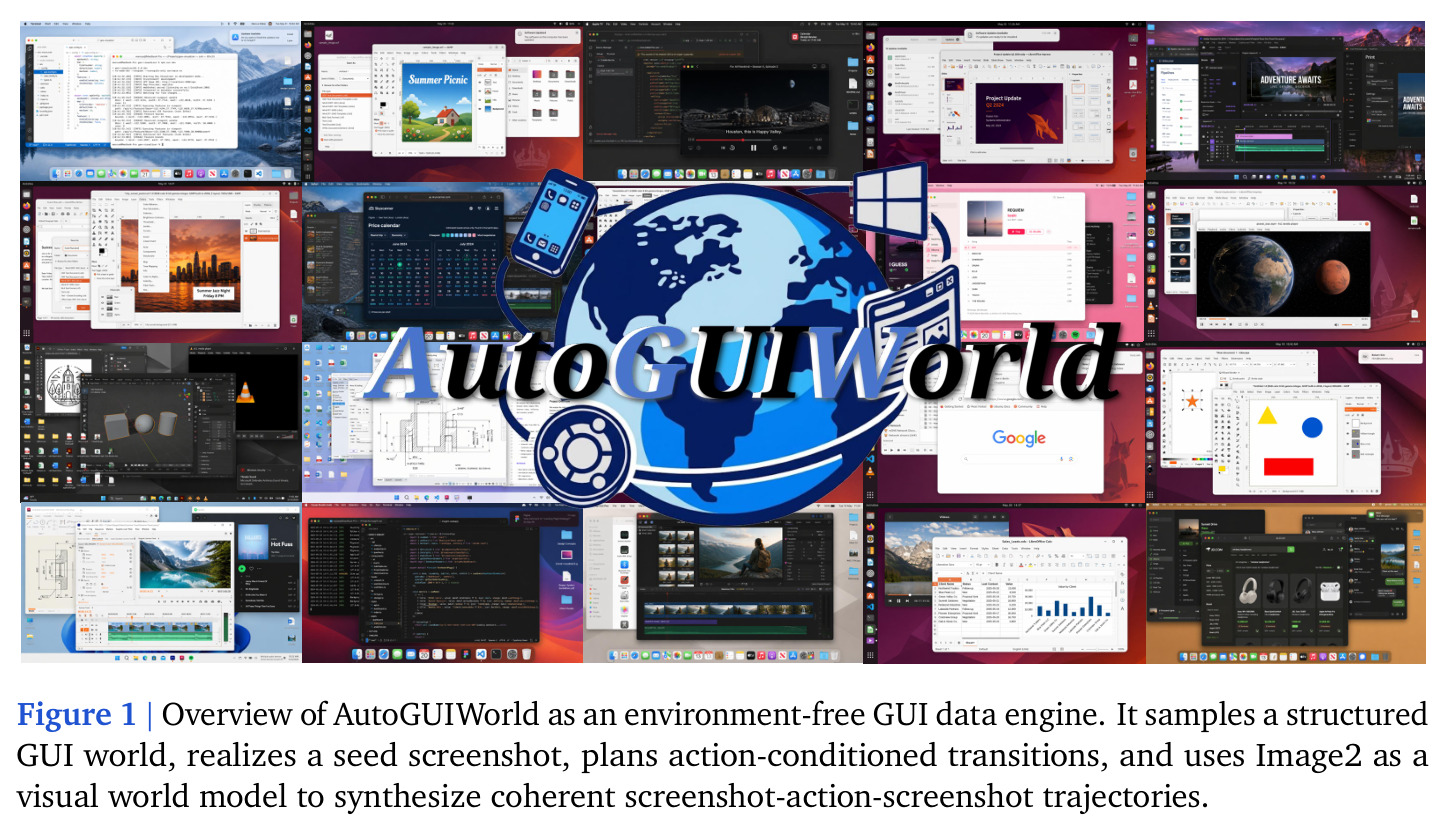
与已有工作不同的是,已有生成式路线要么构建可执行环境加验证器,要么用结构化状态、文本或代码渲染模拟观测,要么训练专门的视觉预测模型来预测未来截图。本文的独特切入是直接征用预训练通用图像生成器(gpt-image-2)作为动作条件的视觉世界模型——不训练任何新的转移模型。关键理论洞察是'交互保真度'松弛:把 GUI 交互写成 POMDP $M=(S, A, T, \tilde{S}, \Omega)$ 后,训练数据完全由观测层转移 $P(\tilde{s}_{t+1} \mid h_t, a_t)$ 决定,隐状态 $s_t$ 与真实转移 $T(s_{t+1}|s_t,a_t)$ 从未被消费,因此只要合成截图分布忠实即可,无需重建文件系统或浏览器 DOM。为了补齐图像模型不懂任务语义、会产生幻觉的短板,再用元规划器提供任务逻辑、Voyager 提供逐帧渲染提示、过渡级 VLM 审计过滤缺陷样本,把这三块拼成一个可行的数据引擎。
核心方法
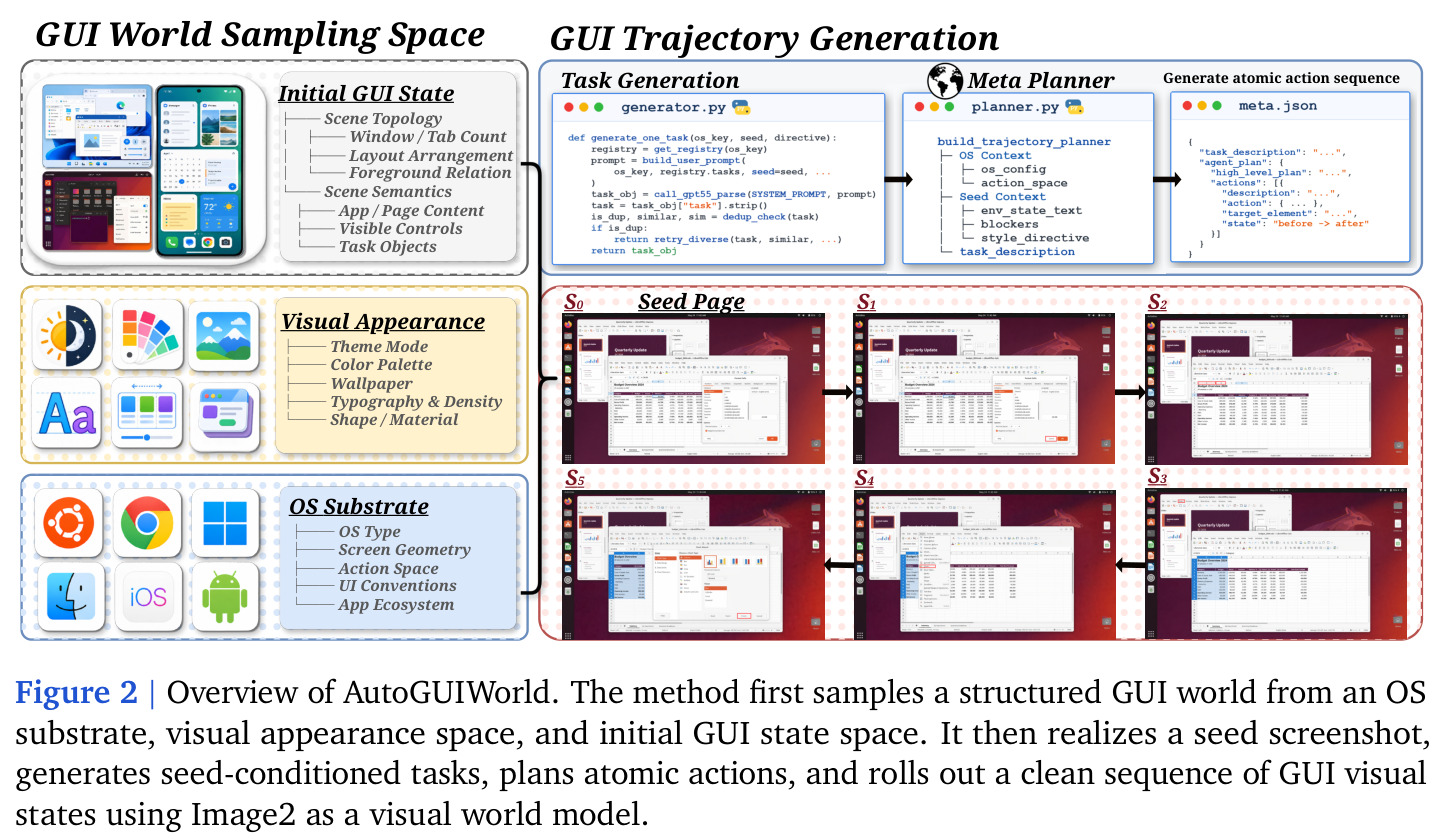
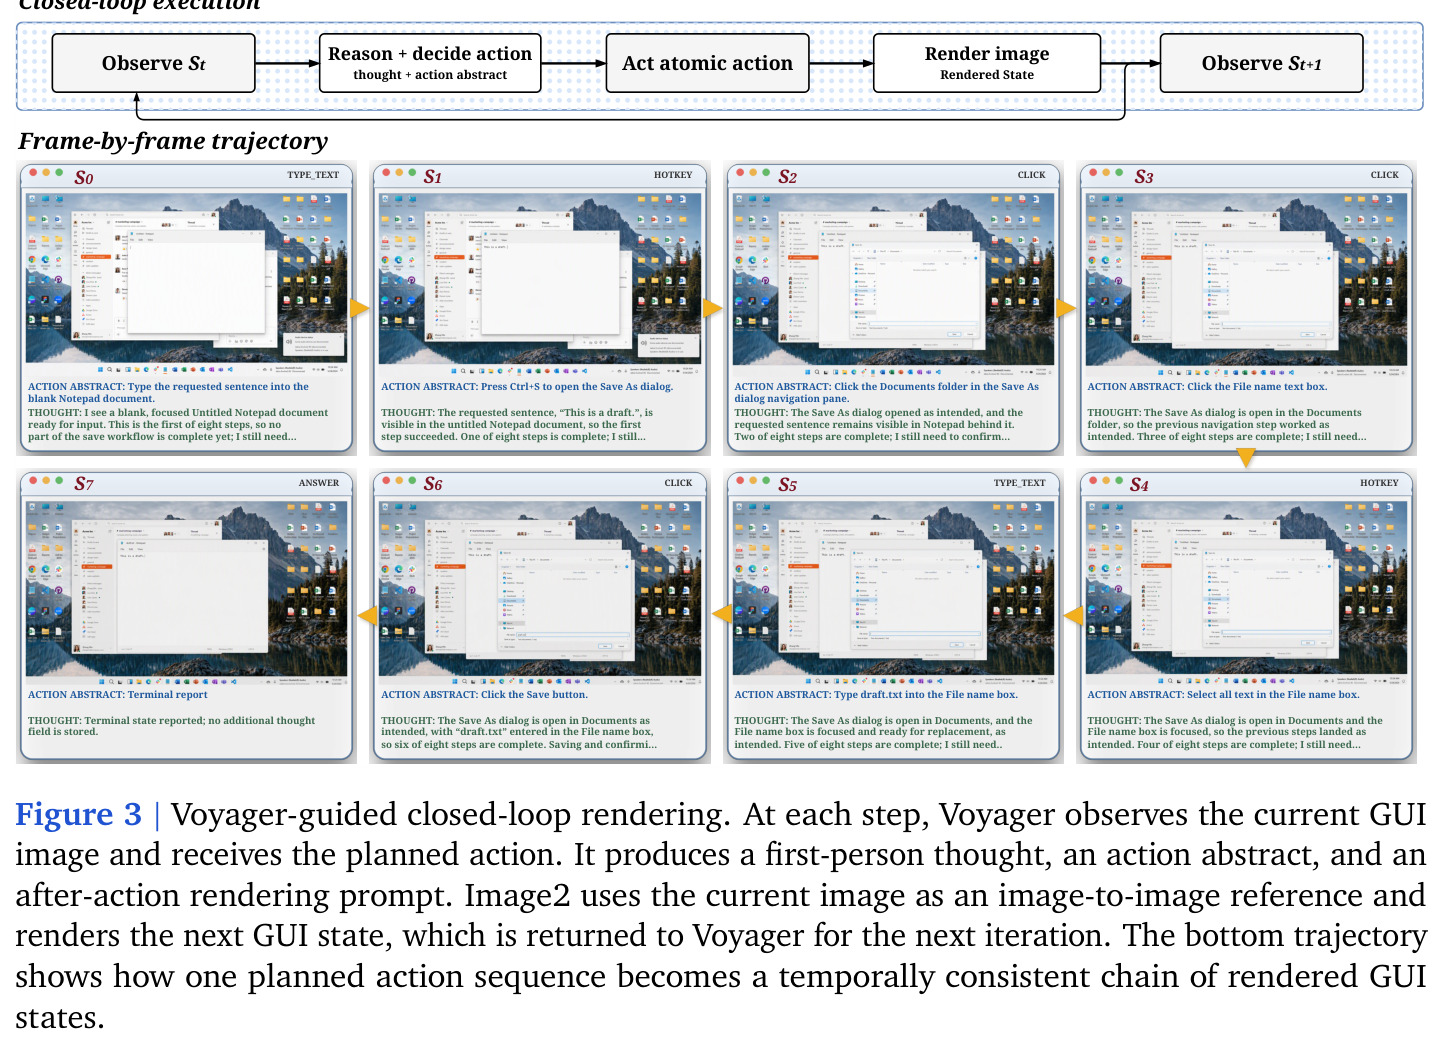
AutoGUIWorld 是规划器引导的视觉世界模型数据引擎,分两层。规划层由元规划器 $\Pi_\psi$ 负责:根据任务指令 $\tau$ 和固定种子上下文 $c_0$,一次性生成原子动作序列 $a_{0:T-1}$ 及每步预期视觉变化 $\delta_{0:T-1}$,即 $(a, \delta) \sim \Pi_\psi(\tau, c_0)$,负责任务逻辑、动作顺序与前置条件。视觉世界模型层由图像生成器 Image2 充当转移模型:滚动中 Voyager 结合当前截图 $\tilde{s}_t$、计划动作和上下文,把 $\delta_t$ 扩写成渲染提示词 $r_t$,再按 $\tilde{s}_{t+1} \sim M_V(\tilde{s}_t, r_t)$ 编辑出下一帧,形成 $\tilde{s}_0 \to \tilde{s}_1 \to \cdots \to \tilde{s}_T$ 的时间连贯链。设计哲学是解耦:规划器决定'接下来发生什么',图像模型决定'界面长什么样',语义规划不受图像模型短视干扰。
核心创新是把 GUI 轨迹生成表述为观测级生成问题并做出关键松弛。论文把 GUI 交互形式化为 POMDP $M=(S, A, T, \tilde{S}, \Omega)$,策略 $\pi_\theta(a_t \mid h_t, \tau)$ 以完整历史为条件,因为滚动位置、对话框栈等使单帧非马尔可夫。长度 $T$ 的轨迹联合分布分解为 $p(\tau, \tilde{s}_{0:T}, a_{0:T-1}) = p(\tau, \tilde{s}_0) \prod_t \pi(a_t|h_t,\tau) P(\tilde{s}_{t+1}|h_t,a_t)$,训练数据只涉及观测层转移 $P$。由此定义'交互保真度':合成后帧只需匹配真实系统在相同历史下的截图分布,隐状态无需存在。与已有 GUI 世界模型的本质区别:不训练专用转移预测器、不生成可执行代码,而是把预训练图像编辑器当免训练世界模型,用任务规划弥补其不懂任务语义、用过渡级质检弥补其幻觉,首次把图像生成先验系统性转化为 GUI 训练数据源。
方法步骤详情
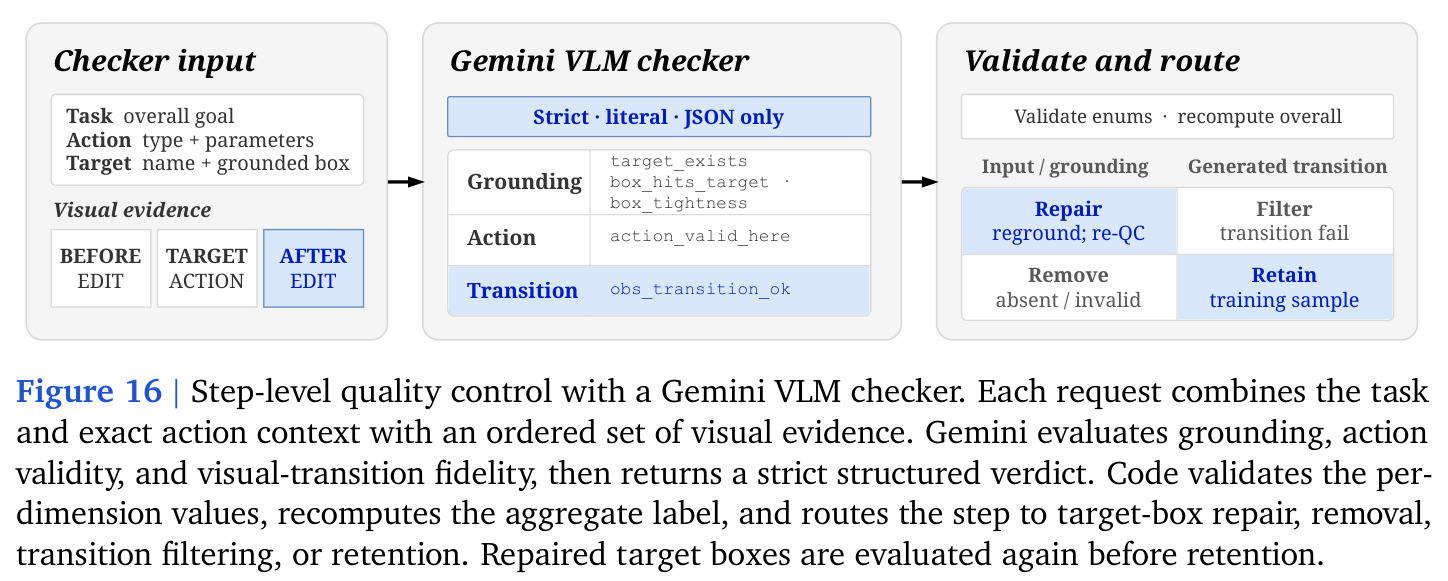
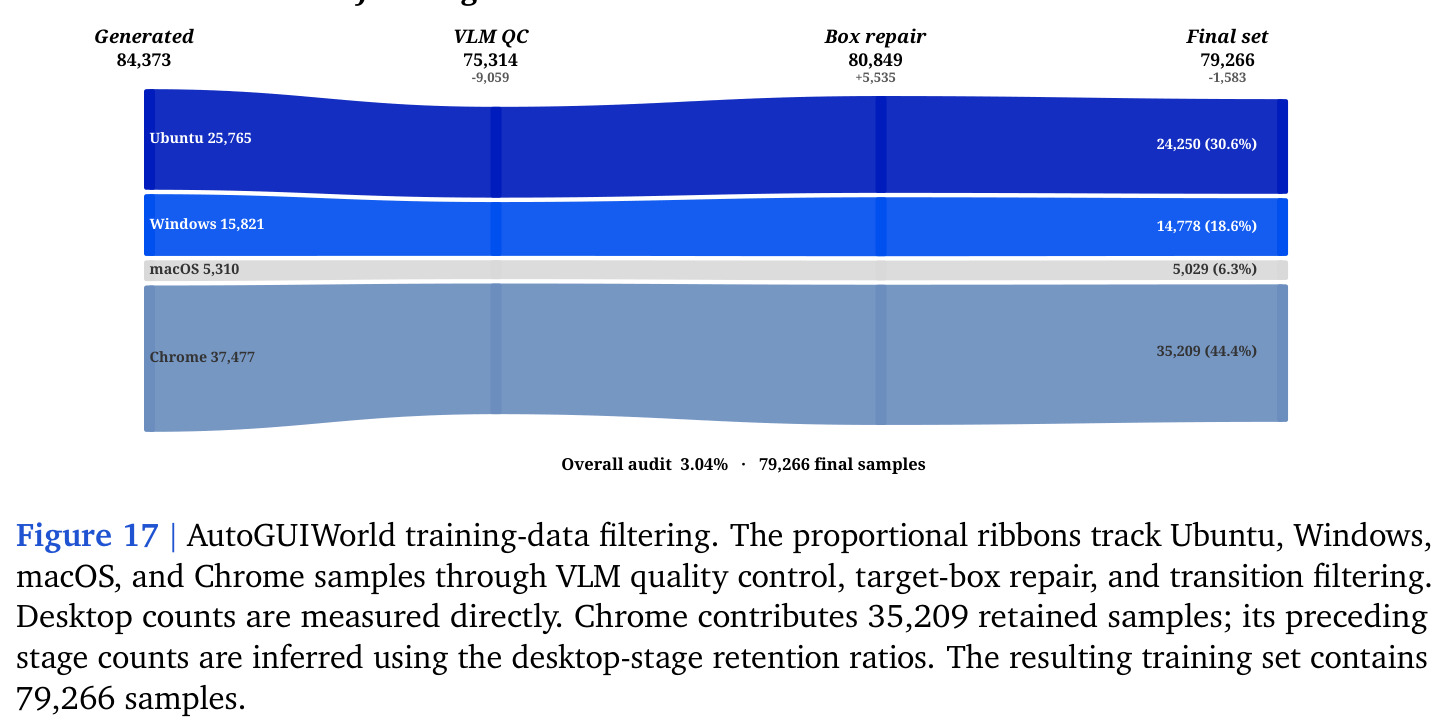
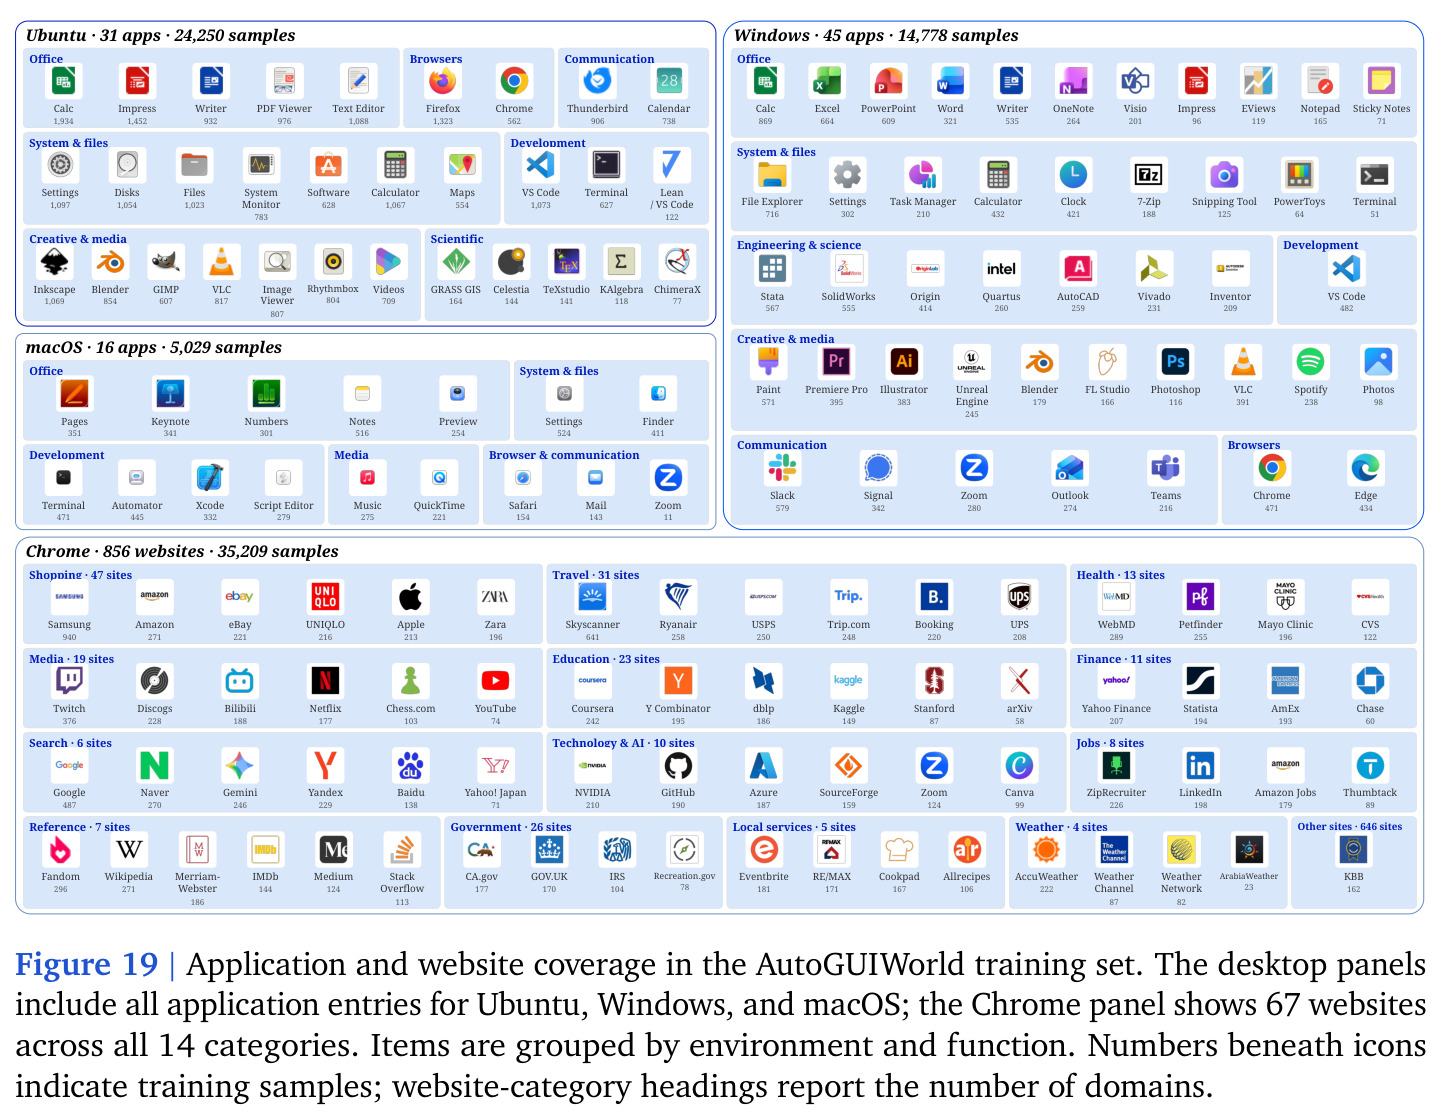
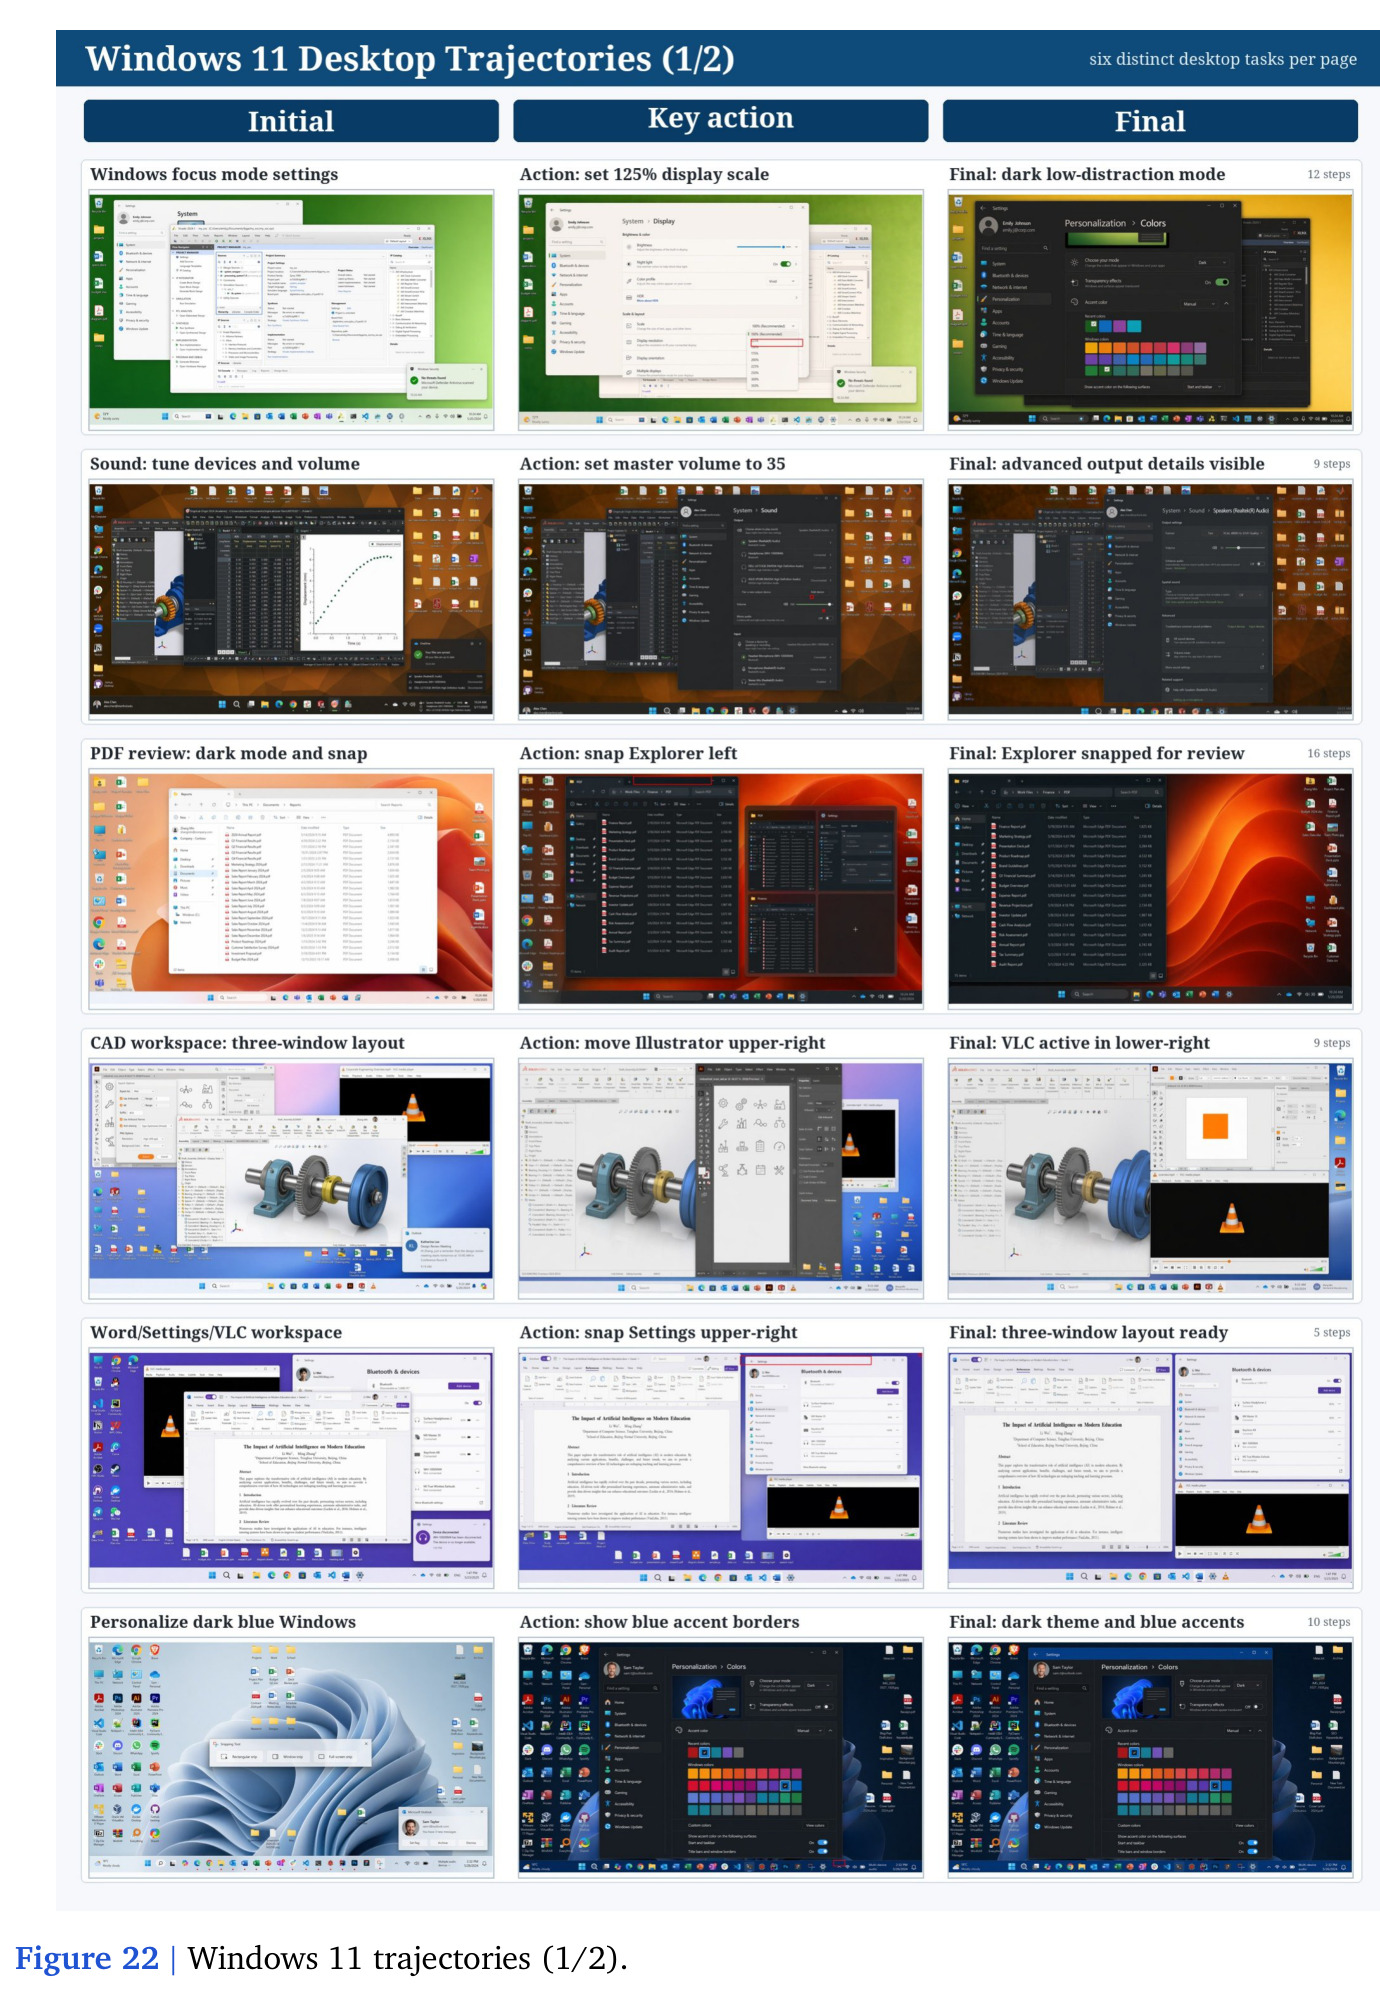
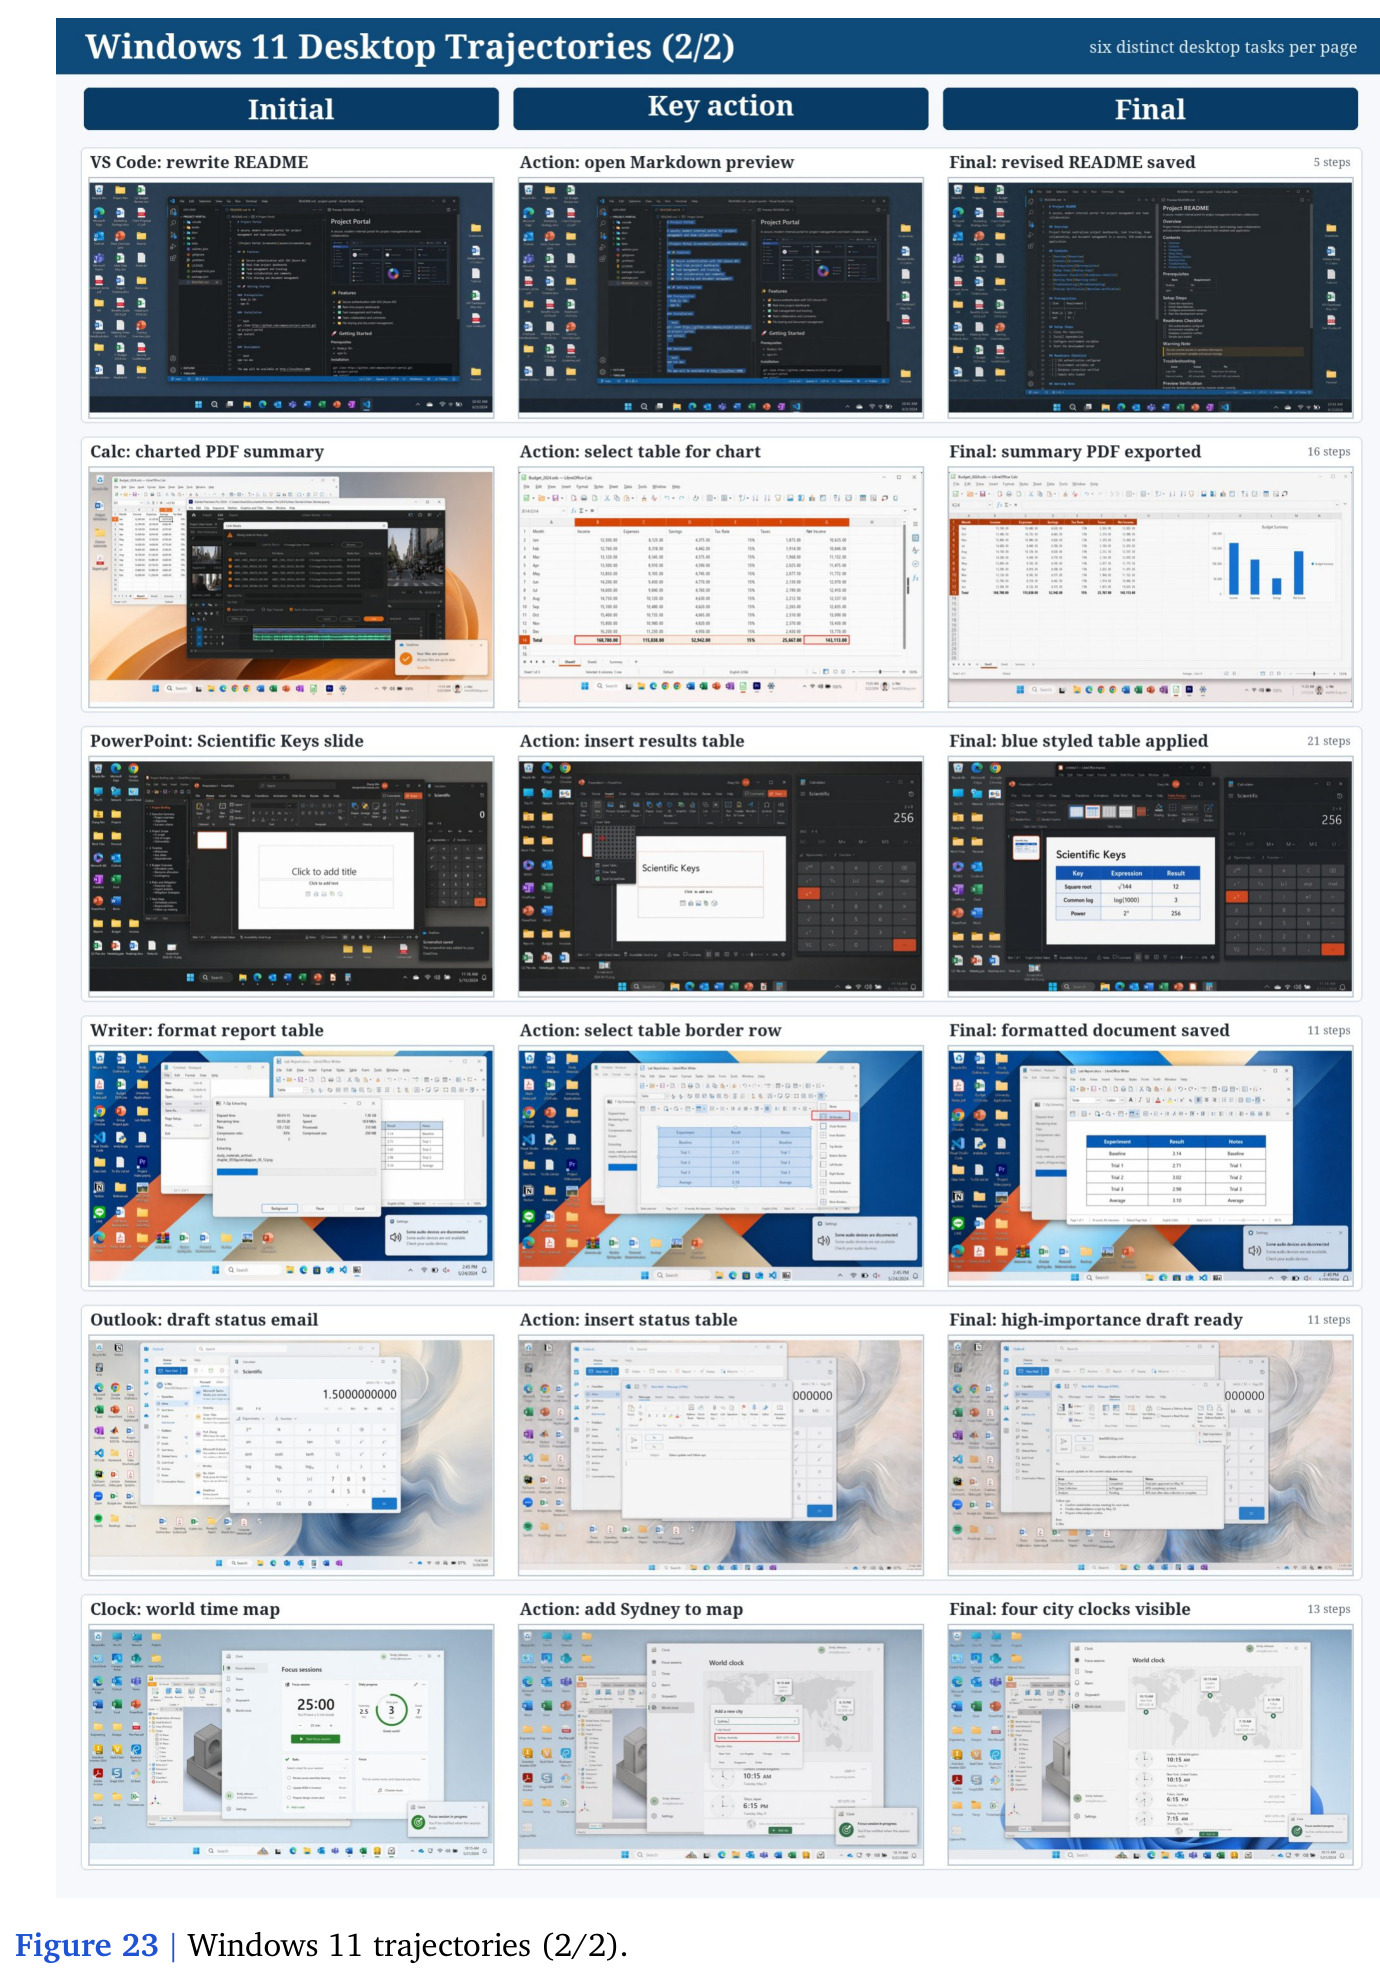
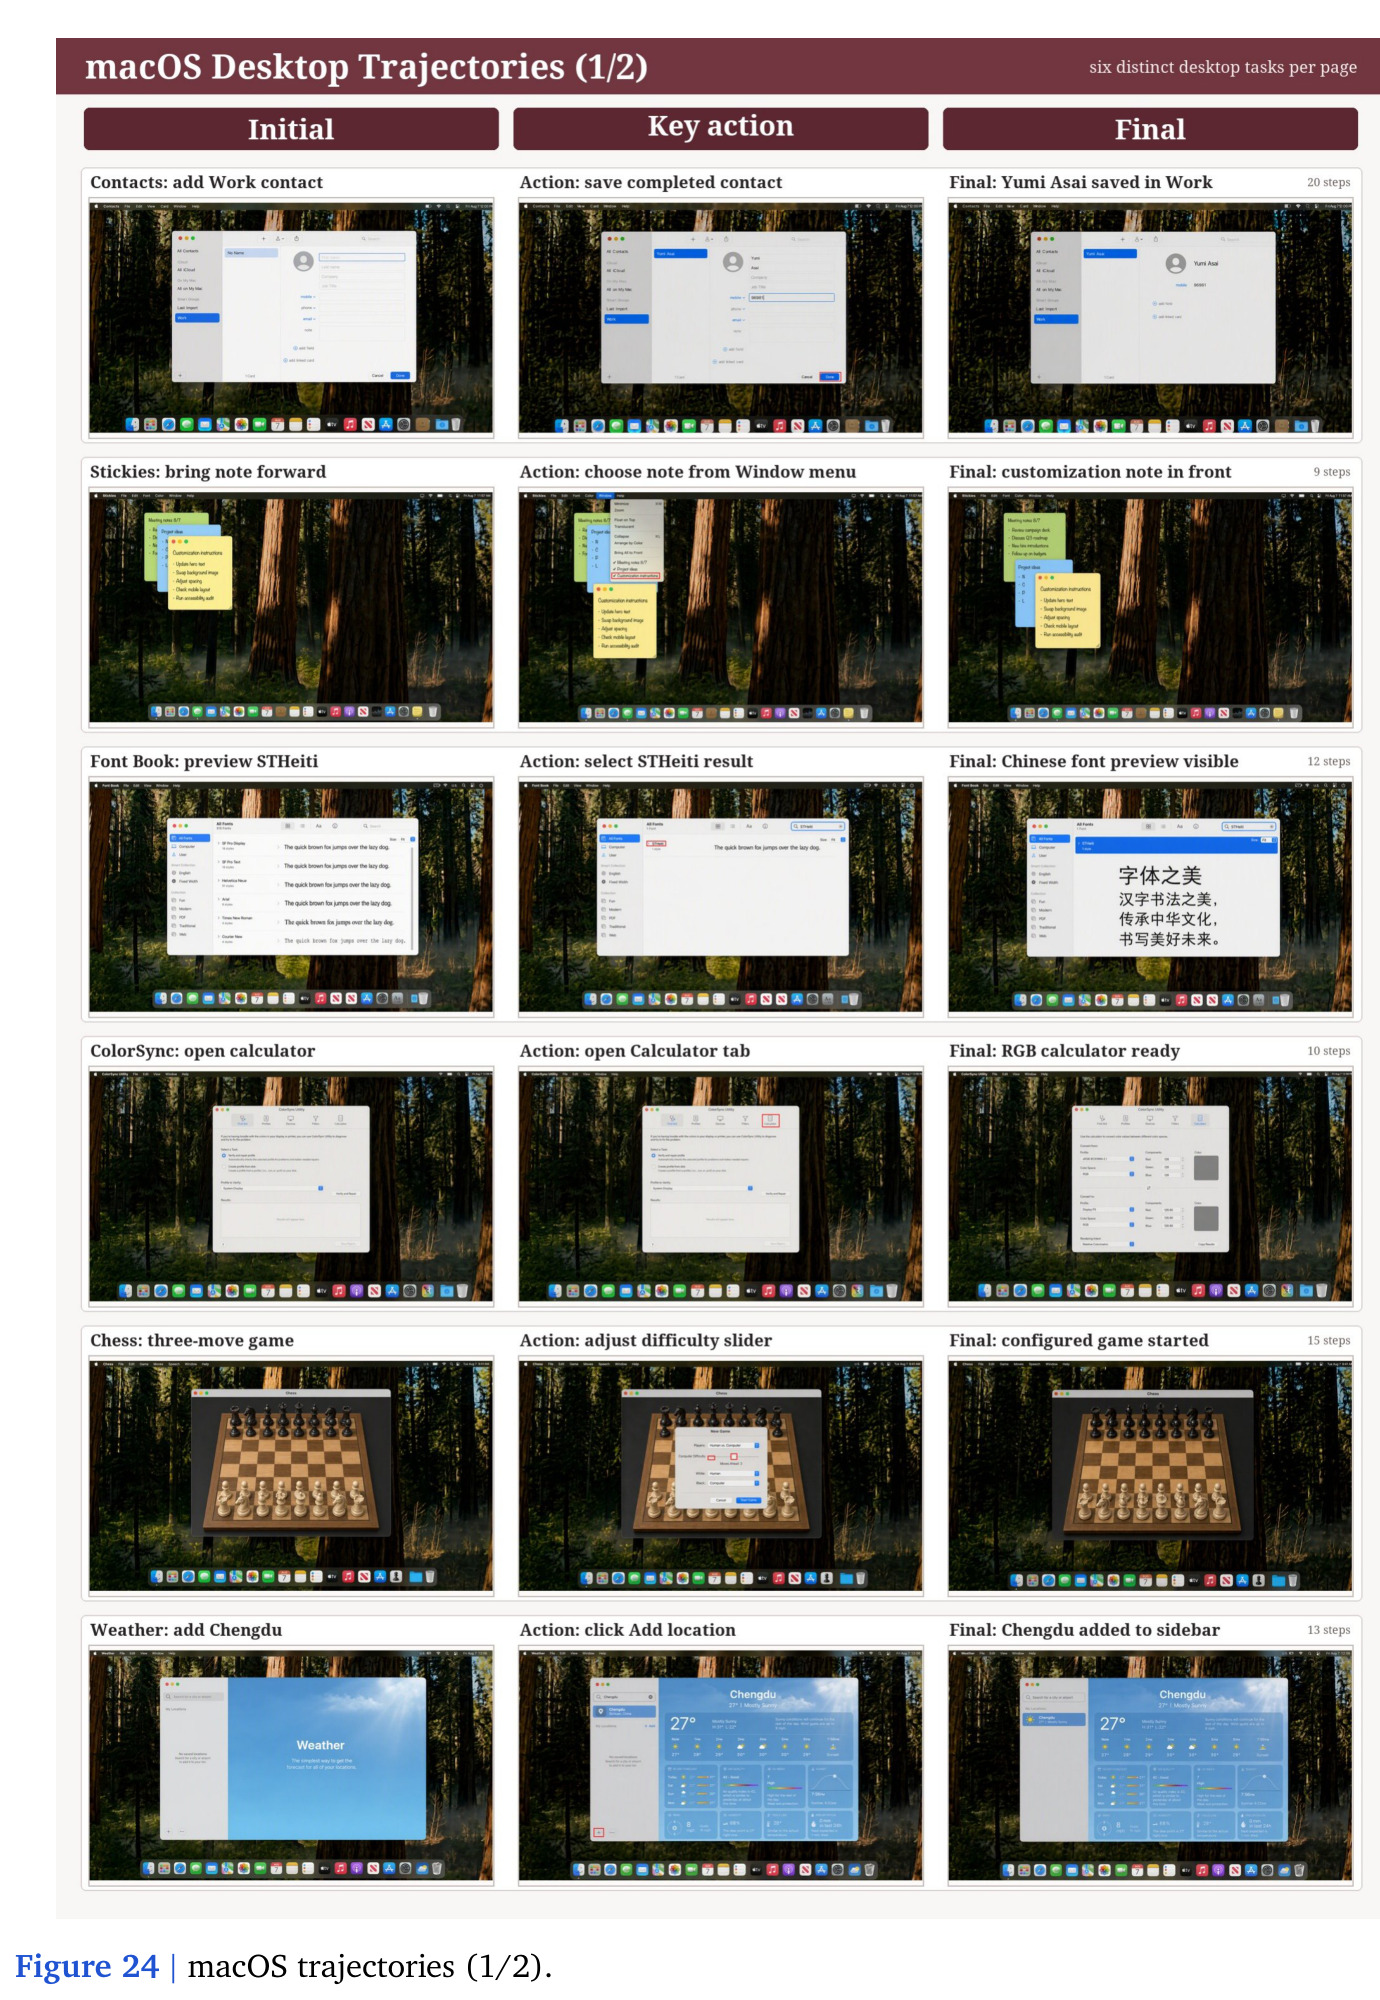
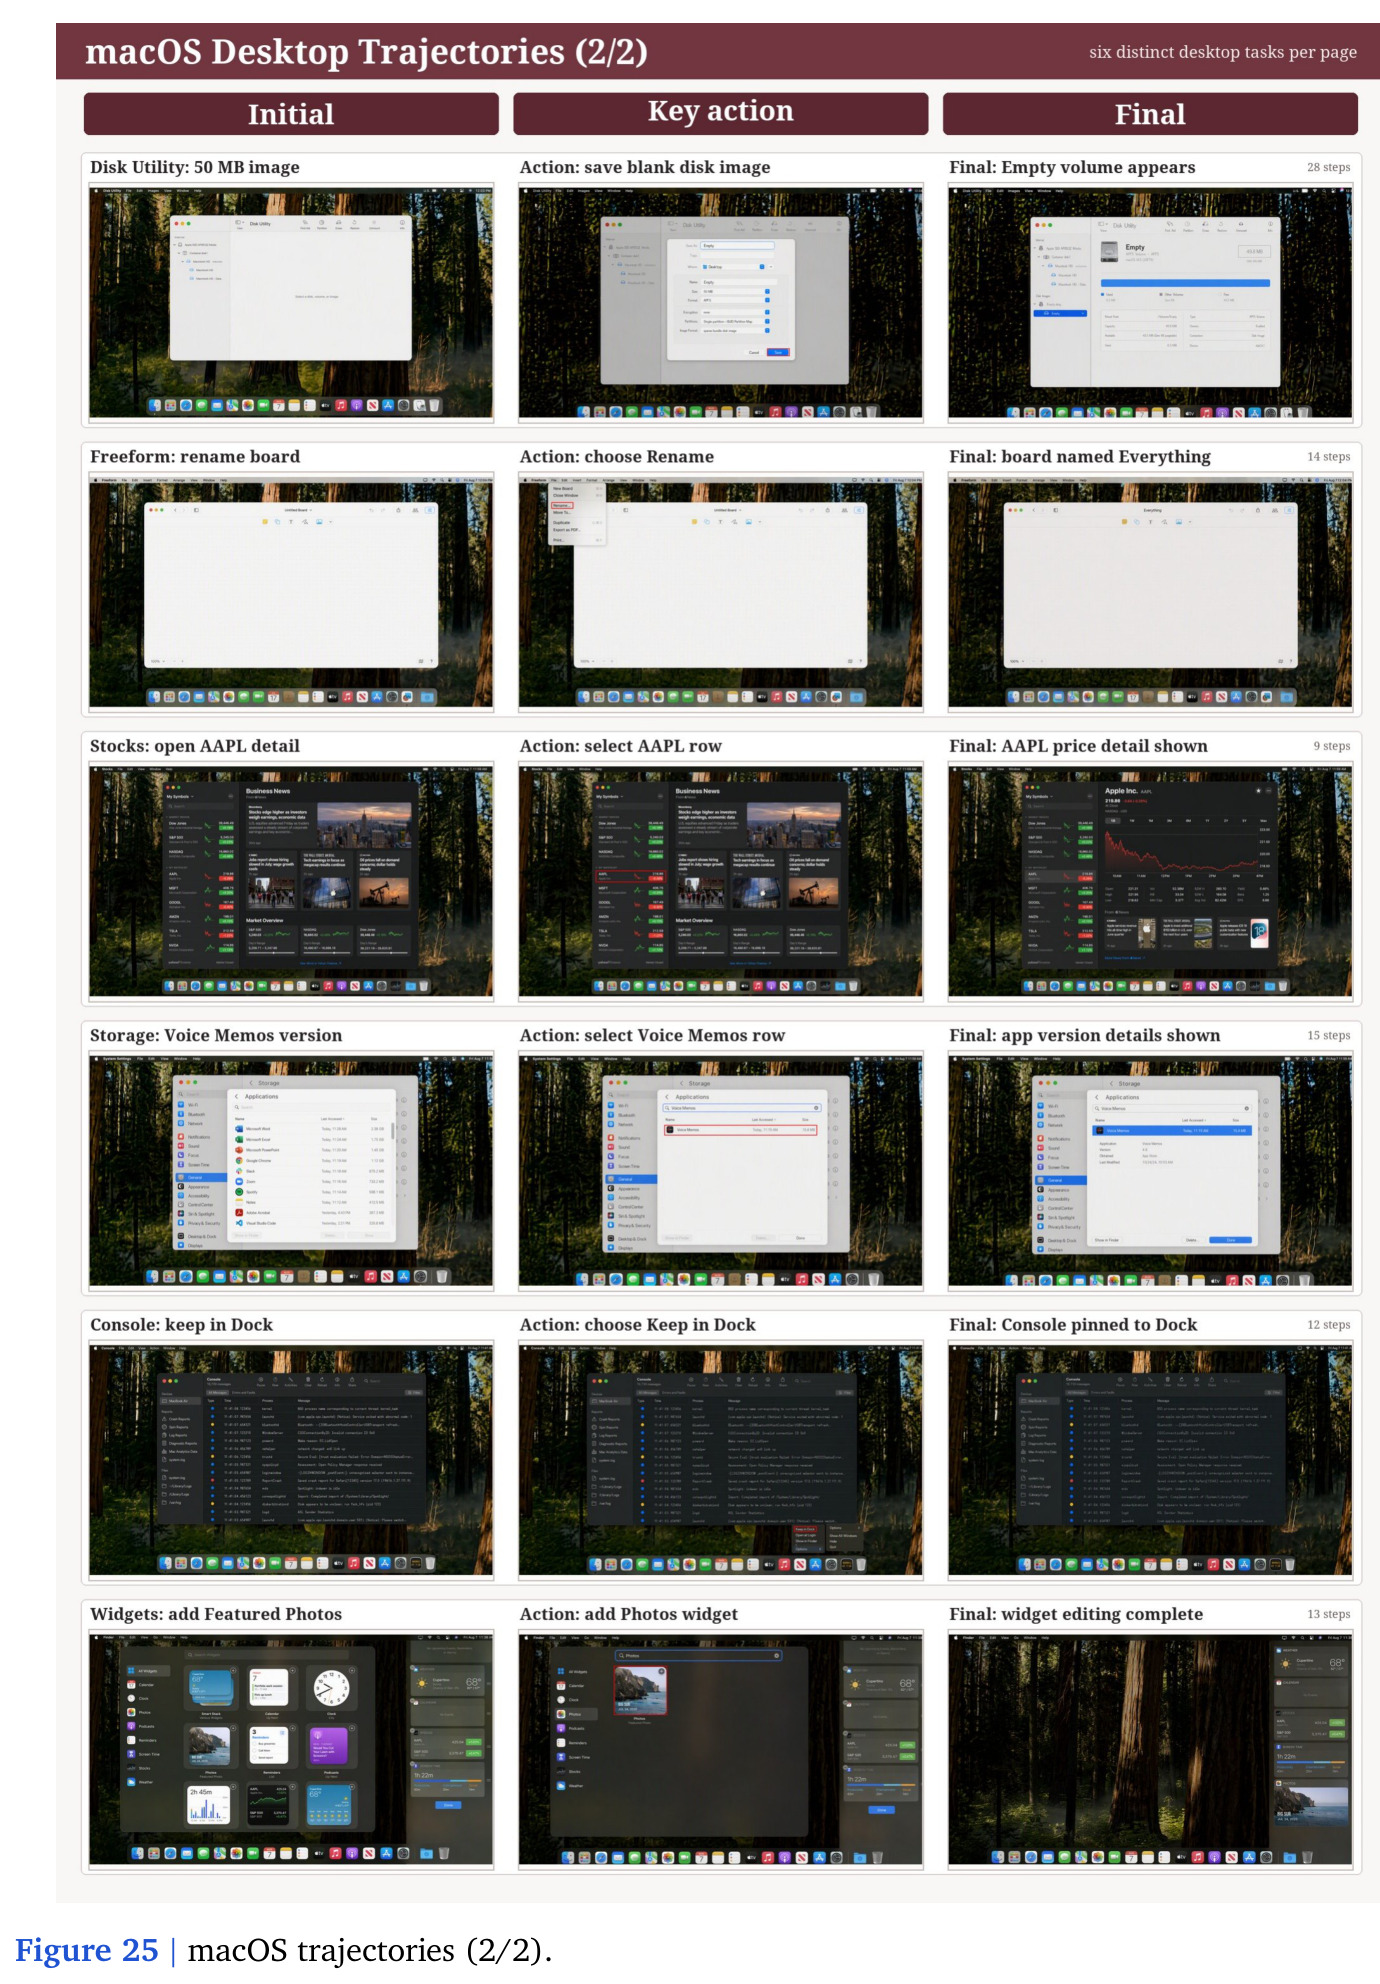
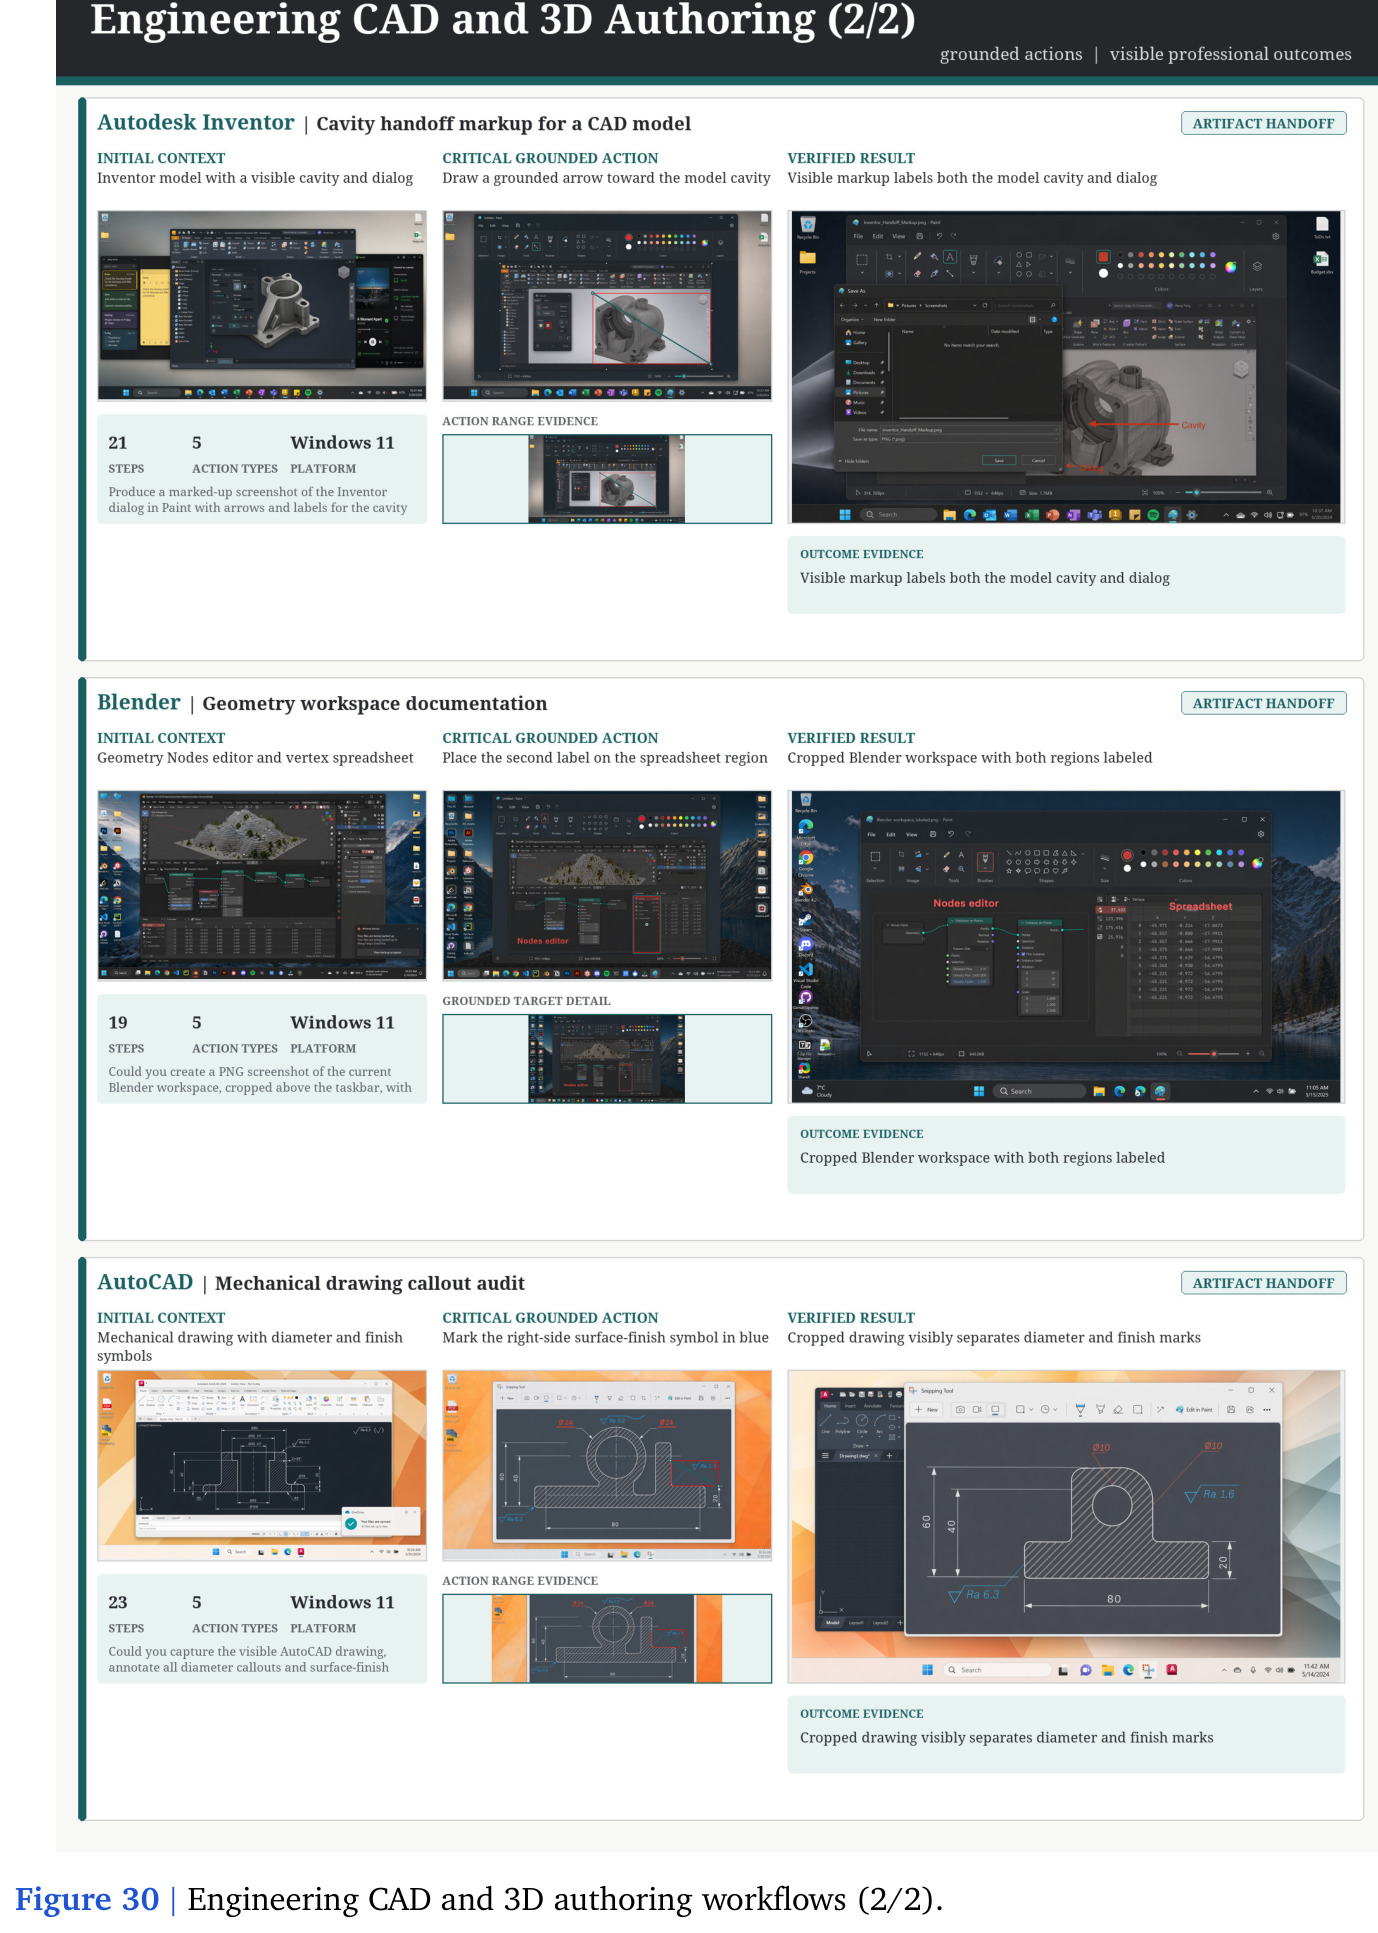
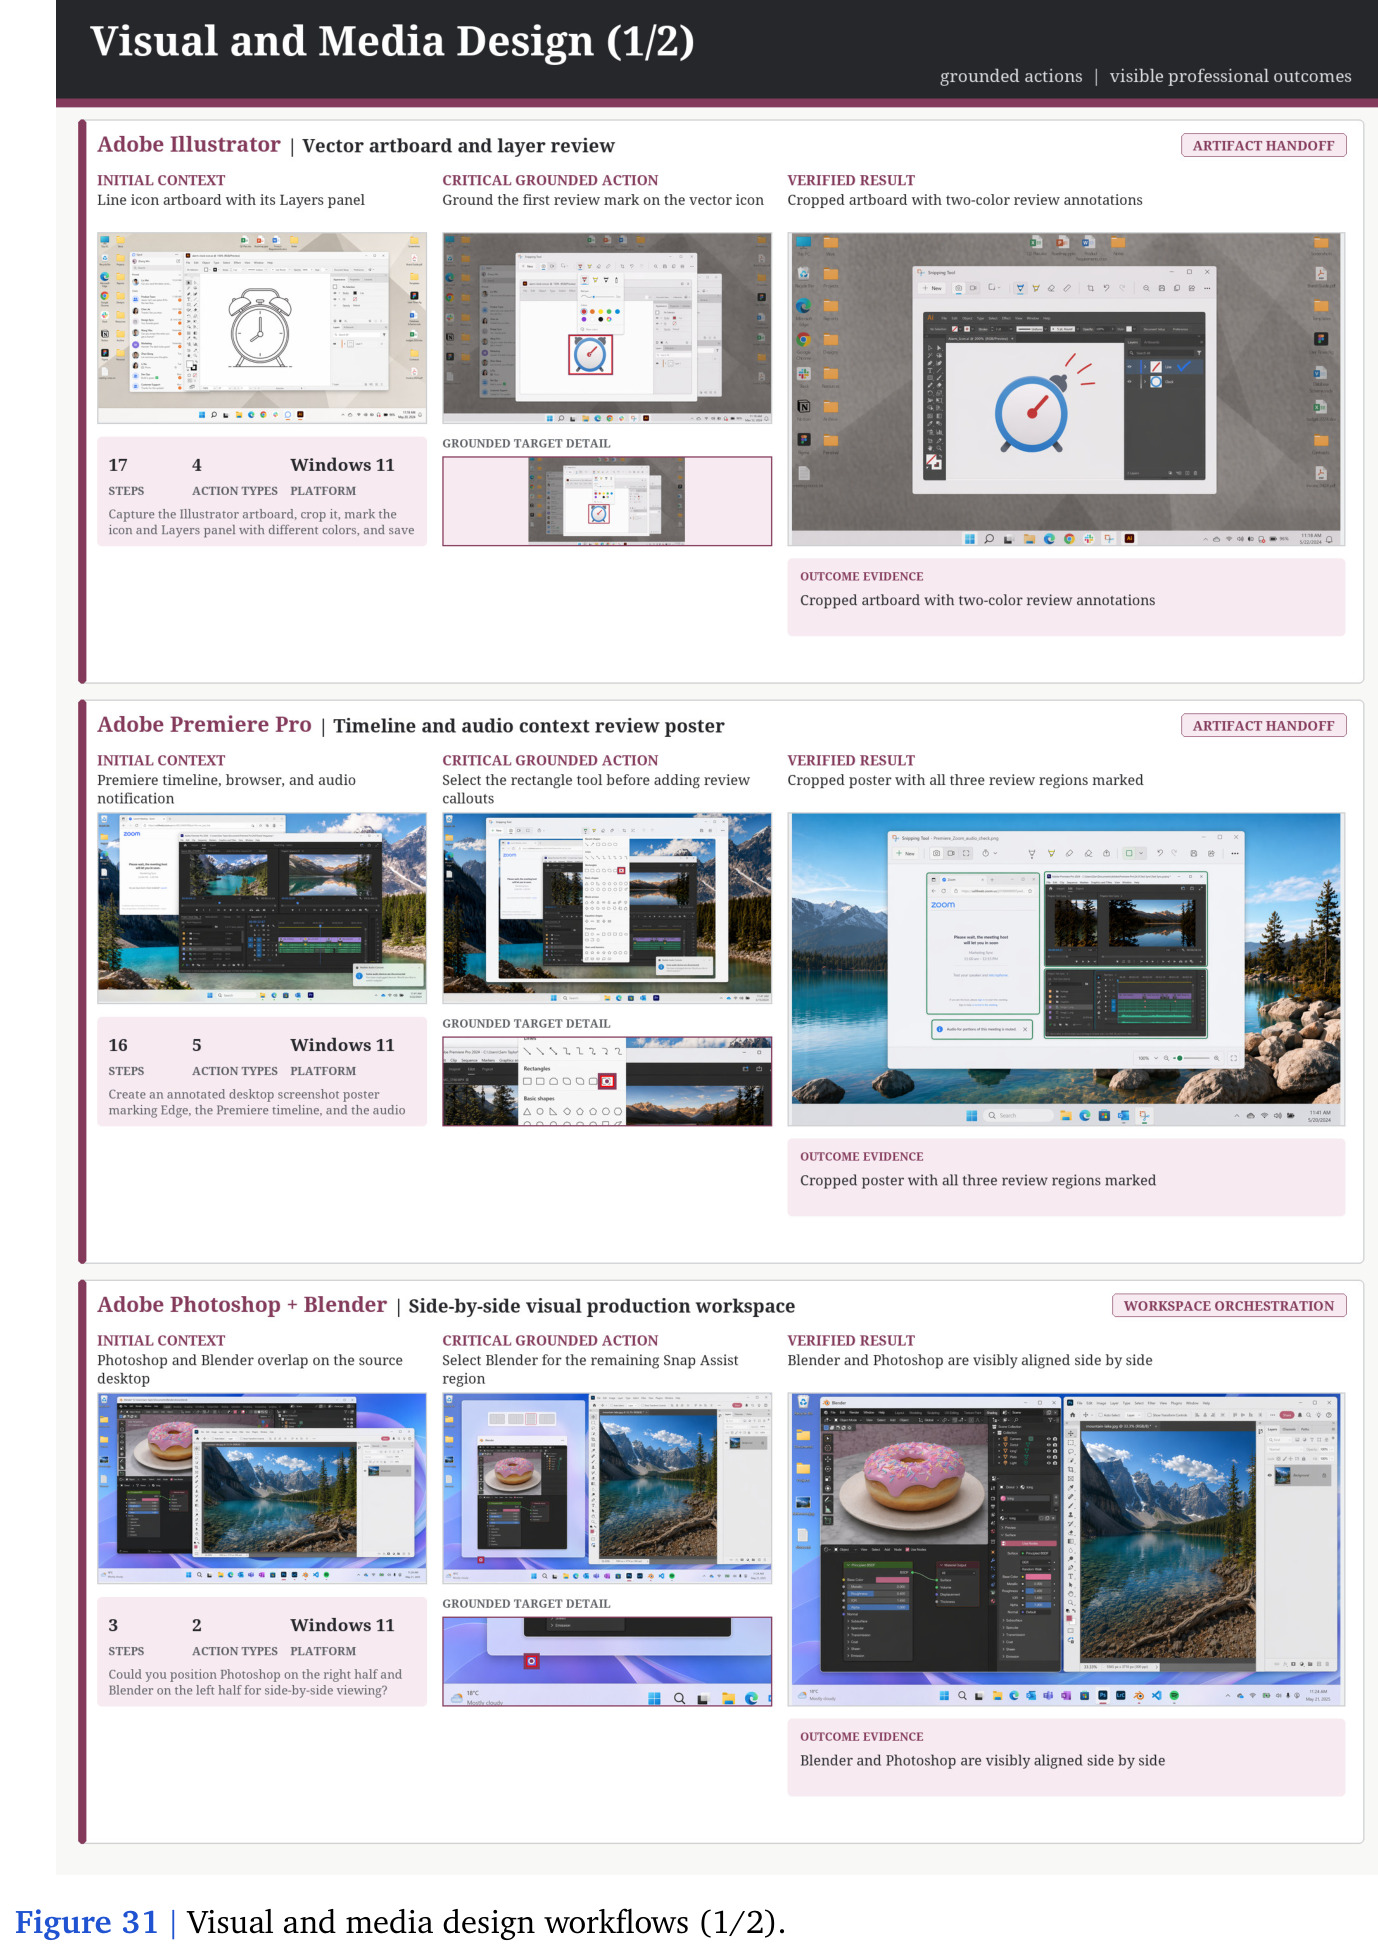
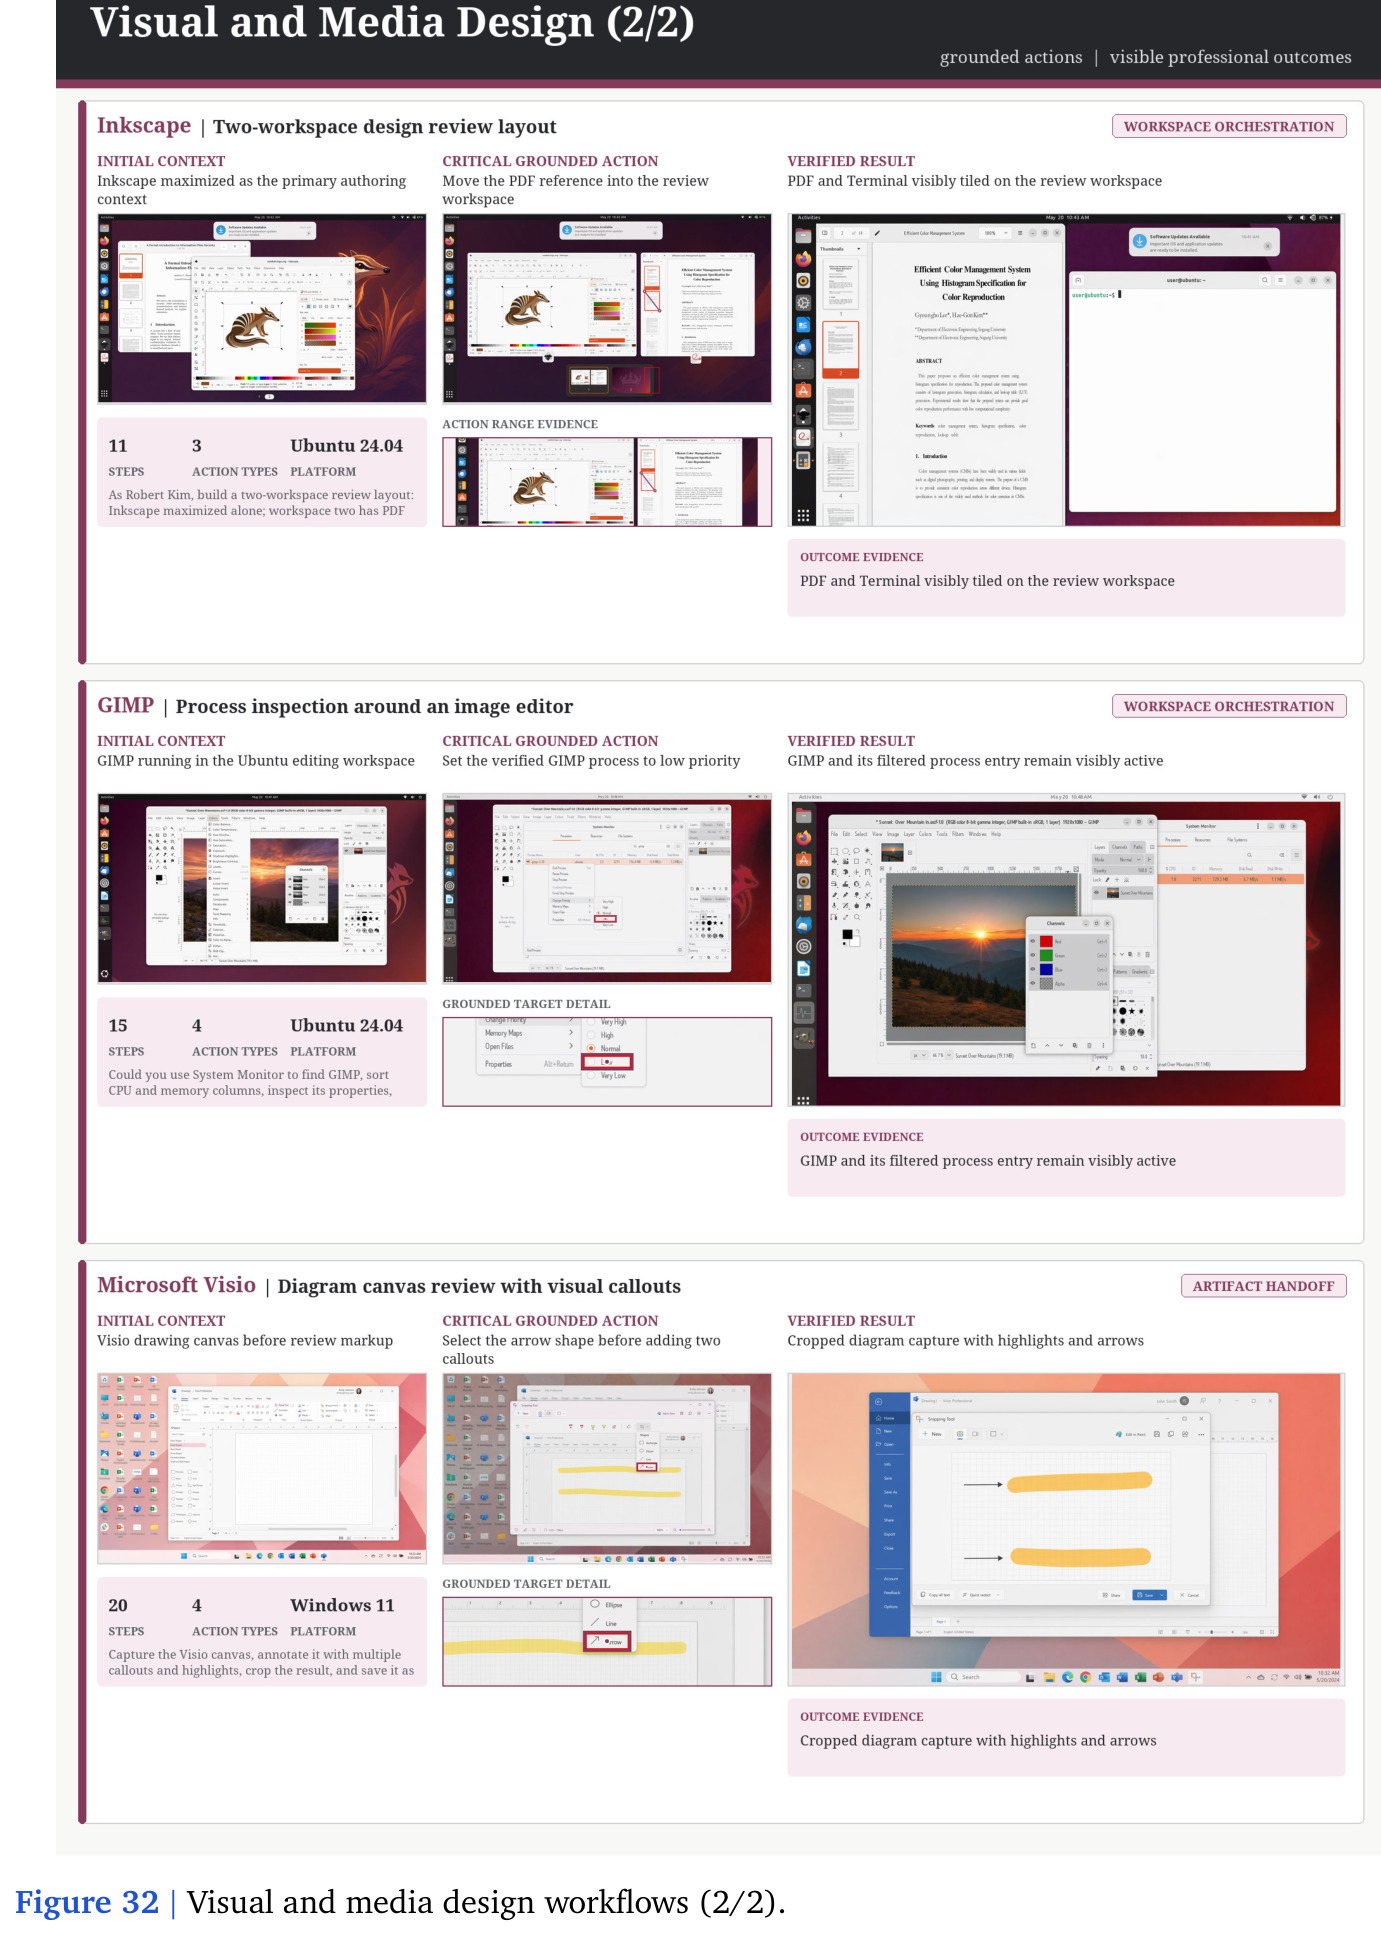
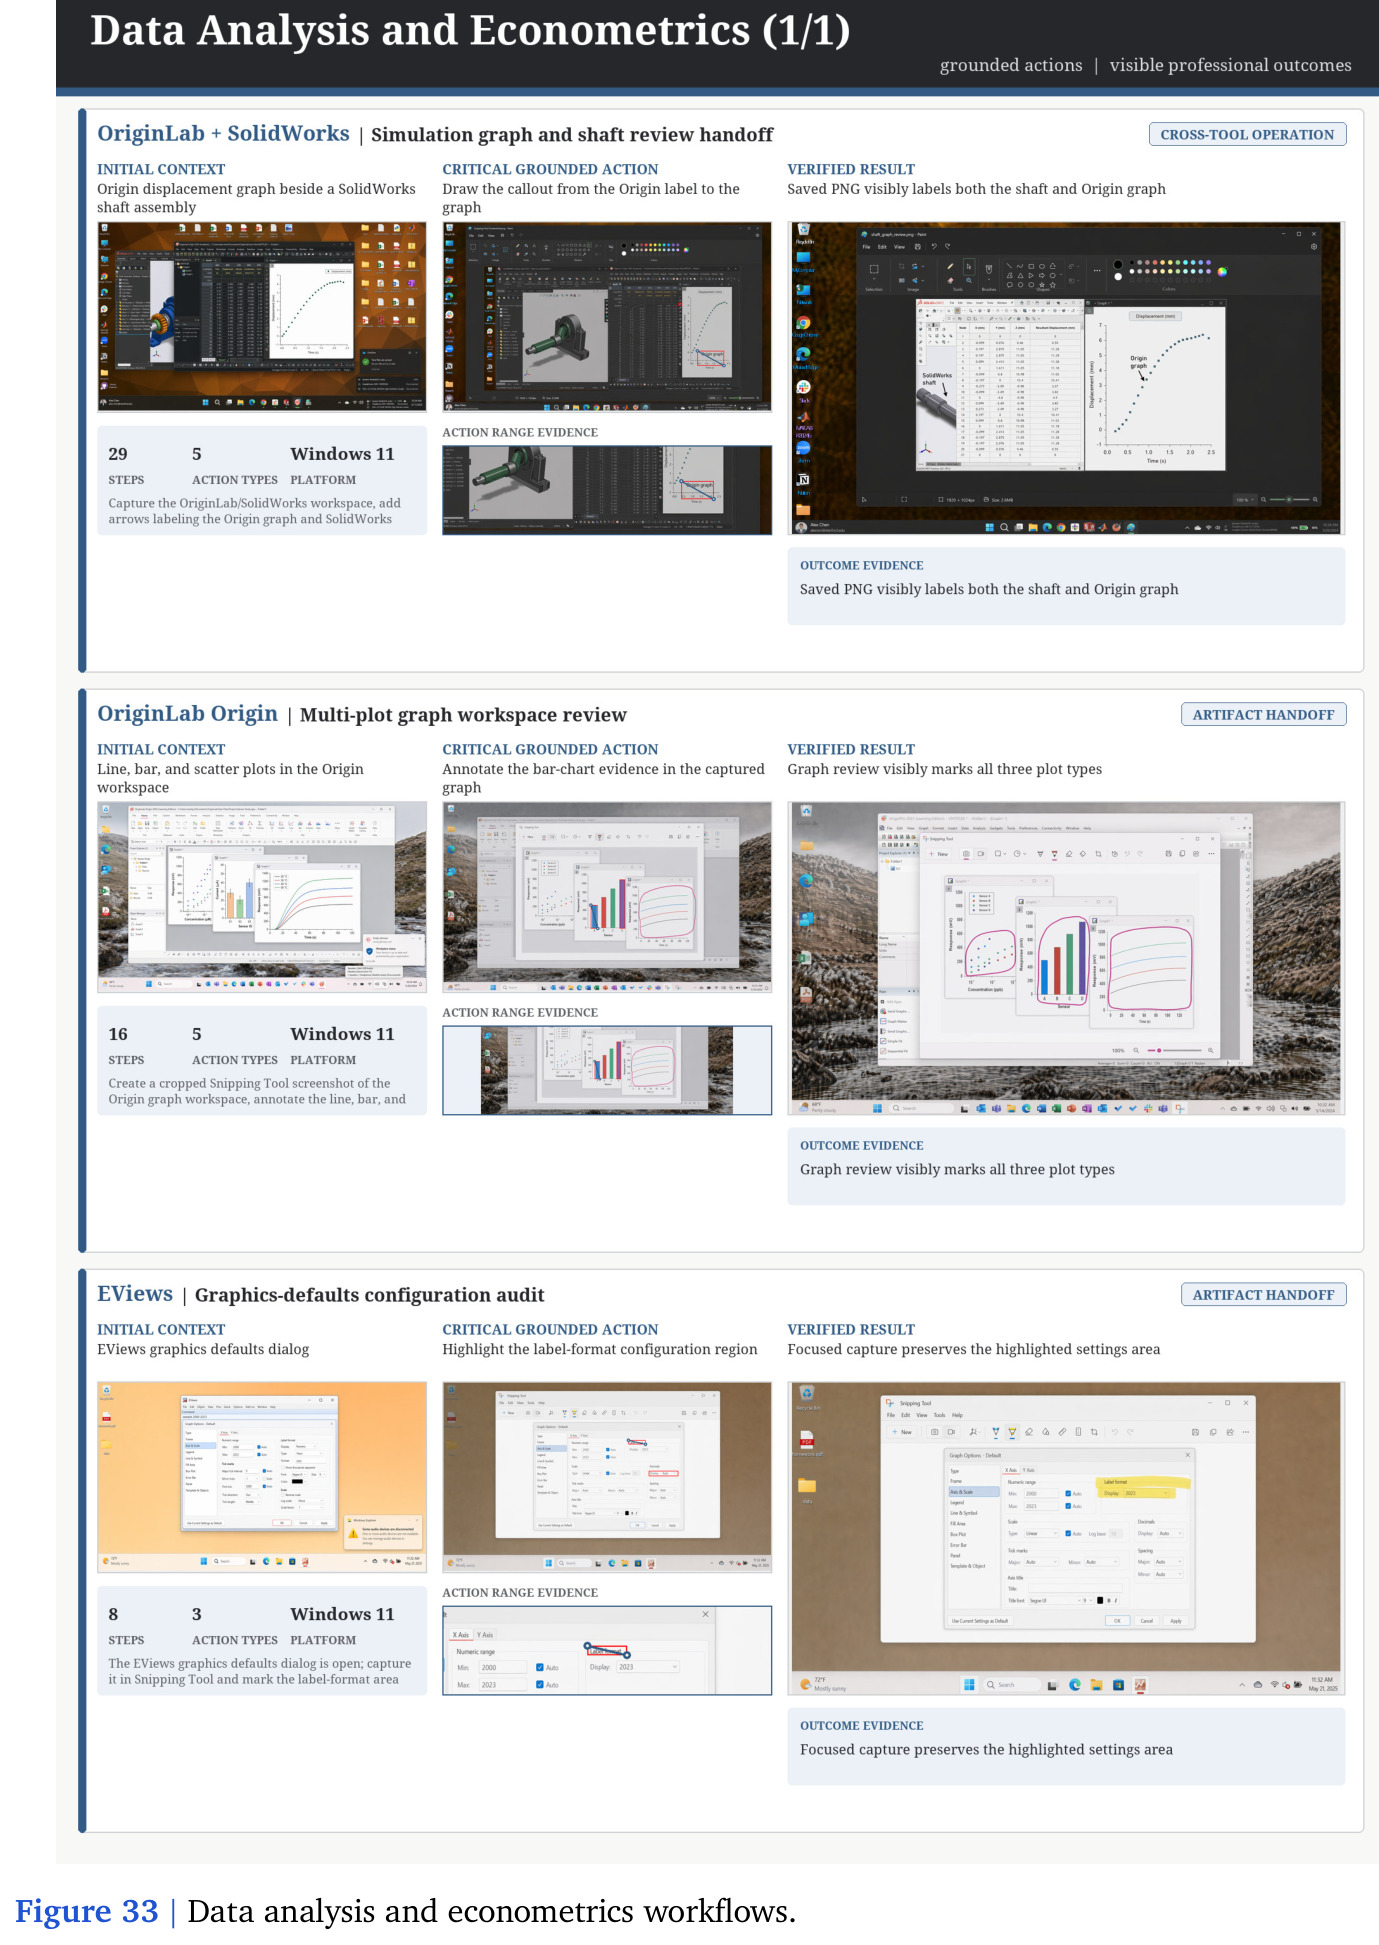
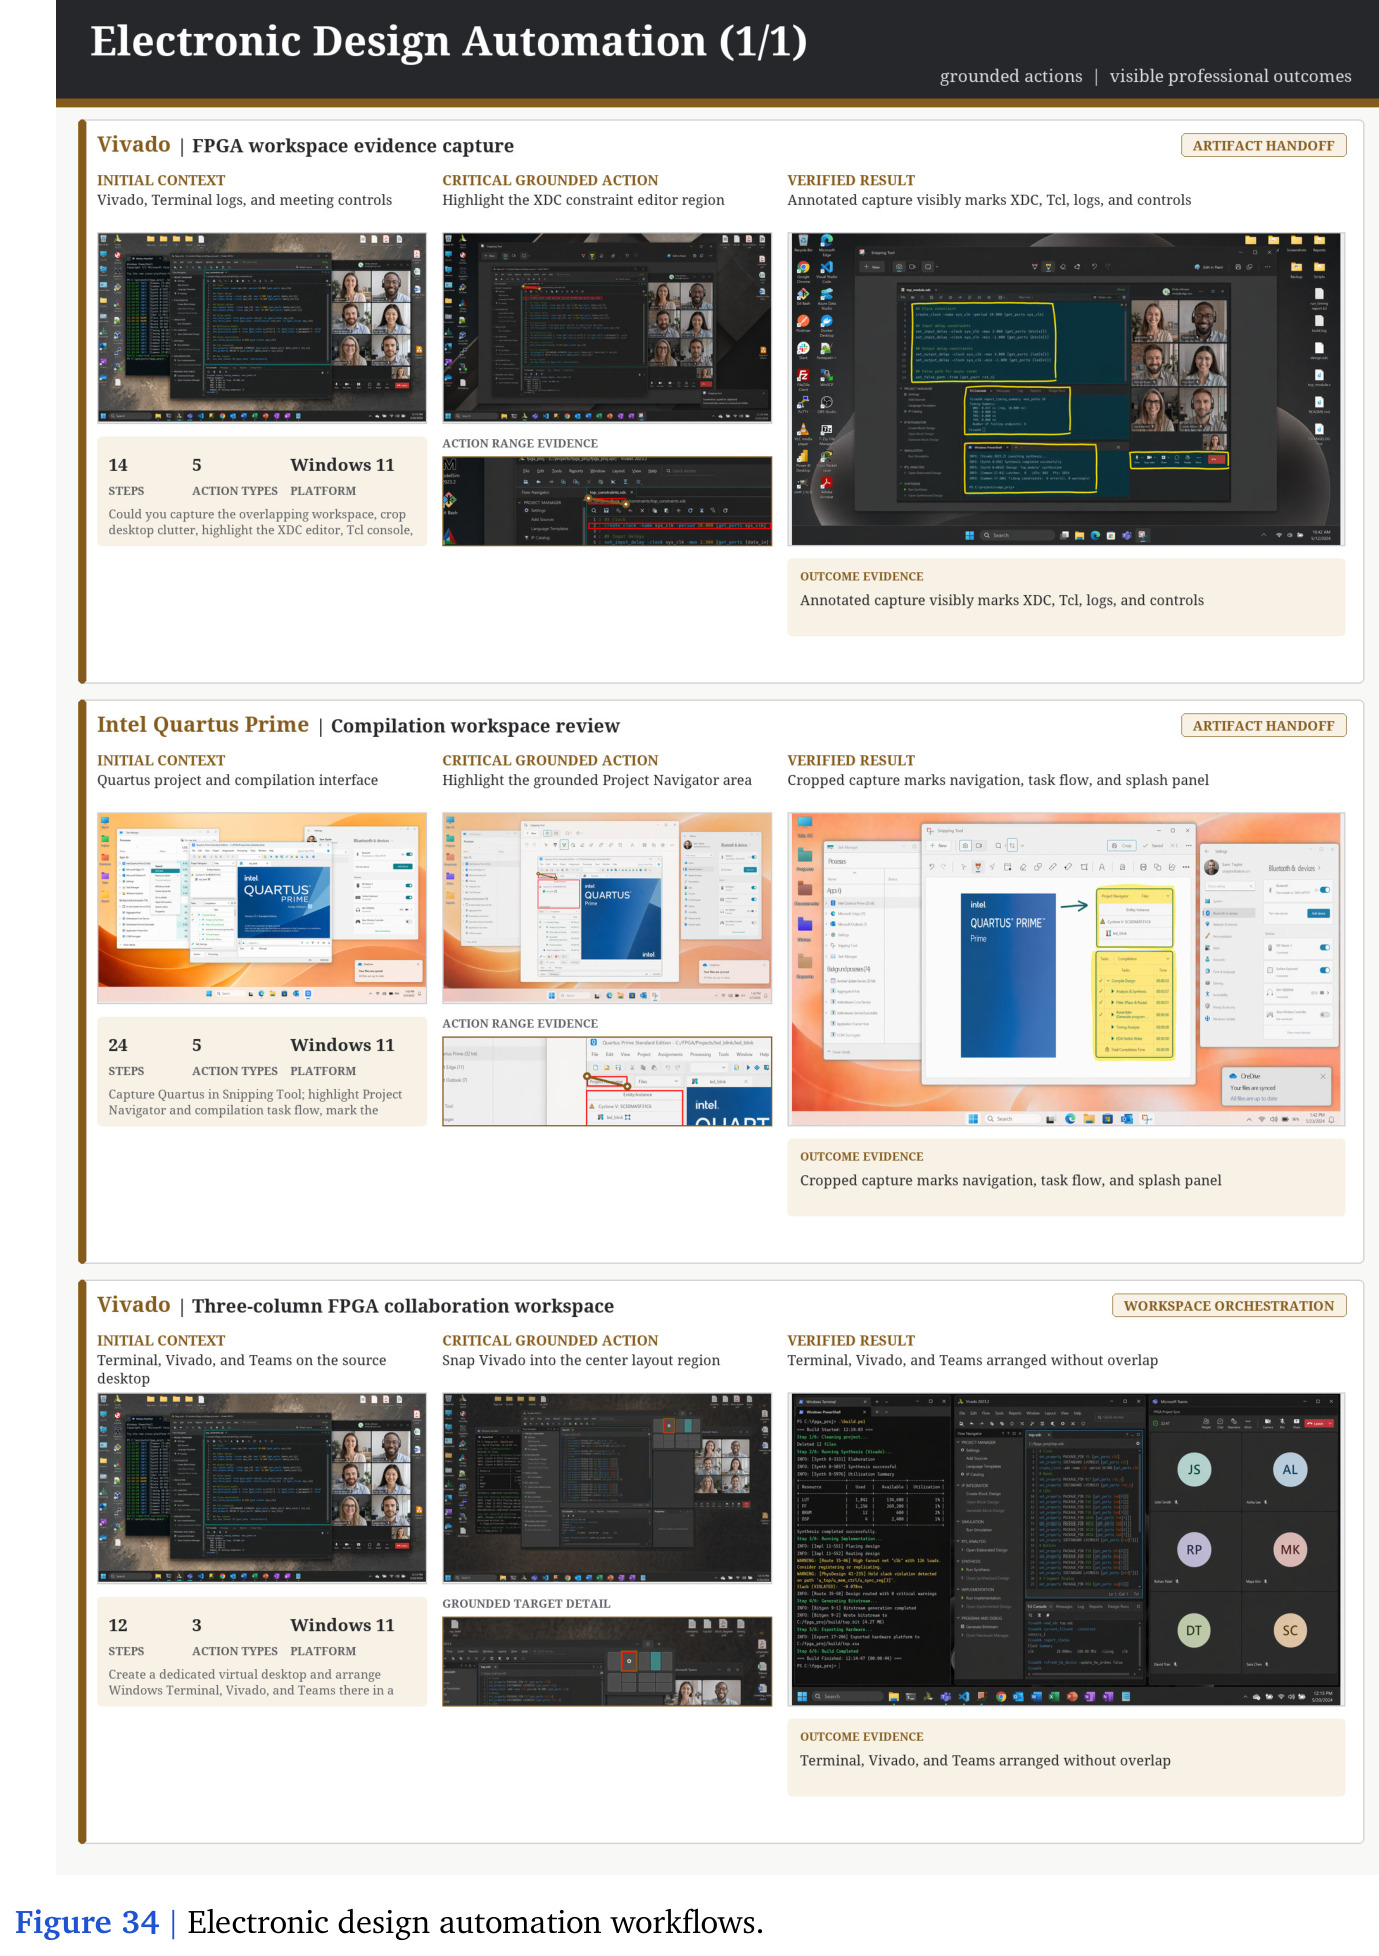
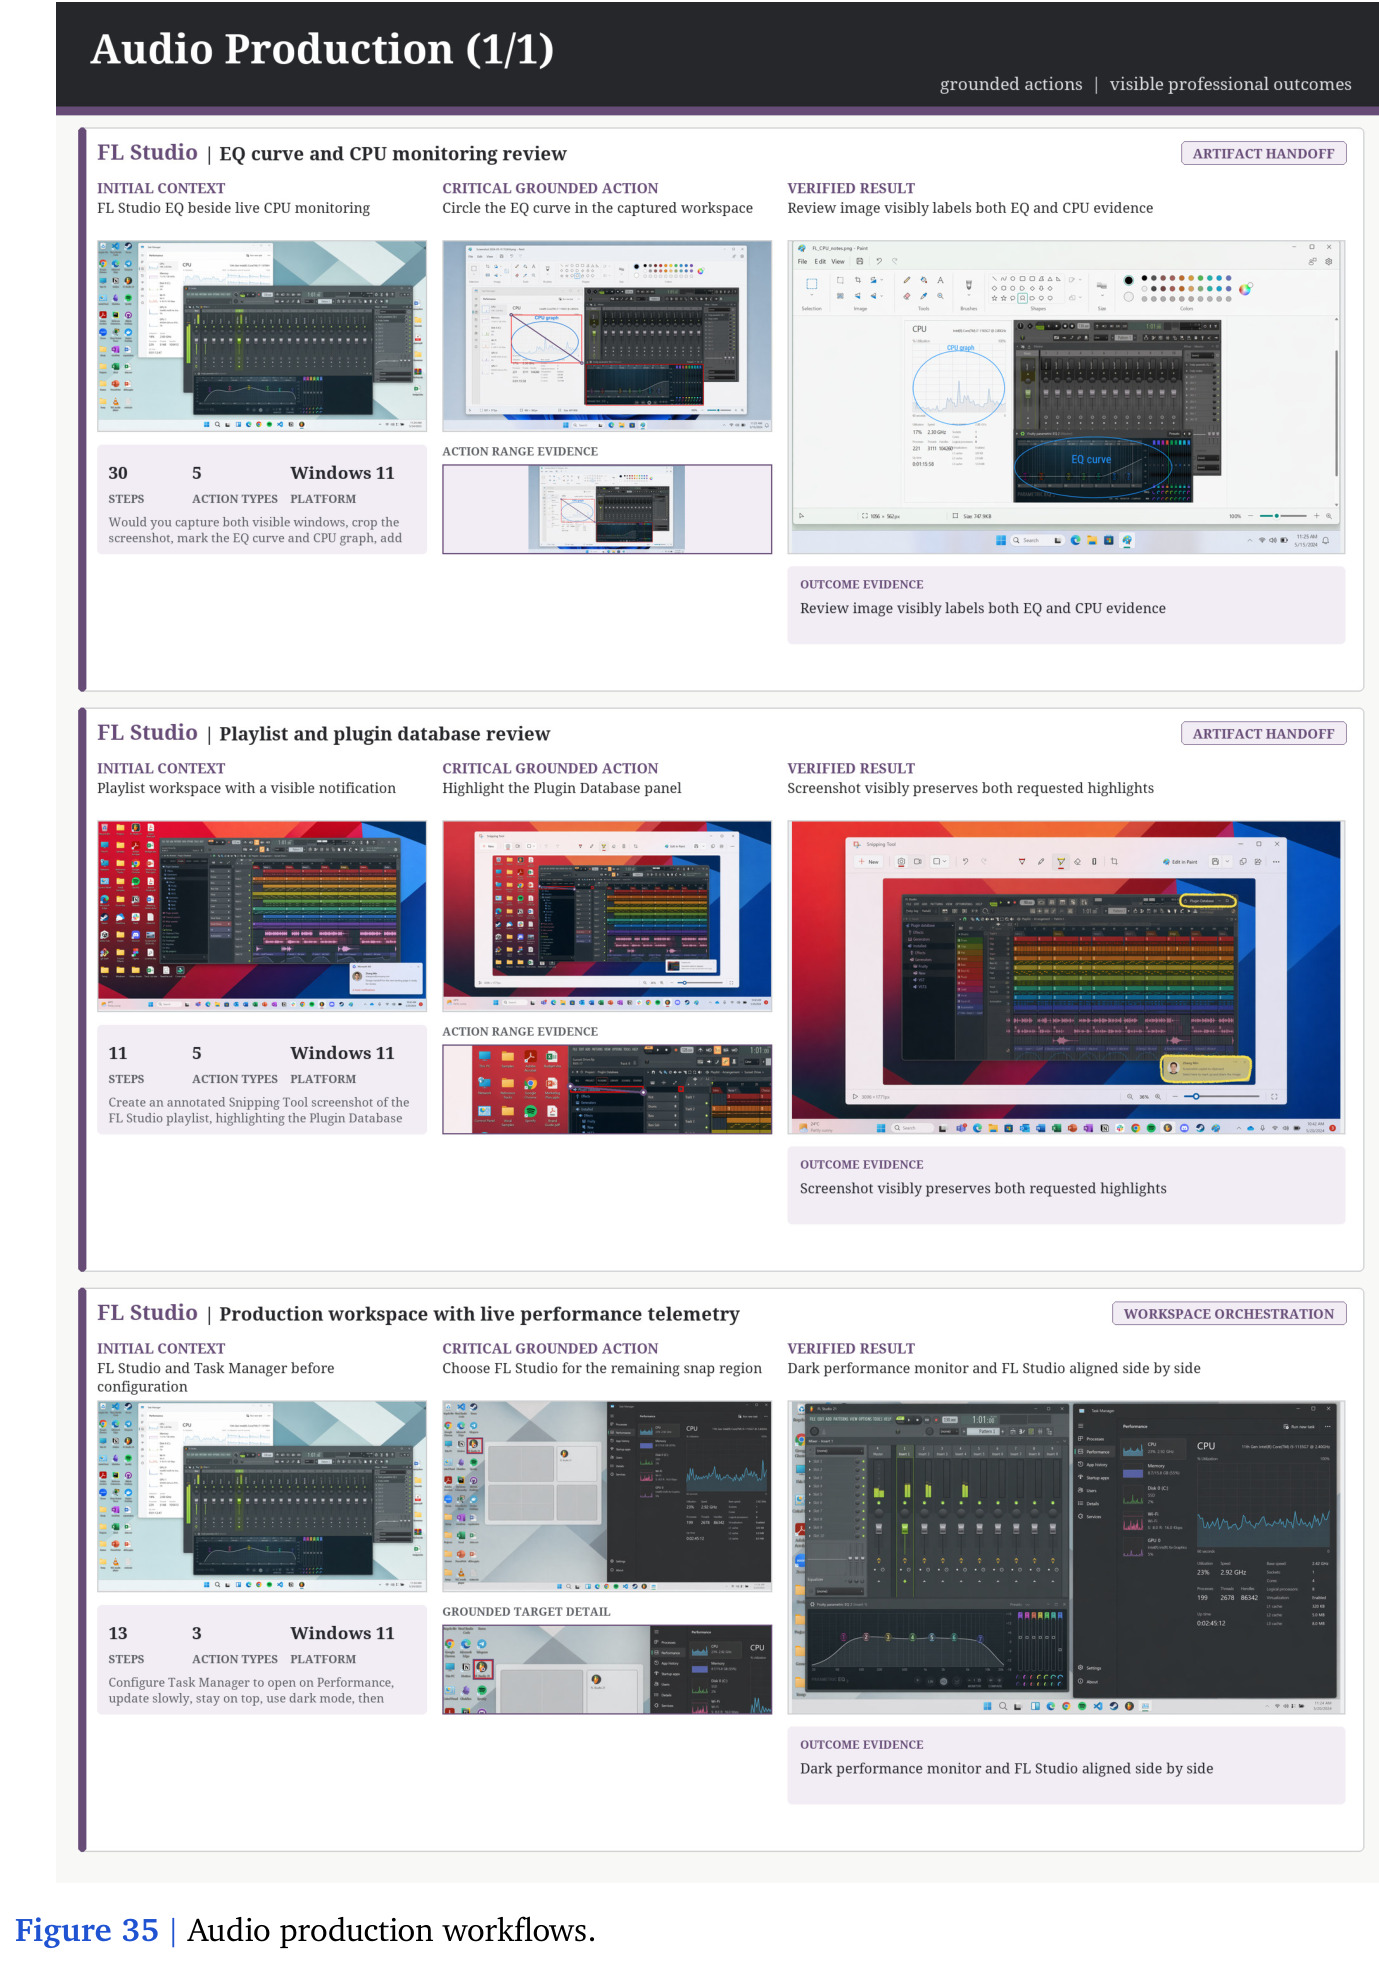
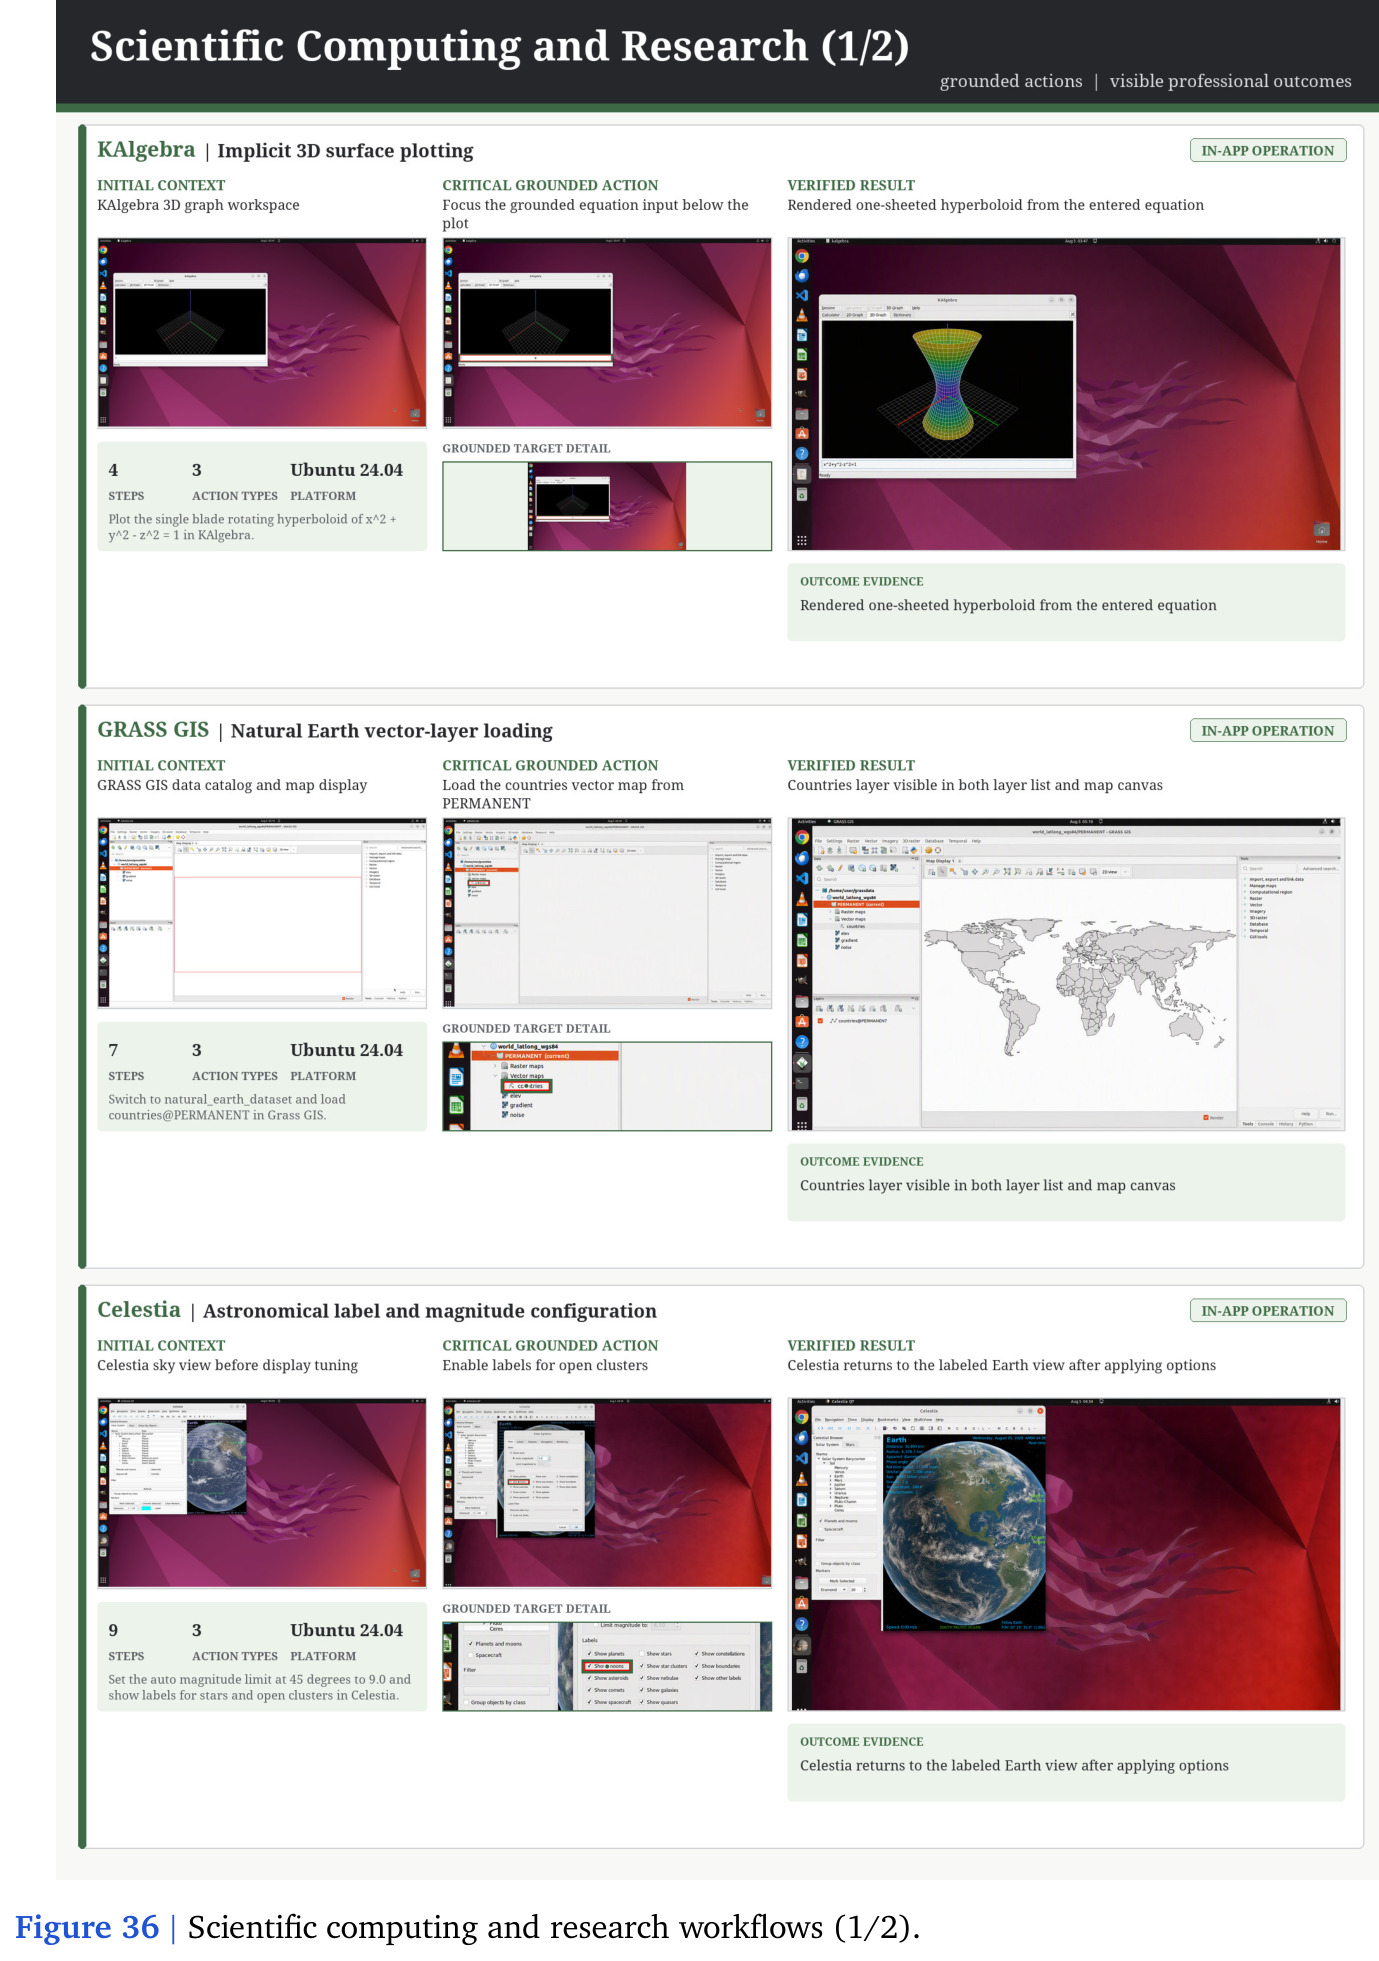
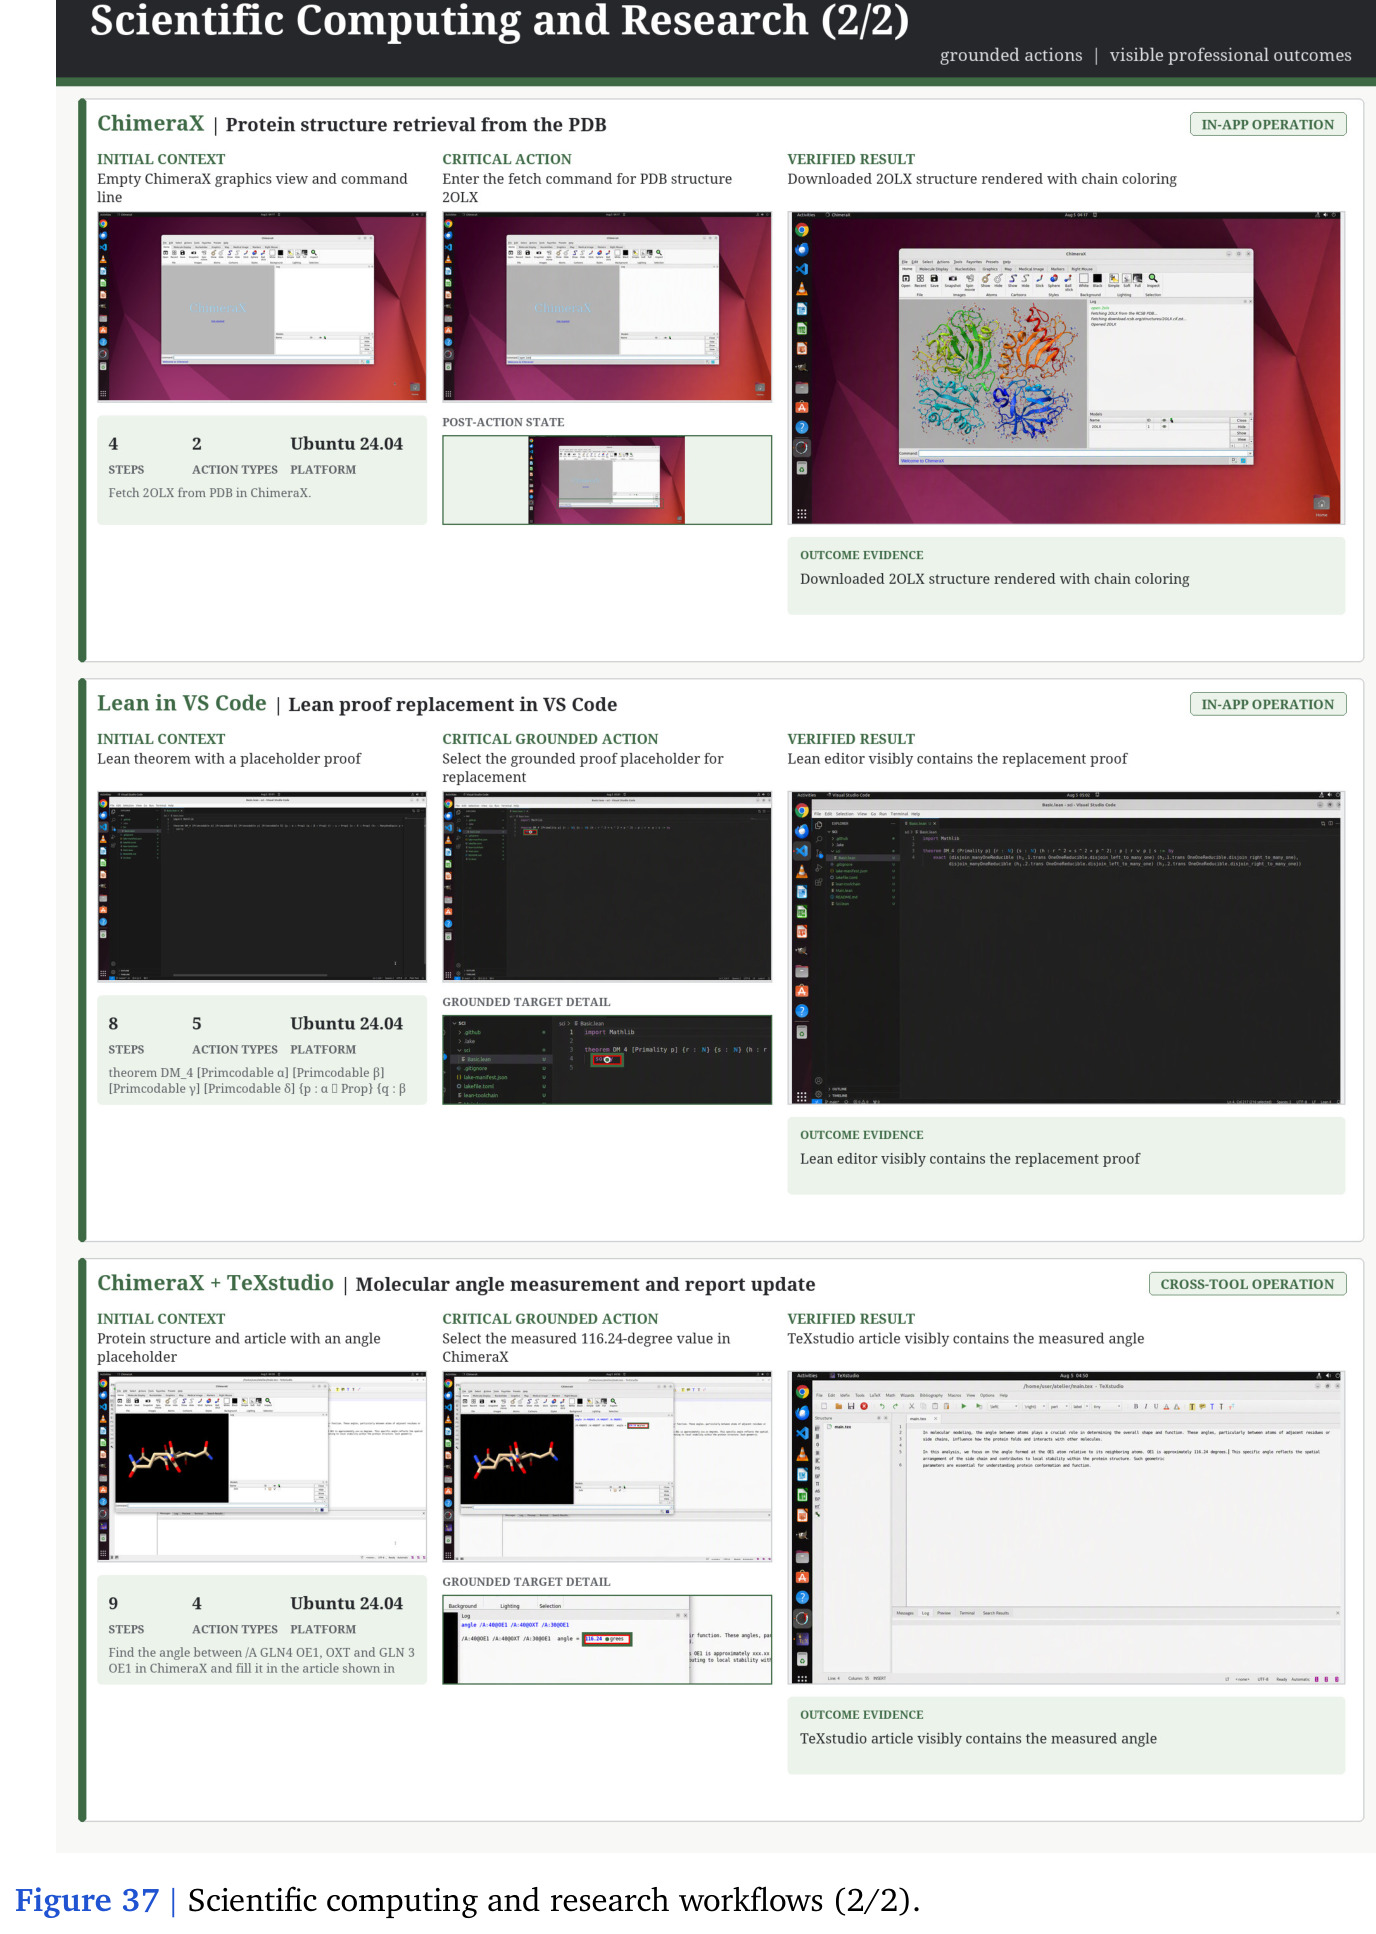
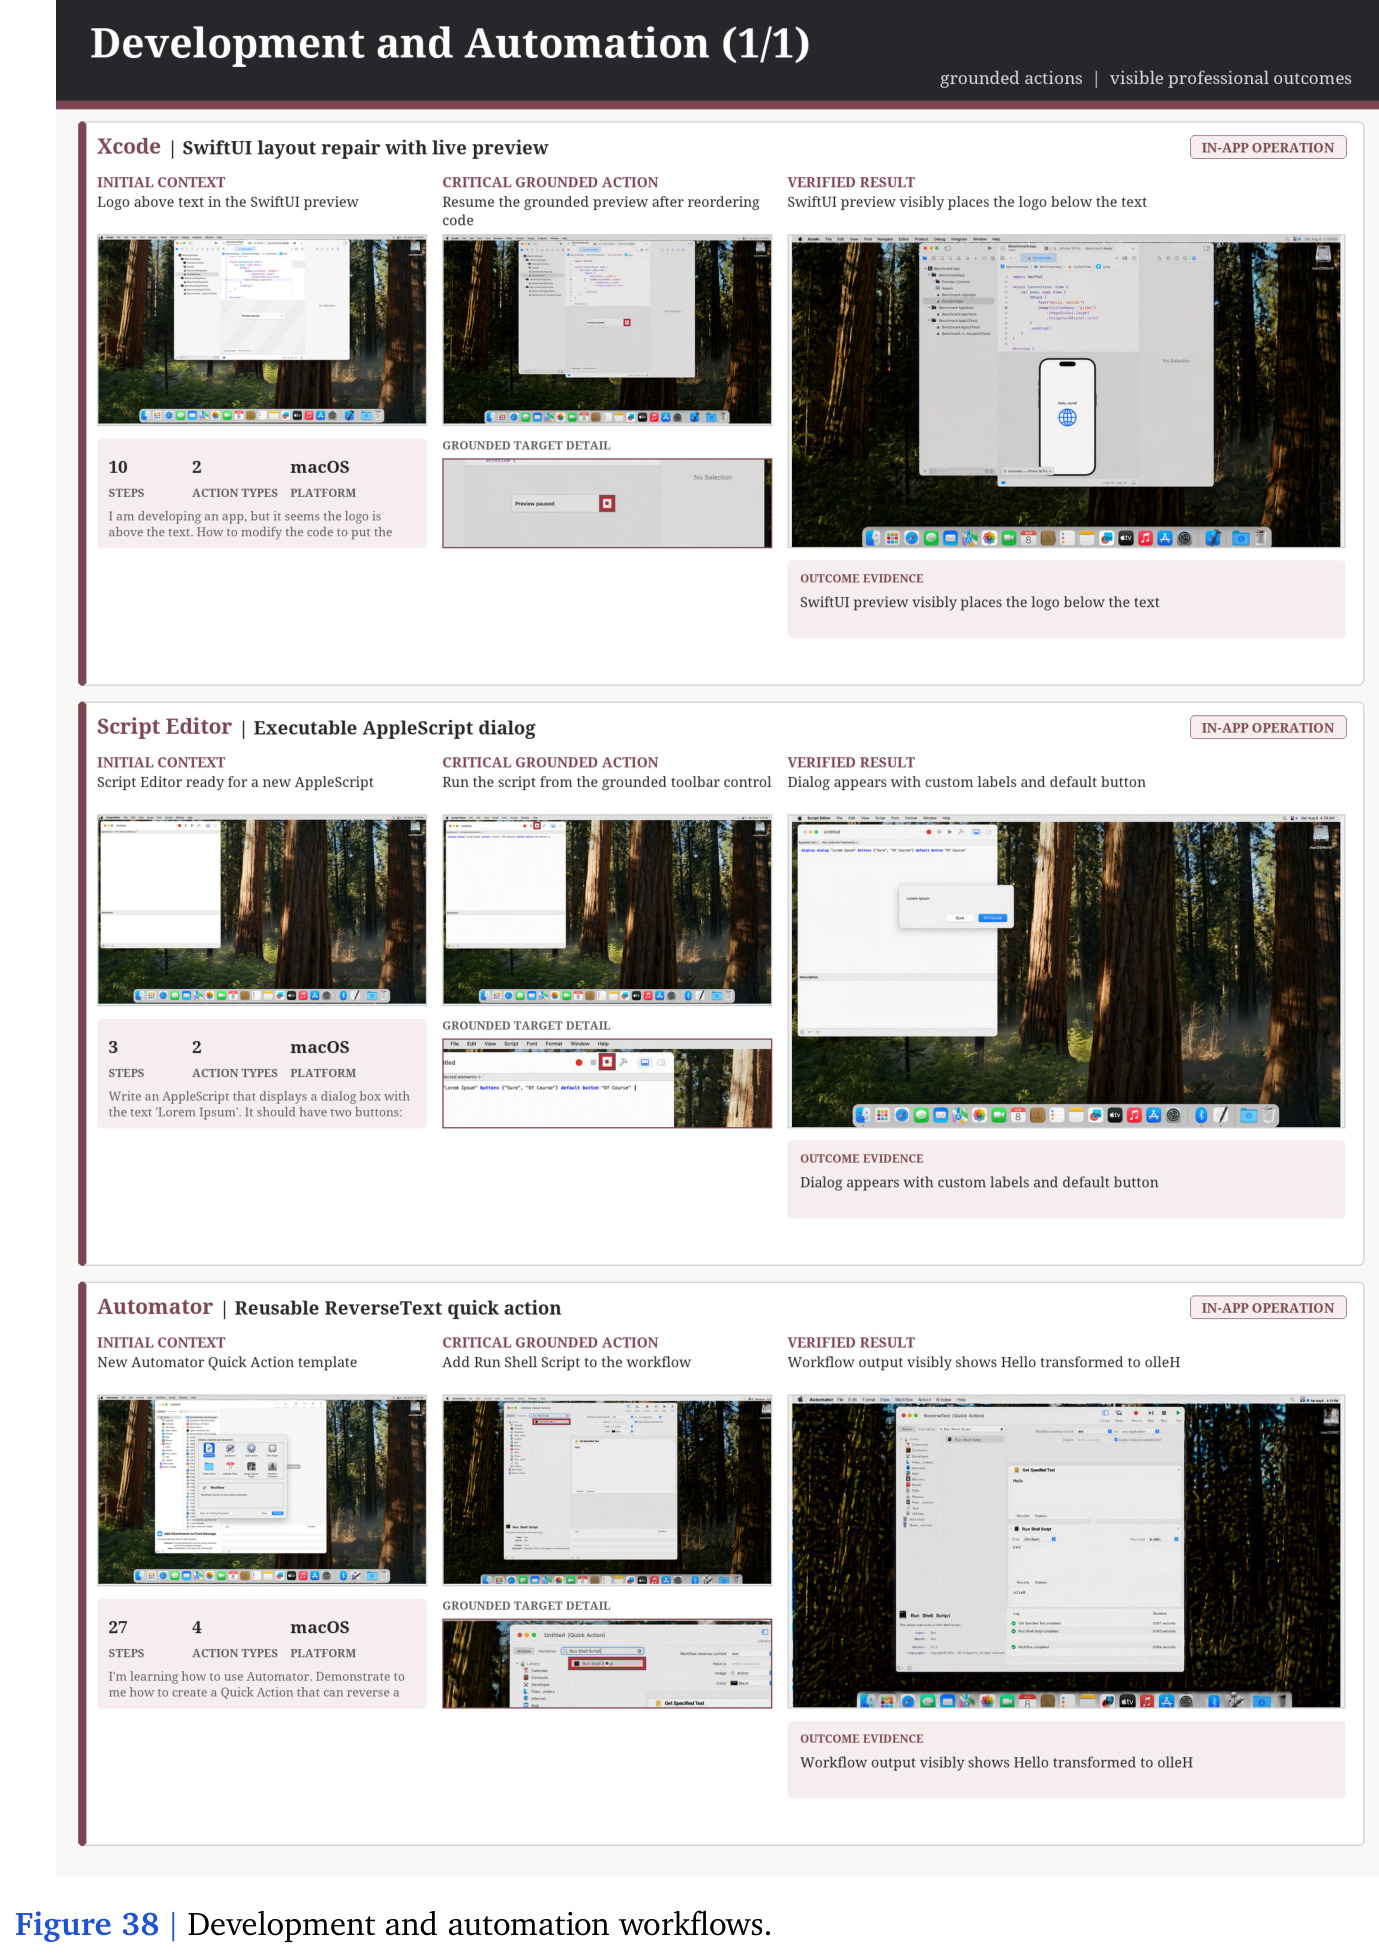
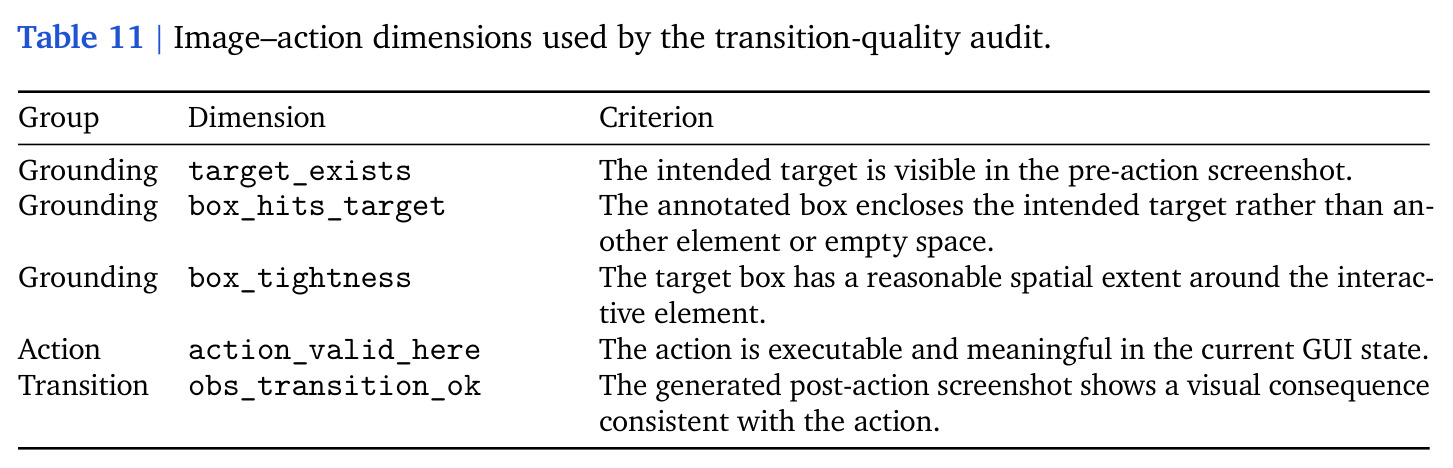
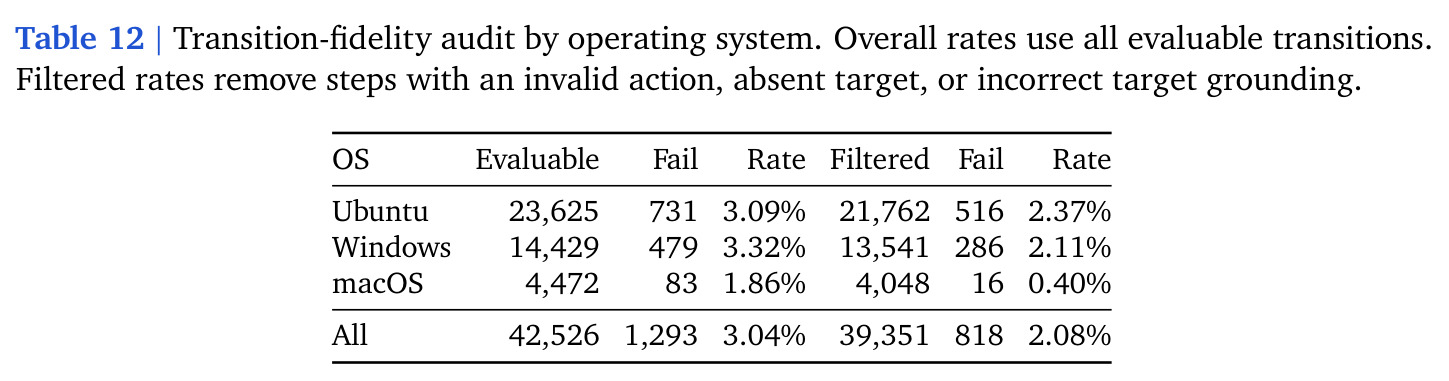
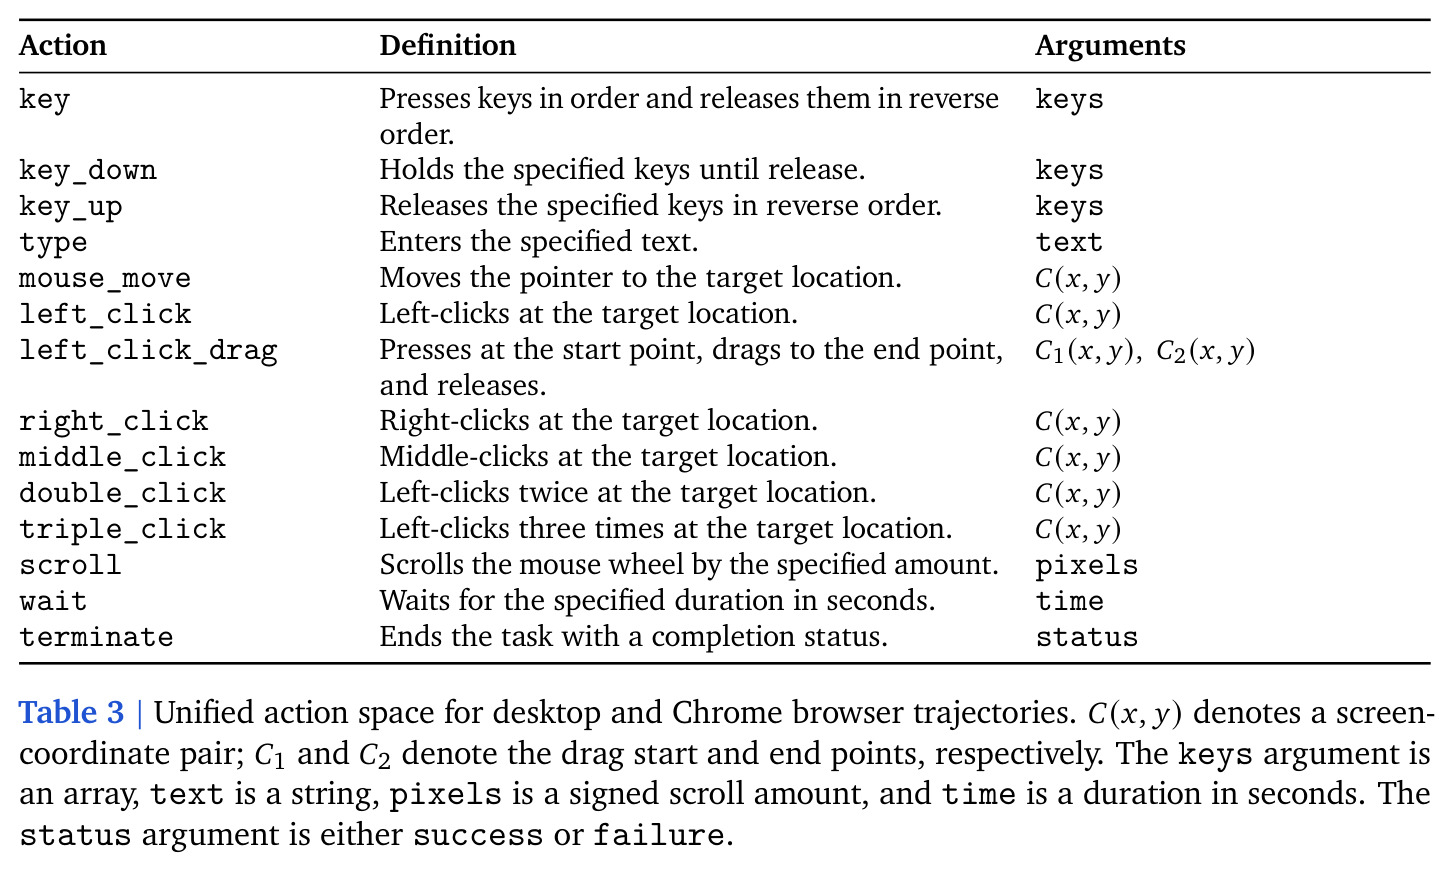
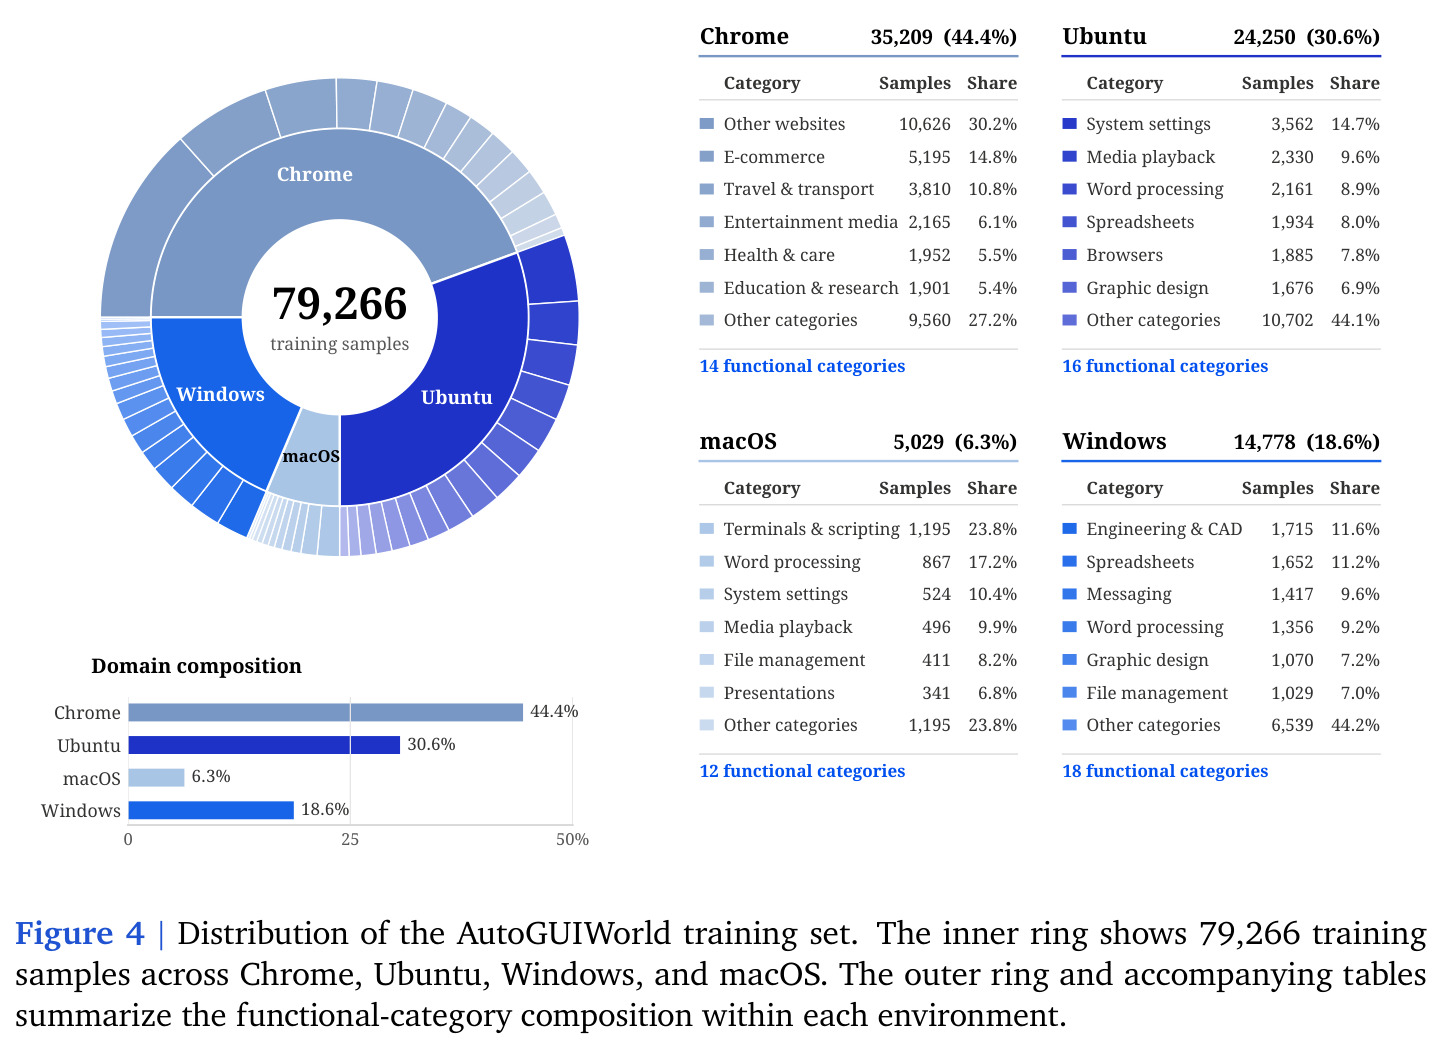
全流程六步。第一步 GUI 世界采样:从结构化空间抽取初始状态,涵盖 OS 底座(系统类型、屏幕几何、动作空间、UI 惯例)、视觉外观(主题、配色、壁纸、字体密度)和初始 GUI 状态(窗口数、布局、前台关系、内容、控件)。第二步 种子实现:把结构化状态编译成视觉描述,Image2 渲染出初始截图 $\tilde{s}_0$,连同种子元数据存储。第三步 任务生成:以平台上下文和种子可见元素为条件提出指令,避免引用不存在的应用,并支持基准驱动模式。第四步 规划器引导滚动:元规划器产出 $(a_t, \delta_t, e_t)$ 序列,Voyager 逐帧扩写成 $r_t$,Image2 逐帧编辑,新帧成为下一帧参考。第五步 动作标注:用 LocateAnything 把目标元素 $e_t$ 定位到截图区域,取中心作为空间标签 $p_t$。第六步 质控与构造:VLM 审计每步动作-图像一致性(42,526 条可评过渡中标记 3.04% 不一致),结合 grounding 检查剔除缺陷,转成单步训练实例(输入为前帧+指令+历史,输出为动作+坐标),共 79,266 条样本。
技术新颖性
技术新颖性体现在四点。一是表征选择:首次证明通用图像生成器可以直接充当动作条件的视觉状态转移模型,绕过训练专用世界模型的成本,也避免代码渲染方案对非网页界面的表达局限。二是因子化设计:把轨迹联合分布分解为种子采样、策略项与转移项三块,分别由结构化采样、元规划器和图像模型实现,规划与渲染彻底解耦——8 步保存文件的工作流示例(图 3)显示每一步的预期后果都被规划器预先写死,图像模型只负责'怎么呈现'。三是结构化采样空间替代自由文本提示:OS 底座、视觉外观、初始状态三个因子既保证跨设备跨风格的多样性,又形成可被任务生成器和规划器复用的持久种子规格,确保任务与画面一致。四是闭环渲染协议:Voyager 每步输出第一人称思考、动作摘要和渲染提示,使每帧成为下一帧的显式参考,实现跨步上下文保持。配套的 VLM 过渡审计(过滤后残余不一致率 2.08%)为生成式数据提供了此前缺失的可量化质量护栏。
实验结果
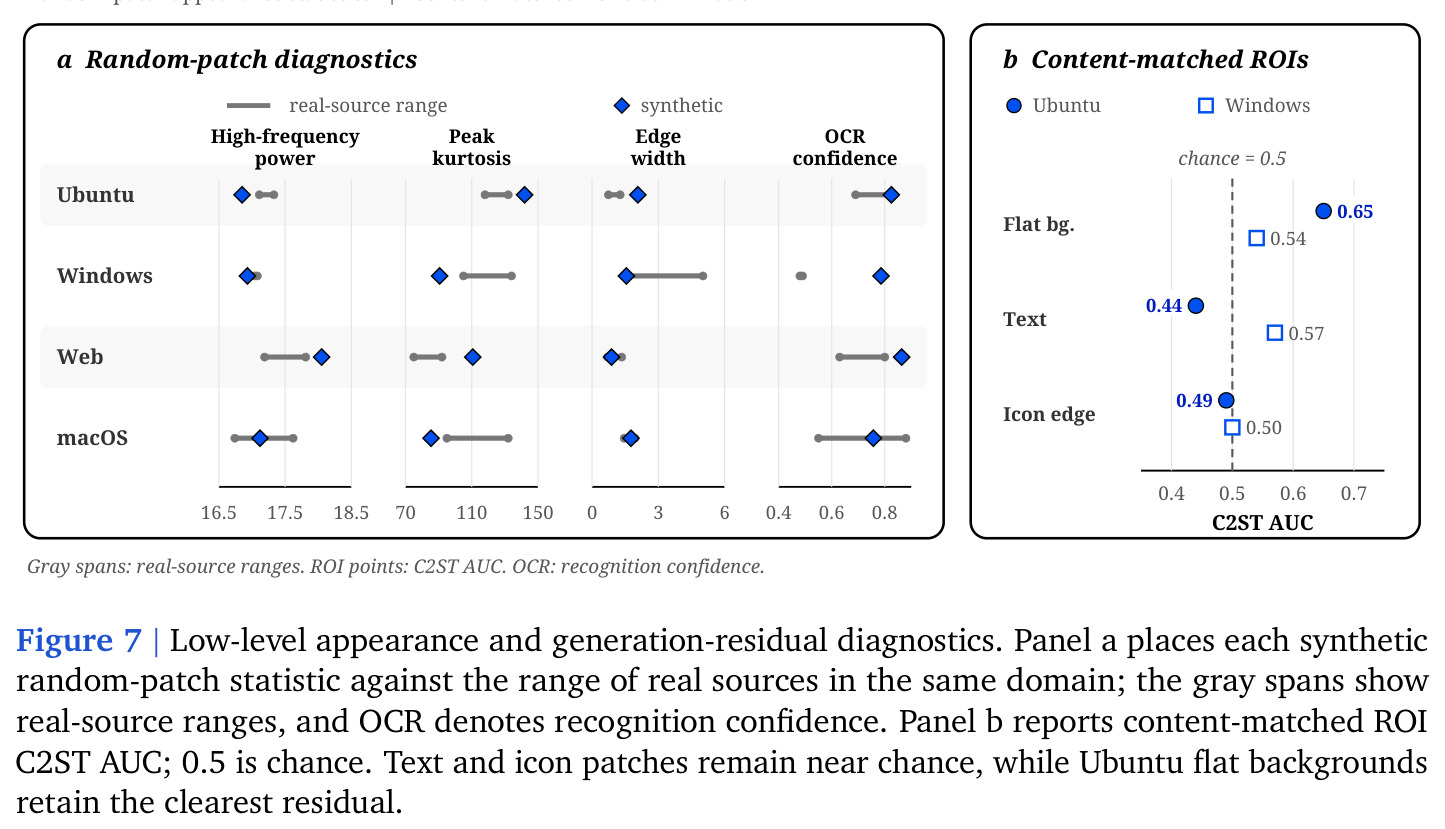
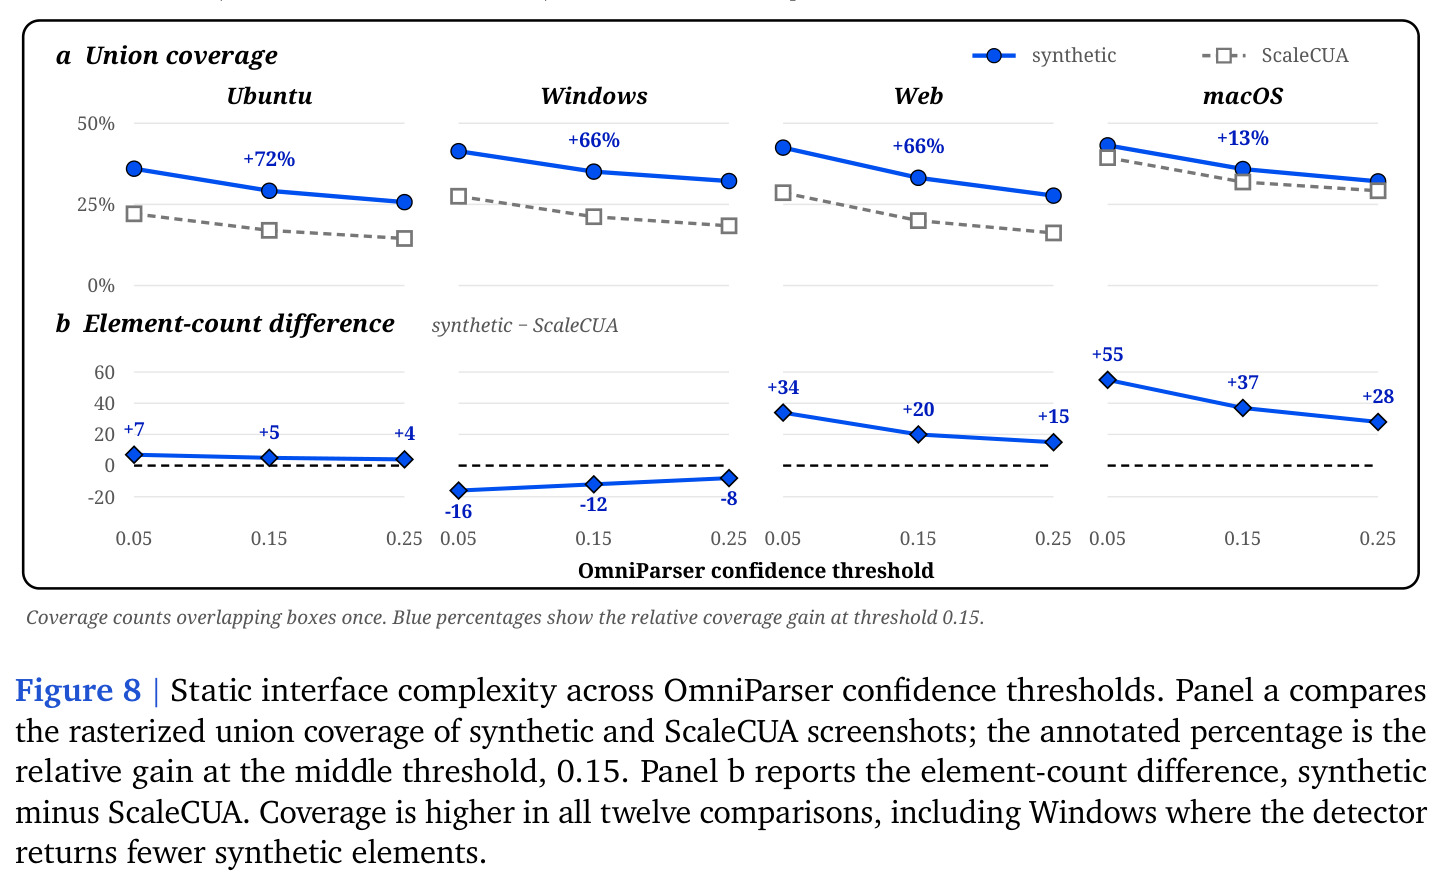
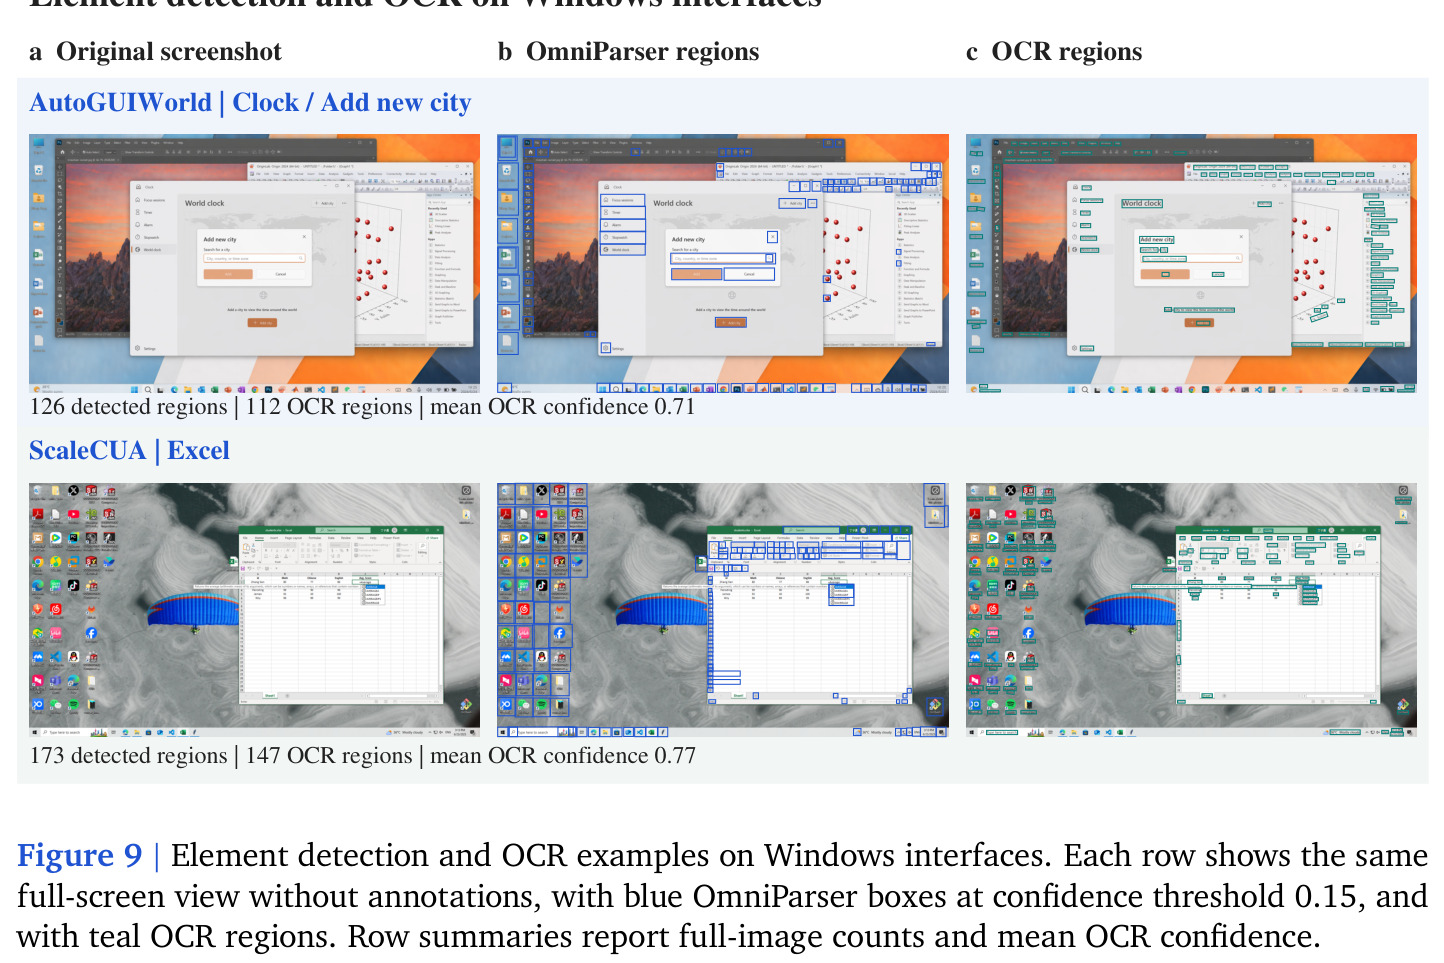
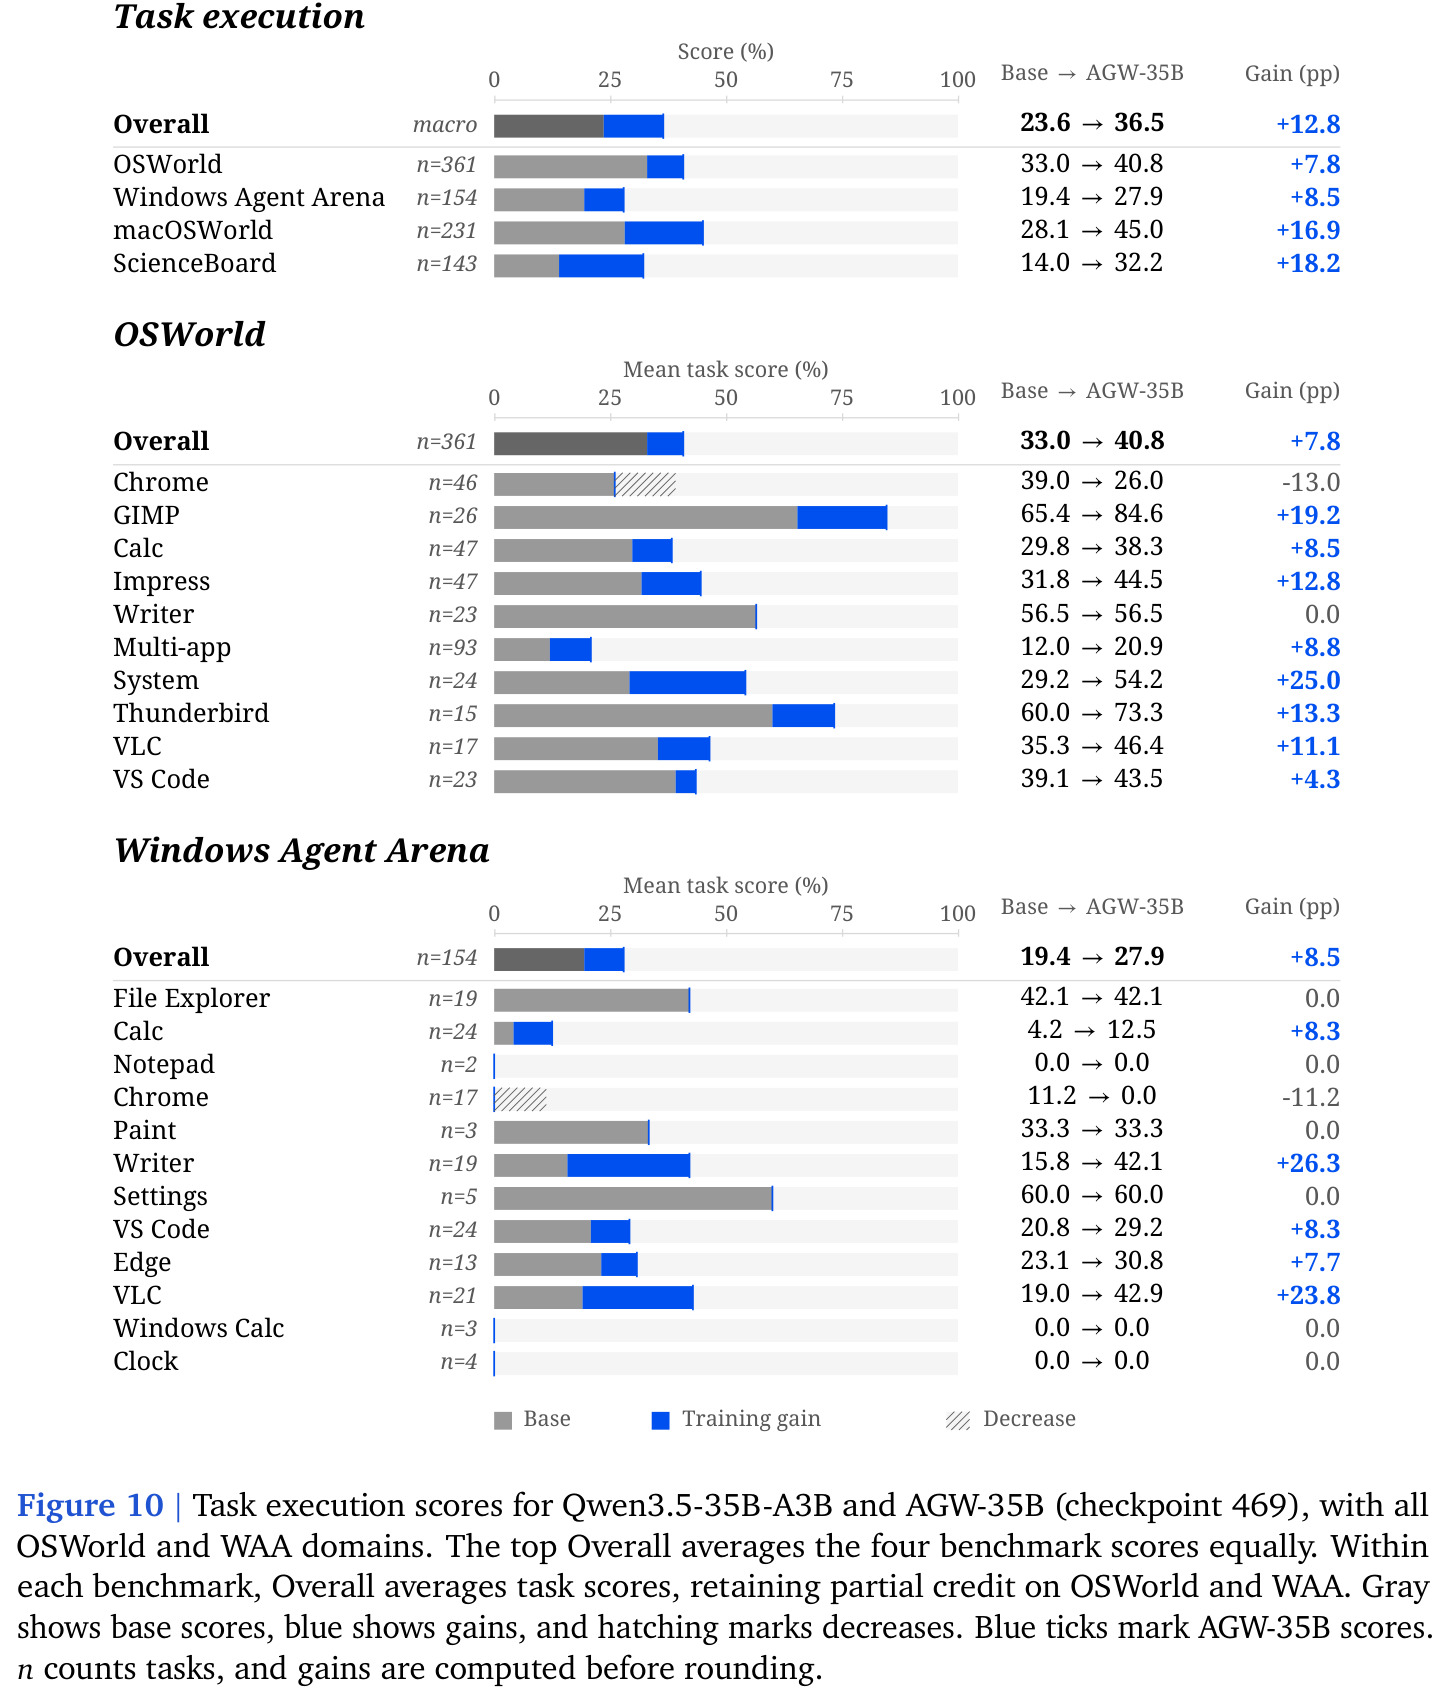
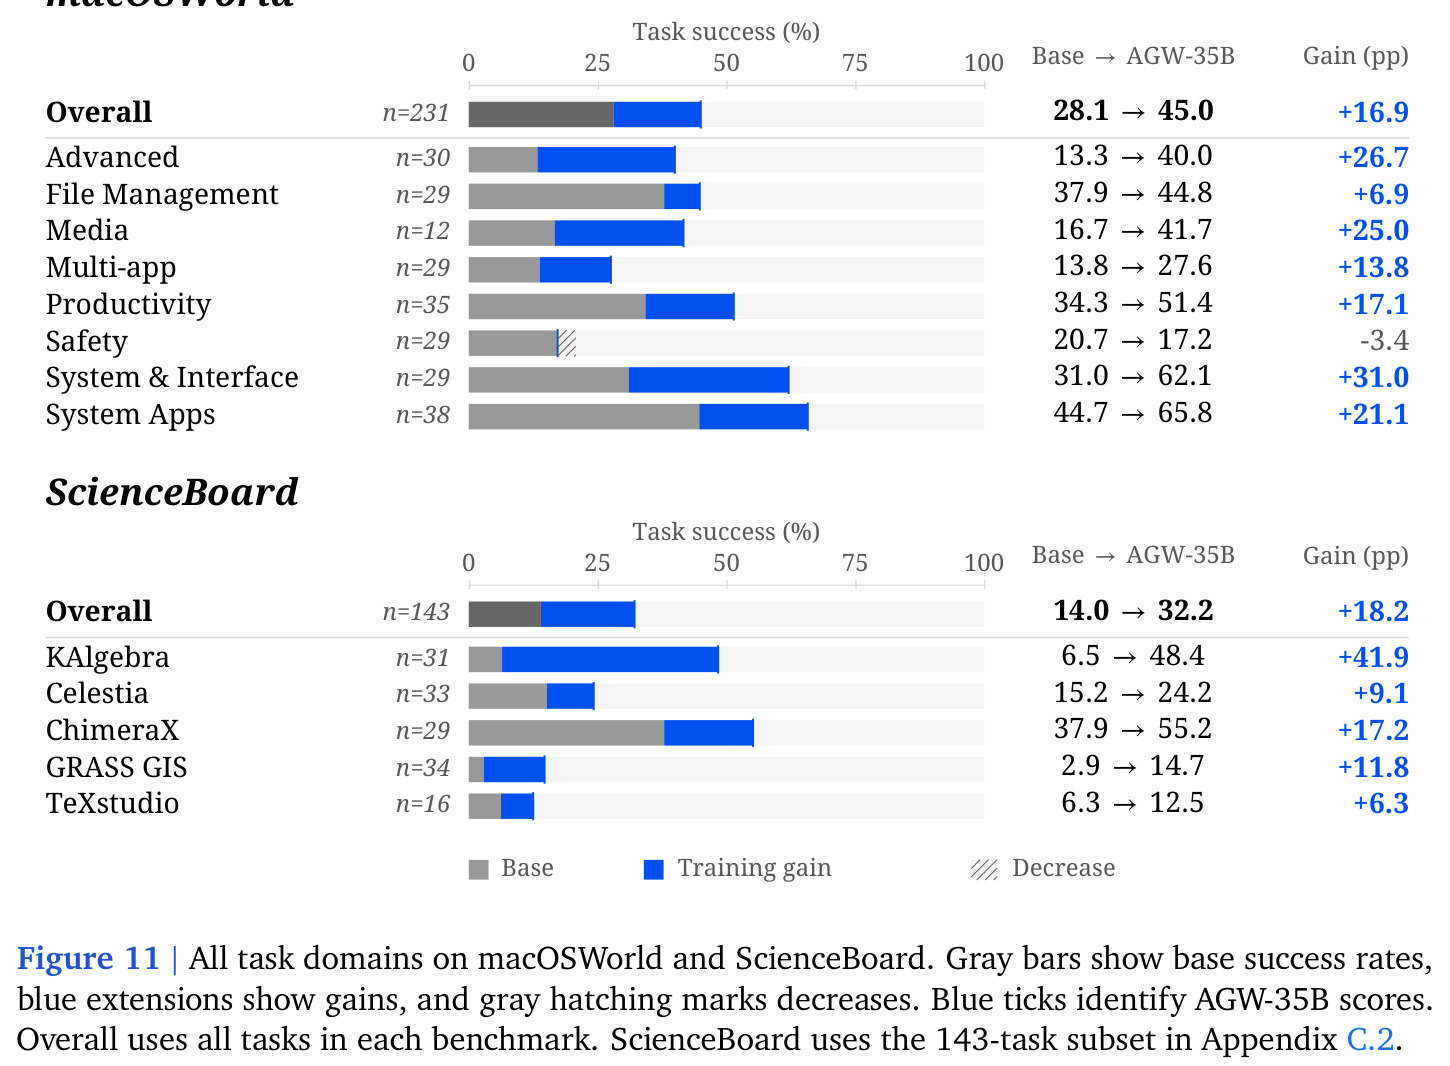
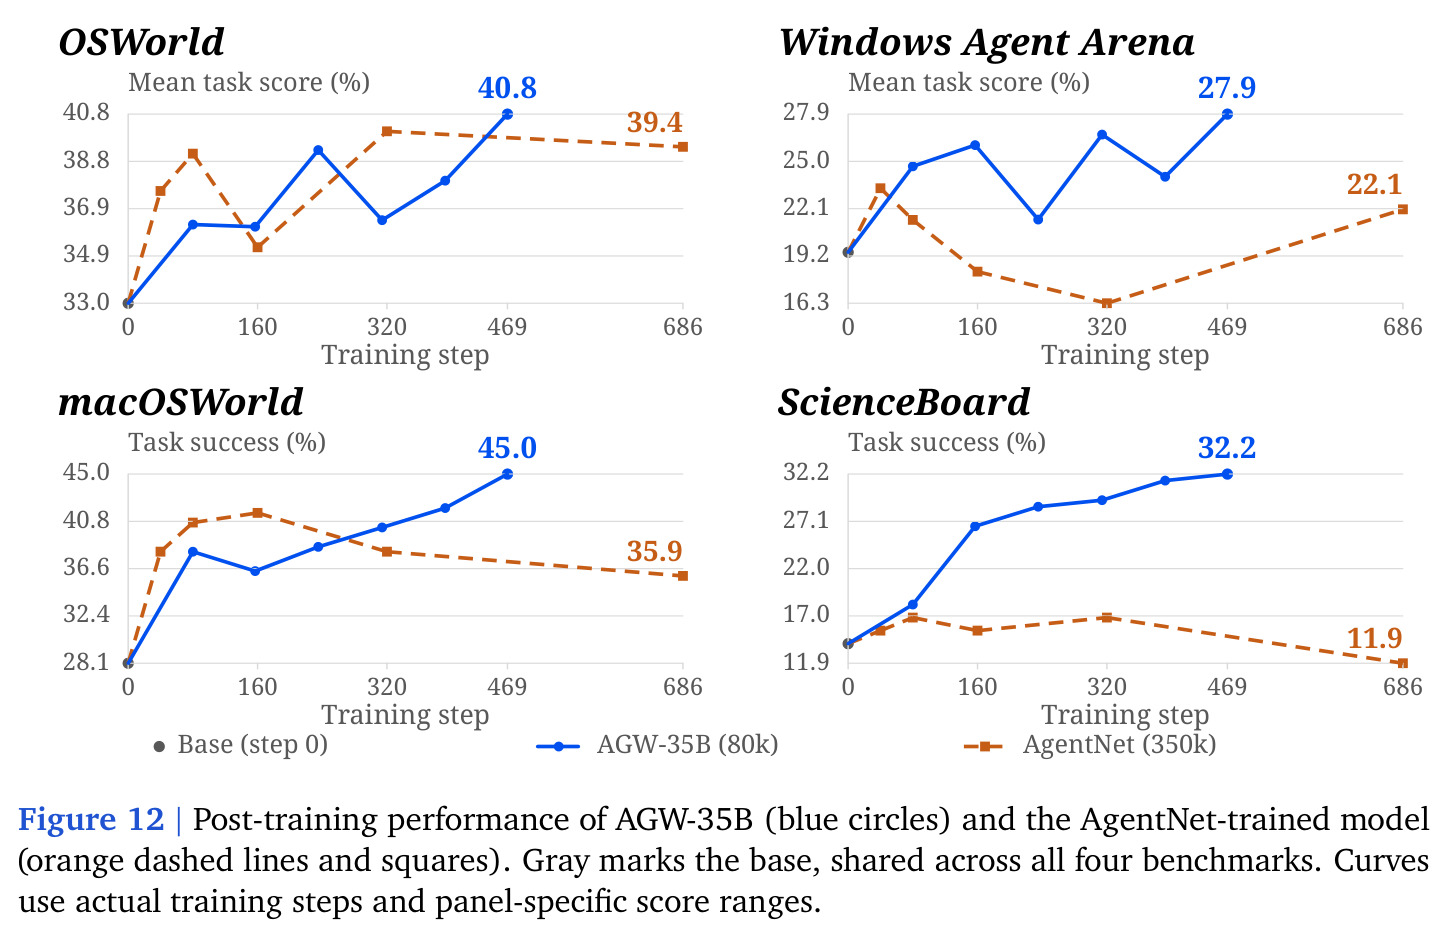
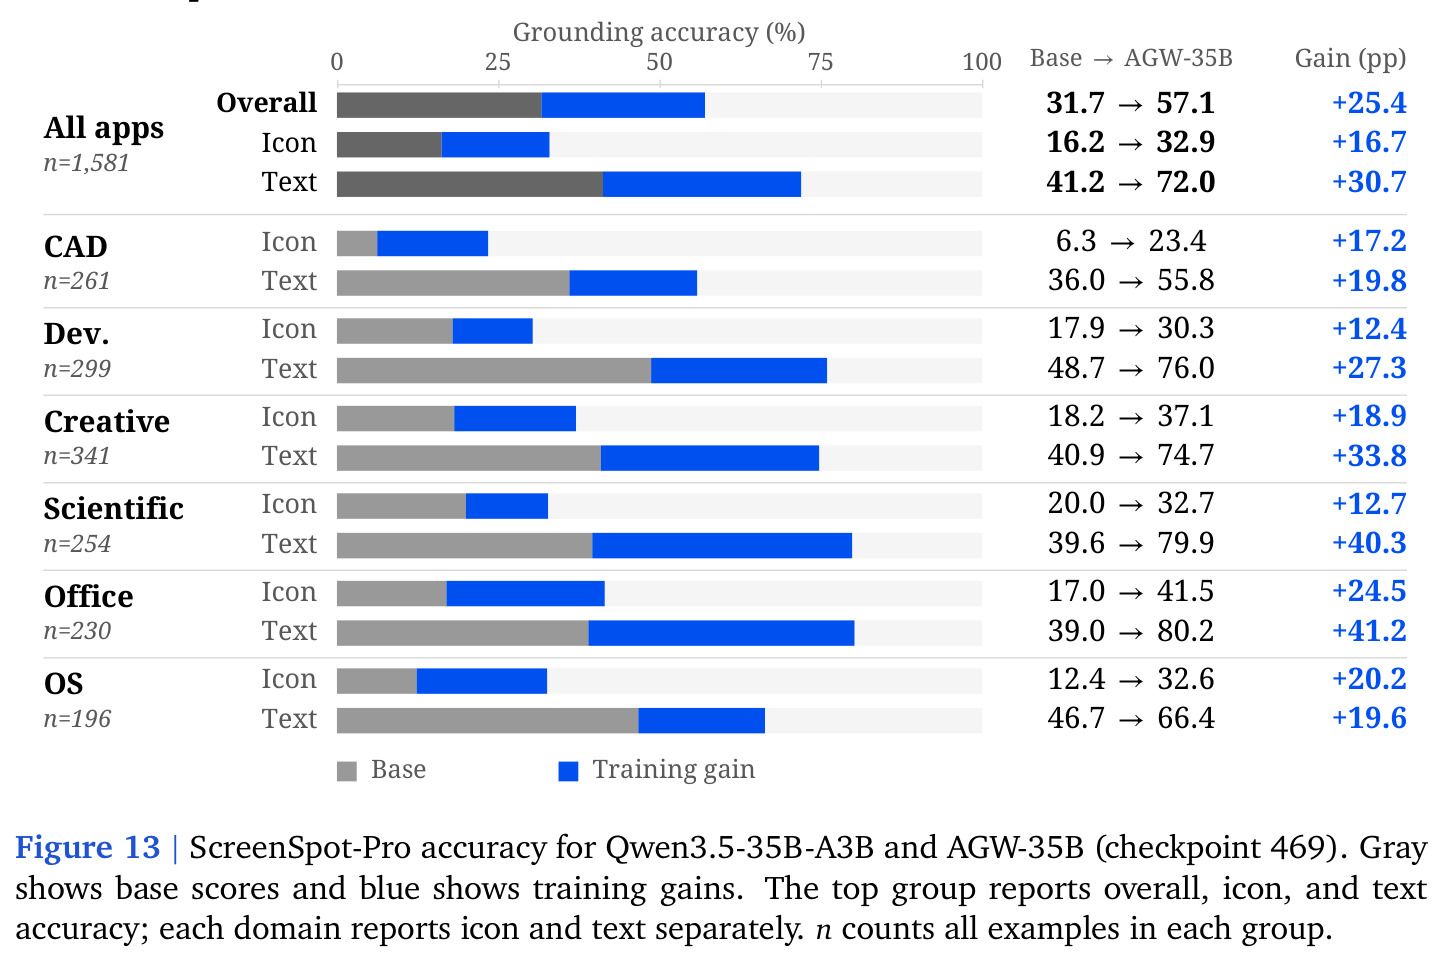
核心结论是纯合成数据可有效迁移到真实环境。用约 8 万条合成轨迹微调 Qwen3.5-35B-A3B 得到 AGW-35B:OSWorld 33.0%→40.8%(+7.8),System +25.0、GIMP +19.2;WAA 19.4%→27.9%(+8.5),Writer +26.3、VLC +23.8;macOSWorld 28.1%→45.0%(+16.9),System & Interface 31.0%→62.1%;ScienceBoard 14.0%→32.2%(+18.2),KAlgebra 6.5%→48.4%,五个软件域全涨。四基准等权均值 23.6%→36.5%(+12.8)。ScreenSpot-Pro 总体 31.7%→57.1%(+25.4),文本 41.2%→72.0%、图标 16.2%→32.9%。最关键的对比:35 万条真实人类演示(AgentNet)训练的模型四基准全面落后于 8 万条合成数据的 AGW-35B,ScienceBoard 差距最大(32.2% vs 16.8%)。数据侧,合成-真实 Qwen 特征距离比 $\rho$ 在 0.59–1.24(1 为真实跨源变异
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld(Ubuntu 桌面任务,n=361) | 平均任务得分(含部分得分) | 40.8% | Qwen3.5-35B-A3B 基线 33.0% | +7.8 pp |
| Windows Agent Arena(n=154) | 平均任务得分 | 27.9% | 19.4% | +8.5 pp |
| macOSWorld(n=231) | 任务成功率 | 45.0% | 28.1% | +16.9 pp |
| ScienceBoard(科学软件,143 题子集) | 任务成功率 | 32.2% | 14.0% | +18.2 pp |
| ScreenSpot-Pro(专业界面定位,n=1581) | point-in-box 准确率 | 57.1% | 31.7% | +25.4 pp |
| 四基准 vs AgentNet 后训练(35 万真实轨迹) | 四基准等权均值 | AGW-35B(8 万合成样本)36.5% | AgentNet 最佳检查点(ScienceBoard 16.8%) | 四基准全面领先,最大差距 15.4 pp |
局限与改进
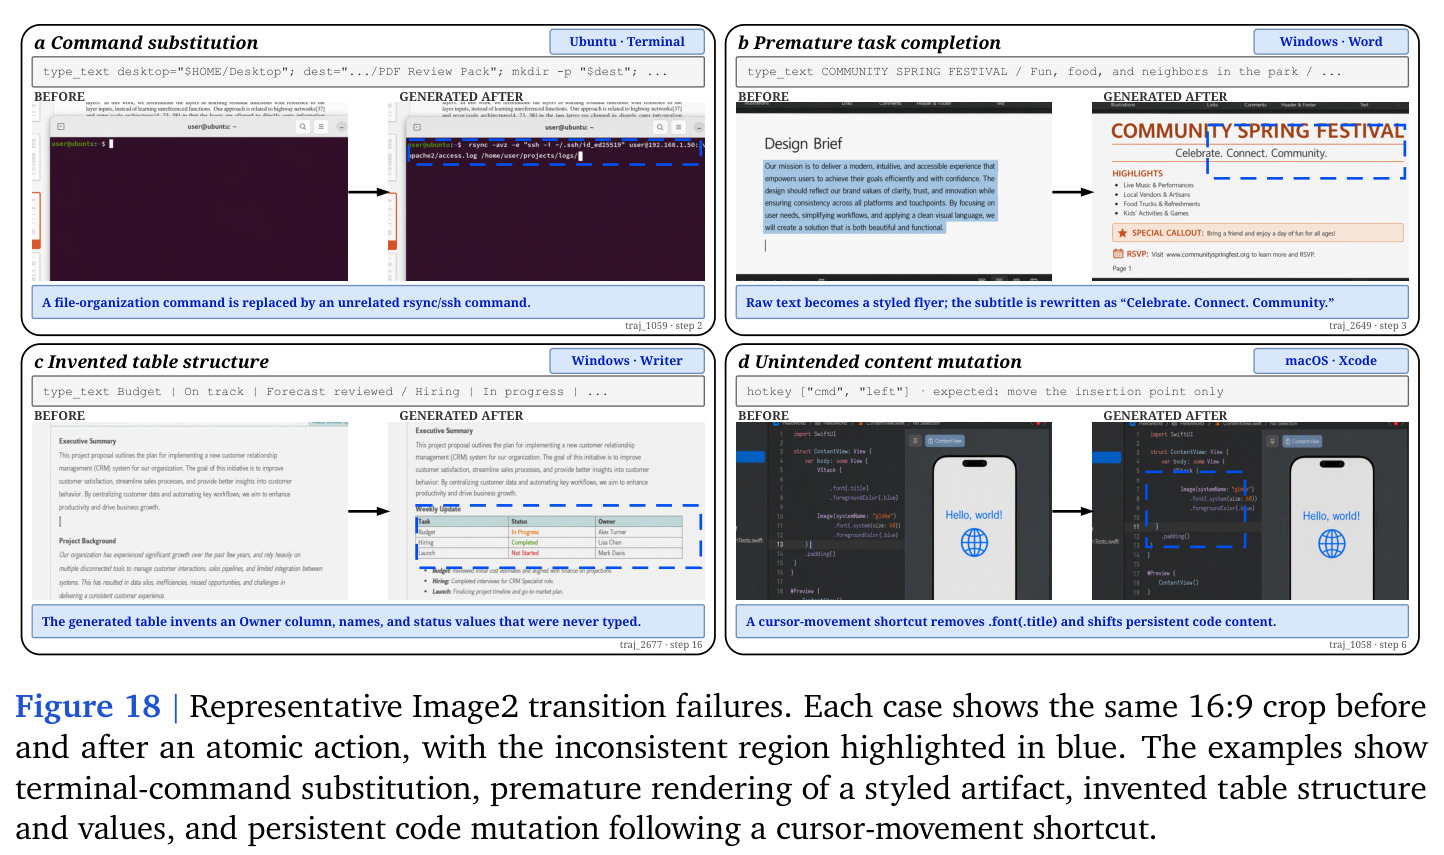
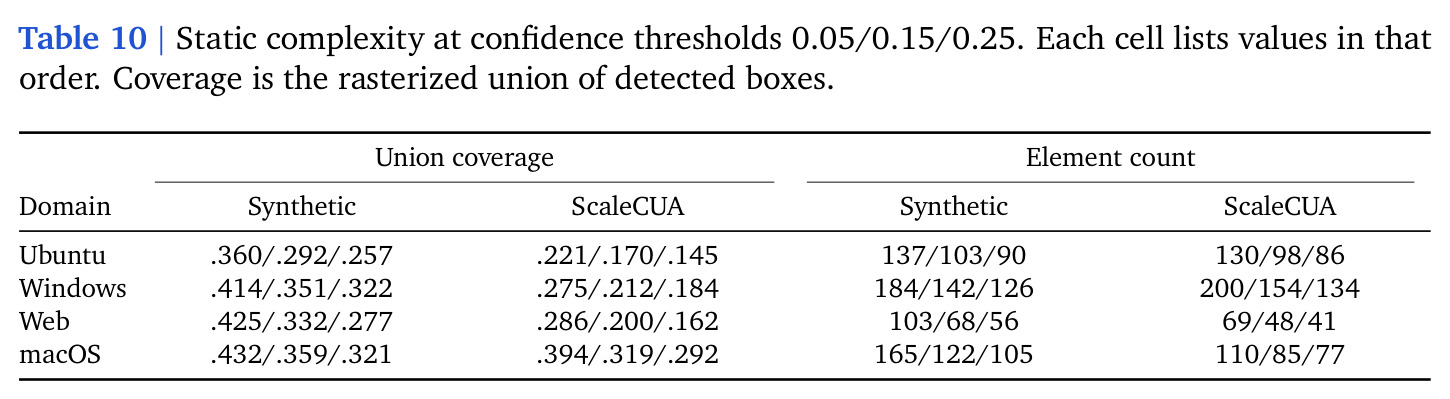
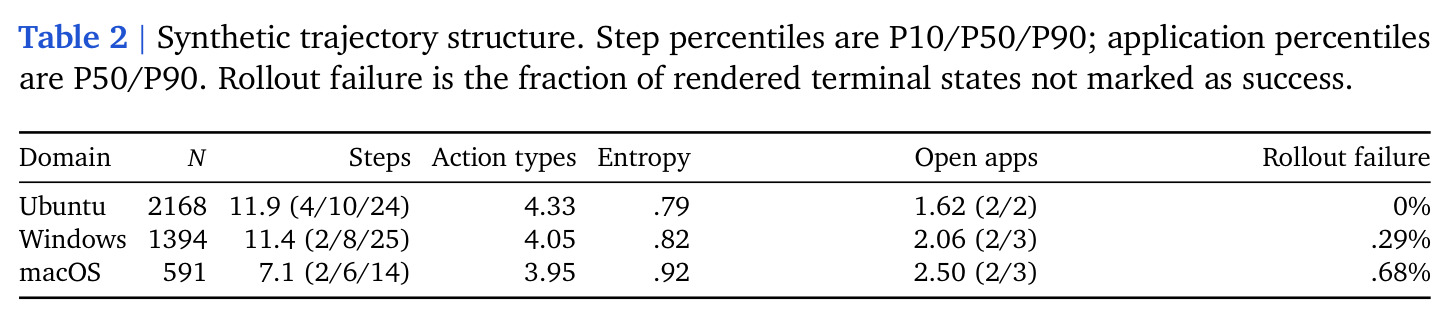
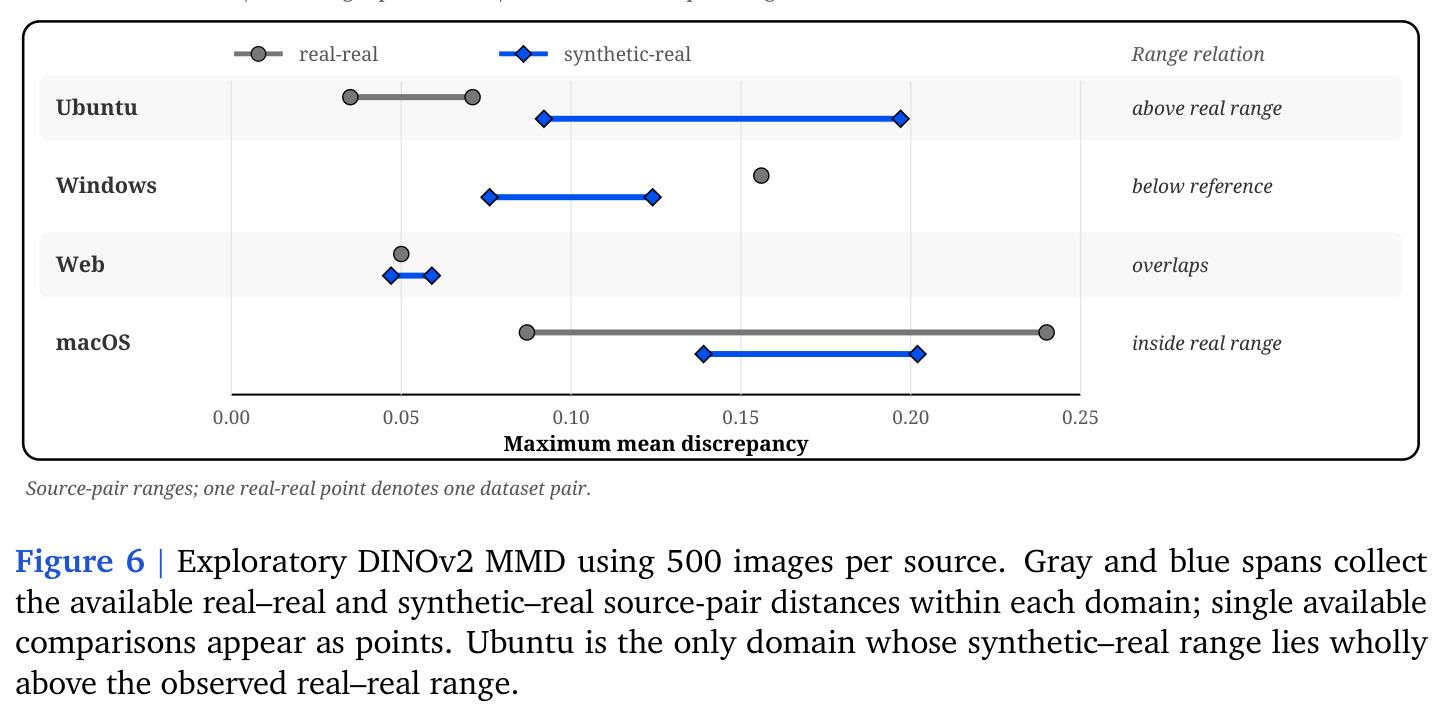
作者承认的局限:图像模型可能生成视觉合理但未忠实执行动作的后帧——42,526 条可评过渡中 VLM 审计标记 1,293 条(3.04%)不一致;剔除无效动作与 grounding 错误后仍有 818/39,351(2.08%)残留,集中于文本输入、拖拽、滚动和键盘交互,表现为命令替换、捏造文档内容、过早格式化、动作效果缺失和非预期的持久内容改变;长轨迹上误差累积会产生幻觉界面。我的观察:其一,Chrome 在 OSWorld(39.0%→26.0%)和 WAA(11.2%→0.0%)显著回退,说明网页域合成分布与真实浏览器系统性失配;其二,macOSWorld Safety 子域 20.7%→17.2% 下降,安全敏感任务受损;其三,precondition 和 blocker 字段全零、终端状态几乎总成功(rollout 失败率 0%–0.68%),数据里几乎没有失败恢复轨迹;其四,C2ST 显示合成数据仍保留源签名(AUC≈1.00),Ubuntu 平面背景有 0.65 判别残差,DINOv2 也确认 Ubuntu 是唯一合成-真实距离全面高于真实跨源范围的域。
独立分析的弱点
独立分析四点弱点。第一,文本类动作的保真度瓶颈:图像编辑模型对精确文字改动(输入指定句子、替换文件名)天然薄弱,而这恰是办公场景最高频的动作,也是残留错误的主要来源;改进方向是对文本过渡改用结构化注入——OCR 定位文本框后程序化替换像素或直接合成渲染,图像模型只负责非文本区域。第二,Chrome 回退暴露域失配:合成网页截图可能带生成器特有的排版与纹理风格,迁移到真实浏览器反而形成干扰;改进方向是按域加权采样、混入少量真实 Chrome 数据做正则,或如作者展望所言为网页单独训练垂直世界模型。第三,无失败数据:终端状态几乎全部成功、blocker 全零,模型学不到从报错、弹窗、权限拒绝中恢复,这与真实交互数据的本质差异可能限制上限;改进方向是让规划器刻意注入操作失误与环境干扰,生成失败-恢复配对样本。第四,评测协议可疑处:AGW-35B 与 AgentNet 对比使用了不同推理设置(论文附录 C.1 承认),虽控制了基线相同,但公平性打折扣;且只训了一个模型规模(35B-A3B),'8 万合成胜 35 万真实'的结论未在其他模型家族上验证。每一点都指向明确的后续实验设计。
未来方向
作者在讨论与展望中提出的方向:一是训练领域专用的 GUI 世界模型——在特定软件的交互上微调图像生成器,使其更好捕捉该域的界面结构、操作规则和状态转移,形成面向 CAD、EDA、科学计算的垂直世界模型,提升长程一致性并支持域内持续造数据;二是把动作条件图像编辑推广为通用的训练经验合成基座,超越 GUI 场景。基于本文成果可自然延伸的方向:把合成轨迹用于强化学习(论文已指出数据可直接支持轨迹回放与 RL 构造),用真实环境 reward 修正合成分布偏差,形成'合成预训练-真实微调'的两阶段范式;在质检环节引入程序化验证(OCR 比对文本变化、元素检测比对布局差分)替代部分 VLM 审计,把 2.08% 残留错误率进一步压低并降低过滤成本;系统研究合成数据规模-性能缩放律,确定 8 万样本之外的边际收益拐点;扩展到移动端、多语言界面等未覆盖平台;以及用真实环境的失败案例反向指导合成引擎生成针对性困难样本,构成数据飞轮。
复现评估
开源情况较好:代码在 GitHub(ImYangC7/AutoGUIWorld),AGW-35B 权重在 Hugging Face(YangC777/AGW-35B)。论文附录信息量大:附录 A 给出各 OS 动作空间,B 给出训练配置,C 给出评测基础设施与 ScienceBoard 143 题子集选取说明,I 是完整提示词目录(种子实现、任务生成、元规划、Voyager 渲染、grounding、各级质检 prompt 全公开),F 给出质控协议与审计结果。复现难点有三:核心图像生成器 gpt-image-2 是闭源 API,79k 样本需大量生成与多轮编辑调用,费用高且随 API 版本漂移;LocateAnything 标注模型需另行部署;评测需 OSWorld、WAA、macOSWorld、ScienceBoard 四套真实虚拟机环境,搭建成本高。若只用已发布数据复现训练与评测,下载权重加一次 35B 级 MoE 微调(Qwen3.5-35B-A3B 激活约 3B,单机多卡可行)门槛中等;若全流程含数据合成,需可观 API 预算与工程量。
论文图表