缩放与蒸馏文本嵌入以提升扩散性 Scaling and Distilling Text Embeddings for Better Diffusibility
缩放T5Gemma-2嵌入并蒸馏解码概率,使连续扩散语言模型生成更有效。
前置知识
连续扩散语言模型(Continuous DLM)
与直接在离散词表上做去噪的离散扩散语言模型不同,连续DLM先用冻结的嵌入模型把token序列 $\boldsymbol{s}\in\mathcal{V}^L$ 映射为连续向量序列 $\boldsymbol{x}=\mathrm{Emb}(\boldsymbol{s})\in\mathbb{R}^{L\times d}$,再在这个嵌入空间上训练去噪器 $\boldsymbol{x}_\theta(\boldsymbol{z}_t,t)$,用MSE损失拟合速度场 $\boldsymbol{z}_t=t\boldsymbol{x}+(1-t)\boldsymbol{\epsilon}$,最后把生成的嵌入经LM头解码回token。
本文研究的核心问题就是『连续DLM应该用哪个嵌入空间』,理解这一流程是读懂全部实验设计(固定ELF框架、只换嵌入)的前提。
ELF(Embedded Language Flow)框架
一个极简的连续DLM基线:冻结嵌入模型编码文本,训练DiT式去噪器做流匹配(自条件、SDE采样等),并用一个与去噪器共享权重、可训练头部的解码器处理token级腐蚀 $\tilde{\boldsymbol{z}}=\lambda\boldsymbol{x}+(1-\lambda)\boldsymbol{\epsilon}$,以 $\mathcal{L}_{CE}=\mathrm{CE}(\mathrm{Head}_{\theta'}(\boldsymbol{x}_\theta(\tilde{\boldsymbol{z}},t=1)),\boldsymbol{s})$ 增强对不完美嵌入的解码鲁棒性。
本文刻意固定ELF作为扩散侧,唯一变量是嵌入模型,这样才能把生成质量的差异干净地归因于嵌入空间的可扩散性。
知识蒸馏与软标签(Distillation & Soft Labels)
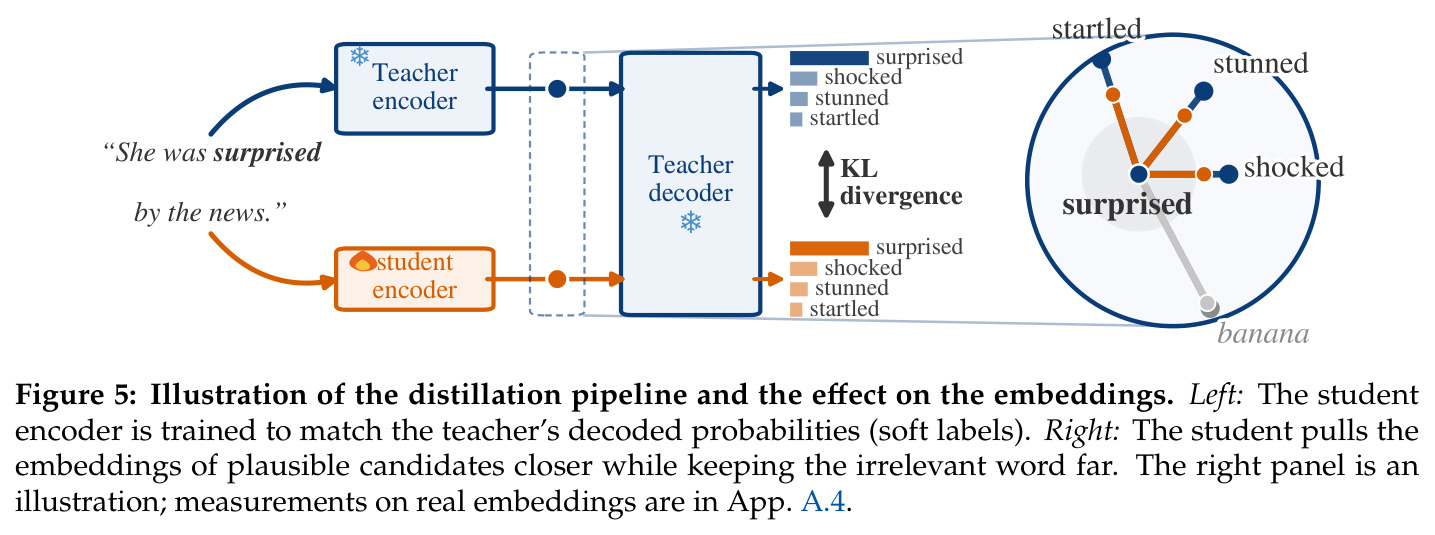
让小型学生模型模仿大型教师模型的输出分布而非one-hot标签。教师解码器输出的概率 $\boldsymbol{p}^T$ 在多个合理候选词上分配概率质量,学生以KL散度 $\mathcal{L}_{KD}(\theta)=\sum_{j=1}^{L}\mathrm{KL}(\boldsymbol{p}^T_j\|\boldsymbol{p}^S_j)$ 拟合它,从而把语义相近的候选词嵌入拉近,形成连续区域。
本文的蒸馏不是压缩参数,而是用软标签重塑嵌入几何:让可互换的词嵌入彼此靠近,正是修复『无效嵌入』失败模式的关键手段。
可扩散性(Diffusibility)
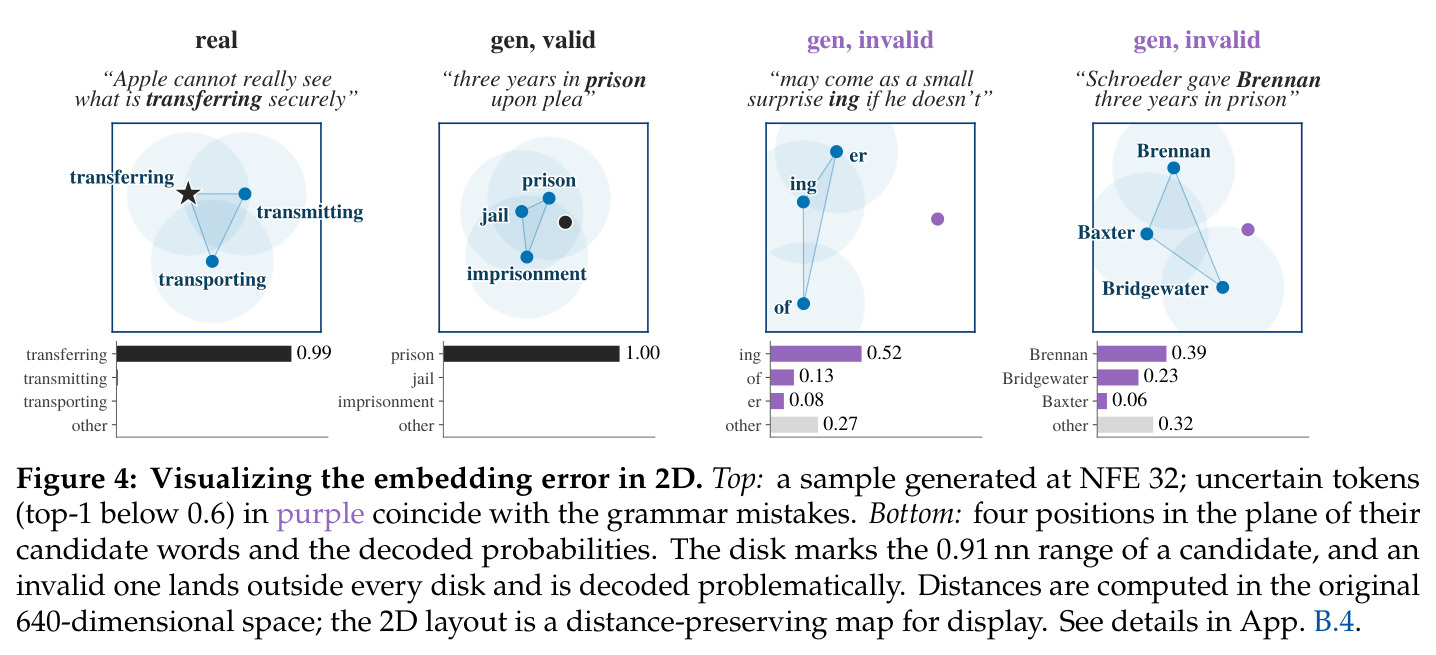
衡量一个潜在空间是否适合做扩散生成的性质。本文给出操作性定义:同一扩散模型在该嵌入上能否采样出『有效且可解码』的嵌入——即生成嵌入距离其top-k候选词在 $0.91\,\mathrm{nn}$ 阈值内(nn为真实嵌入的最近邻中位距离),且解码top-1概率不低于0.6。
这是全文的中心概念:作者论证强判别嵌入未必可扩散,缩放提升可扩散性但有上限,蒸馏进一步改善它,所有实验都围绕这一指标展开。
生成困惑度(Gen. PPL)与熵的联合评估
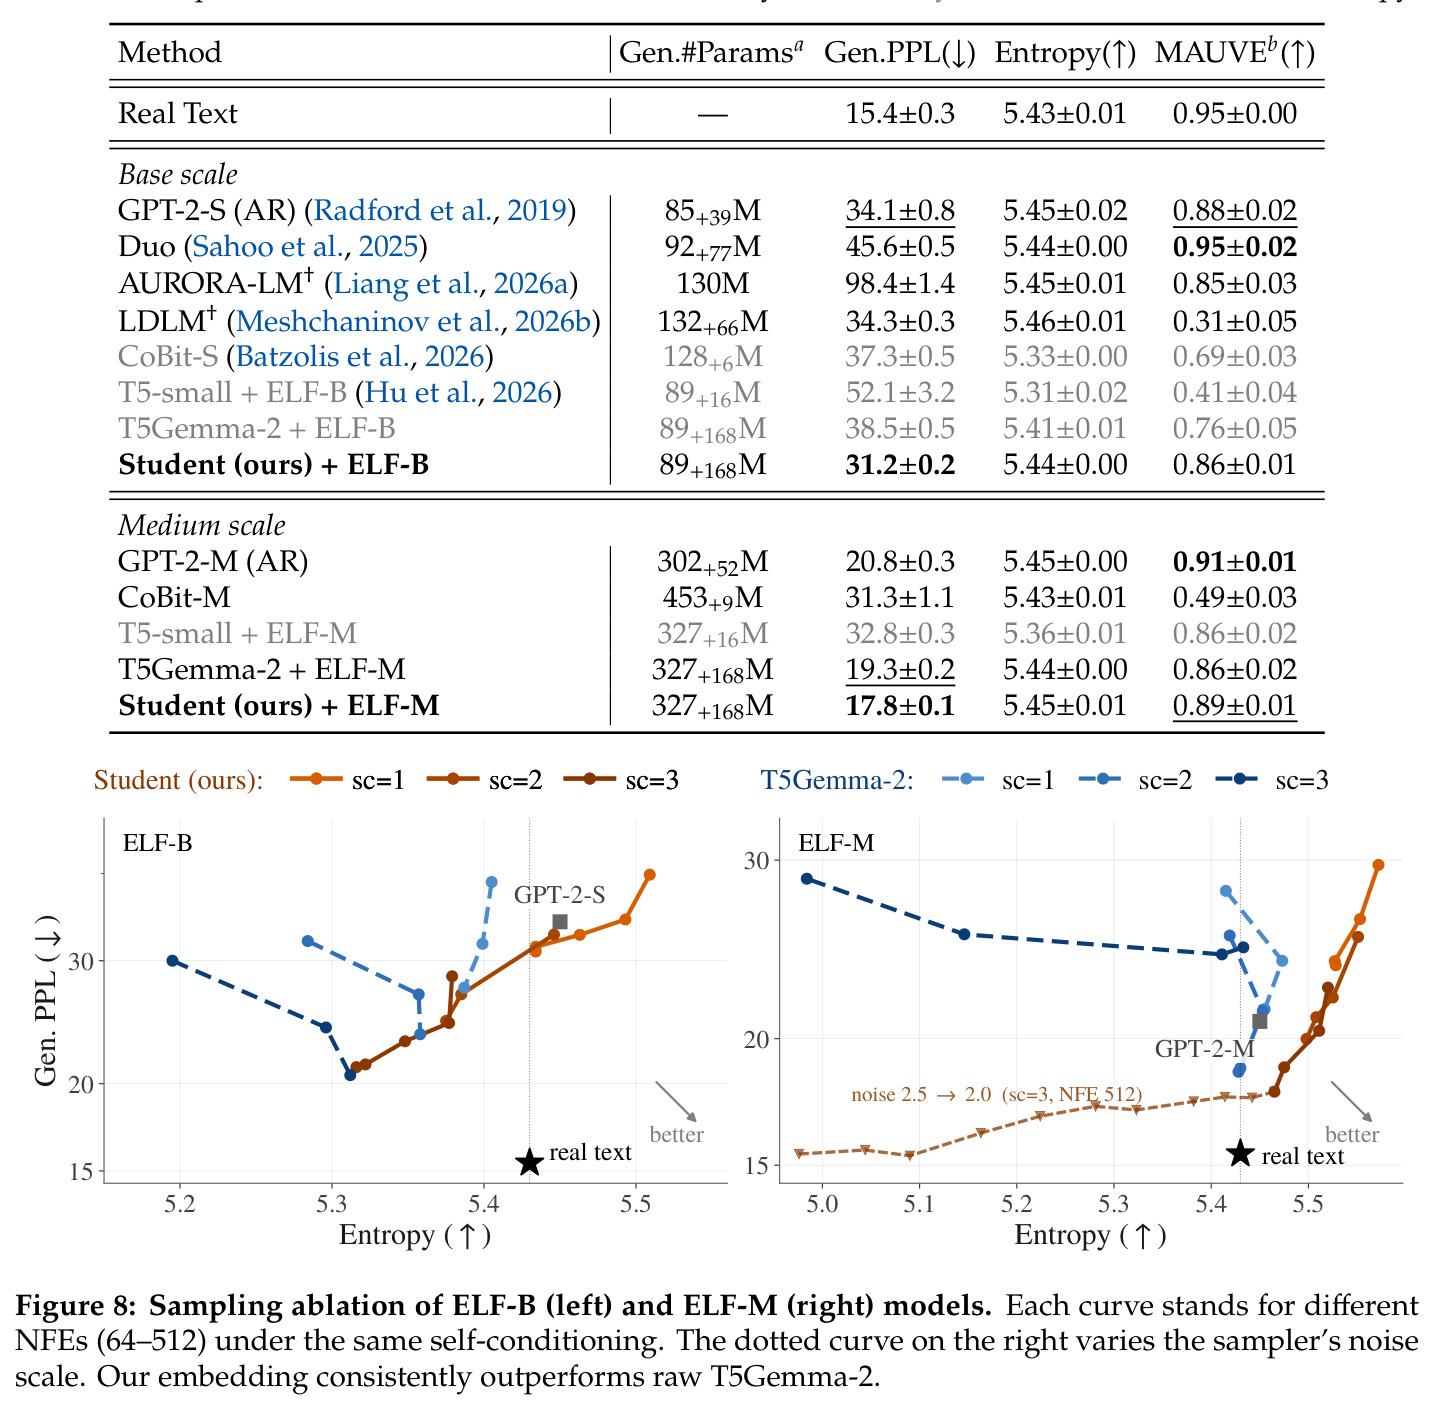
用GPT-2-Large给生成文本打困惑度、算熵,并在PPL-熵平面画曲线:真实文本位于熵5.43、PPL15.4处。曲线越靠左下(低困惑度、高熵)越好;单点比较必须在『熵不低于真实文本』的前提下取最优PPL,否则模型可以靠重复退化刷低PPL。
论文所有表格(如17.8 vs 19.3 vs 20.8)都遵循『在真实文本熵以上报告最优Gen. PPL』的协议,不理解这一点会误读各基线的强弱。
研究动机
连续扩散语言模型把潜在扩散直接作用在文本嵌入上,但『该用哪个嵌入空间』一直未被独立研究。现有工作要么联合训练嵌入与扩散模型——而共训会导致嵌入塌缩(所有点坍到一处最容易降MSE损失);要么依赖较旧的嵌入模型(如ELF默认的T5-small),既无法隔离嵌入本身的贡献,也没发挥预训练表示的潜力。更严重的是一个此前被当作插值效应的失败模式:强判别性嵌入(如T5Gemma-2)把同一位置的可互换候选词在空间里推得很远,而最优去噪器 $\boldsymbol{x}^\star=\mathbb{E}[\boldsymbol{x}|\boldsymbol{z}_t]=\sum_i p(\boldsymbol{x}_i|\boldsymbol{z}_t)\boldsymbol{x}_i$ 是候选嵌入的加权平均,落在彼此分离的候选之间,采样不完美时就会停在谁都不是的『无效嵌入』上。实测NFE 32下生成的1024词序列平均有142个不确定位置、其中109个无效,直接对应 'surprise ing'、'crime ers' 这类语法错误。
本文的目标是本文要在固定扩散框架(ELF)的条件下,系统回答两个问题:其一,缩放嵌入模型能否让潜在空间更可扩散——这里的缩放指在同一家族内换用数据更多、配方更强的模型(T5-small→T5Gemma-1→T5Gemma-2),而非单纯加参数;其二,当原始强嵌入仍存在『生成不出有效嵌入』的问题时,能否通过改造嵌入几何来修复它。最终目标是给连续DLM一个强嵌入基线,并在OpenWebText上达到或超过同规模自回归模型GPT-2-M的生成困惑度,同时保持真实文本水平的熵,为连续DLM这条路线提供可靠、可缩放的基础。
与已有工作不同的是,已有研究要么在图像扩散中探索过『预训练表示替代VAE潜变量』(如RAE用DINOv2),要么在文本侧只是发现预训练嵌入比查找表好,均未回答『哪个嵌入最适合扩散』这一独立问题。本文的独特之处有三:一是把嵌入作为唯一自变量的控制变量实验设计,扩散侧完全冻结为ELF;二是首次从『生成嵌入的有效性/可解码性』角度形式化文本嵌入的可扩散性,给出基于 $0.91\,\mathrm{nn}$ 距离阈值和top-1概率0.6阈值的量化判据,并揭示判别性强与可扩散性之间的张力(ModernBERT判别强却生成出重复句);三是提出用教师解码器概率作软标签的蒸馏来重塑嵌入几何——不是让模仿教师嵌入本身,而是让可互换候选词的嵌入彼此靠近,这与所有已有嵌入改造方式有本质区别。
核心方法
直觉上,连续扩散生成嵌入时,去噪器输出的是多个候选嵌入的加权平均;若候选彼此远离,平均点就悬在无人区,采样走偏即掉进无效嵌入。理想潜在空间应让可互换词的嵌入连成连续区域。路线分两步。第一步缩放实验:固定ELF-B扩散框架,在OWT-512(OpenWebText 25%子集)上分别用T5-small、T5-base、T5Gemma-1-S/B、T5Gemma-2-270M和ModernBERT训练同一扩散模型,画PPL-熵曲线比较可扩散性。第二步蒸馏:把T5Gemma-2编码器蒸馏成学生,在全量OWT上以 $\mathcal{L}_{KD}=\sum_{j=1}^{L}\mathrm{KL}(\boldsymbol{p}^T_j\|\boldsymbol{p}^S_j)$ 匹配教师解码器逐位置的输出分布($\boldsymbol{p}^T$、$\boldsymbol{p}^S$ 分别为教师和学生编码后经冻结教师解码器的输出);学生从教师18层均匀取9层初始化,词表截断top-256候选,最终以学生嵌入作ELF的潜在空间。
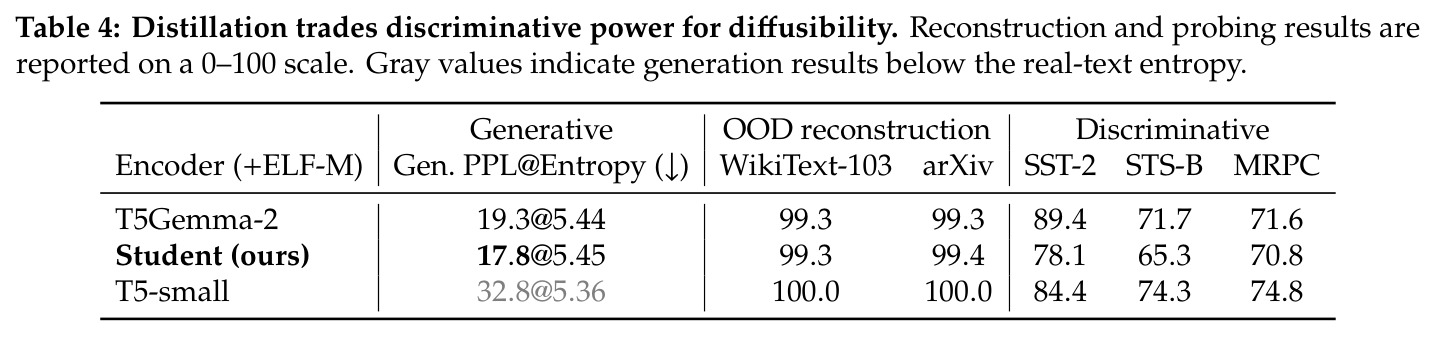
核心创新是『蒸馏解码概率而非嵌入本身』。以往改嵌入的方法要么与扩散模型共训(会塌缩),要么显式重设潜在空间结构;本文则保持编码-解码机制不变,只改变几何。其原理是:T5Gemma-2作为编码-解码器用one-hot标签做似然训练,最大化输入token对所有替代词的对数似然,把语义相近候选推得很远(这对判别任务有益);而软标签把这些概率质量分散到多个合理候选上,学生为了拟合KL损失必须把候选词嵌入拉近,同时保留编码-解码闭环使嵌入仍可被解码回文字。消融证明这是关键:换成对one-hot输入做CE的学生熵最高只到4.18,换成对教师嵌入做MSE的学生只到5.26,都到不了真实文本熵5.43——只有软标签KL能让同DLM的生成嵌入在候选形成的连续区域内落地。另一个反直觉发现是,蒸馏用判别力换生成力(SST-2从89.4降到78.1),说明嵌入空间里『相似嵌入更连通』对扩散更重要。
方法步骤详情
步骤一(缩放基线):用各编码器(T5-small约19+16M参数到T5Gemma-2的100+168M)按ELF的全局均值方差归一化编码,在OWT-512上训练同一ELF-B去噪器,输出PPL-熵曲线,确认T5Gemma-2同熵下Gen. PPL比T5-small低约40%。步骤二(失败分析):NFE 32下生成64条序列,从解码头取每位置top-k候选并放回序列重新编码得候选嵌入,以生成嵌入到最近候选的距离超过 $0.91\,\mathrm{nn}$ 判无效、top-1<0.6判不确定,统计得每序列142个不确定/109个无效。步骤三(蒸馏):全量OWT上冻结教师,学生编码后经教师解码器得 $\boldsymbol{p}^S$,逐位置与教师分布算KL并反向传播,词表截断top-256。步骤四(主实验):学生嵌入替换教师,在OWT-1024与LM1B上训练ELF-B/ELF-M,扫描自条件系数与NFE,GPT-2分词器重分词,报告不低于真实文本熵的最优Gen. PPL,每组3种子×1024样本。
技术新颖性
技术新颖性体现在四个层面。第一,问题定义新颖:首次把『可扩散性』作为文本嵌入的独立属性提出,并给出可操作的量化判据($0.91\,\mathrm{nn}$ 距离阈值、top-1=0.6不确定阈值,两者均由真实文本参照推导——真实嵌入解码top-1≥0.98、最近邻距离恰为 $1\,\mathrm{nn}$),将嵌入误差与生成语法错误一一对应可视化。第二,机制解释新颖:把连续DLM的失败模式与最优去噪器是候选加权平均这一数学事实联系起来,说明分离的离散目标天然对连续扩散不利。第三,方法新颖:软标签蒸馏改变嵌入几何而非模型容量——学生从9层初始化且容量减半仍优于教师,排除『小模型更平滑』的解释;CE和MSE两个替代目标的消融证明解码概率这一监督信号不可或缺。第四,发现新颖:证明判别性表示学习与可扩散性存在系统性张力(缩放提升可扩散性但ModernBERT反例说明不总是;蒸馏进一步提升可扩散性但SST-2下降9分),为『为生成设计嵌入』提供了明确的设计原则。
实验结果
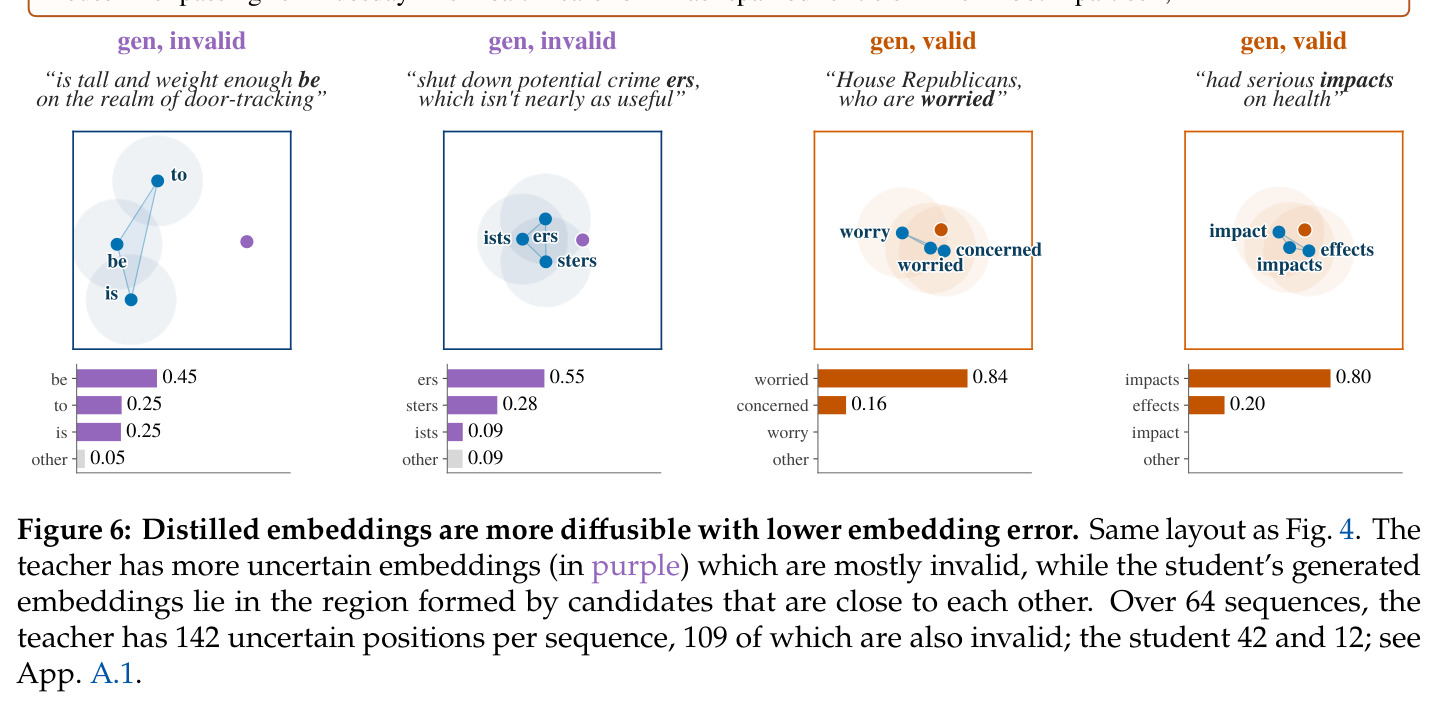
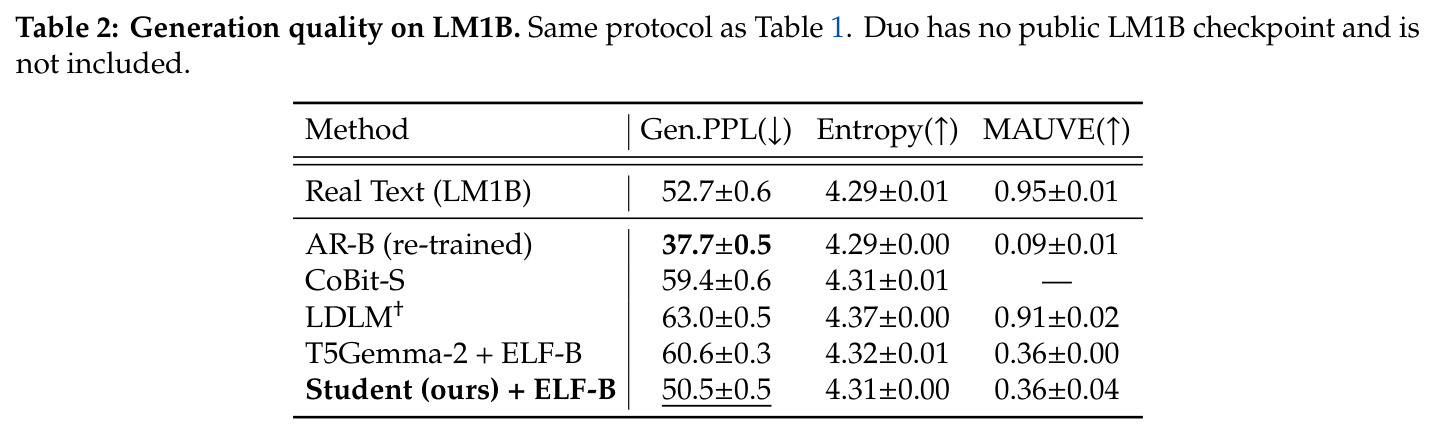
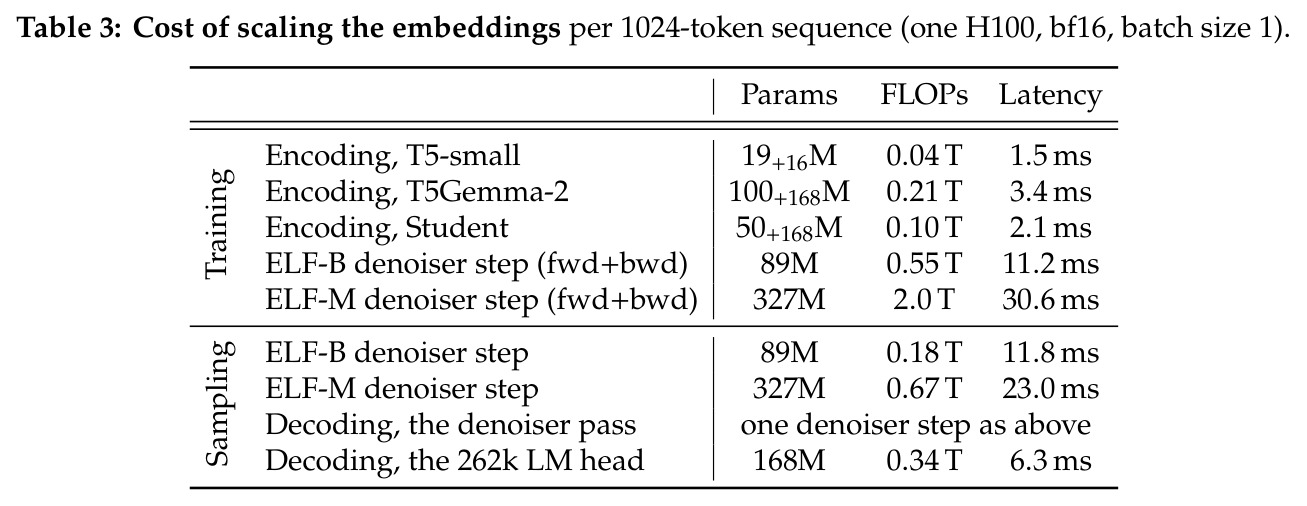
发现一(缩放有效):ELF-B随嵌入缩放(T5-small→T5Gemma-2)单调提升,后者是唯一达到真实文本熵5.43的嵌入,同熵下Gen. PPL比T5-small低约40%;ModernBERT判别强却生成重复句,可见判别强≠可扩散。发现二(强嵌入仍会失败):NFE 32下每条1024词序列平均142个不确定位置、其中109个无效,样本PPL 35.9(真实15.4)。发现三(蒸馏修复):学生把不确定/无效降到42/12个;OWT-1024上Student+ELF-M达Gen. PPL 17.8±0.1、熵5.45,超过教师19.3和GPT-2-M的20.8,逼近真实15.4。Base档Student+ELF-B为31.2±0.2,优于教师38.5和GPT-2-S的34.1。发现四(泛化):LM1B上Student+ELF-B为50.5±0.5,优于教师60.6,低于真实文本52.7;学生各NFE均优于教师且低NFE不塌缩缩放几乎免费:编码每1024词仅0.10–0.21 TFLOPs,远小于去噪单步2.0T;ELF-M生成1024词仅1.5秒,GPT-2-M需10.7秒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OpenWebText 1024词无约束文本生成(Medium规模) | Gen. PPL (GPT-2-Large, 熵≥真实文本) | 17.8±0.1(熵5.45,MAUVE 0.89) | GPT-2-M (AR) 20.8±0.3;T5Gemma-2+ELF-M 19.3±0.2;真实文本15.4±0.3 | 比GPT-2-M降低约14.4%,比教师嵌入ELF-M降低7.8% |
| OpenWebText 1024词无约束文本生成(Base规模) | Gen. PPL (GPT-2-Large, 熵≥真实文本) | 31.2±0.2(熵5.44,MAUVE 0.86) | T5Gemma-2+ELF-B 38.5±0.5;GPT-2-S (AR) 34.1±0.8;Duo 45.6±0.5 | 比教师降低18.9%,首次在Base档超过AR基线GPT-2-S |
| 嵌入缩放消融(OWT-512,同一ELF-B) | 同熵下 Gen. PPL 相对降幅 | T5Gemma-2 达真实文本熵5.43,同熵PPL较T5-small低约40% | T5-small+ELF-B(ELF原始配置,OWT-1024上PPL 52.1±3.2、熵仅5.31) | 约40%,且T5Gemma-2是唯一达到真实文本熵的嵌入 |
| 生成嵌入有效性分析(NFE 32,64条1024词序列) | 每序列不确定/无效嵌入位置数 | 学生:42个不确定、12个无效 | T5Gemma-2教师:142个不确定、109个无效 | 无效嵌入减少约89% |
| LM1B 128词文本生成(几何泛化检查) | Gen. PPL (GPT-2-Large) | Student+ELF-B 50.5±0.5(熵4.31,MAUVE 0.36) | T5Gemma-2+ELF-B 60.6±0.3;LDLM 63.0±0.5;CoBit-S 59.4±0.6;真实文本52.7±0.6 | 比教师降低16.7%,证明提升来自嵌入几何而非OWT数据熟悉度 |
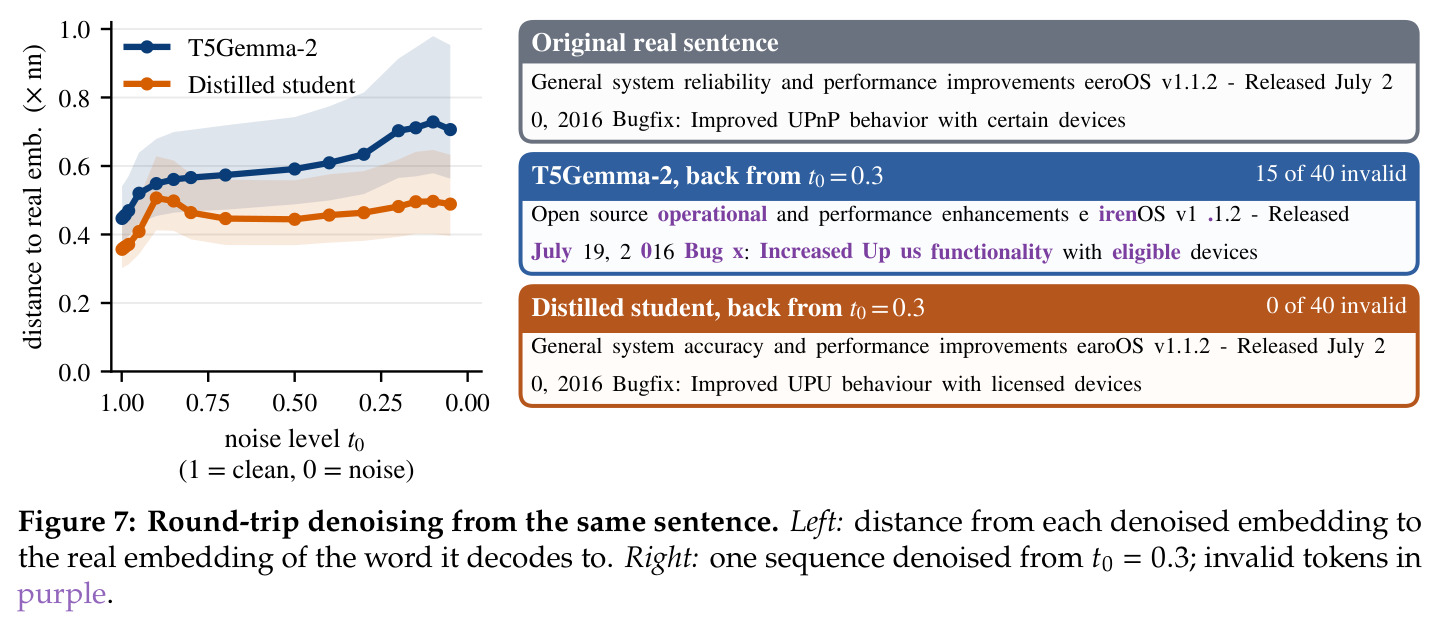
| 往返去噪鲁棒性($t_0=0.3$,40词序列) | 无效token数 | 学生0/40无效,恢复出 'General system accuracy and performance improvements' | 教师15/40无效,恢复文本出现 'irenOS'、'Bug x'、'Up us' 等损坏词 | 同噪声下无效token从15降到0 |
| 判别能力保留检查(SST-2分类) | 分类准确率 | 78.1 | T5Gemma-2教师 89.4 | 下降11.3分——蒸馏用判别力换可扩散性的代价(作者有意展示) |
局限与改进
作者承认的局限:缩放实验只做到270M级编码器,1B/4B留待未来;预训练编码器见过的文本远多于OWT训练的基线,跨编码器行并非完全受控,严格受控的只有T5Gemma-2对学生一组;蒸馏牺牲判别力(SST-2从89.4降到78.1);连续DLM在实用规模(如问答)上的可行性未验证,且原始T5Gemma-2嵌入下ELF低NFE(16–64)欠积分塌缩,少步生成仍是开放问题。我的观察:其一,判据阈值($0.91\,\mathrm{nn}$、top-1=0.6)虽由真实文本参照推导且作者称不敏感,但依赖特定教师的解码头分布,换嵌入家族是否适用缺乏证据;其二,主结果是在自条件系数×NFE全网格扫描后取最优,开销大且可能高估开箱即用性;其三,MAUVE本身对协议敏感,Base档教师仅0.76与学生的差距解读需谨慎;其四,词表截断到top-256对效果的影响只有附录级消融支撑。
独立分析的弱点
弱点一:判别-生成权衡无量化调节手段。蒸馏一旦做,SST-2就从89.4掉到78.1,但论文没提供温度、KL权重等旋钮让使用者插值;可引入可调软标签温度 $\tau$ 或按token置信度加权KL,显式选择工作点。弱点二:有效性判据与教师解耦不足。$0.91\,\mathrm{nn}$ 和0.6阈值都从T5Gemma-2解码分布推导,而论文自己显示不同嵌入几何差异巨大(ModernBERT生成重复句),换嵌入后判据可能失效;可用与模型无关的密度判据替代固定距离阈值。弱点三:缺乏算力匹配的受控缩放验证,40%提升中无法完全剥离预训练数据量的成分;可构造同算力预训练的小模型族做严格缩放律实验。弱点四:低NFE塌缩只是被缓解而非解决,学生『更稳』但未给出极限NFE下界;可结合一致性蒸馏直接攻少步生成。弱点五:只在英文语料验证,多语言或代码等候选分布更散的场景下软标签连通化效果未知,应补跨语言实验。
未来方向
作者在结论中列出的开放方向:一是少步/一步生成——ELF在原始T5Gemma-2嵌入下低NFE欠积分,而蒸馏后采样更稳,这正是蒸馏采样器或一致性蒸馏的切入点;二是实用规模任务(如问答)上的验证,把无约束生成之外的下游能力补齐;三是把现有AR基础模型直接适配为DLM嵌入——T5Gemma-2本就是从Gemma-3改编而来,理想流程应跳过中间步骤。基于成果可延伸的方向:把『软标签连通化』思想搬到图像扩散的RAE类方法上(用生成头而非判别头做蒸馏目标,检验跨模态普适性);探索嵌入缩放律,回答T5Gemma-2-1B/4B能带来多少进一步提升;把有效性判据发展成嵌入模型的标准评测维度,推动社区在训练嵌入模型时同时报告可扩散性;以及尝试在蒸馏目标中加入对比项,用单个可调参数在判别力与可扩散性之间显式权衡,弥补SST-2下降11.3分的代价。
复现评估
复现条件较好。代码基于公开的ELF-pytorch实现,本文只改嵌入模型、保持训练与采样配方(附录B.1),蒸馏细节在B.2,评测协议与表格行选取规则在B.3,首页提供Code和Project page链接,基线用原作者代码与checkpoint复跑或引用。数据全部公开(OpenWebText、LM1B、WikiText-103),模型全部公开(T5Gemma-2、T5-small、ModernBERT),生成样本在附录C可对照。算力门槛不高:ELF-B去噪器89M+168M头、ELF-M为327M+168M,H100单卡bf16批量1下ELF-B去噪器单步0.18 TFLOPs/11.8ms、ELF-M 0.67T/23.0ms,编码每1024词仅1.5–3.4ms且可缓存,蒸馏只需冻结教师前向加学生训练;但完整复现表格需在自条件1/2/3×NFE 64–512网格上扫描、每配置3种子×1024样本并用GPT-2-Large打分,单卡复现单个主结果可行,全套网格需多卡。复现时还需按附录从真实文本参照重新校准有效性阈值。
论文图表
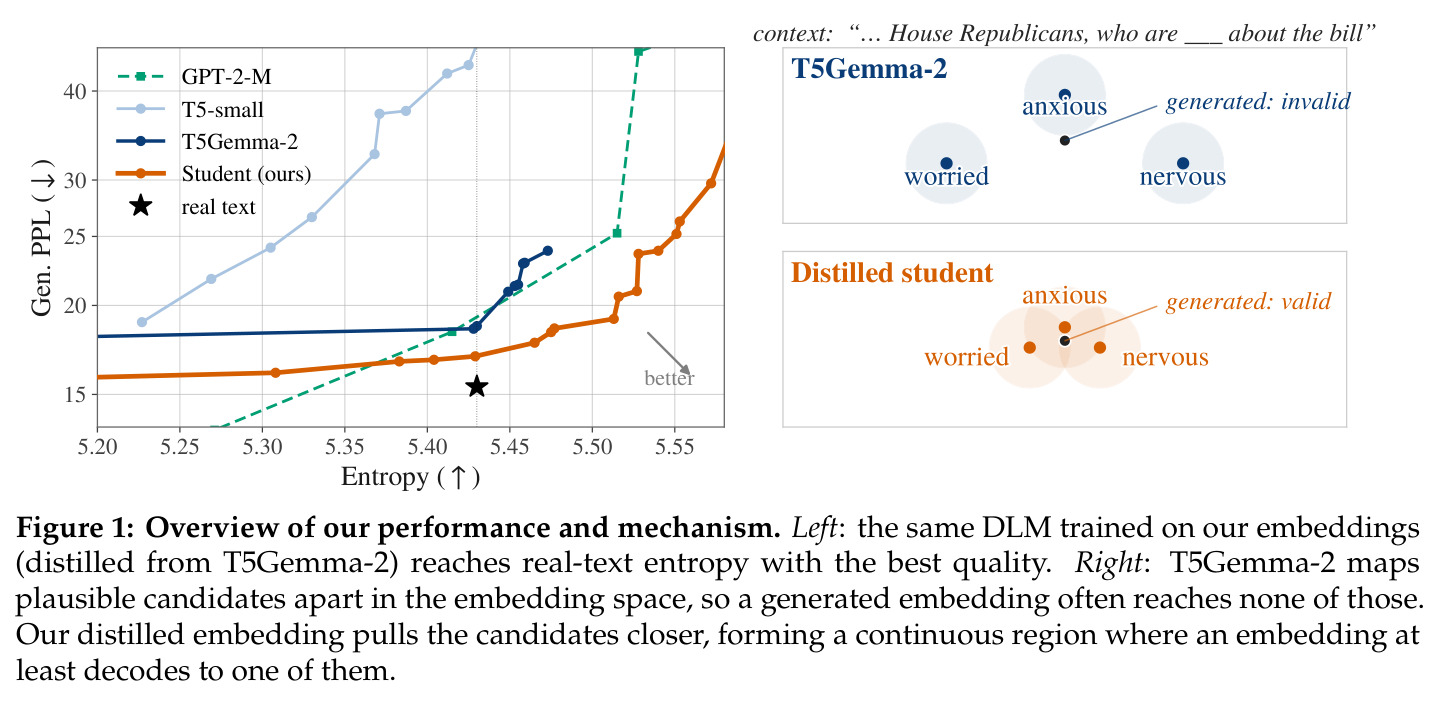
左图:同一DLM分别用T5-small、T5Gemma-2和本文蒸馏学生嵌入训练后的Gen. PPL-熵曲线,学生曲线在真实文本(real text)参考点附近达到最优;右图:机制示意,T5Gemma-2把同位置的合理候选词在嵌入空间里分得很开,生成嵌入落在谁都不是的位置(invalid),而蒸馏后的学生把候选拉近,形成连续区域,生成嵌入至少能解码回其中之一。
这张图一页讲完全文:左半是性能结论(学生最优),右半是机制解释(候选分离导致无效嵌入、软标签蒸馏连通候选),是向他人介绍这篇论文时最先应该展示的图。
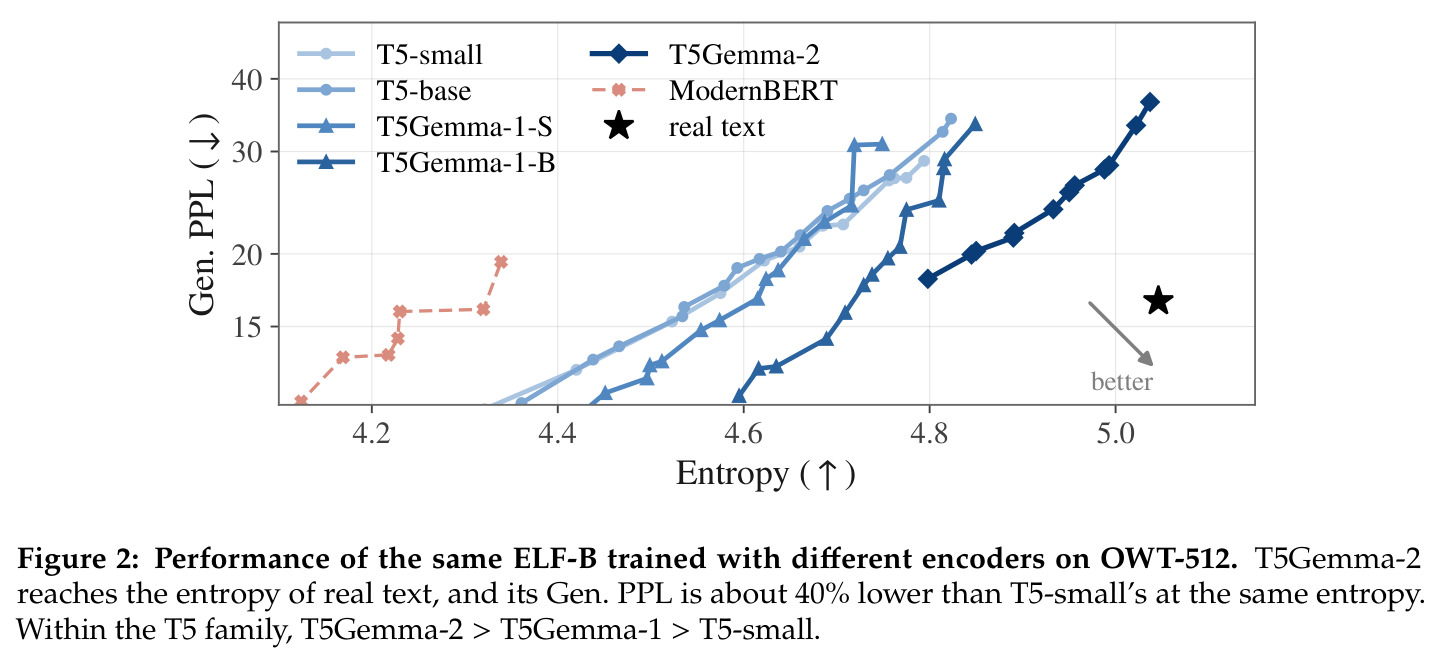
固定ELF-B扩散框架,仅更换编码器(T5-small、T5-base、T5Gemma-1-S、T5Gemma-1-B、T5Gemma-2、ModernBERT)后的Gen. PPL-熵曲线族。T5Gemma-2是唯一到达真实文本熵5.43的嵌入,同熵下Gen. PPL比T5-small低约40%;排序为T5Gemma-2 > T5Gemma-1 > T5-small;ModernBERT虽判别强但生成重复句。
支撑『发现一:缩放嵌入提升可扩散性』的核心实验证据,同时包含ModernBERT这个反例,说明判别能力与可扩散性是两回事。
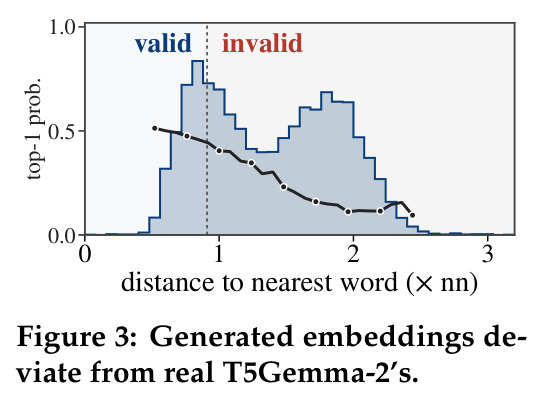
对64条生成序列统计『生成嵌入到最近候选词嵌入的距离』分布(横轴以中位最近邻距离nn为单位)与解码top-1概率。真实嵌入距离恰为1 nn、top-1≥0.98,分布呈双峰;相当比例的生成嵌入落在0.91 nn阈值之外(invalid)或top-1低于0.6(uncertain)。
给出可扩散性的量化判据(0.91 nn、top-1=0.6)及其推导依据,是把『嵌入失效』从轶事观察变成可度量问题的关键一步。