RPTune:面向 LLM 商品目录搜索的学习式上下文策展 RPTune: Learned Context Curation for LLM Catalog Search
学习式目录策展加 GRPO 后训练,让 LLM 商品搜索平均提升 14 分
前置知识
上下文内目录搜索(in-context catalog search)
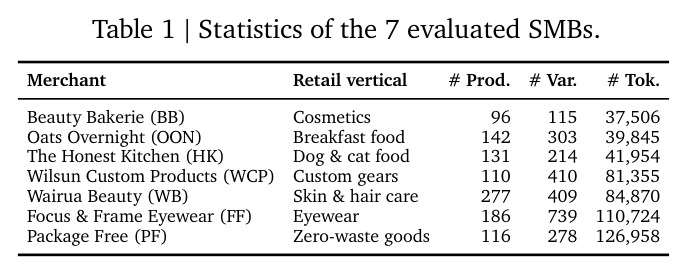
把商户整个商品目录(名称、描述、属性等元数据)直接放进 LLM 的上下文窗口,让模型通读全部候选后直接选出与查询最匹配的商品变体。与『召回-粗排-精排』的多阶段检索不同,它完全不需要独立检索器。论文统计了 56 个真实 Shopify 店铺:92.9% 的目录在 1M token 以内,中位数仅 51K token,现代长上下文 LLM 完全装得下。
这是全文的问题设定:RPTune 的策展与后训练都建立在『全目录可入上下文』这一前提上,理解它才能明白为什么需要学习式上下文策展而非传统 RAG。
Lost in the middle(位置敏感性)
Liu et al. (2023) 的发现:LLM 对长上下文的利用并不均匀,位于上下文中部的相关信息被模型使用的效果明显低于开头或结尾的信息。因此即便目录全部放进上下文,商品的排列顺序和保留哪些商品也会显著影响选择准确率。
这解释了『装得下』不等于『用得好』,也是 RPTune 重组器对商品做剪枝与定位(升序、U 形等布局消融)的直接理论依据。
MNRL 对比学习损失
Multiple Negatives Ranking Loss:对一个 batch 内的查询-正例商品对 $(q_i, c_i)$,最大化正对余弦相似度、压低同批其他商品充当负样本 $(q_i, c_j), j\neq i$ 的相似度,损失形如 $-\frac{1}{B}\sum_i \log \frac{\exp(\tilde{q}_i^\top\tilde{c}_i)}{\sum_j \exp(\tilde{q}_i^\top\tilde{c}_j)}$。编码器输出 L2 归一化嵌入并用它训练。
编码器是 RPTune 流水线的第一阶段,读懂优先级分数中的基础相似度项 $ ilde{q}^\top\tilde{c}_i$ 与编码器训练目标都离不开对比学习这一背景。
GRPO(组相对策略优化)
Group Relative Policy Optimization(Shao et al., 2024):对同一查询采样 $G$ 个回答,用组内奖励的均值 $\mu_q$ 和标准差 $\sigma_q$ 把奖励标准化为优势 $A_g=(r_g-\mu_q)/(\sigma_q+\epsilon)$,免去了价值网络。本文两处用到它:重组器训练的 LLM 反馈信号,以及 LLM 后训练本身。
重组器的 LLM-in-the-loop 训练和后训练的核心算法都是 GRPO 的变体,不理解组相对优势就无法读懂 Algorithm 1 与损失 Eq. 1。
EM 与 FR 评测指标
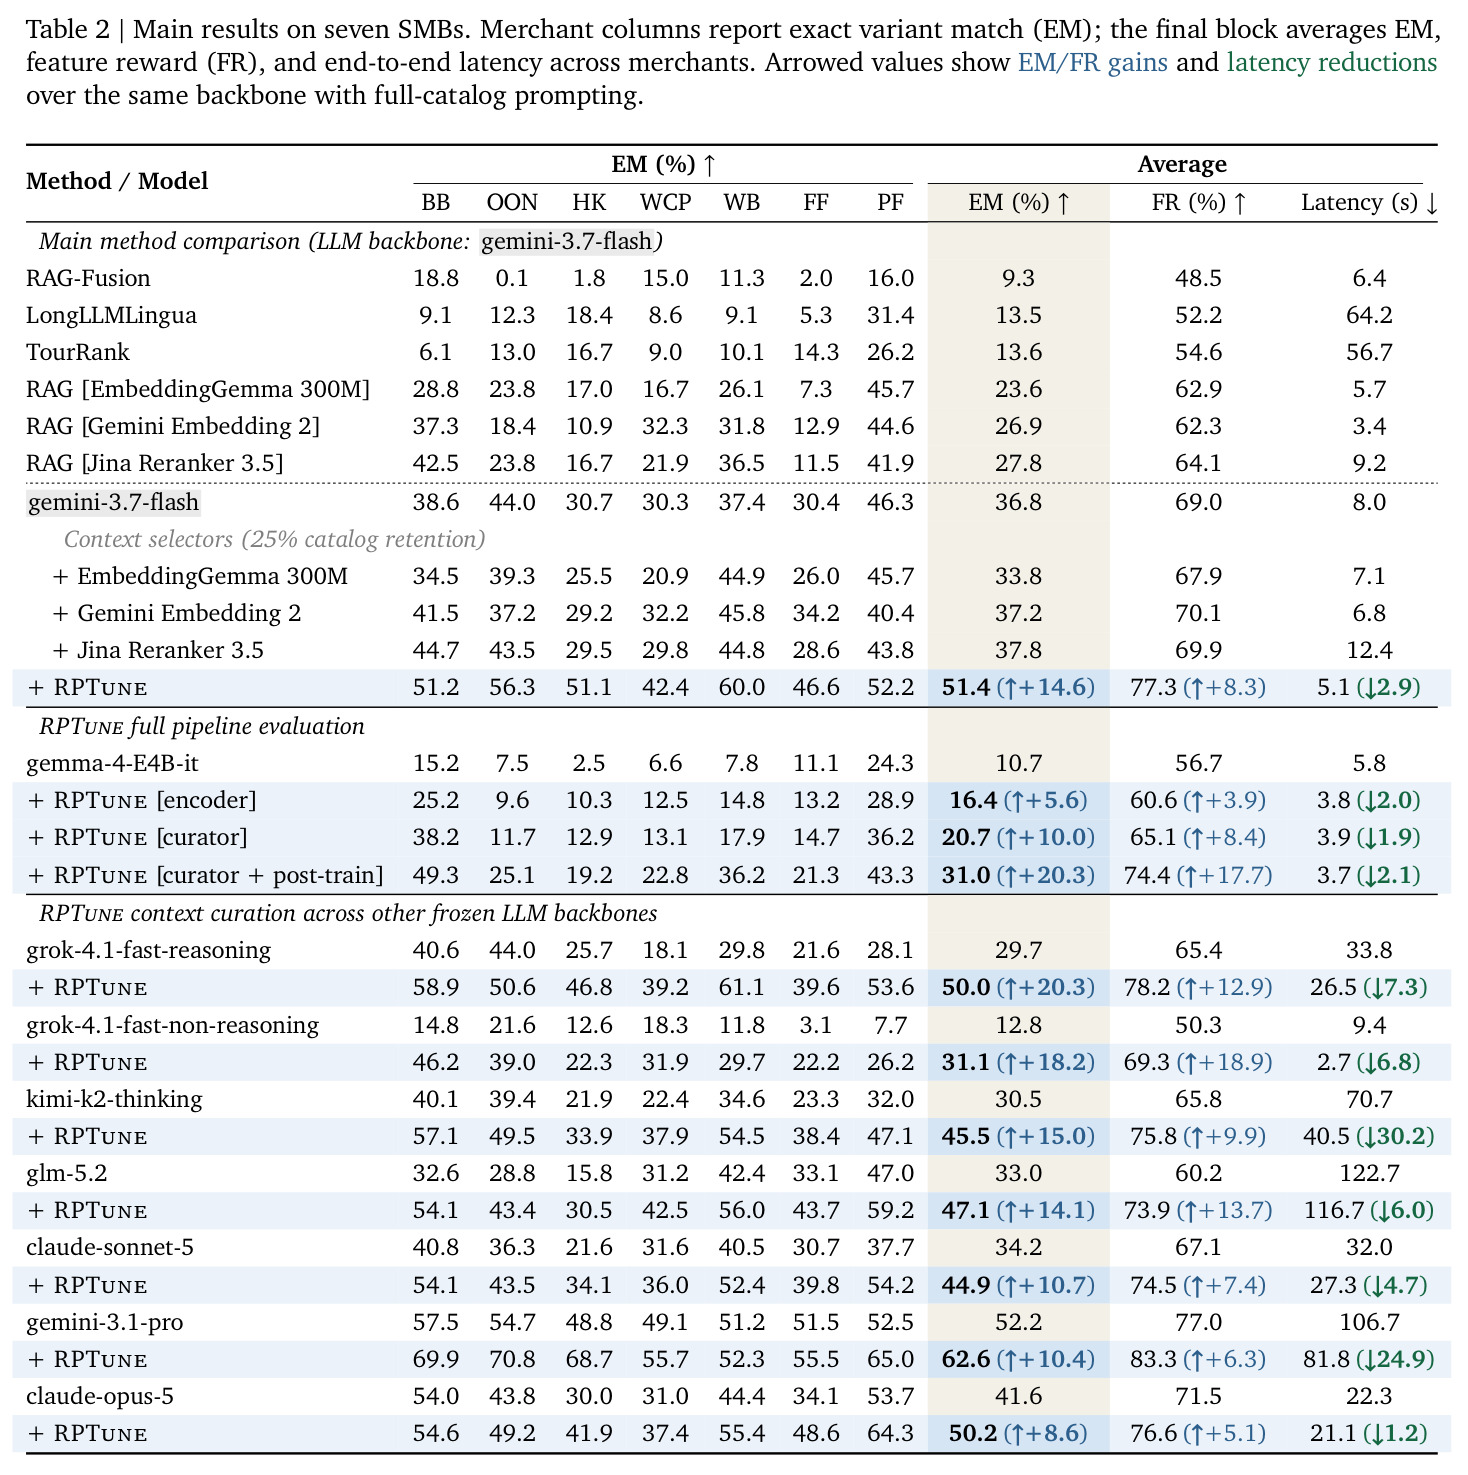
Exact Match(EM)要求模型输出的商品变体与人工标注的真值变体完全一致才算正确,是主指标;Feature Reward(FR)计算所选变体与真值变体在价格、颜色、规格等属性上的加权匹配百分比,用来衡量『部分正确』的程度(如选了对的色号但克重不符)。
论文所有核心数字(+14.6pp、+20.3pp 等)都以 EM/FR 表述,分清二者才能正确解读 Table 2 中逐商户的结果。
合成监督数据
不用商户提供的相关性标签或用户行为日志,而是用 frontier LLM(gemini-3.1-pro)为每个商品变体生成 10 条一两句话的多样化搜索查询,再对每条查询给全目录所有商品打 $[0,1]$ 的分级相关性分,打分时每次处理 10 个变体并附带已打分词典以保证全局一致性。
RPTune 的全部训练信号都来自合成数据,理解其生成与打分机制是评估方法可信度、以及判断能否复现的前提。
研究动机
电商商品搜索长期依赖为百万级商品大平台设计的多阶段检索流水线(向量/词法召回 + 重排 + 精排),它默认商户拥有专门机器学习团队和海量用户行为信号。但 Shopify 上活跃着超过 300 万家小微商户(SMB),这些假设完全不成立,传统流水线对它们来说过于复杂昂贵。作者分析了 56 个真实 Shopify 店铺,发现 92.9% 的商品目录能放进 1M token 窗口、中位目录仅 51K token——现代长上下文 LLM 完全可以直接『读完整目录再选品』,实测比既有检索式方法最高提升 20 个百分点。然而全目录提示远非最优:LLM 对长上下文利用不均匀(中部信息被弱化),目录中大量无关商品构成噪声,面对颜色、持久度、素食认证、重量、价格等多条件交织的复杂对话式查询,准确率仍然很低——例如开源小模型 gemma-4-E4B-it 平均 EM 只有 10.7%,非推理版 grok-4.1-fast 也仅 12.8%。
本文的目标是本文把『上下文内目录搜索』拆成两个互补问题来系统研究:其一,如何为 LLM 精选与编排商品目录——学习一个策展器对目录做排序、剪枝与位置安排,构造紧凑且位置感知的上下文;其二,如何让下游 LLM 适应精选后的上下文以更好地完成商品选择。整个流程有一个关键约束:只用商品目录本身作为数据源,通过 frontier LLM 自动合成查询和全目录分级相关性标注,不依赖商户提供的相关性标签或用户行为日志,从而对任意 SMB 开箱即用。最终目标是在 7 个真实商户、700 条复杂对话式查询上,同时提升 9 个专有与开源 LLM 骨干的精确匹配准确率(EM)、特征奖励(FR),并降低端到端延迟。
与已有工作不同的是,已有工作把『给 LLM 喂哪些候选』当作通用检索/重排问题:用与下游模型无关的目标训练检索器(EmbeddingGemma、Gemini Embedding、Jina Reranker),或用查询压缩与上下文重排(LongLLMLingua、TourRank)提升信息密度。RPTune 的独特切入是让上下文策展对齐下游 LLM 的实际行为:重组器通过 LLM-in-the-loop 强化学习,用冻结 LLM 在精选上下文上的真实采样选择作为反馈来学习打分与排序,而不是拟合静态相关性标签;同时后训练采用『上下文相对』奖励——只要求模型选中精选上下文内的最优商品而非全目录最优,这样即使策展剪掉了全局最佳商品,模型选最佳替代品仍能获得正向学习信号。策展与适配由此形成互相增强的闭环,且训练与推理使用同一套策展上下文。
核心方法
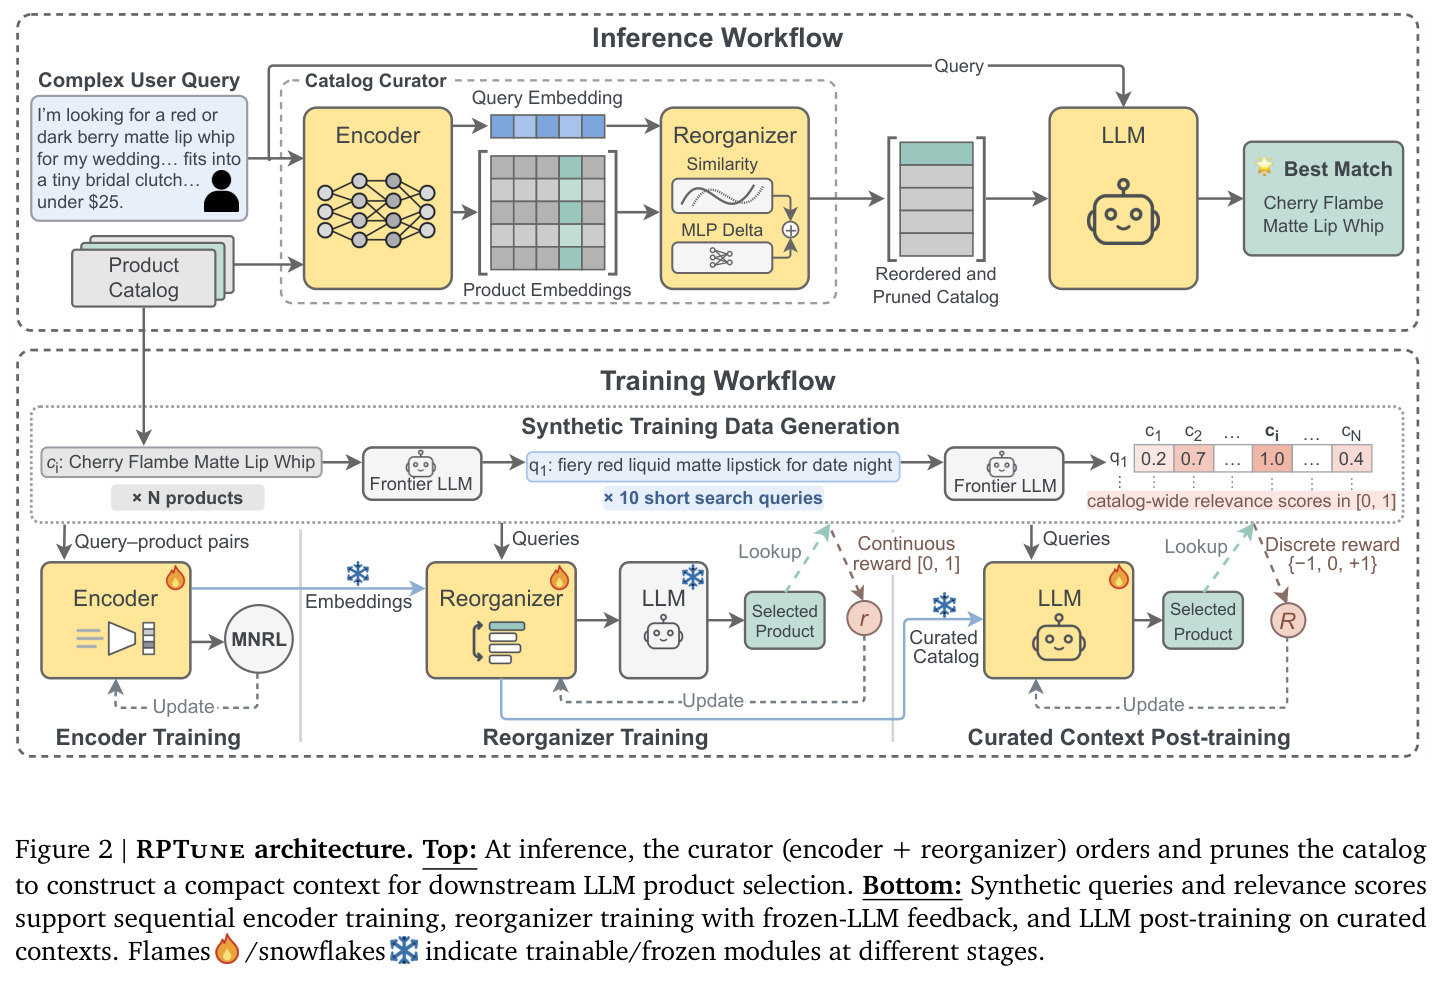
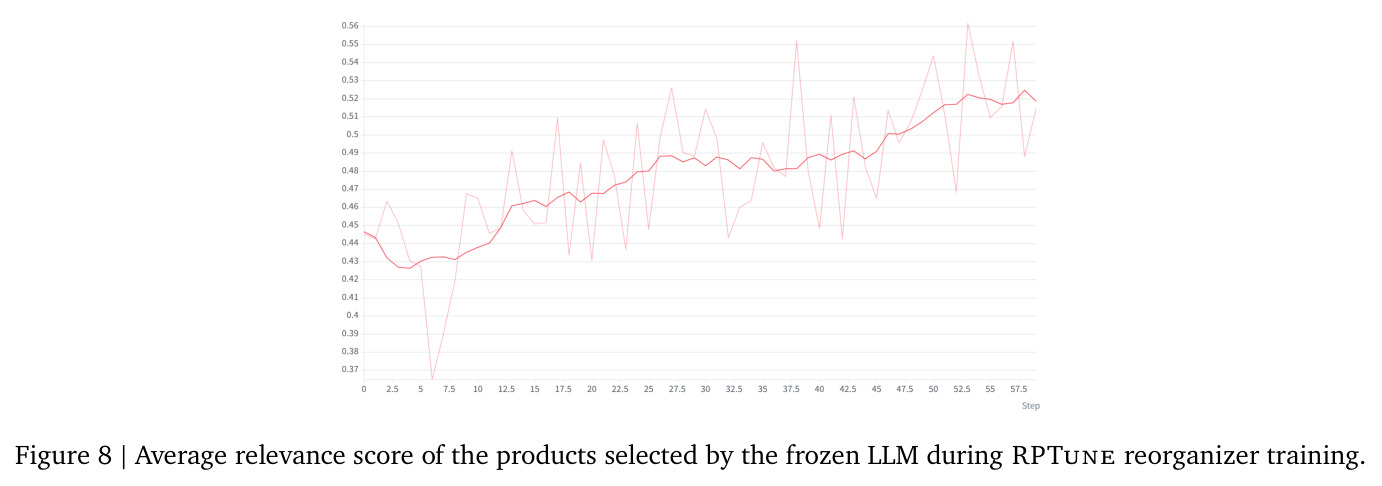
RPTune(Rank, Prune, and Finetune)由一个目录策展器加一个下游 LLM 组成。策展器包含编码器与重组器:编码器把查询和每个商品变体映射为 L2 归一化稠密嵌入;重组器为每个商品计算上下文优先级分数 $s_i=\tau\cdot(\tilde{q}^\top\tilde{c}_i)+\text{MLP}([\tilde{q};\tilde{c}_i])$(基础相似度加可学习调整项,$\tau=10$),保留得分最高的 $k=\lceil(1-\rho)n\rceil$ 个商品(默认剪枝率对应保留 25%),并按优先级升序排列,把高分商品放在离生成位置更近的地方。系统按三阶段串行训练,每阶段只更新目标模块、其余冻结:先训编码器,再用冻结 LLM 的反馈以强化学习训重组器,最后冻结策展器、用 GRPO 后训练 LLM。全部训练数据由 frontier LLM 基于目录自动合成,推理时一次前向即可完成编码、打分、剪枝、排序与选品。
核心创新有三。其一,重组器的训练信号不是静态相关性标签,而是冻结 LLM 在当前精选上下文上的真实采样选择:每个查询让 LLM 采 $G$ 个单商品选择,按 GRPO 组内标准化得到优势 $A_g$,再经目录级 softmax 分布 $w_\theta(c_i|q)=\exp(s_i/\beta)/\sum_j\exp(s_j/\beta)$ 这个可微桥梁转化为重组器分数的梯度(最小化 $\mathcal{L}=-\frac{1}{B}\sum_q\sum_{g\in V_q}A_g\log w_\theta(a_g|q)$),正优势抬高被选商品的分数、负优势压低,分数进而决定下一轮上下文的剪枝与排列。其二,后训练使用上下文相对奖励:$R=1$ 当预测是精选上下文 $\tilde{C}^q$ 内相关性最高者,$R=-1$ 当预测不在 $\tilde{C}^q$(惩罚幻觉),否则 $R=0$。其三,商品按优先级升序排列,主动利用 LLM 的位置敏感性,让最相关商品靠近生成端。
方法步骤详情
第一步,合成训练数据:对每个商品变体用 gemini-3.1-pro 生成 10 条多样化搜索查询得到配对集 $D^{pair}$;再让 LLM 每次对 10 个变体、附带已打分词典,为每条查询给全目录商品赋 $[0,1]$ 分级相关性,得到密集分布 $D^{rel}$。第二步,编码器训练:用批内负例的 MNRL 对比损失最大化正对相似度。第三步,重组器训练(Algorithm 1):MLP 输出层零初始化以保持编码器排序为起点;每步采一批查询,构造精选上下文,冻结 LLM 非零温度采样 $G$ 个选择,从 $D^{rel}$ 查表取奖励(输出不在目录记 $-1$),组内标准化为优势,仅更新 $\theta$,无效 rollout 计入组统计但不进损失。第四步,LLM 后训练:冻结策展器,在其构造的 $\tilde{C}^q$ 上用 GRPO 采 $G$ 个回答,以上下文相对奖励 $R\in\{-1,0,+1\}$ 优化选品行为。评测查询经三阶段合成流水线生成并经人类专家审计(9.6% 拒绝率)。
技术新颖性
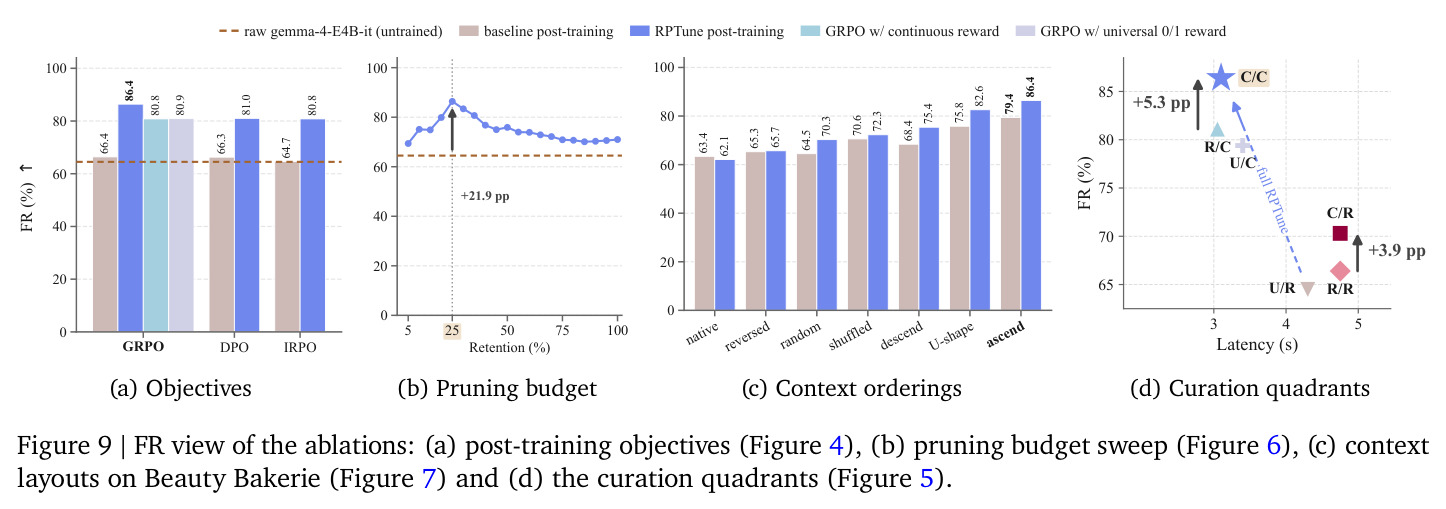
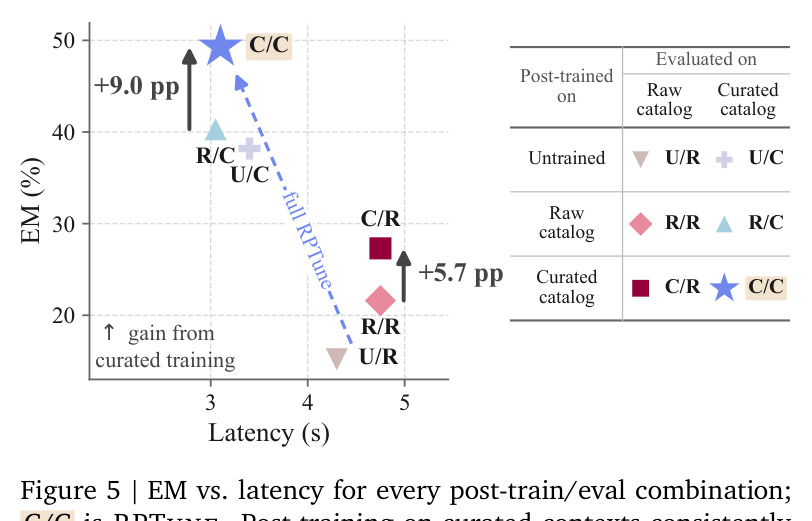
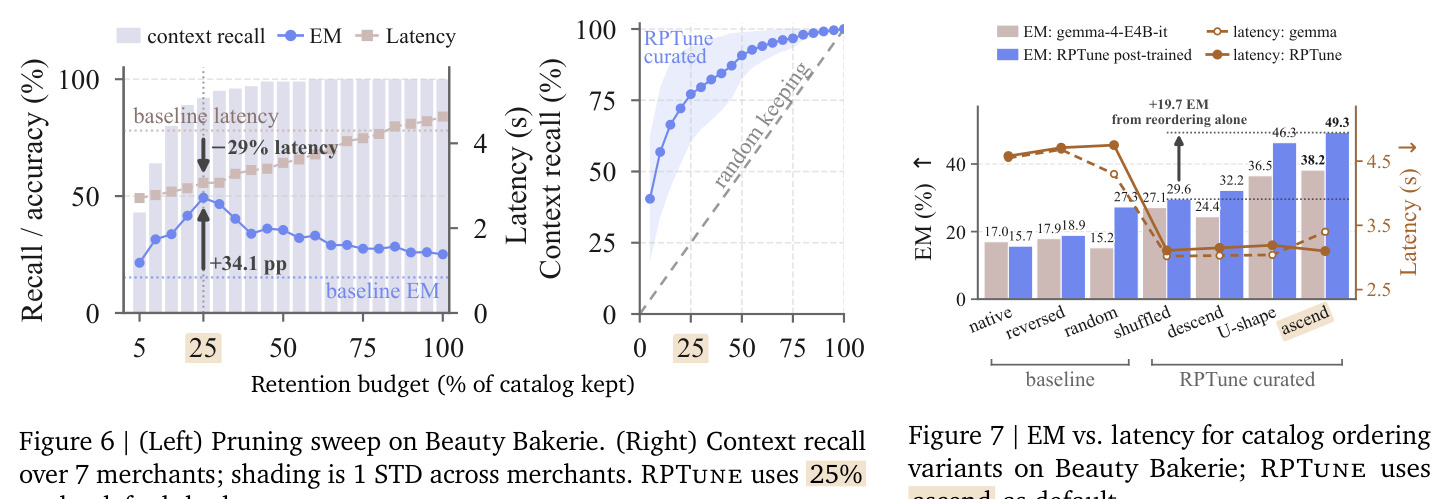
与 off-the-shelf 检索器/重排器的本质区别在训练信号与目标对齐:在完全相同的 25% 保留预算下,把 RPTune 换成 EmbeddingGemma 300M、Gemini Embedding 2 或 Jina Reranker 3.5 作上下文选择器,会在 7 个商户中分别造成多个商户准确率下降(Jina 在 5 个商户退化、Gemini Embedding 在 3 个退化),而 RPTune 让全部 7 个商户提升——收益来自『为 LLM 的解释方式定制上下文』而非单纯剪枝。消融进一步验证:把 LLM-in-the-loop 目标换成直接拟合相关性标签的监督式列表交叉熵,平均 EM 只有 16.4%、与仅用编码器相当,比 RPTune 重组器(20.7%)低 4.3 点且在 7 个商户上全部更差;把上下文相对奖励换成连续奖励或全局 top-1 奖励,Beauty Bakerie 上 EM 掉 10 点;升序排列优于降序、U 形与随机打乱(重排本身贡献 +19.7 EM)。零初始化 MLP、GRPO 组相对优势、策展上下文上训练(C/C 组合)等设计各有对应消融支撑。
实验结果
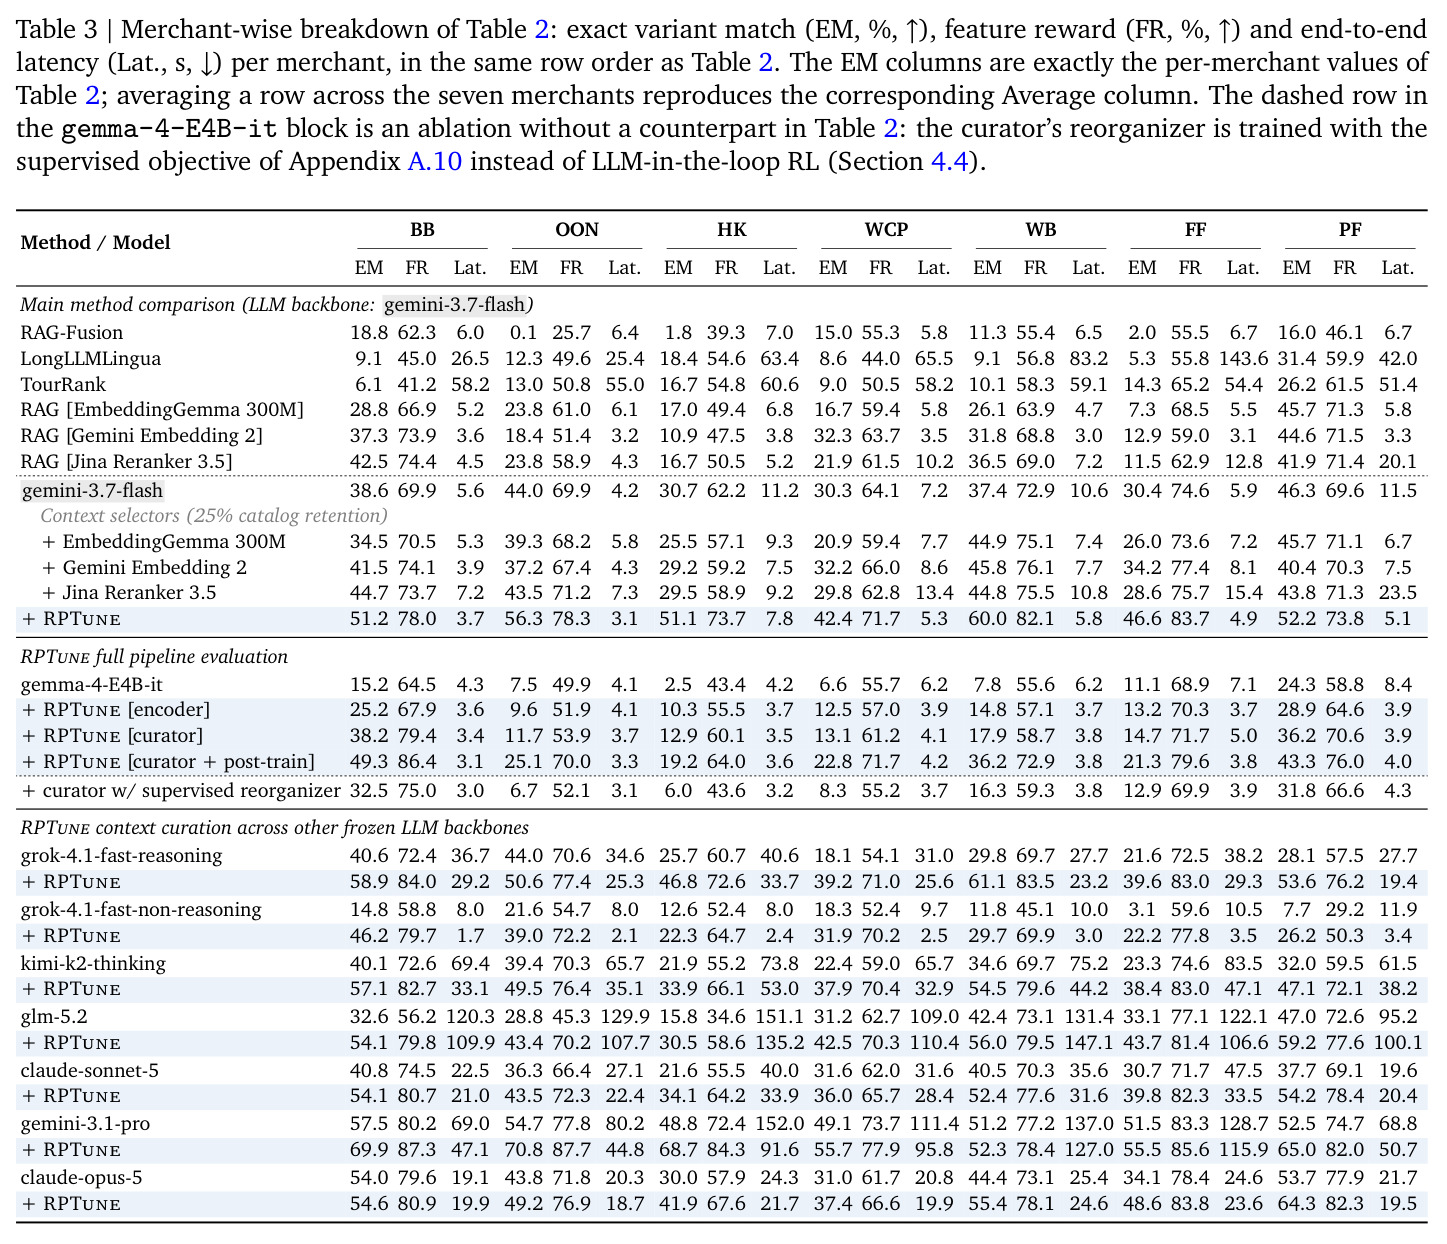
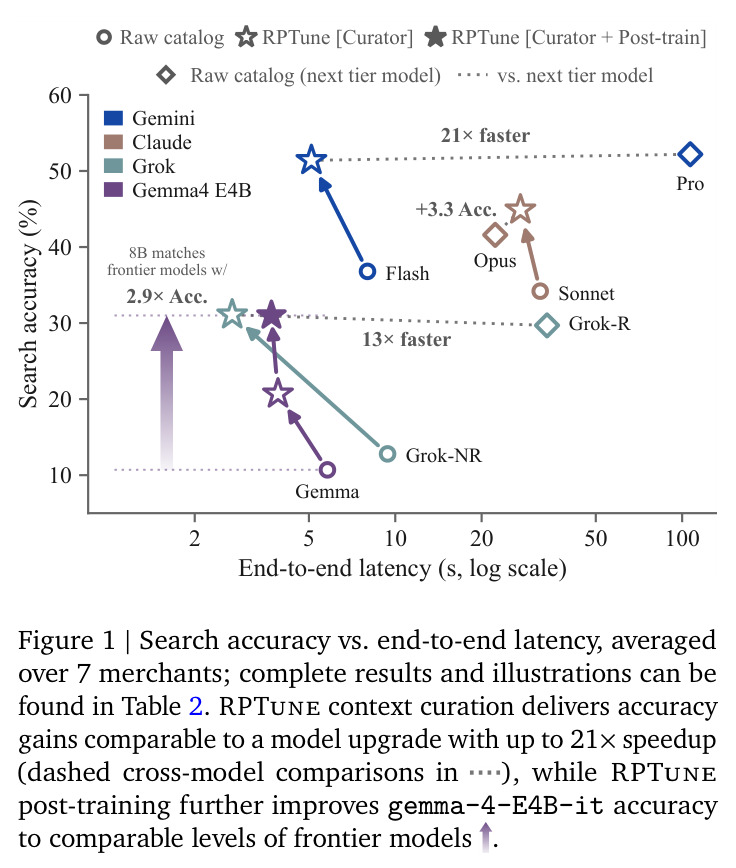
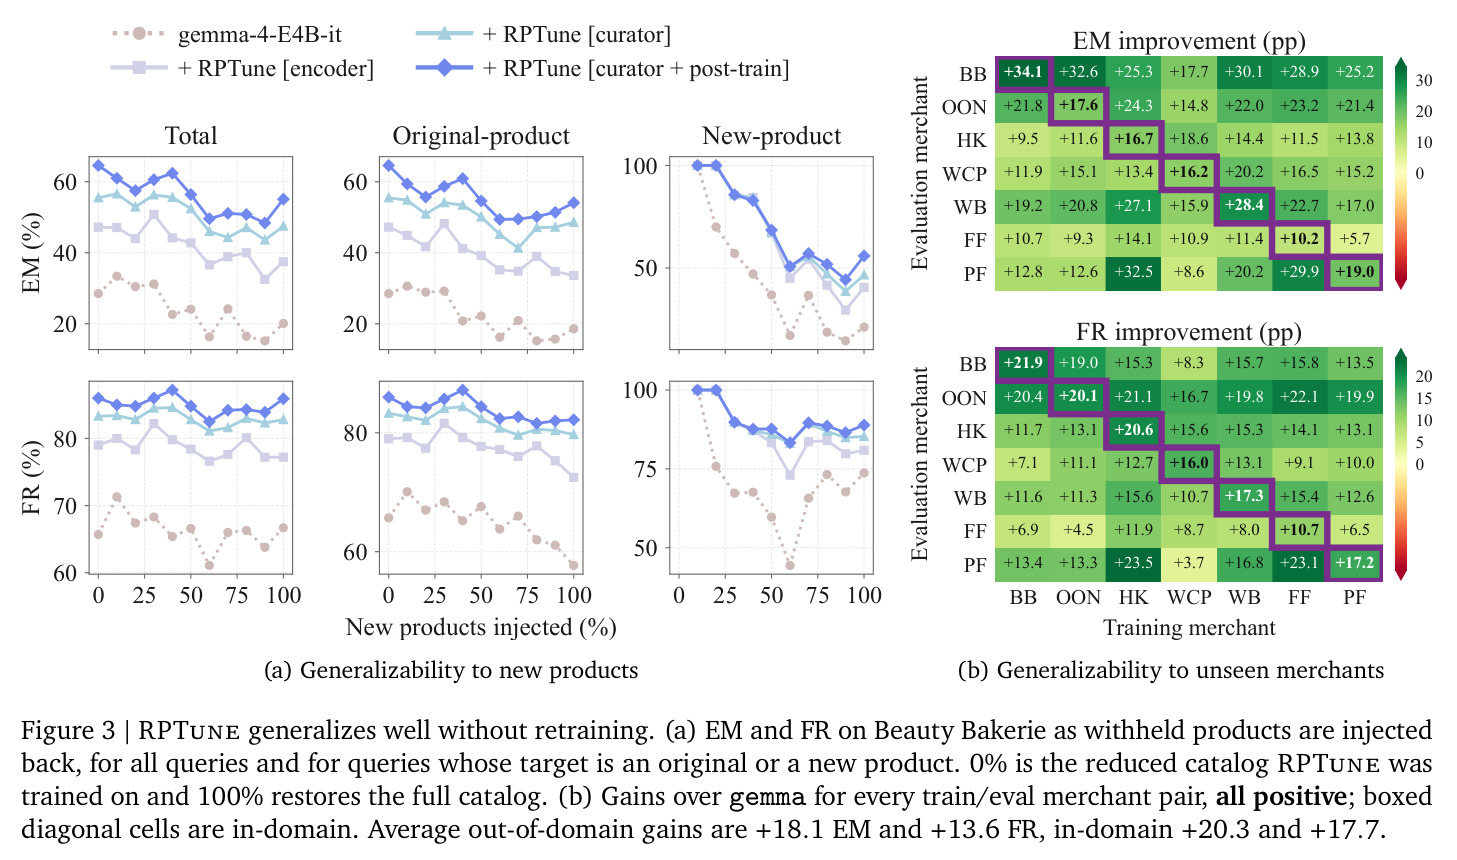
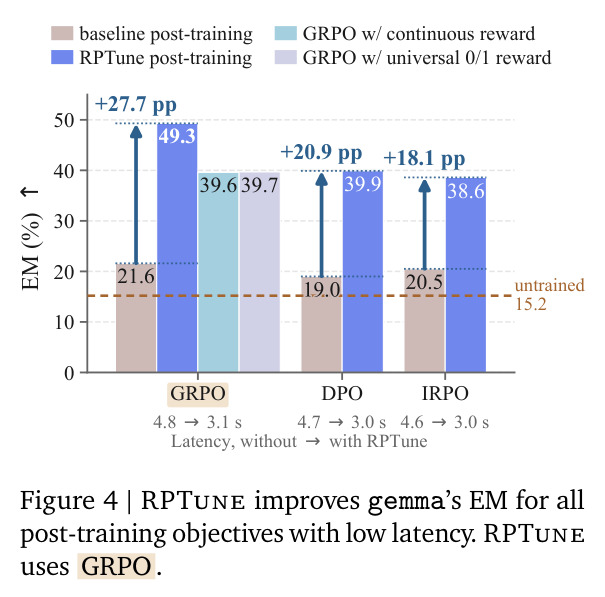
RQ1(全目录提示可行性):以 gemini-3.7-flash 为共同骨干,全目录提示平均 EM 36.8%、FR 69.0%、延迟 8.0s,比所有检索式基线至少高 9.0 个 EM 点(最佳基线 RAG+Jina Reranker 3.5 仅 27.8%)。RQ2(策展收益):在 9 个冻结骨干上策展平均提升 13.5 个 EM 点、10.1 个 FR 点,9×7=63 个骨干-商户组合全部提升;grok-4.1-fast-non-reasoning 的 EM 从 12.8% 翻倍到 31.1%;9 个 LLM 的端到端延迟平均下降 28%(最高 71%)。Figure 1 显示策展让 gemini-3.7-flash 追平下一档模型精度且最多快 21 倍。RQ3(后训练增量):gemma-4-E4B-it 从 10.7%(原始)→16.4%(仅编码器)→20.7%(完整策展器)→31.0%(加 GRPO 后训练),全流程 +20.3 个 EM 点、+17.7 个 FR 点,七个商户每一阶段单调提升。RQ4(泛化):目录翻倍时后训练 RPTune 相对 EM 仅降 14.7%(基线降 29.5%),双倍目录下仍领先 35.0 EM、19.2 FR;7×7 跨商户迁移全部正增益,域外平均 +18.1 EM、+13.6 FR。案例:Q1 中真值 Cherry Flambé(15g)保留在第 8 位,grok-4.1-fast-reasoning EM 0%→100%,gemma 0%→70%→100%(后训练后)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 7 个 SMB 平均商品选择(骨干 gemini-3.7-flash,25% 保留) | Exact Match (EM) / Feature Reward (FR) | RPTune 策展:EM 51.4%,FR 77.3%,延迟 5.1s | 全目录提示 EM 36.8%;最佳 RAG 基线(Jina Reranker 3.5)EM 27.8% | 较全目录 +14.6pp EM、+8.3pp FR、延迟降 2.9s;较最佳 RAG +23.6pp |
| 开源小模型全流程(gemma-4-E4B-it) | EM | 31.0%(策展 + GRPO 后训练) | 原始 gemma-4-E4B-it 10.7% | +20.3pp(其中策展 +10.0pp、后训练再 +10.3pp),FR +17.7pp |
| 弱模型策展收益(grok-4.1-fast-non-reasoning) | EM | 31.1% | 原始 12.8% | +18.3pp(EM 翻倍以上),延迟 9.4s→2.7s |
| 25% 保留率下的上下文召回(7 商户平均) | Context Recall | 77.1%(50% 保留达 90.7%) | 随机选择(约 25% 水平,RPTune 超其 3 倍以上) | 召回超随机 3 倍,且所有保留率下准确率均高于全目录基线 |
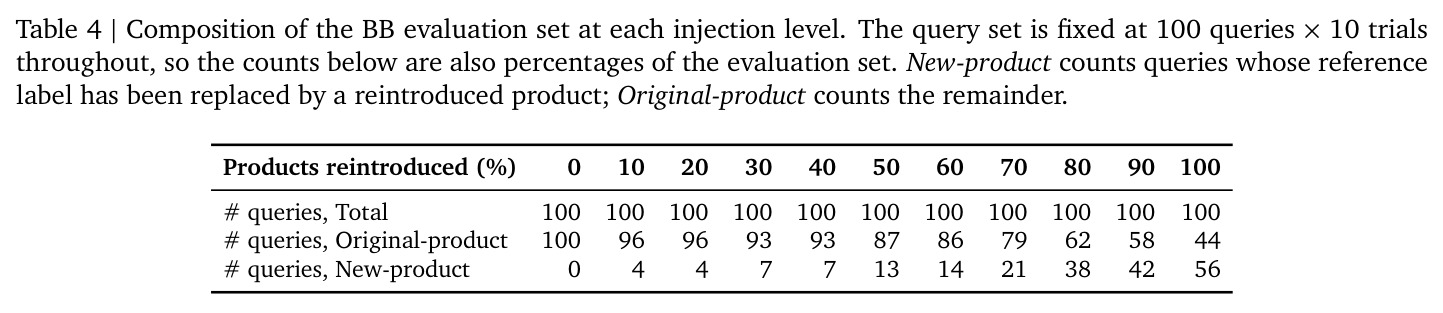
| 目录翻倍泛化(Beauty Bakerie 注入实验) | 相对 EM 下降 | 后训练 RPTune 仅降 14.7%,FR 几乎不变 | 基线相对下降 29.5% | 退化幅度减半,双倍目录下绝对领先 +35.0 EM / +19.2 FR |
局限与改进
作者设定中隐含的局限:评估只覆盖 7 个美国垂直零售商户,目录最大 127K token,未验证更大目录或其他类目;评测查询虽经三阶段合成加人工审计(9.6% 拒绝率),但本质仍是合成数据,且任务限定单轮、单一最佳变体选择,未涉及多轮对话、多品推荐与库存约束;25% 保留率下上下文召回仅 77.1%,约四分之一查询的真值商品根本不在上下文中,只能靠 FR 兜底;EM 指标要求变体级精确匹配,对真实电商中『多个合理答案』的场景偏严。我的补充观察:其一,训练用的相关性分数与评测查询都出自同一系 frontier LLM(gemini-3.1-pro/3.7-flash),存在同源偏置,真实用户查询分布上的收益可能缩水;其二,每商户需独立训练策展器并做 GRPO 后训练,涉及大量 LLM rollout,论文未披露 API 成本与训练算力;其三,与在真实用户行为日志上训练的工业系统没有对比,落地时的画像/个性化优势未讨论。
独立分析的弱点
第一,剪枝召回瓶颈:25% 预算下召回 77.1%,意味着约四分之一查询的真值商品被剪掉,只能指望相关性打分把替代品排进来;改进方向是按查询难度自适应调节剪枝率 $\rho$,或对低置信度查询回退到更大保留率甚至全目录。第二,合成数据同源性:查询生成、相关性打分与部分评测均依赖同一个 frontier LLM,其偏好会同时污染训练信号和性能上界;可引入小样本真实查询做校准,或用多个异构 LLM 交叉打分去噪。第三,落地成本:每商户要生成 $10n$ 条查询、给每条查询打全目录分(Package Free 739 变体×100 查询即约 7.4 万条打分)、再跑两阶段 RL,对小商户未必比直接全目录提示划算;可研究多商户共享编码器/重组器,把 LLM 后训练降级为 LoRA。第四,任务范围窄:单轮、单一最优变体的设定无法覆盖购物车组合、多品推荐与个性化排序,重组器和奖励需要推广到集合选择与用户画像条件化。第五,可解释性:模型直接输出品名、无目录字段级证据链,出错难排查,可在提示与奖励中加入对目录元数据的引用约束。
未来方向
论文自身展示的两个泛化方向(新商品免重训注入、跨商户零样本迁移,域外平均 +18.1 EM)指向了几个自然延伸:把 7 个商户的数据联合训练一个通用策展器并检验更大规模的开放类目迁移;把策展扩展到多轮对话式搜索,让上下文随对话演化增量重组而非每轮全量重算;引入商品图片等多模态信息服务服饰、家居等视觉主导类目;研究目录高频更新下的增量训练与缓存策略(嵌入与相关性分数的局部刷新);把『上下文相对奖励』思想推广到更一般的上下文内任务(文档内问答、代码库内检索),形成策展-适配协同的通用范式;最后,小模型(gemma-4-E4B-it)+ 策展达到前沿模型精度且延迟 3.7s 的结果,暗示了一条边缘端/低成本部署路线,值得做实机与成本测算。
复现评估
论文方法描述相当完整:附录 A.1–A.10 分别覆盖合成数据细节、训练统计与曲线、评测数据构造与人工审核、实现细节、指标定义、逐商户完整结果、失败分析、泛化实验与消融,所用模型(gemma-4-E4B-it、gemini-3.1-pro/3.7-flash、grok-4.1-fast、claude、kimi、glm 等)均公开可访问。但文中未见代码、合成数据集或 700 条评测查询的开源声明;7 个商户为真实 Shopify 店铺,公开存在版权与合规障碍。复现成本:调用 gemini-3.1-pro 生成每商户 10n 条查询并对全目录打分级相关性分(API 开销最大头);编码器与重组器常规 GPU 可训;对 gemma 做 GRPO 后训练需一定算力;评测需 9 骨干×7 商户×10 次重复推理。总体判断:无开源资产时复现工作量中等偏上;核心思路(合成监督 + LLM-in-the-loop RL + 上下文相对奖励)并不复杂,但相关性打分质量与超参($\tau=10$、$\beta$、保留率)对最终数字敏感。
论文图表