运动学MeanFlow:面向机器人基础模型的一步动作生成策略 Kinematic MeanFlow: One-Step Action Generation Policy for Robotic Foundation Models
解耦时间导数项的MeanFlow改进,让机器人基础模型一步生成动作且性能超多步流匹配
前置知识
流匹配
一种生成模型训练范式:构造线性插值路径 $z_t=(1-t)a+t\epsilon$,训练网络预测瞬时速度 $v_t=dz_t/dt=\epsilon-a$,推理时从纯噪声出发、沿预测速度场做多步数值积分(多次前向,即多个 NFE)得到样本。在 RFM 中动作头用流匹配并行生成整个动作块,去噪步数直接决定推理延迟。
本文的核心问题就是把流匹配动作头的多步去噪压缩为一步,必须先理解 NFE 与延迟、成功率之间的权衡关系。
MeanFlow 与平均速度
MeanFlow 学习任意两个时间步 $t,r$ 之间的平均速度 $u_{t,r}=\frac{1}{t-r}\int_r^t v(z_\tau,\tau)d\tau$,并利用 meanflow 恒等式 $u_{t,r}=v_t-(t-r)\frac{d}{dt}u_{t,r}$ 把昂贵的积分改写成可在线估计的局部形式;训练好之后取 $t=1, r=0$ 即可单次前向完成采样。
K-MF 是 MeanFlow 在 RFM 场景的改进版,理解其目标函数构造方式以及直接迁移为何失败,是读懂全文的前提。
自举与 stop-gradient
MeanFlow 的回归目标由当前模型自己经 JVP 估计出的时间导数项经 stop-gradient(记号 $\mathrm{sg}(\cdot)$)构成:模型既当学生又当老师,形成自举反馈回路。$\mathrm{sg}$ 阻止梯度流回目标一侧,但目标本身随参数更新而漂移,导数估计一旦有偏就会跨迭代累积放大。
论文论证 MeanFlow 在 RFM 上崩溃的根源,正是时间导数估计误差通过这一自举回路被正反馈放大,这是设计解耦方案的直接动因。
JVP 与前向自动微分
雅可比-向量积(JVP)计算网络输出对输入某切向量的方向导数。借助对偶数实现的前向模式自动微分,可在一次前向传播中算出网络雅可比 $[\nabla_z\pi_\theta,\partial_r\pi_\theta,\partial_t\pi_\theta]$ 与切向量 $[v_t,0,1]^\top$ 的乘积,无需构建反向计算图。
MeanFlow 和 K-MF 的时间导数项都靠 JVP 在线计算;K-MF 还利用两个子区间导数相互独立的特点把它们沿 batch 维拼接成一次前向,这是训练开销分析的技术基础。
机器人基础模型(RFM)
由 VLM 骨干与 Transformer 动作头组成的通用机器人操作策略:骨干单次前向把视觉观测和语言指令编码为多模态特征,动作头结合本体状态 $s_n$ 生成未来动作块 $a_n$,代表工作包括 GR00T-N1.6、SimVLA、$\pi_0$ 等,动作头普遍采用流匹配做多步去噪。
论文的问题背景与实验载体。动作头延迟占 RFM 端到端推理时间的 40%–50%,理解这一两段式结构才能明白一步生成为何关键。
局部加速度
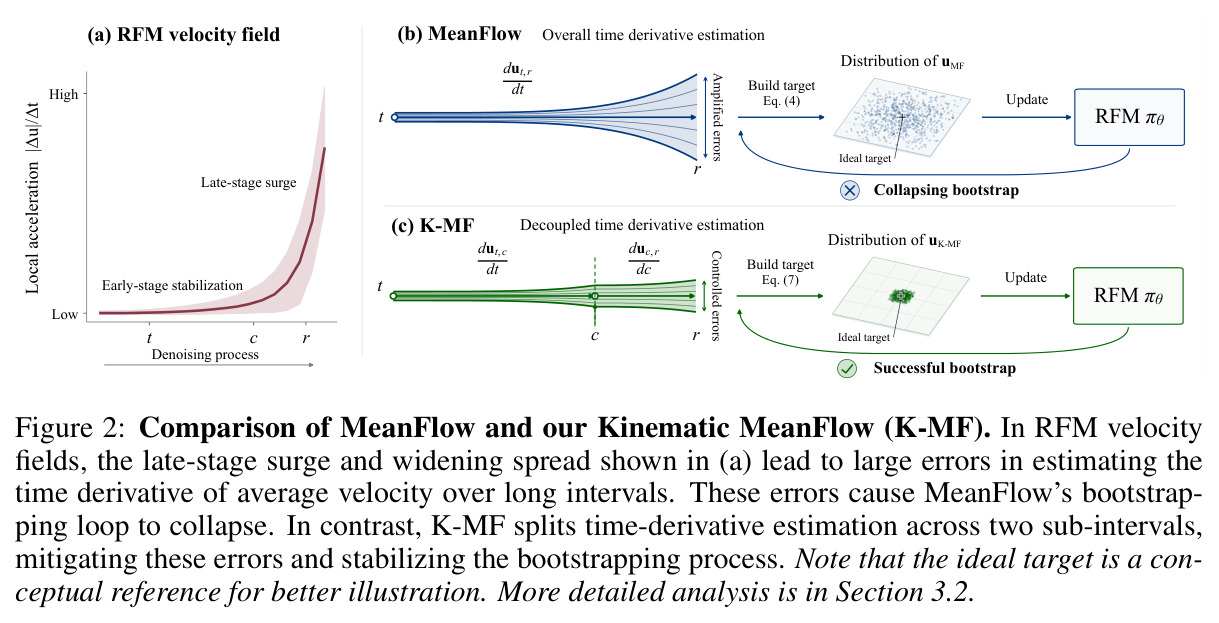
指平均速度随时间步的变化率,用小间隔估计 $\Delta u/\Delta t$(论文取 $\Delta t=0.05$),刻画相邻去噪步之间速度场变化的剧烈程度。图像生成中它全程平稳、散布窄;RFM 中则在去噪后期急剧上升(达初始值 76 倍)且样本间幅度散布不断扩大。
它是论文诊断 MeanFlow 失效的核心观测量:后期激增导致局部估计无法外推全局,散布扩大则放大估计误差,两个 issue 直接对应 K-MF 的两项设计。
研究动机
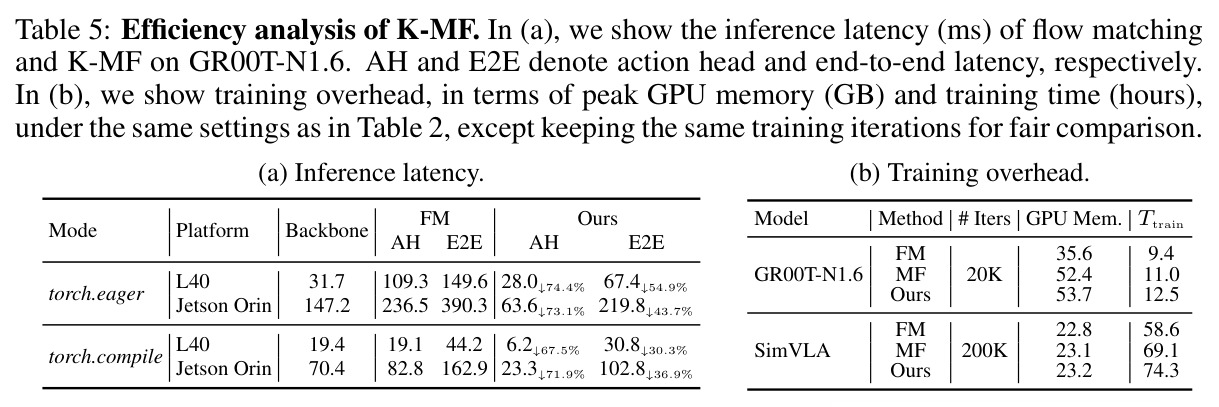
通用机器人基础模型(RFM)如 GR00T-N1.6、SimVLA 普遍采用 Transformer 流匹配动作头:VLM 骨干单次前向提取特征后,策略需在去噪时间步上迭代查询网络 4–10 次才能把高斯噪声变成动作块。论文实测该动作头延迟约占端到端推理时间的 40%(L40 桌面 GPU)到 50%(Jetson Orin 边缘平台),成为决策频率的关键瓶颈。MeanFlow 在图像生成中已证明可一步采样,但直接套用到通用 RFM 会导致训练崩溃:在 LIBERO-10 上,即使加上梯度裁剪、渐进时间步采样并训练 60K 步,MeanFlow 两步生成成功率仅 87.0%,一步则完全失败。作者归因于 RFM 速度场的两个独特动力学:局部加速度在去噪后期急剧飙升,最终达到初始值的 76 倍;且其样本间幅度散布随去噪推进不断拉大,与训练任务多样性正相关。这使 MeanFlow 依赖的自举式时间导数估计产生巨大误差并被正反馈放大,形成尖刺状损失地形,而图像生成(DiT-B/ImageNet)中同样的机制却全程平稳。
本文的目标是论文的目标是让通用机器人基础模型在不损失任务成功率的前提下实现一步(NFE=1)动作生成,并同时覆盖两种训练范式:对预训练流匹配模型(GR00T-N1.6,3B 参数)微调,以及从零训练小模型(SimVLA-S,0.6B 参数)。效率上,希望把动作头延迟降低 65% 以上、端到端延迟降低 30% 以上,且在 L40 与 Jetson Orin、eager 与 torch.compile 等不同软硬件组合下均成立。泛化上,要求方法在 2K(LIBERO)到 87K(Fractal)轨迹的不同数据规模、桌面操作与点导航等不同任务类型、GoogleX/WidowX/Unitree G1 不同机器人本体上都能成立,最终成功率全面达到甚至超过多步流匹配基线。
与已有工作不同的是,既有一步生成研究的切入角度各不相同:MP1、MVP、MeanflowQL、DMPO 等把 MeanFlow 用于专用策略(模仿学习或强化学习),性能虽可行但有折损;α-Flow、SplitMeanFlow 等在图像/音频生成中引入区间划分,动机是课程学习或训练效率,并不处理通用策略的训练崩溃;也没有工作系统回答"为什么 MeanFlow 在通用 RFM 上失效"。本文的独特之处在于先诊断再开药:通过对比图像生成(ImageNet 上的 DiT-B)与动作生成(LIBERO 上的 SimVLA-S)速度场的局部加速度 $\Delta u/\Delta t$ 动力学,定位到 RFM 特有的"后期激增+散布扩大"现象,指出崩溃根源是时间导数项 $\frac{d}{dt}u_{t,r}$ 在长区间上的估计误差被自举回路放大,然后基于一个运动学恒等式对症设计解耦方案,而不是照搬图像领域的蒸馏或一致性技巧。
核心方法
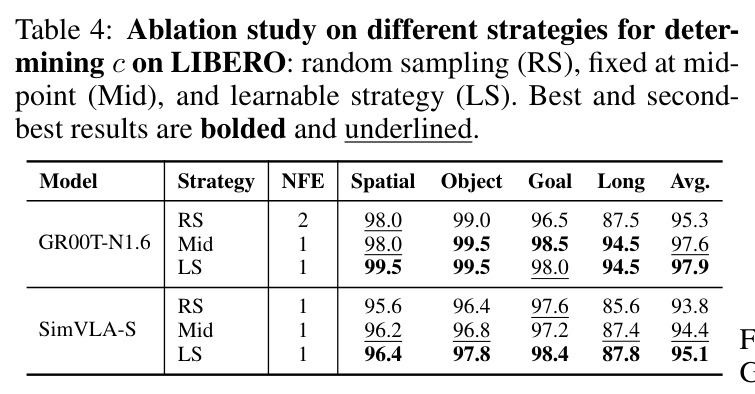
直觉上,MeanFlow 的回归目标 $u_{t,r}=v_t-(t-r)\frac{d}{dt}u_{t,r}$ 把 $t,r$ 间长区间的导数信息压进一次估计,而 RFM 在去噪后期导数剧烈变化且样本间散布巨大,误差极易被自举放大。K-MF 利用运动学恒等式:对任意中间点 $c\in(r,t)$,$u_{t,r}=(1-\lambda)u_{t,c}+\lambda u_{c,r}$。代入 meanflow 恒等式得训练目标 $u^{\text{K-MF}}=v_t-(t-r)\left[(1-\lambda)^2\,\mathrm{sg}\frac{d\pi_\theta(z_t,c,t)}{dt}+\lambda^2\,\mathrm{sg}\frac{d\pi_\theta(z_c,r,c)}{dc}\right]$。其中 $\frac{d}{dt}u_{t,c}$ 负责早期去噪动态,$\frac{d}{dc}u_{c,r}$ 专注后期修正,$c$ 处的第二次估计起锚定作用。锚点 $c$ 有均匀随机、固定中点、可学习 MLP 三种确定策略;推理时一次前向即完成一步动作生成。
核心创新是把 MeanFlow 的"整体时间导数"改为"解耦的子区间导数"。与 MeanFlow 只在 $t$ 处做一次 JVP 估计 $\frac{d}{dt}u_{t,r}$ 不同,K-MF 在 $t$ 和锚点 $c$ 各估计一次,用 $(1-\lambda)^2$、$\lambda^2$ 加权合成,权重直接来自恒等式代入的结果而非启发式。与 α-Flow、SplitMeanFlow 等图像领域的区间划分方法相比,本质区别在动机与构造:后者用划分构造蒸馏目标或课程以提升训练效率,K-MF 则针对 RFM 速度场后期激增与散布扩大的独特动力学,用解耦切断误差的乘性放大——两个子项沿条件流路径独立计算,误差只做加性累积;且 $z_c=(1-c)a+c\epsilon$ 直接锚定在训练数据上,不依赖模型对边际流的预测,避免第一次估计的误差传染到第二次。固定中点策略相对 MeanFlow 不引入任何新超参;可学习策略也只新增 $\alpha,\gamma$ 两个超参。
方法步骤详情
训练流程:(1) 采样 $t,r\sim\mathrm{Beta}(1.5,1.0)$($t>r$,50% 样本 $r=t$)与噪声 $\epsilon$;(2) 构造 $z_t=t\epsilon+(1-t)a$,$v=\epsilon-a$;(3) 一次前向 JVP 得到整体导数估计 $\frac{d}{dt}u_{t,r}$;(4) 确定 $\lambda$(均匀随机、固定 0.5,或 3 层 MLP $G_\phi(t,r)$),得 $c=r+\lambda(t-r)$,构造 $z_c=c\epsilon+(1-c)a$;(5) 两个子区间输入沿 batch 维拼接,一次前向并行算出 $\frac{d}{dt}u_{t,c}$ 与 $\frac{d}{dc}u_{c,r}$;(6) 按 Eq. 7 构建解耦目标做 MSE 回归;可学习策略叠加生成器损失 Eq. 8($\gamma$ 从 -0.5 线性升至 0.5),只更新 $\phi$。实现上需为 $r$ 增加时间嵌入。推理单步完成:$\hat a=z_1-\pi_\theta(z_1,0,1|o,s)$。
技术新颖性
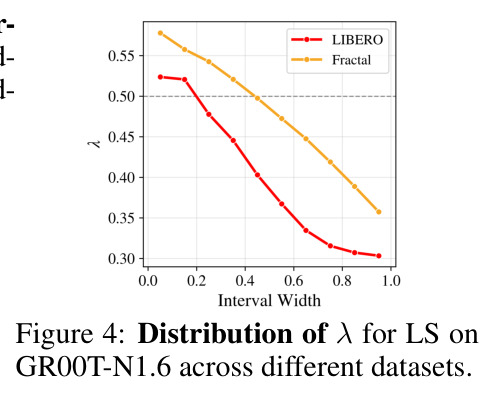
新颖性有四点。第一,首次系统刻画通用 RFM 速度场动力学:不同架构(GR00T-N1.6 与 SimVLA-S)在同一数据上呈现一致的"后期激增"模式,散布宽度随训练任务数先近似对数增长、后转饱和幂律,这本身是对 RFM 的新认识。第二,解耦形式有严格推导支撑:$(1-\lambda)^2$ 与 $\lambda^2$ 的加权是运动学恒等式代入 meanflow 恒等式的自然结果,保证公式在 $c\to t$ 或 $c\to r$ 时退回原式。第三,锚点 $c$ 可以学习:实验发现最优 $\lambda$ 与区间宽度 $t-r$ 强相关,且固定中点显著优于均匀随机采样,说明"锚点位置"而非"划分多样性"才是关键。第四,工程设计高效:两个导数可并行批量计算,$z_c$ 取条件路径点以避免误差传染,使训练开销相对流匹配仅增约 33%(GR00T-N1.6)和 27%(SimVLA),相对 MeanFlow 时间增 7.5%–13.6%、峰值显存至多增 2.5%。
实验结果
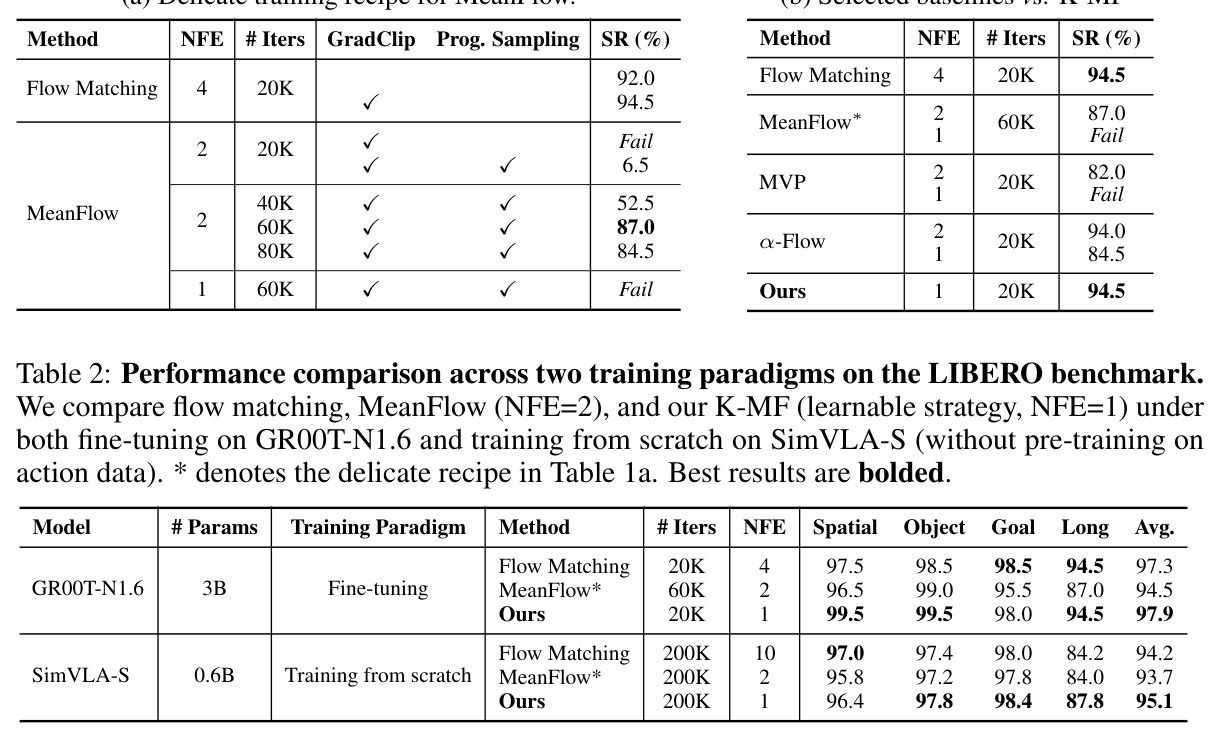
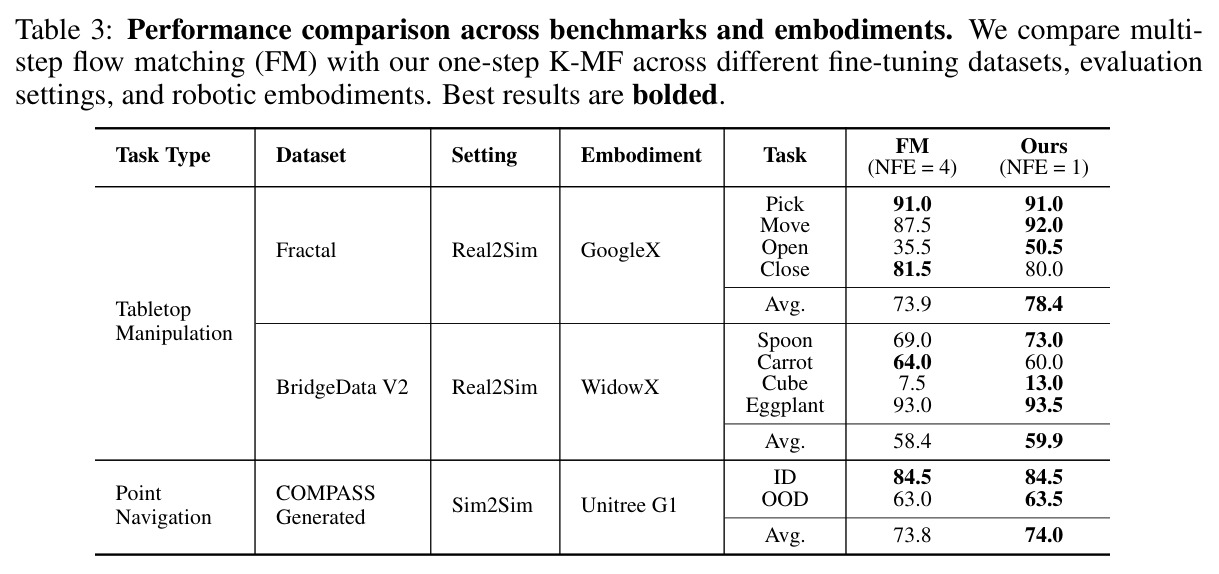
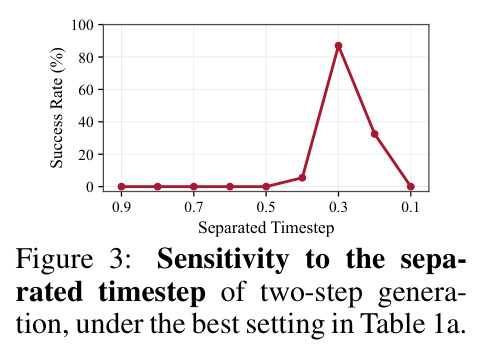
试点实验(Table 1,GR00T-N1.6/LIBERO-10):MeanFlow 需精细配方(梯度裁剪+渐进采样+60K 步)才达 87.0% 两步成功率,一步失败;MVP 一步失败、两步 82.0%;α-Flow 一步 84.5%;K-MF 仅 20K 步达 94.5%,与 4 步流匹配持平。主实验(Table 2,LIBERO 平均成功率):GR00T-N1.6 微调下 K-MF 一步 97.9%,超流匹配四步的 97.3% 与 MeanFlow* 两步的 94.5%;SimVLA-S 从零训练下 95.1% 超十步流匹配的 94.2%,Long 套件 84.2%→87.8%。跨基准(Table 3):Fractal 78.4% 对 73.9%,BridgeData V2 59.9% 对 58.4%,PointNav 74.0% 对 73.8%。消融(Table 4):可学习锚点策略最优,中点次之,随机采样最差。效率(Table 5):动作头延迟降 67.5%–74.4%,端到端降 30.3%–54.9%,如 eager L40 端到端 149.6ms→67.4ms。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO(GR00T-N1.6 微调,4 套件平均) | 成功率 SR (%) / NFE | 97.9 / NFE=1 | 流匹配 97.3 / NFE=4;MeanFlow* 94.5 / NFE=2 | 超过流匹配 +0.6pp,超过 MeanFlow +3.4pp,且步数从 4 降到 1 |
| LIBERO(SimVLA-S 从零训练) | 成功率 SR (%) / NFE | 95.1 / NFE=1 | 流匹配 94.2 / NFE=10;MeanFlow* 93.7 / NFE=2 | 超过流匹配 +0.9pp,去噪步数从 10 降到 1 |
| LIBERO-10 试点(GR00T-N1.6) | 成功率 SR (%) | 94.5 / NFE=1 / 20K 步 | 流匹配 94.5 / NFE=4;MeanFlow* 87.0(60K 步);α-Flow 84.5;MVP 一步失败 | 与流匹配持平,训练步数仅为 MeanFlow 精细配方的 1/3 |
| Fractal(Real2Sim,GoogleX 本体) | 成功率 SR (%) | 78.4 / NFE=1 | 流匹配 73.9 / NFE=4 | +4.5pp,其中 Open 任务 35.5%→50.5% |
| BridgeData V2(Real2Sim,WidowX 本体) | 成功率 SR (%) | 59.9 / NFE=1 | 流匹配 58.4 / NFE=4 | +1.5pp(Cube 任务 7.5%→13.0%,但 Carrot 64.0%→60.0%) |
| PointNav(COMPASS 生成数据,Unitree G1) | 成功率 SR (%),ID/OOD 平均 | 74.0(ID 84.5 / OOD 63.5) | 流匹配 73.8(ID 84.5 / OOD 63.0) | +0.2pp,在 658 条轨迹的小数据与导航任务上仍不落后 |
| 推理效率(GR00T-N1.6,L40/Jetson Orin,eager/compile) | 动作头与端到端延迟 | 动作头延迟降低 67.5%–74.4%,端到端降低 30.3%–54.9%(如 eager L40:149.6ms→67.4ms) | 流匹配 NFE=4(eager L40 端到端 149.6ms) | 一步生成使边缘平台端到端延迟最多降 54.9% |
局限与改进
作者承认两点局限:一是相对流匹配有额外训练开销(GR00T-N1.6 训练时间从 9.4 小时增至 12.5 小时,峰值显存 35.6GB→53.7GB);二是实验未覆盖全身控制与灵巧操作这类对当前 RFM 仍然困难的场景。此外可以看到:所有评估均在仿真闭环(LIBERO 原生仿真、SimplerEnv 的 Real2Sim、COMPASS)中进行,缺少真机闭环部署结果;部分任务存在回退,如 BridgeData 的 Carrot 从 64.0% 降到 60.0%;PointNav 上相对流匹配的提升只有 0.2 个百分点,且全文未报告多次运行的置信区间或显著性检验;可学习策略引入 $\alpha,\gamma$ 两个需要调节的超参,而中点策略已能拿到大部分收益(97.6% vs 97.9%);延迟结论基于 GR00T-N1.6 一个模型的动作头,迁移到其他架构的收益需重新测量;对 MeanFlow 的比较依赖于作者自己实现的"精细配方",基线调优空间存在不确定性。
独立分析的弱点
第一,仿真与真机的鸿沟:Real2Sim(SimplerEnv)评估与真实闭环仍有差距,一步策略对控制频率的增益只有在真机上才能完全兑现,建议补充真机端到端延迟与成功率。第二,提升幅度不均衡:LIBERO 上 +0.6/+0.9 个百分点、PointNav 上仅 +0.2,Carrot 任务甚至从 64.0% 回退到 60.0%,说明一步生成的收益可能取决于任务速度场的平滑程度,可按任务自适应选择一步/两步混合推理。第三,散布与任务多样性的关系停留在相关性层面(对数/幂律拟合),缺乏因果理论,难以在训练前预测新数据集上的难度,可尝试为散布宽度建立可计算的上界并据此自适应增加锚点数量(三分、四分区间)。第四,可学习 $G_\phi$ 的收益(97.6%→97.9%)相对其复杂性和 $\gamma$ 调度的经验性偏小。第五,与 MeanFlow 的对比基线由作者自行实现并调优,应补充多随机种子与显著性检验以增强说服力。
未来方向
作者指出的方向包括把 K-MF 推广到全身控制与灵巧手操作等更高自由度场景,并提醒随着 RFM 数据规模和本体复杂度增长,后期激增与散布问题会更加突出。基于本文成果还可延伸:把解耦导数思想移植到一致性模型、shortcut models 等其他少步生成框架;与强化学习微调结合(如 MVP 的瞬时速度约束、DMPO 的 PPO 优化),检验解耦自举在 RL 噪声回报下是否依旧稳定;利用"散布随任务数增长"的规律设计数据配比与课程采样策略;在 Jetson Orin 等边缘设备上结合量化与算子融合,进一步压缩 eager 模式下 63.6ms 的一步动作头延迟;以及为 RFM 速度场动力学建立理论模型,在训练前即可指导步数选择与锚点设计。
复现评估
复现条件中等偏上。论文承诺接收后开源代码与模型权重(GitHub:IntelChina-AI/K-MF),当前仅有仓库占位。所用模型(GR00T-N1.6、SimVLA-S)与数据(LIBERO 2K、BridgeData V2 53K、Fractal 87K、COMPASS 点导航 658 轨迹)全部公开,评估协议(LIBERO 200/500 次 rollout、SimplerEnv 与 COMPASS 各 200 次)沿用社区标准,超参在 Table A 中给出得相当完整(如 GR00T-N1.6 微调:batch 640、lr 1e-4、AdamW、20K 步、bf16、K-MF 的 flow ratio 0.5、$\alpha=0.1$、$\gamma\in[-0.5,0.5]$)。主要门槛是算力:训练在单节点 8×H20(96GB)上进行,GR00T-N1.6 微调峰值显存 53.7GB、耗时 12.5 小时;好在 Algorithm 1/2 与 JVP、批量导数计算的实现细节描述清晰,可先在 0.6B 的 SimVLA-S 上低成本验证。
论文图表
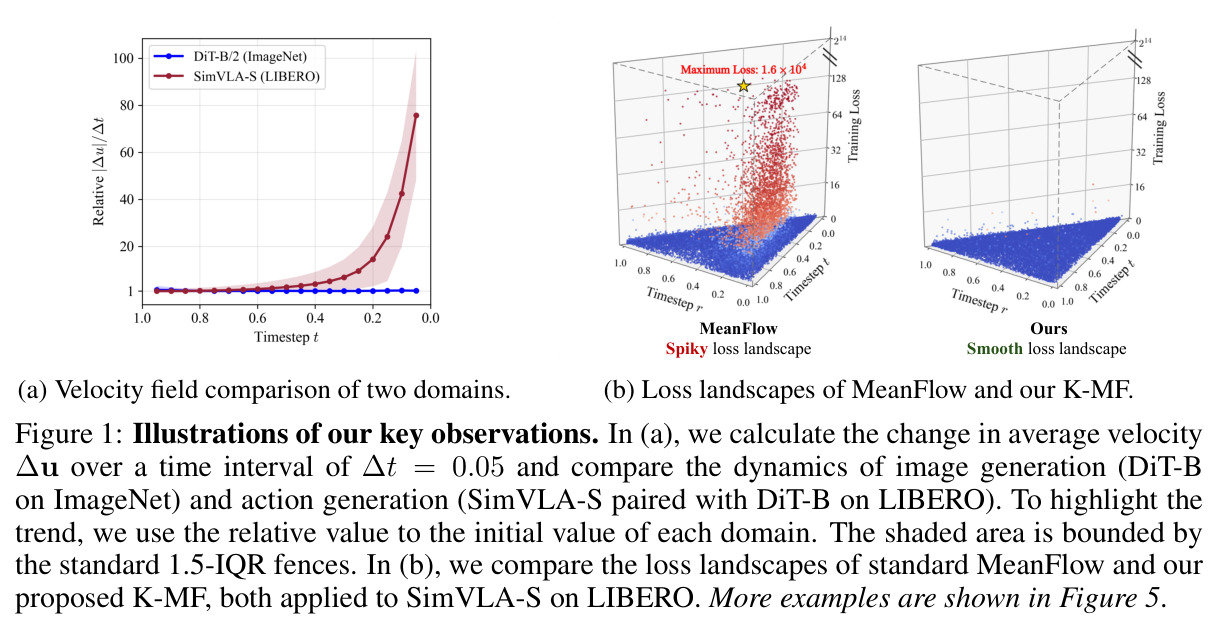
左图比较图像生成与机器人动作生成中平均速度变化量 $\Delta u/\Delta t$($\Delta t=0.05$,红色阴影为 1.5-IQR 散布范围):图像域全程平稳且散布窄,RFM 则在去噪后期急剧上升、散布不断扩大;右图显示标准 MeanFlow 在 RFM 上呈尖刺状损失地形,K-MF 则平滑。
这张图是全文的立论基础:它直观展示了 RFM 速度场区别于图像生成的两个关键动力学,并预告了 MeanFlow 失败与 K-MF 成功的对比。
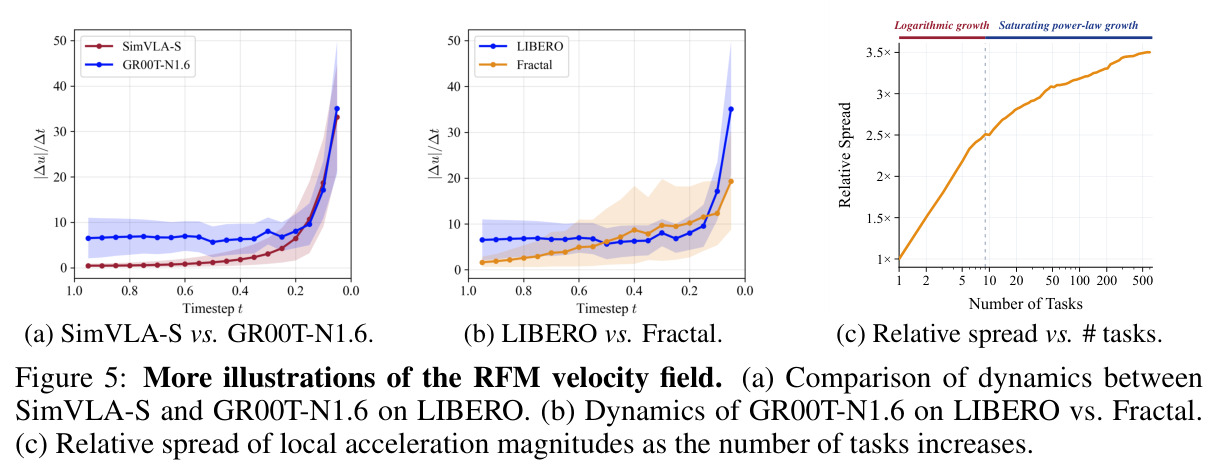
三张补充分析图:(a) 两个不同架构的 RFM 在 LIBERO 上呈现相似的局部加速度上升趋势;(b) 更大更复杂的 Fractal 数据集训练的模型散布明显更宽;(c) 局部加速度相对散布随任务数增加呈低任务数对数增长、高任务数饱和幂律增长。
系统化支撑论文的核心经验发现:RFM 速度场模式跨架构一致,但散布取决于训练分布且随任务多样性扩大,预示数据越大一步生成越难。
示意 MeanFlow 基线所需的渐进时间步采样:flow ratio 从 0 线性升至 0.5($t\neq r$ 样本占比从 100% 降到 50%),gap scale 从 0 升到 1(时间间隔逐渐恢复原幅度),训练先学局部平均速度再过渡到标准目标;K-MF 无需此技巧。
解释对比实验中 MeanFlow 精细配方的具体含义,帮助读者理解 Table 1a 中各配置差异以及 K-MF 在易用性上的优势。
可学习锚点生成器 $G_\phi$ 的结构:输入 $(t,r)\in\mathbb{R}^2$,经两个 128 单元 SiLU 隐藏层,最后 Sigmoid 输出 $\lambda\in(0,1)$,共 3 层(2→128→128→1)。
可学习策略是三种锚点确定策略中最优的一种,此图给出其轻量实现,是复现 Table 4 中 LS 结果的必要细节。
(a) 训练过程中平均 $\lambda$ 先降后升($\gamma<0$ 阶段),$\gamma>0$ 后下降并收敛到约 0.48;(b) 训练好的 $G_\phi$ 在 LIBERO 与 Fractal 上生成的 $\lambda$ 分布趋势一致,大数据集上分布更集中。
展示可学习锚点的实际行为及其学习动态,解释生成器损失 Eq. 8 中 $\gamma$ 调度的设计意图与效果。
在去噪早期时间步对 $z_t$ 施加 1% 随机扰动,测量到 $\frac{d}{dt}u_{t,r}$ 的相对误差放大:早期引入的扰动到去噪结束时放大约 120 倍,扰动引入得越晚($t<0.6$)放大越小。
用受控实验定量验证了"散布扩大导致误差放大"的 Issue 2,是 K-MF 解耦设计正确性的直接证据。
分解 RFM 与图像生成模型速度场的速度大小变化率与角度变化率:RFM 三个指标在去噪后期均剧烈变化,而图像模型平稳;RFM 的局部加速度激增来自速度大小与方向变化的叠加。
回答了一个反直觉问题——RFM 本来只需比图像生成更少的采样步数,为何一步生成反而更难,深化对速度场动力学的理解。
(a) MeanFlow 精细配方消融:不加梯度裁剪或渐进采样时一步失败或仅 6.5%/52.5%,60K 步+全配方达 87.0%(NFE=2),80K 步反降到 84.5%;(b) 基线对比:流匹配 4 步 94.5%,MVP 一步失败/两步 82.0%,α-Flow 一步 84.5%,K-MF 一步 94.5%。
用受控试点确立两个事实:MeanFlow 在 RFM 上需要脆弱的精细配方,且现有 MeanFlow 变体都无法一步追平流匹配,为 K-MF 的必要性提供证据。
完整超参表:全局 batch(64–1024)、学习率(1e-4 至 1.5e-4)、AdamW、训练步数(20K–200K)、warmup、梯度裁剪 1.0、Beta(1.5,1.0) 时间步采样、状态丢弃率 0/0.8、bf16 精度;K-MF 特有的 flow ratio 0.5、α=0.1、γ∈[-0.5,0.5]。
复现实验的关键配置来源,也显示 K-MF 大部分超参与流匹配基线共享、新增超参极少。
α=0.1 最优(97.9%),α 增至 2.0 降至 96.3%;γ 范围取 [-0.5,0.5] 最优(97.9%),扩大到 1.0 降至 96.1%;flow ratio 0.25–1.0 间性能稳定(97.4%–97.9%);$G_\phi$ 3 层最优(97.9%),2 层 97.3%、4 层 97.8%。
证明 K-MF 对超参不敏感、工程上易用,同时给出可学习生成器的最小充分容量,指导复现与迁移。
相对中点策略的增益随数据规模扩大:LIBERO(2K 轨迹)上 LS 97.9% 对 Mid 97.6%,Simpler-WidowX(53K)上 59.1% 对 58.4%,Simpler-Google(87K)上 76.8% 对 73.9%(流匹配 73.9%)。
揭示可学习锚点的价值与数据规模正相关:数据越大、任务越多样,自适应锚点带来的收益越明显。