预测性功劳:衡量科学解释为实验预测带来的增益 Predictive Credit: Measuring What Scientific Explanations Add to Experimental Forecasts
配对冻结预测协议测得:自然解释对实验预测无显著增益,仅降低重复漂移
前置知识
预测性功劳(predictive credit)
指一段科学解释在多大程度上提升了对外部实验结果的预测能力。本文用同一预测器、同一结局下两种上下文的平均损失差 $G_{\text{description}} = R^D - R^M$ 来量化:为正说明解释带来了真实信息增益,为零或为负则说明解释没有携带超出公共描述的内容。
全文的目标就是定义并测量这个量:所有实验设计(配对上下文、供体对照、结局前冻结)都是为了让这个差值可解释、可检验。
可模拟性评估(simulatability)
通过"解释能否帮助观察者预测模型行为"来评估解释质量的一类方法。Hase 等人的泄漏调整可模拟性在扣除答案泄漏后比较有无解释时的预测准确率;Chen 等人扩展到反事实输入;Mayne 等人报告了自解释带来的增益。
本文把这一思路从"预测模型自身输出"迁移到"预测真实执行的外部实验",并加入供体对照与不确定性区间,是与本文最直接对话的已有工作。
适当评分规则与区间评分
同时评价点预测与不确定性区间的严格适当评分。80% 中央区间的评分是 $\mathrm{IS}_{80}(L,U;y) = (U-L) + 10(L-y)\mathbf{1}[yU]$,既奖励窄区间又重罚漏报真值,是 Tox21 研究的预注册主指标。
Tox21 的 harm 门限和 Flash 重放的等效性检验都建立在区间评分上;论文发现匹配卡会显著撑宽区间却不提升覆盖,读懂主结论必须理解这个指标。
意向治疗(ITT)分析
源自临床试验的分析原则:所有被分配到某处理的单位都进入分析,失败响应以确定性兜底值计入分母,不做任何筛选。这里对应"所有被指派的 LLM 调用都保留在分析中",并伴随完整性率(有效响应占比)一起报告。
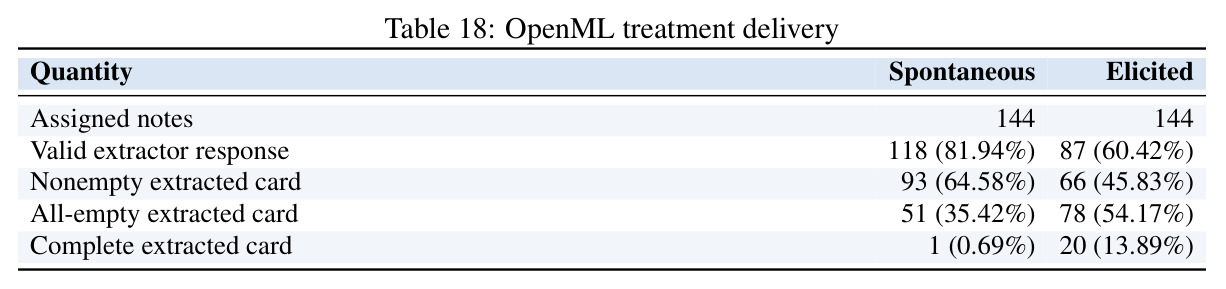
论文所有冻结判定都用 ITT 口径,避免"只统计成功调用"造成的乐观偏差;OpenML 提取臂 60.42% 的有效率正是靠 ITT 才没有被掩盖。
等效性检验
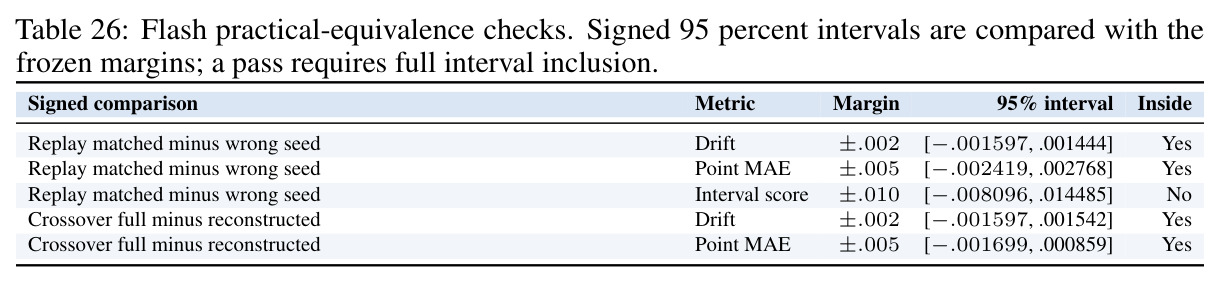
与"是否存在差异"的显著性检验相反,等效性检验要求估计差的置信区间完全落入预先设定的实际等效边际(如区间评分 ±.010、漂移 ±.002)之内,才支持"两者等效";区间跨越边际则只能记录剩余的可能范围。
Flash 重放九项冻结门限中唯一失败的就是区间评分等效性([−.008096, .014485] 越过 ±.010),OpenML 点等效规则也用 90% 置信区间判定,理解判定逻辑离不开它。
重复漂移(repeat drift)
同一预测器对同一固定实验做两次独立调用所得点预测之差的绝对值 $A_i^c = |\hat{y}_{i1}^c - \hat{y}_{i2}^c|$,衡量输出的随机波动。共享的数值中心可以压低漂移却完全不减少对真值 $y_i$ 的误差,因此必须与损失分开报告。
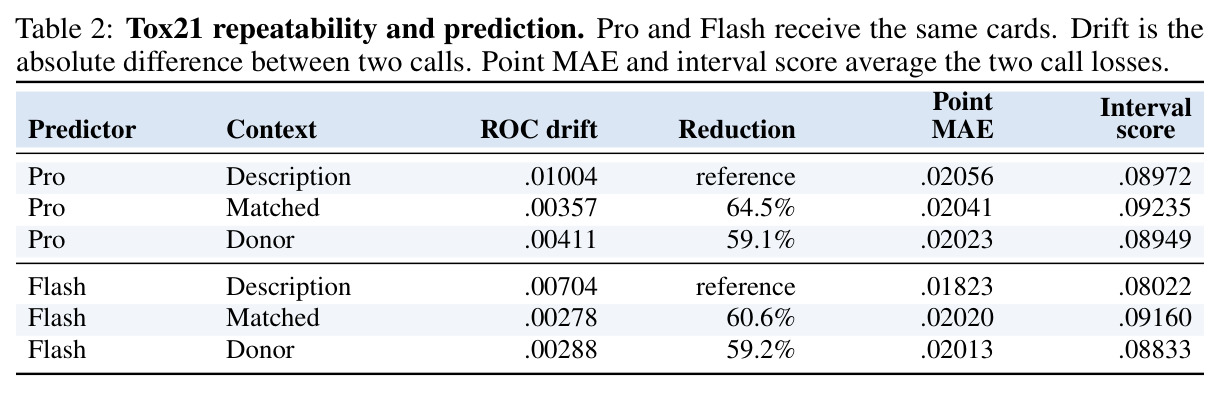
结构化卡片唯一稳定的效应就是降低漂移(Tox21 降 64.5%),这正是论文反复强调"输出一致性不等于预测增益"这一核心区分的经验证据。
研究动机
自动化科研系统(如 AI Scientist、闭环分子性质工作流)在提出实验改动的同时会生成一段"为什么这样改有效"的解释,但现有评估几乎只给最终实验成绩打分:搜索结果有指标,配套的解释却无人计分,这使科研智能体基准无法区分"蒙对的改动"与"有理有据的改动"。与此同时,科学预测研究已能预测 AI 与神经科学的经验结果(如 BrainBench),可模拟性评估也能用解释预测模型行为,但两条线都没有回答"一段解释对预测真实已执行实验到底有多大帮助"。难点在于解释的效应有多种纠缠的可观察形式:它可能让主张显式化(承诺)、让重复预测更接近(一致性)、改变精度、或仅仅把不确定性区间撑宽——此前没有协议把这些行为分开测量,也没有在结局揭晓前冻结判断以防事后拟合。
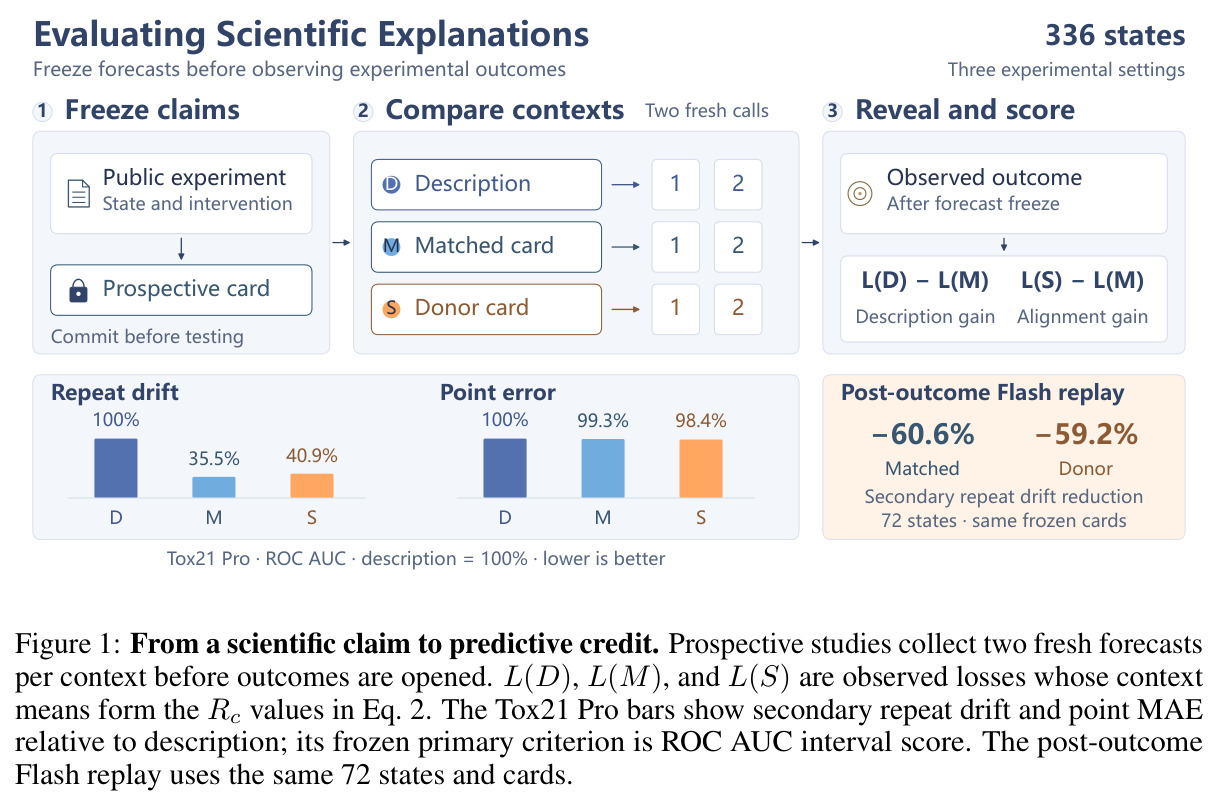
本文的目标是本文要建立一个可复用的"预测性功劳"测量协议:对一批即将执行的实验状态,在结局打开前冻结全部预测调用;每个状态在共享同一干预、同一预测器、同一结局的前提下比较三种上下文——纯描述 $D_i=(x_i,a_i)$、加当前解释的匹配卡 $M_i=(x_i,a_i,h_i)$、加另一状态解释的供体卡 $S_i=(x_i,a_i,h_{\pi(i)})$——用点 MAE、方向准确率、区间覆盖率/宽度、80% 区间评分和重复漂移五类指标执行五项检查(前瞻承诺、证据交付、配对预测价值、供体对齐、已知信号敏感性),最终为科研智能体基准提供一个能给解释打分、并支持成本感知实验选择的评估工具。
与已有工作不同的是,独特切入有三点。第一,评估对象从"模型自身输出"换成"外部真实执行的实验结果"(分子活性 ROC AUC 变化、表格任务 skill 变化),把解释评估对齐科学预测传统;第二,引入供体解释做安慰剂对照——供体来自另一状态(Tox21/OpenML 同单元换种子、v5 换干预),只有匹配解释显著优于供体才支持"状态特异性功劳",从而排除"任何额外文本都有用"的平凡解释;第三,把临床试验的测量纪律搬进 LLM 评估:预注册冻结判定规则、ITT 分析、任务分层 bootstrap、等效性边际、阳性对照(研究者撰写的真/假机制注释、精确信号校准)与完整成本台账,并用六槽预测卡片把散文式解释变成可逐槽核验的显式承诺。
核心方法
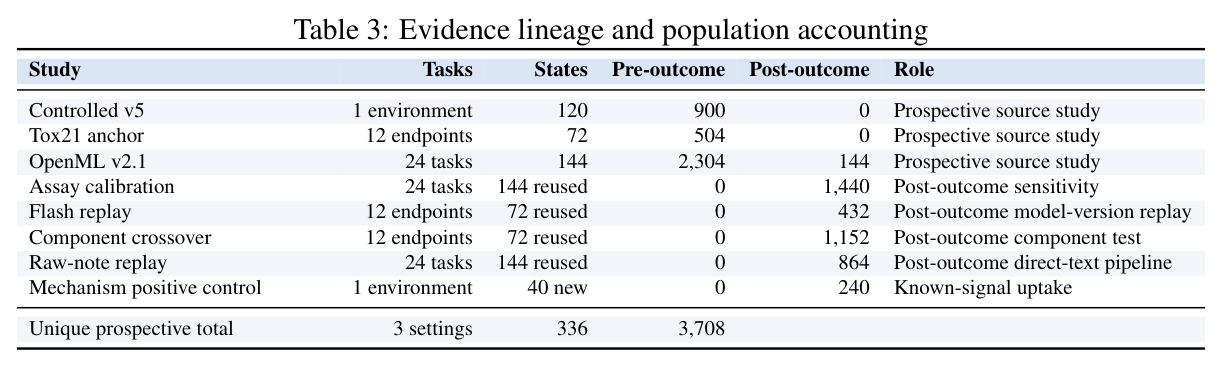
直觉:一个解释只有能帮预测器更准地预见实验结果时才有"功劳"。技术路线是把"有没有解释"变成对照实验:对同一状态 $i$,预测器 $f$ 分别接收 $D_i=(x_i,a_i)$、$M_i=(x_i,a_i,h_i)$、$S_i=(x_i,a_i,h_{\pi(i)})$ 三种上下文,各做两次独立调用,每次返回点预测与中央 80% 区间。定义 $R^c = \mathbb{E}[\ell(f(c_i), y_i)]$ 后,两个核心对比是 $G_{\text{description}} = R^D - R^M$ 与 $G_{\text{alignment}} = R^S - R^M$,为正即匹配解释占优。三个前瞻研究(受控 v5、Tox21 锚点、OpenML v2.1)共 336 个状态、3,708 个调用在私有结局打开前全部冻结,随后按预注册门限判定,再补做一系列事后阳性对照与组件分解。
核心创新是"配对 + 供体"的双重对照与五项检查框架。与可模拟性评估不同,预测目标是真实执行的外部实验而非模型自身行为;与单纯比较有无解释不同,供体上下文控制了"加文本就变好"的平凡效应——若增益来自格式或注意力而非内容,供体应同样受益,因此只有匹配显著优于供体才构成状态特异性功劳。六槽预测卡片(显式方向、数量点/区间、中间观测量、受益区间、证伪标准、反事实)把解释变成可测试承诺,每个槽的提取都要求原文引用支撑。漂移 $A_i^c = |\hat{y}_{i1}^c - \hat{y}_{i2}^c|$ 与损失联合报告,在统计上把"输出协调"与"预测增益"分开——这是此前解释评估没有做的关键区分。
方法步骤详情
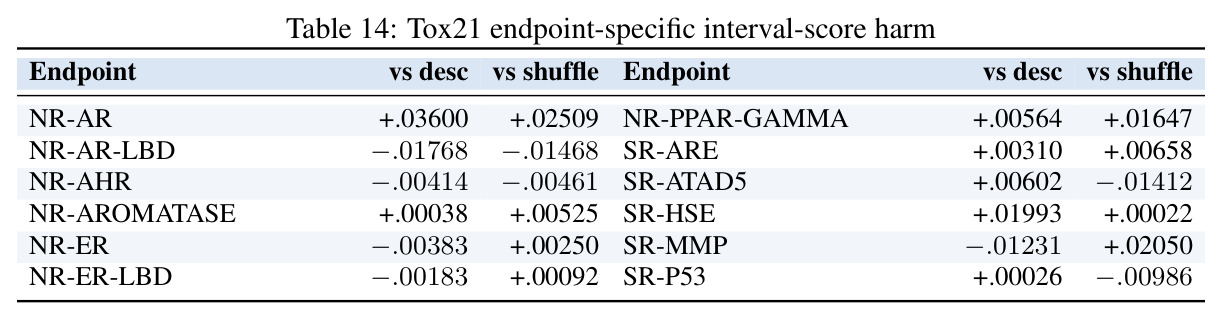
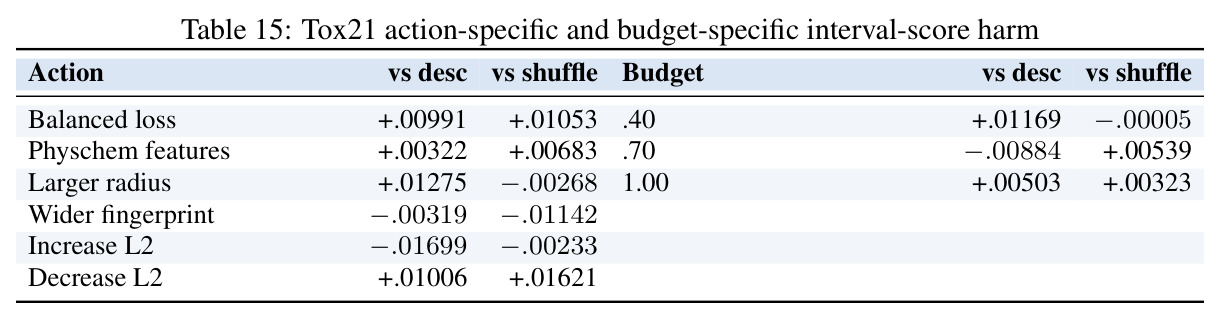
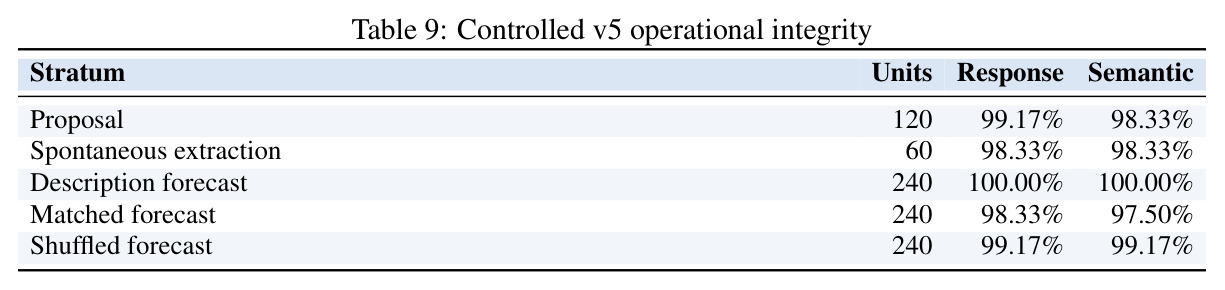
第一步构建状态池:受控 v5 用六个快学习机制×冻结种子生成 120 状态(60 自发提议+60 引出卡片);Tox21 用 12 端点×3 标签预算×2 种子=72 状态,动作按 $(\text{endpoint}+\text{budget}) \bmod 6$ 循环指派六种干预(平衡损失、理化特征、扩大 Morgan 半径、加宽指纹、增/减 L2);OpenML 用元数据哈希抽签选 12 分类+12 回归任务×3 预算×2 种子=144 状态,LightGBM 收到六种干预之一。第二步生成卡片:智能体只看父状态公共指标与指派动作,产出六槽卡片,条件盲提取器映射到六槽。第三步冻结预测:每状态每上下文两次独立 DeepSeek V4 Pro 调用,共 3,708 个调用在结局打开前落盘。第四步评分判定:计算点 MAE、方向准确率、覆盖率/宽度、$\mathrm{IS}_{80}$、漂移,经层级 bootstrap 给出置信区间,对照预注册门限。第五步事后对照:432 调用 Flash 重放、1,152 调用组件交叉、864 调用直接文本重放、240 调用真/假机制阳性对照、1,440 调用精确/噪声/错种子信号校准。
技术新颖性
新颖性体现在测量制度而非单一算法。其一,把试验注册纪律(冻结规则、ITT、等效性边际、预注册阈值、事件台账、成本核算)系统引入 LLM 解释评估,使"解释有没有用"变成可证伪的判定而非印象式评价;其二,五项检查把纠缠的行为分解开:承诺(完备卡片率)、交付(证据支持内容是否进入输入)、预测价值(配对对比)、对齐(供体差)、信号敏感性(已知信号 uptake),每项有独立指标与门限;其三,阳性对照设计证明阴性结果不是预测器失灵——精确信号下 144/144 胜出、Spearman 相关 .99996,真机制注释也显著降错,说明测量工具本身灵敏;其四,同时报告漂移与适当评分,揭示"结构化卡片降低漂移但不改善甚至损害精度与区间"这种单指标评估必然遗漏的解耦现象。
实验结果
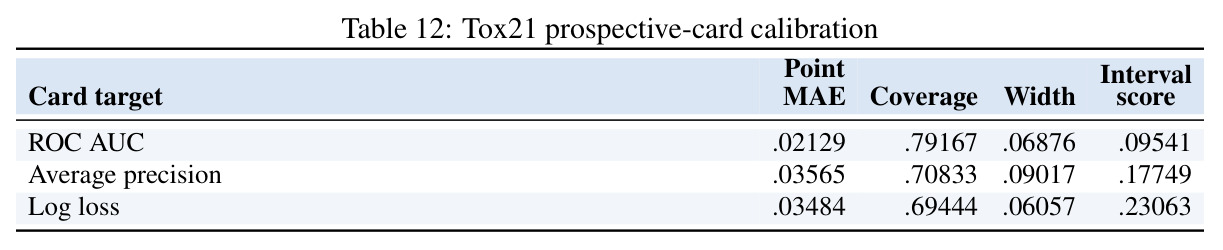
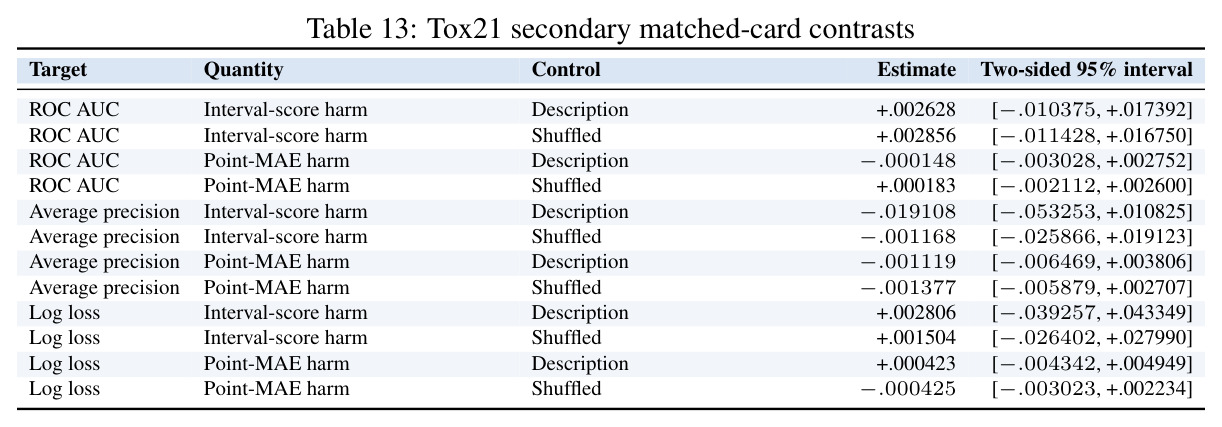
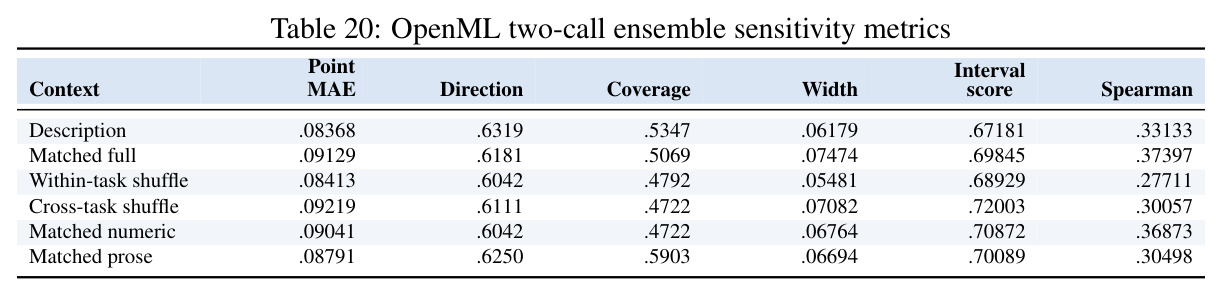
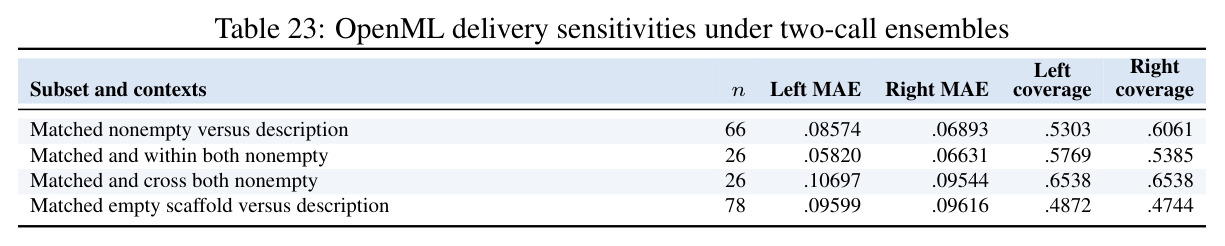
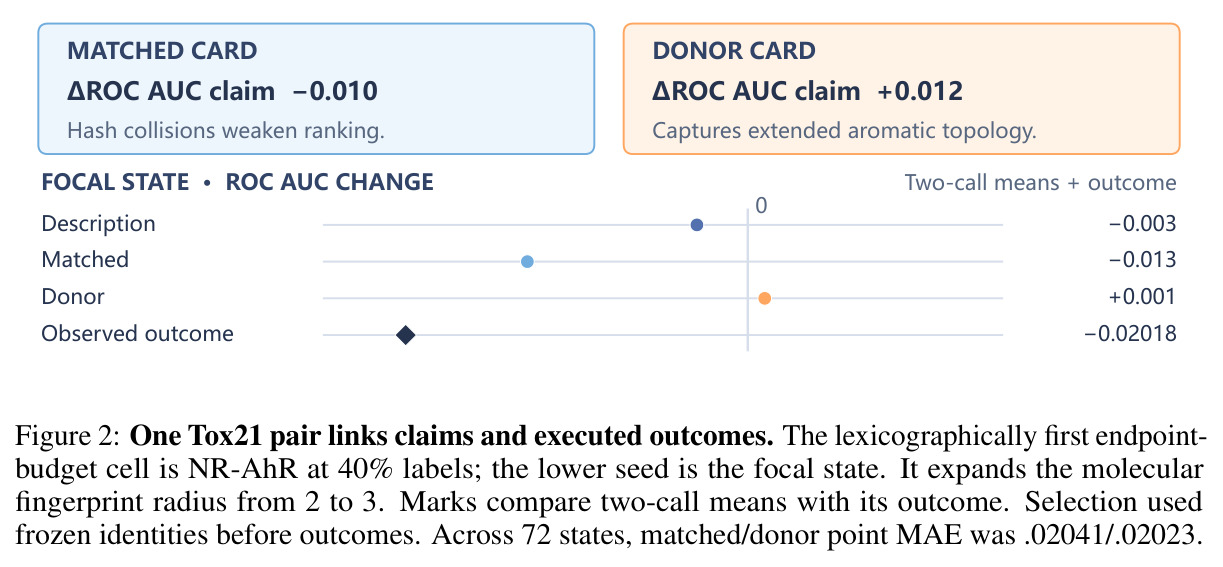
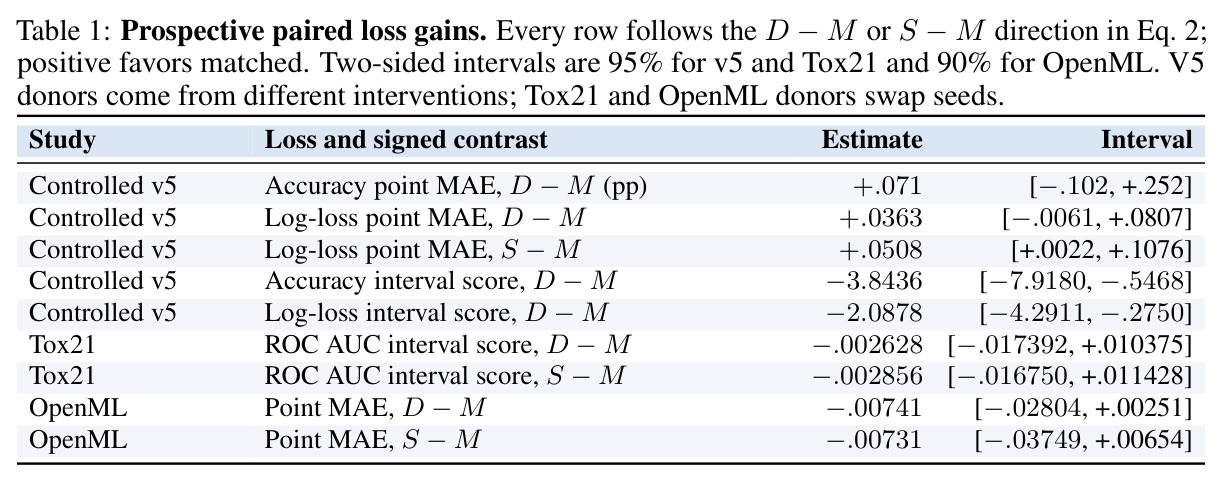
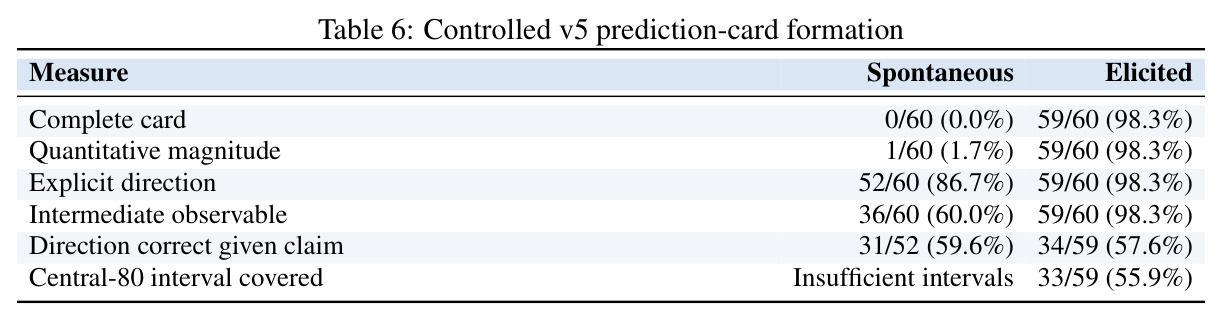
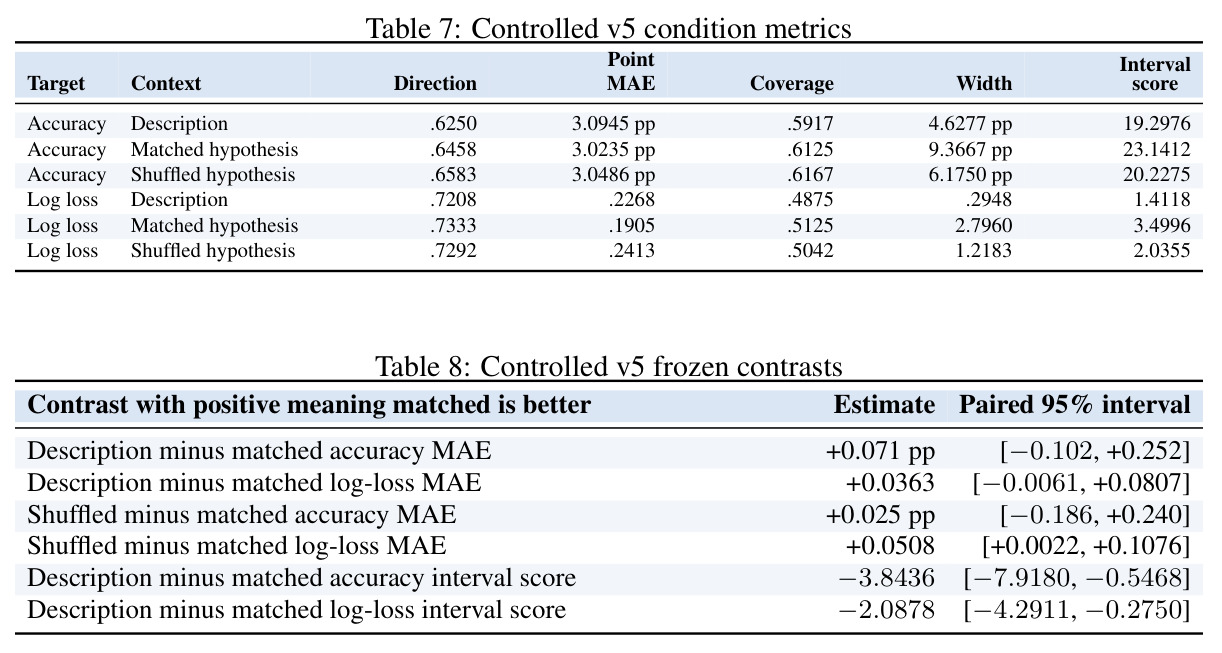
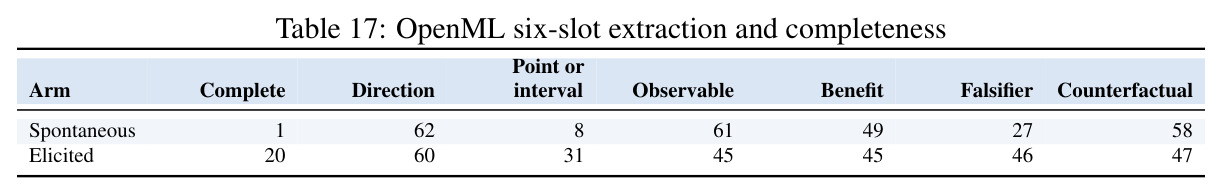
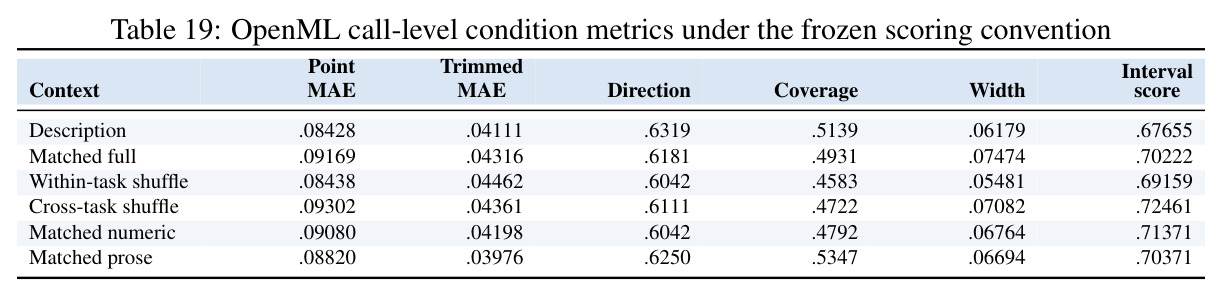
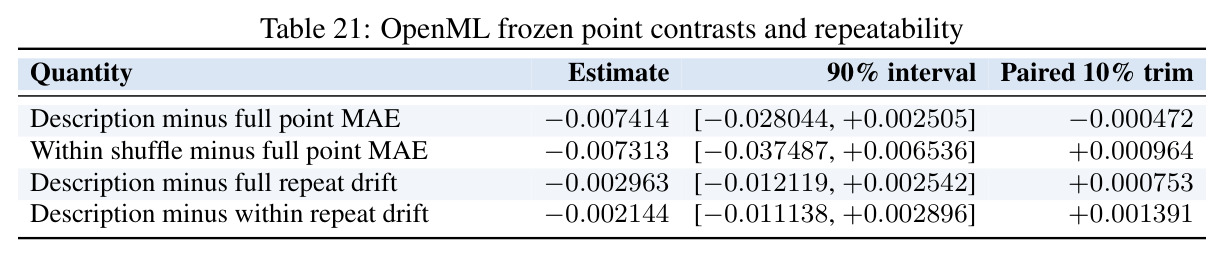
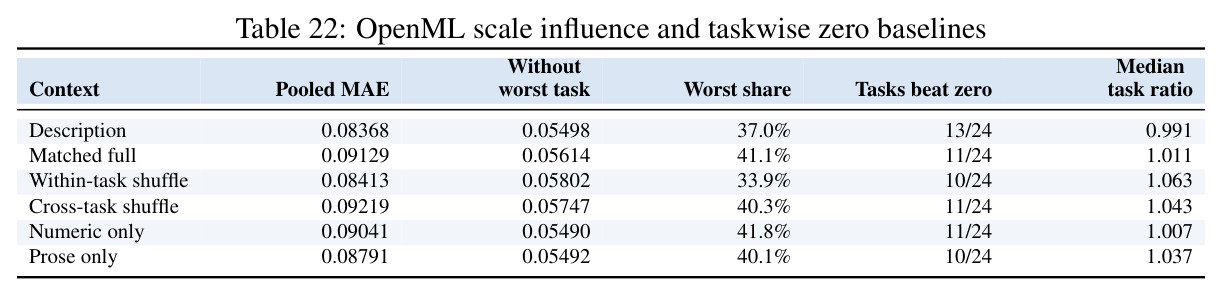
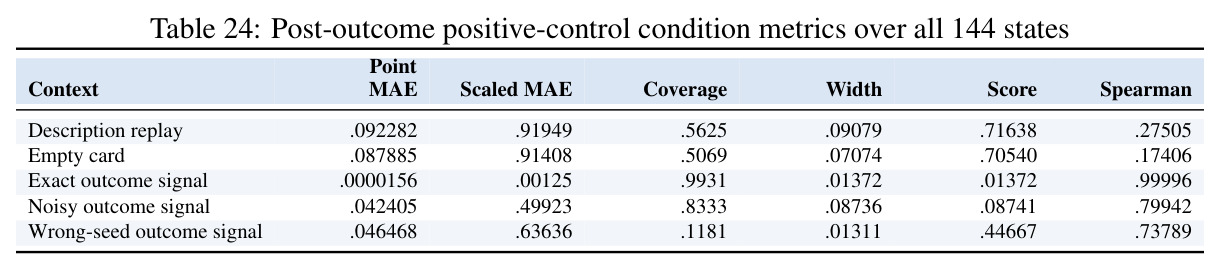
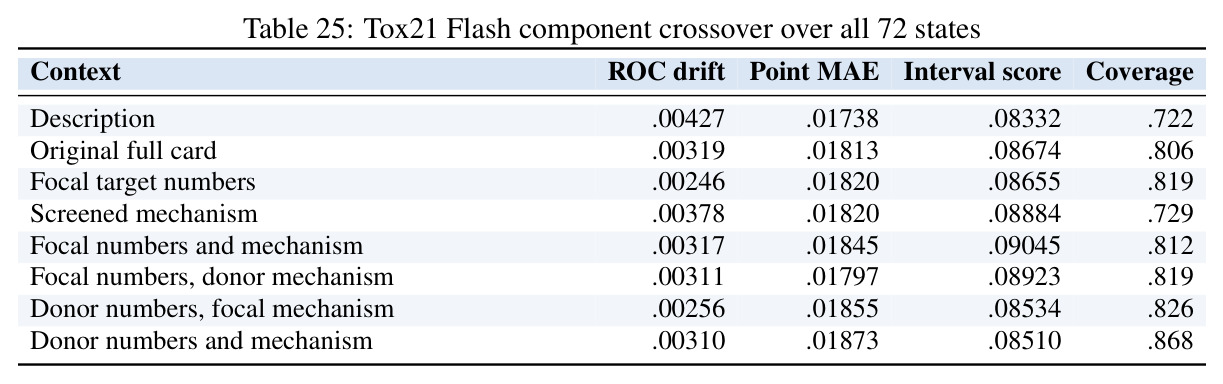
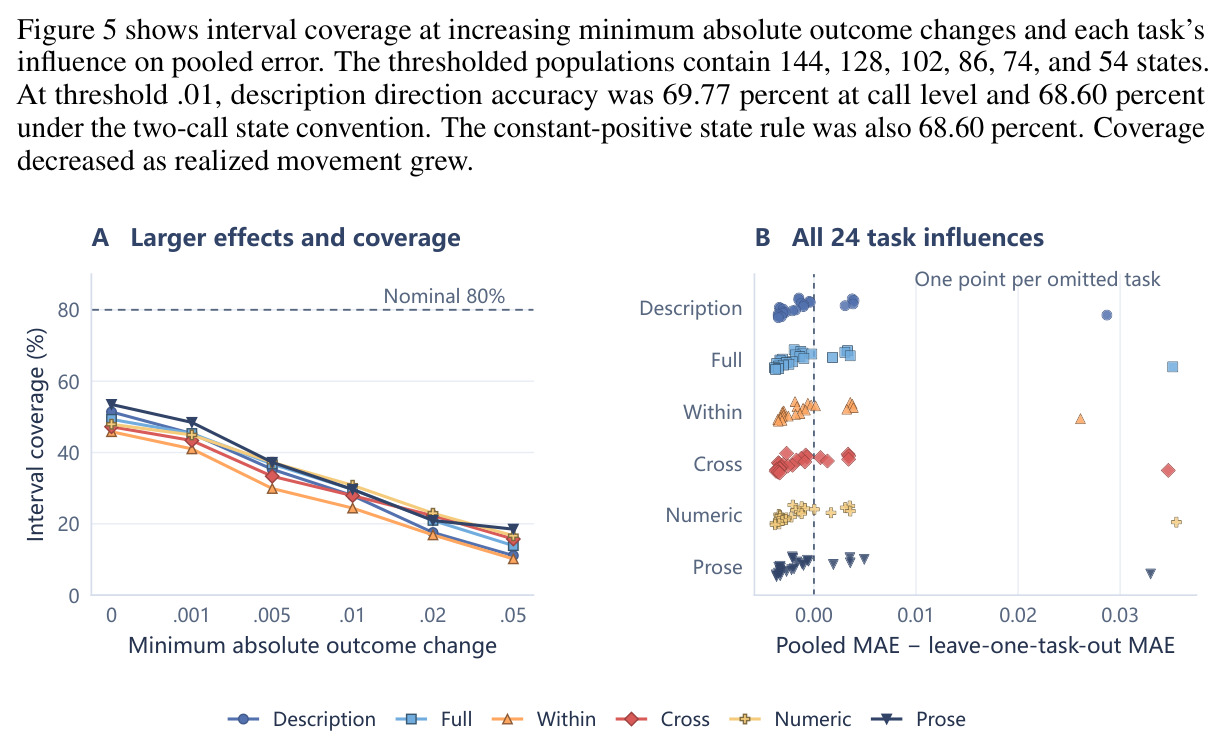
总体结论:自然解释的预测功劳在测试分辨率下未获证实,结构化卡片唯一稳定的效应是降低重复漂移。①受控 v5 判定 inconclusive:匹配 log-loss 点 MAE .1905 好于描述 .2268 与供体 .2413(供体−匹配 +.0508,[+0.0022, +0.1076],唯一显著的供体分离),但两个区间评分显著劣于描述(accuracy 19.30→23.14、log-loss 1.41→3.50);②Tox21 主检验未达 harm 门限:$D-M=-.0026$,95% CI $[-.0174, +.0104]$,远低于要求的 .005,判 confirmation no go;次要结果漂移 .01004→.00357(−64.5%)/.00411(−59.1%),点 MAE 三者 .02056/.02041/.02023 几乎无差;③Flash 重放复现漂移下降(−60.6%/−59.2%)但匹配 MAE 从 .01823 恶化到 .02020,九门过八,唯一失败是区间评分等效性越界 ±.010;④OpenML 全卡把区间宽度扩大 21%(.06179→.07474)而覆盖仅 49.3%(名义 80%),78/144 卡是空骨架,点 MAE $D-M=-.00741$,判 no go;⑤直接文本 Flash 交付全部 144 注释仍无匹配点精度增益(.08257/.08311/.08197);⑥阳性对照证明工具灵敏:真机制注释 MAE 3.795 vs 描述 6.391(−2.596 pp)vs 假机制 8.151;精确信号 144/144 胜、Spearman .99996;⑦方向预测基本是符号先验:v5 111 个显式方向中 109 个预测改进(58.6% vs 恒正基线 57.7%),OpenML 63.19% vs 62.5%。
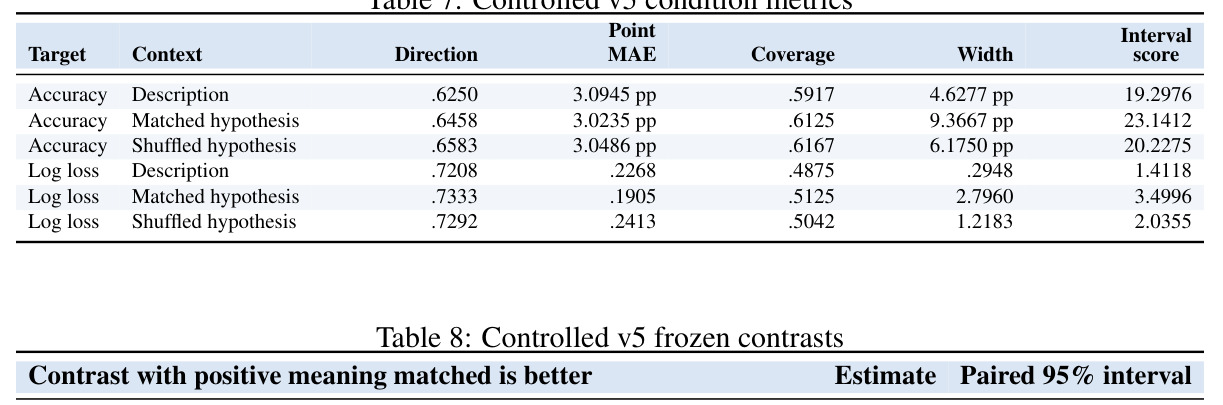
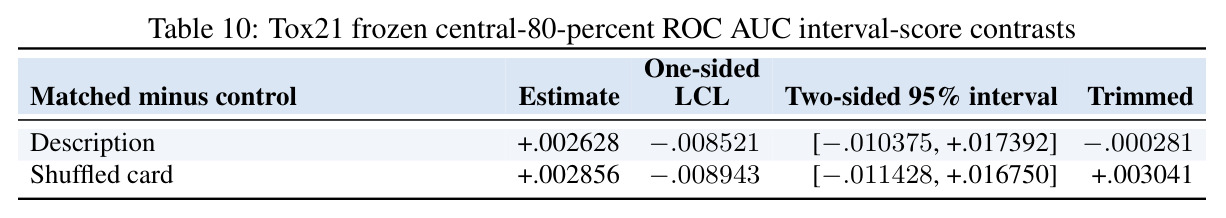
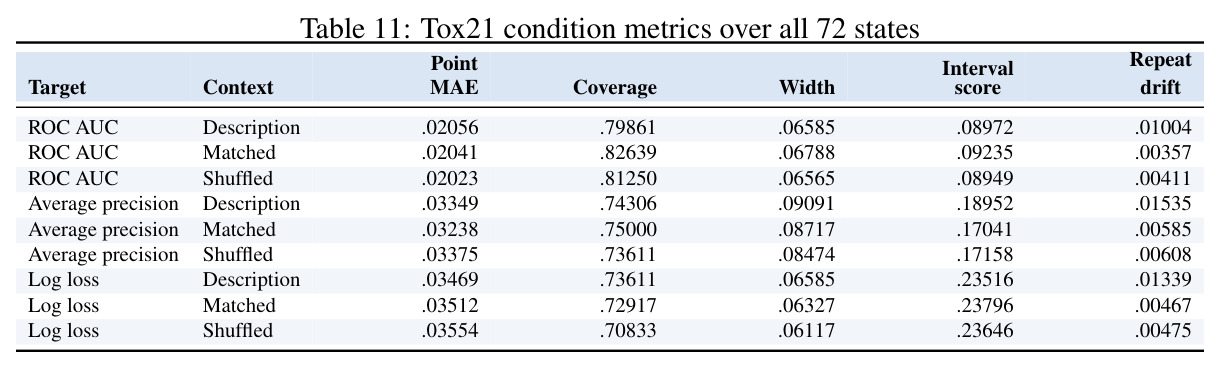
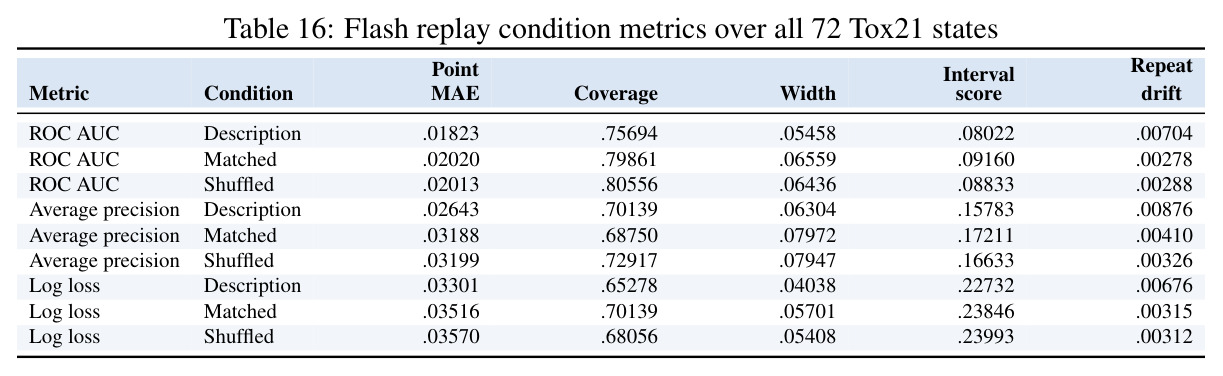
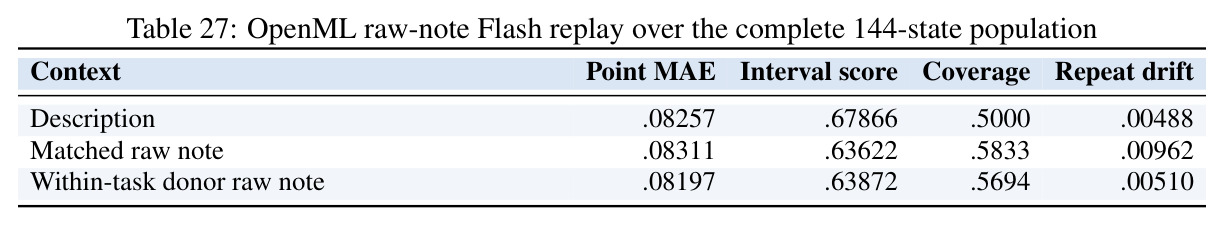
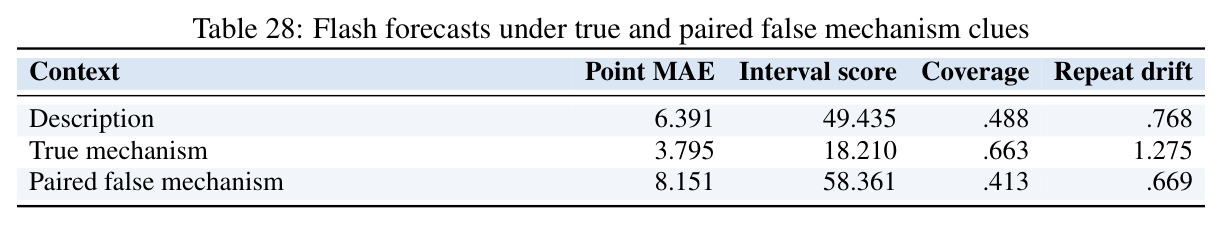
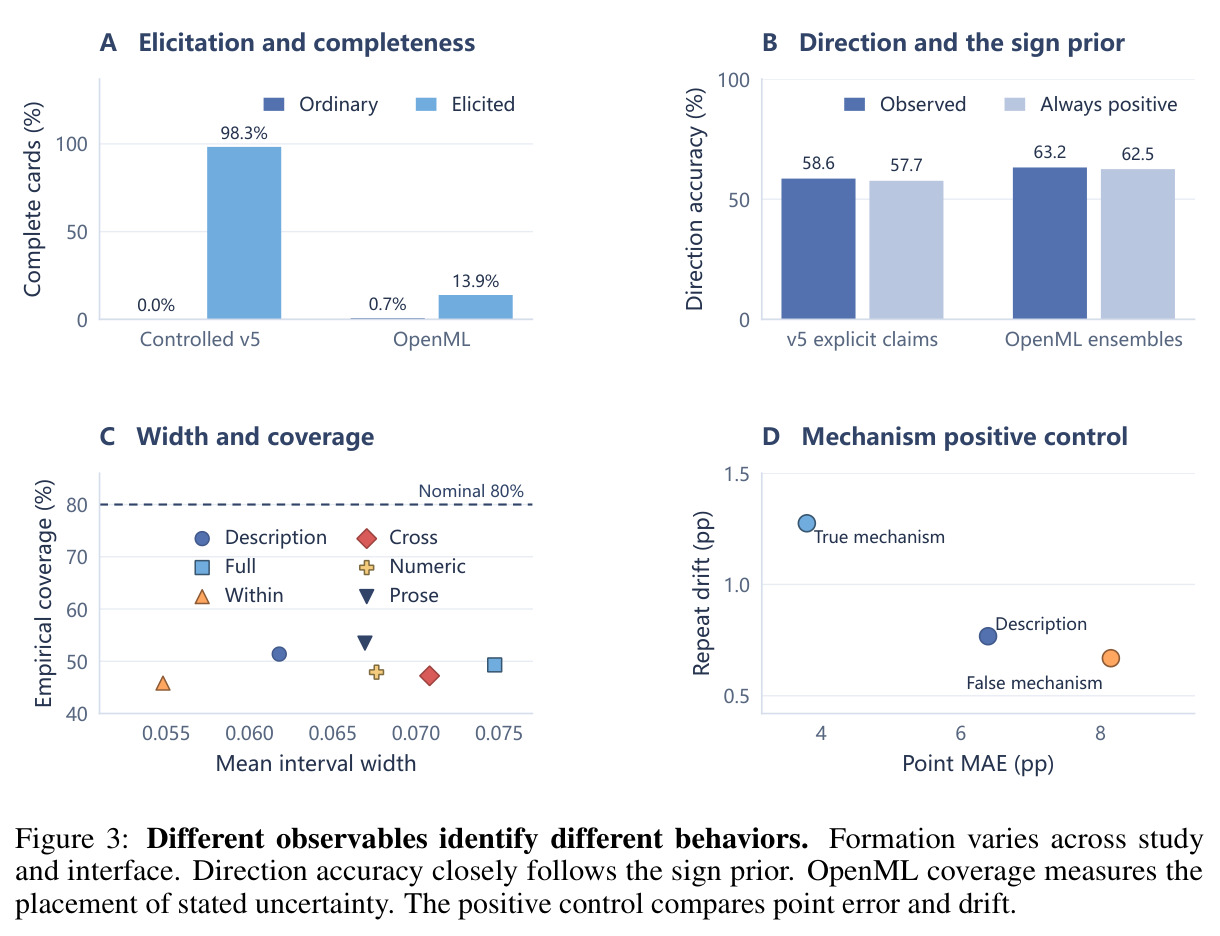
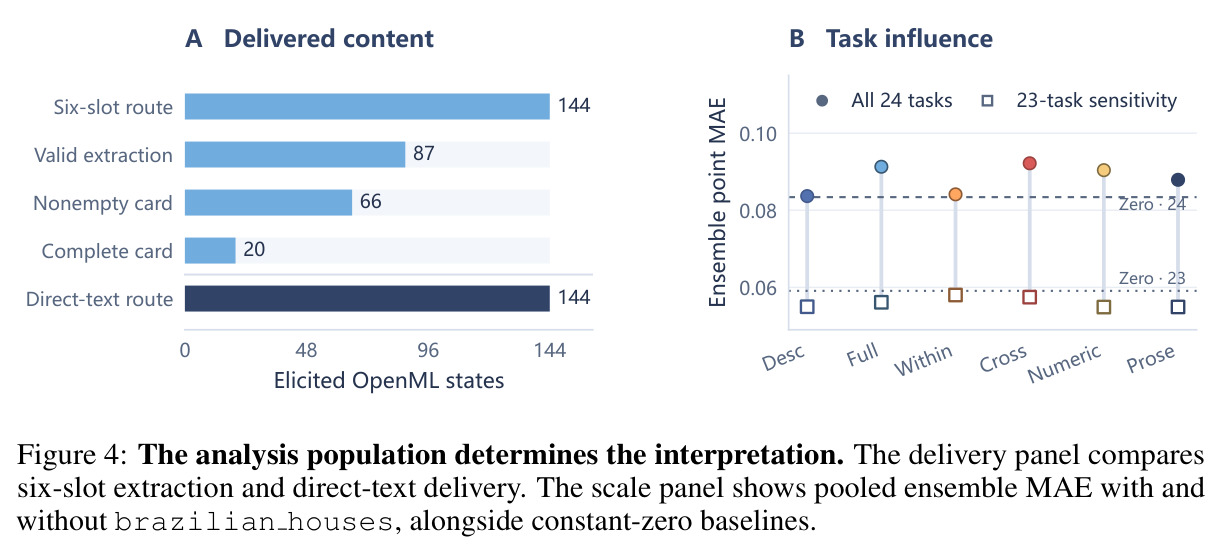
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Tox21 预注册主检验(harm 规则) | ROC AUC 区间评分(80% 中央区间,越低越好) | D−M = −.002628,95% CI [−.017392, +.010375];M−S = +.002856 | 冻结门限要求 M−D 与 M−S 均 ≥ .005 且单侧下界为正 | 未达标(confirmation no go):匹配卡未表现出区间预测增益 |
| Tox21 次要重复漂移(DeepSeek V4 Pro) | 两次调用点预测差 |ŷ₁−ŷ₂|(ROC AUC 单位) | 匹配卡 .00357,供体卡 .00411 | 描述上下文 .01004 | 漂移降低 64.5% / 59.1%(唯一稳定的正效应) |
| Tox21 Flash 重放(432 调用) | 点 MAE、漂移、区间评分等效性 | 匹配 MAE .02020,漂移降低 60.6%;九门过八 | 描述 MAE .01823;区间评分等效边际 ±.010 | 漂移复现下降,但点精度恶化,区间评分等效性未过([−.008096, .014485] 越界) |
| OpenML 预测卡片指派 | 区间宽度 / 覆盖率(名义 80%) | 宽度 .06179→.07474(+21%),覆盖率 49.3% | 描述上下文覆盖率 51.4% | 宽度显著变宽但欠覆盖未改善(覆盖差 −2.08 pp [−6.25, +2.08]) |
| OpenML 点精度(144 状态) | 任务分层点 MAE | 匹配全卡 .09169(调用级);集合口径 .09129 vs 零预测基线 .08341 | 描述上下文 .08428(调用级) | D−M = −.00741 [−.02804, +.00251],无增益且区间越过等效边际 |
| 六槽卡片引出 | 完备卡片比例 | v5 引出 59/60(98.3%);OpenML 引出 20/144(13.9%) | v5 自发 0/60;OpenML 自发 1/144(0.7%) | 完备率 +98.3 pp / +13.2 pp(单侧 95% 下界 6.9 pp),但均未达冻结形成门限(.50) |
| 机制阳性对照(40 配对状态) | 点 MAE(准确率百分点) | 真机制 3.795 | 描述 6.391;假机制 8.151 | 较描述降低 2.596 pp [2.314, 2.880];较假机制降低 4.355 pp [4.048, 4.654] |
| 精确信号校准(144 OpenML 状态) | 状态胜率 / Spearman 相关 | 144/144 状态胜出,Spearman .99996,MAE .0000156 | 描述重放 MAE .092282;错种子信号 MAE .046468 | 冻结判定 assay sensitive:预测器对已知信号完全灵敏 |
局限与改进
作者承认:在测试的供体分辨率下自然解释的预测功劳未获证实,Tox21 与 OpenML 判定 no go,Flash 区间评分等效性未过;卡片交付率低(66/144 非空、20/144 完备)使内容对比只在小子集上有定义;两次 Flash 运行在同一刺激上全卡漂移幅度不同(.00108 vs .00426),提示运行间方差可观。我的补充观察:第一,供体对照分辨率太粗——Tox21 换种子对的结局中位差 .01362(27/36 同号)、OpenML 为 .01504(54/72 同号),与点 MAE(约 .02)同量级,即使解释携带状态特异信息也容易被噪声淹没;第二,结局效应本身偏小(OpenML 中位 |skill 变化| .0236),且 brazilian houses 一个任务占聚合误差 37.0–41.1%,总体结论脆弱;第三,解释由 DeepSeek 生成又由同族模型消费,功劳为负可能反映"生成–消费"错配或家族内偏差,外部效度未知;第四,卡片提取本身有损(引出臂有效率仅 60.42%),直接文本与六槽两条管道结论不同,说明"解释表示"是尚未分离的混淆变量。
独立分析的弱点
弱点一:统计功效与效应量不匹配。±.010 的等效性边际配上 72/144 个状态,意味着只有巨大效应才可判定,改进方向是扩大状态池(更多端点/任务/种子)或采用序贯设计。弱点二:供体对照信息量低。Tox21 的 36 对种子供体中仅 13 对双方卡片都有内容,OpenML 仅 1 对双方都有数量主张,"对齐"检查实际可分辨的案例极少;改进方向是构造对抗性供体(同任务反事实解释、逐槽删改的卡片)形成从完全匹配到完全不匹配的梯度对照。弱点三:空骨架与提取损失。78/144 张空卡说明强制结构化反而稀释内容,且引出臂提取有效率仅 60.42%;改进方向是让预测器直接消费原文(直接文本臂已显示可行)并把提取错误纳入敏感性分析。弱点四:单模型族闭环。生成与预测都用 DeepSeek V4 系列,结论可能是模型族特异的,应做跨家族(不同生成者 × 不同预测器)复制。弱点五:聚合指标被单一任务主导(brazilian houses 占 37–41% 误差),任务级比值与留一分析目前只是诊断,应升级为预设主分析。
未来方向
作者提出的方向:把配对预测检查作为科研智能体基准的评分组件——只有通过检验的预测器才能参与成本感知效用排序,用于选择性价比最高的实验;冻结的预测记录可复用于基准再分析、科学预测与实验选择方法研究。基于本文成果可延伸:其一,跨模型解释交换(生成者 A 的解释交给预测器 B),检验功劳是否模型族特异;其二,供体梯度设计——组件交叉已暗示数值槽比机制散文更有用(纯数字漂移降低 .00181 [.00005, .00383] 显著,固定数字时换供体机制的 MAE 差仅 −.00047 [−.00228, .00104]),可逐槽定位携带信息的成分;其三,把六槽卡片作为智能体训练的显式目标,联合优化解释质量与预测增益;其四,把协议迁移到效应量更大的真实科研域(湿实验室、AI Scientist 管道)重新检验;其五,结合语义熵等不确定性估计,修复 49.3% 对名义 80% 的严重欠覆盖。
复现评估
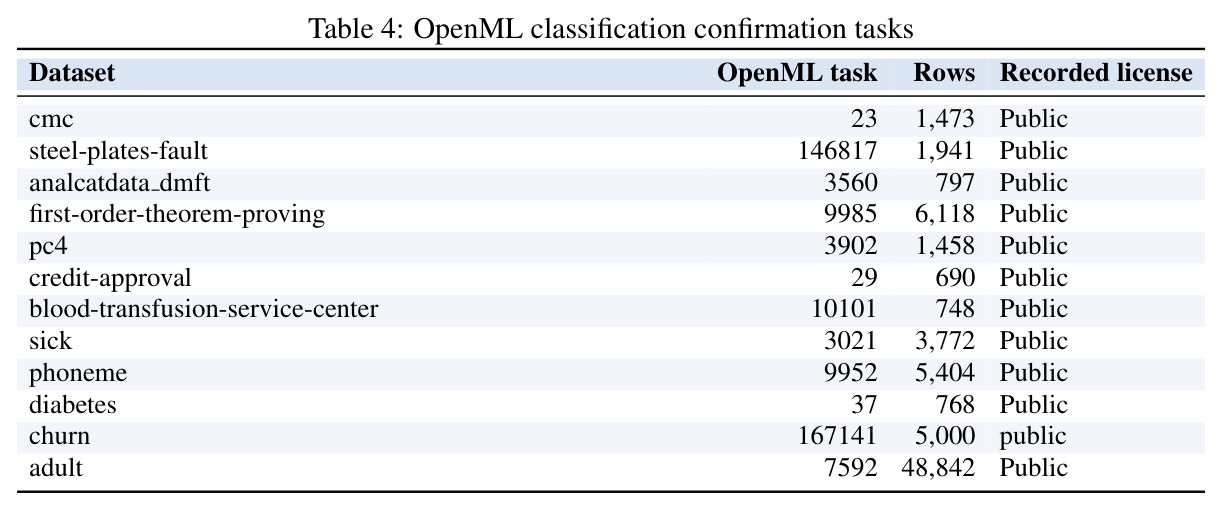
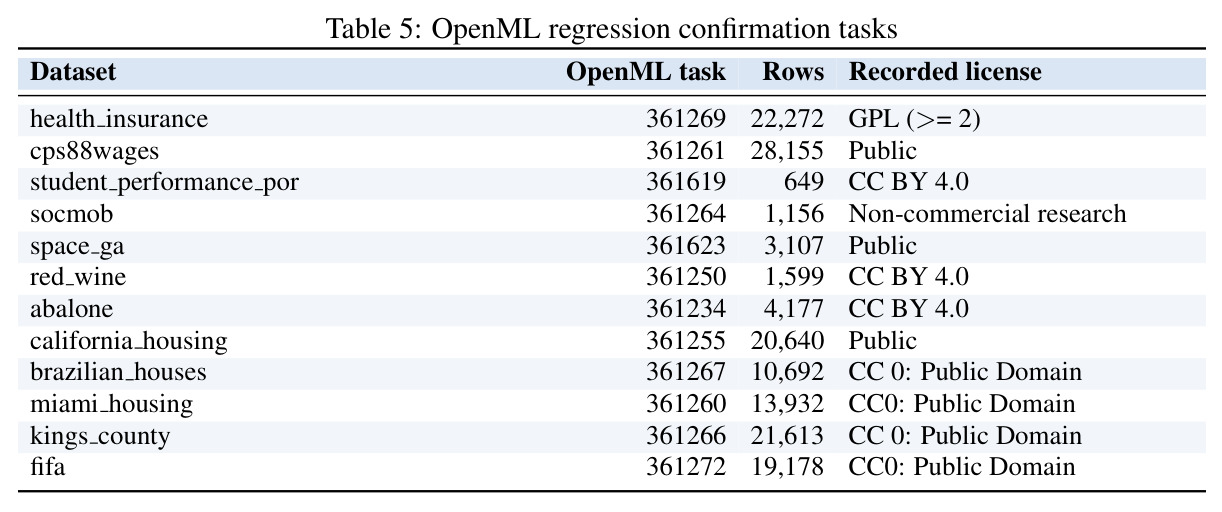
复现条件良好。数据全部公开:Tox21 来自 MoleculeNet,OpenML 任务取自 CC18/CTR23(论文表 4/5 列出全部 24 个任务的 OpenML task ID、行数与许可字符串);附录 A 给出供体规则、循环指派公式、冻结门限与数据划分,作者声明保留首次响应、源快照、冻结报告与精确划分供审计。算力需求很低:所有 LLM 调用经 DeepSeek 的 Anthropic 兼容端点(v4-pro 与 v4-flash),重建的成功用量成本合计约 20 美元(v5 $6.01、Tox21 $2.87、OpenML $9.59、Flash 重放 $0.50),另需执行 336 个轻量训练实验(逻辑回归/LightGBM)产生结局。主要工程负担是忠实重建"先冻结后揭晓"的时序与事件台账。论文自述 LLM 深度参与了编排、分析与写作,仓库另有工件清单。总体难度中等:协议细节完备、成本可忽略,但时序纪律是结论有效性的前提。
论文图表