PivotOPD:学习从多轮智能体的关键错误中恢复 PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents
在关键错误处施加预防性蒸馏、在其后施加恢复性蒸馏,让多轮智能体学会避免并从关键错误中恢复。
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
学生模型自己采样轨迹,教师模型在这些学生生成的响应上提供逐 token 的密集监督(通常是最小化学生与教师分布的 KL 散度),而不是只在轨迹结束时给一个稀疏的结果奖励。常见实现是让冻结的学生在特权提示(如答案)条件下充当自己的教师,即特权自教师。
本文的出发点就是标准 OPD 在多轮场景下修不好关键错误,PivotOPD 是对 OPD 的针对性扩展,理解 OPD 的机制才能看懂预防/恢复两项蒸馏改了什么。
前向 KL 与反向 KL
前向 KL $D_{KL}(q\|p)$ 的期望在被模仿分布下取,是 mass-covering(覆盖模式),会迫使学生给教师所有高概率行为分配概率;反向 KL $D_{KL}(p\|q)$ 的期望在学生分布下取,是 mode-seeking(追逐模式),只影响学生已采样的响应。
PivotOPD 的核心机制就是按监督落点选方向:预防蒸馏在学生已采样的响应上用反向 KL,恢复蒸馏在自教师生成的响应上用前向 KL,两者的分工是全文理论分析的骨架。
组相对强化学习(GRPO / group-based RL)
对每个任务从同一初始状态采样 $G$ 条轨迹,用组内结果奖励的均值归一化得到组相对优势 $A_{RL}$,再用 PPO 裁剪代理目标更新策略。当一组内所有轨迹都失败(或都成功)时,组相对优势恒为零,不提供任何学习信号。
PivotOPD 建立在组相对 RL 之上,蒸馏优势作为逐 token 附加项并入同一次 PPO 更新;而全组失败时优势为零正是恢复蒸馏要补的信号缺口。
特权自教师(Privileged Self-Teacher)
把冻结的学生模型在额外特权信息(如金标准动作提示 $h(a)$)条件下运行,得到一个与学生只差这点信息的教师版本;用它重打分学生的响应或生成训练目标,使蒸馏目标保持在学生自身的推理风格之内,测试时特权信息完全移除。
PivotOPD 的全部 token 级蒸馏目标都来自被提示了金标准/恢复动作的冻结学生,而不是外部大模型,这是它避免教师风格迁移问题的关键设计。
关键错误与剩余最优轨迹(Pivotal mistake, $L(s_t)$)
$L(s_t)$ 表示从潜在状态 $s_t$ 完成任务所需的最少轮数(任务不可解时为 $\infty$)。若某轮提交的动作使 $L(s_{t+1}) > L(s_t)$,该动作就是关键错误,该轮为关键轮。ALFWorld 的符号 oracle 可精确计算 $L$,但绝大多数环境没有 oracle,只能靠教师模型事后阅读轨迹来估计。
这是全文诊断与方法的核心概念:pivot detection 检测的就是它,预防蒸馏针对它,恢复蒸馏训练它之后的状态。
研究动机
多轮交互中,智能体的每个动作都会改变环境状态并决定后续可选动作,一个错误动作会让之后遇到的状态全部出自自己的错误,误差跨轮累积。作者在 ALFWorld 上利用符号 oracle(可精确计算任一状态到完成任务的剩余最优轨迹长度 $L(s_t)$)诊断三个 Qwen3 模型(8B、30B-A3B、235B-A22B):262 条失败轨迹中 155 条(59%)包含关键错误,即满足 $L(s_{t+1})>L(s_t)$ 或使任务不可解的动作;首个关键轮中位数出现在第 8–12 轮(30 轮上限),之后模型平均再浪费 18–21 轮仍不恢复。训练方法层面问题更尖锐:标准 OPD 训练 Qwen3-8B 120 步后,总失败率从 79% 降到 56%,但关键轮后失败仅从 51% 降到 49%;蒸馏把已提交错误动作的概率中位数从 0.999 压到 $10^{-5}$ 以下,oracle 动作概率在每个关键轮却仍低于 $10^{-2}$——8 条一组几乎采不到一次,学生在自己错误创造的状态上完全没有直接学习信号。
本文的目标是本文要让多轮智能体同时学会两件事:预防关键错误,以及从关键错误造成的状态中恢复。具体约束与目标包括:(1) 不依赖环境 oracle——大多数环境没有 ALFWorld 那样的符号 oracle,需要通用的关键轮检测机制;(2) 在关键轮提供指向金标准动作的密集 token 级监督,把学生从已提交的错误动作上拉开;(3) 在关键轮之后的若干轮训练恢复动作,尤其是学生自身分布几乎不覆盖的恢复行为——这正是组相对 RL 和反向 KL 都给不出信号的地方;(4) 把这些信号与组相对 RL 融合进单一 PPO 更新,推理路径不变,测试时不增加任何教师、提示或回放开销;(5) 在具身家务、网页购物、搜索问答、真实软件工程四个领域和 Qwen3、Nemotron 两个模型家族上验证有效性。
与已有工作不同的是,已有工作的共同盲区是只在学生自己采样的响应上学习:多轮 OPD 变体(TurnOPD、TCOD、SOD、StepOPSD、AgentOPSD)通过重加权轮次或课程化蒸馏深度缓解误差累积,OPID 和 PivotRL 把训练集中到决定结果的轮次或技能上,但都给不了学生几乎不采样的动作任何概率质量。本文的独特切入是先用 oracle 回放回答两个被搁置的问题:失败是否系于单个决定性错误(是,59%);错误后是否仍可恢复(是——保留错误、只在后续两轮强制 oracle 动作仍达 58%,而不干预只有 8%)。方法上的新颖组合有三:借鉴特权信息学习,教师只「点名」动作、由被提示的冻结学生自己生成 token 级目标;借鉴交互式模仿学习(DAgger/HG-DAgger),在学生自己到达的错误后状态上查询教师;再按监督落点精挑 KL 方向——已采样响应用反向 KL,自教师生成的响应用前向 KL。
核心方法
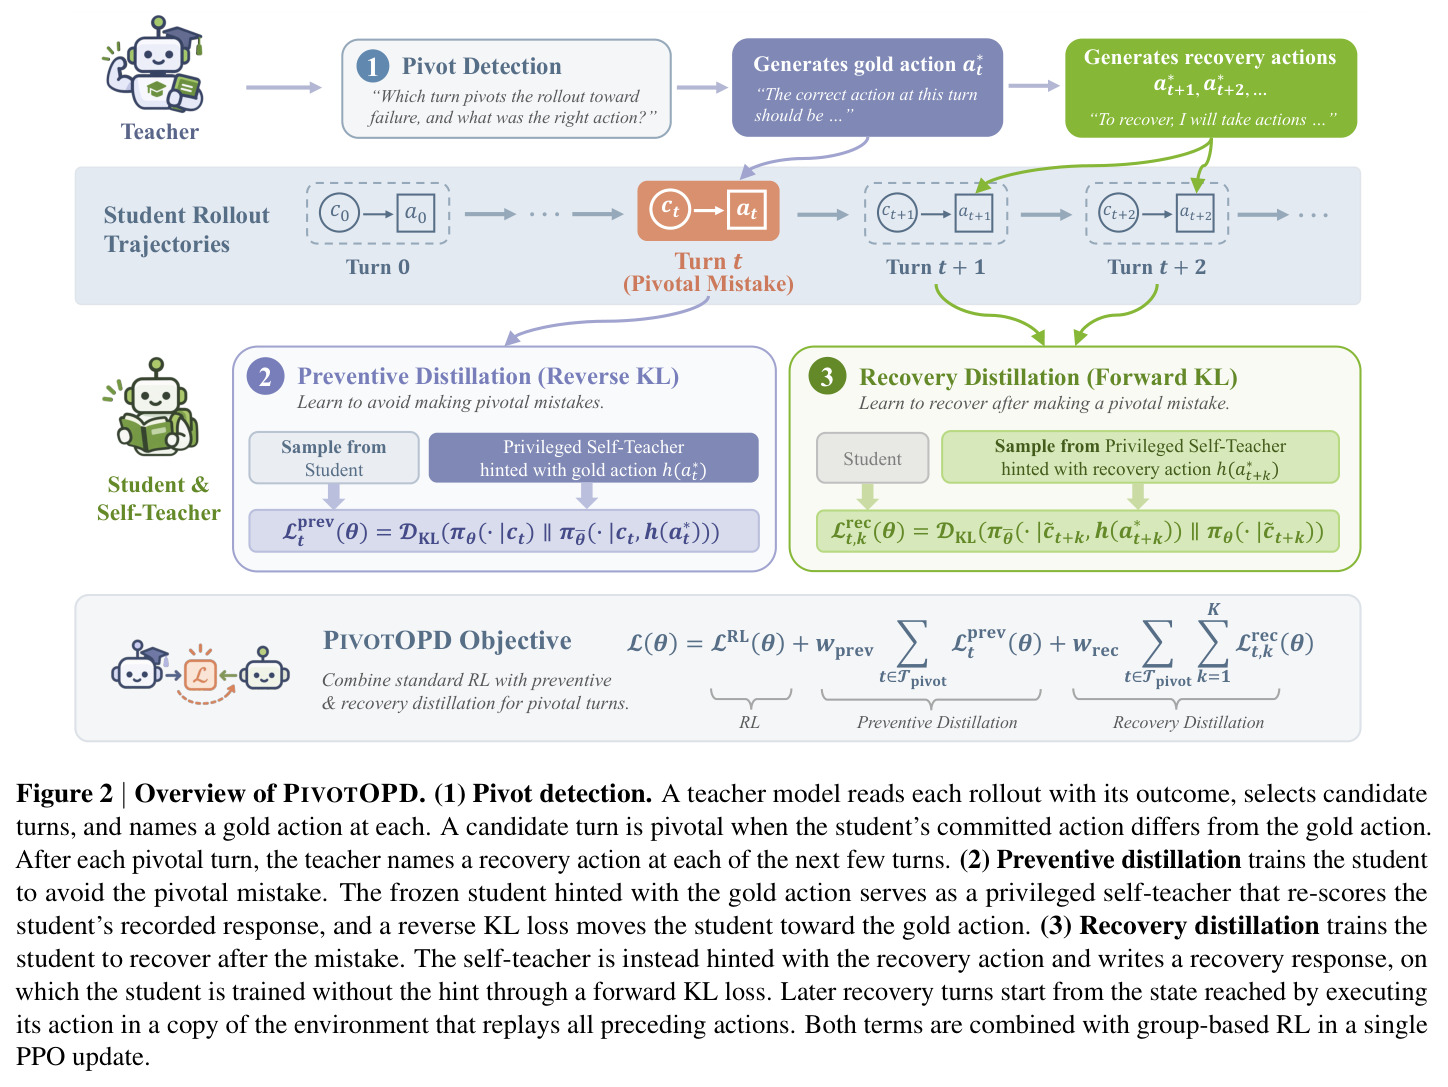
直觉:既然过半失败源于一个可恢复的关键错误,就把 OPD 的密集 token 级监督精准投放到关键轮和它之后的几轮,而不是均匀铺满整条轨迹。技术路线是在组相对 RL(PPO)上加三个组件。(1) Pivot detection:教师模型读入完整轨迹连同结果,选出最多 $m$ 个候选轮并在每轮点名金标准动作 $a^*_t\in\mathcal{A}(c_t)$;学生提交动作与之不一致($a_t\neq a^*_t$)即判为关键轮,全体构成 $\mathcal{T}_{pivot}$;对每个关键轮,教师再在最多 $K$ 个恢复轮上点名恢复动作 $a^*_{t+k}$。(2) 预防蒸馏:在关键轮,被提示了 $a^*_t$ 的冻结学生充当特权自教师,重打分学生已记录的响应,最小化反向 KL $\mathcal{L}^t_{prev}=D_{KL}(\pi_\theta(\cdot|c_t)\|\bar\pi_\theta(\cdot|c_t,h(a^*_t)))$。(3) 恢复蒸馏:自教师被提示恢复动作后写出恢复响应 $y^{rec}$,学生在无提示条件下按前向 KL $\mathcal{L}^{t,k}_{rec}=D_{KL}(\bar\pi_\theta(\cdot|\tilde c_{t+k},h(a^*_{t+k}))\|\pi_\theta(\cdot|\tilde c_{t+k}))$ 学习。三项合成单一目标 $\mathcal{L}(\theta)=\mathcal{L}_{RL}+w_{prev}\sum_{t}\mathcal{L}^t_{prev}+w_{rec}\sum_{t}\sum_{k=1}^{K}\mathcal{L}^{t,k}_{rec}$,在同一次 PPO 更新中完成。
核心创新是把「在哪里监督」与「用哪个方向的 KL」绑定,从而修复一个被形式化证明的结构性缺陷:命题 2 证明当学生给恢复动作的概率 $p(a^*)\to 0$ 时,任何在学生采样分布下取期望的更新(组相对 RL、反向 KL)在 $a^*$ 上的分量 $g(a^*)=p(a^*)(w(a^*)-\mathbb{E}_p[w])$ 都会消失;全组轨迹都失败时组相对优势恒为零;$G$ 条 rollout 中出现恢复动作的概率上界是 $Gp(a^*)$,期望要等 $1/p(a^*)$ 次采样才见一次。恢复蒸馏把采样分布换成被提示的自教师后,裁剪的期望更新 $g(a^*)\ge\delta(q(a^*)-p(a^*))>0$,其大小由教师而非学生决定——这是「前向 KL 覆盖模式、反向 KL 追逐模式」的经典对比在「错误后状态」这一新场景的精确运用。另一本质区别在教师角色:教师不写示范,只命名动作;token 级目标由提示了该动作的冻结学生(特权自教师)生成,保证目标停留在学生自己的推理风格内,规避外部教师示范的风格不匹配与分布外问题。
方法步骤详情
每个训练步五步。第一步,用当前学生对每任务采 $G=8$ 条 rollout(训练温度 1.0),按结果算组相对优势 $A_{RL}$。第二步,pivot detection:教师(1.7B 学生配 Qwen3-30B-A3B,8B 配 Qwen3.5-122B-A10B)读轨迹和结果,返回结构化报告:轨迹摘要、轨迹级教训、逐轮教训和最多 $m=5$ 个候选轮的金标准动作块;自由文本动作经四级解析(归一化精确匹配→去冠词→唯一命令包含→token 重叠阈值)映射到可行动作集;学生动作与金标准动作(小写化、折叠空白后比较)不一致的候选轮进入 $\mathcal{T}_{pivot}$。第三步,预防蒸馏:构造提示 $h(a^*_t)$(声明该动作合理、要求从零推理且不得提及提示),前向冻结学生得逐 token 蒸馏优势 $A^{distill}_\ell=\log\bar\pi_\theta(y_\ell|c_t,h(a^*_t),y_{<\ell})-\log\bar\pi_\theta(y_\ell|c_t,y_{<\ell})$,以 $w_{prev}=0.001$ 加到 $A_{RL}$ 上。第四步,恢复蒸馏:从错误后状态 $\tilde c_{t+1}$ 起向教师查询恢复动作;提示自教师采样 $y^{rec}$ 并过滤(必须提交动作、不得泄漏提示);$k<K$ 时在环境副本中重放前缀、校验观测逐字一致后执行其动作得到下一恢复上下文;每个恢复序列以裁剪到 $[-\delta,\delta]$($\delta=5$)的 $w_{rec}A^{distill}_\ell$ 为唯一优势。第五步,全部 rollout 与恢复序列(每步至多 64 个恢复)合入一次 PPO 裁剪更新;教师轨迹级教训以 $w_{traj}=0.001$ 在每一轮蒸馏。
技术新颖性
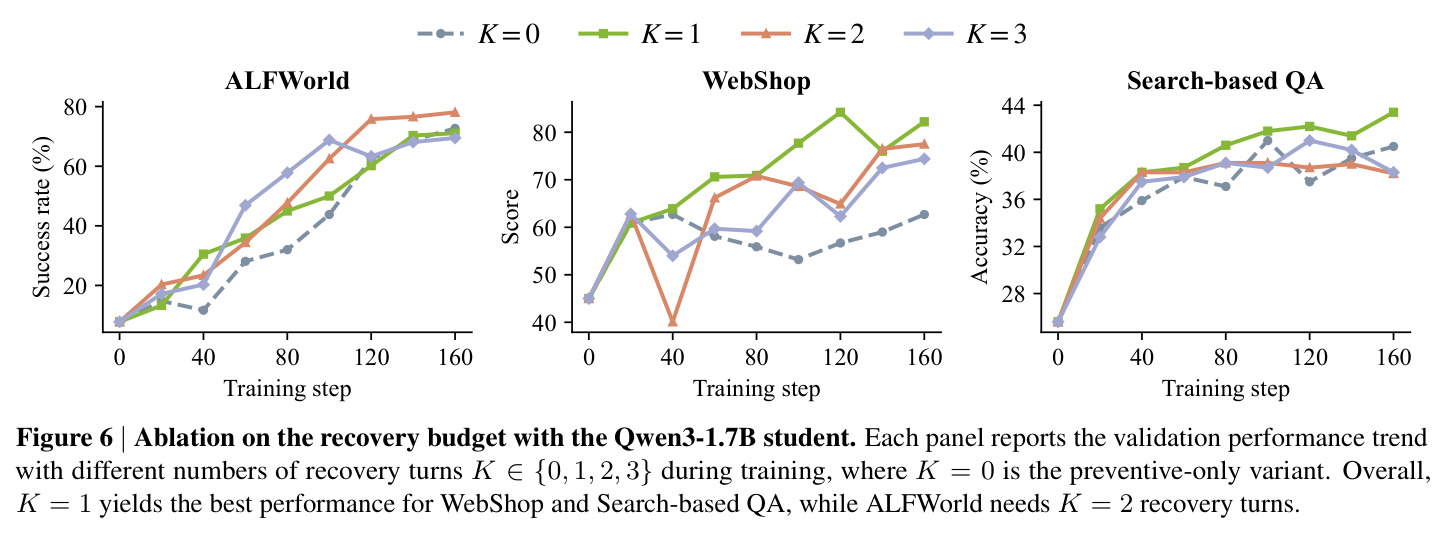
与最近邻工作的本质差异:(1) 相对标准 OPD/OPSD,监督不再均匀施加于所有响应,而是集中在检测到的关键轮,且首次在「学生自己错误创造的状态」上提供 token 级监督;(2) 相对轮级蒸馏方法(TurnOPD/TCOD/SOD/StepOPSD/AgentOPSD),它们只重加权学生采样的轮次,恢复项则在自教师生成的响应上训练,能种出学生饥饿的模式;(3) 相对 OPID/PivotRL,OPID 的轮级技能蒸馏最接近预防项,但既无恢复项,也无 KL 方向分工的理论刻画;(4) 相对 DAgger/HG-DAgger,专家不接管完整示范,只点名动作、单次提示生成即得 token 目标,成本大幅降低;(5) 相对 Agent-R/ETO/NAT/LEMA 等从失败学习方法,它们依赖结果奖励或离线修订数据,PivotOPD 在在线 RL 中即时构造错误后状态的密集监督;(6) 理论新贡献:命题 1–3 给出学习信号的形式化刻画,包括恢复损失下界 $\mathcal{L}_{rec}\ge q(a^*)\log(1/p(a^*))-\log 2$、裁剪更新正下界,以及链深度与预算的关系(剩余 $d-K$ 步链的完成概率 $\le\varepsilon^{d-K}$),为超参 $K$ 提供了原理性指导。
实验结果
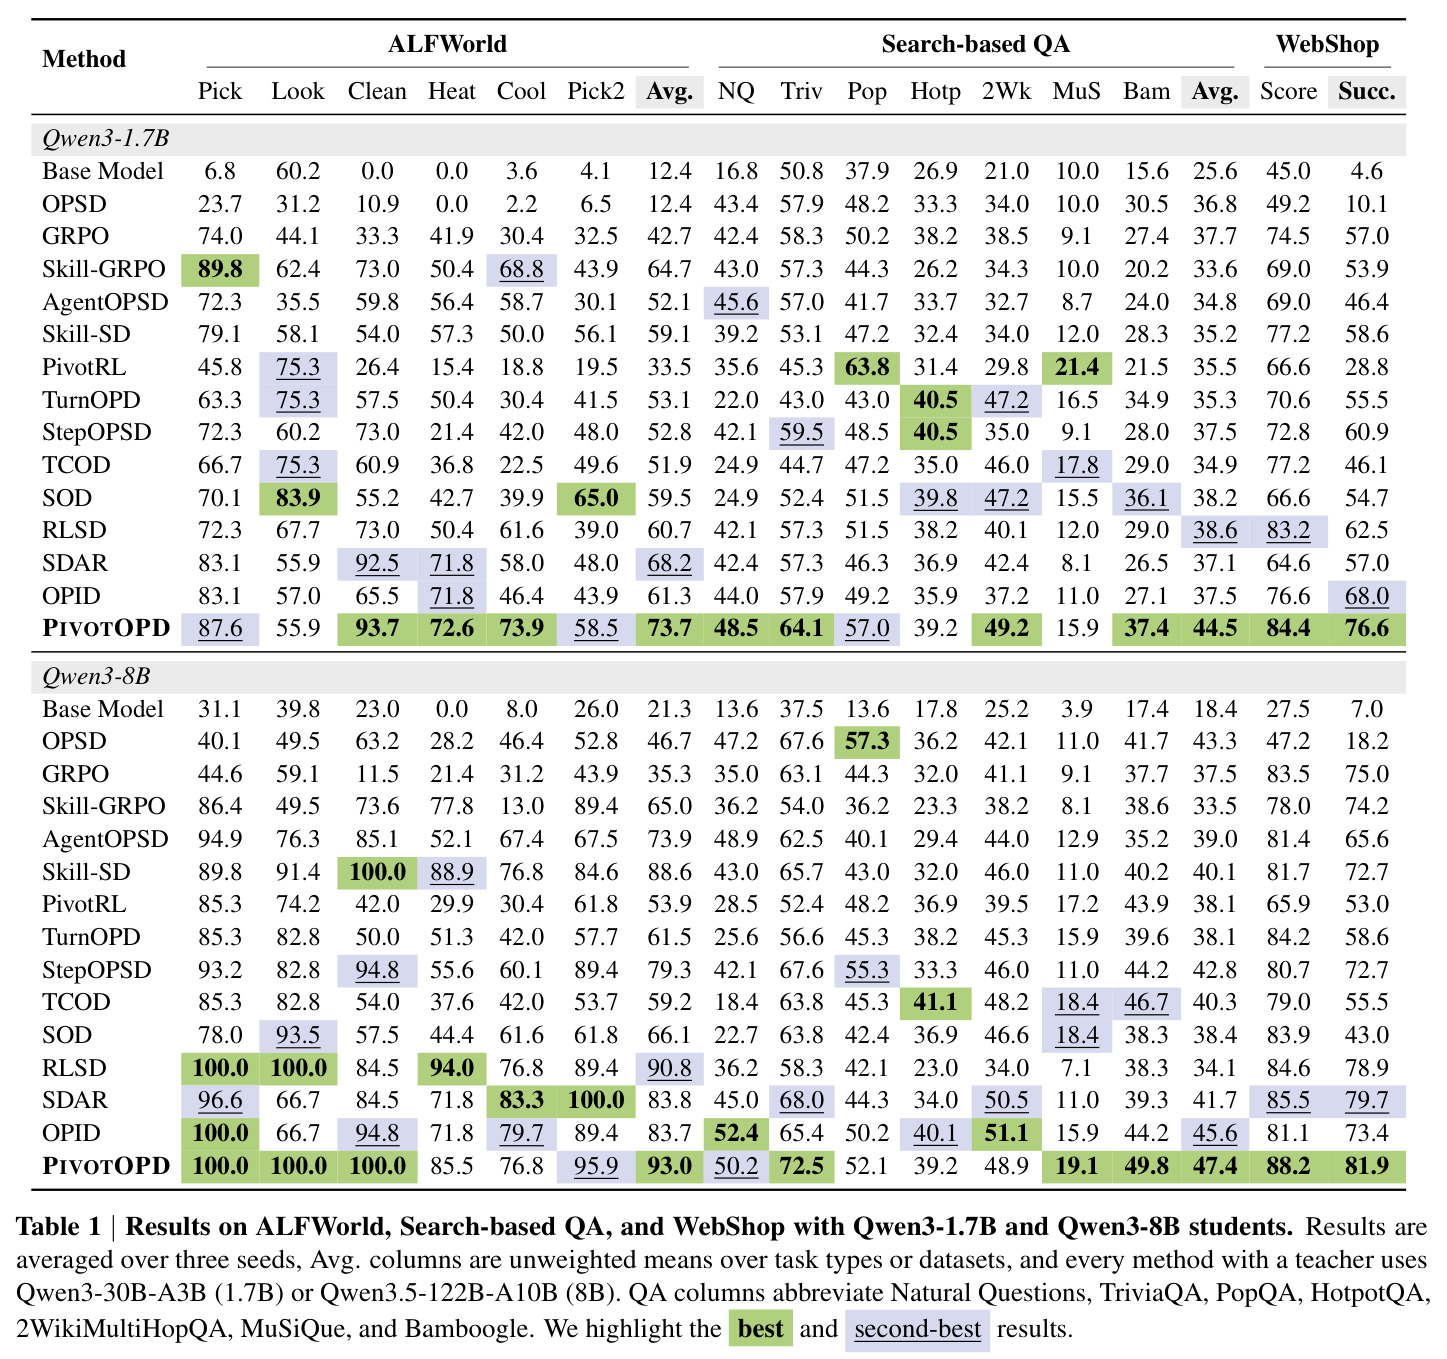
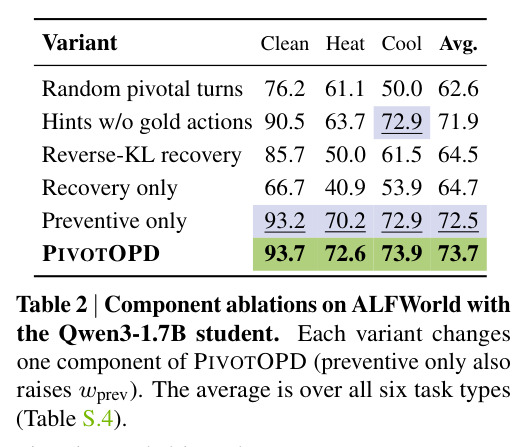
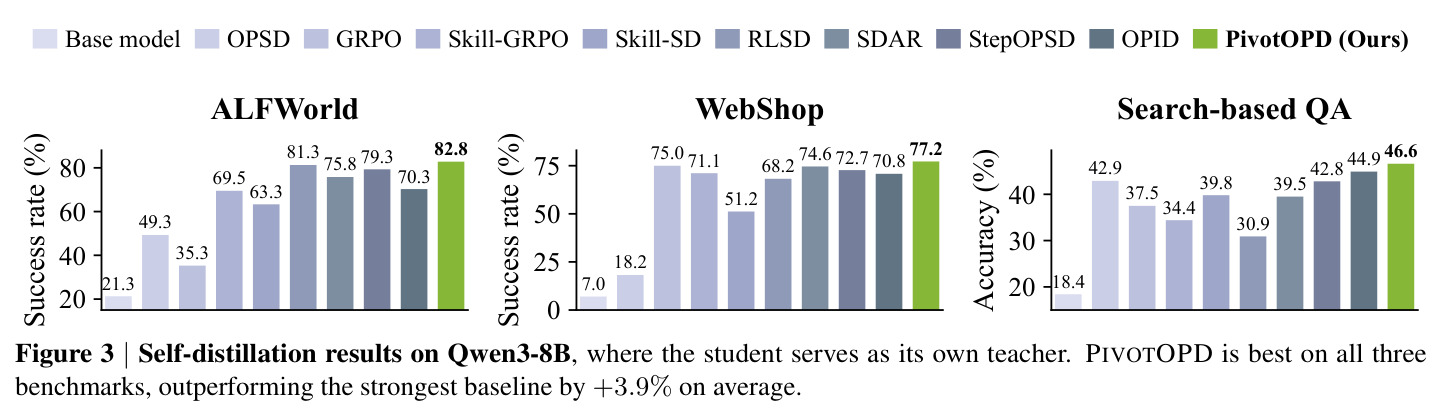
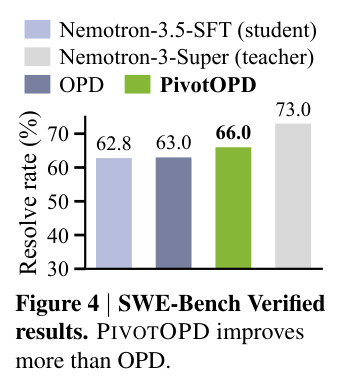
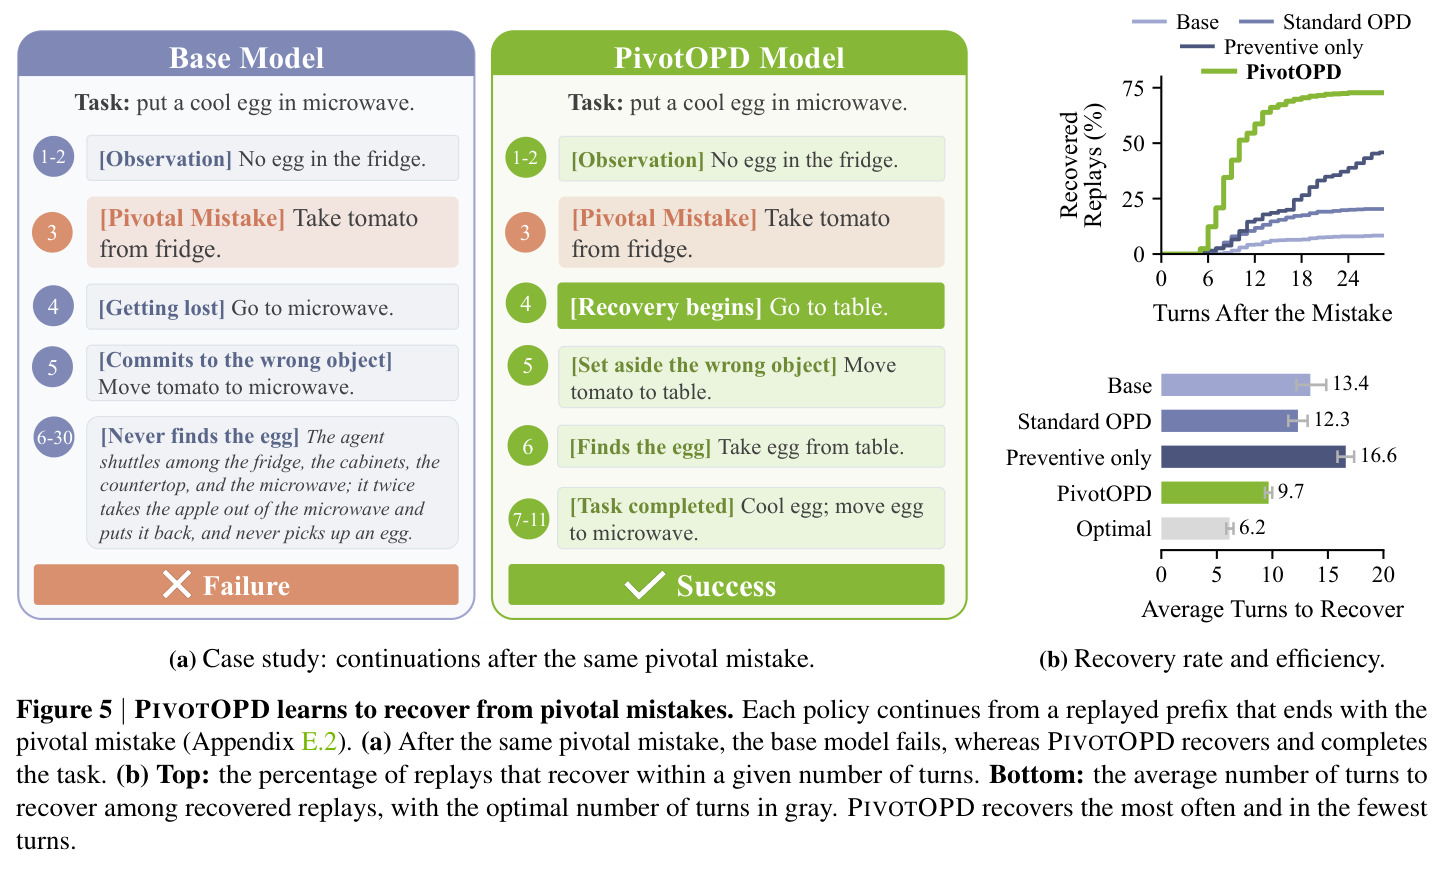
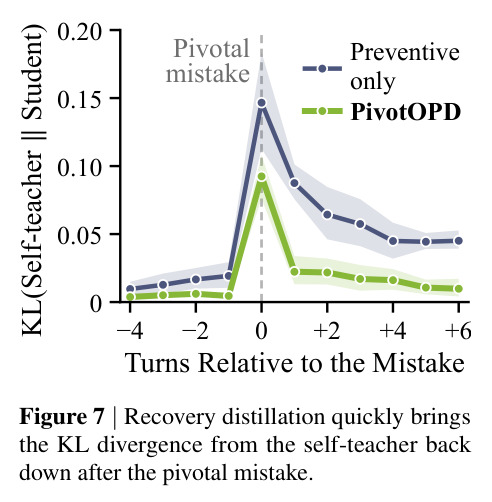
主实验对 13 个基线、3 个随机种子(Table 1):Qwen3-1.7B 学生的 PivotOPD 在 ALFWorld 六任务型平均成功率 73.7%(最强基线 SDAR 68.2%,+5.5%)、Search-based QA 七数据集平均精确匹配 44.5%(RLSD 38.6%,+5.9%)、WebShop 分数 84.4/成功率 76.6%(RLSD 83.2/62.5);Qwen3-8B 学生 ALFWorld 93.0%(RLSD 90.8%)、QA 49.8%(TCOD 46.7%)、WebShop 88.2/81.9,八个均值全部第一,且在 base 模型最难解的 Clean/Cool/Heat 上对 GRPO 提升最大。WebShop 上分数只高 1.2% 而成功率高 14.1%,支持「恢复蒸馏把部分完成变成真正完成」的机制解释。自蒸馏设定(学生自任教师,Figure 3):三基准全部最优,平均超最强基线 +3.9%,说明收益主要来自干预位置与方式而非教师容量,但 ALFWorld 比强教师版低约 10%。跨家族迁移(Figure 4):Nemotron-3.5-SFT 在 SWE-Bench Verified 解析率 +3.2%(62.8%→66.0%),标准 OPD 仅 +0.2%,教师 73.0%。恢复能力(Figure 5b,72 个 oracle 关键错误各重放 8 次):最终恢复率 Base 8.3%、标准 OPD 20.3%、仅预防 45.8%、PivotOPD 72.7%(约为 base 的 9 倍、比仅预防 +26.9%),平均恢复轮数 9.7 对最优 6.2;逐错误配对比较改善 60/72、零恶化。消融(Table 2):随机轮提示 62.6、无金标准动作 71.9、反向 KL 恢复 64.5、仅恢复 64.7、仅预防 72.5,完整方法 73.7。KL 追踪(Figure 7):错误后仅预防变体与自教师的距离至少是 PivotOPD 的两倍,且差距延伸到未训练的后续轮,说明恢复能力可泛化。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld(Qwen3-1.7B) | 六任务型平均成功率 | 73.7% | 最强基线 SDAR 68.2% | +5.5% |
| ALFWorld(Qwen3-8B) | 六任务型平均成功率 | 93.0% | 最强基线 RLSD 90.8% | +2.2% |
| Search-based QA(Qwen3-1.7B) | 七数据集平均精确匹配 | 44.5% | 最强基线 RLSD 38.6% | +5.9% |
| Search-based QA(Qwen3-8B) | 七数据集平均精确匹配 | 49.8% | 最强基线 TCOD 46.7% | +3.1% |
| WebShop(Qwen3-1.7B) | 任务成功率 | 76.6% | RLSD 62.5% | +14.1%(分数仅 +1.2%) |
| SWE-Bench Verified(Nemotron-3.5-SFT) | 解析率 Resolve rate | 66.0% | 标准 OPD 63.0%(SFT 起点 62.8%) | +3.2%(OPD 仅 +0.2%) |
| 关键错误恢复重放(Qwen3-8B,72 个 oracle 关键错误) | 最终恢复率 | 72.7% | 标准 OPD 20.3%(Base 8.3%) | +52.4 个百分点(约为 Base 的 9 倍) |
局限与改进
作者承认的(Appendix G):$K>1$ 需要环境能逐字重放记录观测,ALFWorld/WebShop/QA 满足但真实网站等交互环境不满足;方法依赖教师——错误的金标准/恢复动作会成为错误蒸馏目标,pivot 检测与 oracle 的 ±1 轮一致率平均只有 77.8%,其余约四分之一情形监督落在错误位置,合理的替代动作也可能被误判为关键轮;$K$ 与 $w_{rec}$ 强耦合,换基准都要重新扫参;关键错误的诊断本身依赖 ALFWorld oracle,其他基准只有教师估计;所有智能体的历史窗口不超过 5 轮,「浪费轮数」的统计可能部分来自受限历史。我的补充观察:SWE-Bench 实验实际退化为 $m=1, K=0$(只对最后提交动作做预防蒸馏,且提示分布直接来自 Nemotron-3-Super 而非特权自教师),恢复蒸馏在最长的软件工程场景并未真正检验,+3.2% 不能归功于完整方法;开放动作空间(QA/SWE)中自由文本动作很少逐字匹配,mismatch 默认判 pivotal 会系统性引入假阳性;教师能力边界未探测(教师仅略强于学生时是否仍有效未知);Figure 1c 的 OPD 诊断只训练 120 步,与主实验 160 步协议不完全可比。
独立分析的弱点
独立分析四个弱点。其一,教师单点故障:gold/recovery 动作错了就是错目标,且每条轨迹只采一次教师回复(测一致率时抽 5 次才达 77.8%),低置信监督直接进入训练。改进方向:对命名的动作做多次采样自一致性投票,或按师生分歧度、动作在环境中执行后的可行性校验来加权蒸馏强度。其二,精确重放假设:$K\ge 2$ 需要确定性环境,且重放开销大($K=2$ 时每步训练时间 +89.5%)。改进:训练轻量世界模型或状态摘要做近似重放,或用值函数 bootstrap 替代深层恢复链。其三,超参脆弱:$w_{rec}$ 与 $K$ 互相牵制(WebShop 上 $K=2$ 需要只用 $K=1$ 的四分之一权重才稳定),跨基准迁移需重新调参。改进:按恢复序列数量或 token 预算自动归一化权重,或联合自适应选择。其四,开放动作空间的 pivot 质量不可控:QA/SWE 中自由文本几乎必判 mismatch,假阳性比例无监控。改进:抽样人工或强模型审计 pivot 标注、引入动作等价性判定器,并报告假阳性率对最终性能的敏感性曲线。
未来方向
作者点名的方向:把 pivot detection 扩展到 SWE-Bench 等长 episode 中更早的轮次(当前只审计最后提交动作、$K=0$),让恢复蒸馏在软件工程真正落地;在不支持精确重放的环境(真实网站)中实现后续恢复轮;在蒸馏前估计每个命名动作的可靠性以降低教师依赖。基于成果可延伸的:把恢复蒸馏与过程奖励模型结合,学习 $L(s_t)$ 的神经代理,使关键轮检测不再依赖教师事后阅读整条轨迹;用学到的恢复能力反哺测试时机制,例如显式回退动作或「发现偏离即反思」的提示策略;在自蒸馏设定(Figure 3 显示即便无强教师仍全面占优)下把框架并入前沿模型的自改进循环;把命题 3 的链深度 $d$ 估计出来,按任务自适应选择 $K$;多教师集成或师生互评以降低单一教师偏差;在具身/网页等非文本环境中验证重放与恢复机制的可移植性。
复现评估
复现条件相当好。训练栈全开源(verl + vLLM + FSDP,H100 节点),数据全公开(ALFWorld 标准 split、WebShop 6910 条指令、Search-R1 训练 split 169,615 题、SWE-Bench Verified 500 题),超参完整到表级(Table S.2/S.3:学习率 $1\times10^{-6}$、KL 系数 0.01、clip 0.2、$\gamma=0.95$、160 步、$G=8$、$w_{prev}=0.001$、$\delta=5$、$K$ 与 $w_{rec}$ 按基准给出),四个关键 prompt 模板(学生轮次、教师报告、恢复动作、hint)在附录 D.4 全文给出。算力门槛:1.7B 学生单节点 4×H100 即可(GRPO 每步 367.3s,PivotOPD $K=1$ 仅慢 12.4%);8B 学生需 Qwen3.5-122B-A10B 教师(TP=8)更耗卡;SWE-Bench 部分每步 32 实例×16 轨迹、196K 上下文容器化环境,门槛最高。需要注意:论文与项目页未见明确的代码开源声明,可能需按论文细节自行实现。总体难度:前三个基准中等偏易(提示与配置齐全、成本可控),SWE-Bench 部分困难(依赖 Nemotron 模型家族、NeMo Gym/OpenCode 栈和去污染课程数据)。
论文图表
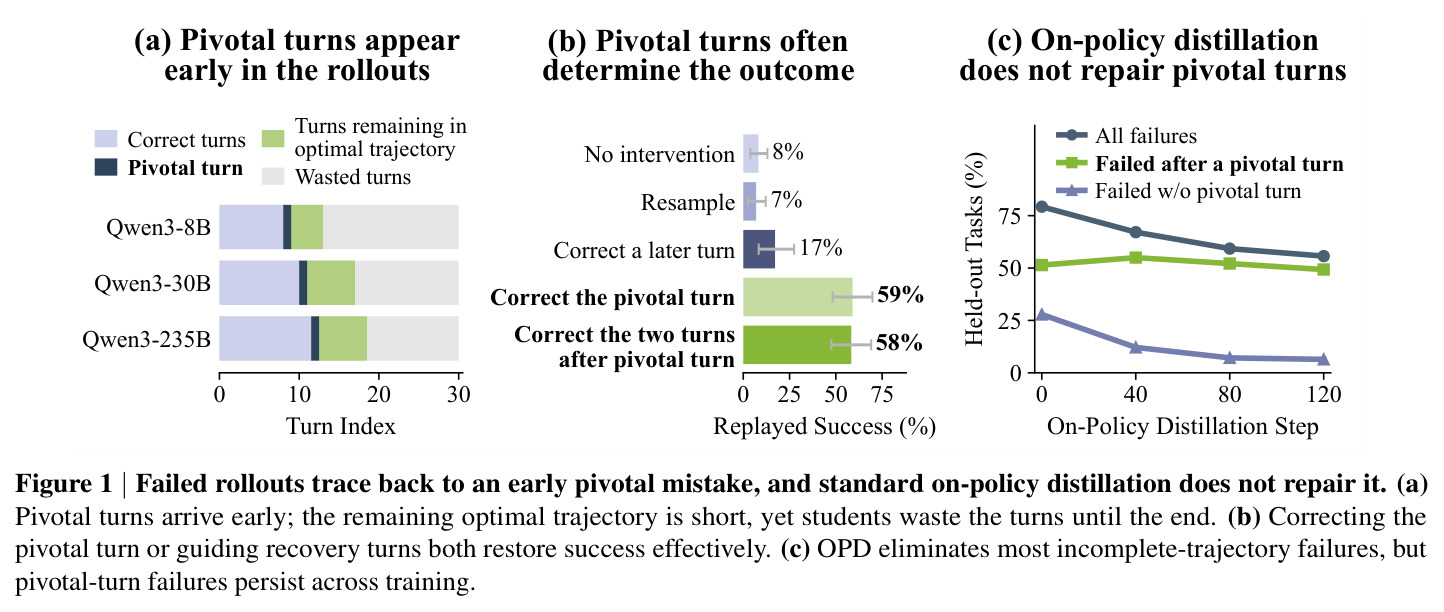
三联诊断图。(a) 三个 Qwen3 模型(8B/30B/235B)失败轨迹的首个关键轮出现很早(中位数第 8–12 轮),剩余最优轨迹很短,但模型把剩余 18–21 轮全部浪费掉。(b) Qwen3-8B 的 72 条含关键错误的失败轨迹反事实回放:不干预 8%、在关键轮重采样 7%、在后面随机轮纠正 17%、纠正关键轮 59%、保留错误并在其后两轮强制 oracle 动作 58%。(c) OPD 训练 120 步过程中,总失败率大幅下降(79%→56%),但关键轮后失败几乎不动(51%→49%),无关键轮失败下降 21.4%。
这是全文的立论基础,同时证明了两个前提假设——失败大多系于一个早期且可恢复的关键错误,以及标准 OPD 修不好它——没有这张图,方法的动机不成立。
两位教师对各自学生失败轨迹做 pivot 检测与 oracle 标注的一致率:Qwen3-30B-A3B(训练 1.7B)±1 轮一致率 71.1%,随机基线 33.6%;Qwen3.5-122B-A10B(训练 8B)84.4%,随机基线 28.1%;平均 77.8%,均至少是随机的两倍。
方法不使用 oracle 训练,pivot detection 的可靠性全靠这张表背书,是评估「监督是否落在正确位置」的关键证据。
Table 2 扩展到全部六个任务型:去掉金标准动作后 Pick2 从 43.4 掉到 34.1(-9.3),说明在「无法从观测推断决策」的任务型上提示必须点名具体动作;随机轮变体在 Pick2 也最低(38.6)。完整方法在 Pick2 达 58.5。
补齐 Table 2 的任务型细分,展示了消融差异主要集中在哪些任务,支持「监督的位置与内容都要对」的结论。
以 GRPO 每步 367.3s(4×H100)为基线:自教师前向 +4.7%;恢复回放 $K=1$ +7.8%(首恢复轮无需重放)、$K=2$ +89.5%、$K=3$ +107.6%(后续轮需环境重放);总开销 +12.4%/+94.2%/+112.3%。WebShop 上 $K=1$ 仅 +12.2%。推理时零开销。
量化方法的实用性边界:$K=1$ 便宜、$K\ge 2$ 因环境重放而昂贵,是决定部署预算时必须参考的数据。