游戏引导的技能发现:通过自博弈实现人类可玩的智能体控制 Game-Guided Skill Discovery through Self-Play for Playable Agent Control
用1v1竞技游戏自博弈发现少量语义分明、人类按键即可操控的机器人技能
前置知识
技能发现
无监督强化学习的一个分支:不给任务奖励,让智能体自行探索出一组可复用的行为基元。主流做法是最大化技能编码 $Z$ 与状态 $S$ 的互信息 $I(Z;S)$,使不同技能对应可区分的状态分布或轨迹,代表工作有 DIAYN、DADS、METRA。
本文讨论的所有基线方法与"MI 只是关联机制而非行为来源"的核心论点都建立在这一框架上,不懂它就无法理解游戏引导相对无引导探索的优势到底在哪里。
自博弈与过去自我池
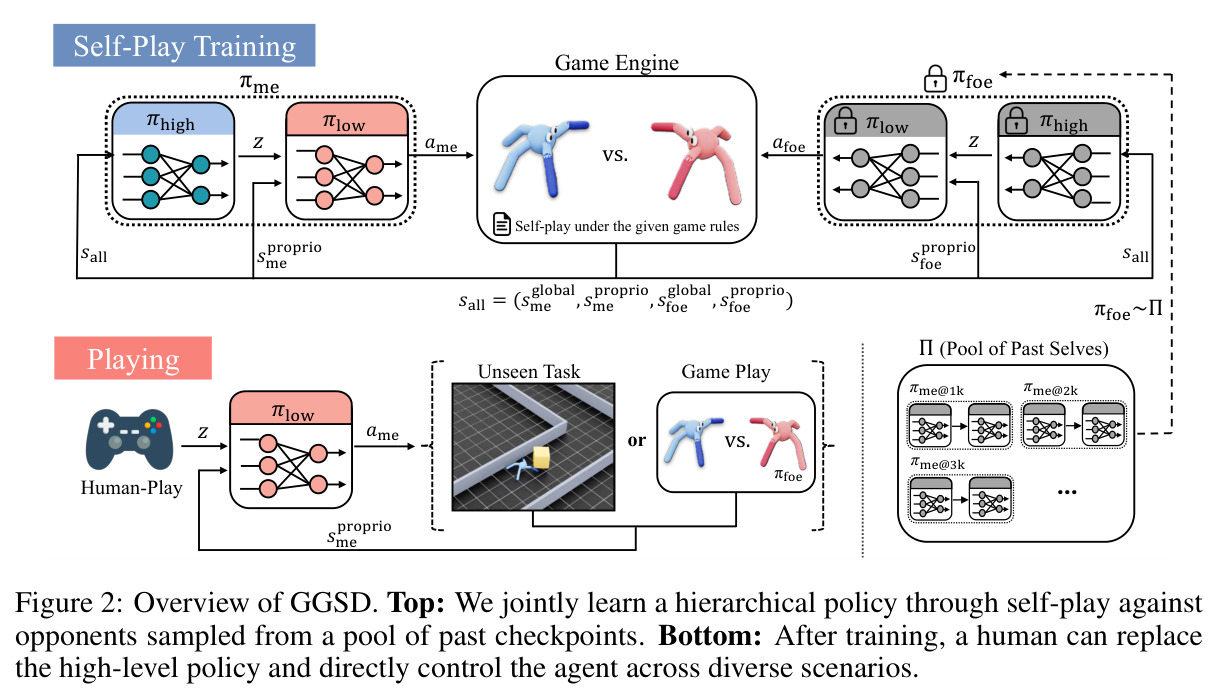
智能体与自身历史版本对战以获得持续竞争压力。GGSD 维护检查点池 $\Pi_K=\{\pi^{(1)},\ldots,\pi^{(K)}\}$,按分布 $\rho_K$ 采样:最新检查点以概率 $p$(实验取 0.6-0.8)被选中,其余概率均分给更早版本,且对手在整条回合内固定,使训练目标分段平稳而非连续漂移。
对手池的多样性直接决定涌现行为的丰富度,是"游戏规则能替代人工示范"这一主张成立的机制基础,也是训练稳定性的关键。
层次强化学习与时间抽象
把策略分成两层:高层每 $k$ 个环境步(本文 $k=10$)从离散技能集中选一个 $z_j\sim\pi_{high}(z|s_{all})$,低层 $\pi_{low}(a|s_{proprio}, z)$ 每步输出电机动作。两层各配独立的价值函数与 PPO 目标,高层在相邻决策之间使用有效折扣 $\gamma^k$。
训练完成后人类替换的正是高层策略,理解时间抽象与两层联合优化,才能明白为什么 5-6 个键盘按键就能控制高自由度机器人。
本体感知观测
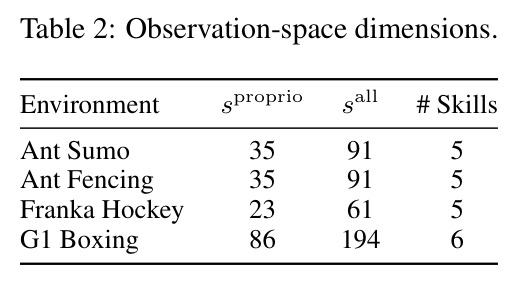
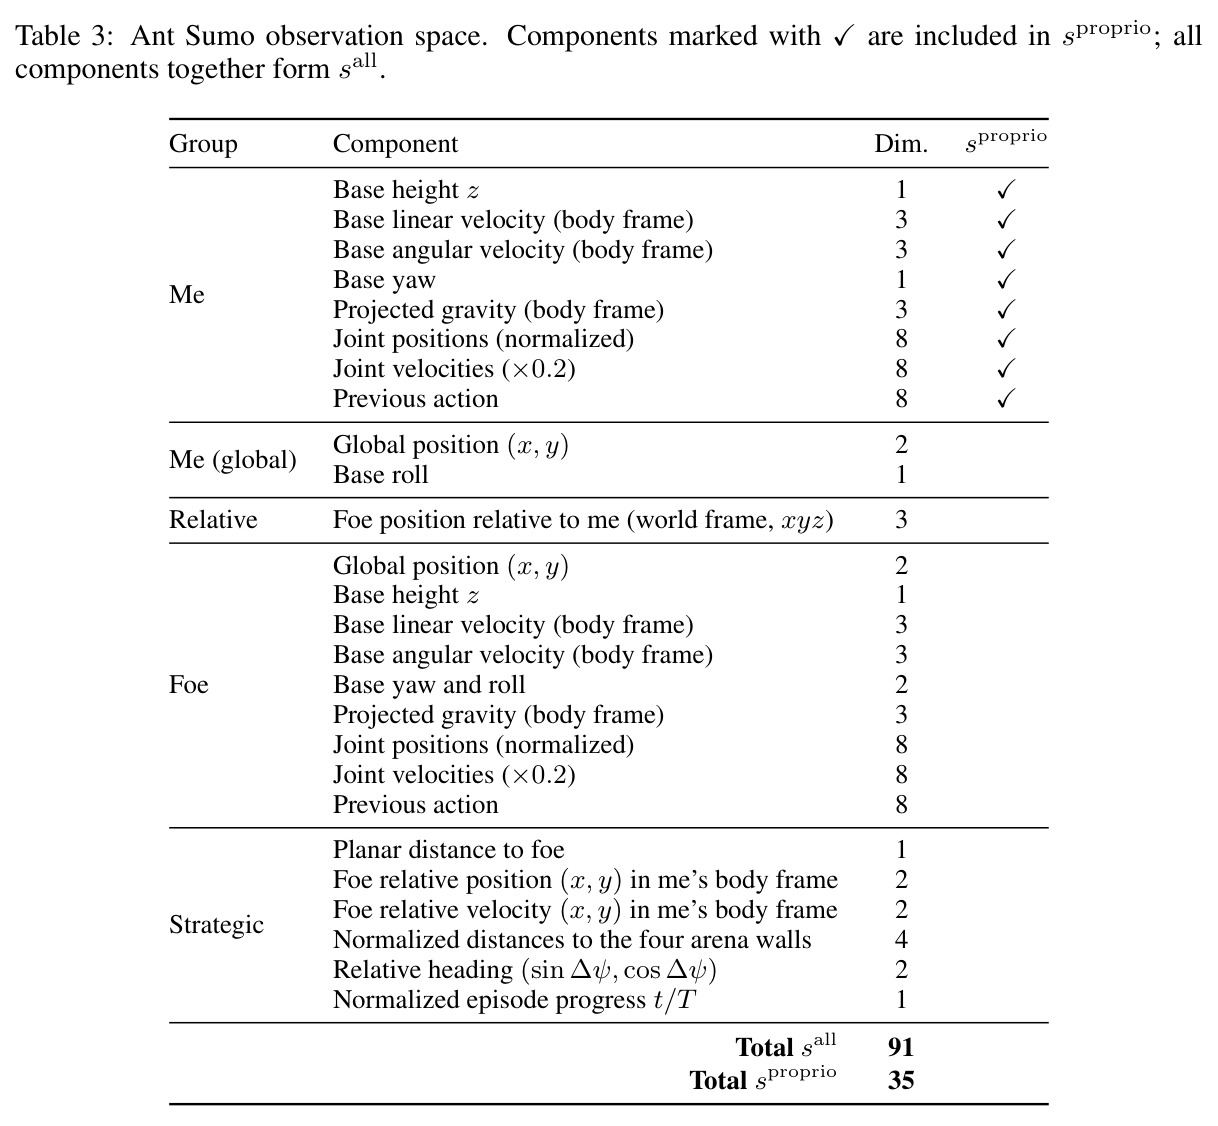
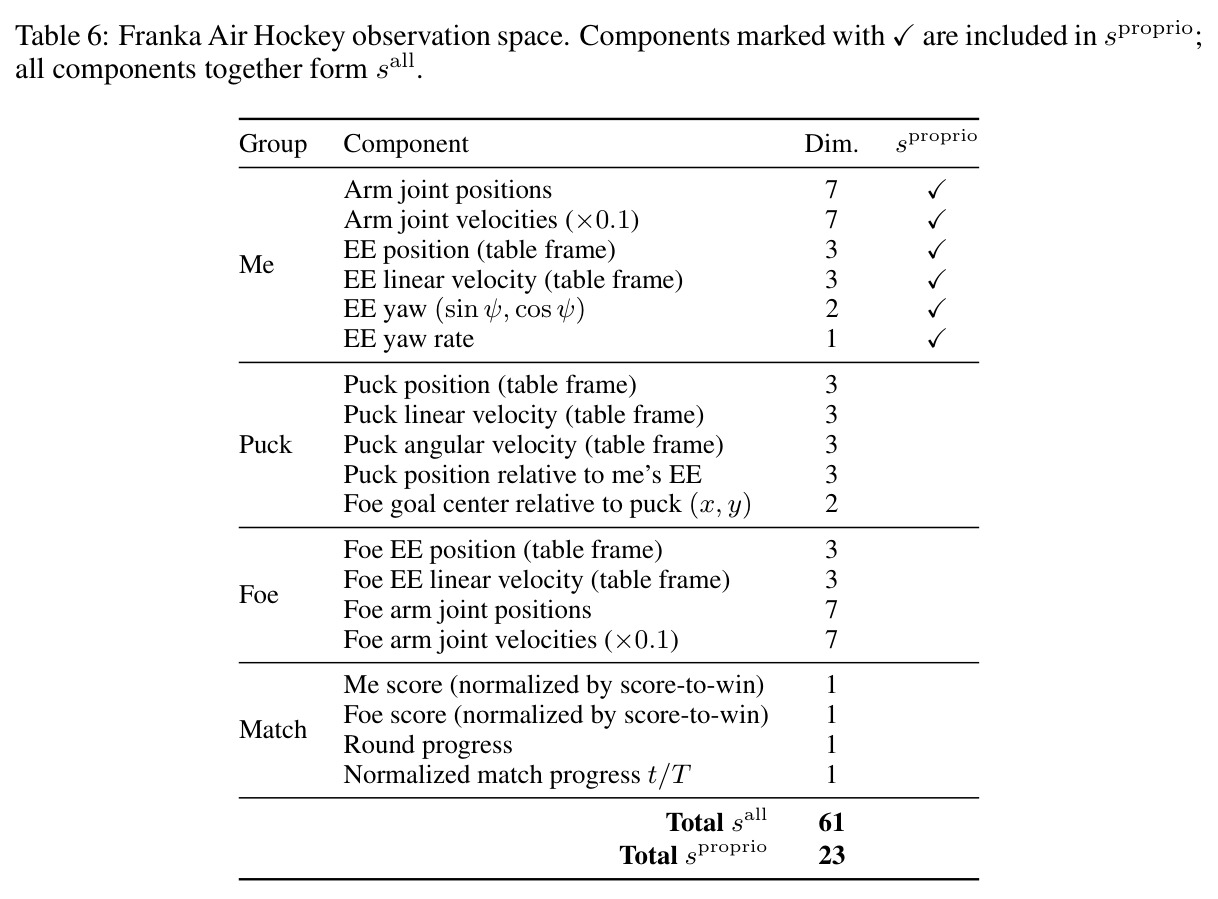
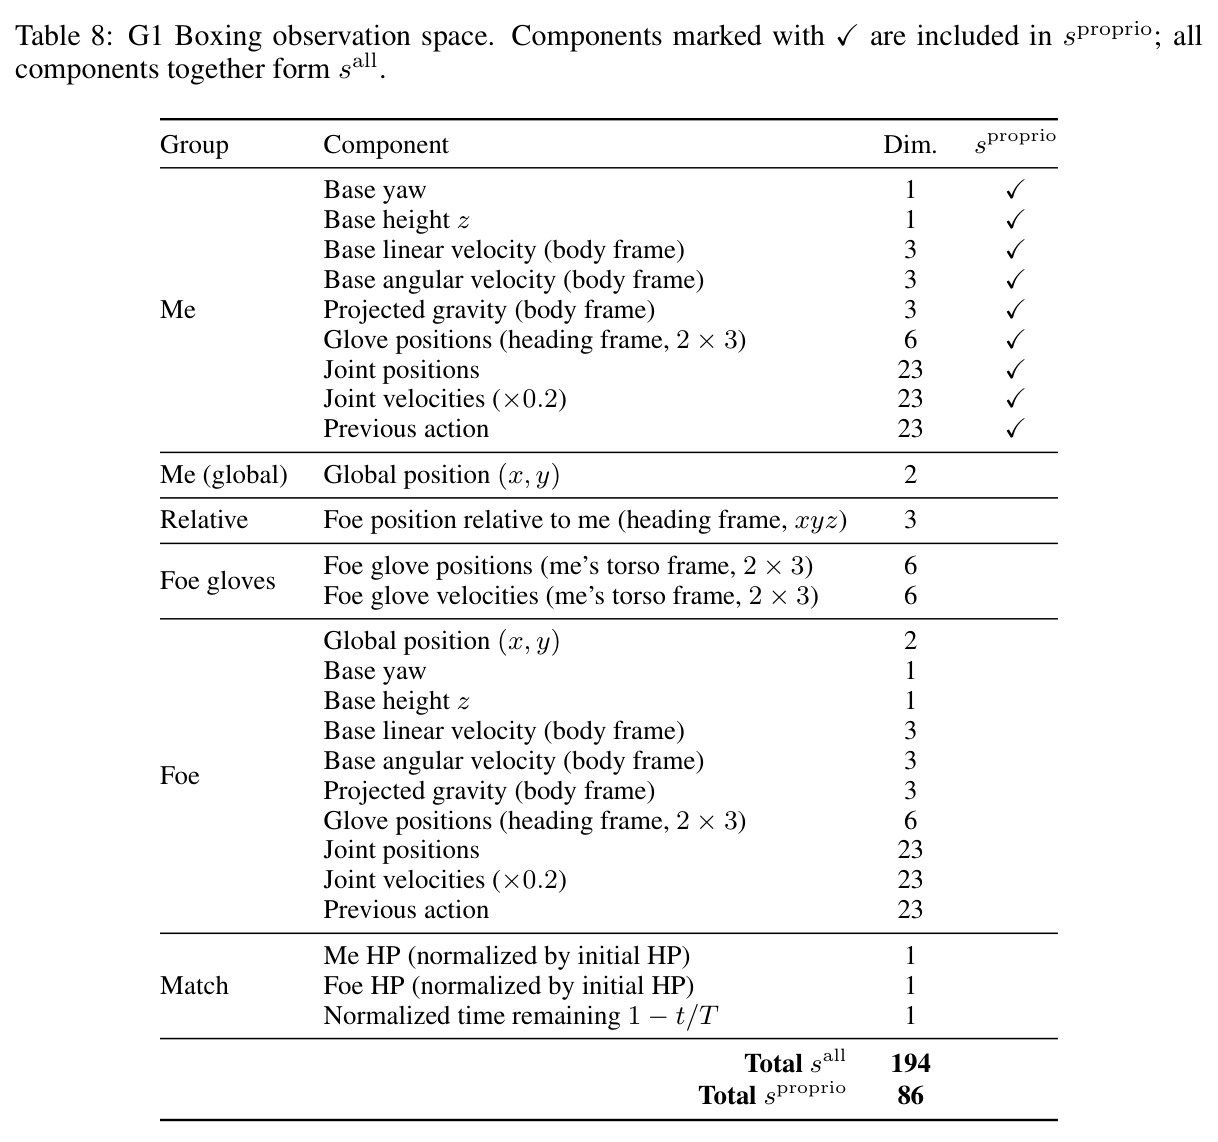
只包含智能体自身状态的观测,如关节位置与速度、底座线/角速度、投影重力、上一帧动作等,不含对手与全局信息。例如 Ant 中本体感知 $s_{proprio}$ 为 35 维,而完整博弈状态 $s_{all}$ 为 91 维。
GGSD 强制低层策略与判别器只能使用 $s_{proprio}$,这是技能语义跨对手、跨博弈局面保持一致、从而对人类可玩的关键设计,也是本文观测工程的核心。
互信息判别器与内在奖励
训练判别器 $q_\phi(z|s)$ 从状态反推技能编码,最大化变分下界 $I(Z;S)\ge H(Z)+\mathbb{E}[\log q_\phi(z|s)]$,低层策略因此获得内在奖励 $r_{MI}=\log q_\phi(z_j|s_t)$,促使不同编码产生可区分行为。
附录 B 论证该目标只负责"哪个编码表示哪个行为",而"涌现什么行为"需要外部引导决定——这一'引导 + 关联'分解是全文的理论主线。
研究动机
现有无监督技能发现主要依赖互信息目标(DIAYN、DADS)或 Wasserstein 依赖度量(METRA),通过让不同技能产生可区分的状态分布来获得行为多样性。但在高自由度智能体上,可区分的方式太多:两个技能可能只差一些微小且无行为意义的细节就能被判别器分开,结果是技能"好分辨却难解释、难复用"——distinctiveness 不等于语义上有意义。为注入语义,后续工作引入外部引导,但各有代价:LGSD 用 LLM 生成状态描述,随智能体维度增长,为整个探索空间获取语言描述变得不现实;DoDont 依赖正/负示范视频;RGSD 用参考动作引导,技能库被参考数据集塑形,而准备足够多样的参考动作本身成本高昂。
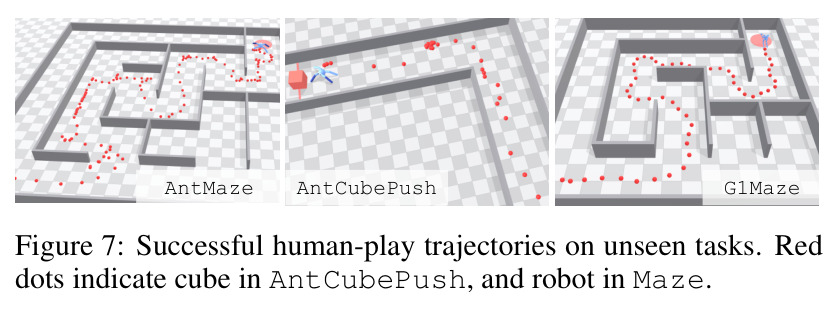
本文的目标是本文的目标是证明:只用一个几行代码就能写清的 1v1 竞技游戏规则作为引导,就能自动发现一组小型(5 或 6 个)离散技能,同时满足四个性质——语义可分、人类可解释、可扩展到高自由度本体(如 23 关节的 Unitree G1 人形)、以及在紧凑动作空间下仍具足够表达力。训练完成后移除高层策略,把每个技能映射到键盘按键,人类无需训练任何任务专用控制器即可直接操控智能体,并把技能组合迁移到 AntMaze、AntCubePush、G1Maze 等训练中从未出现的任务上,且跨模拟器(Isaac Lab 训练、MuJoCo web 评测)依然有效。
与已有工作不同的是,论文的独特切入是把竞技游戏当作"轻量引导源":游戏规则只规定什么算赢、不规定怎么赢,自博弈中不断演化的对手自动暴露新的策略与物理情境,让有用行为自然涌现。这与两条已有路线都不同:其一,Bansal 等 2018 等自博弈工作学到的是整体博弈策略,而非可复用、可人工接管的技能库;其二,Won 等 2021 的高自由度人形拳击/击剑虽也用对抗训练,但底层运动技能来自参考动作而非自博弈本身。附录 B 进一步给出统一分解"行为引导 + MI 关联":引导决定涌现什么行为,MI 只决定哪个编码表示它——GGSD 的贡献正是提供了一种全新的引导源,并证明其产出的技能对人类直接可用。
核心方法
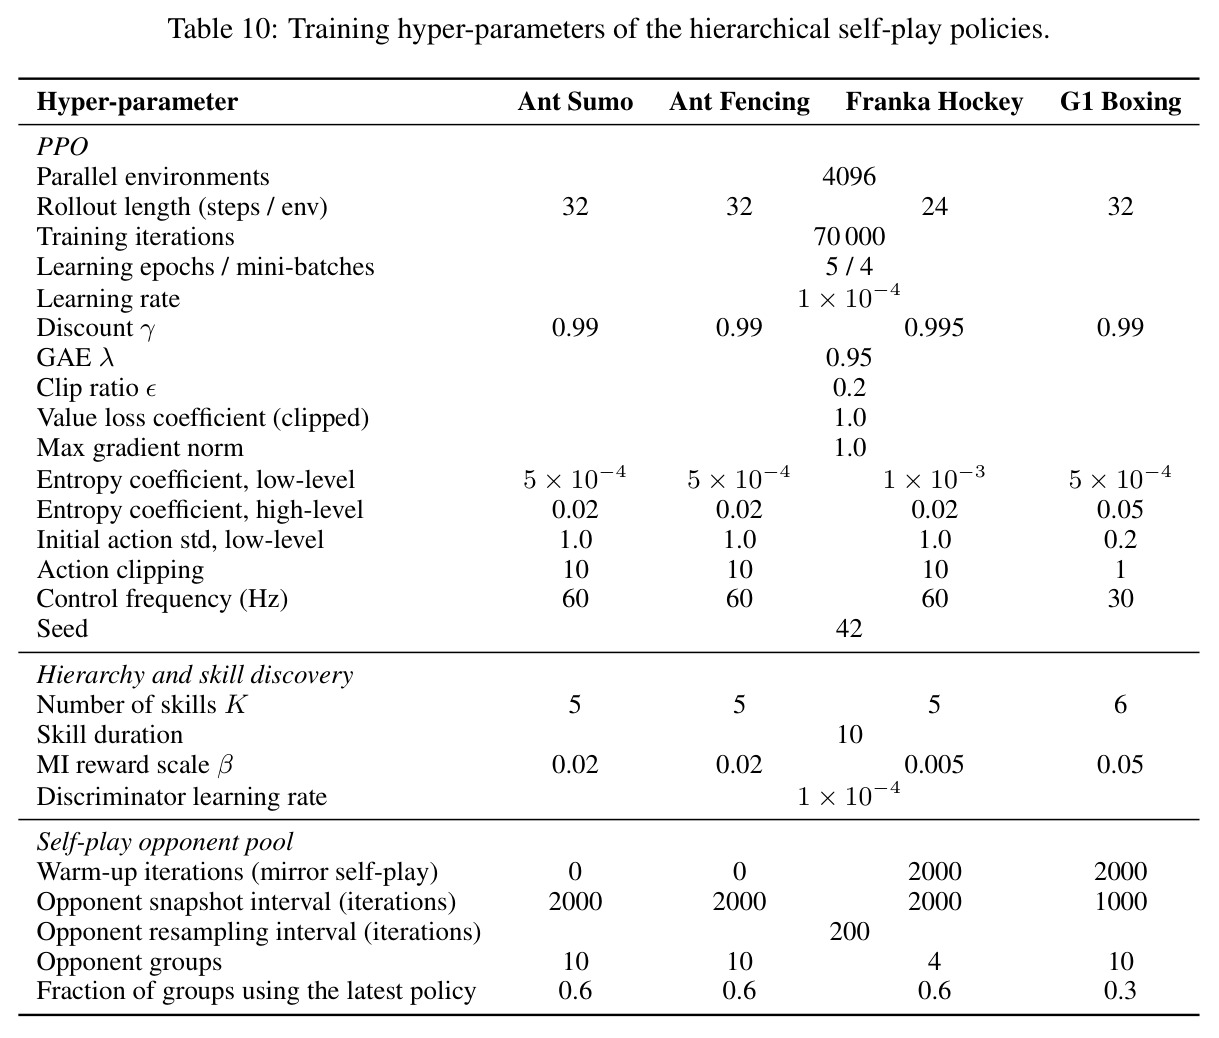
GGSD 是层次化自博弈框架。每个智能体由高层策略 $\pi_{high}(z|s_{all})$ 与低层策略 $\pi_{low}(a|s_{proprio}, z)$ 级联控制:高层每 $k=10$ 个环境步从 $M=5$ 或 6 个 one-hot 离散技能中选一个,低层逐步输出关节动作。训练在 1v1 竞技游戏(AntSumo、AntFencing、FrankaAirHockey、G1Boxing)中进行,对手从历史检查点池 $\Pi_K$ 按分布 $\rho_K$ 采样——最新策略以概率 $p\in[0.6,0.8]$ 入选、其余均分给旧检查点,且整回合固定,形成分段平稳的训练目标。4,096 个并行环境分成 10 组共享对手,GPU 上只需同时驻留当前策略与 10 个冻结对手。低层奖励为 $r_{low}=r_{game}+\lambda_{MI} r_{MI}$,其中 $r_{MI}=\log q_\phi(z_j|s_t)$ 由只看本体感知的判别器给出;高层只优化游戏奖励并加类别熵正则防止技能坍缩。两层各用独立 PPO 更新,共训练 70,000 次迭代。
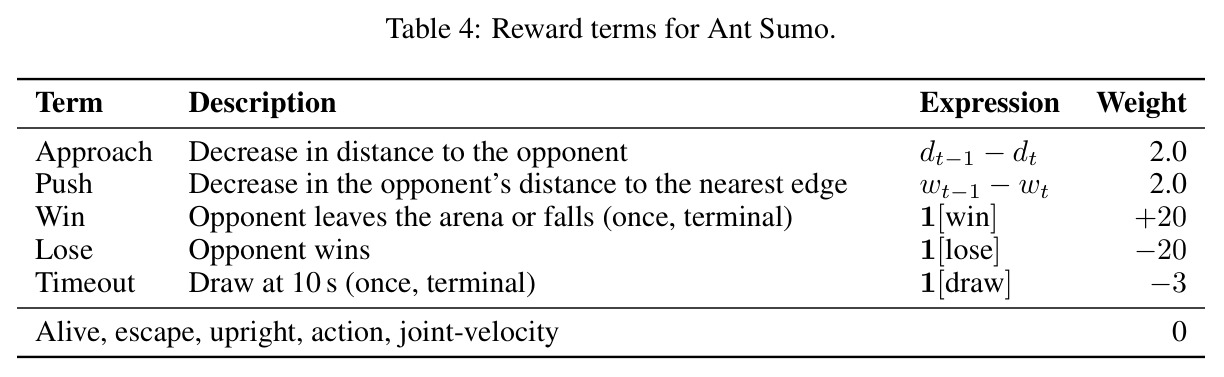
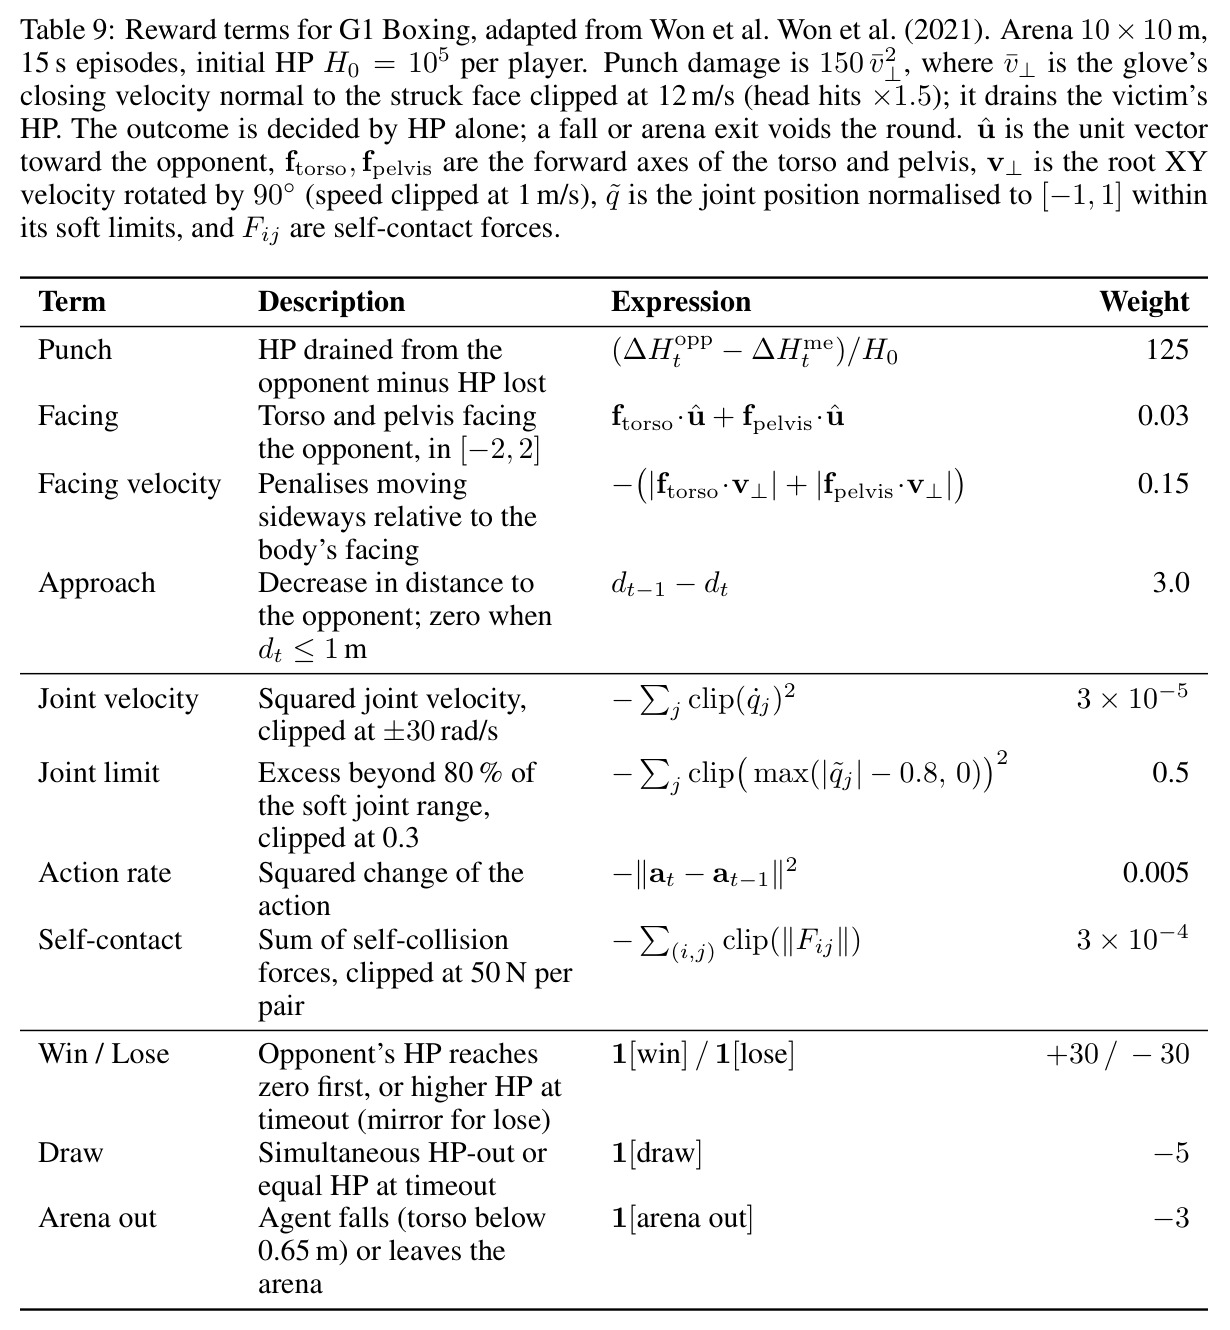
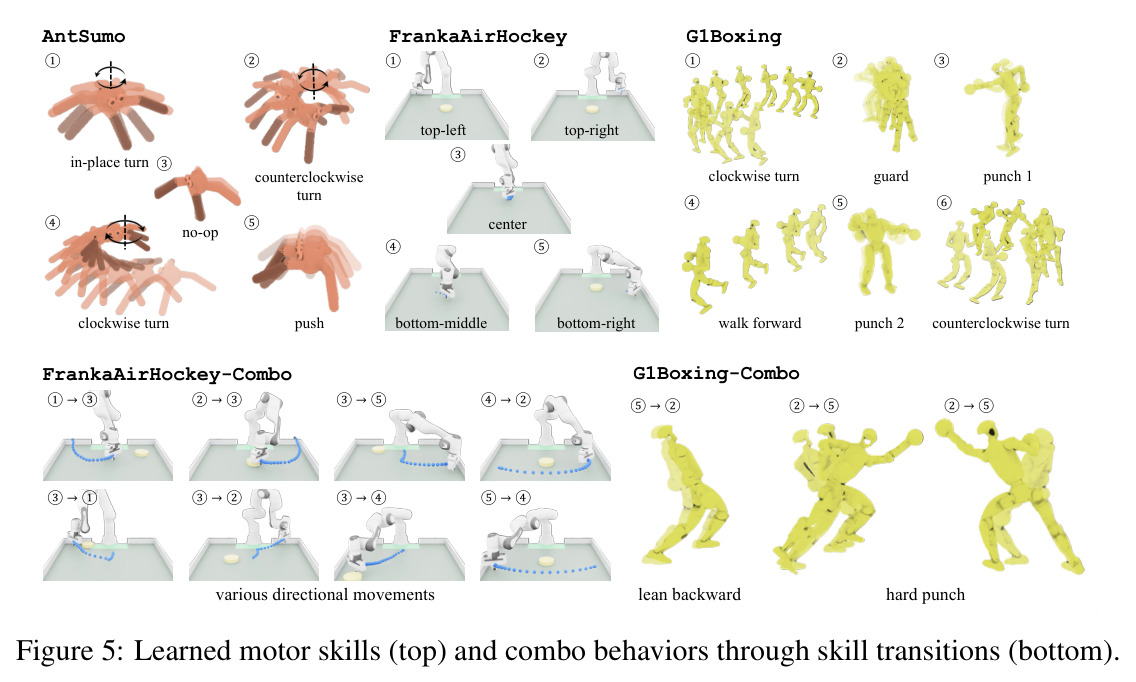
核心创新有三层。第一,用竞技游戏规则替代语言描述、示范或参考动作作为技能发现的引导信号:以 AntSumo 为例,奖励表只有约 5 项(接近对手 +2.0、推离边缘 +2.0、胜利 +20、失败 −20、超时 −3),却能涌现转身、走位、推挤等多样行为,因为"如何赢"完全交给自博弈去探索。第二,对手无关的低层控制:低层策略与判别器只看 $s_{proprio}$,对手相关的策略推理全部留给看全局 $s_{all}$ 的高层,使同一按键在不同博弈局面下保持稳定的运动语义。第三,刻意的技能稀疏性加连招补偿:只保留 5-6 个离散技能以维持简单的人机接口,表达力缺口由技能转换的涌现连招(combo)补足——G1 拳击中 5→2 产生后仰闪避、2→5 借助姿态与动量打出重拳,机制上类似商业游戏中的按键组合。
方法步骤详情
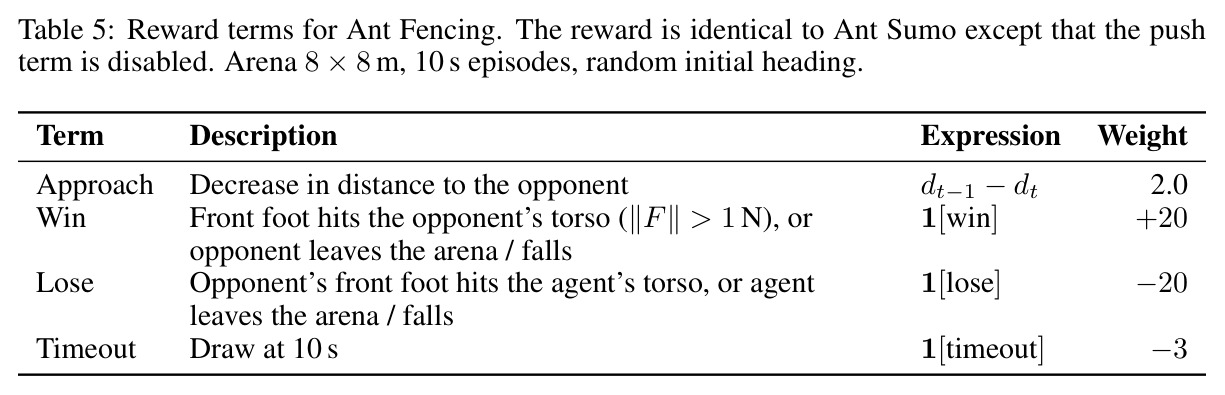
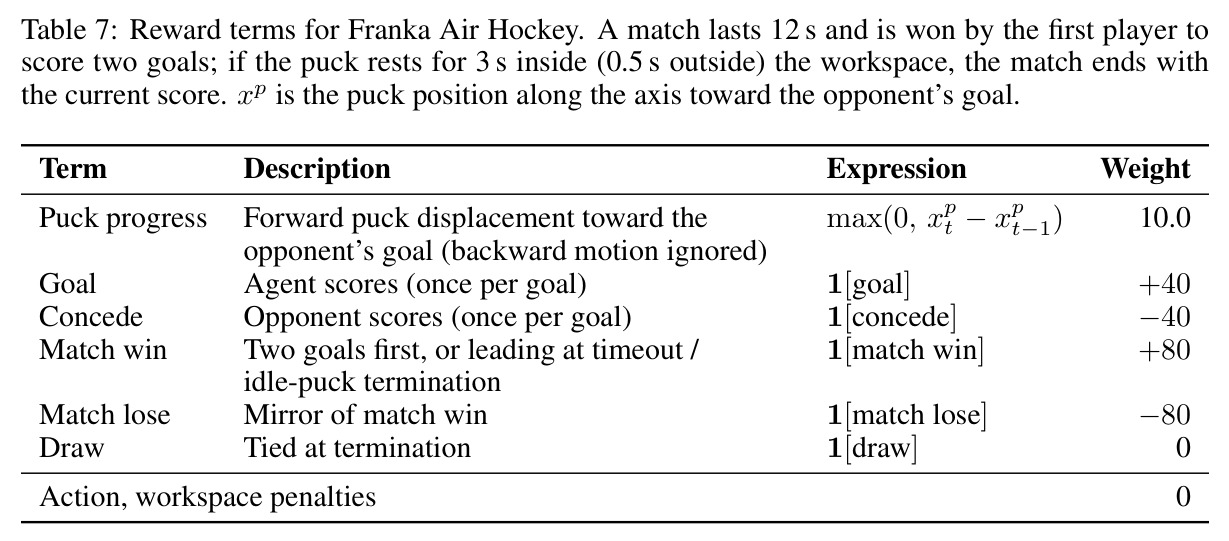
① 定义规则与奖励:AntSumo 推对方出界、AntFencing 前脚触碰对方躯干(力 >1 N)、FrankaAirHockey 先进两球者胜、G1Boxing 按伤害 $150\bar{v}_\perp^2$ 结算 HP。② 构建对手池:每 2,000 迭代(G1 为 1,000)入池当前策略,每 200 迭代为各组重采样对手(Franka 4 组、其余 10 组)。③ 每个高层决策时刻 $\tau_j=jk$,从 $s_{all}$(Ant 91 维)采样技能 $z_j\sim\pi_{high}$。④ 低层仅凭本体感知 $s_{proprio}$(Ant 35 维)在 $k=10$ 步内输出动作 $a_t$。⑤ 训练判别器最大化 $\mathbb{E}[\log q_\phi(z|s_{proprio})]$,得 $r_{MI}=\log q_\phi(z_j|s_t)$。⑥ 高层按 $y^{high}_j=\sum_i \gamma^i r^{game}_{\tau_j+i}+\gamma^k V_{high}$ 更新,两层 PPO 各加熵正则(高层 0.02-0.05、低层 $5\times10^{-4}$)。⑦ 70k 迭代后删除高层,技能绑定键盘供人游玩。
技术新颖性
技术新颖性在于用观测通道分离把"学策略"与"学技能"解耦进同一个层次结构:高层看 $s_{all}$ 学博弈策略,低层与判别器只看 $s_{proprio}$ 学可迁移动作,这一设计直接导致技能语义与对手无关、跨局面可复用。与 DIAYN/DADS/METRA 相比,MI 在此只是"关联机制"而非行为来源(附录 B 的分解:引导决定什么行为涌现,MI 决定编码归属);与 ASE/RGSD 相比,引导来自几行代码的程序化规则而非昂贵的动作数据集;与 SDAX 相比,任务奖励不是人工设计的运动任务而是对抗目标。论文还把状态空间形式化为少量"行为 regime"的并集 $S=S_1\cup\cdots\cup S_R$,用有限状态控制器式的解释说明"同键多义"的连招为何不破坏可玩性——技能语义只需在 regime 内局部一致。这为技能组合性与人机接口设计提供了新的理论视角。
实验结果
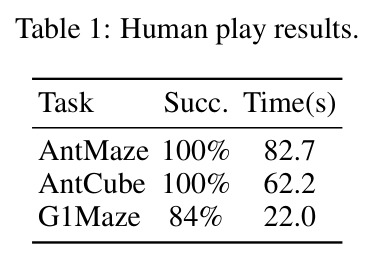
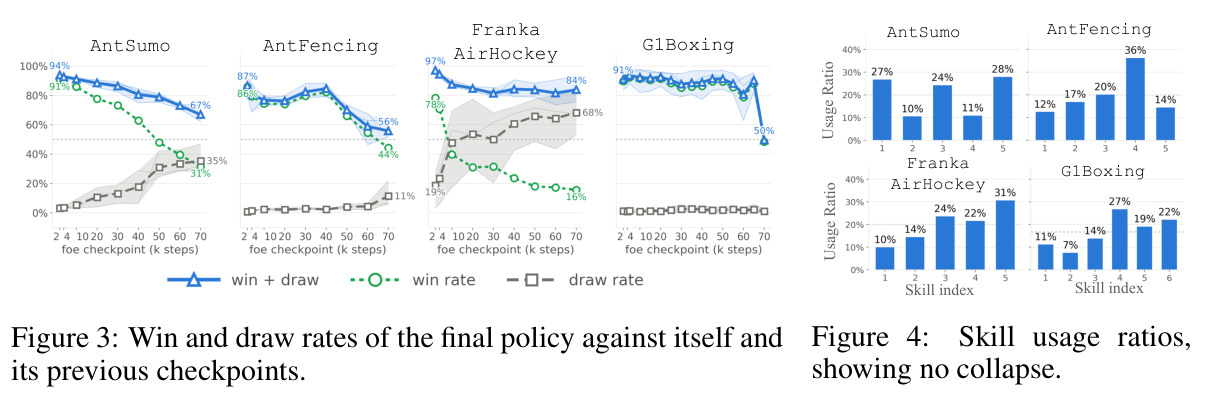
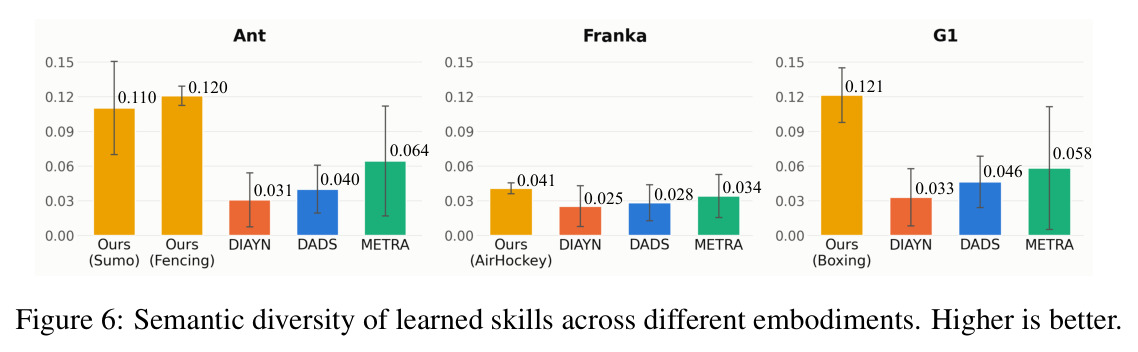
实验覆盖四个游戏。自博弈质量(Figure 3):最终策略(70k 迭代)对 2k-70k 各检查点每配对 1,000 局×3 种子平均,所有配对胜+平率高于 50%;G1Boxing 对除 70k 自身外的检查点胜率超 80%。真人对抗:4 名用户各打 5 局 AntSumo 最终策略仅赢 2 局(人类胜率 10%)。技能使用(Figure 4):各游戏高层策略都不坍缩到单一技能。语义多样性(Figure 6):用 Gemini-3.6-Flash 为每技能 5 秒视频生成描述、Gemini-Embedding-2 算两两余弦距离,GGSD 在所有本体上最高——Ant 和 G1 约为最强基线(DIAYN/DADS/METRA)的 2 倍,Franka 高 28%。零训练人类迁移(Table 1):5 名参与者每人每任务 5 次试验、最多 5 分钟练习,AntMaze 成功率 100%、平均 82.7 秒;AntCubePush 100%、62.2 秒;G1Maze 84%、22.0 秒;且策略在 Isaac Lab 训练、MuJoCo web 评测,任务与模拟器双重偏移下仍可靠完成。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语义多样性(Ant/Franka/G1 三种本体) | VLM 描述 + 文本嵌入的两两余弦距离(越高越好) | 所有本体上最高:Ant 与 G1 约为最强基线的 2 倍,Franka 高 28% | DIAYN / DADS / METRA(METRA 用 5 维连续技能取 one-hot 基向量评测) | 约 2×(Ant、G1),+28%(Franka) |
| AntMaze(人类游玩,未见任务) | 成功率 / 平均完成时间 | 100% / 82.7 s | 无直接基线(零训练迁移设定) | 5 名参与者共 25 次试验全部成功,技能学自 AntSumo 而非迷宫 |
| AntCubePush(人类游玩,未见任务) | 成功率 / 平均完成时间 | 100% / 62.2 s | 无直接基线 | 训练游戏中不存在物体交互,仍实现 100% 成功率且用时短于 AntMaze |
| G1Maze(人类游玩,未见任务) | 成功率 / 平均完成时间 | 84% / 22.0 s | 无直接基线 | 人形本体(23 关节)技能从拳击迁移到迷宫导航 |
| 自博弈竞技强度(四个游戏) | 对历史检查点的胜+平率(每配对 1,000 局、3 种子) | 对所有检查点 >50%;G1Boxing 对非最终检查点胜率 >80% | 2k-70k 训练阶段的历史检查点 | 证明训练整体提升而非过拟合某个特定对手 |
局限与改进
作者承认的核心局限是技能库上界由游戏决定:简单游戏只逼出窄行为集,例如 G1Boxing 学到的技能不可能包含灵巧操作,论文把"扩展到需要更广运动能力的游戏"列为未来工作。我的补充观察有五点:其一,人类评测规模小(5 人、含 2 名作者、每任务仅 5 次试验),未报告学习曲线、挫败感等可用性指标,G1Maze 84% 的置信区间可能很宽;其二,关键超参数按环境手工调——MI 系数 $\beta$ 从 Franka 的 0.005 到 G1 的 0.05 不等,技能数 M、技能时长 $k=10$ 也是固定值,缺乏自适应机制;其三,连招带来的"同键多义"与语义一致性存在张力,附录 A 只定性指出 regime 过多会使界面难懂,没有给出量化边界;其四,实验仅限 1v1 对称博弈,团队竞技或非对称博弈是否同样有效未验证;其五,语义多样性评测依赖专有 VLM(Gemini 系列),得分受模型版本影响。
独立分析的弱点
第一,技能库天花板:想覆盖操作、导航、跑酷等广谱行为可能需要多游戏混合课程,但同一按键在不同游戏中的语义会冲突,改进方向是游戏条件化的技能空间或分层技能库。第二,评测依赖专有模型:语义多样性用 gemini-3.6-flash 与 gemini-embedding-001(3072 维嵌入),模型更新可能导致得分漂移,可用开源 VLM 做鲁棒性对照并报告方差。第三,技能数固定为 5-6,没有自动确定技能粒度的机制,可引入技能分裂/合并或非参数贝叶斯方法。第四,人类研究设计偏弱:参与者含作者、练习上限 5 分钟、每任务仅 5 次,应报告按试验序号分解的成功率以区分学习效应与技能本身质量。第五,完全未触及真机:Isaac Lab 到 MuJoCo web 的 sim-to-sim 已验证,但真机的接触动力学、传感延迟与安全约束是更大挑战,建议先在低速任务上做遥操作实验验证接口可用性。
未来方向
作者提出的方向是把 GGSD 扩展到需要更广、更多样运动能力的游戏,使技能库可迁移到更大范围的下游任务。基于其成果还可延伸:把游戏引导与 LGSD 的语言引导结合,用"竞技涌现 + 语义描述"双重约束技能空间;设计游戏序列课程,让技能库随博弈复杂度增长并研究技能的持续积累机制;量化 regime 数量与可玩性的权衡,给出"同键多义"的安全设计准则;扩展到 2v2 等多人博弈以发现协作与分工技能;把按键接口迁移到真机遥操作场景。另外 Table 1 显示 AntCubePush(62.2 秒)比 AntMaze(82.7 秒)完成更快,提示物体操作类技能的组合效率可能高于纯移动类,技能组合性的系统研究值得单独展开。
复现评估
复现材料相当充分:官方交互 demo(https://ggsd-demo.github.io)可直观验证技能与连招;附录 D 的 Table 10 给出全部超参数(4,096 并行环境、70k 迭代、学习率 $1\times10^{-4}$、$\gamma$ 0.99-0.995、技能时长 10、判别器学习率 $1\times10^{-4}$、对手池快照间隔 1,000-2,000、重采样间隔 200、组数 4-10、最新策略组比例 0.3-0.6);附录 C 的 Table 3-9 完整列出四个游戏的观测空间与奖励项;附录 E 给出 VLM 评测的提示词原文、视频采样设置(5 fps、温度 0.1、按环境截取 1-4/2-4/0-5 秒片段)与示例描述。但论文未提及开源代码,训练依赖 Isaac Lab 大规模 GPU 并行(4,096 环境、70k 迭代),人类实验经 IRB 审批但仅 5 人。总体属于"细节充分、算力昂贵":单游戏小规模复现门槛中等,完整四游戏复现需要较强 GPU 资源与强化学习工程经验。
论文图表
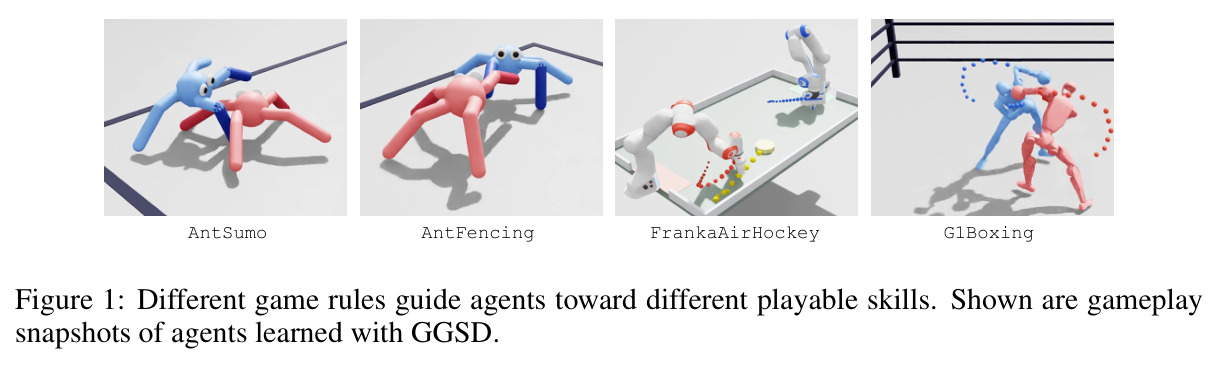
四个游戏(AntSumo、AntFencing、FrankaAirHockey、G1Boxing)中训练出的智能体的对局快照,涵盖四足、机械臂与人形三种本体,展示同一框架在不同规则下学到完全不同的技能库。
一眼呈现'游戏规则决定技能库'这一核心主张,是理解论文动机与实验设计(为何选这四个游戏)的入口。
最终策略(70k 迭代)对 2k-70k 各历史检查点的胜率与平率柱状图,每个配对 1,000 局、3 个种子平均。对手越新胜率越低、平局越多,但胜+平率始终高于 50%;G1Boxing 对除自身外所有检查点胜率超 80%。
验证自博弈训练稳定、持续进步且不过拟合单一对手的核心证据。