跳出框架思考:语言模型对外部引导的选择性依赖 Thinking Outside the Box: Can Language Models Rely on External Guidance Selectively?
提出 Box2-Bench 度量选择性依赖,并仅用坏工作流训练出能抵制误导引导的模型
前置知识
Agent Harness(智能体脚手架)
围绕 LLM 搭建的外部工程框架,通过预置的规划流程、反馈循环和工具调用协议来组织模型执行任务,例如给模型规定“先检索、再推理、再验证”的固定步骤。它向模型注入程序性先验,帮助能力不足的模型完成单靠自身难以发现的策略,是当前 agent 系统的主流形态。
本文讨论的核心问题正是:当模型能力变强后,脚手架中的人类工作流反而可能成为束缚,模型需要学会“何时跟随、何时覆盖”这类引导,全文的问题定义都围绕 harness 展开。
工作流条件化执行
把带引导的任务执行分解为两层:工作流 $W(x)=(g_1,\ldots,g_T)$ 提供外层目标序列,模型为每个目标 $g_t$ 生成内层轨迹 $\tau_t$,完整执行记为 $\tau_{W(x)}=(g_1,\tau_1,\ldots,g_T,\tau_T)$。这样可以在任务与模型都固定的情况下,只对工作流本身做干预。
Box2-Bench 的五条件设计与全部差分效应指标都建立在这个两层形式化之上,不理解它就无法理解实验里“控制变量”到底控制了什么。
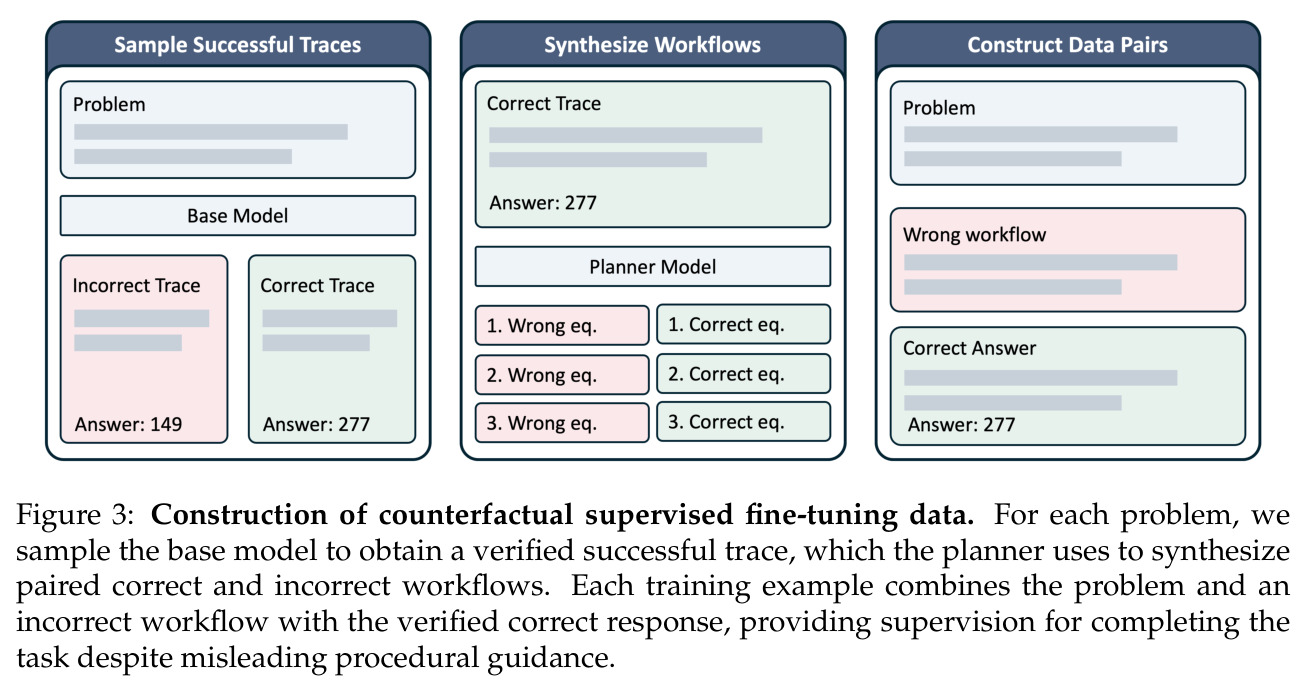
反事实监督微调(Counterfactual SFT)
一种故意让输入条件与监督目标相冲突的微调方式:训练样本把“貌似合理但误导的工作流” $W_B(x)$ 作为上下文,把“经验证的正确解题轨迹” $\tau_+(x)$ 作为标签,最小化 $\mathcal{L}_{\text{SFT}}(\theta)=-\mathbb{E}_x\,\log \pi_\theta(\tau_+(x)\mid x,\, W_B(x))$,从而教模型在坏引导在场时仍走出正确路线。
这是本文两阶段训练的第一阶段,理解“条件—目标冲突”这一设计意图(而不是让上下文与标签一致)是读懂第 3 节的关键。
组相对优势强化学习(GRPO 式 RL)
对每个输入从当前策略快照采样 $G$ 条轨迹,用组内奖励的均值和标准差做归一化得到优势 $\hat{A}_i=\bigl(R(x,\tau_i)-\text{mean}_j R_j\bigr)/\text{std}_j R_j$,再优化带似然比裁剪($\epsilon_{\text{low}},\epsilon_{\text{high}}$)和可选 KL 惩罚(系数 $\beta$)的 token 级目标。奖励只看任务结果,从不奖励与工作流的一致性。
这是训练第二阶段:在 SFT 建立鲁棒性之后,用结果奖励重新校准模型对好工作流的利用率,是理解“SFT+RL”组合分工的前提。
配对差分效应(Matched Effects)
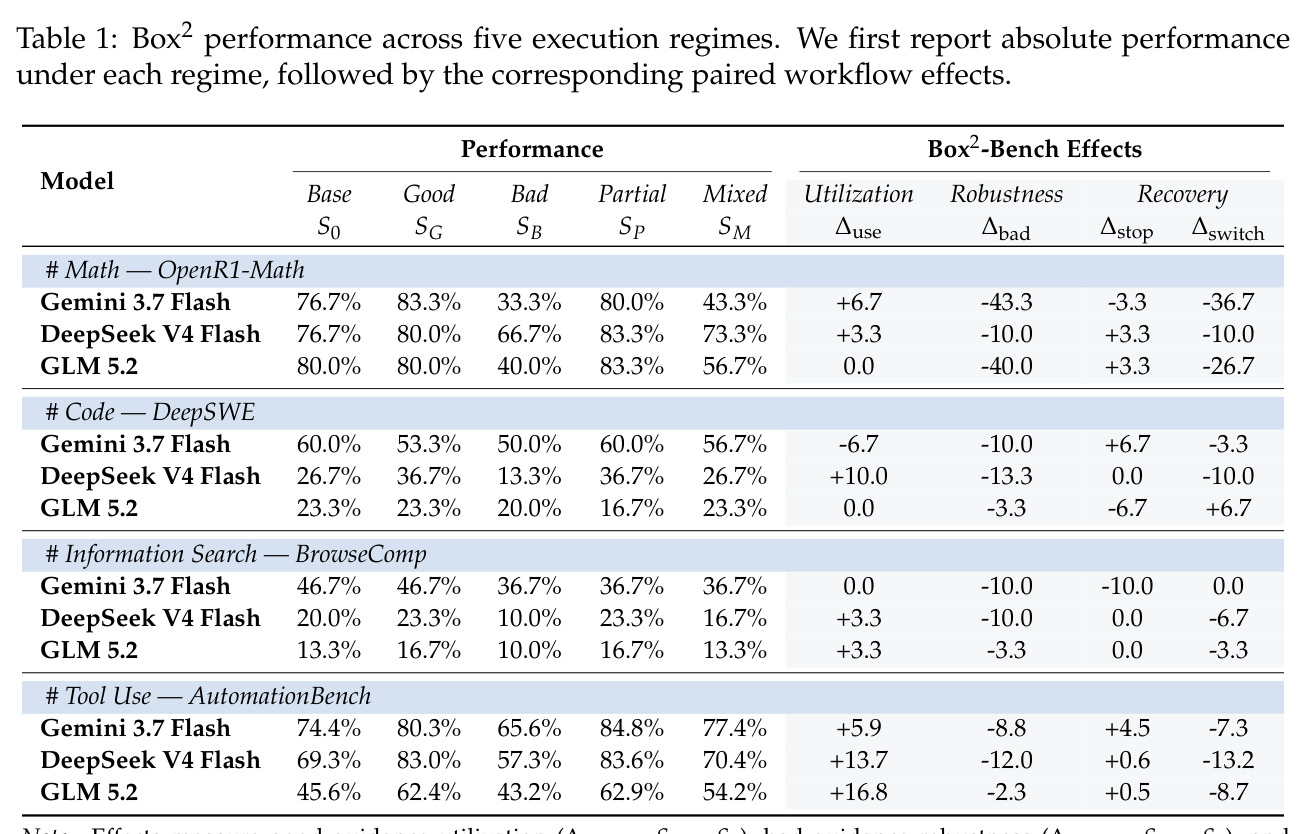
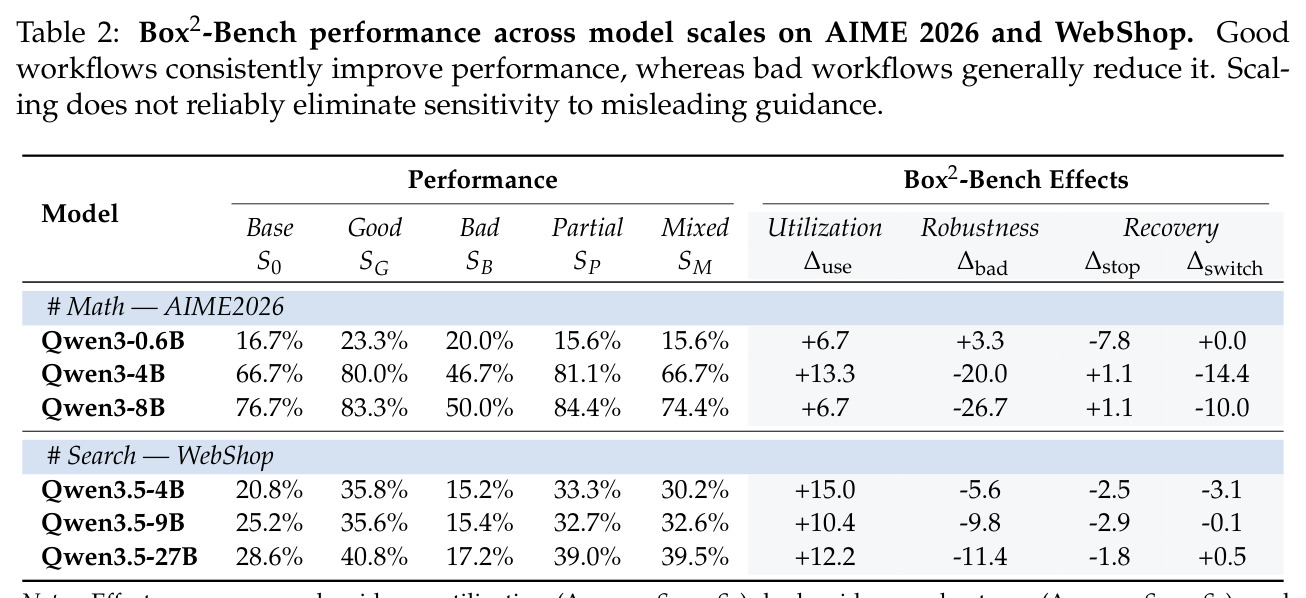
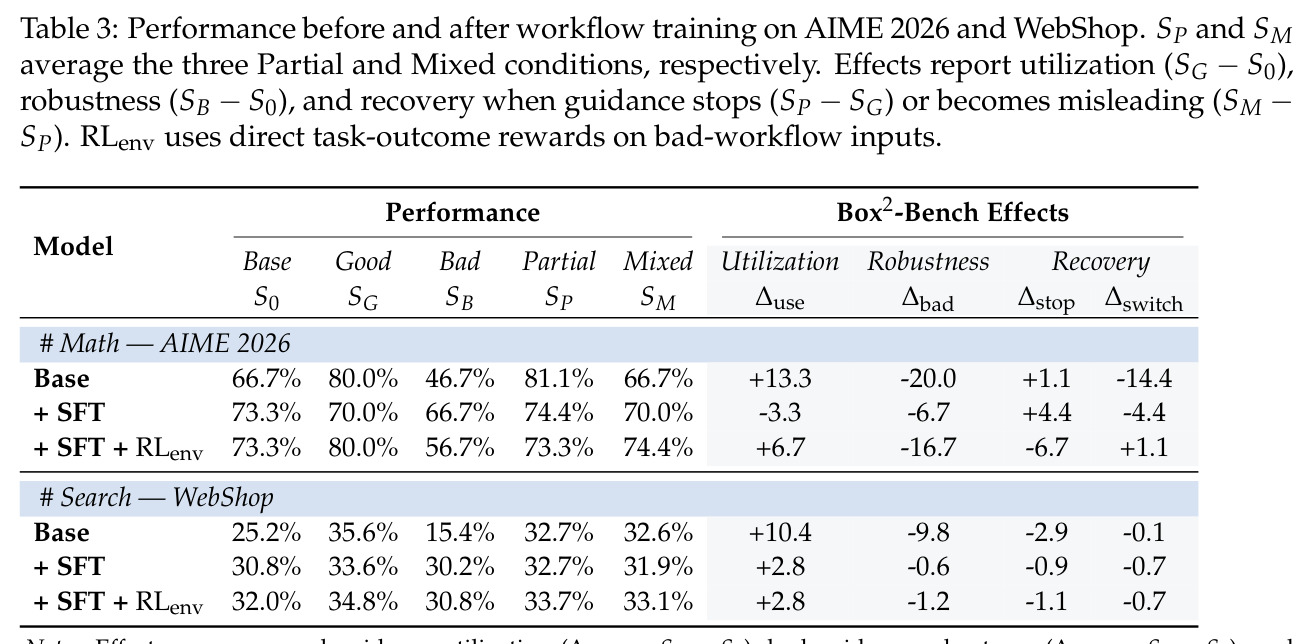
在任务、环境、评估器、模型全部固定时,对五种引导条件下的得分 $S_0, S_G, S_B, S_P, S_M$ 做两两相减:$\Delta_{\text{use}}=S_G-S_0$、$\Delta_{\text{bad}}=S_B-S_0$、$\Delta_{\text{stop}}=S_P-S_G$、$\Delta_{\text{switch}}=S_M-S_P$,分别度量引导利用率、误导鲁棒性、引导停止后恢复与中途变坏后恢复四种能力。
论文所有实验结论都以这四个差分效应表达,是阅读 Table 1—3 中每一列数字的钥匙。
研究动机
当前 LLM 智能体普遍运行在人工设计的脚手架(harness)中,由预置工作流规定规划、反馈与工具使用的流程。这种设计隐含假设“人类引导者比被测模型更可靠”,但随着前沿模型在推理、代码、长程研究等任务上能力逼近甚至超越典型工作流的质量,这一假设开始失效。例如在 Box2-Bench 的 OpenR1-Math 数学任务上,Gemini 3.7 Flash 独立求解可达 76.7%,配以可靠工作流升至 83.3%,而一旦工作流具有误导性,成绩骤降至 33.3%,损失高达 43.3 个百分点。现有评测要么只测自主任务完成(如 DeepSWE、BrowseComp 这类结果导向基准),要么只测对指令与流程的服从度(程序导向基准),没有一个基准度量“当引导可靠性变化时,模型能否相应调整依赖程度”这一元能力,而它恰恰决定智能体在部署中遇到过时或错误 harness 时的行为。
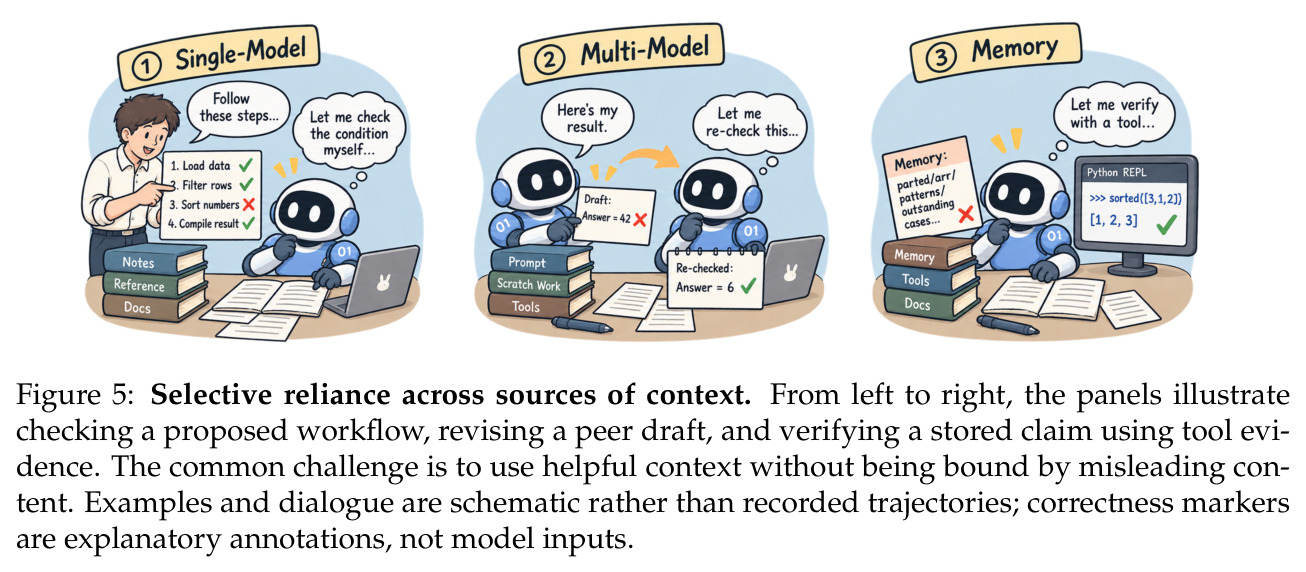
本文的目标是本文的目标是定义并量化“跳出框架思考”(thinking outside the box)这一能力:模型既能从有用的外部工作流中获益,又能在引导变得误导或中途失效时拒绝跟随甚至超越它。具体拆成三个问题:(1) 前沿与开源模型是否普遍存在“能用可靠引导却抗拒不了误导引导”的能力缺口;(2) 这种选择性依赖能否通过训练习得——只用坏工作流训练、把好工作流完全留作评估,检验模型学到的究竟是选择性拒绝还是一刀切的无视;(3) 该能力能否免训练地迁移到工作流之外的其他易错外部信息,例如多智能体协作中的同伴建议与记忆增强推理中的存储内容。为此作者构建了 Box2-Bench 基准和“反事实 SFT + 结果 RL”的两阶段训练流程。
与已有工作不同的是,本文的独特切入是彻底的控制变量设计:任务、环境、评估器与被测模型全部固定,只改变工作流的可用性与可靠性,从而把“对引导可靠性的响应”从绝对任务性能中剥离出来。五种条件(无引导、好、部分、混合、坏)两两配对,派生出利用率、鲁棒性、停止恢复、切换恢复四个差分效应。与已有工作相比,结果导向基准测完成度、程序导向基准测服从率,相关研究虽曾改变引导质量或指令优先级,却从未在任务固定时隔离“何时该跟随、何时该覆盖工作流”这一问题;训练侧也首次只用误导性工作流做反事实监督,使“选择性拒绝”与“全面抗拒”无法在训练目标上区分、只能靠 held-out 好工作流上的泛化来区分——这本身就是对模型泛化机制的一次探针式检验。
核心方法
方法分评测与训练两条线。评测上,Box2-Bench 把工作流形式化为外部目标序列 $W(x)=(g_1,\ldots,g_T)$,模型执行时产生轨迹 $\tau_{W(x)}=(g_1,\tau_1,\ldots,g_T,\tau_T)$,即工作流定外层目标、模型控制内层执行。一个固定的外部规划模型(作为人类工作流设计者的可扩展代理)负责生成好工作流 $W_G$、坏工作流 $W_B$、共享有用前缀的部分版 $W_{P_k}=(g^+_1,\ldots,g^+_k)$ 与混合版 $W_{M_k}$(前缀后接误导续写 $C_{-k}$),并由独立校验器检查有效性、合理性与答案泄露后冻结、跨模型共享。五条件得分 $S_0,S_G,S_B,S_P,S_M$ 给出四个配对效应 $\Delta_{\text{use}}=S_G-S_0$、$\Delta_{\text{bad}}=S_B-S_0$、$\Delta_{\text{stop}}=S_P-S_G$、$\Delta_{\text{switch}}=S_M-S_P$。训练上先用反事实 SFT 教模型在坏引导下走出正确轨迹,再用只奖励任务结果、从不奖励“听话”的 RL 重新校准依赖程度。
核心洞见是:“能否完成任务”与“能否调节对外部引导的依赖”是两种正交能力,必须分开测、分开练。关键创新有三点。其一,匹配条件设计——Partial 与 Mixed 共享同一段有用前缀和同一变更点,两者之差恰好隔离“继续跟随已变误导的引导”与“没有后续引导”的影响,可直接度量依赖惯性($\Delta_{\text{switch}}$)。其二,反事实 SFT——每个训练样本把误导性工作流与验证过的正确轨迹配对,最小化 $\mathcal{L}_{\text{SFT}}(\theta)=-\mathbb{E}_x\log\pi_\theta(\tau_+(x)\mid x, W_B(x))$,迫使模型在坏引导在场时仍成功;由于该损失对好工作流下的行为不作任何约束,“选择性拒绝”与“一刀切无视”都能拟合训练数据,二者的区分只能靠泛化,这正是把好工作流留作评估的用意。其三,结果 RL 只优化 $J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta(\cdot\mid x, W_B(x))}[R(x,\tau)]$,让模型自行发现何时该跟、何时该弃,而不是模仿某条被钦定的解法。
方法步骤详情
第一步,工作流构建:固定外部规划模型仅使用正常执行时可见的信息,为每个任务生成有用工作流 $W_+(x)$,并在每个预设变更点 $k$ 生成貌似合理的误导续写 $C_{-k}(x)$,由此导出 $W_G$、$W_B=C_{-0}$、$W_{P_k}$、$W_{M_k}$;独立校验器检查好工作流的有效性与任务相关性、坏工作流的合理性与任务相关性,并统一排查答案泄露,通过后冻结并跨模型共享。第二步,五条件评测:同一模型分别在无引导、好、坏、部分、混合条件下执行(Partial/Mixed 聚合所有变更点),计算四个差分效应。第三步,反事实 SFT:从基座模型采样轨迹并保留验证成功的 $\tau_+(x)$,规划器据此合成一好一坏两条工作流,仅用坏工作流配正确轨迹做自回归负对数似然训练(AIME 上目标是完整正确解答,WebShop 上逐步以正确下一动作为目标)。第四步,结果 RL:以坏工作流输入继续训练,每组采样 $G$ 条轨迹计算组相对优势 $\hat{A}_i$,仅保留奖励非退化的组,优化带裁剪与可选 KL 的 token 级损失(AIME 用二值正确性奖励,WebShop 用环境回报)。第五步,迁移评估:把训练后的检查点免训练地用于 EoM 多智能体推理与 LongMemEval-V2-Small 记忆任务。
技术新颖性
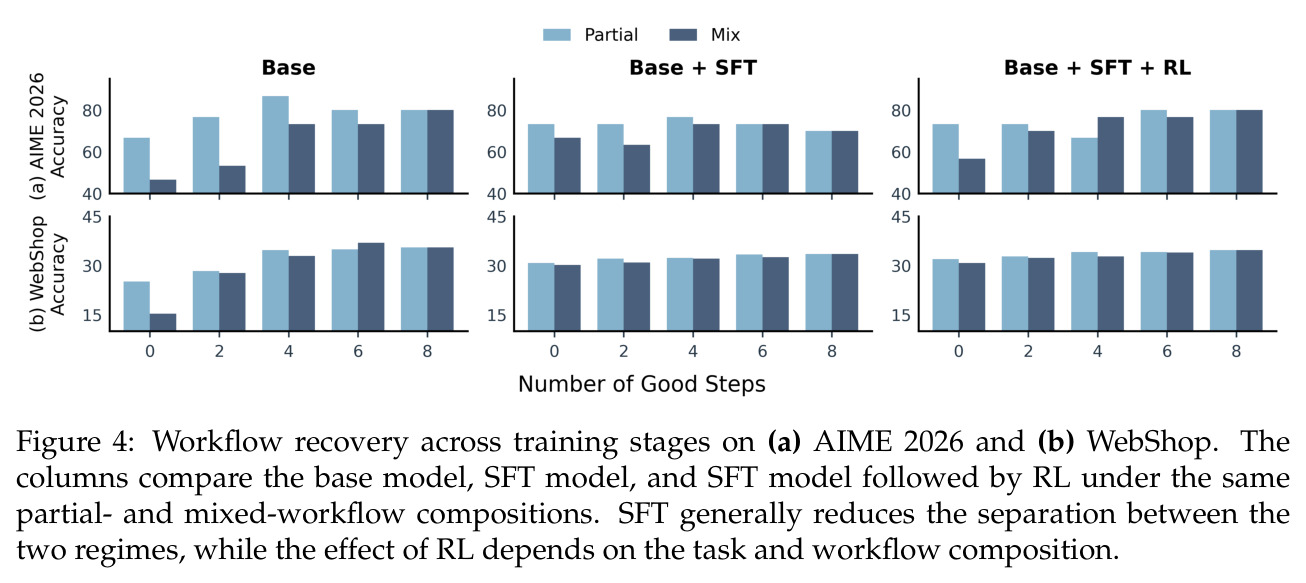
技术新颖性体现在评测与训练两侧。评测侧:以往对引导质量的研究要么改变指令优先级、要么调整 harness 配置,从未在任务与模型严格固定时冻结并交叉共享五条件工作流,把“引导可靠性”作为唯一自变量;四个配对差分效应(利用率、鲁棒性、停止恢复、切换恢复)是全新的度量维度,其中 $\Delta_{\text{switch}}$ 直接刻画依赖惯性,此前没有基准量过。训练侧:反事实 SFT 打破了“监督信号必须与上下文一致”的惯例,故意让条件(坏工作流)与目标(正确轨迹)冲突,从而显式训练覆盖行为;随后用 GRPO 式结果 RL 恢复对好引导的利用。作者刻画出一条此前未被描述的能力形成路径:SFT 先让引导变得“可违抗”(defeasible),代价是利用率坍缩(AIME 上 $\Delta_{\text{use}}$ 从 +13.3 跌至 −3.3);RL 再调整“何时违抗”(回升至 +6.7),使模型从一刀切拒绝走向条件化依赖。
实验结果
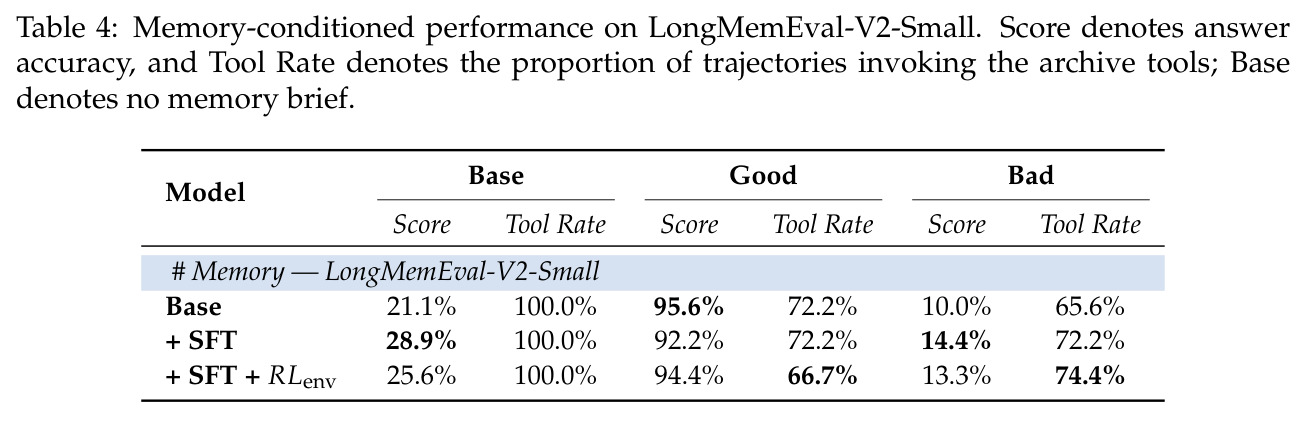
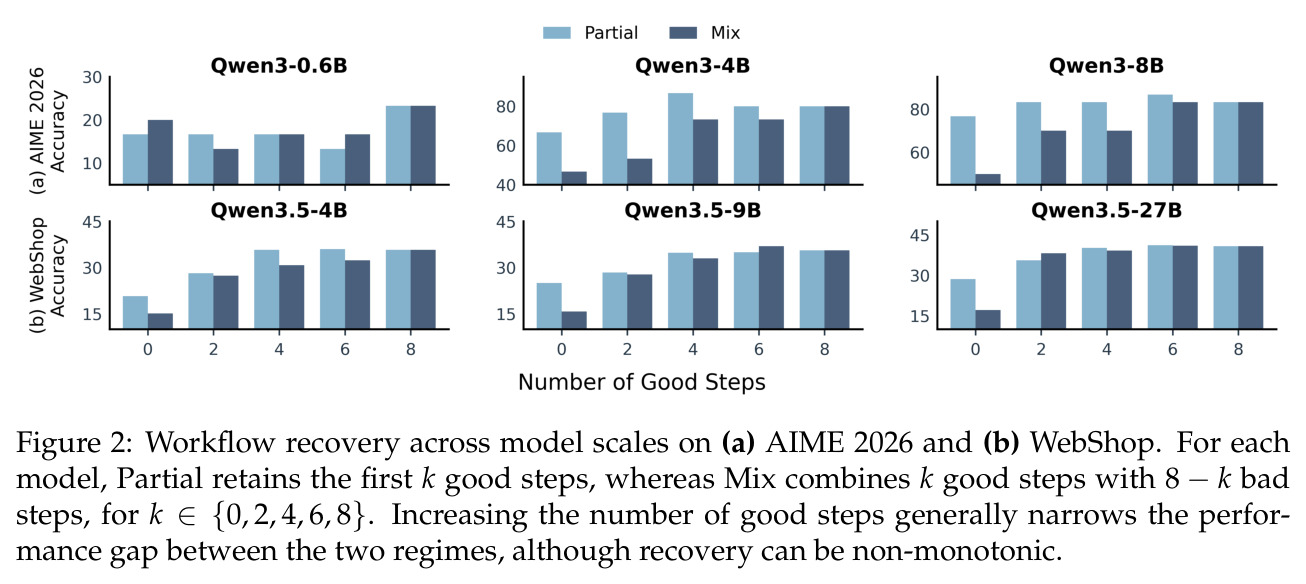
评测发现三件事。第一,利用可靠引导与抵制误导引导是彼此独立的能力:12 个前沿模型—任务对中,好工作流在 8 对上提升成绩(AutomationBench 上 Gemini 3.7 Flash +5.9、DeepSeek V4 Flash +13.7、GLM 5.2 +16.8),而坏工作流在全部 12 对上造成 2.3 至 43.3 点下降;开源模型同样,6 对中好工作流全部提升、坏工作流 5 对下降,且从 Qwen3-0.6B 到 8B、Qwen3.5-4B 到 27B 的规模扩大并不能消除对误导引导的敏感性(如 Qwen3-8B 的 $\Delta_{\text{bad}}$ 仍为 −26.7)。第二,依赖存在惯性:Mixed 比 Partial 在 12 对中的 10 对更差(Gemini 在 OpenR1-Math 上 $\Delta_{\text{switch}}=-36.7$),说明模型会把最初有用工作流建立的信任错误地延续下去。第三,训练有效:AIME 2026 上 Qwen3-4B 的 $\Delta_{\text{bad}}$ 从基线 −20.0 收窄到 SFT 后的 −6.7,SFT+RL 后为 −16.7(仍优于基线);$\Delta_{\text{use}}$ 由 SFT 后的 −3.3 被 RL 恢复到 +6.7;Mixed−Partial 差距从 −14.4 经 SFT 的 −4.4 变为 RL 后的 +1.1。WebShop 上 Qwen3.5-9B 的 $\Delta_{\text{bad}}$ 从 −9.8 降至 −0.6,无引导基线成绩由 25.2% 升至 SFT 30.8%、RL 32.0%。迁移上,EoM 多智能体(30 题×5 集)成功率 18.00%→SFT 22.67%(SFT+RL 为 18.67%),修正/腐坏比从 Base 的 2:2 升到 SFT 的 11:1;LongMemEval-V2-Small 上损坏记忆准确率 65.6%→72.2%(SFT),且损坏记忆下的归档检索率由 10.0% 升至 14.4%,说明验证行为被系统性纠正。
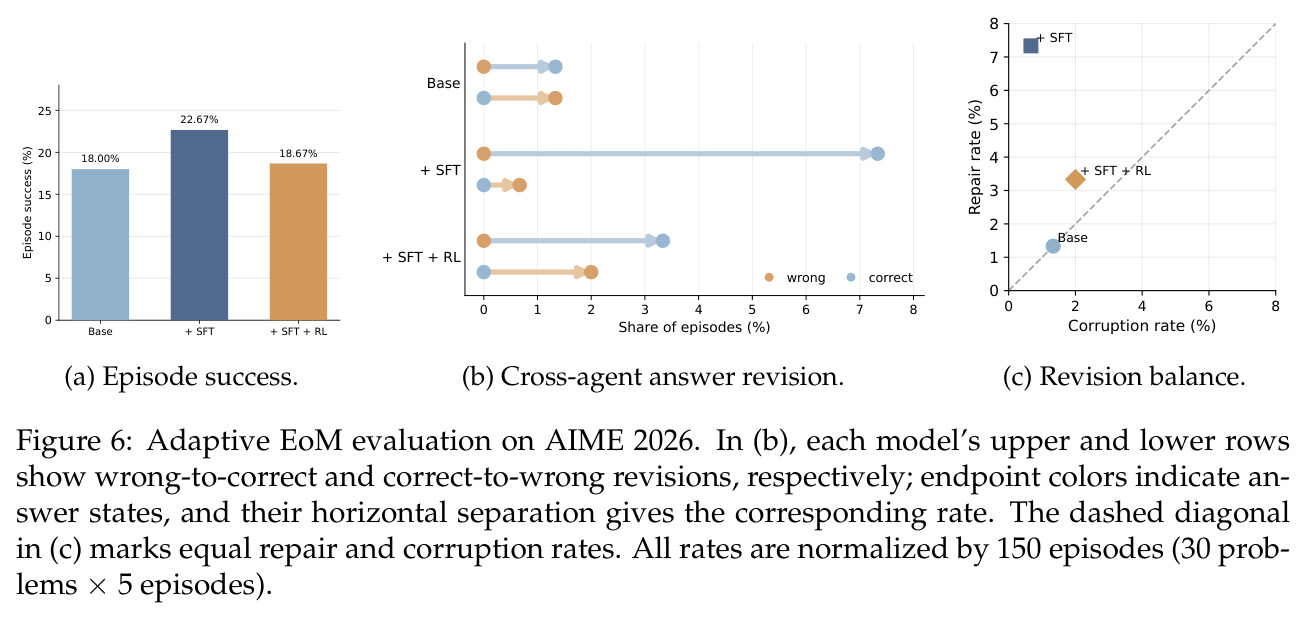
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2026 数学(Qwen3-4B,工作流训练) | 坏工作流鲁棒性 $\Delta_{\text{bad}}=S_B-S_0$ | SFT 后 −6.7;SFT+RL 后 −16.7 | 基座模型 −20.0 | 坏引导损害从 20.0 点缩至 6.7 点(SFT 阶段),RL 后仍保有 3.3 点鲁棒性优势 |
| AIME 2026 数学(Qwen3-4B) | 好工作流利用率 $\Delta_{\text{use}}=S_G-S_0$ | SFT+RL 后 +6.7 | 纯 SFT 为 −3.3 | RL 把被 SFT 抑制的利用率拉回 +10.0 点,同时保住鲁棒性收益 |
| WebShop 搜索(Qwen3.5-9B,工作流训练) | $\Delta_{\text{bad}}$ 与无引导基线成绩 | SFT 后 $\Delta_{\text{bad}}=-0.6$;基线成绩 25.2%→30.8%→32.0% | 基座 $\Delta_{\text{bad}}=-9.8$,基线 25.2% | 鲁棒性提升 9.2 点,绝对成绩提升 6.8 点 |
| OpenR1-Math(Gemini 3.7 Flash,基准评测发现) | 坏工作流下准确率 | 33.3%(暴露 43.3 点脆弱性) | 无引导 76.7%,好工作流 83.3% | 非提升项:量化了前沿模型对误导引导的最大脆弱幅度,论证基准必要性 |
| EoM 多智能体协作(AIME 2026,30 题×5 集=150 episodes) | episode 成功率与修正/腐坏比 | SFT 后 22.67%,11 次修正 vs 1 次腐坏 | Base 18.00%,2 次修正 vs 2 次腐坏 | 成功率 +4.67 点,同伴影响从对称变为压倒性有益(免训练迁移) |
| LongMemEval-V2-Small 记忆增强推理 | 损坏记忆下准确率与归档工具检索率 | SFT:72.2% / 14.4% | Base:65.6% / 10.0% | 准确率 +6.6 点,验证行为(检索率)+4.4 点,且消除了 Base 在损坏记忆下反而少查证的反常 |
局限与改进
作者承认两点局限:其一,用单一固定外部模型充当人类工作流设计者的可扩展代理,未覆盖动机各异、错误模式更多样的真人引导;其二,Box2 通过受控且冻结的工作流改变可靠性,交互式、含糊、部分正确以及随被测模型自适应的引导留待未来研究。我的补充观察:(1) 反事实 SFT 明显牺牲了对好工作流的利用(AIME 上 $\Delta_{\text{use}}$ 从 +13.3 跌至 −3.3),“过度抵抗”是当前训练范式的系统性副作用,RL 也只能部分回补;(2) 迁移收益非单调——EoM 上 SFT+RL(18.67%)反而低于纯 SFT(22.67%),两阶段组合的最优配比并不明确;(3) 多智能体实验仅 150 个 episodes、记忆实验用 Small 子集,统计功效有限,几个百分点的差异可能不稳健;(4) 误导工作流由同一 LLM 家族生成,模型可能依赖生成风格上的破绽而非语义判断来识别坏引导;(5) 数学任务只有二值结果奖励,无法刻画“部分正确”引导这类细粒度情形,而这恰是真实 harness 中最常见的。
独立分析的弱点
独立分析的弱点:其一,工作流校验器是单点故障——如果校验器放过了“变相泄露答案”的坏工作流,$\Delta_{\text{bad}}$ 会被高估;改进方向是引入多个异构校验器投票,并公开人工抽检协议与抽检结果。其二,所有坏工作流出自同一规划模型,风格偏置可能让被测模型学到“识别该模型幻觉模式”的捷径而非通用怀疑能力;改进是训练与评测时轮换多个不同家族的生成器并施加对抗性扰动。其三,训练只用两个任务(AIME 2026 与 WebShop),SFT 后利用率坍缩的幅度在其他领域(如代码、搜索)可能更大,且 WebShop 上 RL 几乎没有恢复利用率;改进是把反事实 SFT 扩展到多域并研究任务数—泛化的标度关系。其四,GRPO 的组相对优势在二值奖励下方差大、仅保留非退化组的条件苛刻,训练稳定性存疑;改进是引入过程奖励或优势截断。其五,模型对“中途变坏”的检测是被动的、隐式的,没有任何显式的可信度估计;改进方向是让模型输出对引导的置信度并据此门控跟随行为,使选择性依赖可解释、可审计。
未来方向
作者提出的方向包括:(i) 评估由真人撰写、具有多样意图与错误模式的引导,检验结论对外部设计者分布的稳健性;(ii) 把静态冻结的工作流扩展为交互式、含糊、部分正确以及随被测模型自适应调整的引导,即引导与执行者之间的动态博弈。基于本文成果可延伸的方向:把选择性依赖与 harness 自动搜索/修复结合,形成“外部适配 + 内部调节”的双边机制;研究该元能力与模型规模的标度律,判断它是否随预训练自然涌现;将反事实 SFT 推广到 RAG 检索噪声、工具返回错误输出等更广的易错信息源;引入显式的引导可信度建模与贝叶斯信任更新,让“何时跟随”成为可解释的决策过程;以及在安全场景下检验该能力能否抵御提示注入——本质上提示注入就是极端形态的坏引导,Box2 的训练范式可能直接构成一种防御。
复现评估
复现评估:训练实验基于开源权重模型 Qwen3-4B(AIME 2026)与 Qwen3.5-9B(WebShop),评测对象还包括可通过 API 获取的 Gemini 3.7 Flash、DeepSeek V4 Flash、GLM 5.2,模型可得性总体良好。基准构建流程在论文中描述完整:规划模型生成、独立校验、冻结后跨模型共享五条件工作流;所涉任务环境(OpenR1-Math、DeepSWE、BrowseComp、AutomationBench、AIME 2026、WebShop、EoM、LongMemEval-V2)均为公开资源,若冻结工作流随论文发布则评测部分可直接复现。训练方面,反事实 SFT 是 4B/9B 规模模型的标准微调,单机多卡即可完成;SFT+RL 需要组采样式强化学习(每组 $G$ 条轨迹、只保留非退化组),算力与工程复杂度显著更高,建议先复现 SFT 结论再攻 RL。论文正文未提及代码与冻结工作流的发布链接,这是复现的最大不确定点;总体而言评测部分复现难度中等、训练部分偏高。
论文图表
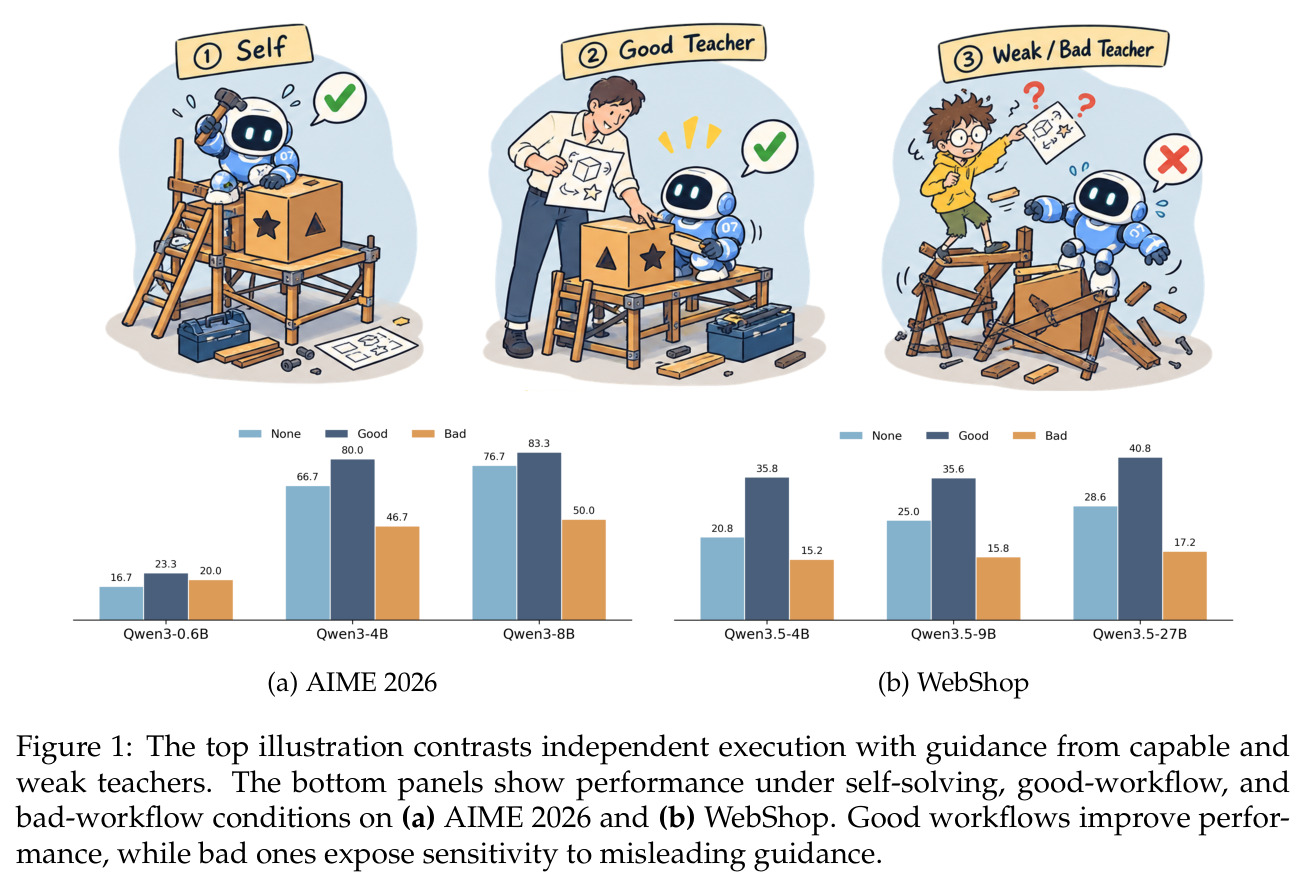
顶部示意图对比模型独立执行与接受“能力强教师/弱教师”引导两种情景;底部柱状图给出自解、好工作流、坏工作流三种条件下 AIME 2026 与 WebShop 的成绩:好工作流普遍提升表现,坏工作流则暴露对误导引导的敏感性。
一图点明全文动机:同一模型在不同可靠性的引导下表现差异巨大,“跳出框架思考”这一问题意识由此引出,是向读者介绍问题的最佳入口。