DAGent:面向深度研究智能体的评估后生长式 DAG 规划 DAGent: Evaluate-then-Grow Planning for Deep Research Agents
逐批生长的增量 DAG 规划替代先规划后修补,并利用 DAG 拓扑设计结构化 RL 信用分配。
前置知识
深度研究(Deep Research)任务
一类信息密集型任务:AI 系统需自主在大型知识空间中导航、综合数十到上百个来源的证据、通过多步推理解决复杂查询。与普通检索问答不同,中间发现会改变后续调查方向,甚至推翻初始假设,因此对规划的动态性要求远高于传统信息搜索。
本文的全部设计(增量规划、分层上下文、拓扑 RL)都是针对深度研究任务中'证据随执行演化'这一特性展开的,理解任务特性才能理解方法动机。
DAG 多智能体系统与 Plan-then-Patch 范式
将任务分解为有向无无环图(DAG),每个节点是一个原子子任务,边表示依赖关系;无依赖的分支可并行执行,每个智能体只看依赖节点的输出而非全部上游历史。现有 DAG 深度研究系统(如 Flash-Searcher、FlowSearch)遵循 Plan-then-Patch:在执行任何节点前先提交覆盖整个任务的完整计划,执行中再通过删改节点来修补。
本文的核心论点是 Plan-then-Patch 在证据最弱时做出最强承诺,是脆弱的;作者提出 Evaluate-then-Grow 作为替代范式,两者的对比贯穿全文所有实验。
ReAct 循环
LLM 智能体的经典执行模式:模型交替输出思考/动作(如搜索、打开网页)与观察结果,直到得出答案。本文中每个 DAG 节点的子任务由一个 ReAct Executor 执行,配备领域工具和 RECALLTOOL,并保留完整的动作-观察序列。
DAGent 的每个节点就是一个 ReAct 智能体的运行轨迹,Executor 的输出(QueryDoc 和 InteractionTranscript)是 Orchestrator 评估和上下文传播的基础。
GRPO(组相对策略优化)
在线 RL 训练 LLM 的主流算法:对同一任务采样一组(group)轨迹,用组内奖励的均值和方差对每条轨迹的奖励做归一化得到优势(advantage),再用 PPO 式的 clip 目标更新策略。传统 GRPO 是 outcome-only 的——轨迹级奖励均匀分配到所有 rollout,忽略轨迹内部结构。
DAGRPO 是 GRPO 的 DAG 条件化改造,理解 GRPO 的组归一化和优势计算才能看懂 DAGRPO 如何在其中注入拓扑信号。
信用分配(Credit Assignment)与答案包含闭包
RL 中的核心难题:当最终奖励只有一个 0/1 时,如何决定轨迹中每部分各贡献多少。本文定义答案包含闭包 $S(\tau)$:answer 节点及其在 DAG 中的全部祖先节点集合,即输出直接或间接进入最终综合的 Executor rollout;闭包外的 rollout 视为'链外'。
DAGRPO 的第一个结构信号就是基于闭包的:链上 rollout 保留完整奖励,链外按系数 $\alpha$ 衰减。这是论文 RL 贡献的关键概念。
研究动机
深度研究任务要求智能体在大型知识空间中导航、跨数十上百个来源综合证据,并随中间发现调整计划。DAG 式多智能体系统(如 Flash-Searcher、FlowSearch)是天然的架构基础:并行执行、每个子任务隔离在聚焦的依赖上下文中。但现有系统都采用 Plan-then-Patch 策略——Flash-Searcher 用一次分解调用产出完整计划再周期性更新,FlowSearch 在多个 planner 迭代中初始化知识流图后才执行、再由 refiner 通过六种编辑操作改写图。两者共同的问题是在任何节点尚未执行、系统对问题理解最浅的时刻,就做出最强的规划承诺;后续修订把算力浪费在原本不该规划的分支上。作者用一个尖锐的表述概括:'系统在证据最弱时承诺最强'(commits most strongly when its evidence is weakest)。随着任务复杂度增长,这种计划承诺与计划修订混杂的轨迹会降低答案准确率并浪费计算。
本文的目标是本文的目标是重新设计 DAG 智能体的规划时机与强化学习目标,使二者都反映'DAG 是增量构建的'这一事实。具体分为三层:(1) 规划层:把'一次性提交完整计划、事后修补'替换为 Evaluate-then-Grow——Orchestrator 每次只生长一批节点,每次扩展都以已完成节点的置信度(confidence)和不确定性(uncertainty)等结构化信号为条件;(2) 上下文层:支持长程证据使用而不让每个子任务的上下文爆炸,默认传播紧凑的 QueryDoc、按需回溯完整执行轨迹;(3) 训练层:利用增量规划产出的逐轮记录的 DAG 拓扑,定义 outcome-only 配方(如标准 GRPO)无法表达的结构化 RL 信号,让不同 DAG 位置的 rollout 获得不同的信用。
与已有工作不同的是,本文的独特切入角度是'规划决策的时机与信息量'。已有工作把 DAG 编辑当作执行失败的补救手段(refine 是修补,规划仍是预先的),而 DAGent 把每个已完成节点的结构化反馈(子任务结果、理由、可靠性)当作规划的必要输入——据作者所知,这是第一个让每个规划决策都以结构化逐节点反馈为条件的深度研究智能体。第二个独特角度是 append-only 性质带来的 RL 机会:由于增量图中节点从不被删除或重连,节点运行时看到的上下文与它在最终图中的祖先严格一致,因此'答案包含闭包'这一拓扑信号无需重执行即可从记录的轨迹中读出;而 Plan-then-Patch 轨迹中节点可能事后被删除或重连,祖先关系与实际读取的上下文不再对应,该信号无法良定义。这把'规划范式'与'可用的 RL 信号'用一条结构性事实串联起来,是概念层面的关键洞察。
核心方法
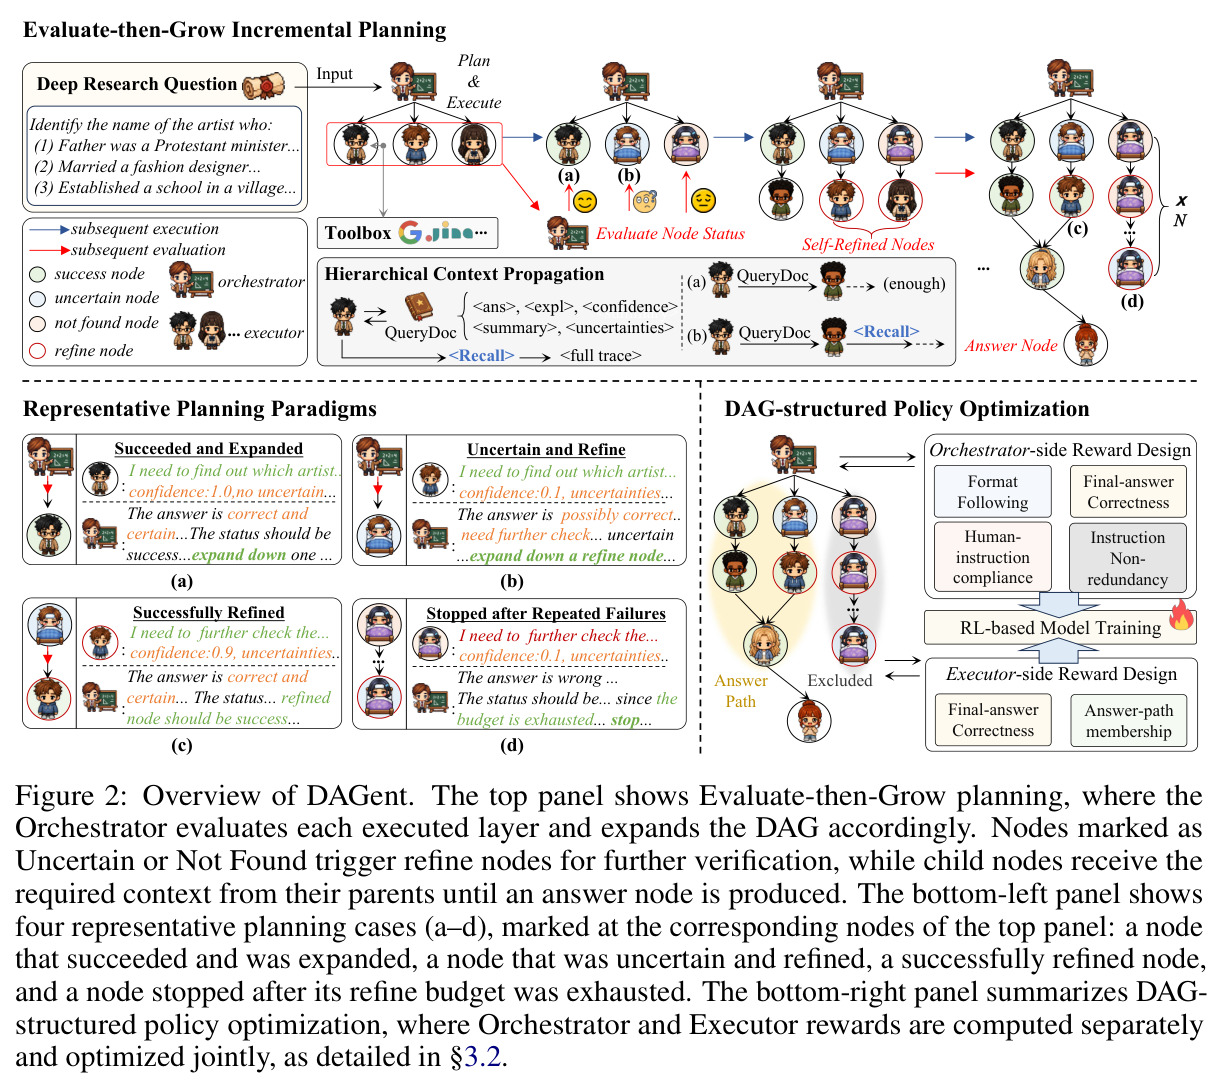
直觉上,DAGent 像一个边干边想的资深研究员:先派出一小批探索任务,等结果回来并评估可靠性后,才决定下一步是扩大战果、回头验证可疑结论,还是收网写答案;而不是出发前就把整个调查方案钉死。技术路线上,任务 $T$ 建模为 DAG $G=(V,E)$,每个节点 $v_i$ 含子任务描述 $\delta_i$、Executor 提示 $p_i$、依赖集 $dep_i$ 和状态 $\sigma_i$。每个节点执行后输出两样东西:紧凑的结构化摘要 QueryDoc $D_i=(\alpha_i, \text{expl}_i, \text{steps}_i, \text{conf}_i, \text{unc}_i)$(答案、解释、关键步骤、$[0,1]$ 置信度、不确定性列表)和完整的交互轨迹 InteractionTranscript $T_i$。Orchestrator 每轮对最新完成批次产出规划决策 $P_k=\pi_O(T, G_k)=(S_k, V_k^{new})$:状态评估 $S_k$ 把每个节点标记为 Success / Uncertain / Not Found,后两者触发 refine 节点(每条线最多 3 次尝试:1 次初始 + 2 次精炼);目标扩展 $V_k^{new}$ 实例化新节点及其依赖边,同批无依赖节点并行执行。当 Orchestrator 调度 answer 型节点(必须单独成批)时终止。训练层面,DAGRPO 在 GRPO 目标上加两个结构信号做奖励塑形,再用角色分离的组归一化计算优势。整个系统的一个关键不变量是 append-only:图中没有节点会被删除或重连,记录的图就是实际运行的图。
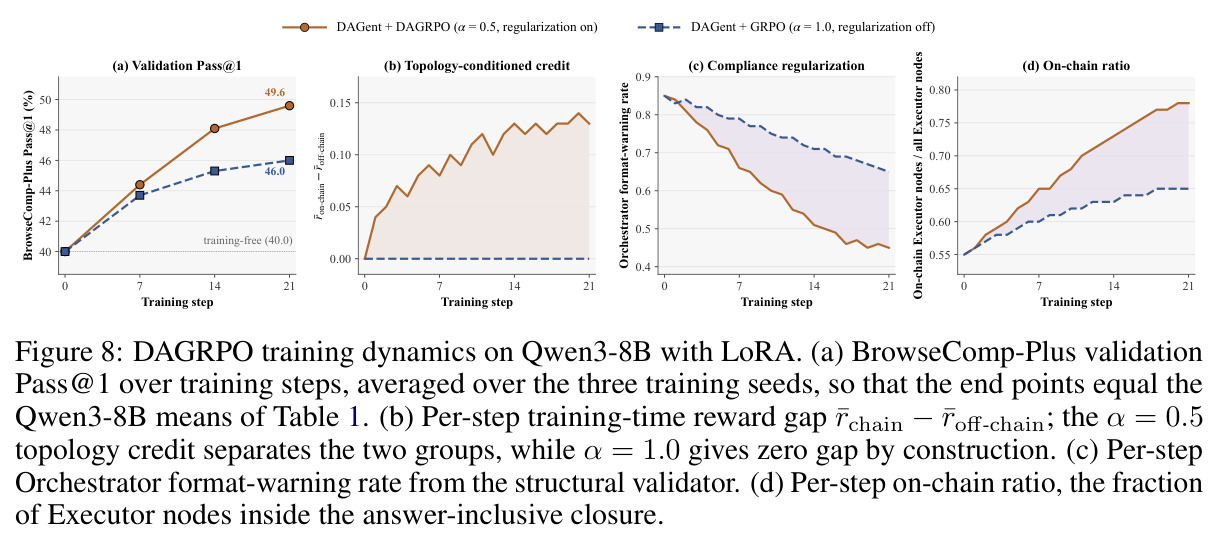
核心创新是与 Plan-then-Patch 的时机对偶:不再'先承诺、后修补',而是'先评估、再生长'。每个规划决策都条件化于已完成节点的 QueryDoc 中的置信度与不确定性字段——这是首次把结构化逐节点反馈作为深度研究规划的一等输入。第二个关键思想是把规划范式与 RL 信号用 append-only 拓扑绑定:增量生长记录的图保证了'节点运行时看到的上下文 = 它在最终图中的祖先',因此答案包含闭包 $S(\tau)$(answer 节点及其全部祖先)是一个无需重执行即可读取的贡献结构代理。DAGRPO 由此注入两个 outcome-only GRPO 无法定义的信号:其一是拓扑条件信用——闭包内的 Executor rollout 保留完整奖励 $R(\tau)$,链外 rollout 的奖励乘以衰减系数 $\alpha$($\tilde{r}_{\text{off-chain}}=\alpha R(\tau)$,训练时 $\alpha=0.5$;无 answer 节点时回退 $\alpha=1$);其二是结构合规正则 $r_{proc}(\tau)=-\lambda_{proc}\min(N(\tau), K_{proc})$,惩罚违反结构约束的 Orchestrator 轮次(节点须有显式状态、可精炼节点须在预算内补 refine、answer 节点须单独成批、不得重复子任务、须输出可解析 JSON 且依赖引用有效),训练取 $\lambda_{proc}=0.3, K_{proc}=5$。此外 Orchestrator 与 Executor 奖励分布不同、rollout 数量不同,组统计量 $(\mu_u, \sigma_u)$ 按角色分离计算,防止数量占优的 Executor 信号淹没 Orchestrator 梯度。
方法步骤详情
完整流程(算法 1)如下。第一步,初始化空图 $G=(\varnothing,\varnothing)$,首批节点仅由任务描述规划(这是唯一一次无证据规划,刻意保持小规模)。第二步,进入迭代循环(每任务上限 $K=30$ 轮,每轮为一层):Orchestrator 读取任务与当前图状态,输出状态评估 $S_k$ 和新节点批 $V_k^{new}$;新节点携带 id(search/refine/answer 三类,如 t1、t1_refine1、t_answer)、自包含描述、给 Executor 的提示和依赖列表。第三步,批内无依赖关系的节点并行执行:每个 ReAct Executor 的上下文按 Selective Propagation 策略构建——默认只拼接直接依赖节点的 QueryDoc(上下文规模由 fan-in 决定而非图深度);每个上下文的 prompt 上限 8192 token、响应(含工具输出)上限 32768 token;Executor 配备搜索、网页打开等工具,单子任务最多 200 轮、评估超时 600 秒。第四步,若紧凑摘要不够用(如需要原文措辞或被否决的候选),Executor 调用 $E=\text{Recall}(v_j, goal, T_j)$:一个语言模型从直接依赖 $v_j$ 的完整 InteractionTranscript 中按 goal 抽取聚焦证据片段,且回溯结果是备用通道而非默认通道。第五步,节点输出 QueryDoc 并存档轨迹,Orchestrator 在下一轮评估并生长,直到调度单独成批的 answer 节点,返回其 QueryDoc 的答案字段。RL 训练时(DAGRPO),每任务采 $G=8$ 条 on-policy 轨迹,LLM judge 给轨迹级 $R(\tau)\in\{0,1\}$,按公式 (5)(6) 以 DAPO 式非对称 clip($\epsilon_\ell=0.20, \epsilon_h=0.28$)优化,LoRA rank 64、AdamW 学习率 $1\times10^{-5}$、2×H200 上训练 21 步。
技术新颖性
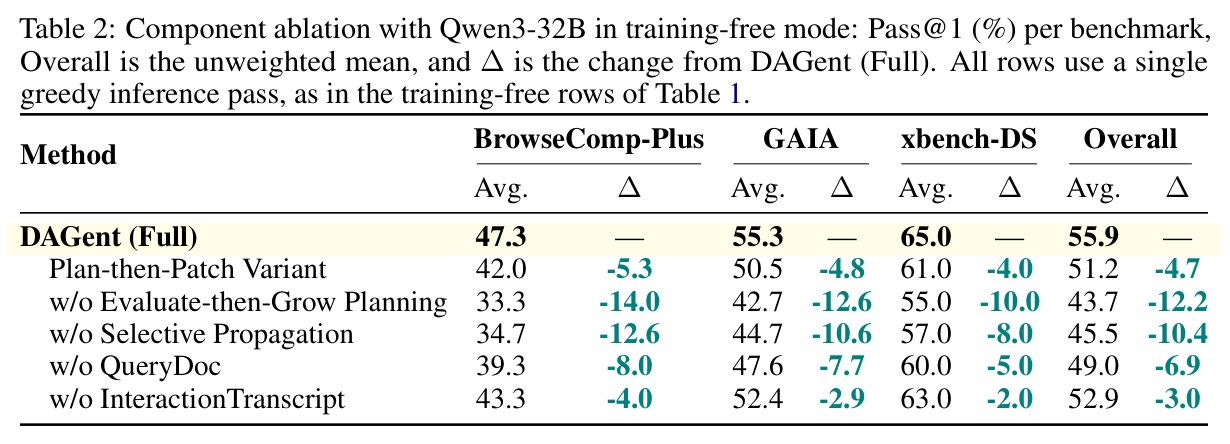
技术新颖性有四点。第一,规划范式层面:作者论证 Evaluate-then-Grow 与 Plan-then-Patch 的区别在于决策时机与决策时的信息量,而非一次调用产出多少节点——Flash-Searcher 一次分解调用、FlowSearch 多轮 planner 迭代,都发生在执行前;DAGent 中包括 answer 节点在内的每个节点都在其依赖执行并评估之后才被创建。同架构消融(表 2)证明仅改这一时机就损失 5.3/4.8/4.0 分,完全 upfront 规划再损失 8.7/7.8/6.0 分。第二,RL 层面:与 DeepPlanner 的熵塑形、Graph-GRPO 的固定通信拓扑、M-GRPO 的纯角色信用、CCPO 的反事实移除相比,DAGRPO 的拓扑条件信用依赖'rollout 是否喂给 answer 节点'这一仅由 append-only 轨迹决定的结构事实,且作者论证该信号不可被训练时膨胀依赖边所利用(额外每条边都会把无关 QueryDoc 塞进下游上下文从而损害准确率)。第三,工程层面:Selective Propagation + RECALLTOOL 的分层上下文把每节点上下文规模与图拓扑(fan-in)绑定而非总轨迹长度,按需回溯完整轨迹(附录统计:仅 11.0–22.0% 任务触发 recall)。第四,实证层面:增益跨三个基准、四个厂商骨干和 GPT-5@327K 复现,且效率分析表明增益来自更精准的证据扩展而非更多计算——Plan-then-Patch 变体反而多花 40/29/18% token。
实验结果
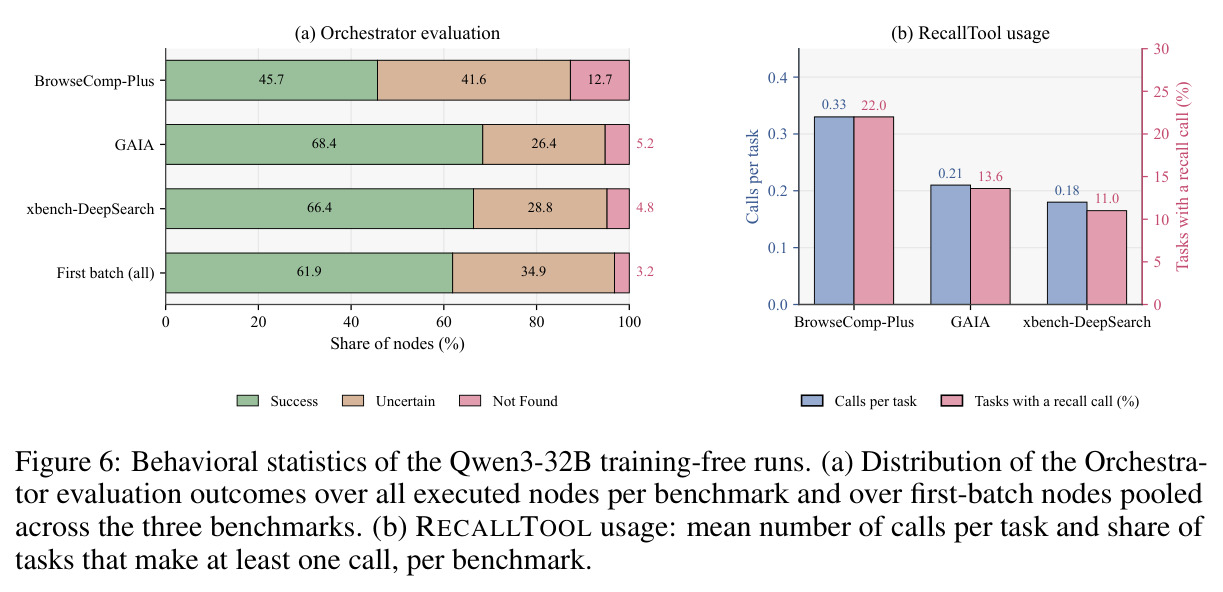
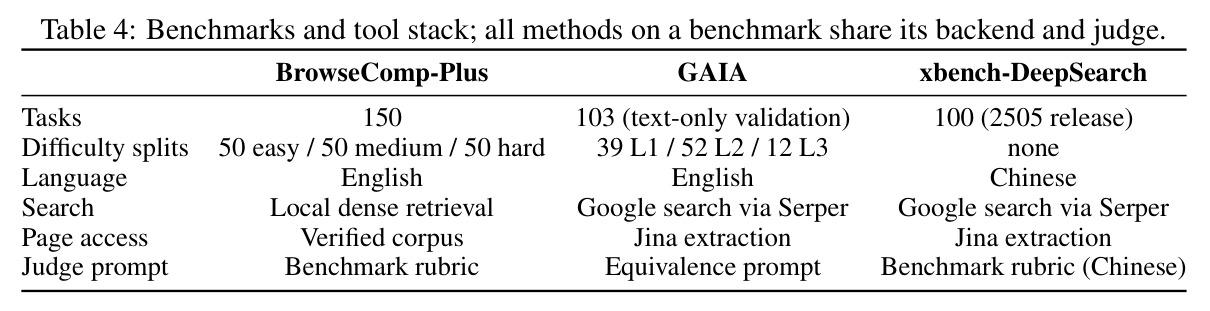
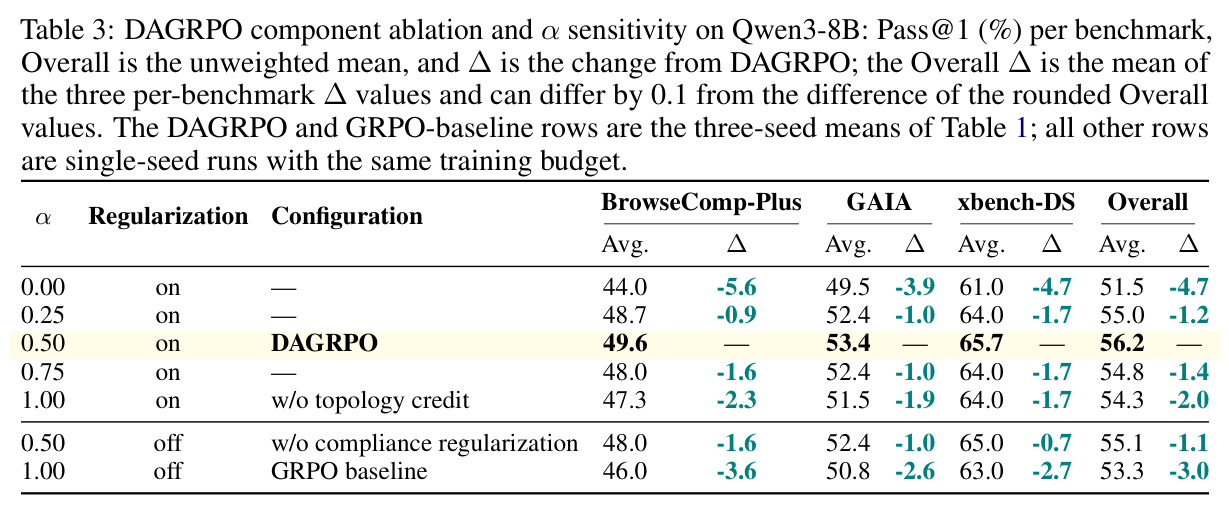
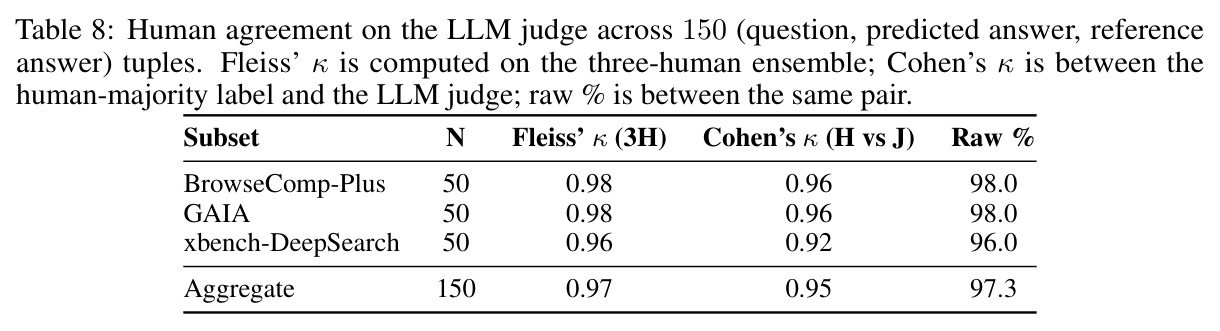
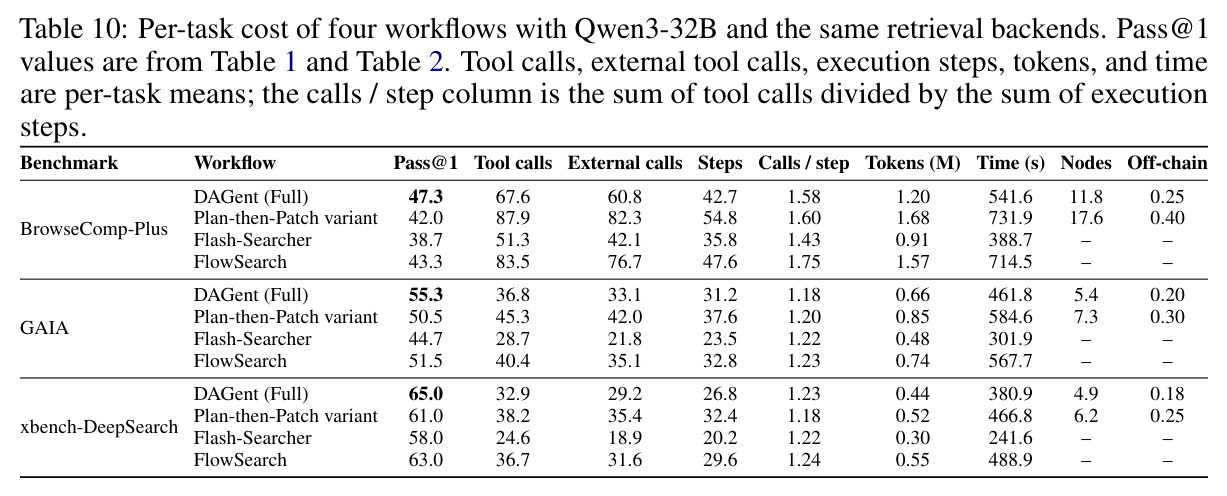
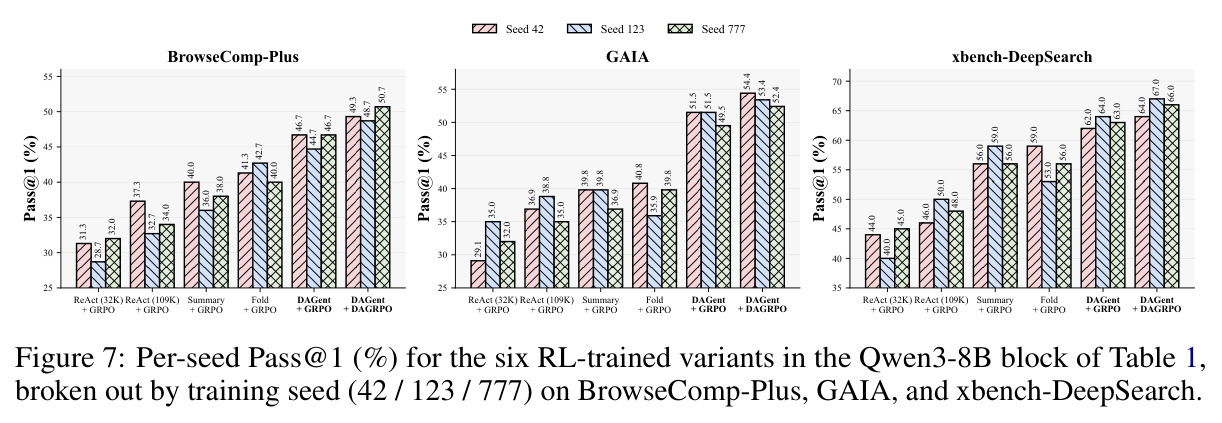
论文围绕四个研究问题组织实验。RQ1(主结果,表 1):训练自由模式下,Qwen3-32B 的 DAGent 在 BrowseComp-Plus / GAIA / xbench-DeepSearch 上达到 47.3 / 55.3 / 65.0 Pass@1,比该规模最强基线 FlowSearch(43.3 / 51.5 / 63.0)高 4.0 / 3.8 / 2.0 分,比其余基线最强者高 6.0 / 10.6 / 7.0 分;Qwen3-8B 为 40.0 / 46.6 / 60.0(+5.3 / +7.8 / +5.0),Qwen3-235B-A22B 为 61.3 / 63.1 / 72.0(+5.3 / +5.8 / +2.0),且各难度分段全部持平或领先。RQ2(跨骨干,图 3/4):在 Seed-OSS-36B、GLM-4-32B、Nemotron-3-Nano-30B 三个额外厂商骨干上均保持第一(如 Seed-OSS-36B 上 54.0 / 54.4 / 69.0);GPT-5@327K 下领先最强已报告基线 5.7 / 2.5 / 2.0 分。RQ3(消融,表 2/3):同架构下把 Evaluate-then-Grow 换成 Plan-then-Patch 损失 5.3 / 4.8 / 4.0 分,进一步退化为单次 upfront 规划再损失 8.7 / 7.8 / 6.0 分(合计 14.0 / 12.6 / 10.0);上下文组件中 Selective Propagation(-12.6 / -10.6 / -8.0)> QueryDoc(-8.0 / -7.7 / -5.0)> InteractionTranscript(-4.0 / -2.9 / -2.0)。RL 层面,DAGRPO 把 Qwen3-8B DAGent 从 40.0 / 46.6 / 60.0 提升到 49.6 / 53.4 / 65.7(三种子均值),比同预算 outcome-only GRPO 基线(46.0 / 50.8 / 63.0)高 3.6 / 2.6 / 2.7、平均 +3.0 分;同一 GRPO 配方给其他可训练基线带来 2.9–10.7 分提升,说明 DAGRPO 的额外增益定位于结构信号。$\alpha$ 扫描在三个基准上都在 0.5 达到峰值:$\alpha=0$ 跌破 GRPO 基线,$\alpha=0.25$ 保留 75/62/37% 增益;去掉拓扑信用损失 2.3 / 1.9 / 1.7 分,去掉合规正则损失 1.6 / 1.0 / 0.7 分。RQ4(效率,图 5、表 10):Plan-then-Patch 变体使链外 Executor 比例从 0.25 / 0.20 / 0.18 升至 0.40 / 0.30 / 0.25,多花 40 / 29 / 18% token、28 / 21 / 21% 步骤、35 / 27 / 21% 外部工具调用(82.3 vs 60.8 次等)和 35 / 27 / 23% 墙钟时间(731.9 s vs 541.6 s),准确率反而低 5.3 / 4.8 / 4.0 分。行为统计(图 6)显示 Uncertain + Not Found 在 BrowseComp-Plus 占 54.3% 的已执行节点(负面证据是常规规划输入);首批节点 61.9% Success / 34.9% Uncertain / 3.2% Not Found,refine 挽救 44.4% 的弱首节点;含结构违规的任务比无违规的低 14.7 分(43.6 vs 58.3)。LLM judge 经人工校准:与三人多数标签的聚合 Cohen's $\kappa=0.95$、原始一致率 97.3%(表 8)。
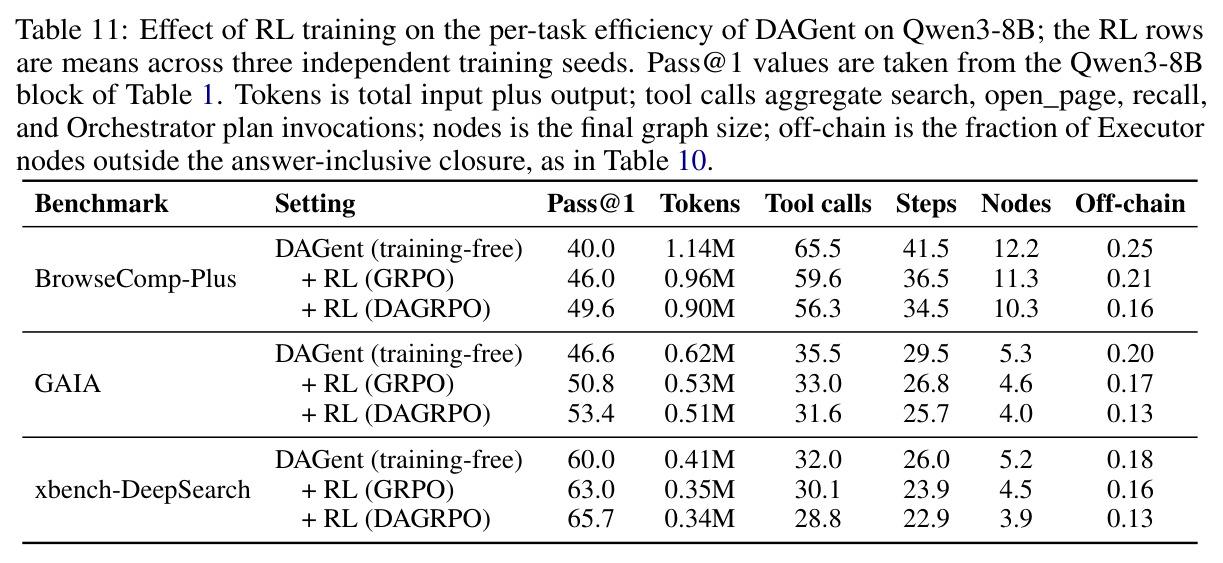
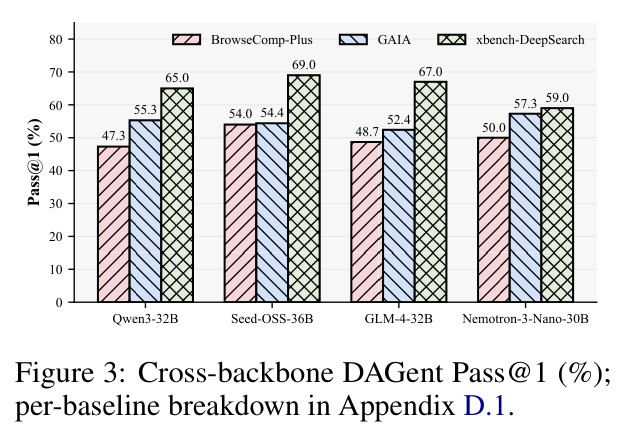
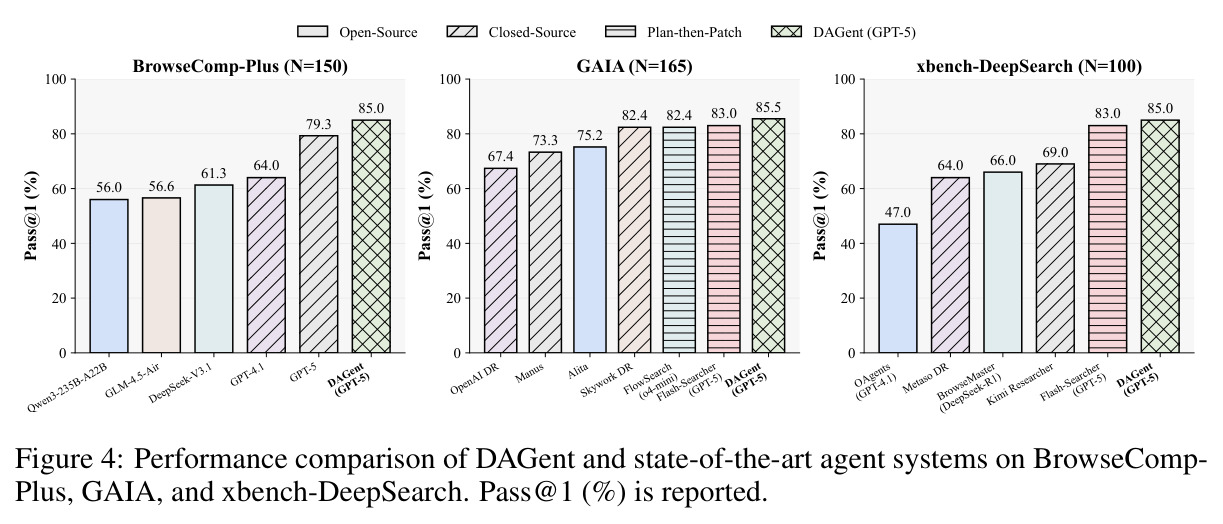
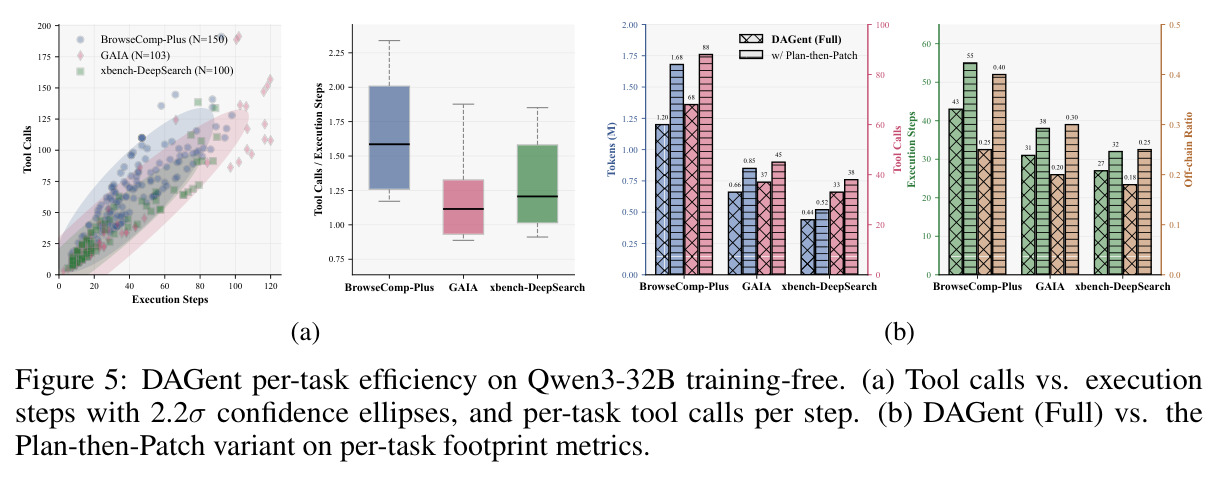
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BrowseComp-Plus(150 题,本地稠密检索,Qwen3-32B 训练自由) | Pass@1 (%) | 47.3 | FlowSearch 43.3(最强基线);Flash-Searcher 38.7 | +4.0 |
| GAIA(103 题文本子集,Google 搜索,Qwen3-32B 训练自由) | Pass@1 (%) | 55.3 | FlowSearch 51.5 | +3.8 |
| xbench-DeepSearch(100 题中文,Qwen3-32B 训练自由) | Pass@1 (%) | 65.0 | FlowSearch 63.0 | +2.0 |
| 三基准平均(Qwen3-235B-A22B 训练自由) | Pass@1 (%) | 61.3 / 63.1 / 72.0 | 最强基线 Flash-Searcher 52.7 / 55.3 / 70.0 | +5.3 / +5.8 / +2.0 |
| 三基准(Qwen3-8B + DAGRPO,3 种子均值) | Pass@1 (%) | 49.6 / 53.4 / 65.7 | 同预算 GRPO-DAGent 46.0 / 50.8 / 63.0 | +3.6 / +2.6 / +2.7(平均 +3.0) |
| 三基准(GPT-5 @327K 上下文) | Pass@1 (%) | 领先最强已报告基线 | 开源/闭源 SOTA 智能体系统 | +5.7 / +2.5 / +2.0 |
| 同架构规划范式消融(Qwen3-32B,三基准平均) | Pass@1 (%) | 55.9(Evaluate-then-Grow) | Plan-then-Patch 变体 51.2;单次 upfront 规划 43.7 | +4.7 / +12.2 |
局限与改进
作者承认的局限:(1)DAGent 是文本原生的——GAIA 全集 165 题评测时,62 道多模态题通过 inspector 工具把附件预转换为文本描述再进入规划,多模态证据若要在循环内原生处理需改动 Orchestrator 评估和 Executor 轨迹表示,不只是加工具;(2)系统只能规划工具返回的证据,无法创造检索器没检索到的内容,准确率受搜索引擎、嵌入模型和页面抽取质量制约;(3)答案包含闭包是贡献的结构代理而非因果归因,结构合规与准确率的 14.7 分差距是相关性观察而非因果估计;(4)三个基准都是 LLM judge 可验证的闭式答案,开放式报告生成不在证据范围内;(5)RL 只在 Qwen3-8B + LoRA + 21 步 + 3 种子上验证,DAGRPO 增益在更大训练规模、更长 schedule 或全参微调下是否保持未确立。我的补充观察:置信度 $\text{conf}_i$ 和不确定性 $\text{unc}_i$ 由 Executor 自报,其校准质量未被单独评估,小模型上自报可靠性可能失真并连锁影响 Orchestrator 评估;首批节点仍是唯一的无证据规划(61.9% Success),Plan-then-Patch 的'最弱时刻承诺'问题在此有残余;与 FlowSearch 的受控对比仅在 Qwen3-32B 一个规模进行;每任务节点数很少(GAIA 5.4、xbench 4.9),多数任务一两轮即收网,DAG 架构的并行优势在轻任务上可能不划算;每条线 3 次尝试上限是硬编码的,复杂任务可能需要自适应预算。
独立分析的弱点
弱点一:可靠性信号是自报的。QueryDoc 的 $\text{conf}_i\in[0,1]$ 与 $\text{unc}_i$ 由 Executor 自己生成,论文没有校准实验(如置信度与实际正确率的相关性);若 8B 级模型过度自信,Uncertain 节点会被误判为 Success 而跳过 refine。改进方向:用检索证据的覆盖率、来源一致性等客观指标校准置信度,或像校准 LLM judge 一样对自报置信度做温度缩放。弱点二:闭包信用是粗糙的结构代理。链上/链外的二值划分不区分链上节点贡献大小(一个只提供背景的祖先与一个提供关键事实的祖先同权),且多父节点均分使信用进一步稀释。改进方向:在闭包内按子节点对 QueryDoc 的实际引用率加权,或用消融式重打分做更细粒度归因。弱点三:负面证据处理依赖 refine 预算上限。3 次尝试后'接受缺口继续前进',在 BrowseComp-Plus 的 hard 分段(最高也只有 22 分@235B)上,检索不到的证据无从补偿;改进方向:把搜索预算动态转向替代信息源(如本地语料 vs 网页),或引入假设驱动的反向验证节点。弱点四:RL 验证规模小。仅 8B/LoRA/21 步,$\alpha=0.5$ 的峰值可能是该小规模下的偶然最优;改进方向:在 32B 或全参微调下复跑 $\alpha$ 扫描,并检验 $K_{proc}$ 上限的敏感性。弱点五:多智能体逐节点上下文的固定开销。表 10 显示 Flash-Searcher 这类单轨迹系统在低成本端仍有一席之地(虽准确率低 8.6–10.6 分),DAGent 在简单任务上可能过度工程化;改进方向:引入复杂度估计器,简单查询退化为单轨迹执行。
未来方向
作者提出的方向:在循环内原生处理多模态证据(改动 Orchestrator 的证据评估方式与 Executor 的轨迹表示);DAG 内的逐节点因果归因(作者明确说这是开放问题);把评测扩展到开放式报告生成任务。基于成果可延伸的方向:(1)把 DAGRPO 的拓扑信用从二值闭包推广为连续的贡献权重,例如学习一个轻量归因头预测每条边对最终答案的边际贡献,与 reachability 信号互补;(2)将 Evaluate-then-Grow 与 test-time scaling 结合——由于图是逐批生长的,可以在每个分支上维持多个假设并按证据淘汰,天然支持 best-of-N 式的分支级采样;(3)训练一个显式的'规划价值模型'替代 Orchestrator 的自评估,用已完成批次的评估结果作为监督信号;(4)把 RECALLTOOL 的按需回溯推广为跨任务记忆检索,让历史任务的 InteractionTranscript 成为可复用证据库;(5)在更大模型与全参微调下检验 DAGRPO,特别是探索 $\alpha$ 的退火调度(训练早期 $\alpha\to1$ 保证探索、后期衰减聚焦链上);(6)把结构合规校验器扩展为可微或可学习的约束,使 Orchestrator 内化规划规范而非依赖外部惩罚。
复现评估
复现条件较好。代码已开源(https://github.com/hanwenliu6825/DAGent),附录 G 逐字给出了 Orchestrator/Executor/Recall 提取与三个 LLM judge 的全部提示词,附录 C 列出全部框架参数(上下文 8K+32K、迭代上限 30、单子任务 200 轮、每线 3 次尝试等)与基线预算(表 6),附录 E.1 给出全部三种子逐种子数值,配置写入每条结果记录。数据与工具栈全部公开可得:BrowseComp-Plus 用 Qwen3-Embedding-8B 本地稠密检索 + 官方 680/150 划分,GAIA 用 Serper Google 搜索 + Jina 页面抽取,xbench-DeepSearch 同栈;训练仅需 2×H200、LoRA rank 64、21 步更新(每批 32 任务、每任务 8 rollouts),是普通实验室可负担的规模。主要门槛在于:(1) RL 训练依赖异步 vLLM rollout 的工程搭建(基于 VeRL,默认参数可继承);(2) LLM judge 需 GPT-4o-mini + GPT-4.1 tie-breaker 及作者的三套 prompt,评测成本主要是推理调用(每任务 0.44–1.20M token);(3) 训练自由模式下主干模型需支持 32K 子任务预算;FlowSearch 基线需按附录 C.3 的三处修改(角色模型替换、启用 Coordinator、限制工具集)才能公平对比。总体难度中等:推理复现容易,RL 部分需要对 VeRL/GRPO 训练栈有操作经验。
论文图表
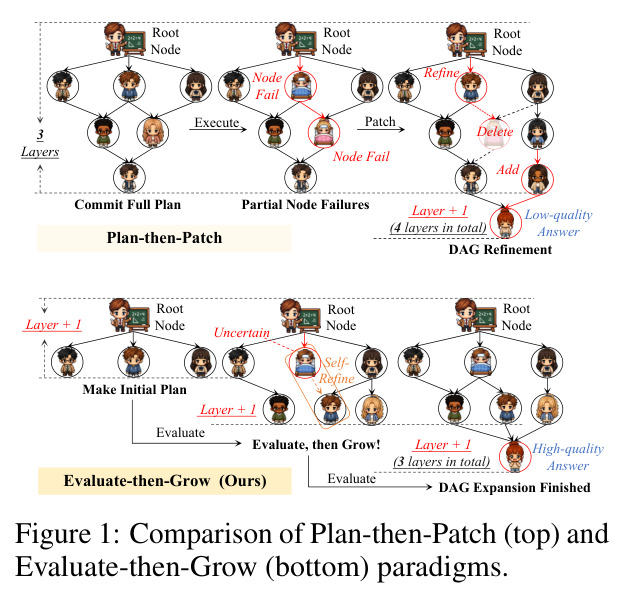
上下两栏对比两种规划范式:上方的 Plan-then-Patch 在执行前一次性提交覆盖全部层的完整计划(共 4 层),节点失败后通过 Refine/Patch/Delete/Add 等编辑操作修补既有图;下方的 Evaluate-then-Grow 图 initially 几乎为空,每执行一层就评估一次(标记 uncertain/success 等状态),再依据评估结果生长下一层(共 3 层即完成),直到产出高质量答案。
这张图是全文核心论点的可视化:两种范式的本质区别不在图的结构,而在规划决策的时机与决策时可用的信息量。理解了这张图就理解了为什么 append-only 生长能支撑后续的拓扑 RL 信号。