虚假前沿:自进化搜索代理中共谋作弊的诊断与缓解 False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents
自进化搜索代理中出题者与解题者共享错误形成共谋;源级交叉拟合反馈切断回路,七基准平均提升8.8点。
前置知识
自进化搜索代理(proposer–solver 自博弈循环)
不依赖人工标注、自己生成训练经验的搜索增强 LLM:proposer(出题者)把源文档转成问题与伪标签,被采纳的问答对训练 solver(解题者),solver 的表现再反过来决定 proposer 的奖励,循环往复自动生成课程。Dr. Zero 是代表系统,也是本文的诊断载体。
本文诊断和修复的正是这个闭环中的奖励回路,理解出题、训练、打分三个环节如何衔接,才能看清“共谋”发生在哪一环、干预应该加在哪里。
伪标签确认偏差
在半监督学习中,模型用自己或教师生成的伪标签训练自己,一旦伪标签错误,模型会把该错误当作监督信号加以强化,错误随训练轮次自我放大(Arazo et al., 2020)。典型表现是模型在错误样本上的置信度越来越高,而真实准确率停滞甚至下降。
co-cheating 可视为确认偏差在双智能体系统中的放大版:错误不仅被自己学走,还会经由反馈回路被当作“进步”而奖励,理解这一概念才能领会假一致质量的含义。
交叉拟合(Cross-fitting)
源自计量经济学 double/debiased ML(Chernozhukov et al., 2018):把数据分成若干折,预测某一折的 nuisance 函数时只用其他折训练模型,保证预测与被预测数据独立,消除同数据上既拟合又评估的过拟合偏差。
CrossFit 方法直接借用其“排除”原则——评估某源派生问题的 solver 必须从未在该源上训练过。理解这一统计学渊源是领会方法命名与设计动机的关键。
策略梯度与序列归一化优势
强化学习中直接对 $\log \pi_\theta$ 求梯度的方法。本文把每条轨迹的奖励做组内标准化得到优势 $\hat{A}_e$,损失按可训练 token 数加权;prompt、工具与 proposer 终答案 token 被掩蔽,仅 solver 答案 token 参与更新(公式1)。
论文的训练目标与 Dr. Zero 的前沿奖励 $f(k)=(5-k)/4$ 都建立在这个框架上,CrossFit 只替换打分者而不改动目标函数,读懂公式1和公式(奖励)离不开它。
Cover-EM 与多跳问答基准
宽松的答案匹配指标:归一化(大小写、标点、冠词、空白)后,非空参考答案出现在预测中即得 1 分。多跳基准(HotpotQA、MuSiQue、2WikiMQA、Bamboogle)需串联多份证据,单跳含 NQ、TriviaQA、PopQA。
论文所有下游结论都在这套 1,325 题、7 个基准的固定评测集上以 Cover-EM 度量,且多跳任务恰恰是 CrossFit 收益最大的地方,读懂表格必须掌握指标与任务构成。
研究动机
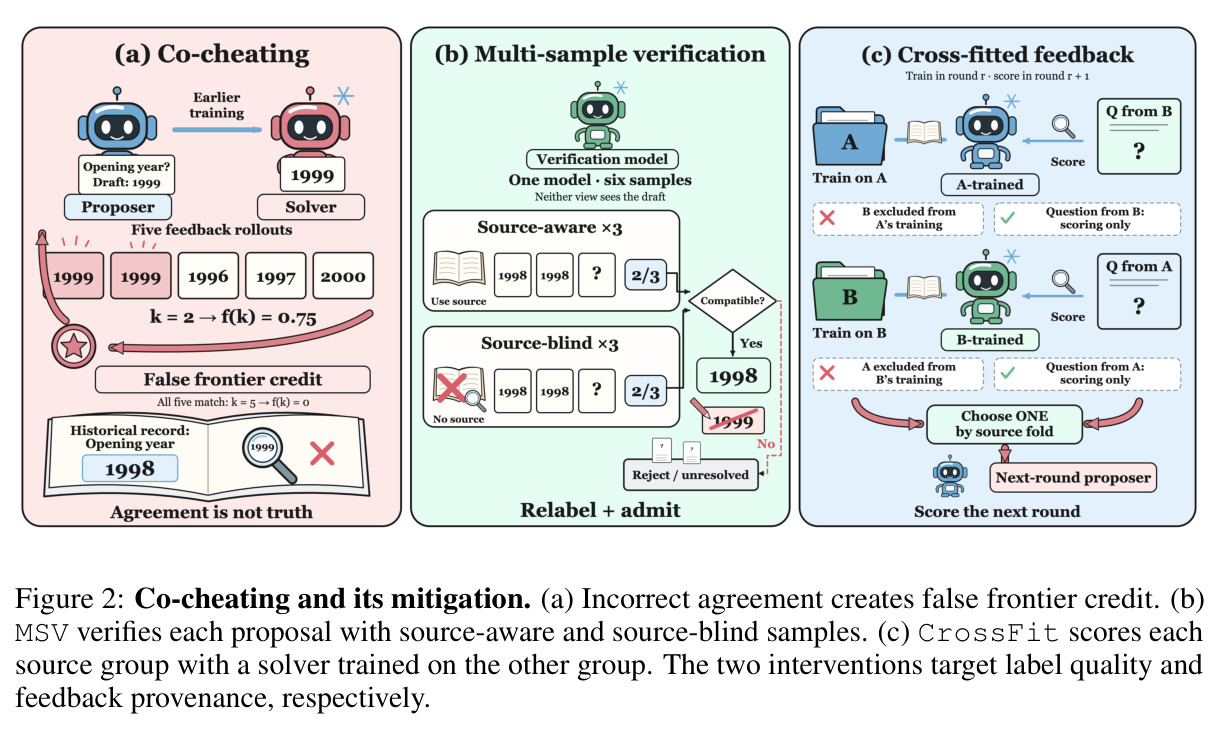
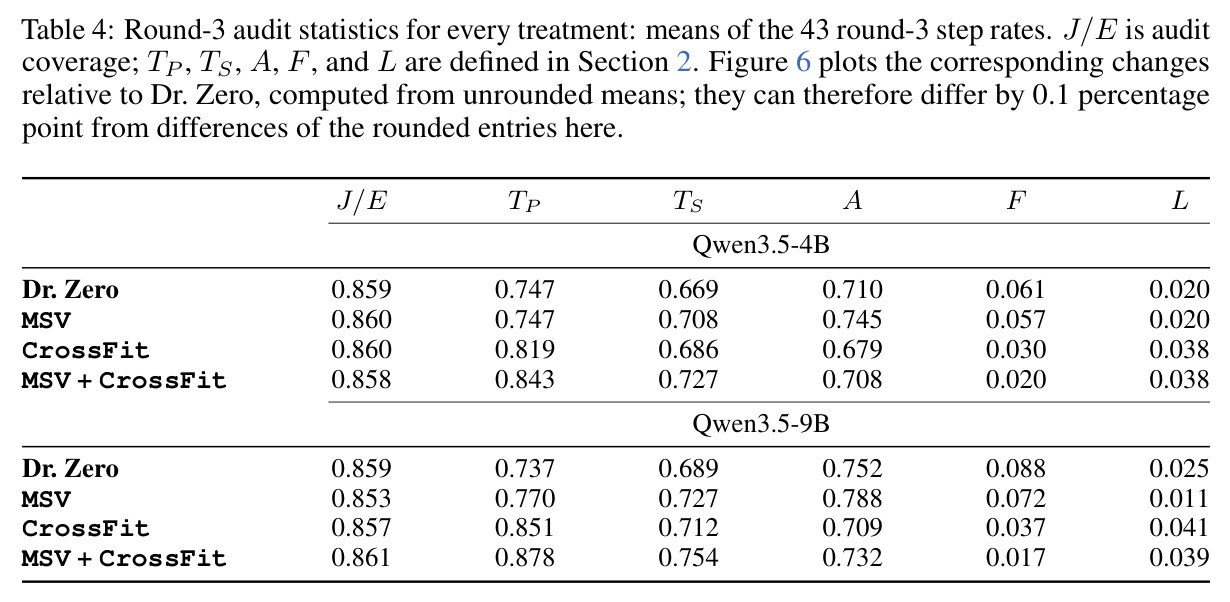
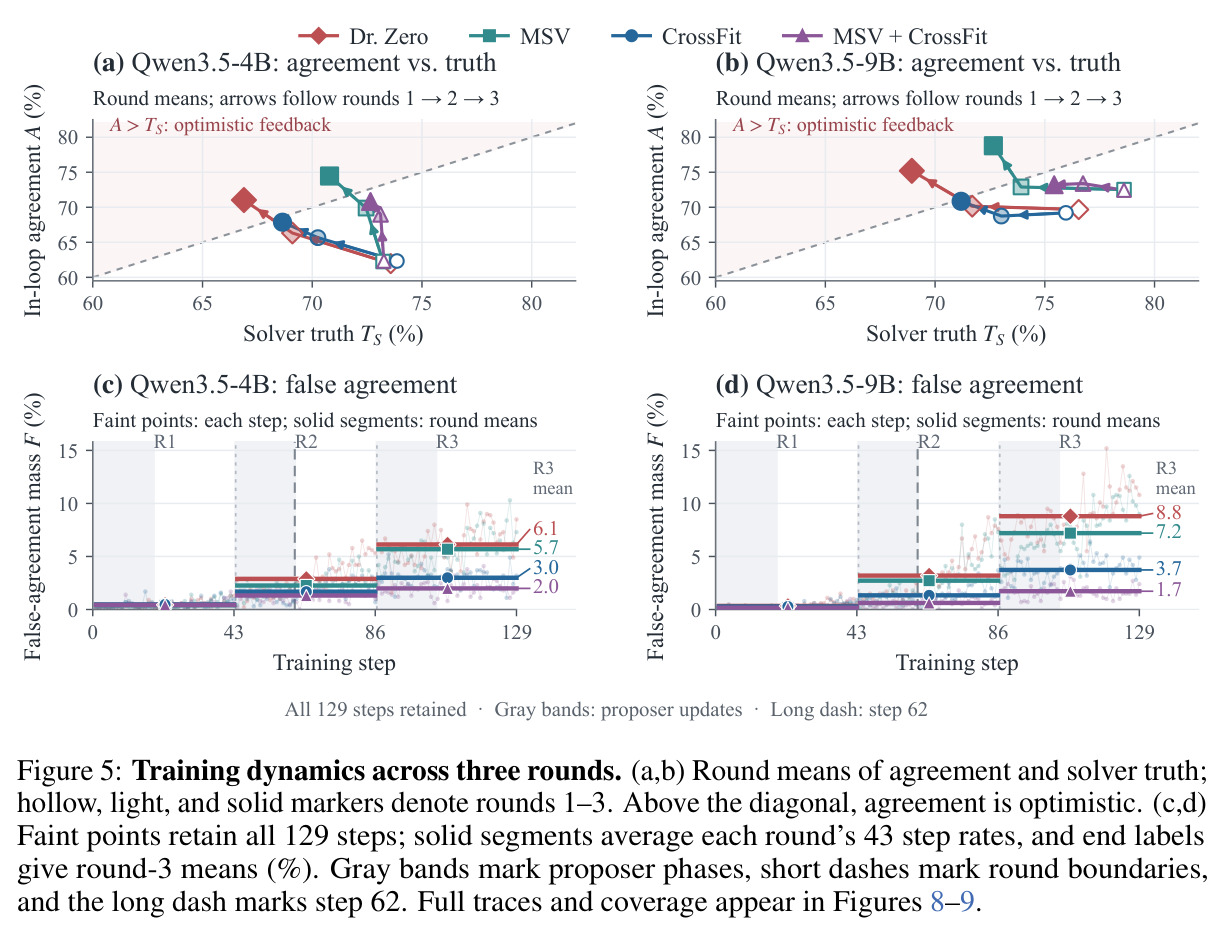
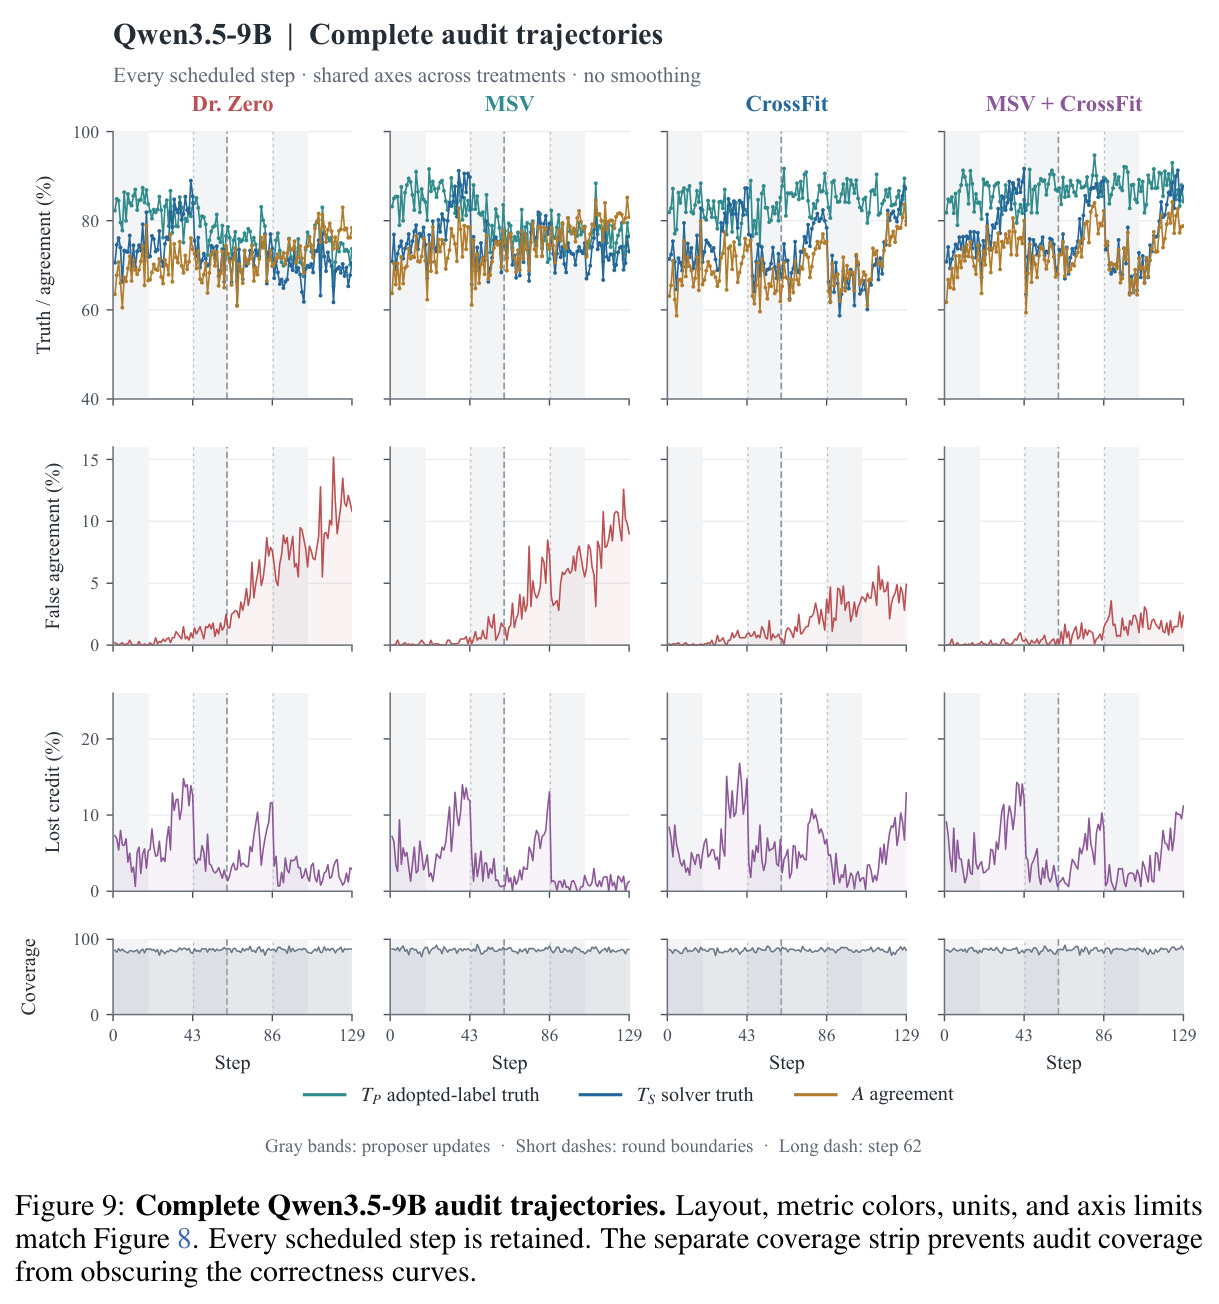
以 Dr. Zero 为代表的自进化搜索代理构建了一个闭环:proposer 从源文档生成问题与伪标签,solver 用被采纳的问答对训练,再以 solver 的表现反过来决定 proposer 的奖励,如此往复自动生成课程、无需人工标注。该设计使“一致率”成为内生的正确性代理——一个错误伪标签会把 solver 训得在来自同一源文档的后续问题上复现同一错误,而这种“假一致”又被前沿奖励 $f(k)$ 记为 proposer 的功劳,误差被逐轮放大。作者用不参与训练的事后审计器(gpt-6-astra/high 基于源文档构建有证据参考后判卷)量化了这一现象:在 Qwen3.5-4B/9B 上,第 1 轮假一致质量 $F$ 仅 0.004/0.003,到第 3 轮升至 0.061/0.088,同时失去信用 $L$ 反而下降;即内部训练信号(一致率)持续上升,而外部正确性停滞——“前沿”是虚假的,这就是本文命名的 co-cheating(共谋作弊)。
本文的目标是论文有双重目标。诊断层面:在不改变训练过程的前提下,对自进化循环的每个调度步保存源文档、采纳伪标签以及用于计算 proposer 奖励的 5 个 solver 回复,由独立审计器判定采纳标签正确率 $T_P$、solver 回答正确率 $T_S$、标签—回答一致率 $A$、假一致质量 $F$(双方匹配同一错误答案的比例)与失去信用 $L$(solver 回答正确却被错误标签拒绝奖励),从而把“真实进步”与“共享错误”区分开,并证明一致率上升可以在真值不动的情况下由假一致驱动。干预层面:设计能在保留自动化课程优势的同时抑制共谋的机制——先检验直接思路 MSV(训练前验证每个提案),在其暴露成本高、残留共谋的局限后,提出更根本的 CrossFit,通过改变 proposer 反馈信号的训练来源切断同源错误的返回路径,最终在 7 个下游搜索基准上验证外部正确性的真实提升。
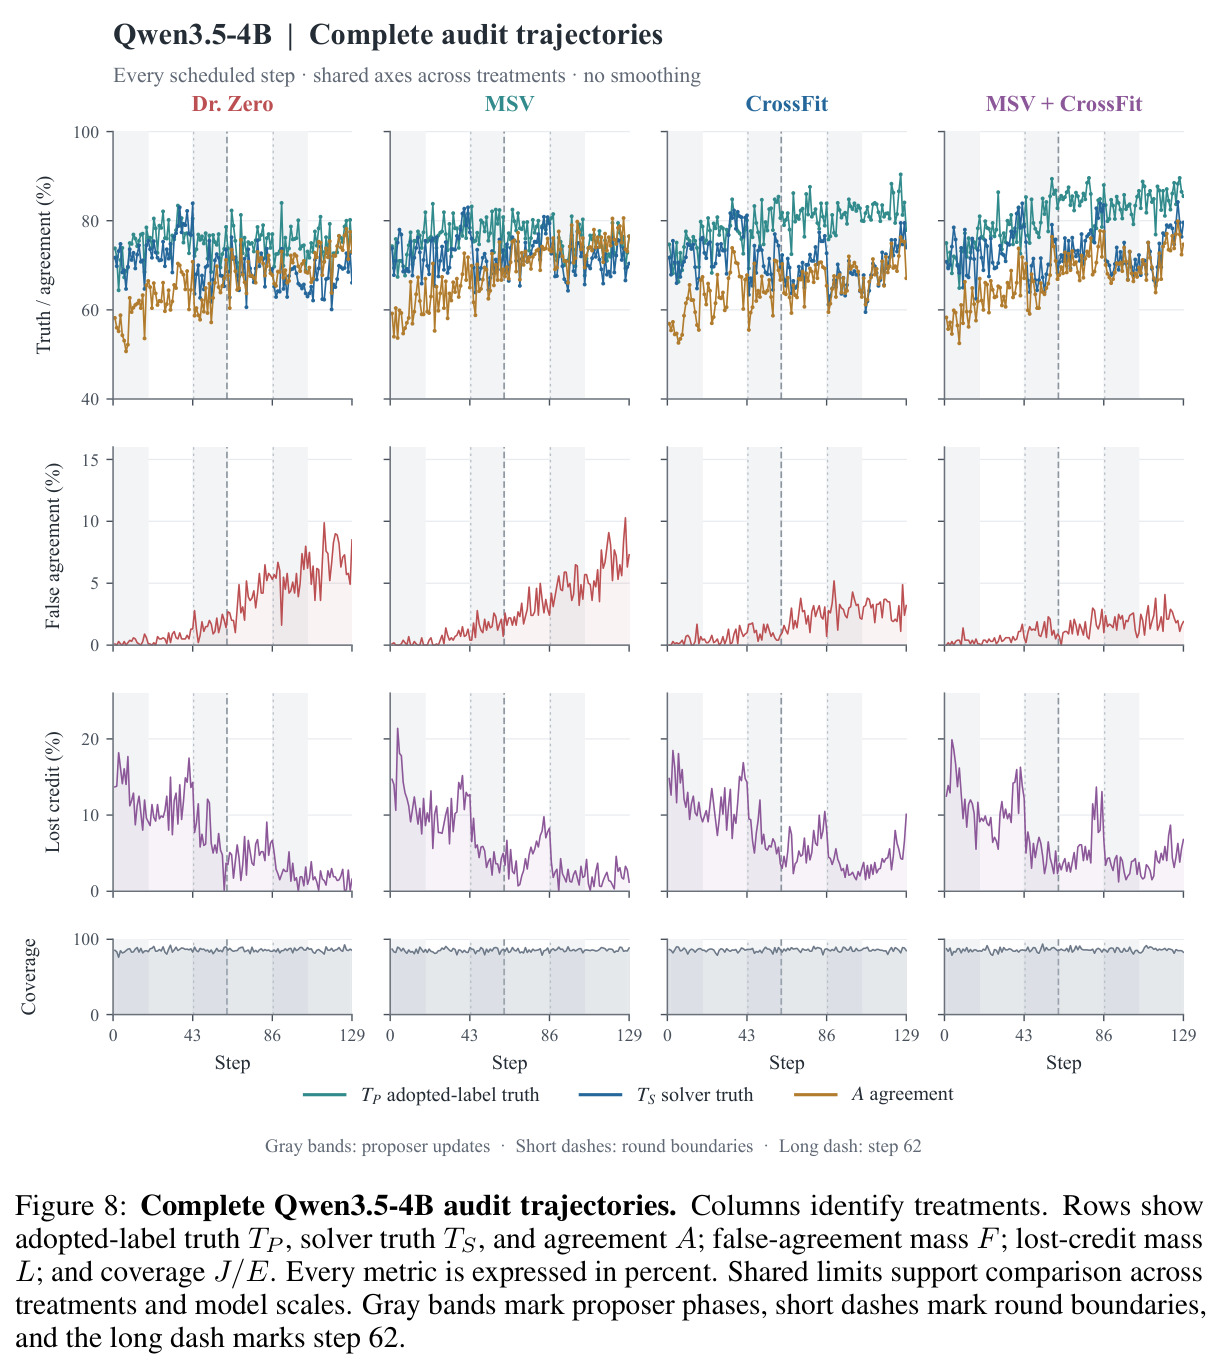
与已有工作不同的是,已有研究分别覆盖伪标签噪声(半监督学习中的确认偏差)、奖励模型过优化(Gao et al., 2023)、以及搜索自博弈中的误导信号(如 SearchMaster),但本文的独特切入是“反馈评估者的训练数据来源(ancestry)”这一此前被忽视的变量:问题不只是伪标签对不对(MSV 式验证只改善进入训练的监督),而是后来评估同源新问题的 solver 是否恰恰在被评估源派生的伪标签上训练过。作者借用计量经济学 cross-fitting 的排除原则,但明确声明只取其“排除”思想而不取渐近保证,因为自适应课程缺乏已证明的正交得分与独立样本结构。消融干净地支撑了这一视角:换一个独立评估器没用(全量数据辅助 solver 的 $F$ 仍为 0.058/0.069),随机划分单条题目也没用(0.050/0.062),必须按源文档身份划分(0.004/0.001)——起作用的唯一变量是源级排除。
核心方法
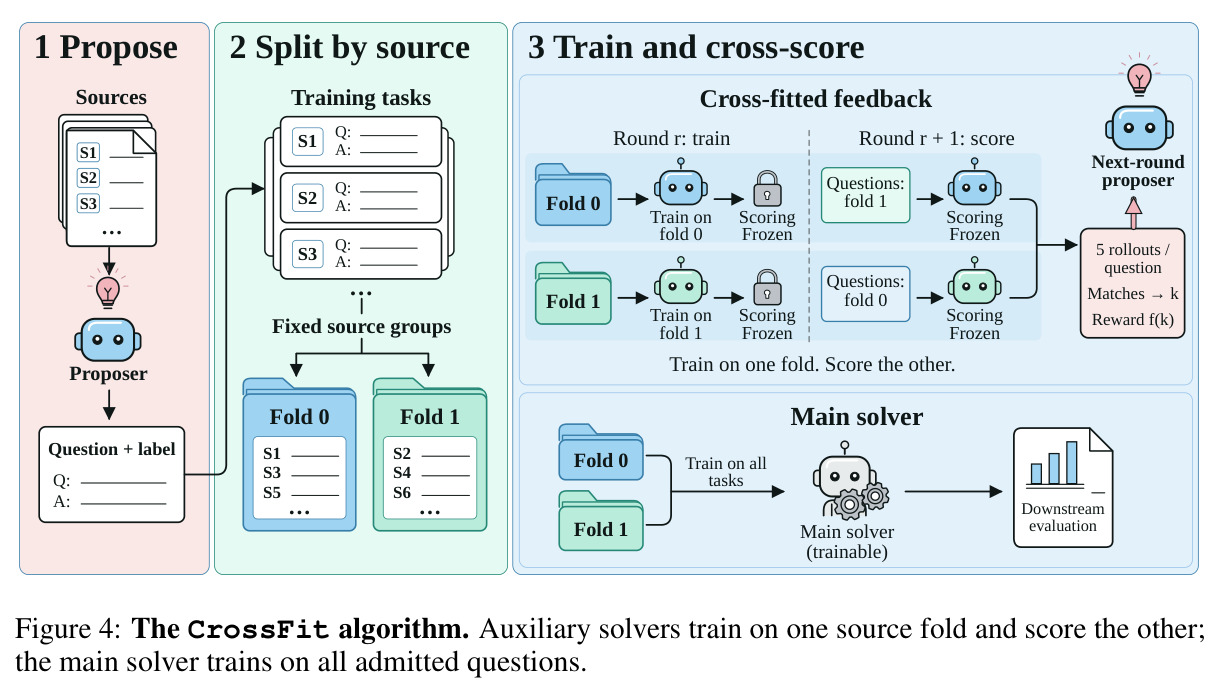
直觉上,这就像考试:出题人不能既出题,又在自己出的题目上受过针对性训练,再把这样的考试成绩当作出题质量的反馈。技术上,论文先建立诊断:对标准耦合回路(Dr. Zero)做事后审计,定义 $T_P$(采纳标签真值)、$T_S$(solver 回答真值)、$A$(标签—回答匹配率)、$F$(假一致质量)与 $L$(失去信用),发现耦合训练下 $A$ 与 $F$ 同涨而 $T_S$ 停滞。随后给出两级干预:MSV 在任务准入时用同一模型做 3 次带源采样加 3 次无源采样,两个多数票相容才采纳任务并用共识标签替换草稿标签;CrossFit(主方法)把 proposer 的源文档划成 fold 0/1,两组各维护一个只在己方数据上训练的辅助 solver,下一轮交叉打分——fold 0 的问题由 fold 1 训练的 solver 评估,反之亦然。主 solver 不拆分,仍在全部被采纳题目上照常训练;整条主训练更新规则不变,只有“谁给 proposer 提供反馈”被改变。两者也可组合:MSV 先决定准入与标签,CrossFit 再选择评估用的辅助 solver。
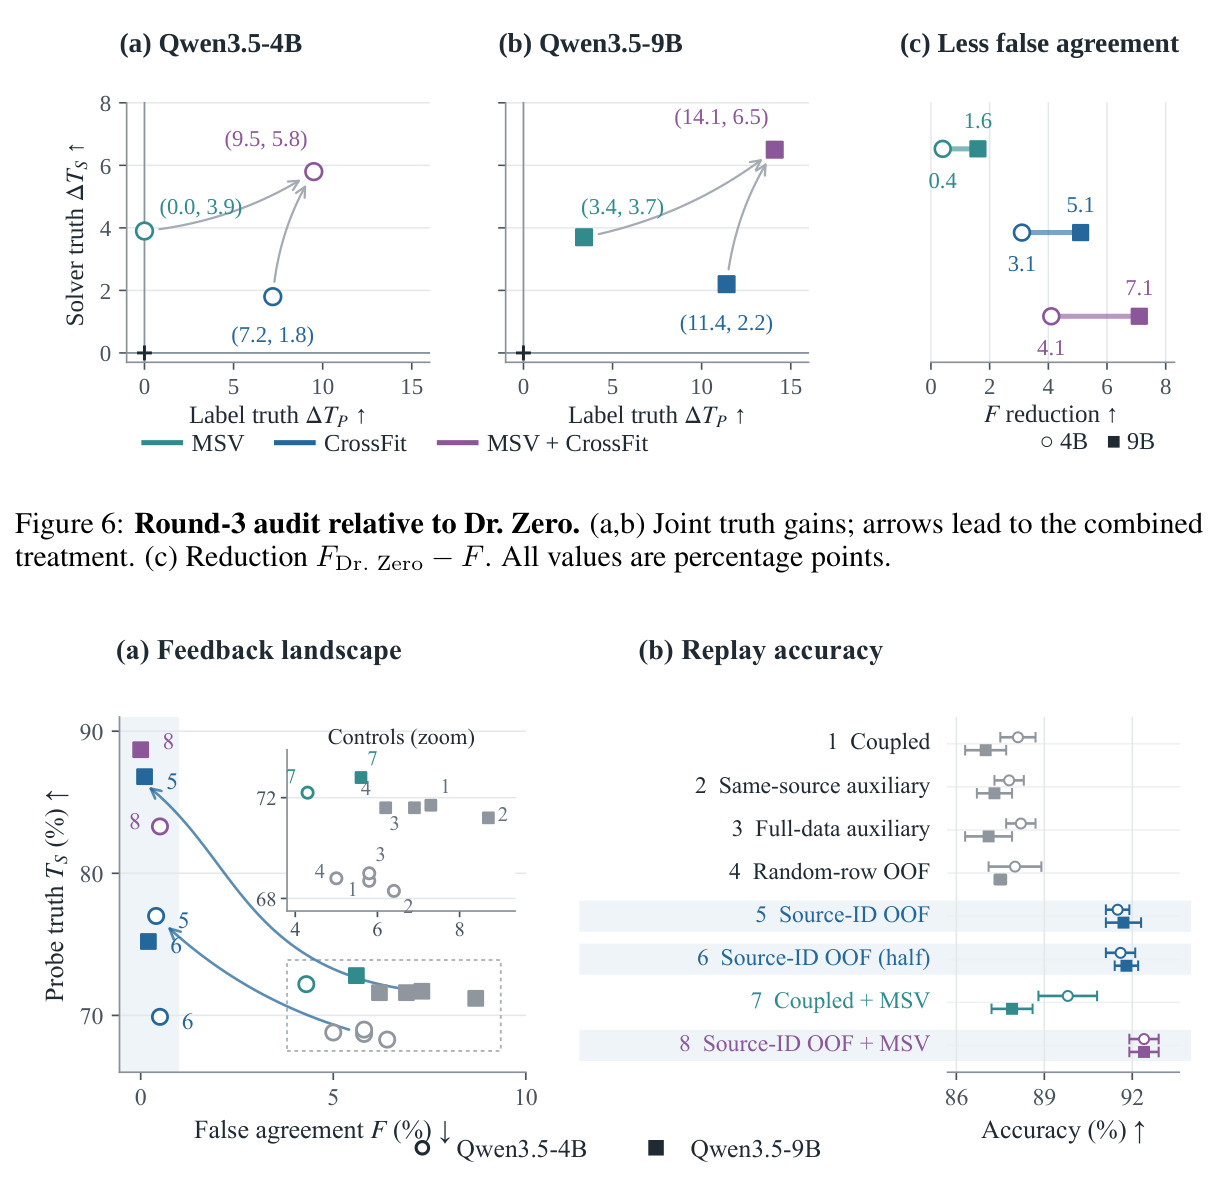
核心创新是把“反馈信号的训练数据来源”当作一等公民来控制,而非笼统地提高标签质量。耦合回路中存在一条完整的错误返回路径:源 $s$ 的错误伪标签训练 solver → solver 在同源新问题上复现该错误 → 这种一致被 $f(k)=(5-k)/4$ 的前沿奖励记为 proposer 的功劳,课程于是向共享错误漂移。CrossFit 保留奖励函数与前沿塑造逻辑完全不变,只把打分者换成从未见过该源的互补 fold 辅助 solver,使“仅仅因为评估者被同源误差训练过而获得一致奖励”在结构上不可能发生。这与 MSV 的本质区别在于作用点:MSV 改善进入训练的监督(标签质量),CrossFit 改变塑造下一轮课程的反馈谱系(谁训练过评估者)。实验印证了层次差异——MSV 只把 $F$ 从 6.1%/8.8% 降到 5.7%/7.2%,CrossFit 降到 3.0%/3.7%,固定题库重放下源级排除更将 $F$ 压到 0.4%/0.1%,证明反馈谱系才是主要矛盾。
方法步骤详情
流程五步。(1) 诊断:每个调度步保存源文档、采纳伪标签与 5 个 solver 回复,审计器(gpt-6-astra/high)从源构建有证据参考后判卷,证据不足记为未决,覆盖率约 0.86,不影响训练。(2) 提案:proposer 从源文档生成问题 $q$ 与伪标签 $\tilde{y}$。(3) 准验(可选 MSV):对同一模型做 3 次带源、3 次无源采样($a^{src}_i, a^{blind}_i$),两个多数票在匹配器 $\simeq$ 下相容才采纳并替换草稿标签,每候选多 6 次生成。(4) 交叉反馈:源文档一次性指派到 fold 0/1,派生问题终身沿用;第 $r$ 轮后辅助 solver 各自在己方折的被采纳题上训练 25 步;第 $r+1$ 轮 fold $h$ 的问题由 $S_{r,1-h}$ 打分,$R_P(q)=f(\sum_j \mathbf{1}[z_j \simeq \tilde{y}])$。(5) 主训练:主 solver 在全部被采纳题上照常训练,每轮 1,600 题、共 129 步,每轮末以 1,325 题套件评测。
技术新颖性
技术新颖性体现在三处。其一,co-cheating 的命名与量化本身是贡献:论文不是泛泛讨论标签噪声,而是证明一致率上升可以在真值停滞时由假一致驱动,并用 $F$ 与 $L$ 的反向运动(第 1 轮错误多表现为失去信用,第 3 轮转为共享错误)刻画这一动力学相变,为自进化系统提供了可复用的审计协议。其二,机制归因干净:通过固定题库重放(相同的 3,000 道题与标签,只换反馈 solver 的训练谱系)排除课程选择与准入效应,通过半预算对照($F$=0.005/0.002,与全预算几乎相同)排除额外更新量的解释,再通过同源辅助、全量辅助、随机划分三个对照,证明起作用的唯一变量是源级排除而非评估器复制本身。其三,CrossFit 与 Dr. Zero 的前沿奖励设计完全兼容——不改变 $f(k)$、不拆分主 solver,只在反馈通路上做手术,任何 proposer–solver 式自进化系统都可以低成本嫁接这一原则;相比 CAFE 等共同进化反馈工作,本文把问题收窄到“反馈策略的训练数据谱系”这一可精确控制的因素。
实验结果
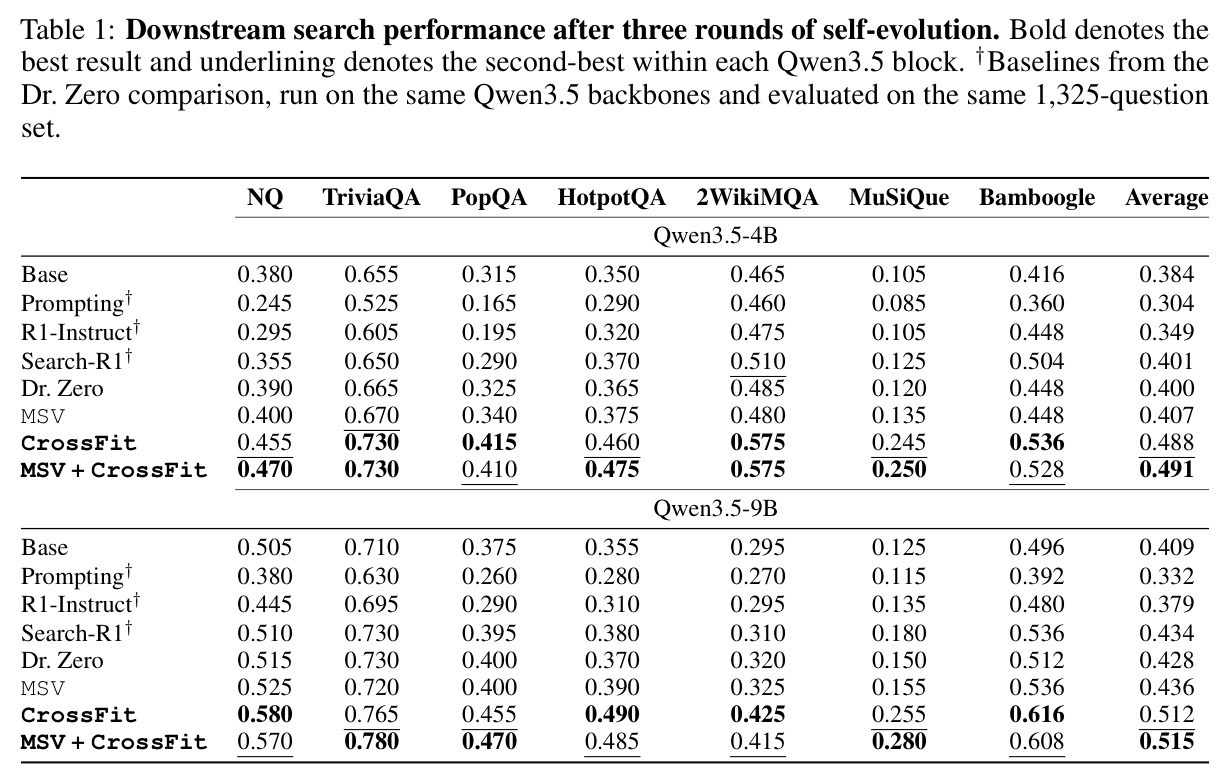
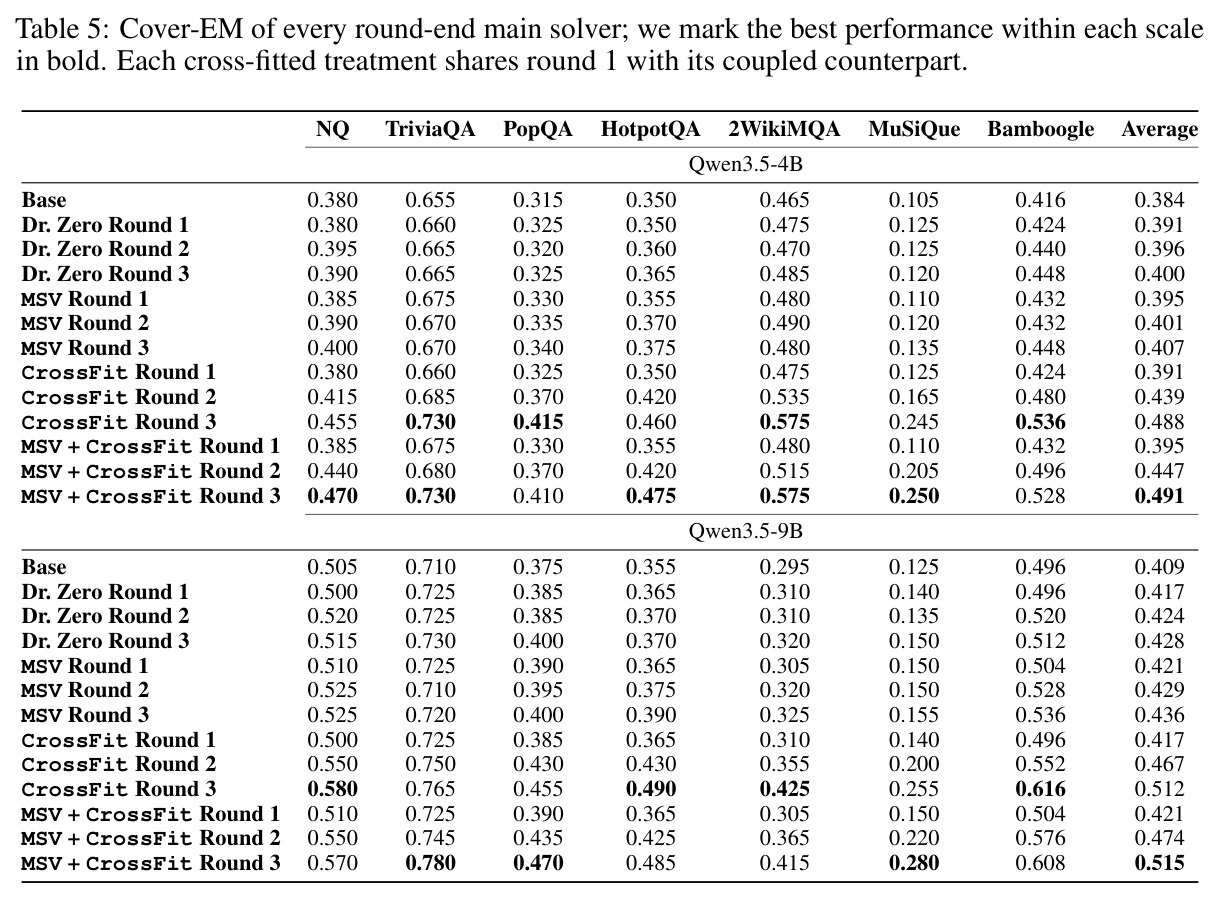
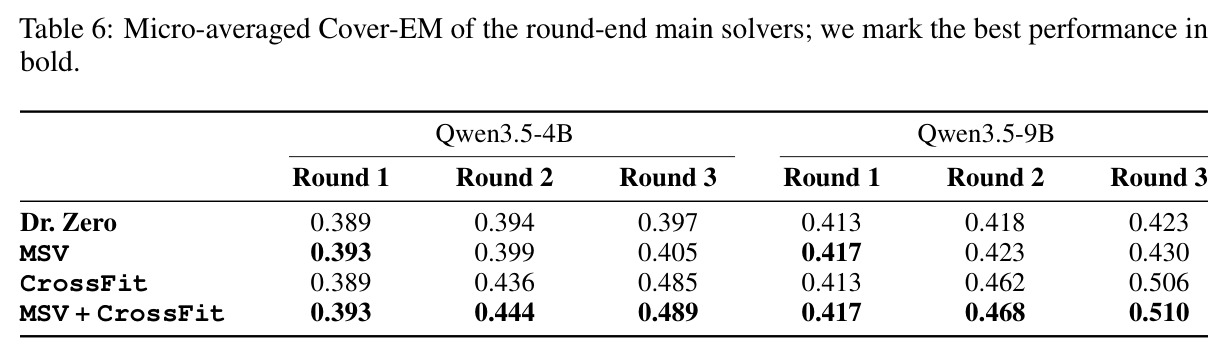
诊断:129 步审计显示,耦合反馈下假一致质量从第 1 轮的 0.004(4B)/0.003(9B)升至第 3 轮的 0.061/0.088,同时失去信用 $L$ 下降——分歧被共享错误取代。下游(1,325 题、Cover-EM):4B 上 Base 0.384 → Dr. Zero 0.400 → MSV 0.407 → CrossFit 0.488 → 组合 0.491;9B 上 0.409 → 0.428 → 0.436 → 0.512 → 0.515。CrossFit 超 Dr. Zero 8.8/8.4 点、超 Search-R1 8.7/7.8 点,七基准全升;多跳平均 +10.0/10.9 点,大于单跳 +7.3/5.2 点。轨迹上 CrossFit 使标签真值升至 0.819/0.851(基线 0.747/0.737)。消融:固定题库重放中源级排除把 $F$ 从 0.058/0.073 压到 0.004/0.001,准确率升至 91.5%/91.7%。MSV 仅 +0.7–0.8 点,组合只比 CrossFit 高 0.3 点——反馈谱系比标签质量更关键。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 七基准平均(Qwen3.5-4B) | Cover-EM | CrossFit 0.488(MSV+CrossFit 0.491) | Dr. Zero 0.400;Search-R1 0.401;Base 0.384 | +8.8pp vs Dr. Zero,+8.7pp vs Search-R1 |
| 七基准平均(Qwen3.5-9B) | Cover-EM | CrossFit 0.512(MSV+CrossFit 0.515) | Dr. Zero 0.428;Search-R1 0.434;Base 0.409 | +8.4pp vs Dr. Zero,+7.8pp vs Search-R1 |
| 假一致质量(4B,第3轮) | False-agreement mass $F$ | CrossFit 3.0%(组合 2.0%;固定题库源级重放 0.4%) | Dr. Zero 6.1%;MSV 5.7% | 较耦合反馈降低过半;源级重放下接近归零 |
| 假一致质量(9B,第3轮) | False-agreement mass $F$ | CrossFit 3.7%(组合 1.7%;固定题库源级重放 0.1%) | Dr. Zero 8.8%;MSV 7.2% | 较耦合反馈降低约 58%;源级重放下接近归零 |
| 采纳标签真值(9B,第3轮) | $T_P$ | CrossFit 0.851(MSV+CrossFit 0.878) | Dr. Zero 0.737;MSV 0.770 | +11.4pp vs Dr. Zero |
| 固定题库重放准确率(3,000题,五种子) | Accuracy | Source-ID 排除 91.5%(4B)/ 91.7%(9B);Coupled+MSV+排除 92.4% | Coupled 88.1%(4B)/ 87.0%(9B) | +3.4pp / +4.7pp |
局限与改进
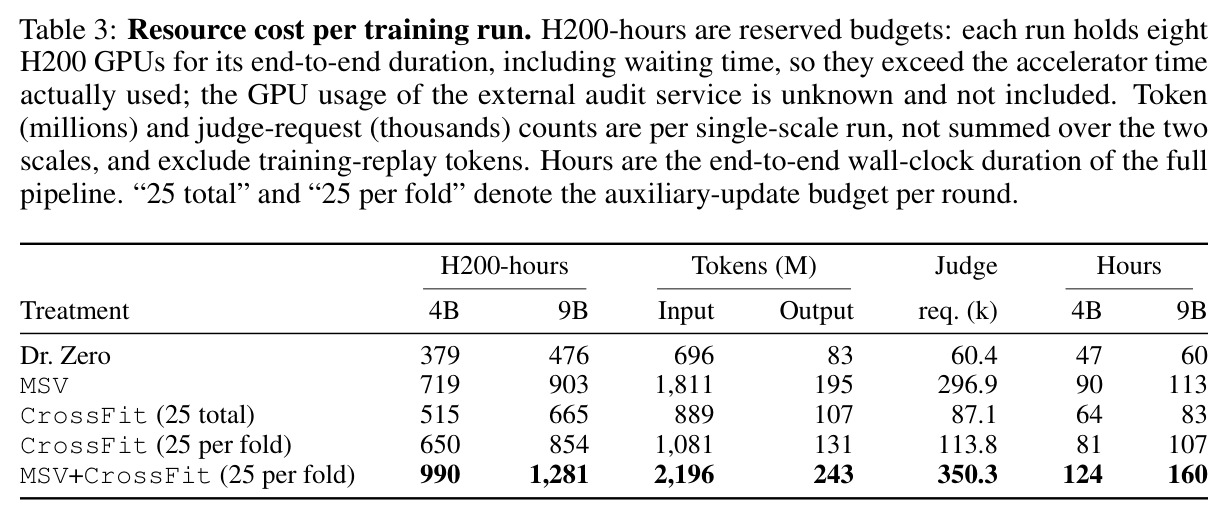
作者承认的(附录 D):CrossFit 只改变“谁提供反馈”,不改变“什么使答案为真”——共享预训练错误、重叠证据、语义相关源仍可诱发相关错误;$F$ 下降也可能来自拒绝难题而非学习改善,须结合覆盖率与固定探针解读;只在两个尺度上验证,未建立更低的端到端成本,也未检验相互连接源的鲁棒性。我的观察:(1) 诊断与验证都依赖 LLM 裁判(gpt-6-astra/high),而作者自己引用了 LLM-as-judge 系统性偏差文献,若裁判对某些错误失明,$F$ 的绝对值可能失真,且缺少人工标注校准集;(2) MSV 的无源采样假设参数知识足以稳定作答,纯文档推理型问题可能被系统性拒绝;(3) 结论仅限 Qwen3.5 家族与开放域 QA,跨家族、跨域泛化未知;(4) MSV+CrossFit 预算是 Dr. Zero 的 2.6–2.7 倍(990/1,281 H200-hours),缺少单位提升成本的效率分析。
独立分析的弱点
独立弱点与改进方向:(1) 审计与验证的单点依赖——judge 与 labeler 可能共享偏差,改进是引入异构模型委员会或人工校准集,显式量化 $F$ 的测量误差;(2) 源级划分粒度粗糙——同一事件的不同文档可能分属两折,语义泄漏仍会残留,改进是先用 embedding 聚类把连接源归入同一超 fold 再二分,正对应作者的 connected sources 问题;(3) 反馈成本偏高——默认每折 25 个辅助更新使预算增加 72–79%(4B:379→650 H200-hours),而半预算对照表明每轮 25 个总更新即可保住效果($F$=0.005/0.002),改进是把辅助 solver 做成主训练的周期性快照;(4) MSV 性价比低——每候选 6 次生成只换来 0.7–0.8 点提升与 0.4pp 的 $F$ 下降,改进是先做单次 source-blind 廉价预筛,仅对边缘提案执行完整 MSV;(5) 前沿奖励 $f(k)$ 未被重审——CrossFit 修复了谱系问题,但“越难得分越高”的塑形在两折难度不均时仍可能激励出偏题,可考虑折间难度归一化。
未来方向
作者提出的(结论与附录 D):把排除原则扩展到相互连接的源,用相似度结构做连通分量级的折间隔离;测量端到端效率,证明排除原则可在成本可控下部署。基于本文可延伸的:(1) 把 source-exclusion 推广到 self-rewarding 与 LLM-as-judge 场景——评判某回答的 judge 不应在该回答的来源上训练过,与 RLAIF 的 judge 污染直接相关,可能催生“谱系审计”工具;(2) 理论化:在自适应课程下给出假一致质量的收敛界,刻画 $A$-$T_S$ 分离何时必然发生;(3) 与 co-evolving feedback(CAFE)结合,研究评估者与提议者共同进化时的最优隔离频率与折数;(4) 跨预训练谱系的异构交叉验证——用不同基座家族互为辅助 solver,削弱共享预训练错误;(5) 把固定题库重放发展成自进化系统的标准诊断套件,像 reward-model overoptimization 的 scaling law 一样给出 $F$ 随轮数的增长曲线与预警阈值。
复现评估
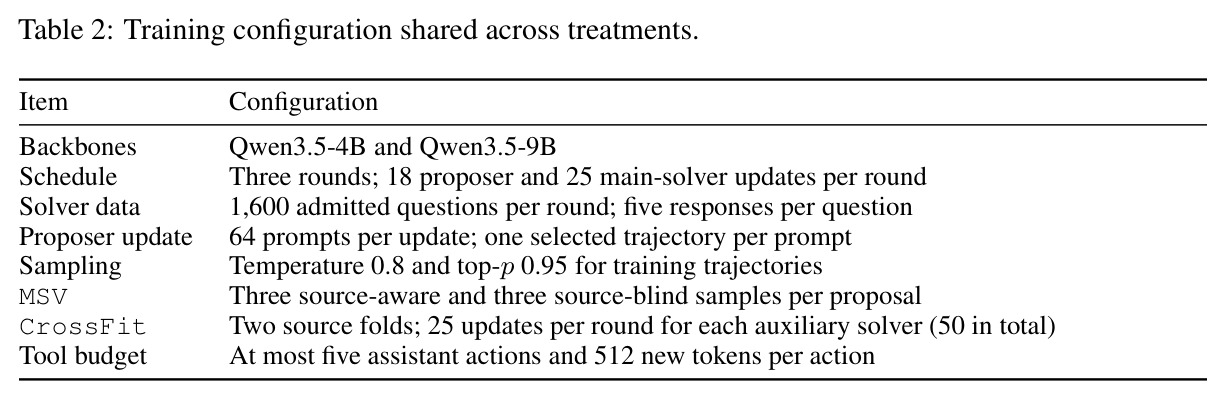
复现评估:配置信息相当完整——Table 2 给出共享训练设置(三轮、每轮 18 个 proposer 与 25 个主 solver 更新,每轮 1,600 题、每题 5 条轨迹,温度 0.8/top-p 0.95,最多 5 次工具动作、每次 512 新 token),公式(1)(2)给出目标与聚合方式,附录 B 描述审计流程,附录 E 保留全部 129 步轨迹。数据全为公开基准(NQ、TriviaQA、PopQA、HotpotQA、2WikiMQA、MuSiQue、Bamboogle),骨干为公开 Qwen3.5-4B/9B,无需人工标注数据。主要门槛是算力:每次运行独占 8 张 H200,Dr. Zero 4B 需 47 小时(379 H200-hours),CrossFit 64–81 小时,MSV+CrossFit 9B 需 160 小时(1,281 H200-hours),个人难以完整复现,但 4B 的 CrossFit(515 H200-hours)在实验室集群可行。审计依赖商业 API 且费用未计入;论文未给出开源代码链接,严格复现需自行实现循环与折间路由,难度中等偏高。
论文图表
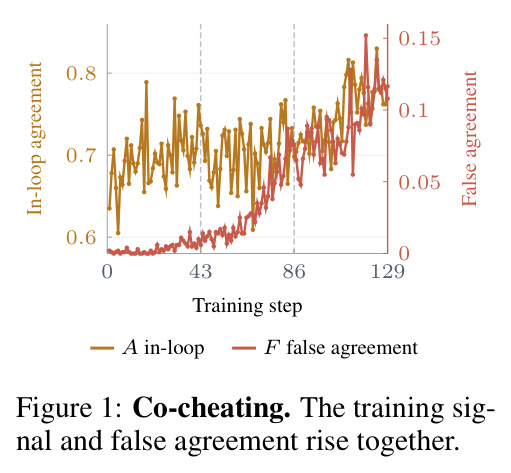
展示 Dr. Zero 耦合训练过程中,循环内一致率(in-loop agreement)从 0 附近随 129 个训练步持续上升至约 0.1 量级,同时假一致(false agreement)同步攀升,两条曲线在训练步 0/43/86/129 的时间轴上同步走高。
这是全文的核心现象图:一张图就说明了“内部训练信号与外部正确性脱钩”——一致率的上升并非真实进步,而是出题者与解题者共享错误的结果,是提出 co-cheating 概念的直接证据。
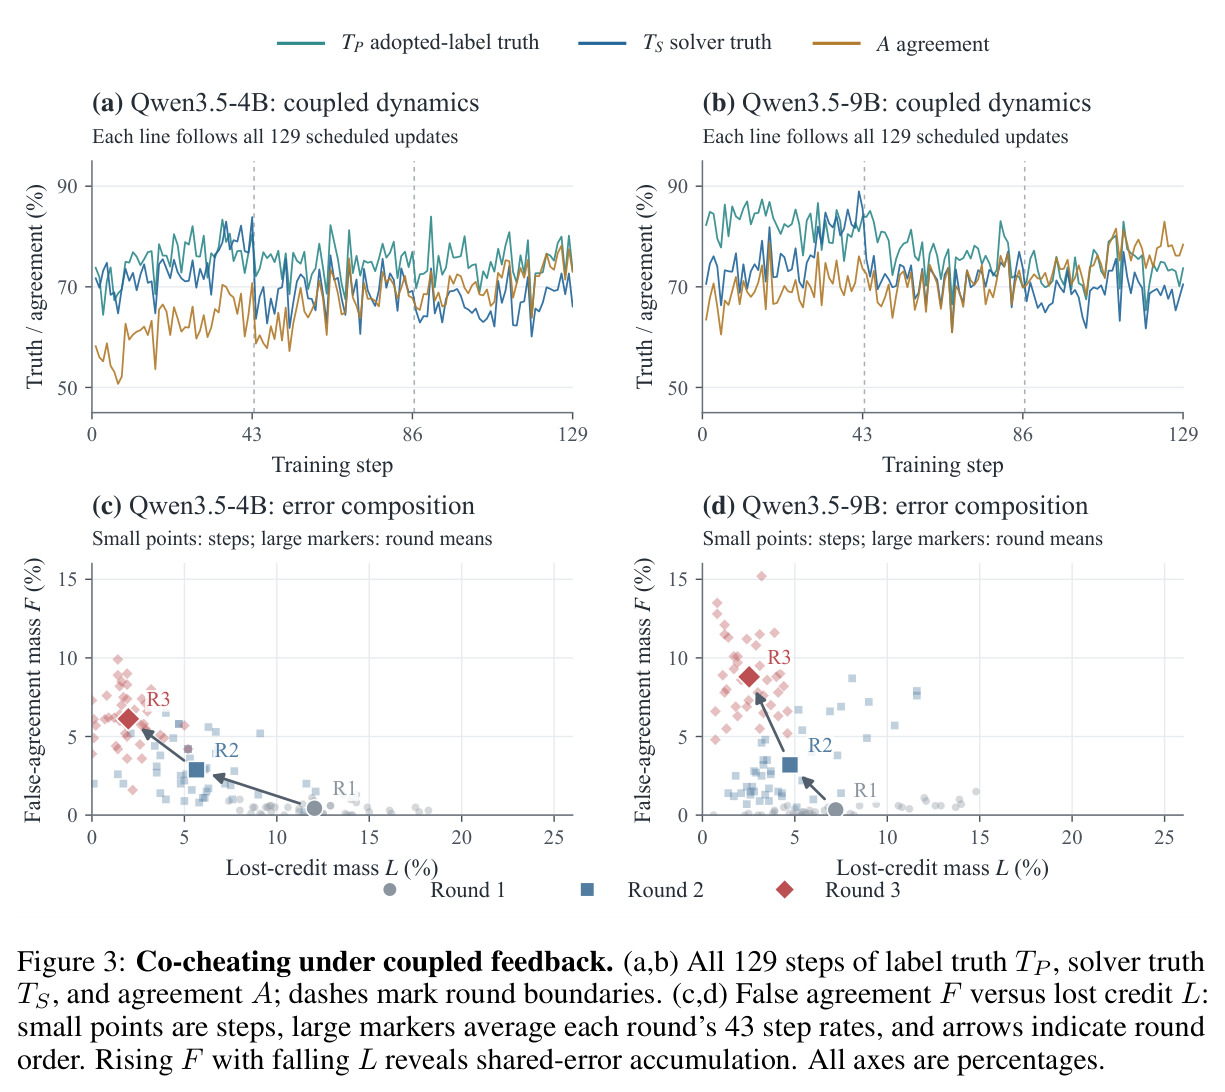
上排(4B/9B)画出全部 129 步的采纳标签真值 $T_P$、solver 真值 $T_S$ 与一致率 $A$,虚线标出轮次边界;下排以散点图展示假一致质量 $F$ 对失去信用 $L$ 的关系,小点是单步、大标记是每轮 43 步的均值,箭头指示轮次顺序,可见 $F$ 上升而 $L$ 下降。
这是诊断部分的核心证据:第 1 轮 $F$ 仅 0.004/0.003,第 3 轮升至 0.061/0.088,且 $F$-$L$ 平面上轮次箭头呈反向运动,证明分歧正在被共享错误取代,而非题目变难。
在固定的 3,000 题重放库上比较 8 种反馈配置:(a) solver 真值对假一致质量,同源辅助(0.064/0.087)与全量辅助(0.058/0.069)紧贴耦合对照,而源级排除(0.004/0.001)远离;(b) 重放准确率,源级排除把 88.1%/87.0% 提升到 91.5%/91.7%,半预算对照与全预算几乎相同。
这是机制归因的关键图:通过同源辅助、全量辅助、随机划分、半预算等一排对照,证明起作用的唯一变量是“源级排除”,而非拥有独立评估器或额外训练量。