PatchHolmes:基于列表式选择的智能体补丁检索 PatchHolmes: Agentic Patch Retrieval via Listwise Selection
混合检索配列表式智能体审查,把CVE精准定位到修复提交,R@1领先点式基线25.34个百分点
前置知识
补丁检索(Patch Retrieval)
给定一条 CVE 漏洞公告和对应的开源仓库,从数千到数百万个提交(commit)中找出真正修复该漏洞的那一个 commit ID。它是漏洞公告、CVSS 评分、受影响版本追踪和 SBOM 供应链扫描的基础环节。现实需求很大:独立研究显示 GitHub Advisory Database 和 NVD 中 60%–63% 的 CVE 缺失补丁链接,人工标注无法扩展,因此需要能在冻结 LLM、本地 Git 仓库、无付费搜索 API 约束下运行的自动化系统。
这是本文要解决的核心任务。理解其输入(CVE 描述加本地仓库)、输出(单一 commit ID)和部署约束(不微调、无外部 API),是读懂全文动机和方法设计的起点。
点式(Pointwise)与列表式(Listwise)排序
点式方法对每个候选文档独立打分或判 yes/no,候选之间互不可见,多个候选同时得高分时只能靠候选顺序等外部信号打破平局;列表式方法把全部候选放在同一上下文里联合比较,模型可以参考其他候选的样子来决定哪个最优。列表式思想在经典 IR 中早已存在,本文的新意是把它实例化为 LLM 智能体在推理时的工具调用行为,而不训练任何排序模型。
全文的核心主张就是列表式优于点式:基线 Favia 对 10 个候选独立打分,在 CVE-2015-9251 上全部标 yes、按顺序错选第 1 名;PatchHolmes 的智能体一次纵览 100 个候选再逐个精读。两种范式的对比贯穿动机、方法和实验。
ReAct 智能体循环与工具调用
ReAct 范式让 LLM 在多轮对话中交替推理和行动:每轮调用一个工具(如读文件、检索),把工具返回的观察写回上下文,再决定下一步动作,直到给出最终答案。与一次性输出的开环系统不同,智能体可以根据每次观察修正后续行为,形成闭环。开源框架 OpenHands SDK 提供了现成的会话运行时。
PatchHolmes 第二阶段就是一个 ReAct 式循环:智能体通过 list_candidates、read_commit、read_file_diff、submit_answer 四个工具在最多 15 次迭代内审查候选,每次工具观察都会更新它对下一个候选的判断,这正是相对传统开环打分器的优势来源。
BM25、时间衰减与倒数排名融合(RRF)
BM25 是基于词频的经典词汇检索算法。时间衰减分数按 commit 日期与 CVE 日期在候选列表中的排名差给分,形如 $1/(1+2|r-c|)$,离 CVE 越近分越高。RRF 把两路检索的排名融合:$s_{RRF}(c) = \frac{1}{k+r_{lex}(c)} + \frac{1}{k+r_{dense}(c)}$,只依赖排名、不需要校准两路分数的量纲,本文取 $k=60$。
Phase 1 的词汇路由 commit message、diff 正文、CVE 预留日期、公开日期四个信号加权(0.35/0.15/0.30/0.20)组成,再与稠密路 RRF 融合成 top-100。看懂消融表中各检索路的贡献(BM25 单路 39.68%、加时间衰减 49.57%、稠密单路 57.11%)离不开这套打分机制。
稠密检索与嵌入模型(Dense Retrieval)
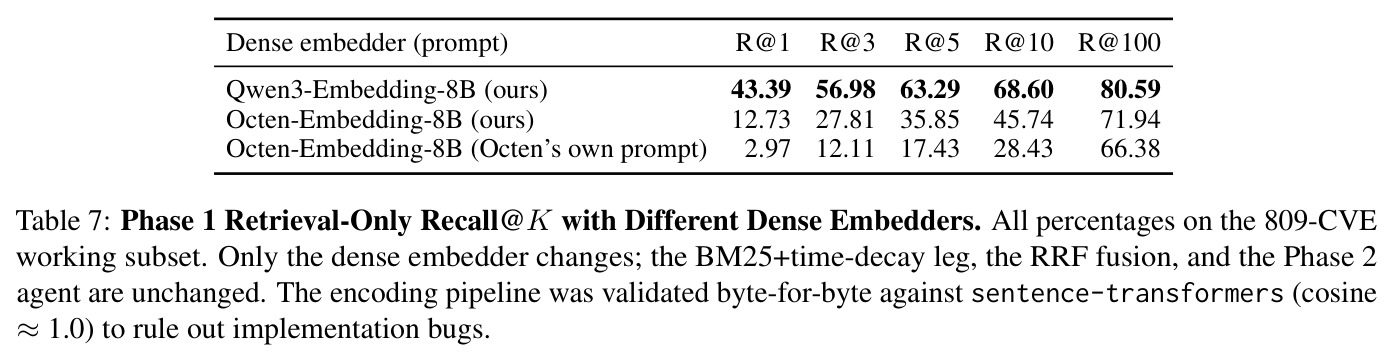
把查询和文档映射到同一向量空间(本文用 Qwen3-Embedding-8B,4096 维),按余弦相似度排序。相比 BM25 只匹配字面词,稠密检索能部分缓解 CVE 描述写症状、修复提交写根因之间的词汇鸿沟,但对领域漂移敏感:RTEB 榜首的 Octen-Embedding-8B 在本任务上 Recall@1 只有 12.73%,远低于未微调的 Qwen3-Embedding-8B 的 43.39%。
消融证明稠密路是 Phase 1 的主力(单路即达 57.11% Recall@1),且嵌入模型选型对结果影响巨大——通用榜单成绩与补丁检索表现严重脱节,这是复现和改进本系统时最关键的工程决策之一。
Recall@K / NDCG / MRR 评价指标
Recall@K 问金标 commit 是否出现在预测列表前 K 名;NDCG@K 按金标落点位置加权,越靠前分越高;MRR 是金标排名倒数的均值。本文有两点特殊约定:运行出错的 CVE 计 0 分而非剔除,防止系统靠在难题上失败刷分;单选输出的方法(IRCoT)所有指标坍缩为同一个数。
论文所有对比都用这套指标,且做了对齐处理(如把 PatchHolmes 的审查列表补齐到长度 10 以匹配 Favia 的 10 深输出、把 IRCoT 的输入换成本文 top-100 候选),不理解这些约定会误读主表数字。
研究动机
漏洞管理的第一步是把每条 CVE 映射到上游仓库中修复它的 commit,但供给严重滞后:GitHub Advisory Database 和 NVD 中 60%–63% 的 CVE 缺失补丁链接,辅助信息匹配即便有人工协助也只能找回 12%–53% 的已披露开源漏洞,NVD 自身面临维护积压——CVE-2013-1814(Apache Rave)的补丁在披露十年后才被找到。自动化补丁检索面临三重固有困难:语料大,49% 的 CVE 针对超过 5,000 commits 的仓库;diff 长,8,401-CVE 语料中平均每个 commit diff 约 15,000 tokens,远超 BERT 类编码器 512 tokens 的窗口,大部分内容在打分前就被截断;词汇错配,CVE 描述写安全症状(buffer overflow),补丁提交写底层根因(out-of-bounds read),词汇检索难以匹配。现有最强点式系统 Favia 对 10 个候选独立做 yes/no 加置信度分类,在 CVE-2015-9251(jQuery 跨域 Ajax XSS)上把 10 个候选全部标成置信度 5 的 yes,只能按候选顺序选中排第 1 的无关重构 e7b3bc4,而真正的修复 b078a62 排在第 9。
本文的目标是本文要构建一个能随 CVE 积压规模扩展的补丁检索系统,部署约束是硬性的:必须运行在冻结的开源权重 LLM 上、面向本地 Git 仓库、不做按仓库微调、不调用付费外部搜索 API,因为其中任何一项的成本都会随 CVE 数量线性增长。具体目标包括:在 GitHubAD 基准上端到端超越最强点式基线 Favia(Recall@1 34.61%)、检索-推理基线 IRCoT(28.55%)和无 LLM 的两阶段检索器 SPFinder(27.32%);把每条 CVE 的成本从 Favia 的 10 次独立点式对话(每对约 67,000 tokens)压到一次智能体会话;并通过候选集对齐实验量化智能体审查本身(而非更好的检索器或更大的模型)贡献了多少精度;最后验证同一智能体不做任何修改即可迁移到由别人预筛候选的 PatchFinder_top10 基准。
与已有工作不同的是,已有工作分三条线,各留缺口。传统两阶段流水线(PatchScout、PatchFinder、SPFinder)是开环的:静态特征栈给每个候选打一次分就输出最终排名,无法在发现 top 结果可疑时回看、细读或换路重试,且依赖 512-token 的 BERT 类编码器,15,000-token 的平均 diff 大部分被截断。Favia 把打分器换成 LLM,但结构上仍是点式:10 次调用互相独立,多个候选同时为 yes 时没有联合信号破平局,破平局靠的是候选顺序而非内容。通用域闭环检索器(IRCoT、FLARE、Self-RAG)为开放网页多跳问答设计,每一跳之间共享词汇,迁移到这种封闭世界、单答案、词汇错补的场景效果差(IRCoT 仅 28.55%)。本文的独特切入是把列表式排序这一经典 IR 思想搬进智能体的工具循环:一次会话内先用一次调用纵览全部 100 个候选清单,再按需选择性精读 3–10 个候选,让候选在同一上下文里直接互相比较。
核心方法
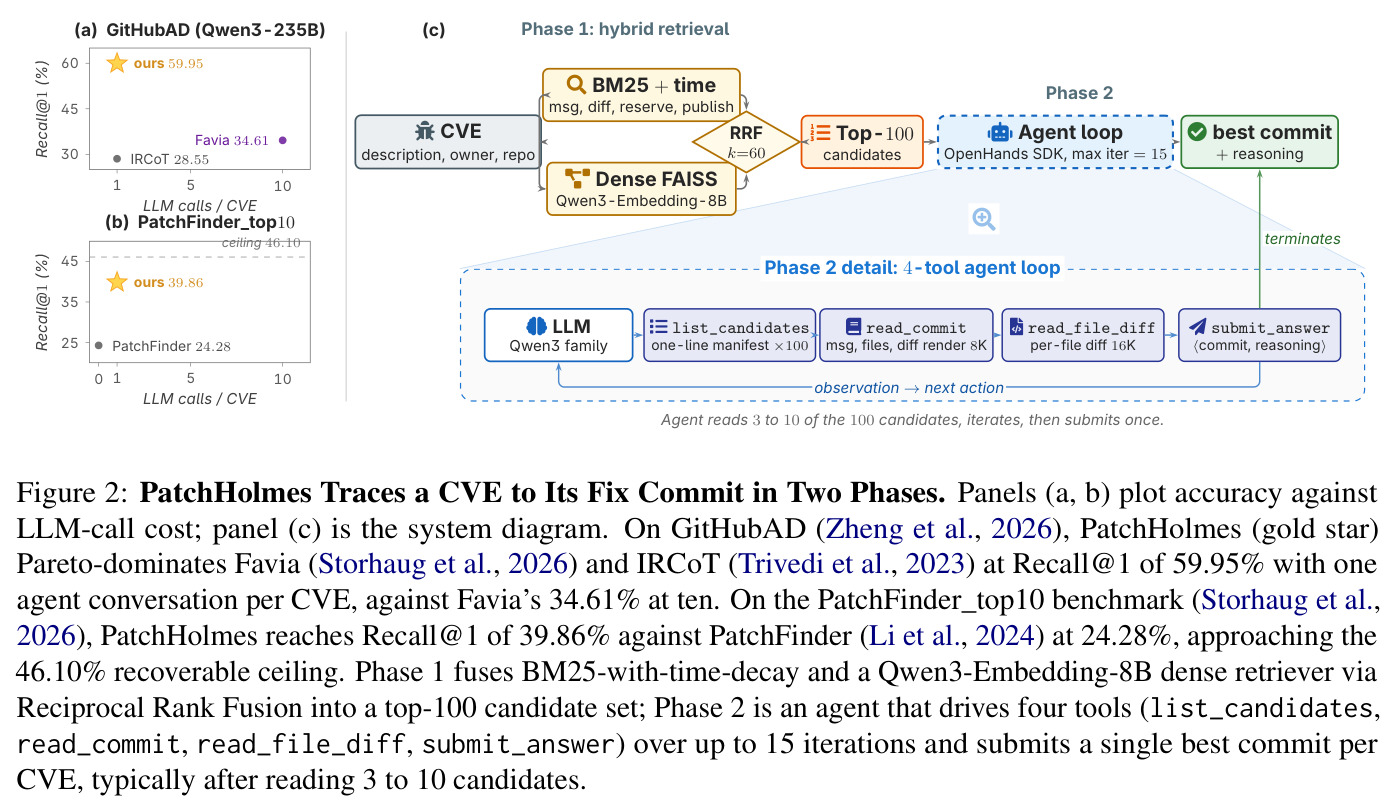
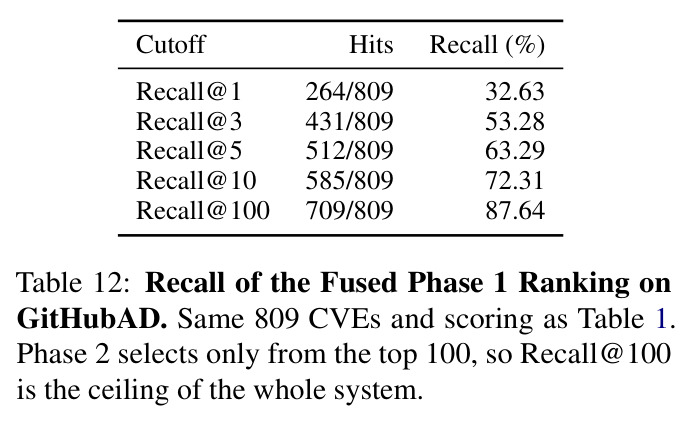
整体思路有个直觉起点:Phase 1 只需保证正确 commit 出现在前 100——它的融合排序 Recall@100 已达 87.64%,真正稀缺的是在这 100 个里认出那一个的能力,这需要联合比较和按需细读,恰好是 LLM 智能体擅长的。技术路线分两阶段。Phase 1 召回导向,两路并行:词汇路对 commit message(权重 0.35)和 diff 正文(0.15)做 BM25、对 CVE 预留日期和公开披露日期做时间排名衰减分数(各 0.30/0.20,形如 $1/(1+2|r-c|)$);稠密路用 Qwen3-Embedding-8B 在 4096 维空间按余弦相似度排序,diff 按信息密度分桶填满 6,000 字符预算。两路经 $s_{RRF}(c) = \frac{1}{60+r_{lex}(c)} + \frac{1}{60+r_{dense}(c)}$ 融合,取前 1,000 落盘、Phase 2 读前 100。Phase 2 精度导向:一个四工具智能体(OpenHands SDK,max_iter=15,带卡死检测)按 survey-inspect-drill-submit 的次序在预算内精读 3–10 个候选,最后调用 submit_answer 提交唯一答案。两阶段只通过候选 ID 交接,互不共享状态。
核心创新是列表式选择:智能体调用一次无参数的 list_candidates 即可看到全部 100 个候选的清单(排名、commit ID、message 首行、改动文件统计如 2src/1test/1doc),然后按 Phase 1 排名次序选择性精读,所有候选在同一上下文里互相比较。这与 Favia 有本质的信息结构差异:Favia 的 10 次点式调用互相独立,无法表达候选 A 比候选 B 更像修复这类相对判断,多个 yes 只能按候选顺序破平局;而 PatchHolmes 的每一次 read_commit 观察都会更新后续行动——在 CVE-2015-9251 上智能体按排名 1,2,9,4,3 的顺序读了 5 个 commit,认出唯一添加了 ajaxPrefilter(阻止跨域 Ajax 响应中 text/javascript 自动执行)的 b078a62。次级创新是工具中介的分块 diff 渲染(commit 级 8K、单文件级 16K 字符预算,按信息密度分桶、源码优先于测试文档),让智能体绕过 512-token 编码器窗口直接读完整的 15,000-token diff,这正是传统两阶段系统做不到的。
方法步骤详情
第一步,Phase 1 词汇路:对仓库每个 commit 计算 $s_{lex}(c) = 0.35\,\tilde{b}_{msg}(c) + 0.15\,\tilde{b}_{diff}(c) + 0.30\,t_{reserve}(c) + 0.20\,t_{publish}(c)$,两个 BM25 分数在各自字段 top-10,000 命中内 min-max 归一化,时间分数按候选与 CVE 在按日期排序的 top-10,000 内的排名差打 $1/(1+2|r-c|)$。第二步,稠密路:Qwen3-Embedding-8B 离线把全部 commit 编码缓存成单一矩阵,查询时一次矩阵乘法完成检索(与 Sourcegraph Zoekt、GitHub Blackbird 同款工业模式);diff 先按信息密度排序(文件路径 > hunk 头 > ± 行 > 上下文行)再逐桶填满 6,000 字符,保持整行不截半行。第三步,RRF($k=60$)融合取前 100。第四步,Phase 2 智能体:list_candidates 纵览清单;read_commit(commit_id) 返回 message、文件清单和 8,000 字符预算的 diff 渲染;渲染层三步走——按 diff --git 切分成每文件一条记录、按 $\pi(f) = \text{BASE}[\text{tag}(f)] + \min(20, a{+}d) + 15\cdot\mathbb{1}[t_q \cap t_f] - 10\cdot\mathbb{1}[a{+}d{>}500]$ 打优先级(源码高于测试文档,惩罚超大重构型 diff)、按优先级降序填预算;read_file_diff 以 16,000 字符预算下钻单个文件(用于 read_commit 截断处的深读或同文件多候选并排比较);submit_answer 只允许调用一次。系统提示含排名提示(rank 1 只有约 12% 的 CVE 是答案),以对抗 LLM 过度信任列表首项的位置偏差。
技术新颖性
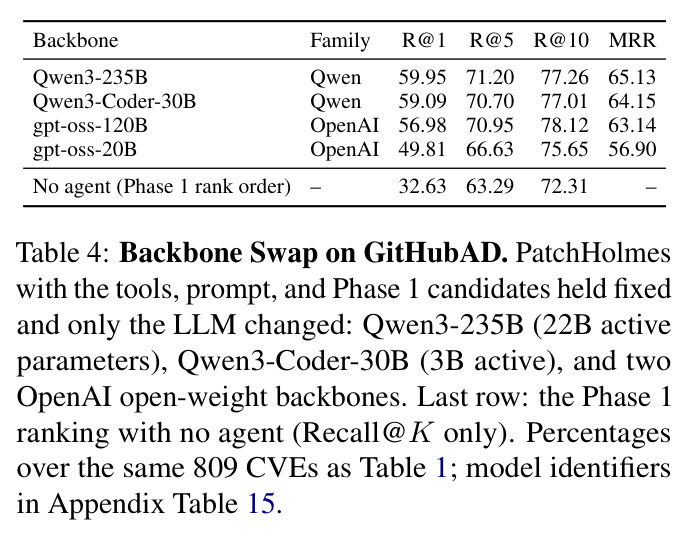
技术新颖性有四点。其一,把列表式排序从训练时的 loss 函数变成推理时的智能体行为:不训练任何模型,看全列表再选这个动作由工具接口直接保证,消融显示它是最大的单项增益(+15.58% Recall@1)。其二,最小充分工具面:SWE-agent 用 10 个工具支持开放式代码编辑,mini-SWE-agent 折叠成单个 bash,本文论证补丁检索只需要 4 个工具——因为不改代码、候选集固定,导航和编辑类工具没有角色,且每个工具的贡献都能在消融中独立量化(清单 +15.58、read_commit +9.27、read_file_diff +2.47)。其三,时间信号采用排名差形式 $1/(1+2|r-c|)$,使其可与 RRF 的排名分数直接相加而无需重新校准绝对时间差。其四,整套系统零微调运行在冻结模型上,并用骨干交换实验(家族内近 7 倍激活参数差距 Recall@1 变化小于 1%)证明收益来自脚手架而非模型规模,这与深度研究文献中换检索器比换智能体更重要的结论相互印证。
实验结果
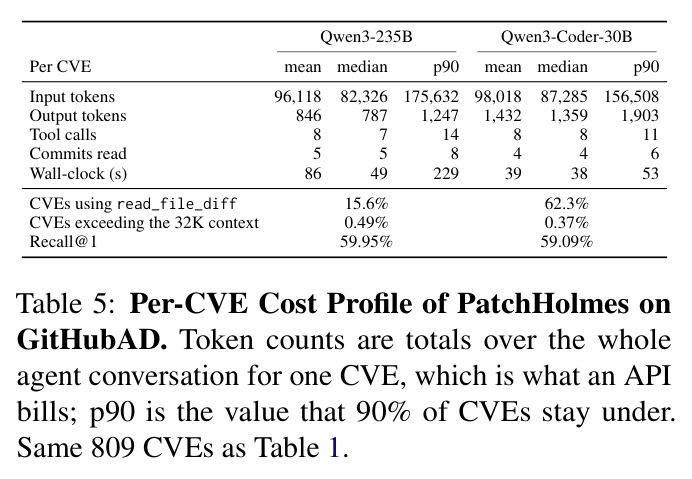
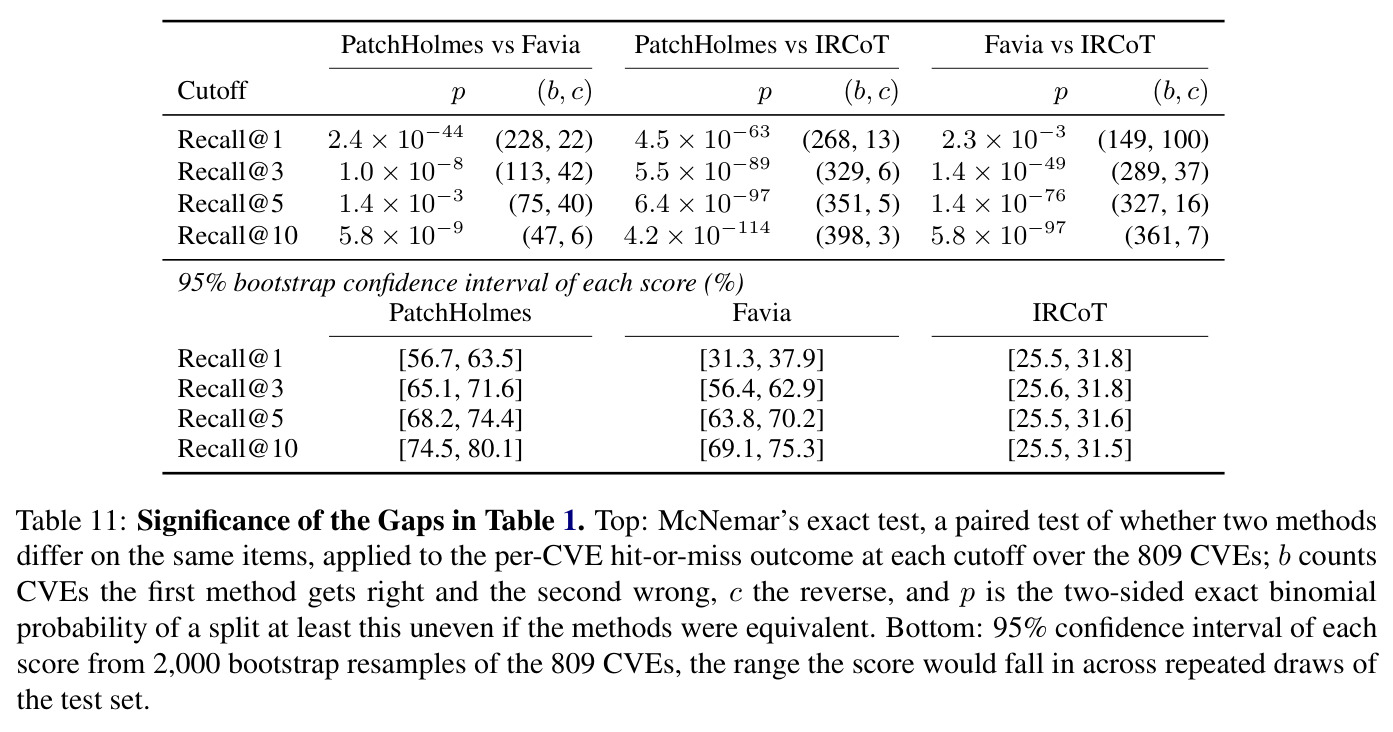
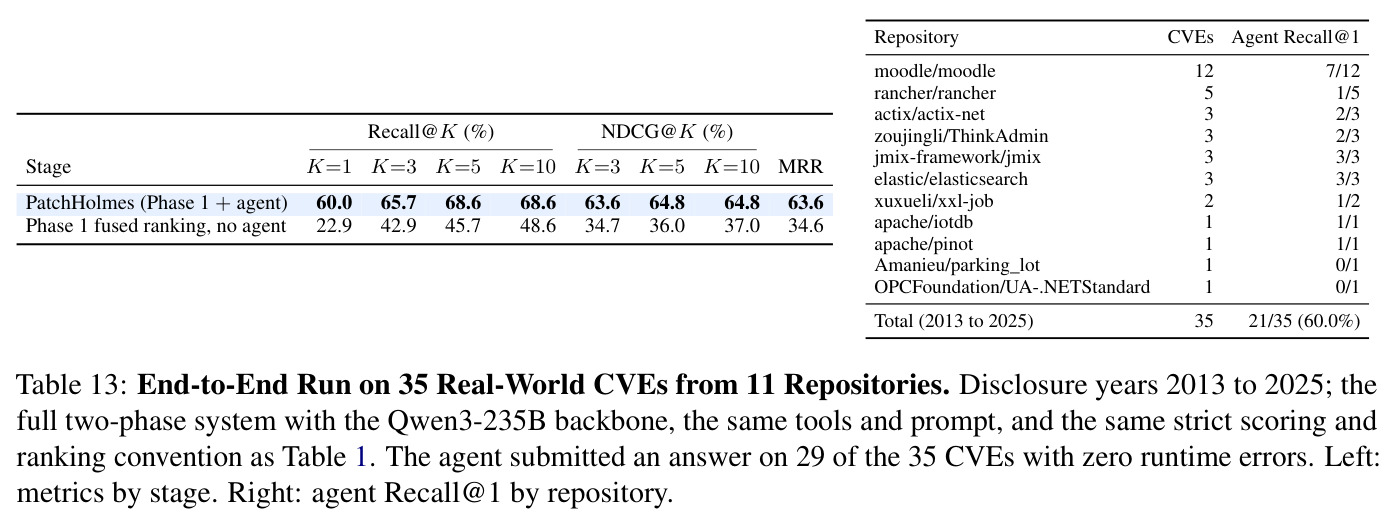
在 GitHubAD 809-CVE 工作子集(Qwen3-235B)上 PatchHolmes 全列领先:Recall@1 59.95%,对 Favia 34.61%(+25.34)、IRCoT 28.55%(+31.40)、SPFinder 27.32%(+32.63);Recall@10 77.26%,NDCG@10 68.01% 对 Favia 53.91%。McNemar 精确检验 p=2.4×10⁻⁴⁴,95% bootstrap 置信区间 [56.7, 63.5] 与 Favia 的 [31.3, 37.9] 不重叠。候选对齐后差距纯来自选择方法:同一 100 候选上无智能体的 Phase 1 排序仅 32.63%,智能体加 27.32%;Favia 换用本文 top-10 升至 39.80(+5.19),IRCoT 换用 top-100 升至 37.58(+9.03),剩余 20.15/22.37 个百分点是选择方法本身。跨语料 PatchFinder_top10(1,252 CVE,仅 577 条候选池含金标,上限 46.10%)上,同一智能体原封不动把 Recall@1 从 PatchFinder 自身 top-1 的 24.28% 提到 39.86%(相对 +64.16%),收回可达上限距离的 71.40%。消融:BM25 单路 39.68%、加时间衰减 49.57%、稠密单路 57.11%、完整融合 59.95%;把短 CVE 描述换成完整 NVD 报告几乎无效(59.83%)且上下文溢出率从 0.49% 升至 2.60%(5 倍);工具阶梯 32.63→48.21(清单 +15.58)→57.48(read_commit +9.27)→59.95(read_file_diff +2.47)。骨干交换:Qwen3-235B 59.95 对 Qwen3-Coder-30B 59.09(差 0.86%),gpt-oss-120B 56.98、gpt-oss-20B 49.81 均远高于无智能体地板 32.63%。成本:每 CVE 平均 96,118 输入 tokens、846 输出、约 8 次工具调用、读 5 个 commit、86 秒(中位 49 秒),约 0.007 美元/CVE、全语料约 58 美元,对 Favia 同价率的约 400 美元约省 7 倍。Phase 1 融合排序 Recall@100 = 87.64% 是系统天花板;35 条基准外真实 CVE 上 Recall@1 60.0%(21/35),与基准内一致。
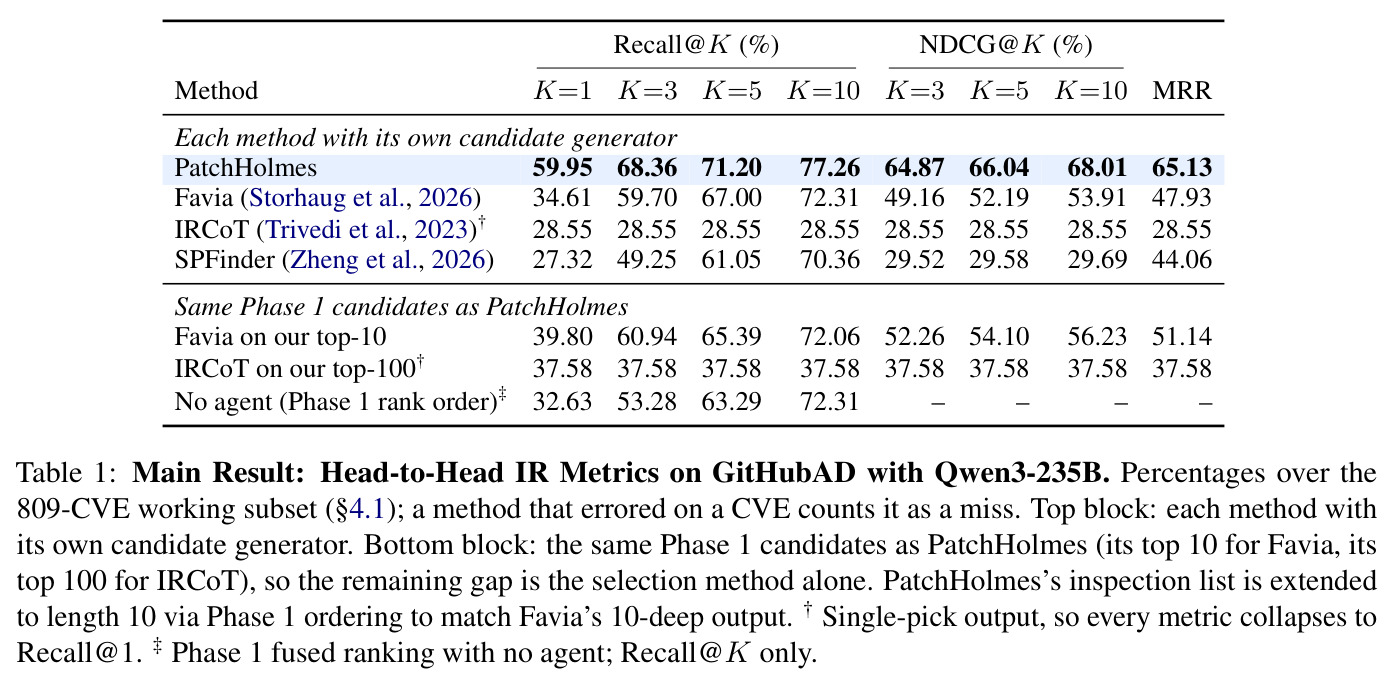
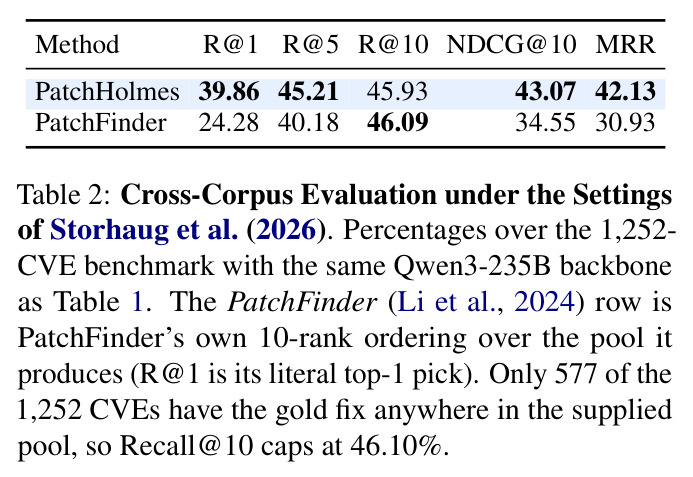
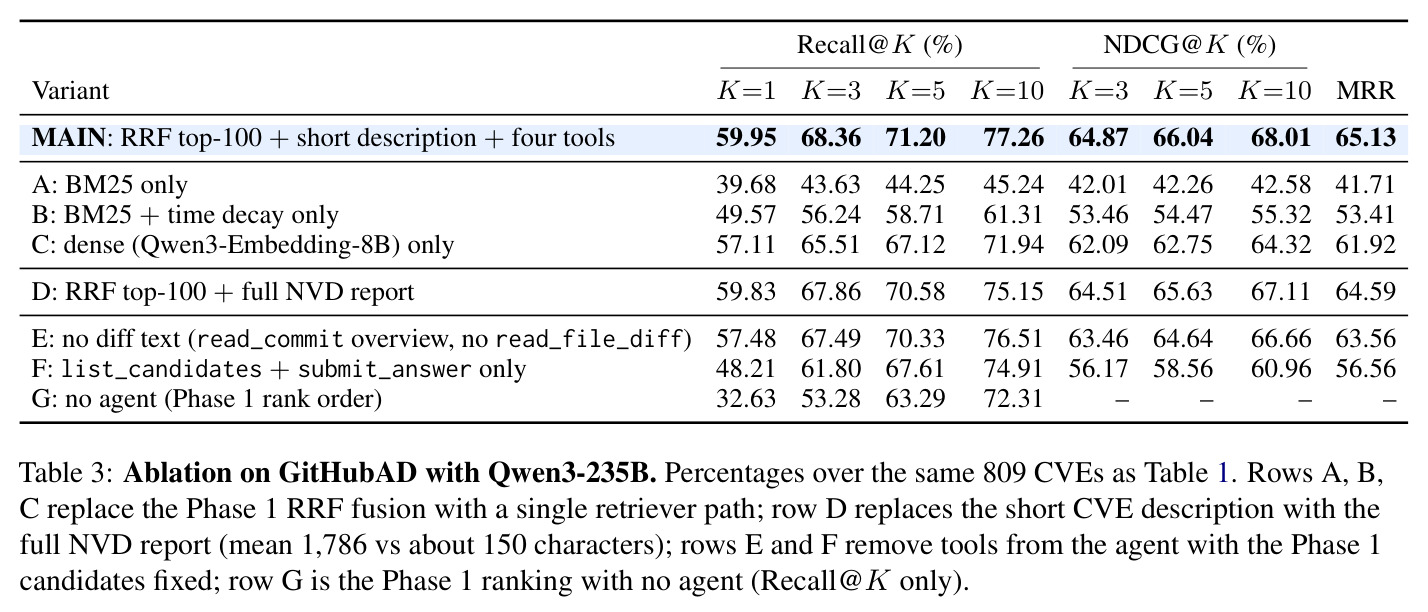
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GitHubAD 补丁检索(809 CVE,各用自家候选生成器) | Recall@1 | 59.95% | Favia 34.61% / IRCoT 28.55% / SPFinder 27.32% | 对最强基线 Favia +25.34 个百分点(McNemar p=2.4×10⁻⁴⁴) |
| GitHubAD(同一 Phase 1 top-100 候选,控制检索器变量) | Recall@1 | 59.95%(智能体) | 无智能体,取 Phase 1 第 1 名 32.63% | +27.32 个百分点,纯智能体审查增益 |
| PatchFinder_top10 跨语料(1,252 CVE,10 候选池,上限 46.10%) | Recall@1 | 39.86% | PatchFinder 自身 top-1 24.28% | +15.58 个百分点(相对 +64.16%),收回可达上限距离的 71.40% |
| GitHubAD | NDCG@10 | 68.01% | Favia 53.91% | +14.10 个百分点 |
| 35 条基准外真实 CVE(11 个仓库,2013–2025) | Recall@1 | 60.0%(21/35) | Phase 1 排序取第 1 为 22.9% | +37.1 个百分点,与基准内 59.95% 一致 |
局限与改进
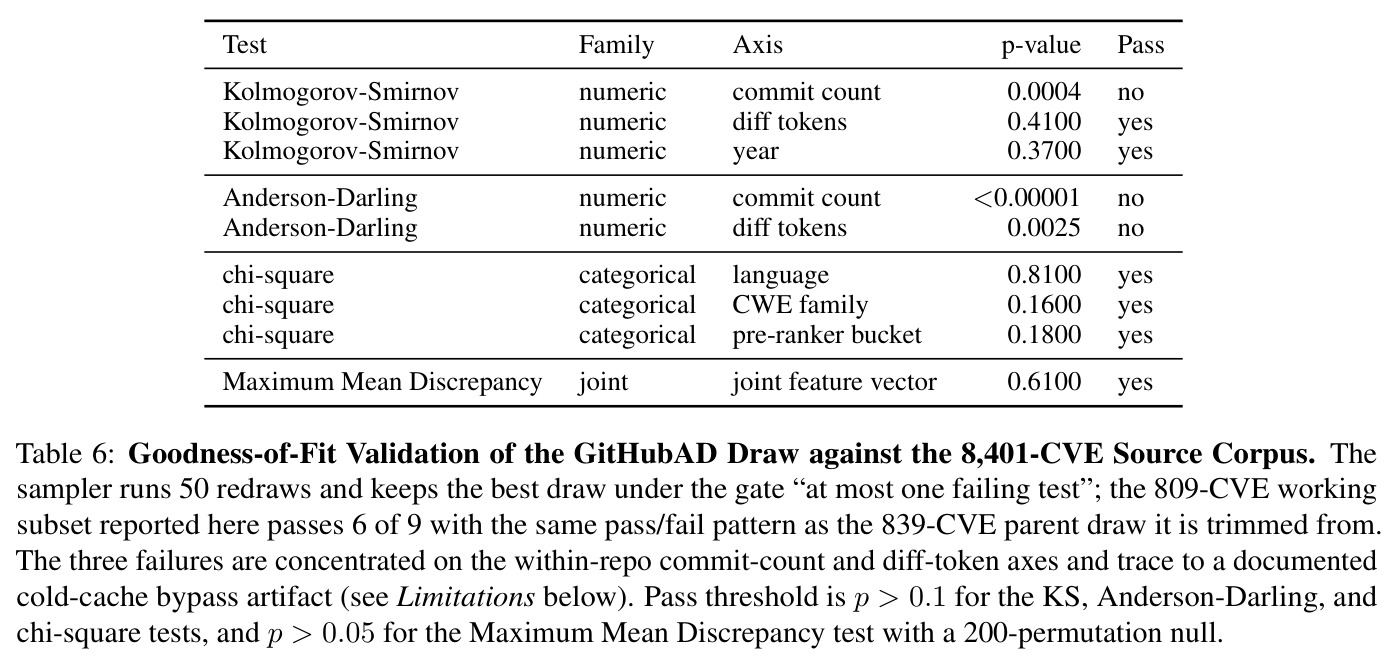
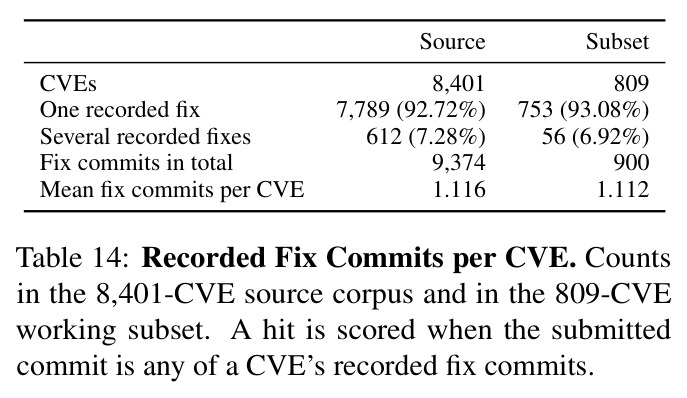
作者承认的局限:第一,真值稀疏造成幸存者偏差——只能在补丁已被找到的 37%–40% CVE 上评测,没人找到过修复的硬案例缺席于所有基准,35 条真实 CVE 的外部检验(60.0%)仍需已知修复才能计分;第二,PatchFinder_top10 的 46.10% 可恢复上限压低了绝对数字(675/1,252 条的候选池里根本没有金标);第三,采样伪影——2,816 个源仓库中 143 个的 commit 分片超过 500MB(CoreNLP 15GB、aws-sdk-java 12GB、phpmyadmin 10GB)被跳过全量解析,commit 数和 diff 长度用中位数插补,导致 KS 检验(p=0.0004)和 Anderson-Darling 检验(p<0.00001)在 commit-count 轴上未通过;第四,多修复歧义——7.28% 的 CVE 有多个记录修复,选中有效但未被记录的修复(如 backport)会计为 miss;第五,输出的排名列表缺少校准置信度。我的补充观察:系统的硬上限是 Phase 1 的 87.64% Recall@100,12.36% 的案例对智能体不可达;GitHubAD 为私人共享,完整复现依赖 SPFinder 论文的构建流程;稠密路对嵌入选型极其敏感(RTEB 榜首模型崩到 12.73%)却缺乏选型指导;时间衰减信号假设 CVE 日期与修复 commit 日期邻近,对长期 backport 或先修后披露的情形可能失效。
独立分析的弱点
弱点一,召回天花板:Phase 1 融合排序 Recall@100 只有 87.64%,即使智能体完美也有 12.36% 的 CVE 必然失败,改进方向是用 LLM 对查询做扩展改写(把症状词汇翻译成根因词汇)或引入文件路径、CWE 先验过滤来扩大候选覆盖。弱点二,token 开销仍重:每 CVE 平均 96K 输入 tokens 在数十万级部署下依然可观,且每次 read_commit 都重发整个渲染 diff,可对已读 commit 做增量摘要缓存,或让渲染层按 CVE 描述做查询感知压缩。弱点三,迭代预算一刀切:max_iter=15 对推理型模型太紧(gpt-oss 提交率仅 70%/54%),撞上限后回退到 Phase 1 排序浪费了已完成的阅读,可改为动态预算或在超时时输出当前最优候选而非直接回退。弱点四,嵌入模型脆弱性:Octen 在 RTEB 排第一但在本任务仅 12.73%,榜单成绩与本任务严重脱节,缺乏面向补丁检索的选型方法,可探索轻量任务适配微调或自动化 prompt 搜索。弱点五,单修复输出假设:对约 7% 多修复 CVE 及 backport 场景,输出 commit 集合或按分支分组会更合理。弱点六,评测偏差:809 条子集在 commit 数与 diff token 的尾部与源语料分布不符(3/9 检验未通过),极大型仓库上的表现可能被系统性高估,应在移除冷缓存旁路后重跑验证。
未来方向
作者明确提出的是给输出排名列表加校准置信度分数,使其能安全接入自动化下游(如 SBOM 扫描器的可达性判断),并建议产出仅作人工审核的候选而非自动填充漏洞库。基于本文成果可延伸的方向:其一,把列表式智能体循环推广到相邻封闭世界检索任务,如回归引入型 commit 识别、崩溃栈到 commit 的溯源、SBOM 依赖可达性判断;其二,用强化学习训练 Phase 2 的工具选择策略(类似 Search-R1、ToolRL 的思路),进一步压 token 成本或提高 15 次迭代内的提交率;其三,改进 Phase 1 召回上限,包括查询扩展、仓库级元数据索引、多嵌入器融合;其四,多修复输出与 backport 检测,把任一记录修复计对的评分升级为更细的修复等价性判断;其五,反向利用 NVD 报告无增益的发现——设计按需选择性调用元数据工具的混合接口,只在短描述不够时拉取完整报告;其六,在人机协同部署中实测从未被找到过补丁的那 60% CVE,检验系统在真实未解案例上的价值。
复现评估
复现条件相当好。代码已在 GitHub 开源(github.com/Aizhouym/PatchHolmes);全部超参数列于表 16(RRF k=60、top-100 截断、max_iter=15、8K/16K 字符预算、各检索路权重),系统提示逐字公开于 Listing 1,四个骨干的规范标识符与提供方列于表 15。数据方面:GitHubAD 为作者私人共享,但论文说明可按 SPFinder 论文的流程重建;PatchFinder_top10 由 Storhaug 等人分发(无明确许可证,作者按学术合理使用处理);采样器伪代码(Algorithm 1)和 9 项拟合优度检验套件(Table 6)齐全。算力门槛不高:Phase 1 需对仓库做离线嵌入(Qwen3-Embedding-8B 本地 GPU,缓存为单矩阵),Phase 2 主骨干 Qwen3-235B 可经 OpenRouter 按约 0.007 美元/CVE 调用(全 8,401 条约 58 美元),Qwen3-Coder-30B 与 gpt-oss 可在大学集群 vLLM 上运行。难度评级中等:工程上需处理大分片仓库(作者自己在此踩坑,143 个仓库被插补)、多语言仓库解析和嵌入管线的字节级校验;复现主表约需数十美元 API 费或一张足够大的本地 GPU,完整复现全部消融与骨干交换成本会翻数倍。总体属于开源充分、数据可重建但需费力、算力门槛低的可复现类型。
论文图表
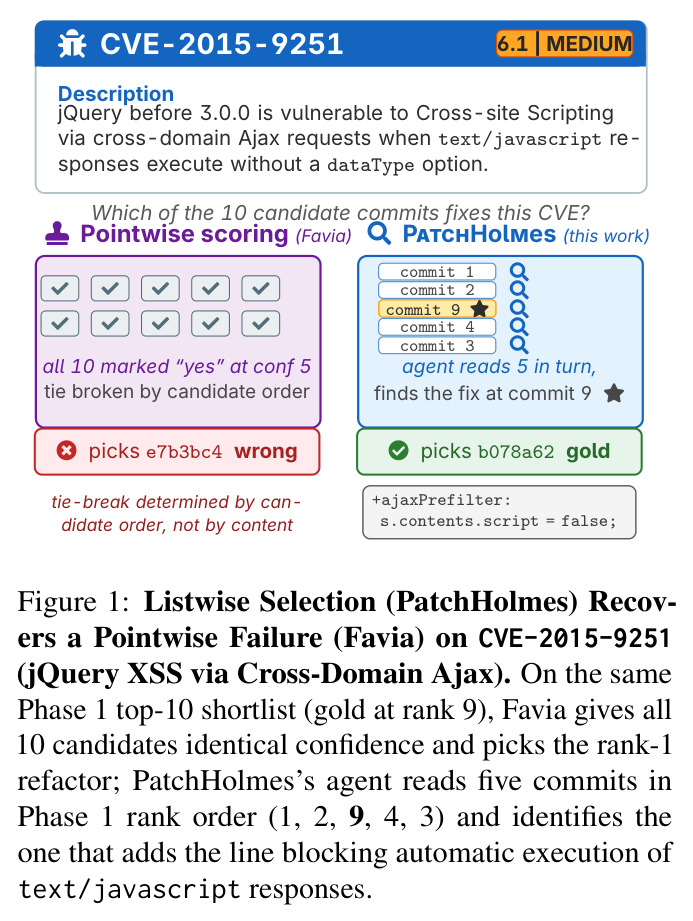
以 CVE-2015-9251 为例对比两种范式:在同一个 Phase 1 top-10 候选列表(金标排第 9)上,Favia 的 10 次点式调用给所有候选相同的置信度 5 的 yes,最终按候选顺序选中排第 1 的无关重构 e7b3bc4;PatchHolmes 的智能体按排名次序 1,2,9,4,3 读了 5 个 commit,认出 b078a62——它唯一地添加了阻止跨域 Ajax 响应中 text/javascript 自动执行的 ajaxPrefilter。
这是全文论点的最小实例:点式打分在多个候选都像修复时没有联合破平局的信号,只能按候选顺序选;列表式审查能通过内容对比找到深排名的金标,直接启发了 Phase 2 的设计。