打破巴别塔:面向长篇剧集字幕翻译的自进化多智能体系统 Breaking Babel: A Self-Evolving Multi-Agent System for Long-Form Subtitle Translation
用测试时自进化的多智能体加剧集级持久记忆,在15个语向字幕翻译上全面登顶。
前置知识
MQM(多维质量度量)
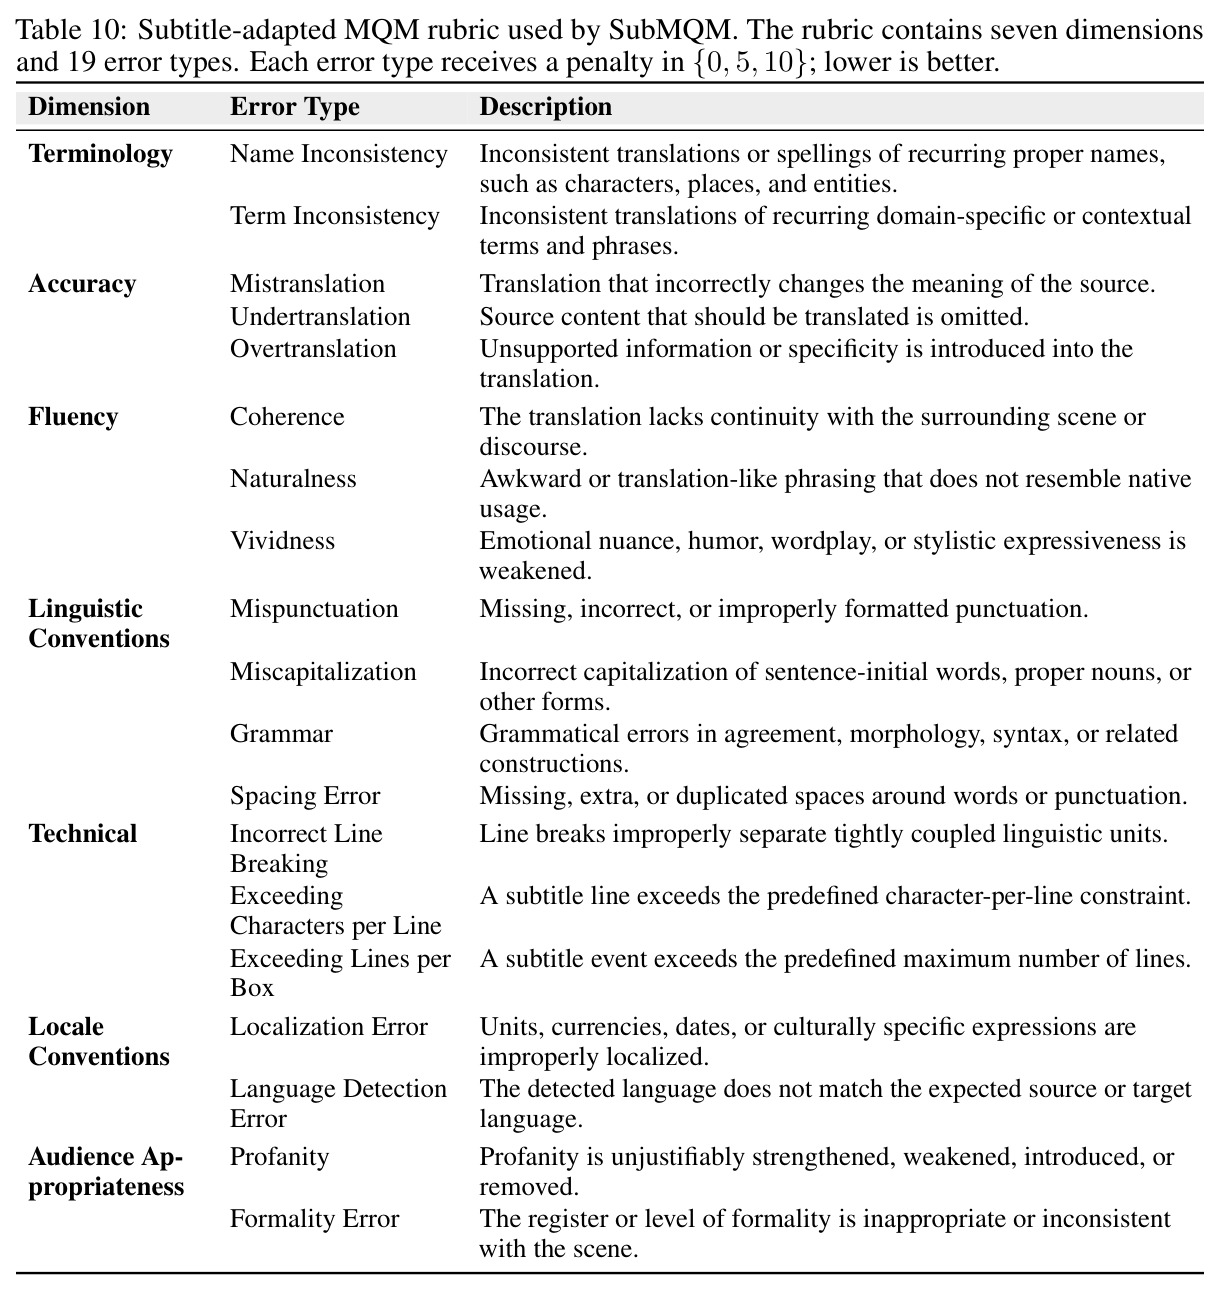
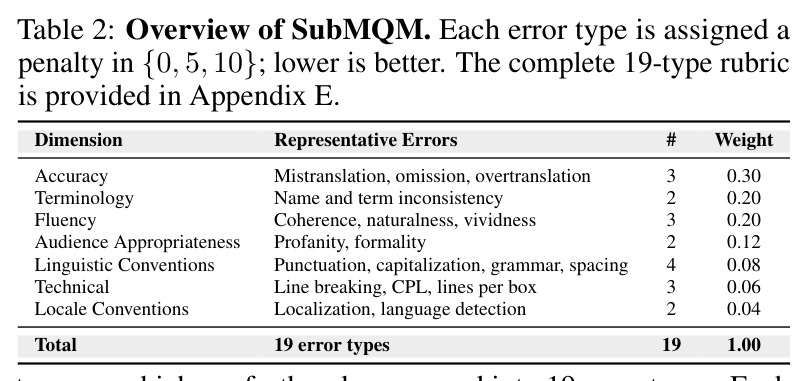
翻译行业的质量评估框架:评审员按预定义错误类型(误译、术语不一致、标点错误等)和严重度给译文扣分,得分是罚分(penalty),越低越好。本文将其适配为面向字幕的 SubMQM,含7个维度、19种错误类别,每类罚分取0/5/10。
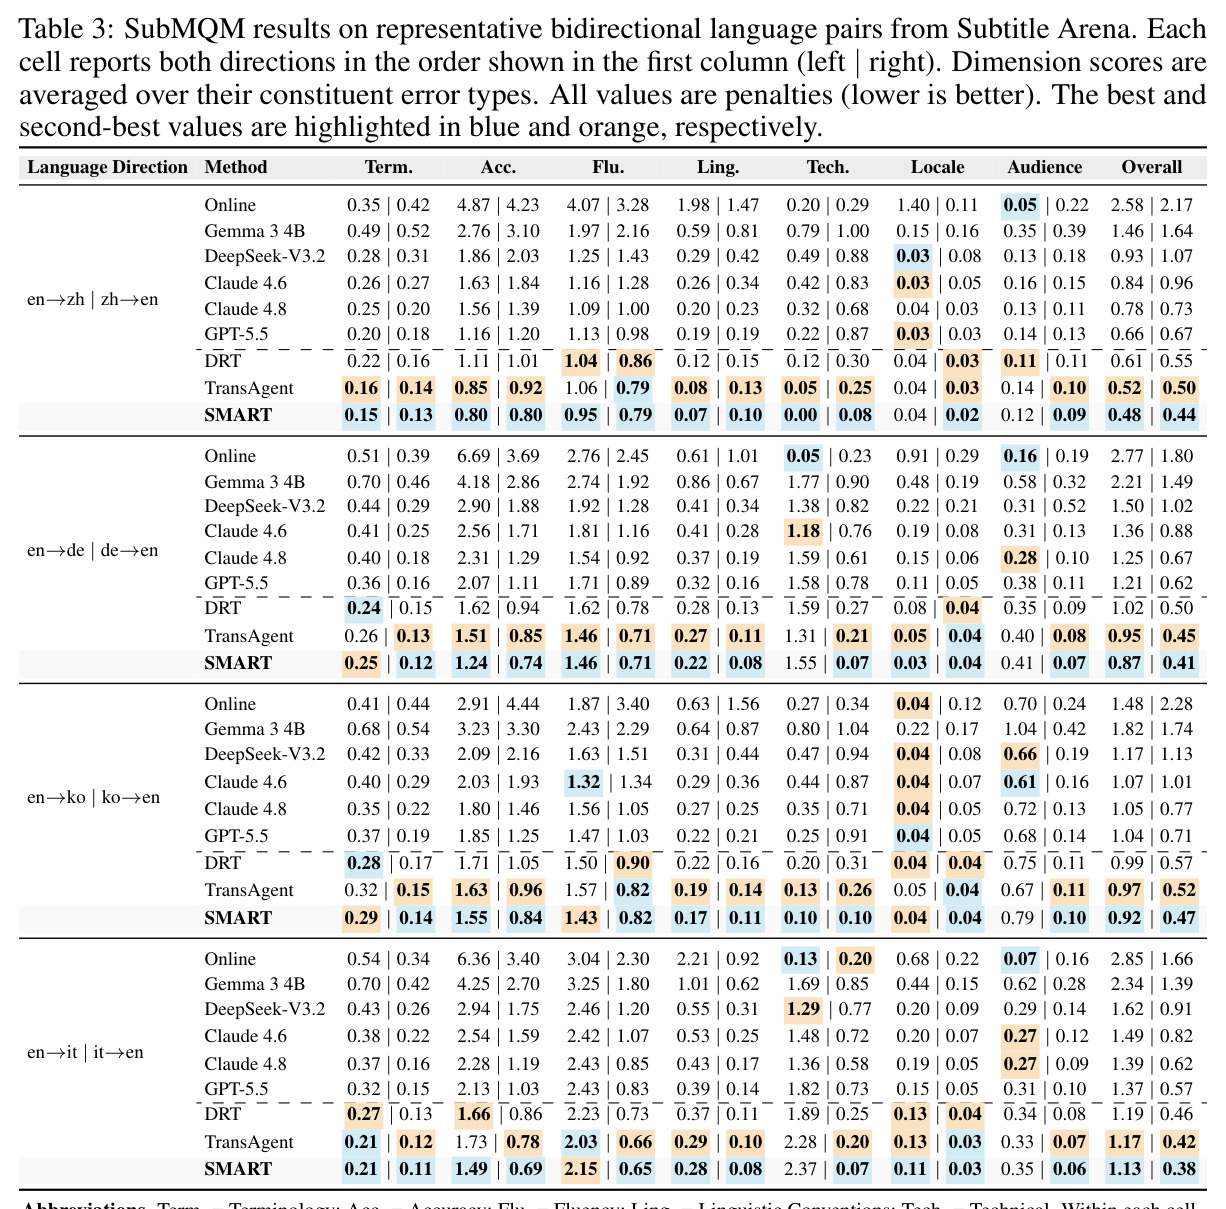
论文所有主实验结果都以 SubMQM 罚分报告,不懂 MQM 的'罚分越低越好'逻辑就无法读懂 Table 3–6 的任何一张表。
多智能体系统与混合智能体(MoA)
把一个复杂任务拆给多个角色化的 LLM 实例协作完成。MoA(Mixture-of-Agents)指多个译员智能体各自独立生成翻译候选,再由上层机制挑选/融合,与单个大提示词生成相比能产生互补的多样化假设。
SMART 的翻译层就是 MoA:5种专职译员(忠实、自然、表现力、长度感知、口语)被路由器按句激活,消融显示去掉 MoA 平均罚分上升0.61。
测试时训练与文本反馈优化
不更新底层 LLM 权重,而是在推理阶段用任务反馈迭代改进系统的可编辑部分——提示词、路由规则、工具配置。反馈以自然语言批评的形式'反向传播',更新本质是对配置文本的受约束重写,无需任何梯度计算。
这是本文标题里 self-evolving 的含义:SMART 在每部剧前30%内容上做这种进化,然后冻结配置翻译剩余70%,是全文最核心的机制。
LLM-as-a-Judge
用大模型按评分细则对另一个模型的输出打分并生成自然语言批评,可替代或补充人工评估。在机器翻译中有 GEMBA-MQM、AutoMQM 等先例,输出结构化的错误列表与严重度。
SMART 里 judge 有双重身份:既给候选译文打0–10分驱动选择与精修,又在评测中执行 SubMQM 打分;理解它才能理解系统闭环与评测协议。
字幕显示约束(CPL 与阅读速度)
专业字幕的硬性排版规范:每行字符数(CPL)、每屏行数、以及阅读速度(每秒可读字符数,依据时间码计算)。超限的字幕即使语义正确也不合格,属于 Technical 维度的检查对象。
长句必须拆分到多条时间码内,这是字幕翻译区别于普通翻译的关键约束;论文的 constraint check 工具、Length-aware 译员和 Technical 维度都围绕它设计。
研究动机
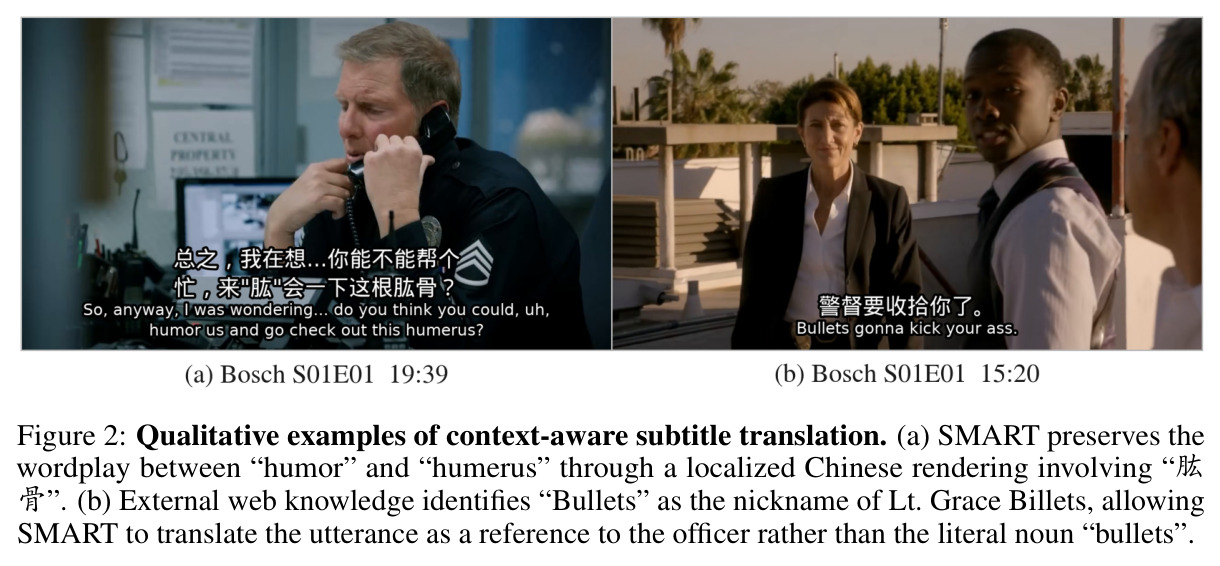
长篇剧集字幕翻译远难于逐句机翻:一集含数百句台词(实验中平均每集611.7句),某句话的含义常常取决于跨说话人、跨场景甚至跨集的话语和文化语境;同时人物名、术语、叙事口吻必须在整部剧甚至整个系列内保持一致,还要满足每行字符数和阅读速度等硬性排版约束。现有两条路线都力不从心:单 LLM 方法(如直接调用 GPT-5.5、Claude)逐句翻译,没有持久的剧集级上下文,导致专有名词、称呼语和风格跨场景漂移——在 Subtitle Arena 上这类单次调用基线的 Overall 罚分普遍在 0.6–1.5,社区字幕(Online)更是高达 2.17–2.85;多智能体方法(TransAgent、DRT)虽然引入角色分工,但工作流是静态固定的,简单对白和需要文化考据的疑难句用完全相同的流程,无法按场景难度分配算力;此外两类方法都缺乏按剧集类型、年代、文化背景动态检索外部知识的能力。
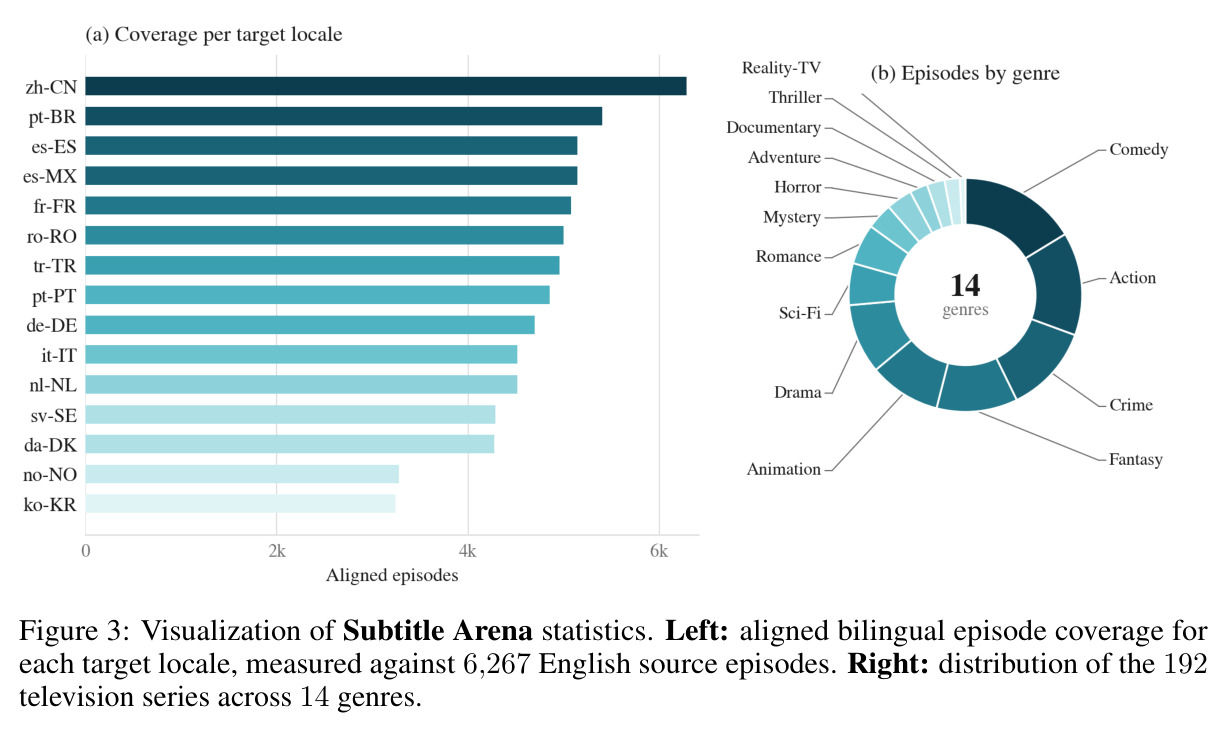
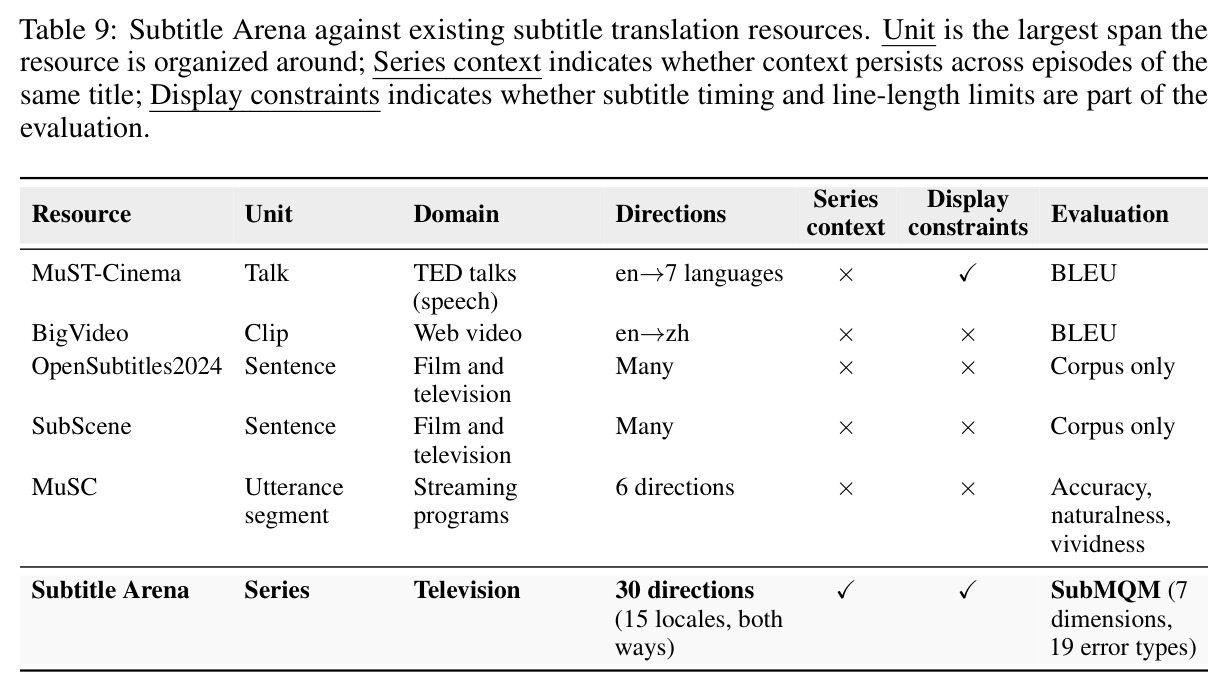
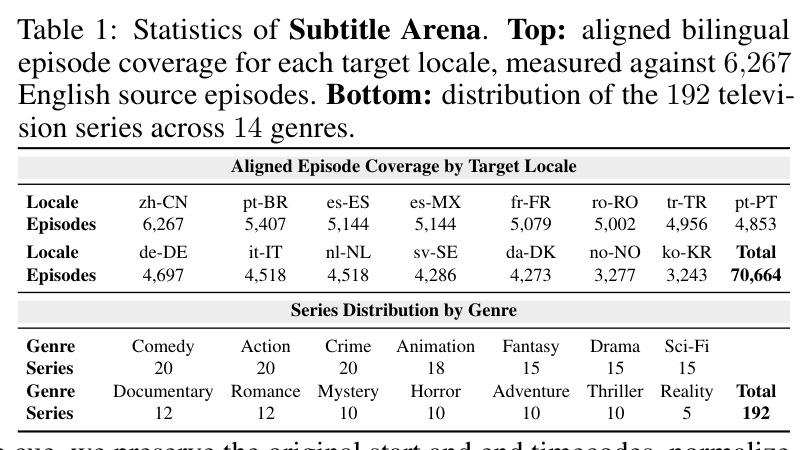
本文的目标是本文要构建一个把字幕翻译当作'有状态、自适应过程'的系统 SMART:第一,维护剧集级持久记忆(术语表、人物档案、领域知识、习语库),让跨集实体和信息可检索而非反复重推;第二,引入测试时训练机制——在每部剧前30%的内容上,通过评审反馈以纯文本方式进化译员提示词、路由策略和工具分配(完全不改动 LLM 权重),再冻结配置翻译剩余70%,兼顾适应性与防泄漏;第三,构建 Subtitle Arena 大规模基准(192部剧、6,267个英文源集、70,664个双语集对、15个目标语言、14种类型、1959–2023年作品)和字幕定制的 SubMQM 评测协议(7维度19错误类别),系统检验语篇理解、跨集一致性与显示约束合规这三个被传统 MT 评测忽视的维度。
与已有工作不同的是,本文的独特切入是把'自进化智能体'从优化未来通用任务,拉回到单一长篇任务内部的适应性上。其一,已有翻译多智能体(TransAgent、DRT、多模态系统)工作流预先固定;已有的自进化智能体和提示词优化(APE、OPRO 等)面向固定的外部目标集,本文首次把二者结合:提示词与路由被视为可被'文本梯度'更新的持久系统状态,且更新是受约束重写——提示词必须保留角色声明与工作流骨架,路由表在固定类别内重排且每类至少保留2个译员,可达空间有限可枚举,避免了自由改写的漂移。其二,可学习状态(提示/路由)与任务状态(剧集记忆)严格分离:前者训练后冻结防止评估信息泄漏,后者推理期持续累积维持一致性。其三,为字幕任务定制了时间码保持、句子合并拆分、显示预算校验等机制,这是通用文档翻译系统不具备的。
核心方法
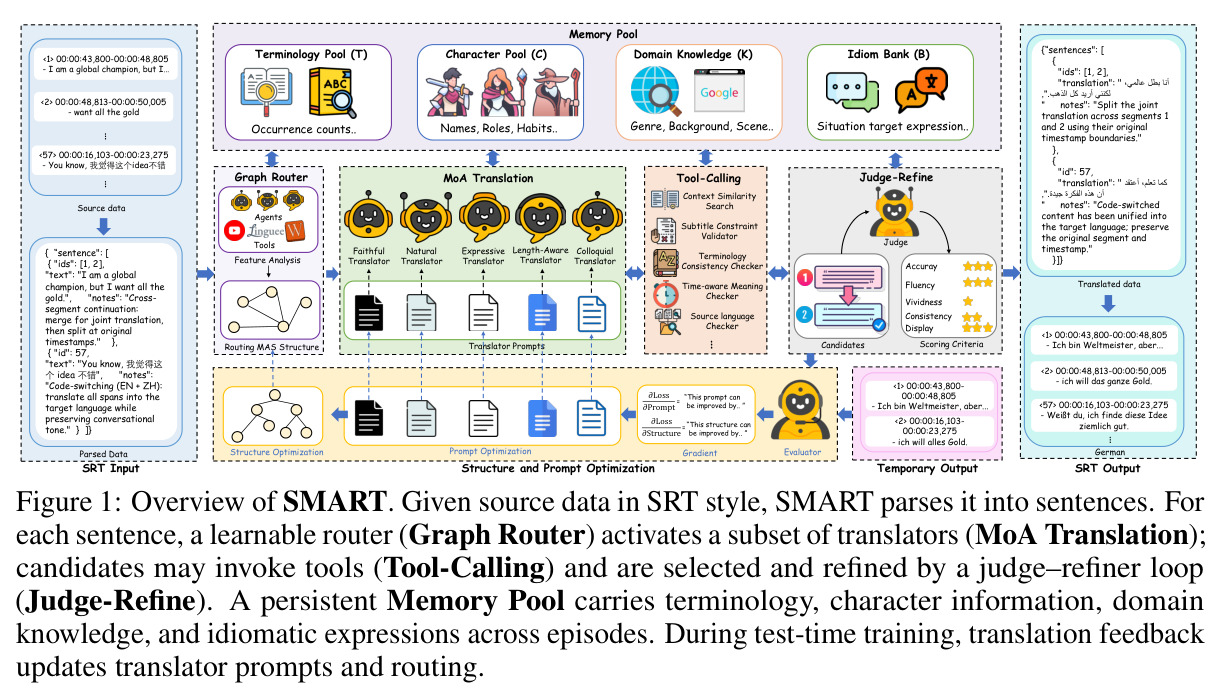
直觉上,好字幕翻译像一支会成长的译制组:有场记持续记录术语和人物(记忆池),有风格各异的译员分工(忠实/自然/表现力/长度/口语五种角色),有审稿人挑错并要求返工(judge–refiner),而且整支队伍会随着剧集推进总结教训(自进化)。技术上,SMART 把系统状态形式化为 $S_t = (R, \Pi_t, \rho_t, M_t)$,其中 $R$ 是固定的译员角色池,$\Pi_t$ 是各角色提示词,$\rho_t$ 是路由策略,$M_t$ 是剧集级持久记忆。流程分两阶段:测试时训练阶段,对每部剧按时间顺序取前30%剧集(3:7划分),运行3个epoch,每个epoch结束用聚合的评审分数与批评 $\Delta_t = \mathcal{E}\{c_i^{(r)}, \delta_i^{(r)}\}$ 更新提示词 $\Pi_{t+1} = \mathcal{F}_\Pi(\Pi_t; \Delta_t)$ 和路由 $\rho_{t+1} = \mathcal{F}_\rho(\rho_t; \Delta_t)$;推理阶段冻结 $(\Pi_T, \rho_T)$ 翻译剩余70%剧集,记忆 $M$ 继续增长。每句翻译经过:图路由器激活译员子集 → MoA 各译员(可调用8种工具)生成候选 → judge 0–10打分并给批评 → refiner 精修最优候选 → 结果写回记忆,最后每集做一次窗口式一致性修订。
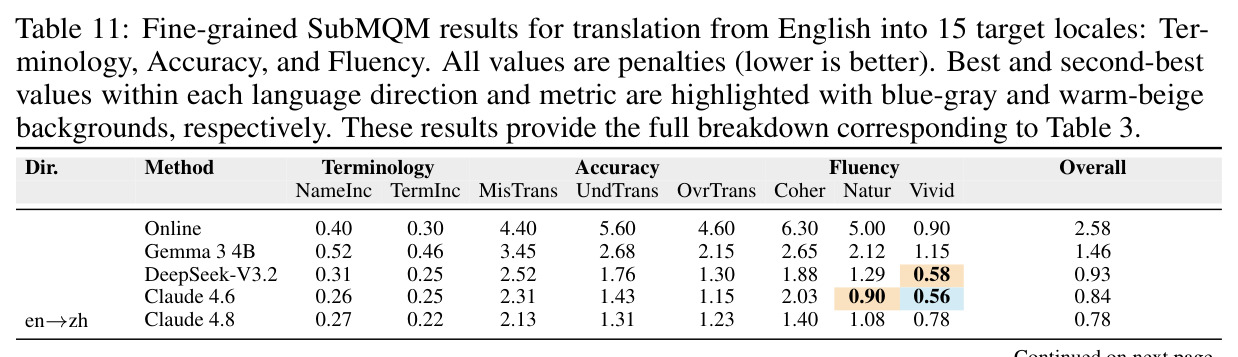
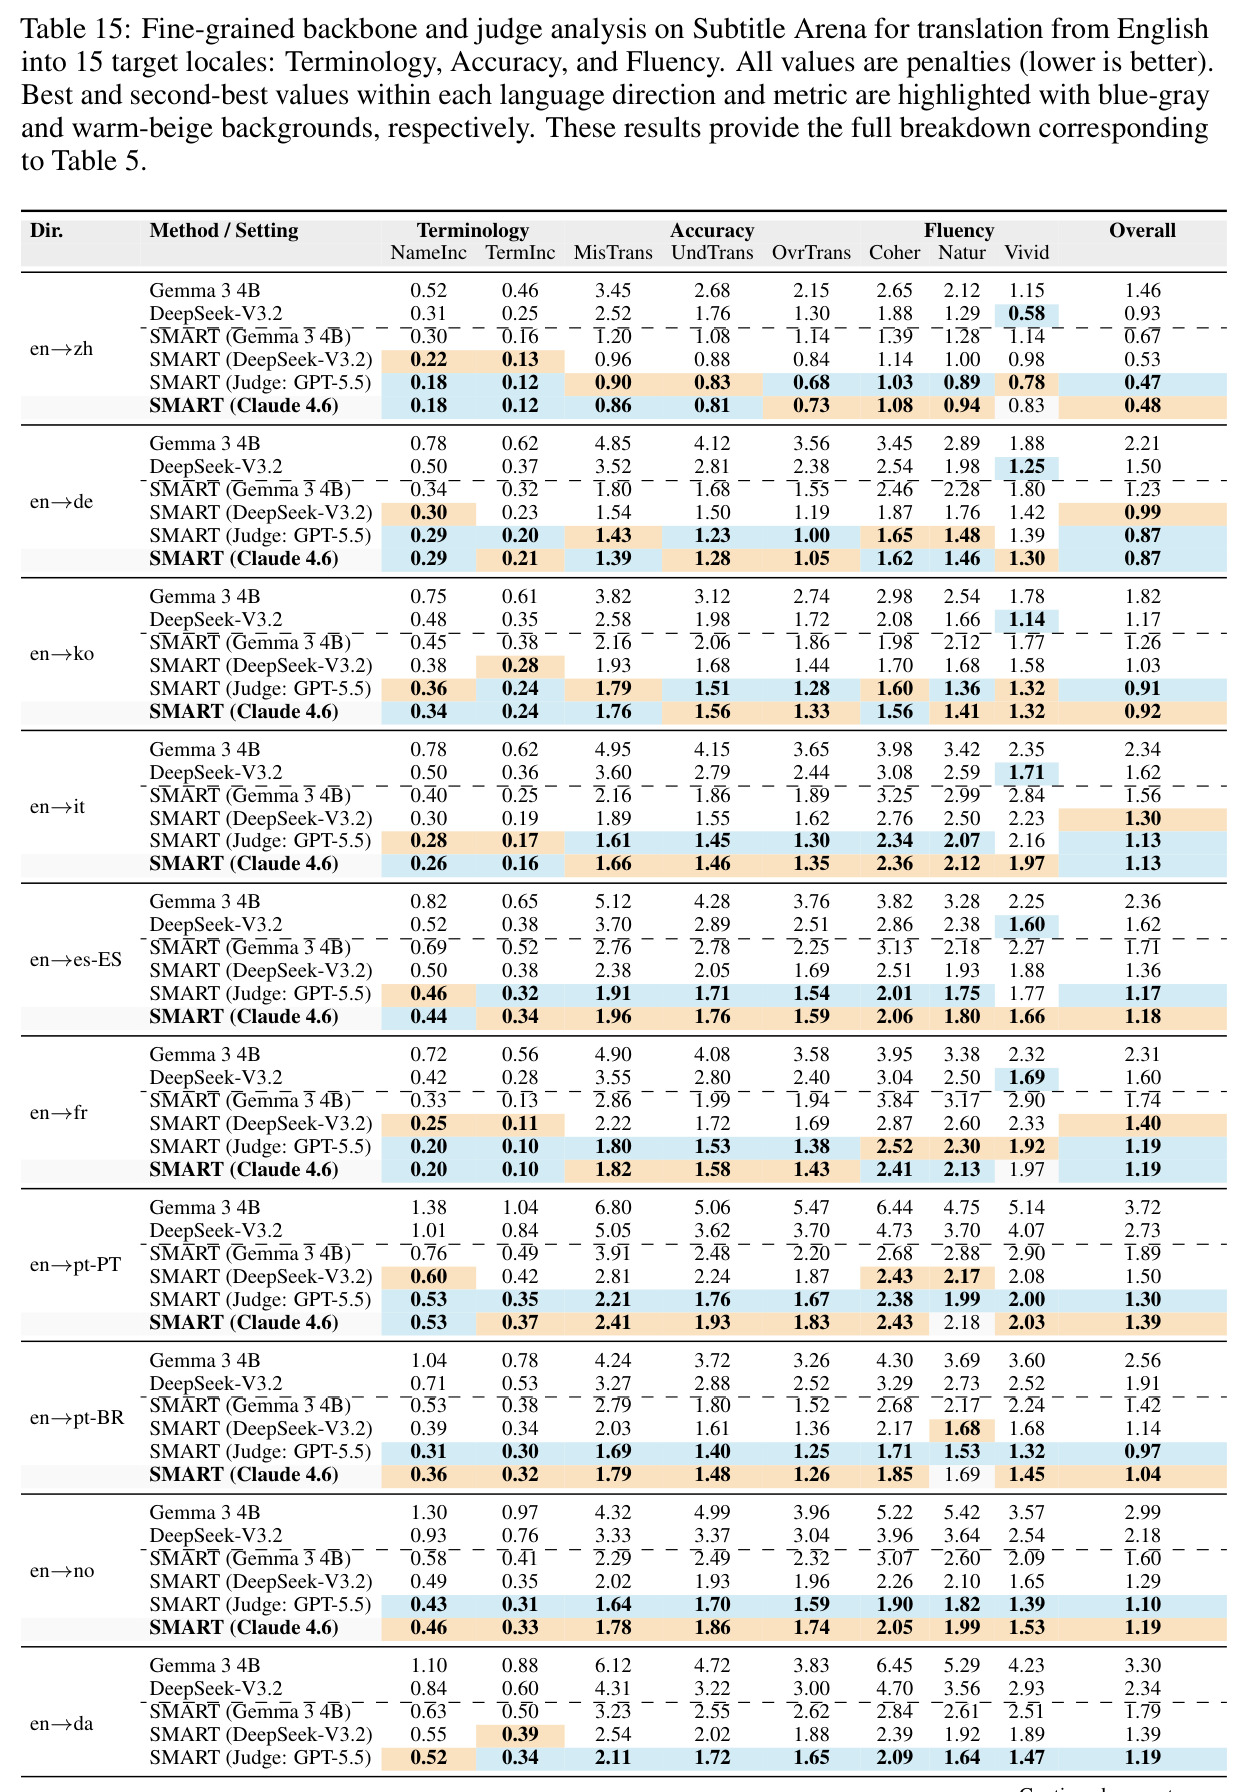
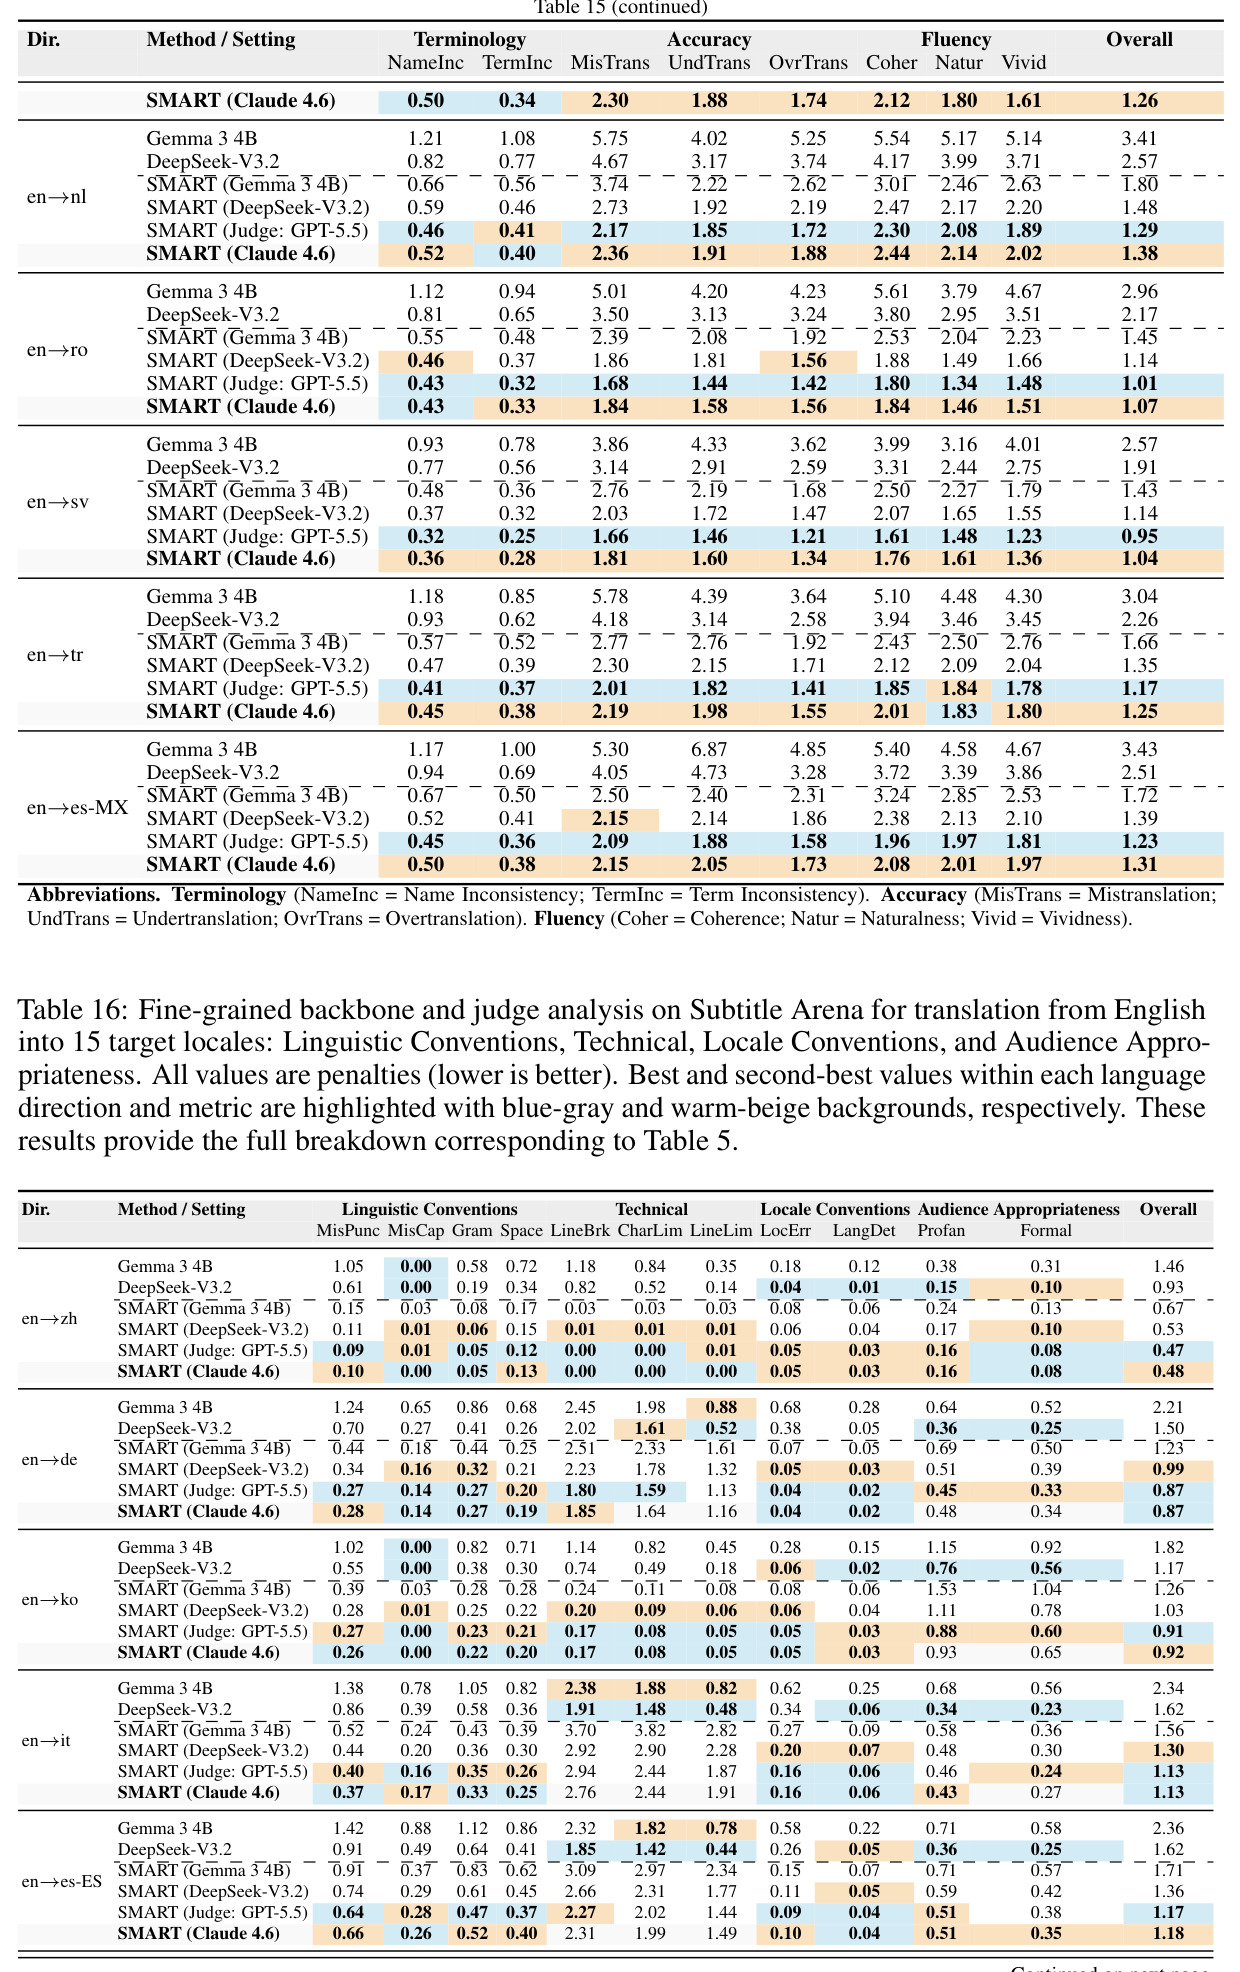
核心创新是'测试时训练'的形式化与约束化。与静态工作流多智能体的本质区别:SMART 的协调结构本身可学习——路由表和提示词都是文本状态,由评审反馈驱动的两个算子更新,且更新空间被严格限定:$\mathcal{F}_\Pi$ 重写表现不佳译员的提示词时必须保留其角色声明与工作流骨架,只能增改规则;$\mathcal{F}_\rho$ 在固定的路由类别表内重排译员与工具、每类至少2个译员,因此可达配置空间有限且可枚举。与通用提示词优化的本质区别:更新目标是翻译同一部剧的后续句子,必须保留已建立的术语、风格与既有翻译能力,批评描述失败模式而非给正确答案,防止逐句过拟合;且更新以 epoch 为粒度基于整段训练前缀的聚合统计,而非逐句修改。与 LLM-as-a-Judge 的本质区别:judge 的输出不用于局部修订后就丢弃,而是转化为持久的系统状态。整个进化无需梯度、不改模型权重,弱模型加好脚手架也能大幅受益(Gemma 3 4B 上 en→zh 罚分从1.46降到0.67)。
方法步骤详情
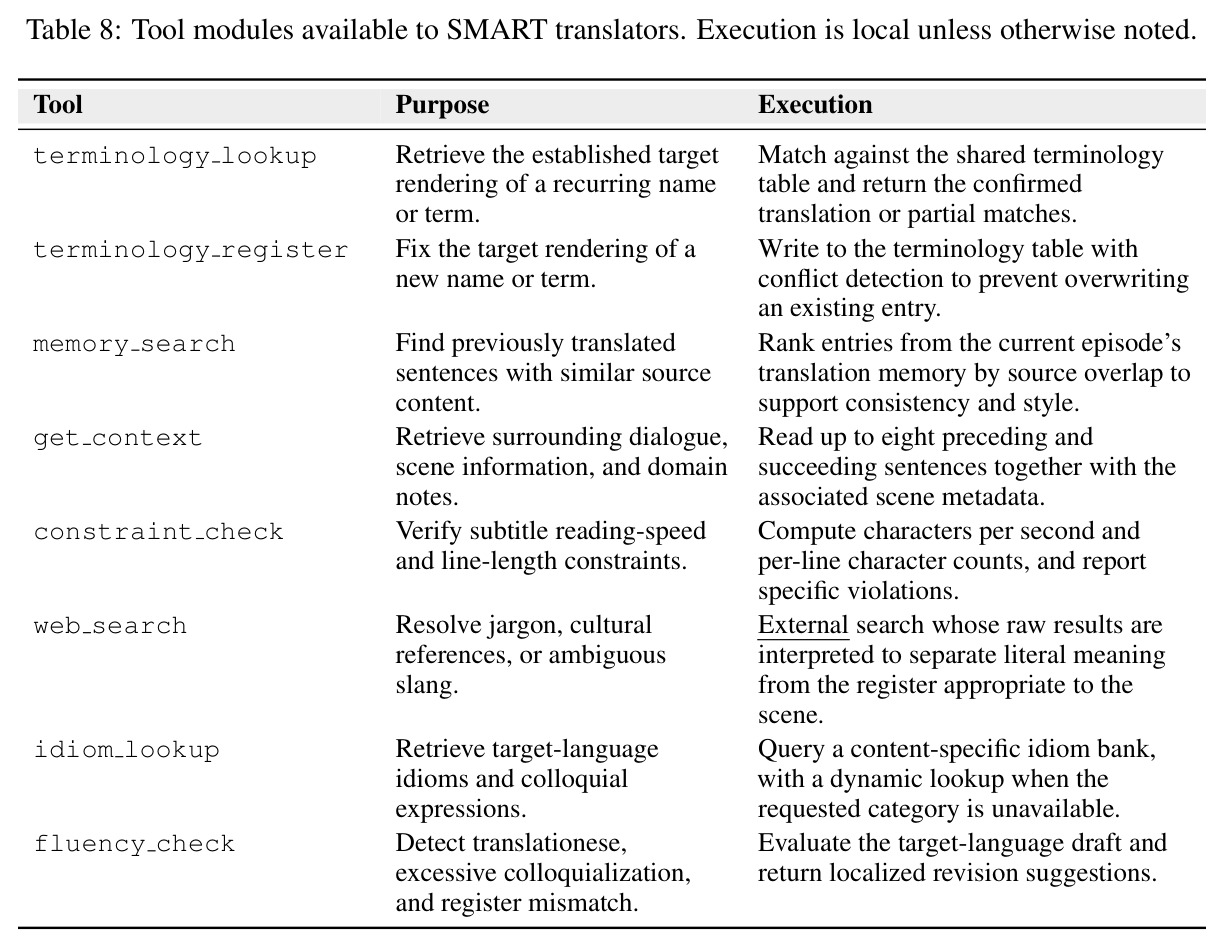
第一步,SRT解析与上下文构建:每个字幕块解析为(索引、起止时间码、源文本),被切断成多条的完整句合并为一句翻译,再按原始时间码边界拆回,保住时间轴对齐。第二步,内容档案与记忆初始化:开头先建立类型、背景设定、主要人物和领域术语的初始档案 $M=(T,C,K,B)$(术语池/人物池/领域知识/习语库),可疑行话、文化梗触发 web search,检索结果先经语境解释步骤分离字面义与得体译法再入库。第三步,动态路由:$\phi(d_i, M_t)$ 提取句子长度、时长、场景基调、俚语/脏话标记、显示预算压力等特征,$A_i = \rho_t(\phi(d_i, M_t))$ 从5个译员中激活子集(默认路径为忠实+自然译员,俚语句加口语译员,情绪句加表现力译员等)。第四步,MoA候选生成:每个活跃译员按 $y_i^{(r)} = r(d_i, \pi_{r,t}, M_t, \mathcal{T})$ 产出候选,可调用8个工具——terminology lookup/register(查/登记术语并冲突检测)、memory search(相似已译句)、get context(前后各8句+场景信息)、constraint check(每秒字符数与每行字符数)、web search、idiom lookup、fluency check。第五步,judge–refiner:judge 按 $J(y_i^{(r)}, d_i, M_t)$ 给出分数 $c_i^{(r)}$ 和批评 $\delta_i^{(r)}$,选 $r^\star = \arg\max_{r \in A_i} c_i^{(r)}$,精修 $\hat{y}_i = \mathcal{R}(y_i^{(r^\star)}, \delta_i^{(r^\star)}, M_t)$;若最高分低于救援阈值 $\theta = 8.0$,附带批评重跑一轮 MoA。第六步,写回:接受的译文更新本集翻译历史,确认的信息合并进记忆 $M^{(e+1)} = M^{(e)} \cup \Delta M^{(e)}$。第七步,集级一致性检查:以5/10/20三种窗口、50%重叠扫全集,对照锁定的前文修术语、指代和翻译腔残留。第八步,自进化epoch五阶段循环:Translate(记录分数/译员/工具/类别)→ Evaluate(每译员均分与最差用例统计)→ Prompt优化(低于阈值译员的重写提示)→ Structure优化(重排路由表和工具分配)→ 保存配置,3个epoch后冻结用于推理。
技术新颖性
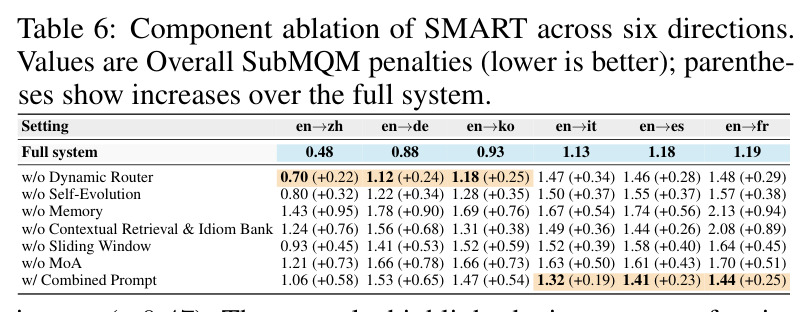
技术新颖性体现在四个层面。第一,把'测试时训练'从概念变成可操作协议:可学习状态(提示词、路由、工具分配)全部表达为文本或配置,梯度被替换为基于聚合评审统计的受约束自然语言重写,无反传、无权重更新,任何 API 模型都能即插即用。第二,提示空间与结构空间联合优化:此前提示词优化只改指令、多智能体工作流固定不变,SMART 的 $\mathcal{F}_\rho$ 会根据每类路由上哪个译员得分最高来换人、换工具,实现'软专家混合'的结构搜索;消融证明去动态路由和去自进化分别使罚分升高0.27和0.36,且把 MoA 换成合并提示的单译员(+0.41)说明收益来自独立假设的多样性而非指令堆叠。第三,训练/推理的状态二分法:可学习部分在3个epoch后冻结防止 held-out 信息泄漏进配置,记忆作为任务状态继续增长维持跨集一致性,这一分离设计干净地兼顾了适应性、公平评测和一致性。第四,任务定制:时间码保持的句子合并拆分、CPL/阅读速度硬校验、习语库按交际情景索引,都是针对字幕形态的原创工程,通用文档翻译智能体没有对应物。
实验结果
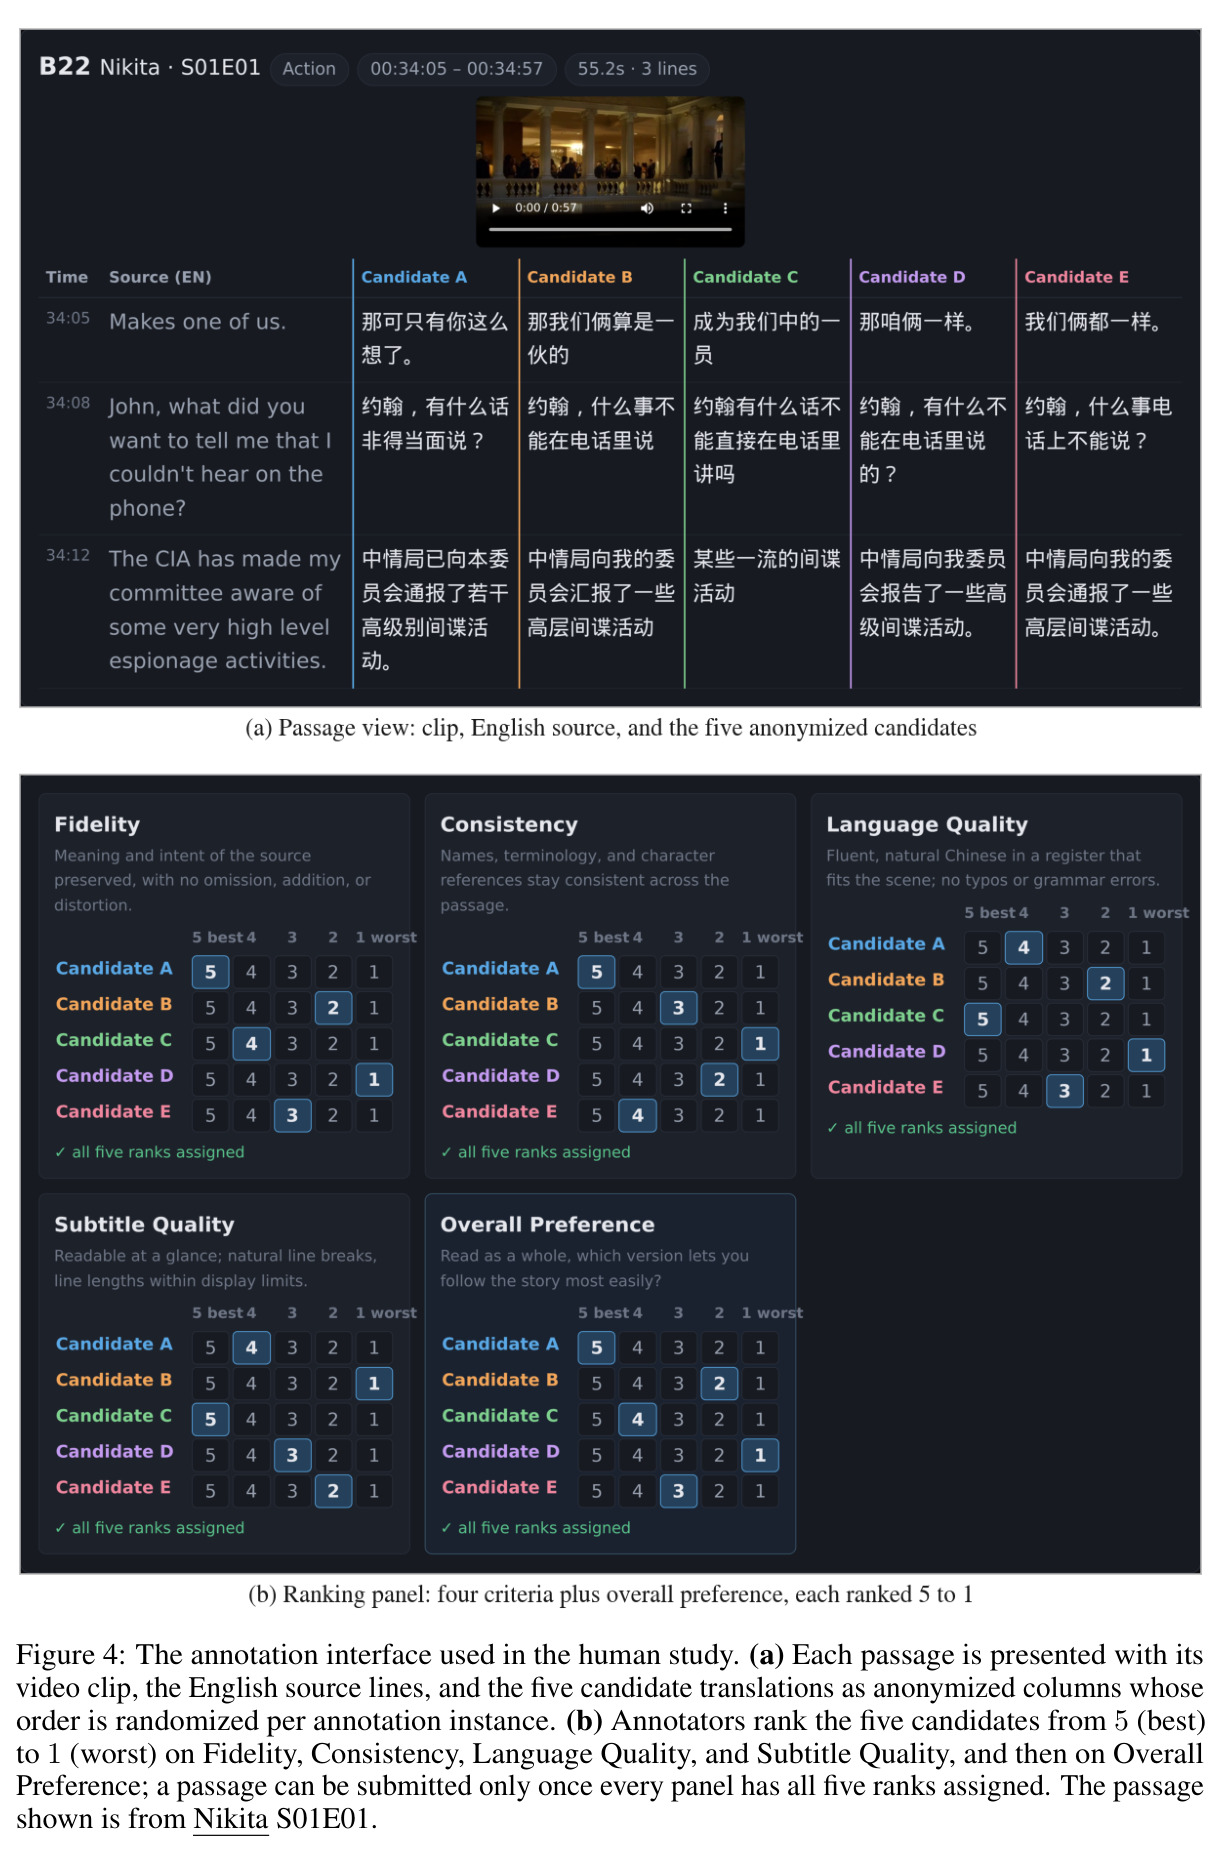
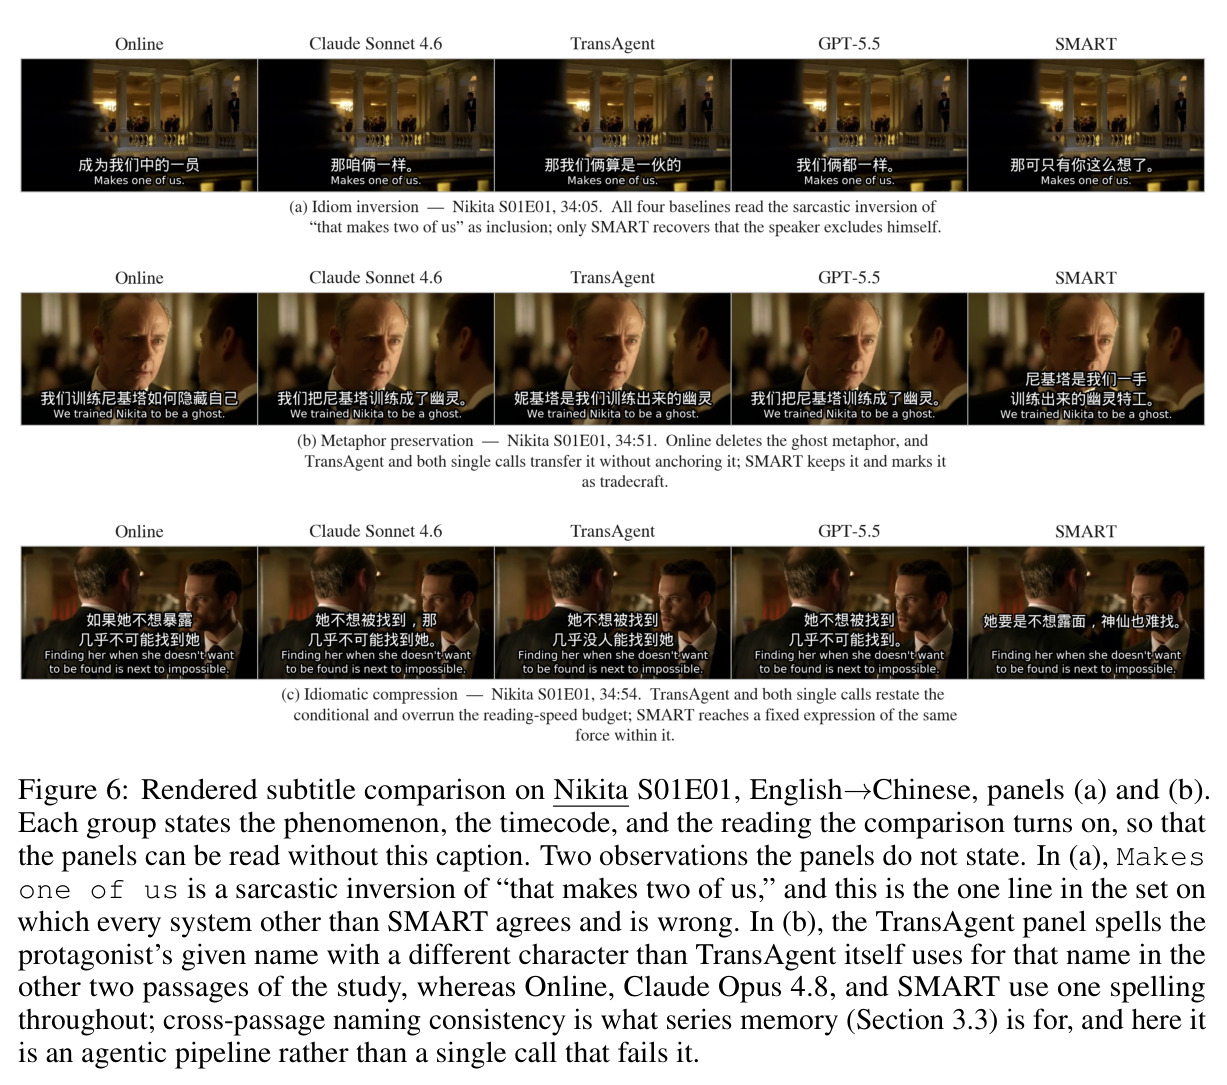
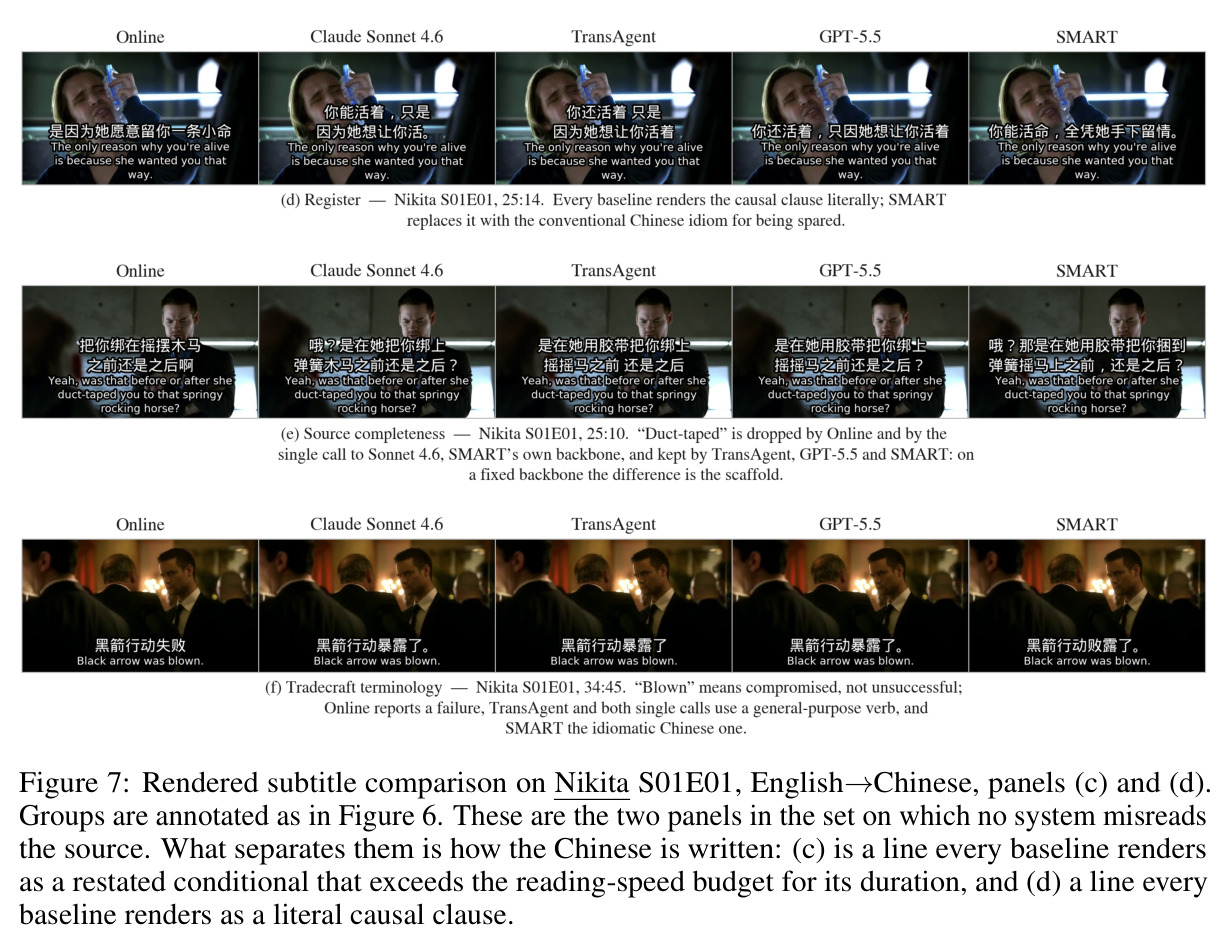
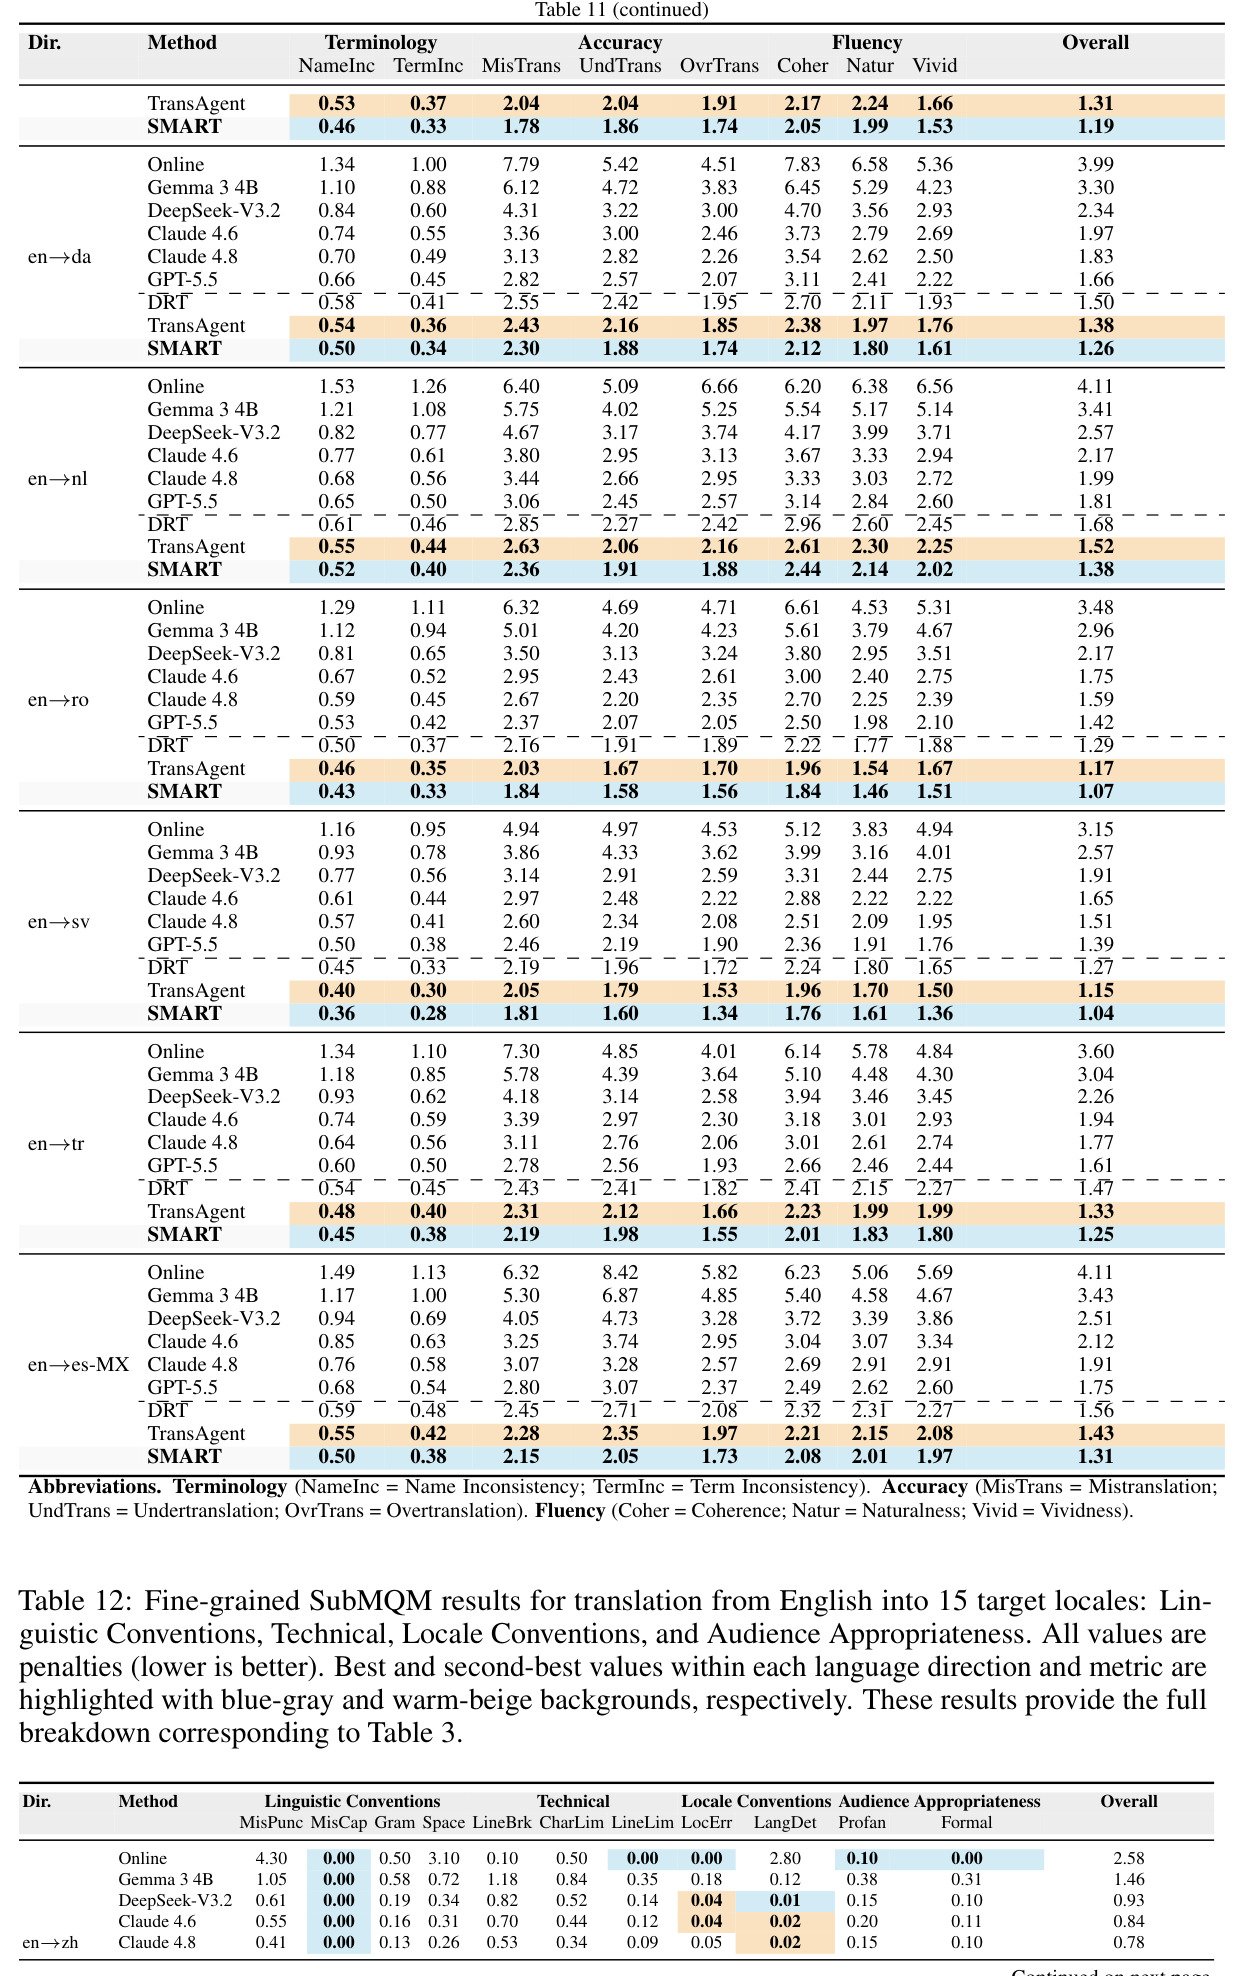
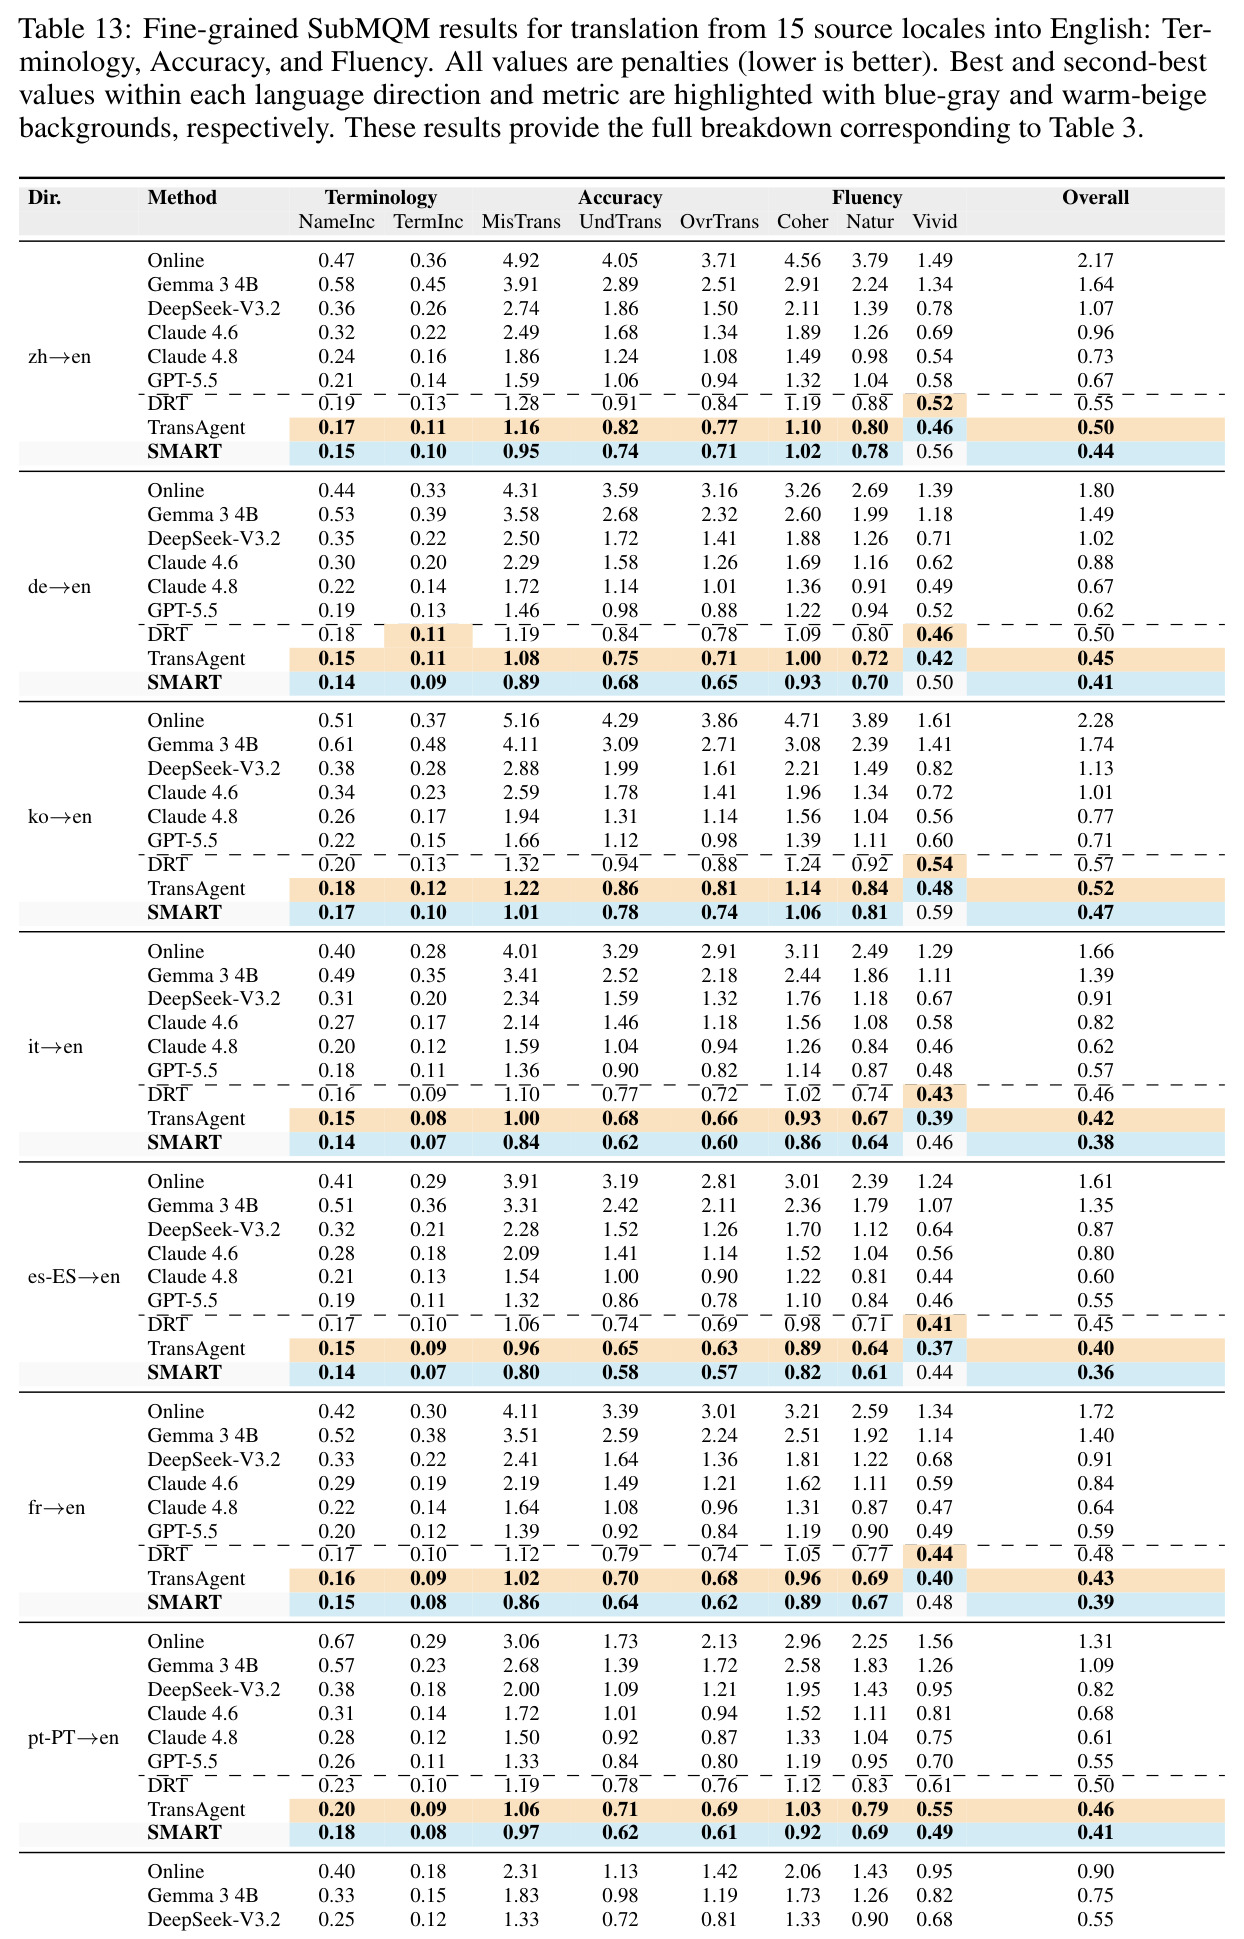
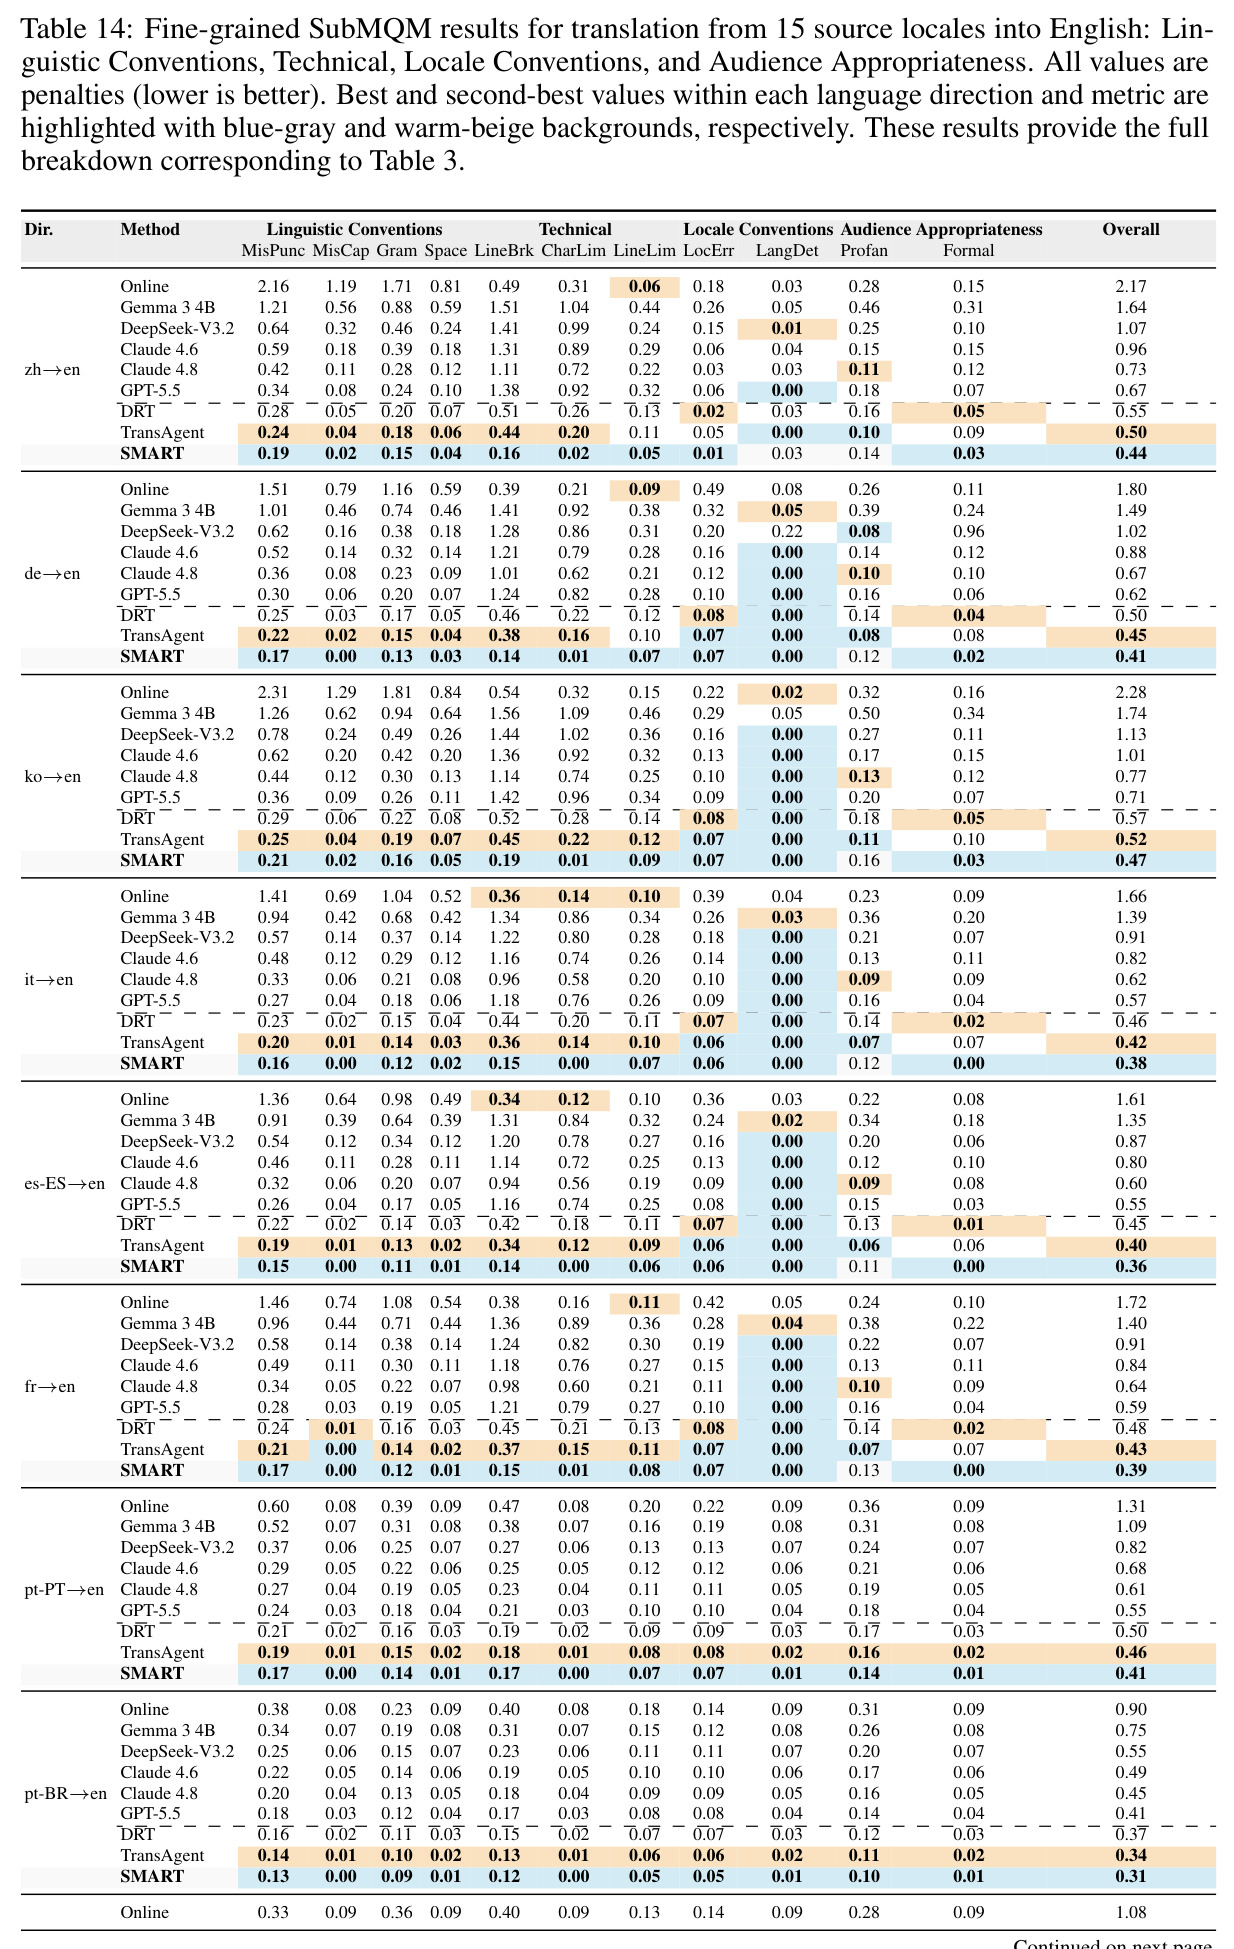
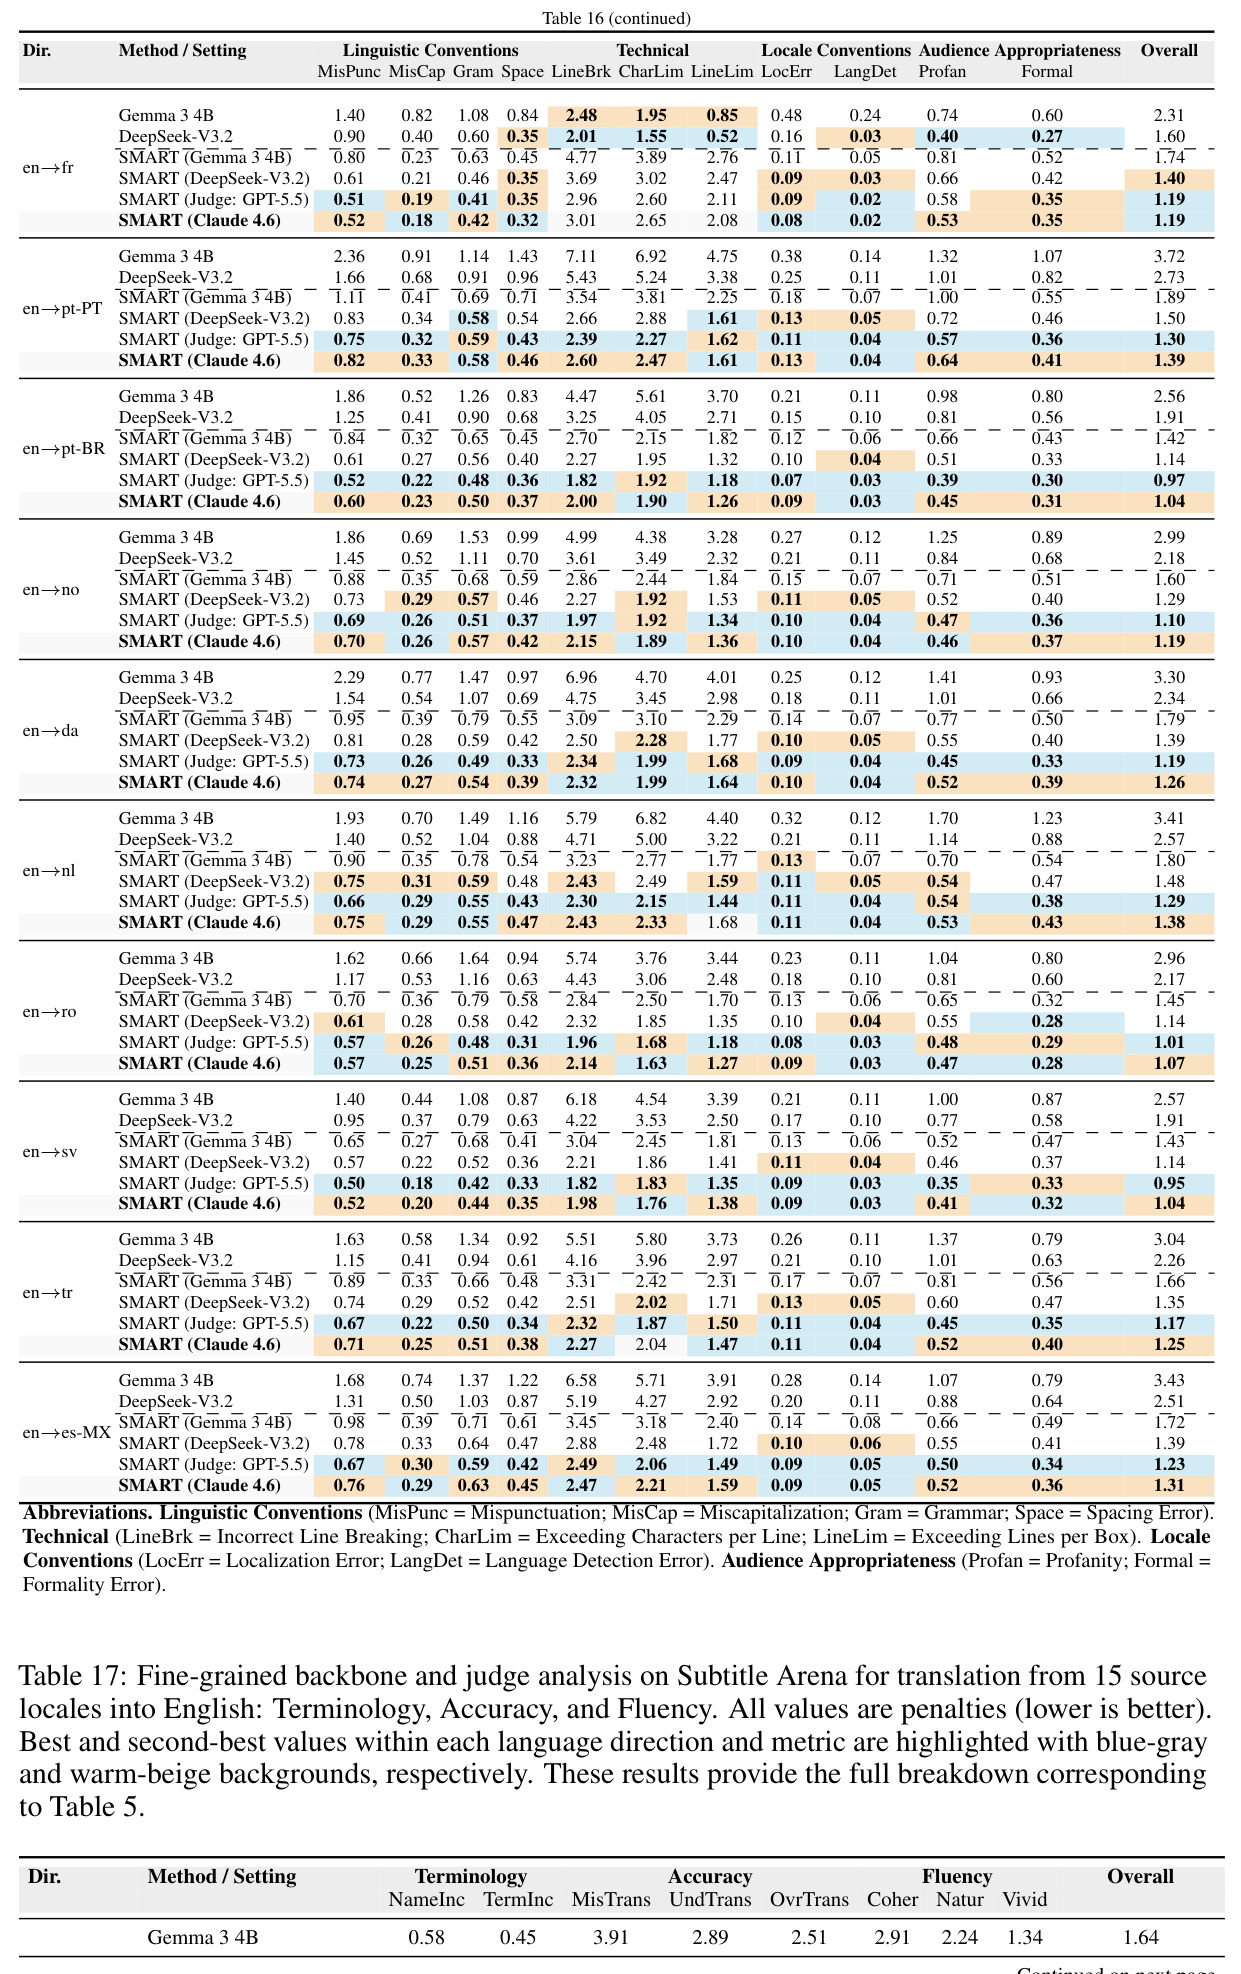
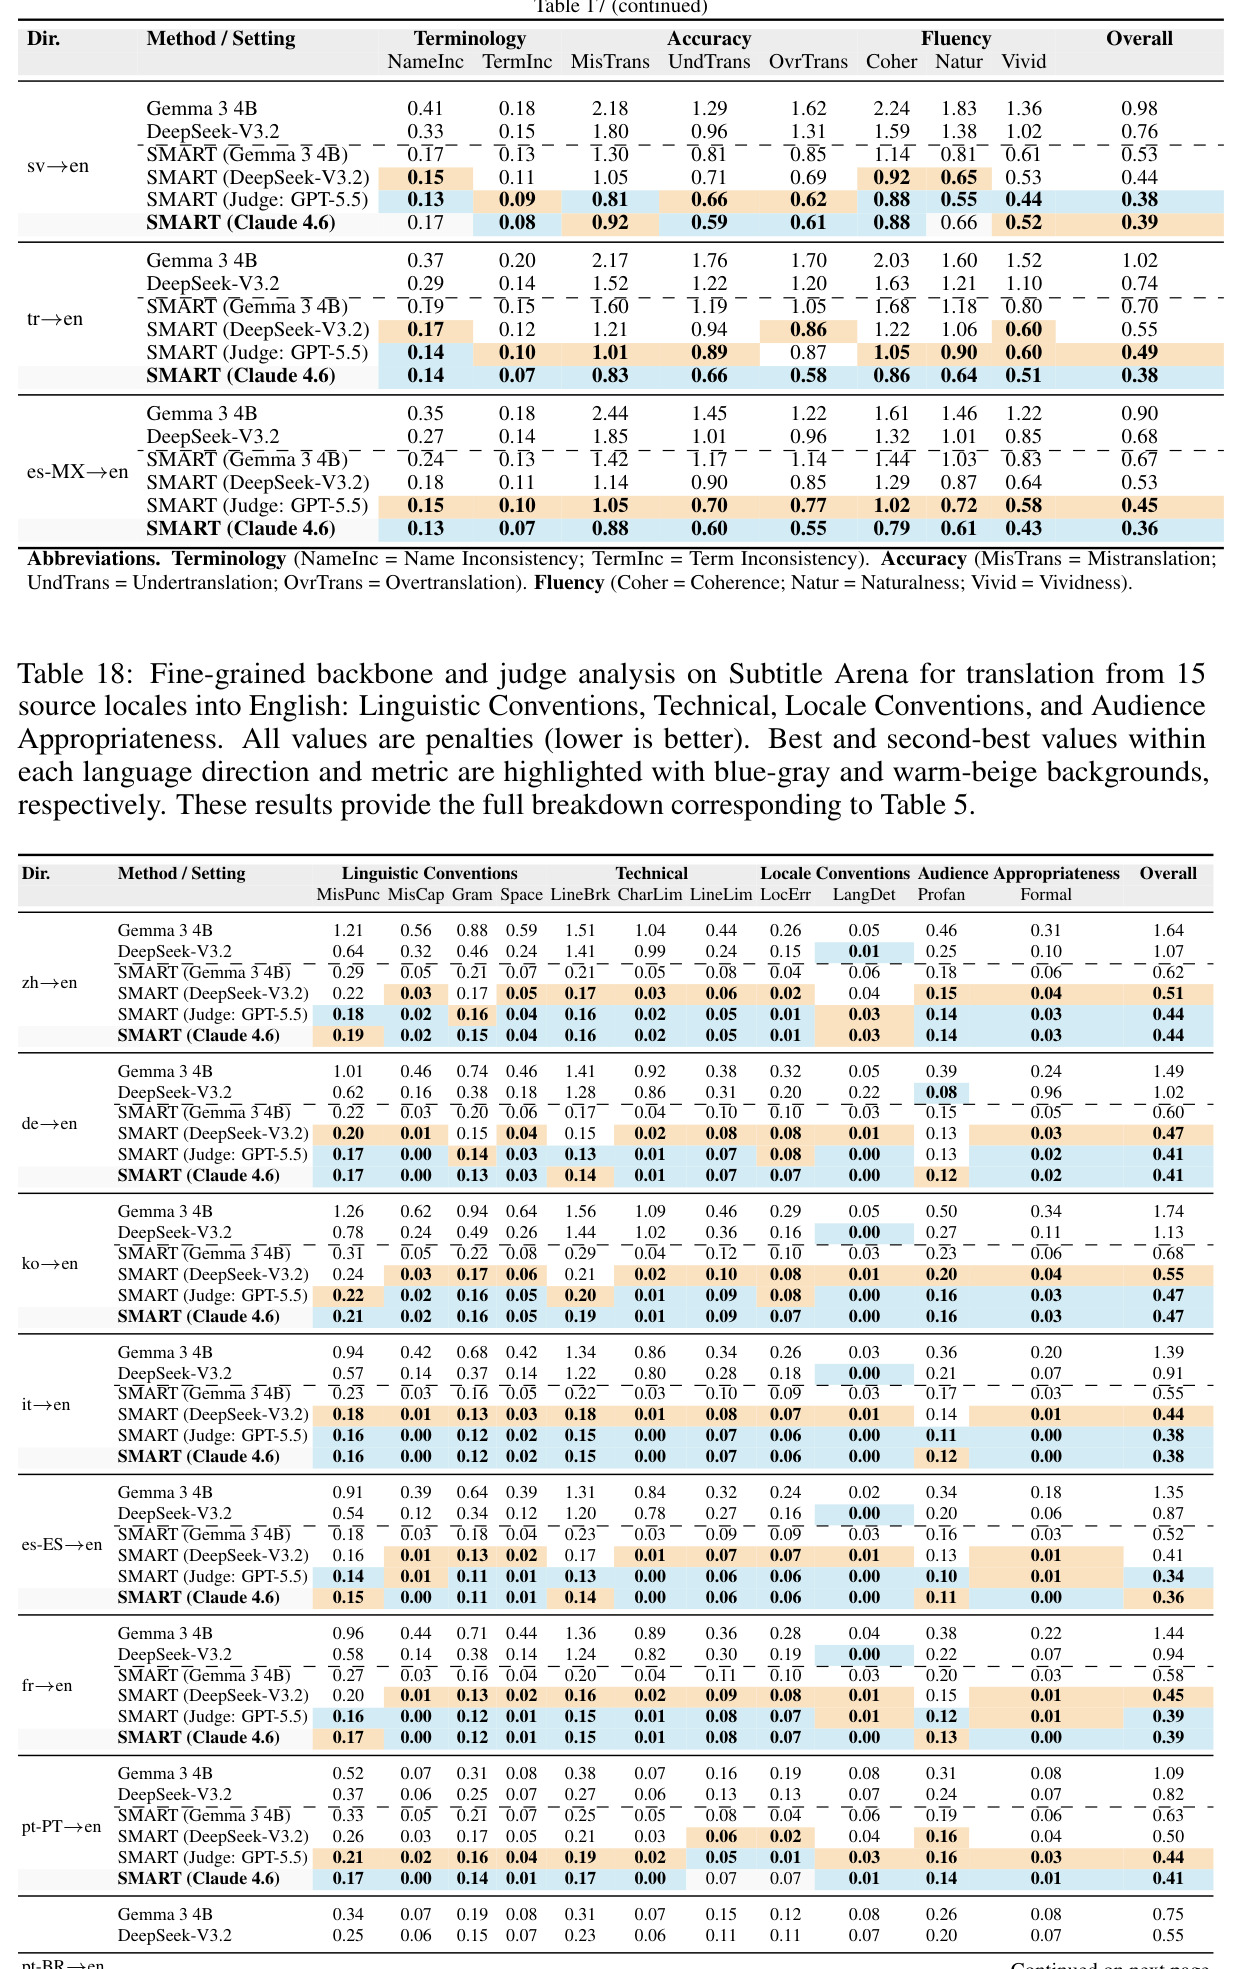
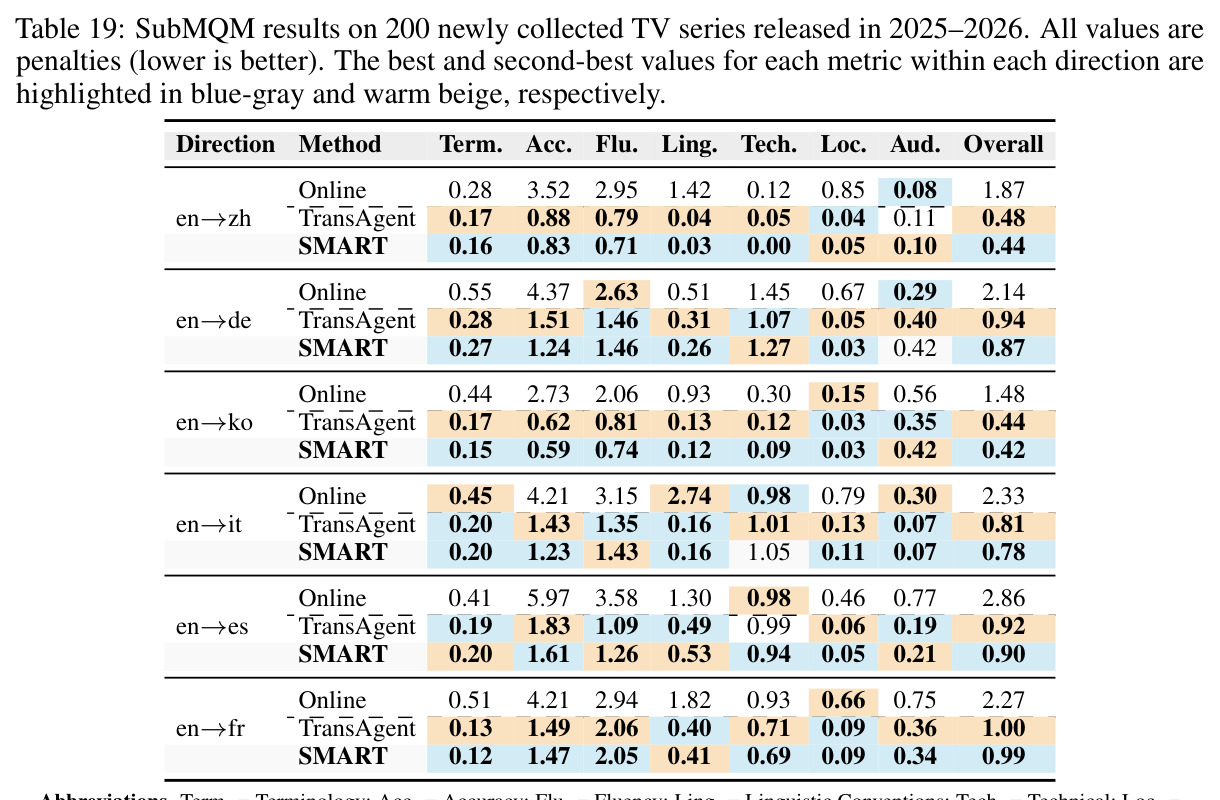
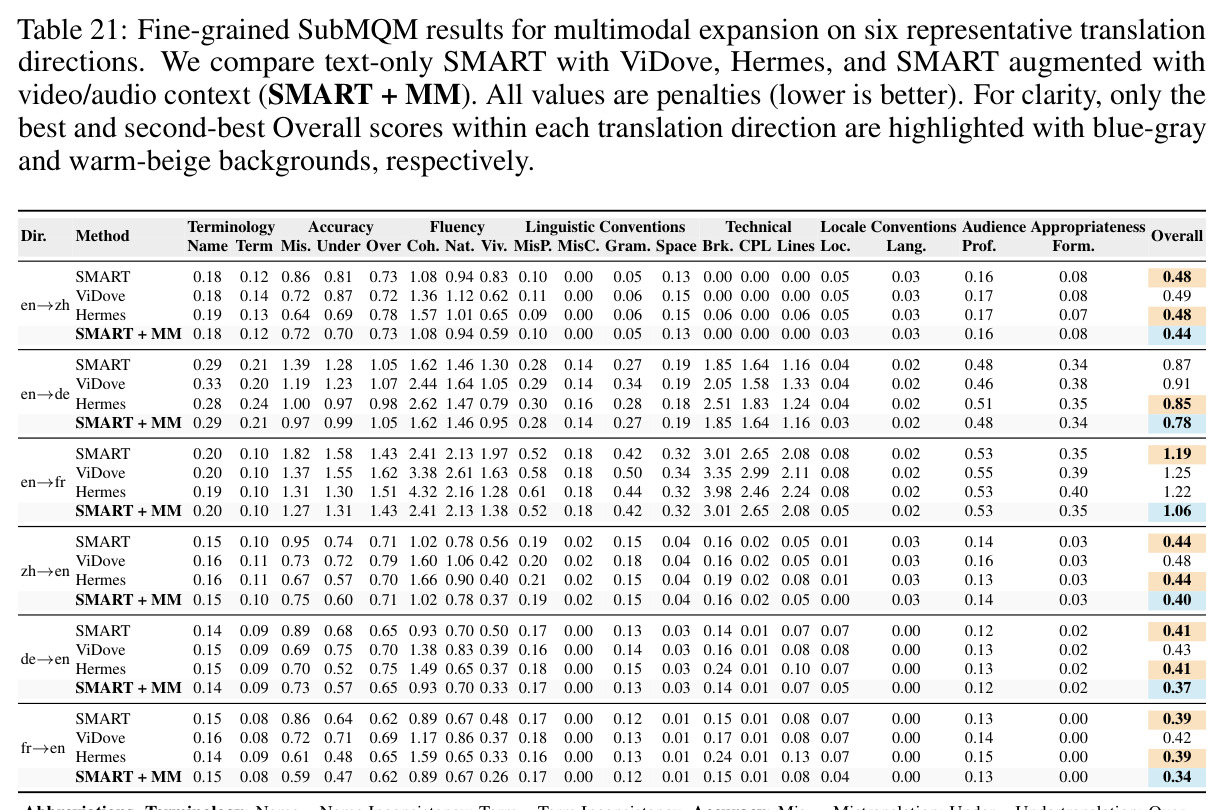
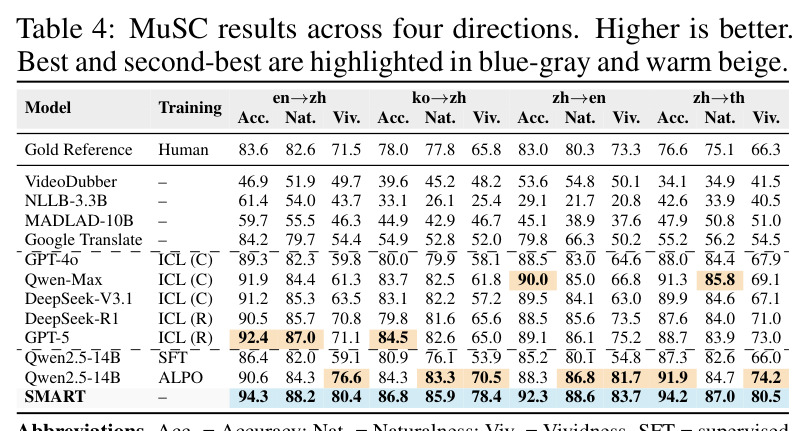
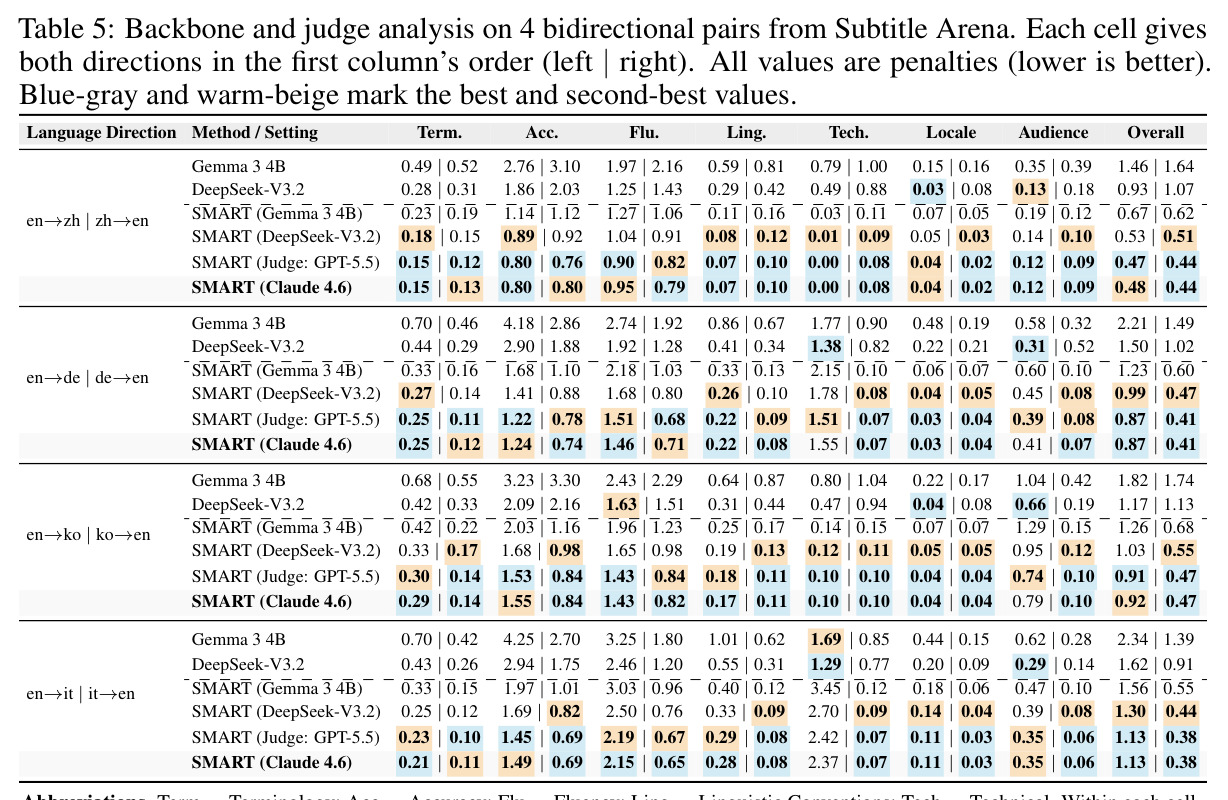
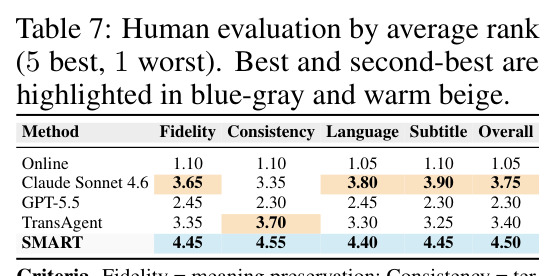
在自建的 Subtitle Arena 上,SMART 在全部15个 en→目标语语向取得最优 Overall SubMQM 罚分,平均从最强智能体基线 TransAgent 的1.20降至1.11(相对降低6.9%);反向15个语向→en 从0.41降至0.37(降低10.0%),同样全部第一。尽管骨干只是 Claude Sonnet 4.6,SMART 平均仍超过更强的单次调用模型 GPT-5.5(1.44)和 Claude Opus 4.8(1.55)。以代表性语向为例:en→zh Overall 0.48(TransAgent 0.52、GPT-5.5 0.66、Online 社区字幕 2.58),zh→en 0.44;相对 TransAgent,Accuracy 维度从1.83降至1.67、Technical 从1.83降至1.72,术语、流畅、语言规范、本地化、受众适宜性全面下降。公开基准 MuSC 上,SMART 在全部4个方向(en→zh、ko→zh、zh→en、zh→th)的 Accuracy/Naturalness/Vividness 均为最佳模型:比各列最强非 SMART 系统平均高约3.0分(1.2–7.9),Vividness 提升最大,分别+3.8/+7.9/+2.0/+6.3,例如 en→zh 准确率94.3、生动性80.4,超过 GPT-5(92.4/71.1)和微调后的 ALPO(90.6/76.6)。人工盲评(20名标注者、13部剧267行)中 SMART 四项标准全部第一,Overall 排名4.50/5(一致性最高4.55),远超 TransAgent 3.40 和 GPT-5.5 2.30。消融(6方向平均罚分增量):去记忆 +0.78 影响最大,去 MoA +0.61,去语境检索与习语库 +0.56,去滑窗一致性 +0.47,合并提示 +0.41,去自进化 +0.36,去动态路由 +0.27——长程上下文与多假设融合是关键。鲁棒性:换 Gemma 3 4B 或 DeepSeek-V3.2 当骨干,en→zh 罚分仍从1.46/0.93 降到0.67/0.53;把 judge 换成 GPT-5.5 结果几乎不变(0.48 vs 0.47)。扩展实验:接入 Qwen3-Omni 视听工具的多模态版把6方向平均罚分从0.63降到0.57,超过 ViDove 和 Hermes;在200部2025–2026年新剧(超出 Claude 4.6 知识截止)上6个方向全胜 TransAgent,说明增益可时间外推。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Subtitle Arena 英语→15个目标语向字幕翻译 | SubMQM Overall 平均罚分(越低越好) | 1.11 | TransAgent 1.20(次优);GPT-5.5 1.44;Claude Opus 4.8 1.55 | 相对最强基线降低6.9%,且15个语向全部第一 |
| Subtitle Arena 15个源语向→英语 | SubMQM Overall 平均罚分 | 0.37 | TransAgent 0.41 | 相对降低10.0%,15个语向全部第一 |
| Subtitle Arena en→zh / zh→en | SubMQM Overall 罚分 | 0.48 / 0.44 | TransAgent 0.52 / 0.50;GPT-5.5 0.66 / 0.67 | en→zh 较 GPT-5.5 降低27% |
| MuSC en→zh | Vividness(LLM评分,越高越好) | 80.4 | ALPO(微调Qwen2.5-14B)76.6;GPT-5 71.1 | +3.8(该方向 Accuracy 94.3 也是全场最佳) |
| MuSC ko→zh | Vividness | 78.4 | ALPO 70.5;DeepSeek-R1 65.6 | +7.9(四个方向中最大提升) |
| 人工盲评(20标注者×267行×13部剧) | 平均排名(5最好,1最差) | 4.50 | TransAgent 3.40;GPT-5.5 2.30;Online 1.05 | +1.10,四项标准(忠实/一致性/语言/字幕质量)全部第一 |
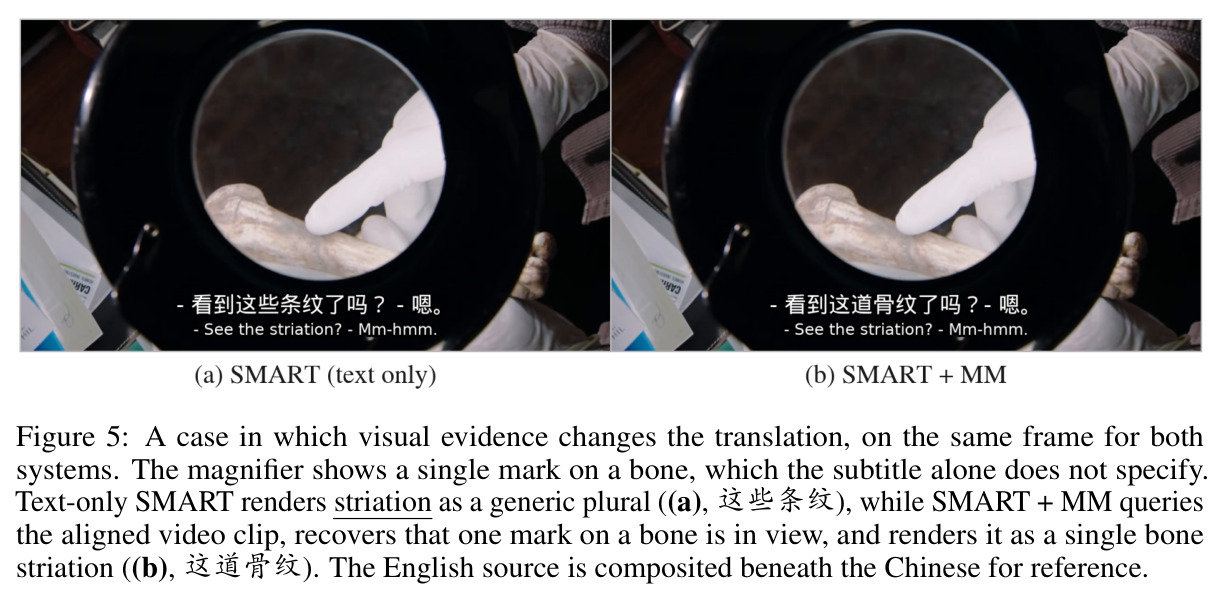
| 多模态扩展(6个代表语向) | SubMQM Overall 平均罚分 | 0.57(SMART+MM,Qwen3-Omni工具) | SMART 文本版 0.63;ViDove、Hermes 更差 | 较自身文本版降低约9.5% |
局限与改进
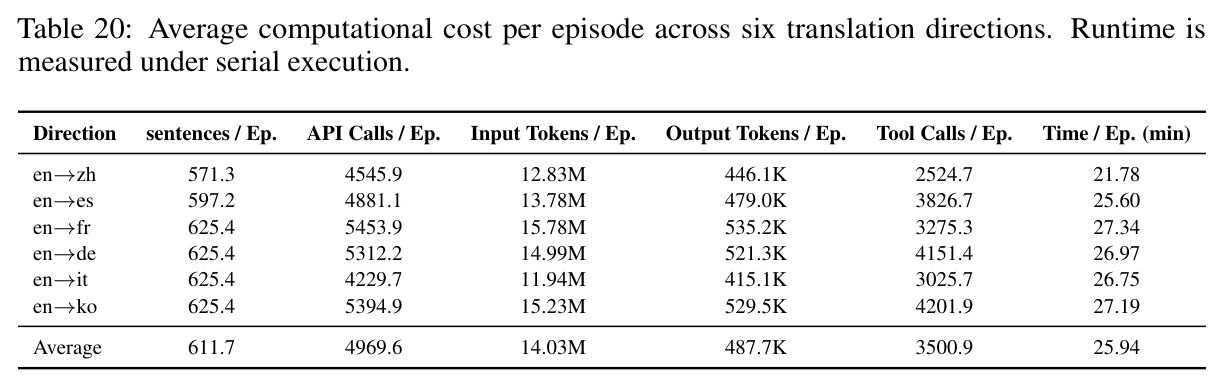
作者承认的局限:人工评估规模有限(仅20段、267行、20名标注者)且标准较粗,只能作观众视角验证;Online 社区字幕质量参差,不能当作受控的人工上界;计算开销大——平均每集611.7句需要约4,970次模型调用、1,403万输入token、3,501次工具调用,串行执行约25.9分钟/集(22–27分钟区间),作者明言 SMART 只适合质量优先而非延迟敏感的场景。我自己的观察:其一,SubMQM 由 LLM judge 打分且与系统生成共享同族模型(Claude 系),虽有换 judge 的鲁棒性检查,但仍不能排除模型家族自偏好;其二,路由类别是固定集合,$\mathcal{F}_\rho$ 只能在表内重排,进化上限受限于人工预设的类别划分;其三,$\mathcal{F}_\Pi$/$\mathcal{F}_\rho$ 的提案被直接采纳、没有验证集门控,存在退化风险(论文以'约束空间有限'辩护);其四,70%推理集仍属同一部剧,跨剧泛化仅由200部新剧的6个方向部分验证;其五,en→de 的 Technical 维度 SMART 反而劣于部分基线(1.55 vs TransAgent 1.31),en→ko 的 Audience 维度也略逊,说明德语等语言的长度约束处理仍有短板。
独立分析的弱点
弱点一:推理成本过高。每集约5,000次API调用、26分钟串行、14M输入token, translating 一部100集的剧要花费数千美元级API费用和40多小时串行时间。改进方向:句间批量流水线化、相似句缓存、用小模型做路由前置过滤只把疑难句送入完整 MoA 流程(消融显示简单句本不需要额外译员),或蒸馏进化后的提示词到单模型。弱点二:judge 单点0–10打分噪声未量化。候选选择、rescue 触发、路由更新全部依赖同一个 judge,若其打分方差大,整条进化链路都会被误导。改进方向:多 judge 集成、打分校准(如成对比较转绝对分)、或用少量人工标注校验 judge 与专业字幕审稿员的一致性。弱点三:记忆增长无淘汰机制。术语有冲突检测,但人物池、领域知识随剧集数(最多198集)线性膨胀,可能引入过时或被剧情推翻的条目。改进方向:给记忆条目加置信度、出现次数加权和剧情时间衰减。弱点四:3:7划分假设剧内分布平稳,若前30%集中了风格突变(如新角色、新场景),进化出的配置会系统性偏移。改进方向:按场景分层采样训练前缀,或允许推理期极低频率的受控更新。弱点五:评测与生成同源风险,SubMQM rubric 权重(Accuracy 0.30、Terminology/Fluency 各0.20等)为人工设定,且 rubric 与系统内部 judge 的评审维度高度同构,存在'为指标优化'的隐患,需要第三方独立评测(如专业字幕公司盲审)来交叉验证。
未来方向
作者方向:多模态深化——已用 Qwen3-Omni 接入视频/音频证据使6方向罚分从0.63降到0.57,未来可让视觉信息参与更多决策(如 on-screen text、说话人识别辅助指代消解);时间泛化——在2025–2026年新剧上的验证可扩展为持续评测协议,检验系统对超出模型知识截止内容的鲁棒性。基于成果可延伸的方向:其一,跨剧迁移的'经验库'——目前每部剧独立进化3个epoch,不同剧积累的提示词改写和路由规则可汇聚成可复用的翻译经验,实现 few-shot 级冷启动;其二,文本梯度与参数微调的混合——用进化后的提示词-行为对作为数据蒸馏进小模型,兼顾质量与成本;其三,流式与配音场景——把时间码约束从'事后校验'升级为解码期硬约束求解,衔接 dubbing 的口型/时长对齐;其四,低资源语言与方言——Subtitle Arena 的15个语言对仍以高资源为主;其五,评测科学——用专业字幕从业者标注校准 SubMQM 与人工 MQM 的相关性,并探索对 judge 模型家族去偏的评测协议。
复现评估
协议层面复现性很好:算法1给出完整的自进化伪代码,$\mathcal{F}_\Pi$/$\mathcal{F}_\rho$ 的约束(保留角色骨架、每类至少2译员、固定类别集)、3个epoch、3:7划分、rescue阈值 $\theta=8.0$、一致性窗口5/10/20@50%重叠等超参全部明示;8个工具的接口和执行方式在 Table 8 逐一说明;SubMQM 完整19类 rubric 与权重(Accuracy 0.30、Terminology 0.20、Fluency 0.20、Linguistic 0.12、Audience 0.08、Technical 0.06、Locale 0.04)在附录E公开;Subtitle Arena 的构建流程(OpenSubtitles2024 + IMDb 标识符/季/集索引对齐、清洗规则)在附录D详述。但需注意:论文正文与附录均未给出代码或数据的开源仓库链接,基准需自行从 OpenSubtitles 重建(70,664个双语集对的清洗对齐工作量大);默认配置依赖 Claude Sonnet 4.6,按 Table 20 的成本(每集约4,970次调用、14.03M输入token、26分钟)复现全部15个语向×192部剧的实验,API 费用预计在数万美元量级。综合评估:思路与小规模验证(单语向、单剧、弱骨干)中等难度可复现,全量结果复现难度高,主要门槛是算力预算与缺失的官方 artifact。
论文图表