AIM:面向自动化科研的智能体式研究想法管理框架 AIM: Agentic Idea Management for Automated Research
用智能体化贝叶斯优化管理研究想法,AutoLab 十任务全面领先且最高提速 3.1 倍
前置知识
贝叶斯优化(Bayesian Optimization)
一种针对评估代价高昂的黑盒函数的优化方法:用代理模型拟合已观测的(输入,输出)对,再由采集函数决定下一个采样点,在“利用已知高分区域”和“探索未知区域”之间自动权衡。典型流程是每轮更新代理、最大化采集函数、评估新点、循环直到预算耗尽。
AIM 的整体架构就是对这个结构的类比移植:Agentic Surrogate 对应代理模型(组织和评估想法的“价值”),Agentic Acquisition 对应采集函数(决定下一个要实验的想法)。理解这个对应关系,才能明白各模块为什么这样分工、以及它与 MCTS/进化等固定搜索结构的本质差异。
LLM 智能体(Agent)与多阶段分工
以大语言模型为控制器的系统,能调用工具、生成并执行代码、读取执行反馈,并自主决定下一步动作。复杂任务常拆成多个角色(提出者、实现者、审查者),各自用不同 prompt 驱动,形成流水线。
本文的自动化科研系统完全由 LLM 智能体模块组成:Ideator 生成想法、Solver 写代码、Auditor 审计结果、Planner 分配预算。论文中每个“算子”($\phi_{org}$、$\phi_{est}$、$\phi_{disp}$ 等)背后都是具体的 LLM 调用,附录还给出了全部 prompt 模板。
探索-利用权衡(Explore–Exploit Trade-off)
在有限预算下,是把资源投入到已知表现好的方向(利用),还是尝试尚未验证、可能上限更高的方向(探索)。纯利用容易陷入局部最优,纯探索浪费预算在平庸方向上。
AIM 的 Dispatch 算子在“簇级”和“想法级”两个层次上显式地为每个并行分支选择 explore 或 exploit 动作,这是它区别于“直接让 LLM 挑想法”的关键设计。论文的定性案例显示:exploit 的选择回落到 0.119,而 explore 的选择追平了最佳分 0.377,说明两级动作缺一不可。
语义覆盖(Semantic Coverage)与凸包面积
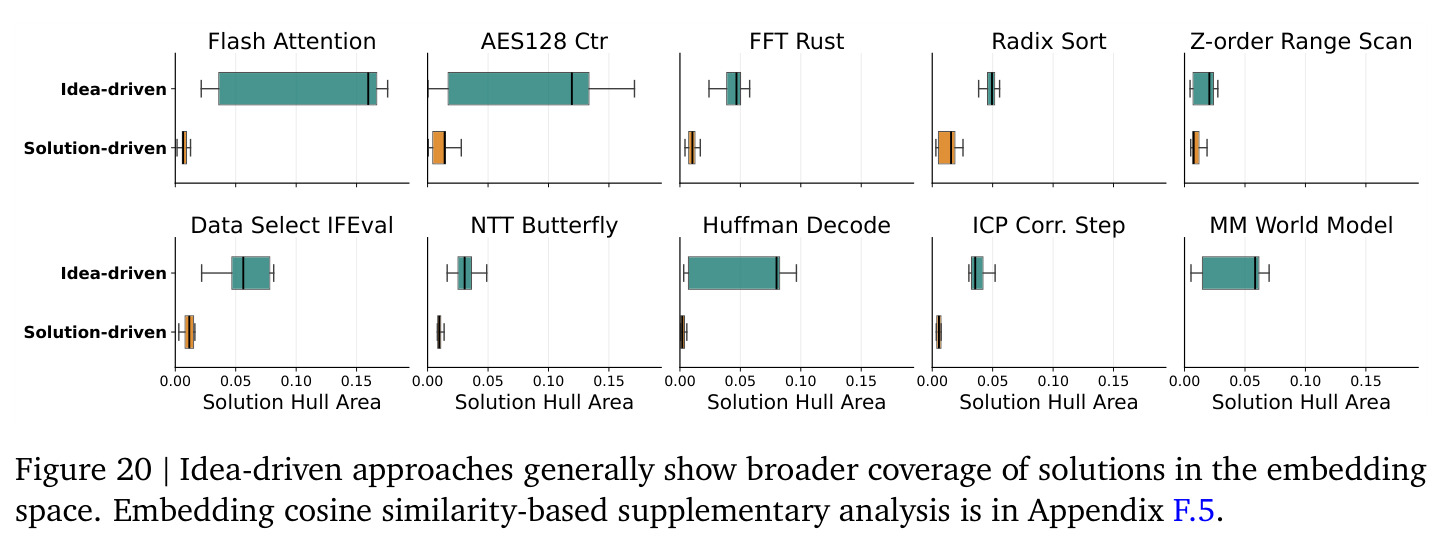
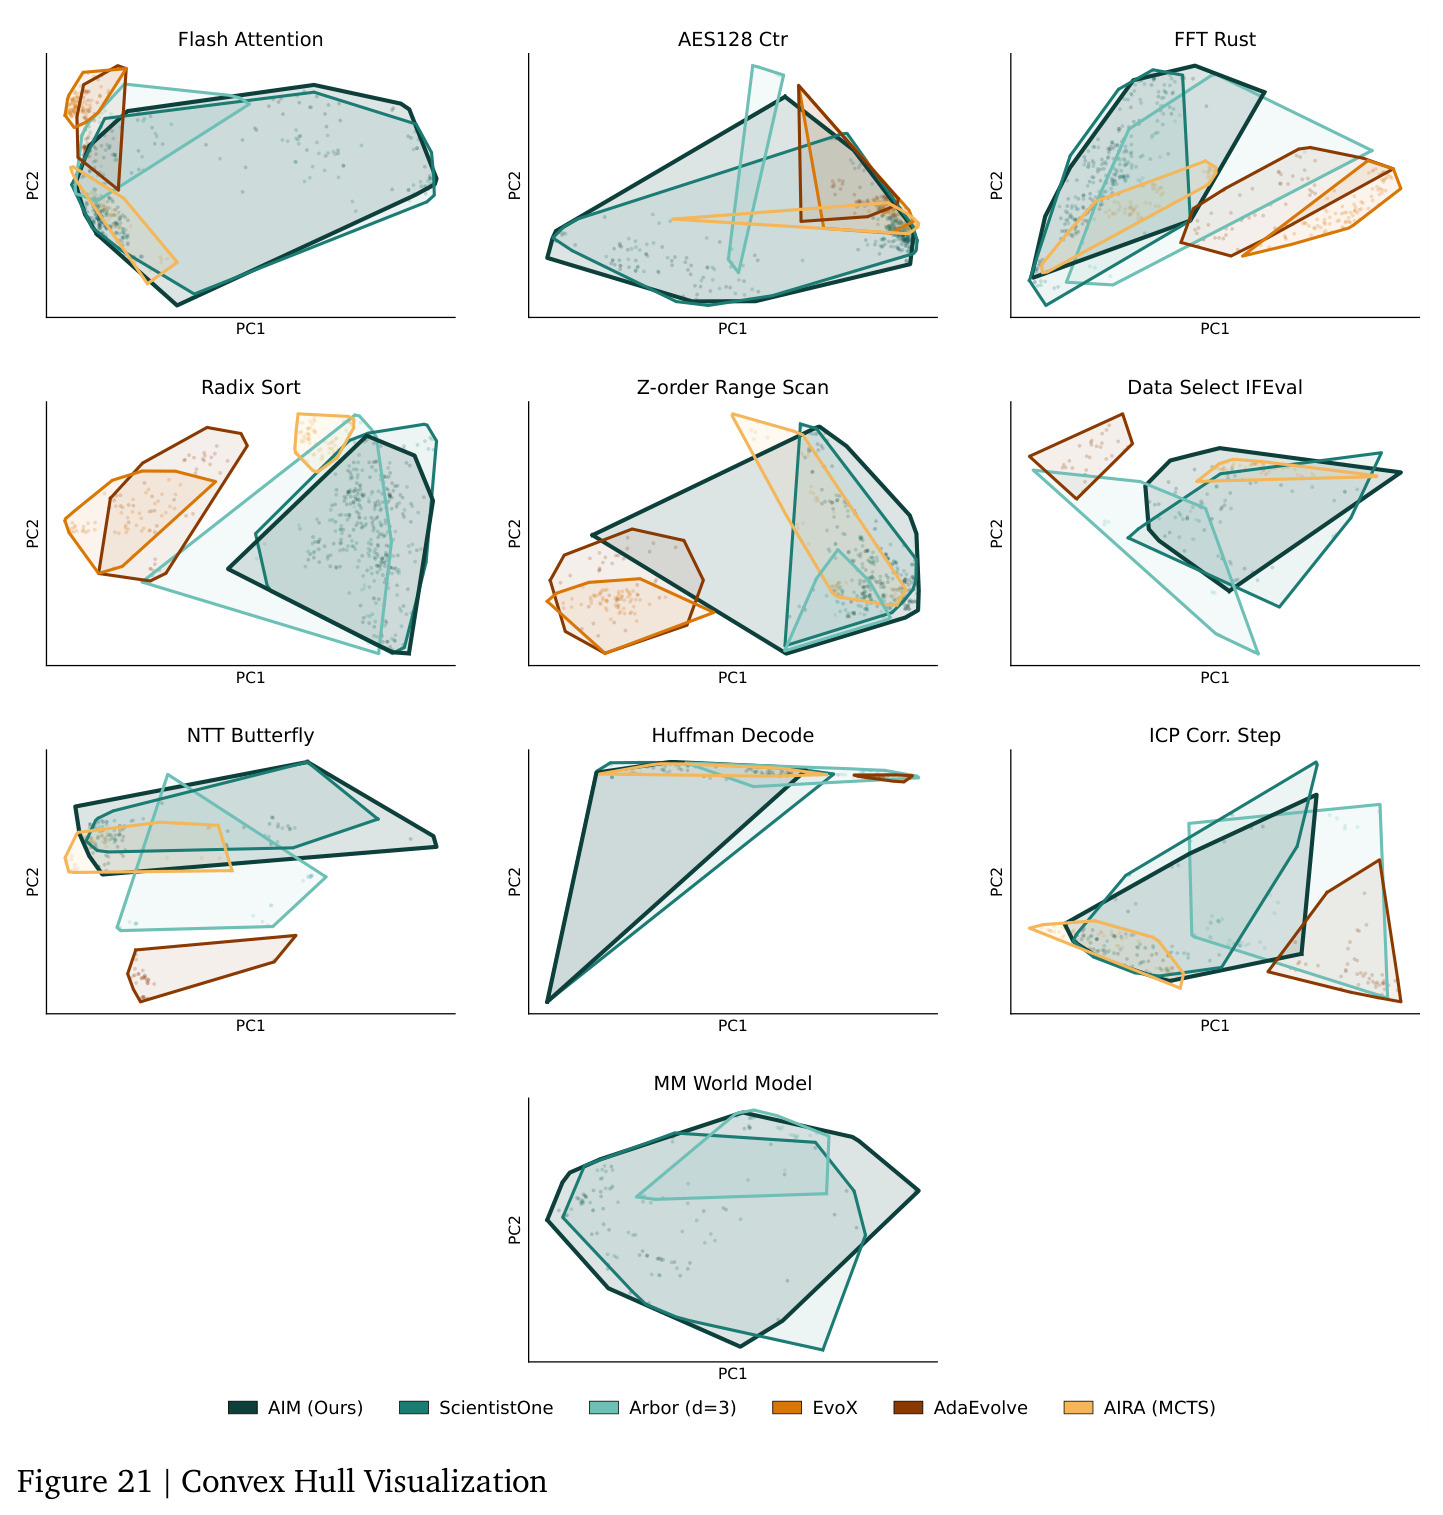
论文定义映射 $\pi: \mathcal{Z} \to \mathcal{X}$ 把每个可执行解归到其背后的研究想法,语义覆盖 $C(E)=|\{\pi(z):z\in E\}|$ 表示已评估解集合覆盖了多少个不同研究方向。实证上用嵌入向量经 PCA 降维后的凸包面积作为探索广度的代理指标。
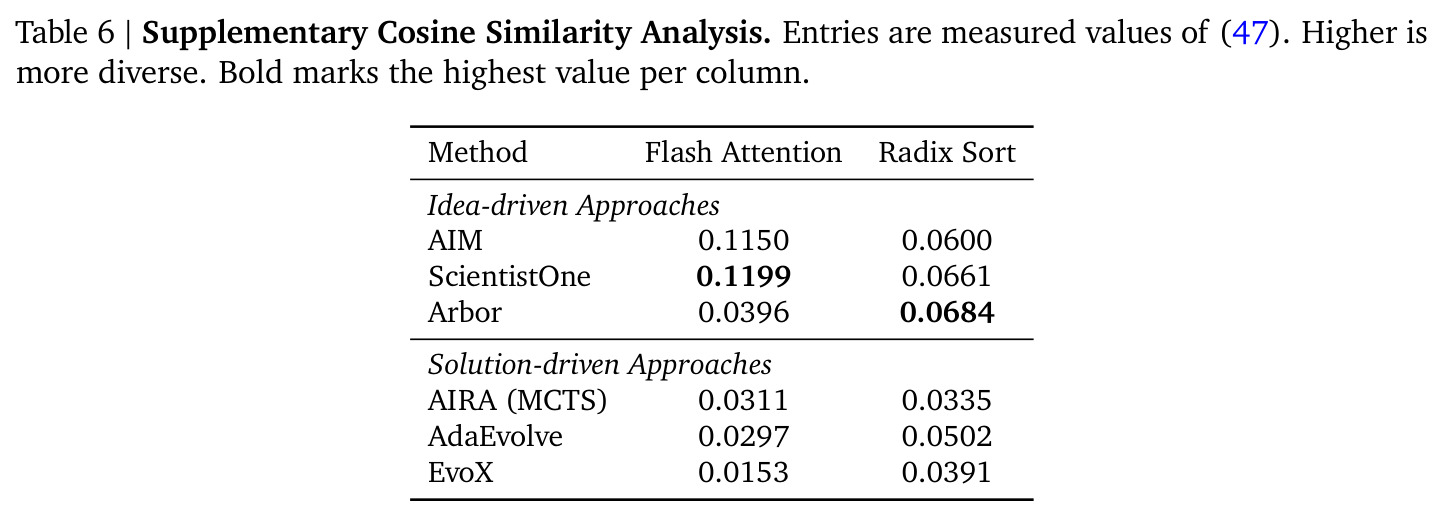
这是第 6 节理论分析的核心量:命题 1 说明想法级搜索能把语义广度变成直接可控的量,命题 2 给出找到 $\varepsilon$-最优方向所需覆盖的充分条件 $C \ge (K/G_\varepsilon)\ln(1/\delta)$。读懂它才能理解“什么时候该用 idea-driven 搜索”。
Verifier 与 Reward Hacking
Verifier 是给候选解打分的固定评测程序(如测代码运行时间、模型 PSNR)。Reward hacking 指智能体不真正解决问题,而是钻评分规则的空子骗取高分,例如缓存结果、绕过约束。无效或作弊的解必须被识别,否则会污染后续搜索决策。
AIM 的 Solution Auditor 专门负责检查 trivial、task_mismatch、idea_mismatch、reward_hacking 四类问题:作弊或跑题的结果直接丢弃(预算照扣),只有想法跑偏的结果会被“重建想法”后重新归因。这是保证搜索历史干净、经验教训可靠的关键机制。
研究动机
前沿 LLM 智能体正在被用于自动化科研:提出候选方案、写代码实现、跑实验、看 verifier 反馈、决定下一步。但实现和评估非常昂贵,一个 AutoLab 系统优化任务允许 300 次实验执行、6 小时墙钟时间,如何把这些预算花在最值得的方向上就是核心难题。现有工作分两派:solution-driven(AIDE、AlphaEvolve、AdaEvolve、AIRA 等)直接在可执行代码上搜索,反馈只作用于代码修改,导致“研究方向上的进展”和“单个代码工件的工程决策”被纠缠在一起;idea-driven(AI-Scientist-v2 用 MCTS、Arbor 用树、DeepScientist 用列表、ScientistOne 用 beam search)把研究想法作为显式搜索对象,但存在三大缺口:其一,想法池会不断膨胀,现有方法用固定脚手架组织,结构僵化且不可解释;其二,选哪些想法去做昂贵实验,现有方法依赖 UCB、MCTS 这类硬编码规则,或者干脆让 LLM 凭直觉挑、没有显式估计;其三,想法与实现分离后出现“完整性风险”——solver 写出的代码可能没有忠实实现所选想法,导致分数和经验教训被错误归因,甚至出现 reward hacking 污染整条搜索链路。
本文的目标是本文的目标是构建一个完全自主的研究想法管理框架 AIM,在固定的实验预算(执行次数与墙钟时间双重限制)内,最大化找到的最佳解性能。具体拆解为对应三大挑战的三个子目标:(1)把不断扩张的想法池组织成一个持久、可解释、随证据演化的语义结构;(2)基于显式的、有证据支撑的“前景估计”来选择要实现的想法,并自适应地在探索与利用之间分配并行分支;(3)在每个结果进入搜索历史之前审计其有效性和想法-实现一致性,保证后续决策建立在“实际被评估的机制”而非“最初设想的想法”上。检验标准是在 AutoLab 的 10 个任务(5 个系统优化、2 个模型开发、3 个 CUDA 内核)上与 solution-driven 和 idea-driven 两类最强基线比较平均分、收敛速度与 token 成本。
与已有工作不同的是,本文的独特切入角度有三个层面。概念层面,它首次把自动化科研方法按“搜索单元”划分为 solution-driven 与 idea-driven 两类,并把“想法管理”本身提炼为一个独立的设计问题,而不是附属于具体脚手架的实现细节。方法层面,它借鉴贝叶斯优化“代理模型 + 采集函数”的经典结构,但把两者彻底智能体化:代理不再是参数化回归模型,而是每轮从全池重建语义簇、并给出序数排名的 LLM 算子;采集不再是 UCB/MCTS 公式,而是 LLM 基于显式估计做的两级 explore/exploit 决策。系统层面,它额外引入了此前 idea-driven 系统普遍缺失的两个组件——Solution Auditor(通过“想法→实现→审计→校正想法”的闭环解决归因错位)和 Resource Planner(把并行度从固定值变成随搜索状态自适应的变量)。理论层面,它用语义覆盖的形式化分析回答了“什么时候想法级搜索才值得”,而不是无条件宣称想法驱动更好。
核心方法
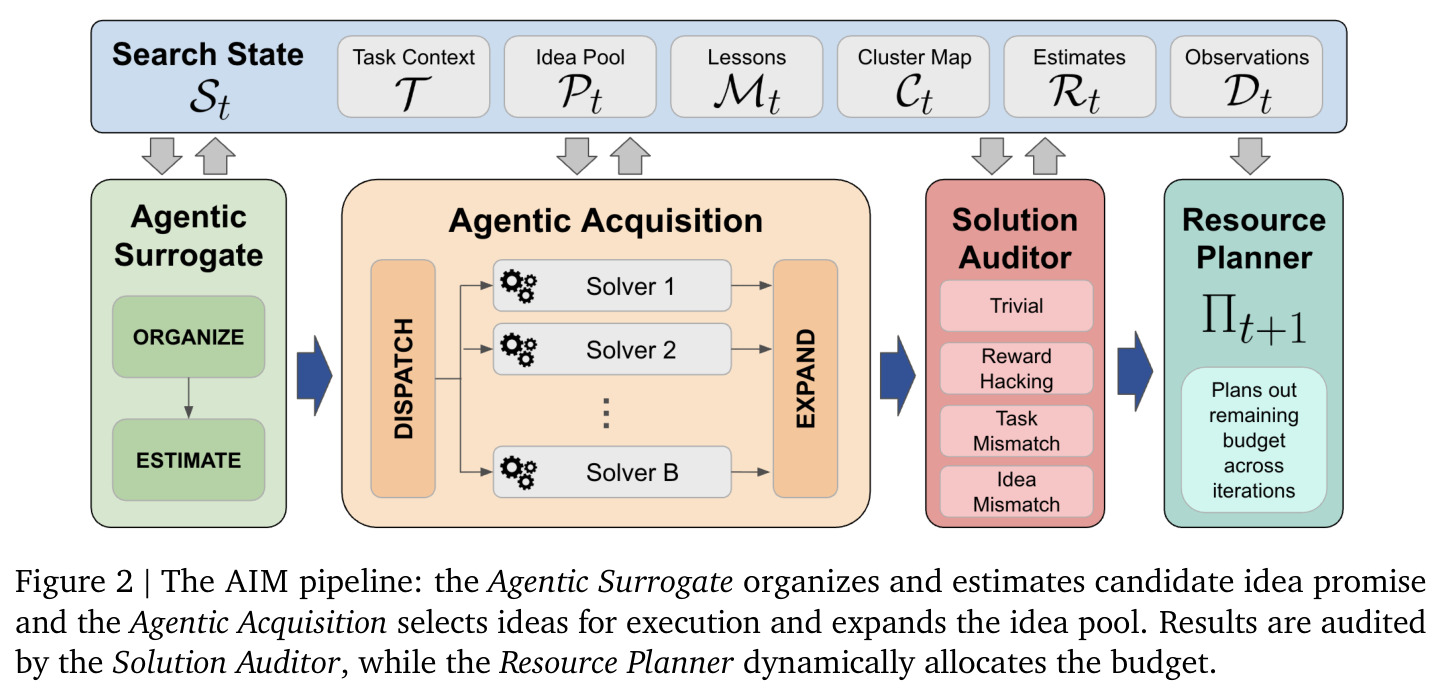
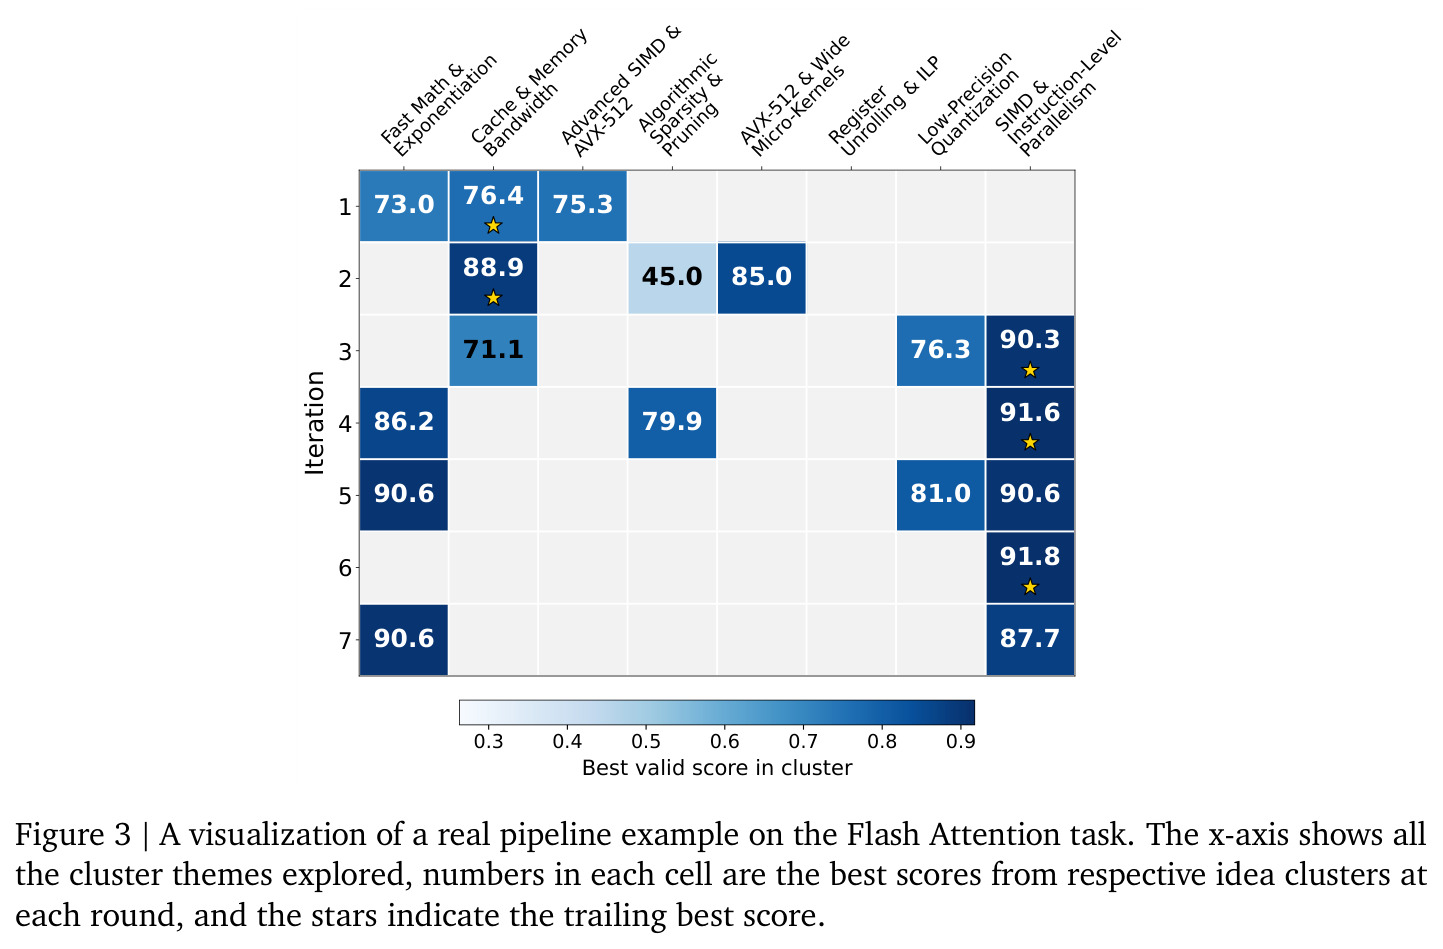
先说直觉:AIM 把“管理研究想法”这件事本身变成一个由 LLM 驱动、随实验证据不断演化的搜索控制器,相当于给自动化科研配了一个会自己整理思路、决定把算力投向哪里的“科研项目经理”。技术路线如下:对任务 $\tau$,AIM 维护搜索状态 $S_t=(\mathcal{T}, P_t, M_t, \mathcal{C}_t, R_t, D_t)$,分别是任务上下文(任务描述加初始 research brief)、当前想法池、已验证的实现教训记忆、想法的语义聚类组织、簇级与想法级的序数前景估计、以及历史想法-分数观测 $D_t$。每轮迭代依次执行:Agentic Surrogate 先做 Organize(把想法池聚成 2 到 5 个语义簇,已评估的分数作为解读未评估想法的锚点)再做 Estimate(对簇和簇内想法分别排序);Agentic Acquisition 的 Dispatch 按照簇级/想法级两级 explore-exploit 动作选出 $B_t$ 个想法,交给 $B_t$ 个并行 Solver(默认 ScientistOne 的 Gemini Deep Solver)分别实现并打分;Solution Auditor 审计每个结果的合法性与想法一致性;Expand 把教训写入记忆并按四种模式扩充想法池;Resource Planner 根据当前状态决定下一轮开多少个并行分支。当总分支数 $B_{tot}$ 或墙钟预算耗尽,返回历史最高分对应的解。
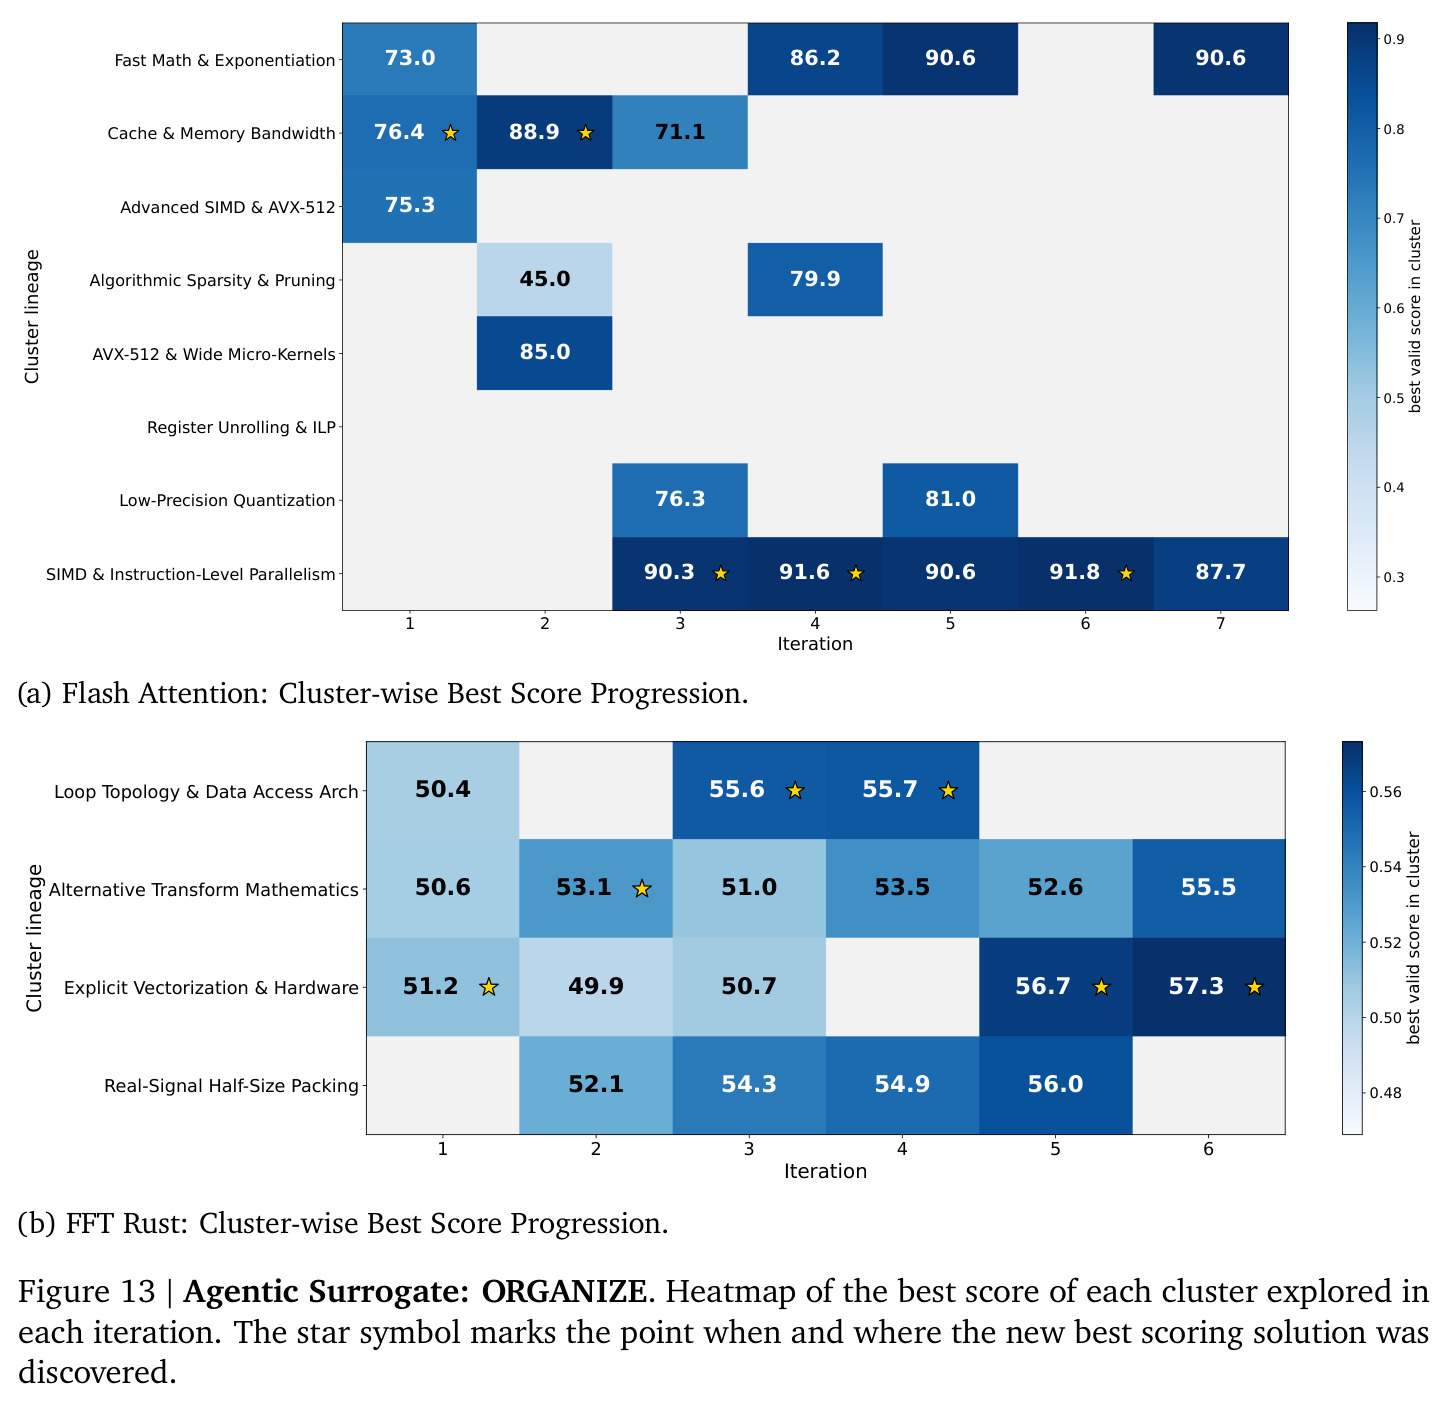
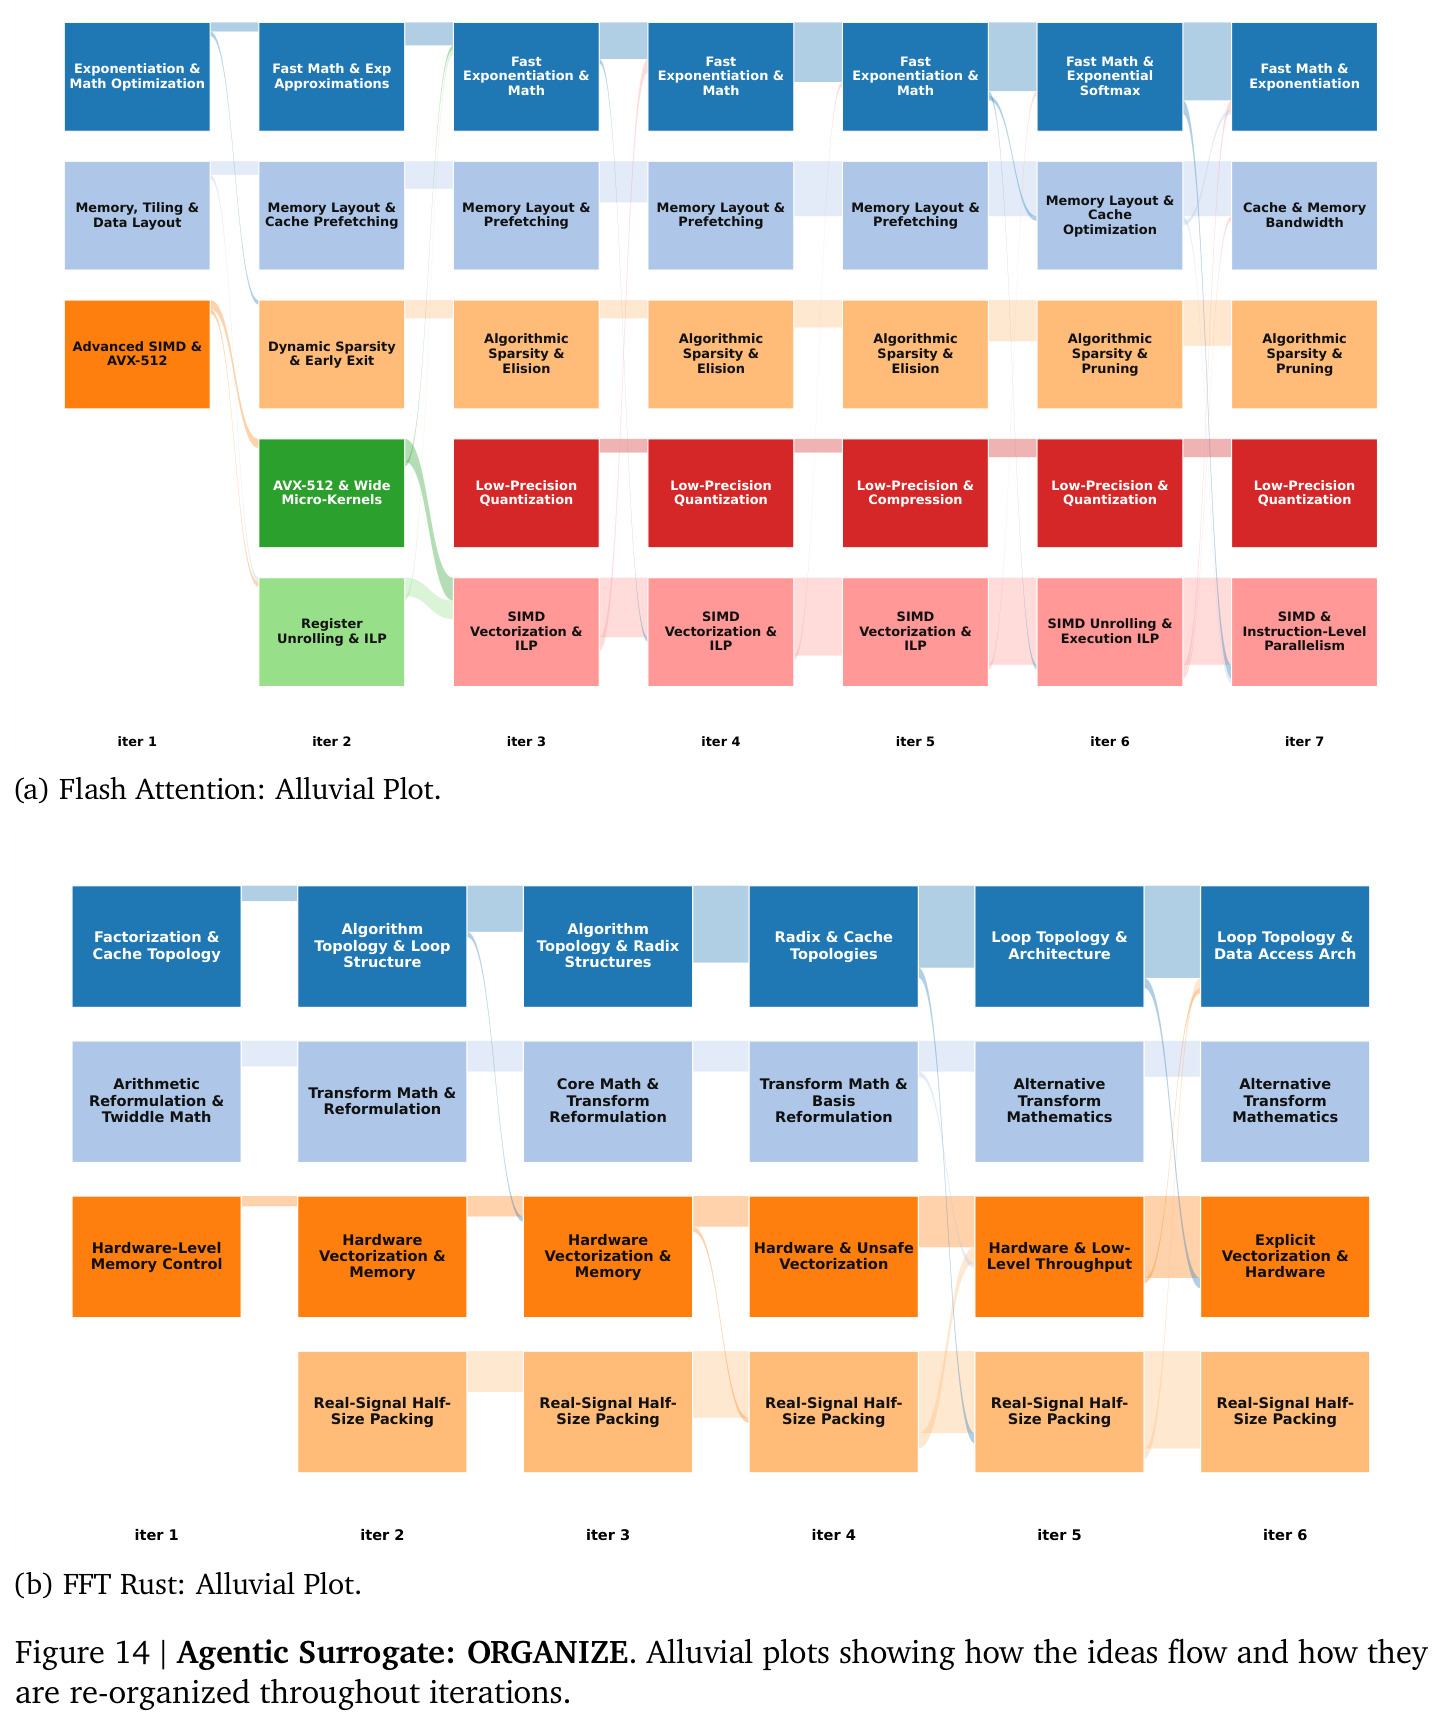
核心创新是把贝叶斯优化的 surrogate-acquisition 骨架 agentic 化并搬进自然语言想法空间,这与已有想法驱动系统的本质区别体现在四点。第一,组织结构是动态语义簇而非固定脚手架:聚类映射 $\mathcal{C}_t=\phi_{org}(\mathcal{T},P_t,D_t,\mathcal{C}_{t-1})$ 每轮从完整想法池重建,来自不同生成谱系的想法可以跨 lineage 重新分组,不像树/beam 那样把想法锁死在固定谱系里。第二,选择依据是显式的序数估计:$R_t=(R^{cluster}_t, R^{idea}_t)$ 只做相对排名、不要求校准的数值预测,这匹配了 LLM 擅长相对比较而拙于绝对打分的特点(消融中直接回归分数确实更差)。第三,新增 Solution Auditor 堵住想法-实现分离带来的归因漏洞,只标记 idea_mismatch 的结果会被“重建想法”后重新挂分,而不是简单丢弃。第四,Resource Planner 把并行度 $B_t$ 变成搜索状态的自适应函数,权衡“宽迭代多想法并行”与“窄迭代高频反馈”。这四个组件在 DeepScientist、AI-Scientist-v2、Arbor、ScientistOne 等系统中要么缺失、要么是硬编码规则。
方法步骤详情
完整流程如下。第 0 步初始化:用 ScientistOne 的 Ideator 生成约 10 个可行想法构成 $P_1$;给定执行预算 $N$、总分支数 $B_{tot}$、最大并行 $B_{max}$,每分支固定预算 $N_{branch}=\lfloor N/B_{tot}\rfloor$(如 $N=300$、$B_{tot}=25$ 时每分支 12 次执行)。第 1 步 Organize:输入任务、想法池、评分历史和上一轮聚类,输出 2–5 个语义簇,每个想法恰好归入一簇。第 2 步 Estimate:输入 $\mathcal{C}_t$ 和 $D_t$,输出簇级排名与簇内想法排名,综合考虑已观测性能、证据稀缺度、语义新颖性和实现教训。第 3 步 Dispatch:两次 LLM 调用,第一次给每个并行分支分配(簇级动作,想法级动作)$\in\{explore,exploit\}^2$ 的组合,第二次据此选定目标簇和具体想法,得到批次 $Q_t$。第 4 步 Solve:每个想法交给独立 Solver,产出可执行解 $z=g(x)$、验证分 $\tilde{y}=v(z)$ 和执行记录;被审计否决的执行同样消耗预算。第 5 步 Audit:输出标志集 $F\subseteq\{trivial, task\_mismatch, idea\_mismatch, reward\_hacking\}$;除 idea_mismatch 外的问题一律丢弃且不入历史;仅 idea_mismatch 时重建输入想法,把分数和教训挂到修正后的想法上。第 6 步 Expand:先把可复用教训 $\Delta M_{t+1}$ 并入记忆 $M_{t+1}$,再按 score-guided refinement(保留高分想法的已验证组件并攻其瓶颈)、cross-pollination(跨簇杂交互补想法)、error-guided repair(按 verifier 反馈修错)、new_idea(引入全新方向)四种模式生成新想法,每分支至多 3 个。第 7 步 Resource Planner:$B_1=5$,之后 $3\le B_t\le 10$ 且 $\sum_t B_t=B_{tot}$,决定何时耗尽预算并终止;最终返回 $D_t$ 中最高分的解。
技术新颖性
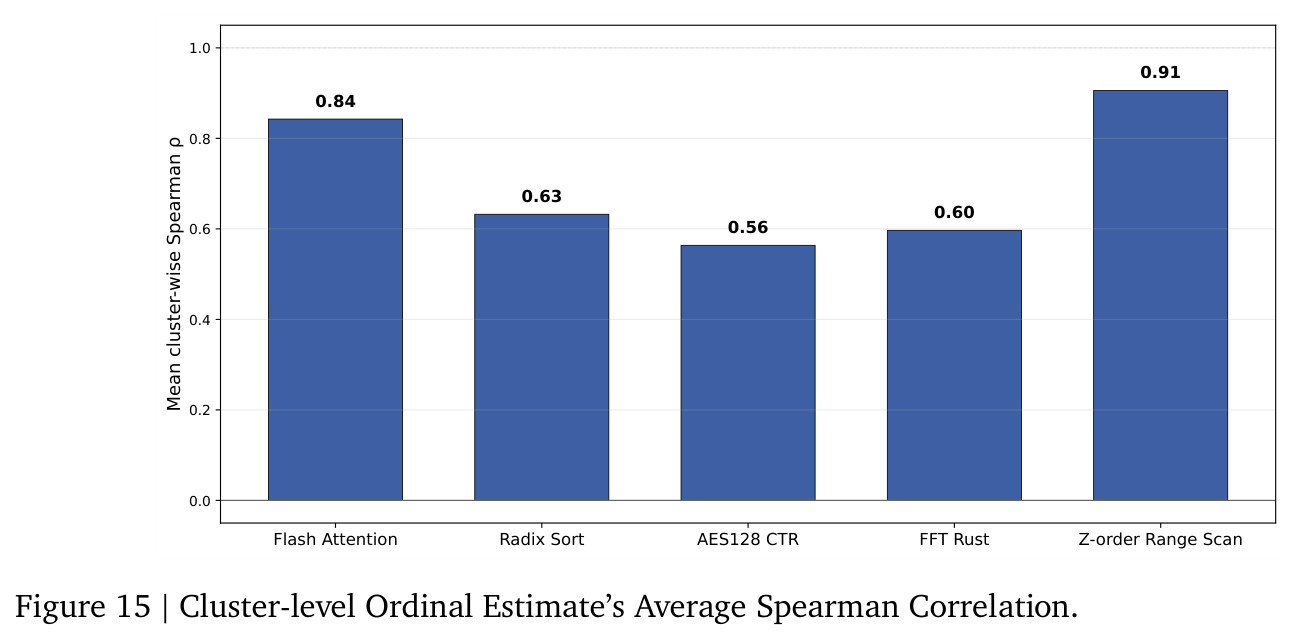
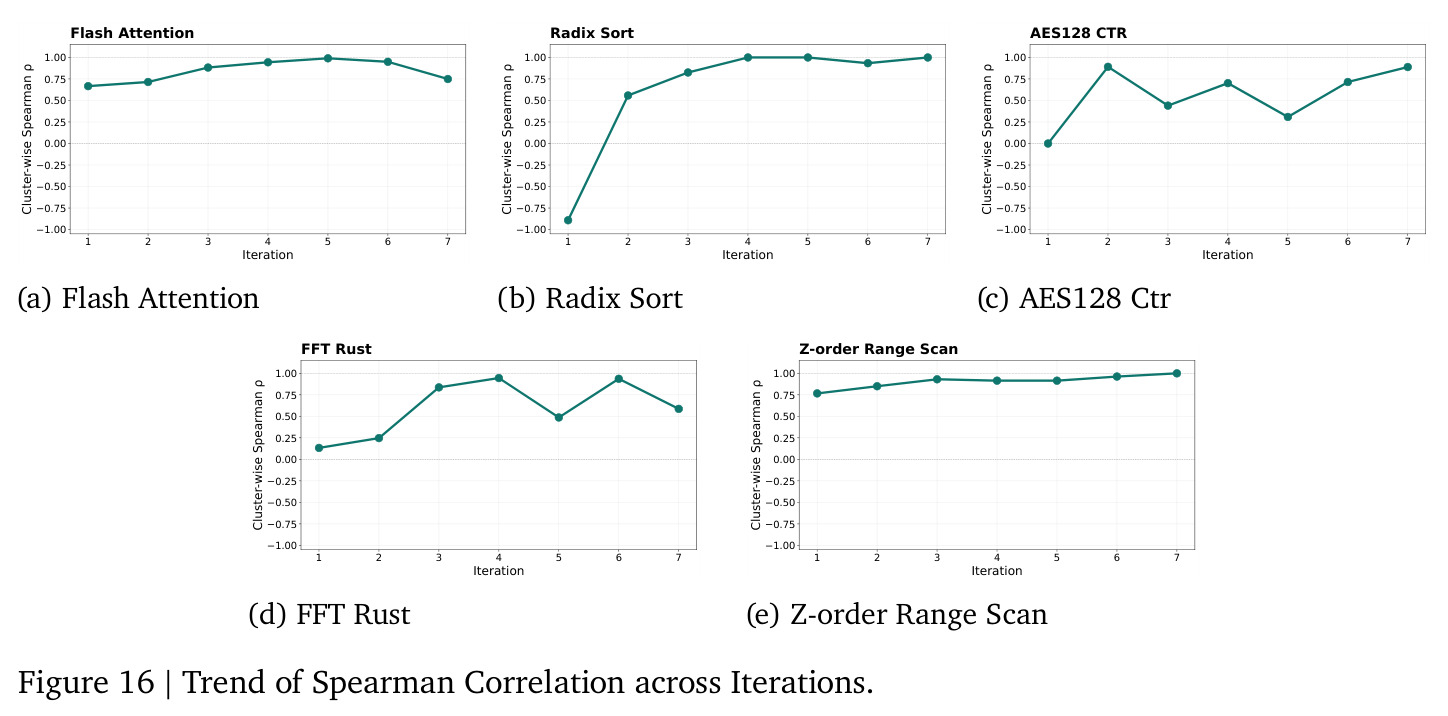
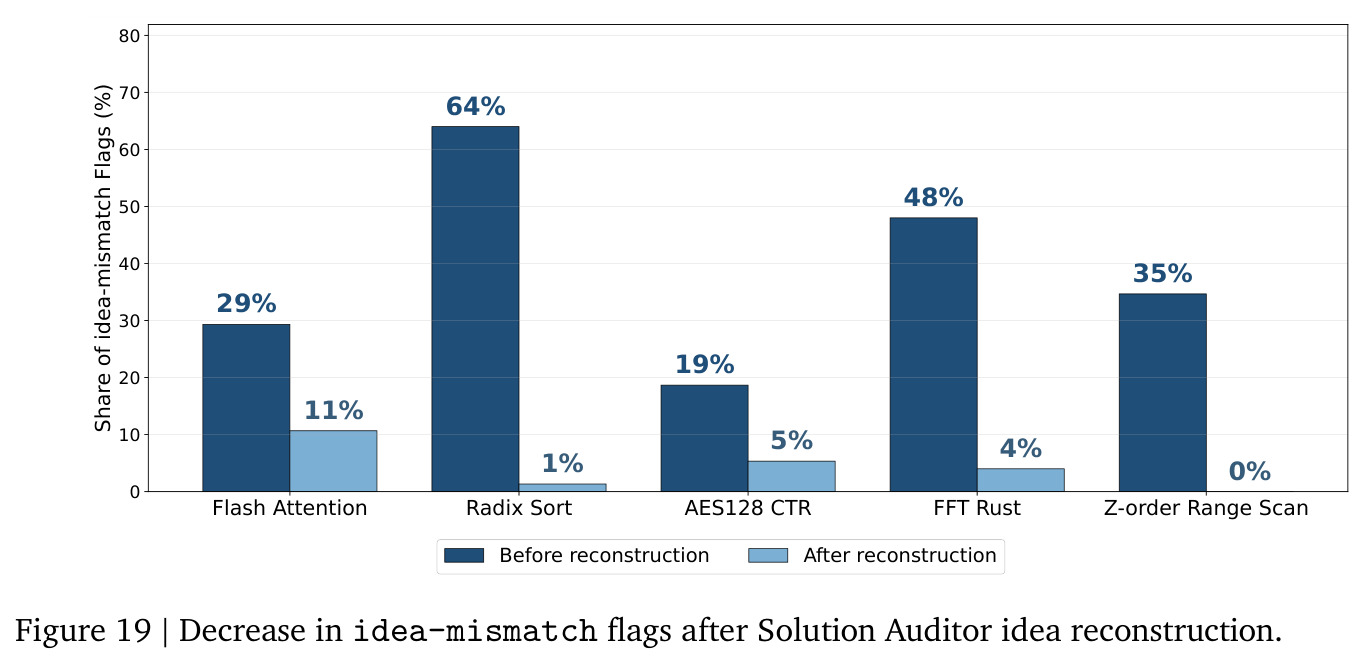
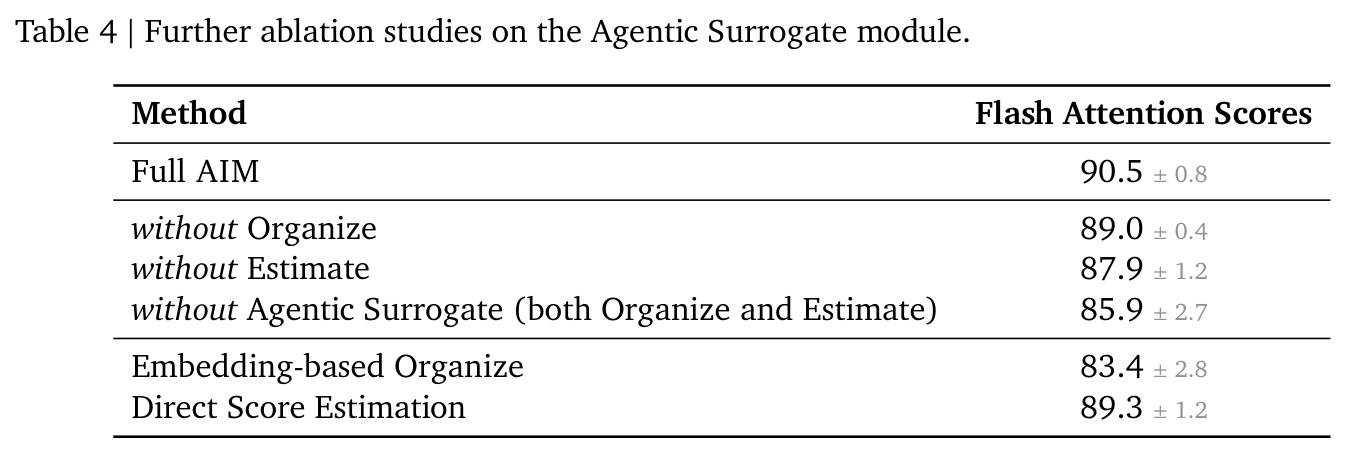
技术新颖性可以从对比中看清。对比固定脚手架:DeepScientist 的列表、AI-Scientist-v2 的 MCTS、Arbor 的树、ScientistOne 的 beam 都是搜索前就定死的结构,而 AIM 的簇结构是搜索过程中每轮重建的涌现产物,跨谱系重组让“教训”能在语义相近但来源不同的想法间流动。对比固定选择规则:UCB/MCTS 依赖数值化的统计量,在自然语言想法空间里既难定义也难校准;AIM 用 LLM 的序数估计替代,附录 E.3 显示其 Spearman 相关随迭代累积证据而上升(Radix Sort 上后期接近完全一致)。对比“让 LLM 直接挑想法”:AIM 把估计作为显式中间产物并强制 verbalize 两级 explore/exploit 决策,使策略可解释且证据接地;附录 D.2 的消融很有说服力——用 Gemini 嵌入做 K-means 聚类替换 LLM Organize 掉到 83.4 分(甚至低于完全去掉 Surrogate 的 85.9),直接分数回归替代序数估计掉到 89.3,说明“LLM 语义组织”和“序数化”两个设计各自必要。Solution Auditor 的 idea 重建机制也有实证支撑:各任务的想法不匹配比例在重建后大幅下降(多数降到个位数百分比)。最后,命题 1 和命题 2 给出了想法级搜索何时占优的充分条件 $C\ge(K/G_\varepsilon)\ln(1/\delta)$,为这个经验性设计提供了理论支点。
实验结果
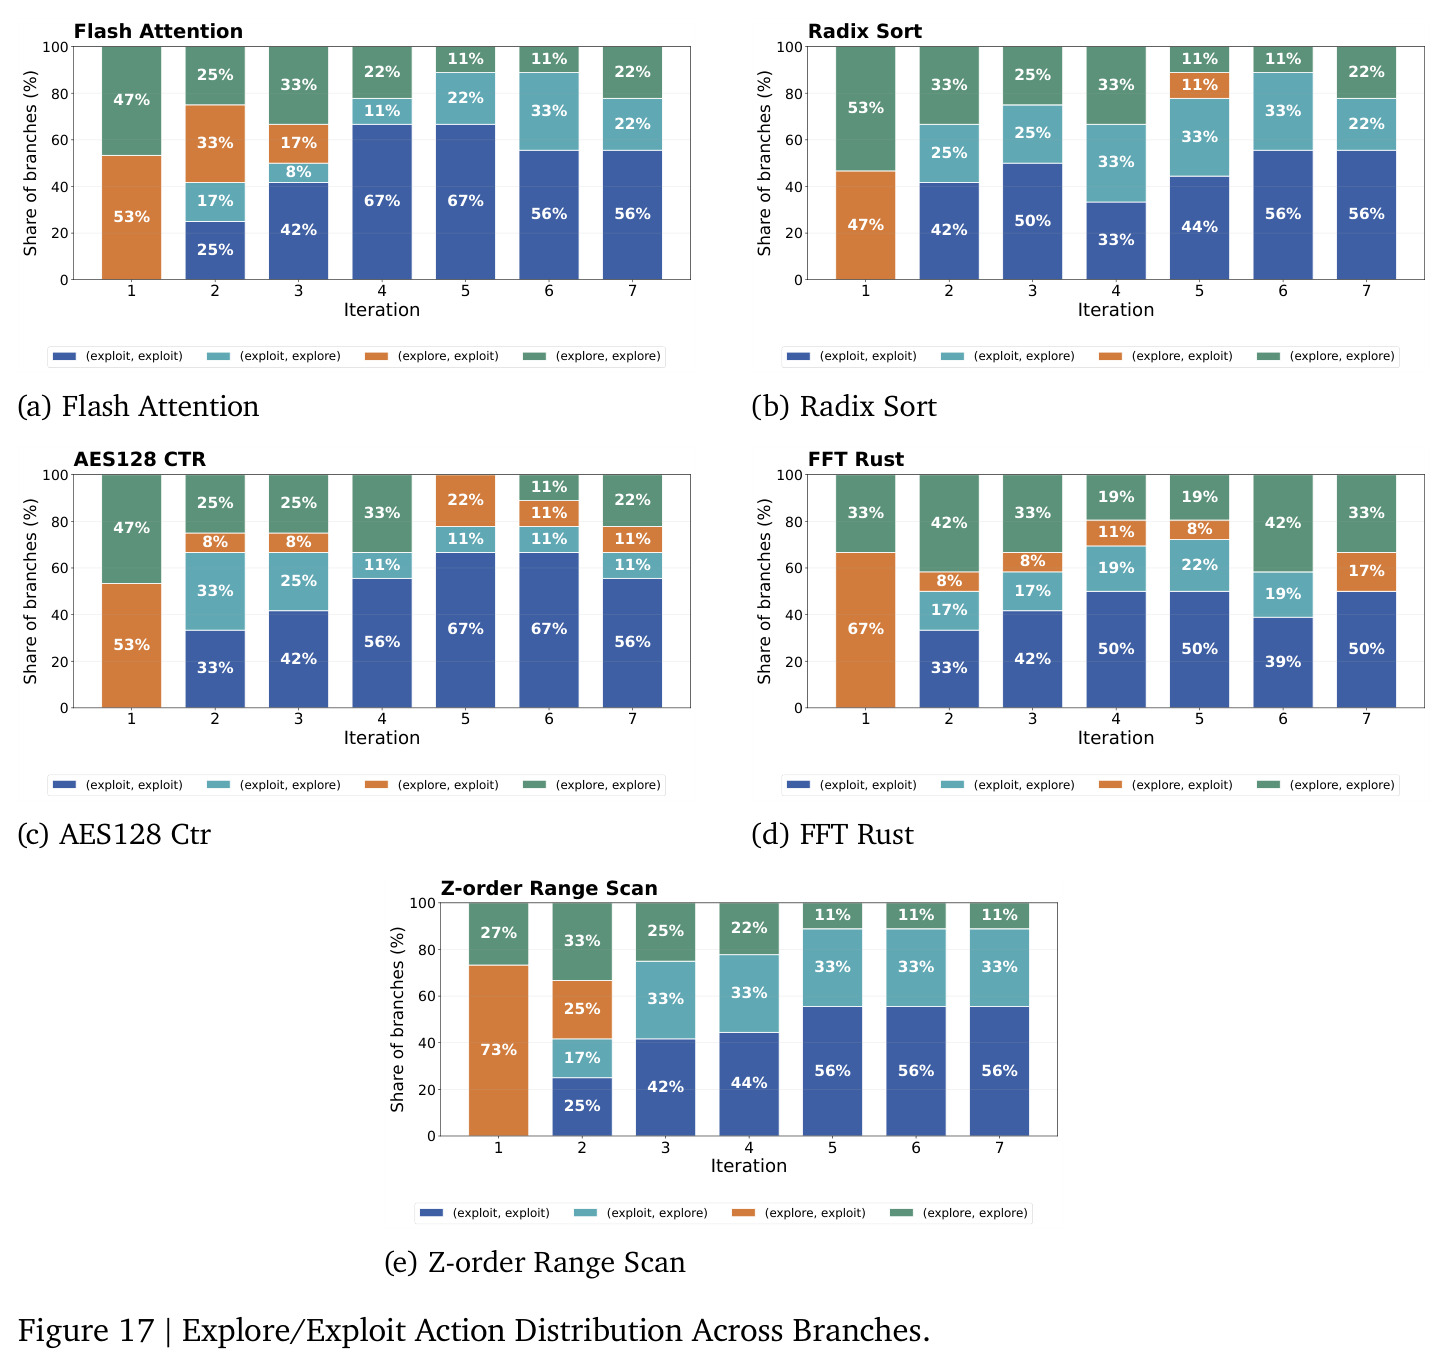
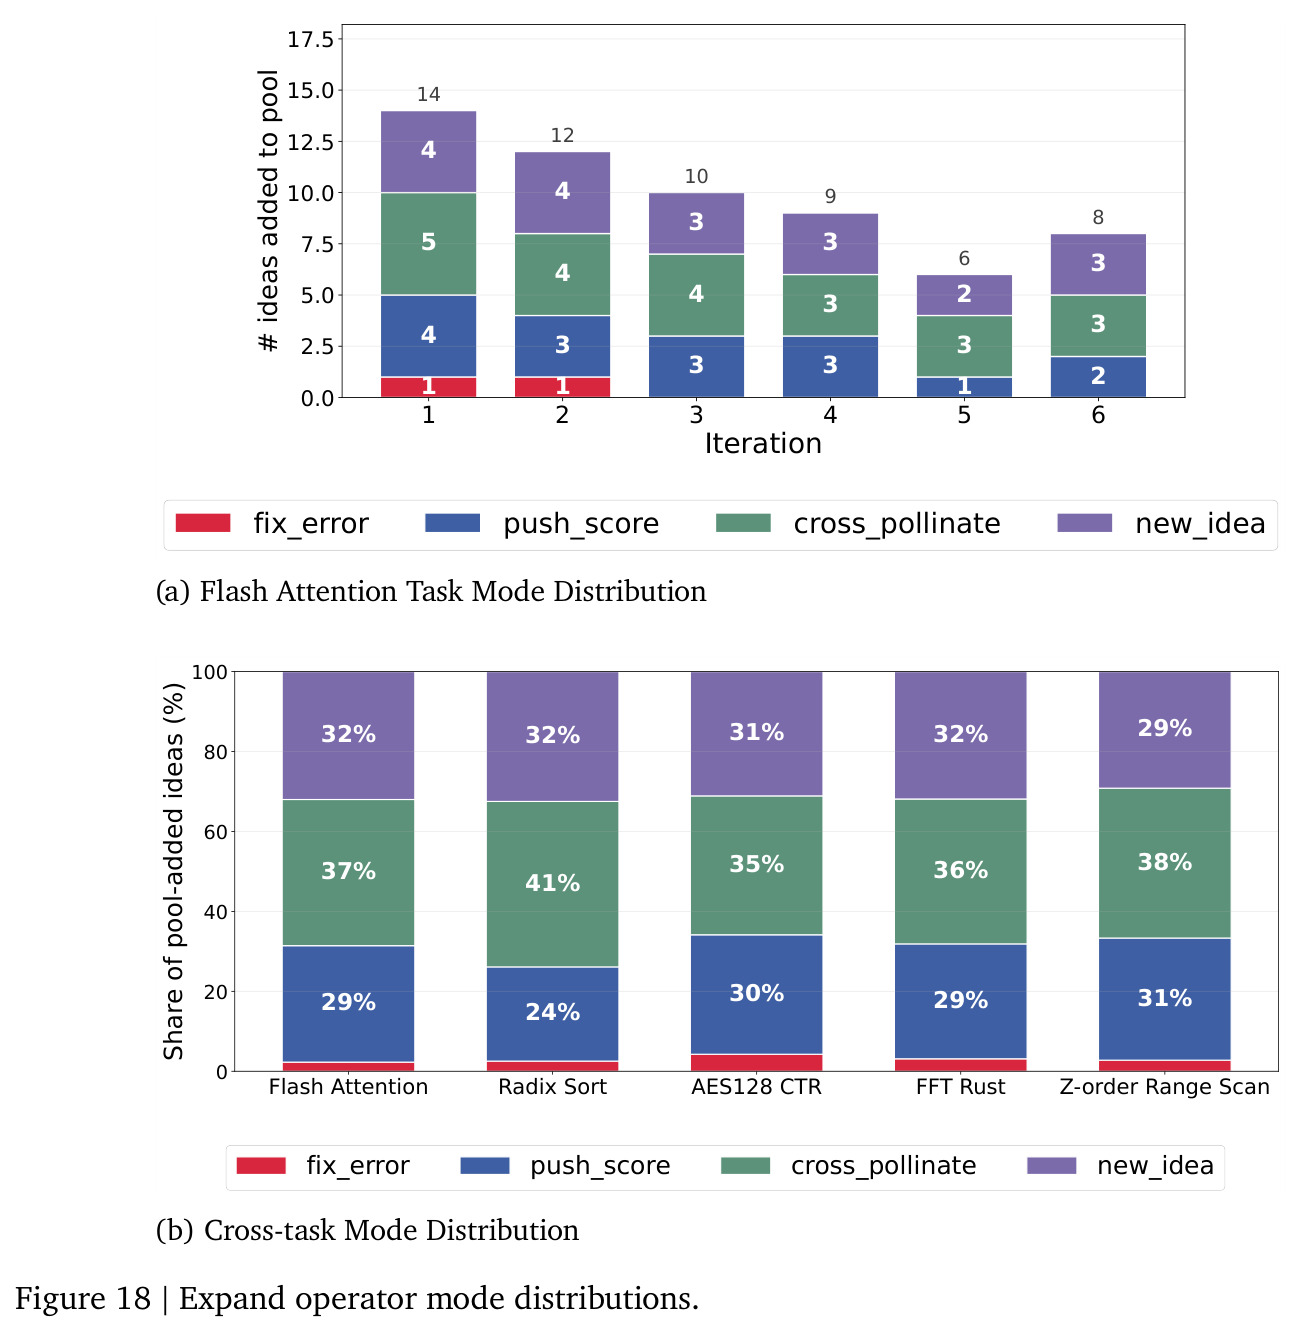
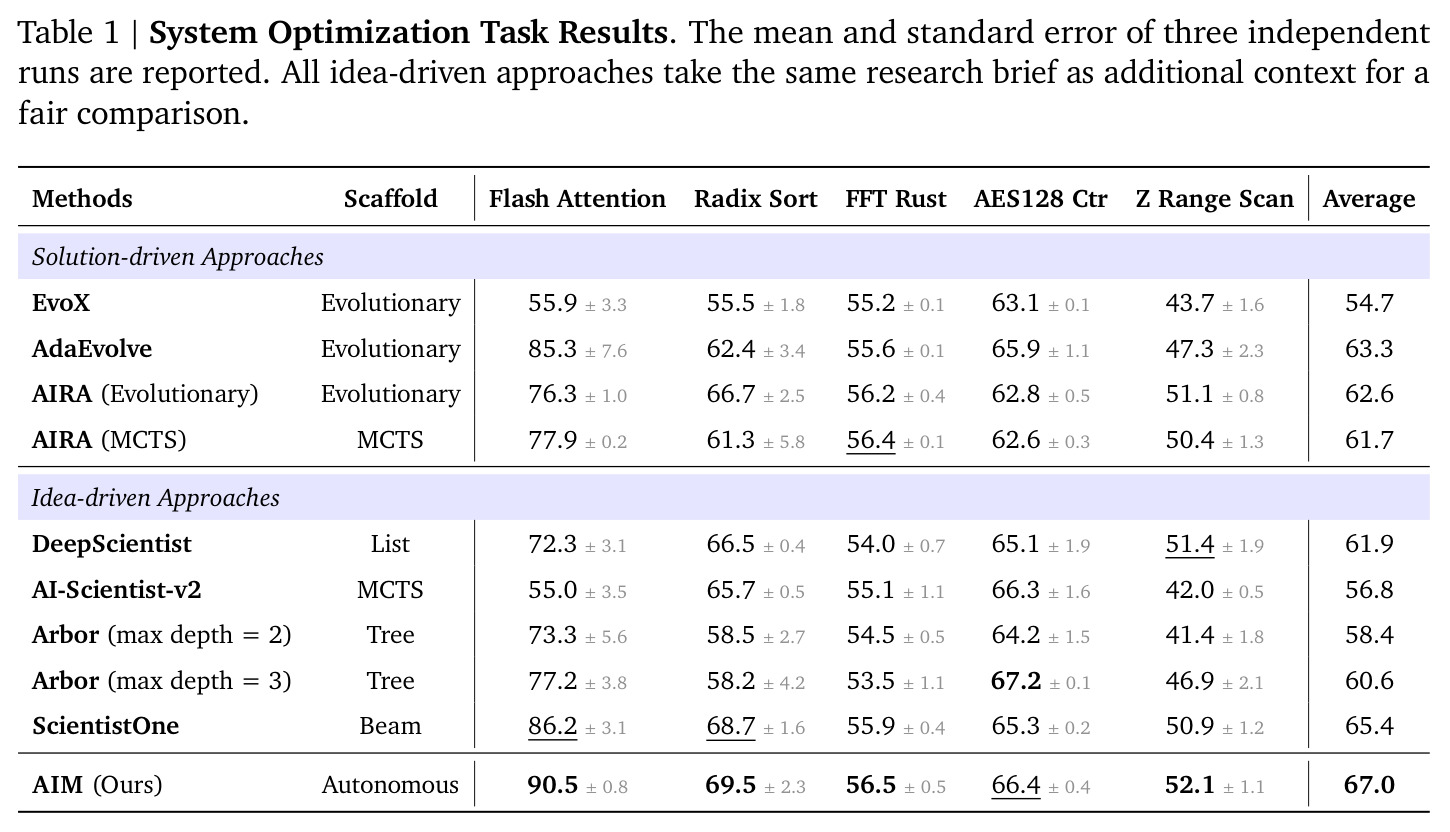
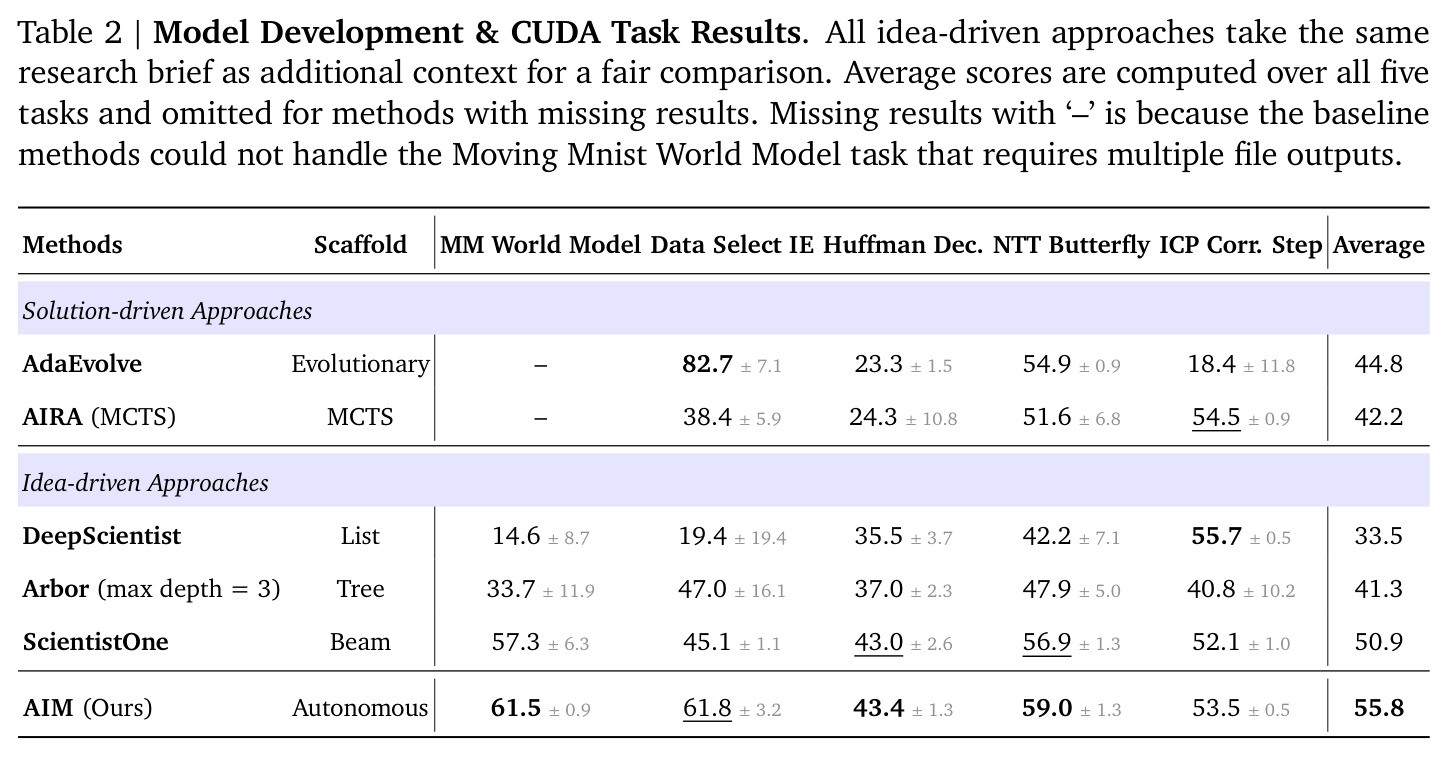
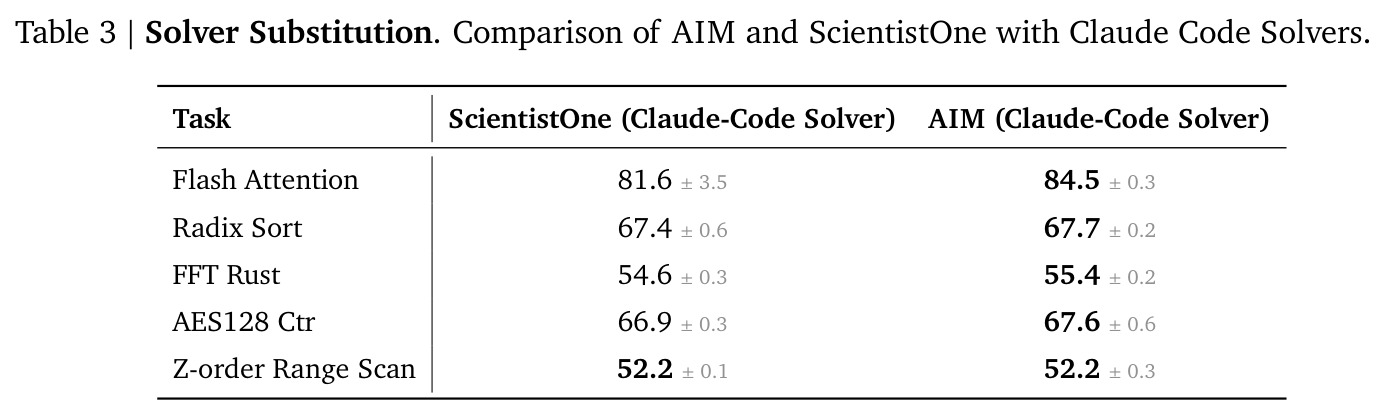
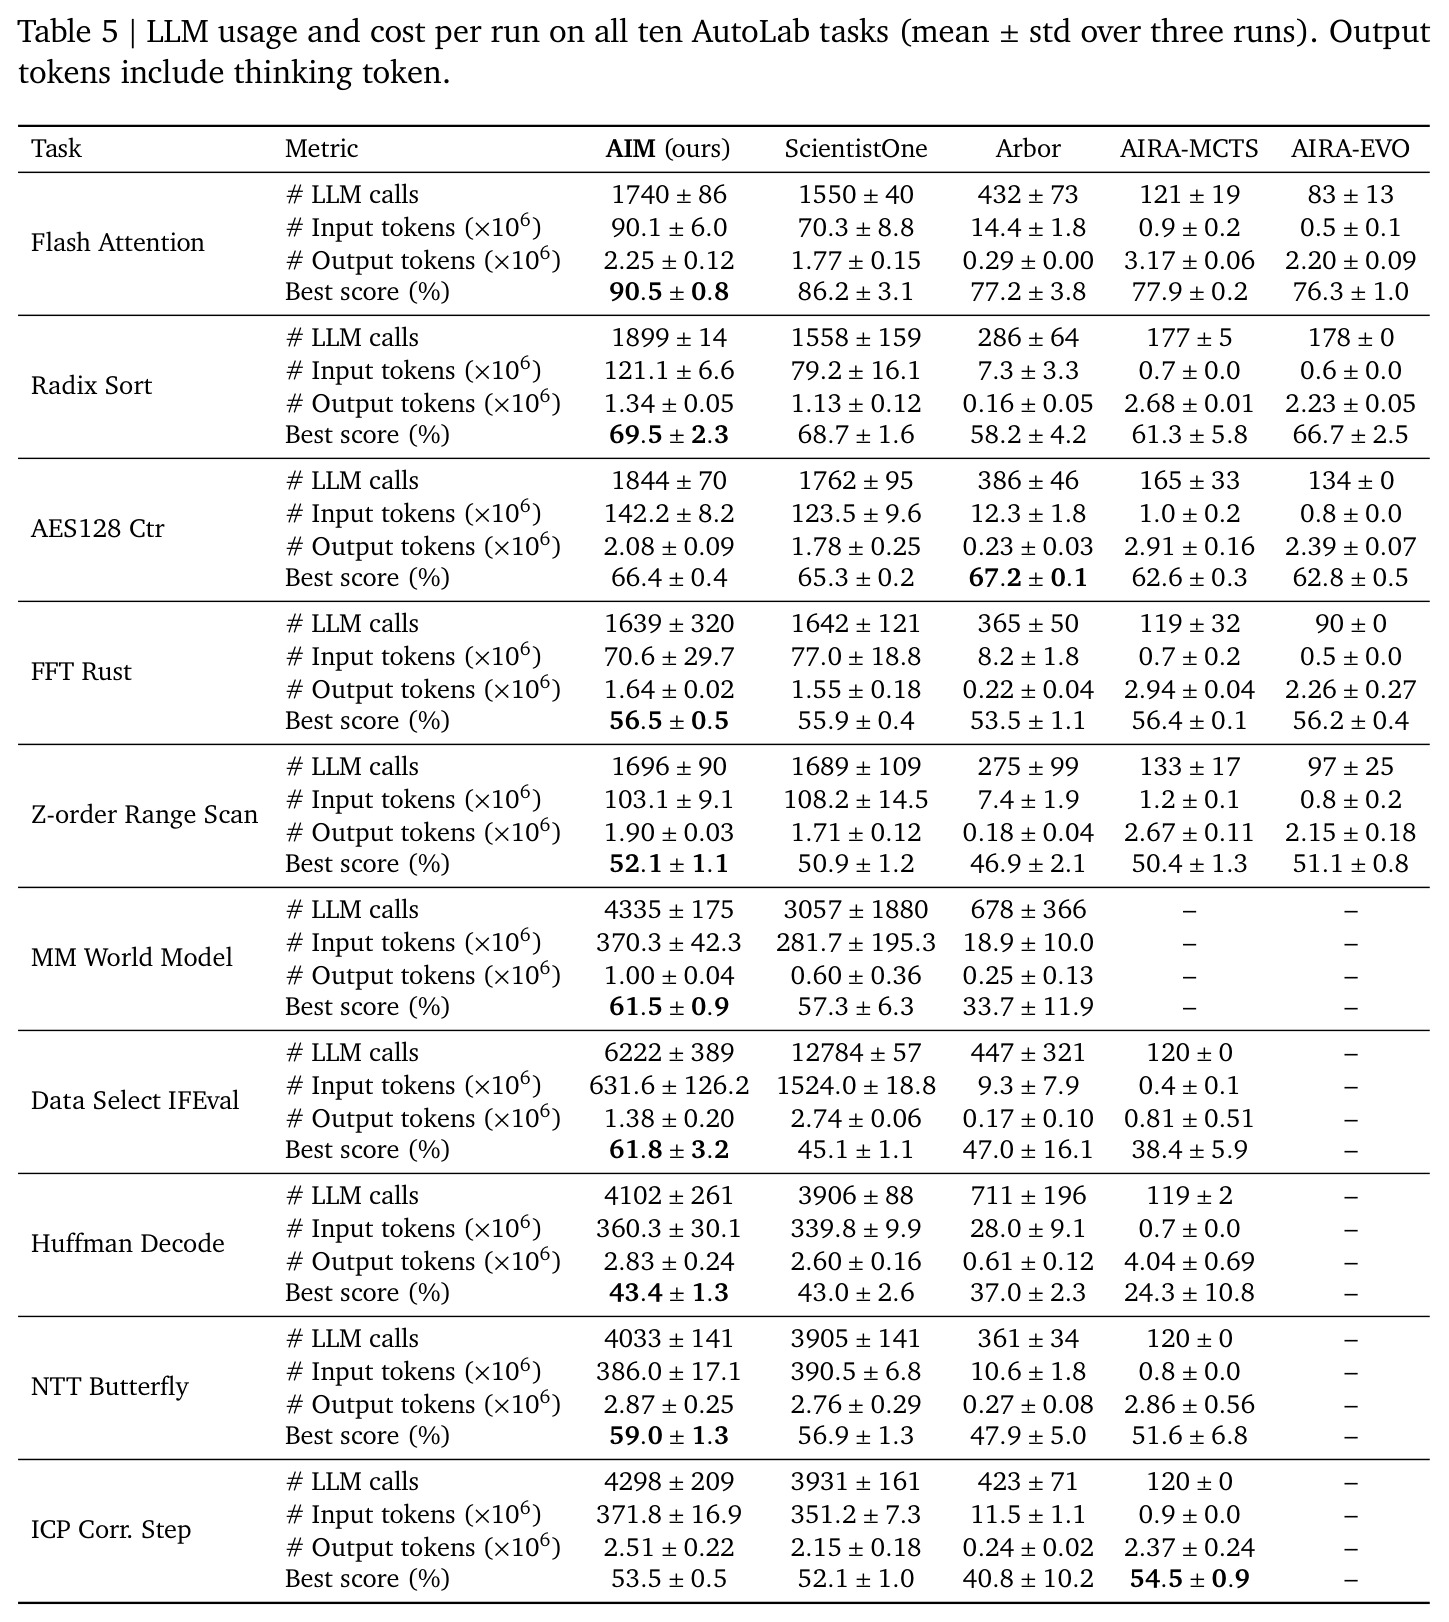
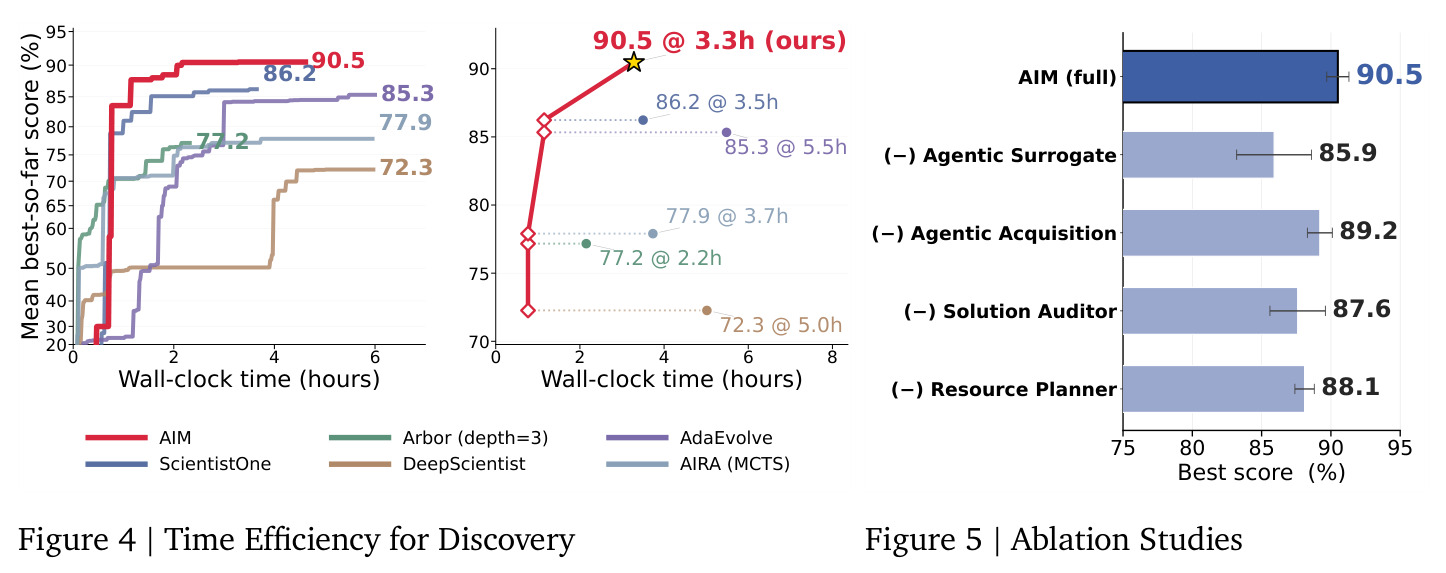
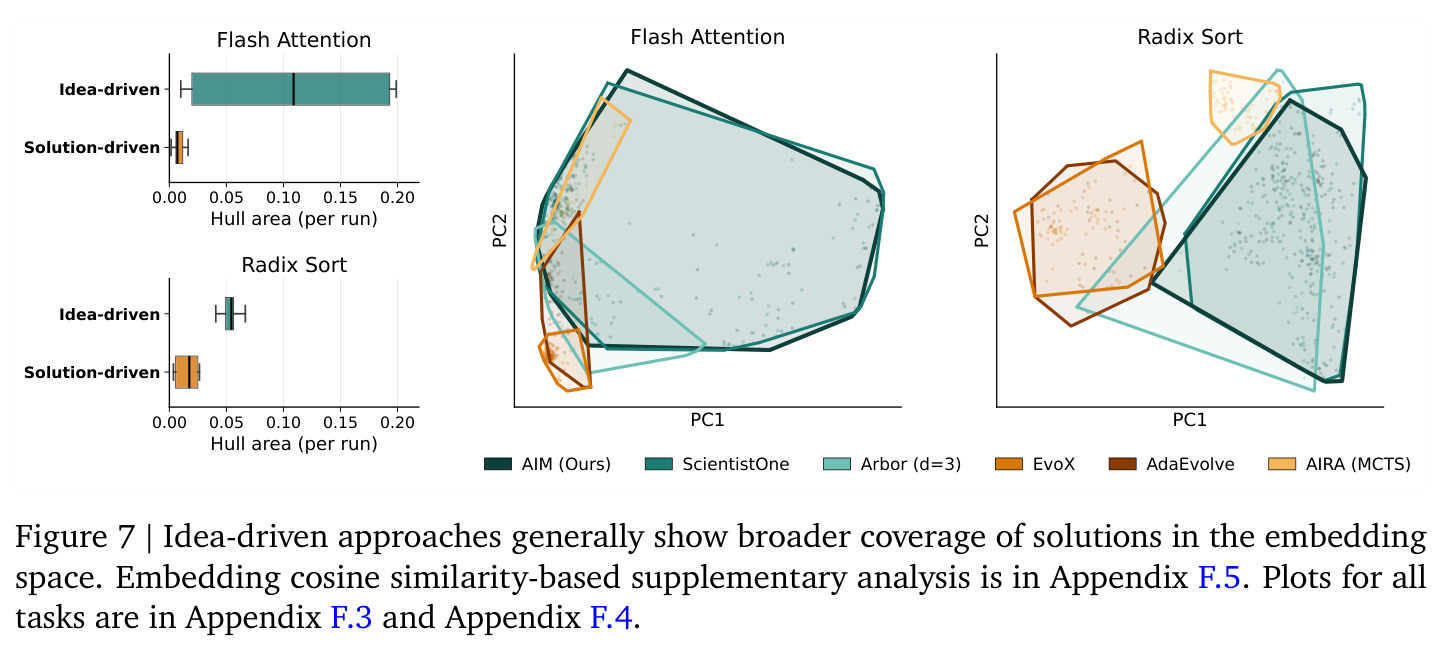
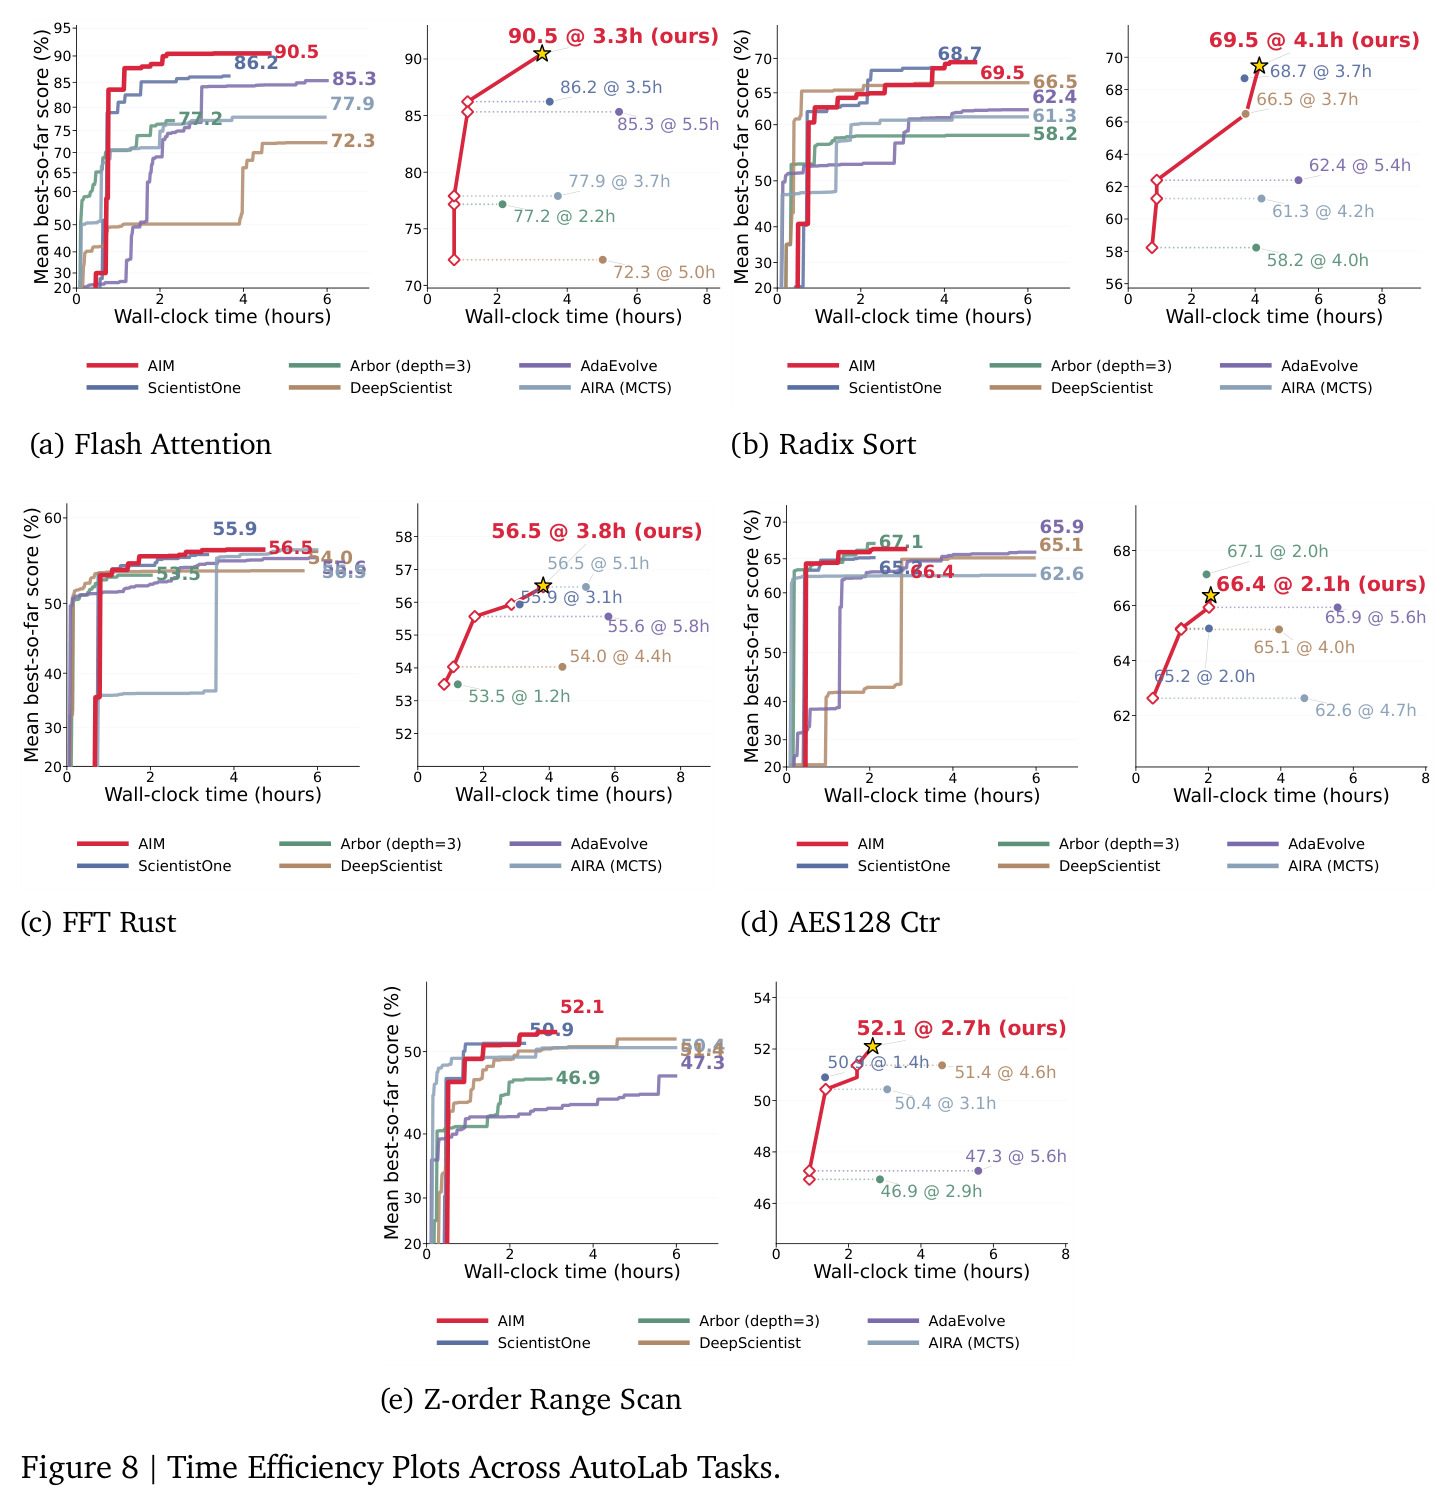
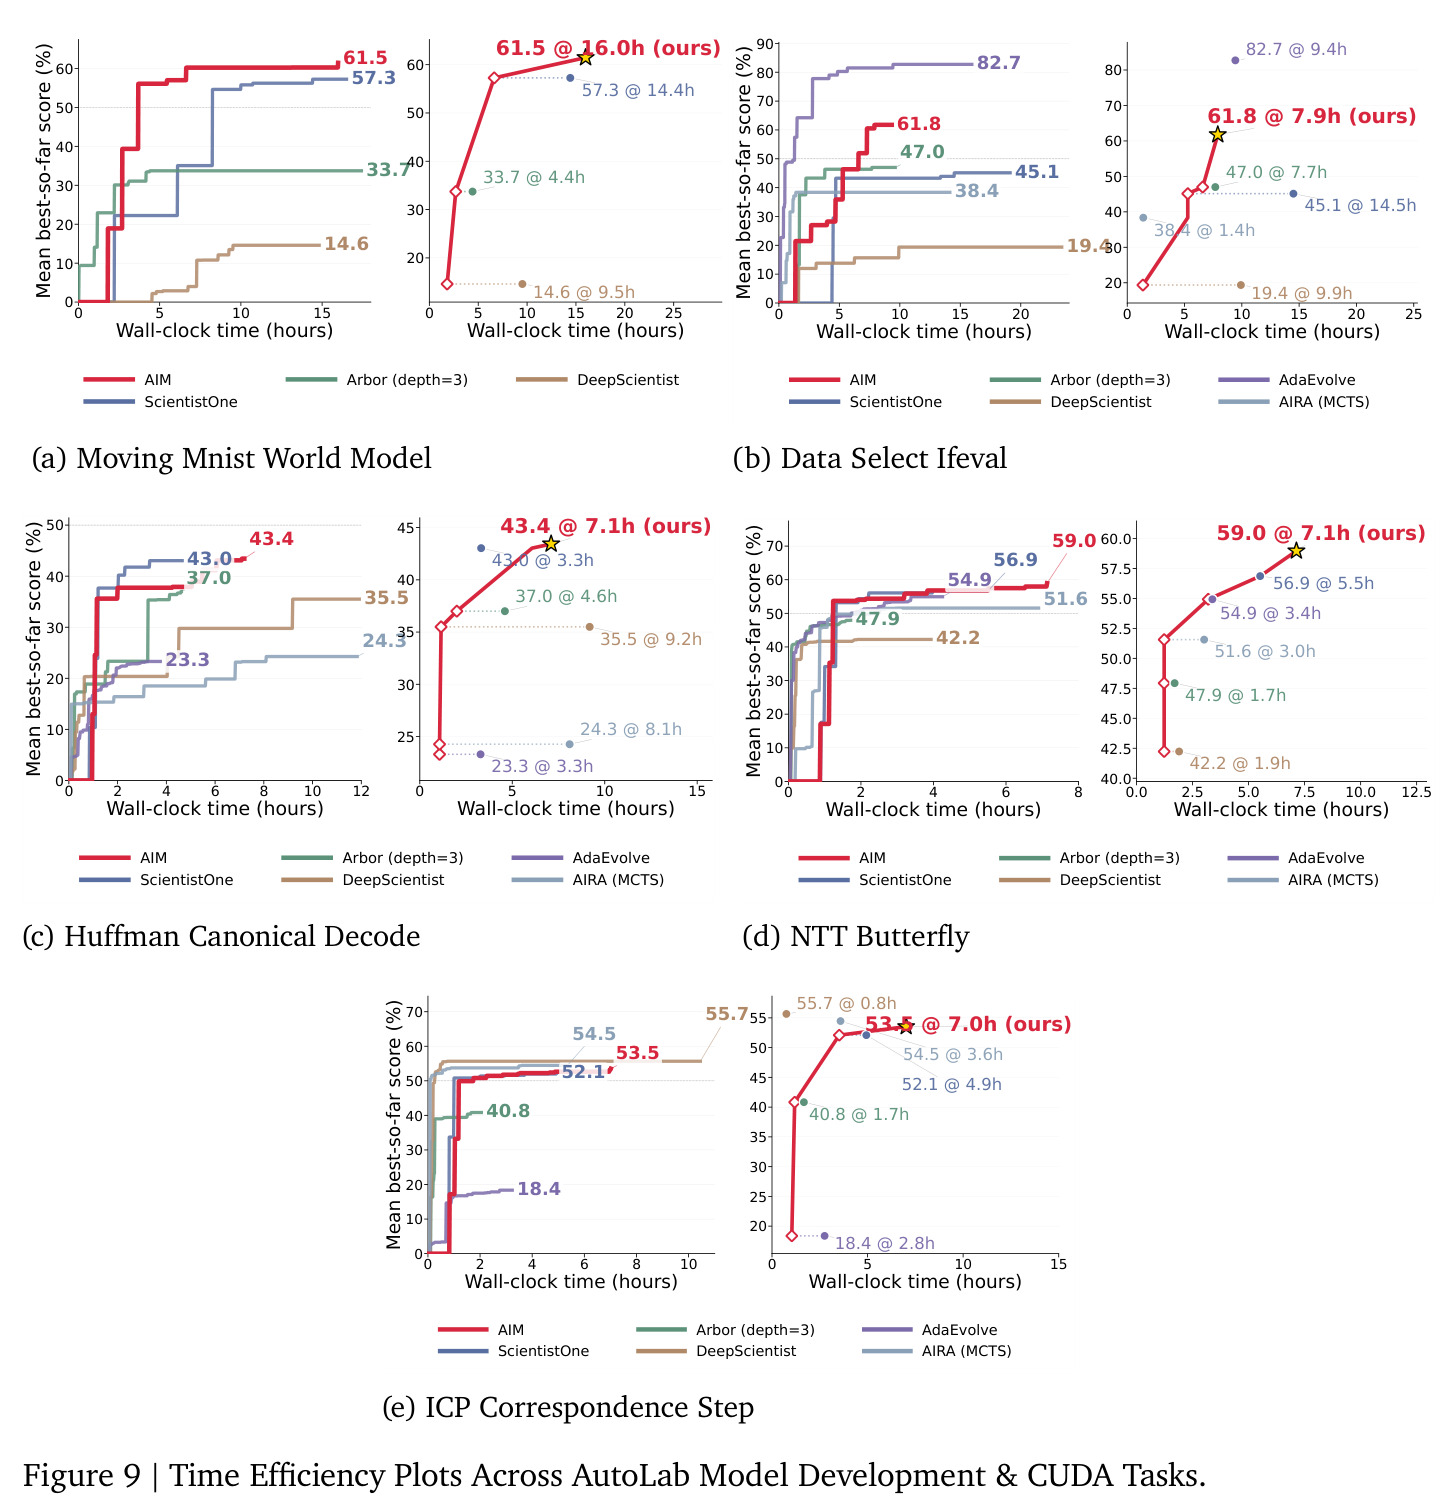
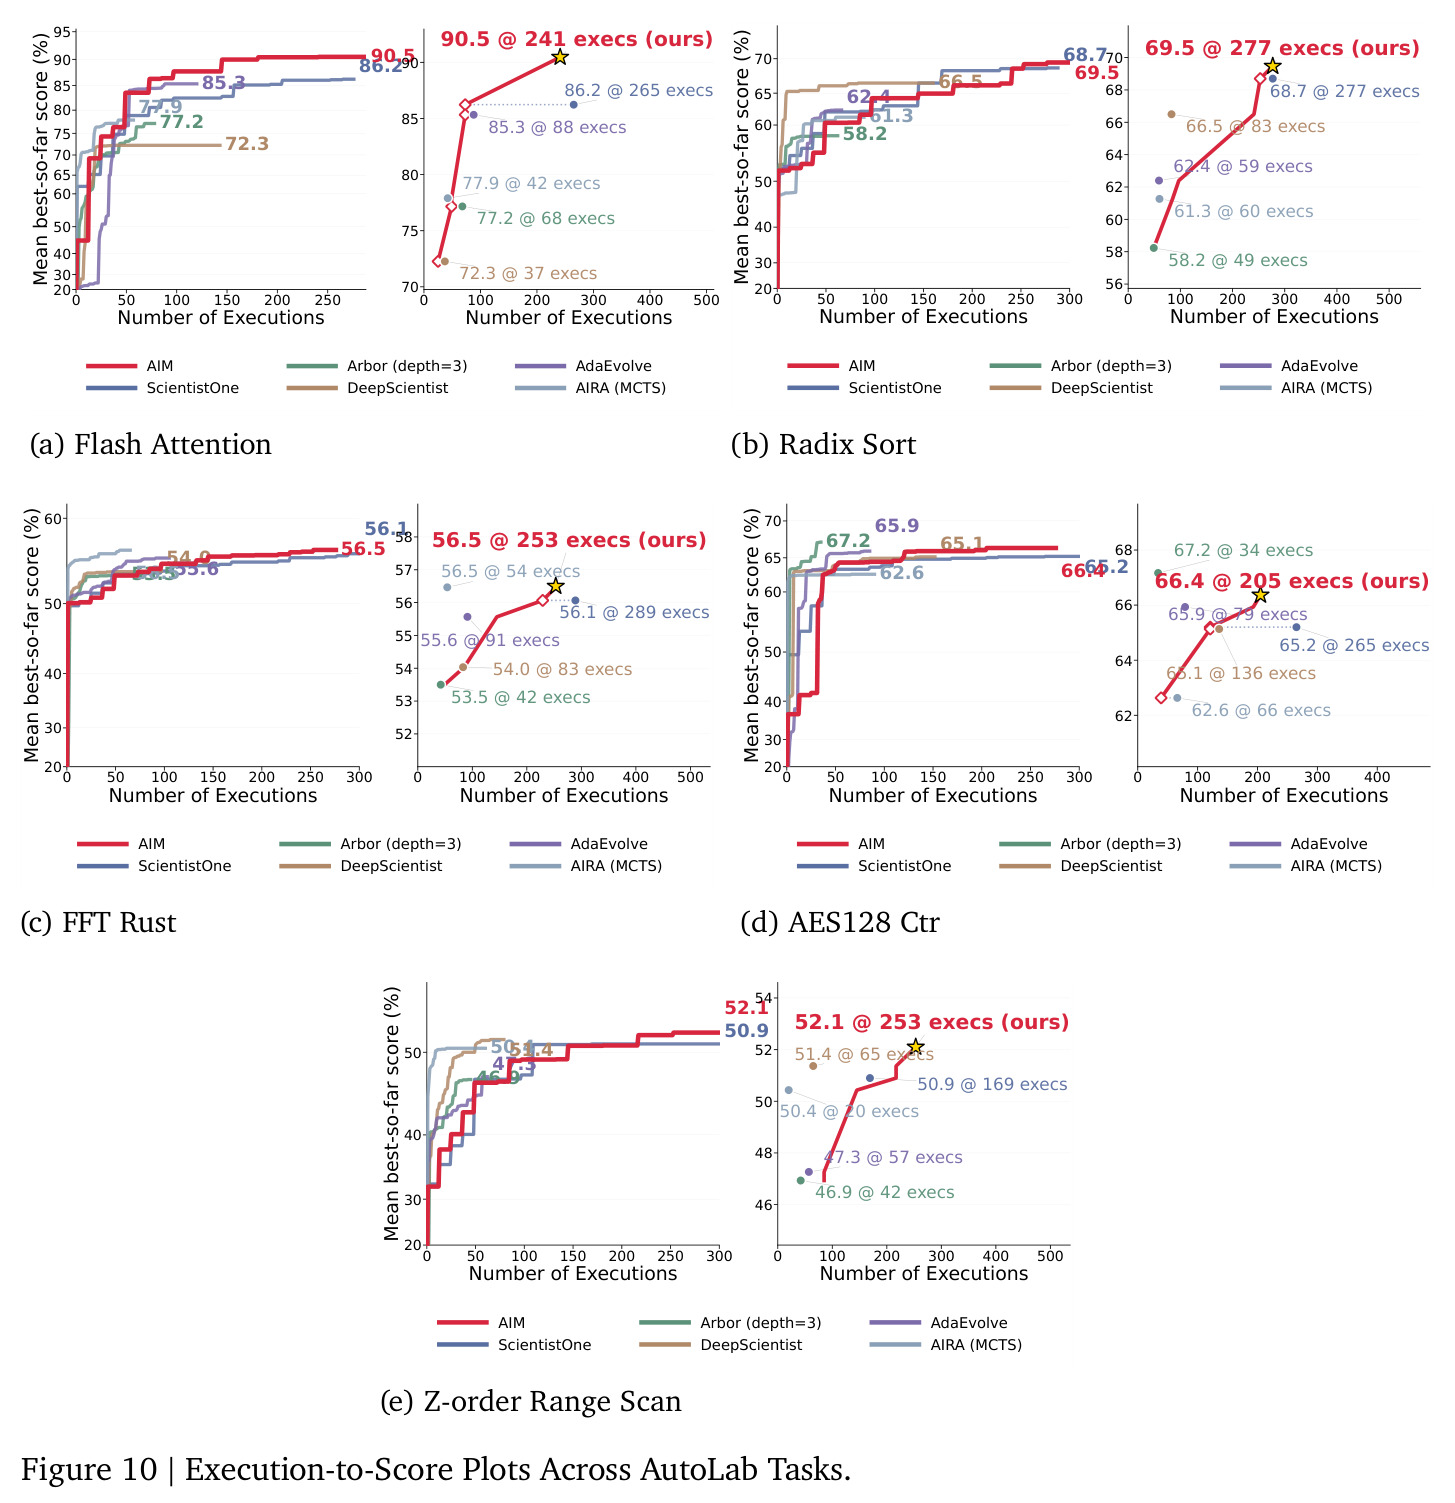
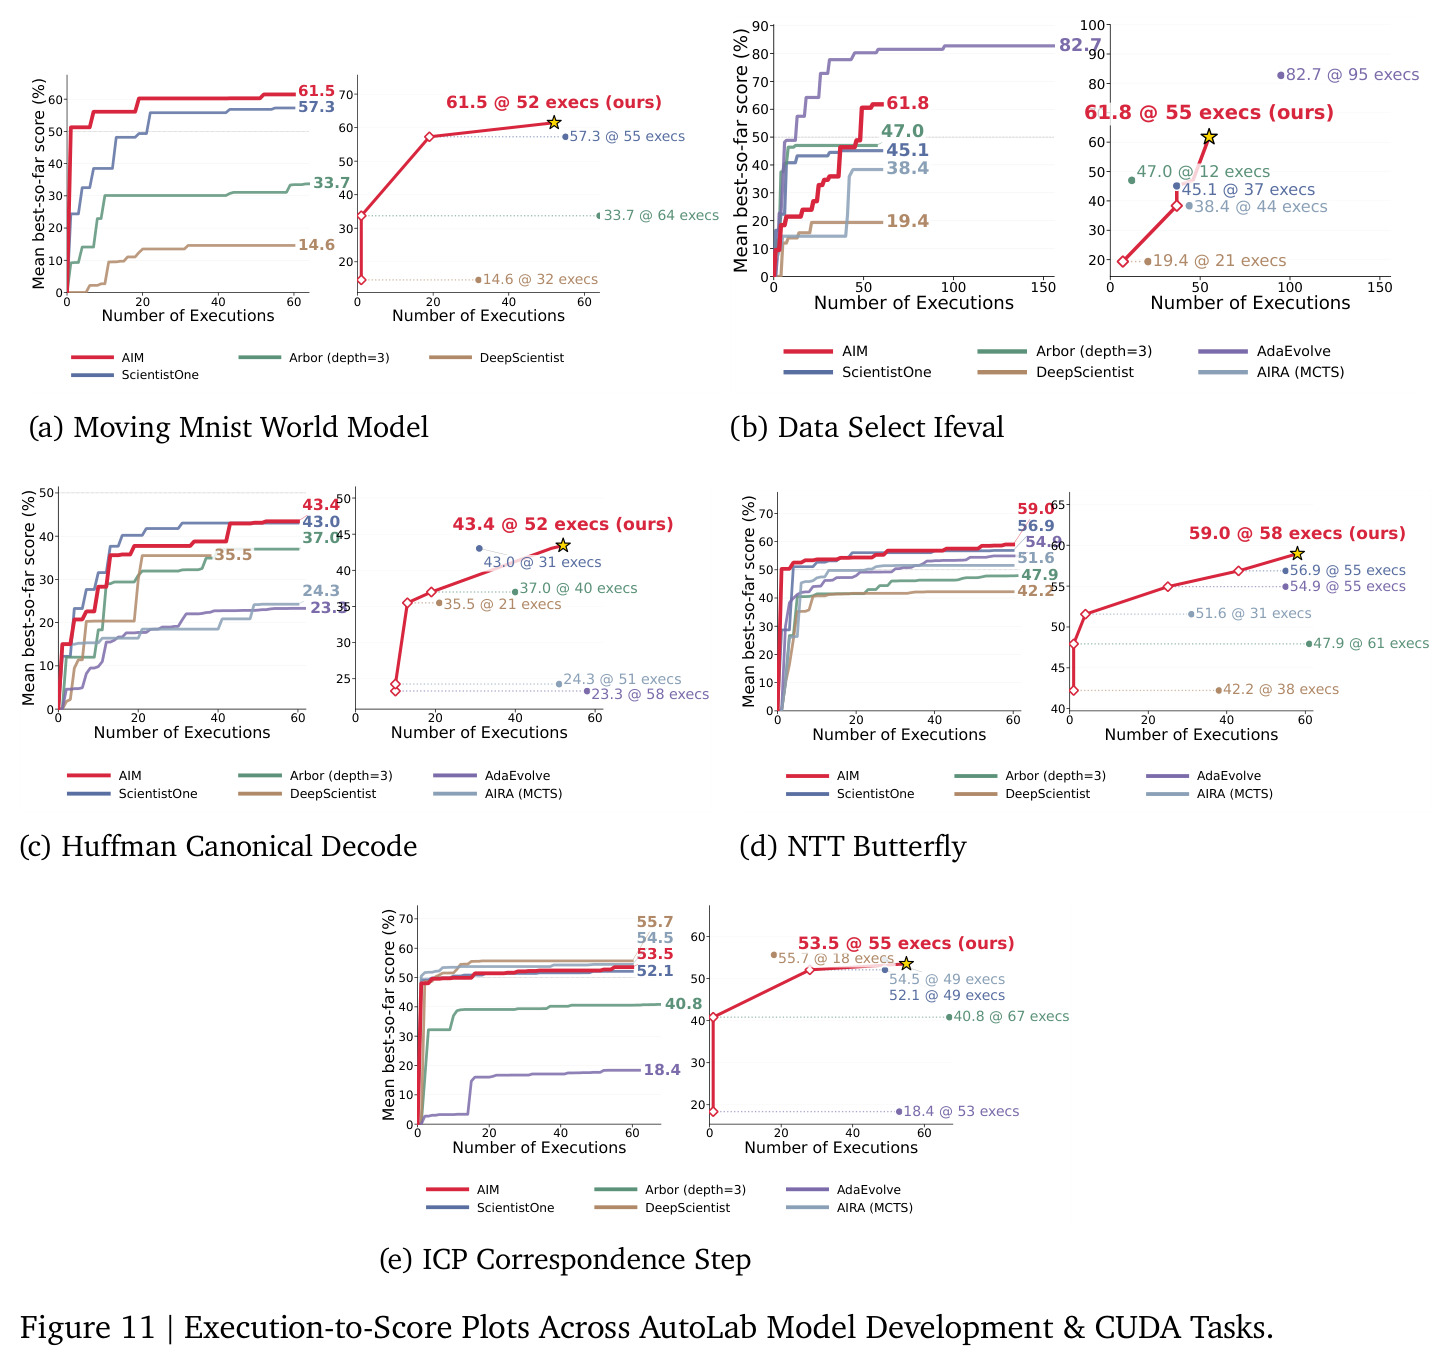
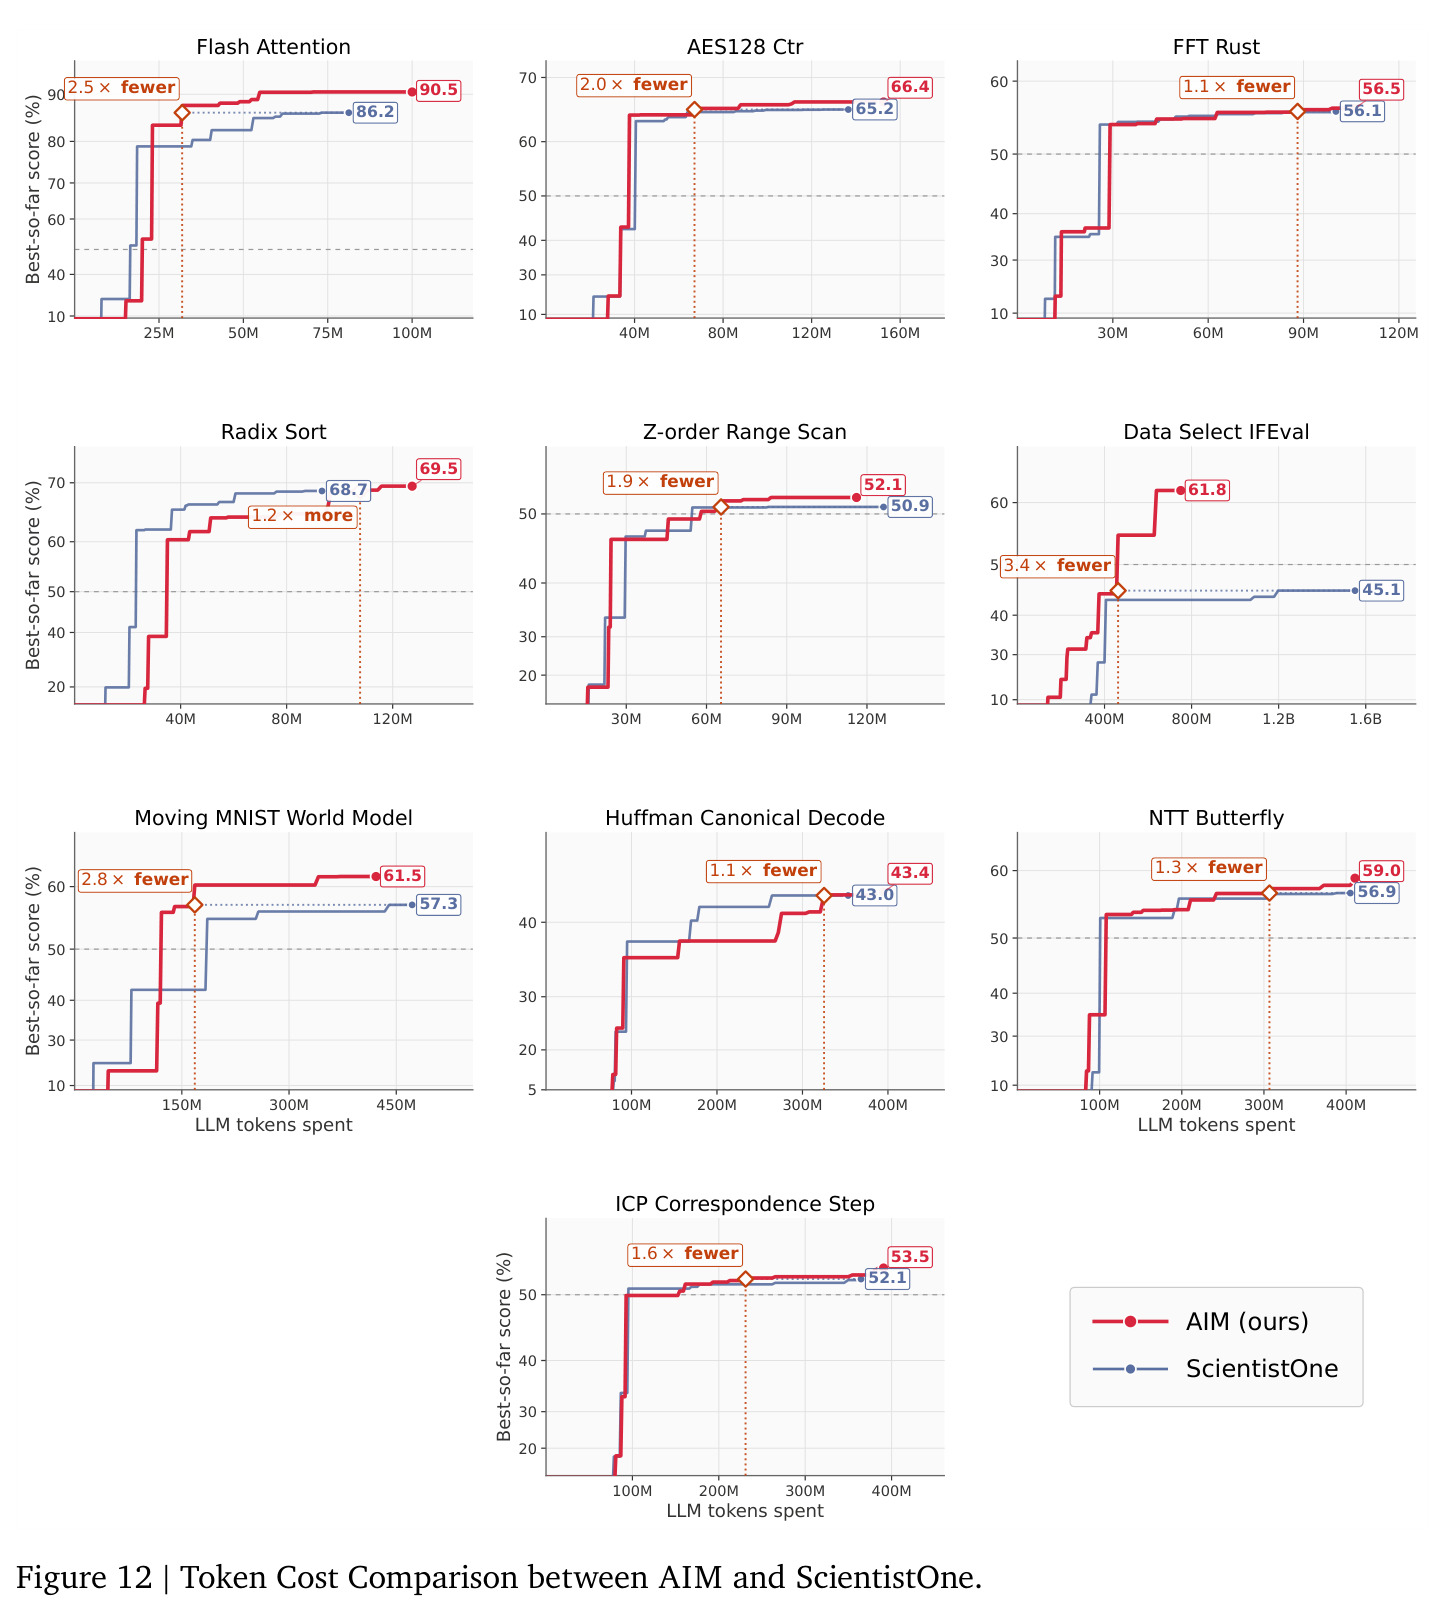
主实验覆盖 AutoLab 全部 10 个任务,每个方法-任务对跑 3 次独立实验报均值和标准误,骨干模型统一为 Gemini-3.1-Pro-Preview。系统优化任务(表 1):AIM 平均 67.0%,超过最强 idea-driven 基线 ScientistOne 的 65.4%(+1.6pp)和最强 solution-driven 基线 AdaEvolve 的 63.3%(+3.7pp);最大增益在 Flash Attention(90.5 vs ScientistOne 86.2、AdaEvolve 85.3,分别 +4.3/+5.2pp),且 AIM 标准误最小(±0.8),稳定性更好。长时程的模型开发与 CUDA 任务(表 2):AIM 平均 55.8% vs ScientistOne 50.9%(+4.9pp),在 5 个任务中的 3 个(MM World Model 61.5 vs 57.3、Huffman Decode 43.4 vs 43.0、NTT Butterfly 59.0 vs 56.9)拿下最佳;例外是 Data Select IFEval,AIM 61.8 低于 AdaEvolve 的 82.7,作者解释该任务景观平滑、适合对单一启发式配方做局部微调,变异循环的 AdaEvolve 占优。时间效率(图 4):AIM 在 Flash Attention 上约 1–2 小时内就达到所有基线的最终分数水平,其最佳分 90.5% 出现在 3.3 小时,早于 ScientistOne 的 86.2%@3.5h 和 AdaEvolve 的 85.3%@5.5h,相对最强基线最高提速 3.1 倍。消融(图 5,Flash Attention):完整 AIM 90.5;去掉 Agentic Surrogate 掉到 85.9(−4.6,最大降幅)、去掉 Solution Auditor 掉到 87.6(−2.9)、固定 5×5 资源调度掉到 88.1(−2.4)、去掉显式 Acquisition 动作掉到 89.2(−1.3),四个组件均有效。换用 Claude Code 做 solver(表 3)AIM 仍在 5 个系统优化任务上全面持平或领先(如 Flash Attention 84.5 vs 81.6)。Token 成本(表 5、图 12):AIM 输入 token 单任务常达 0.7–6.3 亿,但在 10 个任务中的 9 个上,AIM 到达 ScientistOne 最终最佳分所需 token 更少,Data Select IFEval 上最多省 3.4 倍。理论实证(图 7):用嵌入凸包面积作覆盖代理,Flash Attention 这类“方向多、能打的少”的任务上 idea-driven 方法覆盖显著更宽,而 Radix Sort 这类算法基本固定的任务上两派差距明显缩小,与命题 2 的预测一致。行为分析(图 17、18):早期分支偏探索、后期偏利用;Expand 的四种模式使用均衡(cross-pollination 占 35–41%、new_idea 29–32%、score-guided 24–31%、error-repair 很少),没有塌缩到单一策略。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 系统优化 5 任务平均(Flash Attention / Radix Sort / FFT Rust / AES128 Ctr / Z-order Range Scan) | 归一化分数(%,3 次运行均值) | 67.0 | ScientistOne 65.4(最强 idea-driven);AdaEvolve 63.3(最强 solution-driven) | +1.6pp / +3.7pp |
| 模型开发与 CUDA 5 任务平均(MM World Model / Data Select IFEval / Huffman Decode / NTT Butterfly / ICP Corr. Step) | 归一化分数(%,3 次运行均值) | 55.8 | ScientistOne 50.9;Arbor(d=3) 41.3;DeepScientist 33.5 | +4.9pp |
| Flash Attention(单任务) | 归一化分数(%) | 90.5 ± 0.8 | ScientistOne 86.2 ± 3.1;AdaEvolve 85.3 ± 7.6 | +4.3pp |
| Moving MNIST World Model(长时程,24h 墙钟) | PSNR 锚点插值分数(%) | 61.5 ± 0.9 | ScientistOne 57.3 ± 6.3;Arbor 33.7 | +4.2pp |
| 到达最强基线最终分数的墙钟时间(Flash Attention) | 小时 | 约 1–2 小时(最佳分 90.5% @ 3.3h) | ScientistOne 86.2% @ 3.5h;AdaEvolve 85.3% @ 5.5h | 最高 3.1 倍提速 |
| 匹配 ScientistOne 最佳分所需 token(10 任务中的 9 个) | LLM token 数 | 更少,Data Select IFEval 上最多省 3.4 倍 | ScientistOne | 最多 3.4× fewer |
局限与改进
作者明确承认和可以观察到的局限有以下几方面。第一,任务依赖性:Data Select IFEval 上 AIM 61.8 显著低于 AdaEvolve 的 82.7,说明当任务的得分景观平滑、由单一配方的局部微调主导时,idea 级的广度探索不占优——这与作者自己的理论($K/G_\varepsilon$ 小时广度价值有限)自洽,但意味着 AIM 并非普适赢家。第二,忠实实现假设(Assumption 2)被作者承认是理想化的:solver 可能产出不完整或部分偏离想法的实现,有些任务(如需要调超参的 ML 系统)本来就要大量 solution 级打磨才能评估一个方向的价值。第三,成本:AIM 单任务 LLM 调用 1700–6200 次、输入 token 数千万到 6.3 亿,多数任务高于 ScientistOne,靠的是“更快达标”而非绝对更省。第四,理论中假设每个想法对应单一确定性实现 $g(x)$、verifier 无噪声,而实际实现方差和测量噪声都不小(作者自己也用实现噪声解释估计相关性非单调)。第五,评估规模有限:10 个 AutoLab 任务、每对仅 3 次运行,部分基线方差很大(如 AdaEvolve 在 Flash Attention ±7.6),结论的统计功效一般。第六,全部基准都是可自动验证的工程任务,尚未触及需要文献调研、外部实验或人类评审的开放式科学问题。
独立分析的弱点
独立分析的话,我认为有六个值得注意的弱点。其一,成本结构:每轮都要对全池做 LLM 重聚类和重排序,这种“全局刷新”式设计是 token 开销偏高的根源(如 Data Select IFEval 631.6M 输入 token),可以引入增量聚类和估计缓存来削减。其二,探索-利用策略完全交给 LLM 自由裁量,虽然可解释,但没有任何 regret 保证,也没有与序数估计的不确定性挂钩——把排名与置信上界(类 UCB 的序数版本)结合可能更稳。其三,Solution Auditor 由同一个 LLM 担任法官,idea_mismatch 的“重建想法”本质上是让模型自己改写归因,可能引入新的系统性偏差,值得用人工标注子集校验审计精度。其四,关键超参都是手工设定的:簇数 $[2,5]$、并行分支 $[3,10]$、每分支每轮至多 3 个新想法,论文没有做敏感性分析,换到更大规模任务上未必合适。其五,每个想法只允许单一确定性实现路径 $g(x)$,忽略了同一想法多次实现的方差,而系统优化任务的运行时间测量本身就带噪声,这会直接污染 Estimate 的排序依据。其六,所有结论都来自 AutoLab 这种有完美 verifier 的封闭环境,当评分稀疏、延迟或主观时(更接近真实科研),Auditor 和估计器的行为是否退化完全未知,每个弱点都对应明确的改进方向。
未来方向
作者在 6.2 节明确提出的方向是:不要预先固定 idea-driven 与 solution-driven 的程度,而是根据观测到的实现难度、solver 保真度和任务的语义结构动态调节两者平衡——即让 Resource Planner 的思想从“分支数”扩展到“搜索层级”。基于论文成果还能自然延伸出几条线:第一,把命题 2 的覆盖理论推广到带噪声 verifier 和软性 $\varepsilon$ 的设定,并给出有限预算下的 regret 界,让探索-利用决策有理论依据;第二,成本感知采集:不同想法的实现代价 $c(x)$ 差异巨大(CUDA 内核 vs 训练世界模型),采集决策应显式纳入预期成本与成功概率;第三,跨任务的想法库与教训迁移——论文中教训 $M_t$ 只在单任务内流动,把 Flash Attention 上学到的“内存带宽优先”类教训泛化到新任务值得探索;第四,把单一 Auditor 扩展为多角色审计委员会,或用程序化检查(静态分析、单元测试)分担 LLM 审计;第五,接入文献检索工具让 new_idea 模式生成有文献根据的方向,把评测从 AutoLab 推向 MLAgentBench、RE-Bench 等更开放的测试床;第六,人类在环的混合流水线,让科学家在簇地图上做少量关键干预。
复现评估
可复现性材料相当齐全:正文给出完整算法伪代码(Algorithm 1),附录 C 提供基准任务定义、评分公式(运行时间对数插值与质量指标锚点插值)、预算设置(系统优化 300 次执行/6 小时,模型开发 60 次/24 小时,CUDA 60 次/12 小时)与全部实现超参,附录 C.3 公开了所有 LLM 算子的 prompt 模板,附录 D–F 提供消融、token 统计和理论证明,结果以 3 次独立运行的均值±标准误报告,项目主页为 imhgchoi.github.io/agentic-idea-manager/(正文未见明确的代码开源链接,需以项目页为准)。复现的实际门槛在算力而非信息:骨干是 gemini-3.1-pro-preview 级别的前沿模型,单任务需 1700–6200 次 LLM 调用、最多 6.3 亿输入 token、6–24 小时墙钟;若要复现完整的 10 方法 × 10 任务 × 3 次运行对比,API 开销估计在数十亿 token 量级,还需搭建 AutoLab 容器化环境。基线代码多来自各自论文的开源实现,但集成与对齐工作量大。总体评级:流程可循、细节透明,但属于高成本复现,适合有充足 API 预算的团队。
论文图表
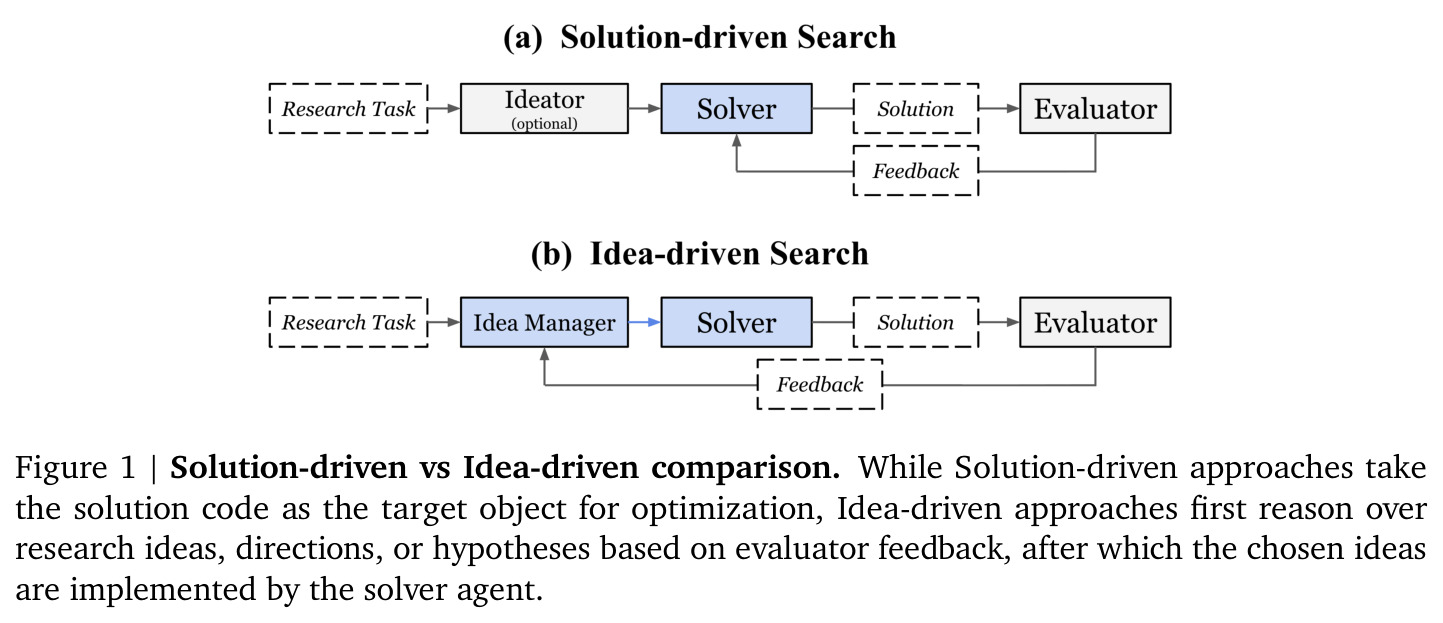
并排对比两类自动化科研范式:solution-driven 直接把解决方案代码作为优化对象,用评估器反馈迭代修改代码;idea-driven 先基于评估器反馈对研究想法/方向/假设做推理和选择,再把选中的想法交给 solver 智能体去实现。
这张图定义了全文的分类学框架和问题定位,理解了两种搜索单元的差别,才能理解 AIM 为什么把“想法管理”当作独立设计问题。
Flash Attention 上的组件消融:完整 AIM 90.5;去掉 Agentic Surrogate 85.9(−4.6);去掉 Solution Auditor 87.6(−2.9);去掉 Resource Planner(固定 5×5 调度)88.1(−2.4);去掉 Agentic Acquisition 89.2(−1.3)。
逐一验证四个模块的贡献,Surrogate 的结构化组织贡献最大,为设计选择提供了直接的实证依据。
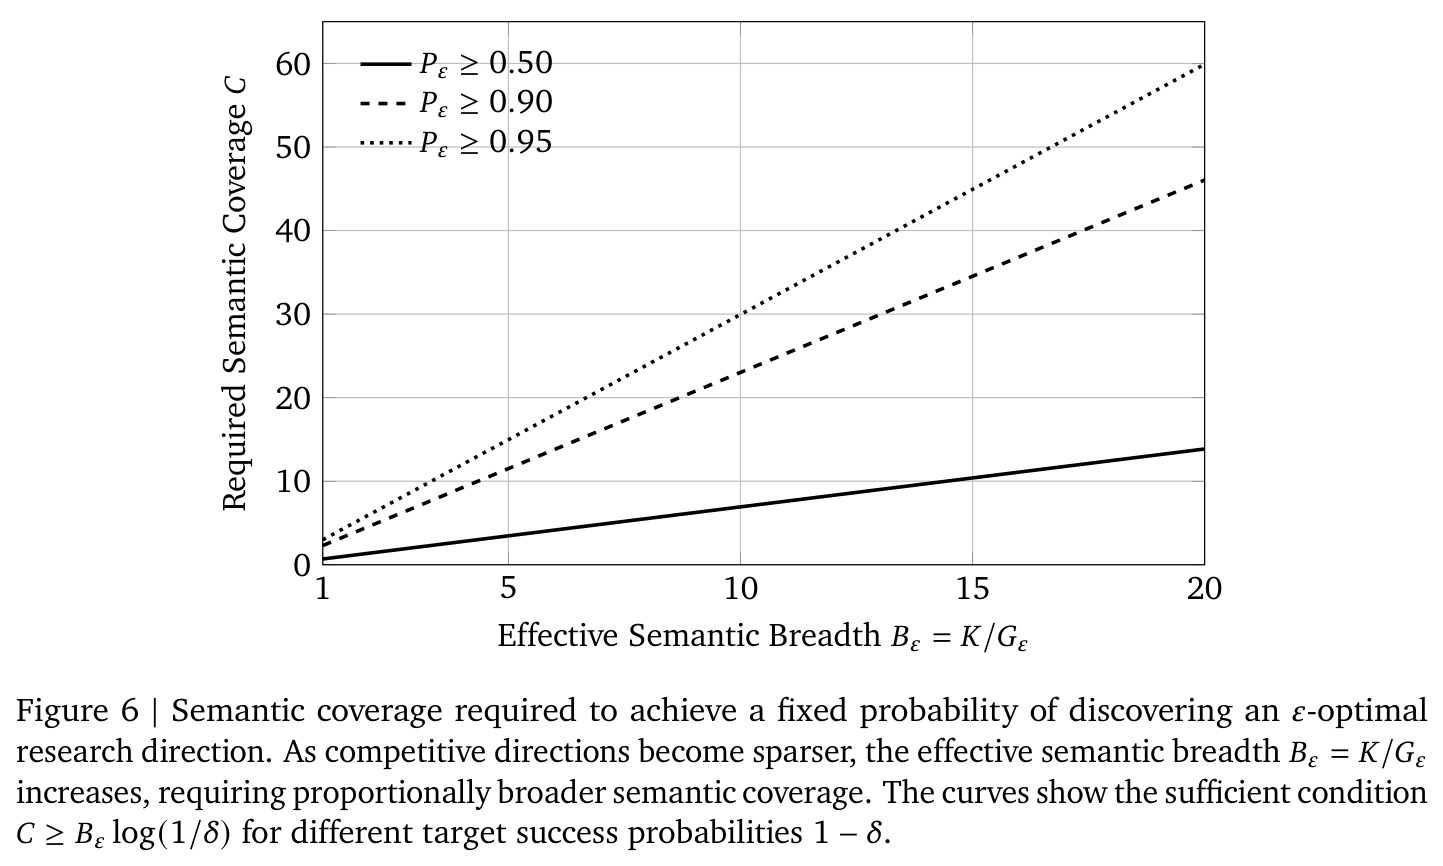
理论界可视化:为以 $1-\delta$ 概率找到 $\varepsilon$-最优方向所需语义覆盖 $C\ge B_\varepsilon\ln(1/\delta)$,横轴为有效语义宽度 $B_\varepsilon=K/G_\varepsilon$;当 $B_\varepsilon=20$ 时,达到 0.50/0.90/0.95 成功率分别需覆盖约 14/46/60 个方向。
把“什么时候想法级搜索值得”的核心结论画成一条线性需求曲线,是理论部分最有信息量的图。