像素扩散模型的对抗训练 Adversarial Training for Pixel Diffusion
在预训练像素扩散模型上加判别器后训练,恢复缺失高频细节并全面提质
前置知识
像素扩散 vs 潜空间扩散
潜空间扩散(如 Stable Diffusion)先用 VAE 把图像压缩到低维潜空间再扩散建模,最后靠冻结解码器渲染成 RGB;像素扩散(如 DeCo、PixelGen)则直接在 RGB 像素上做去噪/流匹配,网络输出就是最终图像。像素路线省去自编码瓶颈,但去噪器必须同时负责全局结构和细节纹理。
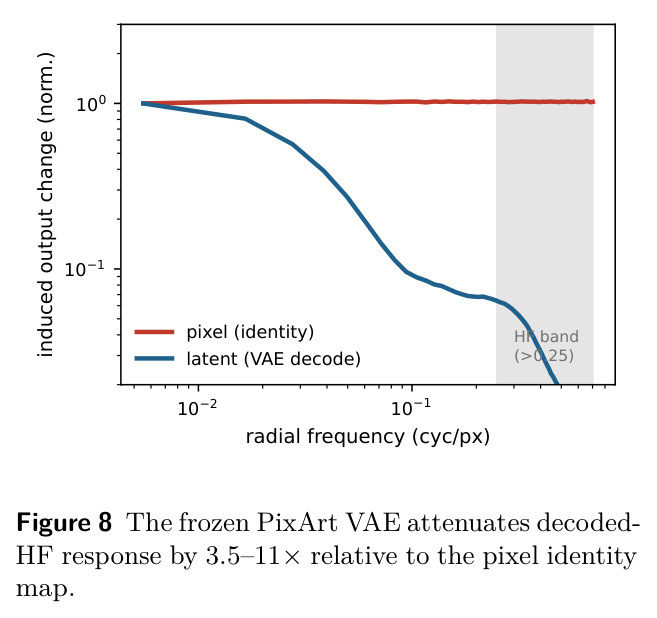
本文核心论点:像素模型的输出就是最终图像,判别器能直接作用于待修正的高频子空间;而潜空间模型隔着冻结 VAE 解码器,梯度虽能回传但对解码后高频的响应被强烈衰减,这是像素-潜空间效果差异的机制根源。
径向功率谱与幂律斜率 $\alpha$
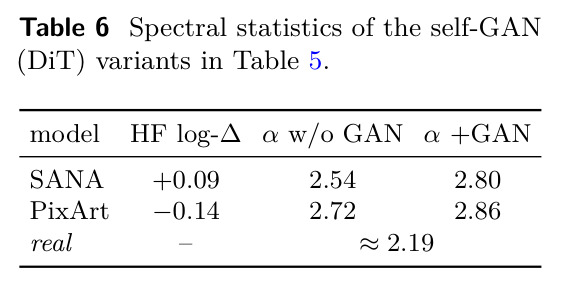
对图像亮度通道做 2D 汉宁窗加窗 FFT,再对恒定空间频率的圆环做方位角平均得到 $P(f)$,自然图像满足幂律 $P(f) \propto f^{-\alpha}$,$\alpha \approx 2$(COCO 约 2.19)。$\alpha$ 越大说明功率随频率衰减过快,即高频不足、图像偏软偏糊;趋近 0 则说明混入白噪声式伪影。
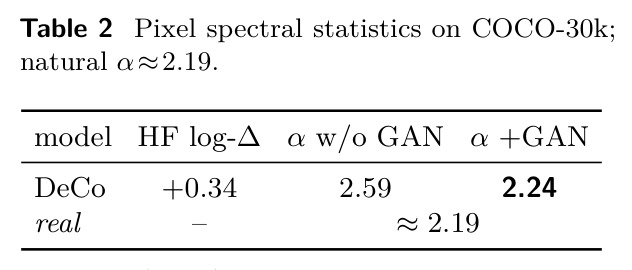
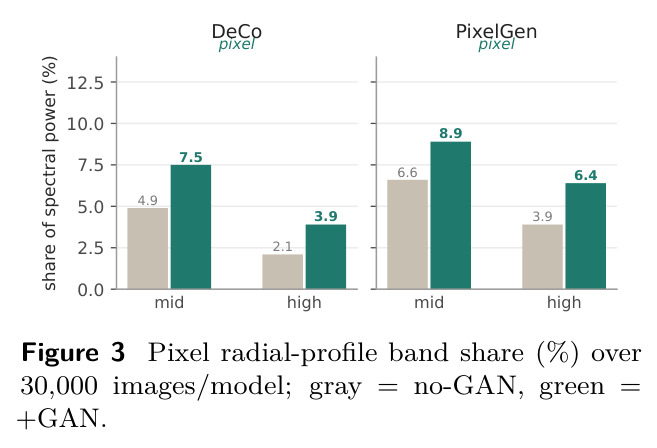
这是论文诊断像素模型'系统性欠产高频'的核心测量工具:DeCo 基线 $\alpha=2.59$,加 GAN 后降到 2.24、贴近真实图像的 2.19,把'更清晰'从主观感受变成可量化的谱证据。
铰链对抗损失(hinge GAN)
生成器最小化 $\mathcal{L}_G = w_{\text{gan}}\,\mathbb{E}[-D(h(\hat{y}_0))]$,判别器最小化 $\mathcal{L}_D = \tfrac{1}{2}\mathbb{E}[\mathrm{relu}(1-D(h(y_0)))] + \tfrac{1}{2}\mathbb{E}[\mathrm{relu}(1+D(h(\hat{y}_0)))]$。其中 $\hat{y}_0$ 是模型预测的干净图像,$h$ 是到判别器输入空间的映射(像素模型中为恒等映射)。
理解方法的关键:对抗损失不是替代而是叠加在原扩散/流匹配目标之上,且只施加在预测的 $\hat{x}_0$ 上而非噪声样本上,这使原有生成分布能力得以保留。
信噪比时间步门控
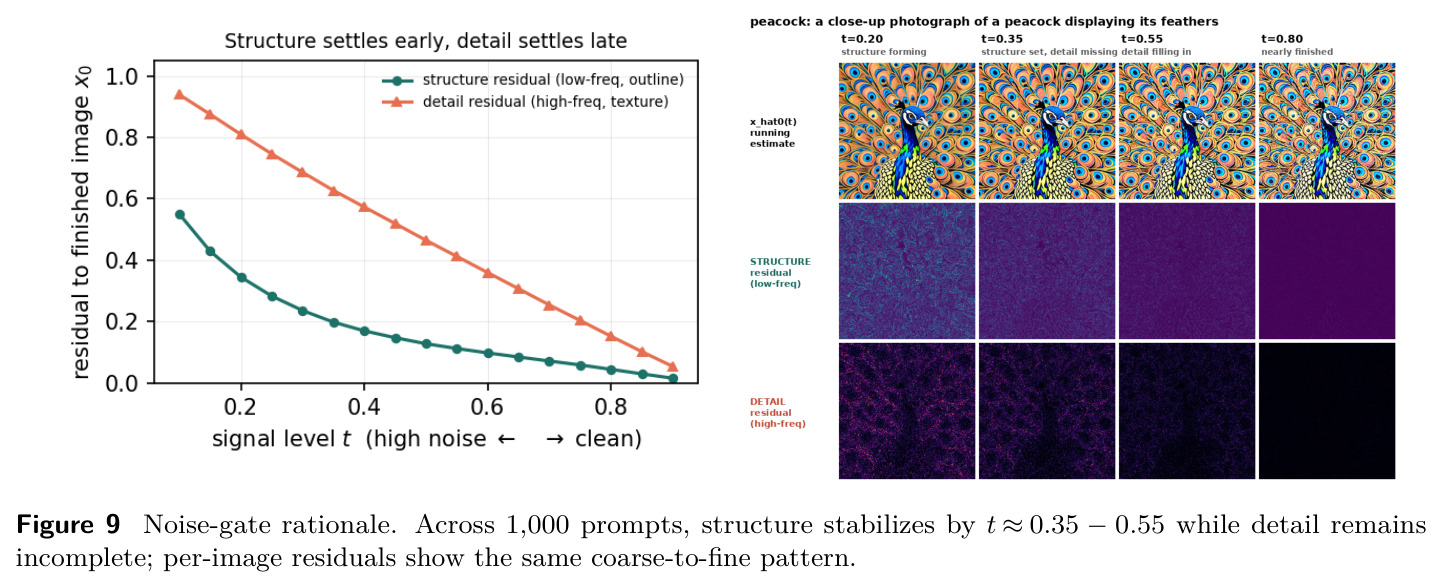
扩散采样是先粗后细的过程:低噪声时刻全局结构已定型但细节未补全。本文用信号分数门 $\alpha_t = 1 - \sigma_t \ge \tau$ 只在非高噪声时刻施加对抗损失。图 9 显示结构残差在 $t \approx 0.35$ 就已收敛趋平,而细节残差直到 $t=1$ 才消失。
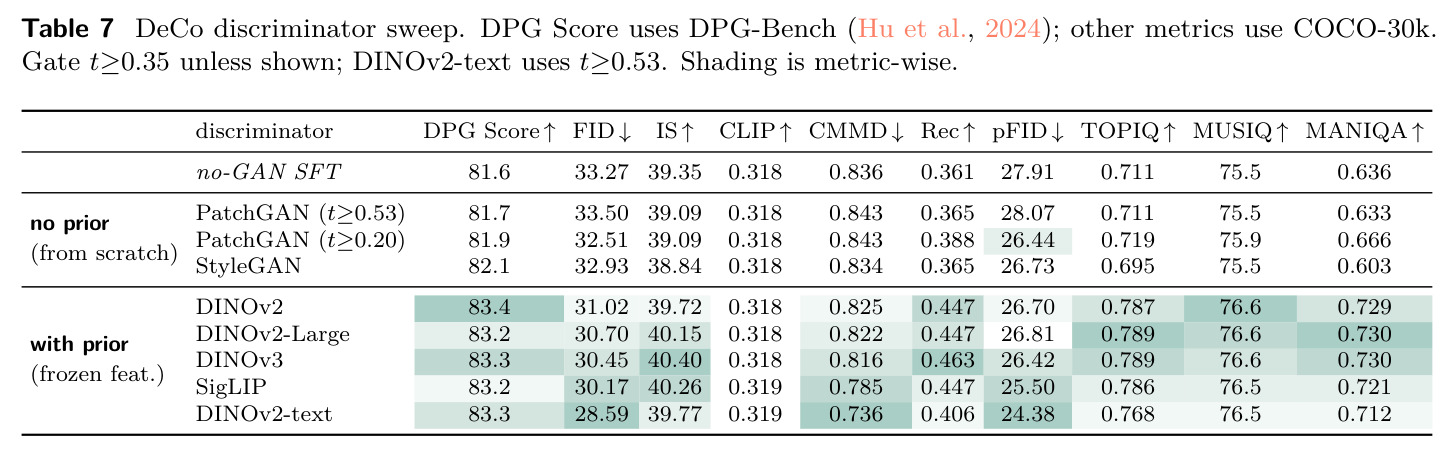
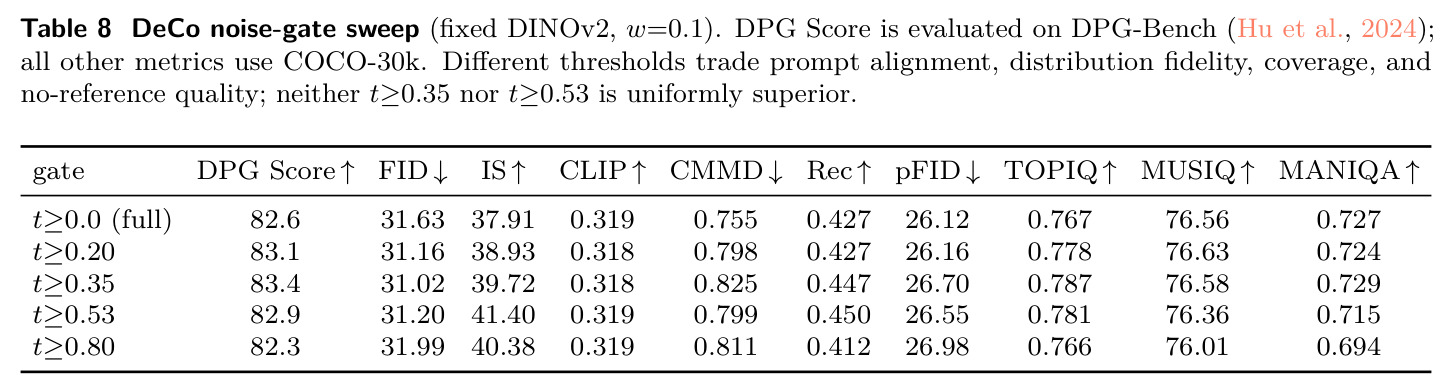
门控位置决定了 GAN 是'在正确形状上补细节'还是'把细节推到未成形的结构上'。论文扫描了多个门限($t \ge 0.35$ 与 $t \ge 0.53$),发现没有单一最优,只有面向不同指标的多个可用工作点。
FID / CMMD / recall / DPG Score
FID 衡量生成图像与真实图像在 Inception 特征空间的分布距离(越低越好);CMMD 是基于 CLIP 特征的低偏差替代指标;recall 衡量对真实分布的模式覆盖率(防模式坍缩);DPG Score 基于 DPG-Bench 衡量图文对齐度;TOPIQ/MUSIQ/MANIQA/NIQE 是无参考图像质量评价。
论文主张'联合提升'——单一指标变好容易(如感知损失也能刷高 TOPIQ),但 FID、recall、DPG、IQA 同时变好才能证明 GAN 修正不是以牺牲多样性或对齐为代价。
输出可达性算子 $A_H = P_H J_h$
论文提出的机制探针:$J_h$ 是从模型原生输出到判别器输入空间的雅可比,$P_H$ 是向高频带的投影。像素模型中 $h$ 是恒等映射,$A_H$ 响应强;潜空间模型中 $h$ 是冻结 VAE 解码器,相同幅度的原生输出扰动经 $A_H$ 测得的解码高频响应弱 3.5–11 倍。
这是'何时有效'问题的直接实验证据:潜空间路线不是梯度被阻断,而是影响解码后高频的方向被衰减,解释了为何同样的 GAN 后训练在 PixArt/SANA 上失效。
研究动机
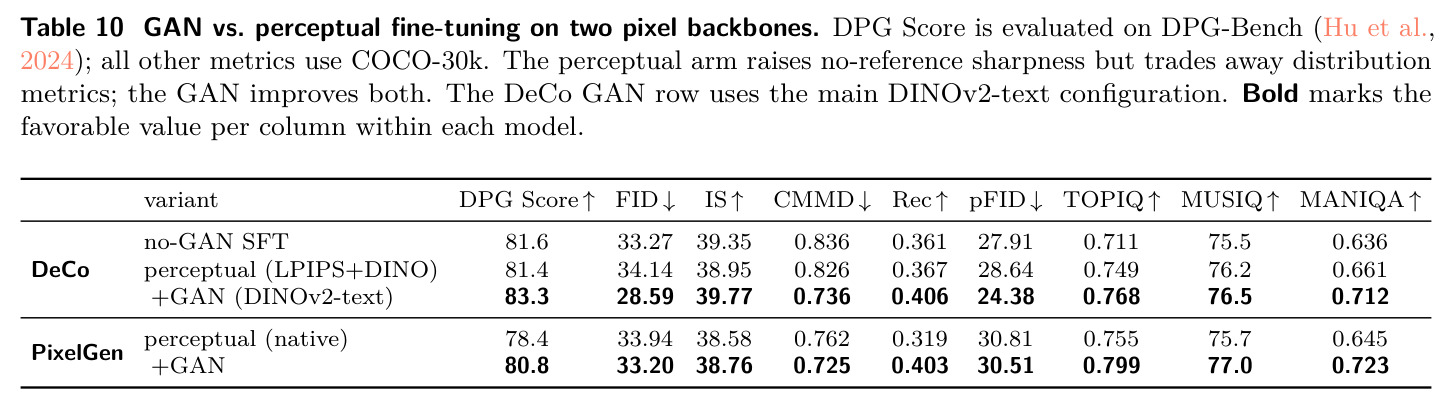
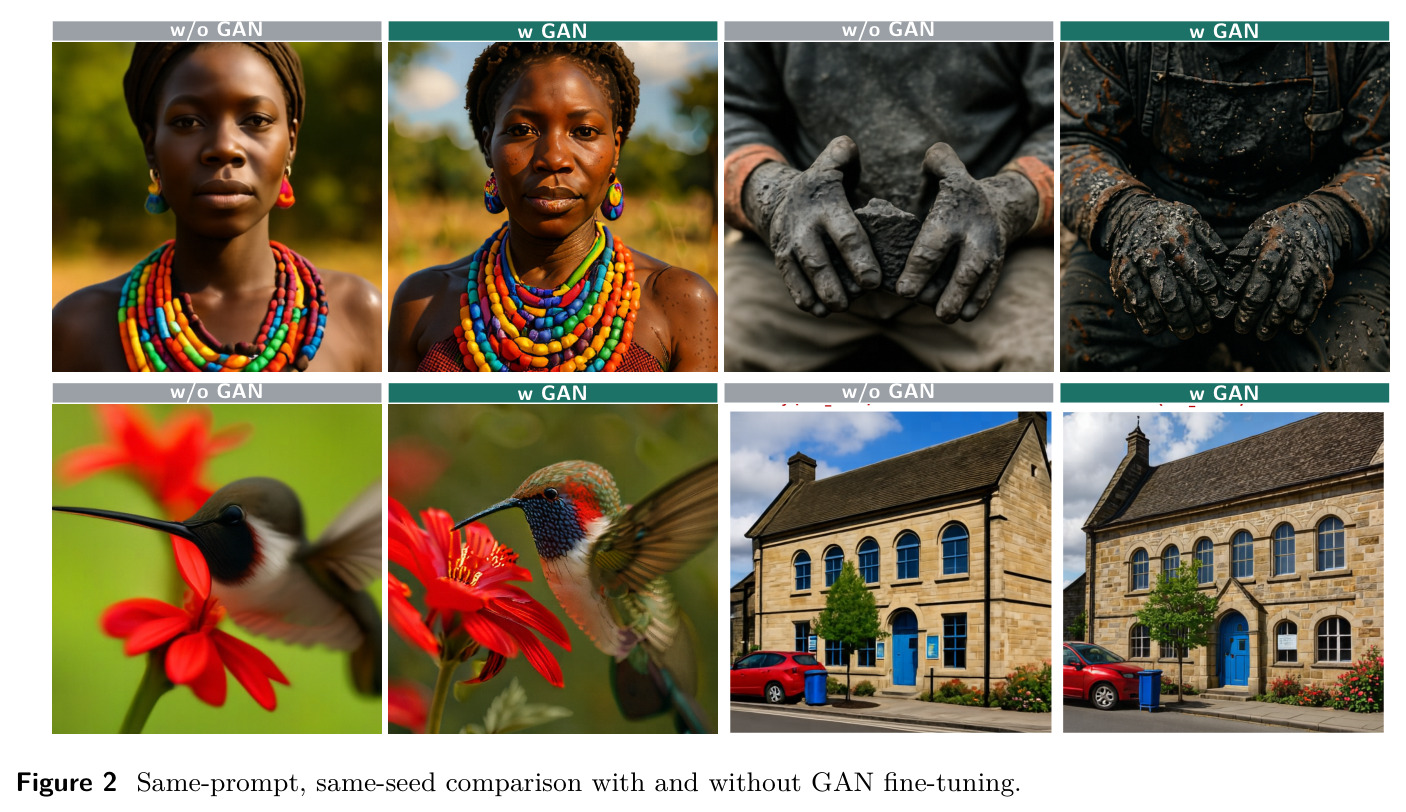
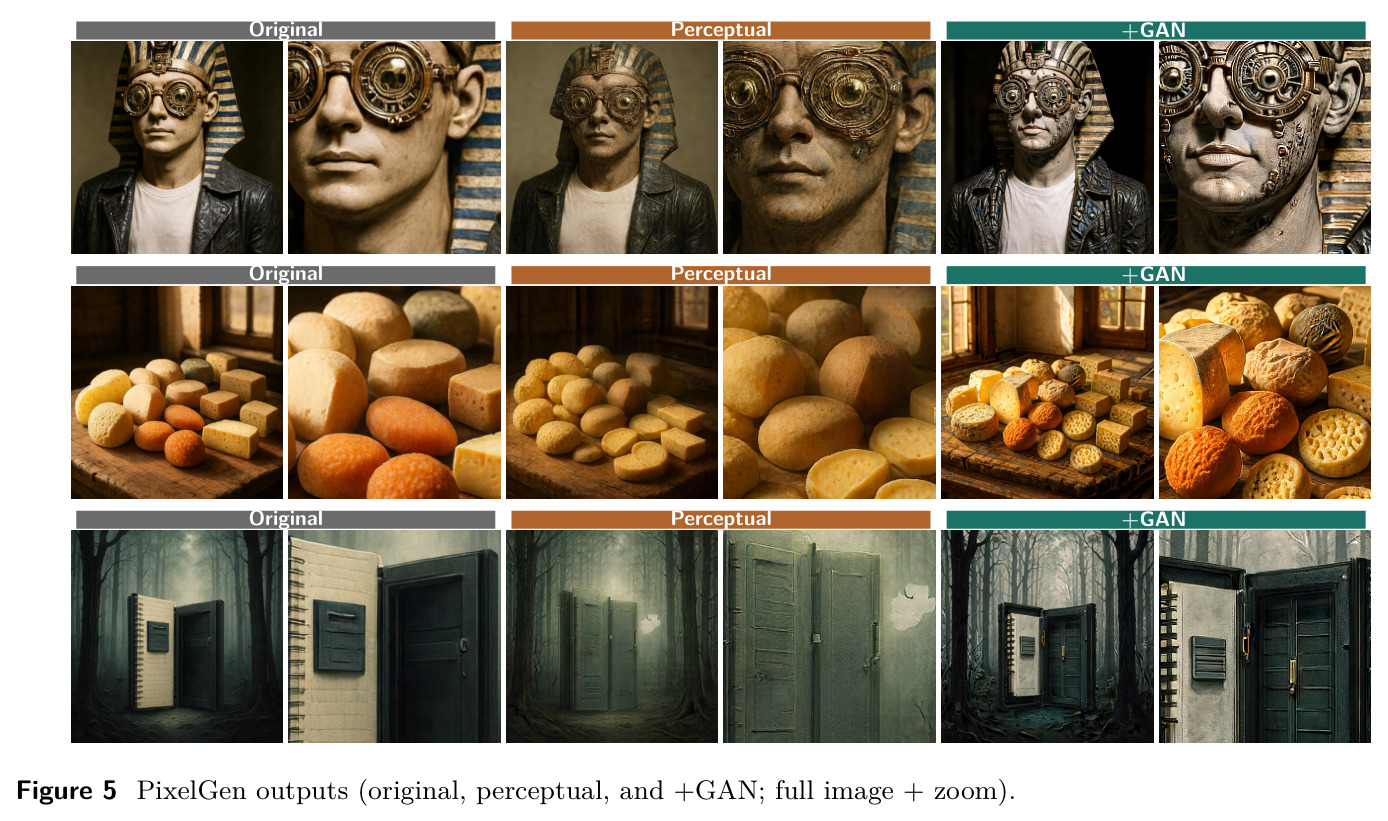
像素扩散模型直接生成 RGB 图像、避免了自编码器瓶颈,但收敛后的输出仍系统性地欠表示自然图像的细尺度统计特性:在径向功率谱上,DeCo 基线的幂律斜率 $\alpha = 2.59$,显著陡于真实 COCO 图像的约 2.19,说明高频能量不足,生成图像肉眼可见地平滑、缺乏纹理(论文 Figure 1)。与此同时,潜空间扩散范式里对抗损失只被用在两个传统位置——VAE/tokenizer 的解码器训练(配合 LPIPS 的 patch-GAN)以及一步/少步蒸馏(ADD、DMD)——从来没有人把对抗损失当作已收敛多步模型的纯质量修正项来研究,像素扩散上更是完全空白。简单的替代方案各有缺陷:感知损失(LPIPS+DINO)虽也能加高频,却会引入去饱和、低对比度的色彩域偏移;无参考质量指标无法区分真实质感与过锐化伪影。
本文的目标是本文的目标是验证并刻画一个具体假设:对已收敛的预训练像素文生图扩散模型,保留其原始扩散/流匹配目标不变,仅在预测的干净图像 $\hat{x}_0$ 上、于非高噪声时间步叠加一个铰链对抗损失(记作 +GAN),就能在不改变模型架构、不改变采样步数、不使用偏好标签或奖励模型、不做蒸馏的前提下,联合提升分布保真度(FID/CMMD/pFID)、模式覆盖(recall)、提示词对齐(DPG Score)和无参考感知质量(TOPIQ/MUSIQ/MANIQA)。更进一步,论文要回答三个递进问题:是否有效(whether)、为何有效(why,指向高频谱缺失的修正)、何时有效(when,像素与潜空间的机制对比)。
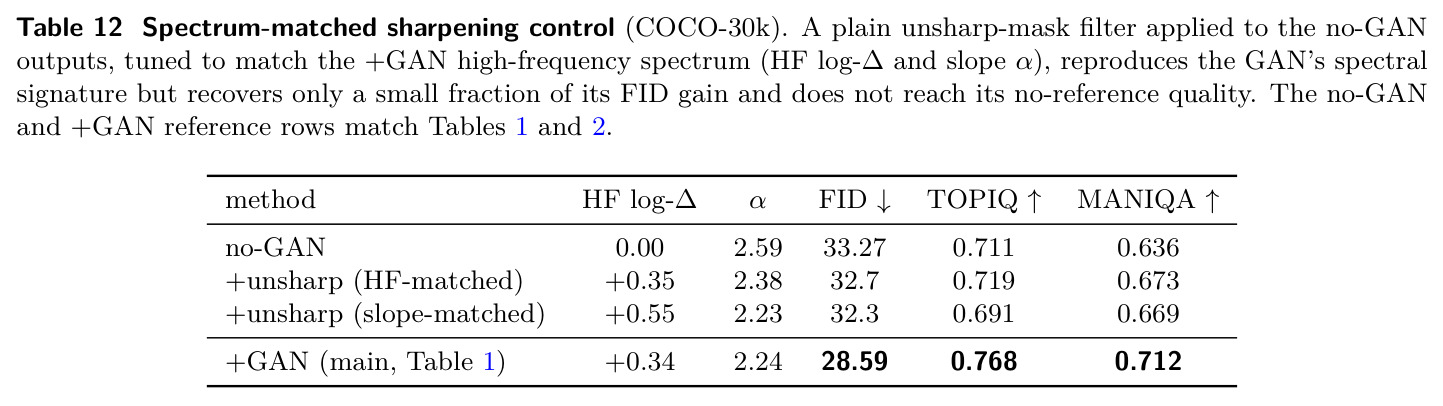
与已有工作不同的是,论文的独特切入角度有三点。第一,重新定位对抗损失的角色:现有文献中 GAN 在扩散体系里只服务于 tokenizer 训练或步数蒸馏,本文首次把它作为多步已收敛模型的纯质量后训练项系统研究,被试是 DeCo 和 PixelGen 两个公开像素骨干。第二,把'为什么有效'归因到可测量的谱机制上——用频段功率占比和幂律斜率证明基线模型欠产高频、GAN 恢复的正是这部分缺失功率,并通过与谱匹配的 unsharp-mask 滤波对照(FID 最好只到 32.3,远逊于 GAN 的 28.59)排除'泛锐化'解释。第三,用像素-潜空间配对实验加 $A_H$ 雅可比探针,提出并验证'输出可达性'这一机制性条件:修正必须能直接触达最终图像统计量,这为'对抗后训练在哪类模型上可行'给出了普适判据。
核心方法
方法在直觉上很简单:收敛的扩散模型已经把全局结构学对了,剩下的错误集中在细节纹理层,而判别器恰好在纹理分布层面最敏感,所以让一个冻结特征骨干判别器来'挑剔'预测图像的高频质感即可。技术路线上,从收敛检查点出发继续训练:生成器损失为原扩散/流匹配目标加上 $\mathcal{L}_G = w_{\text{gan}}\,\mathbb{E}[-D(h(\hat{y}_0))]$;判别器用铰链损失 $\mathcal{L}_D = \tfrac{1}{2}\mathbb{E}[\mathrm{relu}(1-D(h(y_0)))] + \tfrac{1}{2}\mathbb{E}[\mathrm{relu}(1+D(h(\hat{y}_0)))]$,其中 $y_0$ 是模型原生输出空间的干净目标(DeCo/PixelGen 为 RGB $x_0$,SANA/PixArt-$\alpha$ 为潜码 $z_0$)。对速度预测的 DeCo/SANA,$y_t = (1-\sigma_t)y_0 + \sigma_t\epsilon$,$\hat{y}_0 = y_t - \sigma_t v_\theta(y_t, t)$;PixelGen 直接预测 $\hat{x}_0$。判别器主体是冻结的 DINOv2/DINOv3/SigLIP 特征加文本条件投影头(StyleGAN-T 式),整个流程不减少采样步数、不需要任何偏好数据。所有定量实验基于 BLIP3o-60k 数据集微调公开检查点,GAN 与 no-GAN 对照共享相同起始检查点、数据和训练时长。
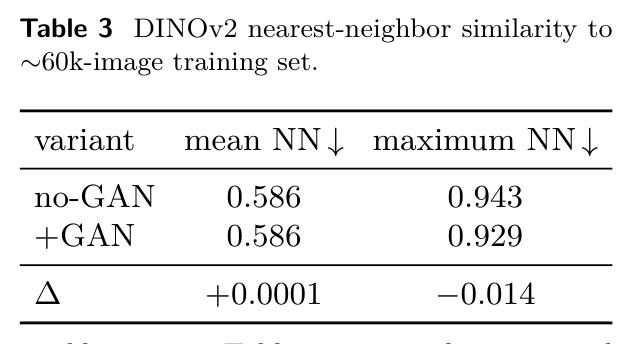
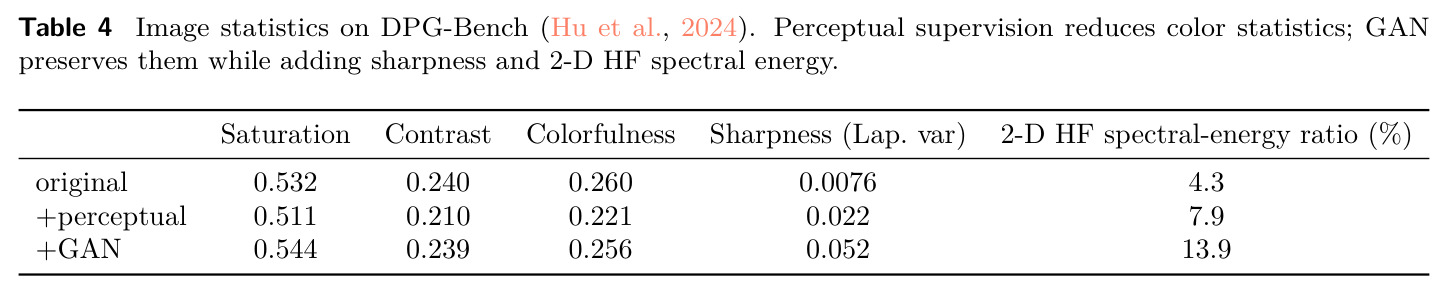
核心创新是把对抗损失从'架构组件'降格为'外科手术式的质量修正项',并配上一套机理解释。与已有工作的本质区别有三:(1)与 tokenizer 中的 GAN 不同,这里判别器直接打在扩散模型自身的输出上,而像素模型中 $h$ 是恒等映射,修正可以无损地落到最终像素;(2)与 ADD/DMD 等蒸馏不同,这里不追求步数压缩,扩散目标原样保留,因此不牺牲多样性和对齐——recall 反而从 0.361 升到 0.406 而非下降,DINOv2 最近邻相似度均值不变(0.586)、最大值还降低(0.929 vs 0.943),排除了模式坍缩和记忆化;(3)与感知损失对照揭示的机制:两者都能加高频,但感知损失伴随饱和度 0.532→0.511、对比度 0.240→0.210 的色彩域偏移而 GAN 保持(0.544/0.239),且谱匹配的锐化滤波无法复现 GAN 的 FID 增益,证明增益来自'恢复自然高频统计'而非'泛锐化'。时间步门控 $\alpha_t = 1-\sigma_t \ge \tau$ 进一步保证对抗信号只在结构已定型、细节仍缺失的窗口生效。
方法步骤详情
第一步,准备配对实验:选取 DeCo、PixelGen 两个像素骨干与 PixArt-$\alpha$(0.61B)、SANA(1.6B)两个潜空间骨干,统一在 BLIP3o-60k 上从公开检查点微调,GAN 组与 no-GAN SFT 对照组共享相同检查点、数据与训练步数,保证比较公平。第二步,构造判别器:冻结 DINOv2/DINOv3/SigLIP 提特征,接文本条件投影头;消融中还测试了从零训练的 PatchGAN/StyleGAN 判别器、以及作用在 SANA 预测潜码上的轻量 Feature-PatchGAN。第三步,定义时间步门控:仅在 $\alpha_t = 1-\sigma_t \ge \tau$ 的时刻对 $\hat{x}_0$ 施加对抗项,主配置 DINOv2-text 用 $t \ge 0.53$,固定 DINOv2 消融用 $t \ge 0.35$。第四步,联合训练:每步同时优化扩散/流匹配损失与对抗损失,权重 $w_{\text{gan}} = 0.1$ 为参考工作点,VAE 在所有潜空间实验中保持冻结,只优化扩散模型与判别器。第五步,四组评估:DPG-Bench 测对齐;COCO-30k 测 FID/pFID/CMMD/IS/recall/CLIP;TOPIQ/MUSIQ/MANIQA/NIQE 测无参考质量;径向功率谱测 $\alpha$ 与高频段 log 功率变化。第六步,机制验证:unsharp-mask 谱匹配对照、感知损失配对比较、潜空间三种判别器位置对比,以及通过冻结 PixArt VAE 的 $A_H = P_H J_h$ 输出可达性扰动探针。
技术新颖性
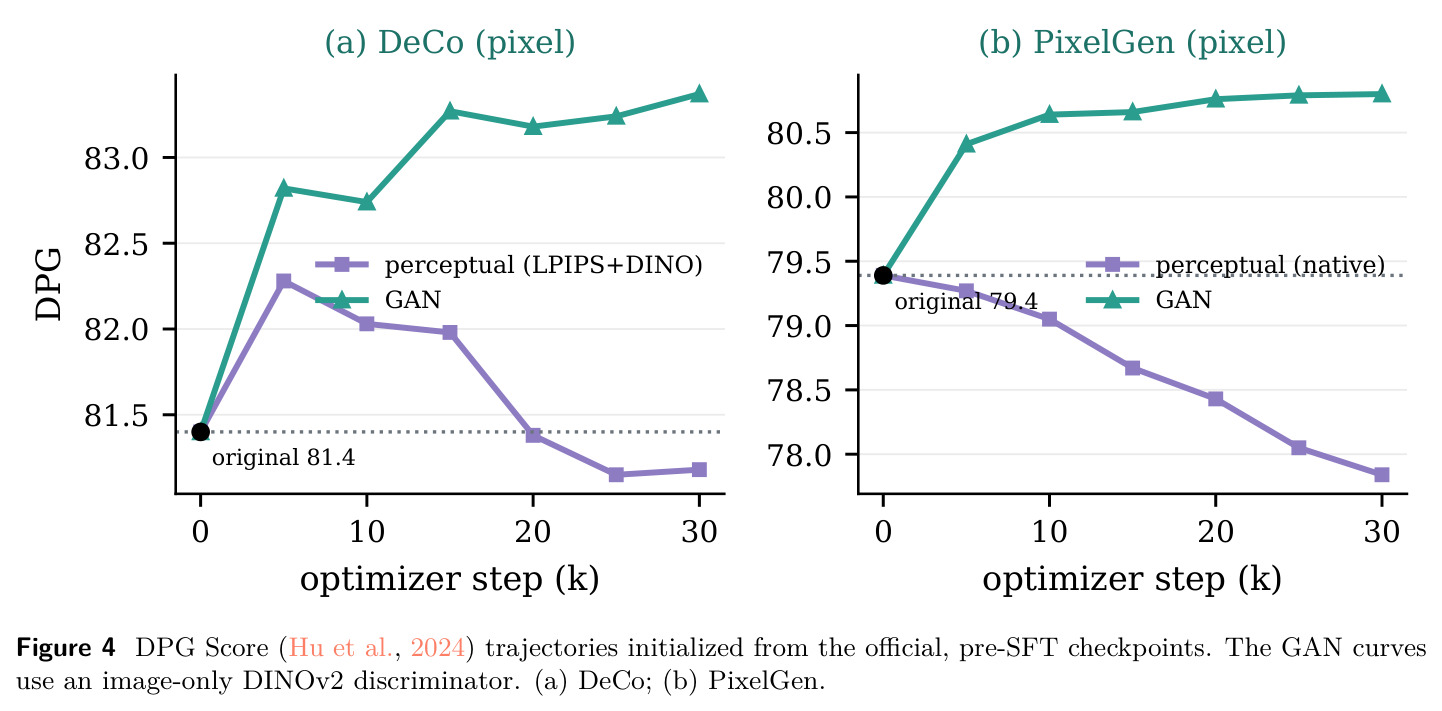
技术新颖性体现在四个层面。第一,问题定位新颖:这是首个针对像素扩散的系统性 GAN 后训练研究,填补了对抗损失在扩散体系中只用于 tokenizer 和蒸馏的空白。第二,诊断工具新颖:把天体物理和 GAN 保真性分析中常用的方位角平均功率谱方法引入扩散质量诊断,用 $\alpha$ 斜率(DeCo 从 2.59 修到 2.24,真实约 2.19)和未归一化高频 log 功率变化 $\Delta$(+0.34 dex)把'更清晰'变成可证伪的谱学命题,并证明增加的能量是相干纹理而非噪声($\alpha$ 未趋向 0)。第三,机制论证新颖:提出两条件论——可修正的输出子空间误差加上训练输出到该子空间的局部可达性——并用 $A_H = P_H J_h$ 探针定量测得 VAE 使解码高频响应弱 3.5–11 倍、VAE 编解码本身使真实图像谱斜率升至 2.48 并损失约 0.2 dex 高频功率,把像素-潜空间的效果差异从经验观察提升为机制解释。第四,实验设计严谨:所有结论都建立在 GAN 与同起点同训练量的 no-GAN SFT 对照、预 SFT 检查点轨迹(Figure 4)以及 1065 对 DPG-Bench 匹配对的胜率评估之上,排除了额外优化带来的混淆。
实验结果
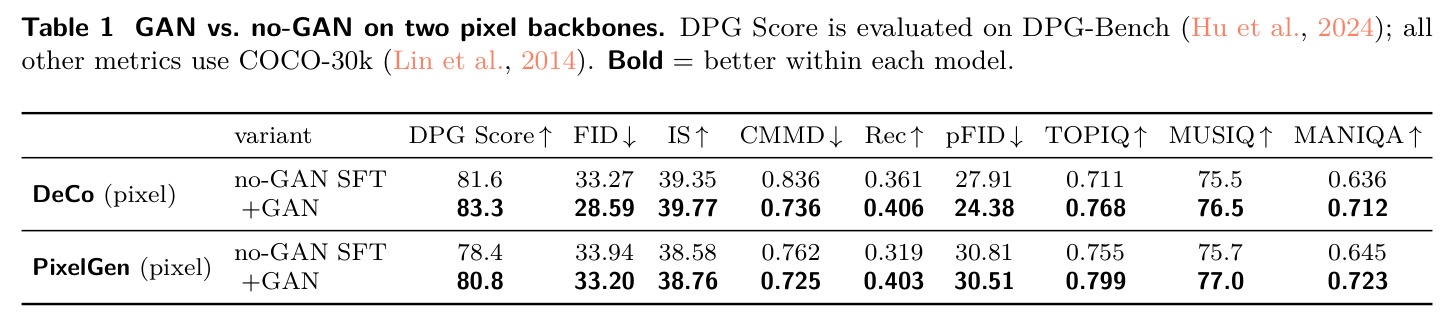
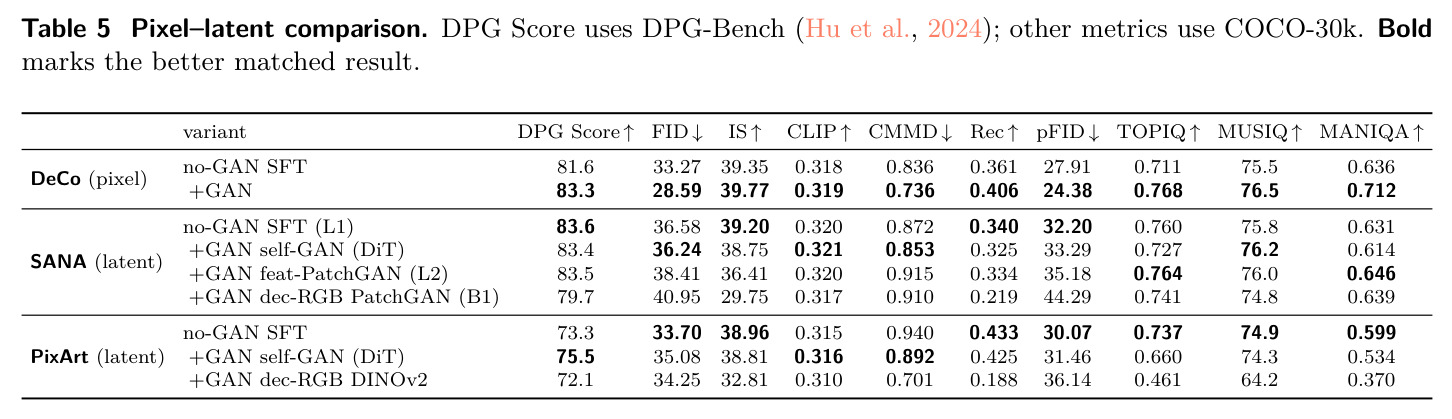
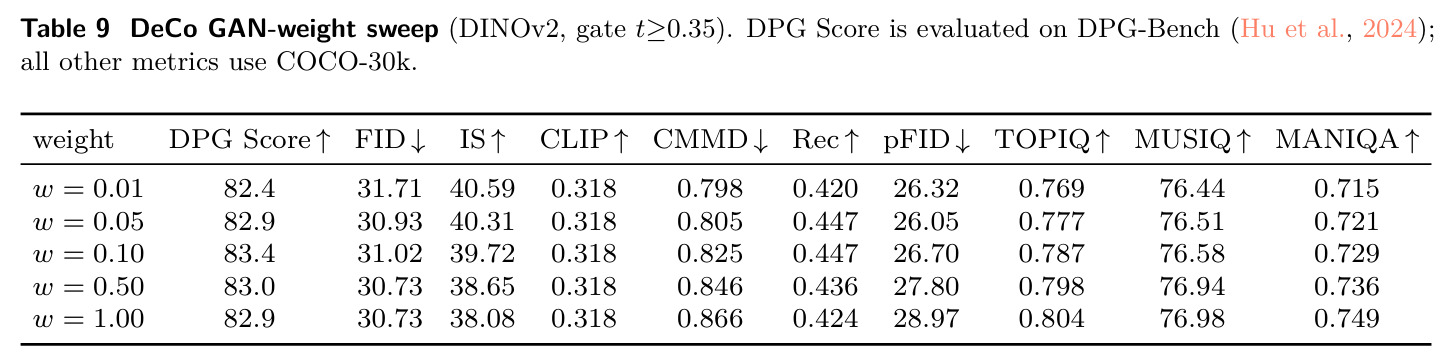
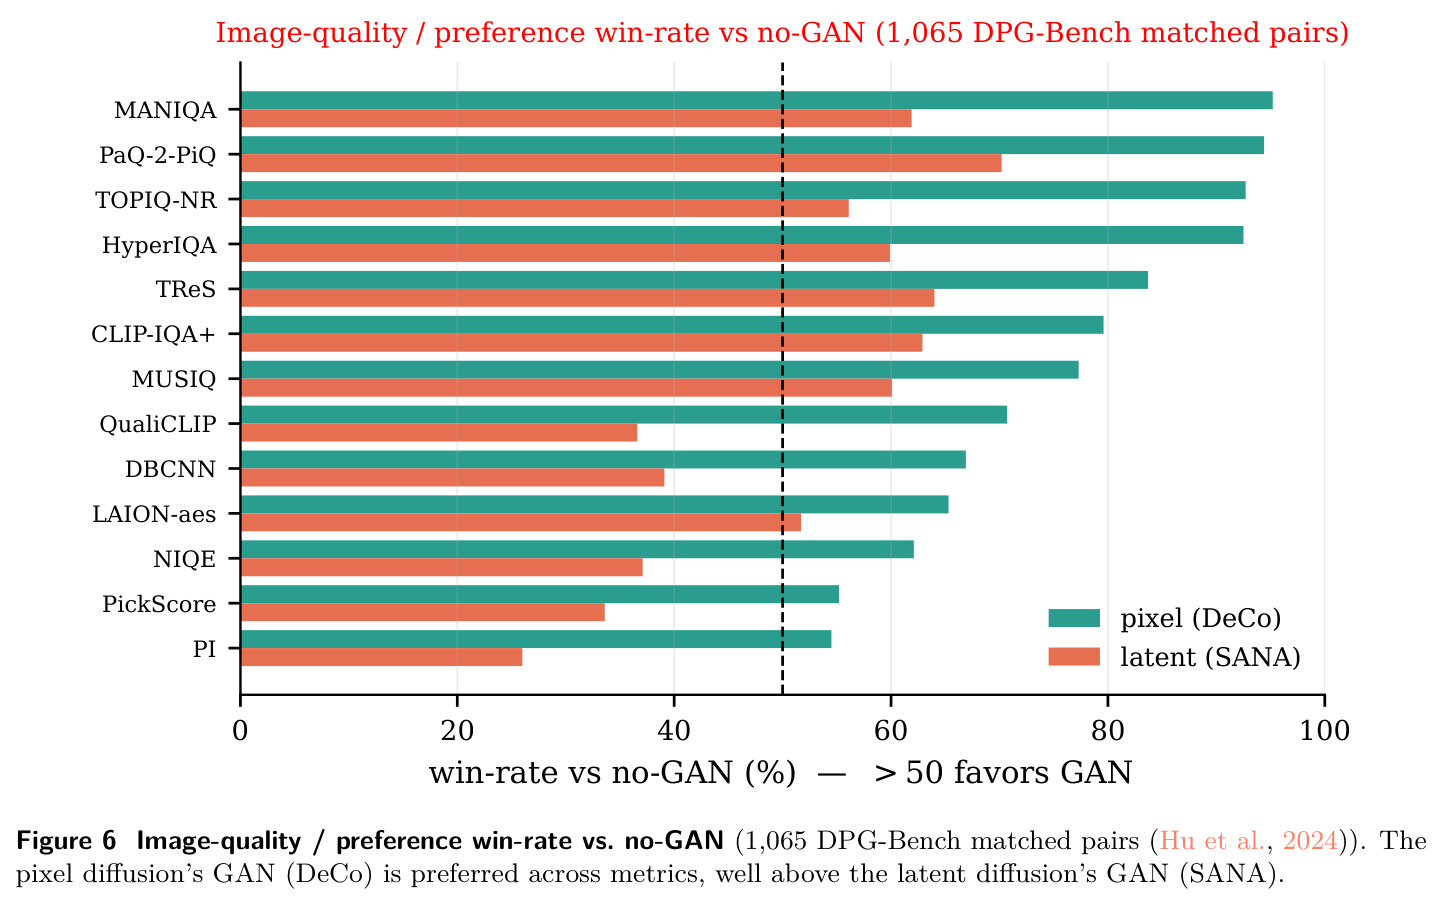
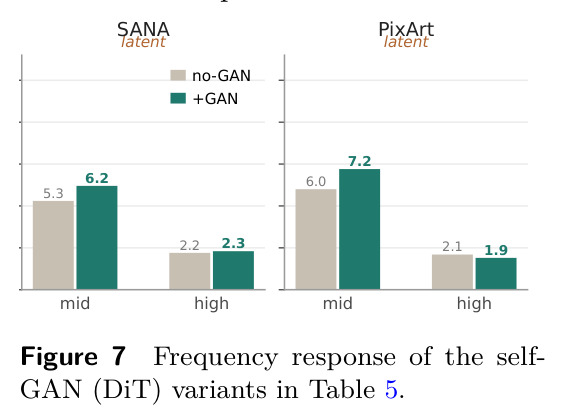
核心发现一:对抗后训练在两个像素骨干上实现全指标联合提升(Table 1)。DeCo 上 FID 33.27→28.59、pFID 27.91→24.38、CMMD 0.836→0.736、recall 0.361→0.406、IS 39.35→39.77、TOPIQ 0.711→0.768、MUSIQ 75.5→76.5、MANIQA 0.636→0.712、DPG Score 81.6→83.3;PixelGen 上 DPG 78.4→80.8、FID 33.94→33.20、recall 0.319→0.403、TOPIQ 0.755→0.799,同样全面占优。核心发现二:增益来自恢复缺失高频(Table 2、Figure 3):DeCo 中频功率占比 4.9%→7.5%、高频 2.1%→3.9%;PixelGen 中频 6.6%→8.9%、高频 3.9%→6.4%;DeCo 高频 log 功率 +0.34 dex,$\alpha$ 从 2.59 降到 2.24,贴近真实的 2.19 且未趋向白噪声。核心发现三:不是泛锐化、不是模式坍缩、不是记忆化——谱匹配 unsharp-mask 最好只把 FID 降到 32.3(GAN 为 28.59);recall 上升;最近邻相似度均值 +0.0001 不变、最大值 0.943→0.929 反而下降(Table 3)。核心发现四:感知损失路线失败(Table 4、10):TOPIQ 升至 0.749 但 FID 恶化到 34.1、DPG 81.6→81.4,伴随饱和度 0.532→0.511、色度 0.260→0.221 的域偏移;而真实照片本身 TOPIQ 仅 0.57,说明无参考指标会误导。核心发现五:潜空间模型无等效增益(Table 5):SANA 三种判别器位置(self-GAN DiT / Feature-PatchGAN / dec-RGB PatchGAN)与 PixArt 两种配置均无联合改善,dec-RGB 变体甚至崩溃(SANA dec-RGB PatchGAN 的 FID 40.95、recall 0.219);解码后高频占比几乎不动(SANA 2.2%→2.3%,PixArt 2.1%→1.9%,Figure 7);$A_H$ 探针测得 VAE 对解码高频的响应弱 3.5–11 倍(Figure 8)。核心发现六:消融给出多个工作点而非唯一最优(Table 7/8/9):冻结预训练骨干判别器(FID 28.6–31.0)优于从零训练(32.5–33.5);门控 $t\ge0.35$ 偏重 DPG 与 IQA、$t\ge0.53$ 偏重 IS/recall;权重 $w=0.1$ 为参考点,增大权重单调提升无参考锐度但损害分布指标。Figure 6 的 1065 对人评式胜率测试确认像素 GAN 在 12 项质量/偏好指标上全面超过 50% 而潜空间 GAN 多数低于 50%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| COCO-30k 文生图分布保真度(DeCo 骨干) | FID ↓ | 28.59(+GAN) | 33.27(no-GAN SFT) | 降低 4.68,约 14% |
| COCO-30k 模式覆盖(DeCo) | Recall ↑ | 0.406 | 0.361 | +0.045,反常地不降反升 |
| DPG-Bench 提示词对齐(DeCo) | DPG Score ↑ | 83.3 | 81.6 | +1.7;从官方预 SFT 检查点出发则 81.4→83.4 |
| COCO-30k 补丁级保真度(DeCo) | pFID ↓ | 24.38 | 27.91 | 降低 3.53 |
| COCO-30k CLIP 特征距离(DeCo) | CMMD ↓ | 0.736 | 0.836 | 降低 0.100 |
| 无参考感知质量(DeCo) | TOPIQ ↑ / MANIQA ↑ | 0.768 / 0.712 | 0.711 / 0.636 | +0.057 / +0.076 |
| 自然图像谱匹配(DeCo,COCO-30k) | 功率律斜率 $\alpha$(真实≈2.19) | 2.24(高频 log 功率 +0.34 dex) | 2.59 | 距离真实值差距从 0.40 缩到 0.05 |
| COCO-30k 全指标(PixelGen 骨干) | DPG / FID / recall / TOPIQ | 80.8 / 33.20 / 0.403 / 0.799 | 78.4 / 33.94 / 0.319 / 0.755 | 九项指标全部占优 |
| DPG-Bench 匹配对人评式胜率 | 12 项 IQA/偏好胜率 vs no-GAN | 像素(DeCo)GAN 全部 >50% | 潜空间(SANA)GAN 多数 <50% | 像素-潜空间优势贯穿全部指标 |
| 输出可达性扰动探针(PixArt VAE) | 解码高频响应倍数 | 像素恒等映射为参照 | 冻结 VAE 解码 | VAE 响应弱 3.5–11 倍 |
局限与改进
作者明确承认的局限:消融实验(判别器设计、门控、权重)只展示趋势、各配置 favor 不同指标,没有给出全指标占优的普适最优配置,把选择留给目标指标的权衡;论文反复声明结论限于'所测试的配置'——潜空间失败结论仅覆盖 PixArt-$\alpha$ 和 SANA 两个模型及三种判别器位置,不能排除更强的潜空间方案(例如联合微调解码器、或可训练 tokenizer)有效;$\alpha$ 接近 2 只说明谱形状正确,不能证明语义细节全部正确。我自己观察到的局限:其一,评估主要在 COCO-30k 与 DPG-Bench 上进行,缺少大规模人工偏好评测(如人评 ELO)和更难的非 COCO 分布外提示,28.59 的 FID 绝对值仍远未达到 SOTA 文生图水平,方法的价值是'修正'而非'追平';其二,训练在 BLIP3o-60k 这个小规模数据集上进行,与许多 T2I 后训练工作一样未报告与 RLHF/DPO 类方法的对比,'不用偏好标签'是否真的优于有偏好数据的方案尚无直接证据;其三,判别器依赖 DINOv2 等冻结特征,其归纳偏置可能引入隐蔽的分布偏移,论文只测了色彩统计未做更细的伪影分析;其四,高频增益在 512² 分辨率验证,更高分辨率下门控阈值与权重是否需要重调没有探讨。
独立分析的弱点
弱点一:潜空间失败结论的外部效度受限。论文只测试了把判别器打在预测潜码或冻结解码后的 RGB 上,'输出可达性弱'是针对固定 VAE 的机制结论;一个显然的改进方向是联合微调 VAE 解码器或对其做 LoRA 适配,让 $A_H$ 响应恢复后再施加 GAN,这能直接检验机制的因果性并可能拯救潜空间路线。弱点二:无参考指标的悖论没有被解决——论文自己指出真实照片 TOPIQ 只有 0.57,低于所有生成变体,说明这套 IQA 体系本身奖励过锐化,那么'MANIQA 0.636→0.712'到底有多少是真实质感提升、有多少是指标偏好,需要引入人评或分布层面的感知指标来交叉验证。弱点三:超参数依赖面广(判别器骨干选择、门限 $\tau$、权重 $w$ 三者相互耦合,Table 7/8/9 显示不同组合 favor 不同指标),实践者难以复现论文主配置的选择逻辑,改进方向是把配置搜索形式化为多目标优化并给出自动选择准则。弱点四:对抗训练的稳定性风险被轻描淡写——只报告了短训练窗口内的 DPG 轨迹(Figure 4 最长 30k 步),缺少判别器过拟合、生成器崩溃的长期训练动力学分析和失败案例展示;建议补充更长时间的训练曲线和早期停止准则。弱点五:只做了 T2I,未验证在图像编辑、超分、视频等像素输出任务上同样成立,而'输出可达性'论点其实预测这些任务也应受益,这是低成本可验证的推广实验。
未来方向
作者方向上:把门控、判别器和权重组合的系统扫描扩展为对'目标指标权衡'的自动化配置推荐;在更多像素骨干与分辨率上验证;探索潜空间模型上恢复输出可达性的方案(如可训练解码器)。基于成果可延伸的方向:其一,把 $A_H = P_H J_h$ 探针发展成架构设计工具——在新模型训练前就评估其原生输出对高频的可达性,预测对抗后训练的收益上限;其二,将本方法与 RLHF/DPO 类偏好优化结合,用 GAN 修谱、用偏好学习修语义,二者作用子空间不同、可能正交;其三,将同样的'恢复自然谱统计'目标用于视频扩散,视频的高频时间维统计是否同样被欠产是开放问题;其四,利用论文发现的'感知损失引起色彩域偏移'这一现象,设计显式的色彩/统计正则项加到感知目标上,做无 GAN 的稳定替代方案;其五,从谱学角度重新审视现有 T2I 评测集,建立以功率谱斜率为核心的细尺度质量基准,弥补 FID 对高频不敏感的问题;其六,探索在流匹配框架下理论化门控位置的选择,把 $t \approx 0.35$–0.55 的经验窗口与最优传输理论中的细节生成时刻联系起来。
复现评估
复现难度评估:中等偏高。有利条件:论文全部实验基于公开检查点(DeCo、PixelGen、PixArt-$\alpha$、SANA)和公开数据集 BLIP3o-60k(约 6 万图文对),判别器骨干 DINOv2/DINOv3/SigLIP 均为开源权重,评估协议(COCO-30k、DPG-Bench、标准 IQA 指标)全部公开可复现,方法本身是标准扩散/流匹配训练加铰链 GAN,无定制算子。不利条件:论文正文未给出学习率、batch size、训练步数、优化器等关键训练超参数(文中指向'Appendix A'但该部分不在提供的正文里),判别器文本条件投影头的具体结构、$\sigma_t$ 调度细节、门限 $\tau$ 的精确取值与主配置对应关系需要读者自行拼合;对抗训练对超参敏感,Table 7 显示判别器选择会造成 FID 从 28.6 到 33.5 的巨大波动,意味着复现者需要一定的搜索预算;算力方面需同时微调一个十亿级扩散模型和一个判别器,估计需要 8×A100 级别的多卡环境训练数天。若作者后续开源代码与配置,复现门槛将大幅降低;就目前信息而言,经验丰富的工程团队可在明确超参后可靠复现主结果(DeCo +GAN 的 FID 28.59 一线),但完整复现全部消融表格的工作量较大。
论文图表
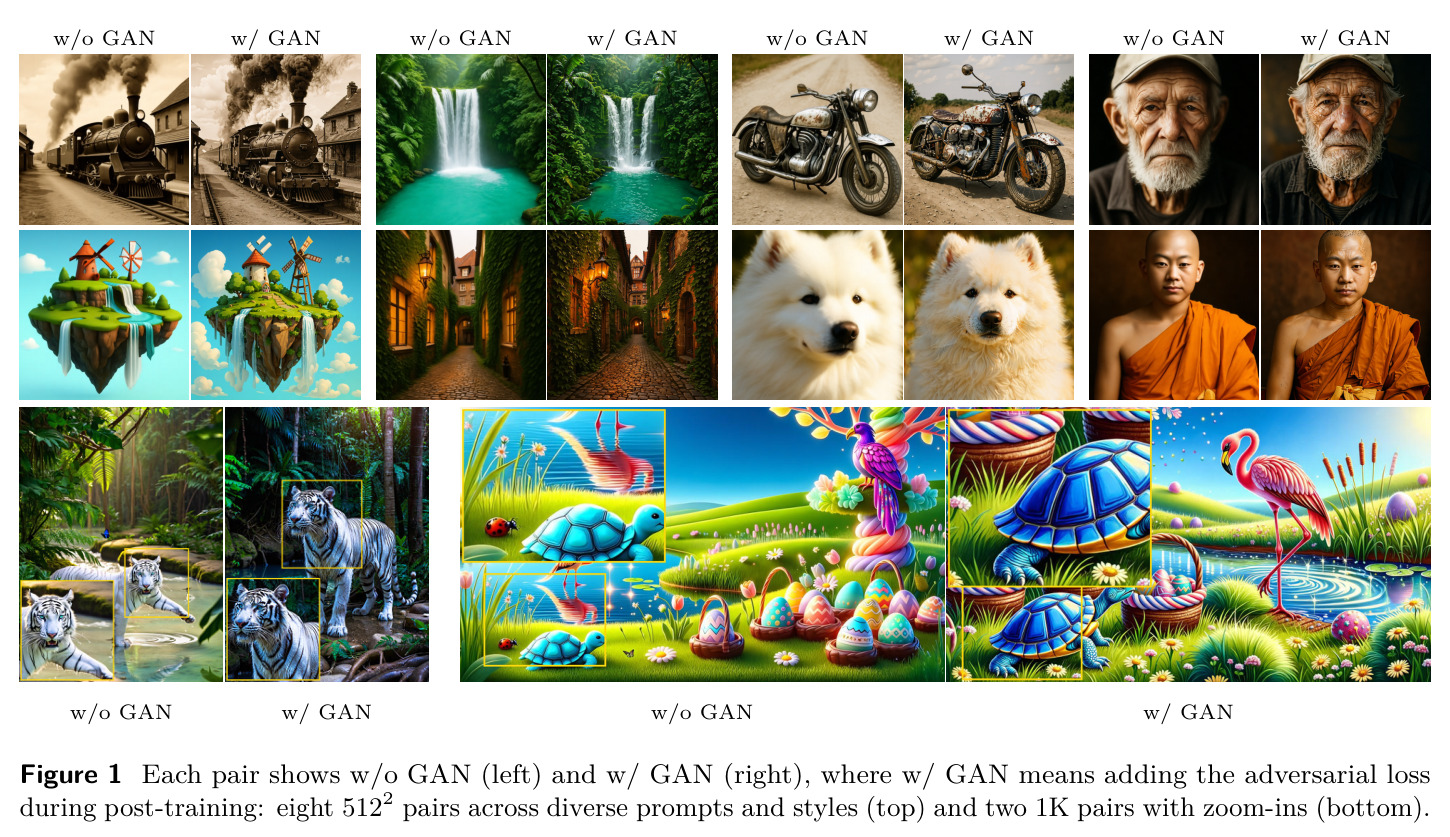
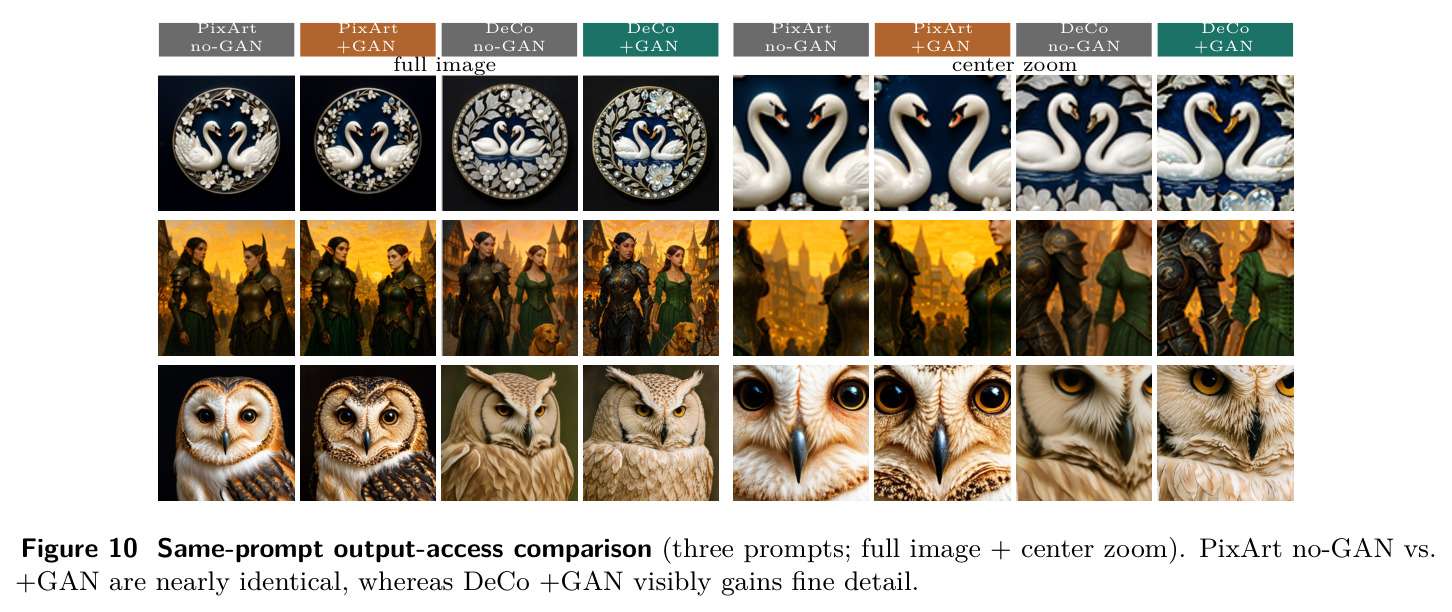
开篇对比图:上排 8 组 512×512 生成图对,下排 2 组 1024 分辨率带局部放大的图对,每组左侧为不加 GAN 的基线、右侧为加对抗损失后的结果,覆盖多种提示词与风格。
一眼看到论文动机的可视化证据:no-GAN 输出平滑、缺乏纹理,+GAN 在保持全局结构和颜色一致的前提下补齐了细颗粒细节,正是后续谱分析所量化的'高频缺失'的主观呈现。