CrossBFM:跨人形机器人具身蒸馏共享潜在行为空间 CrossBFM: Distilling a Shared Latent Behavior Space Across Humanoid Embodiments
用统一编码器把冻结行为基础模型的潜在空间跨具身蒸馏到新人形机器人,单台仅需约10 GPU小时
前置知识
Forward-Backward (FB) 表示
FB 表示是无监督强化学习中实现『零样本策略』的代表性技术。它对后继度量做有限秩近似,同时学习前向映射 $F(s,a,z)\in\mathbb{R}^d$、后向映射 $B(s)\in\mathbb{R}^d$ 和潜在条件策略 $\pi_z$,满足 $M^{\pi_z}(ds'|s,a)\approx F(s,a,z)^\top B(s')\,\rho(ds')$。训练完成后,任意奖励 $r$ 可经闭式解 $z_{rew}=\mathbb{E}_{s\sim\rho}[B(s)r(s)]$ 转成一个 latent,再由 $\pi_z(s)=\arg\max_a F(s,a,z)^\top z$ 直接执行,无需任何面向奖励的微调。
本文的核心资产正是冻结源 BFM 的后向映射 $B_S$ 定义的行为坐标系。理解 FB 才能明白为什么只要让新机器人『输出同一坐标系下的 latent』,就能一次性继承运动跟踪、目标到达、奖励优化三种提示模式,以及为什么作者只蒸馏 $B$ 而不蒸馏 $F$。
后继度量 (successor measure)
对策略 $\pi$,后继度量记录从状态-动作对 $(s,a)$ 出发、经折扣 $\gamma$ 加权后未来访问各状态集合的概率:$M^{\pi}(X|s,a)=\sum_{t\ge0}\gamma^t\Pr(s_{t+1}\in X|s,a,\pi)$。它的关键性质是把价值函数分解为『策略会走到哪里』乘『那里有多少奖励』:$Q^{\pi}_r(s,a)=\int_S M^{\pi}(ds'|s,a)\,r(s')$。因此『动力学+策略行为』可以与具体奖励解耦,离线学一次、测试时代入任意奖励。
这是 FB 表示的数学根基,解释了 BFM 潜在空间为何是 value-functional(值函数性)的——每个 latent 坐标直接对应动作价值。本文引言中批评已有跨具身方法『编码形态而非行为』,就是在对比这种性质。
行为基础模型 (Behavior Foundation Model, BFM)
BFM 是在无奖励环境下用无监督 RL 预训练的策略加潜在行为空间:一个 $d$ 维向量 $z$ 可以表示一段要模仿的运动、一个要到达的姿态或一个要最大化的奖励,测试时通过三种提示模式驱动策略而无需重训练。BFM-Zero 首次把 FB 表示的人形全身控制搬到真实机器人(经域随机化和安全奖励塑形),UFO 随后重构训练管线把 FB 预训练压缩约 5 倍,但单机器人仍需 100+ GPU 小时。
论文要解决的两个痛点都来自 BFM:训练昂贵(每机器人 100+ GPU 时)且潜在空间绑定单一机器人(换机器人即换坐标系)。理解 BFM 的提示接口才能理解『共享行为空间』到底共享了什么。
动作重定向 (motion retargeting)
把人类动捕轨迹映射到特定机器人运动学的管线,需处理关节极限、连杆长度、关键体约束等具身差异。现代重定向(如 GMR、Omniretarget)已足够快且准,既能离线处理大规模数据集,也能支撑实时遥操作。本文的独特用法是:把同一 LAFAN 动作片段分别重定向到源机器人 G1 和各目标机器人,因时间轴和帧率对齐,同一帧在各机器人上对应『同一个行为』。
重定向在本文中不是数据预处理,而是『跨具身对应关系的预言机』——它免去了跨域模仿学习中最难的对齐问题,把目标端学习从无监督 RL 降为不到 1 小时的监督回归,这是全文方法成立的基石。
知识蒸馏 (knowledge distillation)
Hinton 等人提出的模型压缩/知识迁移范式:让小的学生模型模仿大的教师模型的输出。本文中教师是冻结的源 BFM 后向映射 $B_S$,学生是统一编码器 $E_X$,训练目标是对源 latent 的逐帧余弦回归 $\mathcal{L}_{align}=\frac{1}{N}\sum_t(1-\cos(\hat z_t, z^\star_t))$。
理解这一点就能把握全文定位:不是学一个新的行为空间,而是把已有空间『蒸馏』到新具身上,因此源空间的全部语义(闭式奖励推理等)原封不动地保留。
非对称 actor-critic 与 PPO
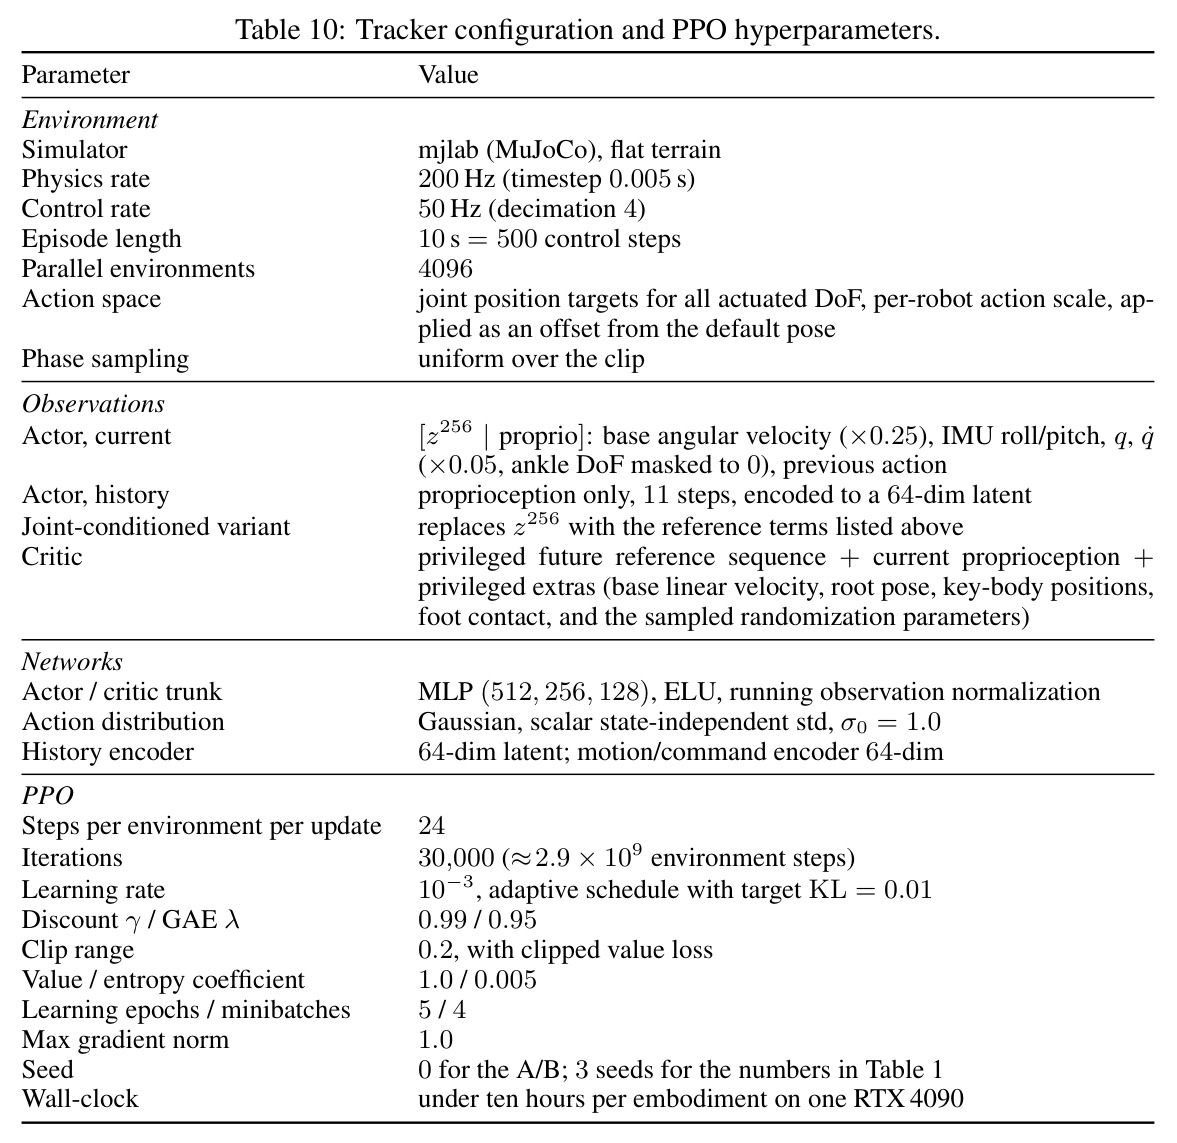
PPO 是常用的 on-policy 策略梯度算法。非对称 actor-critic 指训练时 actor 只使用部署时可得的观测(本文为 $[z_{256}|\text{proprio}]$),而 critic 额外访问仿真内特权信息(如未来参考序列、真实基座速度),既保证价值估计准确又不把不可得信息泄漏进策略。对照基线 TWIST2 是关节条件跟踪器,每步都能看到确切的参考关节角。
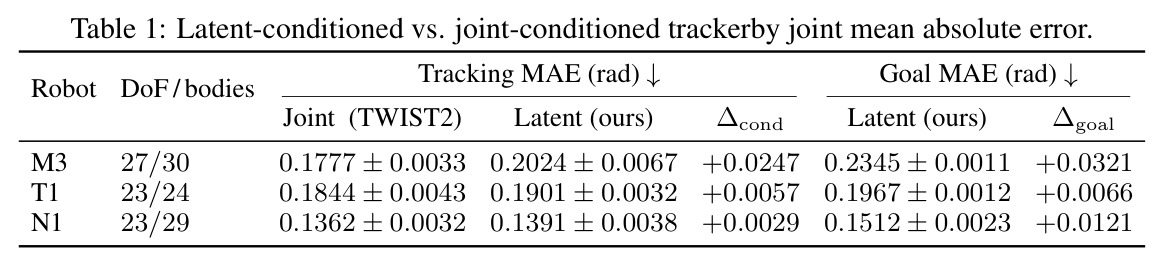
Table 1 的对比就是潜在条件 tracker(只看一个 latent)对关节条件 tracker(看逐帧参考)的 A/B 实验,二者共享奖励、终止、随机化和 PPO 预算。理解非对称结构才能明白为何 latent 条件策略能逼近关节条件的上界。
Rectified Flow / 流匹配
一类生成模型:学习速度场 $v_\theta$ 把高斯噪声沿直线路径输运到数据。训练时取插值 $z_t=(1-t)\epsilon+t z_1$,目标速度 $v^\star=z_1-\epsilon$,最小化 $\mathcal{L}_{FM}=\mathbb{E}\,\|v_\theta(z_t,t,c)-v^\star\|$;采样时积分 $dz/dt=v_\theta$ 数十步完成。常配合 classifier-free guidance(训练时随机丢弃条件)增强条件可控性。
因为潜在空间被所有机器人共享,作者训练了一个 rectified flow 生成器直接在 $Z$ 中采样 64 帧 latent 片段,用行为模式提示生成走路、跑步、跳舞的 latent——这是『一个生成器驱动所有机器人』这一卖点的技术实现,也是第四种提示模式的来源。
分位数/边际传输 (quantile transport)
把一个分布上的阈值通过两个经验分布的 CDF 复合映射到另一个分布:$\theta^{(r)}=\Phi_r^{-1}(\Phi_S(\theta))$,即先算出阈值在源分布中的分位数,再取目标分布上同一分位数对应的值。它保证『同一个姿态百分位』在不同体型机器人上对应可比的绝对量。
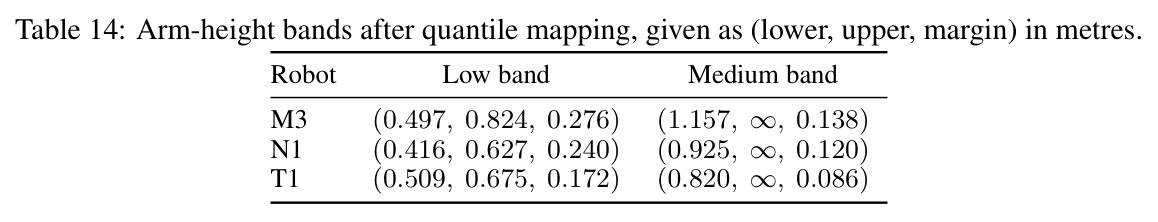
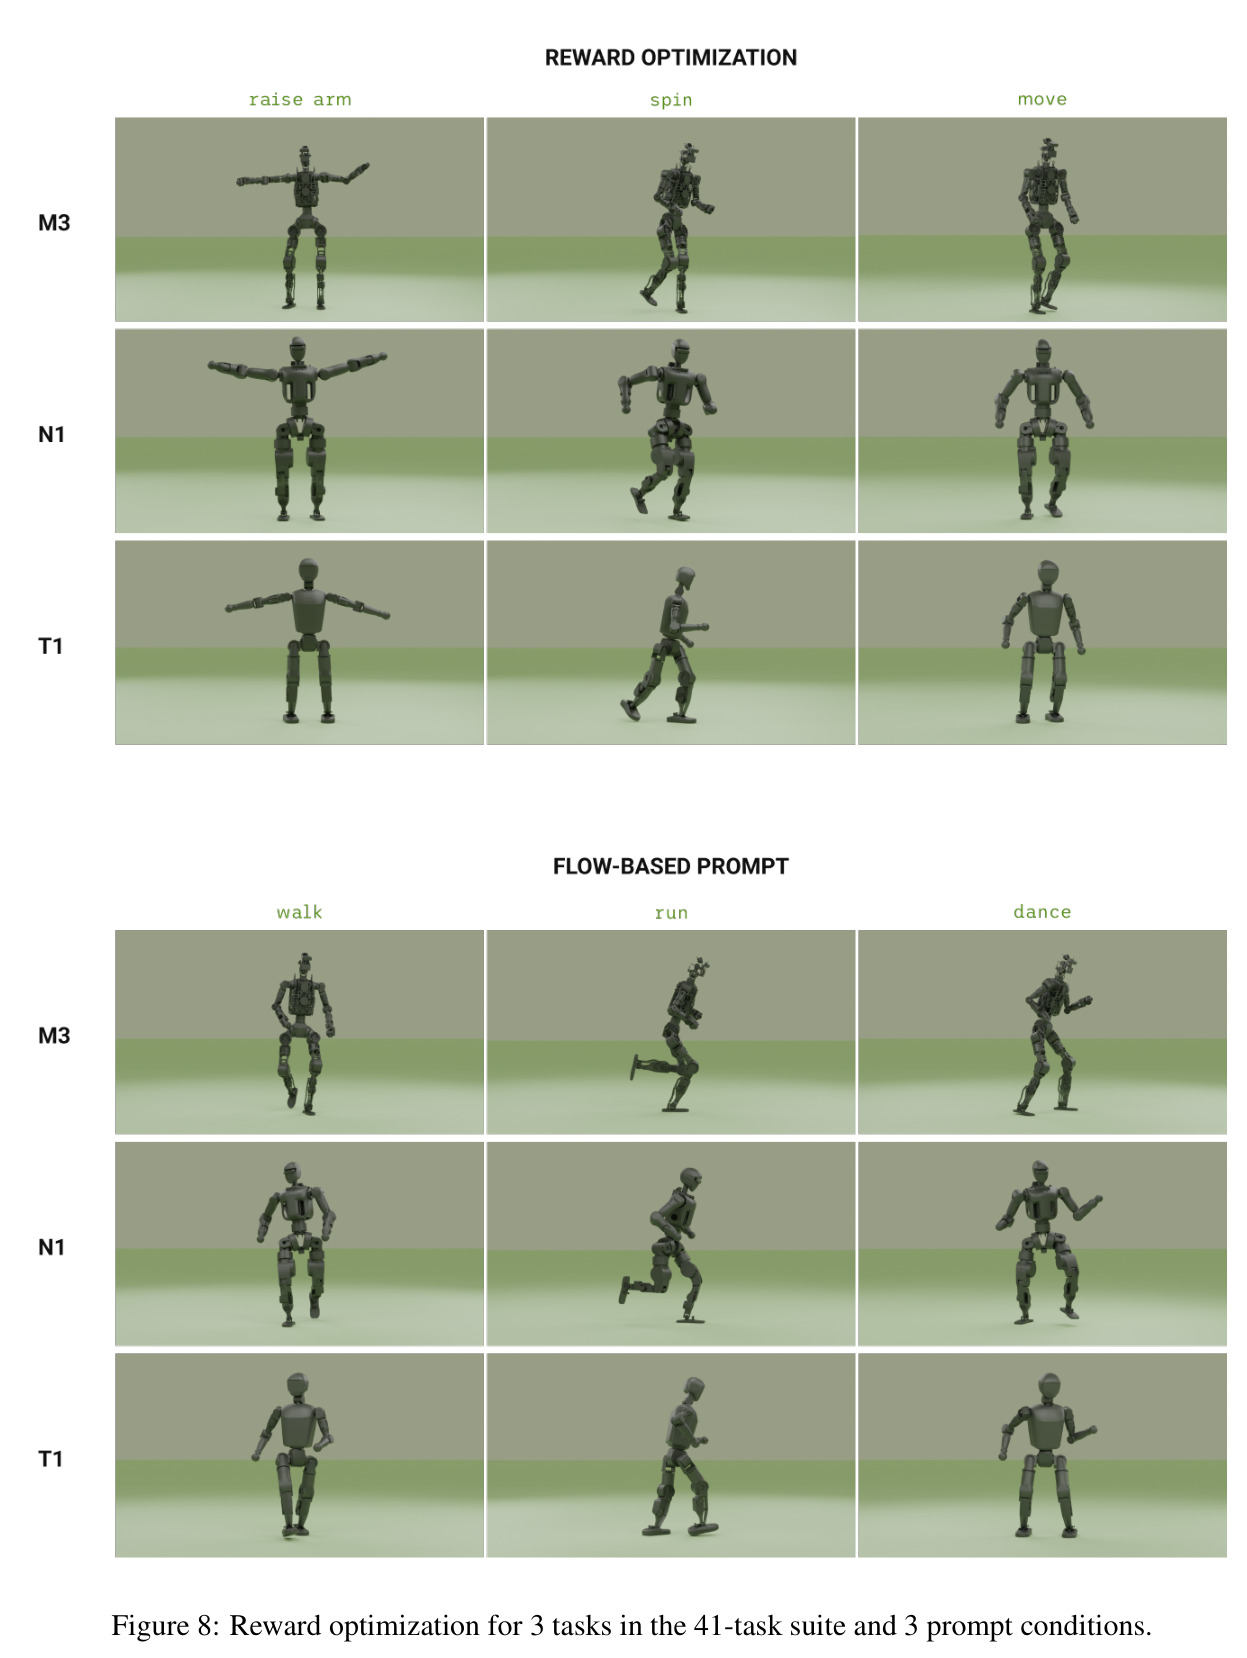
奖励优化模式迁移时,G1 的『举臂中带 $\ge$1.0 m』对 0.66 m 高的 T1 物理上不可能达成。本文用 40 段帧对齐重定向动作共 264,625 帧估计各机器人手臂高度的经验分布,把阈值换算到 T1 的 0.820 m、N1 的 0.925 m,这是奖励提示跨体型可用的关键技巧。
研究动机
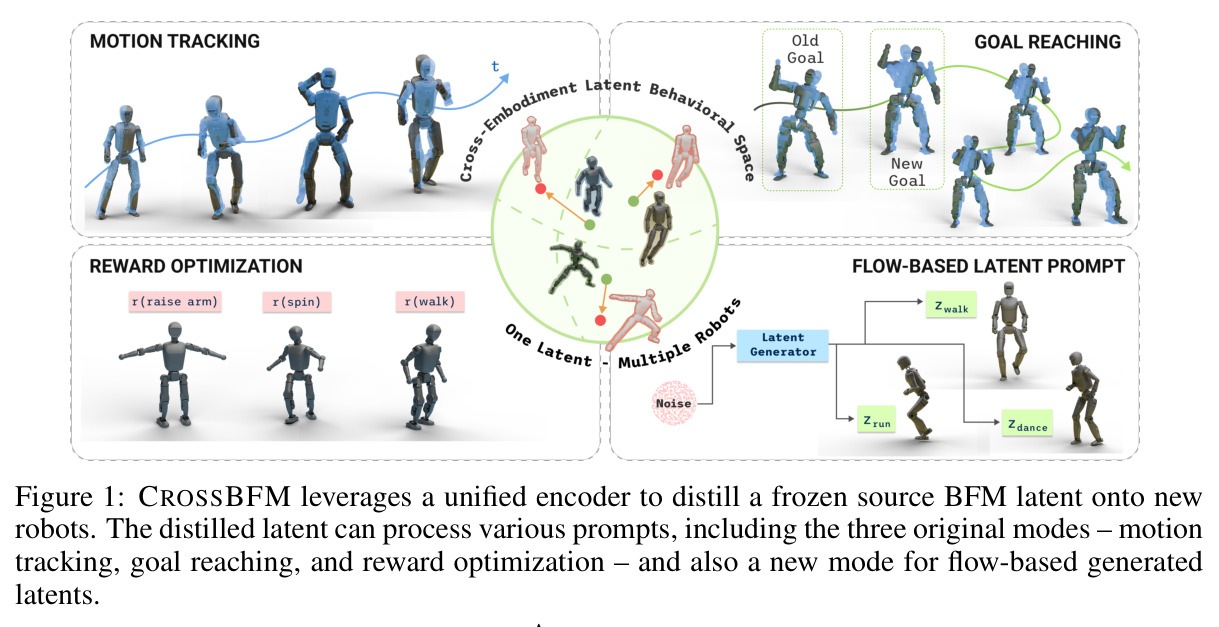
基于 Forward-Backward 表示的行为基础模型(BFM-Zero、UFO 等)给了人形机器人一个非常优雅的指令接口:一个 256 维 latent 向量 $z$ 可以表示一段要模仿的运动、一个要到达的姿态、或一个要最大化的奖励,策略 $\pi(\cdot|z)$ 在测试时零重训练地响应全部三类提示。但这个范式有两个昂贵的代价。第一,训练成本:即使用 UFO 把 FB 预训练压缩 5 倍,为单个机器人训练一次仍需 100+ GPU 小时的在线无监督 RL(重放缓冲、潜在条件判别器、域随机化缺一不可);第二,空间不通用:为新机器人重跑训练会得到一个与旧空间『几何相似但坐标含义不同』的潜在空间——同一个坐标点在 G1 上是『迈左脚』,在另一台机器人上可能是完全不同的行为,而所有下游任务(跟踪、到达、奖励优化、行为检索)都建立在这个坐标系之上,因此跨具身迁移的困难与重复训练的成本一样致命。另一类现役方案——多具身单策略(Body Transformer、GET-Zero、embodiment scaling laws 等)——虽然能泛化到未见机器人,但受限于单一任务(速度跟踪运动或手内旋转),其共享表示编码的是『形态』而非『任务条件行为』,没有『我要最大化的奖励』『我要到达的姿态』这种值函数语义;而关节空间指令类策略则需要逐帧重定向参考,复杂任务难以获得,且关节目标的不连续跳变会产生大力矩导致早停。
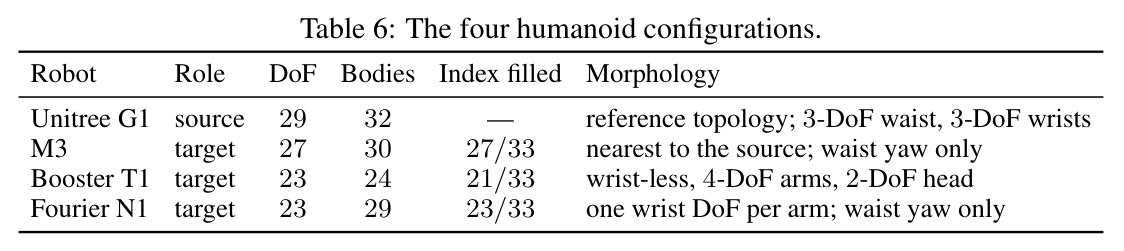
本文的目标是本文的目标是把潜在行为空间本身当作可在具身之间迁移的资产:冻结在 Unitree G1 上预训练的 BFM,只保留其后向映射 $B_S$ 作为固定的『行为坐标系』,然后把这一坐标系蒸馏到任意新人形机器人上。具体量化目标包括:(1) 用一次训练同时覆盖多个训练机器人,把目标端从 100+ GPU 小时的无监督 RL 压到 1 GPU 小时以内的监督回归;(2) 蒸馏出的 latent 必须保留源空间全部三种提示模式(运动跟踪、目标到达、奖励优化)的语义;(3) latent 在不同机器人之间要足够一致,以至于一个生成模型(或同一段 latent)就能同时驱动整个机器人平台;(4) 训练后的 latent 条件 tracker 性能要逼近关节条件 tracker 的上界。整个管线的预算目标是在单张 RTX 4090 上约 10 GPU 小时完成一台新机器人的全部训练。
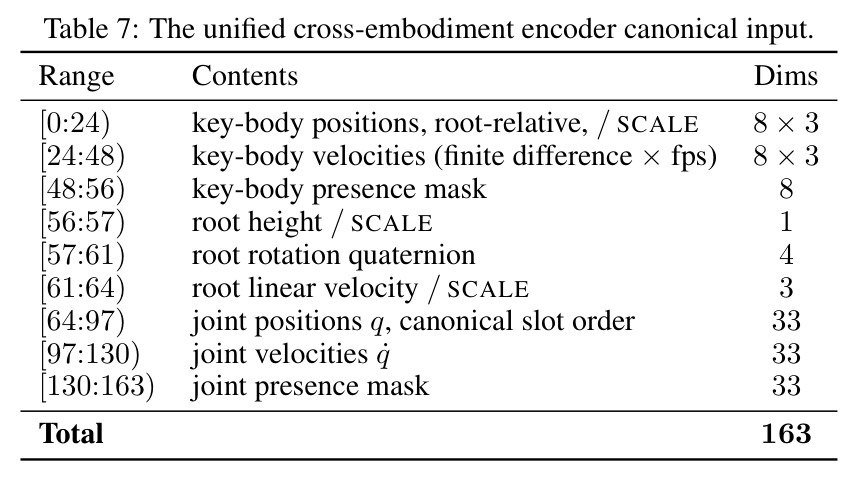
与已有工作不同的是,本文的独特切入角度有三层。第一,『不学新空间、只继承旧空间』:与所有从头学习跨具身潜在空间的工作(如统一具身 latent、PHASOR、MOTIF 等)不同,CrossBFM 的 latent 空间不是学出来的而是从冻结 FB 模型继承来的,因此天然保留『奖励→latent』的闭式推理——这是描述性 latent 做不到的。第二,『把重定向当作对应关系的预言机』:作者观察到同一动作数据集经重定向后在所有机器人上逐帧对应同一行为,于是跨具身 latent 迁移问题被等价改写为『对冻结源 latent 的监督回归』,从而把目标端学习中的仿真器、RL 训练和对抗判别器全部移除;此前用最优传输或图匹配做策略状态对齐的工作需要昂贵得多的对齐流程。第三,『统一编码器架构』:不做每机器人一个编码器,而是定义 163 维固定宽度的规范本体感知输入(33 个关节槽位 + 8 个关键体槽位,缺失槽位零填充并打 mask),使任何自由度数量的人形都能以相同输入维度进入同一个网络,一次训练同时服务所有机器人——这既把参数量从 3×12.8M 压到 3.27M,又天然产生跨机器人一致的 latent,并意外地获得了对形态相似未见机器人的泛化能力。
核心方法
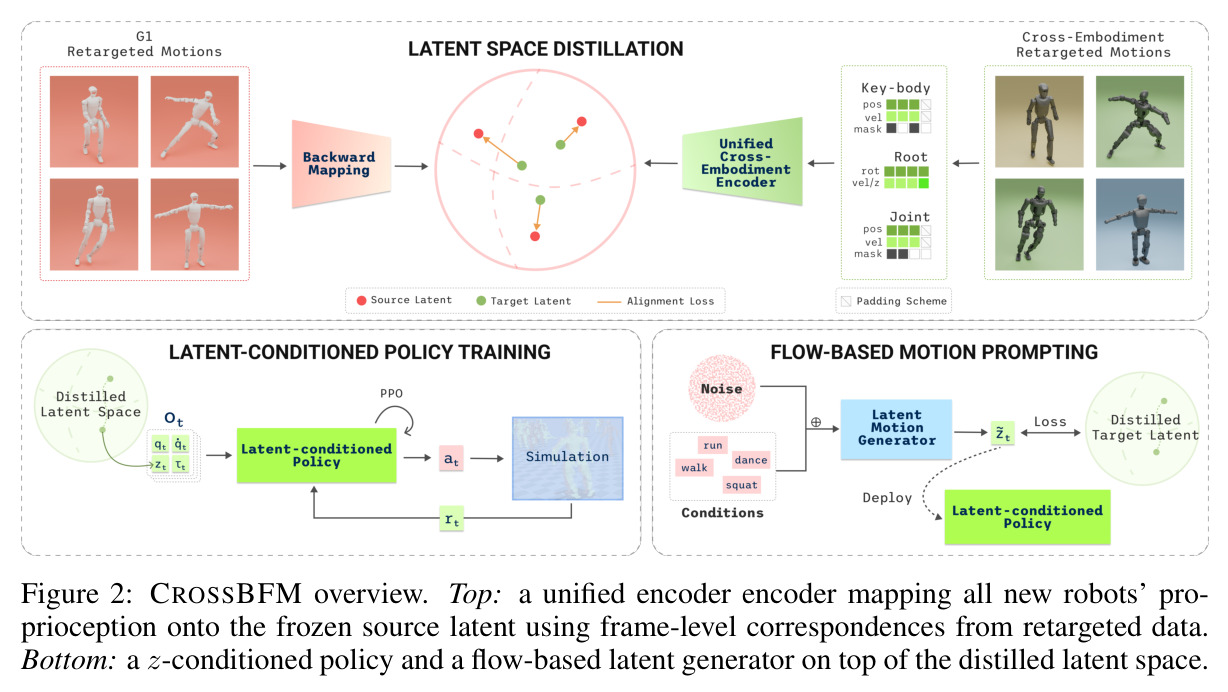
先说直觉:同一支舞分别重定向到 G1 和新机器人后,两条轨迹逐帧对应同一行为;而 G1 的冻结 BFM 能对每一帧算出 $z^\star_t=\text{proj}(B_S(o^{G1}_t))$,这个向量就是新机器人对应帧的『正确行为坐标』标签。于是新机器人只需要学一个『读表器』,把自己的本体感知翻译成源坐标系里的坐标。技术路线分两阶段。Stage 1(后向映射回归):设计一个无机器人特定参数的统一编码器 $E_X$,输入新机器人 64 帧本体感知窗口,逐帧输出投影到半径 $\sqrt{d}$ 球面的 256 维 latent,用逐帧余弦损失 $\mathcal{L}_{align}=\frac{1}{N}\sum_t(1-\cos(\hat z_t, z^\star_t))$ 回归冻结源 latent,单张消费级 GPU 上不到 1 小时训完。Stage 2(潜在条件策略):为每台机器人用 PPO 训练一个只输入 $[z|\text{proprio}]$ 的全身跟踪策略(约 10 GPU 小时),critic 保留仿真内特权参考。部署时三种提示模式直接继承:跟踪用 $\hat z_t=E_X(o^X_{t-T+1:t})$,目标到达用止于目标姿态的窗口,奖励优化用缓存重定向数据近似状态分布并做分位数阈值传输;另训一个 rectified flow 生成器在共享空间中按行为模式采样 latent,构成第四种提示方式。
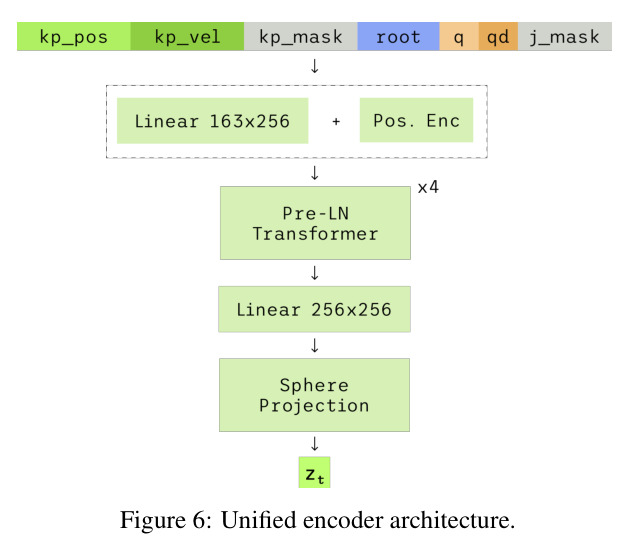
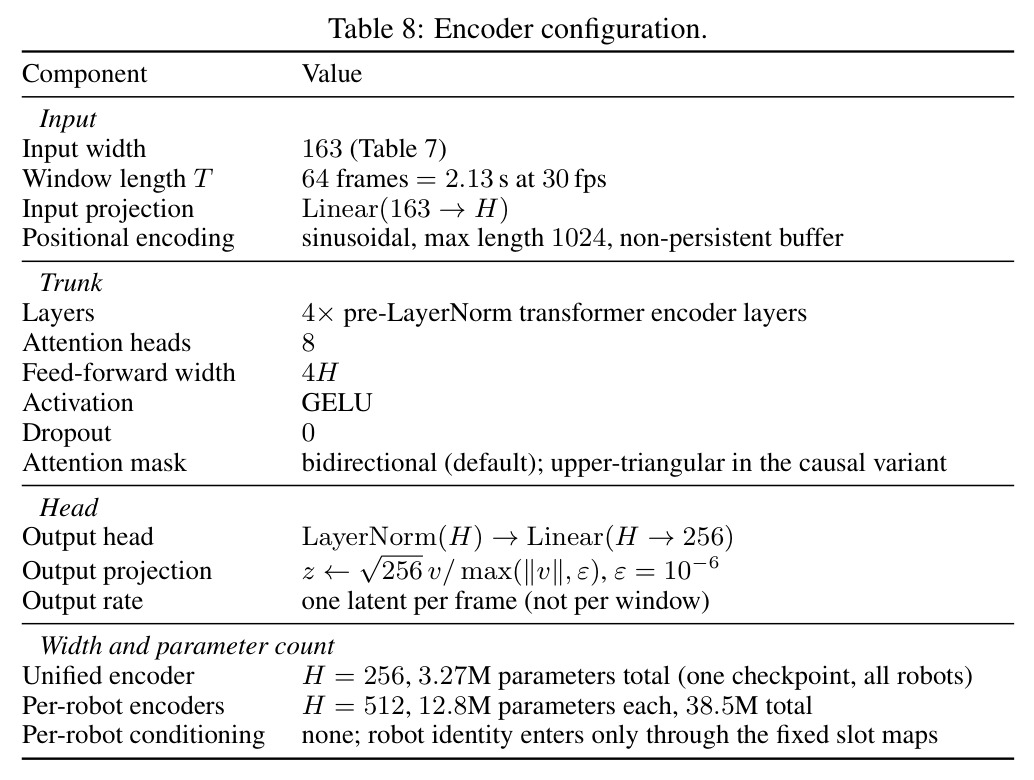
核心创新是『重定向作为对应预言机 + 统一编码器蒸馏冻结后向映射』的组合,它与已有方法的本质区别在三点。其一,与 BFM-Zero/UFO 的区别:BFM 为每个机器人从头训练一个行为空间(100+ GPU 小时),得到互不相关的坐标系;CrossBFM 把源空间当作固定资产,新机器人只学『坐标读出』(<1 GPU 小时回归 + 10 GPU 小时 PPO),学到的 latent 与源逐点对应,FB 的闭式提示语义($z_{rew}=\text{proj}(\sum_i \omega_i r_i B(s_i))$ 等)原样保留。其二,与跨具身单策略工作(GNN、Body Transformer、GET-Zero 等)的区别:那些方法的共享组件是『形态编码器』,latent 描述机器人长什么样;CrossBFM 的共享组件是『行为空间』,latent 描述机器人要做什么,且是值函数性的。其三,与统一潜在空间工作(Yan & Lee、PHASOR、UniT、MOTIF)的区别:那些 latent 从头学、是描述性的,没有『奖励→latent』的闭式解;CrossBFM 继承 FB 空间,三种提示模式零成本迁移。工程上另一个关键决定是统一编码器的 163 维规范输入:8 个关键体({左,右}×{膝,脚,肘,臂端},根节点因参考系原因排除)的位置/速度/存在掩码 + 根的高度/四元数/线速度 + 33 个规范关节槽位(12 腿 + 3 腰 + 16 臂 + 2 头)的位置/速度/掩码,故意保留所有机器人都不存在的槽位(如腰 roll/pitch、头关节),用 mask 区分『关节值为零』和『关节不存在』——机器人身份只经由固定的索引映射进入网络,没有任何 per-robot 权重。
方法步骤详情
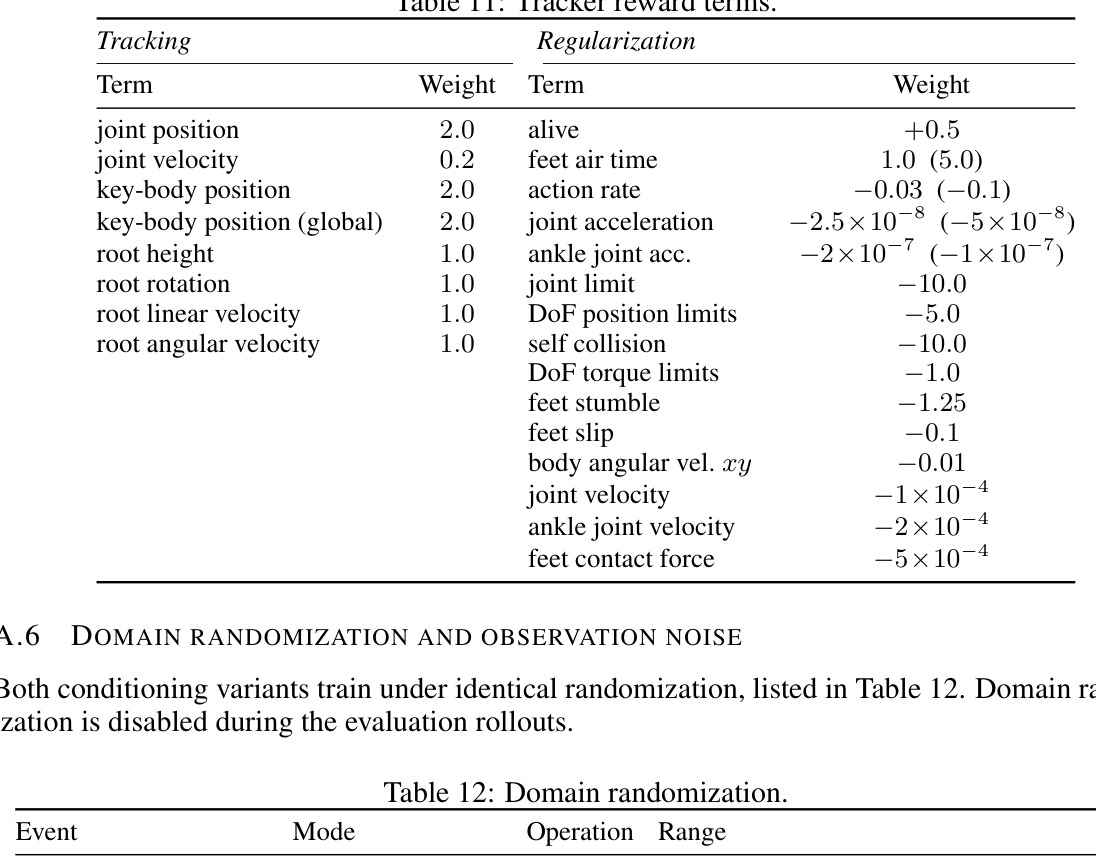
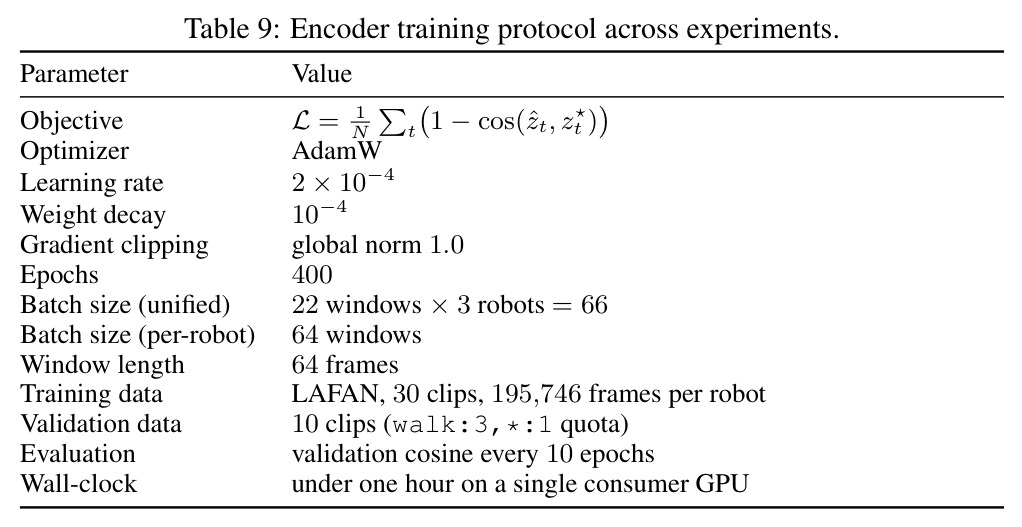
完整流程六步。第一步,数据与标签:LAFAN 数据集 40 段动作(8 类行为)按 30 训练/10 验证划分;对每帧在 G1 上计算源 latent $z^\star_t=\text{proj}(B_S(o^{G1}_t))$;把每段 clip 独立重定向到每个目标机器人(M3、T1、N1),同时间轴同帧率,使第 $t$ 帧在新机器人上的观测 $o^X_t$ 与 $o^{G1}_t$ 对应同一行为,再把 $z^\star_t$ 作为该帧标签。第二步,统一输入构造:按 Table 7 的布局拼 163 维规范输入,长度除以 SCALE(各机器人语料中位根高:M3 0.7956 m、N1 0.6743 m、T1 0.6552 m),并做符号规范化(如 T1 腰 yaw 符号与 G1 相反,增加一个约定索引)。第三步,Stage 1 编码器训练:输入投影 Linear(163→H)、正弦位置编码、4 层 pre-LayerNorm transformer(8 头、FFN 宽 4H、H=256,共 3.27M 参数)、输出头 LayerNorm→Linear(H→256) 后投影到半径 $\sqrt{256}$ 球面($\text{proj}(v)=\sqrt{d}\,v/\max(\|v\|,\epsilon)$);窗口 64 帧(2.13 s @30 fps),causal 上三角注意力掩码使第 $t$ 帧只见 $\le t$ 帧以支持实时流式;AdamW lr $2\times10^{-4}$、400 epochs、batch 22 窗口×3 机器人=66,<1 GPU 小时。pre-LN 被证明必要——换成 post-LN 会坍缩到常数 latent 且余弦损失无法恢复。第四步,Stage 2 tracker 训练:mjlab(MuJoCo)200 Hz 物理/50 Hz 控制,4096 并行环境,3 万次迭代(约 $2.9\times10^9$ 环境步),每台机器人 <10 GPU 小时(RTX 4090);actor 观测 $[z_{256}|\text{proprio}]$(基座角速度、IMU 横滚/俯仰、关节位置速度、上一动作),用 $z$ 替换关节条件版的 5 个参考项;critic 非对称,保留特权未来参考;两种条件变体共享奖励、终止、域随机化与 PPO 预算。第五步,部署推理:跟踪模式的参考 latent 为 $\hat z_t=E_X(o^X_{t-T+1:t})$;目标到达用预定义窗口止于目标姿态;奖励优化因目标端没有 RL 采样的 $\rho$,改用缓存重定向数据集近似——只用关键体运动学奖励特征(根高/根速、直立性、角速度、臂端与膝高),丢弃关节配置项,对缓存帧算 $\omega=\text{softmax}(\tau r)$ 后 $z_{rew}=\text{proj}(\sum \omega_i r_i Z_i)$,奖励阈值经 $\theta^{(r)}=\Phi_r^{-1}(\Phi_S(\theta))$ 分位数传输(G1 中带下沿 1.0 m 位于分位数 0.938,映射后 M3/N1/T1 分别为 1.157/0.925/0.820 m)。第六步,flow latent 生成器:6 层、宽 512、8 头、约 16M 参数的 pre-LN transformer 学 64 帧 latent 块上的 rectified flow,条件为行为模式嵌入 + 前 16 帧 latent 历史 + 帧对齐运动特征(零初始化门控),各条件以 0.1 概率独立丢弃支持 classifier-free guidance 2.5,采样 20 步、每步后重投影球面,输出 latent 流直接驱动冻结的潜在条件策略。
技术新颖性
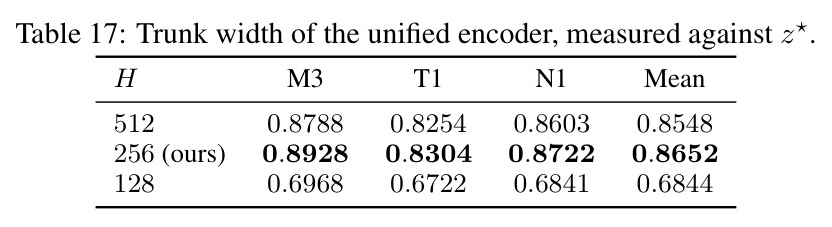
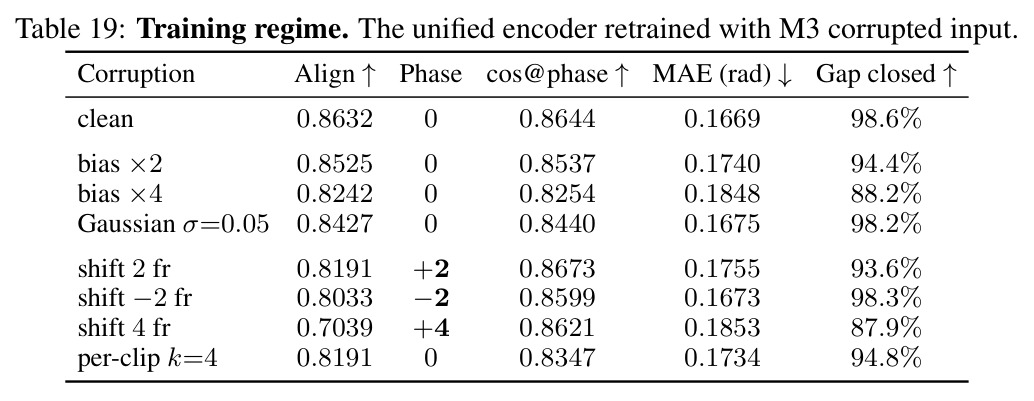
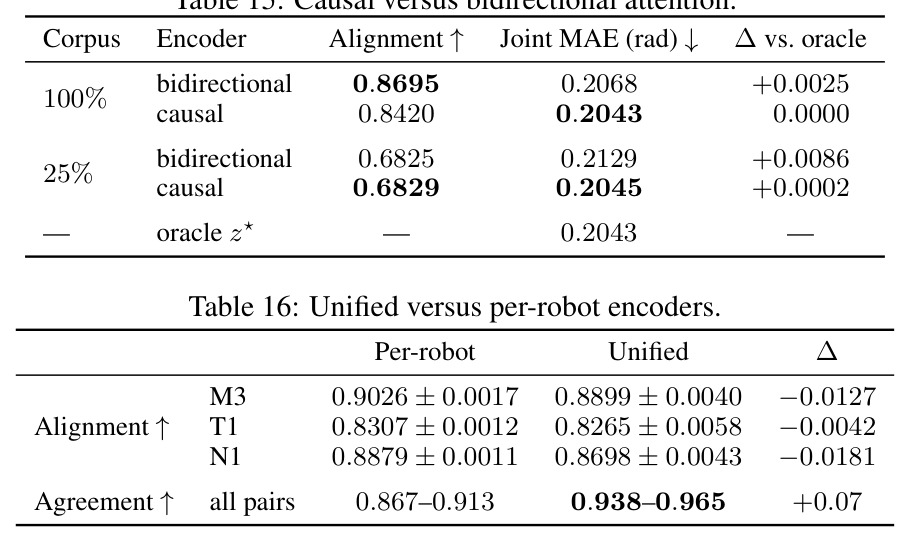
技术新颖性可以从四个层面评估。问题重构层面:把『为新机器人建行为空间』重构成『把已有空间蒸馏到新机器人』,这一步的杠杆是识别出重定向数据隐含免费的帧级跨具身监督——此前学界要么为每个机器人重跑 FB(昂贵),要么用最优传输/图匹配做策略对齐(Fickinger 2022、Le 2025,更贵),要么从头学统一 latent(丢失值函数性),没有人把这三条线索拼起来。架构层面:统一编码器本身并不新颖(pre-LN transformer、规范槽位输入类似 One Policy to Run Them All 的具身随机化思路),但把它用于『蒸馏值函数性 latent』且证明 3.27M 参数、H=256 优于 H=512(Table 17:平均余弦 0.8652 vs 0.8548)、H=128 崩溃(0.6844),是有信息量的设计结论;causal attention 变体在几乎不损失闭环性能的前提下(Table 15:100% 数据时 MAE 0.2043 vs 双向 0.2068)使实时参考流式部署成为可能。算法层面:目标端奖励优化的近似方案(用重定向数据替代 RL 状态分布 + 分位数阈值传输 + 关键体特征过滤)是针对『目标机器人从未跑过无监督 RL』这一新问题的原创工程解,实验还反直觉地显示它比直接搬源机器人 RL buffer 的 $z_{rew}$ 好 2-3.5 倍。鲁棒性分析层面:附录 C.3 对『重定向对应关系假设』做了系统性的腐蚀实验(几何偏差/噪声、时间偏移),这类对蒸馏监督源质量的敏感性分析在同类工作中少见,结论(时间偏移可经一维相位搜索完全恢复、系统偏差 ×4 内无害 ×8 致命)对后续工作有直接指导价值。
实验结果
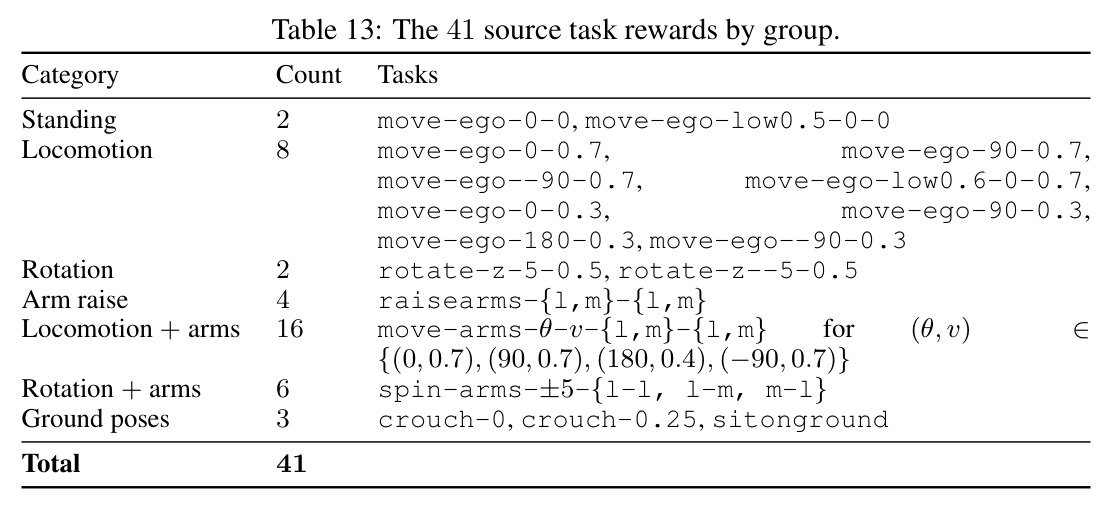
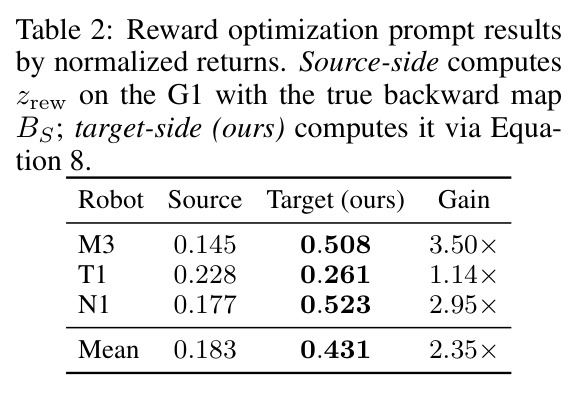
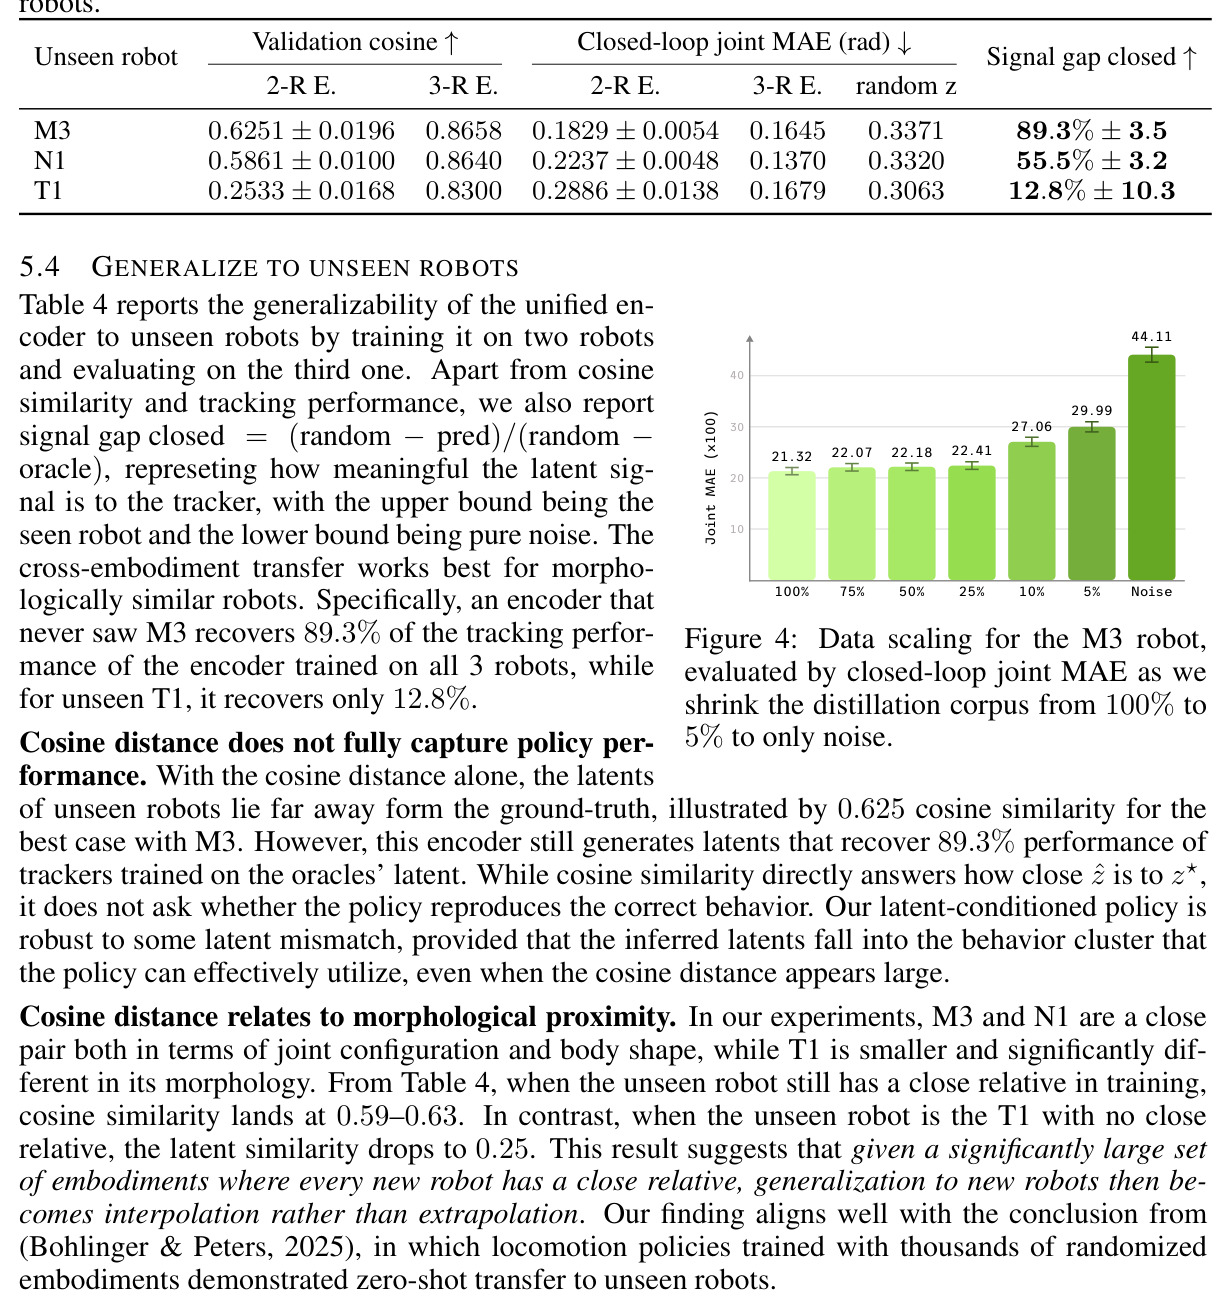
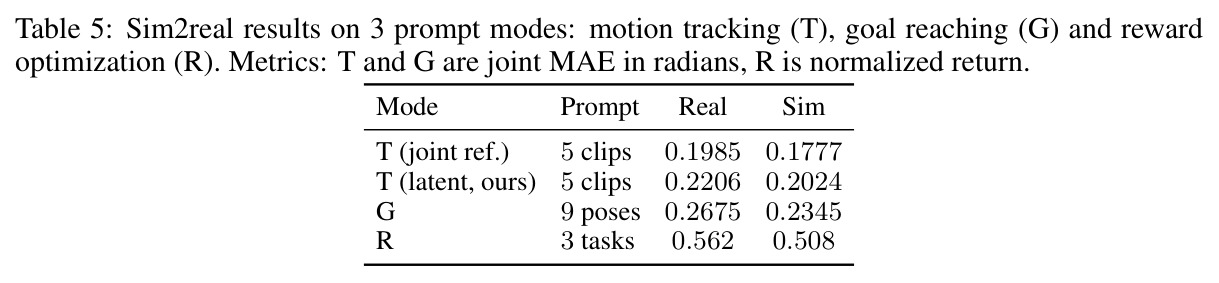
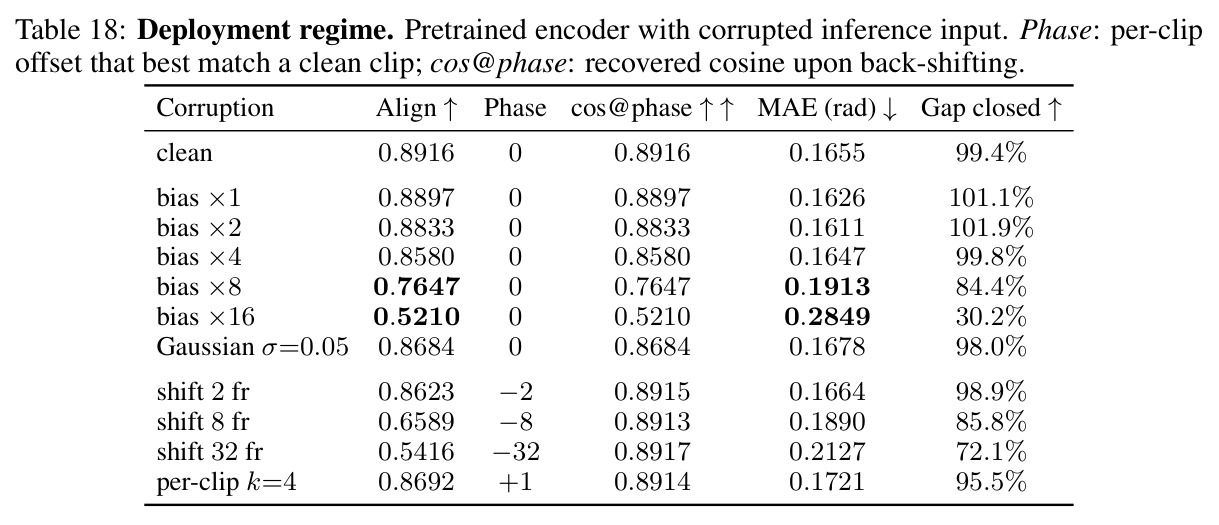
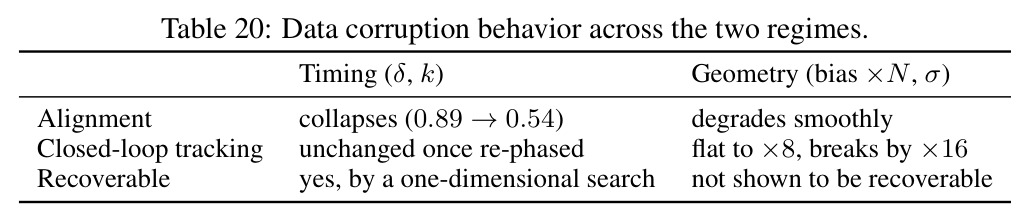
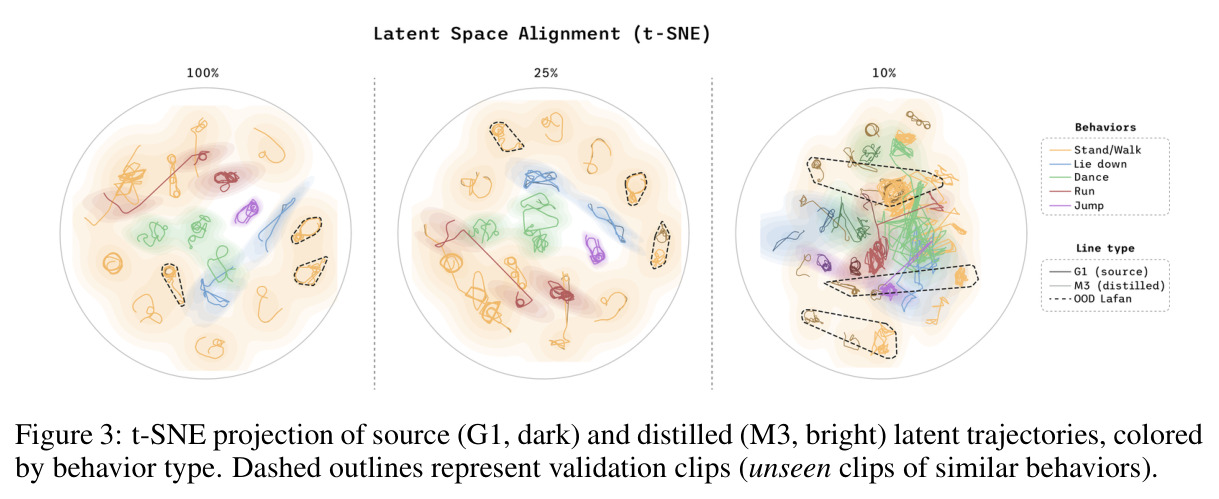
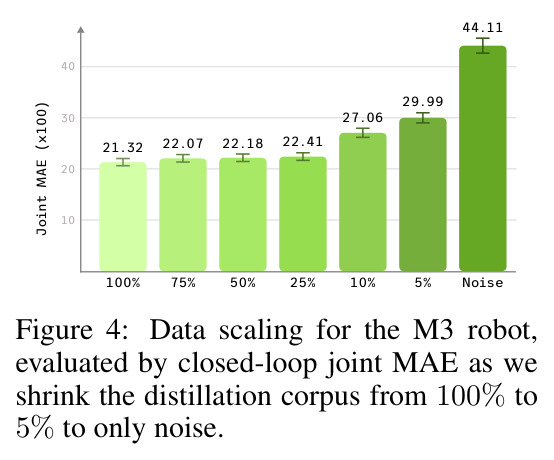
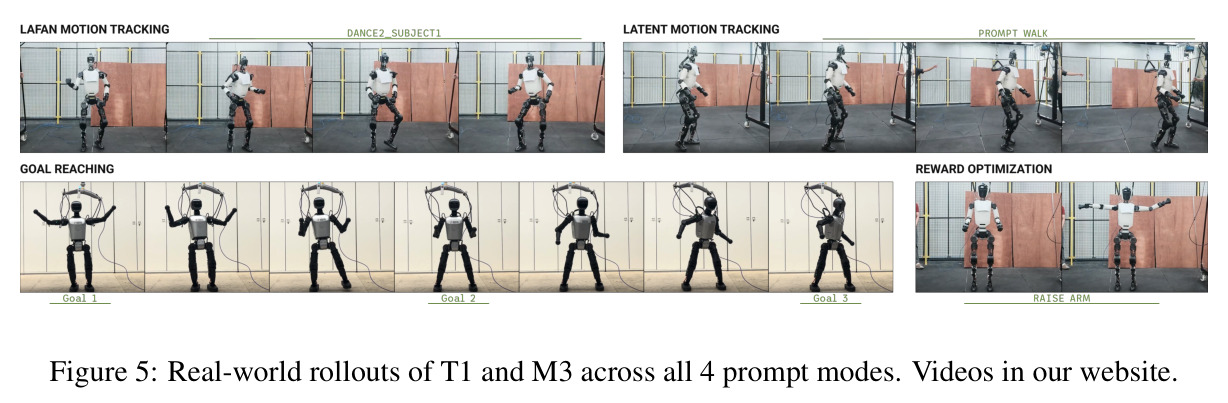
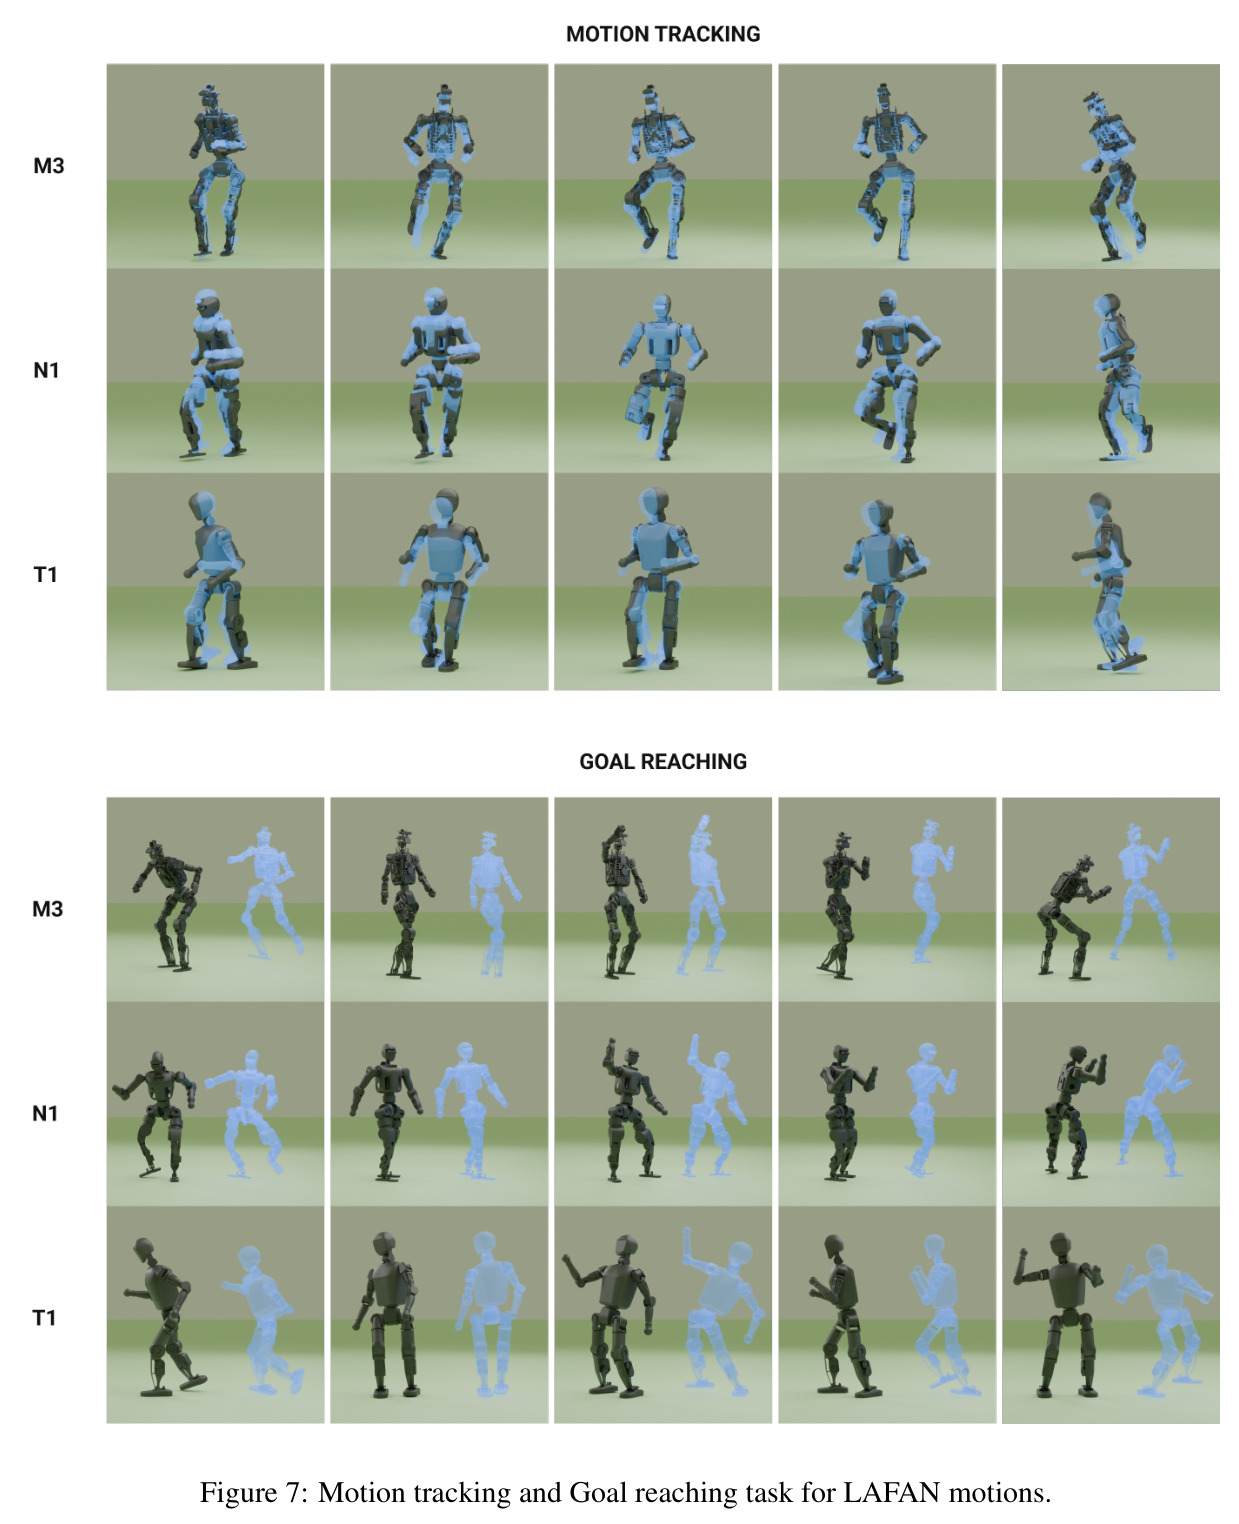
实验围绕三个问题展开,全部结果可归纳为五组。第一组,三种提示模式迁移(Table 1、2、5):在三个目标机器人上,潜在条件 tracker 与关节条件上界的差距保持在 0.025 rad 以内(M3:0.2024 vs 0.1777 rad,T1:0.1901 vs 0.1844,N1:0.1391 vs 0.1362);目标到达通过 latent 插值实现平滑过渡,代价最多 +0.032 rad 且无摔倒,而关节条件策略因目标跳变产生大力矩会早停,根本不具备该能力;奖励优化在全部 41 个 G1 任务上工作,均值归一化回报 0.431,是用源机器人真实后向映射 $B_S$ 加 RL buffer 计算 $z_{rew}$ 的 2.35 倍(M3 上 0.508 vs 0.145,3.50×;N1 上 0.523 vs 0.177,2.95×;T1 上仅 1.14×),原因是奖励加权投影应选择目标机器人实际可达的状态。真实世界在 M3 和 T1 上验证了全部提示模式(Table 5:M3 真实跟踪 latent 0.2206 vs 仿真 0.2024 rad,目标到达 0.2675,奖励 0.562 vs 0.508)。第二组,未见动作泛化(Table 3):用编码器推断 latent 替代 oracle latent,训练 clip 上误差甚至略低(M3:8.02 vs 8.14 ×10⁻² m),验证 clip 上只多付出 1.4–6.7 mm 关键体误差;t-SNE(Figure 3a)显示蒸馏轨迹几乎完全覆盖源轨迹,验证 clip 落入所属行为簇内部而非流形间隙。第三组,数据缩放(Figure 4):把蒸馏语料砍到 25%,M3 闭环关节 MAE 仅从 0.2132 升到 0.2241(5% 退化),10% 时开始崩坏(0.2706),随机 latent 对照为 0.4411;几何结构上 25% 时行为簇仍清晰分离(Figure 3b),10% 时纠缠。第四组,未见机器人泛化(Table 4):只用两个机器人训练的编码器在形态相近的 M3 上恢复 89.3%±3.5 的信号间隙(closed-loop MAE 0.1829 vs 三机器人 0.1645),N1 恢复 55.5%,形态差异大的 T1 只有 12.8%±10.3;余弦相似度与形态学距离强相关(M3/N1 互为近亲时 0.586–0.625,T1 无近亲时仅 0.253),且余弦低不等于策略失效——0.625 的余弦仍换来 89.3% 性能恢复,说明策略对落入正确行为簇的 latent 有容忍度。第五组,消融与鲁棒性:统一编码器对比三个独立 per-robot 编码器,对齐度略降(M3 −0.0127)但跨机器人一致性大幅提升(agreement 从 0.867–0.913 升至 0.938–0.965,Table 16);对重定向误差,时间偏移可通过一维相位搜索完全恢复(余弦回到 0.8913–0.8917,干净基线 0.8916),系统性偏差 ×4 内无害、×8 开始破坏(余弦 0.8580→0.7647),高斯噪声 σ=0.05 只损失 +0.002 rad(Table 18–20)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 运动跟踪(M3,仿真) | 关节 MAE (rad) ↓ | 0.2024 ± 0.0067(潜在条件) | 0.1777 ± 0.0033(关节条件 TWIST2 上界) | 差距仅 +0.0247 rad,同时获得 latent 插值平滑过渡能力 |
| 运动跟踪(T1,仿真) | 关节 MAE (rad) ↓ | 0.1901 ± 0.0032 | 0.1844 ± 0.0043 | 差距仅 +0.0057 rad |
| 运动跟踪(N1,仿真) | 关节 MAE (rad) ↓ | 0.1391 ± 0.0038 | 0.1362 ± 0.0032 | 差距仅 +0.0029 rad |
| 目标到达(三机器人) | 目标 MAE (rad) ↓ | M3 0.2345 / T1 0.1967 / N1 0.1512 | 关节条件策略无法执行(跳变目标导致大力矩早停) | 0–0.032 rad 额外代价换来平滑姿态间过渡 |
| 奖励优化(41 任务均值) | 归一化回报 ↑ | 0.431(缓存重定向集 + 分位数传输) | 0.183(源侧 $B_S$ + G1 RL buffer) | 2.35×;M3 3.50×、N1 2.95×、T1 1.14× |
| 未见动作跟踪(验证集,oracle vs 推断) | 关键体 mpjpe local (×10⁻² m) ↓ | M3 7.07 / T1 5.60 / N1 5.60(推断 latent) | M3 6.40 / T1 5.26 / N1 5.46(oracle latent) | 推断仅多付出 1.4–6.7 mm;训练集上推断甚至略优于 oracle |
| 未见机器人泛化(M3 为未见) | 信号间隙闭合率 ↑ | 89.3% ± 3.5(2 机器人编码器) | 随机 latent 0%(下界)/ 三机器人编码器 100%(上界) | MAE 0.1829 vs 0.1645 rad;但 T1 为未见时仅 12.8% |
| 蒸馏数据缩放(M3) | 闭环关节 MAE (rad) ↓ | 0.2241(25% 语料) | 0.2132(100% 语料);随机 latent 0.4411 | 四分之一数据仅损失 5% 性能 |
| Sim2Real(M3,真实) | 跟踪关节 MAE (rad) ↓ / 奖励归一化回报 ↑ | 跟踪(潜在)0.2206;奖励 0.562 | 仿真 0.2024 / 0.508 | 真实退化约 +0.018 rad,三种模式均保持可用 |
局限与改进
作者承认的局限主要有:未见机器人泛化本质上依赖形态学近亲,2 机器人编码器对形态差异大的 T1 只恢复 12.8%±10.3(且标准差巨大),作者明确说这是『插值而非外推』,并援引 Bohlinger & Peters 的大规模具身随机化结论暗示需要大得多的机器人集合;余弦相似度与下游策略性能脱钩(0.625 余弦换 89.3% 恢复,0.253 只剩 12.8%),论文缺少一个能统一预测策略行为的评估指标;奖励优化的收益在 T1 上只有 1.14×,且 41 个奖励任务本是为 G1 设计的,迁移时被迫丢弃所有关节配置类奖励特征,只能表达关键体级别的粗粒度奖励。我自己的观察还有几点:其一,源 BFM 仍是单一 G1 模型,行为空间的粒度和覆盖完全继承自 LAFAN 的 8 类行为(走、跑、舞蹈等),精细操作类、接触丰富的行为根本不在源空间里,蒸馏再好也无法无中生有;其二,方法对重定向管线的质量有硬依赖——系统性偏差 ×8(约 0.216 rad rms,即两次『合理调参』差异的 8 倍)就会破坏对齐,而现实中重定向本身对小众形态可能直接失败,这把可靠性外包给了重定向研究的进展;其三,所有策略都在平地训练,tracker 观测不含外部感知,场景局限于仿真平地与实验室演示;其四,flow 生成器只有仿真内的定性展示,没有对生成 latent 的跟踪成功率、多样性和分布外行为的定量评估;其五,缺一个关键基线——『多机器人联合 FB 训练』,虽然成本高一个量级,但它能回答继承单一源空间相比从头联合学习损失了多少行为覆盖。
独立分析的弱点
独立分析如下。第一,泛化是插值不是外推:未见机器人要有『近亲』才可用(T1 无近亲时仅 12.8% 恢复),固定 33 槽位的硬编码索引也限制了体型拓扑差异大的机器人(四足、带灵巧手的平台无法套用)。改进方向:把固定槽位换成结构感知编码(关节图 token、GNN 或形态描述 token),结合大规模具身随机化预训练,使新机器人变成对形态流形的插值;或者在推断时用少量新机器人数据做轻量微调(本文框架下只需回归头部,成本极低)。第二,监督信号依赖重定向的时间对齐与几何精度:per-clip 随机时移(k=4)在训练时不可恢复,系统性偏差 ×8 致命。改进方向:训练时加入时移/几何噪声的数据增强以显式提高容差;用软对应(可微对齐、对比式时间扭曲)替代硬帧配对;部署端内置自动相位搜索模块(论文已证明一维搜索即可恢复)。第三,奖励提示的表达能力被削弱:目标端只能用关键体特征,且分位数传输假设两个分布形状可比,对奖励中涉及接触、力或关节耦合的项无能为力。改进方向:为目标机器人学一个轻量残差后向映射(在冻结 $B_S$ 附近微调),或经由各机器人的逆运动学把关节级奖励映射到任务空间。第四,评估指标缺位:余弦对齐、agreement 与策略行为一致性三者脱钩,消融结论(如 causal vs 双向)在不同指标下方向相反。改进方向:建立以下游行为检索/跟踪一致性为核心的基准协议,报告『行为级』而非『向量级』指标。第五,sim2real 缺口仍存(M3 真实跟踪 0.2206 vs 仿真 0.2024),且域随机化范围(±3 kg 配重、±0.5 m/s 推扰)较为保守。改进方向:更强的随机化、在线 latent 校准(利用本体历史隐式估计漂移,类似作者另一工作 CompliantWBC 的思路)。
未来方向
作者在结论中明确提出三条:第一,沿『更丰富训练数据』轴扩展源行为空间以获得更细粒度的行为基元——本文已证明蒸馏只需源空间四分之一语料即可保留 95% 功能,说明瓶颈在源而非蒸馏端;第二,沿『更多训练机器人』轴扩展以把未见机器人泛化从插值推向更广覆盖,呼应 embodiment scaling laws 的大规模随机化路线;第三,文本指令提示——由于潜在空间共享,可把附录 D 中 flow 生成器的模式嵌入换成冻结 T5 文本编码器,实现自然语言→latent→全身控制的长时程 loco-manipulation。基于成果还可以延伸:多源蒸馏——把多个不同源 BFM 的坐标系对齐进同一个空间,合并彼此不重叠的行为覆盖;持续学习——新行为以新簇形式注入共享空间,老机器人的 tracker 无需重训;与柔顺控制结合——latent 只描述运动学意图,接触丰富任务需要作者团队 CompliantWBC 方向的力/柔顺通道;理论层面研究『什么条件下 FB 行为空间在同构形态间可迁移』(本文的形态学近亲现象暗示存在可形式化的形态距离-性能关系);把 flow 生成器接入 VLA/世界模型管线,让语言模型在行为空间而非关节空间做规划,这是比关节级 action chunking 更高层、更可迁移的接口;以及奖励设计标准化——目前 41 个 G1 奖励经关键体过滤后才能迁移,设计一族天然具身无关的奖励原语会是实用的社区贡献。
复现评估
复现条件总体友好。数据:LAFAN 公开;41 个 G1 奖励任务在 BFM-Zero(arXiv 2511.04131)中定义;FB 训练基础设施可参考已开源的 UFO 框架(RoboParty Lab Team, GitHub),但论文未明确说明 CrossBFM 自身是否发布代码与 BFM-Zero 源权重,目前只能依赖论文附录。超参数文档化程度极高,是本文复现性的最大亮点:附录 A 给出 163 维输入的逐维布局(Table 7)、编码器完整配置(Table 8:4 层 pre-LN、8 头、H=256、3.27M 参数、窗口 64 帧)、训练协议(Table 9:AdamW、lr 2e-4、400 epochs、batch 66、<1 GPU 时)、tracker 全套 PPO 超参(Table 10:4096 环境、3 万迭代、KL 目标 0.01、<10 GPU 时/机器人 RTX 4090)、奖励项权重(Table 11)与域随机化范围(Table 12);附录 B 给出 41 任务清单与分位数传输的具体数值(264,625 帧、低带分位 0.079/0.320、中带 0.938);附录 C–D 覆盖消融与 flow 生成器细节。算力门槛很低:单张 RTX 4090 即可完成全部训练(编码器 <1 时 + 每机器人 <10 时),无需集群。主要工程量在三处:为三个目标机器人搭建重定向与 MuJoCo 模型(M3 是 inhouse 机器人,外部复现需换成可获得的替代形态)、获取或自训 G1 源 BFM、以及真实机器人验证(T1 为 Booster 商用机,N1 为 Fourier 商用机)。综合评估:仿真部分复现难度中等偏低,前提是能拿到 BFM-Zero 权重或愿花 100+ GPU 时用 UFO 自训源;真实机器人部分则依赖硬件渠道。项目网站(dotandung.github.io/crossbfm)提供全部演示视频。
论文图表