TabFM:面向表格数据的零样本基础模型 TabFM: A Zero-Shot Foundation Model for Tabular Data
400M参数表格基础模型,纯合成数据预训练,单次前向零样本登顶TabArena
前置知识
先验数据拟合网络(PFN)与上下文学习(ICL)
PFN 的核心思想是把监督学习变成条件概率估计:模型 $f_\theta$ 接收一批带标签的训练样本 $\mathcal{D}_{train}$ 和一条测试查询 $x_{test}$,在单次前向中直接输出后验预测分布 $p(y_{test}\mid x_{test},\mathcal{D}_{train})$,不做任何梯度更新。训练时在合成任务分布(先验)上采样大量小任务,让 Transformer 的注意力层在激活值中隐式执行贝叶斯推断或迭代优化算法。
TabFM 的整个方法论基石就是把表格预测形式化为上下文学习,理解 PFN 才能明白为什么纯合成数据训练出的模型能零样本迁移到真实数据集并在单次前向中完成预测。
集合 Transformer 与诱导自注意力块(ISAB)
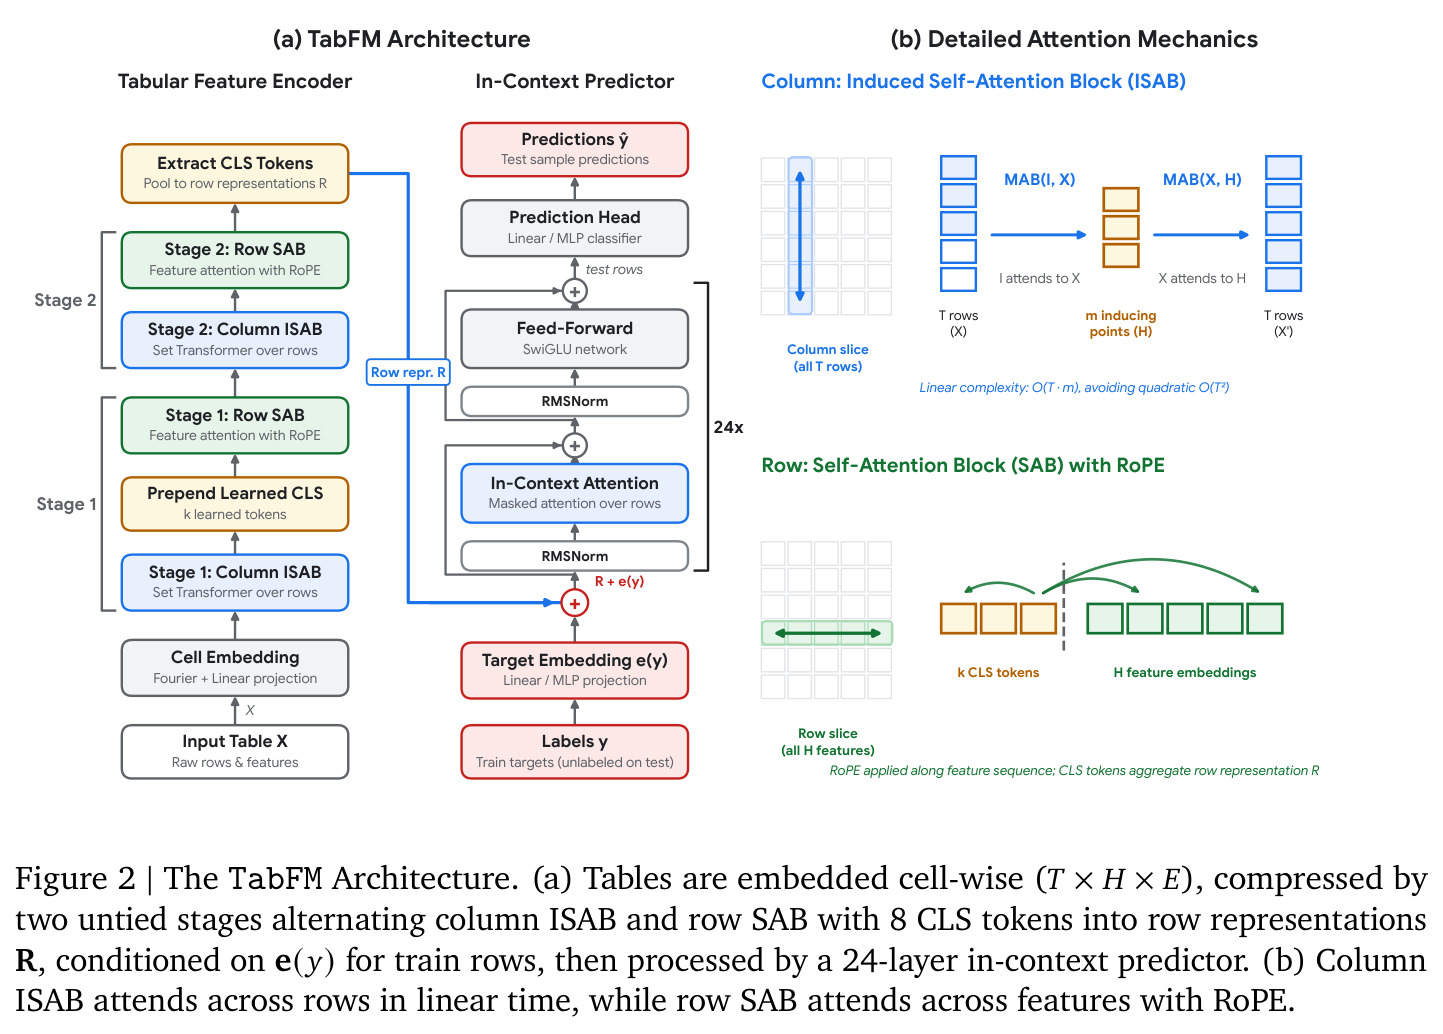
表格的行是可交换的,要求模型对行置换等变,Set Transformer 是常用骨架。其 MAB 模块 $\mathrm{MAB}(X,Y;M)=\mathrm{MHA}(XW_Q, YW_K, YW_V;M)$ 配合三明治 RMSNorm 与 SwiGLU 前馈层。ISAB 先用 $m$ 个可学习诱导点把 $T$ 行压缩成 $m$ 个摘要,再读回全部行,把 $O(T^2)$ 的全注意力降为线性 $O(T\cdot m)$。
TabFM 的列编码阶段正是 256 诱导点的 ISAB,这是它能把上下文扩展到 16,384 行的关键,论文的复杂度分析和防泄漏设计都建立在这个模块之上。
旋转位置编码(RoPE)
RoPE 把位置 $p$ 的信息以旋转矩阵 $R_{\Theta,p}$ 的形式作用于 query 和 key,使注意力得分只依赖相对位置差。它不需要可学习的位置查表,因此序列长度不被权重固定,具备外推到比训练更长序列的潜力。
TabFM 把 RoPE 限定在特征轴(列方向),使列数 $H$ 不被预训练权重锁死,推理时能处理超过训练上限 100 列的宽表,这也是 TabFM+ 列置换增强可行的前提。
结构因果模型(SCM)
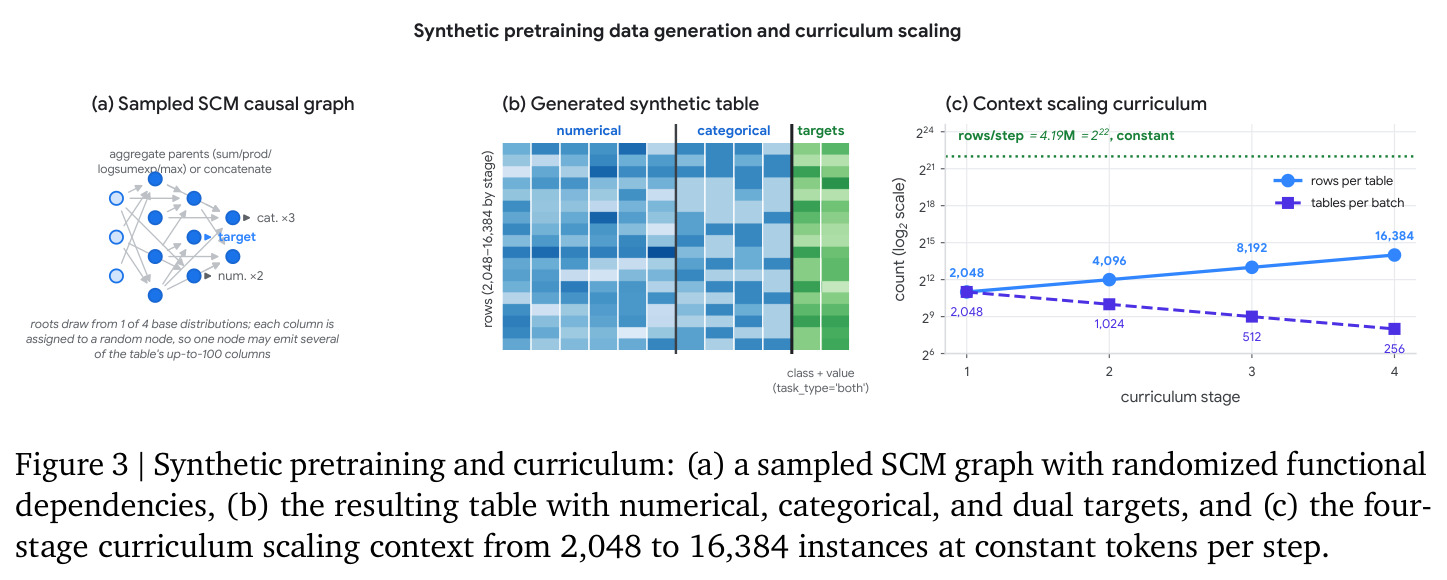
SCM 用有向无环图(DAG)描述变量间的生成机制:每个节点是其父变量的随机函数。采样一条 DAG 并随机化函数形式后,根变量经非线性变换与代数聚合(求和、乘积、logsumexp、max)向下游传播,就能生成列之间带真实统计依赖、混合连续与离散类型的合成表格。
TabFM 完全不用真实数据预训练,SCM 合成表就是它的全部训练语料,理解 SCM 才能判断这种训练分布为何能覆盖真实任务的多样性并支持零样本迁移。
Bradley–Terry / Elo 评分
Bradley–Terry 模型把两两比较结果映射为方法强度:$i$ 击败 $j$ 的概率为 $\sigma(s_i-s_j)$。TabArena 在(数据集, 折)粒度上拟合 Elo,以 Random Forest 锚定 1000 分,取 100 次 bootstrap 的中位数,让不同数据集上的异构评估指标能在同一尺度上汇总比较。
TabArena 的所有结论(如 TabFM 合计 1785.4 Elo 排名第一)都用 Elo 表述,不懂这个评分体系就无法正确解读论文实验部分的数字与排名。
研究动机
表格机器学习长期被“逐数据集工作流”主导:面对一个新任务,实践者要做定制预处理、用 GBDT(XGBoost、LightGBM)或随机森林从头拟合,或者跑 AutoGluon 这类多模型堆叠的 AutoML 搜索,动辄需要数小时预算(TabArena 中 AutoGluon 配置就有 4 小时档位),每个数据集都要从零学起。另一条路线是 PFN 式的上下文表格模型(TabPFN 系列),但它们受制于全单元注意力的 $O(T^2H^2)$ 复杂度——$T$ 行 $H$ 列的表格里跨行注意力是二次的,历史上只能处理不到 1000 行的小表;同时连续值若用普通 embedding 编码会丢失数值分辨率,类别值又没有天然序关系,行可交换性还要求置换等变。因此“大样本、宽表、单次前向出预测”这一目标此前没有模型同时达成,TabArena 51 个数据集的榜首长期由 4 小时 AutoML 与调参基线把持。
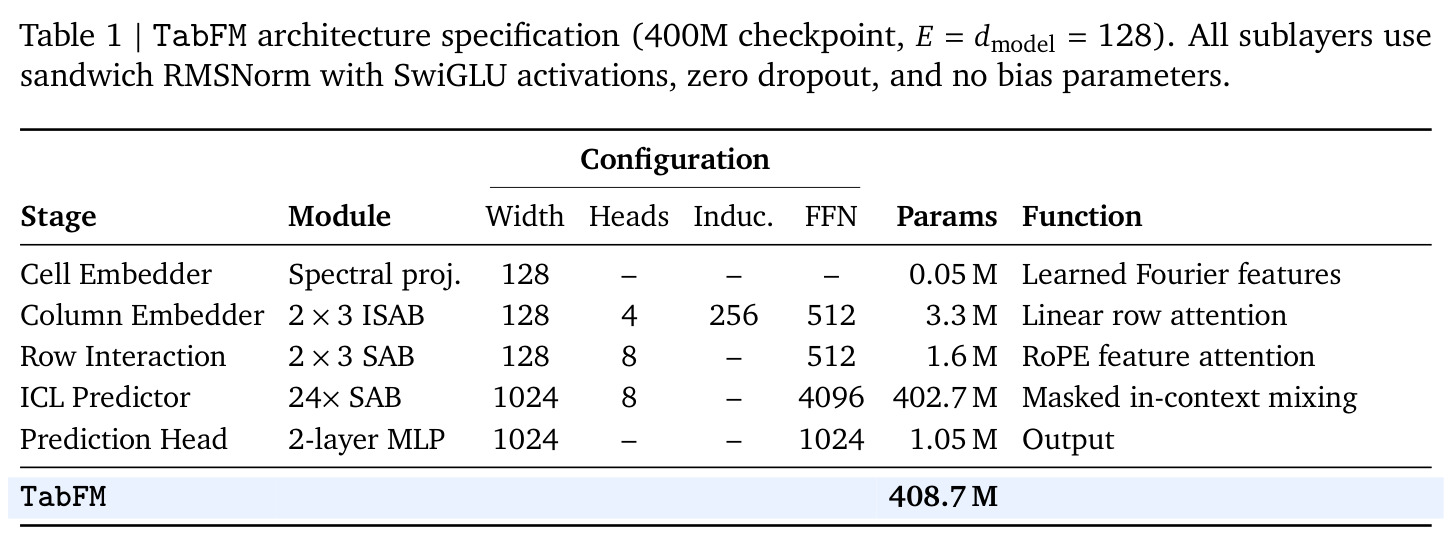
本文的目标是本文的目标是构建一个真正零样本的表格基础模型 TabFM:一个 400M 参数(总参数 408.7M)的 Transformer,把监督表格预测统一为上下文学习,在单次前向中对任意新数据集输出校准的概率预测,全程不做任务特定微调。具体量化目标包括:把可处理的上下文规模从以往的不到 1000 行提升到 16,384 行、最多 100 列;仅在结构因果模型生成的合成表上训练就能零样本迁移到真实任务;在 TabArena 基准(51 个数据集:38 个分类共 594 个任务、13 个回归共 222 个任务;对比池共 67 个方法配置)的分类与回归两条赛道上都超过 EXAONE-Tabular、TabPFN-3、AutoGluon 等最强基础模型与 AutoML 系统;并在权重完全冻结的前提下,通过推理期集成(TabFM+)与 LLM 引导的特征工程(TabFM-Auto)两个可选扩展进一步拉开差距。
与已有工作不同的是,论文的独特切入有三点。其一,训练信号完全来自合成数据:用随机采样的结构因果模型生成同时带分类和回归双目标的表格,并联合随机化表形状、类别列比例与基数、缺失、标签噪声和类别平衡,避开真实语料的许可与偏差问题,让零样本迁移成为可能。其二,架构上把“特征编码”与“跨实例推理”解耦:列方向用 256 个诱导点的 ISAB 实现 $O(T\cdot m)$ 线性复杂度,行方向用带 RoPE 的 SAB 编码特征交互,使列数不被权重固定;非对称上下文掩码 $M_{ctx}$ 保证测试行只注意带标签前缀、彼此条件独立,既防标签泄漏又允许查询块任意拆分重排。其三,把部署明确分为三个层级(零样本 TabFM、推理期增强 TabFM+、Gemini 程序合成的 TabFM-Auto),且全程冻结权重,这在同代表格基础模型工作中是最系统的推理期扩展方案。
核心方法
TabFM 的直觉:既然表格任务的统计结构可由因果图生成,那么在足够多样的合成任务上训练大 Transformer,就能把“从带标签样本中学习并预测”压进权重,推理时一次前向完成。技术上是一条四阶段流水线:先用学习型傅里叶频率库把单元格投影成 128 维谱嵌入(数值保持度量尺度、类别映射为独立向量,二进特征分组捕捉局部交互);再交替执行线性复杂度的列向 ISAB(256 诱导点、沿行轴聚合列统计)与带 RoPE 的行向 SAB(沿特征轴捕捉交互),两阶段各 3 块且不共享权重,8 个 CLS token 池化出 1024 维行表示;接着 24 层宽 1024 的 SAB 预测器在带标签上下文条件下做隐式多步推理(402.7M 参数,约占总参数 98%);最后经三明治 RMSNorm 的 2 层 MLP 头输出。预训练全程用 SCM 合成表,四阶段课程把上下文从 2,048 行扩到 16,384 行,每步 token 恒为 $2^{22}\approx 4.19$M,损失只在 query 行上、联合覆盖分类与回归双目标。
核心创新是把“表格预测的摊销”推到此前不可及的规模,关键在三个设计决策。第一,非对称上下文掩码 $M_{ctx}$:所有行只允许注意带标签的训练前缀 $k\le T_{train}$,测试行互不通信,保证给定 $\mathcal{D}_{train}$ 时查询条件独立——这不仅是防泄漏技巧,更让 ISAB 的诱导摘要 $\mathrm{MAB}(I,X;M_{ctx})$ 只由训练行计算,把列统计“广播”给每行而不串信息。第二,用 ISAB 而非全注意力做跨行编码:$T\times H$ 表的全单元注意力是 $O(T^2H^2E)$,TabFM 把跨行注意压到 $O(T\cdot m\cdot E)$($m=256$),跨行深度推理只发生在池化后的 1024 维行表示上($O(T^2d)$ 且只做一次),上下文因此达 16,384 行,比 TabPFN 初代大一个数量级。第三,RoPE 只用于特征轴:相对位置编码让列数 $H$ 与权重解耦,推理可超出预训练 100 列上限,也为 TabFM+ 的列置换视图增强提供架构基础。
方法步骤详情
流程分五步。第一步,细胞嵌入:输入 $T\times H$ 的表,每列 $j$ 与二进偏移 0、1、3 的邻居组成 3 个槽位($j_g=(j+2^{g-1})\bmod H$),每槽用 32 个可学习傅里叶频率 $\omega_g$ 把标量投影为 $\gamma_g(v)\in\mathbb{R}^{64}$,数值/类别各用独立频率库与投影,跨槽求和得 $X^{(0)}\in\mathbb{R}^{T\times H\times 128}$,训练行每格加目标嵌入 $e(y_i)$。第二步,列嵌入:2 组×3 个 ISAB(4 头、$m=256$ 诱导点、FFN 512)以 $M_{ctx}$ 掩码在行轴上线性聚合列统计。第三步,行交互:2 组×3 个 SAB(8 头)沿特征轴做带 RoPE 的注意力($M_{pad}$ 掩码),第一阶段后前置 8 个 CLS token,最终拼接成 $r_i\in\mathbb{R}^{1024}$。第四步,ICL 预测:训练行表示再叠一次 $e(y_i)$,24 层宽 1024、FFN 4096 的 SAB 在 $M_{ctx}$ 下混合,2 层 MLP 头输出预测。第五步,预训练与课程:从 SCM 采样 DAG 生成双目标合成表(≤100 列,随机化缺失/噪声/类别平衡),上下文 2,048→16,384 行、批量减半保持每步 $2^{22}$ token;部署可选 TabFM+($K=32$ 视图 NNLS 集成+Platt 校准)或 TabFM-Auto(Gemini-3.8-Flash 闭环特征工程,96 次评估或 6 小时)。
技术新颖性
与已有工作的本质区别在四处。相对 TabPFN 初代(上下文<1000 行):TabFM 用列向 ISAB 把跨行复杂度从二次降到线性,上下文扩到 16,384 行,并验证“先小上下文大批量、后长上下文小批量”的课程可平稳扩展尺度,这在表格基础模型中是首次系统演示。相对 TabPFN-3 与 TabICLv2 的行列解耦:TabFM 的列注意力显式携带 $M_{ctx}$,把“只用带标签行估计列统计”变成架构保证而非训练副作用,从结构上杜绝测试行间信息流。相对树模型的数值处理:32 个可学习傅里叶频率保持连续值的度量结构,作者以此解释回归赛道优势更大(回归领先 EXAONE 82 分而分类仅 0.6 分),因为谱嵌入输出连续而树模型是分段常数。相对 AutoML:TabFM+ 证明冻结权重可通过 32 个变换视图(随机列置换、Yeo–Johnson 预条件、跨特征乘积与截断 SVD)自集成涨 69–134 Elo;TabFM-Auto 证明 LLM 程序合成可在不动权重的前提下超越 4–6 小时的 AutoGluon,为“基础模型+推理期计算”范式提供表格领域最完整的证据链。
实验结果
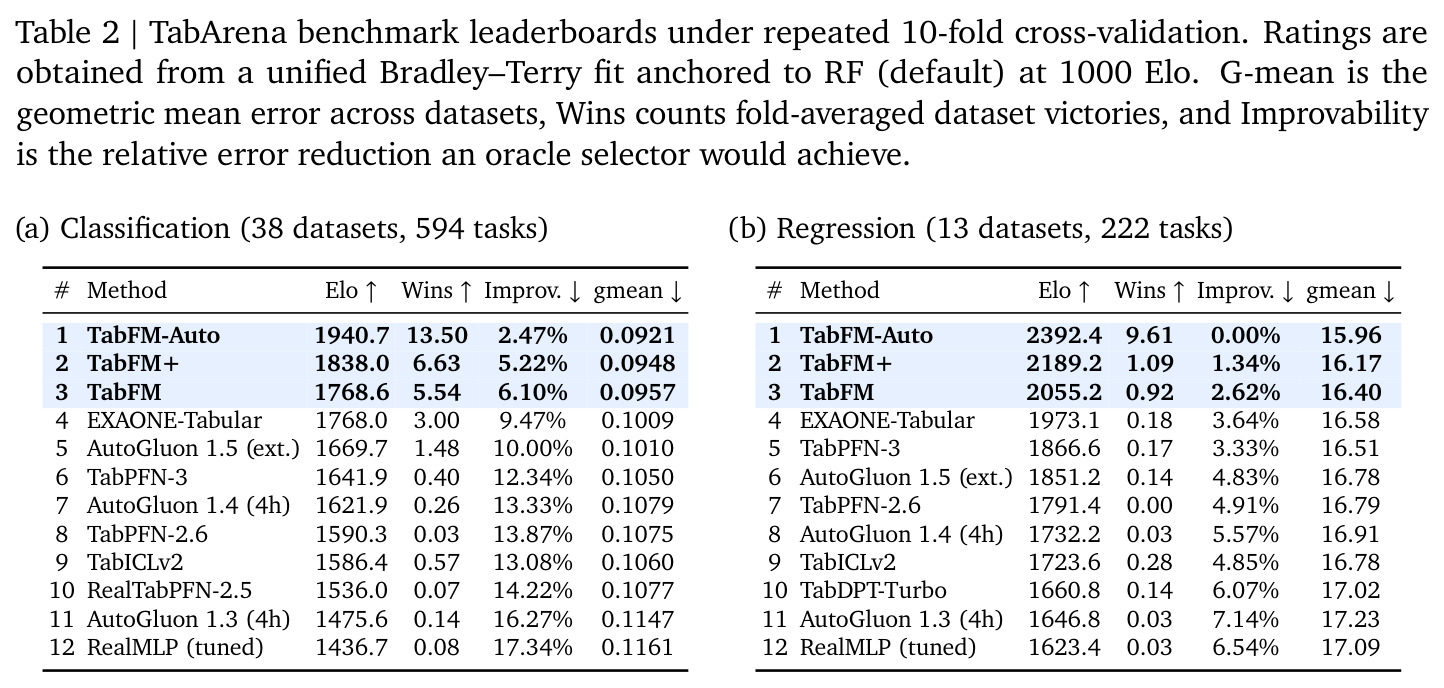
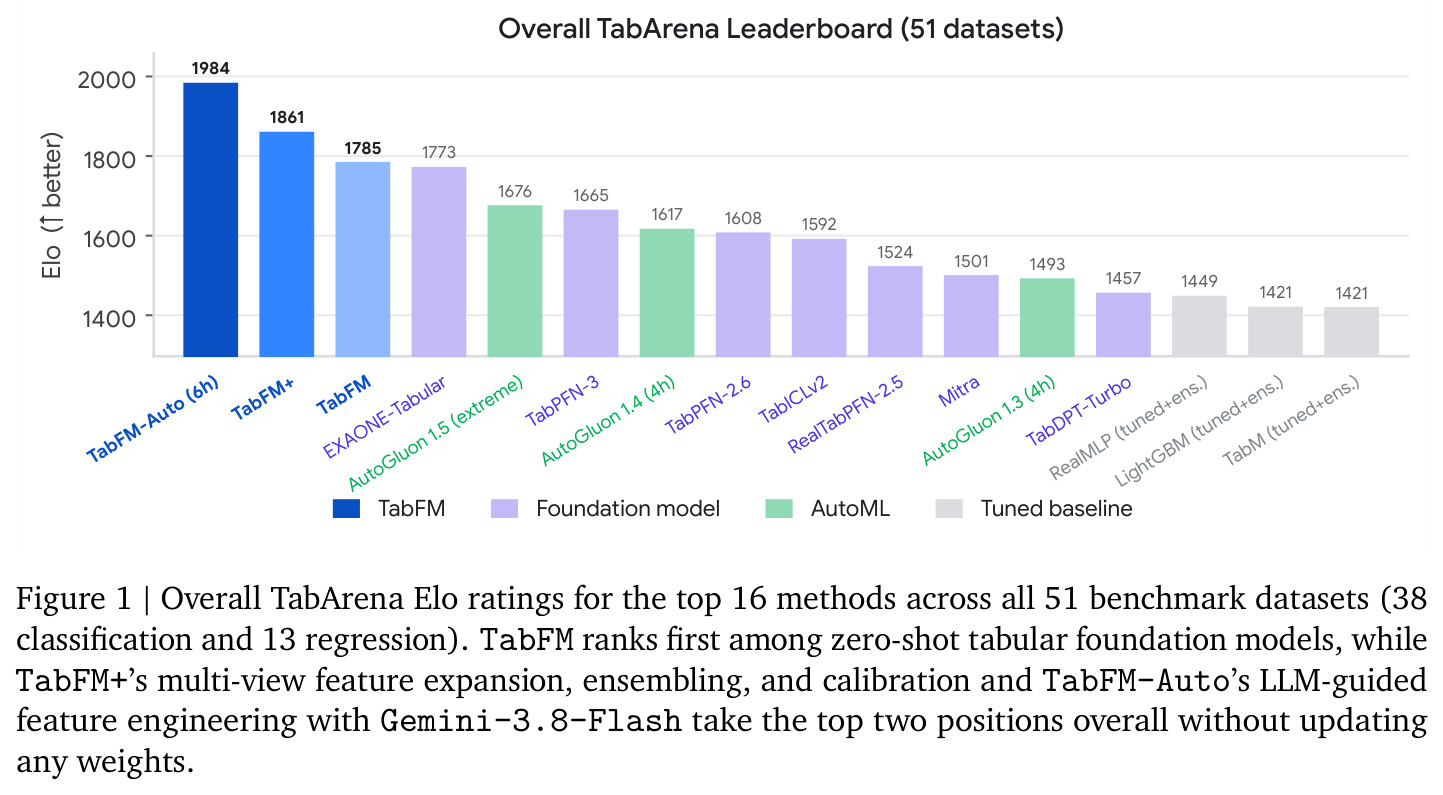
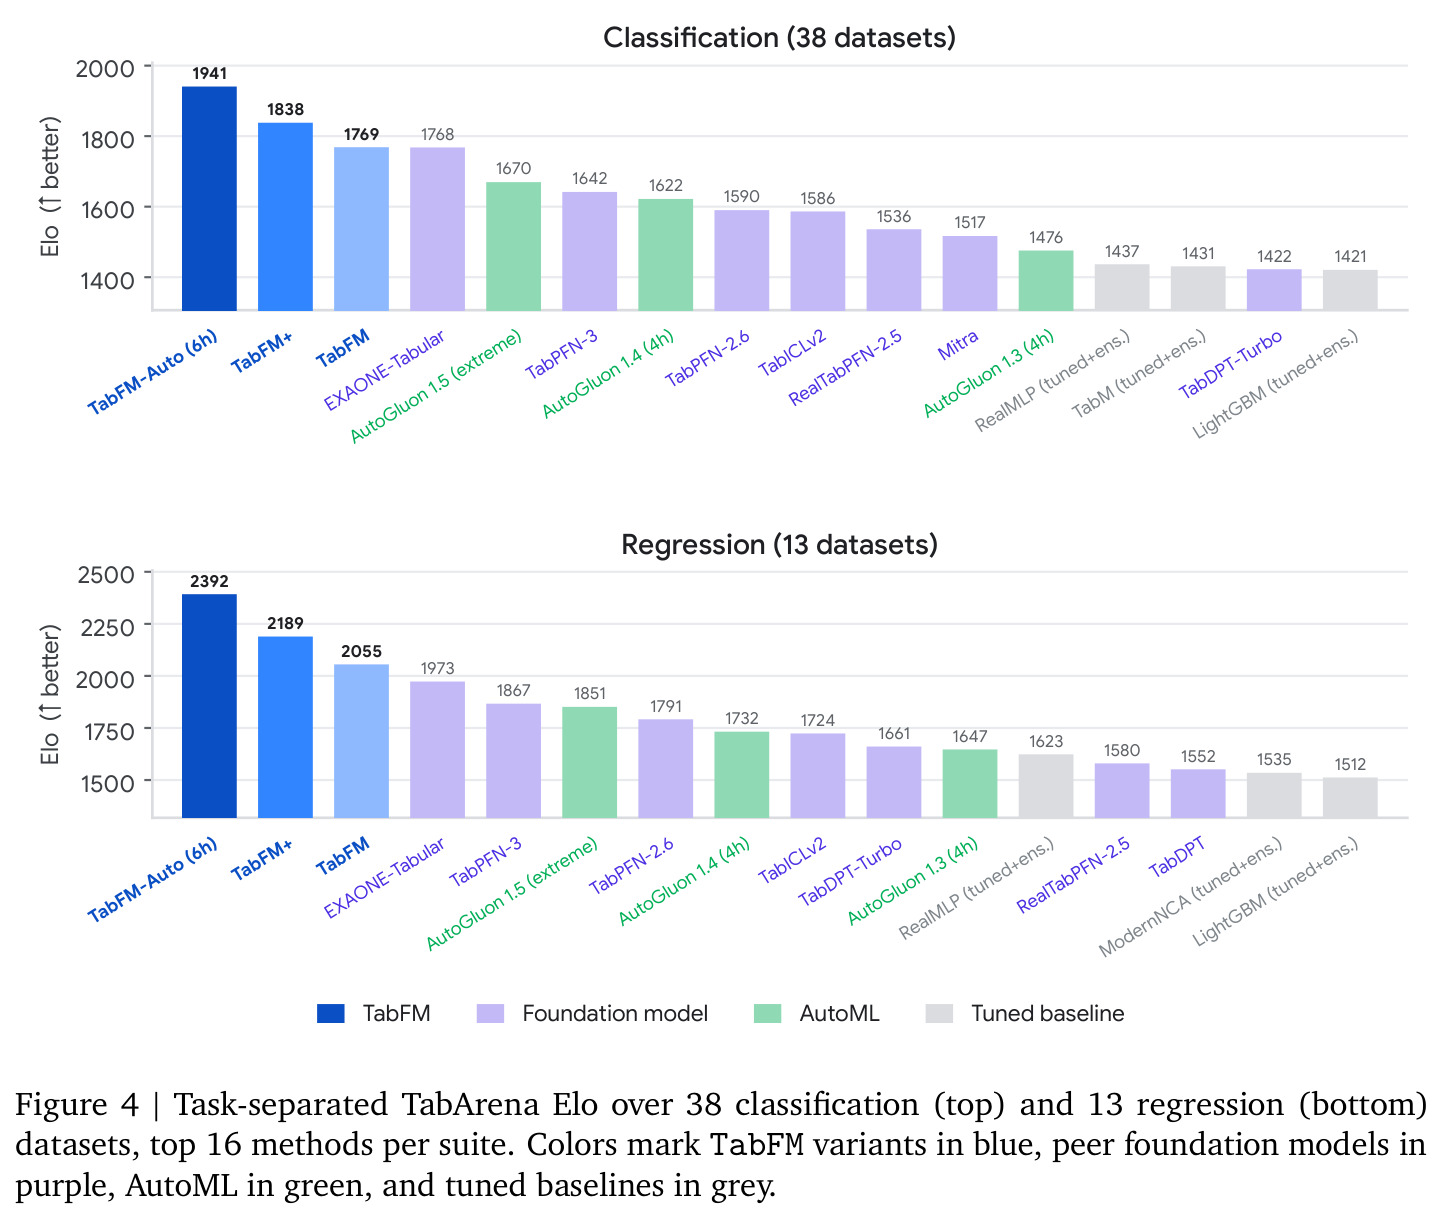
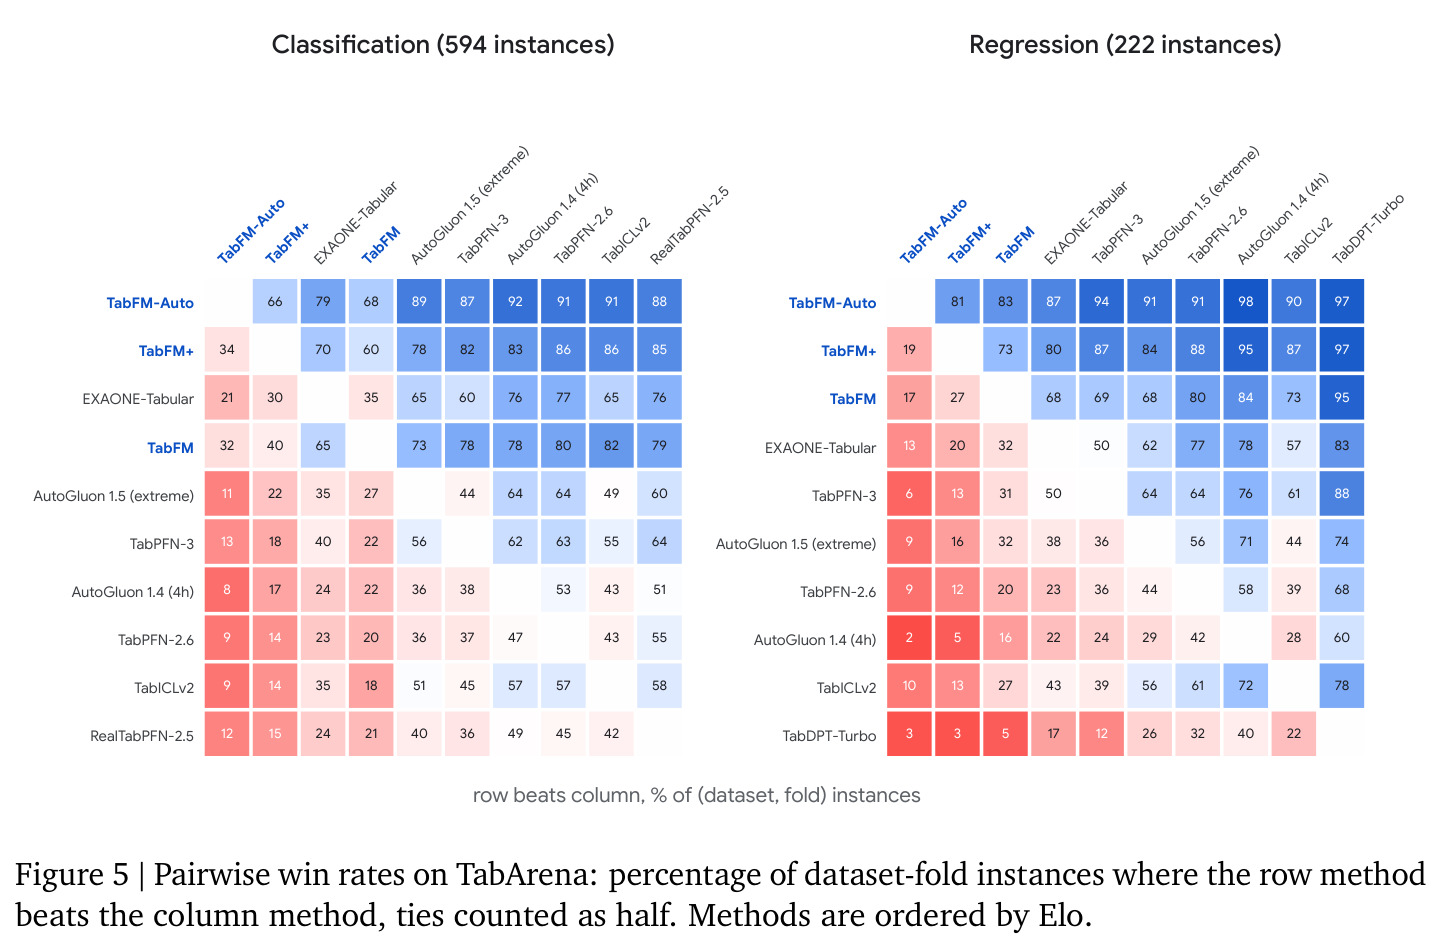
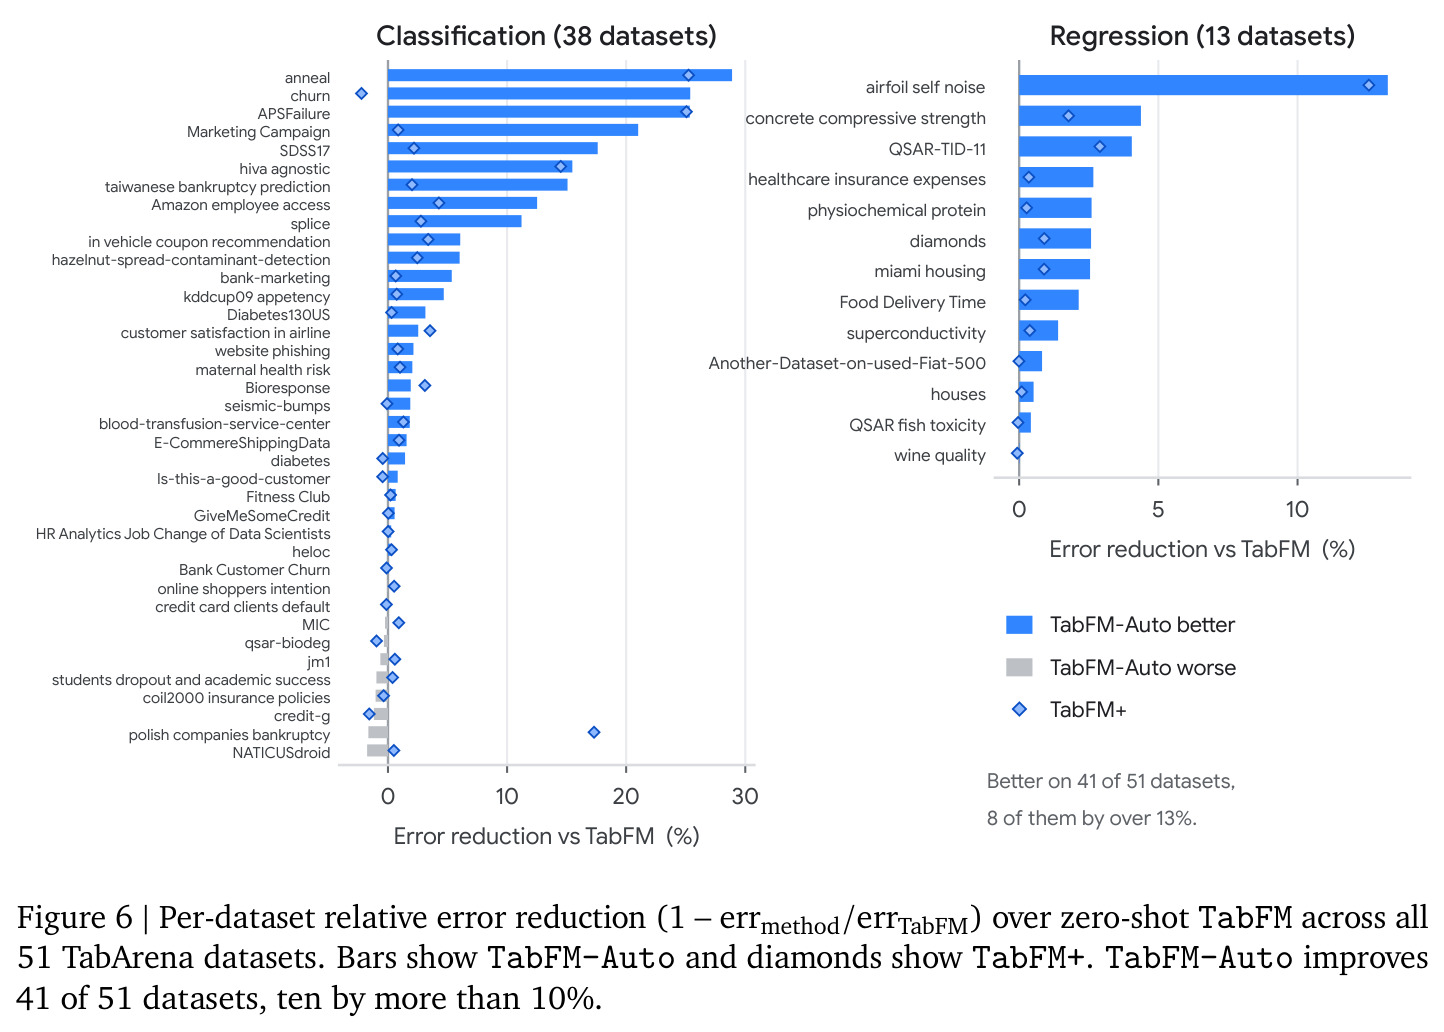
主实验在 TabArena(51 数据集、重复 10 折、67 个方法、Elo 锚定 RF=1000)上进行。零样本 TabFM 合计 1785.4 Elo,居默认基础模型之首:分类 1768.6(EXAONE-Tabular 1768.0、AutoGluon 1.5 extreme 1669.7、TabPFN-3 1641.9),g-mean 0.0957 全场最低、胜场 5.54 最多、oracle 可改进空间 6.10% 最低;回归优势更大,2055.2 领先 EXAONE(1973.1)82 分、领先 TabPFN-3(1866.6)近 190 分,g-mean 16.40 最低、improvability 2.62%。头对头胜率随 Elo 差单调上升:对 EXAONE 65.7%、AutoGluon 1.5 extreme 72.1%、TabPFN-3 75.9%、TabICLv2 79.8%。冻结权重下 TabFM+ 用 $K=32$ 视图集成再涨 +69.4(分类 1838.0)与 +134.0 Elo(回归 2189.2),回归涨幅近两倍,说明集成主要在连续输出上降方差。TabFM-Auto 登顶全部 67 个方法:分类 1940.7(+172.1)、回归 2392.4(+337.2),改善 41/51 个数据集(8 个超 13%),回归 13/13 全改善且 improvability 归零;未改善的 10 个分类集误差至多升 1.8%。归因显示增益主要来自特征构造:程序改动过表的样本中位误差降 2.14%,未改动仅 0.27%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TabArena 总体排名(51 数据集合并) | Bradley–Terry Elo | TabFM 1785.4(零样本基础模型第一);TabFM+ 1861;TabFM-Auto 1984(全场第一) | EXAONE-Tabular 1773;TabPFN-3 1676;AutoGluon 各档位 1592–1665;LightGBM/RealMLP 约 1421–1449 | TabFM 零样本领先最强基础模型约 12 Elo;TabFM-Auto 领先最佳 AutoML 超过 300 Elo |
| 表格分类(38 数据集 / 594 任务) | Elo / g-mean / oracle 可改进空间 | TabFM 1768.6 / 0.0957 / 6.10%;TabFM+ 1838.0;TabFM-Auto 1940.7 | EXAONE-Tabular 1768.0;AutoGluon 1.5 extreme 1669.7;TabPFN-3 1641.9;TabICLv2 1586.4 | TabFM+ 相对 TabFM +69.4 Elo;TabFM-Auto +172.1 Elo |
| 表格回归(13 数据集 / 222 任务) | Elo / g-mean / oracle 可改进空间 | TabFM 2055.2 / 16.40 / 2.62%;TabFM+ 2189.2;TabFM-Auto 2392.4 / 0.00% | EXAONE-Tabular 1973.1;TabPFN-3 1866.6;AutoGluon 1.5 extreme 1851.2;TabPFN-2.6 1791.4 | TabFM 领先最强基线 82.1 Elo;TabFM-Auto +337.2 Elo,13/13 数据集全部改善 |
| 头对头胜率(816 个数据集-折实例) | 获胜折的比例 | TabFM 对 EXAONE-Tabular 胜 65.7% | 对 AutoGluon 1.5 extreme 胜 72.1%、对 TabPFN-3 胜 75.9%、对 TabICLv2 胜 79.8% | 对全部主流基线保持 >65% 胜率,且胜率随 Elo 差单调上升 |
局限与改进
作者明确承认的限制:预训练只覆盖最多 16,384 行、100 列的合成数值/类别表,更大的表格要靠长度泛化或子采样;自由文本字段没有语义分词能力,时间戳和高基数标识符也未覆盖。我的补充观察:其一,分类赛道优势极其微弱——1768.6 对 EXAONE-Tabular 的 1768.0 仅差 0.6 Elo,前四名挤在约 130 Elo 内,论文自己也承认 TabFM 的领先主要体现在低 regret(oracle 可改进空间 6.10% 对 9.47%)而非逐数据集必胜,在具体业务数据集上未必稳定占优;其二,TabFM-Auto 虽登顶但依赖闭源 Gemini-3.8-Flash,单数据集最多 6 小时与 96 次评估,成本比“单次前向”高若干个量级,与零样本卖点属于两种使用模式;其三,基准集以中小规模 UCI 风格数据为主,百万行工业级表格上没有直接证据;其四,Elo 锚定与数据集等权的选择会影响排名解读,分类 594 任务对回归 222 任务的不平衡也使合并榜偏向分类表现。
独立分析的弱点
独立分析有五个弱点。1) ISAB 的 256 诱导点是信息瓶颈:跨行依赖先被压缩到 $m$ 个向量再读回,若列间存在需要多跳传播的高阶结构,压缩会损失细节,改进方向是层级化诱导点或按列负载自适应分配容量。2) 特征轴 100 列上限依赖子采样:基因组、推荐场景常有数千列,随机子列会丢弃弱但真实的信号,可引入稀疏特征注意力或按互信息排序的列选择。3) 训练分布与真实的 gap:SCM 的聚合形式(求和/乘积/logsumexp/max)覆盖不了真实数据中的选择偏差、时间漂移与漏斗结构,分类赛道仅 0.6 Elo 的领先可能正是这种 gap 的体现,可在预训练中混入少量真实语料。4) TabFM+ 把推理成本放大 32 倍,且 NNLS+Platt 堆叠需要内部验证折,小数据集上集成权重估计噪声大,可蒸馏成单视图或学习视图采样策略。5) TabFM-Auto 是黑盒 LLM 搜索循环,反馈仅有分数与 traceback,96 次评估内易陷局部最优,应显式缓存已验证的特征算子库并支持跨数据集迁移复用。
未来方向
作者提出的方向:把预训练直接扩到百万行、千列规模,用分层行池化与稀疏特征注意力保持可行;把合成因果先验与真实表格语料、预训练文本/时间编码器结合,扩展到含自由文本字段、时间戳、高基数标识符的多模态表格;把架构从单张平面表推广到关系型 schema,免去手工 join 与展平;最有趣的是把 TabFM-Auto 合成出的特征工程管线蒸馏回预训练,让特征发现直接发生在前向传播内部。基于本文成果可延伸的研究:一是上下文外推的系统研究——16,384 行是训练上限,测试时能否配合位置插值或记忆机制处理更长上下文;二是利用 $M_{ctx}$ 的条件独立性质做严格的不确定性量化与共形预测校准;三是把 TabFM+ 的视图预算与 TabFM-Auto 的搜索预算统一为“推理期计算最优分配”问题,按数据集难度自适应分配算力;四是在隐私敏感的医疗/金融场景验证纯合成训练是否确实规避了训练数据记忆风险,这可能是该路线最大的制度性优势。
复现评估
复现条件分层明显。零样本推理层最容易:400M 的 PyTorch 权重已开源在 HuggingFace(google/tabfm-1.1.0-pytorch),TabArena 基准公开(Erickson et al., 2025),数据集多为公开表格数据,单卡即可跑 16,384 行上下文的推理,普通实验室一两天可复现表 2 的 TabFM 行。TabFM+ 层中等:视图构造(跨特征、截断 SVD、列置换、Yeo–Johnson、标签循环移位)与 NNLS/Platt 堆叠描述足够细($K=32$、内部验证折拟合、$w_{final}=0.75w+0.25\mathbf{1}/K$ 收缩),属数百行代码工程量。最难的是预训练与 TabFM-Auto:论文未给出总 GPU 时,DAG 采样超参与随机化变量分布未开源,400M×四阶段课程全量复现估计需数十卡天;TabFM-Auto 依赖 Gemini-3.8-Flash 的访问与计费,闭环细节引用 Fu et al. (2026a)。总体判断:推理与评测级复现友好,训练级复现需要显著算力且缺关键细节。
论文图表