学习采样之外:面向RLVR的离策略感知跨模型轨迹交换 Learning Beyond What You Sample: Off-Policy-Aware Cross-Model Trajectory Exchange for RLVR
两个异构模型互换彼此全错提示上的同伴轨迹,等预算下GRPO平均多涨2.1分
前置知识
RLVR(可验证奖励强化学习)
用程序化验证器(如数学答案比对、单元测试)自动给出0/1奖励的强化学习后训练范式,不依赖人工标注或学习的奖励模型,代表工作有DeepSeek-R1、Tulu 3。本文的奖励由 math_verify 检查最终 \boxed{} 答案,验证超时记0分,无格式或长度奖励。
交换的前提是奖励可独立复核:GRAFT 和存储轨迹版都会重新验证同伴回答的奖励;二值奖励也是GRPO组内归一化和“源方优势”设计的地基。
GRPO 与组相对优势
Group Relative Policy Optimization:对每个提示采 $n$ 条回答,优势按组内归一化计算 $\hat{a}_i=\frac{r_i-\mathrm{mean}(R(q))}{\mathrm{std}(R(q))+\epsilon_{adv}}$,不需要价值网络。当组内全对或全错时奖励方差为零,所有优势变为零,该提示对策略梯度的贡献为零。
全错(all-fail)组零梯度正是本文要解决的问题;理解组内归一化才能明白为何要整组替换并保留源方优势、禁止跨模型池化奖励。
离策略学习与重要性采样
当训练数据由行为策略 $\pi_\beta$ 生成而更新对象是 $\pi_\theta$ 时,需用比率 $\rho_{j,t}=\pi_\theta(o_t|q,o_{<t})/\pi_\beta(o_t|q,o_{<t})$ 校正分布差异;PPO 进一步把 $\rho$ 裁剪到 $[1-\epsilon,1+\epsilon]$ 附近以防止单步更新过大。
同伴轨迹对接收方是极端的离策略数据(连分词器都不同),GRAFT 的序列级兼容性权重与 token 级裁剪正是把离策略修正拆成两层来处理。
分词器异构
不同 LLM 使用不同分词器,同一回答字符串会被切成不同 token 序列,逐 token 概率无法对齐,两个策略之间的精确似然比率在数学上没有定义。论文把回答 $o$ 在模型 $M$ 词表下记为 $o^M=(o^M_1,\dots,o^M_{|o^M|})$ 以显式区分分词。
这是跨模型轨迹交换区别于普通离策略 RL 的核心障碍:GRAFT 只能在接收方自己的分词上计算 token 级比率,跨模型差异只能交给近似的序列级兼容性分数。
token 级损失与非对称裁剪(DAPO 风格)
把策略损失按 token 数而非样本数归一化(token-mean),并把 PPO 裁剪窗口设为非对称的 $[1-\epsilon_{low},1+\epsilon_{high}]$(本文为 $[0.8,1.28]$),以缓解对长回答的压制。GRAFT 的目标函数直接继承这套形式。
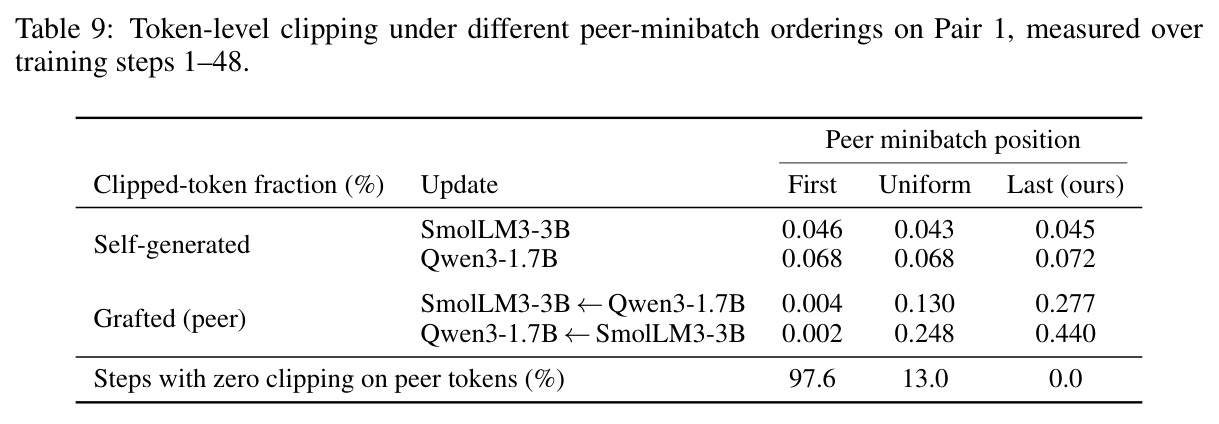
理解裁剪窗口何时激活(只有 $\rho$ 偏离1后才起作用),才能理解 GRAFT 中 peer-last 更新顺序这一设计为什么关键。
研究动机
GRPO 类 RLVR 方法完全依赖模型自己采样出的成功轨迹来学习:每个提示采 $n$ 条回答,用组内相对优势 $\hat{a}_i$ 加权更新。当 $n=8$ 条回答全部答错(all-fail 组)时,组内奖励方差为零、所有优势归零,这个提示对策略梯度毫无贡献。现有补救手段都在“自己多试几次”的框框里打转:DAPO 的动态采样丢弃零方差组后重采样、直接增大组规模($n=16/32$)、或用熵引导的优势塑形——它们要么推高 rollout 成本,要么在全错时最多只能压制已采样的错误,永远无法凭空补出一条正确轨迹。作者在 SmolLM3-3B-Base 与 Qwen3-1.7B-Base 两条独立 GRPO 训练线上量化了这一浪费:SmolLM3 解决了 Qwen3 全错提示中的 47.9%,Qwen3 也解决了 SmolLM3 全错提示中的 18.7%,且这种互补成功贯穿整个训练过程(Figure 1)。也就是说,每个模型都有大量“自己怎么做都做不对、但同伴轻松做对”的提示,其经过验证的正确解法被白白丢弃。
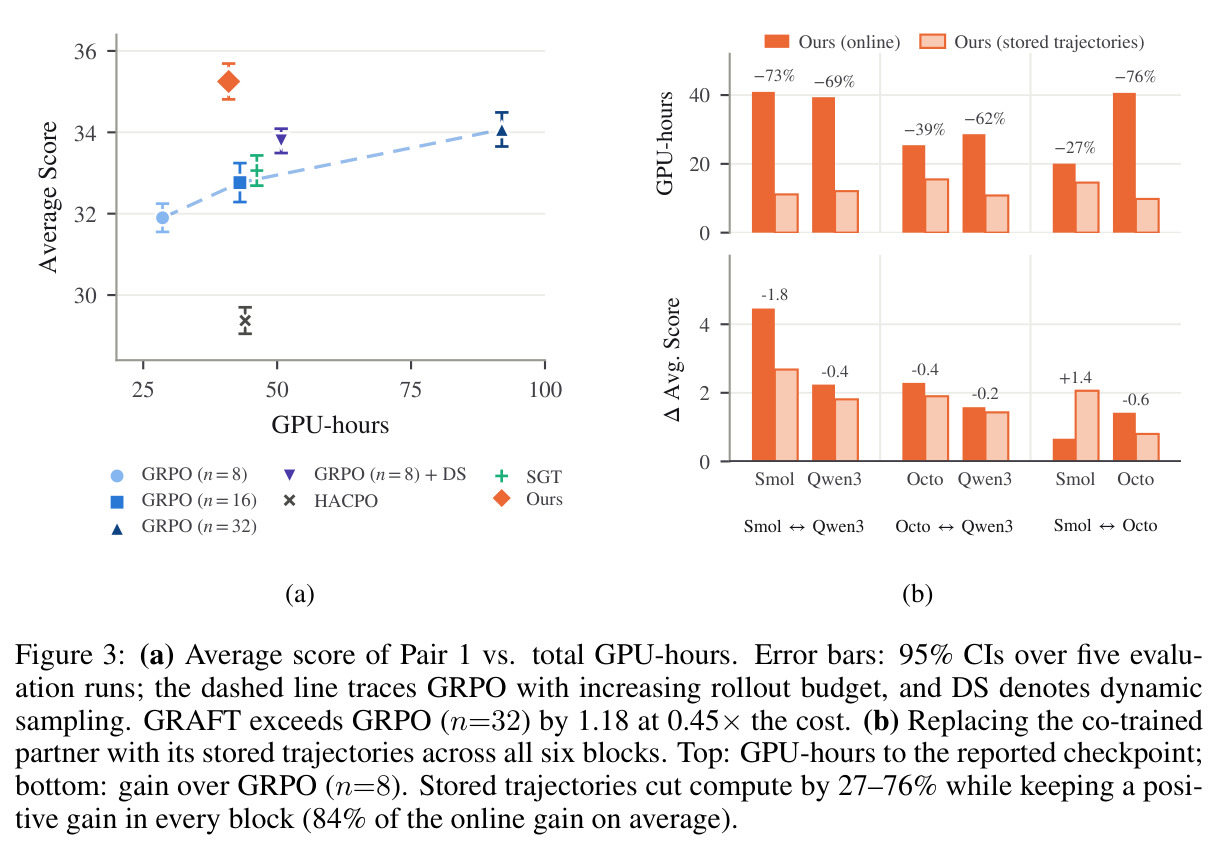
本文的目标是本文的目标是把这种跨模型的互补成功转化为可衡量的学习收益:让两个异构(不同预训练语料、不同分词器、不同架构)的小模型在 RLVR 训练中互相供给对方缺失的监督信号,且不依赖更强的教师模型、不增加每个模型的 rollout 预算(保持 $n=8$)。具体要回答两个耦合的设计问题:一是“换什么”——只在接收方自己 8 条全错、而同伴组内既有成功又有失败的提示上交换,且双向交换量要平衡,避免一方喂给对方大量数据而换不回来;二是“怎么学”——接收方如何在分词器都不同、策略分布严重偏移的同伴轨迹上安全地做策略梯度更新,防止同伴数据污染自身策略。作者还希望收益不依赖两模型同步共训:即使只有同伴历史训练中存下的轨迹(离线重放),大部分增益也应保留,从而支持异步、低耦合的多方训练协作。
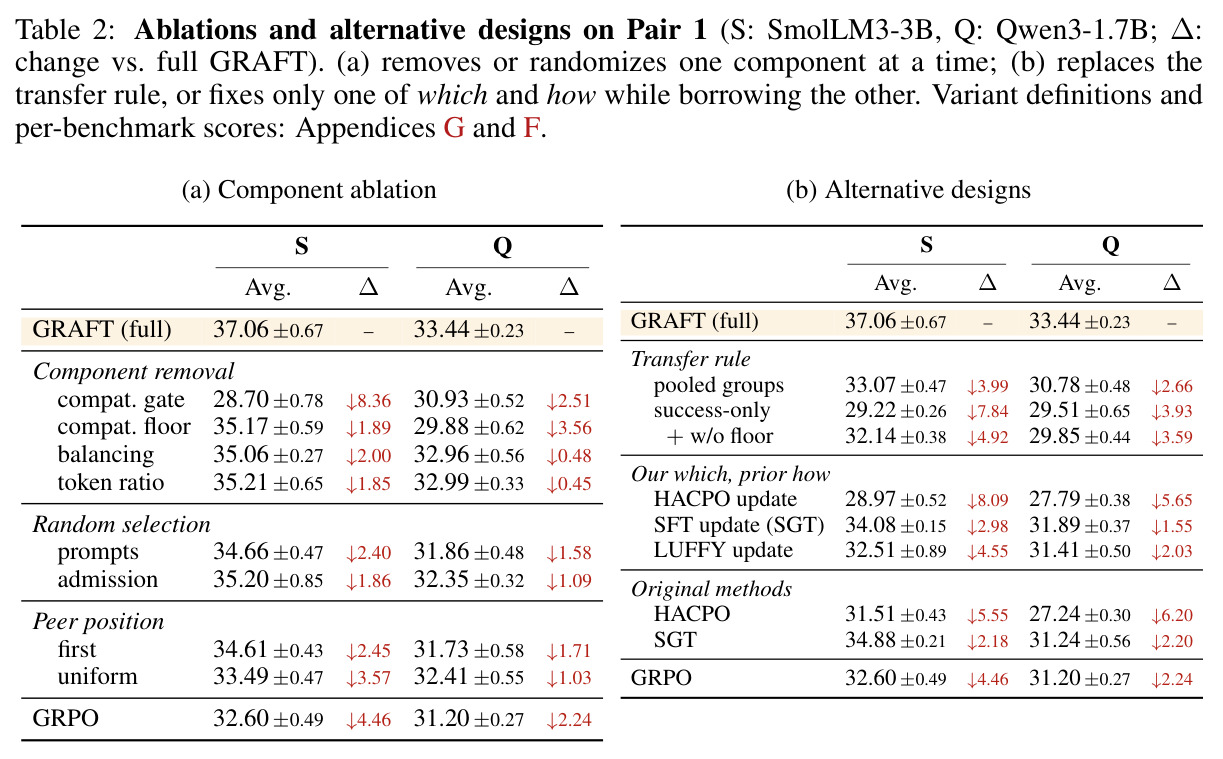
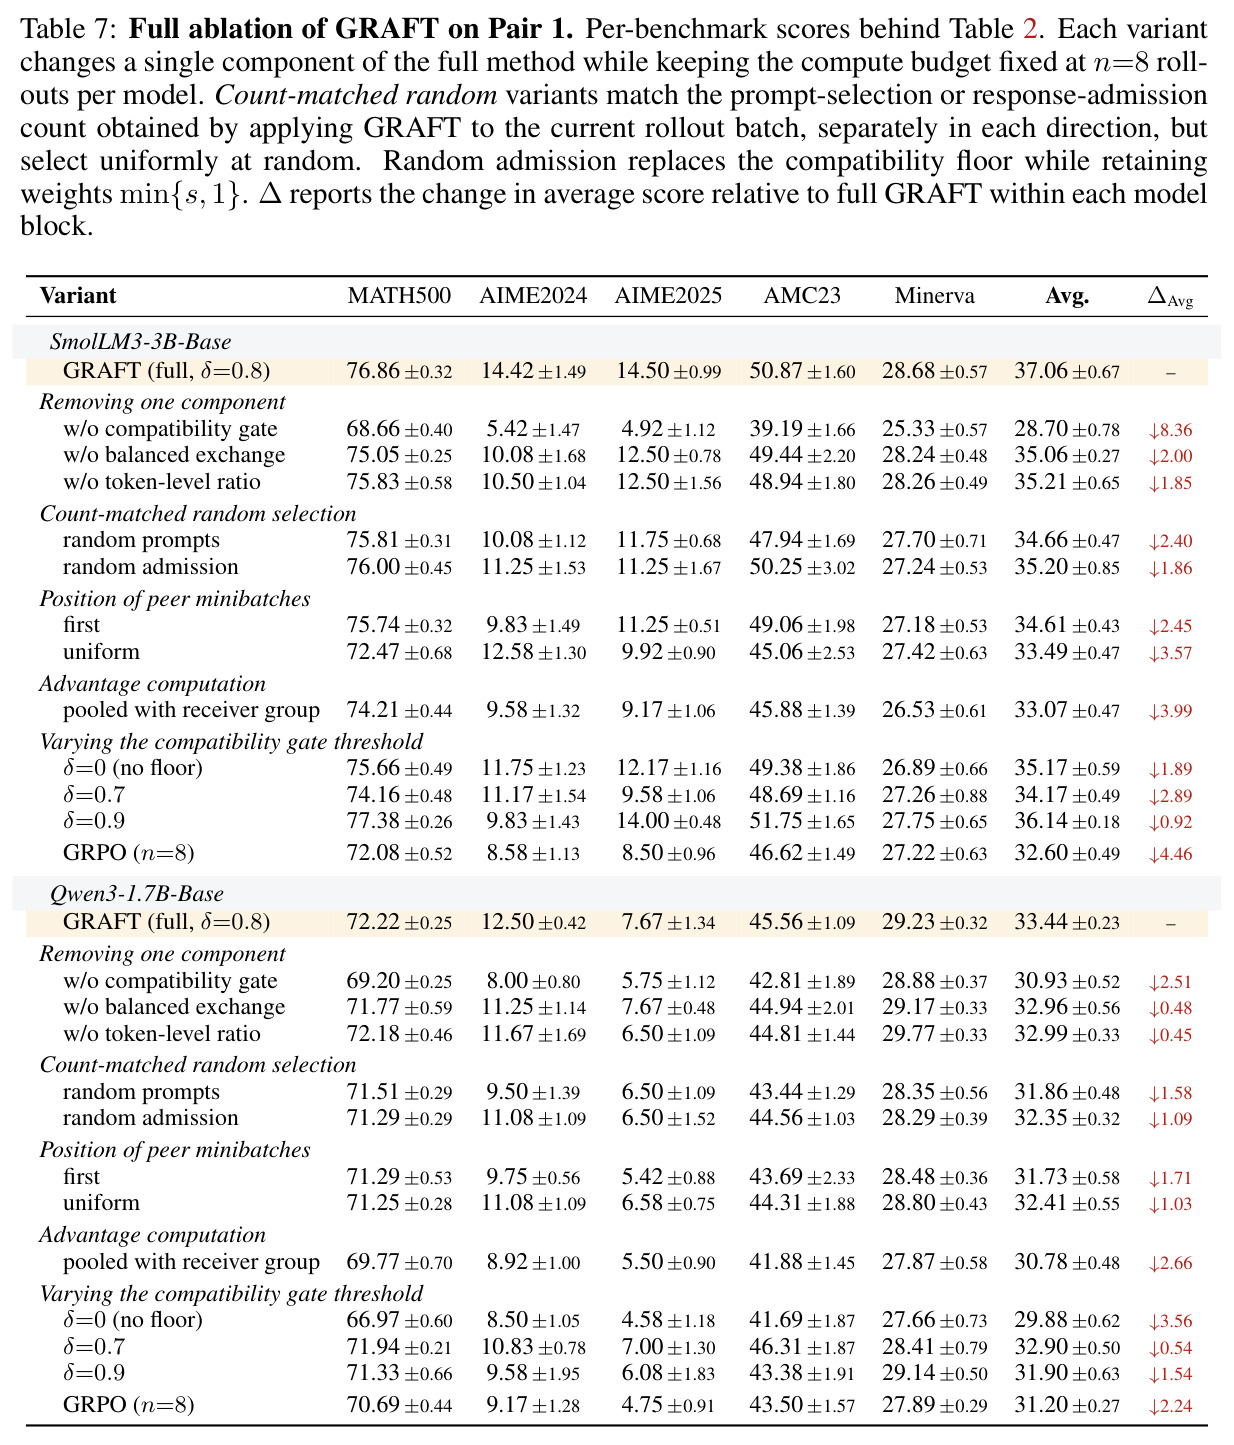
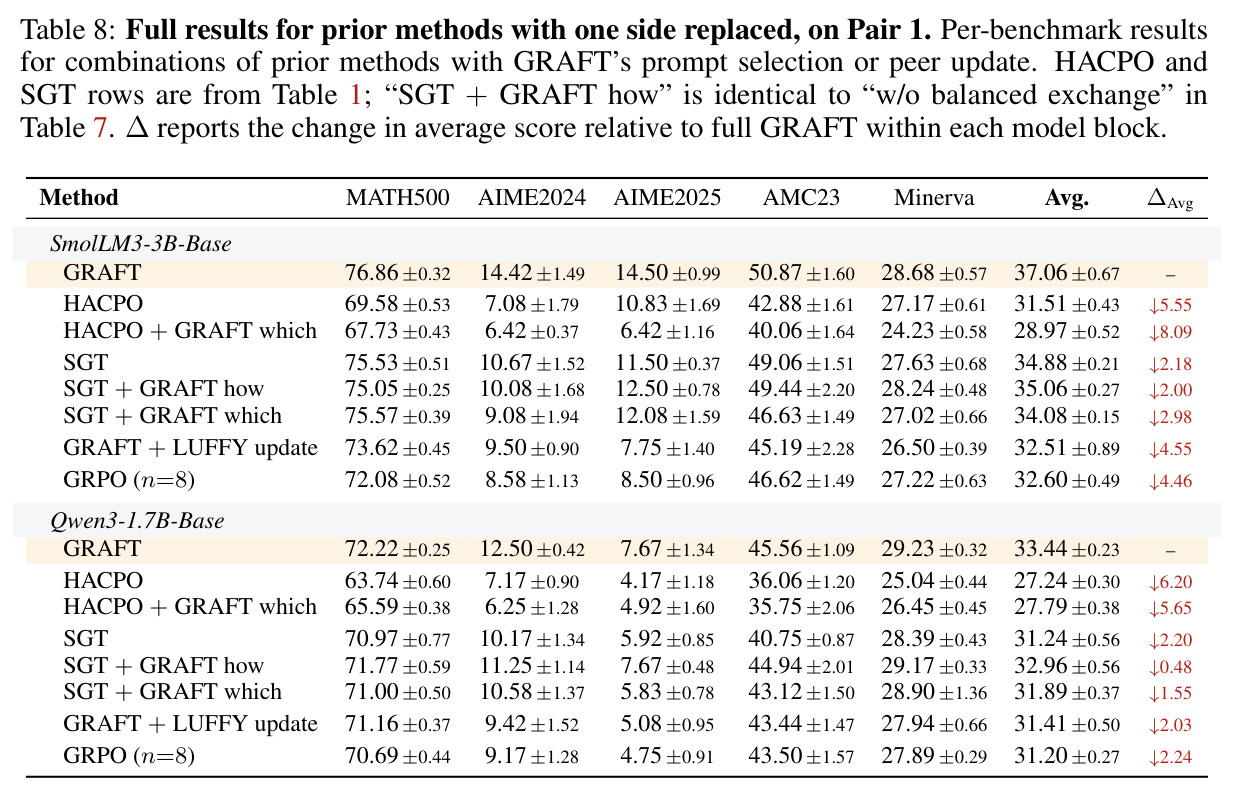
与已有工作不同的是,已有的跨模型工作各自只解决了“换什么”与“怎么学”的一半。HACPO 用能力感知优势估计、序列级重要性采样和裁剪来处理跨模型失配,但它在几乎所有提示上都共享同伴 rollout,并不限于接收方失败的提示,等于在已有在策略学习信号的更新上叠加离策略数据;SGT(Mutual RL)瞄准接收方全错的提示,但只用固定权重的监督负对数似然辅助损失学单条成功回答,没有任何基于兼容性的加权;F-TIS 只研究同家族、共享词表模型的协作 GRPO,不涉及跨分词器。本文的独特切入是把两个决策作为一个整体来设计:互补且平衡的提示选择,配上“整组替换+源方优势+兼容性门控+token级裁剪+peer-last更新顺序”的完整学习规则。消融证实两个决策必须配套:把 GRAFT 的选组规则套在 HACPO 的更新规则上比完整 GRAFT 掉 8.09/5.65 分,反过来 SGT 选组配 GRAFT 更新也差 2.00/0.48 分——单独拿到任何一半都不够。
核心方法
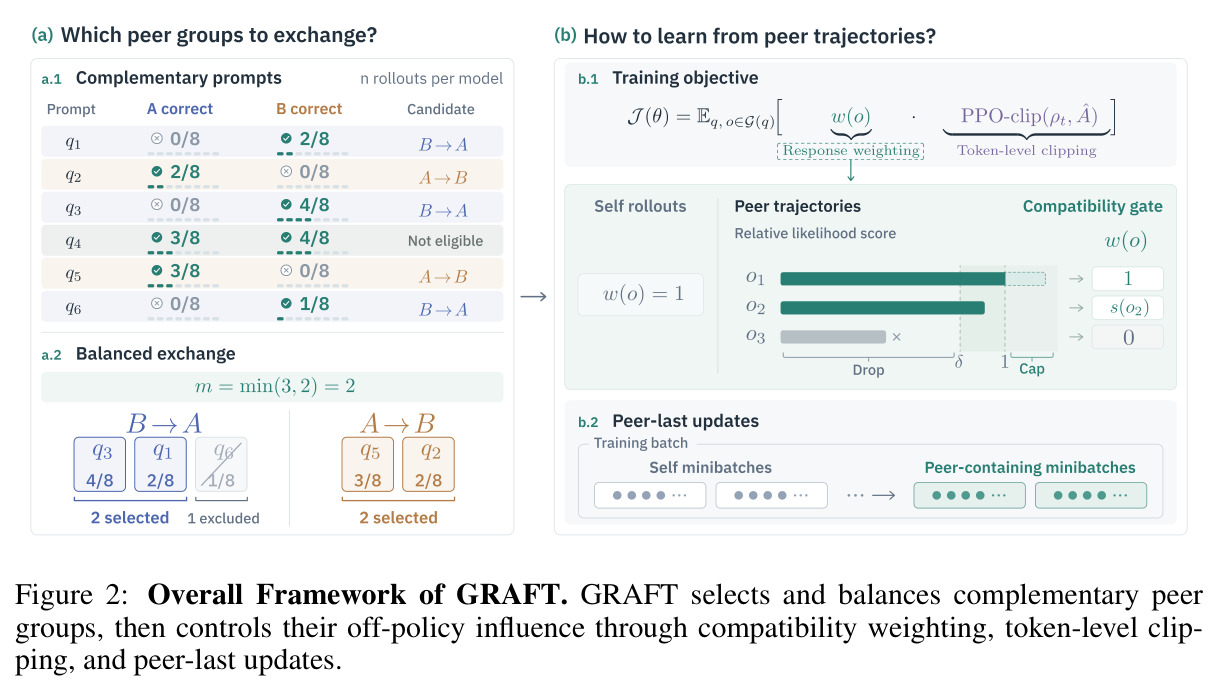
直觉上,GRAFT(Gated Replacement of Answer-Failed groups with peer Trajectories)把“自己 8 条全错、同伴做得出来”的提示当作免费教学素材:既然自己的 rollout 组方差为零、给不出任何梯度,不如整组换成同伴的 rollout 组——里面有验证正确的答案(正向信号)也有错误答案(负向信号),天然保留了组内奖励对比度。但直接照搬同伴轨迹有两个风险:同伴的解题风格与接收方差异大,硬学可能伤及自身;两个模型分词器不同,严格的重要性比率无法定义。技术路线因此分四层:(1)选择层,只交换满足 $C_{A\to B}=\{q: k_B(q)=0 \wedge 1\le k_A(q)<n\}$ 的互补提示($k_M(q)$ 为模型 $M$ 的成功数),并用 $m=\min(|C_{A\to B}|,|C_{B\to A}|)$ 按源方成功数降序做双向平衡;(2)权重层,用平均 token 对数似然之差构造序列级兼容性分数 $s(o|q)=\exp(\bar{\ell}_{\pi_{\theta^{old}_B}}(o^B|q)-\bar{\ell}_{\pi_\phi}(o^A|q))$,低于阈值 $\delta=0.8$ 的轨迹直接丢弃,通过的权重封顶为 $\min\{s,1\}$;(3)裁剪层,在接收方自己的分词上计算标准 PPO token 级比率并用非对称裁剪 $(1-\epsilon_{low},1+\epsilon_{high})=(0.8,1.28)$;(4)调度层,把含同伴数据的 minibatch 排在自身在策略 minibatch 之后处理,让裁剪机制对同伴数据生效。整个过程不需要任何额外 rollout,额外开销仅为接收侧对被传递回答的似然评估。
核心创新是“整组替换+源方优势+双层失配控制”的组合,与已有方法的本质区别有三点。第一,替换而非混合:接收方全错组被同伴组整体替代,优势仍用源方组内算出的 $\hat{a}^A_i$,绝不把两个模型的奖励池化再归一化——消融显示池化掉 3.99/2.66 分、只传成功回答掉 7.84/3.93 分,说明保留同伴组内正负对比是收益的关键来源。第二,把似然比分解 $\frac{\pi_{\theta_B}(o|q)}{\pi_\phi(o|q)}=\underbrace{\frac{\pi_{\theta_B}(o^B|q)}{\pi_{\theta^{old}_B}(o^B|q)}}_{\text{接收方自身漂移}}\cdot\underbrace{\frac{\pi_{\theta^{old}_B}(o^B|q)}{\pi_\phi(o^A|q)}}_{\text{跨模型失配}}$ 当作设计原则而非严格推导:前者交给 token 级 PPO 比率处理,后者交给序列级兼容性门控处理,两者各司其职。第三,安全性约束保证同伴数据永远是“配角”:自身数据权重恒为 1,同伴权重 $w\le 1$ 且低于门槛直接剔除,再加上 peer-last 顺序,同伴 token 的影响从一开始就被压在自身数据之下。与 SGT 只学单条成功回答不同,GRAFT 连失败回答一起传以供给负梯度;与 HACPO 到处共享不同,GRAFT 只在自身梯度为零的地方注入数据。
方法步骤详情
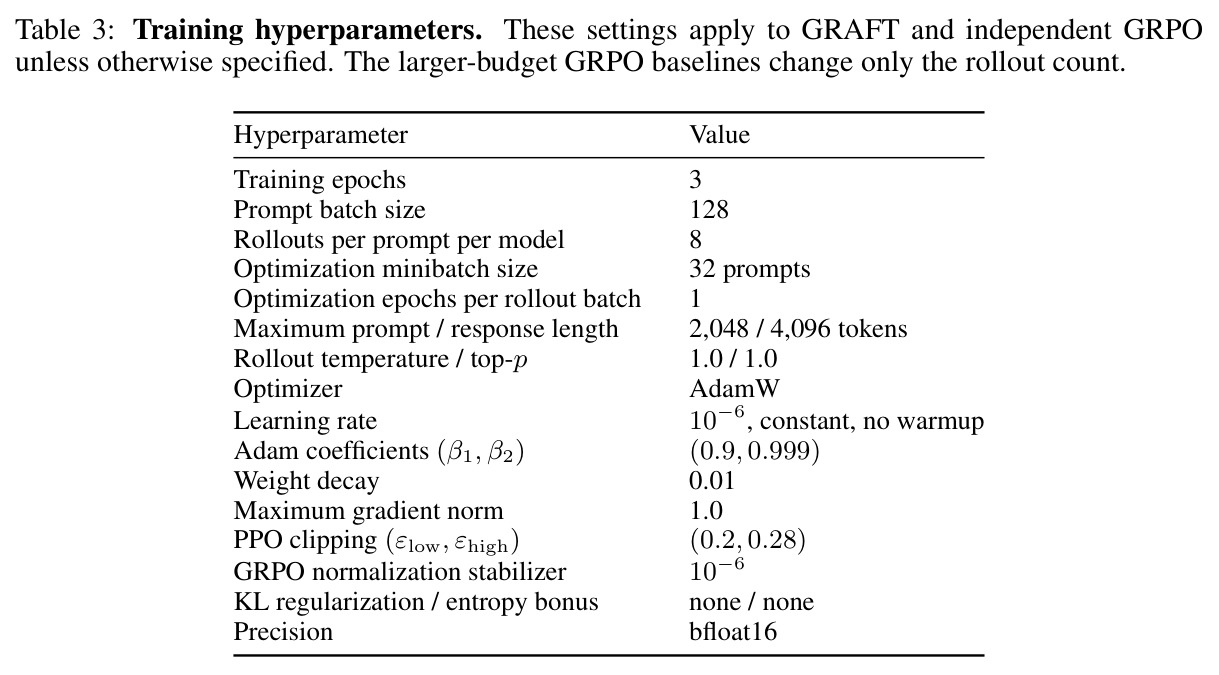
完整流程(论文 Algorithm 1)每步如下。步骤1 采样与评分:两个模型取同一批 128 个提示,各自从行为策略 $\pi_{\theta^{old}_M}$ 为每个提示采 $n=8$ 条回答,存储回答字符串与生成时 log 概率;用 math_verify 对最终 boxed 答案打 0/1 奖励,统计成功数 $k_M(q)$ 并按 GRPO 公式计算组内优势,零方差组优势置零。步骤2 候选选择:对每个方向 $(S,R)$ 找出 $C_{S\to R}=\{q: k_R(q)=0 \wedge 1\le k_S(q)<n\}$。步骤3 平衡交换:取 $m=\min(|C_{A\to B}|,|C_{B\to A}|)$,各方向按源方成功数降序保留前 $m$ 个提示(边界并列全保留)。步骤4 组替换与门控:被选中提示的接收方失败组整组换成源方组;每条同伴回答用接收方分词器重新分词,计算 $s(o|q)=\exp(\bar{\ell}_{\pi_{\theta^{old}_R}}(o^R|q)-\bar{\ell}_{\pi_{\phi}}(o^S|q))$($\bar{\ell}$ 为平均 token 对数似然),$s\le\delta=0.8$ 的直接剔除,其余赋权 $w=\min\{s,1\}$;组优势在剔除前按完整源组计算并在整个优化期间冻结。步骤5 优化:接收方在自己的 tokenization 上计算 $\rho_{j,t}(\theta_R)=\frac{\pi_{\theta_R}(o^R_{j,t}|q,o^R_{j,<t})}{\pi_{\theta^{old}_R}(o^R_{j,t}|q,o^R_{j,<t})}$,最大化 $J(\theta_R)=\mathbb{E}\big[\sum_j w(o_j)\frac{1}{|o^R_j|}\sum_t \min(\rho_{j,t}\hat{a}_j,\ \mathrm{clip}(\rho_{j,t},1-\epsilon_{low},1+\epsilon_{high})\hat{a}_j)\big]$;自身数据用 $w=1$ 和自身优势。每个 rollout batch 只做 1 个优化 epoch、切 4 个 32 提示的 minibatch,含同伴组的 minibatch 一律排最后。训练超参:学习率 $10^{-6}$ 的 AdamW、裁剪 $(0.2,0.28)$、最大长度 2048/4096、rollout 温度与 top-p 均为 1.0、共 3 epochs/174 步。
技术新颖性
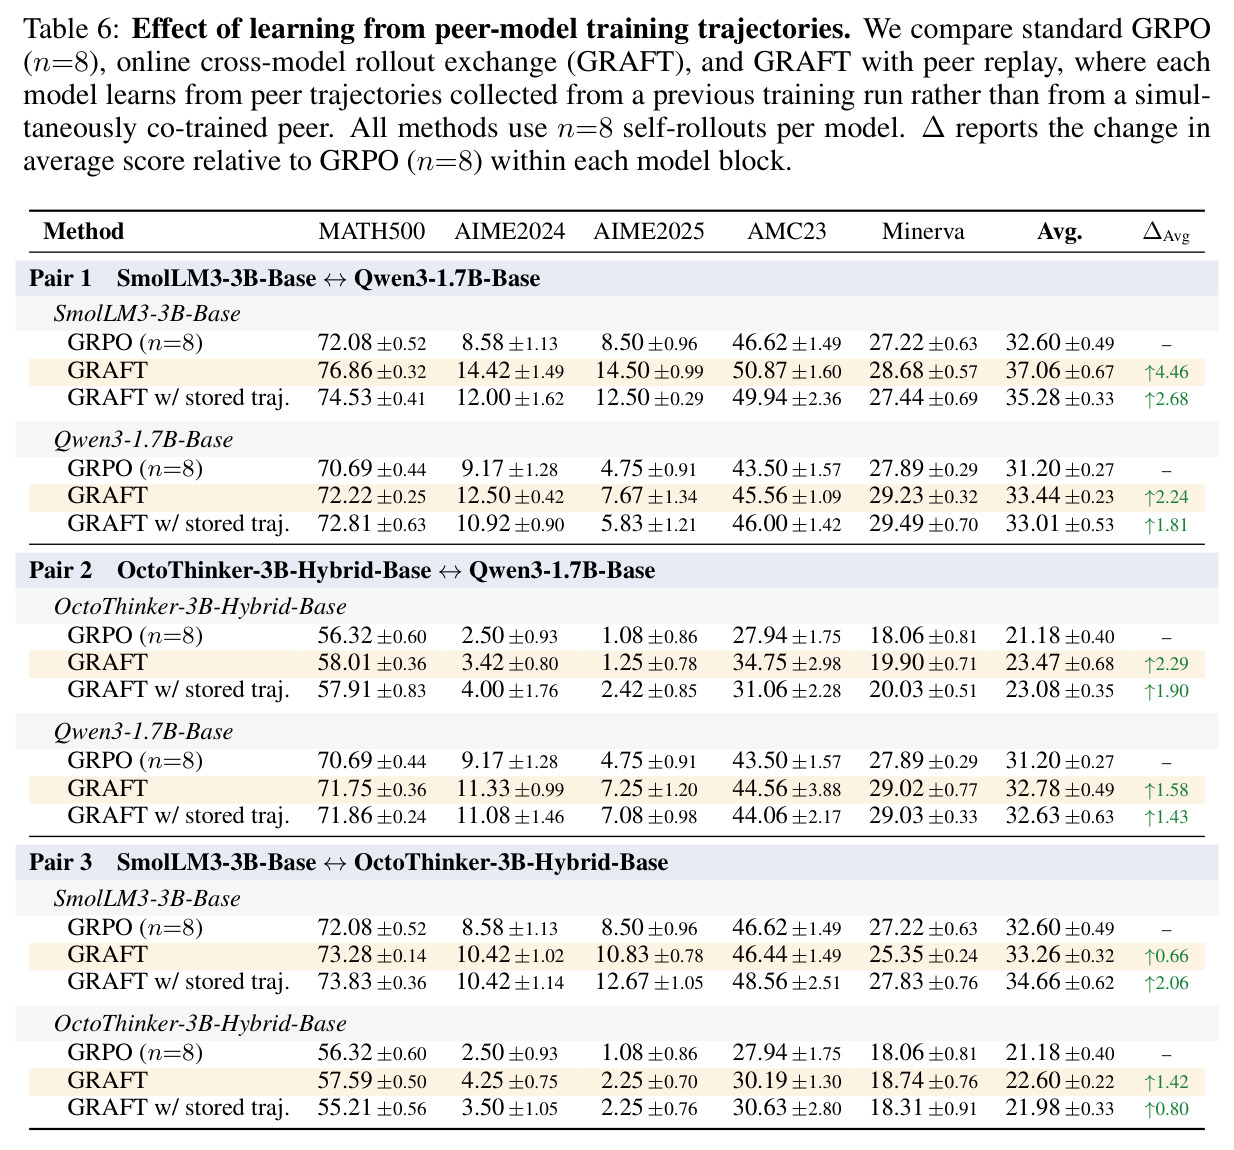
从技术新颖性看:第一,这是首个把“何处注入同伴数据”(which)与“如何控制失配”(how)作为耦合问题联合优化的 RLVR 跨模型框架,交叉消融(Table 8)证明拆开任何一半都显著掉分。第二,跨分词器的失配处理是诚实的工程—理论折中:论文明确承认 $s(o|q)$ 是经验代理而非精确的跨分词器密度比率——分词相同时它退化为长度归一化似然比,不同时解释为兼容性分数;这种近似换来了对不同词表模型的通用性,而 F-TIS 只能处理同词表模型。第三,peer-last 更新顺序是一个被精细验证的机制设计:第一个优化步之前 $\theta_R=\theta^{old}_R$、$\rho=1$,裁剪完全失效,若同伴 minibatch 先处理,兼容性权重就是唯一的闸门;排到后面处理时,先前自身数据的更新已把同伴 token 的比率推出 $[0.8,1.28]$ 区间,裁剪开始作为第二道闸门介入——Table 9 显示 peer-last 使同伴 token 裁剪率达 0.277%/0.440%(SmolLM3/Qwen3),peer-first 仅 0.004%/0.002%,且 peer-first 下 97.6% 的步骤同伴 token 完全未被裁剪。第四,存储轨迹重放(平均 +1.78 分,保留在线增益的 84%)证明方法价值不依赖同步共训,为异步多模型协作训练提供了新范式。
实验结果
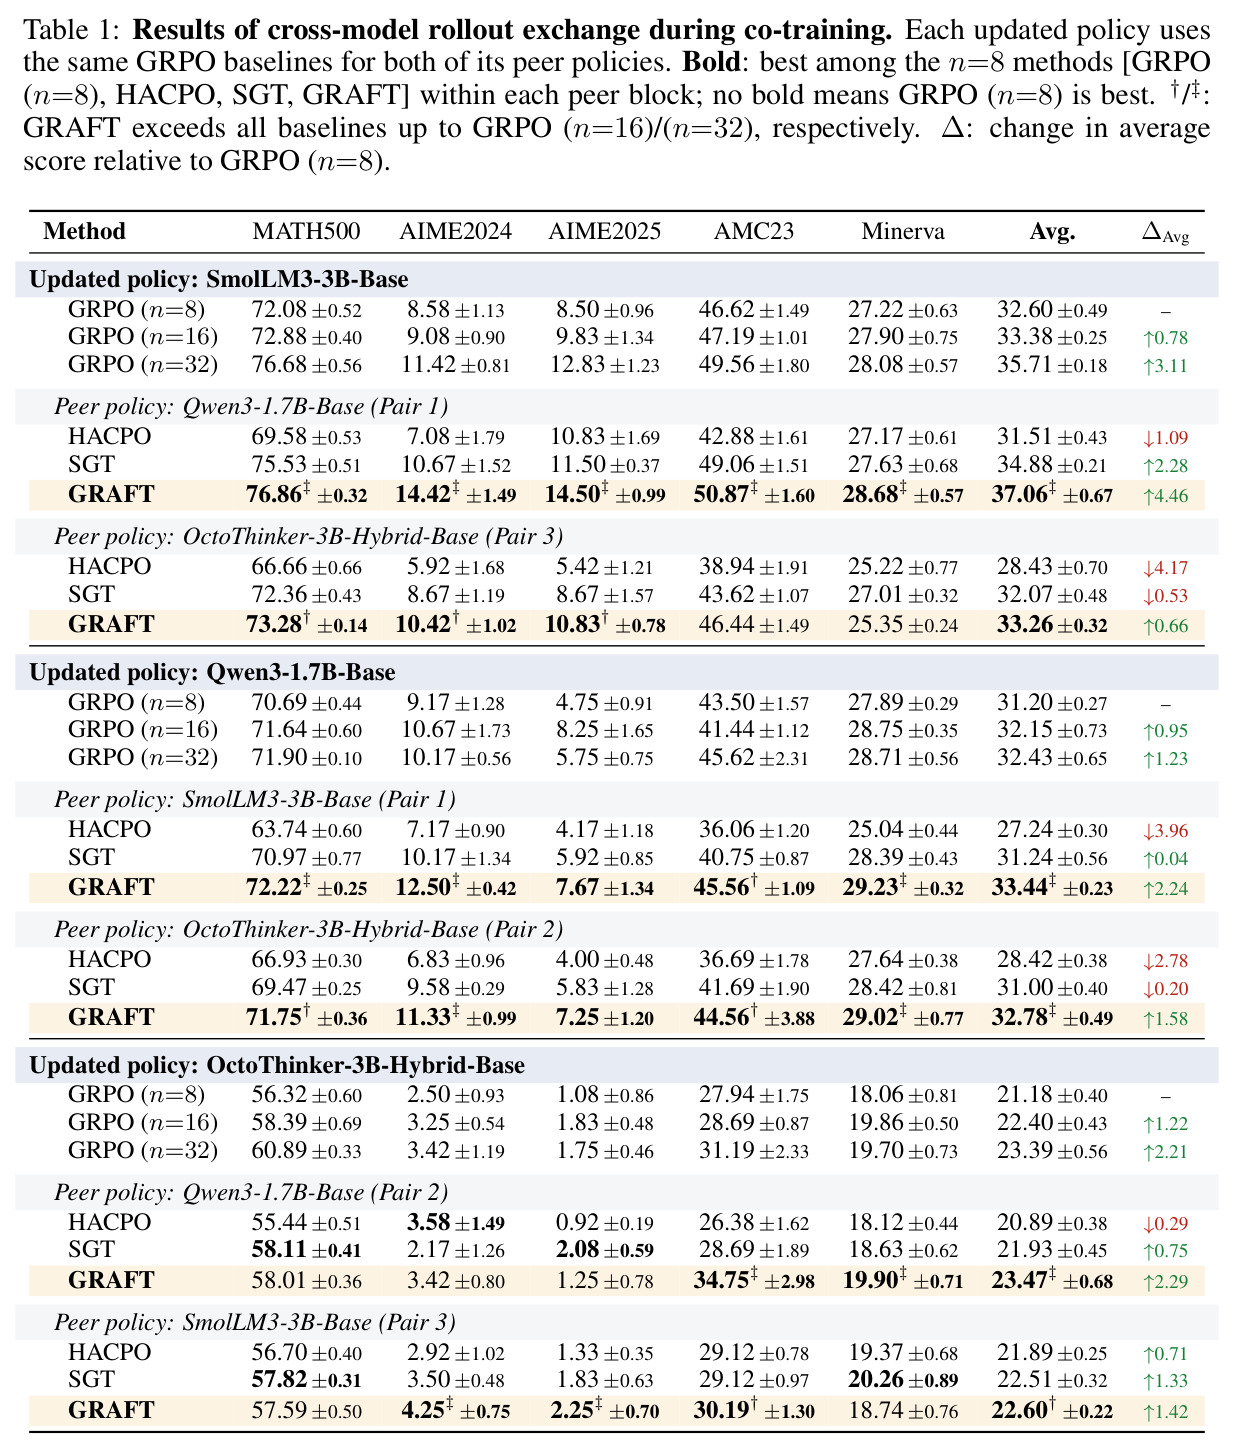
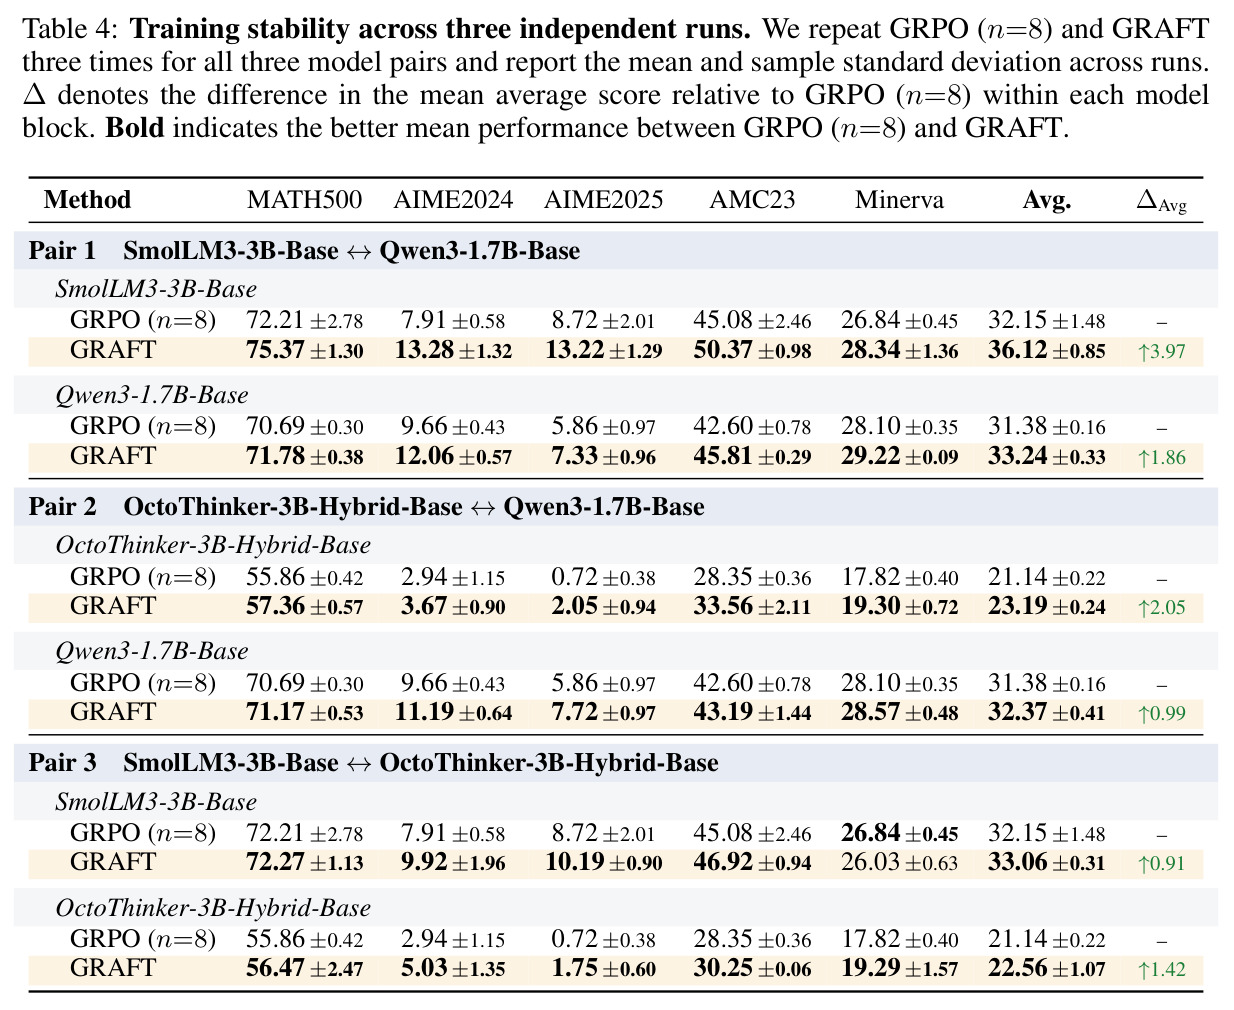
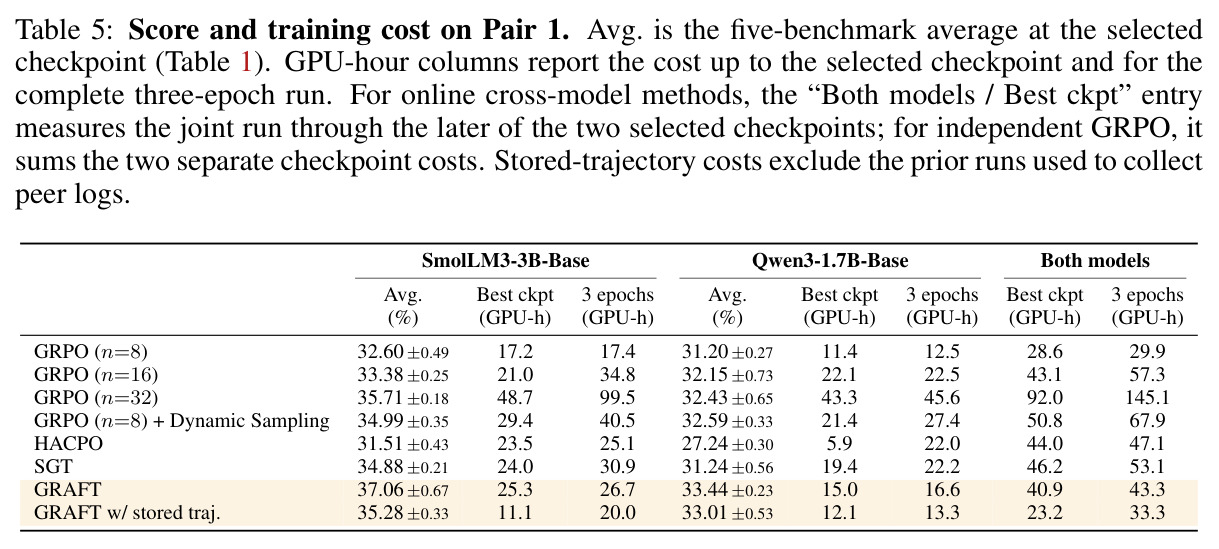
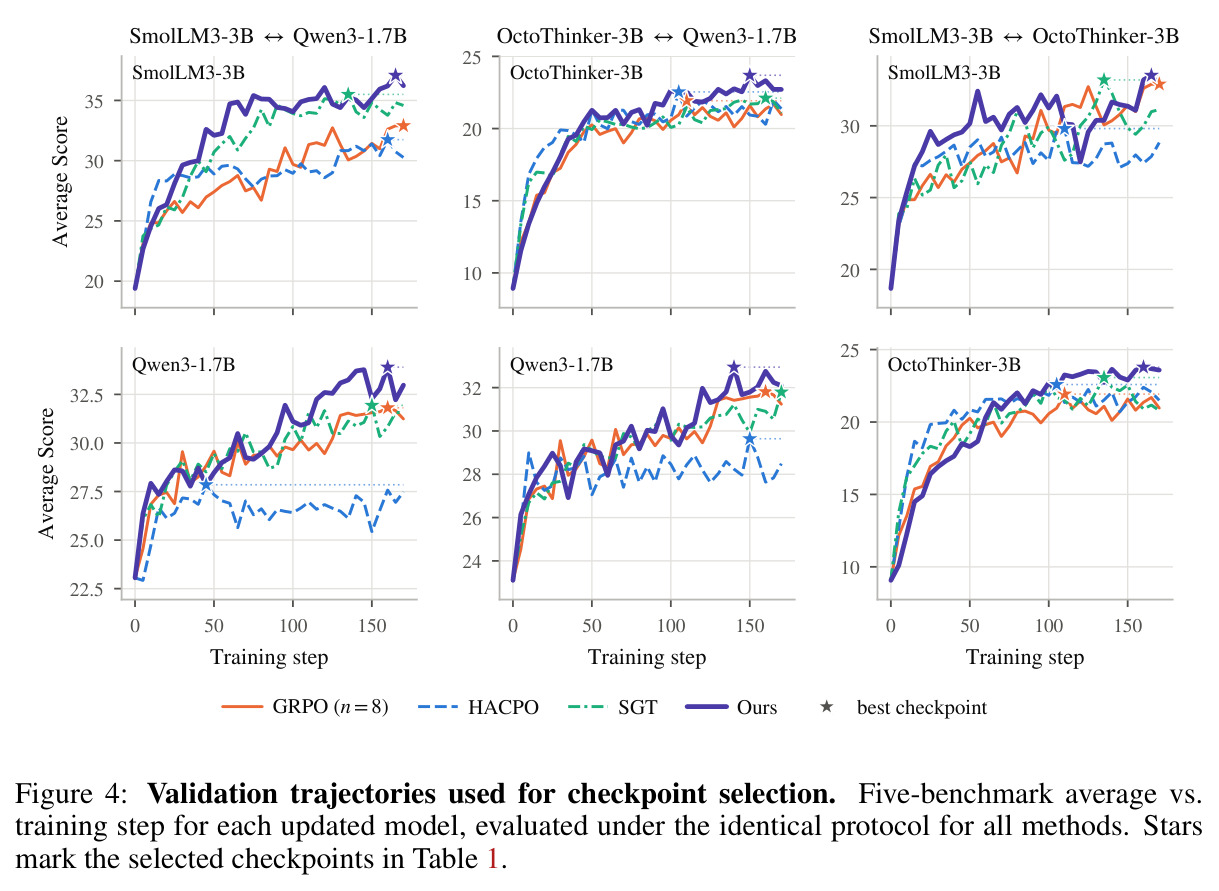
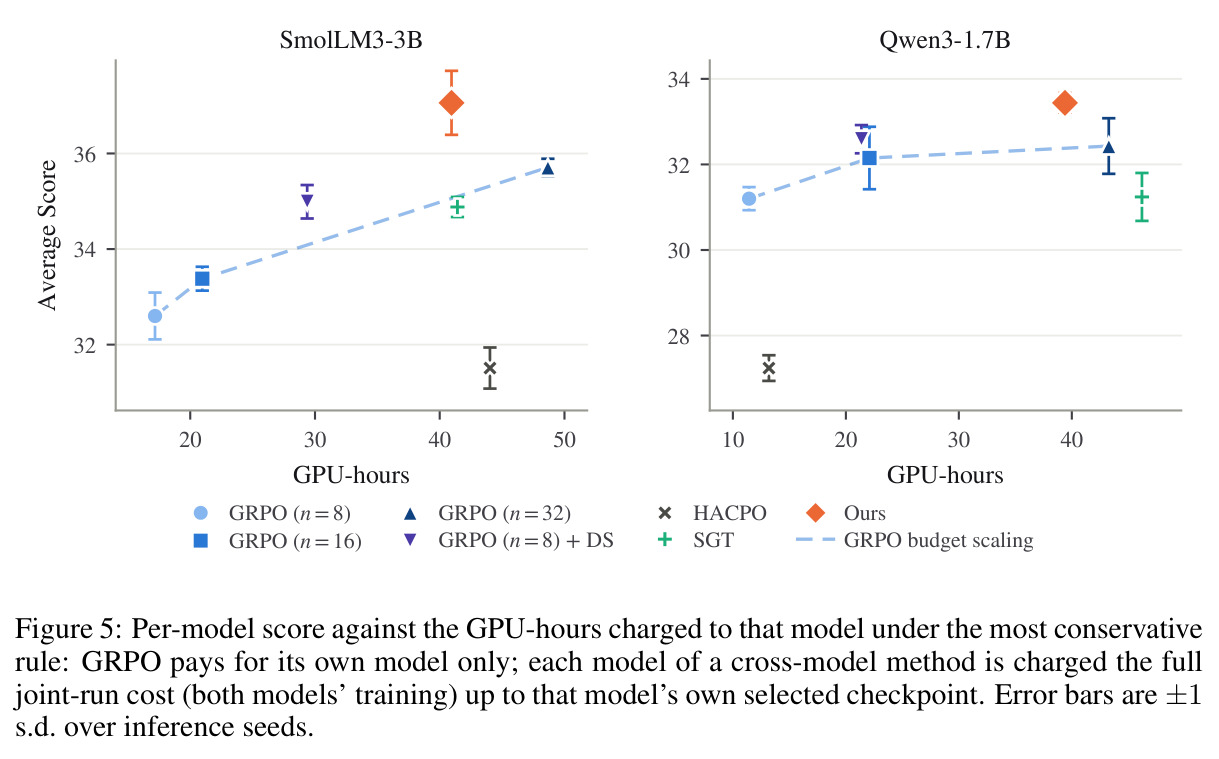
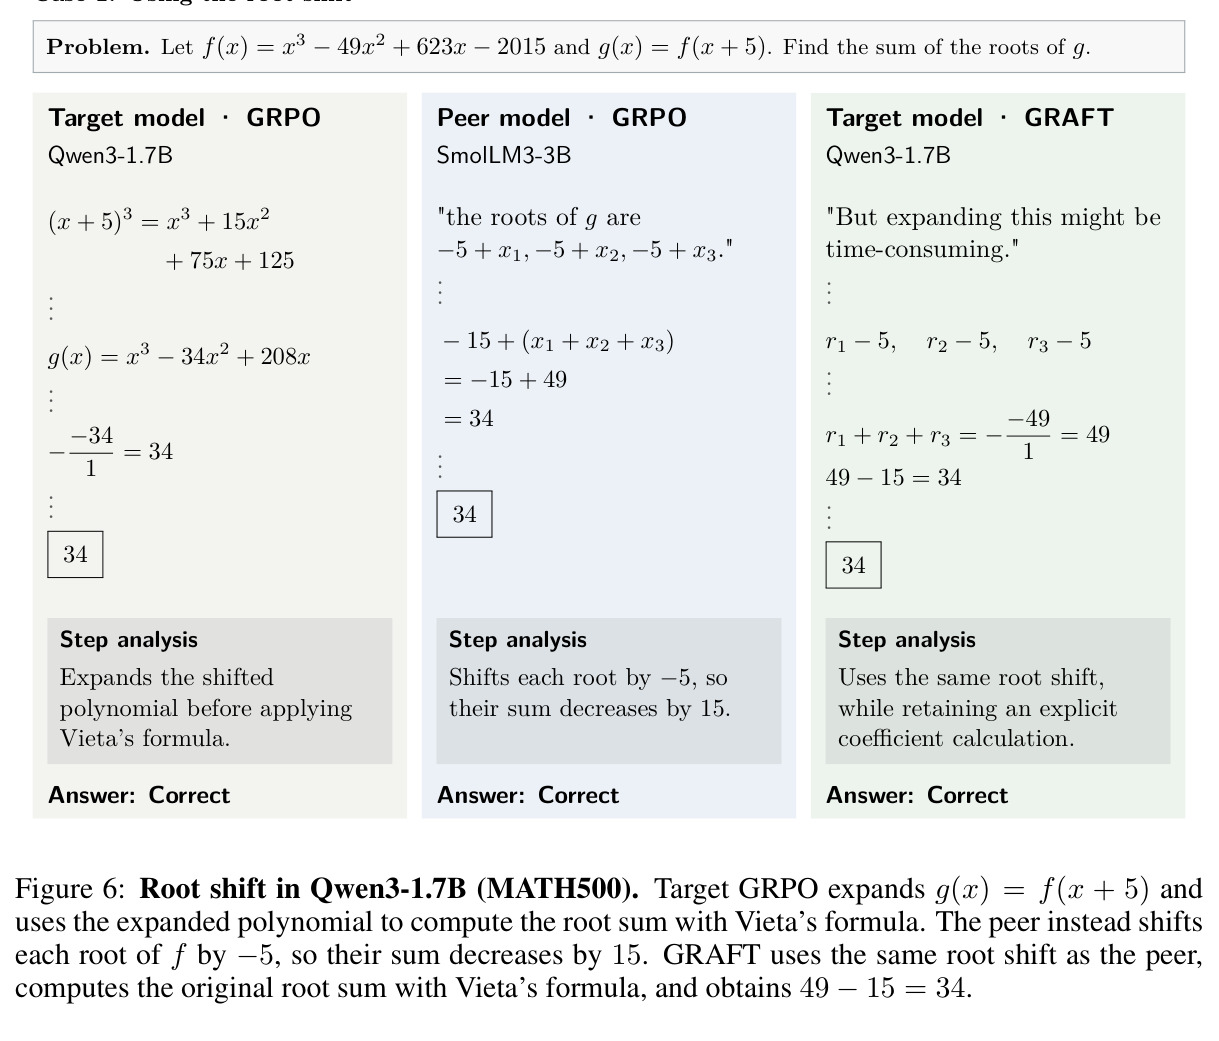
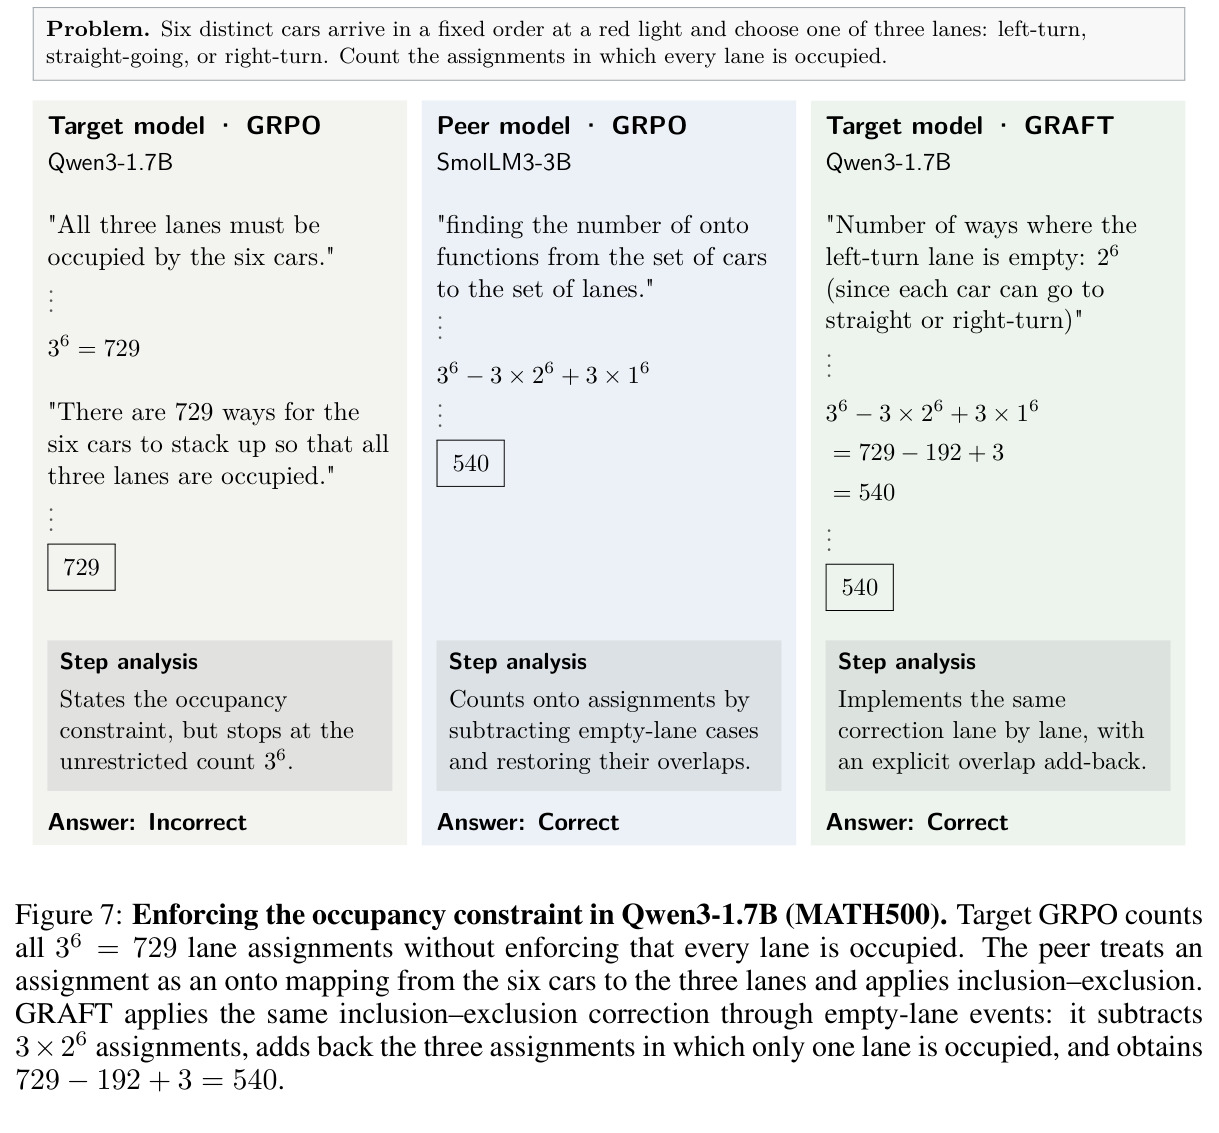
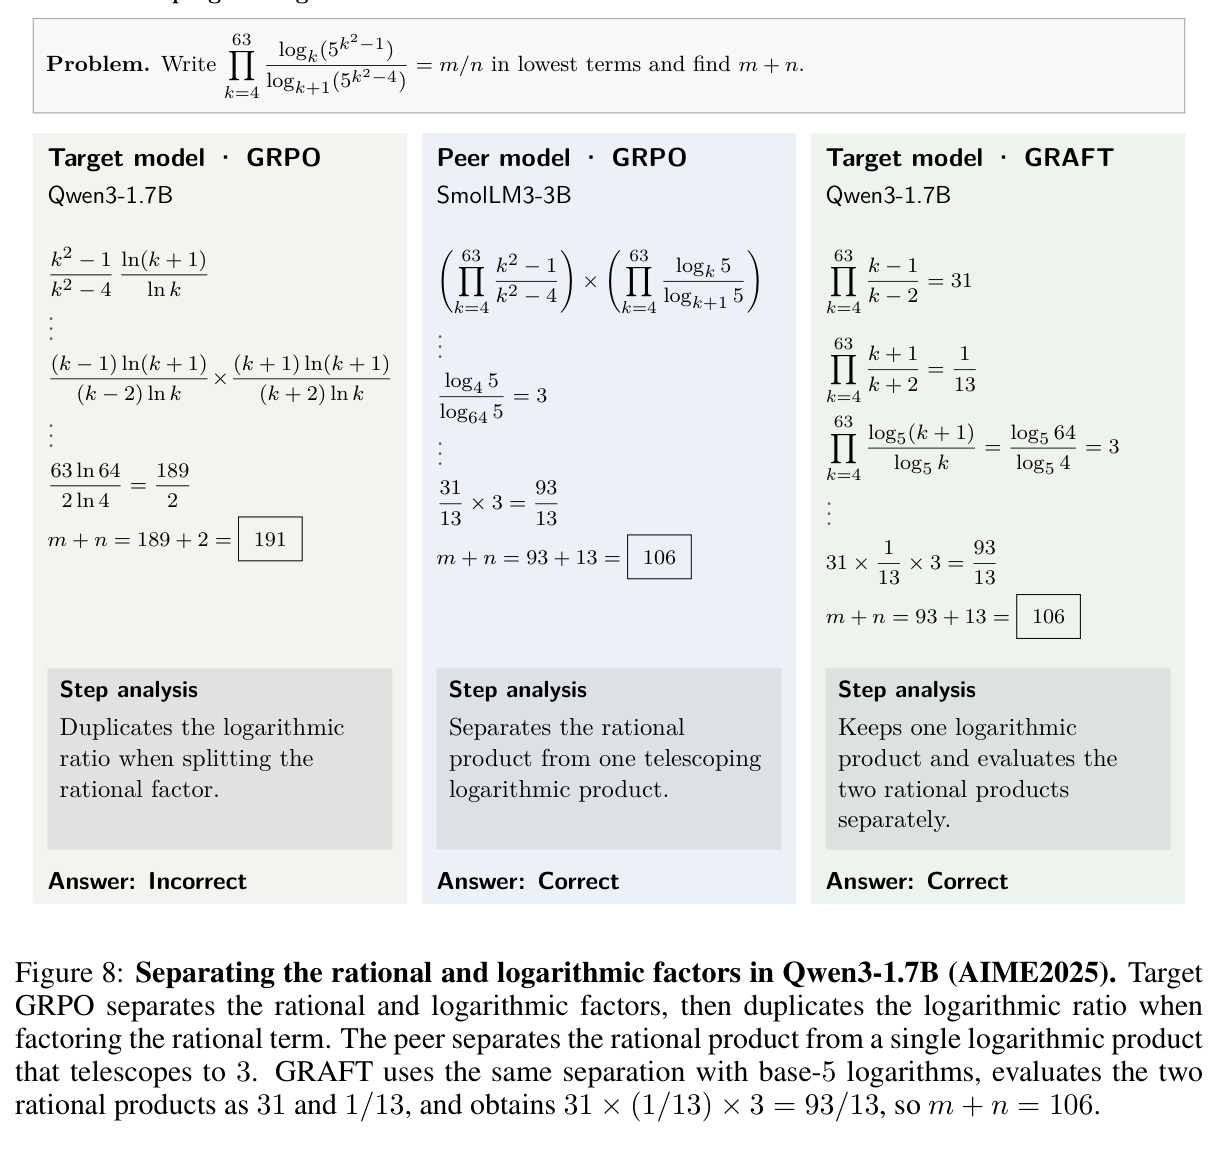
主实验(Table 1)在三个异构模型对、五个数学基准(MATH500、AIME2024、AIME2025、AMC23、Minerva)上报告 pass@1。GRAFT 在全部六个模型块上超过等预算 GRPO(n=8):Pair 1 中 SmolLM3-3B 从 32.60 涨到 37.06(+4.46),Qwen3-1.7B 从 31.20 涨到 33.44(+2.24),双双超过用 4 倍 rollout 的 GRPO(n=32)(35.71/32.43);Pair 2 中 OctoThinker 21.18→23.47(+2.29)、Qwen3 31.20→32.78(+1.58);Pair 3 增益最小:SmolLM3 32.60→33.26(+0.66)、OctoThinker 21.18→22.60(+1.42)。平均增益 2.1 分,最高 4.46 分。对比同期方法,GRAFT 平均高出 HACPO 4.0 分、高出 SGT 1.5 分:HACPO 在六个块中五个低于等预算 GRPO(最多 −4.17),SGT 在 −0.53 到 +2.28 间波动。计算效率(Figure 3a):GRAFT 以 40.9 GPU 时达到 pair 均分 35.25,比 GRPO(n=32)(92.0 GPU 时)高 1.18 分且只用 0.45 倍算力。消融(Table 2/7)显示:去掉兼容性门控 SmolLM3 暴跌 8.36 分;去掉门槛(δ=0)Qwen3 掉 3.56 分;只传成功回答掉 7.84/3.93 分;池化优势掉 3.99/2.66 分;换用 HACPO/LUFFY/SGT 更新分别掉 8.09/5.65、4.55/2.03、2.98/1.55 分;peer-first 与乱序分别掉 2.45/1.71 和 3.57/1.03 分。存储轨迹版(Table 6)在六个块全部保持正增益,平均 +1.78(在线 +2.11 的 84%),Pair 3 的 SmolLM3 存储版 34.66 甚至高于在线版 33.26。三次独立重复实验(Table 4)中 GRAFT 均值全部更高,如 Pair 1 SmolLM3 36.12±0.85 vs 32.15±1.48。案例研究(Figures 6–11)证实 GRAFT 学到了同伴的推理策略:如对 $g(x)=f(x+5)$ 直接换根(和减少 15 得 34)、容斥原理($3^6-3\cdot2^6+3=729-192+3=540$)、对数连乘积拆分($m+n=106$)、拉格朗日乘数法(最大值 540)、恢复离线高度(面积 468)、对 $\|Av\|$ 取平方根($C=4$)。
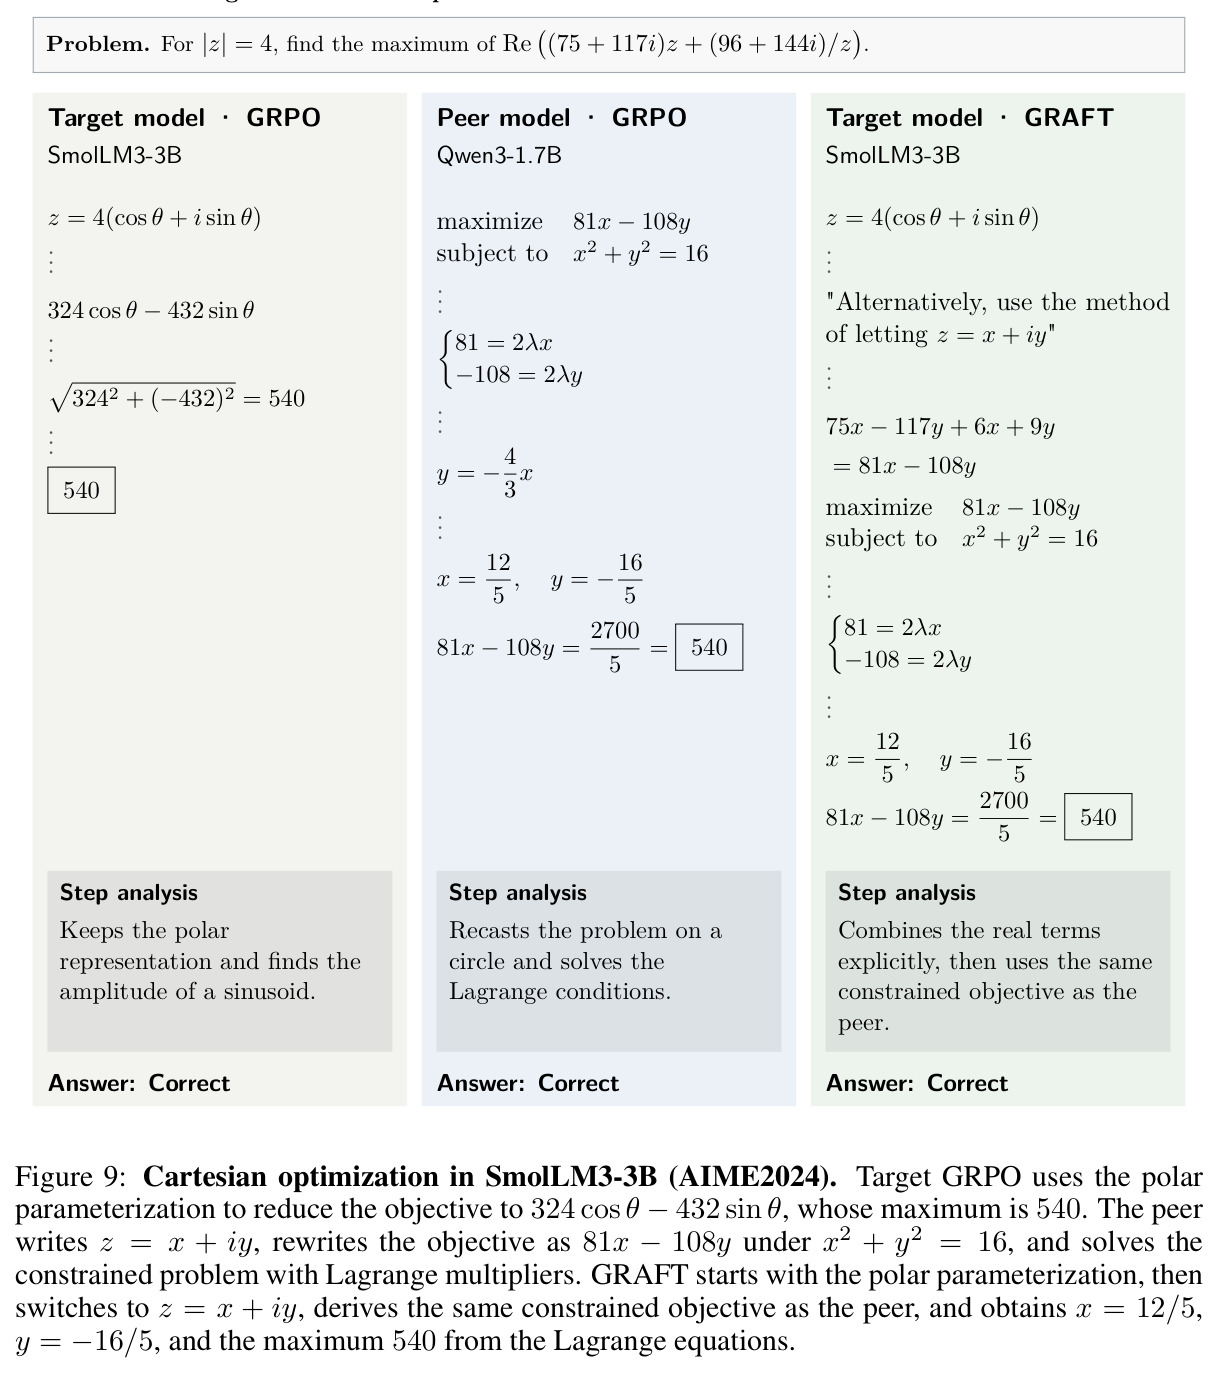
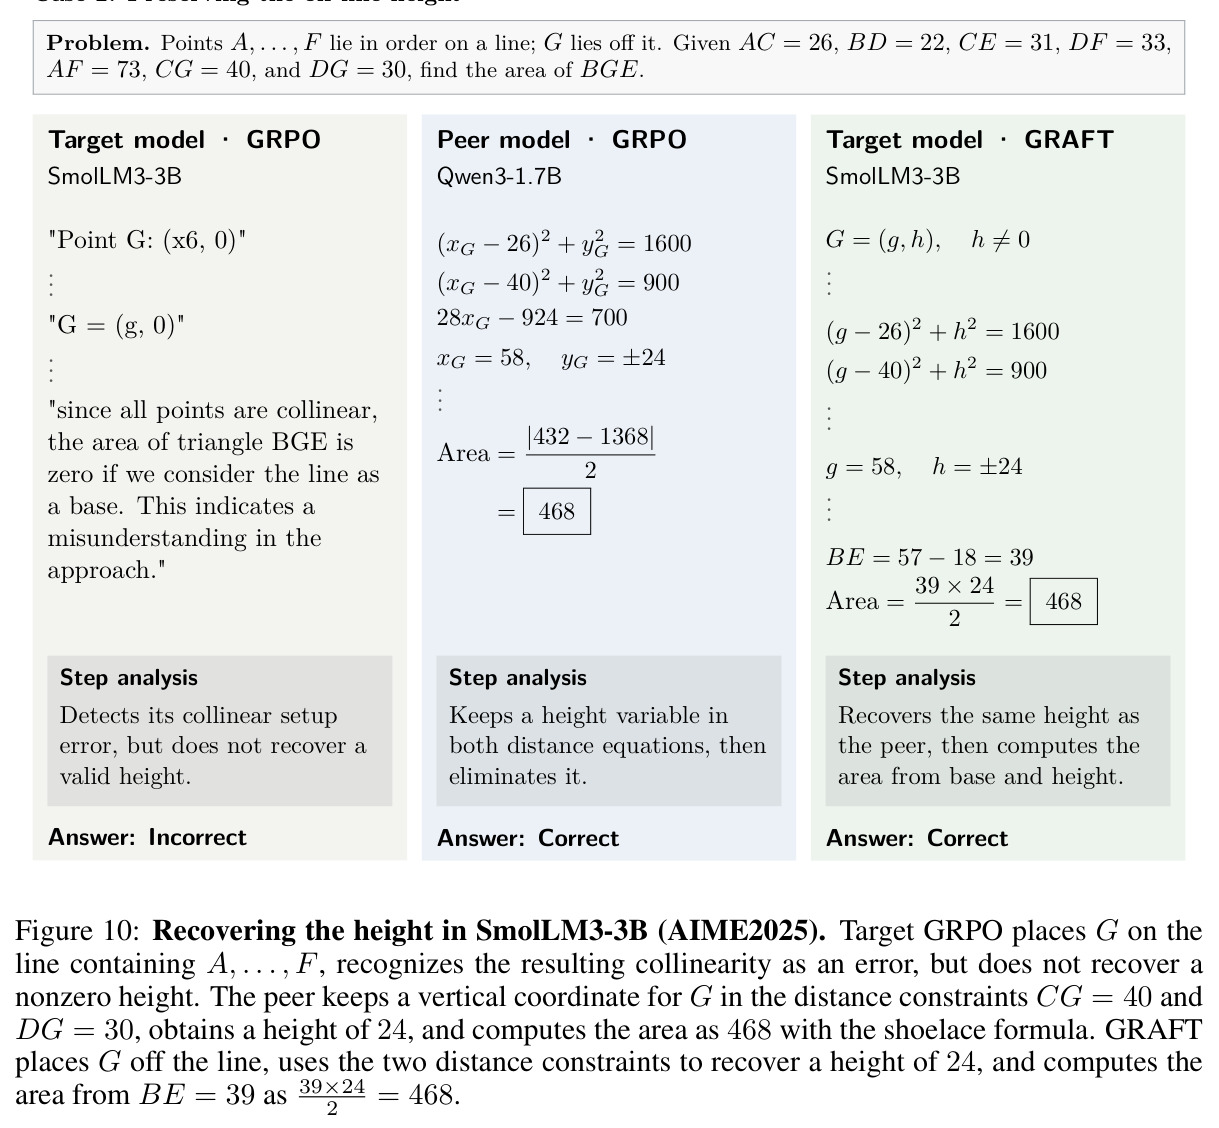
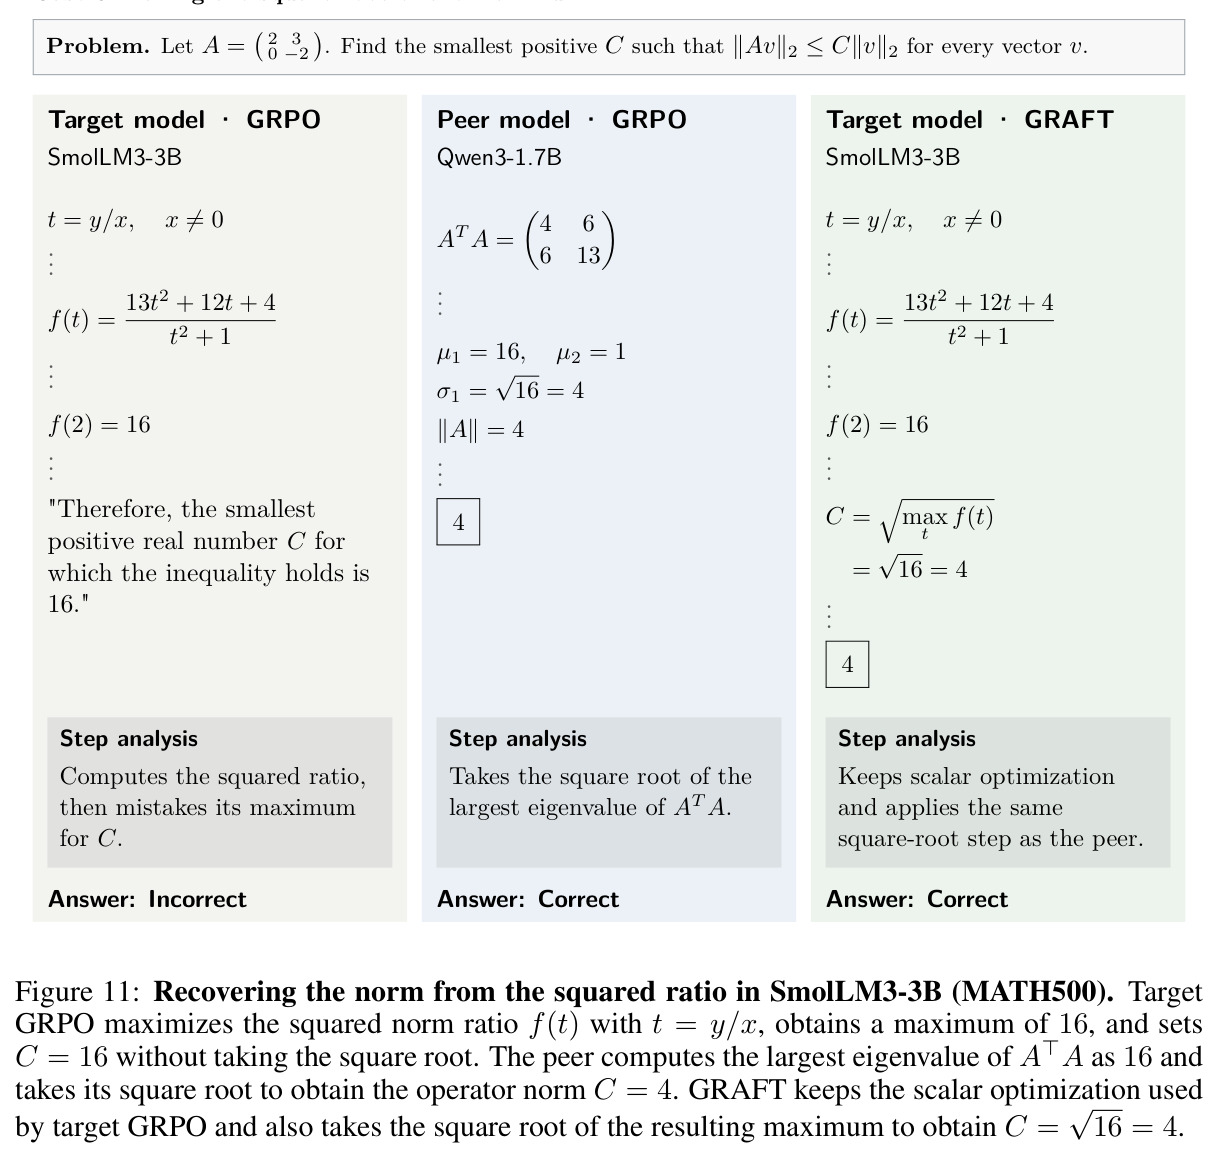
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五基准平均 pass@1(Pair 1 SmolLM3-3B-Base) | pass@1 均分 | 37.06 | GRPO (n=8): 32.60;GRPO (n=32): 35.71 | +4.46(并超 4 倍预算基线 +1.35) |
| 五基准平均 pass@1(Pair 1 Qwen3-1.7B-Base) | pass@1 均分 | 33.44 | GRPO (n=8): 31.20;GRPO (n=32): 32.43 | +2.24(并超 4 倍预算基线 +1.01) |
| 五基准平均 pass@1(Pair 2 OctoThinker-3B-Hybrid-Base) | pass@1 均分 | 23.47 | GRPO (n=8): 21.18 | +2.29 |
| 五基准平均 pass@1(Pair 2 Qwen3-1.7B-Base) | pass@1 均分 | 32.78 | GRPO (n=8): 31.20 | +1.58 |
| 五基准平均 pass@1(Pair 3 SmolLM3-3B-Base) | pass@1 均分 | 33.26 | GRPO (n=8): 32.60 | +0.66 |
| 五基准平均 pass@1(Pair 3 OctoThinker-3B-Hybrid-Base) | pass@1 均分 | 22.60 | GRPO (n=8): 21.18 | +1.42 |
| 对比跨模型基线(Pair 1 SmolLM3-3B) | pass@1 均分 | 37.06 | HACPO: 31.51;SGT: 34.88 | +5.55 / +2.18 |
| 存储轨迹重放(六模型块平均) | 相对 GRPO(n=8) 的均分增益 | +1.78 | 在线交换 +2.11 | 保留在线增益的 84%,且免同步共训 |
| 计算效率(Pair 1 两模型合计) | pair 均分 / GPU 时 | 35.25 分 @ 40.9 GPU 时 | GRPO (n=32): 34.07 分 @ 92.0 GPU 时 | +1.18 分,仅 0.45× 算力 |
| 单基准示例 AIME2024(Pair 1 SmolLM3-3B) | pass@1 | 14.42 | GRPO (n=8): 8.58 | +5.84 |
局限与改进
作者承认的局限:增益大小取决于两模型的互补程度——Pair 3(SmolLM3↔OctoThinker)最小只有 +0.66/+1.42,且 Pair 3 中 SmolLM3 未能超过 GRPO(n=32);兼容性分数在跨分词器时只是经验代理而非精确密度比率;只研究了双模型配对、只有数学领域、只用不超过 3B 的 base 模型。我的补充观察:第一,平衡交换取 $m=\min$ 会人为压制候选更多的方向——Pair 1 中 SmolLM3 能解 Qwen3 47.9% 的全错题而反向只有 18.7%,强方向的传递被截断;第二,选择条件 $1\le k_A(q)<n$ 排除了“同伴 8 条全对”的提示,而这恰是接收方最容易受益、只是需要不同优势处理的题目;第三,评测沿用“每 5 步在取自评测基准的验证集上选最优 checkpoint”的通行做法,AIME2024/2025 各只有 30 题、AMC23 只有 40 题,小样本方差不可忽视(如 Pair 2 Qwen3 的 AMC23 标准差达 ±3.88);第四,δ=0.8 只在 Pair 1 上调过即冻结,虽然 0.7–0.9 扫描显示不太敏感,但迁移到更大模型或非数学领域未必成立;第五,在线共训要求两模型严格同批同步,工程耦合度高,存储轨迹版又退化为单向传递、失去平衡机制;第六,与许多 RLVR 工作一样只训 3 epochs/174 步、每 batch 只做 1 个优化 epoch,更长训练下的稳定性未验证。
独立分析的弱点
独立分析的弱点与改进方向:(1)互补性是前提而非保障——若两模型同源同数据(如同家族不同尺寸),候选集 $C$ 会迅速缩水、收益趋近于零;改进方向是引入三个以上异构同伴形成交换池,按互补度动态挑选交换对象。(2)全局标量 δ=0.8 一刀切:一道题的正确解法若恰好采用接收方不熟悉的冗长风格,$s$ 值可能低于门槛被误杀;可按题目难度或回答长度分桶校准阈值,或把硬门槛换成平滑的 softmax 型权重。(3)整组替换意味着接收方在这些提示上完全见不到自己的失败尝试,错失“自身错误 vs 同伴正确”的对比学习机会;可尝试自身组与同伴组的软插值或保留部分失败样本。(4)方法绑定二值可验证奖励,代码测试覆盖不足或开放生成任务无法直接使用;须先有可信奖励再谈交换。(5)peer-last 与非对称窗口 $(0.8,1.28)$ 均为经验最优,缺理论刻画——为何后处理能激活裁剪、裁剪强度与同伴数据占比的最优配比值得形式化。(6)存储轨迹版的同伴数据来自单一历史 run,若接收方训练中能力已漂移,同伴轨迹的新颖性会衰减;可用多个历史 checkpoint 的轨迹池缓解。(7)被选中的全错提示可能本就超出接收方当前能力边界,模仿同伴究竟带来真实泛化还是浅层记忆,需要 pass@k 与分布外评测进一步区分。
未来方向
作者提出的未来方向:扩展到两个以上同伴的交换(交换拓扑与贡献分摊);推广到没有可验证奖励的领域。基于本文成果可自然延伸的:(1)多方 RLVR 训练网格——让 N 个异构模型两两交换,用平衡机制防止强者被稀释、弱者被淹没,甚至引入基于兼容性分数的动态伙伴匹配;(2)异步/去中心化训练——存储轨迹版已证明 84% 增益可离线获得,可进一步结合轨迹银行或参数平均构建“训练轨迹市场”;(3)跨规模与非对称配对——3B↔7B、base↔instruct,研究何时应退化为蒸馏、何时仍是对等交换;(4)理论层面,为兼容性加权的离策略代理目标建立偏差-方差分析,或学习双向分词映射以构造更精确的比率;(5)扩展到代码(单元测试通过率)、形式化证明等仍有可验证奖励的领域;(6)与推理时扩展(多数投票、best-of-n)联动的预算分配研究——本文展示了“换数据”优于“堆 rollout”,可量化该结论在何种任务难度分布下成立。
复现评估
复现条件相当友好。实现基于公开的 verl + Ray + FSDP + vLLM 0.8.5 栈;训练数据是公开的 MATH 训练集 7,500 题(全难度);三个模型 SmolLM3-3B-Base、Qwen3-1.7B-Base、OctoThinker-3B-Hybrid-Base 均开源;附录 B/Table 3 给出完整超参(LR $10^{-6}$ AdamW、裁剪 0.2/0.28、batch 128、n=8、3 epochs/174 步、bfloat16、无 KL/熵正则),基线 HACPO/SGT/LUFFY 按官方实现默认配置,并报告了调参尝试。算力需求低:每对模型 4 张 H200,GRAFT 在 Pair 1 上跑到两模型最优 checkpoint 共 40.9 GPU 时(完整 3 epochs 43.3),GRPO(n=8) 仅需 28.6 GPU 时——单机多卡即可承受。评测协议完全透明:pass@1、温度 0.6/top-p 0.95、每题 8 样本、5 次重复、统一的最优 checkpoint 选择规则。论文文本未明确给出开源代码链接,跨分词器的重分词与生成 log 概率记账是主要工程量;不过 δ=0.8 在 0.7–0.9 范围内不敏感、方法超参少,总体复现难度中等偏低,熟悉 verl 的团队预计数天内可复现主结果。
论文图表
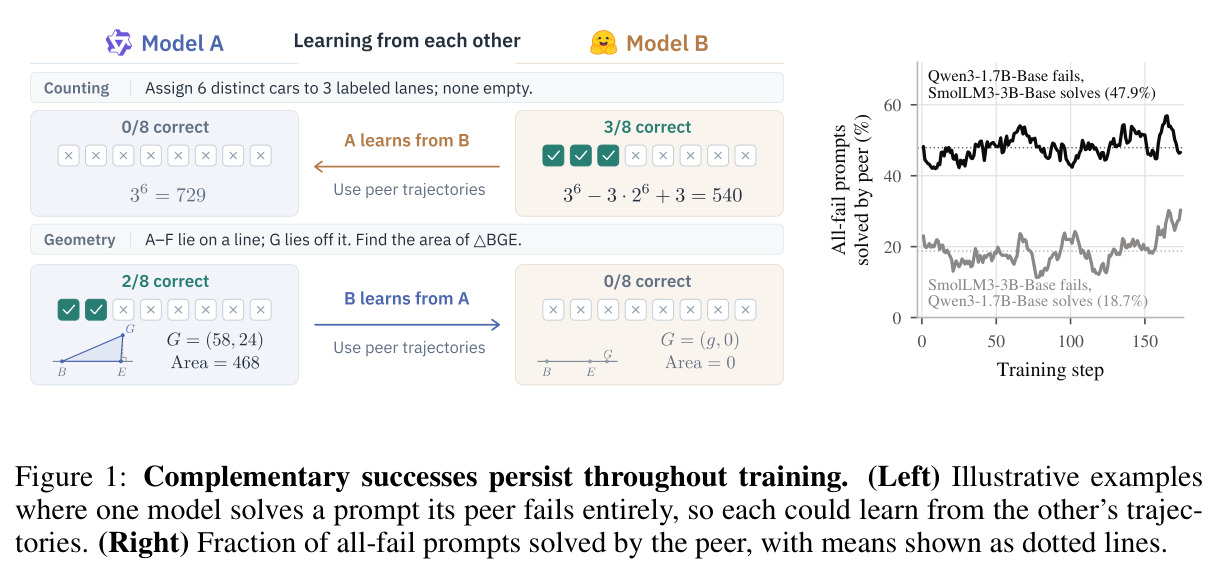
左侧示意两类互补情形:Qwen3 全错而 SmolLM3 能解的提示,以及 SmolLM3 全错而 Qwen3 能解的提示;右侧画出训练全程中“对方全错而本方解出”的提示占比曲线,均值(虚线)分别为 47.9% 和 18.7%。
全文动机的实证基础:证明跨模型互补成功不是训练早期的偶发现象,而是贯穿始终的系统性机会,值得专门设计交换机制。