HiRAE:基于残差预算的层次化表征自编码 HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
按深度分组施加残差预算,融合DINOv3全部24层,rFID降30%且生成不受损。
前置知识
表征自编码器(RAE)
用冻结的预训练视觉编码器(如 DINOv2/v3)提取特征,只训练一个解码器把特征还原成图像的自编码框架;由于编码器表征语义组织良好,可直接在该 latent 空间训练扩散模型生成图像,绕开传统 VAE 重建优先、语义贫弱的问题。RAEv2 进一步固定聚合若干中间层特征。
HiRAE 是 RAE/RAEv2 范式的直接扩展,理解 frozen encoder + learned decoder 的分工是读懂动机与对比实验的前提。
rFID 与 gFID
FID 用 Inception 网络衡量两组图像分布的 Fréchet 距离;rFID(reconstruction FID)比较重建图与原图分布,gFID(generation FID)比较生成图与真实分布,均越低越好。ImageNet-256 上通常按 ADM 协议生成 5 万张图计算。
论文的核心结论——rFID 从 0.299 降到 0.209、guided gFID 从 1.060 降到 1.038——都建立在这两个指标上。
DiT 与内部引导(IG)
DiT 是在 latent token 上做去噪的 Transformer 生成器;内部引导是 RAE 系列提出的采样技巧,利用生成器内部的中间预测构造引导信号,在不启用外部 CFG 的情况下提升样本质量与细节。本文 guided 实验均在训练 80 epochs 的 EMA 生成器上用 IG 完成。
Table 3 的主对比(gFID 1.038 对 1.060)依赖 IG 采样协议,理解 IG 才能判断各系统对比的公平性。
Frobenius 范数与范数帽(norm cap)
矩阵全部元素平方和的平方根 $\|A\|_F=\sqrt{\sum_{i,j}a_{ij}^2}$,用来度量一个修正量的整体幅度。范数帽指当修正量 $\Delta_g$ 的 Frobenius 范数超过预算 $c_g\|H_{23}\|_F$ 时按比例缩回的硬约束机制。
残差预算是本文的命名性创新,组级范数帽是其数学载体,公式 (4)(5) 的推导完全基于它。
LPIPS
学习式感知相似度:把两张图送入预训练网络(如 AlexNet),计算各层特征差异的加权和,比 PSNR 更符合人眼感知,数值越低越相似。
论文用匹配 5K 子集上的 LPIPS(0.074 降到 0.043)验证感知质量提升,潜空间扰动分析也以输出 LPIPS 的变化衡量解码灵敏度。
层间特征融合与 CKA/有效秩
Transformer 不同深度的特征语义层级不同,融合即把多层输出组合成单一表征;CKA(中心核对齐)衡量两组表征几何结构的相似性,空间有效秩刻画特征能量在方向上的分散程度。
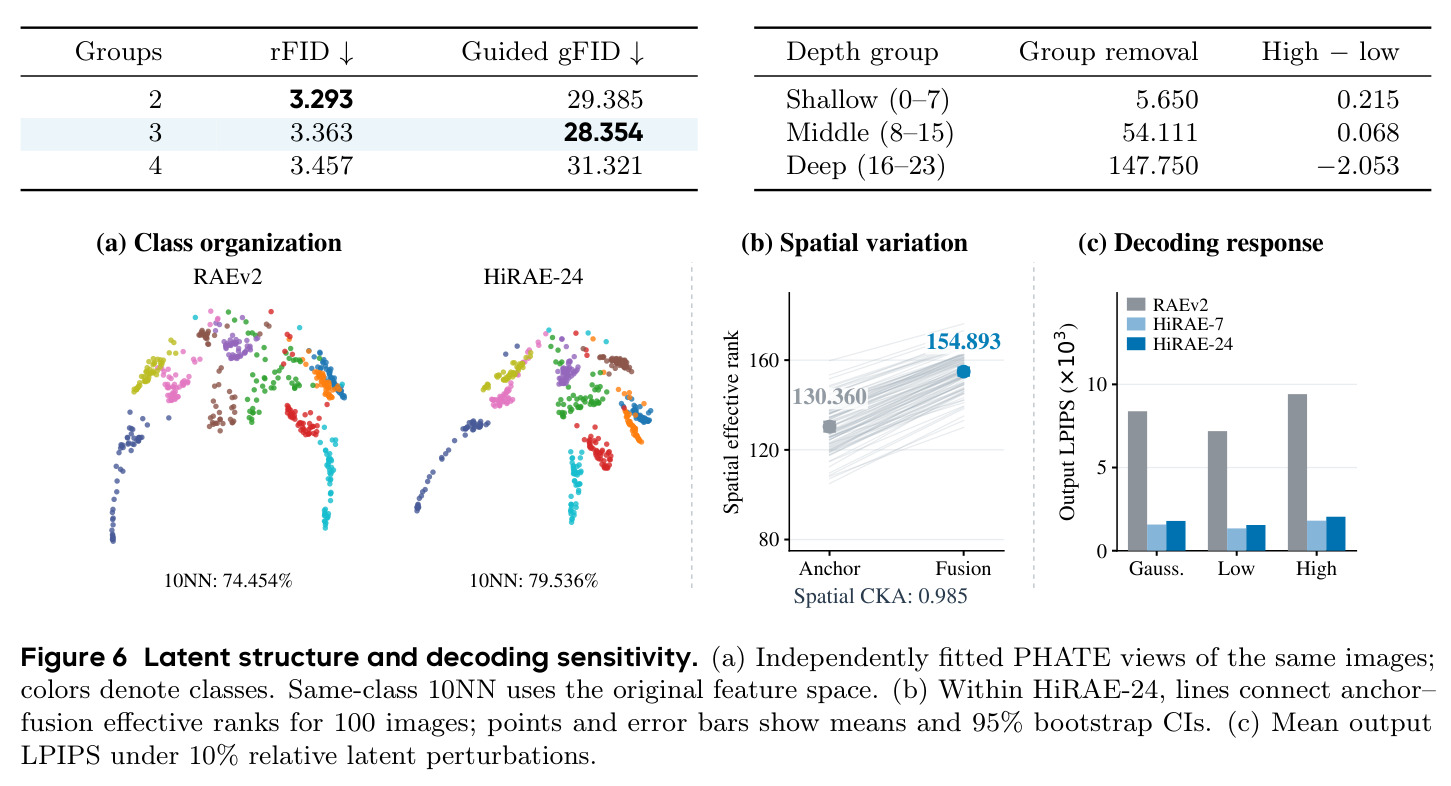
Figure 6 用同类 10 近邻占比、CKA 保持 0.985、有效秩从 130.360 增到 154.893 论证『加细节而不破坏语义组织』,是读懂分析章节的钥匙。
研究动机
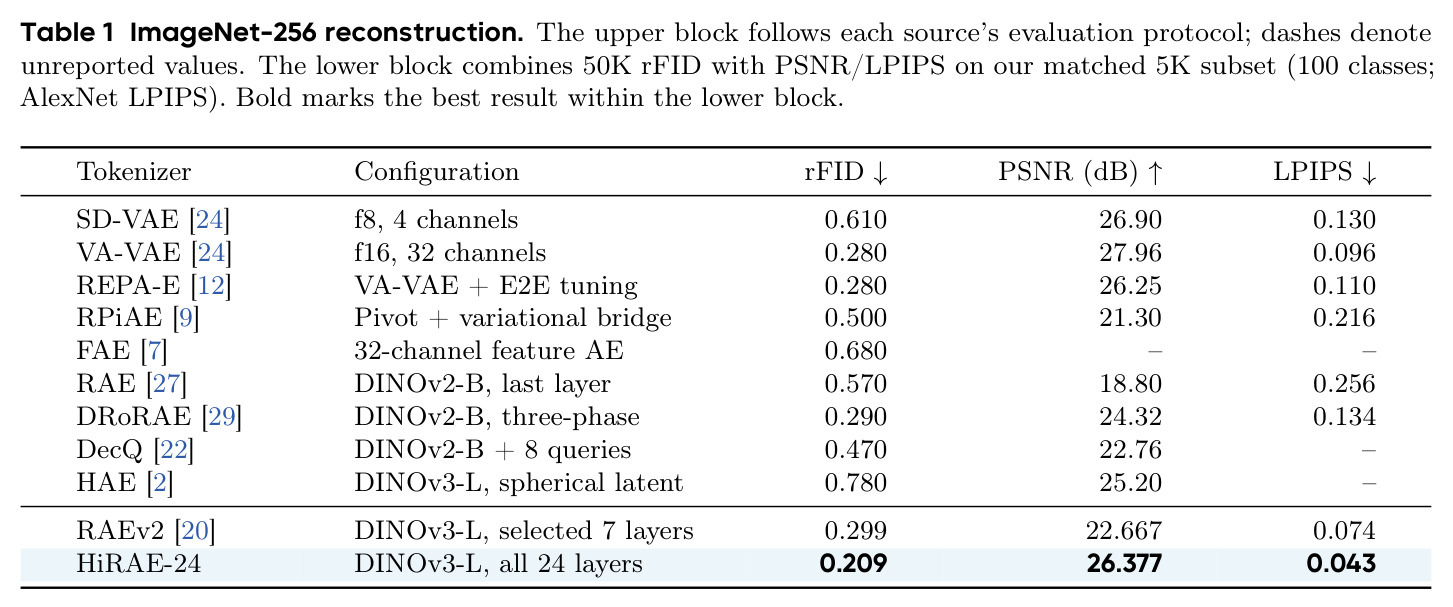
预训练视觉编码器(如 DINOv3-L)的最终层表征语义组织良好,可直接作为扩散模型的生成空间,但高度抽象的输出丢失了忠实重建所需的细粒度细节——原文 Table 1 显示仅用最后一层的 RAE 的 rFID 高达 0.570、PSNR 仅 18.80 dB。中间层虽保留互补的视觉细节,但把多层特征融进 latent 会改变其分布,使生成模型更难学习。现有融合方案各有代价:RAEv2 对 7 个经验挑选的层做固定聚合,找到合适的层子集需要反复训练与评估,作者称这一选择本身就是关键设计变量;DRoRAE 学习全深度融合,却要把融合模块先对着冻结解码器训练、再单独适配解码器,流程分阶段且复杂;DecQ 追加 8 个细节查询 token,并观察到使用更浅层或更多查询虽改善重建却损害生成。因此『融合更多细节』与『保持生成兼容』之间存在尚未被结构性解决的权衡。
本文的目标是本文目标是构建一个同时服务高保真重建与高质量生成的视觉 tokenizer:在冻结 DINOv3-L 编码器上自动利用全部 24 层特征,无需人工挑选层子集,也无需 DRoRAE 那样先把融合模块与解码器分开训练,而是在 tokenizer 阶段一步联合训练融合模块与解码器。同时严格保持 latent 形状不变(16×16 共 256 个 token、1024 通道),使下游 DiT 生成器的训练成本与 RAEv2 完全一致。量化目标上,希望在 ImageNet-256 把 rFID 从 RAEv2 的 0.299 显著降低、PSNR 与 LPIPS 同步改善,guided 生成 gFID 保持 1.0 量级的竞争力;在文本到图像任务上让 GenEval、DPG-Bench、GenAI-Bench 在预训练和 SFT 两个阶段都超过 RAEv2。
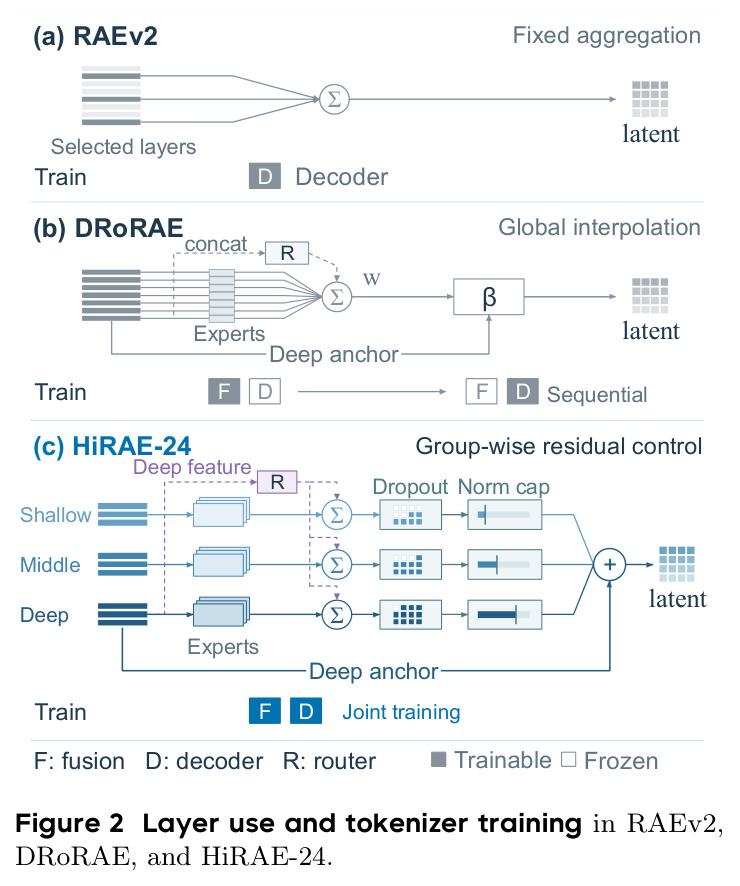
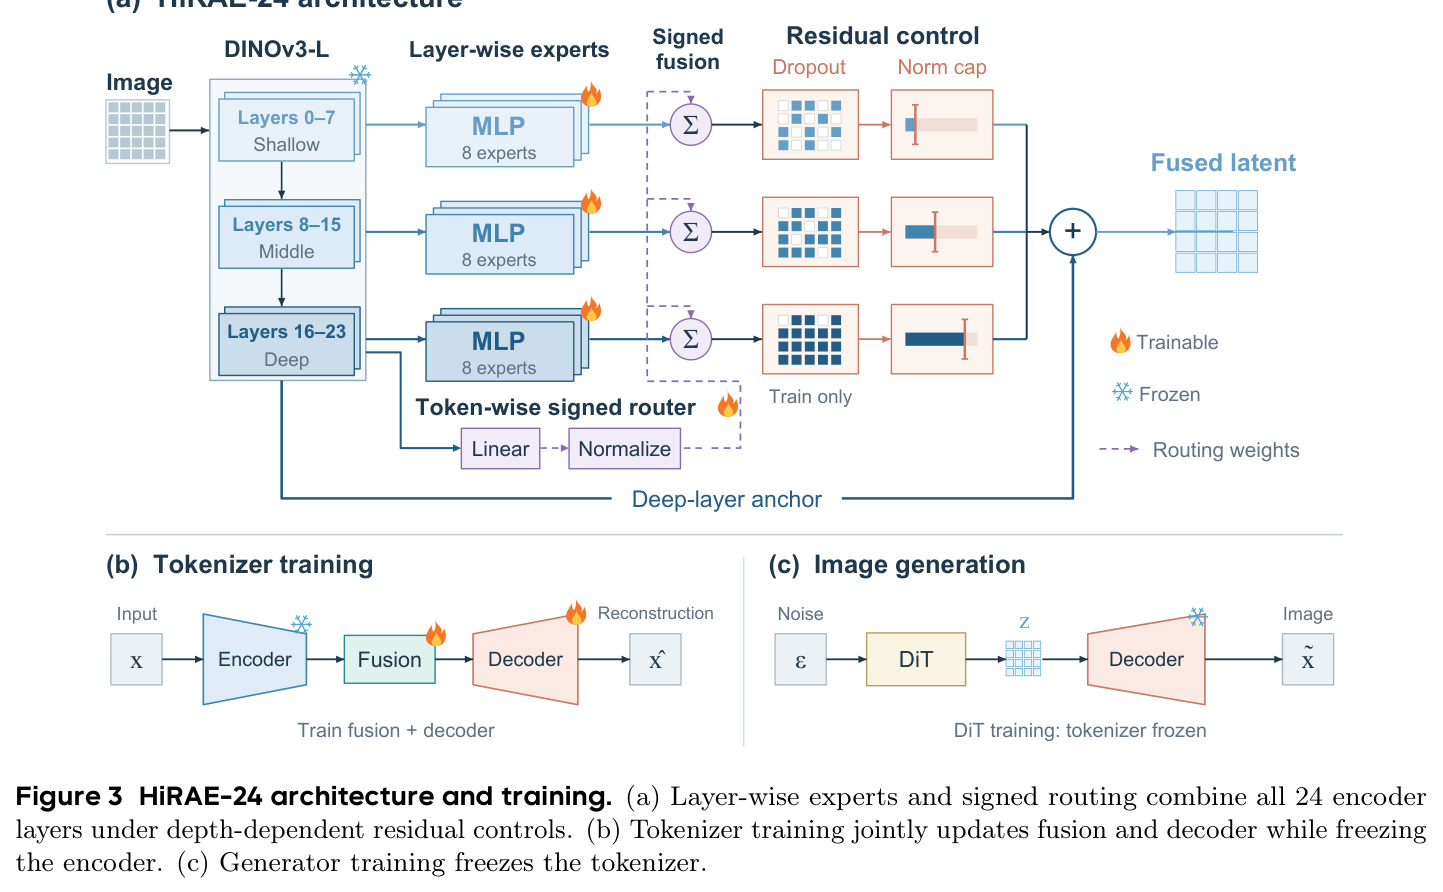
与已有工作不同的是,本文的独特切入是把『融合对最深层锚点的修改幅度』当作一等公民来显式预算,而不只是学融合权重。此前 DRoRAE 用固定 80:20 的全局插值把深锚点与聚合专家输出混合,插值比例是硬编码的;RAEv2 干脆不学融合。HiRAE 则把 24 层按深度分成浅(0–7)、中(8–15)、深(16–23)三组,为每组设定随深度递增的 Frobenius 范数帽 $(c_s,c_m,c_d)=(0.025,0.075,0.150)$,并配套随深度递减的 dropout(0.50/0.25/0.10),使浅层细节只能以『小额、受约束的修正』方式注入深锚点。这一设计在理论上由三角不等式保证总修正不超过 $0.25\|H_{23}\|_F$,在机制上阻止 latent 分布向重建主导漂移,从而直接回应 DecQ 指出的重建-生成权衡。
核心方法
直觉上,最深层特征是语义主干,应作为锚点完整保留;浅中层特征提供空间细节,但注入量必须被预算约束,否则 latent 会偏向重建而难以被生成模型建模。技术路线分四步:第一步,冻结 DINOv3-L,为每层特征 $H_\ell\in\mathbb{R}^{N\times C}$($N=256$,$C=1024$)配一个 token-wise MLP 专家,得到 $U_\ell=E_\ell(H_\ell)$;第二步,用最深特征经共享线性投影产生逐 token 路由分数,再做保留符号的 ℓ2 归一化 $w_n=a_n/\|a_n\|_2$;第三步,把 24 层按深度分三组,每组求加权和 $R_g=\sum_{\ell\in G_g} w_\ell\odot U_\ell$,经组内 dropout 与范数帽压成受控修正 $\Delta_g=C_g(R_g;H_{23})$;第四步,融合 $Z=\mathrm{LN}(H_{23}+\sum_g\Delta_g)$ 经解码器重建,以重建、感知、对抗损失联合训练融合与解码器,再冻结 tokenizer 训练 DiT。
核心创新是深度相关的残差预算(residual budgets)机制,与已有方法的本质区别有三点。其一,RAEv2 对选定的 7 层做固定聚合,完全没有可学习的融合模块,层选择成为昂贵的设计变量;HiRAE 学习全部 24 层的空间可变贡献,彻底免去子集搜索。其二,DRoRAE 虽学习逐层专家与路由,但用固定 80:20 的全局插值与锚点混合,且必须先训融合、再适配解码器的多阶段流程;HiRAE 用组级范数帽 $\|\Delta_g\|_F\le c_g\|H_{23}\|_F$(逐图在全部空间 token 与通道上计算 Frobenius 范数)硬性约束修正幅度,使融合与解码器可以一步联合训练。其三,预算随深度递增(浅 0.025、中 0.075、深 0.150)、dropout 随深度递减(0.50、0.25、0.10),编码了『越浅的层越可能是低级噪声、只允许微幅修正』的先验,配合三角不等式给出总修正 $\le 0.25\|H_{23}\|_F$ 的全局界,是对重建-生成权衡的首个显式结构性解法。
方法步骤详情
训练分两阶段。阶段一:256×256 图像输入,冻结编码器逐层输出 $H_\ell$,24 个专家 MLP 输出 $U_\ell$;深锚点 $H_{23}$ 经线性投影产生逐 token 路由分数,带符号 ℓ2 归一化得权重;按深度分组聚合 $R_g=\sum_{\ell\in G_g}w_\ell\odot U_\ell$;控制模块 $C_g$ 先以 (0.50, 0.25, 0.10) 的概率做残差 dropout,再在 $\|\Delta_g\|_F$ 超过预算 $c_g\|H_{23}\|_F$(0.025/0.075/0.150)时缩回;融合 $Z=\mathrm{LN}(H_{23}+\Delta_s+\Delta_m+\Delta_d)$ 经解码器重建,用 L1、感知与对抗损失(带解码器输入噪声)联合更新融合与解码器。阶段二:冻结 tokenizer,按 RAEv2 协议训练 DiT;ImageNet 训 80 epochs,T2I 在 JourneyDB 加 BLIP3o 预训练 100K 步、再在 BLIP3o-60k 上 SFT。
技术新颖性
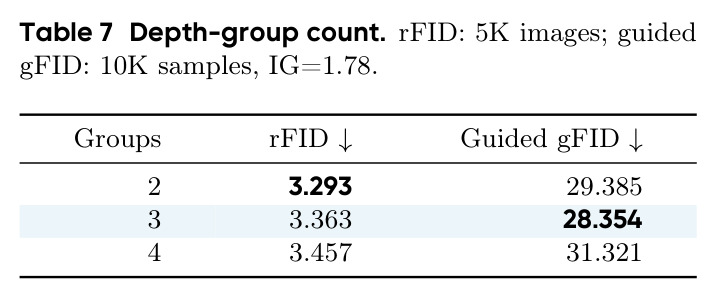
技术新颖性体现在三方面。第一,『预算化融合』的形式化:把多层特征融合从『学权重』升级为『学权重加控幅度』,范数帽 $\|\Delta_g\|_F\le c_g\|H_{23}\|_F$ 是对 latent 修改量的硬约束,与权重衰减等软约束不同,它对任意训练动态都成立,三角不等式进一步给出 $\|\Delta_s+\Delta_m+\Delta_d\|_F\le 0.25\|H_{23}\|_F$ 的全局界。第二,用结构先验替代架构搜索:三组划分与 1:3:6 的预算比有消融支持(Table 7 中 2/3/4 组的 guided gFID 为 29.385/28.354/31.321,3 组最优),把 DRoRAE 的层子集与阶段式训练问题转化为少数可解释超参。第三,实证揭示重建-生成解耦:未正则化配置 rFID 可低至 0.023 但 gFID 崩到 7.905、FD6r 14.722,而加预算后 rFID 0.209、gFID 1.038,说明在冻结编码器范式下预算是重建增益转化为生成增益的必要条件。
实验结果
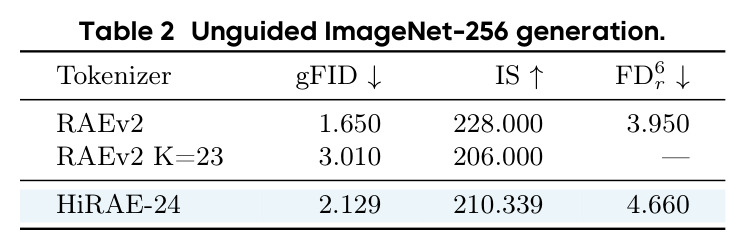
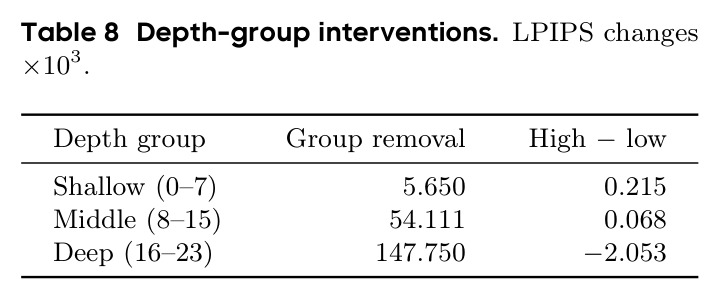
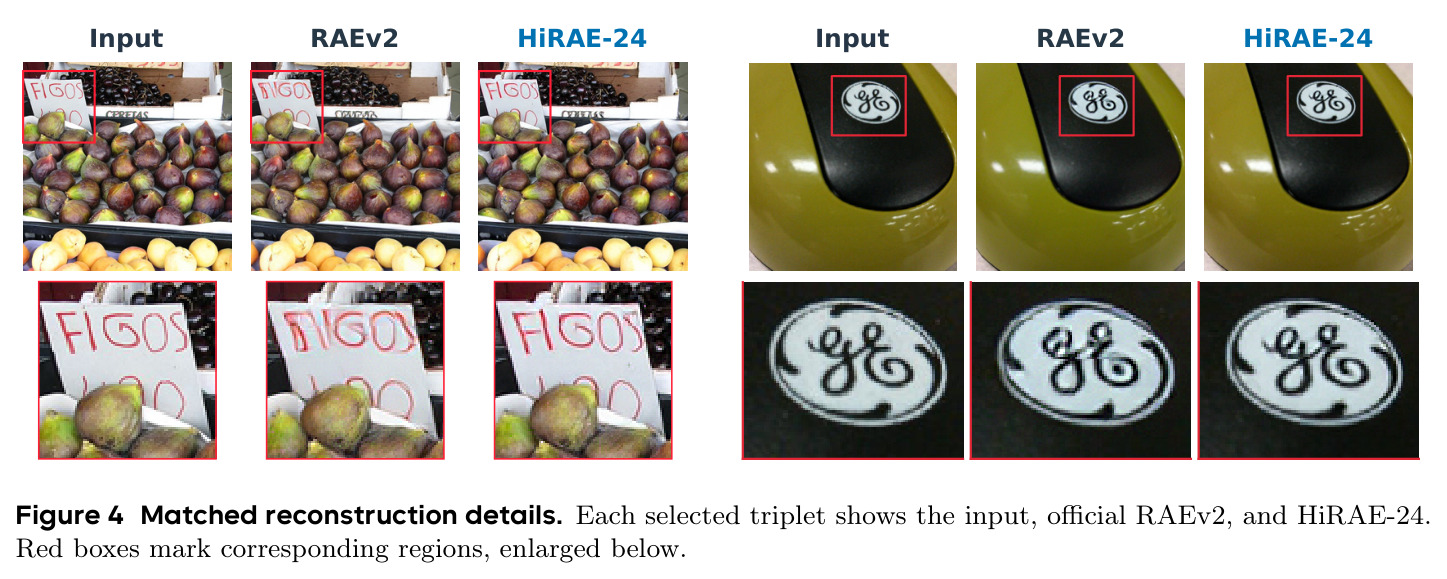
重建上(Table 1),latent 形状不变时 rFID 从 0.299 降到 0.209(约 30%),5K 匹配子集 PSNR 22.667 升至 26.377 dB、LPIPS 0.074 降至 0.043,改善覆盖全部纹理分位。类条件生成(Table 2/3)guided gFID 由 1.060 降至 1.038、IS 升至 257.823、FD6r 降至 1.856;无引导 gFID 2.129,优于 RAEv2 K=23 的 3.010、不及 RAEv2 的 1.650。文本生图(Table 4)SFT 后三项对齐基准全面超过 RAEv2,GenEval 领先 2.84 分且预训练阶段已领先 4.52 分。消融(Table 5–8):raw-layer 专家优于 depth-mode 专家(0.209 对 0.230);无正则化配置 rFID 低至 0.023 但 gFID 崩至 7.905,证明预算是重建增益转化为生成增益的前提;同 7 层的 HiRAE-7 把 rFID 降至 0.217;移除浅/中/深组使 LPIPS 分别增 5.650/54.111/147.750(×10⁻³)。潜空间分析(Figure 6):同类 10 近邻占比 74.454% 升至 79.536%,有效秩 130.360→154.893 而 CKA 保持 0.985,10% 潜扰动的输出 LPIPS 变化仅为 RAEv2 的 21%–22%。
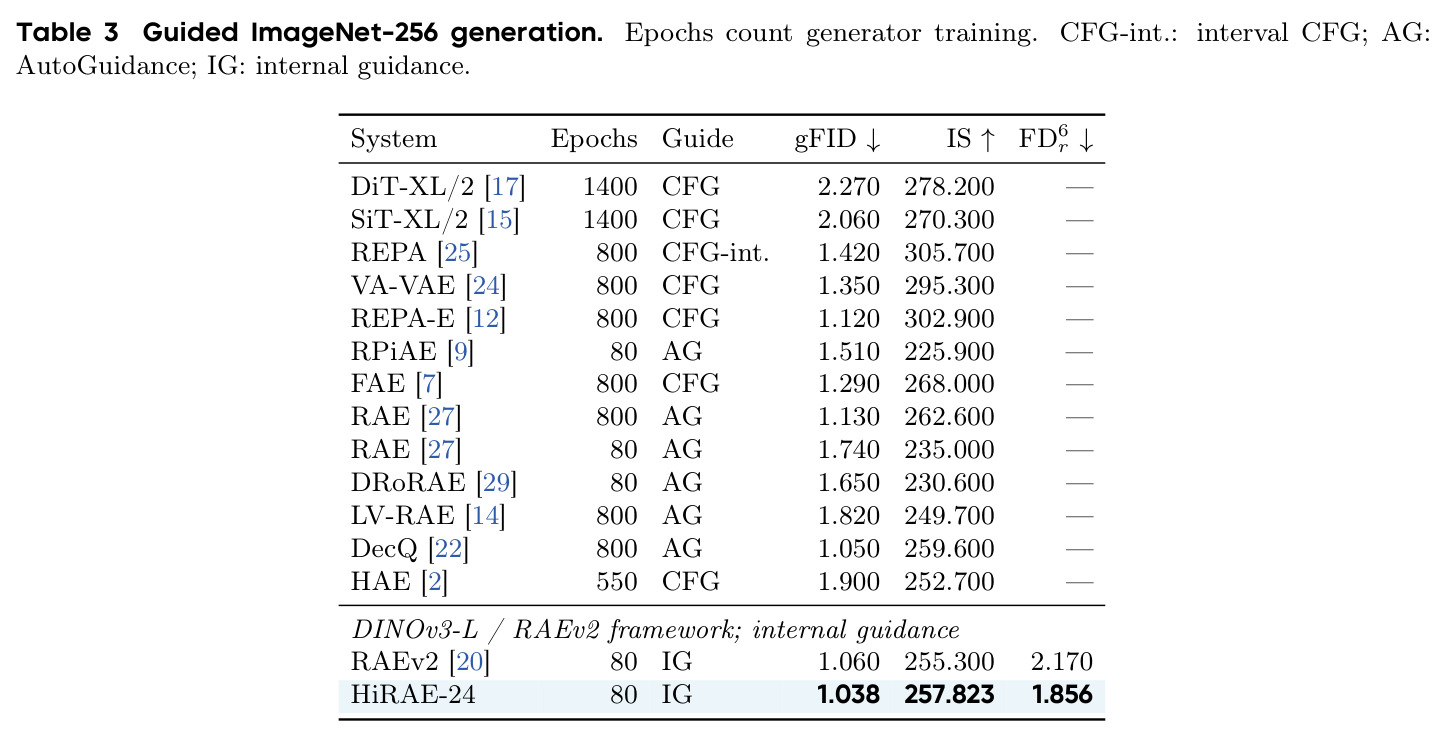
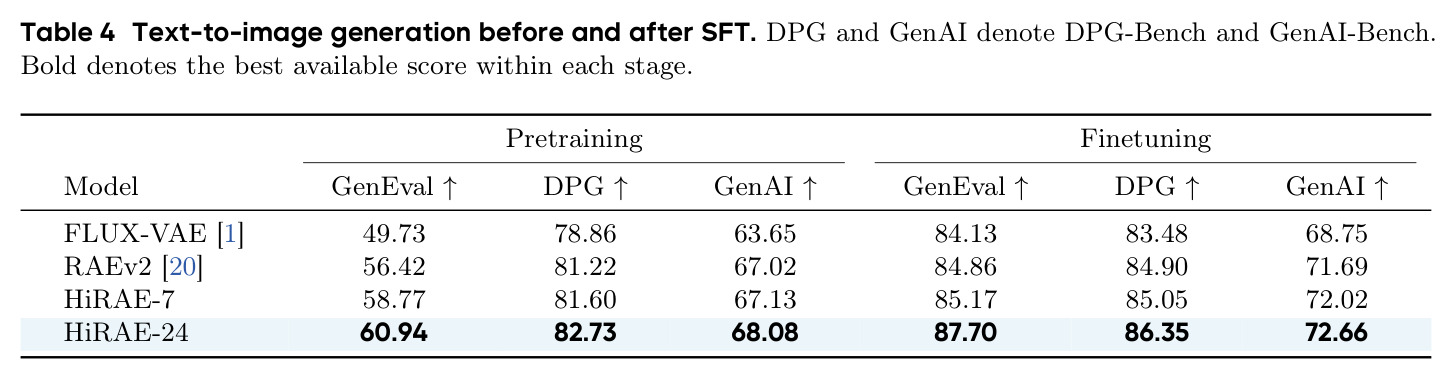
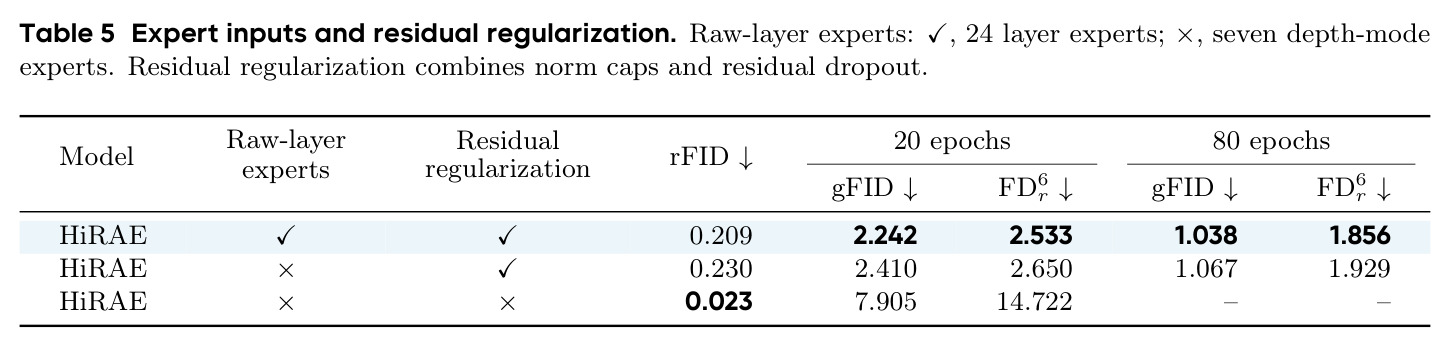
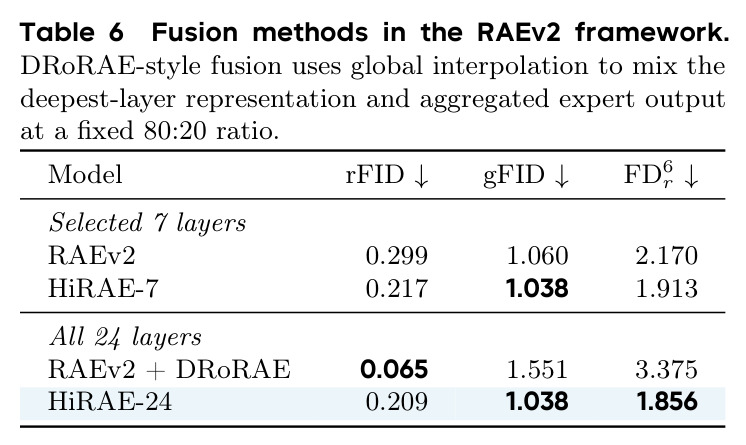
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-256 图像重建 | rFID ↓ | 0.209 | RAEv2 0.299 | 相对降低约 30% |
| ImageNet-256 图像重建(匹配 5K 子集) | PSNR ↑ | 26.377 dB | RAEv2 22.667 dB | +3.710 dB |
| ImageNet-256 图像重建(匹配 5K 子集) | LPIPS ↓ | 0.043 | RAEv2 0.074 | 降低约 42% |
| ImageNet-256 类条件生成(80 epochs,内部引导) | gFID ↓ | 1.038 | RAEv2 1.060 | 降低 0.022 |
| ImageNet-256 类条件生成(80 epochs,内部引导) | IS ↑ | 257.823 | RAEv2 255.300 | +2.523 |
| ImageNet-256 类条件生成(80 epochs,内部引导) | FD6r ↓ | 1.856 | RAEv2 2.170 | 降低 0.314 |
| 文本生图(SFT 后) | GenEval ↑ | 87.70 | RAEv2 84.86 | +2.84 |
| 文本生图(SFT 后) | DPG-Bench ↑ | 86.35 | RAEv2 84.90 | +1.45 |
| 文本生图(SFT 后) | GenAI-Bench ↑ | 72.66 | RAEv2 71.69 | +0.97 |
局限与改进
作者承认的局限:无引导生成 gFID 为 2.129,明显差于 RAEv2 的 1.650,说明预算约束在无引导设定下仍限制了重建细节向样本质量的转化;未正则化的深度模式配置可达 rFID 0.023,暗示本文方法距重建上限尚远;中间深度组高/低频敏感性差异的 95% 置信区间包含零,组间功能划分并非完全清晰。我自己的观察:其一,所有结论都基于 DINOv3-L 单一编码器,预算系数 (0.025,0.075,0.150) 与 dropout 率 (0.50,0.25,0.10) 换骨干后是否需要重调未知,相当于把『层选择』换成了『组超参选择』;其二,ImageNet 生成只训了 80 epochs,而表中多数对比系统训练 550–1400 epochs,长程训练下优势是否保持缺乏证据;其三,T2I 实验沿用 RAEv2 协议,未与 DecQ、DRoRAE 在同一 T2I 设置下对比,也未与 REPA-E 这类端到端调优方法在同等算力下公平比较;其四,范数帽按整图 Frobenius 范数计算,无法约束空间上不均匀的修正,理论上存在局部区域被过度修改的空间。
独立分析的弱点
独立分析出四个弱点。第一,超参只是换了个形态:虽然免去了 7 层子集搜索,但三组划分、预算 (0.025,0.075,0.150)、dropout (0.50,0.25,0.10) 共引入约 6 个新超参,且 Table 7 显示组数 2/3/4 的 guided gFID(29.385/28.354/31.321)差异并不悬殊,方法对超参的敏感度未知;改进方向:给出预算系数扫描曲线,或把预算设为可学习的软上限。第二,无引导生成存在短板:gFID 2.129 对 RAEv2 的 1.650,提示预算压缩了 latent 的表达带宽;可探索推理期自适应放松预算,或对生成器输入做分布对齐。第三,单一骨干、单一分辨率:仅在 DINOv3-L 与 256×256 上验证,16×16 token 的低分辨率 latent 对细节容量有先天限制,应在 ViT-H/384 等更大骨干和 512 分辨率上复验。第四,评估覆盖不均:T2I 得分来自 100K 步预训练加短程 SFT,缺少与 DecQ、DRoRAE 的 T2I 对照;Table 8 的组干预消融未报告样本量与置信区间,稳健性有待加强。
未来方向
作者方向上:HiRAE-7 已展示框架可退化到既有层子集上的紧凑融合,未来可系统研究预算如何随层数与骨干深度缩放;潜空间分析显示解码灵敏度降低 21%–22%,可把『低解码灵敏度』从诊断指标升级为显式训练目标,替代或补充范数帽;文中还指出中间组功能模糊,值得用频域分解在组内细分。延伸方向上:其一,把残差预算思想迁移到视频 tokenizer(按时间深度分组施加分层预算),检验跨模态通用性;其二,与 REPA-E 的端到端调优结合——预算约束恰好为端到端微调 tokenizer 提供安全护栏,防止 latent 漂移;其三,做输入自适应的预算(按图像纹理强度或类别动态调整 $c_g$),附录 C.3 已发现高纹理图像获益更大,这是明显的自适应线索;其四,联合优化解码器容量与预算,尝试在无引导设定下追赶 RAEv2 的 1.650;其五,从理论上刻画预算界与 latent 分布性质(高斯性、有效秩、解码灵敏度)的定量关系,为 tokenizer 设计提供预测性工具。
复现评估
复现评估:正文未给出开源代码或权重的链接,这是复现的最大不确定性,需关注作者后续是否发布。利好因素:数据全部公开——ImageNet-1K、JourneyDB、BLIP3o 长短 caption 子集与 BLIP3o-60k 均可获取;冻结的 DINOv3-L 编码器公开可用,tokenizer 只训练融合模块与解码器,参数量远小于从头训练;论文承诺附录 A 给出 loss 权重与训练配置、A.1 给出专家与归一化实现细节、A.4 给出训练日程与评分协议,实验协议描述较完整(50K 样本 ADM 协议、匹配 5K 子集的 PSNR/LPIPS、CFG=6 且关闭内部引导的 T2I 推理设置等)。挑战:DiT-XL 级生成器 80 epochs 加 T2I 100K 步预训练再加 SFT 的总算力对学术实验室偏重;范数帽的缩放方式、Frobenius 范数按图还是按 batch 计算、EMA 细节等仍需精读附录确认。综合判断:tokenizer 部分复现难度中等,完整生成结果复现难度较高。
论文图表
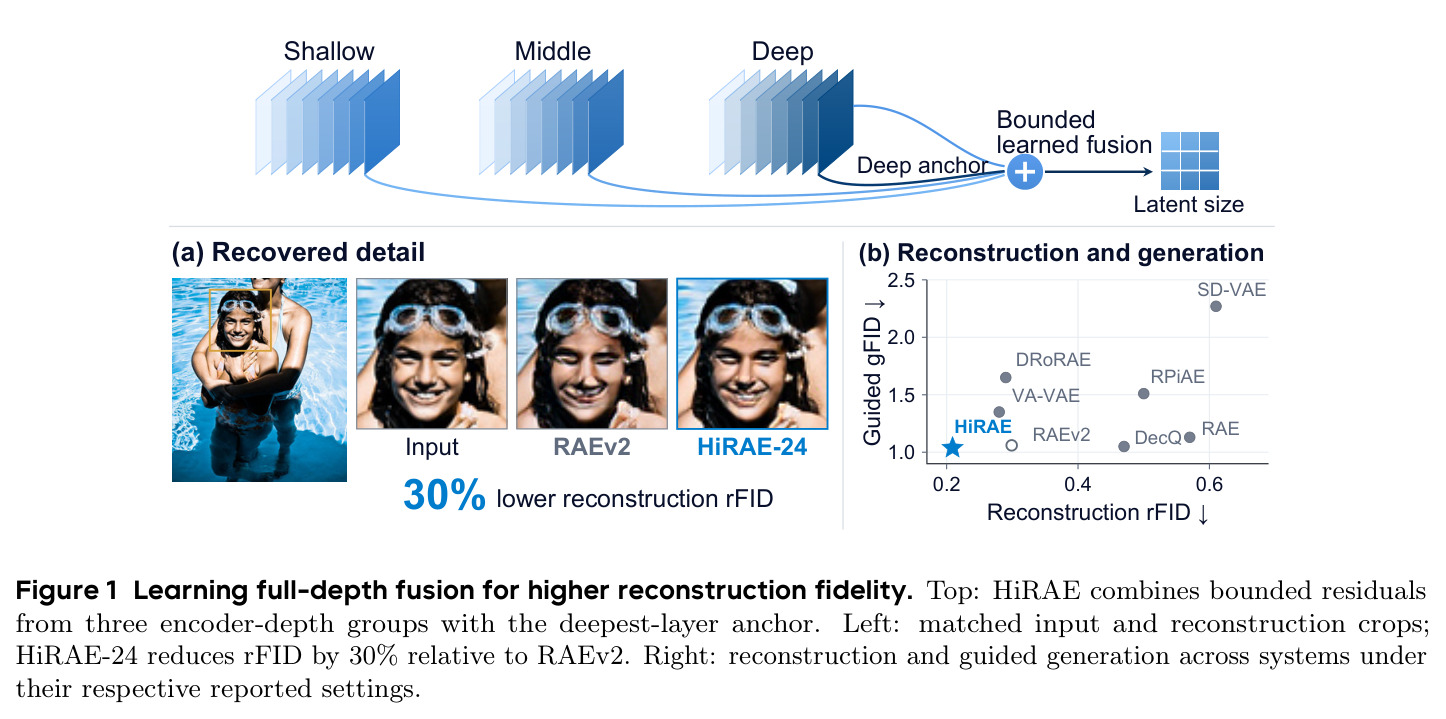
总览图:顶部示意 HiRAE 把三个深度组的有界残差与最深层锚点结合;左侧为输入与重建的对比裁剪块,标注 HiRAE-24 相对 RAEv2 把 rFID 降低 30%;右侧散点对比 SD-VAE、VA-VAE、RAEv2、DRoRAE、HiRAE 等系统的重建 rFID 与 guided gFID。
一张图同时讲清动机(最终层细节缺失)、方法(全深度有界融合)与结果(重建-生成双赢),是全文的摘要级图示。