上下文语言模型:把上下文当文件、由模型自主管理的原生上下文管理范式 Context Language Models
把上下文变成模型可自由编辑的文件,零样本即超越人工设计的上下文管理策略
前置知识
KV 缓存与前缀复用(Prefix Caching)
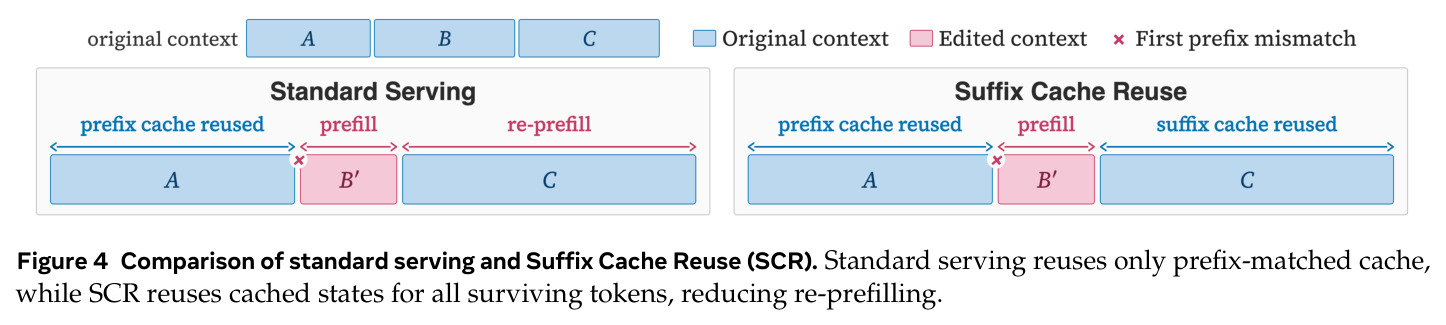
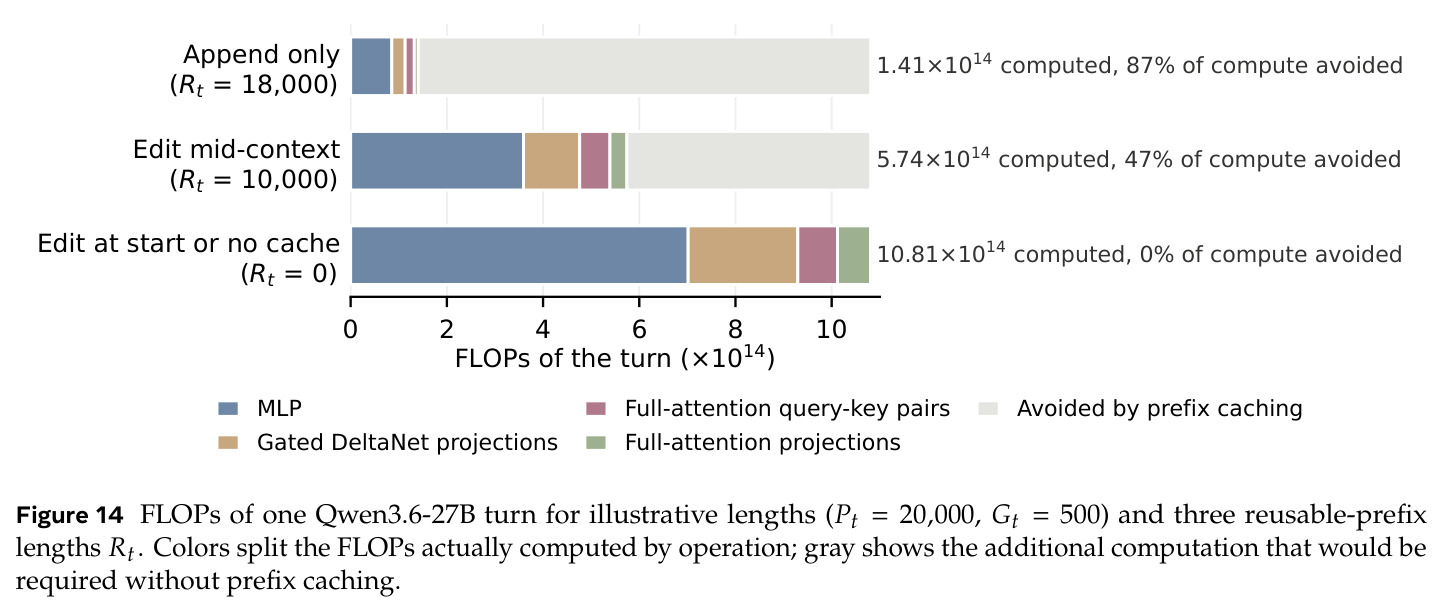
Transformer 推理时每个 token 的注意力键值(KV)会被缓存以避免重复计算。前缀复用(如 SGLang 的 radix tree)让共享相同开头的新请求直接沿用已缓存的 KV,只对第一个不匹配 token 之后的部分重新预填充(re-prefill)。一旦上下文中段被编辑,其后所有 token 的缓存即告失效,必须整体重算。
本文的效率度量 prefix-reuse FLOPs 和服务端优化 SCR 完全建立在前缀复用机制之上,不懂它就无法理解为什么中间编辑在推理系统中代价高昂。
智能体 harness 与上下文压缩
harness 是包裹模型的执行框架,负责把工具结果和历史消息组装成每轮输入。当上下文逼近窗口上限时,主流 harness(Codex、Cursor、Terminus2 等)按预设阈值触发压缩:用一条总结消息替换全部历史。压缩的时机、保留什么都由人工写死在框架里。
本文对比的全部基线(Codex 式总结、Self-Compact、ACM、MEM1、Context Folding、RLM)都是不同自主程度的 harness 策略,理解它们才能看出 CLM 把控制权放到了什么程度。
递归语言模型(RLM)
把超长输入放进 REPL(交互式编程环境)变量,模型通过写代码按需检索、分块处理输入,而不是把全文塞进上下文。它解决的是何时把什么信息读进来,但模型自己的活上下文仍是只读的、只增不减的。
RLM 是与 CLM 最相近的先行工作,两者在外置输入与可写活上下文之间的区别,是理解本文定位和创新点的关键。
GRPO 与 stepwise 强化学习
GRPO(组相对策略优化)对每个 prompt 采样一组完整轨迹,用组内平均奖励作为基线计算每条轨迹的优势,无需价值网络。智能体轨迹包含多次模型调用,stepwise 版本把轨迹级结果优势广播到每个调用分段,让每次调用都在其原始输入下计算策略梯度。
CLM 的上下文编辑会改写后续轮次的输入,破坏了标准的 append-only 轨迹结构,作者正是用 stepwise GRPO 解决这一问题并在此基础上加了效率优势项。
旋转位置编码(RoPE)
RoPE 用旋转矩阵把 token 的绝对与相对位置信息注入注意力的 Q/K 向量,是当前主流 LLM 的位置编码方案。KV 缓存复用时若 token 的位置发生改变,其 key 向量需要按新位置重新旋转才能保持注意力计算的正确性。
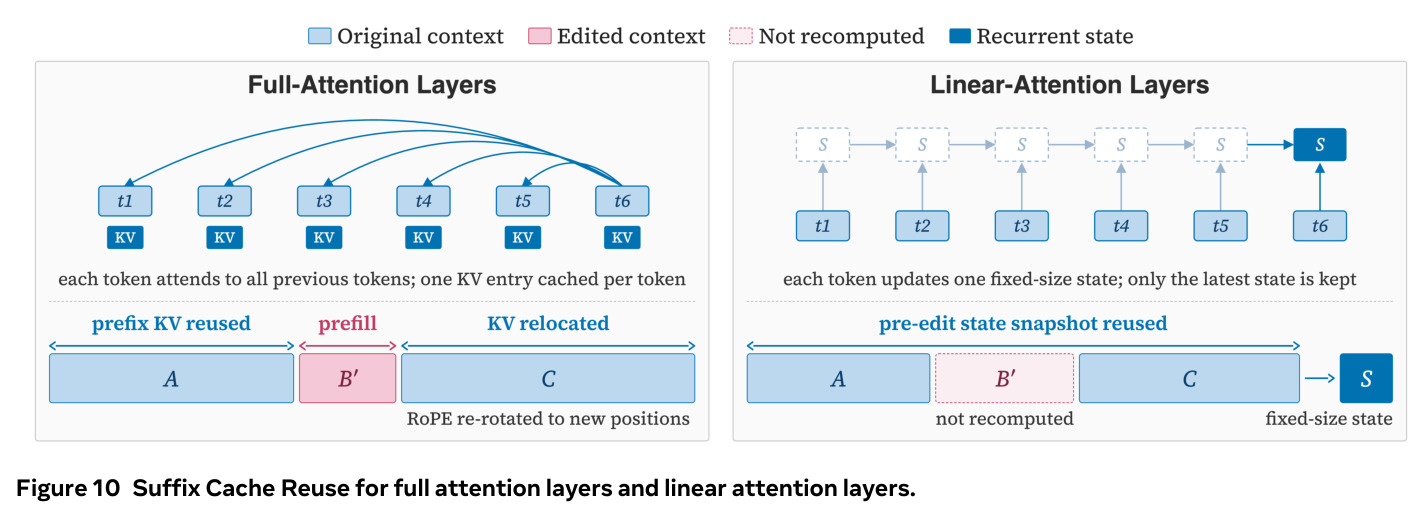
Suffix Cache Reuse 之所以能把编辑后幸存 token 的缓存搬到新位置继续复用,靠的正是对 key 的 RoPE 重旋转,理解 RoPE 才能明白 SCR 的实现原理。
研究动机
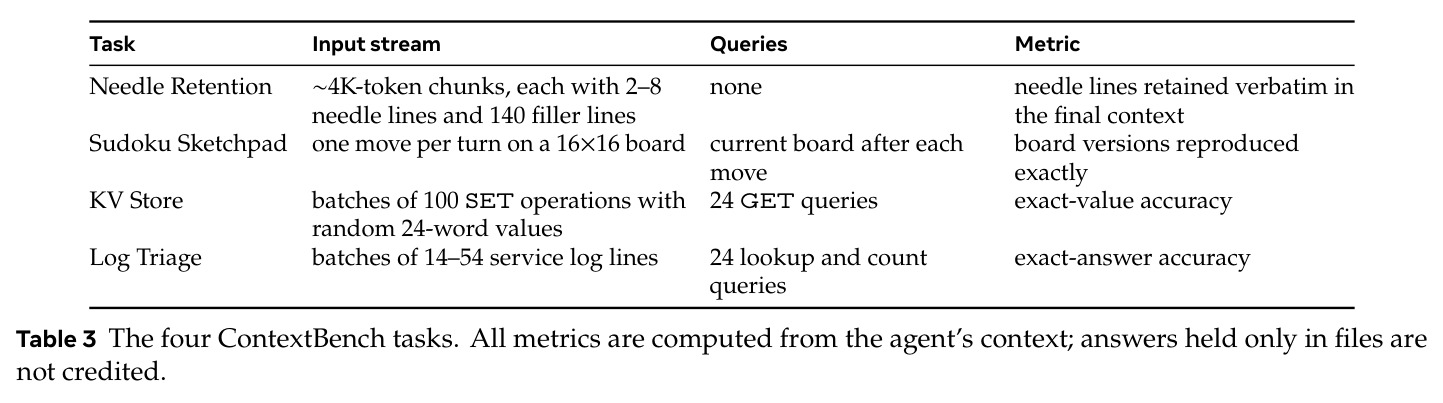
长程智能体任务中上下文会持续膨胀到失控:BrowseComp-Plus 深度研究的平均上下文达 97K token,Software World 六仓库协同优化用 272K 预算跑 24 小时以上,EdgeBench 单仓优化持续 12 小时。现有上下文管理几乎都由外部 harness 主导:Codex、Cursor、Terminus2 在预设长度阈值触发固定的总结流程;Self-Compact、AutoCompact、ACM、Context Folding 等虽让模型决定何时压缩,但可用的操作仍被限制在人工定义的动作空间里(压缩、外置、检索等固定工具)。作者的 ContextBench 诊断实验揭示这些固定策略连简单任务都做不好:在 32K 上下文限制、输入压力拉到 24 倍时,总结式压缩在 Needle Retention 上会丢失或幻觉出必须逐字保留的关键信息;不具备原位编辑能力的方法在 Sudoku Sketchpad 上每次细粒度改动都要重新生成整个 16×16 棋盘;标准编码工具能在 KV Store 上把信息外置到磁盘,却无法按需把已无用的信息从活上下文中驱逐。结果是没有任何现有方法在这些刻意简单的任务上做到满分,人工先验设计的策略已成为瓶颈。
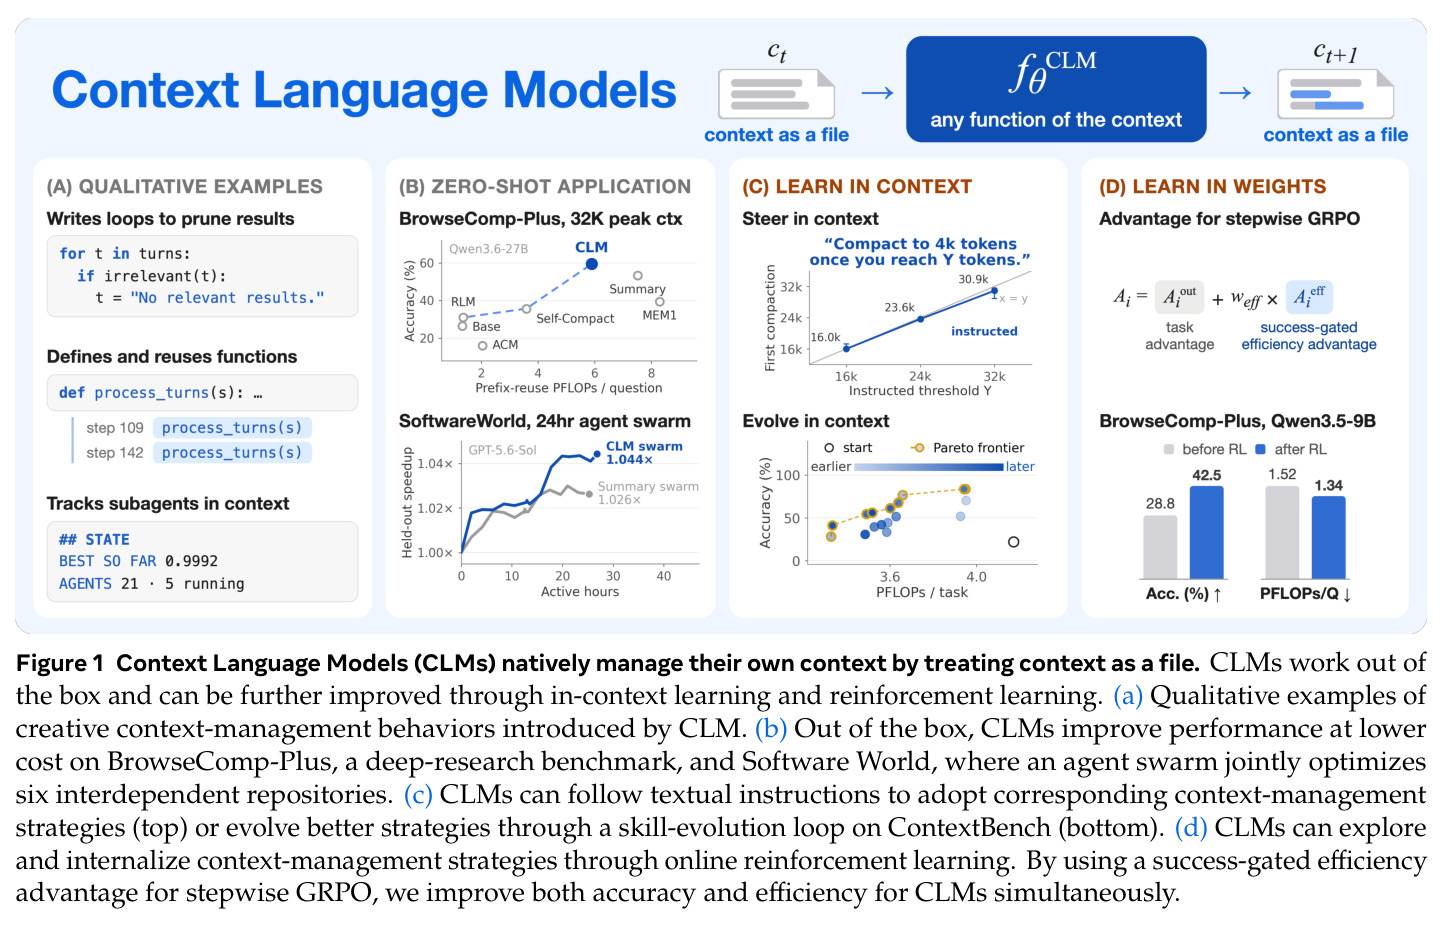
本文的目标是本文要把上下文管理从外部 harness 的职责彻底变成语言模型的原生能力:让模型对自己的上下文拥有不受限的读写权,形式化为上下文转移 $c_{t+1} = f^{\theta}_{\text{CLM}}(c_t)$,由模型自主学习或搜索最优管理策略,而非执行人类预设的动作。具体目标分四层:一是零样本开箱即用,现有模型无需训练即可在同等或更少算力下超过最强 harness 基线(如在 BrowseComp-Plus 上准确率高 11.4% 且 FLOPs 少 21.5%);二是可被自然语言指令和技能文档在上下文中引导和演化;三是可通过在线强化学习把策略写入模型权重;四是配套解决服务效率问题(提出 prefix-reuse FLOPs 度量和 Suffix Cache Reuse)并提供解耦上下文管理与推理能力的诊断基准 ContextBench。
与已有工作不同的是,前人工作沿着逐步放权的路线推进:从 harness 固定策略,到模型决定何时压缩,再到模型在预定义动作集中选择,但始终没有人把定义管理函数本身的元能力交还给模型。本文的切入角度是:压缩、外置、检索都只是上下文变换的特例,与其枚举动作,不如给模型一个通用接口——把活上下文镜像为可任意编辑的文件并提供 Bash 权限——让模型自己发明管理动作。此外还有两个被忽视的点:其一,现有评测把上下文管理与推理、知识混在一起,无法单独诊断管理能力,本文用 ContextBench 把三者解耦;其二,现有效率度量忽略中间编辑导致的大量 re-prefill,本文提出 prefix-reuse FLOPs 把轨迹级真实推理成本计入比较,并据此设计了只在成功轨迹内重排的成功门控效率奖励。作者将其总结为对 The Bitter Lesson 的呼应:应该让模型自己搜索超越人类先验的策略。
核心方法
直觉上,本文把模型的工作记忆从一条只增不减的聊天记录,变成一份模型自己可以随意改写的草稿文件:重要的记在正文,过时的删掉,细节存到磁盘留个索引。技术路线分四步。首先是形式化:标准 LM 的上下文转移是追加式 $c_{t+1} = c_t \oplus f^{\theta}_{\text{LM}}(c_t)$,其中 $\oplus$ 为拼接;CLM 则直接由模型创造下一轮上下文 $c_{t+1} = f^{\theta}_{\text{CLM}}(c_t)$,$f^{\theta}_{\text{CLM}}$ 可以是模型控制的任意函数,先前的工具化方法都是它的特例。其次是实现:把活上下文镜像成一个文件并在系统提示中给出路径,模型每轮要么直接生成 token(默认追加到上下文),要么用 Bash 命令编辑该文件,编辑即时同步为下一轮的真实输入;多智能体场景即多个上下文文件共存,子代理的初始化与终止对应文件的创建与删除。第三是效率:定义 prefix-reuse FLOPs $= \text{首个前缀不匹配处之后所有 token 的 prefill FLOPs} + \text{新输出 token 的 decode FLOPs}$,并实现 Suffix Cache Reuse 复用编辑后幸存 token 的缓存。第四是学习:支持自然语言指令引导、技能文档的文本演化($s^* = \arg\max_s \mathbb{E}_{x \sim \mathcal{D}}[R(\tau(x;s))]$),以及带成功门控效率优势的逐步 GRPO 强化学习。
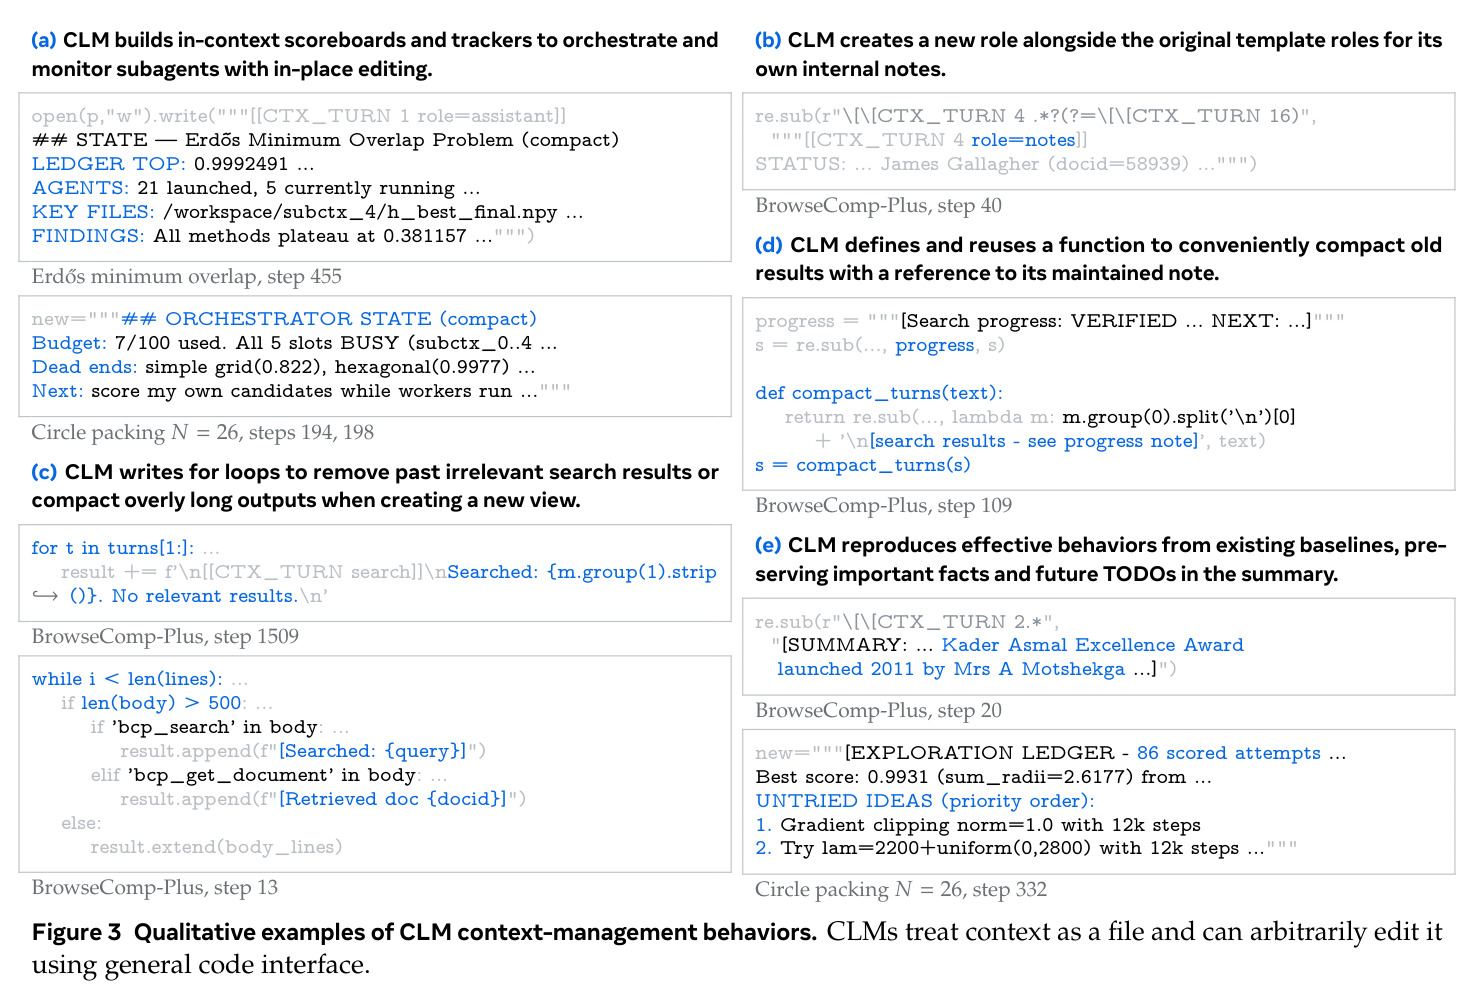
核心创新是上下文即文件加不受限编辑所带来的元能力:管理上下文的函数由模型自己定义,而非 harness 预设。模型可以隐式地通过规划来管理,也可以显式地定义可复用函数——例如在 BrowseComp-Plus 上模型自己写出 compact_turns 函数并调用了 37 次;在多智能体编排中维护记分板并进行 163 次原位编辑,同时把上下文稳定压在 6–8K token;甚至发明新的消息角色 notes 来存放内部笔记。这与 RLM 有本质区别:RLM 把长输入外置为只读的 REPL 变量,解决何时读什么,但活上下文本身仍只增不减;CLM 让活上下文可写,模型对外置与驱逐都有完全控制权。与强化学习的结合同样是新的:作者观察到单纯奖励结果对上下文编辑只有弱监督(成功轨迹可能含低效编辑,失败轨迹可能有有用编辑),而直接奖励编辑次数或删减量会诱发 reward hacking,因此提出成功门控效率优势 $A^{\text{eff}}_i = \text{clip}\left(\frac{\bar{c}_g - c_i}{\bar{c}_g}, -1, 1\right)$(仅对成功轨迹组 $\mathcal{G}^+_g$ 内生效,$c_i$ 为轨迹的 prefix-reuse FLOPs,$\bar{c}_g$ 为组内成功轨迹均值),只在成功轨迹内部按推理成本重排,总优势 $A_i = A^{\text{out}}_i + w_{\text{eff}} A^{\text{eff}}_i$。
方法步骤详情
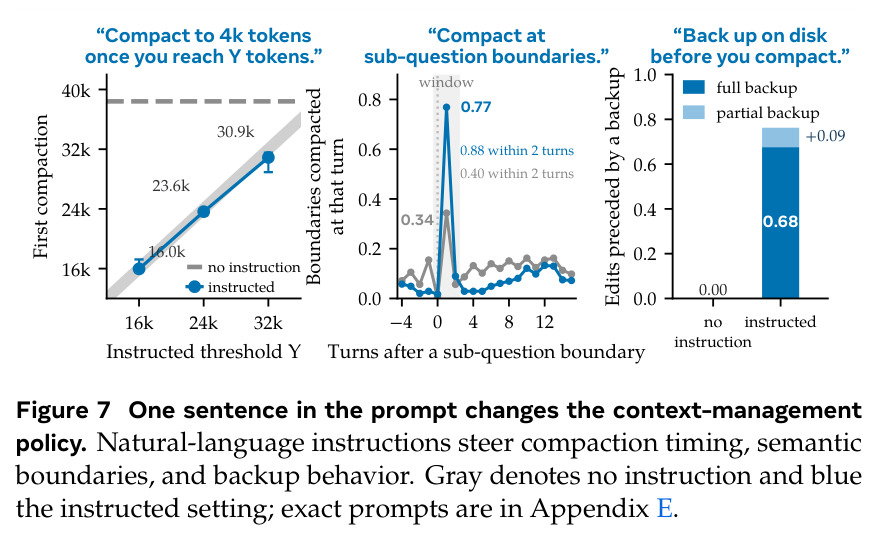
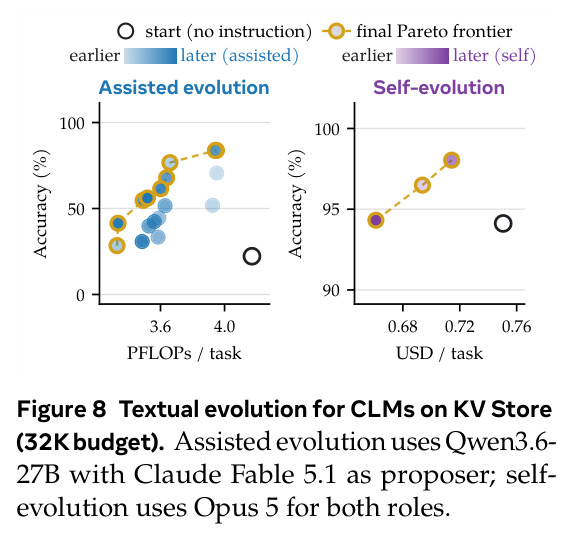
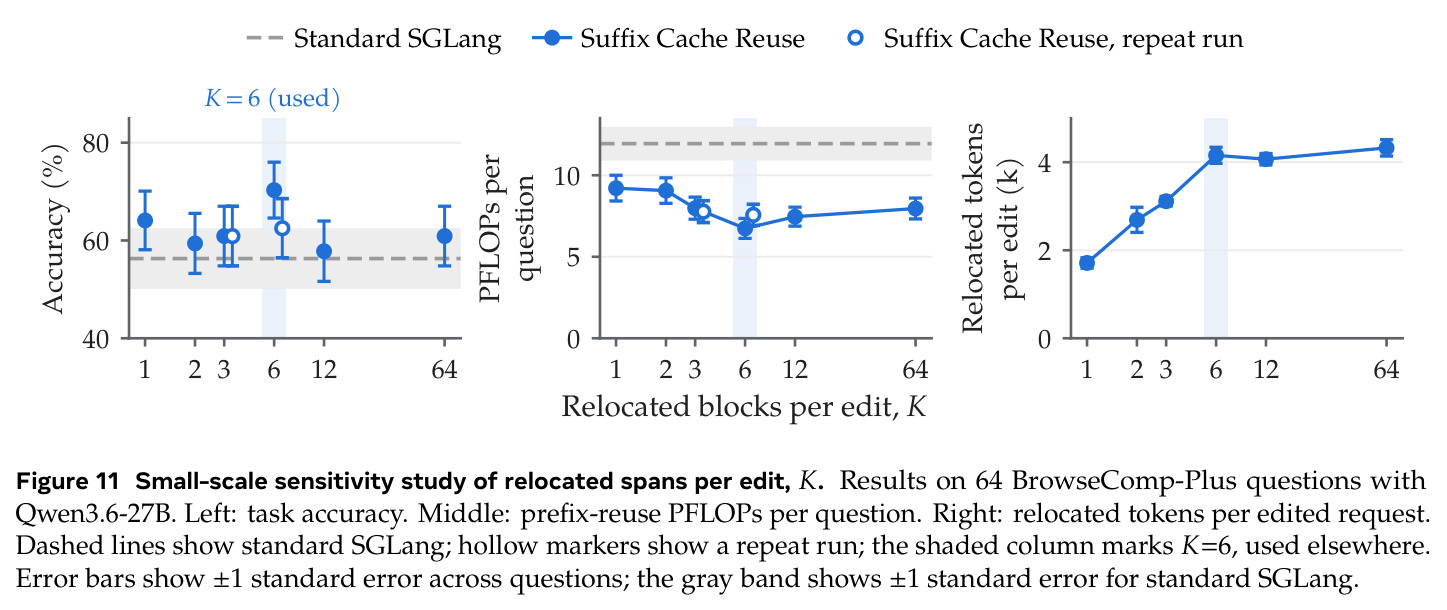
完整流程如下。第一步运行时:系统提示给出上下文文件路径(如 /tmp/.live_ctx/LIVE_CTX_MAIN.txt),模型每轮输出默认追加;也可用 Bash(python heredoc、re.sub 等)改写文件,改写在下一轮生效。为弥补模型上下文长度感知的不足,CLM 在预算耗尽前 2048 token 收到一次环境提醒;BrowseComp-Plus 上当请求将超预算时回滚最后一轮重试,最多 6 次。第二步指令引导:在任务提示后追加一句话即可改变策略,如超过 $Y$ token 就压缩到约 4000 token、只在子问题边界压缩、每次编辑前先备份,harness 与参数均不改动。第三步技能演化:每轮在训练集上 rollout,proposer 模型(辅助演化用 Claude Fable 5.1,自演化用 Opus 5 自任两角)至少读 10 条轨迹(含同一实例的成功与失败各 5 条)并写至少 4 个完整重写;候选技能先过 6 个训练实例,再在 102 题开发集上决定 Pareto 前沿归属,结束后在 held-out 测试集评一次,血统连续 5 次无改进即终止。第四步强化学习:用 stepwise GRPO,每个 prompt 采 8 组、每组 32 条轨迹,轨迹级结果优势广播到全部分段;效率优势权重 $w_{\text{eff}} = 0.25$ 且只作用于上下文管理 token,另加工具调用失败与格式错误的惩罚;训练 70 步,学习率 $10^{-6}$,KL 系数 0.01。第五步 Suffix Cache Reuse:新请求到达时 diff 新旧 prompt 找出编辑后幸存的 span,按长度降序最多搬迁 $K = 6$ 个,对其 KV 复用缓存并把 key 的 RoPE 重旋转到新位置后拼接,其余照常 re-prefill;对 Qwen3.6-27B 这类 48/64 层为线性注意力的混合架构,线性层改为从编辑前的 recurrent 状态快照续算。
技术新颖性
与已有技术相比有四个明确的新点。第一,动作空间的定义权移交:harness-defined 方法(Codex、Cursor、MEM1)固定压缩时机与流程,action-based 方法(Self-Compact、ACM、Context Folding、Sculptor)提供固定的工具集,CLM 是这条自主性递增路线的极限——模型用通用代码接口发明自己的操作。第二,学习范式完整:同一形式化同时支持上下文内学习(指令、可演化技能文档)与参数化学习(RL),而现有 RL 工作都绑定在特定 harness 机制上。第三,效率度量与奖励设计:先前的效率奖励多基于长度(如只对正确答案罚长度、在正确子集内算长度优势),本文首次用轨迹级 prefix-reuse FLOPs 刻画中间编辑引发的 re-prefill,并以成功门控方式避免给失败轨迹发效率奖。第四,服务优化 SCR:与 PIE、CacheBlend、Memento 同属非前缀 KV 复用,但首次面向智能体活上下文编辑场景集成进 SGLang,并扩展到全注意力与线性注意力混合架构(线性层无 per-token 缓存,改用状态快照)。
实验结果
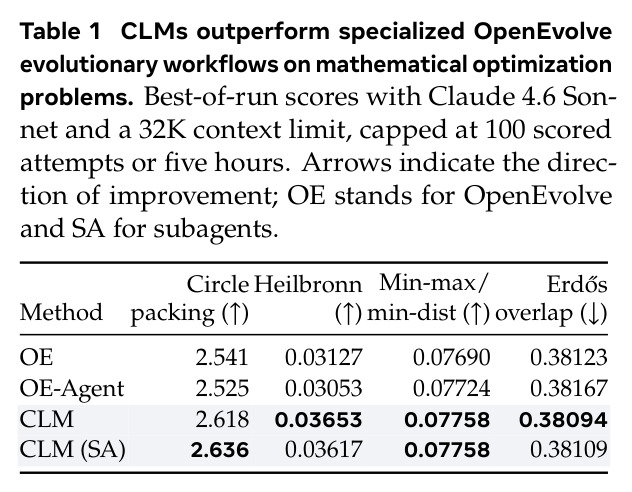
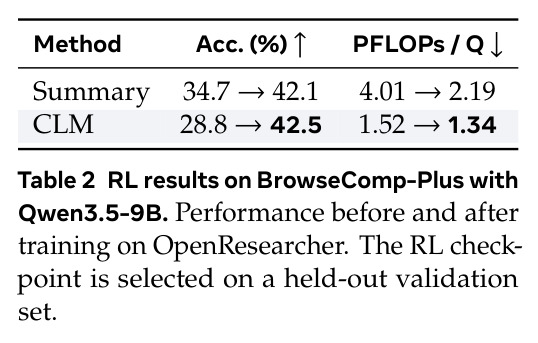
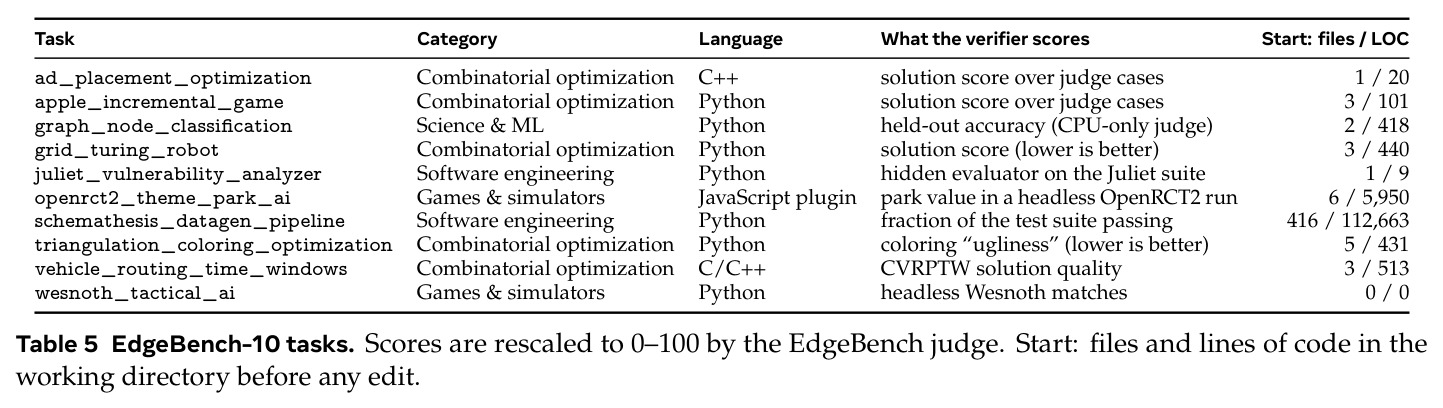
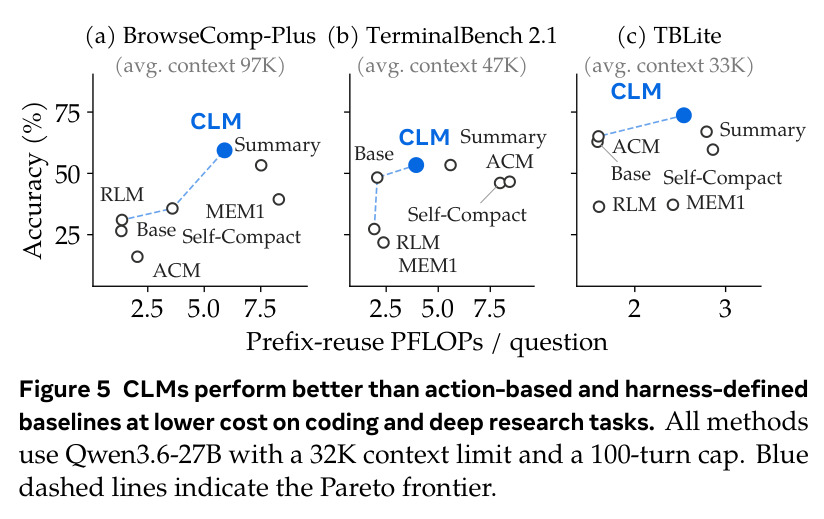
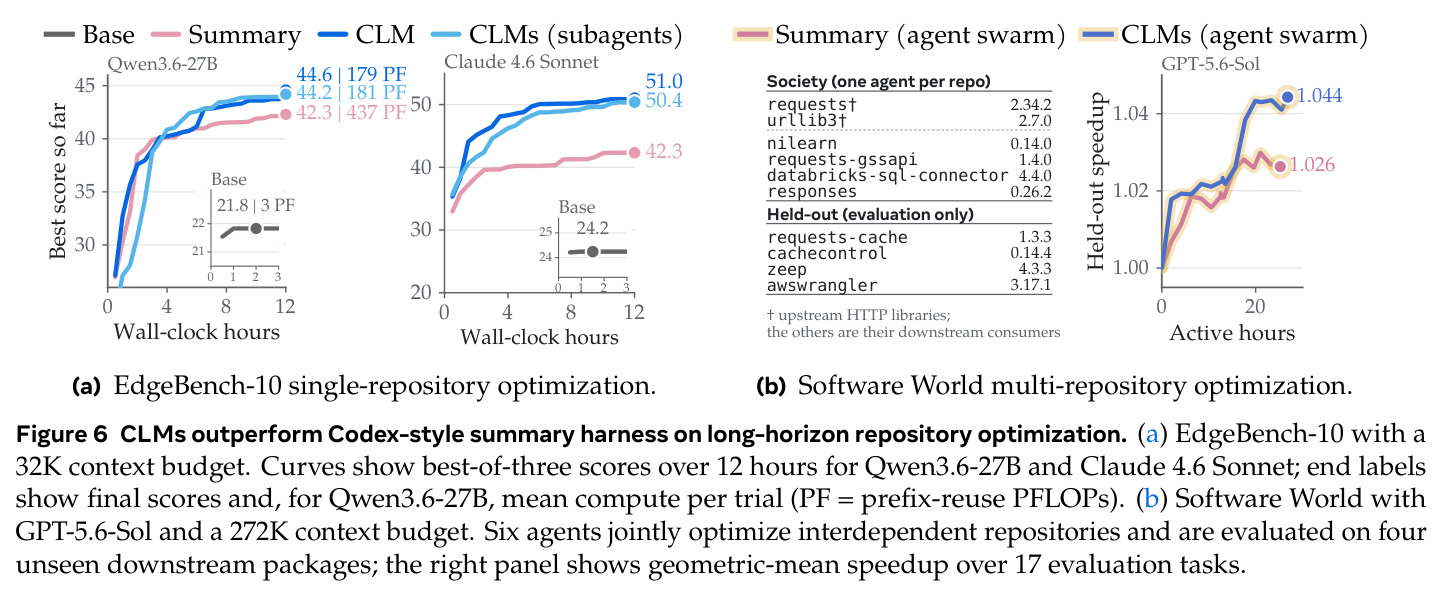
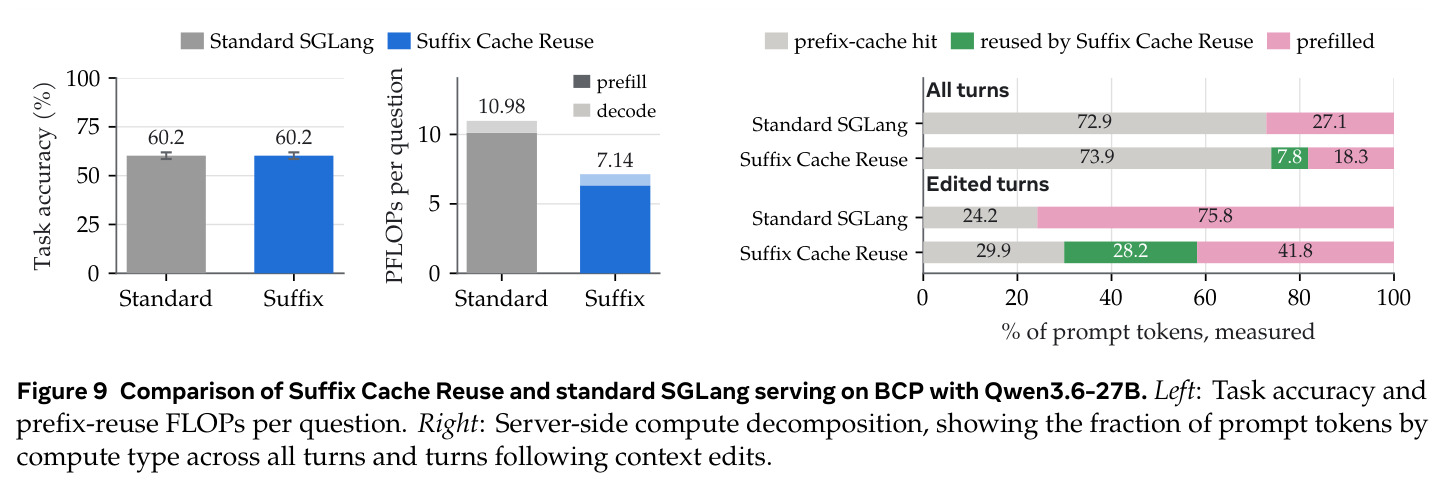
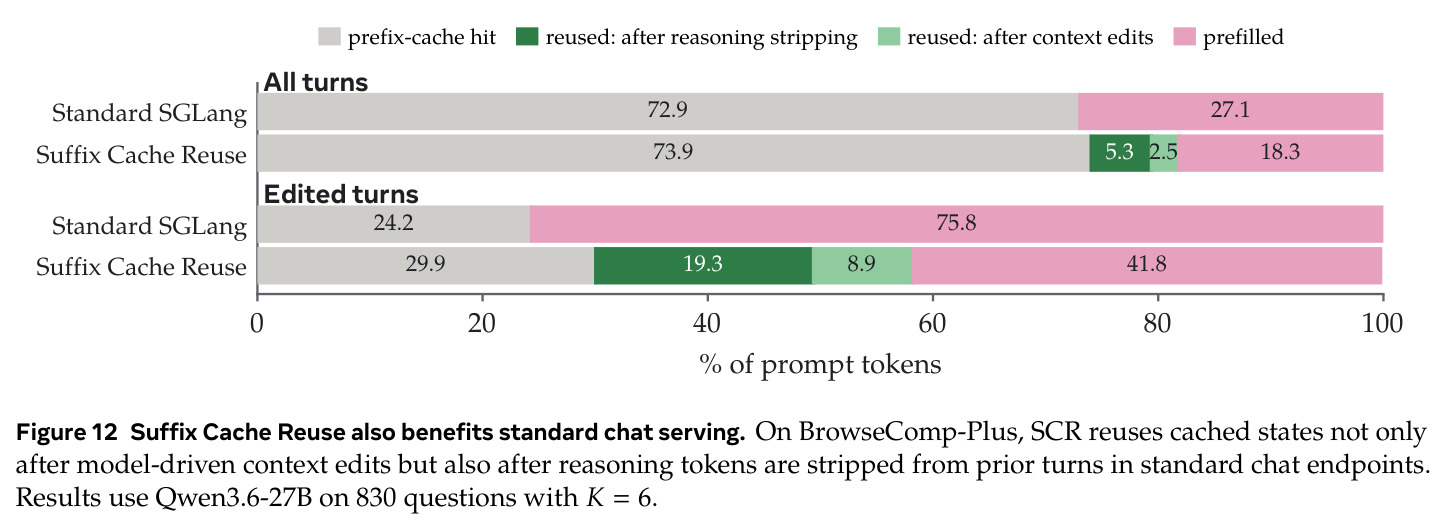
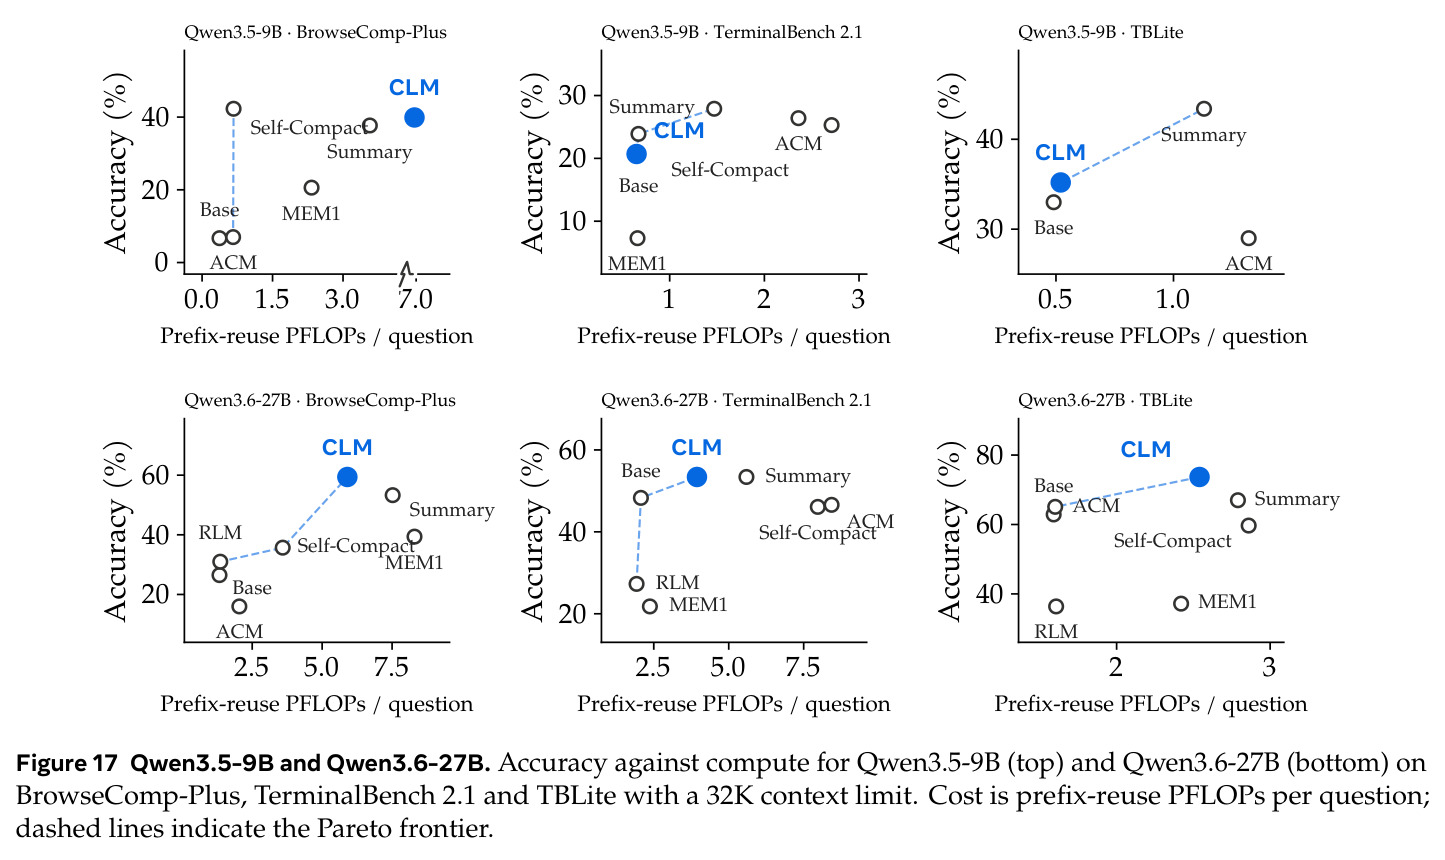
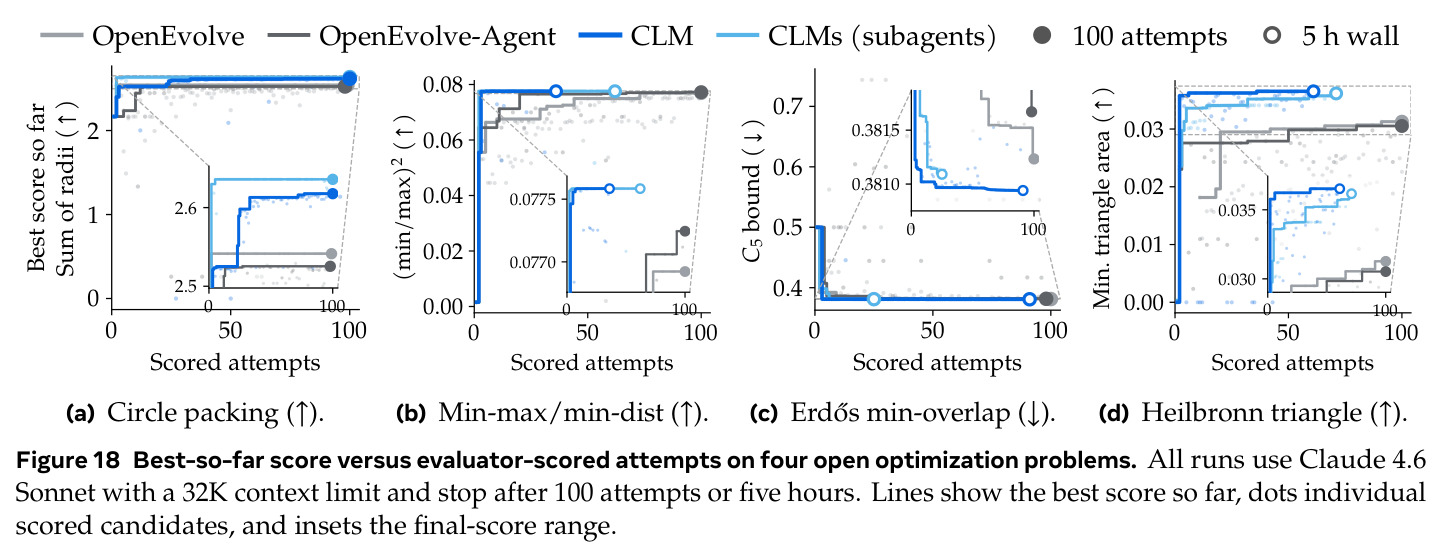
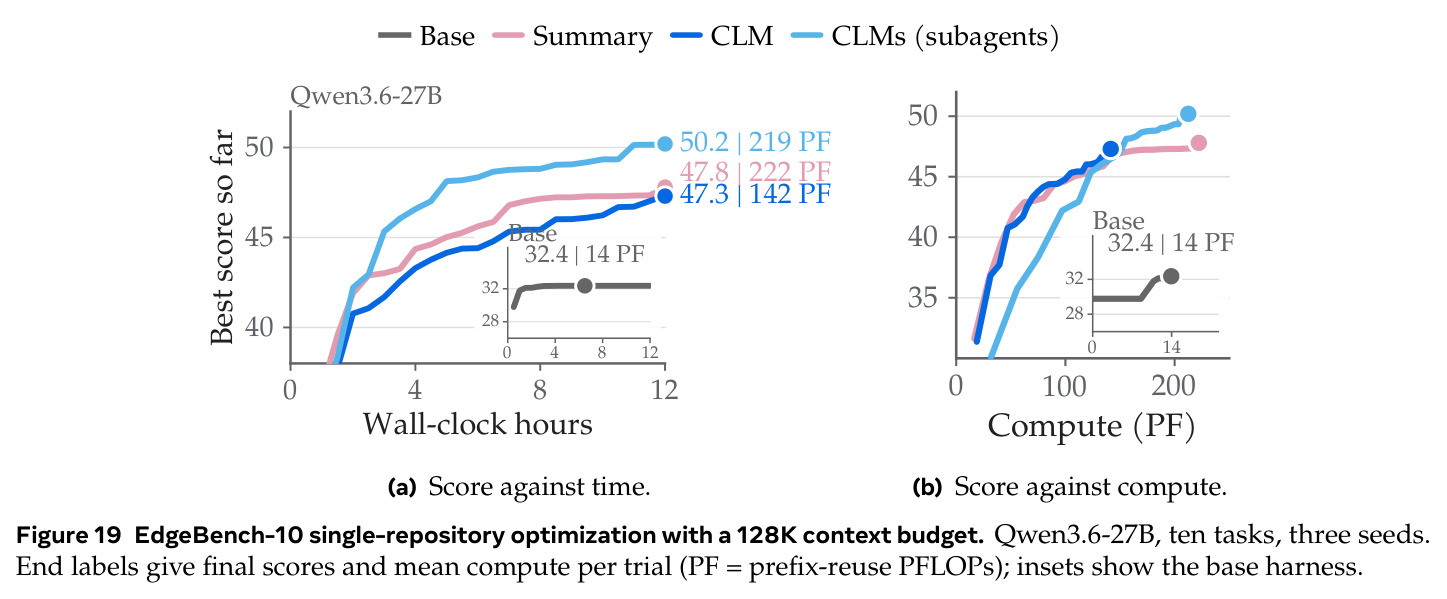
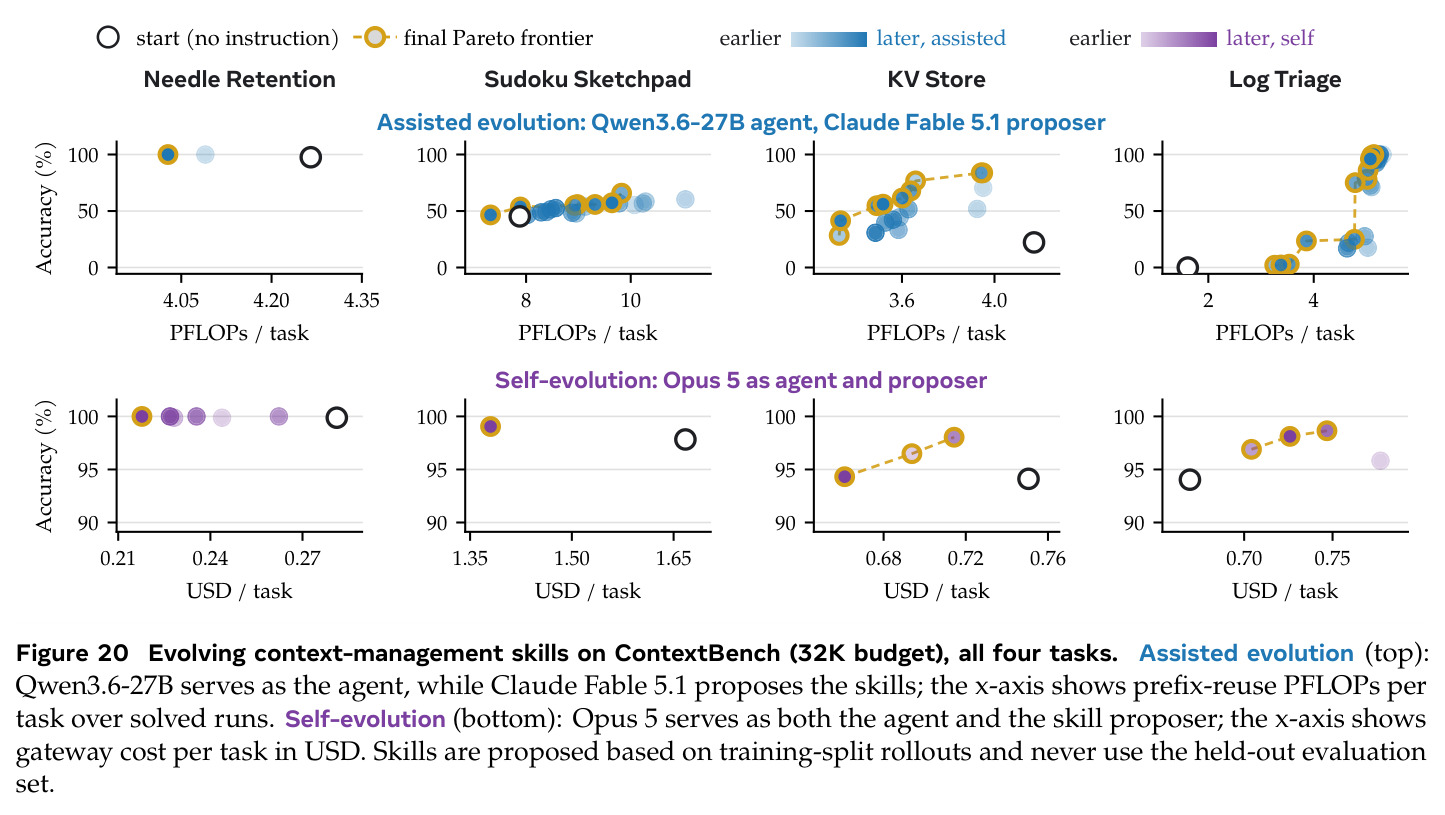
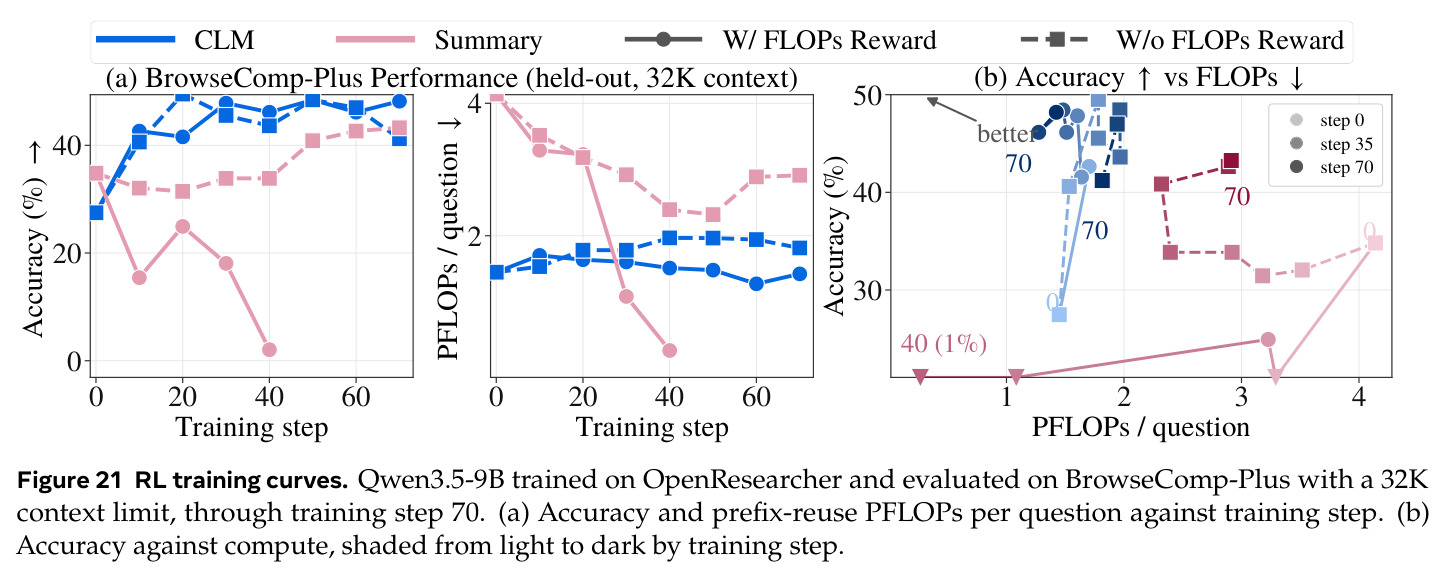
零样本评测(Qwen3.6-27B,32K 上下文预算):在 BrowseComp-Plus(830 题,平均上下文 97K)上 CLM 得 59.4%,以相对 11.4% 超过最强基线 Codex 式总结,且 prefix-reuse FLOPs 比总结和 MEM1 分别少 21.5% 和 28.9%;TerminalBench 2.1 上与最强基线打平但只用其 70% 的 FLOPs;TBLite 上 73.7% 对 67.0%,用 91% 的 FLOPs。数学优化(Claude 4.6 Sonnet,100 次评分或 5 小时):四个问题上全部第一,Heilbronn 0.03653 对 OpenEvolve 0.03127(+16.8%),circle packing 2.618(子代理版 2.636)对 2.541(+3.0%),Erdős 最小重叠 0.38094 优于 0.38123,证明通用智能体加上下文控制能胜过专门的进化工作流。EdgeBench-10 十二小时仓库优化:Qwen3.6-27B 下 CLM 44.6 分用 179 PF,总结基线 42.3 分用 437 PF(得分 +5%、FLOPs -59%);Claude 4.6 Sonnet 下 51.0 对 42.3;128K 预算下子代理版达 50.2@219 PF。Software World 24 小时六仓库 agent swarm(GPT-5.6-Sol,272K 预算):同等花费下 held-out 下游包的端到端加速比总结式 swarm 多提升 65%。指令引导:一句话即可让模型遵守指定压缩阈值(16K/24K/32K)、改在子问题边界压缩、或编辑前全量备份。技能演化:辅助演化把 KV Store 开发集准确率从 22.3% 提到 83.8%,held-out 从 38.3% 到 74.2%(+35.9 分),Log Triage 从 0% 到 100%。RL(Qwen3.5-9B):BCP 从 28.8% 升至 42.5%(+13.7 分,相对 +47.6%),FLOPs 从 1.52 降至 1.34 PF/题(-12%),并以少 38.8% 的 FLOPs 超过同配方训练的总结 harness(42.1%)0.4 分。SCR:与标准 SGLang 精度持平(60.2%)时只用其 65.0% 的 FLOPs(7.14 对 10.98 PF/题),其中 7.8 个百分点的复用收益有 5.3 来自推理 token 剥离而非上下文编辑,即标准 chat 服务也能受益。规模分析:Qwen3.5-9B 平均每任务仅编辑 1.4 次、半数任务不编辑,峰值上下文 30.2K/32K,而 27B 编辑 2.6 次、峰值 17.6K,说明 CLM 的收益随模型能力增长。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BrowseComp-Plus 深度研究(Qwen3.6-27B,32K 预算,零样本) | 准确率 / prefix-reuse FLOPs | 59.4% | 最强基线 Codex 式总结约 53.3% | 准确率相对 +11.4%,FLOPs 同时 -21.5% |
| TerminalBench 2.1 终端编程(89 任务) | 通过率 / prefix-reuse FLOPs | 与最强基线持平 | Codex 式总结(最强基线) | 精度持平下 FLOPs 降至 70%(-29.5%) |
| TBLite 终端编程 | 准确率 | 73.7% | Codex 式总结 67.0% | +6.7 分,FLOPs 为基线的 91% |
| 数学优化 Heilbronn 三角形问题(Claude 4.6 Sonnet) | best-of-run 得分(越高越好) | 0.03653 | OpenEvolve 0.03127 | +16.8% |
| EdgeBench-10 单仓优化 12 小时(Qwen3.6-27B,32K 预算) | 得分 / PFLOPs 每次试验 | 44.6 @ 179 PF | Codex 式总结 42.3 @ 437 PF | 得分 +5%,FLOPs -59% |
| Software World 六仓 agent swarm 24 小时(GPT-5.6-Sol) | held-out 下游包几何平均加速比 | 同等花费下加速提升幅度多 65% | 总结式 agent swarm(同等算力) | 端到端加速改进 +65% |
| BrowseComp-Plus(RL 训练后,Qwen3.5-9B) | 准确率 / PFLOPs 每题 | 42.5% @ 1.34 PF | 训练前 CLM 28.8% @ 1.52 PF;同配方训练的总结 harness 42.1% @ 2.19 PF | 较训练前 +13.7 分(相对 +47.6%)、FLOPs -12%;较训练后总结基线 FLOPs -38.8% |
| ContextBench KV Store(技能演化,held-out 测试集) | 准确率 | 74.2% | 无上下文管理指令的起点 38.3% | +35.9 分,且计算成本更低 |
| BrowseComp-Plus 服务效率(Suffix Cache Reuse) | prefix-reuse FLOPs / 准确率 | 7.14 PF/题 @ 60.2% | 标准 SGLang 10.98 PF/题 @ 60.2% | 精度持平下 FLOPs 降至 65.0%(服务端 -35%) |
局限与改进
作者承认的局限:其一,CLM 依赖模型自主决策,能力弱的模型收益缩水——Qwen3.5-9B 在 BCP 上只有 39.9%(27B 为 59.4%),平均每任务只编辑 1.4 次且半数任务不编辑,峰值上下文达 30.2K/32K;其二,现有模型的上下文长度感知很差,倾向输出 6.2K、9.8K、10.4K 这类桶状估计值(Claude 4.6 Sonnet 系统性低估),目前靠环境提示打补丁;其三,SCR 复用的是编辑前上下文算出的陈旧缓存,本质是近似,需要限制每次编辑最多搬迁 $K=6$ 个 span 以防误差复合;其四,可编辑上下文是新的安全攻击面,提示注入可借编辑跨轮持久驻留(OpenAI 已观察到模型把未授权指令写进自己的总结并影响后续行为);其五,SGLang 对混合模型的缓存实现导致大量未变前缀仍被重填充(编辑轮 28.2% 的 prefill 属于未变前缀),这不是 SCR 能解决的。我自己的观察:评测大量依赖 LLM judge(Qwen3.5-27B 按 BrowseComp-Plus 模板判分、RL 用 GPT-5.4-nano),判分偏差会直接影响结论;ContextBench 是合成任务,真实长程任务中上下文管理质量的归因没那么干净;数学优化和 Software World 只跑单次、未报方差;效率用理论 FLOPs 度量而非墙钟时间与显存,实际部署收益可能打折;RL 实验只做了 9B 一个模型、70 步的短程训练,规模效应未经检验。
独立分析的弱点
独立分析出五个弱点。第一,不可逆编辑风险:一次糟糕的 Bash 编辑可能毁掉关键信息,目前仅靠超预算时回滚最后一轮重试(BCP 上限 6 次)兜底;改进方向是给上下文文件引入版本控制或自动快照,把备份后再改训练成默认行为——论文中一句话指令即可诱导备份行为的实验正是雏形。第二,效率奖励覆盖面窄:$A^{\text{eff}}$ 只在组内成功轨迹不少于两条时非零,奖励稀疏的任务上效率信号几乎消失;改进方向是引入过程级成本估计或离线成本模型提供稠密信号。第三,效率度量与真实部署脱节:prefix-reuse FLOPs 是理论量,未计入 SCR 陈旧缓存对生成质量的影响,也未反映 TTFT、吞吐和显存占用;改进方向是补充端到端服务指标测。第四,安全未闭环:可编辑上下文让注入内容获得持久化通道,模型自写的笔记、总结都可能成为后门;改进方向是对上下文编辑做来源标注与完整性校验,并在 RL 中加入对抗注入的鲁棒性奖励。第五,评测自证风险:ContextBench、EdgeBench-10 子集、Software World 均为自建或自选任务,且部分实验单次运行;改进方向是在第三方真实任务上由独立团队复验,并报告多种子方差。
未来方向
作者提出的方向:一是扩大 CLM 的 RL 训练规模,让模型在更大的探索空间中自主发现上下文管理策略(当前仅 9B 模型 70 步);二是 harness-to-CLM 蒸馏管线——把现有 harness 的操作表达为上下文变换,翻译成 CLM 动作进而内化进权重,把 harness 视为可被吸收的程序性记忆或任务技能;三是改进服务端,例如在线性注意力层更细粒度(如消息边界)存储 recurrent 状态检查点,消除当前大量未变前缀的冗余 prefill;四是训练原生的上下文长度感知取代环境提示补丁;五是系统研究可编辑上下文的攻击面与防御。基于成果可延伸的方向:把 SCR 的复用思想推广到多租户共享缓存与跨请求记忆;将 CLM 的编辑轨迹作为监督数据反向蒸馏给小模型,缓解收益依赖模型能力的缩水问题;探索上下文编辑与外部记忆系统(MemGPT、Memory-R1 式)的联合训练,让模型统一决策存哪儿、何时取、何时删。
复现评估
复现条件总体中等偏难,分层评估如下。代码已在 GitHub 开源(facebookresearch/context-language-models),ContextBench 连同各方法的 skill 文档一并发布,ContextBench 的任务设计与压力等级均有完整说明。开源模型部分:Qwen3.6-27B 与 Qwen3.5-9B 用 vLLM 即可本地服务(附录给了全部超参:温度 0.7、top-$p$ 0.95、每轮最多 4096 生成 token、预算与轮数上限),BCP、TB2.1、TBLite 的零样本对比和 9B 的 RL 是可复现的;但 RL 需要 16 张 H200 训练策略加 48 张 H200 生成 rollout(70 步),属大厂级算力,多数团队难以原样复现。API 依赖部分:数学优化用 Claude 4.6 Sonnet、技能演化用 Opus 5 与 Claude Fable 5.1、Software World 用 GPT-5.6-Sol(272K 上下文、24 小时连续运行),这些 headline 实验既昂贵又受模型版本漂移影响,复现难度高。SCR 是 SGLang 补丁,论文描述了 radix tree 集成、RoPE 重旋转、会话私有缓存槽和 $K$ 值敏感性分析($K \in \{1,2,3,6,12,64\}$,收益在 $K=6$ 饱和),工程能力强的团队可在自有 SGLang 部署上重现。
论文图表
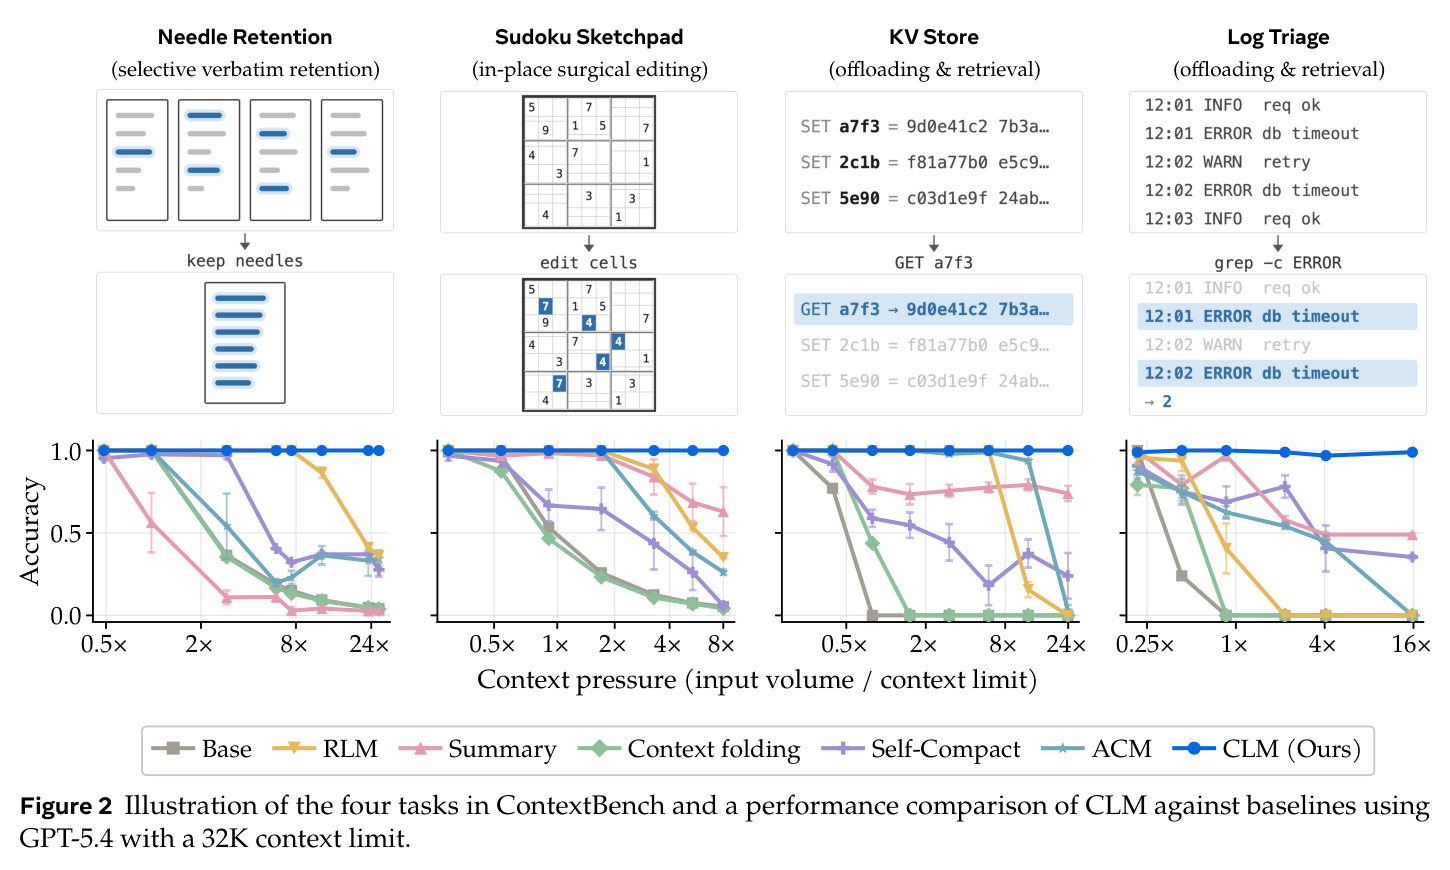
上半部分展示 ContextBench 四个诊断任务(Needle Retention 逐字保留、Sudoku Sketchpad 原位编辑、KV Store 与 Log Triage 外置检索);下半部分在 32K 上下文、压力最高 24 倍下对比 Base、RLM、Summary、Context Folding、Self-Compact、ACM 与 CLM 的准确率曲线,没有任何基线能满分。
这是动机实验:证明现有各类上下文管理策略在刻意简单的任务上都会失败,从而论证需要完全自适应的模型自主管理。
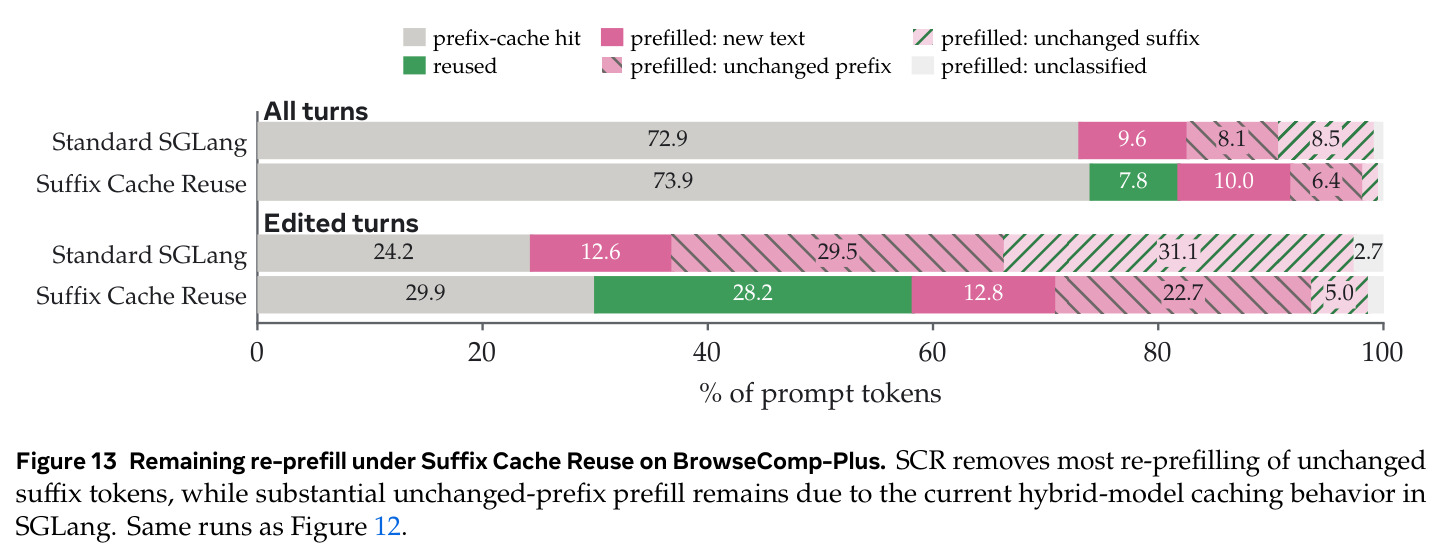
更细的计算分解显示 SCR 已消除编辑后幸存后缀的大部分重填充,但剩余冗余 prefill 主要来自未变前缀——这是 SGLang 对混合模型只在请求边界存线性层 recurrent 状态导致的缓存匹配退化,而非 SCR 本身的问题。
诚实地界定 SCR 的收益边界,并指出服务端下一步改进方向,帮助读者准确评估可获得的加速。
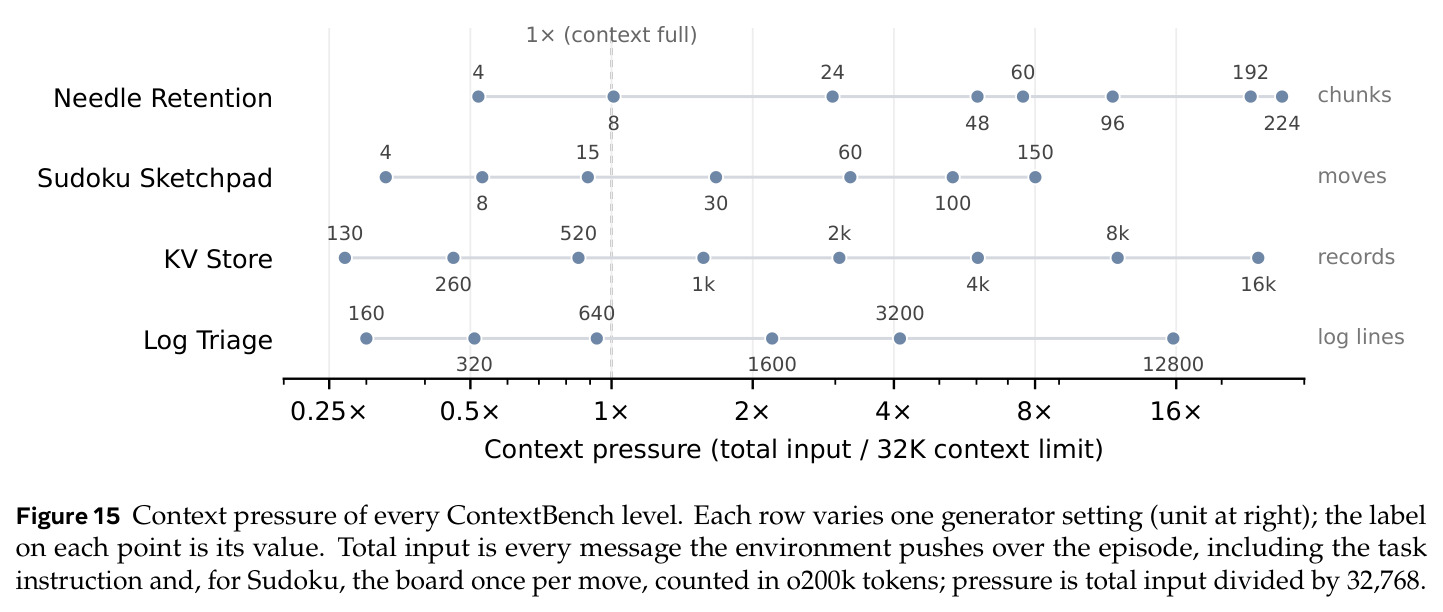
四个任务的每个难度等级的总输入量(以 32,768 token 上限归一化为 0.25×–16×/24× 压力)及对应生成参数(chunk 数、步数、记录数、日志行数),低于 1× 的等级作为装得下的对照组。
说明 ContextBench 如何用单一变量控制上下文压力,保证失败可归因于上下文管理而非任务本身。
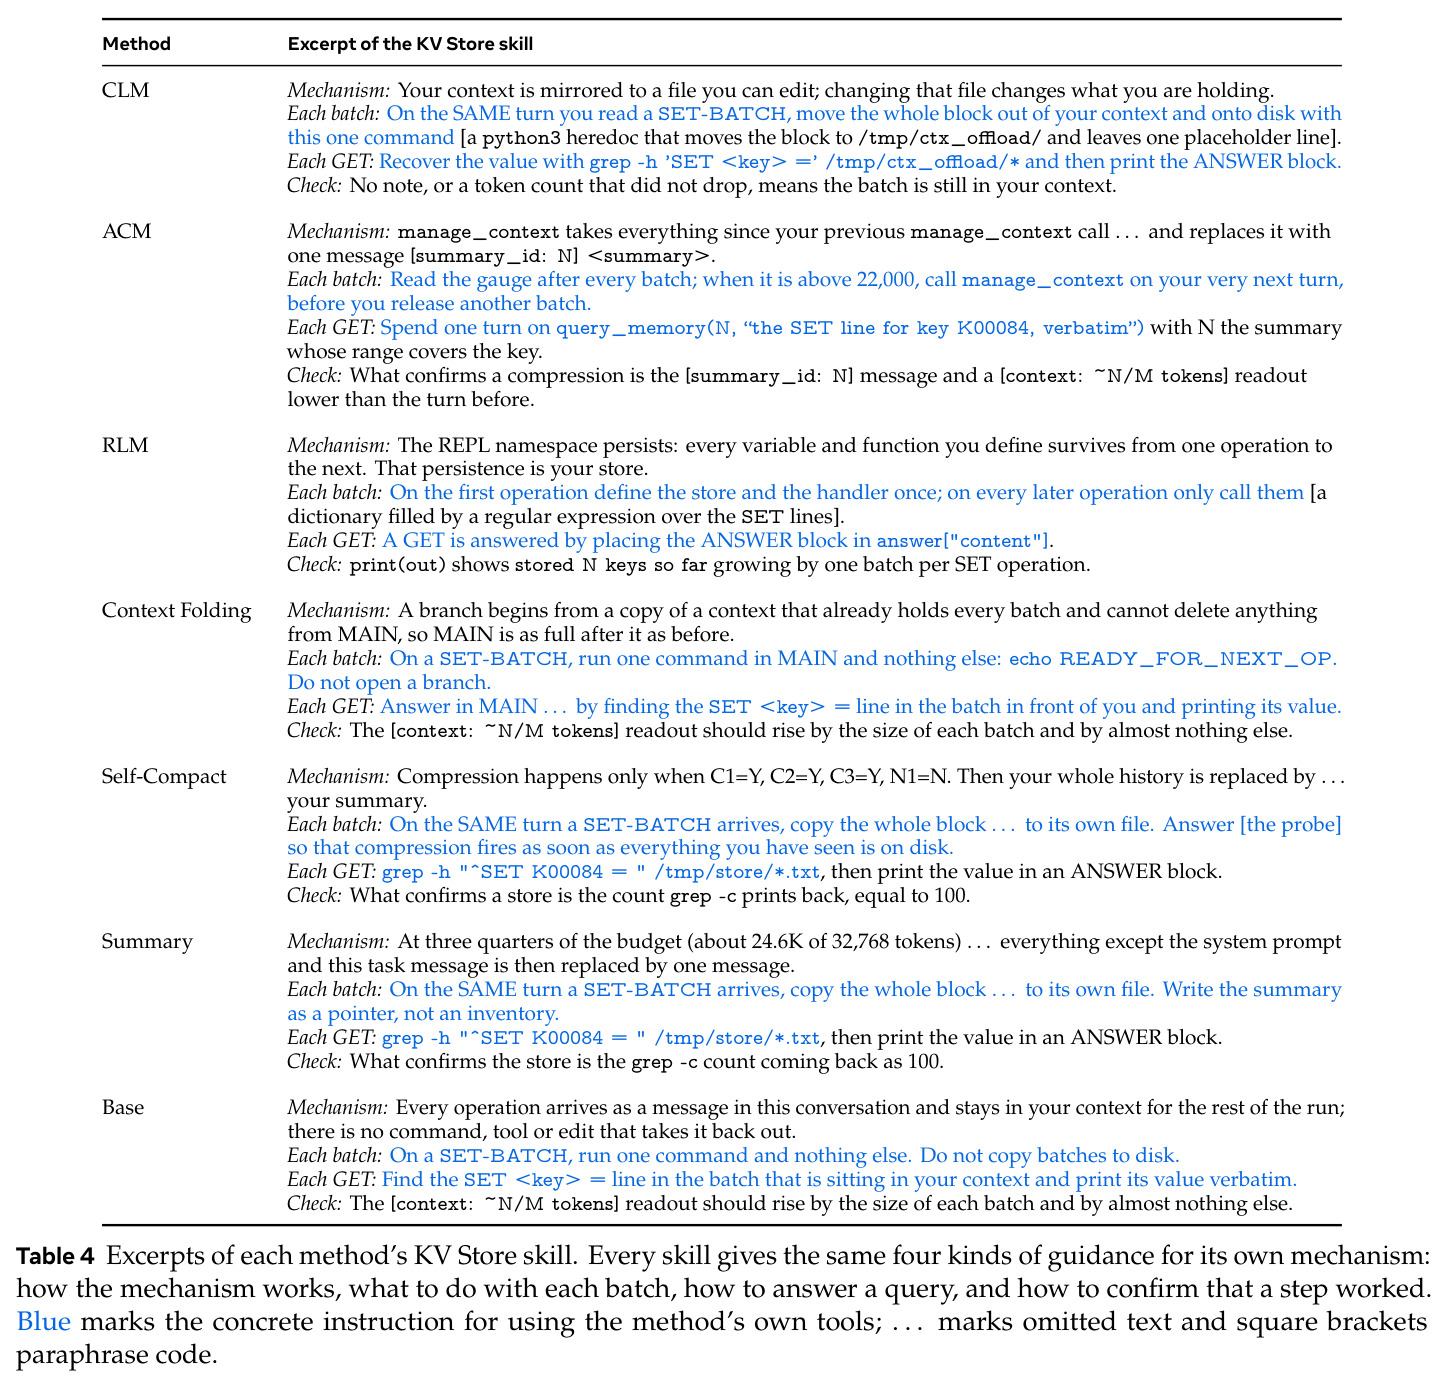
四个任务最小难度下环境推送给智能体的原始消息样例:带 needle 行与 filler 块的 chunk、16×16 数独板与走子指令、100 条 SET 的批次与 GET 查询、日志批次与统计查询,蓝色为期望的 ANSWER 输出格式。
让读者具体理解 ContextBench 考什么:保留、原位更新、外置与精确召回,评测全部从智能体上下文中取材。
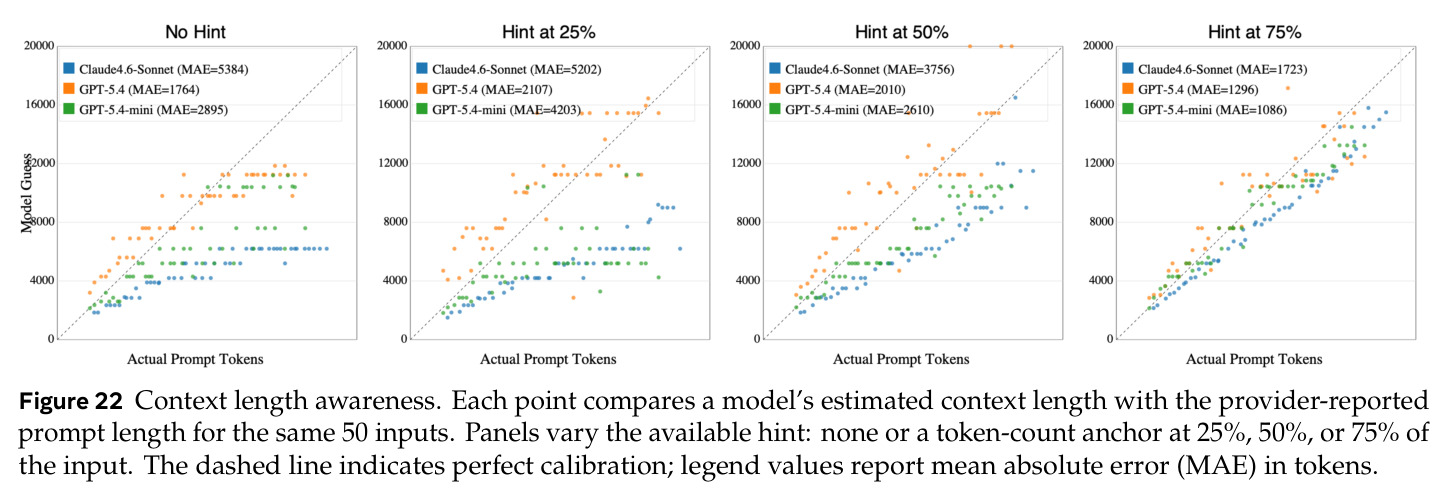
对多个模型在不同提示条件(无提示或 25%/50%/75% 处给 token 锚点)下估计当前上下文长度 vs 实际长度的散点图:模型在长上下文区倾向输出 6.2K、9.8K、10.4K 等桶状值,Claude 4.6 Sonnet 系统性低估,GPT-5.4 校准最好;接近估计点的提示能显著改善。
解释 CLM 为何需要环境提示补丁(预算前 2048 token 提醒),并指出上下文长度感知是未来 CLM 训练应内建的能力。